SPAR:把真实城市空间知识贯穿 SID 构造、继续预训练与 SFT 三个阶段¶
Fangye Wang, Yunjin Gu*, Haowen Lin, Yifang Yuan, Song Yang, Xiaojiang Zhou†, Pengjie Wang AMAP, Alibaba Group(高德地图,北京),* 香港中文大学(深圳),高德实习期间完成;† 通讯作者 arXiv:2609.02062v1 · cs.IR · 2026-09-02 两个公开基准(Foursquare NYC / TKY)+ 四个高德平台级工业数据集(北京 / 上海 / 天津 / 浙江,一个月真实轨迹与交互日志),64 张 A100。 ⚠️ 无线上 A/B、无部署声明:全文没有出现 deploy / online experiment / latency 任何一处,"industrial" 成立的依据是平台规模私有数据而非上线。
研究动机与背景¶
LBS 里"推荐有用"的前提是"用户能到"¶
摘要开门见山地给出本文的价值判断:在 Location-Based Services 里,a recommendation helps only if the user can reach it(推荐只有在用户能到达时才有用)。生成式 POI 推荐(Generative POI Recommendation)把下一个 POI 的预测重述为自回归生成它的 Semantic ID(SID),近年由 TIGER、OneRec、OneRec-V2、PLUM 等工作推成主流:每个 POI 先由文本语义表征经残差量化(RQ-VAE 或 RQ-Kmeans)压成一串由粗到细的码字,LLM 再在被 SID 改写过的用户行为序列上做 SFT,学会自回归生成目标 POI 的 SID;部分方法(PLUM)还在 SFT 之前插一段 CPT,把新增的 SID token 与 LLM 原有知识对齐。
本文对这条流水线的诊断是一句非常锋利的话:地理信息只在 SID 构造这一步作为辅助信号进入,而随后的 CPT 与 SFT 完全由用户行为驱动。因此整条流水线基本上运行在一个由行为共现定义的 interest space(兴趣空间)里,城市空间知识在 tokenization 阶段被不精确地编码,在训练阶段则基本缺席。作者把这个结构性缺陷拆成两条:
(一)tokenization 阶段的地理编码不精确。 经纬度要么被序列化成纯文本语义——数字 token 不携带任何度量结构;要么只通过协同信号与对比目标被间接利用,而这些信号本身派生自共现,无法替代显式的地理度量。于是量化被高方差的语义特征主导,地理退化成一个 weak regularizer,产出的标识符空间缺乏空间连续性:坐标相邻的 POI 不保证 SID 相邻,而语义相似却相距数十公里的 POI(例如同城两家相隔几十公里的连锁分店)反而可能拿到几乎相同的 SID。作者据此提出规范性要求:一个有效的 SID 应当同时编码这个 POI 是什么(what)和它在城市里位于何处(where)。
(二)training 阶段缺失城市空间知识。 这一条是本文与既有 geo-SID 工作真正拉开距离的地方。作者指出:next-POI 预测本质上是在真实城市空间里的移动。用户不是在复现共现模式,而是在物理地行进,因此除了直线邻近性,他们还权衡方向(direction)与可达性(reachability)。而通用 LLM 的 web 规模预训练几乎不提供某个具体城市的细粒度知识;现有的 CPT 通常只是对 POI 文本属性的小规模 warm-up,路网及其连通性从未被学到。只在行为上优化的 SFT 只抓住了兴趣一侧:模型学会了哪些 POI 常被一起访问,却不知道一个候选是否从用户当前位置可达——直线两公里外的 POI 可能隔着一条河或需要长距离绕行。更棘手的是:即便用 CPT 注入了空间知识也不够——在海量行为数据之下,标准 SFT 会把它覆盖掉(overwrite),除非在适配阶段显式保留,模型会重新退回纯行为拟合。
本文方案¶
SPAR 用三个协同阶段分别构建(construct)、培育(cultivate)、保留(preserve)城市空间知识:
- 表征层 — Spatially-Intrinsic SID(SI-SID):用显式正弦(Fourier)地理编码器把原始经纬度抬升成 geospatial embedding,与 POI 的语义嵌入融合后经 RQ-Kmeans 离散化,使每个标识符都锚定到一个具体位置;
- 认知层 — Multi-Granular Geospatial CPT(MG-CPT):在 25 个自建地理空间数据集上继续预训练骨干 LLM,三层递增的空间复杂度(基础属性 / 成对关系 / 城市级导航),把整座城市的空间关系内化进参数;
- 适配层 — Task-Vector Anchored SFT(TV-SFT):把 MG-CPT 学到的知识固化为一个参数空间的 task vector 并冻结,在拟合用户行为的同时防止其灾难性遗忘。
作者承诺开源四个工业级 POI 推荐数据集、每城 25 个数据集的 MG-CPT 训练套件,以及一个 18 任务的空间认知 benchmark。
核心方法 / 模型架构¶
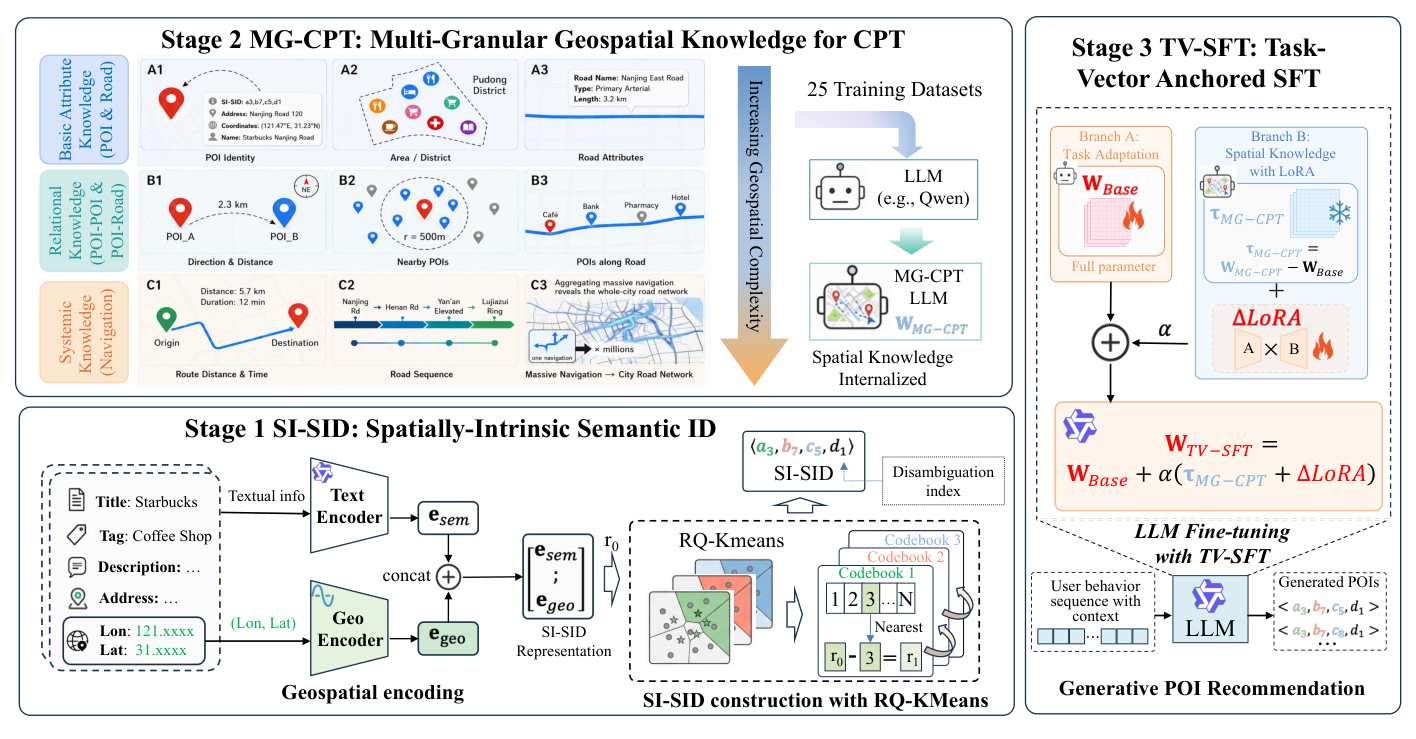
问题形式化¶
令 $\mathcal{U}=\{u_1,\dots,u_M\}$、$\mathcal{P}=\{p_1,\dots,p_N\}$ 分别为用户与 POI 集合。每个 POI 是四元组 $p_i=(\mathrm{lon}_i,\mathrm{lat}_i,\mathrm{addr}_i,\mathrm{ctx}_i)$,含地理坐标、地址与上下文属性(品牌、品类等),并被 RQ-Kmeans 赋予 SID $s_i$。用户 $u$ 的交互轨迹(签到历史)$T_u=\{r_1^u,\dots,r_n^u\}$ 按逆时序排列,每条记录 $r_t^u=(u,p,t,\mathrm{con},a)$ 表示用户 $u$ 在时刻 $t$、条件 $\mathrm{con}$ 下以动作 $a$ 与 POI $p$ 交互。在高德场景里,动作 $a$ 涵盖导航、预约、预订、收藏等行为,条件 $\mathrm{con}$ 捕获实时上下文,如 query、当前坐标及其他元数据。
Next POI Recommendation:给定 $T_u$ 与实时条件 $\mathrm{con}_u$,预测下一个 POI
$$p^{*}_{n+1}=\arg\max_{p\in\mathcal{P}}\ \mathbb{P}(p\mid u,T_u,\mathrm{con}_u)\tag{1}$$
与逐候选打分的判别式方法不同,SPAR 把它形式化为生成式任务:$s_{n+1}$ 以 $(s_1,s_2,\dots,s_n)$ 为条件被自回归解码。
Stage 1:Spatially-Intrinsic SID(SI-SID)¶
显式地理空间编码¶
作者先说明为什么原始经纬度标量不适合直接喂给 LLM:维度上稀疏、与地理距离是非线性(球面)关系、且无法表达经度的固有周期性($-180^\circ\equiv 180^\circ$)。因此借鉴 NeRF 与 Transformer 位置编码,采用显式正弦地理编码器。给定经度 $\lambda$、纬度 $\phi$,先归一化到 $[0,2\pi]$:
$$\hat\lambda=\frac{\lambda+180}{360}\cdot 2\pi,\qquad \hat\phi=\frac{\phi+90}{180}\cdot 2\pi \tag{2}$$
再投影到 $K$ 个指数间隔的频带(超参 $K$ 控制编码粒度):
$$f_k=10000^{-k/K},\qquad k=0,\dots,K-1 \tag{3}$$
得到 Fourier 地理特征 $\gamma(\hat\lambda)\in\mathbb{R}^{2K}$:
$$\gamma(\hat\lambda)=\big[\sin(f_0\hat\lambda),\ \cos(f_0\hat\lambda),\ \dots,\ \sin(f_{K-1}\hat\lambda),\ \cos(f_{K-1}\hat\lambda)\big] \tag{4}$$
$\gamma(\hat\phi)$ 同理。最终地理表征由二者拼接后过一个 Xavier-uniform 初始化的两层 MLP 得到:
$$\mathbf{e}_{geo}=\mathrm{MLP}\big[\gamma(\hat\lambda);\gamma(\hat\phi)\big]\in\mathbb{R}^{d_g},\qquad d_g=4K \tag{5}$$
编码的两条空间性质(令 $u\in[0,2\pi]$ 表示 $\hat\lambda$ 或 $\hat\phi$,逐坐标成立并可延拓到拼接):
Property 1(平移不变核)。 由积化和差恒等式,
$$\langle\gamma(u_1),\gamma(u_2)\rangle=\sum_{k=0}^{K-1}\big[\sin(f_ku_1)\sin(f_ku_2)+\cos(f_ku_1)\cos(f_ku_2)\big]=\sum_{k=0}^{K-1}\cos\big(f_k(u_1-u_2)\big) \tag{6}$$
只依赖位移 $u_1-u_2$ 而与绝对位置无关;又因 $f_k\le f_0=1$,每项 $\cos(f_k\Delta)$ 在 $[0,\pi]$ 上关于 $\Delta$ 递减,而 $\pi$ 这个范围远远覆盖所有城内位移,所以嵌入相似度是坐标位移的单调递减函数。
Property 2(Lipschitz 连续)。 展开平方距离并用 $1-\cos\theta\le\theta^2/2$:
$$\|\gamma(u_1)-\gamma(u_2)\|_2^2=\sum_{k=0}^{K-1}2\big(1-\cos(f_k(u_1-u_2))\big)\ \le\ \Big(\sum_{k=0}^{K-1}f_k^2\Big)(u_1-u_2)^2 \tag{7}$$
编码因此 Lipschitz 连续:坐标相邻保证特征相邻。后续 MLP 是线性层与 ReLU 的复合(Lipschitz 映射的复合),连续性被保留。频率 $f_k=10000^{-k/K}$ 指数间隔,使不同频带以不同速率响应坐标差异,MLP 在端到端训练中学出跨频带的加权组合。
作者诚实地做了一个 Remark:两条性质是对 Fourier 特征 $\gamma$ 陈述的;MLP 精确保留了 Property 2 的连续性,而 Property 1 的"距离—相似度单调性"在学到的投影之后只是定性保留,靠实验验证。另外核依赖的是归一化坐标之差而非测地距离,但在单城尺度内两者近似成正比。
用 RQ-Kmeans 构造 SI-SID¶
语义嵌入 $\mathbf{e}_{sem}\in\mathbb{R}^{d_s}$ 由预训练文本编码器(Qwen3-Embedding-4B)产生,与地理嵌入拼接后做 L2 归一化:
$$\mathbf{x}=\big[\mathbf{e}_{sem};\mathbf{e}_{geo}\big]\big/\big\|[\mathbf{e}_{sem};\mathbf{e}_{geo}]\big\|_2\ \in\mathbb{R}^{d_s+d_g} \tag{8}$$
于是 $\mathbf{x}$ 落在单位超球面上。这一步的作用是防止任一信号因尺度差异主导聚类,同时使基于余弦距离的残差计算成为可能。
融合表征随后经 $L$ 层残差 K-means 量化器离散化。令 $\mathbf{r}^{(0)}=\mathbf{x}$,第 $\ell$ 层码本 $\mathcal{C}_\ell=\{c_\ell^k\}_{k=1}^{N_c}$ 由上一层全体训练 POI 的残差聚类得到:
$$\mathcal{C}_\ell=\text{K-Means}(R_\ell,N_c),\qquad R_\ell=\{\mathbf{r}_i^{(\ell-1)}\}_{i=1}^{N} \tag{9}$$
给定码本后逐层量化:
$$c^{*}_\ell=\arg\min_{c\in\mathcal{C}_\ell}\big\|\mathbf{r}^{(\ell-1)}-c\big\|_2 \tag{10}$$
$$\mathbf{r}^{(\ell)}=\big(\mathbf{r}^{(\ell-1)}-c^{*}_\ell\big)\big/\big(\|\mathbf{r}^{(\ell-1)}-c^{*}_\ell\|_2+\epsilon\big),\qquad \epsilon=10^{-8} \tag{11}$$
注意式 (11) 里残差在传给下一层前被重新归一化,这与标准 RQ 直接前传原始残差不同,是与余弦度量配套的设计。
取 $L=4$:前三层由 RQ-Kmeans 学出,第四层是追加的 disambiguation index,用于区分在前三个码字上碰撞的 POI、保证 SI-SID 唯一(沿用 GNPR-SID 的做法)。SI-SID 记为四元组 $(a^{*},b^{*},c^{*},d^{*})$,如 $\langle a_3,b_4,c_1,d_1\rangle$。每个 SI-SID token 是 SPAR 里空间感知的原子单位,MG-CPT 在其上建立空间推理,TV-SFT 在适配中锚定它。
Stage 2:Multi-Granular Geospatial CPT(MG-CPT)¶
SI-SID 只提供了一个结构上合理的载体,基础模型仍然无法在这些标识符所编码的地理关系上推理。MG-CPT 因此在真实 POI、道路与导航数据上继续预训练,数据按递增的空间复杂度组织成三层。动机直接来自真实 LBS 行为:用户通过推理距离、方向、可达性来选择目的地。
三层地理空间数据体系(共 25 个数据集)¶
- Tier 1 — Basic Attribute Knowledge(POI & Road,13 个数据集):把每个实体锚到它的固有属性上——12 个 POI 数据集建立 SI-SID、坐标与属性(品类、行政区、地址)之间的双向映射;1 个道路数据集刻画单条道路(等级、长度、链路数、车道数、限速)。这一层让 SI-SID token 指代具体地理实体而不是抽象符号,是其余所有空间能力的地基。
- Tier 2 — Relational Knowledge(POI-POI & POI-Road,9 个数据集):教两类成对空间关系。一是真实世界聚集:某位置周边的 POI、某条道路沿线的 POI,反映城市里场所实际如何成簇;二是度量推理:POI 之间的方向与欧氏距离。其中 8 个距离/方向数据集构成一个完全正交的 $2\times2\times2$ 设计——坐标可见性(coord / nocoord)× 推理目标(dis / dir)× 答案格式(choice / open)。coord 与 nocoord 两组的对比直接量化了有多少位置知识被内化,因为后者不提供任何数值提示。
- Tier 3 — Systemic Knowledge(Navigation,3 个数据集):欧氏距离本身会误导——直线距离近的两个 POI 可能因河流、立交或单行道而难以到达。这一层显式引入导航数据的多种形式(路线距离、行程时间、有序道路序列),把三个递进的问题串起来:多远、走哪些路、怎么一步步开,让模型内化整座城市路网的连通性而非记忆单条路线。
四类数据源见 Table 6:
| Source | Information provided | Granularity |
|---|---|---|
| POI snapshot | SI-SID、名称、坐标、地址、品类、行政区… | point (static) |
| Road feature | 道路等级、长度、链路数、车道数、限速… | line (static) |
| POI-pair relation | POI 对的距离与方向,含推导过程… | point–point |
| Navigation route | 驾车距离、时长、道路序列、逐步转向指令… | point–line–point (dynamic) |
所有数据被序列化成 (instruction, input, output) 三元组:instruction 指派"城市地理专家"角色并陈述要求,input 是问题,output 是答案。所有开放式推理任务的输出遵循"答案在前、推导在后"的格式,用自然语言书写,不带任何特殊 reasoning 标签。
距离标注用 Haversine 球面公式(开放式距离任务给出完整推导):
$$a=\sin^2\!\Big(\frac{\Delta\varphi}{2}\Big)+\cos\varphi_1\cos\varphi_2\sin^2\!\Big(\frac{\Delta\lambda}{2}\Big),\qquad d=2R\arcsin\sqrt{a},\quad R=6371\ \text{km} \tag{12}$$
方向判断与部分任务用城市尺度平面近似 $d\approx\sqrt{(\Delta\lambda\cdot 85)^2+(\Delta\varphi\cdot 111)^2}$ km(111 为每纬度公里数,85 为该城纬度上每经度公里数);八方向由 $\Delta\lambda,\Delta\varphi$ 的符号定东西南北,再比较东西位移 $|\Delta\lambda|\cdot 85$ 与南北位移 $|\Delta\varphi|\cdot 111$ 决定是主方向还是复合方向。选项构造上,正确选项位置由主键哈希决定以保证 A–D 均匀分布且可复现;数值干扰项按倍率缩放 ground truth(距离用 ×1.5、×0.6、×2.0、×0.4)或逐步偏移坐标,类别干扰项从循环列表中按与列表长度互质的偏移抽取,防止重复或可被平凡排除的选项。
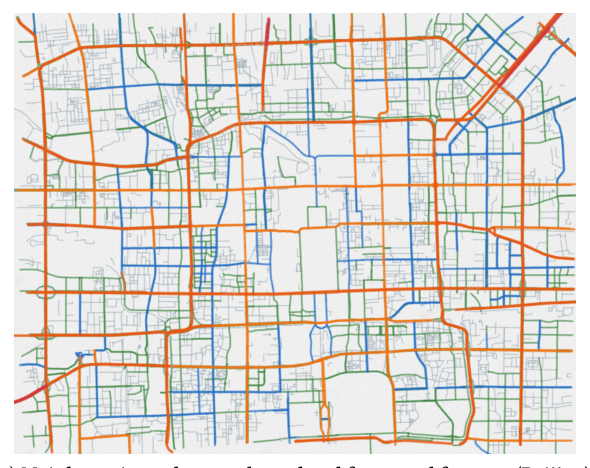
作者用 Figure 8 讲清了为什么要静态路网与动态流量两种信号:Figure 8(a) 由 road feature 渲染出北京的静态路骨架(主干道、环路、快速路的等级、走向与连通性),它只告诉模型路在哪里,街道仍然是空的——不知道人们实际在哪些地方之间往返、走哪条路线。Figure 8(b) 用 2,000 条导航轨迹(训练集实际用约 50,000 条)就已经显出城市的主要流量动脉:每条轨迹把一个起点 POI、一段道路序列、一个终点 POI 穿成一条线,成千上万条叠加后,繁忙走廊被点亮,原本孤立的 POI 变成一张活的交通图上的节点。
继续预训练目标¶
全部数据集被序列化成 next-token-prediction 实例,在标准因果语言建模目标下联合继续预训练:
$$\mathcal{L}_{\text{MG-CPT}}=-\sum_t\log P(x_{t+1}\mid x_1,\dots,x_t) \tag{13}$$
这把参数为 $\mathbf{W}_{Base}$ 的基座 LLM 扩展成参数为 $\mathbf{W}_{\text{MG-CPT}}$ 的城市空间感知 LLM。
Stage 3:Task-Vector Anchored SFT(TV-SFT)¶
由于 MG-CPT 已内化整城空间关系,next-POI 推荐可以被重述为:把用户的行为轨迹投影到真实城市空间上,再从已访问 POI 之间的空间关系推断下一个位置,而不是单纯拟合行为序列。但要实现这一点必须在大规模行为数据上微调,于是出现两难:
- 从 $\mathbf{W}_{\text{MG-CPT}}$ 直接微调 → 刚获得的空间知识被逐渐侵蚀(catastrophic forgetting);
- 从 $\mathbf{W}_{Base}$ 微调 → 行为拟合没有城市空间的接地。
作者受模型编辑与知识注入(task arithmetic、TIES-merging、PAVE)的启发——LLM 获得的某项具体能力可以被表示并操纵为参数空间中的一个方向——提出 TV-SFT,把行为适配与空间保留解耦为两条并行分支。先把 MG-CPT 学到的空间知识分离为一个 task vector:
$$\tau_{\text{MG-CPT}}=\mathbf{W}_{\text{MG-CPT}}-\mathbf{W}_{Base} \tag{14}$$
该向量捕获 MG-CPT 引起的参数变化;由于这一变化仅来自注入的空间知识,$\tau_{\text{MG-CPT}}$ 是空间知识增量的显式参数化表示。两条分支:
- (i) Task Adaptation(学兴趣空间):基座 $\mathbf{W}_{Base}$ 做全参数 SFT 拟合用户行为——这也是既有 GRM 唯一使用的分支;
- (ii) Spatial Knowledge(保城市空间):$\tau_{\text{MG-CPT}}$ 冻结作为锚,同时在 Linear 层权重上施加一个低秩 LoRA 适配器 $\Delta\text{LoRA}=\mathbf{B}\mathbf{A}$,其中 $\mathbf{B}\in\mathbb{R}^{d_{lin}\times r}$、$\mathbf{A}\in\mathbb{R}^{r\times d_{lin}}$,秩 $r\ll d_{lin}$。
因此 TV-SFT 阶段唯一可训练的参数是 $\mathbf{W}_{Base}$ 与 $\Delta\text{LoRA}$,$\tau_{\text{MG-CPT}}$ 保持冻结。两分支合成最终模型:
$$\mathbf{W}_{\text{TV-SFT}}=\mathbf{W}_{Base}+\alpha\big(\tau_{\text{MG-CPT}}+\Delta\text{LoRA}\big) \tag{15}$$
超参 $\alpha$ 控制空间知识强度,默认 1。由于 $\mathbf{W}_{Base}+\tau_{\text{MG-CPT}}=\mathbf{W}_{\text{MG-CPT}}$,这个公式把两个已有范式收成特例:$\alpha=1$ 相当于在 MG-CPT LLM 基础上通过全参数分支加 $\Delta\text{LoRA}$ 微调;$\alpha=0$ 丢弃空间知识,退化为基座的纯全参数 SFT。
训练目标。 给定由历史行为序列与上下文信号拼成的 prompt,微调后的 LLM 自回归生成目标 POI 的 SI-SID $Q_t=\langle a^{*},b^{*},c^{*},d^{*}\rangle$,最小化负对数似然:
$$\mathcal{L}_{\text{TV-SFT}}=-\log P_{\mathbf{W}_{\text{TV-SFT}}}(Q_t\mid \text{prompt})=-\sum_{i=1}^{4}\log P_{\mathbf{W}_{\text{TV-SFT}}}\big(q_i\mid \text{prompt},q_{<i}\big) \tag{16}$$
实验设置¶
数据集(Table 1)。 两个公开基准 NYC、TKY(Foursquare 签到,按时序 8:1:1 切分,预处理沿用 GNPR-SID)+ 四个高德工业数据集:收集并清洗一个月的用户轨迹与交互日志,其中每一次交互都被当作一个预测目标,回溯该用户此前的行为构造历史序列,于是每个 (history, target) 对构成一个完整训练实例;最后一天的交互留作测试集,更早的全部用于训练。
| Type | Dataset | #Users | #POIs | #Instances | Sparsity |
|---|---|---|---|---|---|
| Public | NYC | 2,083 | 5,135 | 104,074 | 98.10% |
| TKY | 2,293 | 7,873 | 361,430 | 98.98% | |
| Industry | Beijing | 5,431,217 | 678,819 | 20,980,626 | 99.99% |
| Shanghai | 4,819,962 | 919,594 | 22,333,204 | 99.99% | |
| Tianjin | 2,552,323 | 499,972 | 15,182,776 | 99.99% | |
| Zhejiang | 11,252,453 | 3,281,512 | 28,068,268 | 99.99% |
评估指标。 Recall@K、NDCG@K、MRR@K,$K\in\{5,10,20\}$,分别度量 top-K 命中覆盖、排序质量与首个正确预测的倒数排名;表中简记 R@K / N@K / M@K。
Baselines 分三类:(1) 传统序列模型 SASRec、BERT4Rec、GRU4Rec、Caser、$S^3$-Rec;(2) Transformer 类 POI 推荐 TPG、Rotan;(3) 生成式推荐模型 TIGER、GNPR-SID、PLUM。
实现细节。 全部实验在 64 张 NVIDIA A100 上完成。骨干 LLM 用 Qwen3-0.6B / -4B / -8B(MG-CPT 与 TV-SFT 共用),POI 表征由对应的 embedding 模型产生;默认 4B。SI-SID 用 $L=4$(三层 RQ-Kmeans + 一个 disambiguation index),$N_c=32$(NYC/TKY)、$N_c=512$(AMAP)。为公平比较,所有 GRM 都采用四级 SID,最后一级作为 disambiguation index。 batch size 32,学习率 $2\times10^{-5}$。
主要实验结果¶
Table 2:公开基准 NYC / TKY¶
| Dataset | Metric | SASRec | BERT4Rec | GRU4Rec | Caser | $S^3$-Rec | TPG | Rotan | TIGER | GNPR-SID | PLUM | SPAR-4B (Rela.Imp) | SPAR-8B (Rela.Imp) |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| NYC | R@5 | 0.3151 | 0.2857 | 0.1977 | 0.2883 | 0.3071 | 0.3551 | 0.4448 | 0.4965 | 0.5311 | 0.5619 | 0.6213 (10.57%) | 0.6556 (16.68%) |
| R@10 | 0.3896 | 0.3564 | 0.2460 | 0.3570 | 0.3854 | 0.4441 | 0.5223 | 0.5514 | 0.5942 | 0.6143 | 0.6686 (8.84%) | 0.6996 (13.89%) | |
| R@20 | 0.4506 | 0.4130 | 0.2889 | 0.4135 | 0.4503 | 0.5121 | 0.5834 | 0.6001 | 0.6455 | 0.6642 | 0.7120 (7.20%) | 0.7649 (15.16%) | |
| N@5 | 0.2224 | 0.2074 | 0.1442 | 0.2044 | 0.2235 | 0.2464 | 0.3471 | 0.4131 | 0.4430 | 0.4672 | 0.5116 (9.50%) | 0.5415 (15.90%) | |
| N@10 | 0.2467 | 0.2304 | 0.1599 | 0.2267 | 0.2489 | 0.2755 | 0.3723 | 0.4276 | 0.4634 | 0.4870 | 0.5363 (10.12%) | 0.5651 (16.04%) | |
| N@20 | 0.2622 | 0.2448 | 0.1708 | 0.2410 | 0.2654 | 0.2927 | 0.3878 | 0.4443 | 0.4766 | 0.4951 | 0.5608 (13.27%) | 0.5906 (19.29%) | |
| TKY | R@5 | 0.3450 | 0.2649 | 0.2514 | 0.3257 | 0.3365 | 0.3725 | 0.4333 | 0.5031 | 0.5354 | 0.5526 | 0.6108 (10.53%) | 0.6474 (17.16%) |
| R@10 | 0.4284 | 0.3326 | 0.3106 | 0.4067 | 0.4115 | 0.4601 | 0.5113 | 0.5808 | 0.6130 | 0.6255 | 0.6712 (7.31%) | 0.7098 (13.48%) | |
| R@20 | 0.4976 | 0.3943 | 0.3651 | 0.4758 | 0.4739 | 0.5291 | 0.5894 | 0.6431 | 0.6675 | 0.6812 | 0.7217 (5.95%) | 0.7623 (11.91%) | |
| N@5 | 0.2384 | 0.1907 | 0.1833 | 0.2273 | 0.2423 | 0.2591 | 0.3293 | 0.4003 | 0.4437 | 0.4659 | 0.4994 (7.19%) | 0.5342 (14.66%) | |
| N@10 | 0.2655 | 0.2127 | 0.2025 | 0.2535 | 0.2666 | 0.2881 | 0.3568 | 0.4251 | 0.4623 | 0.4843 | 0.5116 (5.64%) | 0.5473 (13.01%) | |
| N@20 | 0.2831 | 0.2284 | 0.2163 | 0.2711 | 0.2825 | 0.3051 | 0.3739 | 0.4401 | 0.4788 | 0.4936 | 0.5331 (8.00%) | 0.5712 (15.72%) |
结论一:GRM 显著优于其它两类。 六个指标上 GRM(TIGER / GNPR-SID / PLUM / SPAR)一致超越传统与 POI 专用方法:NYC R@5 上最好的 GRM(0.6556)比最好的传统方法(0.3071)高 113.5%,比最好的 POI 专用方法(0.4448)高 47.4%。作者的解释是:自回归解码更完整地建模了 user–POI 依赖,绕开了判别式方法在候选打分阶段的表征瓶颈。
结论二:SPAR 显著优于既有生成式 baseline。 SPAR-8B 在所有指标上超过最强 baseline PLUM(8B),相对提升 11.91%–19.29%。值得注意的是 SPAR-4B 也在每个指标上超过所有 baseline,说明强化空间感知带来的收益大于单纯扩参。
Table 3:四个高德工业数据集¶
| Dataset | Beijing R@5 / N@5 / M@5 | Shanghai R@5 / N@5 / M@5 | Tianjin R@5 / N@5 / M@5 | Zhejiang R@5 / N@5 / M@5 | Ave.Imp |
|---|---|---|---|---|---|
| TIGER (8B) | 0.4112 / 0.2959 / 0.2452 | 0.3426 / 0.2328 / 0.1924 | 0.3362 / 0.2373 / 0.2029 | 0.4358 / 0.2808 / 0.2432 | −17.54% |
| GNPR-SID (8B) | 0.4243 / 0.3272 / 0.2840 | 0.3593 / 0.2501 / 0.2215 | 0.3624 / 0.2590 / 0.2241 | 0.4404 / 0.3209 / 0.2843 | −6.19% |
| PLUM (8B) | 0.4514 / 0.3403 / 0.3017 | 0.3704 / 0.2712 / 0.2396 | 0.3910 / 0.2761 / 0.2408 | 0.4665 / 0.3518 / 0.3006 | (Base) |
| SPAR-0.6B | 0.4729 / 0.3546 / 0.3193 | 0.4062 / 0.2975 / 0.2469 | 0.4310 / 0.3083 / 0.2631 | 0.4892 / 0.3618 / 0.3165 | 9.92% |
| SPAR-4B | 0.5708 / 0.4325 / 0.3866 | 0.4910 / 0.3656 / 0.3241 | 0.5051 / 0.3775 / 0.3352 | 0.5424 / 0.4079 / 0.3633 | 28.54% |
| SPAR-8B | 0.6176 / 0.4643 / 0.4113 | 0.5353 / 0.3968 / 0.3502 | 0.5528 / 0.4122 / 0.3654 | 0.5708 / 0.4266 / 0.3825 | 38.32% |
| R.I (8B→4B) | 8.20% / 7.35% / 6.39% | 9.02% / 8.53% / 8.05% | 9.44% / 9.19% / 9.00% | 5.23% / 4.58% / 5.28% | – |
工业规模上优势保持。 SPAR-8B 在四个数据集上全面超过 PLUM,R@5/N@5/M@5 平均相对增益 38.32%;SPAR-4B 与 SPAR-0.6B 分别是 28.54% 与 9.92%。尤其值得注意:连 0.6B 变体也在全部十二个指标上超过所有 8B baseline。 作者强调与 PLUM 对比特别有信息量,因为 PLUM 实例化的正是一条通用的 SID–CPT–SFT 流水线,而 SPAR 是把这三个阶段全部围绕城市空间知识重组。因此四个城市上一致的增益来自"让每个阶段都空间感知",而不是多阶段流水线本身——这说明在生产 LBS 数据的噪声、稀疏与分布漂移之下,这类知识格外有价值。
模型 scaling 持续有效。 性能随规模单调增长,相对 PLUM 的平均增益从 0.6B 的 9.92% 升到 4B 的 28.54% 与 8B 的 38.32%;4B→8B 每个指标仍能再加 4.58%–9.44%。作者的解读是更大的 LLM 更能存储与理解城市空间知识。
消融与分析¶
Table 4:四个工业数据集上的逐阶段消融¶
四个变体逐步叠加组件:TextOnlyGR(纯文本 SID + FullSFT)→ SPAR-NoCPT(SI-SID + FullSFT)→ SPAR-FullSFT(SI-SID + MG-CPT + FullSFT)→ SPAR(SI-SID + MG-CPT + TV-SFT)。Ave.Imp 是相对 TextOnlyGR 的九个指标的平均相对提升;R.I(TV-SFT) 是 SPAR 相对 SPAR-FullSFT 的相对提升,用以隔离 TV-SFT 的贡献。
| Dataset | Model | R@5 | R@10 | R@20 | N@5 | N@10 | N@20 | M@5 | M@10 | M@20 | Ave.Imp |
|---|---|---|---|---|---|---|---|---|---|---|---|
| Beijing | TextOnlyGR | 0.4391 | 0.5423 | 0.6455 | 0.3059 | 0.3392 | 0.3654 | 0.2552 | 0.2689 | 0.2761 | – |
| SPAR-NoCPT | 0.4656 | 0.5790 | 0.6768 | 0.3566 | 0.3933 | 0.4181 | 0.3138 | 0.3291 | 0.3359 | 14.62% | |
| SPAR-FullSFT | 0.5324 | 0.6429 | 0.7321 | 0.3975 | 0.4334 | 0.4560 | 0.3527 | 0.3676 | 0.3739 | 27.34% | |
| SPAR | 0.5708 | 0.6813 | 0.7702 | 0.4325 | 0.4684 | 0.4910 | 0.3866 | 0.4015 | 0.4078 | 37.47% | |
| R.I(TV-SFT) | 7.21% | 5.97% | 5.20% | 8.80% | 8.07% | 7.67% | 9.61% | 9.22% | 9.06% | – | |
| Shanghai | TextOnlyGR | 0.3706 | 0.4794 | 0.5861 | 0.2693 | 0.3045 | 0.3315 | 0.2292 | 0.2437 | 0.2512 | – |
| SPAR-NoCPT | 0.4056 | 0.5165 | 0.6164 | 0.2907 | 0.3267 | 0.3520 | 0.2528 | 0.2677 | 0.2746 | 8.14% | |
| SPAR-FullSFT | 0.4376 | 0.5486 | 0.6537 | 0.3204 | 0.3564 | 0.3830 | 0.2817 | 0.2966 | 0.3039 | 17.91% | |
| SPAR | 0.4910 | 0.5989 | 0.6927 | 0.3656 | 0.4007 | 0.4245 | 0.3241 | 0.3386 | 0.3452 | 32.09% | |
| R.I(TV-SFT) | 12.20% | 9.17% | 5.97% | 14.11% | 12.43% | 10.84% | 15.05% | 14.16% | 13.59% | – | |
| Tianjin | TextOnlyGR | 0.3801 | 0.4881 | 0.5961 | 0.2646 | 0.2996 | 0.3269 | 0.2331 | 0.2475 | 0.2551 | – |
| SPAR-NoCPT | 0.4050 | 0.5149 | 0.6184 | 0.2948 | 0.3304 | 0.3567 | 0.2585 | 0.2732 | 0.2804 | 8.64% | |
| SPAR-FullSFT | 0.4380 | 0.5516 | 0.6571 | 0.3225 | 0.3593 | 0.3861 | 0.2843 | 0.2996 | 0.3070 | 17.97% | |
| SPAR | 0.5051 | 0.6191 | 0.7171 | 0.3775 | 0.4145 | 0.4394 | 0.3352 | 0.3506 | 0.3575 | 35.67% | |
| R.I(TV-SFT) | 15.32% | 12.24% | 9.13% | 17.05% | 15.36% | 13.80% | 17.90% | 17.02% | 16.45% | – | |
| Zhejiang | TextOnlyGR | 0.4719 | 0.5920 | 0.6992 | 0.3240 | 0.3628 | 0.3901 | 0.2884 | 0.3044 | 0.3120 | – |
| SPAR-NoCPT | 0.4995 | 0.6135 | 0.7096 | 0.3695 | 0.4065 | 0.4309 | 0.3265 | 0.3418 | 0.3486 | 11.53% | |
| SPAR-FullSFT | 0.5129 | 0.6269 | 0.7224 | 0.3797 | 0.4167 | 0.4409 | 0.3356 | 0.3509 | 0.3577 | 14.88% | |
| SPAR | 0.5424 | 0.6506 | 0.7379 | 0.4079 | 0.4431 | 0.4653 | 0.3633 | 0.3779 | 0.3841 | 23.29% | |
| R.I(TV-SFT) | 5.74% | 3.77% | 2.15% | 7.43% | 6.33% | 5.54% | 8.25% | 7.70% | 7.37% | – |
作者给出三条结论:
(1)SI-SID 与 MG-CPT 支撑起分层的空间感知。 TextOnlyGR → SPAR-NoCPT 的平均提升为 10.76%,证明 SI-SID 通过 RQ-Kmeans 把地理邻近性直接写进标识符结构,提供了一个拓扑载体,让模型能把"空间上合理"的候选与"语义相似但很远"的候选区分开。再引入 MG-CPT(SPAR-NoCPT → SPAR-FullSFT)又带来 15.38% 的增益,说明在多粒度空间数据上继续预训练确实教会了模型 POI 位置以及 POI–道路之间的空间关系。两阶段一致且不重叠的增益验证了 SI-SID 解决 "where" 接地问题、MG-CPT 解决 "空间关系理解" 问题的分工。
复核提醒(本人核算):"15.38%" 无法从 Table 4 复现。 按论文自己 Ave.Imp 的口径(九个指标相对提升的平均),SPAR-FullSFT 相对 SPAR-NoCPT 的相对提升为北京 11.08%、上海 9.00%、天津 8.60%、浙江 2.51%,四城均值约 7.9%;若改按 Ave.Imp 的百分点差值(27.34−14.62 等),四城均值为 8.79 个百分点。两种口径都远低于 15.38%。另外浙江 SPAR-NoCPT 的 Ave.Imp 我复算为 9.41% 而非表中的 11.53%(北京 14.62、上海 8.14、天津 8.64 三城我均能精确复现,说明口径无误)。这两处不影响定性结论,但属于确凿的数值不一致。
(2)TV-SFT 通过保留空间知识取得更好性能。 R.I(TV-SFT) 跨四个数据集在 2.15%–17.90% 之间,天津增益最大(R@5 15.32%、N@5 17.05%、M@5 17.90%)。作者的解释是:MG-CPT 之后接 Full-SFT 虽然已经优于只有 SI-SID 的基线,但 SFT 中海量的用户行为序列会逐渐淹没 CPT 学到的空间知识,使模型退化成纯行为推荐器;TV-SFT 通过冻结 $\tau_{\text{MG-CPT}}$ 阻止这种稀释,同时用 LoRA 提供轻量精修,使空间知识适应共现的行为模式。
(3)完整框架的累积优势。 SPAR 相对 TextOnlyGR 在四个数据集上提升 23.29%–37.47%,远超各组件单独贡献的简单相加,说明三者之间存在正协同:高质量的空间标识符是有效继续预训练的前提,而 task-vector 锚定的微调保证了预训练空间知识在下游被完整释放。
Figure 2:空间邻近性与阶段演化¶
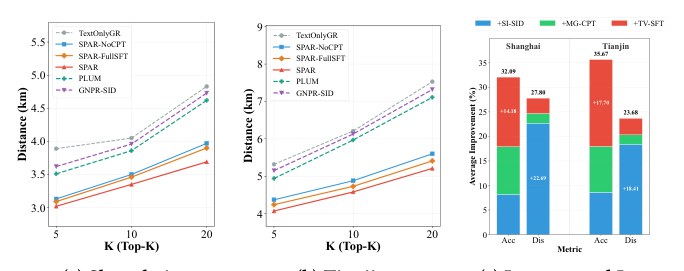
Figure 2(a)/(b) 画的是 Top-K 推荐 POI 与用户实时位置之间的平均 haversine 距离(Dis@K),Figure 2(c) 把相对 TextOnlyGR 的累积改进(来自 Table 4)分解到三个阶段。
(1)SI-SID 奠定空间基础:把推荐拉近用户。 TextOnlyGR、GNPR-SID、PLUM 的标识符都从含坐标与地址的文本描述导出,还被对比目标与协同信号进一步强化,但它们的 Dis@5 在上海仍是 3.51–3.89 km、天津 4.94–5.32 km。SI-SID 改为在量化之前把归一化地理特征融进表征,使邻近性成为码本的结构性质:与这些基线主要差别就在 SI-SID 的 SPAR-NoCPT 直接把 Dis@5 压到 3.13 km 与 4.37 km,同时准确率提升 8.14% 与 8.64%。
(2)MG-CPT 与 TV-SFT 是准确率提升的主要驱动。 加入 MG-CPT 使准确率从 8.14% 提到 17.91%(上海)、8.64% 提到 17.97%(天津),而最后的 TV-SFT 阶段带来最大的一段增益(累计到 32.09% 与 35.67%),距离则继续下降(累计减少 27.80% 与 23.68%)。
(3)阶段演化印证 SPAR 的设计。 距离下降由 SI-SID 主导(上海 22.69 / 27.80 个百分点、天津 18.41 / 23.68 个百分点来自 SI-SID),准确率提升由 MG-CPT 与 TV-SFT 主导(上海 TV-SFT 一段就贡献 +14.18 个百分点、天津 +17.70)。 论文明确写下这条分工:SI-SID 把空间拓扑嵌进标识符词表,MG-CPT 与 TV-SFT 在其上培育与保留空间推理。
Table 5:冷启动 / 热启动¶
按用户行为序列长度切分:冷启动(< 8)与热启动(≥ 16);注意 query 与实时位置在两种设定下都可用,稀疏的只是历史交互。
| Task | Metric | Shanghai TextOnlyGR | Shanghai SPAR | Zhejiang TextOnlyGR | Zhejiang SPAR |
|---|---|---|---|---|---|
| Cold-start | R@5 | 0.2821 | 0.4164 | 0.3033 | 0.4490 |
| N@5 | 0.2107 | 0.3157 | 0.2442 | 0.3286 | |
| M@5 | 0.1705 | 0.2608 | 0.1981 | 0.2735 | |
| Warm-start | R@5 | 0.3908 | 0.5106 | 0.4922 | 0.5654 |
| N@5 | 0.2950 | 0.3773 | 0.3512 | 0.4217 | |
| M@5 | 0.2593 | 0.3483 | 0.2911 | 0.3661 |
TextOnlyGR 在历史稀疏时严重退化:R@5 在上海掉 27.9%(0.3908→0.2821)、浙江掉 38.3%(0.4922→0.3033)。SPAR 在两种设定下都提升,且冷启动增益明显更大:R@5 在上海 +47.6%、浙江 +48.0%,而热启动只有 +30.7% 与 +14.9%。作者把这归因于 SI-SID 的拓扑接地标识符与 MG-CPT 学到的空间关系提供了可补偿缺失历史的排序信号。SPAR 因此把冷—热 R@5 差距从 27.9%–38.3% 收窄到 18.5%–20.6%。
Figure 3:SI-SID 的分层可视化¶
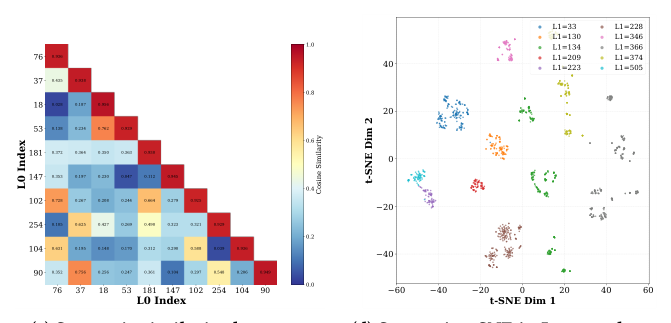
对 top-10 的 L0 簇做语义 t-SNE(3a)、地理坐标散点(3b)、簇间余弦相似度热图(3c),并放大 L0=102 看它的 top-10 L1 子簇(3d)。
L0 簇同时具备语义一致性与地理可区分性。 同一 L0 簇内的 POI 在语义 t-SNE 上形成紧致组(3a),热图(3c)显示对角线(簇内)相似度高达 0.925–0.956,而簇间大量落在 0.03–0.76;同时不同 L0 簇占据几乎不重叠的地理区域(3b)。这说明第一级量化主要按地理邻近性划分 POI;它们的语义一致性很可能是派生现象——相邻城市区域往往共享相似的业态构成或功能角色。
L1 子簇捕获地理之外的细粒度语义区分。 在 L0=102 内部,top-10 的 L1 子簇在语义上清晰分离(3d),地理上却互相重叠(3b 的插图)。原因很直白:L0 簇内的 POI 已经地理邻近,地理维度在第一级基本被耗尽,传给 L1 的残差因此由语义变化主导。这条 "L0 地理划分 → L1 语义精修" 的由粗到细演进,使 SPAR 能把 L0 的粗地理约束与细粒度语义偏好结合,在用户位置与 query 意图的条件下做检索。
Figure 4:MG-CPT 的空间认知评测(18 任务 benchmark)¶
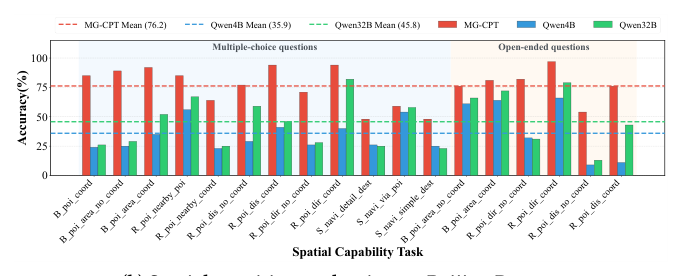
每个工业数据集配一个 benchmark,各含 18 个任务、2,000 道题,涵盖选择题与开放式两种格式。任务名由类别前缀(B / R / S = 基础属性 / 关系 / 系统)加能力后缀构成:dis/dir 为距离/方向推理,area/nearby 为区域/周边查询,navi 为导航;coord/no_coord 后缀指示题面是否给出坐标,后者强制模型依赖内化的地理知识。
- 地理空间认知是 MG-CPT 灌进去的,不是靠规模得来的。 MG-CPT 把 4B 骨干(Qwen3-4B)的平均准确率从 36.8 提到 76.1(绝对 +39.3 点,是基线的 2 倍多),并超过大 8 倍的 Qwen3-32B(45.3)达 30.8 点。上海 benchmark 上 MG-CPT 均值 78.1 vs Qwen4B 35.9 / Qwen32B 44.3;北京 76.2 vs 35.9 / 45.8。
- 扩大通用 LLM 只带来边际的空间增益。 通用骨干 4B→32B 平均只提升 8.5 点(36.8→45.3),比 MG-CPT 的增益小一个数量级。这证明工业规模预训练本身无论多大都不赋予模型某个具体城市的细粒度地理知识,必须显式培育。
- MG-CPT 内化的是城市的地理布局,而不是在给定坐标上做计算。 基座 LLM 严重依赖显式坐标:Qwen3-32B 在方向题上一旦给出坐标就从 21 跳到 82。而 MG-CPT 在没有坐标时依然强劲(方向类选择题 76、开放题 79),超过无坐标的 Qwen3-32B 三倍以上。这说明 MG-CPT 把对应城市的地理构型编码进了参数,使推理时无需提供坐标也能做度量与方向推理。
- 性能沿三层复杂度梯度分布。 基础属性任务最高(80–95),关系任务居中,系统导航任务最低(48–65),恰好镜像训练数据的组织方式。导航仍是最难的一层,但 MG-CPT 在其上依然大幅超过两个基线,说明连城市级连通性也被部分内化。
Figure 5:Case Study——邻近性 vs 可达性¶
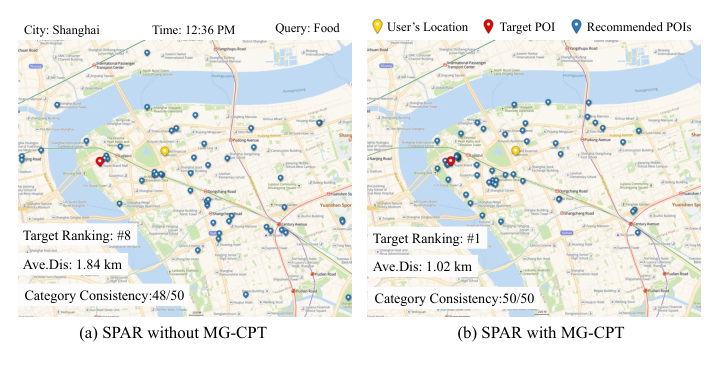
同一个上海用户(query: Food,时间 12:36 PM),对比 SPAR 有无 MG-CPT 时的 top-50 推荐:
- 无 MG-CPT:推荐在语义上已经站得住(50 个里 48 个与目标同品类),但空间上散乱——平均距离 1.84 km,目标只排到 #8。许多候选甚至落在河的对岸:直线距离近、品类正确,但只能绕桥或隧道才能到达。
- 有 MG-CPT:推荐集中在用户所在河岸、沿周边道路分布,平均距离降到 1.02 km(−44.6%),品类一致性升到 50/50,目标被提到 #1。
作者强调:由于两个变体在品类一致性上本就相当,改进来自空间接地而非更好的语义。这个 case 把"地理上近"与"实际可达"这两件事的区别做实了。
Figure 6:TV-SFT 的超参分析¶
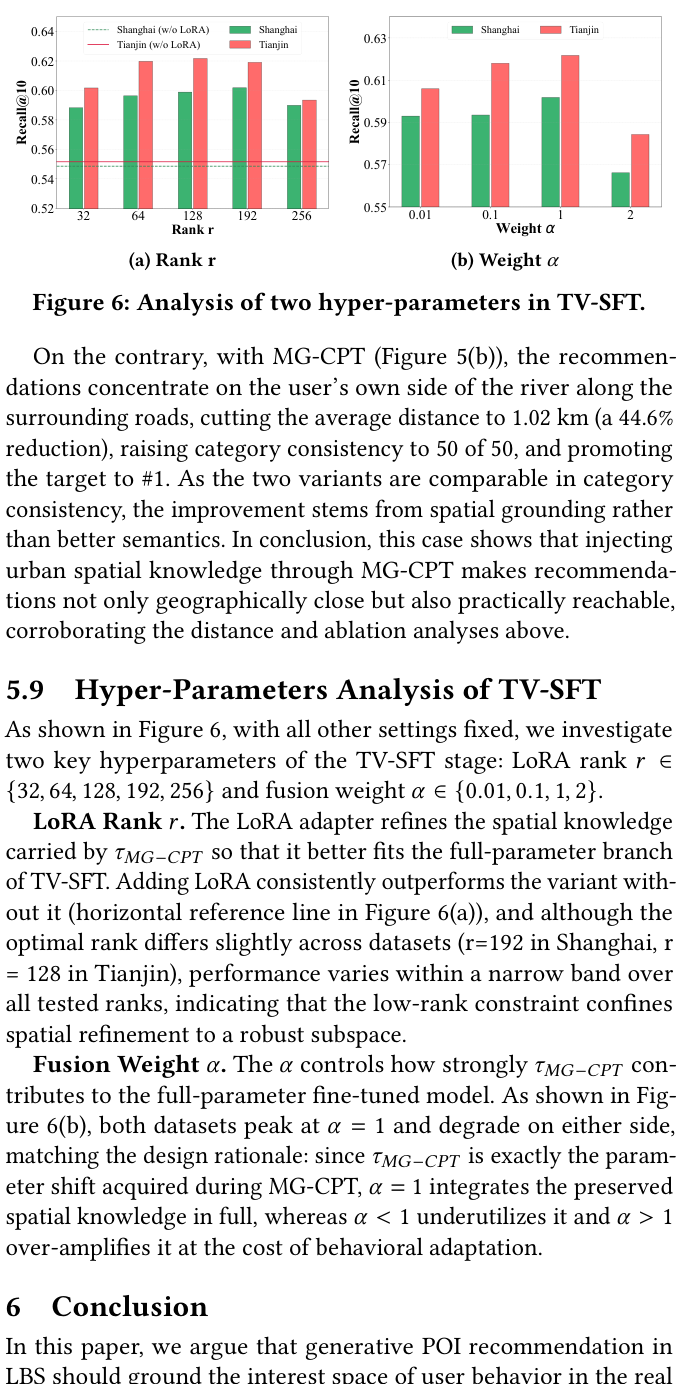
固定其余设置,考察 LoRA 秩 $r\in\{32,64,128,192,256\}$ 与融合权重 $\alpha\in\{0.01,0.1,1,2\}$(指标为 Recall@10)。
LoRA 秩 $r$。 LoRA 适配器精修 $\tau_{\text{MG-CPT}}$ 携带的空间知识,使其更好地契合 TV-SFT 的全参数分支。加 LoRA 一致优于不加(图中水平参考线);最优秩略有差异(上海 $r=192$、天津 $r=128$),但所有秩下性能都落在一个窄带内,说明低秩约束把空间精修限制在一个稳健的子空间里。
融合权重 $\alpha$。 两个数据集都在 $\alpha=1$ 取峰值并向两侧退化,与设计动机吻合:$\tau_{\text{MG-CPT}}$ 恰是 MG-CPT 阶段获得的参数位移,$\alpha=1$ 完整整合被保留的空间知识;$\alpha<1$ 利用不足,$\alpha>1$ 过度放大并牺牲行为适配。
复核提醒(本人从图中读数):图 6(a) 的 "w/o LoRA" 水平参考线在上海约 0.551、天津约 0.553,而 Table 4 中 SPAR-FullSFT 的 R@10 分别是 0.5486 与 0.5516。也就是说,只冻结 $\tau_{\text{MG-CPT}}$ 作为锚、不加 LoRA 时,相对 Full-SFT 只提升约 +0.4% / +0.3%;而完整 TV-SFT 达到 0.5989 / 0.6191。R.I(TV-SFT) 的绝大部分其实来自那个可训练的 LoRA 分支,而不是来自 TV-SFT 这一节所命名的"防遗忘"机制本身。 详见"讨论与局限性"。
附录 A:地理编码器的实证验证¶
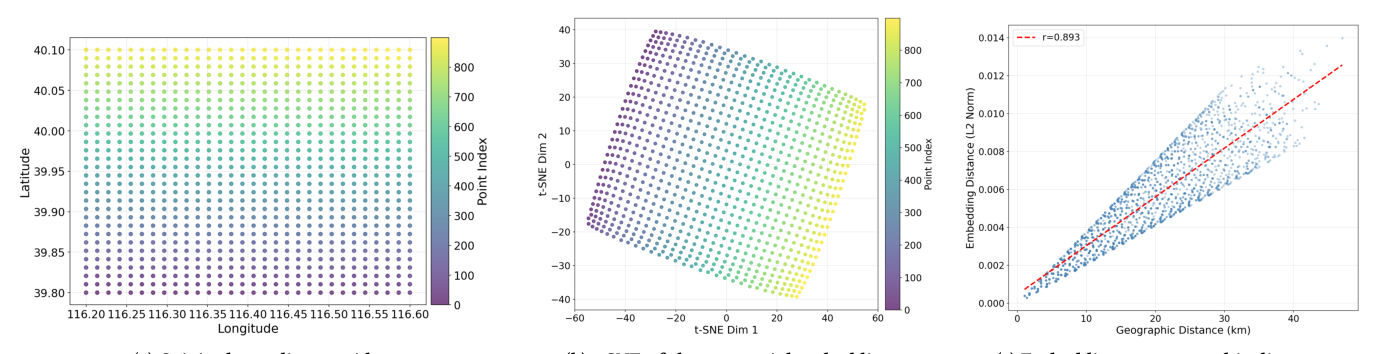
在北京城区(116.2°–116.6°E、39.8°–40.1°N,约 44 km × 33 km)上取 30×30 = 900 点的均匀坐标网格,编码后检查嵌入几何:
- 平移不变性表现为嵌入格点的规整性:900 个嵌入的 t-SNE 投影仍构成一个等间距网格、镜像原网格——同样的坐标步长在任何位置引起几乎相同的嵌入变化,城市的任何区域都没有被拉伸或压缩,这正是 Property 1 预言的位置无关响应。
- 连续性与度量保持:在采样点对上,嵌入距离随地理距离单调且近线性增长,Pearson $r=0.893$。
作者进一步指出,这个编码器层面的几何性质与正文里标识符层面的层次结构互相印证:因为融合表征带着显式的坐标度量结构,第一级量化继承了它并主要按地理邻近性划分;一旦第一级码字吸收了这个共享的地理成分,传给更深层的残差就由语义变化主导——于是同一 L0 簇内的 L1 子簇地理重叠而语义清晰分离。从坐标编码到空间连续标识符的链条由此闭合。
核心贡献总结¶
- 把"空间感知"从 tokenization 一个点扩展到整条训练生命周期:SI-SID(构建)→ MG-CPT(培育)→ TV-SFT(保留)。这是本文与所有既有 geo-SID 工作最本质的区别——后者几乎全部只动 tokenizer。
- SI-SID 的 Fourier 地理编码器带两条可证明的性质(平移不变核 + Lipschitz 连续)并给出实证验证(Pearson $r=0.893$、t-SNE 网格保形),把"坐标相邻 ⇒ 嵌入相邻 ⇒ SID 前缀相邻"这条链条讲透。
- MG-CPT 是本文最有独立价值的资产:25 个自建数据集,三层递增复杂度(13 个基础属性 + 9 个关系 + 3 个系统导航),用 ~50,000 条真实导航轨迹把静态路骨架填成活的交通图;配套的 18 任务空间认知 benchmark 让"LLM 到底懂不懂这座城市"第一次可测量。一个 4B 的 CPT 模型在无坐标条件下的方向推理超过 Qwen3-32B 三倍以上,是全文最有说服力的单点结论。
- TV-SFT 把 task arithmetic 引入推荐 SFT:$\mathbf{W}=\mathbf{W}_{Base}+\alpha(\tau+\Delta\text{LoRA})$ 这个形式优雅地把"从 CPT 模型微调"($\alpha=1$)与"从基座微调"($\alpha=0$)收成两个特例。
- 平台级验证广度:四座城市 / 一个月日志 / 5.4M–11.3M 用户 / 0.5M–3.3M POI,三个模型规模(0.6B/4B/8B)的单调 scaling,冷启动子集分析,距离与准确率的正交分解。
- 承诺开源四个工业数据集 + 每城 25 个 MG-CPT 数据集 + 18 任务 benchmark。
与已归档相关工作的对比¶
HF-SID HF-SID: High-Fidelity Semantic IDs for Generative Retrieval in LBS(AMAP, Alibaba,2026-08-31)¶
关系:同公司同团队的独立并发(SPAR 引文列表中完全没有 HF-SID,两篇相隔两天)· 已加载对方精读
- 作者层面的核对结果:两篇的作者集合高度重叠——Fangye Wang(SPAR 一作 / HF-SID 第四作者)、Haowen Lin(HF-SID 共同一作 / SPAR 第三作者)、Song Yang、通讯作者 Xiaojiang Zhou、末位作者 Pengjie Wang 五人同时出现在两篇上。这不是两个团队,是同一个团队在两天内投出的两篇论文。但 SPAR 的 41 条参考文献里没有任何一条指向 arXiv:2608.30479,正文也从未出现 "HF-SID" 或 "High-Fidelity" 字样;HF-SID 因为早两天出,自然也未引用 SPAR。两篇互不引用。
- 共同关注的问题:root cause 陈述几乎可以互换。HF-SID:SID 是 POI 信息到达生成模型的唯一通道,tokenizer 把坐标切成数字子 token 的那一刻精度就没了,下游任何网格、旋转或聚类都无法恢复一个从来就不连续的值。SPAR:经纬度被序列化成纯文本时数字 token 不携带任何度量结构,量化被高方差语义主导,地理退化成 weak regularizer。两者都把病根定位在量化之前,都主张"标识符必须同时编码 what 与 where"。
- 相近的技术骨架:流程图可以叠合——用一个连续性保持的编码器把坐标抬升成稠密表征 → 与文本语义表征融合 → 交给基本未改动的残差量化器。两者都不改量化算法本身,都用 RQ-Kmeans/K-means 残差量化,都用 Qwen3 系列骨干,都跑在 64 张 A100 上,都在 Foursquare NYC/TKY 上做公开验证。
- 本文的差异与推进(两套完全不同的空间编码,且融合位置相反):
- HF-SID 的地理编码在 LLM 内部:球面→3D 笛卡尔变换(米制)→ 进位连续的"极坐标"标量分解($\bar d_i=(|x|/10^i)\bmod 10$ 让整数进位连续,$(\cos2\pi f,\sin2\pi f)$ 让小数进位连续)→ 冻结的数值编码器把标量升维成一个
[NUM]token,替换进 LLM 的输入嵌入序列,再经 Geo-CPT / Num-CPT 内化,POI 表征取最后一个 token 的隐状态。地理是穿过 LLM 到达表征的。 - SPAR 的 SI-SID 在 LLM 外部:NeRF 式 Fourier 正弦编码($K$ 个指数频带)→ 两层 MLP → $\mathbf{e}_{geo}$ 与文本编码器输出的 $\mathbf{e}_{sem}$ 直接拼接后 L2 归一化,地理向量从不进入 LLM,只在量化器的输入上与语义并列。
- 一个直接的张力:HF-SID 的核心论断之一正是"把地理当作辅助特征拼接/注入到一个混合嵌入里"是失效模式(它点名批评的三条路线里就包含 token 级连续注入)。SPAR 的做法形式上属于被批评的那一类,但它用 Property 1/2 论证自己的 $\mathbf{e}_{geo}$ 本身就是连续且度量保持的,因而不受"值从来就不连续"这条指控约束——并用 Figure 3 显示 L0 确实由地理主导。两篇在同一家公司内部对"地理该在 LLM 里还是 LLM 外"给出了相反的工程判断。
- 标识符长度上也相反:HF-SID 明确以不加长标识符为卖点(3-token,打赢 6-token 的 GenPOI,因为自回归解码步数直接是成本);SPAR 用 4 级(3 个码本 + 1 个 disambiguation index),并要求所有 GRM baseline 也用四级以求公平。
-
SPAR 的真正推进不在 tokenizer 而在训练阶段:HF-SID 的 Geo-CPT/Num-CPT 是为了让 LLM 读懂数值 token(成对距离计算、最近对识别、属性大小比较,三类任务);SPAR 的 MG-CPT 是为了让 LLM 记住一座城市(25 个数据集、含路网与 50,000 条导航轨迹、覆盖可达性而不止直线距离),并配了 18 任务 benchmark 来证明这件事发生了。"reachability(可达性)"这个维度是 HF-SID 完全没有触及的,也是 SPAR 的 Figure 5 case study 里最有说服力的部分(河对岸的候选)。TV-SFT 更是 HF-SID 全无对应物。
-
可比的方法 / 实验差异(以及一处令人不安的空白):两篇的工业数据集切法不同、不可直接比较——HF-SID 的 AMap-L 是完整一天日志(11.0M 用户 / 48.1M POI / 16.3M 交互,$N_c=4096$),SPAR 是一个月、按城市切成四份($N_c=512$)。公开集上勉强可比但口径不同:NYC 上 HF-SID 报 Hit@5 0.5983(Qwen3-4B SFT),SPAR-8B 报 R@5 0.6556、SPAR-4B 0.6213;TKY 上 HF-SID 0.5737,SPAR-8B 0.6474 / SPAR-4B 0.6108。但两者的 baseline 集合几乎不交(HF-SID 重实现了 RQ-KMeans / RQ-OPQ / GNPR-SID / Cosine-RQ / Pro-GEO / GeoGR / GenPOI 七个 SID 方法并同时报 ICR 与 Avg.Dist;SPAR 只有 TIGER / GNPR-SID / PLUM,且不报任何 SID 侧质量指标),因此两篇的公开集数字不能相互替代。更值得注意的是:HF-SID 已在高德首页 POI 推荐链路上线并替换了前代生成式检索系统(按其作者与引文推断即 GeoGR),一周 A/B 平均 PV_CVR +6.74%;而 SPAR 全文没有任何线上实验或部署声明。 同一团队的两条路线里,只有一条走到了线上,另一条(本文)停在离线。SPAR 既不与 HF-SID 比、也不与团队自己的 GeoGR 比,这是它实验部分最大的空白。
LGRID LGRID: Interpretable Representation via LLM-Driven Generative Disentanglement(Kuaishou,2026-07-30)¶
关系:独立并发(SPAR 未引用 LGRID,两者对同一 root cause 给出了相反的处方)· 已加载对方精读
- 共同关注的问题:LGRID 把主流范式命名为 single-representation-then-quantization,并指出其致命处——地理信号被注入的是一个混合的物品表示,量化器仍作用在地理、品牌、品类混杂的潜向量上,于是品牌这类主导信号会遮蔽细粒度但对决策至关重要的地理区分(它的失败案例是 "Beijing–Haidian–KFC" 与 "Shanghai–Xuhui–KFC" 拿到高度相似的 SID)。SPAR 的措辞是"量化被高方差语义特征主导,地理退化成 weak regularizer",并给出同类失败案例(同城相隔数十公里的连锁分店共享几乎相同的 SID)。两篇诊断的是同一个 root cause,甚至举了同构的例子。
- 相近的技术骨架:都在 quantization 之前动手,都保持"由粗到细的残差量化"这个大框架,都用 LLM/文本编码器产生 POI 表征,都以"让地理与语义在码里各占其位"为目标。
- 本文的差异与推进(显式解耦 vs 涌现式解耦):LGRID 认为必须显式解耦,SPAR 证明拼接 + 残差结构可以让解耦自己涌现。 LGRID 用 Structured Disentangled Block 把 LLM 隐状态路由进 4 个地理槽 + 4 个语义槽(锚点初始化、组内自回归 / 组间独立掩码),再用 Synergistic Alignment Learning 做七个课程式 PGD 任务与三族结构化难负例,最后用 Dual-Stream Residual Quantization 把两条流分别离散化成 4-token 可解释 SID。SPAR 则把 $\mathbf{e}_{geo}$ 与 $\mathbf{e}_{sem}$ 简单拼接后联合归一化、单流量化,却在 Figure 3 里观测到了功能等价的分层:L0 主要按地理划分(不同 L0 簇地理几乎不重叠),L1 在 L0 内部按语义精修(地理重叠、语义分离)。SPAR 的解释是"地理维度在第一级被耗尽,传给 L1 的残差由语义主导"。这是一个很有价值的可检验分歧:如果残差量化本身就能把地理与语义分到不同层级,那么 LGRID 的槽位路由 + 双流量化所付出的复杂度买到的到底是什么? LGRID 的答案会是"可解释性与可诊断性"(它报 >99% 的粗粒度地理属性解码准确率、把全 SID 碰撞率从 LGSID 的 97.0% 降到 39.9%),而 SPAR 恰恰完全不报任何 SID 侧指标(碰撞率、码本利用率、簇内地理距离),只报推荐侧的 Dis@K——所以这个分歧目前无法在数据上裁决。
- 可比的方法 / 实验差异:LGRID 的下游是判别式排序(跨 10 个骨干最高 +5.44% 相对 AUC),SPAR 的下游是生成式检索(Recall/NDCG/MRR),指标不可比。另一处对照很有意思:LGRID 用 Table 4 反驳了"把字段独立编码"这条路(相对独立字段级编码有 31.4%–88.5% 的相对 MRR 提升),理由是独立编码阻断了 geo-content 交互——"Apple 出现在电子产品街区更可能是零售商而非水果摊"。SPAR 的拼接方案在这一点上其实站在 LGRID 的对立面更远:$\mathbf{e}_{geo}$ 与 $\mathbf{e}_{sem}$ 由两个完全独立的编码器产生、之间没有任何交互,geo-content 依赖只能靠下游 LLM 在 MG-CPT/SFT 阶段补回来——这恰好解释了为什么 SPAR 必须有 MG-CPT 这一步。
Pro-GEO Pro-GEO: Birds of a Feather Cluster Nearby(BUPT / Meituan,2026-04-25)¶
关系:显式引用但未展开对比(SPAR 只在 intro 的一处合并引用 "[2, 9, 31]" 里带到 arXiv:2604.23156,正文从不出现 "Pro-GEO" 字样,也不作为 baseline)· 已加载对方精读
- 共同关注的问题:Pro-GEO 在某本地生活平台上量化出"超过 50% 的 POI 与同 SID 下其他 POI 相距 >40 km",并把根因归为"SID 聚类目标里语义信号高维、方差大,几何信号被淹没,即使把经纬度 concat 进嵌入也只是 weak regularizer"。这句话与 SPAR intro 的诊断几乎逐字一致——但 SPAR 引用它时只把它归入"地理只作为辅助信号进入 SID 构造"的被批评一方。
- 相近的技术骨架:都保持三层 RQ-Kmeans 框架不变,都通过改造某一层的输入来承载地理,都用余弦度量替代欧氏(Pro-GEO 显式论证欧氏在高维判别力弱;SPAR 通过 L2 归一化到单位超球面达到同样效果)。
- 本文的差异与推进(又一次镜像对称):Pro-GEO 把地理放在第三层,SPAR 把地理放在第一层。 Pro-GEO 前两层用余弦 K-means + 正交投影去冗余做纯语义聚类,第三层才用 geo-centroid 局部坐标系 + 双向 Geo-RoPE 把相对地理位置以正交旋转注入;SPAR 则在量化开始之前就把地理拼进表征,结果 L0 直接由地理主导、语义被挤到 L1。这个对调的后果与 HF-SID 精读里对 Pro-GEO 的判断完全一致:Pro-GEO 的地理信号只能影响最细的那个 token,塑造不了 beam search 遍历的前缀树;SPAR 的地理信号塑造整棵前缀树。 有意思的是,SPAR 与 HF-SID 虽然编码方式相反,却在"地理必须占据粗层"这一点上完全站在同一边,共同与 Pro-GEO 对立。 SPAR 因此可以说继承了本团队(GeoGR / HF-SID 一脉)对 Pro-GEO 的路线判断,只是它没有像 HF-SID 那样把 Pro-GEO 拉进表里用数字说话。
- 可比的方法 / 实验差异:Pro-GEO 的 Geo-RoPE 有一个 SI-SID 没有的性质——余弦距离变化 $\Delta D_{\cos}\propto\sin^2(\Delta\sigma/2)\times$ 语义相似度是乘积形式,因此语义不相似的 POI 不会被地理信号污染;SPAR 的拼接是加性并列,地理与语义的相对影响力完全由 $d_g=4K$ 与 $d_s$ 的维度比决定——而论文从头到尾没有给出 $K$ 的取值,也没有对 $K$ / $d_g$ 做任何敏感性分析,这是 SI-SID 这一节最实质的复现障碍。数字上没有共同数据点:Pro-GEO 报 Meituan 量级数据上平均地理聚类距离 −45.60%、Hit@50 +1.87%,SPAR 报高德四城 Dis@5 从 3.51–3.89 km 降到 3.13 km(上海,SI-SID 单独)与最终累计距离 −27.80%;公开集上 Pro-GEO 的 NYC Hit@5 = 0.5300 / TKY 0.4927(本库已归档),SPAR 未将其列入 Table 2。
被剔除的近似候选(终端日志):
- RCBS(2607.28971,Karrot):同样从"地理可行性"出发,但解法是区域同质 mini-batch 负采样改造对比学习的负例分布,不触及 tokenization 与 SID,方法流程图无法与 SPAR 重合 → 剔除。
- ChronoID(2606.14260,Rochester/Meta):结构上最接近的"专用编码器编码额外信号 → 融合 → 量化",但注入的是逐次交互变化的外生时间而非 item 固有的地理属性,且其核心结论轴(早融合 vs 晚融合、残差 vs 并行量化)与 SPAR 的贡献轴(三阶段生命周期)不重合;该对比已由 HF-SID 精读承担 → 剔除。
- PAMT(2604.23388,UvA):与 TV-SFT 共享"适配阶段防遗忘"的半边,但其问题是持续 GenIR 中语料增量导致的遗忘,解法是 product-key 参数记忆头 + 稀疏行选择,既无地理也无 tokenizer 改造,问题不同构 → 剔除。
- AuthGR(2604.13468,SKKU):同样是"CPT–SFT 流水线注入一条非语义轴(文档权威度)",但权威度是标量质量先验、无度量几何,也没有 tokenizer 侧改造与知识保留机制 → 剔除。
讨论与局限性¶
关于 SI-SID 归因的独立判断¶
先把两种口径分清楚,因为它们给出的排序不同:
| 口径 | SI-SID | MG-CPT | TV-SFT |
|---|---|---|---|
| 各阶段相对其前一阶段的相对提升(乘法口径) | 10.76% | 论文称 15.38%,本人复算 ≈7.9% | ≈10.19%(四城 R.I 均值:7.87 / 11.95 / 14.92 / 6.03) |
| 对累计 Ave.Imp 的百分点分解(Figure 2(c) 口径) | 上海 8.14 / 天津 8.64(最小) | 上海 9.77 / 天津 9.33 | 上海 +14.18 / 天津 +17.70(最大) |
| 对距离下降的百分点分解(Figure 2(c)) | 上海 +22.69 / 27.80 ・ 天津 +18.41 / 23.68(绝对主导) | — | — |
评分 agent 的观察在百分点口径下成立(TV-SFT 那一段最长、SI-SID 最短),但在乘法口径下不成立——SI-SID 的 10.76% 反而是三段里最大的一段,而百分点口径天然偏袒后置阶段(每一段都在更大的基数上计算,复利效应)。所以"SI-SID 只贡献约 10.76%"这个说法本身把一个相对量当成了份额来读。
我的结论是:这里不构成「引入新信号 ≠ 收益来源」意义上的错误归因,但存在另一处更严重、评分 agent 未指出的归因问题。 理由如下:
- 标题主打的是 "Real-World Spatial Perception",不是 SI-SID。 三个阶段全部是空间机制,TextOnlyGR → SPAR 的 23.29%–37.47% 百分之百可归因于空间信号的引入。所以"新引入的信号就是收益来源"这条是成立的,没有标题与消融错位。
- 论文自己就把分工写在正文里。 §5.4(3) 原话是 "Distance reduction is led by SI-SID while accuracy gains are led by MG-CPT and TV-SFT",§5.3 也明说 SI-SID 的作用是"提供拓扑载体"。主动写出"我这个组件不是准确率主力"是诚实,不是错误归因。 摘要里 SI-SID 排在第一位是叙述顺序(构建→培育→保留的时序),而非贡献排序,且摘要用的词是 "three synergistic stages",没有暗示 SI-SID 最重要。
- 在 LBS 里把"拉近距离"读作次要,本身是误判。 距离即可达性,可达性即能否成单。已归档的 HF-SID 线上 A/B 给出了直接证据:PV_CVR +6.74% / UV_CVR +6.03%,比 PV_CTR +0.67% / UV_CTR +0.29% 高一个数量级——点击由标题封面驱动,转化由"这个 POI 真的到得了"驱动。SI-SID 独占的正是这条与转化直接因果相关的轴(上海 22.69 / 27.80 个百分点的距离下降来自它)。把 SI-SID 的价值折算成它的 Recall 份额,等于用错了业务目标函数。
真正的归因问题在 TV-SFT 内部,而它比 SI-SID 那条严重得多:
- TV-SFT 的增益几乎全部来自它顺带引入的可训练 LoRA,而不是它命名的"冻结 task vector 防遗忘"机制。 从 Figure 6(a) 读数:w/o LoRA 的参考线在上海 ≈0.551、天津 ≈0.553,而 Table 4 的 SPAR-FullSFT R@10 是 0.5486 / 0.5516——光靠冻结 $\tau_{\text{MG-CPT}}$ 只买到 +0.4% / +0.3%;完整 TV-SFT 是 0.5989 / 0.6191。也就是说 R.I(TV-SFT) 那 12.20% / 12.24% 里,约 95% 由 LoRA 分支贡献。而论文把这一节整节命名为 "Task-Vector Anchored SFT"、把 §5.3 结论写成"TV-SFT 通过防止稀释取得更好性能"——被命名的机制恰恰是几乎不起作用的那一半。
- 而 LoRA 那一半也没有被正确归因。 论文从未做 "Full-SFT + LoRA,但不加 $\tau$" 的对照。因此"LoRA 精修的是空间知识"这个说法与"LoRA 只是多给了一批可训练参数 / 换了一种两分支参数化"这个平凡解释在实验上无法区分。$\alpha$ 的钟形曲线($\alpha=1$ 最优)确实说明 $\tau$ 的方向有意义,但那与"$\tau$ 冻结带来的增益"是两回事。
- 灾难性遗忘这个前提本身从未被测量。 论文建了一个很好的 18 任务空间认知 benchmark,却只在 MG-CPT LLM 与 Qwen3-4B/32B 上跑过,从没在 SPAR-FullSFT 与 SPAR 上跑过。只要把这个 benchmark 在两个 SFT 后的模型上各跑一次,"SFT 会覆盖空间知识、TV-SFT 能保住它"就能被直接证实或证伪。 现成的工具摆在那里没用,是全文最可惜的一处。
其它局限¶
- 没有线上 A/B、没有部署声明。 全文不出现 deploy / online experiment / latency 任何一次。所以 "Industrial-Scale" 这个标题词只由平台级私有数据支撑(四城、一个月、5.4M–11.3M 用户、64×A100),不由上线支撑。对比同团队的 HF-SID(已上线替换前代系统 + 一周三场景 A/B),这条差距很明显。
- baseline 集合对本文的核心主张不够。 论文的主张是"既有方法把地理留成 weak regularizer",但最强的几个 geo-SID 方法一个都不在表里:Pro-GEO(只在合并引用里被带到)、GeoGR(本团队自己的前代系统,在 related work 里被点名却不做 baseline)、OneLoc、GenPOI、HF-SID 全部缺席。留下的 geo 相关 baseline 只有 GNPR-SID。相比之下 HF-SID 重实现了七个 SID 方法并统一报 ICR / Avg.Dist / p90 / p95。SPAR 的 SOTA 声明因此只在"相对通用流水线 PLUM"这个范围内成立。
- 完全不报 SID 侧质量指标。 SI-SID 是一个 tokenizer 贡献,但论文既不报码字独立率 / 利用率、也不报碰撞率、也不报簇内平均地理距离——而这三项是这条线(Pro-GEO、GeoGR、GenPOI、HF-SID、LGRID)的标准指标。它只报推荐侧的 Dis@K。更微妙的是:SI-SID 用了第四层 disambiguation index 来兜住碰撞,这恰恰意味着前三层的碰撞率被隐藏了,读者无法判断"地理主导 L0"是否以码本坍缩为代价(GeoGR 就是靠牺牲 ICR 换地理紧凑度的典型)。
- $K$(频带数)与 $d_g=4K$ 从未给出。 SI-SID 的全部机制取决于拼接后地理与语义的维度比 $d_g : d_s$($d_s$ 是 Qwen3-Embedding-4B 的输出维度),而 $K$ 未公布、也无敏感性分析。这是一个决定方法能否复现的缺失。
- 两处数值不一致(见正文复核提醒):§5.3 的 MG-CPT "15.38%" 在两种口径下均无法从 Table 4 复现(复算 ≈7.9% / 8.79 个百分点);浙江 SPAR-NoCPT 的 Ave.Imp 复算为 9.41% 而非 11.53%(其余三城可精确复现)。
- 方法论可扩展性上的老问题依旧:SI-SID 是离线冻结的两阶段量化——文本编码器与地理编码器都在推荐模型之外训练,码本一旦固化就限定了下游能表达的物品空间,参数量 scaling 时"如何表征物品"这条路径不会跟着长。SPAR 的 scaling 实验(0.6B→4B→8B)扩的只是序列建模与空间知识存储那一半。这是整条 SID 路线的共性瓶颈,不是本文独有,但本文也没有正面回应。
- MG-CPT 的成本与迁移性:25 个数据集是逐城构建的("a per-city MG-CPT suite"),每进一座新城市就要重跑一遍 CPT。论文没有讨论跨城迁移、增量更新(城市路网与 POI 每天都在变),也没有报 CPT 的算力成本。对一个覆盖全国的地图产品,这是落地的第一道关。
- 一个未被讨论的耦合风险:SI-SID 的 token 被直接写进 MG-CPT 的训练语料(Tier 1 的十二个 POI 数据集建立的正是 SI-SID ↔ 坐标/属性的双向映射)。这意味着 SI-SID 一旦重建(新 POI 入库、码本重训),MG-CPT 语料与 CPT 模型都要跟着重做。 三阶段的"协同"在工程上也是三阶段的强耦合,论文对这条运维代价只字未提。
总评¶
SPAR 最有价值的地方不是它的 tokenizer,而是它把"LLM 是否真的懂这座城市"变成了一个可测量的问题,并给出了一个规模可观的答案:25 个自建数据集 + 50,000 条导航轨迹的 CPT,能让 4B 模型在无坐标的方向推理上超过 Qwen3-32B 三倍以上,而单纯把通用模型从 4B 扩到 32B 只涨 8.5 点。"可达性 ≠ 邻近性"这条主张,加上河对岸候选的 case study,是这条线上此前(Pro-GEO / GeoGR / GenPOI / HF-SID 全部只谈直线距离)没有人正面处理过的维度。18 任务 benchmark 与 25 数据集套件如果真的开源,本身就是有价值的公共品。
扣分则集中在实验的自证不足:核心机制(TV-SFT 的 anchoring)被自己的超参图证伪了大半而作者未觉察,防遗忘的前提从未测量,最强的同类 baseline(含本团队自己的 GeoGR 与两天前的 HF-SID)全部缺席,SID 侧指标一个不报,关键超参 $K$ 未公布,还有两处数值对不上。这是一篇工程执行扎实、数据规模真实、但论证链条比它的野心松散的论文。