MoEMB: Scaling Universal Multimodal Embeddings with Efficient Mixture-of-Experts Models 精读¶
AI at Meta + University of Central Florida,2026-09-08(arXiv 标注日期 September 7, 2026)
研究动机与背景¶
通用多模态嵌入(UME)撞上的是"编码器容量"这堵墙¶
嵌入模型的任务是把异构输入映射进一个共享空间供检索使用。早期的嵌入任务以简单的对称检索为主,而当下的通用多模态嵌入(Universal Multimodal Embedding, UME)要求同一个编码器同时处理分类、问答、检索、grounding、视觉文档搜索等多种任务,跨图像 / 视频 / 视觉文档 / 文本多种模态(Meng et al., 2025 的 MMEB-V2 有 78 个任务)。
作者的诊断是:随着任务变得更杂更难,性能越来越依赖编码器本身的视觉推理与指令跟随能力,但绝大部分"扩展嵌入"的工作扩的都不是编码器,而是被存下来的表征。论文用 Figure 2 把已有路线归成四类:
- (a) 维度轴:Matryoshka Representation Learning(Kusupati et al., 2022)调节嵌入维度;
- (b) 多向量轴:ColBERT / ColPali / MetaEmbed(Khattab & Zaharia, 2020;Faysse et al., 2025;Xiao et al., 2025)每个输入保留多个向量做细粒度 late interaction;
- (c) 推理 token 轴:Think-Then-Embed(TTE)系(Cui et al., 2025;Lan et al., 2025 的 UME-R1;Cheng et al., 2026)在产出嵌入前先自回归生成一段推理 token;
- (d) 专家轴(本文):用稀疏 MoE 扩编码器容量。
(a) 和 (b) 扩的是存储与检索预算,编码器原封不动,因此提供不了更难的 UME 任务所需的理解与推理能力。(c) 确实扩了能力,但代价极高:作者给的数字是,在 MMEB-V3 的文本分区上,一个常规 MLLM-based 2B 编码器完成评测要 1.7 天,而 TTE 的 UME-R1-2B 光编码 query 就要约 7.8 H200-days,编码候选集要 431 H200-days,对真实部署是不可接受的。
一个关键的经验观察:generalist–specialist gap 随总容量收缩¶
作者做了一个直接指向"容量"的对照实验(Figure 3 / 附录 D.2):在三个骨干上分别训一个多任务 generalist 和若干单任务组 specialist,看两者的差距。
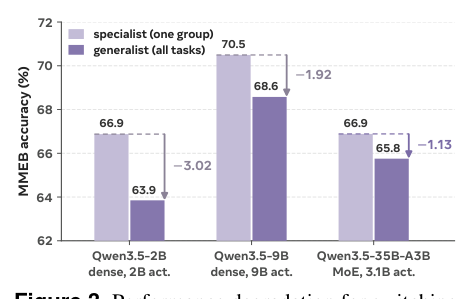
| Backbone | Arm | Image-CLS (10 tasks) | Image-Ret. (16 tasks) | Mean |
|---|---|---|---|---|
| Qwen3.5-2B(dense, 2B act.) | specialist | 60.69 | 73.06 | 66.88 |
| generalist | 56.53 | 71.17 | 63.85 | |
| Δ | −4.16 | −1.89 | −3.02 | |
| Qwen3.5-9B(dense, 9B act.) | specialist | 63.50 | 77.49 | 70.50 |
| generalist | 61.34 | 75.81 | 68.58 | |
| Δ | −2.16 | −1.68 | −1.92 | |
| Qwen3.5-35B-A3B(MoE, 3.1B act.) | specialist | 59.73 | 74.04 | 66.89 |
| generalist | 58.97 | 72.54 | 65.75 | |
| Δ | −0.76 | −1.50 | −1.13 |
(全部配置共享同一套超参:global batch 256、lr $5\times10^{-5}$、LoRA rank 64、$\alpha=128$、<emb> pooling、1 epoch。)
多任务联合训不如单任务专训,这一现象在 Qwen3-VL-Embedding 相对纯文本 Qwen3-Embedding 的 MTEB 退化上也能看到。可能的解释有两个:任务间的破坏性梯度干扰,或者模型容量本身不够同时服务所有任务。作者用附录 D.2 的第二个实验把第一种解释排除掉了:在 10 个 MMEB-V2 任务类别之间计算 router 参数梯度的两两冲突 $C = \mathrm{clamp}(-\cos(g_i, g_j), 0, 1)$,均值仅 0.020、最大 0.112。
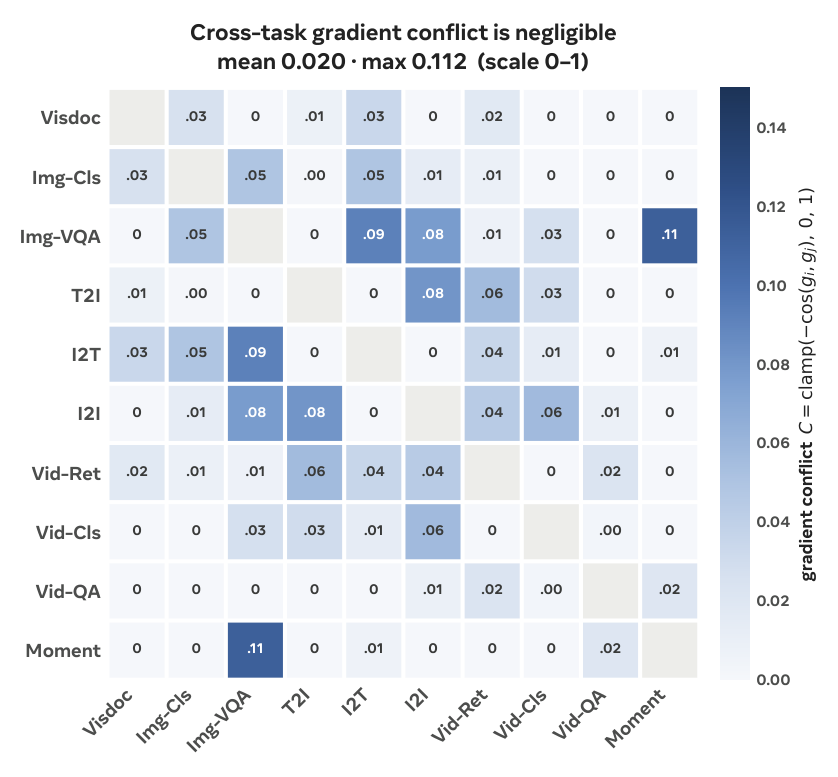
既然任务之间并不互相拉扯梯度,generalist 的退化就主要来自总容量约束——这条推理链是全文"扩专家"主张的逻辑起点。
为什么"扩容"对嵌入模型格外难¶
作者列了四条结构性困难:
- 检索侧的规模与延迟:搜索与推荐系统要为天文数量级的 query 和 item 算嵌入,还要低延迟;
- 对比训练的激活显存翻倍:InfoNCE 要同时编码并回传 query 与 target;
- 参数与 batch size 直接互斥:加参数就挤掉 in-batch negative 的数量,而 batch size 是对比质量的关键;
- 任务复杂度异构:简单任务上,庞大的 LLM 骨干本身就是浪费——MLLM 自带的对比预训练视觉编码器(CLIP 式)可能已经够用。
前三条催生了本文的方案一(沿专家轴扩容:总容量涨、激活 FLOPs 不涨),第四条催生了方案二(自适应计算:按输入复杂度动态砍算力)。
预备知识:UME 的形式化¶
一个 UME 编码器把多模态、指令条件化的 query 或 target $\{q, t\} = (I_x, I_v, I_t)$(任务指令 $I_x$、可选视觉输入 $I_v$、文本输入 $I_t$)映射成单个向量。同一个编码器 $F_\theta$ 同时处理 query 与 target:
$$e_\theta(\{q, t\}) = \mathrm{norm}\big(\mathrm{Pool}(F_\theta(\{q, t\}))\big) \tag{1}$$
对一个含 $N$ 对样本的 batch,用标准单向 InfoNCE:
$$\mathcal{L}_{\text{emb}} = -\frac{1}{N}\sum_i \log \frac{e^{S_{ii}}}{\sum_j e^{S_{ij}}}, \qquad S_{ij} = \cos(q_i, t_j)/\tau \tag{2}$$
$\tau$ 是温度,$\cos$ 是余弦相似度。注意这里的分母是 in-batch negative,这正是"参数量挤压 batch size"矛盾的来源。
核心方法(一):怎么造一个稀疏 MoE 嵌入器¶
论文探索了三条构造路径。
路径 1:原生 MoE(Native MoE)——最终采用¶
直接复用一个 FFN 已经是稀疏 MoE 的 MLLM,其中含一个共享专家 $\mathrm{FFN}_{\text{shared}}$ 与 $E$ 个稀疏专家。对 token 隐状态 $h \in \mathbb{R}^d$,预训练 router $W_r \in \mathbb{R}^{E \times d}$ 给全部 $E$ 个专家打分并保留最高的 $k$ 个,$S = \mathrm{TopK}(W_r h, k)$;分数在 $S$ 上重新归一化,另有一个学到的向量 $w_{\text{shared}} \in \mathbb{R}^d$ 经 sigmoid $\sigma$ 门控共享专家:
$$\mathrm{MoE}(h) = \gamma\, \mathrm{FFN}_{\text{shared}}(h) + \sum_{j \in S} \alpha_j\, \mathrm{FFN}_j(h), \quad \alpha_j = \frac{e^{(W_r h)_j}}{\sum_{u \in S} e^{(W_r h)_u}}, \quad \gamma = \sigma\big(w_{\text{shared}}^\top h\big) \tag{3}$$
这条路径保留了语言建模预训练学到的 MoE,实测最好,被定为全文默认设置。
路径 2:Dense-to-MoE Upcycling¶
把一个稠密 MLLM 的 FFN 切开、复制成 $E$ 个专家,再从零学一个 router。附录 D.1 给出完整设计空间:
- 结构粒度:虚拟组数 $G$ 决定 FFN 怎么切。$G=1$ 时每个专家是原 FFN 的完整副本(top-1 路由复现稠密的 FLOPs 足迹);$G>1$ 时沿中间维切成 $G$ 个窄专家($d_{\text{expert}} = d_{\text{ffn}}/G$),需要 $k=G$ 个激活专家才能匹配稠密层的容量。
- Router 初始化:(1) 随机初始化 $\mathcal{N}(0, 0.02)$ 打破相同专家之间的对称;(2) tiled 把稠密 gate 那一行复制到所有专家;(3) zero+bias 把初始 pre-softmax logit 置零并加正 bias,保证每个 FFN 切片从第一步就被选中,使该层输出在适配前与稠密一致。
Table 10(2B 编码器上的 upcycling 结果):
| $E$ | $G$ | $k$ | Init | Act. | Image | Video | VisDoc | Overall |
|---|---|---|---|---|---|---|---|---|
| — | — | — | Dense reference | 1× | 62.5 | 42.6 | 77.2 | 62.41 |
| 4 | 1 | 2 | tiled | 2× | 62.6 | 45.3 | 77.3 | 63.12 |
| 4 | 1 | 1 | random | 1× | 63.8 | 40.0 | 77.2 | 62.44 |
| 32 | 1 | 1 | random | 1× | 61.0 | 38.8 | 75.2 | 60.26 |
| 32 | 4 | 4 | zero+bias | 1× | 60.3 | 40.0 | 73.4 | 59.64 |
| 8 | 4 | 4 | zero+bias | 1× | 59.5 | 40.4 | 73.8 | 59.50 |
| 8 | 4 | 4 | tiled | 1× | 59.9 | 34.9 | 72.1 | 57.88 |
结论极其关键:在相同激活算力下,upcycling 全线打不过稠密基线。粗粒度 top-1 upcycling($E=4, G=1$)与稠密持平(62.44 vs 62.41),把专家数加到 $E=32$ 反而掉到 60.26,细粒度切分($G=4$)掉到 60 以下。只有把激活算力翻倍(top-2 路由)才能到 63.12。作者的解释是:MMEB-V2 这个规模的对比训练不足以从零训出一个强 router,比不上语言预训练海量数据学到的原生 router。
路径 3:模态级专家(Modality-level MoE)¶
把稠密 FFN 复制成模态级专家,用固定 router 把某个模态的全部 token 送到对应专家,与常规 token 级动态路由形成对照(论文 Figure 4)。这条路比稠密略好,但显著落后于原生 MoE。
关键技术细节:Pooling、Router 适配与训练动态¶
Pooling¶
已有 UME 工作(Cui et al., 2025)发现 last-token pooling 常优于 mean pooling 或 latent attention pooling,因此作者只比较两种:简单 last token vs 一个专设的 <emb> token。后者更好。
Router 适配与辅助目标¶
预训练 router 建立的是很精细的 token-to-expert 分配,下游对比微调可能破坏它。作者系统比较了冻结 vs 可训练 router,外加三类辅助目标:
(a) Load-balancing 与 z-loss:$\mathcal{L}_{\text{aux}} = \lambda_{\text{lb}}\mathcal{L}_{\text{lb}} + \lambda_z \mathcal{L}_z$,其中
$$\mathcal{L}_{\text{lb}} = \mathbb{E}\sum_{j=1}^{E} f_j P_j, \qquad \mathcal{L}_z = \frac{1}{B}\sum_{b=1}^{B}\Big(\log \sum_{j=1}^{E} e^{g_{bj}}\Big)^2 \tag{4}$$
$f_j$ 是路由到专家 $j$ 的 token 比例,$P_j$ 是该专家的平均 router 概率,$g$ 是 pre-softmax logit。取 $\lambda_{\text{lb}} = 0.01$,$\lambda_z = 0.001$。
(b) Conflict-aware routing:对任务 $t$ 在第 $\ell$ 层维护其专家分配分布的滑动平均 $\bar{\pi}_t^{(\ell)} \in \mathbb{R}^E$ 与 router 梯度 $g_t^{(\ell)}$,冲突定义为 $C_{st}^{(\ell)} = \mathrm{clamp}(-\cos(g_s^{(\ell)}, g_t^{(\ell)}), 0, 1)$,目标是最大化冲突加权的 JS 散度:
$$\mathcal{L}_{\text{conf}} = -\frac{1}{|P|}\sum_{t \in P} \frac{1}{L}\sum_{\ell=1}^{L} C_{st}^{(\ell)}\, \mathrm{JS}\big(\bar{\pi}_s^{(\ell)} \,\|\, \bar{\pi}_t^{(\ell)}\big) \tag{5}$$
即把互相冲突的任务对推向不相交的专家子集,对协作或正交的任务对不施加惩罚。
(c) 任务先验:往 router logit 里注入一个加性 bias $b^{(\ell)} \in \mathbb{R}^E$,$g^{(\ell)} = W_r^{(\ell)} h + b^{(\ell)}$。两种取法:task-ID prior(从可学任务 embedding 表取,hidden 256、dropout 0.3)与 instruction prior(由指令 token 的 mean pooling 在每层投影得到,随深度动态更新路由 bias)。
Table 5(pooling 与 router 消融):
| Pooling | Routing objective | Router trained | Image | Video | VisDoc | Overall |
|---|---|---|---|---|---|---|
| last | ✗ | ✓ | 70.7 | 51.6 | 81.1 | 69.50 |
| last | LB + z | ✓ | 65.6 | 53.7 | 77.8 | 66.62 |
| last | conflict-aware | ✓ | 70.4 | 53.2 | 81.3 | 69.80 |
<emb> |
✗ | ✓ | 71.1 | 54.5 | 81.1 | 70.34 |
<emb> |
task-ID prior | ✓ | 69.9 | 53.5 | 81.0 | 69.55 |
<emb> |
instruction prior | ✓ | 70.1 | 54.1 | 80.3 | 69.55 |
<emb> |
✗ | ✗(冻结) | 71.8 | 53.5 | 81.0 | 70.38 |
结论分析:(1) <emb> token 换掉 last-token pooling 是单项最大增益(69.50→70.34,+0.84);(2) 冻结 router 与训练 router 基本持平(70.38 vs 70.34),说明预训练路由无需调整;(3) 所有路由辅助目标都没有正收益——load-balancing + z-loss 灾难性地掉到 66.62(把 token 强行从预训练的专家分配上拉走),conflict-aware 只有 +0.30 的噪声级差异,task/instruction 先验反而掉到 69.55。这条负面结论本身很有价值:语言预训练学到的路由分配对对比目标已经近乎最优,任何"帮它一把"的正则都在做减法。
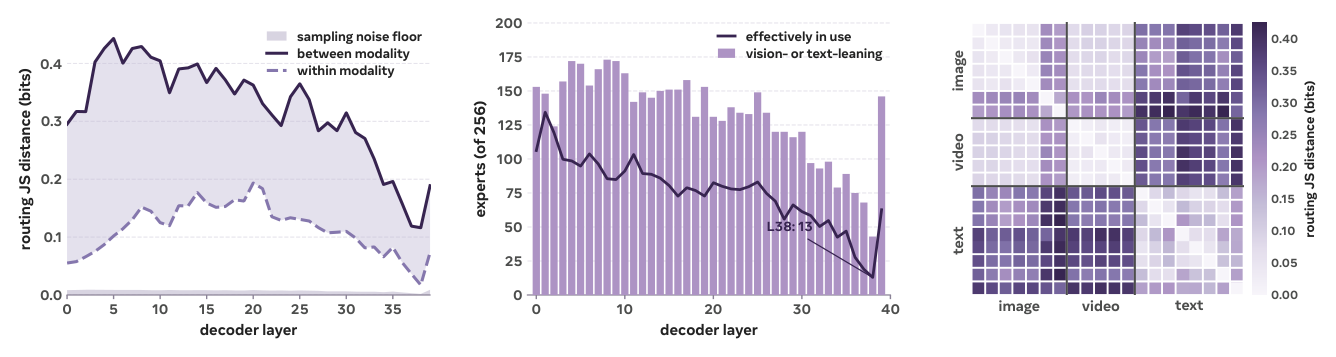
这与附录 D.3 的路由行为分析互相印证:逐层平均 JS 距离在模态内(0.114)远低于模态间(0.323),而按任务类别分组则没有统计显著分离($z = -0.66$, $p = 0.73$)。也就是说路由按模态而非按任务组织,且这种模态特化是在没有 load-balancing / z-loss 的情况下自然涌现的。用偏好指数 $\pi_j = (v_j - t_j)/(v_j + t_j)$($|\pi_j| > 0.5$ 记为模态偏好专家)度量,模态分歧在浅层达到峰值(第 4 层 JS = 0.339,256 个专家里 172 个有强模态偏好),随深度稳定收敛(第 38 层 JS = 0.099,只剩 43 个),最后在第 39 层为构造序列嵌入短暂再次分化。
训练超参敏感性¶
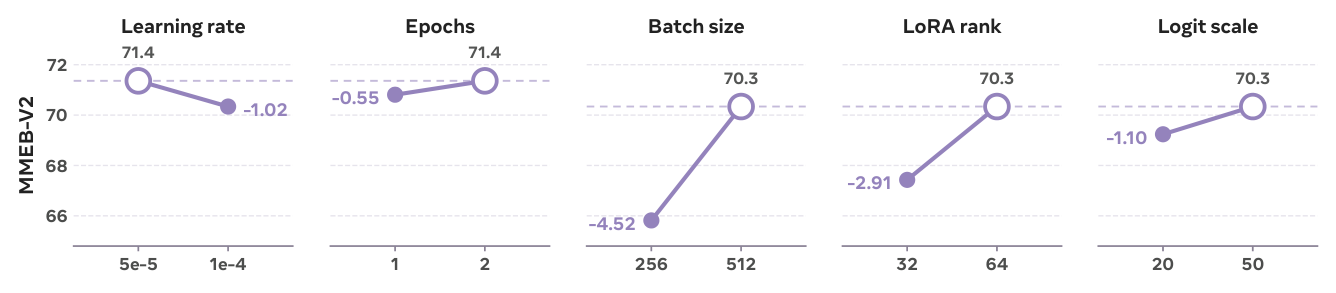
在 35B 骨干上逐项扫:
| 超参 | 变化 | Overall 变化 |
|---|---|---|
| Global batch size | 512 → 256 | −4.52 |
| LoRA rank | 64 → 32 | −2.91 |
| Logit scale | 50 → 20 | −1.10 |
| Learning rate | $10^{-4}$ → $5\times10^{-5}$ | +1.02(70.34 → 71.36,78 个任务中 56 个变好) |
| Epochs | 1 → 2(在低 lr 下) | +0.55 |
batch size 是压倒性的第一因素,这直接验证了动机里"参数量与 batch size 互斥"的判断——对比学习对 in-batch negative 池的依赖是硬约束,这也是为什么"加激活参数"这条路对嵌入模型特别不划算,而"加总参数、不加激活参数"的 MoE 显得有吸引力。
核心方法(二):MoE-UME 的自适应计算¶
稀疏 MoE 改善了质量-算力权衡,但每个 token 仍然跑固定预算。论文系统研究了六类自适应计算动作(Figure 5):token 剪枝、层跳过、早退(前三者通用)与专家跳过、自适应 top-k、专家剪枝(后三者 MoE 专属),并覆盖训练期决策与推理期决策两种 regime。
Table 1(设计空间总览,节选):
| Action | Method | Regime | Basis |
|---|---|---|---|
| Token pruning | One-shot pruner after decoder block $n$(Gumbel/STE) | Train | Huang et al. (2025a) |
| Layer-wise gradual drop gate, packed varlen(GRPO) | Train | ours | |
| GDN $\beta$-ranked one-shot drop | Inf. | ours | |
| Expert skipping | Per-token three-way skip gate(soft fade) | Train | ours |
| GDN $\beta$-ranked expert skip | Inf. | ours | |
| Per-layer Otsu split on $\beta$ or router logit | Inf. | Otsu (1979) | |
| Adaptive top-k | Null experts, load-balance–scheduled | Train | Zeng et al. (2024) |
| Dynamic modality thresholding | Inf. | Huang et al. (2025b) | |
| Layer skip & exit | Trained layer-skip gate(STE, distillation) | Train | ours |
| Expert pruning | Routing frequency, router probability mass | Inf. | Lu et al. (2024) |
| MAN, MSAN, REAP saliency | Inf. | Liu et al. (2026); Lasby et al. (2025) | |
| Combined | Discrete and unified action rollouts(GRPO) | Train | ours |
训练期方法¶
Token 剪枝分 one-shot(在早层 $K$ 做一次决策)与 gradual(每层一个 per-token gate,token 的存活质量 $\alpha_{t,\ell} = \prod_{j<\ell}(1 - p^{\text{drop}}_{t,j})$ 随深度衰减)。one-shot 用直通估计器(STE)训练;gradual 的 STE 与 AViT 式 halting 都因训练不稳定失败(附录 E.1),最终改用 GRPO 采样离散动作。两者都从一个不带自适应计算的 teacher 嵌入 $e_{\text{full}}$ 蒸馏。给定目标预算 $\rho^\star$ 与当前保留率 $\rho_{\text{keep}}$:
$$\mathcal{L}_{\text{drop}} = \mathcal{L}_{\text{emb}} + \lambda_d\big(1 - \cos(e, e_{\text{full}})\big) + \lambda_b\big(\rho_{\text{keep}} - \rho^\star\big)^2 \tag{6}$$
学习式专家跳过(灵感来自 Mixture-of-Depths)在既有 router 之上加一个跳过门 $p^{\text{skip}}_{t,\ell} \in [0,1]$,决定是否整体跳过专家计算:
$$\mathcal{L}_{\text{skip}} = \mathcal{L}_{\text{emb}} + \lambda_c\big(1 - \rho_{\text{skip}}\big), \qquad \rho_{\text{skip}} = \frac{1}{L|\mathcal{T}|}\sum_{\ell=1}^{L}\sum_{t \in \mathcal{T}} p^{\text{skip}}_{t,\ell} \tag{7}$$
预算作用于整个模型,允许各层跳过率不同。硬跳过不可导,因此用 soft fade:设 $u_{t,\ell}$ 为路由专家输出、$v_{t,\ell}$ 为该层其余输出,
$$h_{t,\ell} = v_{t,\ell} + \big(1 - p^{\text{skip}}_{t,\ell}\big)\, u_{t,\ell} \tag{8}$$
GRPO 统一多动作。同时开多个动作时,各动作抢同一份预算、STE 穿过多个离散决策不稳定。作者改用策略优化:每个效率门给出动作分布,对每个输入采样 $G$ 个 rollout,每个 rollout 从每个门采一个动作。因为没有可作参考的预训练策略,KL 项被替换成对全算力 teacher 嵌入的蒸馏损失;为防 reward hacking,效率奖励 $S(a_i)$ 被 in-batch 检索 $\mathrm{recall}@G(a_i) \in [0,1]$ 门控:
$$\mathcal{L} = -\mathbb{E}\left[\frac{1}{G}\sum_{i=1}^{G}\min\big(r_i \hat{A}_i,\ \mathrm{clip}(r_i, 1-\epsilon, 1+\epsilon)\hat{A}_i\big)\right] + \lambda_d\, \mathbb{E}\big[1 - \cos(e_a, e_{\text{full}})\big] \tag{9}$$
$$r_i = \frac{\pi_\theta(a_i)}{\pi_{\theta_{\text{old}}}(a_i)}, \quad \hat{A}_i = \frac{R(a_i) - R_\mu}{R_\sigma}, \quad R(a_i) = \underbrace{\mathrm{recall}@G(a_i)}_{\text{recall gate}}\Big(\underbrace{\bar{s}^+(a_i) - \bar{s}^-(a_i)}_{\text{ranking margin}} + \lambda_s S(a_i)\Big) \tag{10}$$
效率奖励按各层被移除的算力计价:
$$S(a) = 1 - \frac{\mathbb{E}[\mathrm{FLOPs}(a)]}{\mathrm{FLOPs}_{\text{dense}}}, \quad \mathbb{E}[\mathrm{FLOPs}(a)] = \sum_\ell \sum_t \alpha_{t,\ell}\Big[f^{\text{attn}}_\ell + f_{\text{sh}} + \big(1 - p^{\text{skip}}_{t,\ell} - p^{\text{drop}}_{t,\ell}\big) f_{\text{rt}}\Big] \tag{11}$$
其中 $\alpha_{t,\ell}$ 是 token $t$ 抵达第 $\ell$ 层的概率。实现细节:GRPO 只优化每个 MoE 层一个轻量三分类头,输出 $\{\text{ROUTE}, \text{SKIP}, \text{DROP}\}$;原生专家选择保持贪心,策略只决定执行状态;策略梯度只流到效率门头,骨干与 LoRA 权重冻结在对比训练后的取值上。
四种多动作组合策略(附录 E.1):(1) 单一全局 FLOPs 预算、全部门同时更新——优化器会全押最便宜的动作,token dropping 早期就主导,其余门欠优化;(2) 每动作独立二次惩罚 $\sum_a \lambda_a(\rho_a - \rho_a^\star)^2$、同时更新——门之间互相引起分布漂移;(3) 每步只更新一个门(交替);(4) 按预定顺序逐个训练,达标即冻结。
推理期方法:用 GDN 的写入强度 $\beta$ 当免费显著性信号¶
这是本文最有意思的一个技术点。推理期 token 剪枝通常按 token 收到的注意力质量排序,但FlashAttention 根本不物化注意力矩阵,所以需要另找免训练信号。
作者提出用 Gated DeltaNet(GDN)的写入强度 $\beta$。GDN 层的门控 delta rule 用一个 token 相关的写入强度更新循环记忆 $S_t \in \mathbb{R}^{d_v \times d_k}$:
$$S_t = S_{t-1}\big(\alpha_t(I - \beta_t k_t k_t^\top)\big) + \beta_t v_t k_t^\top, \qquad \beta_t = \mathrm{sigmoid}\big(W_\beta^\top x_t\big) \in (0,1) \tag{12}$$
$k_t, v_t$ 是 $\ell_2$ 归一化的 key 与 value,$\alpha_t \in (0,1)$ 是遗忘门。$\beta_t$ 在"完全不动记忆"($\beta_t \to 0$)与"在 $k_t$ 方向上完全覆写为 $v_t$"($\beta_t \to 1$)之间插值,天然是 token 重要性的代理。把 $\beta_t$ 在 GDN 层与 head 上平均,就得到每个 token 一个重要性分数,驱动全部推理期 token / 专家决策。注意 $\beta$ 是预训练骨干自带的门,推理时直接读出,零额外开销。
自适应 top-k:设第 $\ell$ 层 token $t$ 的路由权重排序为 $\alpha_{\ell t(1)} \ge \cdots \ge \alpha_{\ell t(k)}$,自适应 top-k 按预设条件动态选 $k_{\ell t} \le k$ 个专家。MoDES(Huang et al., 2025b)保留满足 $s_\ell \alpha_{\ell t(m)} \ge \tau$ 的专家 $m$,全局阈值 $\tau$ 与逐层缩放 $s_\ell$ 由一次标定 pass 估出(标定集用 ImageNet-1K 评测分片)。
总专家剪枝:永久删掉专家,减的是显存而非算力。每层保留显著性 $\phi_j$ 最大的 $E'$ 个专家。两族显著性:router-based(路由频率或平均 router 概率)与 output-based
$$\phi_j = \mathrm{mean}_{t \to j}\, w_{tj}, \quad w_{tj} \in \Big\{ \underbrace{\|o_{tj}\|}_{\text{MAN}},\ \underbrace{\|o_{tj}\|^2}_{\text{MSAN}},\ \underbrace{\alpha_{\ell t j}\|o_{tj}\|}_{\text{REAP}} \Big\}, \quad o_{tj} = \mathrm{FFN}_j(h_{\ell t}) \tag{13}$$
MAN / MSAN 完全忽略 router,只看专家输出幅度;REAP 额外乘上路由权重,实测最好。
Otsu 自适应阈值:不强制各层统一跳过率,而是对每层的分数分布用 Otsu 方法最大化类间方差二分,低分区的 token 跳过路由专家;用变异系数(0.05–0.40)限制只在分布足够双峰的层上做,并设 70% 单层跳过上限。
把 FLOPs 省下变成 wall-clock¶
作者明确指出这是一个被大量自适应计算工作忽略的缺口:逻辑算力的减少不等于 QPS 的提升。
- Token 剪枝用 packed variable-length:每层把存活 token gather 成连续段并更新累积序列长度,用一个 segment index 防止注意力跨样本混合。这允许 token 数逐层变化的批量自适应计算,比 one-shot 剪枝的实现要难得多。
- MoE 类方法用 tile-aware grouped-GEMM kernel(SonicMoE, Guo et al., 2025)配合 batched grouped GEMM。作者点名批评:不少工作要么不测 wall-clock,要么不给能兑现节省的实现,要么用逐专家循环的 naive 实现——后者比 fused kernel 慢 5.7–8.0×($B=8, S=1024$ 时 1189.5 ms vs 210.2 ms),任何以它为基线测出的加速都是虚高。
Tile-bound 分析(附录 C.3,非常值得记住):grouped GEMM 每个专家的 token 按至少 $M = 128$ 行一块的 tile 处理,半空的 tile 与满 tile 耗时几乎一样。持有 $n_j$ 行的专家需要 $\lceil n_j / M \rceil$ 个 tile,跳过 token 只有在清空整个 tile 时才产生真实节省。top-8 路由下 $T$ 个 token 产生 $8T$ 个 token–专家对,均摊到 $E = 256$ 个专家上每人约 $8T/E = T/32$ 行:
- $T = 4096$ 时约 128 行/专家,52.9% 的跳过率把它砍到约 50 行,两者都是一个 tile——kernel 执行的工作量不变,模型却还要多花跳过门的时间,净结果是 0.91× 减速;
- $T = 8192$ 时约 256 行(两个 tile),69.6% 跳过砍到约 78 行($\lceil 256/128 \rceil = 2 \to \lceil 78/128 \rceil = 1$),去掉第二个 tile 是真实节省,1.11×。
也就是说,专家侧稀疏能否兑现成加速取决于序列长度与 batch size。
实验设置¶
模型与训练:适配 Qwen3.5-35B-A3B 与 Qwen3.5-122B-A10B 两个多模态 MoE 骨干。两个变体都用 $E = 256$ 路由专家、top-8 路由、1 个共享专家。MoEMB-A3B:$d = 2048$、40 层解码器(30 个 Gated-DeltaNet + 10 个全注意力块)、专家中间维 $d_{\text{ffn}} = 512$,激活 3.1B;MoEMB-A10B:$d = 3072$、48 层、$d_{\text{ffn}} = 1024$,激活 10.2B。
训练:2 epoch、序列长 8192、BF16、global batch 512(64 张 H200)、AdamW($\beta_1 = 0.9, \beta_2 = 0.98$,weight decay 0.01),lr 10 步 warmup 到 $10^{-4}$ 后余弦衰减到 $10^{-5}$,LoRA $r = 64, \alpha = 128$ 施加于视觉编码器、注意力投影与专家 FFN,可训练参数 A3B 73.6M / A10B 196.6M。训练框架用 NVIDIA Megatron Core MoE + Expert Parallelism。
训练数据:24 条采样流的多任务混合,含 MMEB 的 17 个图文任务、ViDoRe 与 VisRAG 的 4 条视觉文档流、LLaVA-Hound 派生的 3 条视频检索流。排除生成的 CoT 序列。权重(相对值):VisRAG subset 1/2 各 6.00,ViDoRe subset 1/2 各 5.00,Video retrieval 5.76、Video caption 5.27、Video QA 4.38,MSCOCO image pairs 3.78、VisualNews t2i 3.49、VisDial 3.75,ImageNet-1K 2.25 等。
评测:MMEB-V2(78 个任务,跨图像 / 视频 / 视觉文档)与 MRMR(推理密集型多模态检索,含跨模态知识检索、定理识别、矛盾检测;除 Negation 用 Hit@1 外均报 NDCG@10,Avg 为 11 个子任务均值)。均按官方评测协议。
FLOPs 计量协议(附录 C.1):在全部 78 个 MMEB-V2 任务上用同一 query/target 子集计数;FlashAttention 与线性注意力这类 fused kernel 的 FLOPs 解析补上;grouped expert GEMM 按物理执行的行体积计算,避免把被剪掉的专家分配重复计入。
主要实验结果¶
MMEB-V2¶
作者做了一个值得称道的公平性处理:按训练数据来源把 Table 2 分成两组。理由是 MMEB-V2 的评测套件相对其训练数据大量 OOD,很多头部基线依赖镜像评测格式的外部语料,这会通过 domain-wise 数据泄漏抬高分数。
Table 2(节选,Overall 为 78 任务总分):
| 组 | Model | Act. (B) | Image Ov | Video Ov | VisDoc Ov | All |
|---|---|---|---|---|---|---|
| 外部数据 | DME-2B | 2.2 | 76.3 | 61.3 | 80.9 | 74.2 |
| 外部数据 | Qwen3-VL-Embedding-2B | 2.1 | 75.0 | 61.9 | 79.2 | 73.2 |
| 外部数据 | DME-Large | – | 81.1 | 74.4 | 83.4 | 80.2 |
| 外部数据 | Octen-VL-Embedding-Large | – | 81.9 | 76.0 | 80.5 | 80.1 |
| 外部数据 | Qwen3-VL-Embedding-8B | 8.1 | 80.1 | 67.1 | 82.4 | 77.8 |
| 外部数据 | IFM-TTE-7B | 8.3 | 77.9 | 59.2 | 81.8 | 74.8 |
| 公开数据 ≤4B | PLUME | 2.1 | 66.3 | 44.1 | 67.5 | 61.6 |
| UME-R1-2B | 2.2 | 66.6 | 42.2 | 67.3 | 61.2 | |
| VLM2Vec V2-2B | 2.2 | 64.9 | 34.7 | 68.7 | 59.1 | |
| BToks | 2.2 | 66.0 | 39.9 | 62.7 | 59.0 | |
| VLM2Vec V1-2B | 2.2 | 59.7 | 28.5 | 31.7 | 43.9 | |
| MoEMB-A3B | 3.1 | 71.8 | 53.5 | 81.0 | 70.4 | |
| 公开数据 ≥8B | Embed-RL-4B† | 13.2 | 71.2 | 53.0 | 74.7 | 68.1 |
| Embed-RL-2B† | 10.9 | 69.2 | 52.1 | 74.1 | 66.8 | |
| UME-R1-7B | 8.3 | 71.2 | 47.5 | 70.6 | 65.6 | |
| UniME-V2 | 8.0 | 71.8 | 39.0 | 60.1 | 60.6 | |
| VLM2Vec V1-7B | 8.3 | 65.4 | 33.8 | 34.1 | 48.5 | |
| MoEMB-A10B | 10.2 | 74.0 | 56.3 | 82.2 | 72.4 |
†Embed-RL 用一个共享的 8.77B 自回归 reasoner 配 4.44B/2.13B 嵌入器,故激活参数 13.2B/10.9B。
结论分析:MoEMB-A3B 以 3.1B 激活参数拿到 70.4,超过激活参数 4 倍于它、且要先跑一遍自回归推理的 Embed-RL-4B(68.1)与 UME-R1-7B(65.6)。A10B 到 72.4,比 Embed-RL-4B 高 4.3、比 UME-R1-7B 高 6.8。在公开训练集能提供域内监督的少数分片上(ViDoRe、VisRAG),MoEMB 甚至无需外部数据就达到 SOTA:A3B 的 VisDoc 81.0 已超过全部 4B 以下外部数据模型(DME-2B 80.9、Qwen3-VL-Embedding-2B 79.2),A10B 的 82.2 距 Qwen3-VL-Embedding-8B 仅差 0.2。
但要注意结构性短板:MoEMB-A3B 的 Image-CLS 只有 60.6,是公开数据 ≤4B 组里最差的(PLUME 66.5、BToks 64.3、UME-R1-2B 64.8)。逐任务看(附录 G),N24News 39.5 vs PLUME 81.1、HatefulMemes 59.8 vs PLUME 75.5,掉得非常厉害。它的总分优势几乎全部来自 QA(73.8)、grounding(92.4)与 VisDoc-OOD(82.8 vs PLUME 57.4,差 25.4 点)。也就是说,"扩专家"的收益并不是均匀铺开的,而是高度集中在文档理解与视觉推理这类依赖骨干世界知识的任务上——这一分布本身就更像"换了个更强骨干"的指纹,而不是"专家更多了"的指纹。
加速-精度 Pareto 前沿(Figure 1)¶
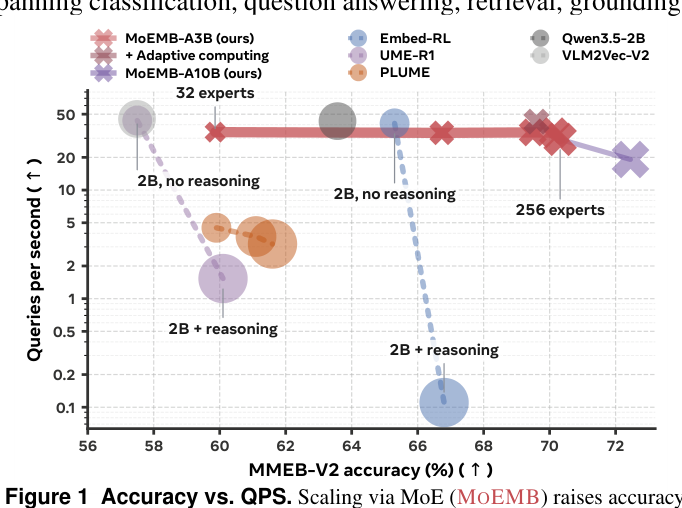
红色曲线(MoEMB-A3B)从约 60.0(标注 "32 experts")平推到 70.4("256 experts"),QPS 只从 34.2 掉到 29.3。对照之下,Embed-RL-2B 打开 reasoning 只涨 +1.5 点,QPS 却从 41 崩到 0.11(370× 减速)。TTE 路线的算力代价与收益完全不成比例,这个对比是成立且有力的。
但这条红色曲线的构造方式必须点明(详见后文"独立复核"一节):附录 C.2 写得很清楚——$E \in \{32, 64, 128, 192, 256\}$ 这五个点是把训练好的 $E = 256$ 模型用 REAP(重构误差准则,即式 13)剪枝得到的,不是分别训练的五个 MoE。
MRMR(推理密集型检索)¶
Table 3(节选,除 Neg. 为 Hit@1 外均为 NDCG@10;Avg 为 11 子任务均值):
| Model | Act.(B) | Art | Med. | Sci. | Hum. | Math | Phy. | Eng. | Bus. | Neg. | Design | Traffic | Avg |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| BToks | 2.2 | 72.0 | 48.2 | 62.2 | 62.3 | 22.5 | 36.1 | 29.1 | 49.0 | 14.5 | 46.4 | 36.0 | 43.5 |
| UME-R1-2B | 2.2 | 70.8 | 48.9 | 60.6 | 57.8 | 21.3 | 31.5 | 27.2 | 47.0 | 11.5 | 33.7 | 30.1 | 40.0 |
| PLUME | 2.1 | 69.9 | 47.7 | 63.6 | 56.7 | 18.6 | 30.3 | 27.7 | 44.5 | 9.5 | 43.2 | 27.5 | 39.9 |
| VLM2Vec-V2 | 2.2 | 53.1 | 28.9 | 43.4 | 39.9 | 11.7 | 22.3 | 22.5 | 43.0 | 11.0 | 8.3 | 25.0 | 28.1 |
| ColPali† | 3.0 | 36.1 | 29.9 | 42.7 | 29.2 | 7.3 | 17.5 | 13.5 | 34.6 | 28.5 | 19.4 | 18.2 | 25.2 |
| MoEMB-A3B | 3.1 | 80.3 | 62.6 | 73.3 | 76.3 | 28.2 | 35.3 | 34.3 | 54.0 | 11.0 | 63.6 | 49.2 | 51.6 |
| LaME-7B | 8.3 | 72.7 | 57.1 | 69.8 | 63.3 | 29.9 | 44.4 | 38.0 | 49.4 | 6.5 | 66.9 | 39.8 | 48.9 |
| UME-R1-7B | 8.3 | 79.2 | 58.2 | 71.8 | 66.1 | 28.2 | 40.2 | 32.7 | 50.3 | 6.0 | 57.6 | 39.5 | 48.2 |
| Embed-RL-4B | 13.2 | 73.5 | 53.1 | 60.5 | 69.8 | 32.9 | 45.6 | 35.1 | 52.6 | 6.0 | 54.3 | 31.7 | 46.8 |
MoEMB-A3B 以 3.1B 激活拿到最高的 51.6,超过全部 7B–13.2B 的系统,包括专为推理密集检索设计的 TTE 方法:PLUME(+11.6)、UME-R1-7B(+3.4)、Embed-RL-4B(+4.8)。作者据此认为"用 MoE 扩容量比用 CoT 扩测试时算力更有效"。逐列看,MoEMB 在 Knowledge 四列(Art/Med./Sci./Hum.)与 Design/Traffic 上优势巨大,但在 Math/Phy./Eng. 三列并不占优(Phy. 35.3 输给 Embed-RL-4B 的 45.6 与 LaME-7B 的 44.4),Negation(Hit@1 11.0)也明显不如 ColPali 的 28.5。这说明"扩专家"补的主要是知识检索而不是多步逻辑推理——后者恰恰是 TTE 路线声称要解决的,而这块 MoEMB 并没有真正赢下来。
自适应计算的实验结果¶
Table 6(每类动作取一个代表性预算,括号内为相对无缩减基线 70.3 的变化):
| Regime | Action | Method | Budget | Image | Video | VisDoc | Overall | FLOPs↓% | QPS↑× |
|---|---|---|---|---|---|---|---|---|---|
| — | — | No reduction | top-8 / keep all | 71.0 | 54.5 | 81.1 | 70.3 | — | 1.00 |
| Train | Adaptive top-k | AdaMoE | 2.94 experts | 68.2 (−2.8) | 49.1 (−5.4) | 79.3 (−1.8) | 67.2 (−3.1) | — | — |
| Train | Expert skip | Learned skip gate | dynamic | 69.7 (−1.3) | 53.4 (−1.1) | 81.1 (+0.0) | 69.4 (−0.9) | 12 | — |
| Train | Token pruning | One-shot drop | drop 70% | 69.4 (−1.6) | 54.2 (−0.3) | 80.5 (−0.6) | 69.3 (−1.0) | 32 | — |
| Train | Layer skip | Trained gate | skip 20% | 70.0 (−1.0) | 52.6 (−1.9) | 81.3 (+0.2) | 69.5 (−0.8) | ≈20 | ≈1.40 |
| Train | Combined | GRPO(gradual drop + skip) | dynamic | 70.1 (−0.9) | 53.0 (−1.5) | 81.4 (+0.3) | 69.6 (−0.7) | 22.5 | 1.46 |
| Train | Combined | Global budget | 80/40% target | 64.5 (−6.5) | 46.8 (−7.7) | 78.5 (−2.6) | 64.7 (−5.6) | — | — |
| Train | Combined | Per-action, simultaneous | drop70/skip30/layer20 | 67.3 (−3.7) | 50.5 (−4.0) | 79.4 (−1.7) | 67.1 (−3.2) | — | — |
| Train | Combined | Per-action, alternating | drop70/skip29/layer20 | 66.8 (−4.2) | 51.2 (−3.3) | 78.6 (−2.5) | 66.8 (−3.5) | — | — |
| Train | Combined | Per-action, sequential | drop70(frozen)+skip49 | 66.3 (−4.7) | 51.1 (−3.4) | 78.6 (−2.5) | 66.6 (−3.7) | — | — |
| Inf. | Adaptive top-k | Uniform top-k | 50% skip | 70.5 (−0.5) | 53.6 (−0.9) | 80.9 (−0.2) | 69.8 (−0.5) | 11.6 | 1.19 |
| Inf. | Adaptive top-k | MoDES (DMT) | — | 70.4 (−0.6) | 53.6 (−0.9) | 80.9 (−0.2) | 69.8 (−0.5) | 13.8 | 1.18 |
| Inf. | Adaptive top-k | Random | — | 63.2 (−7.8) | 46.4 (−8.1) | 77.5 (−3.6) | 63.7 (−6.6) | 11.6 | 1.19 |
| Inf. | Expert pruning | REAP | E=128 | 70.3 (−0.7) | 53.8 (−0.7) | 80.1 (−1.0) | 69.5 (−0.8) | ≈0 | 1.16 |
| Inf. | Expert pruning | MSAN | E=128 | 69.9 | 54.0 | 80.2 | 69.4 (−0.9) | ||
| Inf. | Expert pruning | MAN | E=128 | 70.1 | 53.6 | 80.3 | 69.4 (−0.9) | ||
| Inf. | Expert pruning | Router-prob | E=128 | 68.8 | 52.7 | 80.4 | 68.7 (−1.6) | ||
| Inf. | Token pruning | GDN-$\beta$ | keep 50% | 69.7 (−1.3) | 53.5 (−1.0) | 80.2 (−0.9) | 69.2 (−1.1) | 22.8 | 1.39 |
| Inf. | Token pruning | Random | keep 50% | 69.0 (−2.0) | 52.8 (−1.7) | 79.4 (−1.7) | 68.4 (−1.9) | ||
| Inf. | Combined | MoDES + GDN-$\beta$ | 30% skip, keep 50% | 69.7 (−1.3) | 53.4 (−1.1) | 80.0 (−1.1) | 69.1 (−1.2) | 28.9 | 1.44 |
结论分析:
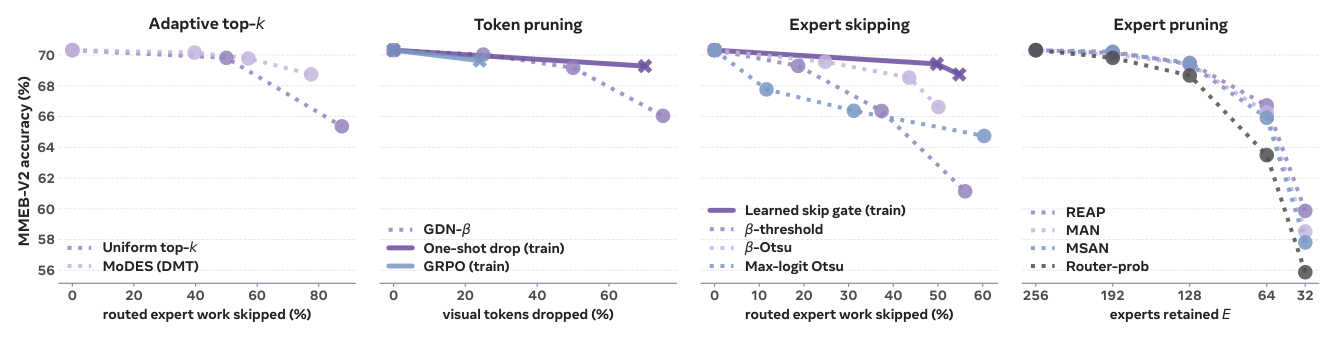
- 所有动作都能在 1.2 点内保住精度,说明 MoE 嵌入器在序列维与参数维上都有大量执行冗余。top-8 降到均匀 top-4 只掉 0.5 点却省 11.6% FLOPs、提 1.19× QPS;one-shot token 剪枝丢掉 70% 视觉 token 省 32% FLOPs、掉不到 1.0 点;静态专家剪枝把专家池砍一半(256→128)掉不到 1.0 点。
- 推理期方法竟然普遍不输训练期方法。自适应 top-k 上,训练式 AdaMoE 收敛到平均 2.94 个专家(63.3% 跳过)只有 67.2,而推理式 MoDES 在 57.1% 跳过率下有 69.8、在 77.5% 跳过率下仍有 68.8(用更少专家反而高 1.6 点)。作者的解释是预训练 router 的 logit 排序本身已近最优,无需专门训练。这与前面 Table 5"冻结 router 最好"的结论完全一致,两处互相加强。
- 排序质量是收益的真正来源,不是稀疏本身。同样 11.6% 的 FLOPs 缩减,按 router 排序取 top-4 掉 0.5,随机取 4 个掉 6.6;同样保留 50% token,$\beta$ 排序掉 1.1,随机掉 1.9。这两组对照做得很好,直接证明信号本身有效。
- 训练式方法的优势只在极端预算下出现:丢掉 70–75% 视觉 token 时,训练式 dropper 仍只掉 1.0,而启发式掉 4.3。
- 多动作联合几乎全是负结果:四种组合策略(全局预算 −5.6、同时 −3.2、交替 −3.5、顺序 −3.7)都远差于单动作,只有 GRPO 版(−0.7,省 22.5% FLOPs、1.46× QPS)成功。这是一个诚实且有信息量的负面报告。
FLOPs → wall-clock 的实测¶
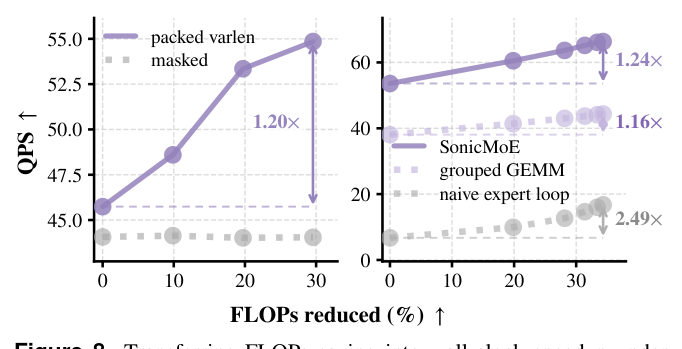
Table 9(token 剪枝:masking vs 物理压缩):
| Keep | Masked QPS | Masked Speedup | FLOPs↓% | Packed varlen QPS | Packed Speedup |
|---|---|---|---|---|---|
| 1.00 | 45.7 | 1.061 | 0.0 | 45.7 | 1.024 |
| 0.75 | 44.1 | 1.025 | 9.9 | 48.6 | 1.088 |
| 0.50 | 44.0 | 1.023 | 19.7 | 53.4 | 1.194 |
| 0.25 | 44.0 | 1.023 | 29.6 | 54.9 | 1.228 |
空间 masking 保持张量形状 $[B, S, H]$ 不变,因此在所有剪枝预算下都是平坦的 1.02×,等于白剪;物理压缩才把节省兑现出来。
Table 8(不同 kernel 下的专家跳过):naive expert loop 在 $S=1024$ 时 210.2 ms(grouped GEMM)对 1189.5 ms,慢 5.7–8.0×,但对稀疏"极其敏感"(延迟降 32.3–59.9%,换算成 163–174% 的转化率),所以拿它当基线会严重夸大专家稀疏的价值。SonicMoE 相对 grouped GEMM 在 $k=8$ 固定时就有 1.40× 加速(210.2 ms → 149.2 ms,$S=8192$),$k$ 从 8 降到约 4 再多 1.11–1.24×;降到 $k \approx 1.1$ 收益递减(grouped GEMM 累计 1.17×、SonicMoE 1.74×),因为剩下的是注意力、共享专家与 dispatch。
总体转化率:packed varlen 把移除的 FLOPs 的 63–82% 转成 wall-clock,SonicMoE 56–58%,未改的 grouped GEMM 只有 41%,masking 是 0%。
自适应计算的行为分析¶
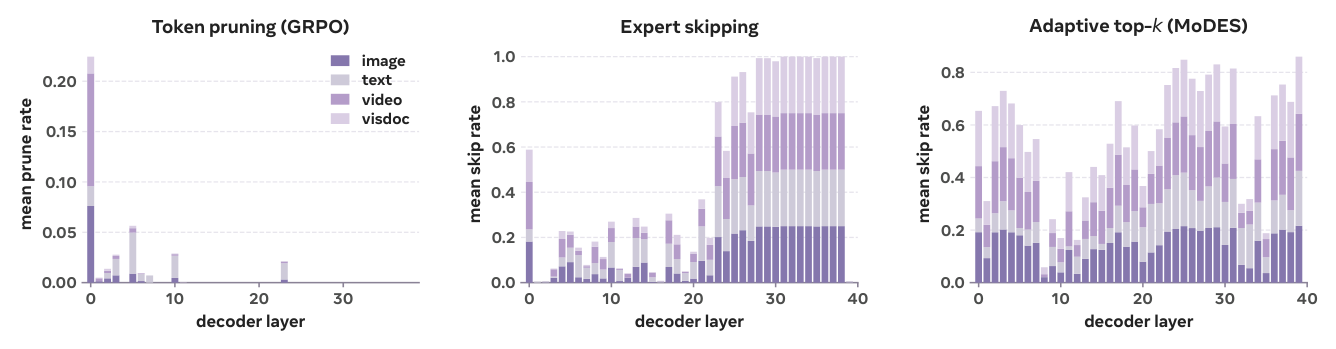
- Token 剪枝主要发生在浅层且模态敏感:视频与图像的时空冗余高可以立刻剪;视觉文档含密集版面文字,文本 query 又编码了任务指令,必须先保留以给表征提供上下文,只能渐进剪。
- 专家跳过在浅层(<24)与深层行为不同:浅层各模态跳过率分化大,文本跳得更多(因为跳过只去掉专家计算,文本 token 仍然在场供注意力使用,并靠共享专家处理样板化的指令);深层各模态趋同。最后一层跳过率几乎为零——那是构造输出嵌入的地方。
- 自适应 top-k 则倾向给文本模态分配更多专家,尤其在浅层。
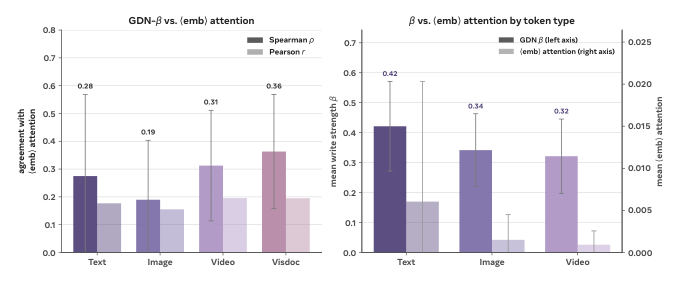
$\beta$ 是一个与注意力独立的显著性信号。$\beta$ 与 <emb> 注意力的一致性只有 Spearman 0.19–0.36(按模态),与"收到的注意力质量"的 Spearman 在 0.491–0.619 之间;但注意力的空间方差高得多——token 级变异系数均值 2.316 vs $\beta$ 的 0.226。附录 F 给出三条性质:
- 语义对齐:$\beta$ 高亮语义信息区(自然图像的前景物体、文档的图表/文字元素),形成连续空间簇而非孤立噪点;
- 深度稳定:$\beta$ 的跨层余弦相似度平均 0.989(最低 0.973),而
<emb>注意力只有 0.752(范围 [0.68, 0.86])——浅层被判为重要的 token 在深层依然重要; - 时间持久:视频跨帧余弦相似度 0.992 vs 注意力 0.744。
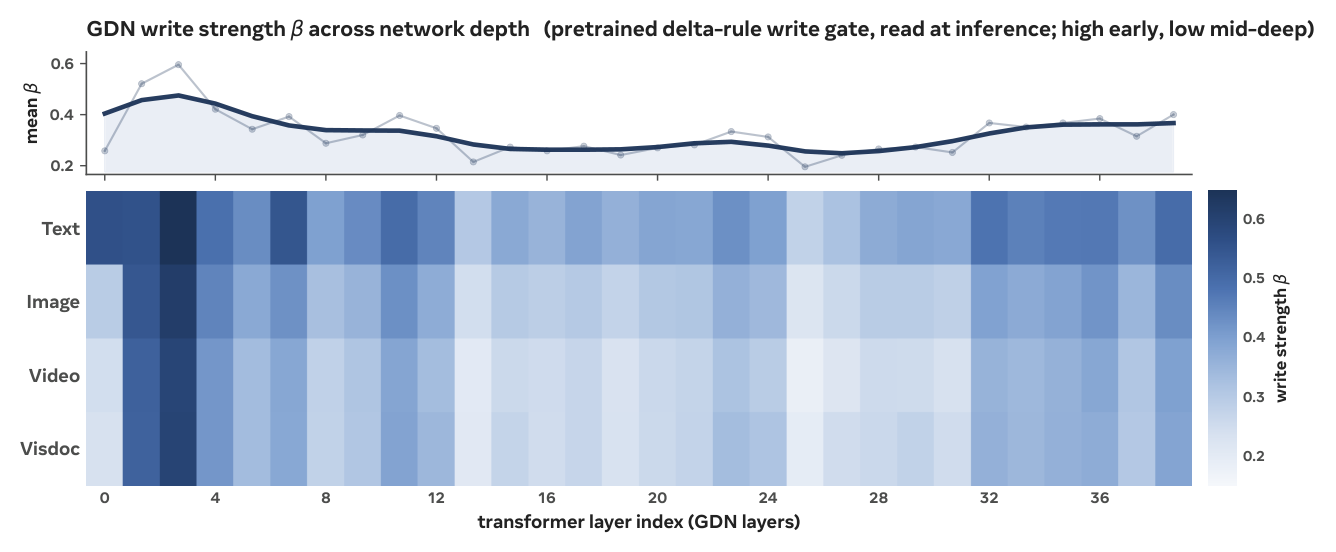
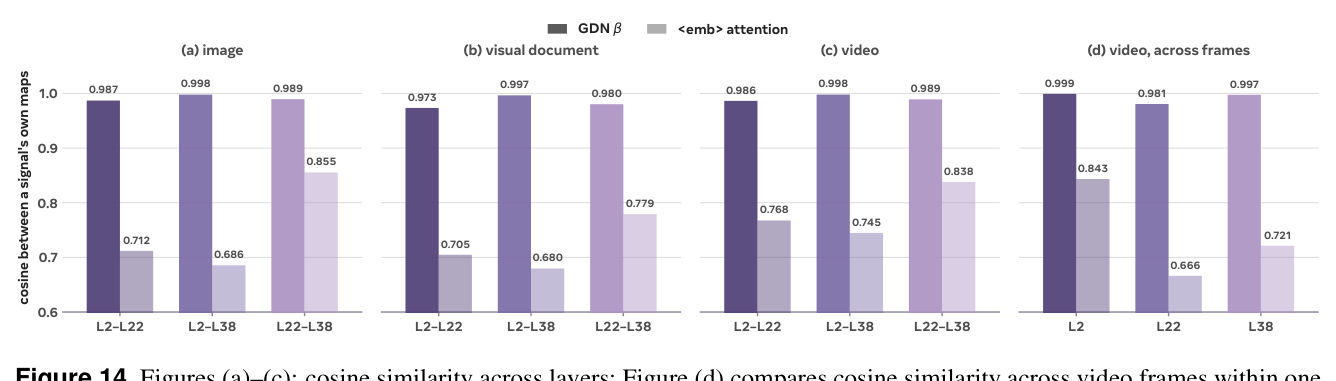
这三条性质正好解释了为什么 $\beta$ 适合做早层一次性剪枝:决策在后续层依然有效。Table 13 也验证了这一点——把决策层从 4 换到 2,75% keep 下精度只变 +0.04(70.03→70.07),25% keep 下 +0.21(66.05→66.26)。
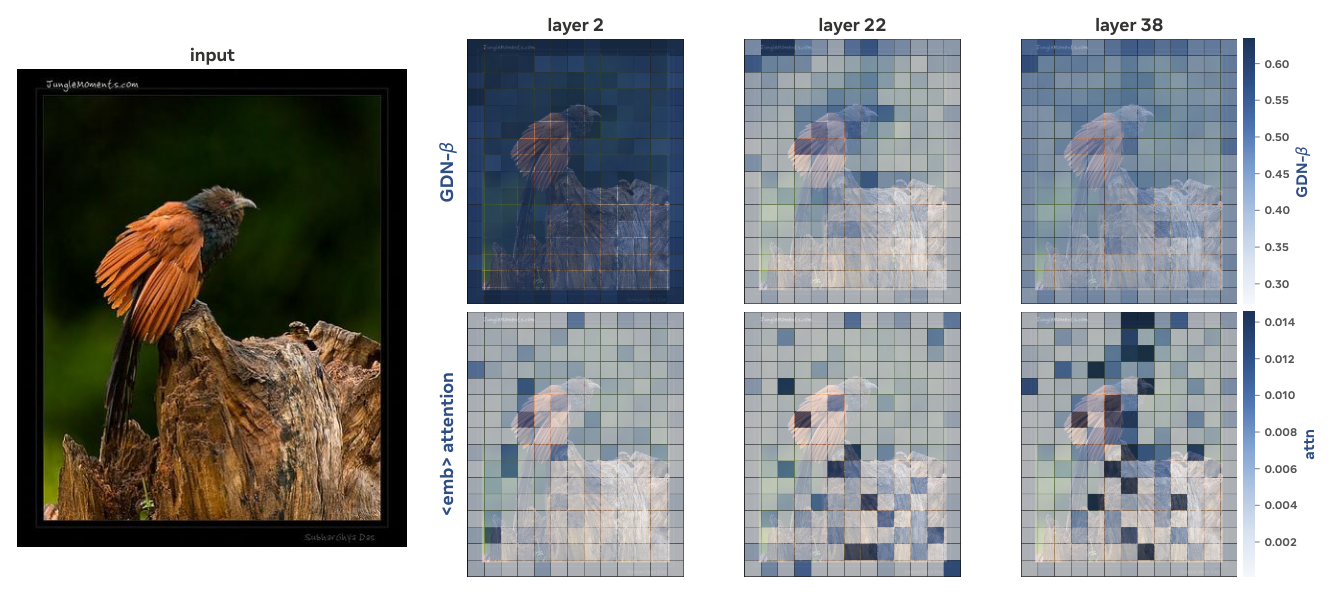
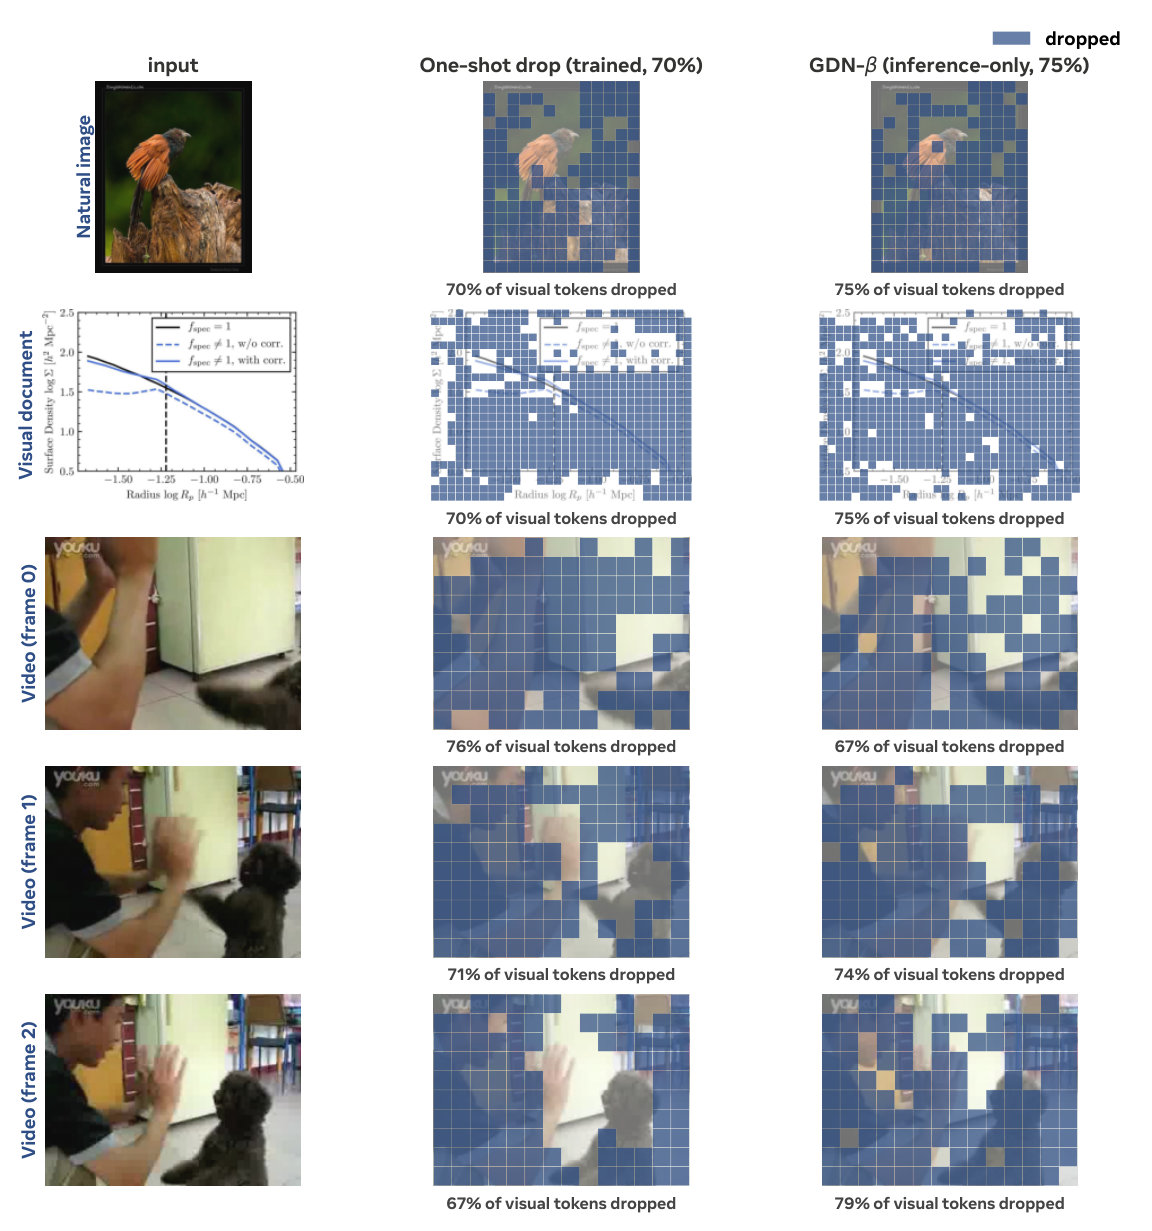
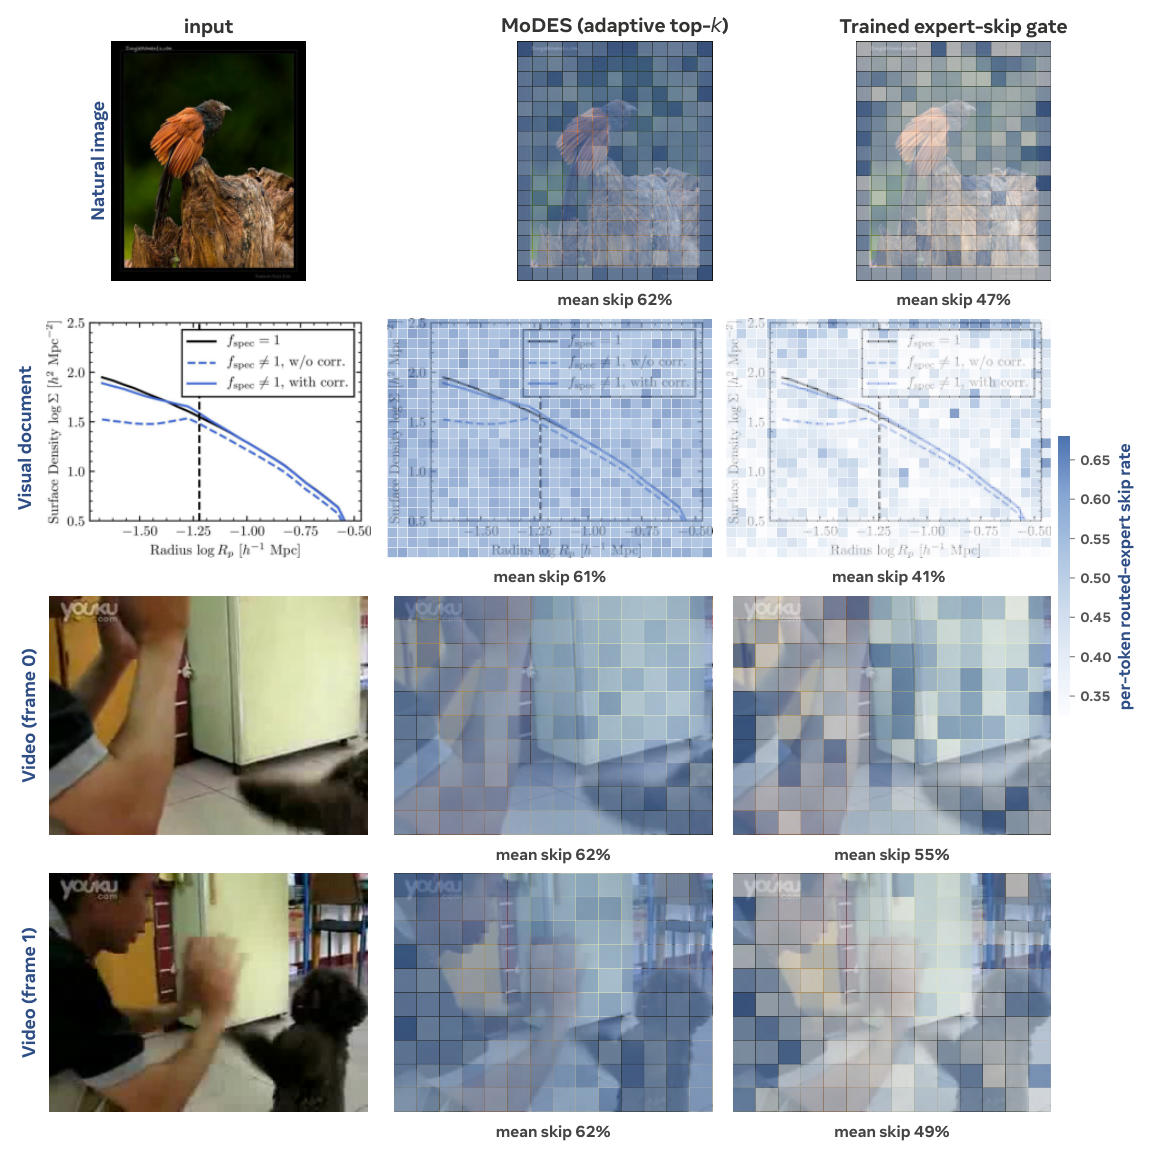
Figure 18 显示训练式 one-shot dropper 与 GDN-$\beta$ 策略选出的 token 子集几乎一致,这解释了两者精度接近的原因;而 Figure 19 显示训练式专家跳过门与 MoDES 的分配决策明显分歧(同样总跳过率下,MoDES 均值 62%、训练门 41–55%),说明专家侧还有优化空间。
失败案例表(Table 12)也值得记录:projected A-ViT gate(丢弃率超 ~85% 后嵌入 token 失去视觉上下文、表征与梯度双双崩溃)、cumulative drop logit(算力奖励把所有 halting 逼到第一层)、GDN-$\beta$ halting(门变惰性回到零丢弃,激进设置则训练不稳)、learned early exit(退出概率收敛到最后一层,节省可忽略)。作者的假设是:穿过不可导或延迟的注意力路径做信用分配会引入高梯度方差,导致效率惩罚在表征对齐稳定之前就占了上风。
核心贡献总结¶
- 把"专家容量"提出为 UME 的一条扩展轴,并给出三条构造路径(原生 MoE / dense-to-MoE upcycling / 模态级路由)与完整的适配配方对照。其中"冻结 router 最好、所有路由辅助目标都有害、upcycling 打不过稠密"这一组负面结论,比正面数字更有信息量。
- 在公开 MMEB-family 数据这一受控口径下,MoEMB-A3B / A10B 在 MMEB-V2(70.4 / 72.4)与 MRMR(51.6)上刷新 SOTA,且不依赖数据挖掘或复杂多阶段训练。
- 首次系统研究 MoE 嵌入器的自适应计算:六类动作 × 训练期/推理期两种 regime,得出"token 剪枝与自适应 top-k 权衡最好、省一半算力掉不到 1 点"的结论,并给出多动作联合的四种策略与它们的失败模式。
- 提出用 GDN 的写入强度 $\beta$ 作为免注意力图的 token 显著性信号,并用三条统计性质(语义对齐 / 深度稳定 0.989 / 跨帧持久 0.992)论证其适合早层一次性剪枝。
- 把 FLOPs 节省真正兑现成 QPS:packed varlen + tile-aware grouped GEMM,并给出 tile-bound 的定量分析,指出"专家稀疏能否加速取决于序列长度"这一被普遍忽略的事实,同时点名 naive expert loop 基线会把加速夸大 5.7–8.0×。
与已归档相关工作的对比¶
EMO EMO: Frustratingly Easy Progressive Training of Extendable MoE(2026-05-13)¶
关系:独立并发(本文未引用 EMO,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇都在追问同一件事——沿专家轴扩容,收益与代价各是多少。EMO 把 MoE"容量与每 token FLOPs 解耦"的承诺拆开,指出这个解耦只在 FLOPs 层成立、在 wall-clock 层不成立,并把它命名为 MoE efficiency paradox;MoEMB 面对的是同一个裂缝的推理侧版本——它必须证明"专家更多"不会把 QPS 拖垮。
- 相近的技术骨架:两者都把"专家池规模 $E$"当成一条独立的可优化轴,都强调必须同时看 loss/精度与系统成本,也都为此做了实测的 wall-clock 基准。
- 本文的差异与推进:EMO 是训练侧的答案——它拟合一条稀疏度感知的标度律 $L(N_{\text{act}}, E, D) = m(E)N_{\text{act}}^{\mu(E)} + n(E)D^{\nu(E)} + c$($R^2 = 0.9957$),据此解出每个 $E$ 的 compute-optimal 累计 token 数并归一化成扩张调度,让 $E$ 从 8 逐步涨到 128;MoEMB 是推理侧与下游适配侧的答案——它接受一个已经训好的 $E = 256$ 骨干,只研究怎么对比微调它、怎么在推理期把冗余算力砍掉。
- 可比的方法/实验差异(也是本文最大的缺口):EMO 提供了 MoEMB 完全缺失的那个受控实验——在训练期真正把 $E$ 变化并测量收益。EMO 在固定 top-$k=8$、固定激活参数下把 $E$ 从 8 加到 128,理论 FLOPs 完全不变,但实测每步 wall-clock 在 A4B 规模上慢 1.72×(A1.1B 规模只慢 1.08×,且缺口随激活规模变宽)。MoEMB 的 Figure 1 报告 $E$ 从 32 到 256 时 QPS 只从 34.2 掉到 29.3(1.17×),量级与 EMO 的观测以及 MoEMB 自己 Table 6 里"REAP 把 $E$ 从 256 剪到 128 得 1.16× QPS,而 FLOPs 减少 ≈0"是一致的——总专家数确实在推理侧也要付 wall-clock 代价,只是幅度可控。反过来,MoEMB 在精度侧的 +10.4 点没有 EMO 那样的从头训练网格支撑(见下节复核)。
Compute-Optimal Is Not Cluster-Optimal: Systems-Aware Scaling for Sparse Mixture-of-Experts Compute-Optimal Is Not Cluster-Optimal: Systems-Aware Scaling for Sparse Mixture-of-Experts(MOSAIC,Amazon AGI Foundations,2026-08-11)¶
关系:独立并发(本文未引用 MOSAIC)· 已加载对方精读
- 共同关注的问题:稀疏度 / 专家数这条轴上的收益,不能只用 model FLOPs 计价。MOSAIC 的核心论断是:在纯 model-FLOPs 预算下,拟合 loss 随稀疏度单调下降,因此最优稀疏度是边界解($S^\star = S_{\max}$);稀疏度的内点最优只有把集群系统约束(MFU、显存、并行布局)折进去之后才出现。MoEMB 的 Figure 1 用"精度 vs QPS"两轴画 Pareto 前沿,本质上就是 MOSAIC 那个论断的一个具体化实例。
- 相近的技术骨架:两者都拒绝"只报 FLOPs",都要求把系统可交付性放进同一张图里评价架构选择。
- 本文的差异与推进:MOSAIC 用约 150 次从头训练(104M–2.7B 激活、最高 79B 总参)拟合四维联合律 $L(N_{\text{tot}}, S, D, G) = aN_{\text{tot}}^{-\alpha} + bD^{-\beta} + c(1-S)^{-\lambda} + j(1-S)^{-\delta}N_{\text{tot}}^{-\gamma}G^{-\eta} + e$,把"专家切分因子 $G$ 的收益"钉成一个可辨识的系数 $\eta \approx 0.95$(95% BCa 区间 [+0.911, +0.954],与 $\beta$ 并列为全律中仅有的两个被数据唯一钉住的系数)。MoEMB 则完全没有这一层:它有两个训练好的点(35B-A3B 与 122B-A10B,两者 $E$ 都是 256),加一条剪枝退化曲线。
- 可比的方法/实验差异:MOSAIC 的读数对 MoEMB 是双向的。一方面它支持 MoEMB 的大方向——$\eta > 0$ 意味着更细的专家切分确实能折掉稀疏度带来的 loss 惩罚,专家轴的收益是真的;另一方面它约束了幅度——MOSAIC 实测在 $G=4$ 之后收益就进噪声了(预测单调下降但实测 $G=8$ 持平甚至轻微反转,作者因此明确不宣称普适的专家切分律),并且在 $C_{\text{model}} = 10^{22}$、world size 512 下,随 $G$ 从 1 到 8 每单位 FLOP 的墙钟时间要涨到 2.66×。以这个尺度衡量,MoEMB"扩专家几乎不要钱"的叙事只在推理、单机、固定序列长度这个特定切面上成立,换到训练或分布式服务就不成立。
SMELT SMELT: Scaling Laws for Compute-Matched MoE Looped Transformers(2026-09-01)¶
关系:独立并发(本文未引用 SMELT,发表仅早 7 天)· 已加载对方精读
- 共同关注的问题:两篇都在处理"一个架构改动的收益,有多少是它自己的,有多少是混进来的额外预算"。SMELT 针对的是循环 Transformer 文献的记账错误——把重复前向的额外 FLOPs 记成架构优势("a fraction of the parameter count is not a fraction of the cost");MoEMB 面对的是同构的问题:它宣称的收益里,有多少来自"专家更多",有多少来自"骨干换大了"。
- 相近的技术骨架:耐人寻味的是,两篇都把 MoE 当成解决问题的杠杆。SMELT 之所以选 MoE,正是因为 MoE 把总参数与 per-token FLOPs 解耦,使它能在收窄隐藏维 $H$ 支付第二次前向的 FLOPs 之后,通过加专家把损失的容量补回来;MoEMB 用的是同一个解耦性质,只是目的相反——它要在不加激活 FLOPs 的前提下加容量。
- 本文的差异与推进:差异在方法论严格度上,而且方向对 MoEMB 不利。SMELT 要求同时锁死三个预算:per-token FLOPs(残余错配 <4%)、总非嵌入参数(<1%)、KV cache(<4%),并在 0.1B–54B 非嵌入参数的四级标度阶梯上为两种架构各拟合一条独立标度面,最终把结论收成"在算力最优前沿上省 6.8–18.0% 训练 FLOPs"。SMELT 甚至用 Table 1 把前人的口径缺陷逐条列出(哪一篇匹配了 FLOPs、哪一篇只匹配参数、哪一篇两者都没匹配),并诚实承认在等 FLOPs 口径下有前人报告"循环输"。
- 可比的方法/实验差异:把 SMELT 的表格标准套到 MoEMB 上,MoEMB 的核心对照(Table 4:Qwen3.5-2B dense 63.6 vs MoEMB-A3B 70.4)只匹配了激活参数(2.2B vs 3.1B,还差 41%),总参数(2B vs 35B,差 17.5×)与预训练算力都没匹配。按 SMELT Table 1 的记法,这一行应该被标成 FLOPs ✓(部分)、Params ✗、KV ✗。这不是说 MoEMB 的数字是假的——它们都是真实测量——而是说这条对照无法支撑"专家轴"这个归因。
独立复核:四个核心问题¶
本节是精读者对该论文关键论断的独立核查,全部结论均以正文与附录原文为依据。
复核一:+10.4 点的"专家轴扩容"曲线,是 REAP 剪枝得到的退化曲线¶
结论:成立,且性质比"扩容收益"弱得多。
正文 §5.2 的原话是:"Scaling the number of total experts from $E = 32$ to $E = 256$ improves MoEMB-A3B accuracy by +10.4 points while QPS drops negligibly (34.2 → 29.3)";摘要与结论也写成 "adds over 10 accuracy points at near-constant active compute"。但附录 C.2 明确交代了这条曲线的构造:
"The expert-scaling curve for MoEMB-A3B evaluates the performance with different number of total experts $E \in \{32, 64, 128, 192, 256\}$, constructed by pruning the full $E = 256$ model using REAP (Lasby et al., 2025) under the reconstruction-error criterion."
交叉验证也对得上:Figure 7 最右侧"Expert pruning"面板的 REAP 曲线,$E = 256 \to 192 \to 128 \to 64 \to 32$ 对应约 70.3 → 70.0 → 68.6 → 66 → 59–60,与 Figure 1 红色曲线从 60.0 到 70.4 的跨度是同一组数,只是换了横轴。
这条曲线能不能当作"扩容收益"的证据?我的判断是不能,理由有三:
- 剪枝损伤与"本来就训练得小"是两回事,且偏差方向明确。$E = 32$ 的那个点,是一个在 256 个专家上完成了预训练与对比微调、其路由分配、专家特化与下游各层都是围绕 256 个专家协同训练出来的模型,被事后砍掉 87.5% 的专家。一个从头就用 32 个专家训练(或至少在 32 个专家上重新适配)的模型,会把容量分配得完全不同,性能必然远高于 59–60。因此 REAP 曲线测的是"这个 256 专家模型对它的专家池有多依赖",而不是"32 专家的模型能做到多好"。作为扩容收益的证据,它系统性高估。
- 横轴与纵轴在这条曲线上是解耦的,"QPS 几乎不变"是构造出来的恒等式而非发现。REAP 剪枝保持 top-8 路由不变(论文自己在 Table 6 写明 FLOPs↓ ≈0),五个点跑的是完全相同的激活路径。所以"扩专家不掉 QPS"在这条曲线上是定义使然(残余的 1.17× 差异来自显存/kernel 效应),并不构成对"专家轴可以免费扩容"的独立验证。
- 论文其实有一个真正测过专家数变化的实验,但结论相反。附录 D.1 的 Table 10 里,在同一个 2B 稠密骨干上做 upcycling,$E$ 从 4 加到 32($G=1$、top-1、激活算力不变),Overall 从 62.44 掉到 60.26。这是全文唯一一处"其他条件不变、只改专家数"的训练侧对照,而它的符号是负的。
需要公允地补一句:作者没有隐瞒构造方式,附录 C.2 写得很清楚,也没有声称训练了五个模型。问题出在披露层级与叙事层级不匹配——摘要、引言、Figure 1 caption 与结论四处都用"expert scaling gains over 10 points"的表述,而唯一的限定条件只出现在第 19 页的附录里。以读者的默认解读计,这是一处被放大了的归因。
复核二:native MoE 比 dense +6.8 是否控制了骨干与总参数量¶
结论:激活算力大致对齐,骨干与总参数量完全没有控制;而真正控制了骨干的两个对照,增益是 −0.5 与 +0.6。
Table 4 的四行是:
| Method | Act. | Overall | 骨干 | 总参数量 |
|---|---|---|---|---|
| Qwen3.5-2B (dense) | 2.2B | 63.6 | Qwen3.5-2B | ≈2B |
| Dense-to-MoE upcycling | ~3.0B | 63.1 | Qwen3.5-2B | ≈2B(切分复制) |
| Modality-wise MoE | 2.2B | 64.2 | Qwen3.5-2B | ≈2B(复制 FFN) |
| MoEMB-A3B (native) | 3.1B | 70.4 | Qwen3.5-35B-A3B | ≈35B |
正文把这张表描述为 "compare structural MoE strategies against a dense baseline at equal active compute"。逐条核查:
- 激活算力:2.2B vs 3.1B,差 41%,"equal"是宽松的说法但方向无碍。
- 总参数量:2B vs 35B,差约 17.5×。这一项完全没有控制。
- 预训练骨干:Qwen3.5-2B vs Qwen3.5-35B-A3B 是两个不同的预训练模型,预训练算力与所吸收的世界知识差着一个数量级。这一项也完全没有控制。
关键在于:论文里唯一控制了骨干的两个 dense→MoE 对照,都没有正收益。 upcycling(同一个 2B 骨干切成 MoE)是 63.1 < 63.6,模态级 MoE(同一个 2B 骨干复制 FFN)是 64.2,只 +0.6。也就是说,"把一个模型变成 MoE"这件事本身,在受控条件下带来的是 ≈0 的增益;那 +6.8 全部来自换了一个总参 17.5 倍、预训练算力高一个量级的骨干。
作者其实在 D.1 结尾自己写出了正确的结论——"These results confirm that synthesizing expert capacity during contrastive fine-tuning is ineffective, highlighting the necessity of native MoE backbones pre-trained at scale"。这句话是准确的,但它说的是"需要一个大规模预训练的原生 MoE 骨干",而不是"专家轴带来 +6.8"。正文与摘要采用的是后一种表述。
一个可以为论文辩护的角度是:稀疏 MoE 的价值主张本来就是"在固定激活算力下拿到更多总参数",而这份总参数只有靠原生预训练才能获得,因此"换一个 35B 总参的 MoE 骨干"在某种意义上就是沿专家轴扩容。这个辩护部分成立,但它把论断降级为"用一个更大的稀疏骨干做嵌入器,比用一个小稠密骨干好"——这是一个显然为真、也不新的命题,与论文标题声称的"a scaling axis"相去甚远。
还有一个交叉验证很能说明问题:附录 D.2 的 Table 11 用统一超参比较了三个骨干的 generalist 表现,Qwen3.5-35B-A3B(MoE, 3.1B act)拿到 65.75,只比 Qwen3.5-2B dense 的 63.85 高 1.9 点,而且明显低于 Qwen3.5-9B dense 的 68.58。当然这只覆盖 Image-CLS + Image-Ret 两组任务、训练配置也更轻(batch 256、1 epoch),不能直接搬到 78 任务上;但它至少说明"MoE 骨干在同口径下对稠密骨干的优势"远没有 6.8 那么大,而且在同等激活算力之外再放开一点激活算力(9B dense)就能反超 MoE。
综合判断:本篇属于"引入新信号 ≠ 收益来源"的实打实命中,而不只是部分命中。 全文没有任何一个实验在训练期真正改变过专家数并观察到正收益:$E$ 变化只出现在剪枝曲线(性质错误)与 upcycling 表(符号为负),而 A3B → A10B 的 70.4 → 72.4 同时改变了激活参数(3.1→10.2B)、隐藏维(2048→3072)与层数(40→48),$E$ 反而都是 256、完全没变。
复核三:7 分是否仍然合适¶
我的独立判断:给 6 分,低于评分 agent 的 7。
支持保住高分的因素是真实存在的,我不想抹掉它们:
- 对外部基线的胜出是真比较(见复核四),且论文主动做了训练数据分组这一少见的自律动作;
- 自适应计算这一半的工作质量很高:六类动作 × 两种 regime 的系统对照、随机基线对照(top-4 随机掉 6.6 vs 路由排序掉 0.5)、GDN-$\beta$ 这个新信号有三条统计性质支撑且做了与注意力的独立性验证、四种多动作组合策略的失败模式与 Table 12 的负面结果表、tile-bound 分析与对 naive expert loop 基线的点名批评——这些都是扎实且对后来者有直接价值的贡献;
- "冻结 router 最好、辅助路由目标全害、upcycling 打不过稠密"这组负面结论有交叉验证(Table 5 与 Table 6 的推理式 vs 训练式 top-k 互相印证),可信度高。
但要打折的地方比评分 agent 记的更重:
- 论文的标题、摘要、引言、Figure 1 与结论这五个最显眼的位置,主张的都是"expert scaling"这条轴,而这条轴没有任何一个合格的实验支撑(复核一、复核二)。这不是某个次要数字的瑕疵,而是一号卖点的证据链断裂。
- 论文自己手上就有反证(Table 10 的 $E$: 4→32 掉 2.2 点;Table 11 的 9B dense 反超 MoE),却没有在正文里与主张对质。
- 按精读评分标准的"实验严谨度"维度——baseline 是否充分(充分)、消融是否系统(自适应计算那半非常系统,MoE 设计那半不系统)、结论是否可信(核心结论的因果归因不可信)——第三条是硬伤。
- 方法论可扩展性方面倒是没有明显隐患:它不是"先离线压缩再在线建模"那类两阶段解耦,参数量 scaling 时表征能力与容量能一起增长。
7 分对应"方法有创新、实验设计合理、结论可信"。这篇的自适应计算部分够 7–8,但它的招牌论断不可信,两半平均下来落在 6(中规中矩偏上:有明确参考价值,但核心创新的证据不足,实际贡献更接近"一份 MoE 嵌入器的适配与提效工程报告"而非"一条新的扩展轴")。如果论文把标题与叙事重心换成"MoE 嵌入器的适配配方与自适应计算研究",同样的内容我会给 7。
复核四:对外部基线的胜出(MMEB-V2 / MRMR)是否真比较¶
结论:在论文自己声明的口径下是真比较,而且比大多数同类论文更自律;但这个口径不足以支撑"专家轴"的归因。
逐项核查:
- 评测协议:MMEB-V2 与 MRMR 都"follow the official evaluation setup"。MRMR 的 Table 3 里带 † 的行是 MRMR benchmark 官方报告的数字、其余是作者自测,这一点在表注里标明了,属于常规且已披露的做法。
- 训练数据规模:这是论文做得最好的一点。它把 Table 2 显式拆成"adapted with external data"与"adapted only with public MMEB-family data"两组,并只在后一组内宣称 SOTA;还主动解释了为什么要拆(MMEB-V2 评测大量 OOD,用镜像评测格式的外部语料会造成 domain-wise 泄漏)。在同组内比较,MoEMB-A3B 70.4 vs 次优 Embed-RL-4B 68.1、UME-R1-7B 65.6、PLUME 61.6,差距足够大,不是噪声。MRMR 上 51.6 vs 48.9/48.2/46.8 同理。
- 激活参数:论文用 "Act. (B)" 列作为公平轴,按这个轴 MoEMB 极其有利(3.1B 打 8.3–13.2B)。这一列的数字与口径(Embed-RL 的 13.2B/10.9B 含共享 reasoner)也在表注里交代了。
- 没有被控制的是骨干:MoEMB 用的是 Qwen3.5-35B-A3B / 122B-A10B——总参 35B/122B 的 2026 年前沿 MoE 骨干;而 PLUME / UME-R1 / VLM2Vec-V2 / BToks / Embed-RL 用的是 2B–7B 量级的稠密骨干(Qwen2-VL / Qwen2.5-VL 世代)。所以"只用公开 MMEB 数据"这个条件被严格控制了,"预训练骨干的容量与世代"完全没有控制,而 MoEMB 在这一项上是全组最占优的。
- 收益分布也印证了这一点:如前所述,MoEMB 的增益高度集中在 VisDoc-OOD(82.8 vs PLUME 57.4,+25.4)、Knowledge 检索与 grounding 上,而在 Image-CLS(60.6,组内最差)与 MRMR 的 Math/Phy./Eng./Negation 上并不占优。这个分布更像"骨干世界知识与文档理解能力强"的指纹,而非"专家数多"的指纹。
综合:胜出是真的(same eval protocol、same finetuning data regime、差距远超噪声),但它证明的是"用一个更强的稀疏骨干 + 一套好的对比适配配方,能在公开数据口径下做出 SOTA 嵌入器",而不是"专家轴是一条有效的扩展轴"。 这两个命题之间的距离,正是本篇最需要补的实验。
讨论与局限性¶
值得借鉴的设计¶
- 按训练数据来源拆分排行榜。这个动作成本很低、信息量很高,值得所有做公开基准的工作照抄。
- 随机基线对照。"同样省 11.6% FLOPs,按 router 排序掉 0.5、随机掉 6.6"这一组数字,把"收益来自信号质量而非稀疏本身"钉死了。任何声称某个信号有效的工作都应该配这样一组。
- GDN 的 $\beta$ 作为零成本显著性信号。这是一个真正巧妙的观察:FlashAttention 不物化注意力图,但线性注意力/GDN 骨干自带一个 token 相关的写入门,读出来就是重要性。随着 GDN / 线性注意力在前沿 MLLM 里普及(Qwen3.5、Kimi K3 都用),这条路线的适用面会越来越宽。三条统计性质(跨层 0.989、跨帧 0.992、变异系数 0.226 vs 注意力 2.316)也解释了它为什么适合"早层一次决策"。
- tile-bound 分析。"跳过 token 只有在清空整个 128 行 tile 时才产生真实节省,因此专家稀疏能否加速取决于序列长度"——这个结论对任何做 MoE 推理优化的团队都是直接可用的工程知识,也是识别"虚高加速比"的检验工具。
- 负面结果表(Table 12)与失败模式记录。A-ViT gate 在丢弃率超 85% 后崩溃、cumulative drop logit 把 halting 全逼到第一层、learned early exit 收敛到最后一层——这些记录能省掉后来者大量重复劳动。
局限与争议¶
- 核心归因缺失(最严重):如复核一、二所述,全文没有任何一个训练期改变专家数并观察到正收益的实验。补这个缺口的成本并不高——哪怕在 2B 或 9B 规模上训 3–4 个不同 $E$ 的原生 MoE 嵌入器,也能把"专家轴"从叙事变成结论。EMO 与 MOSAIC 都做了类似规模的网格,说明这在可行范围内。
- 图像分类的系统性退化未被讨论。MoEMB-A3B 的 Image-CLS 60.6 是公开数据 ≤4B 组最差,N24News 39.5 vs PLUME 81.1 是断崖式的差距。论文没有分析这个现象。可能的原因(
<emb>pooling 对分类任务的适配、训练混合里 ImageNet-1K 权重 2.25 相对 VisRAG/ViDoRe 的 5–6 偏低、MoE 路由的模态特化对细粒度分类不利)都值得一查,但论文只字未提。这在一篇宣称"通用"嵌入的论文里是显眼的遗漏。 - MRMR 上的推理类子任务并没有赢。Math/Phy./Eng. 三列 MoEMB 都输给 Embed-RL-4B 或 LaME-7B,Negation 的 Hit@1 只有 11.0(ColPali 28.5)。论文用 MRMR 的总分论证"扩容量比扩 CoT 更适合推理密集检索",但逐列看,赢的是知识检索、输的恰恰是需要多步逻辑的那几列。这个论断被总分掩盖了。
- 模态而非任务的路由特化,与动机链条有张力。附录 D.3 发现路由按模态组织、按任务无显著分离($p = 0.73$),且模态分歧随深度消失(第 38 层只剩 43/256 个模态偏好专家,有效使用专家数 $\exp(H)$ 降到 13)。既然专家在深层几乎收敛到一个共享子群,"扩专家数"为什么能提升多任务容量,机制上其实没有被解释清楚——论文只是把 generalist–specialist gap 的收缩归因于容量,中间的因果环节是空的。
- 静态专家剪枝减的是显存不是算力。REAP 把 $E$ 从 256 剪到 128 只带来 1.16× QPS 而 FLOPs↓≈0,本质是显存与 kernel 效率收益。论文把它放在"自适应计算"章节里,与真正减算力的 token 剪枝并列,容易引起误读。
- 数据规模与模态覆盖:论文自陈只用公开 MMEB-family 数据,落后于用外部数据训练的模型(72.4 vs DME-Large 80.2),且不支持音频输入。
- AI 使用声明:论文明确写了 "Anthropic Claude Code (Opus 4.8 and Opus 5) was used extensively for drafting code, aggregating results, and drafting manuscript",作者承担最终责任。这与本文归因表述上的滑动是否有关无从判断,但值得记录。
与已有工作的差异¶
论文自己划的两条界线是准确的:与 TSEmbed(Wu et al., 2026)的差异在于后者用固定的任务/模态级 LoRA 路由,专家容量被任务分类法卡死,而本文用原生 token 级稀疏路由,容量可随专家数增长;与 MoEE(Li & Zhou, 2024)的差异在于后者直接从冻结的 router 概率里抽现成文本嵌入,而本文是对稀疏多模态架构做微调再池化隐状态。
值得补充一条论文没提的对照:LIMIT LIMIT 从 sphere-packing 与 sign-rank 出发证明了固定维度的单向量嵌入检索在原理上无法表示所有 top-$k$ 文档集合,并用一个极简数据集让所有 SOTA 嵌入器全线崩溃。MoEMB 的核心设计选择恰恰是"保持单向量、非自回归编码",只扩编码器容量。两者对同一现象给出的诊断方向相反:LIMIT 说瓶颈在输出表征的维度(这正是 MoEMB 明确不去扩的那条轴),MoEMB 说瓶颈在编码器容量。如果 LIMIT 的下界是紧的,那么沿专家轴扩容能推高的是"在可表示范围内逼近最优"的能力,而无法突破单向量本身的组合表达上限——这是本文路线一个未被讨论的天花板。(LIMIT 与本文问题相关但解法骨架不同构,故未列入上面的对比章节。)
工业落地价值¶
本篇按证据判为 academic:全部实验在公开 MMEB-family 数据上完成,无线上 A/B、无部署报告、无平台规模私有数据。但它有两块内容对工业团队是直接可用的:(1) tile-aware kernel 与 packed varlen 的实现思路,以及"FLOPs 转化率"这个评价指标(packed varlen 63–82%、SonicMoE 56–58%、grouped GEMM 41%、masking 0%);(2) 推理期免训练方法(MoDES 自适应 top-k、GDN-$\beta$ token 剪枝)不需要重训就能上,组合起来省 28.9% FLOPs、提 1.44× QPS、掉 1.2 点,这个性价比对大规模检索/推荐的嵌入服务是有吸引力的。