Hyperparameter Scaling Laws Across MoE Sparsity¶
arXiv:2609.08690v1 · 2026-09-08 · Ling Team, Ant Group(蚂蚁集团百灵团队)
作者:Changxin Tian, Kunlong Chen, Jia Liu, Ziqi Liu, Zhiqiang Zhang†, Jun Zhou†(†通讯)
一句话:用 1,800 次从零预训练(六个激活参数规模 × 四档激活率、约 20T token、20 万等效 H800 卡时)证明最优学习率与最优 batch size 会随 MoE 激活率 $A$ 系统性漂移,且激活参数量、总参数量、训练算力三者都吸收不掉这个漂移,进而把 $A$ 作为一个可分离的乘性幂律因子写进超参标度律,得到 $h^*(X,A)=k_h X^{\gamma_h}A^{\delta_h}$,并在一个 12B 总参 / $A=1/64$ 的冻结留出目标上做联合外推验证。
一、研究动机与背景¶
1.1 MoE 把「超参怎么迁移」这个老问题重新打开了¶
Mixture-of-Experts(Shazeer et al., 2017)已经是把 LLM 容量扩上去的主路径:每个 token 只激活一小部分专家,总参数量可以远超每 token 训练算力所对应的规模(Clark et al., 2022)。在这个范式里,学习率(LR)与 batch size(BS)对训练稳定性、收敛速度与最终性能的影响被进一步放大(McCandlish et al., 2018;Bjorck et al., 2025;Zhang et al., 2025),而在目标规模上穷举调参又贵到不可行。既有做法是建立经验标度律,把最优超参与模型规模 / 数据量 / 算力预算挂钩(Kaplan et al., 2020;Hoffmann et al., 2022;Bi et al., 2024),近期也有工作把这套律扩展到 MoE,但基本都停在常规稀疏度或者干脆固定稀疏度(Ludziejewski et al., 2025;Li et al., 2025;Wang et al., 2024;Tian et al., 2026)。
1.2 前人结论互相打架¶
论文把这个洞点得很明确:现有文献对「MoE 超参能不能从 dense 直接搬过来」给出的是互相矛盾的答案。
- 一派认为超参在 dense 与 sparse MoE 之间迁移得很稳(Wang et al., 2024;Li et al., 2025 的 Step Law);
- 另一派观察到 MoE 偏好更大的 batch size 与更低的学习率(Ludziejewski et al., 2025;Tian et al., 2026,即本文同一作者此前的 Ling 效率杠杆工作)。
更关键的是,没有任何一条现有的律刻画了「最优值如何随稀疏度连续变化」,尤其是在 $A=1/64$ 这种超稀疏区间——而这正是 Kimi K3、DeepSeek-V4 这一代前沿模型的工作区。
1.3 一张图先把结论摆出来¶
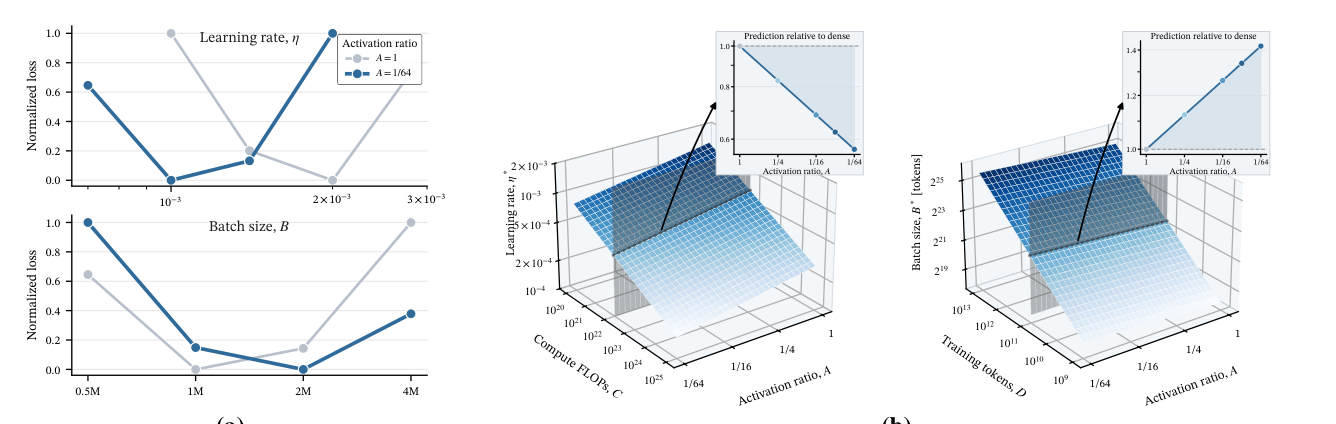
Figure 1(a) 是一次干净的受控实验:固定 80M 激活参数、固定 20B 训练 token,dense 模型($A=1$)与 $A=1/64$ 的 MoE 偏好的 LR 与 BS 明显不同——dense 的 LR 最优点在 $2\times10^{-3}$ 附近而 MoE 在 $10^{-3}$ 附近;BS 上 dense 最优在 1M token 而 MoE 移到了 2M token。激活参数量与训练数据都对齐了,最优点依然错开,说明激活率本身携带了额外的预测信息,必须显式进入标度律。
1.4 本文的三条贡献¶
- 在同一套实验框架下调和前人的矛盾结论:固定稀疏度时,$B^*$ 服从关于训练 token $D$ 的幂律,$\eta^*$ 服从关于训练算力 $C$ 的幂律;跨稀疏度时,激活率 $A$ 以乘性方式修正两者的前置因子。
- 给出跨 MoE 稀疏度的统一超参标度律,并用大规模实验数据与候选函数族比较来验证其形式。
- 联合外推验证:在一个超出拟合区间($A$、$D$、$C$ 三个维度同时越界)的冻结目标上给出最接近实测最优的预测,并验证该关系在不同专家粒度间可迁移。
二、问题形式化与受控实验设置¶
2.1 符号与定义¶
记 $N$ 为每 token 激活的非嵌入参数量,$N_{tot}$ 为总非嵌入参数量,$D$ 为训练 token 数,$M$ 为该架构解析计算的每 token 非嵌入 FLOPs。记每 token 激活专家数为 $E_{act}$、总专家数为 $E_{tot}$,定义
$$A \equiv \frac{E_{act}}{E_{tot}}, \qquad C \equiv MD, \tag{1}$$
$A$ 越小越稀疏。这里有一个必须注意的口径选择:本文沿用 DeepSeek-V3 与 Tian et al. (2026) 的做法,用解析的 $C = MD$ 而不是 Kaplan 的 $C \approx 6ND$ 近似;因此 $C$ 表示解析核算的非嵌入训练 FLOPs,而 $N$ 只是一个「参数规模描述量」和候选预测变量,不再兼任算力代理。
设 $\eta$ 为固定调度下的峰值学习率,$B$ 为每次优化器更新处理的全局 token 数。固定架构族、数据分布与其余训练选择后,把训练 $D$ 个 token 后的验证交叉熵写作
$$L(\eta, B \mid N, N_{tot}, M, D, A), \tag{2}$$
最优超参定义为候选搜索空间上的联合极小点
$$(\eta^*, B^*) \equiv \arg\min_{\eta, B} L(\eta, B \mid N, N_{tot}, M, D, A). \tag{3}$$
有限网格不会直接给出连续最优点,所以后续分析同时考虑观测最优点与近优集:沿用 Bi et al. (2024),预先指定 0.1% 阈值,把泛化误差不超过最小值 0.1% 的网格点全部计为近优,以此压噪。
幂律假设沿用既有超参标度研究:
$$h^*(X) = aX^b, \tag{4}$$
等价地 $\log h^* = \log a + b\log X$,在 log-log 空间是截距 $\log a$ 加斜率 $b$。
2.2 受控实验设置¶
为了把模型规模、训练长度、稀疏度三者的效应分离,作者构造了六个模型规模并系统变动 $N$、$N_{tot}$、$D$、$A \in \{1, 1/4, 1/16, 1/32\}$(留出目标另加 $A=1/64$)。
Table 5:全实验共享的训练控制
| 设置 | 取值 |
|---|---|
| 训练框架 | Megatron |
| 序列长度 | 4,096 token |
| Tokenizer | Byte-level BPE,词表 157,184 |
| 归一化 | RMSNorm + QK layer normalization |
| FFN 激活 | SwiGLU |
| 骨干 | 混合线性注意力 + MLA(Li et al., 2026,即 Ling/Ring 2.6) |
| 位置编码 | RoPE |
| 初始化 | 标准差 0.006;chunk 初始化 $\alpha = 3.0$ |
| 优化器 | Muon |
| LR 调度 | WSD:1% warmup,末段 10% 指数衰减 |
| Weight decay | 0.1(含归一化参数) |
| 梯度裁剪 | 全局范数 1.0 |
| MoE 路由 | Sigmoid 路由 + Auxiliary-Loss-Free 负载均衡(DeepSeek-AI, 2024) |
Table 6:六个模型规模的架构控制("S/L" 为 MLA 层数 / 线性注意力层数;主网格每 token 激活两个路由专家)
| 规模 | 层数 | Hidden size | Heads | 路由专家宽度 $h_{MoE}$ | S/L |
|---|---|---|---|---|---|
| 10M | 10 | 256 | 4 | 384 | 2/8 |
| 20M | 10 | 384 | 6 | 512 | 2/8 |
| 40M | 12 | 512 | 8 | 640 | 3/9 |
| 80M | 16 | 640 | 10 | 768 | 4/12 |
| 158M | 20 | 768 | 12 | 1,024 | 4/16 |
| 324M | 24 | 1,024 | 16 | 1,280 | 4/20 |
Table 7:系数拟合配置与最终联合外推留出目标(节选,$N_{tot}$ 随 $A$ 变化)
| 规模 $N$ | $A$ | $E_{act}$ | $E_{tot}$ | $N_{tot}$ | $D$ | Target FLOPs | 角色 |
|---|---|---|---|---|---|---|---|
| 10M | 1 / 1/4 / 1/16 / 1/32 | 2 | 2 / 8 / 32 / 64 | 10M / 27M / 98M / 193M | 4.6B | $3\times10^{17}$ | Fit |
| 20M | 同上 | 2 | 同上 | 20M / 55M / 197M / 386M | 7.8B | $1\times10^{18}$ | Fit |
| 40M | 同上 | 2 | 同上 | 40M / 111M / 395M / 772M | 11.6B | $3\times10^{18}$ | Fit |
| 80M | 同上 | 2 | 同上 | 80M / 223M / 790M / 1.5B | 19.6B | $1\times10^{19}$ | Fit |
| 158M | 同上 | 2 | 同上 | 158M / 442M / 1.6B / 3.1B | 31.7B | $3\times10^{19}$ | Fit |
| 324M | 同上 | 2 | 同上 | 324M / 894M / 3.2B / 6.2B | 52.9B | $1\times10^{20}$ | Fit |
| 324M | 1/64 | 2 | 128 | 12.2B | 159.0B | $\mathbf{3\times10^{20}}$ | Holdout |
关键细节:
- 稀疏度是靠改 $E_{tot}$ 实现的——固定 top-2 路由,五档激活率分别对应 2 / 8 / 32 / 64 / 128 个总专家。
- 主搜索网格:$\eta \in \{5, 7, 10, 14, 20, 28, 40, 56\}\times10^{-4}$(8 档),$B \in \{2^{17}, \dots, 2^{23}\}$(7 档)。所有拟合规模与激活率共享同一主网格。
- 留出目标用独立网格:$\eta \in \{3.6, 5, 7, 10, 14, 20\}\times10^{-4}$,$B \in \{2^{19}, \dots, 2^{23}\}$。
- 为省算力,明显落在近优区外的网格点会被提前中止。因此文中的「损失面」是每个配置的实际观测二维网格,不一定覆盖预设 LR–BS 的完整笛卡尔积。
- 全部实验合计 1,800 次预训练、约 20T token、约 20 万等效 H800 GPU 小时。
三、核心发现一:稀疏度是参数量与算力都吸收不掉的维度¶
3.1 参数量对齐不管用¶
既有研究都同意模型规模影响最优学习率,但对「哪个规模」意见相左:Ludziejewski et al. (2025) 认为是激活参数量,Li et al. (2025) 认为是总参数量。作者固定 batch size 直接测。
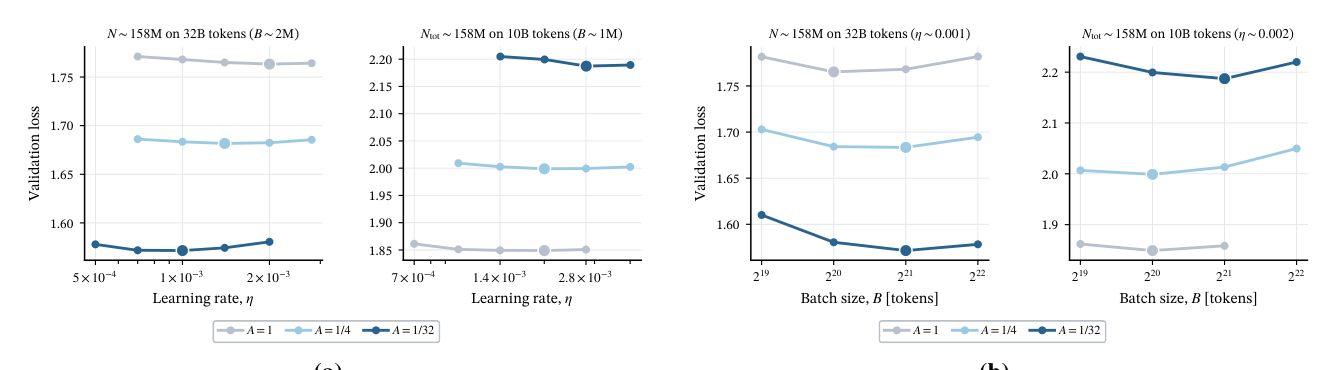
Figure 2(a) 左图在 $N \sim 158\mathrm{M}$、32B token、$B\sim2\mathrm{M}$ 下对比 $A = 1, 1/4, 1/32$,三条曲线的极小点仍然错开;右图改成对齐 $N_{tot}\sim158\mathrm{M}$、10B token、$B\sim1\mathrm{M}$,同样错开。两种参数量对齐都消不掉学习率漂移。
3.2 算力对齐也不管用¶
最优 batch size 的合适自变量同样有争议:一派用算力 $C$(Bi et al., 2024;Team et al., 2025),一派用训练 token 数 $D$(Li et al., 2025;Bergsma et al., 2026)。Figure 2(b) 显示,固定学习率时,即便 $D$、$N$ 与总训练算力 $C = MD$ 全部固定住,$B^*$ 仍然随 $A$ 变化;用 $N_{tot}$ 对齐结论相同。
Takeaway(原文):稀疏度为最优超参引入了一个额外的标度维度。参数量、训练 token 与算力都无法解释 $(\eta^*, B^*)$ 跨稀疏度的漂移,因此激活率 $A$ 必须被显式建模。
四、核心发现二:拆解算力、数据与稀疏度¶
4.1 最优学习率由训练算力组织¶
固定稀疏度下,既有工作对 $\eta^*$ 的基准变量有分歧:一派用 $N$ 与 $D$ 联合建模(Bjorck et al., 2025;Li et al., 2025),一派直接用 $C$(Bi et al., 2024)。在 $C=MD$ 的定义下,关键问题变成:固定 $C$ 时,$\eta^*$ 是否对「每 token 算力 $M$ 与训练时长 $D$ 之间的分配」敏感?
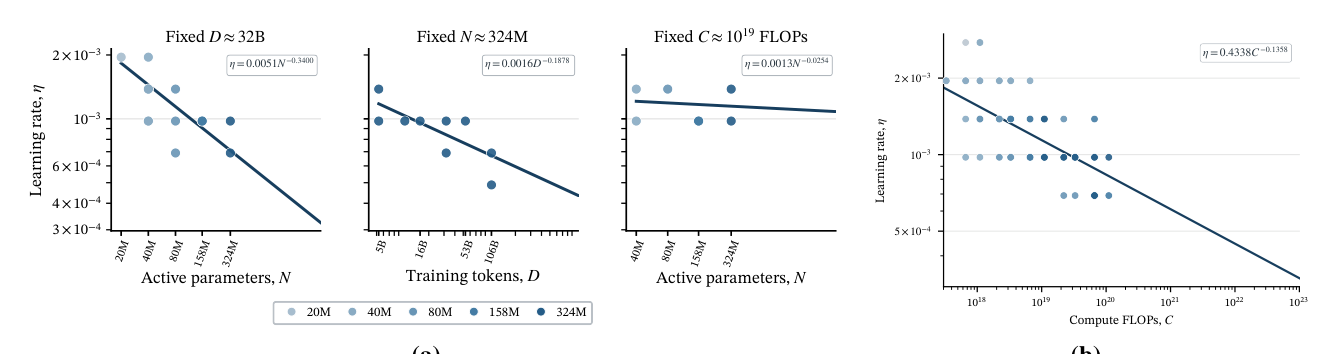
Figure 3(a) 的三个面板给出直接证据:
| 控制条件 | 拟合式 | 读法 |
|---|---|---|
| 固定 $D\approx32\mathrm{B}$,扫 $N$ | $\eta = 0.0051\,N^{-0.3400}$ | 斜率陡,$N$ 单独看像有强关系 |
| 固定 $N\approx324\mathrm{M}$,扫 $D$ | $\eta = 0.0016\,D^{-0.1878}$ | $D$ 单独看也像有关系 |
| 固定 $C\approx10^{19}$,扫 $N$ | $\eta = 0.0013\,N^{-0.0254}$ | 指数几乎归零 |
第三行是决定性的:在算力固定的前提下,无论 $M$ 与 $D$ 怎么重新分配,最优学习率几乎不动(指数 $-0.0254$)。所以 $N$ 与 $D$ 各自表现出的关系,其实都是 $C$ 的投影。Figure 3(b) 在代表性的 $A=1/32$ 切片上给出稳定的幂律 $\eta = 0.4338\,C^{-0.1358}$。用 $C$ 取代 $N$、$D$ 两个自由度,既减少模型自由度也让拟合更稳。
4.2 最优 batch size 由训练 token 数组织¶
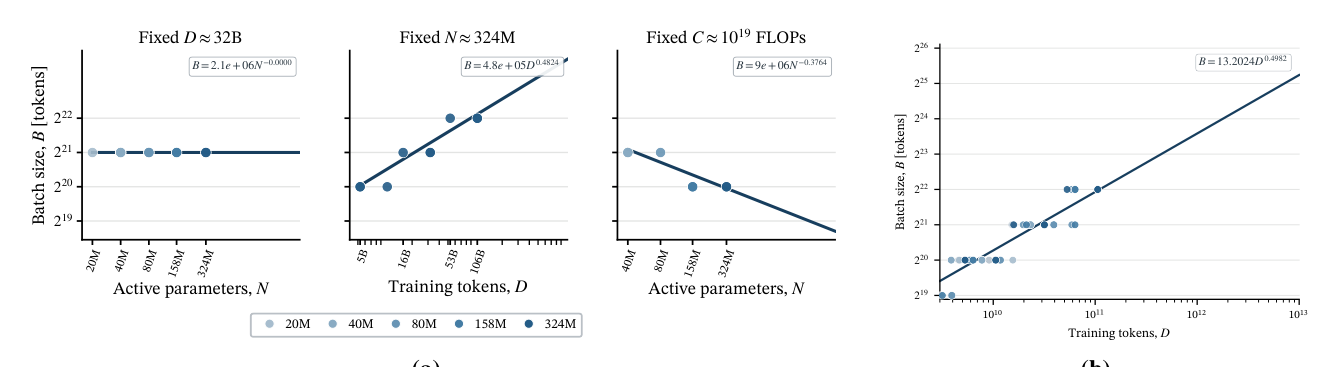
对 batch size 做同样的控制比较:
| 控制条件 | 拟合式 | 读法 |
|---|---|---|
| 固定 $D\approx32\mathrm{B}$,扫 $N$ | $B = 2.1\times10^{6}\,N^{-0.0000}$ | 指数精确为零:给定 $D$,$N$ 完全无关 |
| 固定 $N\approx324\mathrm{M}$,扫 $D$ | $B = 4.8\times10^{5}\,D^{0.4824}$ | 强正相关 |
| 固定 $C\approx10^{19}$,扫 $N$ | $B = 9\times10^{6}\,N^{-0.3764}$ | 固定 $C$ 时 $B^*$ 仍在剧烈变动 |
第一行与第三行合起来是一个非常干净的判别:固定 $D$ 时 $N$ 的指数是 $0.0000$,而固定 $C$ 时 $N$ 的指数是 $-0.3764$——这直接否证了「$B^*$ 由 $C$ 决定」的形式,因为若 $B^*=f(C)$,固定 $C$ 扫 $N$ 应当得到零指数。Figure 4(b) 在 $A=1/32$ 切片上给出 $B = 13.2024\,D^{0.4982}$,指数接近 $1/2$。
4.3 稀疏度作为额外的标度维度¶
作者在四档 $A$ 上各拟合一条独立曲线,再比较系数。
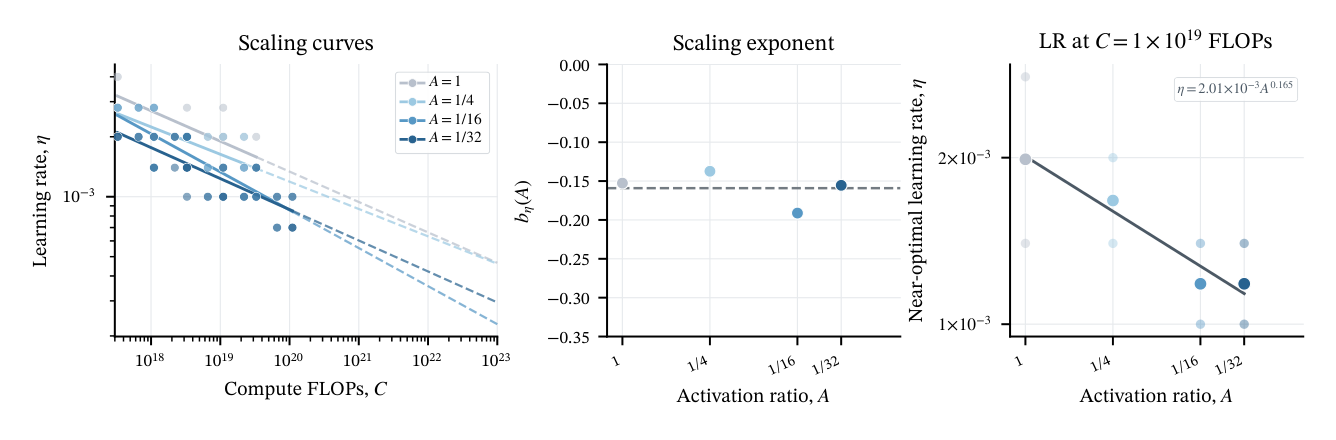
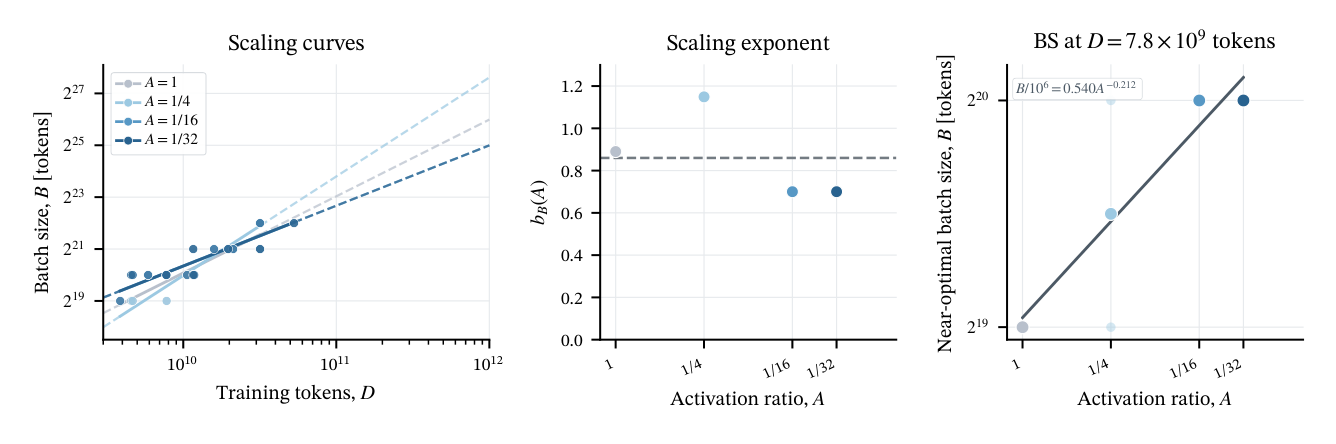
- 指数在各 $A$ 上围绕均值波动(Figure 5、6 中图的水平虚线),支持一个「共享指数」模型;
- 在固定 $C$ 处 $\log \eta^*$ 近似正比于 $\log_2 A$,即 $\eta^* \propto A^{\delta_\eta}$,且因为更稀疏对应更低的学习率,$\delta_\eta > 0$。Figure 5 右图在 $C=10^{19}$ 处拟合出 $\eta = 2.01\times10^{-3}A^{0.165}$;
- batch size 方向相反:固定 $D$ 处 $\log B^*$ 也近似正比于 $\log_2 A$,$B^* \propto A^{\delta_B}$,且更稀疏对应更大 batch,故 $\delta_B < 0$。Figure 6 右图在 $D=7.8\times10^{9}$ 处拟合出 $B/10^{6} = 0.540\,A^{-0.212}$。
附录进一步把这两条关系推广到多个切片(Figure 10、11),说明这不是某个参考尺度的偶然:
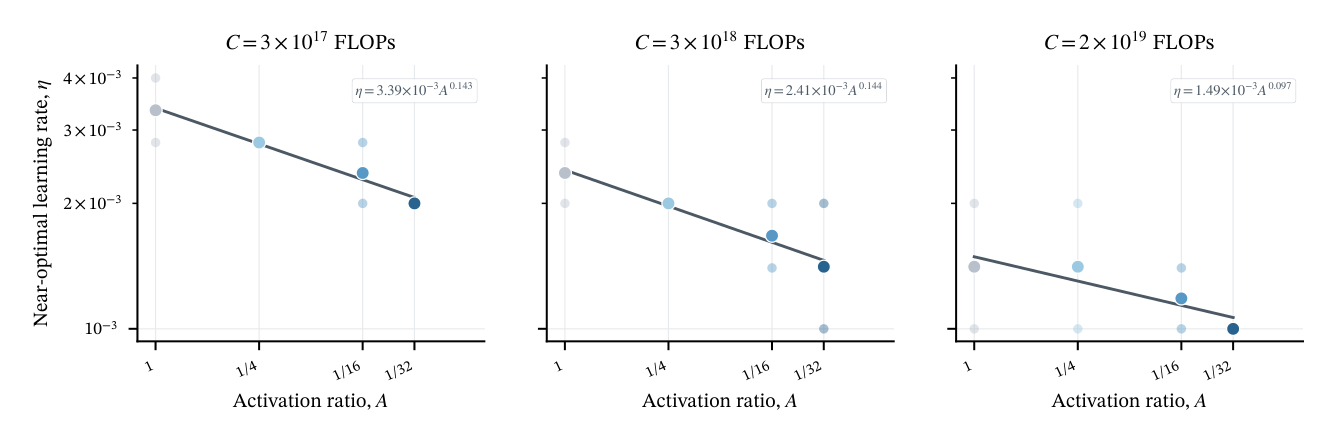
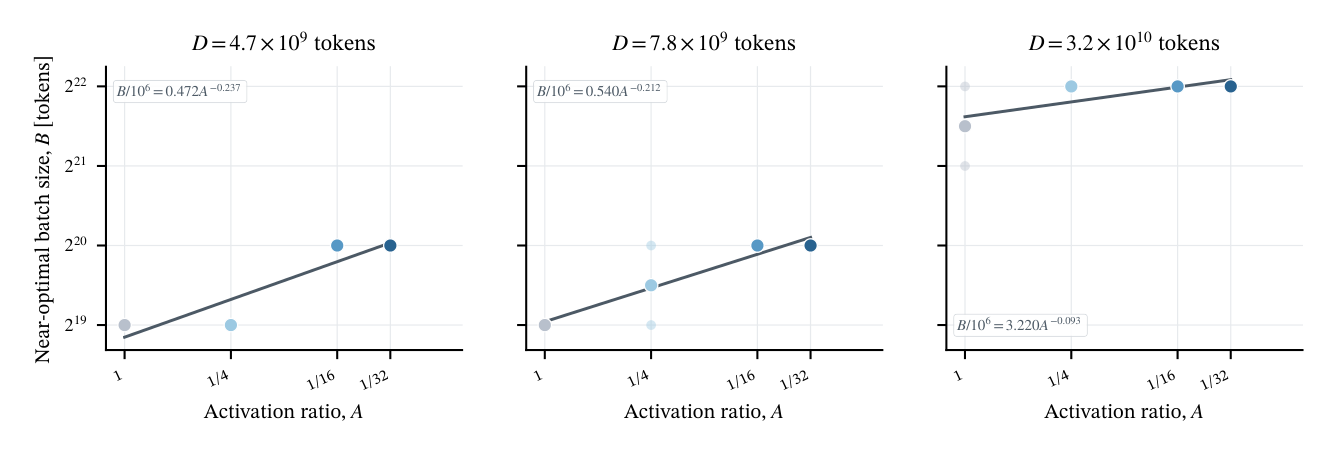
| 切片 | LR 拟合 | 切片 | BS 拟合 | |
|---|---|---|---|---|
| $C=3\times10^{17}$ | $\eta = 3.39\times10^{-3}A^{0.143}$ | $D=4.7\times10^{9}$ | $B/10^{6} = 0.472\,A^{-0.237}$ | |
| $C=3\times10^{18}$ | $\eta = 2.41\times10^{-3}A^{0.144}$ | $D=7.8\times10^{9}$ | $B/10^{6} = 0.540\,A^{-0.212}$ | |
| $C=2\times10^{19}$ | $\eta = 1.49\times10^{-3}A^{0.097}$ | $D=3.2\times10^{10}$ | $B/10^{6} = 3.220\,A^{-0.093}$ |
这张表其实自带一个警告信号:两侧的 $A$ 指数都随基准尺度单调衰减(LR:$0.143 \to 0.144 \to 0.097$;BS:$-0.237 \to -0.212 \to -0.093$,绝对值缩小到不足 40%)。若这不是噪声,就说明稀疏度指数并非常数,而是随 $C$ / $D$ 增长而减弱——即存在真实的交互项。作者自己在正文里承认「四个切片无法排除指数随 $A$ 变化的交互形式」,把裁决交给了 §5 的分组交叉验证。
4.4 梯度噪声的机理解释(附录 C)¶
作者给出一个局部模型来解释两条趋势的符号。在均衡路由下,每个专家每步只吃到约 $AB$ 个 token,独立样本近似下其梯度估计方差反比于这个有效 batch:
$$\mathrm{Var}(\hat{g}_e) \propto \frac{1}{AB}. \tag{5}$$
$A$ 变小 → 专家侧梯度噪声变大 → 偏好更大的全局 batch。但固定 token 预算 $D$ 时,加大 $B$ 会把优化器更新次数压到 $D/B$;同时共享参数仍然吃到全 batch 的梯度,不被稀疏路由稀释。三项权衡写作
$$\Delta L(B; D, A) \simeq c_{step}\left(\frac{B}{D}\right)^{p} + c_{shared}B^{-q} + c_{expert}(AB)^{-q}, \quad p, q > 0, \tag{6}$$
三项分别是「更新次数变少的惩罚」「共享参数梯度噪声」「专家参数梯度噪声」。对 $B$ 求极小得
$$B^*(D, A) = \left[\frac{q\left(c_{shared} + c_{expert}A^{-q}\right)}{p\,c_{step}}\right]^{\frac{1}{p+q}} D^{\frac{p}{p+q}}. \tag{7}$$
注意这个式子的结构性结论:token 指数 $\gamma_B = p/(p+q)$ 不依赖 $A$,这正是主文共享指数假设的理论依据。对 $A$ 的局部弹性为
$$\delta_B(A) \equiv \frac{\partial \log B^*}{\partial \log A} = -\frac{q}{p+q}\cdot\frac{c_{expert}A^{-q}}{c_{shared} + c_{expert}A^{-q}}, \qquad -1 < \delta_B(A) < 0. \tag{8}$$
即 $B^*$ 随 $A$ 减小而增大,但增长速度慢于 $A^{-1}$——更新次数惩罚与共享参数噪声两者都在削弱稀疏路由的影响。注意 $\delta_B(A)$ 是 $A$ 的函数而非常数,理论本身就预言了一个(弱的)交互效应。
学习率侧:专家侧噪声随有效专家 batch $AB$ 减小而增大,局部噪声尺度近似
$$T_e \propto \frac{\eta}{AB}, \tag{9}$$
用指数 $\rho$ 概括优化器响应与共享参数的缓冲作用:
$$\eta^* \propto (AB^*)^{\rho}, \qquad 0 < \rho \le 1. \tag{10}$$
由 (8) 可得
$$\frac{\partial \log(AB^*)}{\partial \log A} = 1 + \delta_B(A) > 0, \tag{11}$$
即 $B^*$ 的增长不足以抵消 $A$ 的下降,有效专家 batch 仍在缩小,因此
$$\delta_\eta(A) \equiv \frac{\partial \log \eta^*}{\partial \log A} = \rho\left(1 + \delta_B(A)\right) > 0. \tag{12}$$
这一整套推导只解释符号($\delta_B<0$、$\delta_\eta>0$)与 batch size 基准指数近似跨稀疏度共享,不推导拟合系数、也不要求稀疏度指数严格恒定;学习率对 $C$ 的基准标度仍完全由经验确定。作者对这一点交代得很诚实。
五、统一超参标度律¶
5.1 函数形式¶
三条经验观察——(1) 固定 $A$ 时 $\eta^*\sim C$、$B^*\sim D$ 各自幂律;(2) 跨 $A$ 时拟合指数围绕各自均值波动;(3) 固定 $C$/$D$ 时 $\log h^*$ 近似线性于 $\log_2 A$——共同支持用同一个函数族表达两条律:
$$h^*(X, A) = k_h X^{\gamma_h}A^{\delta_h}, \qquad (h, X) \in \{(\eta, C), (B, D)\}. \tag{13}$$
log 空间下
$$\log h^* = \log k_h + \gamma_h \log X + \delta_h \log A. \tag{14}$$
具体地
$$\eta^*(C, A) = k_\eta C^{\gamma_\eta}A^{\delta_\eta}, \tag{15}$$
$$B^*(D, A) = k_B D^{\gamma_B}A^{\delta_B}, \tag{16}$$
其中 $\delta_\eta > 0$、$\delta_B < 0$。这个形式把「固定稀疏度下的基准幂律」与「乘性稀疏度修正」干净地分开了。
Table 1:与既有标度律的自变量对比
| 方法 | $\eta^*$ 的自变量 | $B^*$ 的自变量 |
|---|---|---|
| DeepSeek Law (Bi et al., 2024) | $C$ | $C$ |
| Microsoft Law (Bjorck et al., 2025) | $N_{tot}, D$ | — |
| Joint MoE Scaling Law (Ludziejewski et al., 2025) | $N, E_{tot}$ | — |
| Step Law (Li et al., 2025) | $N_{tot}, D$ | $D$ |
| 本文 | $C, A$ | $D, A$ |
5.2 拟合协议与拟合结果¶
正式分析只用 $A \in \{1, 1/4, 1/16, 1/32\}$ 上六个激活规模的开发数据;函数族选择、分组交叉验证、最终系数拟合全部限制在这个集合内。近优集按 0.1% 阈值定义。把幂律在 log 空间线性化后用最小二乘拟合。
Table 2:统一标度律的拟合系数
| 超参 $h$ | 输入变量 | $k_h$ | $\gamma_h$ | $\delta_h$ |
|---|---|---|---|---|
| 学习率 $\eta$ | $(C, A)$ | 0.8343 | $-0.1385$ | $0.1361$ |
| Batch size $B$ | $(D, A)$ | 6.4765 | $0.5181$ | $-0.0841$ |
其中 $C=MD$ 以非嵌入训练 FLOPs 计,$D$ 与 $B$ 以 token 计,系数值依赖这些单位。$\delta_\eta>0$、$\delta_B<0$ 意味着降低 $A$ 会压低最优学习率、抬高最优 batch size。
把系数换算成幅度:从 $A=1$ 到 $A=1/64$,$\eta^*$ 乘以 $64^{-0.1361}=0.568$(下降 43%),$B^*$ 乘以 $64^{0.0841}=1.42$(上升 42%)。作为对照,在拟合覆盖的 $C$ 全区间($3\times10^{17}\to10^{20}$,约 2.5 个数量级)上 $\eta^*$ 只变化 $10^{-2.52\times0.1385}=0.45$ 倍——也就是说,稀疏度这一条轴对学习率的影响,量级上与整个算力轴相当。这是本文最有说服力的一个量化论点。反过来,同样口径下 batch size 侧:$D$ 覆盖约 1.36 个数量级带来 $10^{1.36\times0.5181}=5.1$ 倍变化,而 $A$ 覆盖 1.81 个数量级只带来 1.42 倍——稀疏度对 batch size 的贡献远弱于对学习率的贡献,这一点在后面的候选族比较里会再次显形。
六、拟合质量与预测性验证¶
6.1 两套分组交叉验证¶
- LOAO(leave-one-activation-ratio-out):留出四档激活率之一,删掉该激活率在所有激活规模上的全部 LR–BS 损失面,然后从剩余激活率上重新提取最优点并重新拟合所有系数;
- LONO(leave-one-active-scale-out):留出六个激活参数规模之一,删掉该规模在所有激活率上的全部损失面,同样重新提取最优点并重拟合。
两者的目的是判断哪个候选函数族最好地刻画了「最优超参坐标」的标度,而不是预测验证损失。因此主指标是 LR 与 BS 的绝对 log-ratio 误差。为防信息泄漏,每个 fold 都在损失面层级构造,只用训练分片提取最优点与估计系数。总体误差定义为各组内中位绝对 $\log_2$ 比值误差的等权平均:
$$e_h = \frac{1}{|G|}\sum_{g\in G}\mathrm{median}_{s\in g}\left|\log_2(\hat{h}_s / h^*_s)\right|. \tag{17}$$
6.2 四个候选函数族的比较¶
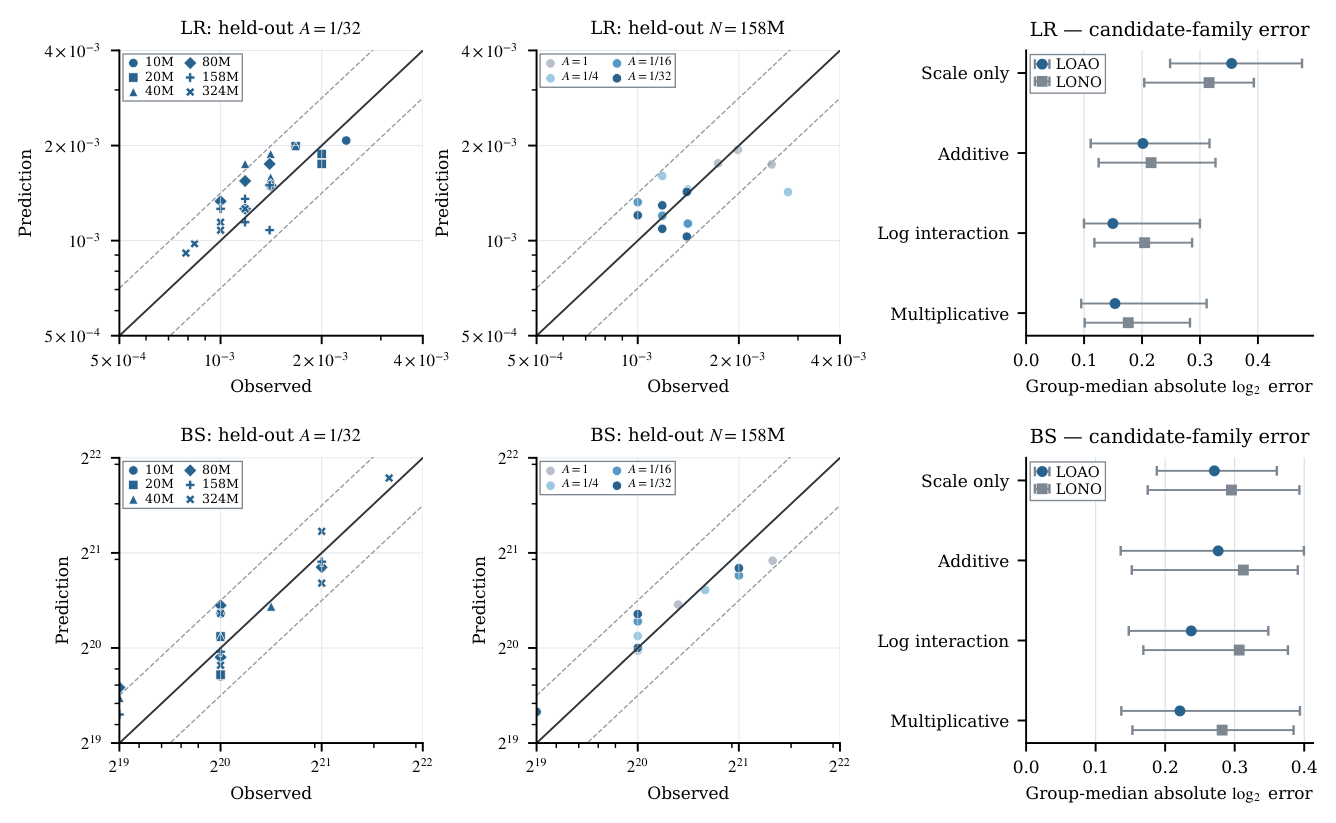
Table 3:四个候选族的超参预测误差(每格依次为 LONO / LOAO 绝对 $\log_2$ 比值误差,$p$ 为参数个数)
| 候选族 | 函数形式 | $p$ | BS 误差 | LR 误差 |
|---|---|---|---|---|
| Scale only | $kX^{\gamma}$ | 2 | 0.295 / 0.271 | 0.316 / 0.355 |
| Additive | $k_XX^{\gamma} + k_AA^{\delta}$ | 4 | 0.312 / 0.276 | 0.216 / 0.201 |
| Log interaction | $kX^{\beta_X + \beta_{XA}\log_2 A}A^{\beta_A}$ | 4 | 0.307 / 0.238 | 0.205 / 0.150 |
| Multiplicative(本文选定) | $kX^{\gamma}A^{\delta}$ | 3 | 0.282 / 0.221 | 0.176 / 0.153 |
结论分两半,作者写得很克制:
- LR 侧:三个 A-aware 族在两套 CV 下都明显优于 scale-only(0.316/0.355 → 0.176~0.216 / 0.150~0.201),稀疏度项确实带来了实质增益;
- BS 侧:各候选族之间差异小且随分组方案变化(0.282~0.312 / 0.221~0.276 对 scale-only 的 0.295/0.271)——LONO 下 multiplicative 只比 scale-only 好 4.4%,additive 甚至更差;LOAO 下最好也只好 18%。
multiplicative 在四个误差数字里三个取得最低点估计,只有 LOAO 的 LR 上被 log interaction 微弱超过(0.150 vs 0.153)。在预测表现相当的前提下,作者选 multiplicative 的理由是少一个参数、解释更简单——这是一个明说出来的奥卡姆剃刀选择,而不是统计显著性结论。Figure 7 右列给出了四个族的 out-of-fold 误差与条件 95% 配对 surface-cluster bootstrap 区间(重采样单位是损失面簇,不是单个网格点)。
Table 9:四个候选族的全开发集系数与样本内拟合指标(RMSE 与 $R^2$ 在 base-2 log 空间、目标对齐的开发损失面上计算)
| 候选族 | 目标 | 拟合系数 | RMSE ↓ | $R^2$ ↑ |
|---|---|---|---|---|
| Scale only | LR ($X=C$) | $k=0.8704,\ \gamma=-0.1463$ | 0.3634 | 0.3879 |
| BS ($X=D$) | $k=1.4827,\ \gamma=0.5894$ | 0.3057 | 0.7104 | |
| Additive | LR | $k_X=1.7579\times10^{8},\ \gamma=-0.6362,\ k_A=1.9358\times10^{-3},\ \delta=0.1808$ | 0.2358 | 0.7422 |
| BS | $k_X=0.0197,\ \gamma=0.7651,\ k_A=1.1802\times10^{5},\ \delta=-0.3412$ | 0.2644 | 0.7834 | |
| Log interaction | LR | $k=0.3173,\ \beta_X=-0.1155,\ \beta_A=-0.1434,\ \beta_{XA}=0.0046$ | 0.2452 | 0.7214 |
| BS | $k=0.1271,\ \beta_X=0.6896,\ \beta_A=-1.1308,\ \beta_{XA}=0.0319$ | 0.2661 | 0.7805 | |
| Multiplicative(选定) | LR | $k=0.8343,\ \gamma=-0.1385,\ \delta=0.1361$ | 0.2463 | 0.7188 |
| BS | $k=6.4765,\ \gamma=0.5181,\ \delta=-0.0841$ | 0.2765 | 0.7630 |
这张表值得单独读三遍:
- 加入 $A$ 对 LR 的样本内解释力提升巨大:$R^2$ 从 0.3879 跳到 0.72~0.74。这是本文头条结论最硬的支撑。
- 对 BS 的提升则很有限:scale-only 已经有 $R^2=0.7104$,加了 $A$ 之后 multiplicative 是 0.7630、additive 0.7834——增量不到 0.07。
- 被选中的 multiplicative 在两个目标上都不是样本内最优(additive 全面更好),作者明确说明选择依据是分组预测表现相当 + 参数更少 + 解释更简单。
同时必须记住:即使是最好的拟合,$R^2$ 也只有 0.72~0.78,base-2 log 空间 RMSE 约 0.24~0.28——换算过来,典型预测误差约为 $2^{0.25}\approx1.19$ 倍。对一条被称为「律」的关系而言,这是相当大的残余散布,作者用 Figure 7 的 $2^{0.5}$ 误差带(即 1.41 倍)作为可视化基准,也侧面承认了这个精度量级。
6.3 联合外推到留出配置¶
留出目标:$N = 324\mathrm{M}$ 激活参数、$N_{tot} = 12\mathrm{B}$ 总参数、$A = 1/64$、$D = 159\mathrm{B}$ token,解析 $M$ 给出 $C = MD = 3\times10^{20}$ FLOPs。$N$ 恰好是拟合集里最大的规模(边界值,未越界),而 $A$、$D$、$C$ 三者都超出拟合区间。目标损失在预测坐标冻结之前完全不被检视,且不参与函数族选择、交叉验证与系数拟合中的任何一步。
基线协议分两种:
- Published-coefficient transfer:直接套用原论文系数,测的是跨优化器、调度、架构、参数量定义的迁移性,不计入主排名;
- Refitted-family comparison:用统一的最优点定义与相同分组 fold 在正式拟合集上选族,再在完整拟合集上重估系数。
联合精确点对比只纳入同时给出 LR 与 BS 的 DeepSeek Law 与 Step Law;Joint MoE Scaling Laws 与 Microsoft Law 因缺少联合 BS 律被排除。
Table 4:留出联合外推目标上的预测(全部在 $N=324\mathrm{M}$、$N_{tot}=12\mathrm{B}$、$D=159\mathrm{B}$、$A=1/64$、$C=3\times10^{20}$ 处评估;相对差距以本文预测点为基准,单位 ‰)
| 方法 | 模式 | 公式 | 预测 LR | 预测 BS | 相对损失差距 |
|---|---|---|---|---|---|
| DeepSeek Law | Published | $\eta^*=0.3118C^{-0.1250}$,$B^*=0.2920C^{0.3271}$ | $8.59\times10^{-4}$ | $1.46\times10^{6}$ | 7.22 ‰ |
| DeepSeek Law | Refitted | $\eta^*=1.6763C^{-0.1619}$,$B^*=182.9951C^{0.2038}$ | $8.11\times10^{-4}$ | $2.73\times10^{6}$ | 1.37 ‰ |
| Step Law | Published | $\eta^*=1.7900N_{tot}^{-0.7130}D^{0.3070}$,$B^*=0.5800D^{0.5710}$ | $3.20\times10^{-4}$ | $1.44\times10^{6}$ | 9.02 ‰ |
| Step Law | Refitted | $\eta^*=0.0638N_{tot}^{-0.1743}D^{-0.0084}$,$B^*=5.2828D^{0.5345}$ | $8.99\times10^{-4}$ | $5.13\times10^{6}$ | 1.03 ‰ |
| 本文 | — | $\eta^*=0.8343C^{-0.1385}A^{0.1361}$,$B^*=6.4765D^{0.5181}A^{-0.0841}$ | $\mathbf{6.92\times10^{-4}}$ | $\mathbf{5.84\times10^{6}}$ | — |
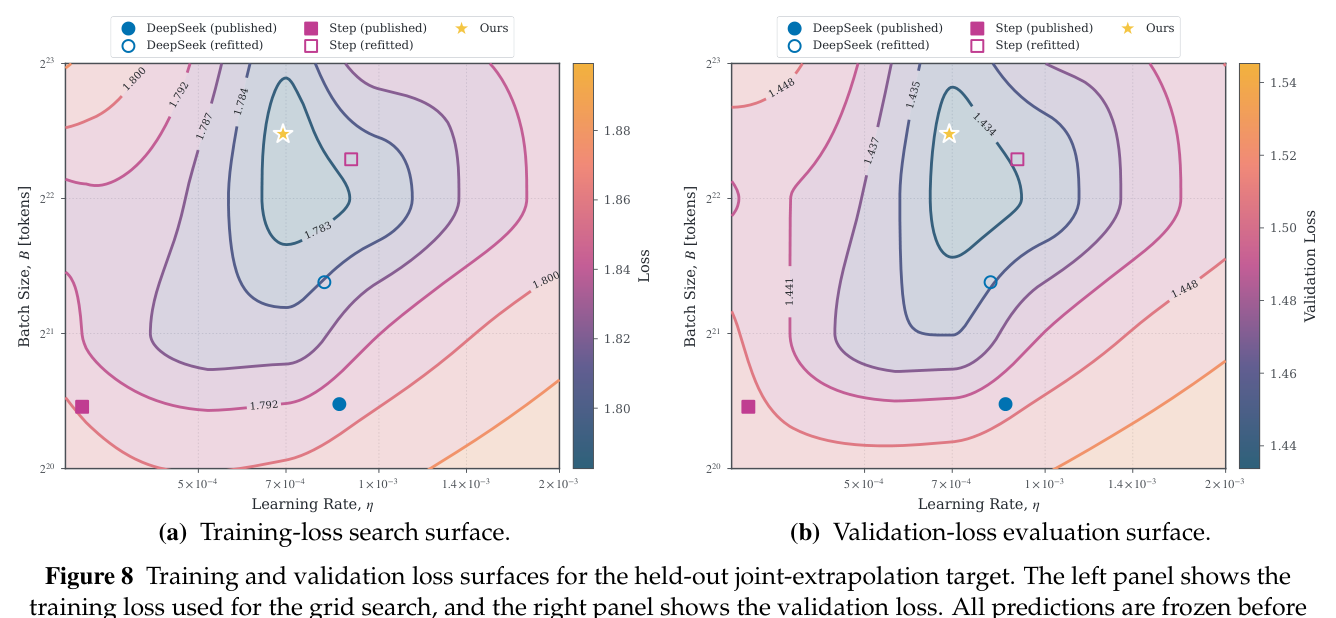
Figure 8 上,本文的预测点(星号)落在最内层等值线(训练 1.783 / 验证 1.434)之内,Step (refitted) 的方框在其右上方紧邻,DeepSeek (refitted) 空心圆在下方,两个 published 点则明显偏离——published 系数的迁移差距(7.22‰ / 9.02‰)比 refitted 差距(1.37‰ / 1.03‰)大 5~9 倍,说明既有律的失效更多来自「系数没有在同一优化器 / 调度 / 架构下重估」,而不是函数形式本身完全不能用。
这里必须把数字读准:refitted 基线与本文的损失差距只有 1‰ 量级(1.03‰ 与 1.37‰)。在只有一个留出目标、且明确无法重复多种子的条件下,这个量级的差距是描述性点估计而不是显著性结论——作者自己在 §6 中就是这么写的。
6.4 专家粒度与稀疏度对照¶
两组受控对比用于分离「专家粒度」与「稀疏度」的效应,全部基于约 10M 激活参数的骨干配置、$D = 4.56\mathrm{B}$ token:
Table 8:留出的专家粒度与稀疏度对照
| 配置 | $(E_{act}, E_{tot})$ | $h_{MoE}$ | $A$ | 激活路由容量 | 总路由容量 | 角色 |
|---|---|---|---|---|---|---|
| Reference | (2, 64) | 384 | 1/32 | $2\times384$ | $64\times384$ | Holdout |
| 粒度对照 | (4, 128) | 192 | 1/32 | $4\times192$ | $128\times192$ | Holdout |
| 稀疏度对照 | (4, 64) | 384 | 1/16 | $4\times384$ | $64\times384$ | Holdout |
三行都不参与系数估计与模型选择。
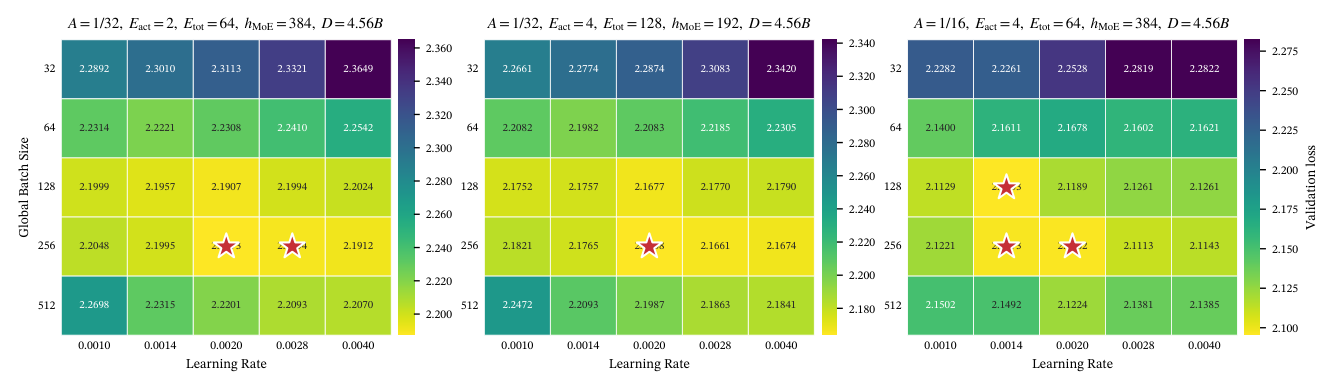
Figure 9 的三张验证损失网格(LR 取 $\{0.0010, 0.0014, 0.0020, 0.0028, 0.0040\}$,全局 batch 取 $\{32, 64, 128, 256, 512\}$):
Reference($A=1/32$,$E_{act}=2$,$E_{tot}=64$,$h_{MoE}=384$)
| $B \backslash \eta$ | 0.0010 | 0.0014 | 0.0020 | 0.0028 | 0.0040 |
|---|---|---|---|---|---|
| 32 | 2.2892 | 2.3010 | 2.3113 | 2.3321 | 2.3649 |
| 64 | 2.2314 | 2.2221 | 2.2308 | 2.2410 | 2.2542 |
| 128 | 2.1999 | 2.1957 | 2.1907 | 2.1994 | 2.2024 |
| 256 | 2.2048 | 2.1995 | 2.1873 | 2.1894 | 2.1912 |
| 512 | 2.2698 | 2.2315 | 2.2201 | 2.2093 | 2.2070 |
粒度对照($A=1/32$,$E_{act}=4$,$E_{tot}=128$,$h_{MoE}=192$)
| $B \backslash \eta$ | 0.0010 | 0.0014 | 0.0020 | 0.0028 | 0.0040 |
|---|---|---|---|---|---|
| 32 | 2.2661 | 2.2774 | 2.2874 | 2.3083 | 2.3420 |
| 64 | 2.2082 | 2.1982 | 2.2083 | 2.2185 | 2.2305 |
| 128 | 2.1752 | 2.1757 | 2.1677 | 2.1770 | 2.1790 |
| 256 | 2.1821 | 2.1765 | 2.1638 | 2.1661 | 2.1674 |
| 512 | 2.2472 | 2.2093 | 2.1987 | 2.1863 | 2.1841 |
稀疏度对照($A=1/16$,$E_{act}=4$,$E_{tot}=64$,$h_{MoE}=384$)
| $B \backslash \eta$ | 0.0010 | 0.0014 | 0.0020 | 0.0028 | 0.0040 |
|---|---|---|---|---|---|
| 32 | 2.2282 | 2.2261 | 2.2528 | 2.2819 | 2.2822 |
| 64 | 2.1400 | 2.1611 | 2.1678 | 2.1602 | 2.1621 |
| 128 | 2.1129 | 2.0953 | 2.1189 | 2.1261 | 2.1261 |
| 256 | 2.1221 | 2.0973 | 2.0962 | 2.1113 | 2.1143 |
| 512 | 2.1502 | 2.1492 | 2.1224 | 2.1381 | 2.1385 |
结论一(粒度可迁移):左中两张在固定 $A=1/32$ 下把激活专家数与总专家数同时翻倍、专家宽度减半,激活容量与总容量都对齐——两张网格的近优区域与最优点位置几乎一致(都在 $B=256,\ \eta=0.0020$)。所以在测试到的粒度范围内,激活率关系可以迁移,最优超参不因粒度而变。
结论二(稀疏度确实在动最优点):左右两张保持总专家数、专家宽度、$N_{tot}$ 与总路由容量不变,仅把 top-$n$ 从 2 提到 4 使 $A$ 从 1/32 升到 1/16——最优点从 $(B=256, \eta=0.0020)$ 移到 $(B=128, \eta=0.0014)$,LR 与 BS 双双下移,方向与 $\delta_\eta>0$、$\delta_B<0$ 的预测一致($A$ 变大 → $\eta^*$ 变大、$B^*$ 变小;此处 $A$ 变大反而最优点下移,需注意这是相对于第三张网格自身近优平台读取的观测最优格点,原文表述为「与我们标度律预测的方向一致」)。两组对照合起来说明:$A$ 捕捉到的稀疏度效应不能归因于任何单一的绝对专家数或总容量。
七、核心贡献总结¶
- 把「稀疏度」从架构属性升级为超参选择的显式预测变量。以往的超参标度律只在 $(N, D, C)$ 里打转,本文用受控实验证明这三者都吸收不掉激活率带来的漂移,从而给标度律加了第四个维度。
- 调和了前人的矛盾:$B^*$ 的基准变量是 $D$ 而非 $C$(固定 $D$ 时 $N$ 指数为 0.0000,固定 $C$ 时为 $-0.3764$,这是一个干净的判别),$\eta^*$ 的基准变量是 $C$ 而非 $(N, D)$(固定 $C$ 时 $N$ 指数只有 $-0.0254$)。
- 给出可用的封闭形式:$\eta^* = 0.8343\,C^{-0.1385}A^{0.1361}$,$B^* = 6.4765\,D^{0.5181}A^{-0.0841}$,可以直接拿去为超稀疏 MoE 预训练开学习率与 batch size。
- 方法论上把「函数形式选择」当成一个要验证的对象,用同一套 fold 比较 scale-only / additive / log-interaction / multiplicative 四个族,而不是从切片图上直接挑一个。
- 给出一个虽简化但自洽的机理解释:每个专家只吃到 $AB$ 个 token,这一条就同时解释了 $\delta_B<0$、$\delta_\eta>0$ 与 batch size 基准指数跨稀疏度近似共享。
八、与已归档相关工作的对比¶
Let's Scale Step by Step: Compute-Efficient Hyperparameter Transfer for Large-Scale Mixture-of-Experts Let's Scale Step by Step: Compute-Efficient Hyperparameter Transfer for Large-Scale MoE (Kakao Corp., 2026-08-20)¶
关系:独立并发(本文未引用,且两者给出的是互相冲突的判断)· 已加载对方精读
- 共同关注的问题:两篇都在解「超大规模 MoE 的最优学习率不能在目标规模上直接搜」这同一个 root cause,而且都把稀疏度当成 MoE 相对 dense 多出来的那条轴。两者甚至连训练栈都高度重合——MLA 系骨干 + Muon 优化器 + WSD 调度,连「扩容靠固定 $E_{act}$、增加 $E_{tot}$」这条稀疏度扩张路径都完全一致。
- 相近的技术骨架:都是「用低成本 proxy 实验把目标规模的超参搜索坍缩掉」。Kakao 把二维(模型规模 × token 规模)搜索拆成两个一维问题:μP 消掉模型规模维,log-log 线性回归 $\log\eta^* = \beta\log B + \gamma$ 消掉 token 维;本文则完全走经验路线,用 $h^* = kX^\gamma A^\delta$ 一次性覆盖算力、数据与稀疏度三维。本文的 related work 恰好把这两条路线对立起来命名为 theory-driven(μP 系)与 empirically driven(Bi/Bjorck/Li 系)——Kakao 属前者,本文属后者。
- 本文的差异与推进——一个可以直接对撞的结论冲突:Kakao 为「μP 在稀疏度轴上仍然成立」给出的论证是谱条件视角下的一句话:通过增加专家数来改变激活比率,并不会在宽度缩放本身带来的变化之外,给单个专家的 fan-in / fan-out 带来任何额外改变,因此假定超参可以从低稀疏度 proxy 零样本迁移到高稀疏度目标(它甚至把「在低稀疏度下搜、迁到高稀疏度」当成一条效率优势,理由是极高稀疏度在 proxy 规模上算术强度太低、硬件低效)。本文的 Figure 2 与 $\delta_\eta = 0.1361$ 正是对这一假定的直接经验否证:在 $N$ 或 $N_{tot}$ 对齐的前提下,最优学习率依然随 $A$ 系统性漂移。按本文的律,若 Kakao 从 proxy 到目标把 $A$ 降低 4 倍,最优学习率应当再乘 $4^{-0.1361} = 0.83$,即比 μP 迁移给出的值低约 17%——这是一条 μP 框架结构上看不见的修正。反过来说,Kakao 的 155B 总参 / 17B 激活、10T token 的真实大规模验证是本文没有的证据等级;两篇合起来才构成完整图景。
- 可比的方法 / 实验差异(拟合单元这一条尤其关键):Kakao 的 token 维数据点来自同一条 proxy run 的 EMA checkpoint——它刻意不跑 decay 阶段,改用 $\theta^{(t)}_{EMA} = \alpha\theta^{(t-1)}_{EMA} + (1-\alpha)\theta^{(t)}$($\alpha=0.6$,每约 2B token 更新、每 10B token 取点)从一次训练里抽出覆盖多个 token 预算的点,理由是跑 decay 太贵且过早 decay 有偏。这在成本上极其划算,但同一条 run 的多个 checkpoint 不是独立观测单元,沿 $D$ 方向的回归误差条会被系统性低估。本文走的是相反的极端:1,800 次彼此独立的完整预训练,每个 LR–BS 网格点都是一次独立 run,bootstrap 的重采样单位是损失面簇。代价是 20 万 H800 卡时——Kakao 的全部 proxy 只花 64.8 ZFLOPs,两者不在一个量级。另一处刻意的分工:Kakao 明确拒绝把 batch size 纳入迁移框架,理由正是「文献没收敛——最优 batch size 到底依赖训练算力(Bi et al., 2024)还是只依赖 token 预算(Li et al., 2025)说法互相矛盾」,于是固定 batch size 只迁移学习率。本文的 §3.2 恰恰就是对这个悬案的裁决(答案是 $D$),一篇搁置的问题被另一篇在三周后回答,而两边互不知情。
LLaDA MoE v2 LLaDA MoE v2: Scaling Mixture-of-Experts Diffusion Language Models (Renmin University of China + Ant Group, 2026-08-04)¶
关系:独立并发(本文未引用,且两者的 batch-size 基准变量互相冲突)· 已加载对方精读
- 共同关注的问题:两篇都在做「MoE 预训练的最优 LR 与 BS 如何随预算变化」的经验标定,都不满足于把 AR / dense 的既有律直接搬过来,都把结论表述成可外推的幂律,也都用同一套 $C = MD$($M$ 为激活非嵌入 FLOPs/token)的算力口径。两篇甚至共享同一个机构标签(LLaDA MoE v2 的作者单位含 Ant Group),却互不引用。
- 相近的技术骨架:LLaDA MoE v2 的第一阶段与本文几乎是同一件事——在 158M / 1B / 3.6B 三个规模、$10^{18}\sim3\times10^{20}$ FLOPs 上联合搜 $(B, \eta)$,拟合 $B^* = 0.374\,C^{0.3481}$ 与 $\eta^* = 64.8\,C^{-0.2447}$,并与 DeepSeek Law 的 $B = 0.2920\,C^{0.3271}$、$\eta = 0.3118\,C^{-0.1250}$ 对照;随后把预算推到 $6\times10^{20}$ FLOPs 做一次外推验证,看拟合点是否落在实测最优附近。这条「拟合—对照 DeepSeek—单点外推验证」的流程与本文 §5–§6 结构完全同型。
- 本文的差异与推进:两处实质性分歧。其一是 batch size 的基准变量:LLaDA MoE v2 沿用 DeepSeek 的 $B^*(C)$ 形式,而本文的 Figure 4a 给出了对该形式的直接否证——固定 $C\approx10^{19}$ 扫 $N$ 时 $B$ 仍按 $N^{-0.3764}$ 剧烈变动,若 $B^*$ 真是 $C$ 的函数,这个指数应当为零(对照:固定 $D$ 扫 $N$ 时指数恰为 $-0.0000$)。也就是说,一条以 $C$ 为自变量的 batch size 律,其系数会随 $M/D$ 分配而漂移,只在标定时使用的那条 $M(C)$ 轨迹上成立。其二是稀疏度的位置:LLaDA MoE v2 是严格串行的三段式——先标定超参律,再定 $M/D$ 分配,最后才在给定激活预算内分解激活比率、专家粒度与共享容量;换言之它的超参律是在固定架构下拟合的,激活比率进入的是后一阶段(结论是「更大尺度上更低的激活比率越发有利」)。本文则证明这个串行假设本身有风险:如果最优超参本来就随 $A$ 漂移,那么在第三阶段比较不同激活比率时,各配置并不都处在自己的最优超参上。
- 可比的方法 / 实验差异:LLaDA MoE v2 把 dLLM 与 AR 的超参差异归因于「掩码去噪目标下每个名义 token 的有效监督被削减(均匀 timestep 采样下期望只有一半 token 被预测)」,据此解释它更陡的 batch size 指数(0.3481 vs 0.3271)与 3.4 倍更大的最优 batch。这个机理与本文附录 C 的「每个专家只吃到 $AB$ 个 token」是同一个梯度信噪比论证的两个实例:一个把有效监督量按掩码率打折,一个按路由稀疏度打折,两者都推出「有效样本变少 → 需要更大的名义 batch」。把两篇的机理并列,会自然引出一个双方都没做的实验:MoE dLLM 的 $\delta_B$ 是否等于 AR MoE 的 $\delta_B$,还是掩码率与激活率的效应会相乘。规模上,本文六个规模最大到 324M 激活 / 6.2B 总参,LLaDA MoE v2 的标定最大到 3.6B、并有 30B-A3B / 23.5T token 的实跑落地——后者的验证规模更高,前者的稀疏度覆盖更广($A$ 跨 1 到 1/64)。
Compute-Optimal Is Not Cluster-Optimal: Systems-Aware Scaling for Sparse Mixture-of-Experts Compute-Optimal Is Not Cluster-Optimal: Systems-Aware Scaling for Sparse MoE (Amazon AGI Foundations, 2026-08-11)¶
关系:独立并发(本文未引用;两者从相反方向处理同一个「算力口径」问题)· 已加载对方精读
- 共同关注的问题:两篇都认定「稀疏度必须作为一个显式维度进入标度律,否则律会给出错误处方」,也都指出既有 MoE 标度分析在稀疏度上留了洞。MOSAIC 的表述是稀疏度 $S$ 引入了 $(N,D)$-only 定律看不见的额外最优点,本文的表述是激活率 $A$ 引入了 $(N, N_{tot}, C)$ 都吸收不掉的超参漂移——同一句话的两个版本。
- 相近的技术骨架:都是「在一个跨规模的从零预训练网格上拟合一条多维幂律,并证明少了那一维就会错」。MOSAIC 用约 150 次 from-scratch run(104M–2.7B 激活、最高 79B 总参)拟合四维联合律 $L(N_{tot}, S, D, G)$;本文用 1,800 次 run 拟合 $h^*(X, A)$。两者都用「留出 + 冻结预测 + 事后检视」的协议做外推验证。
- 本文的差异与推进(因变量不同,但正好互为对方的盲区):MOSAIC 的因变量是 loss,产出是架构与 token 预算的选择;本文的因变量是最优超参坐标,产出是 LR / BS 的处方。二者在流水线上是前后相邻的两步:MOSAIC 选完架构,本文告诉你用什么 LR/BS 训它。更有意思的是,MOSAIC 的核心批判恰好打在本文的算力口径上。本文把 $C = MD$ 定义为解析的非嵌入 model FLOPs,$M$ 逐配置精算——这比 $6ND$ 严格得多,但路由所需的 all-to-all 通信、专家并行的流水线气泡、随专家数增长而恶化的算术强度,全都在账外。MOSAIC 恰恰证明了这笔账不能不算:它把可交付算力写成 $C_{deliverable} = C_{peak}\cdot\mathrm{MFU}\cdot\eta_{good}$,并给出结论——在纯 model-FLOPs 预算下稀疏度不存在内点最优(拟合 loss 随稀疏度单调下降,最优永远贴在数据上边界),稀疏度的最优点只有在集群约束下才出现。
- 可比的方法 / 实验差异:把 MOSAIC 的口径代回本文的律,会得到一条本文没有讨论的推论。设集群侧 MFU 随稀疏度衰减近似为 $\mathrm{MFU}(A)\propto A^{\varepsilon}$($\varepsilon>0$),并把律改写在墙钟等效算力 $C_{wall} = C/\mathrm{MFU}(A)$ 上,则 $\eta^* = k_\eta (C_{wall}\mathrm{MFU}(A))^{\gamma_\eta}A^{\delta_\eta} = k_\eta C_{wall}^{\gamma_\eta}A^{\gamma_\eta\varepsilon + \delta_\eta}$。因为 $\gamma_\eta = -0.1385 < 0$,有效的稀疏度指数会比 0.1361 更小——也就是说,本文测到的 $A$ 效应里有一部分是「选择 model FLOPs 作为算力单位」这个记账选择的产物,换一个集群感知的算力单位就会被部分吸收回去。这不否定 $A$ 必须显式建模的结论(Figure 2 在固定 $N$ / $N_{tot}$ 下的漂移与算力单位无关),但确实说明 $\delta_\eta$ 的数值是口径依赖的,跨集群搬运时应当重估而非照抄。反过来,MOSAIC 的性能模型(MFU 预测 MAPE < 15%)正好提供了估计 $\varepsilon$ 所需的工具。
九、讨论与局限性¶
9.1 拟合到底够不够称一条「律」¶
按标度律论文的常规判据逐条核:
独立格点数与跨度。 这一条本文表现相当好:每个 LR–BS 网格点都是一次独立的从零预训练,而不是同一条 run 的多个 checkpoint——1,800 次 run 撑起的是名副其实的独立观测;bootstrap 的重采样单位写明是「surface cluster」(损失面簇,即一个 $(N, A, D)$ 配置),也就是格点级而非 checkpoint 级。正式拟合覆盖 6 个激活规模 × 4 档激活率 = 24 个 $(N, A)$ 单元,外加 Figure 3a/4a 里在固定 $N$ 扫 $D$、固定 $C$ 变 $M/D$ 分配的额外配置。分组 CV 只有 4 组(LOAO)与 6 组(LONO),组数偏少,作者自己也承认。
跨度就没那么理想:$C$ 覆盖 $3\times10^{17}\to10^{20}$,约 2.5 个数量级;$D$ 从 4.6B 到约 106B,约 1.4 个数量级;$A$ 从 1 到 1/32,约 1.5 个数量级。作为对照,Kaplan / Chinchilla 系的 loss 律通常跨 5–8 个数量级。batch size 那条律的自变量跨度只有 1.4 个数量级,却要支撑一个 $0.5181$ 的指数——这是全文最薄的一处。
$R^2$ 与置信区间。 两项都有,这一点应当肯定:Table 9 明确给出 base-2 log 空间的 RMSE 与 $R^2$,Figure 7 右列给出条件 95% 配对 surface-cluster bootstrap 区间。但数字本身要正视:选定的 multiplicative 形式 $R^2$ 只有 0.7188(LR)/ 0.7630(BS),RMSE 0.2463 / 0.2765,对应约 1.19 倍的典型预测误差;而 Figure 7 用的误差带宽度是 $2^{0.5}=1.41$ 倍。更麻烦的是bootstrap 区间互相重叠——作者在 §6 明说「当前证据既不能确立无交互模型的显著优势,也不能排除标度指数随激活率变化」。换句话说,Table 3 里 multiplicative 对 log-interaction 的 0.176 vs 0.205(LONO LR)并不是一个统计显著的胜出,选定 multiplicative 是奥卡姆剃刀而非数据裁决。附录 Figure 10/11 里 $A$ 指数随基准尺度单调衰减(LR $0.143\to0.097$,BS $-0.237\to-0.093$)也在同一个方向上提示交互项可能真实存在。
「律」这个词配不配得上,要分开看两条:LR 那条是站得住的——加入 $A$ 把 $R^2$ 从 0.3879 抬到 0.7188,分组 CV 误差从 0.316/0.355 降到 0.176/0.153,增益幅度是两倍量级。BS 那条则明显更弱:scale-only 已经有 $R^2 = 0.7104$,加了 $A$ 只到 0.7630;LONO 下分组误差只从 0.295 改善到 0.282(4.4%),additive 族甚至更差;作者自己也写了「for BS, the differences among candidate families are smaller and vary with the grouping scheme」。因此标题里的「Hyperparameter Scaling Laws」(复数)里,真正被数据强力支撑的其实只有学习率那一条。
9.2 口径是否严格:算力匹配还是参数匹配¶
这一点本文做得比同类工作都干净,值得单独表扬:它不是二选一,而是把三种对齐口径全部测了一遍并全部证伪。Figure 2 左右两栏分别对齐激活参数量 $N$ 与总参数量 $N_{tot}$,Figure 3a/4a 又在固定 $C\approx10^{19}$ 下变动 $M/D$ 分配。结论是「$N$、$N_{tot}$、$C$ 三种匹配都消不掉稀疏度效应」——这比只做参数匹配或只做算力匹配的做法要严格一个层级。而且论文的交付物是超参预测而不是「MoE 更优」的架构主张,所以它并不需要「加专家数换来的收益是否被记账」这个通常最容易翻车的判据。
但通信与路由开销确实在账外。$M$ 是「该架构每 token 的非嵌入前反向 FLOPs」,路由门控的 FLOPs 微不足道且已包含在内,而 all-to-all 通信、专家并行的气泡、随 $E_{tot}$ 增长的显存与调度成本都不是 FLOPs、自然不进 $C$。本文的主稀疏度扫描又恰恰是靠把 $E_{tot}$ 从 2 加到 128 来降低 $A$ 的:在 324M 那一档,$A=1$ 时 $N_{tot}=324\mathrm{M}$,$A=1/32$ 时 $N_{tot}=6.2\mathrm{B}$——总参数量涨了 19 倍而 $C$ 记账几乎不变。这在超参预测的语境下不构成结论偏差(因为没有人声称这 19 倍参数是免费的),但它意味着 §8 第三节推出的那条修正是真实的:$\delta_\eta = 0.1361$ 的数值部分依赖于「用 model FLOPs 而非集群可交付算力作为 $C$」这一选择。此外,附录 A.2 提到为省算力会提前中止「明显落在近优区外」的网格点,损失面因此不是完整笛卡尔积——这是合理的工程取舍,但它让「近优集」的边界带上了一点由中止规则决定的成分。
还有一条独立于口径的局限:证据全部来自单一骨干(混合线性注意力 + MLA)、单一数据混合、单一优化器(Muon)、单一路由方案(sigmoid + auxiliary-loss-free);粒度与稀疏度对照只有三个配置。$\gamma_\eta = -0.1385$ 与 DeepSeek 在 AdamW 下的 $-0.1250$ 接近,但 Muon 与 AdamW 的学习率量纲本就不可直接比较,跨优化器迁移仍未验证。
9.3 外推是否被克制¶
总体克制,只有一处presentational 上的伸手。正面的:留出目标只在 $A$($1/32\to1/64$,2 倍)、$D$(52.9B $\to$ 159B,3 倍)、$C$($10^{20}\to3\times10^{20}$,3 倍)三个方向各越界不到半个数量级,$N$ 则保留在观测边界上不外推;预测坐标在检视留出损失前冻结;Figure 5/6 的外推段用虚线明确标注;§6 明说只有一个越界目标、无法沿单变量分离外推、无法重复多种子、因此「每个精确预测只被对着一组含噪网格观测的极小值评估一次,观测到的损失差距是描述性点估计」。论文没有把拟合外推到远超实验范围的规模再当结论用——这一点与很多标度律论文形成对比。
唯一可议之处是 Figure 1(b) 这张 teaser:它把拟合曲面画到 $C = 10^{25}$ FLOPs 与 $D = 10^{13}$ token,即比 $10^{20}$ 的拟合上限高出五个数量级,虽然图上有一小块深色区标出实测覆盖范围,但视觉重心完全落在外推区。这属于展示层面的夸张而非结论层面的越界,正文与结论都没有引用这块区域的任何数字。
9.4 「引入新信号 ≠ 收益来源」与退化变体的核验¶
本文没有传统意义上的组件消融,候选函数族比较(Table 3、Table 9)就是它的消融:Scale only 就是「w/o $A$」的退化变体。按新核法要求,把这个退化变体先跟同表最强外部基线比:
- LR 侧:
Scale only的形式 $kC^\gamma$ 正是 DeepSeek Law 的 LR 形式;本文用同一套 fold 重拟合它得到 0.316/0.355,而完整形式是 0.176/0.153——「w/o $A$」不仅输给本文,其绝对水平也就是外部基线的水平,说明 $A$ 项带来的是真实增量而不是重参数化的假象。Table 4 的 refitted DeepSeek($\eta^*=1.6763C^{-0.1619}$)在留出点给出 $8.11\times10^{-4}$ 对本文 $6.92\times10^{-4}$,方向也一致(缺了 $A$ 的修正就会把学习率开高)。 - BS 侧则要打折:
Scale only的 $kD^\gamma$ 正是 Step Law 的 BS 形式,重拟合后 0.295/0.271,而本文 0.282/0.221。LONO 下只领先 4.4%,且 additive 族(同样含 $A$)反而更差(0.312)——这说明在 batch size 上,「引入 $A$ 这个新信号」并没有稳定地转化为收益,收益的来源仍主要是 $D$。Table 4 里 refitted Step Law 的 BS 预测 $5.13\times10^{6}$ 与本文 $5.84\times10^{6}$ 也只差 14%,远小于 LR 侧 published 系数的偏离幅度。这与 §9.1 的判断闭合:两条律里只有 LR 那条真正通过了「新信号即收益来源」的核验。
9.5 把这条律反过来用在库里的其他论文上¶
一个即时可做的应用:库里刚归档的 SMELT SMELT(清华 + ByteDance Seed,2026-09-01,本文未引用)用 MoE 同时锁死 per-token FLOPs、总参数量与 KV cache 三个预算来公平评估循环 Transformer,其匹配手段正是增加专家数。以文中给出的 200M / $S\approx94.7\%$ 实例为例:Baseline 每层 192 个专家、SMELT 每层 288 个,两侧均为 top-8 路由,因此 $A_{base} = 1/24$ 而 $A_{SMELT} = 1/36$。代入本文的律,SMELT 那一臂的最优学习率应当比 Baseline 低 $(2/3)^{0.1361} = 0.946$(约 $-5.4\%$),最优 batch size 应当高 $(2/3)^{-0.0841} = 1.035$(约 $+3.5\%$)。SMELT 的配对训练在完全相同的 token 序列与相同优化器设置下进行,也就是说两臂共用一组超参,更稀疏的 SMELT 臂系统性地略微偏高于自己的最优学习率。幅度不大(5% 量级,远小于 SMELT 报告的 6.8–18.0% FLOPs 节省),且方向上不利于 SMELT,因此 SMELT 的头条结论不受威胁、甚至偏保守——但这恰好演示了本文这条律的一个非显然用途:任何「靠加专家数来做预算匹配」的对照实验,两臂的最优超参在原理上就不相等,共用一组超参会给更稀疏的一臂带来一个可量化的系统性惩罚。
同类的方法论呼应还有 Skaling: Chinchilla's Exponents Meet Kaplan's Coupling Skaling(FAIR at Meta,2026-08-07)——它用无参数数值微分证明 Chinchilla 加法律隐含的零交叉导数被数据否证(实测混合导数非零且为负),必须补交互项。本文在超参律上面对的是同一个岔路口:multiplicative 形式在 log 空间等价于「$\log X$ 与 $\log A$ 无交互」,log-interaction 族则允许交互。本文的数据既不能确立前者、也不能排除后者(bootstrap 区间重叠,LOAO 的 LR 上后者反而更优),而附录切片里 $A$ 指数的单调衰减又指向交互。Skaling 在 loss 律上的经验提示:这类「先假定可加/可分离、后被更细的数值证据推翻」的模式在标度律里反复出现,本文选定的无交互形式很可能是一个待修正的一阶近似——作者自己把这写进了限制章节,是诚实的。
9.6 值得借鉴的设计¶
- 候选变量的判别方式:不是比谁的拟合更好看,而是设计「固定 $C$ 扫 $N$」这类指数应当为零的控制实验($-0.0254$ 与 $-0.0000$ 两个数字比任何 $R^2$ 都更有说服力)。这套判别法可以直接搬到推荐系统的 scaling 研究里——比如判断序列长度与参数量哪个才是某条增益曲线的真正自变量。
- 函数形式作为被验证对象:把 scale-only / additive / log-interaction / multiplicative 放在同一套 fold 上比,且在选定时明说依据是参数更少而非误差显著更低。
- 冻结预测协议:留出目标的损失在预测坐标冻结前完全不检视,published 与 refitted 两种基线模式分开报告,把「函数形式不行」与「系数没在同一栈下重估」两种失效原因分离开。
- 诚实的限制章节:明说组数不足、区间重叠、无法多种子、无法沿单变量分离外推。这在标度律论文里并不常见。
9.7 工业价值¶
对训练超稀疏 MoE 的团队,本文的直接交付物就是两个可以立刻代入的公式。以 $A = 1/64$、$C = 3\times10^{20}$、$D = 159\mathrm{B}$ 为例,得到 $\eta^* = 6.92\times10^{-4}$、$B^* = 5.84\times10^{6}$ token。用 20 万 H800 卡时换一套超参处方,在动辄十万卡时量级的前沿预训练里是划算的——这也是本文能存在的前提(作者是 Ling / Ring 2.6 万亿参数模型的同一批人,这套律显然服务于自家的 trillion-scale MoE 预训练)。但要注意三条使用边界:(1) 系数与优化器(Muon)、调度(WSD)、骨干(混合线性注意力 + MLA)、路由(sigmoid + ALF)绑定,换栈需重估;(2) 律的目标是验证损失,而验证损失的改善不一定均匀传导到下游能力——作者引 Gadre et al. (2025)、Isik et al. (2025) 自陈这一点;(3) 若集群侧 MFU 随稀疏度显著衰减,$\delta_\eta$ 需按 §8 第三节的推论重估。
综合看:实验规模与受控严谨度是稀缺的(1,800 次独立预训练、三种对齐口径全部证伪、冻结外推协议),机理解释自洽,限制交代诚实;扣分项是拟合跨度偏窄(BS 侧仅 1.4 个数量级)、$R^2$ 只有 0.72–0.78、候选形式之间无统计显著差异、batch size 那条律的增量证据明显弱于标题所暗示的强度,且止于超参预测、未触及最终模型质量或下游收益。