Explainable Recommendations at Scale:把 LLM 理由生成整体搬到离线,换 YouTube Music 发现位 +22.43% 互动
Google LLC(Xiao Liu、Yanwei Song、Srivaths Ranganathan、Yuan Chen、Zheyun Feng、Parker Steenburgh、Jochen Klingenhoefer、Nathan Lasche、Gergo Varady、Tim Steele),arXiv:2609.23877v1,2026-09-20,正文仅 4 页的工业 case study。一句话:YouTube Music 的「Your Daily Discovery」(YDD)发现位上,用户不缺相关候选,缺的是点开陌生艺人的信心;论文用 Gemini 离线异步地为每个用户预计算一份 Discovery Profile(口味簇 + 未听过的新艺人候选 + 每条候选对应的自然语言理由),经 Knowledge Graph 规范化去除幻觉艺人、熟悉度过滤保证"真没听过"、安全过滤兜底,再由在线层做一次低延迟取用——只做 fetch 不做推理,因此完全绕开实时 LLM 成本。两周线上 A/B:YDD 位级互动 +22.43%(CI [16.93%, 27.93%]),发现/留存指标 +8.07%(CI [0.90%, 15.24%]),平均服务延迟只涨 0.3%。
⚠️ 阅读提示:这是一篇纯系统/落地型短文——全文没有任何公式、没有损失函数、没有任何模型训练(作者明确表示"不做权重微调,只做 prompt tuning"),也没有任何公开数据集基准。它的信息量集中在三处:(a) 离线预计算 + 在线 fetch 的解耦拆法与成本工程;(b) KG 规范化对"组合式幻觉艺人"的必要性论证;(c) 一次 multi-arm holdback 得到的、对全文定位有颠覆意义的归因结论。本篇精读会把 (c) 单独拎出来做批判性分析。
研究动机与背景
瓶颈不是候选,是信心
论文开篇给出一个相当锋利的问题陈述。音乐流媒体平台长期夹在两个相互竞争的目标之间:一边要让用户迅速拿到此刻想听的歌(exploitation),一边要让用户有机地发现新音乐以维持长期黏性(exploration)。矛盾在于,虽然用户口头上渴望发现,但在陌生艺人和熟悉艺人之间做选择时,门槛极高。
论文据此提出全文的中心论断:
我们认为,探索的首要瓶颈不是缺少相关候选,而是缺少信心(not a lack of relevant candidates, but a lack of confidence)。提供透明的自然语言理由、明确解释为什么推荐这个陌生艺人,起到了一座认知桥梁(cognitive bridge)的作用,显著降低了新内容的信任门槛。
这个论断决定了整篇论文的攻击面:不去改推荐模型,而去改推荐的"说辞"。
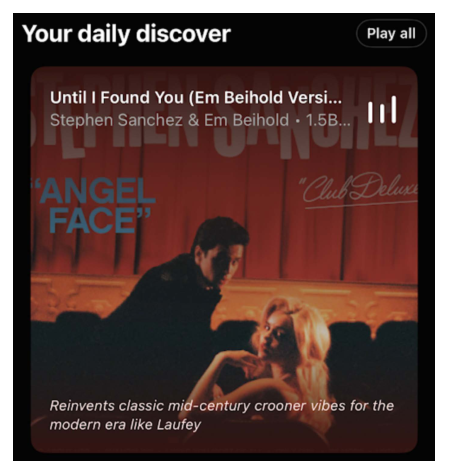
为什么必须是 LLM,以及为什么 LLM 不能在线
论文对"为什么非 LLM 不可"给了三条理由:
- 传统协同过滤(CF)只产出不透明的 affinity 分数 [2],且在数据稀疏时表现吃力 [3];
- LLM 能借海量世界知识,从极少的交互数据里推出丰富的语义联系;
- 更关键的是,LLM 带来一次范式转移——生成式可解释性(generative explainability):在零样本候选生成的同时,顺带产出细腻、人类可读的理由 [4];并且能灵活融入丰富的个人上下文,把个性化推到新的程度。
但紧接着是硬约束:为数十亿用户在线生成个性化理由与候选池是不现实的。实时推理的算力开销与严苛的亚秒级延迟约束,直接排除了把 LLM 放进直播会话的可能 [5]。
论文还补了一条常被忽略的副作用:实时架构为了满足延迟预算,被迫处理截断后的交互序列,这经常导致模型过拟合到瞬时的互动尖峰(transient engagement spikes),产出"脱节、过度反应式"的发现会话。反过来说,一旦把推理挪到离线,不但延迟消失,数据截断也一并消失——可以安全地吃下用户的完整长期收听历史。这是本文对"离线化"的一个额外论证,比单纯的省钱更有说服力。
相关工作的四条脉络
- 对话式与可解释推荐:工业侧 Spotify 的 "AI DJ" 已证明人类可读的上下文能显著提升用户信心 [4];学术侧 Chat-REC [8] 用实时 LLM prompting 换取交互性与可解释性,ReFICR [9] 用 RAG 应对对话场景中不断演化的物料库。差异:实时 prompting 交互性好但在严格延迟预算下难以规模化;本文彻底放弃实时生成,改用预计算的理由池,并在理由触达在线层之前用 LLM-as-a-Judge 对齐 + KG 规范化强制质量、过滤幻觉、保证新颖性。
- 生成式推荐:TIGER [10] 用自回归解码离散 Semantic ID 重构候选检索;OneRec 系列 [11][12] 把检索、排序、优化压进单一生成式架构。差异:这些工作的重心是流水线结构统一与预测效率,输出的是候选 item 本身;本文把生成式范式转向可解释性,输出的是直接讲给用户听的自然语言理由。
- 音乐领域的 LLM 推荐:TALKPLAY [13] 用多模态 tokenizer 把音乐推荐做成端到端 token 生成;LLM2Rec [14] 通过协同监督微调把 LLM 改造成带 CF 感知的通用 embedding 模型。差异:这两者都依赖昂贵的领域微调或端到端生成;本文只用 Gemini 的零样本推理能力,把优化压力全部转移到 prompt tuning 与结构化 CoT [15],不做任何结构性模型改动。
- 离线/在线解耦的工业 LLM 框架:这是与本文最贴身的一支。ReLand [18] 提出"LLM Reasoning Pool"——在种子用户上离线做生成式推荐,再用检索把可靠的推荐理由在线挂给更广的用户群;HyGen 则通过把离线吞吐型 LLM 负载与在线任务共址(co-locate)来化解延迟-吞吐的两难。本文自陈的差异:用机会性 TPU [19] 批处理 + 可配置刷新周期,为数千万日活异步生成个性化 discovery profile,在成本效率与内容新鲜度之间取平衡。
值得注意的是,论文对 ReLand 的表述已经相当接近自认"同一范式的工程延伸"——差异主要在调度与刷新策略,而非机制。
核心方法与系统设计
整体是一个两阶段解耦架构:把计算密集的推理/推荐过程,与延迟敏感的在线服务层彻底隔离。
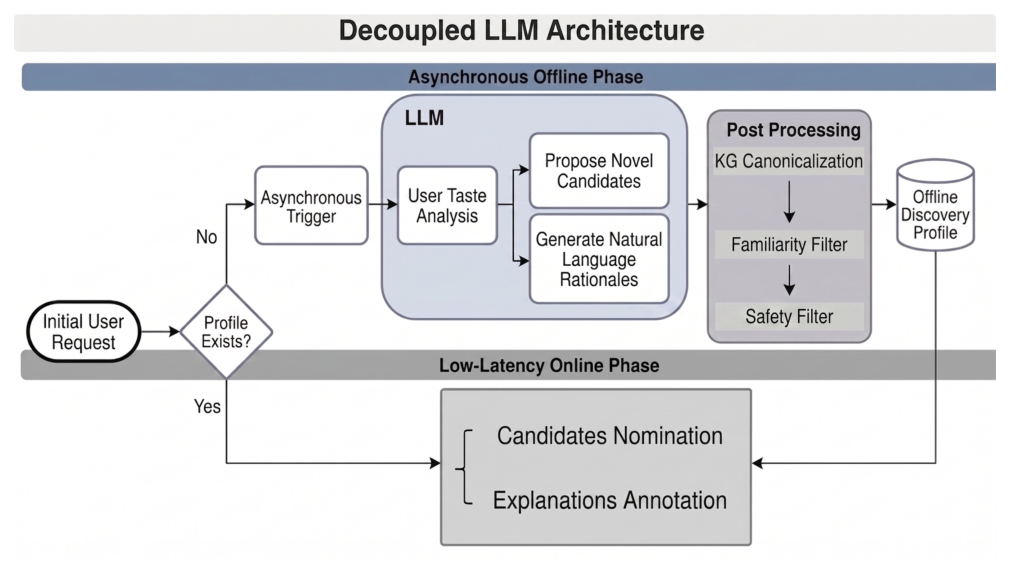
3.1 解耦的 Profile 生成:事件驱动的惰性生成
这里有一个容易被略过但其实是本文少数几个真正的工程巧思:不做全量批处理。
传统批处理架构会主动对整个用户库预计算推荐。本文改为事件驱动的异步触发:profile 生成请求严格按需下发——只在一个合格用户真的打开了 YouTube Music 首页时才触发。配套设计:
- 零体验降级:如果预计算的 profile 还没就绪,在线服务层无缝回退到标准的启发式发现逻辑;
- 一次生成、后续复用:离线 LLM 推理结束后,Discovery Profile 被安全缓存,立即可用于该用户的后续会话。
论文把这套策略称为 lazy-generation,收益是把昂贵的推理严格限制在活跃用户身上,大幅削减无谓算力。这一点相比"全库刷"的常规做法确实更省,也是它区别于 ReLand"种子用户离线生成"的地方。
3.2 LLM 候选与理由生成:一次调用同时产出两样东西
生成流水线的核心,是让 LLM 把用户的原始音乐互动数据转成结构化的 discovery cluster:
- 口味分簇:分析完整收听历史,把用户偏好切成彼此区分、内部内聚的口味组(taste groups);
- 候选提名:对每个口味组,提出与该簇语义对齐、但用户很可能尚未发现的新艺人;
- 理由生成:同时产出自然语言理由,明确articulate用户既有口味与这些新推荐之间的联系。
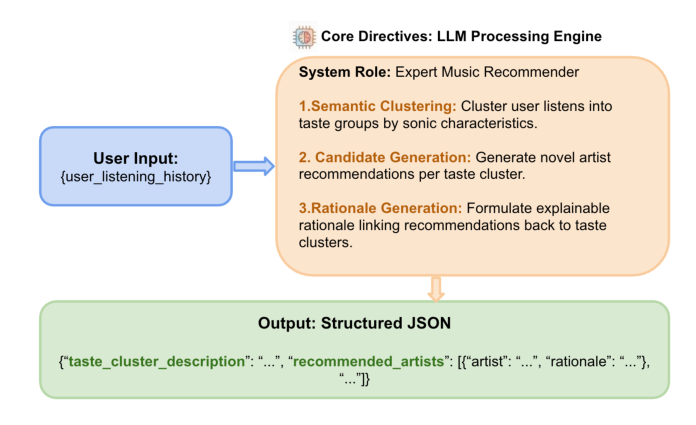
论文特别指出,这个工作流本质上就是一次 Chain-of-Thought 推理:通过要求模型在提名的同时给出理由,一箭双雕地(a) 提升候选推荐本身的语义质量,(b) 顺带产出线上应用所需的用户可见解释。
这是全文方法部分的全部内容——一个 system role + 三条指令 + 一个 JSON schema。没有训练,没有微调,没有公式。
3.3 离线评测与 prompt 调优:LLM-as-a-Judge
为在不依赖昂贵人工标注的前提下大规模评估推荐质量,论文用 Gemini 3.1 Pro [20] 作为自动评分员 [6],系统性地评估生成口味组的结构内聚性与提名新艺人的语义对齐度。
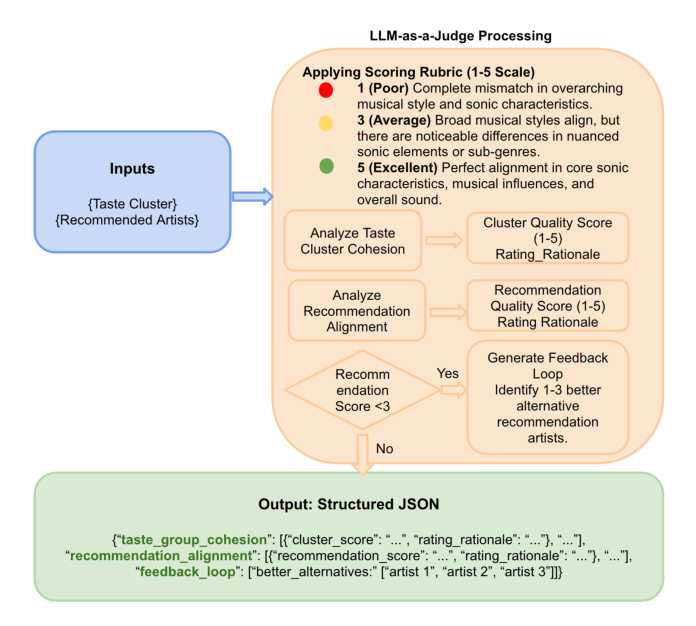
评测被刻意拆成顺序的多步 rubric,目的是精确定位质量退化的来源——区分"根子上口味组就没分好"(结构性失败)与"口味组没问题但候选选歪了"(下游语义失配):
| 阶段 | 评估对象 | 量表 | 作用 |
|---|---|---|---|
| Taste Cluster Cohesion Assessment | 口味组内部一致性,多维分析主 subgenre、演唱风格、文化语境、语言属性的统一度 | 1–5 | 判定差推荐是否只是"口味组没形成好"的结果 |
| Recommendation Alignment Scoring | 提名新艺人与既有口味簇之间的语义对齐度,衡量锚定该簇的用户正向互动的可能性 | 1–5 | 定位候选生成环节的效能 |
| Targeted Feedback Loop | 任何得分 < 3 的推荐 | — | judge 用 forward-reasoning 输出缺陷理由,并给出 1–3 个更契合的替代艺人 |
通过 Loss Pattern 分析做迭代 prompt 调优。得分 < 3 的推荐被系统性标记为负例,judge 聚合这些自动批评,充当一个可扩展引擎去识别生成器行为中反复出现的 "Loss Patterns"。评测中识别出的主要失败模式有三类:
- Semantic Mismatches:推荐艺人的曲风/流派与簇描述实质性偏离;
- Entity Hallucination:模型编造理由,或推荐根本不是音乐人的实体——例如电影导演、作词人、编剧;
- Linguistic Inconsistencies:提出的簇内部出现语言错配。
针对性的修法不是微调权重,而是往 prompt 里注入结构性规则。论文给的具体例子:检测到语言错配后,注入严格的优先级约束——要求模型在做任何进一步的风格分析之前,先按主要语言对所有艺人分组。
唯一被量化的离线结果:
| 配置 | 采样口味簇中推荐质量达标(评分 > 3)的比例 |
|---|---|
| 基线 serving prompt(调优前) | 64.8% |
| 整合 judge 反馈导出的结构规则后 | 74.4% |
即绝对接受率 +9.6 个百分点。论文由此主张:LLM 离线评测框架可以在上线 A/B 之前,充当一个高效、可扩展的系统对齐引擎。
⚠️ 这里有一个论文未承认的循环论证:用于调优 prompt 的反馈,和用于评判调优效果的评分,来自同一个 judge(Gemini 3.1 Pro)。judge 指出 loss pattern → 团队照着 pattern 改 prompt → 同一 judge 给出更高分。64.8% → 74.4% 因此在很大程度上是"针对评分器优化"的必然结果,而非推荐质量的独立证据。全文没有任何人工标注抽检、没有留出 judge、没有与线上指标的相关性验证。这是本文方法论上最实质的缺陷。
3.4 后处理:KG 规范化 + 熟悉度过滤 + 安全过滤
这是本文技术含量最高、也最有可迁移价值的一节。
第一级——确定性的规范化层(KG Canonicalization):把生成的艺人字符串解析到一个权威 Knowledge Graph 上。论文给出的观察非常具体:生成阶段模型会产出形态上完全合理、但实际根本不存在的实体,既有听起来很正常的西方人名(如 Gavin DeBardeleben),也有由真实高棉语音节无缝拼接而成的名字(如 Chhet Sokun、Touch Sokhen)。论文的关键论证是:
因为这些组合式虚构(combinatorial fabrications)在语境上和语言学上都与合法的长尾艺人无法区分,传统的启发式或基于文本的过滤方法从根本上就是不够用的。
解法:强制要求每个推荐候选都必须准确映射到一个可验证的 KG 实体 ID,以此确定性地剪掉幻觉艺人。这个论证值得记住——它说明在长尾实体推荐里,"幻觉检测"不能靠文本层面的置信度或规则,必须靠外部本体做存在性判定。
第二级——熟悉度过滤(Familiarity Filter):把已落地到 KG 的实体与用户完整收听历史交叉比对,严格排除任何此前消费过的艺人,确保最终候选池交付的是真正未被发现的内容。论文强调,这一层之所以能扫完整历史而不必截断,正是因为它运行在解耦后的离线框架里——这是"离线化"带来的第二个非成本收益。
第三级——安全过滤:检测并阻断违反平台政策的内容,任何不合规的 LLM 理由被系统性丢弃。
3.5 在线提名与标注
在线层只做一件轻活:低延迟取回用户已缓存的 Discovery Profile。该 profile 有双重用途:
- 提名(Nomination):把 KG 落地后的新艺人/歌曲候选,补充进传统 CF 检索源产出的候选集;
- 标注(Annotation):把对应的预生成自然语言理由挂上去。
关键在于,理由标注是一次轻量 fetch 操作,而非在线生成式推理,因此在维持亚秒级响应的前提下,用高度个性化的可解释推荐丰富了 YDD 这类目标发现位。
3.6 效率与成本优化
面向数千万日活,论文列了两条成本机制(均无任何量化):
- 机会性 TPU 利用(opportunistic TPU utilization):因为 profile 生成不受用户侧延迟约束,推理负载可以调度到非高峰时段,或路由到低优先级、可抢占(preemptible)的算力层;
- 可配置刷新周期:把 profile 的陈旧度与日常流量尖峰解耦,通过设定更新间隔在内容新鲜度与算力开销之间取最优平衡。
结论是:这套设计彻底消除了对专用高可用推理集群的依赖,使 LLM 驱动的发现体验在全球规模下经济可行。
实验设置
基线 YDD 架构(Section 4.1)
有意思的是,全文描述最详尽的技术细节其实是基线,而非本文方法。YDD 位遵循 YouTube 推荐的经典两阶段架构 21,依次由四个组件构成:(1) 候选检索 → (2) 启发式理由生成 → (3) 候选排序 → (4) 货架打包。
- 候选检索:一组检索模型为每个用户找出初始的个性化歌曲/视频推荐集。该初始集同时服务首页上 YDD 之外的其它位,可能包含用户熟悉的内容;系统从中只挑出"发现合格"的候选——即未出现在用户观看历史里的那些——进入后续处理。
- 启发式理由生成:现有 YDD 理由聚焦于候选与用户高度熟悉的种子实体之间的相似性,模板形如 "For Fans of [Seed Artist]"(听某种子艺人的用户通常也听这首推荐歌)和 "Sounds like [Seed Song]"(推荐歌与种子歌音频属性相近)。生成流程:按观看历史取一组种子实体(艺人 + 歌曲),偏好互动更多、更近期的实体;然后在若干预训练 embedding 空间里计算每个种子实体与每个候选的成对余弦相似度。不同 embedding 语义对应不同理由类别——co-watch embedding 对应 "For Fans of",音频波形 embedding 对应 "Sounds like"。
- 关键的硬约束:对每个候选、每种 embedding,找最相似的种子实体;只有相似度超过给定阈值,才给候选打上对应理由。而最终只有带理由的候选才会被选中并打包进 YDD 位。
这条规则极其重要,是理解本文线上收益来源的钥匙:在基线里,"能否被解释"直接决定"能否被展示"。相似度阈值同时充当了内容准入闸门。
- 排序:用一个深度排序模型 [22] 对候选打分,预测多个互动维度(点击率、条件观看时长、发现率等);一个辅助模型把这些预测聚合成单一 "reward" 预测;按 reward 排序,在业务多样性约束(如保证展示的理由类别有多样性)下把 top 候选打包成最终 YDD 位。
- 注:这里的 [22] 正是本团队此前的 Zero-shot Cross-Domain Knowledge Distillation on YouTube Music(RecSys 2025,已归档 2603.28994),作者名单高度重合。本文方法并未替换这个排序器。
A/B 设置(Section 4.2)
两周 A/B,评估稳定用户行为,用户分两组:
- Control:Section 4.1 描述的生产体验,发现候选的理由依赖规则模板(如 "For Fans of [Artist]" / "Sounds Like [Song]");
- Treatment:整合 LLM 的体验,注入来自预计算 discovery profile 的新候选,并对所有合格 item 施加丰富的自然语言理由。
treatment 具体用两种增广手段:
- 直接加候选:利用基线检索模型已有的带属性约束的受限提名(restricted nomination)能力,用"用户 discovery profile 里出现的艺人"作为约束,补充该艺人的歌曲/视频推荐进候选集;
- 挂理由:把 discovery profile 里的 LLM 理由挂给候选集中所有合格候选——这包括来自基线 YDD 配置的推荐(基线有可能恰好推荐了 profile 里艺人的作品)。
主要实验结果
Table 1: LLM 理由对关键发现指标的影响
| Metric | Value | 95% Confidence Interval |
|---|---|---|
| New Nominator Views | 4.1% | N/A |
| New Nominator Uniqueness Rate | 74.00% | N/A |
| YDD Shelf-Level Engagement | +22.43% | [16.93%, 27.93%] |
| YDD Shelf-Level Discovery Metric (Retention) | +8.07% | [0.90%, 15.24%] |
另有两项非表格数字:
- 平均在线服务延迟仅上升 0.3%,亚秒级响应与高可用性得以保持;
- 上线后,YDD 位自发跃升到 YouTube Music 首页前三位的比率显著提高,论文视之为发现体验实质改善的旁证。
结论分析:论文自己点明了一处张力——来自新提名器的直接消费只带来 4.1% 的观看增量(modest),但位级的整体互动与发现指标却涨得多得多。这个落差本身就在暗示:收益不是"新候选被点了",而是别的机制在起作用。
消融与分析:multi-arm holdback,以及它对全文定位的颠覆
为拆解 LLM 提名 与 理由标注 各自的贡献,论文做了一次 multi-arm holdback,把"完整 treatment holdback"与"单特征 holdback"对比。结论(原文为纯定性描述,无任何数字):
| Holdback 的对象 | 互动(Engagement)影响 | 发现(Discovery)影响 |
|---|---|---|
| 全量 LLM 系统 | 显著退化 | 显著退化 |
| 仅关掉 LLM 理由标注(视觉界面与候选池不变) | 退化幅度与全量关掉"高度接近" | 部分退化 |
| 仅关掉新提名源 | 中性(neutral),无影响 | 部分退化 |
论文自己的表述是:"LLM 理由标注是位级整体互动增益的首要驱动力";而"仅禁用新提名源导致中性的互动影响"。发现指标上则存在系统性相互依赖——全量 holdback 下显著退化,单独省掉任一特征都只是部分退化。
这个结果意味着什么
按档案的既有判据逐条过一遍:
(1) 引入新信号 ≠ 收益来源。 本文引入的"新信号"是 LLM 零样本提名的未发现艺人候选池——这正是摘要与引言反复强调的卖点("LLM-backed recommendations")。但 holdback 明确告诉我们:把这个新信号整个拿掉,互动指标没有变化。也就是说,+22.43% 与新候选无关。真正产生收益的,是把 LLM 写的自然语言文案,挂到本来就会被基线检索+排序系统选出来的候选上。摘要"combining LLM-backed recommendations with these explanatory rationales"这一并列表述,在实证上是站不住的——两项里只有一项有效。
(2) 消融跌幅 vs. 相对最强基线的 margin。 这里无法做这个比较,因为论文根本没有给出任何 holdback 的数值。"closely mirrored"、"neutral"、"partial regressions" 三个副词,承载了全文最重要的归因结论。一个只有 4 页、核心机制主张全靠形容词支撑的实验章节,其可复核性接近于零。同时论文也没有相对"最强基线"的比较——对照组是现有生产启发式模板,不是任何更强的解释生成方案(比如小模型生成、检索式理由、或 ReLand 式理由池)。因此我们无从判断"LLM 理由"相对"更好的非 LLM 理由"有多少净增益。
(3) 一个论文未处理的实质混淆。 回看 4.1:基线里只有相似度超阈值、拿到启发式理由的候选才会被打包进 YDD 位。treatment 中 LLM 理由可以挂给"所有合格候选",包括那些在基线下会因为过不了相似度阈值而被整个丢弃的候选。论文把这一点当作优点来讲——"把发现体验从传统启发式模板的僵硬相似性约束中解放出来,从而浮现出显著更多样的候选池"。但这直接意味着:treatment 组的货架可能更满、内容更多样,而这是一个准入规则的变化,不是"LLM 文案比模板文案更有说服力"。因此 +22.43% 中有多大比例来自"文案质量",多大比例来自"闸门放宽",A/B 没有做任何分离。而这恰恰是论证"认知桥梁"假说所必需的分离。
综合起来:论文声称验证了"自然语言理由充当认知桥梁、降低信任门槛";实际证成的是一个更弱也更混杂的命题——"把发现位的理由从模板换成 LLM 文案、并同时放宽理由准入阈值,位级互动涨了 22.43%"。
核心贡献总结
诚实地列,本文有三条可带走的东西:
- 一份可复制的解耦蓝图:事件驱动惰性生成(只对打开首页的活跃用户触发)+ 完整历史无截断输入 + 预计算 profile 缓存 + 在线纯 fetch + 机会性/可抢占 TPU 调度 + 可配置刷新周期。其中"惰性生成"与"机会性算力"两条是相对 ReLand/HyGen 的真实工程增量。
- KG 规范化对长尾实体幻觉的必要性论证:
Gavin DeBardeleben/Chhet Sokun/Touch Sokhen这组例子,清楚说明了组合式幻觉在文本层面与真实长尾实体不可区分,因此实体存在性必须由外部本体确定性裁决,而非靠文本启发式或模型自信度。这一条可迁移到任何让 LLM 直接吐实体名的推荐/检索系统。 - 一个诚实且反直觉的归因结论:LLM 提名对互动是中性的,收益来自理由标注。论文本可以把这件事含混过去(毕竟 Table 1 只报总体增益),它选择披露,值得肯定——尽管披露得没有数字。
与已归档相关工作的对比
LLM-Based User Personas for Recommendations at Scale LLM-Based User Personas for Recommendations at Scale (Google / Google DeepMind, 2026-06-10)
关系:独立并发(本文未引用该工作,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇都在攻同一个 root cause——LLM 的语义/世界知识对推荐有真实价值,但同步在线推理在十亿/千万级用户规模上成本与延迟不可行;并且两篇都把"打破 exploitation 惯性、推动 exploration"作为直接的业务动机(personas 论文显式区分 Summarized Interests 与 Exploration Interests,本文则聚焦"未发现艺人")。更耐人寻味的是,两篇同属 Google、同为"用 Gemini 为用户生成自然语言画像/档案并落到推荐链路"的工作,本文的参考文献里完全没有出现它。
- 相近的技术骨架:抽象后几乎重合——(i) 把用户长期历史按语义聚成 cluster 作为 LLM 输入结构;(ii) 单次 LLM 调用同时产出"总结既有口味"与"外推新兴趣/新候选";(iii) 异步离线生成 + 数据库缓存 + 在线只读取,请求不等待生成;(iv) 生成结果经安全分类器过滤,不合格则回退到旧档案/启发式;(v) 用受限最近邻/受限提名把自然语言意图接地回 item 空间。连"惰性/按需刷新以控成本"的思路都一致。
- 本文的差异与推进:(a) 本文的产物直接作为用户可见文案展示,personas 论文的画像主要是内部检索信号(虽然论文强调其可解释性潜力);(b) 本文多了一层 KG 确定性实体规范化,针对"LLM 直接吐艺人名"这一更危险的输出形态,personas 论文输出的是自由文本兴趣,不面临组合式实体幻觉问题;(c) 本文是事件驱动惰性触发,personas 论文是"查库—过期则后台重算"的刷新式。
- 可比的方法/实验差异:方法论严谨度差距显著。personas 论文做了知识蒸馏(Gemini 1.5 Pro 教师 → Nano/Flash 学生)以真正解决成本,本文完全不训练,靠机会性算力硬扛;personas 论文有系统的离线消融(元数据类型:标题 vs 描述 vs salient terms;输入结构:序列 vs 聚类;模型规模:Flash/Pro/Ultra 的饱和点)+ 用户调研(>80% 认为画属贴切,57% 偏好 LLM 画像 over 知识图谱实体基线)+ 30+ 天 A/B(观看时长 +0.04%、活跃用户 +0.03%,均 p<0.05,增益集中在轻度用户),本文只有一次两周 A/B、一个循环验证的 64.8%→74.4%,和一组无数字的 holdback。规模口径也需注意:personas 的 +0.04% 是十亿级平台的全局观看时长,本文的 +22.43% 是单个位(YDD)的位级互动,两者不可直接比大小——后者分母小得多。
Hypothesis-Driven Shelf Generation for Personalised Recommendation Hypothesis-Driven Shelf Generation for Personalised Recommendations (Spotify, 2026-07-28)
关系:独立并发(本文未引用,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇都指出音乐流媒体发现界面被"有限的人工启发式/模板"卡住了长尾。Spotify 论文说模板把"满足什么需求 / 什么内容算有效 / 用哪个系统填充"三个决策耦合死,无法覆盖「流派×年代×场景×情绪×熟悉度」的组合爆炸;本文说启发式理由的相似度阈值充当了僵硬闸门,过不了阈值的候选连展示机会都没有。两者诊断的其实是同一个东西:模板/阈值既是文案生成器,又是内容准入规则,这个耦合限制了发现的广度。
- 相近的技术骨架:(i) 用 LLM 从行为画像(而非用户主动 query)生成一段自然语言中间表示——Spotify 叫 shelf hypothesis,本文叫 discovery profile 的 taste cluster + rationale;(ii) 这段自然语言同时充当用户可见文案与下游检索的约束;(iii) 整条流水线离线批处理,不给在线服务加延迟;(iv) 生成物必须被接地到真实目录实体(Spotify 用 trie 约束的 Semantic ID 解码保证标识符总是有效,本文用 KG 实体 ID 映射剪掉幻觉)——两者都独立意识到"LLM 自由生成的实体必须由确定性索引兜底";(v) 最终产物作为候选注入既有首页排序去竞争,而非替换排序器。
- 本文的差异与推进:Spotify 把自然语言假设定位成"规划与履行之间的一份紧凑契约",明确不把用户画像传给履行阶段,以强制两阶段目标解耦;本文没有这层抽象,LLM 一次调用同时做分簇、提名、写文案,三者混在一个 prompt 里。反过来,本文在用户可见解释这一侧走得更远——Spotify 的 LLM 文案是货架标题/副标题(集合级),本文是逐条候选的个性化理由(item 级),且论文的中心假说就是这段文字本身的说服力。
- 可比的方法/实验差异:Spotify 有四阶段各自绑定唯一失败模式与唯一评测挂钩的方法论表(这正是本文最缺的东西),有两个 judge × 12 个评分维度的分阶段 LLM-as-a-Judge,有对检索基线(BM25/稠密/混合)的正面比较(Overall 0.56→0.71,对齐阶段再到 1.27),并且罕见地披露了不利的线上数字(专辑池 +36%、单集 +2%,但歌单 −14%、播客节目 −41%)。本文既无基线比较、也无分维度评测、也无任何负面数字披露,唯一的量化离线指标还是自我循环的。两相对照,本文在评测严谨度上明显落后于同期同赛道的工业工作。
被剔除的近似候选(记录于此以防门槛放水): - Zero-shot CDKD Zero-shot CDKD (Google, YouTube Music) — 同团队、同产品、同界面,且被本文显式引用为 [22](即 YDD 基线里的那个深度排序模型)。但问题(低流量 YouTube Music 学生模型的质量)与解法(跨域零样本知识蒸馏)与本文完全不同构,不涉及 LLM,也不涉及解释。属系统前置依赖,非语义孪生。 - Constrained GRPO Constrained GRPO (Netflix) — 同样是"让 LLM 推荐器生成自己的推荐解释",表层极像。但其 root cause 是解释的无害性(harmlessness)如何从加权奖励项改造成阈值化可行性约束,解法是真刀真枪的 RL 微调 + 两个 LoRA judge;本文不做任何训练,问题是探索的信任门槛而非安全。解法路径实质偏离。 - PushDualGen PushDualGen (Kuaishou) — 共享"解释是廉价的事后文本"与"在线成本决定了解释与决策的先后顺序"这两条 insight,相当接近。但它是一个端到端训练的 SID 生成式推荐器,在同一次解码里先出 SID 再出可跳过的推送文案;本文是不训练、跨离线/在线两个物理阶段的解耦。方法流程图无法抽象重合。 - Improving Item Discoverability in e-Commerce Search via Related Intent Generation Instacart 隐式意图生成 — 共享"两层成本架构:头部离线缓存 LLM 标注、尾部小模型兜底"这一骨架。但 root cause 是搜索场景下 query 意图覆盖不足(item 可发现性),而非用户对陌生 item 的信任门槛,且不产出用户可见解释。问题层不同构。
讨论与局限性
值得借鉴的设计
- "能否被解释"不应等于"能否被展示"。本文最有普适价值的观察藏在基线描述里:生产系统用相似度阈值同时充当文案生成器与内容闸门,于是解释能力的上限直接成了发现广度的上限。一旦解释由 LLM 生成、不再受限于"必须能套进某个模板",闸门自然放宽。任何有"带理由才展示"逻辑的推荐位都应该检查这个隐藏耦合。
- 长尾实体幻觉必须由外部本体裁决。组合式虚构名与真实长尾艺人在文本层面不可区分,这个论证干净且可迁移。
- 离线化的非成本收益:去掉延迟约束后,序列截断和随之而来的"过拟合瞬时互动尖峰"一并消失,可以吃完整长期历史。这比"省钱"更值得强调,论文提了但没量化。
- 事件驱动惰性生成相比全库批处理,是把 LLM 预计算成本与真实活跃度对齐的简单有效手段。
局限与争议
- 零方法论创新。作者明确表示"不追求昂贵而脆弱的权重微调,只迭代改 prompt"。全文没有公式、没有训练、没有新架构,LLM 是现成的 Gemini。按档案标准,这是既有思路的组合与工程改造,不是方法贡献。
- 收益来源与论文卖点错位。holdback 显示 LLM 提名对互动中性,收益全部来自把 LLM 文案挂到既有推荐器产出的候选上。这使本文实质上退化为"给现有排序结果做事后解释"——摘要里"LLM-backed recommendations"这半句没有实证支撑。
- 最关键的实验没有任何数字。全部 holdback 结论由 "closely mirrored / neutral / partial" 三个形容词承载,不可复核。
- 唯一的离线量化指标是循环的。64.8%→74.4% 由被用来调 prompt 的同一个 judge 打出,无人工抽检、无留出 judge、无与线上指标的相关性验证。
- A/B 未分离"文案质量"与"闸门放宽"。treatment 同时改了理由文本与候选准入规则,+22.43% 无法归因到"认知桥梁"假说本身。
- 无最强基线对照。对照组是现有生产模板,不是更强的非 LLM 或轻量 LLM 解释方案,净增益不明。
- 指标口径需警惕。+22.43% 是单个发现位的位级相对提升,不是平台级指标;发现/留存指标 CI 下界仅 0.90%,勉强越过零。New Nominator 的两项数字(4.1% views、74.00% uniqueness)连置信区间都标 N/A。
- 成本章节零量化。3.6 整节讲成本优化,但没有一个数字——没有 TPU 小时、没有单位用户成本、没有与在线推理方案的成本比,"经济可行"是断言而非证据。工业署名不等于工业证据。
- 可扩展性隐患。这条路线的能力天花板完全由外部基础模型与 prompt 决定,系统自身没有可 scaling 的学习组件;profile 与在线排序器之间是彻底解耦的两段,无法端到端联合优化——理由生成拿不到线上互动的梯度信号,只能靠人读 judge 报告再改 prompt 这种低带宽回路迭代。
与已有工作的差异
相比 ReLand 18,本文的机制差异其实很小,主要是调度策略(惰性触发、机会性 TPU、可配置刷新)与后处理强度(KG 规范化)。相比同期的 personas(Google)与 shelf generation(Spotify),本文在评测严谨度与方法深度上都明显落后,但它是唯一一篇把 item 级个性化解释文案作为主角、并给出位级大幅互动增益的工业报告——作为"解释文案值得认真对待"的存在性证据,它是有价值的;作为方法论参考,则几乎没有可学的技术。