Detecting an Effect Is Not Learning to Act on It:为 LLM 获取代理立一条 reward–SNR 地板¶
一句话:当流水线可以按样本付费获取一个昂贵的模型派生观测(LLM 的结构化推理、慢速 oracle、额外测量)时,"检测到这个信号平均有用"和"学会逐样本决定何时该买它"是两件完全不同的事;本文用 reward–SNR 可检测性下界 $\rho^\star(N)\approx 2.8/\sqrt{N}$ 把两者分开,用匹配矩噪声安慰剂证明看似可学的 in-sample oracle 收益不过是噪声顺序统计量,用正对照排除"流水线坏了";具体载体是 Structured Hypothesis Embeddings (SHE)——冻结 LLM 把用户历史分解成 K 条排序、带置信度、有证据引用的意图假设。
作者:Ying Yuan(UC San Diego,单作者,通讯 [email protected])
ArXiv:2608.10441v1 · 2026-08-11 · cs.LG · 20 页(正文 12 + 附录 A–L)
数据与代码:仅用公开数据集(MIND / REES46 / Amazon-Beauty);发布 58 条 claim 的 ledger(每条映射到脚本/CSV/图)与 scripts/reproduce.sh 一键离线复现。
1. 研究动机与背景¶
1.1 一个通常被隐式处理的决策¶
越来越多的机器学习系统里埋着一个几乎从不被显式建模的决策:要不要为这个样本付费获取一个辅助的、模型派生的观测?拿到之后又该不该信它? 观测可以是 LLM 对输入的结构化推理、慢但准的 oracle 或人工标注。获取有真实成本(延迟、金钱、算力),所以自然的愿望是学一个策略,只在辅助信号真正有帮助处花预算——这在 active learning、value-of-information、learning-to-defer 和 LLM-as-feature 流水线里普遍存在。论文明确定义自己用的"agent":这个一次性获取门,不是序贯/RL planner。
1.2 本文的论点:检测均值效应 ≠ 学会逐样本行动¶
论文做的是一个简单但被严重低估的区分:检测到获取的信号"平均有用",与学会"逐样本该不该获取它",不是一回事;后者能否从离线数据里被恢复,受一条容易陈述也容易违反的信噪比定律支配。若逐样本效应的信噪比是 $\rho=\mu/\sigma$,则可靠检测一个条件于该 reward 的策略要求 $\rho$ 越过地板 $\rho^\star(N)\approx 2.8/\sqrt{N}$。在地板之下,那个"显然说明学习有用"的证据——按实现 reward 挑 top-$b$ 的 in-sample oracle——是噪声顺序统计量的产物。 论文用正对照(把可控 SNR 的合成信号注入同一条可部署流水线,$\rho$ 一旦越过地板信号就被恢复)证明它,并反复强调地板是必要条件,不是不可能性定理。
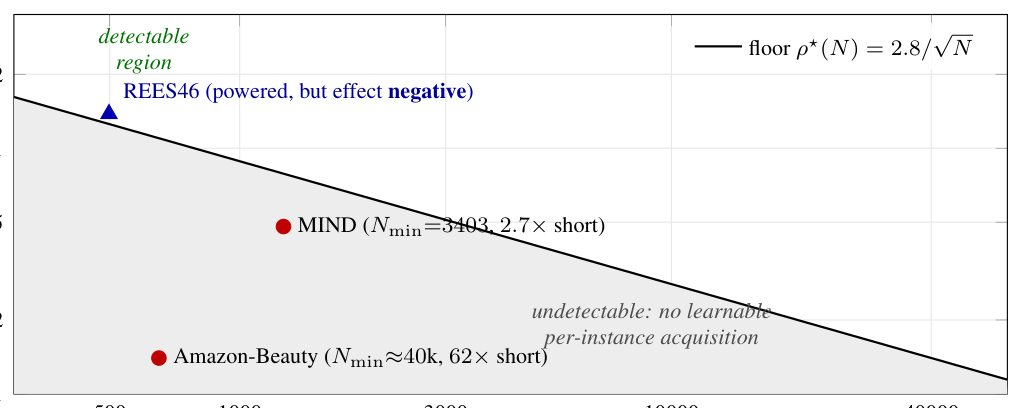
Figure 1 的三个落点是全文骨架:瓶颈不在 LLM 能不能推理,而在下游 reward 是否携带足够信号,让人学出"何时该获取那份推理"。
1.3 贯穿全文的诚实性声明¶
论文在引言挂了一条 honesty caveat:驱动研究的生产观测(结构化意图在冷启动/欠定场景帮助最大)是观察到的,不是受控的;公开数据研究只检验机制,并承诺在每处标出效应是"有方向但不显著"、"仅 in-sample"还是"在地板之下"。
1.4 五条贡献¶
- 一个诊断:跨 per-impression、cluster($K=4\text{–}64$)、regime、uplift tree 四种粒度、三个数据集,没有任何可部署策略显著优于随机;噪声安慰剂复现了 in-sample oracle 表面收益的 $\ge 100\%$——所谓可学结构是噪声顺序统计量。
- 一个解释:mean-detection $\ne$ policy-learnability,以及分开两者的地板 $\rho^\star(N)$,配正对照确认这是真的低 SNR 极限而非流水线坏掉。
- 一个具体载体 SHE:冻结 LLM 产出的排序 + 带置信度 + 带证据引用的假设,作 input-embedding 分支接入推荐器,配 cited-vs-non-cited 忠实度指标。
- 一个可执行处方:改为部署设计期 regime gate,四步 recipe,在 pooled-regime 层面验证。
- 一个可复现产物:58 条 claim 的 ledger + 一键离线复现。
2. 问题设定¶
2.1 形式化¶
设每个样本 $i$(一次 impression / 一个排序 slate)有一个用廉价特征的 base predictor,以及付出固定成本 $c$ 才能获得的昂贵观测 $o_i$。使用 $o_i$ 会把下游 reward $R_i$(本文取 slate 的 NDCG@10)改变一个逐样本的量:
$$\Delta_i = R_i(\text{with } o_i) - R_i(\text{without } o_i), \qquad \mu = \mathbb{E}[\Delta_i], \quad \sigma = \sqrt{\operatorname{Var}[\Delta_i]}, \quad \rho = \frac{\mu}{\sigma} \tag{1}$$
其中 $\rho$ 即reward SNR。一个获取策略
$$\pi:\ x_i \mapsto \{0,1\},\qquad \text{预算约束}\ \ b = \mathbb{E}[\pi] \tag{2}$$
只从廉价侧信息 $x_i$ 决定是否为 $o_i$ 付费。评估是:预算 $b$ 下用实现的系统 reward 对比随机获取基线,配 per-example bootstrap 95% CI,且永远 out-of-fold——策略绝不看到它正在决定要不要买的那个结果。论文强调分开两个问题:(a) 永远获取 $o_i$ 值多少(平均处理效应);(b) 何时该获取是否可学(异质策略)。理论(§8)针对 (b),推荐实验(§4–5)针对 (a)。
2.2 三个数据集:domain × content-richness 的 2×2¶
Table 1:三个公开数据集(各切片占比均从缓存假设重算;$\rho$ 是 §7 的逐样本 reward SNR)
| Dataset | Domain | Content | N | median |H| | multi-intent % | sparse % | $\rho$ |
|---|---|---|---|---|---|---|---|
| MIND | news | rich | 1263 | 20 | 45.7 | 14.0 | 0.048 |
| Amazon-Beauty | e-commerce | rich | 650 | 5 | 64.6 | 34.2 | 0.014 |
| REES46 | e-commerce | thin(87.9% single-cat) | 498 | short | — | — | 0.138 |
历史长度与 multi-intent 占比的巨大差异,正是让"价值 regime-conditional"这一结论能被分离的原因。
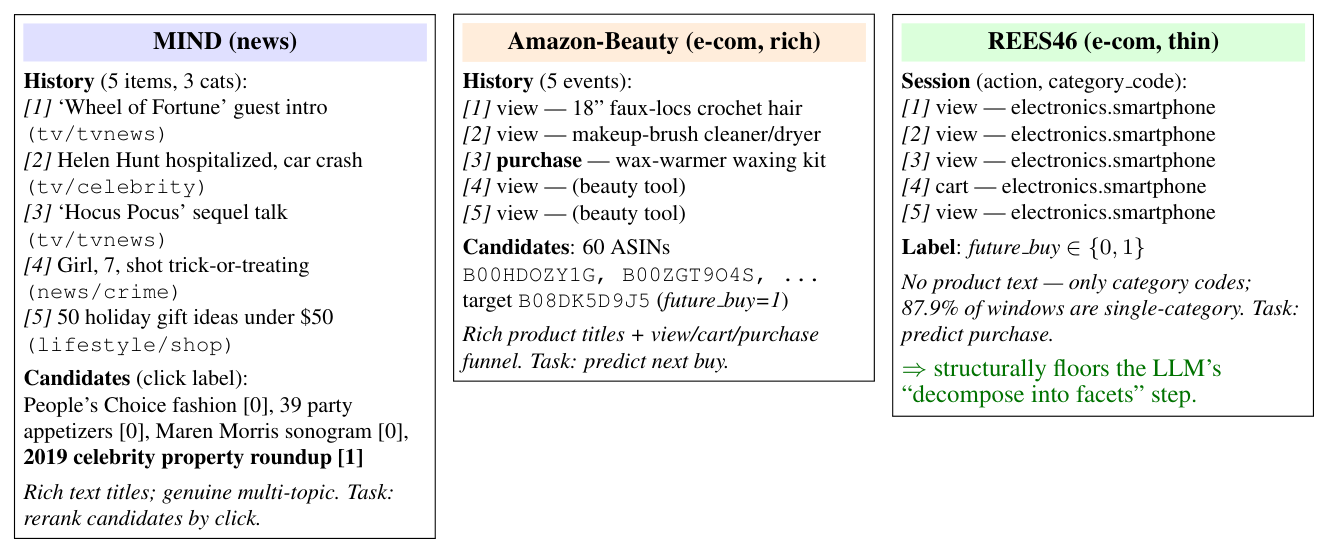
Figure 2 给出三条真实样本:MIND 是带品类的新闻标题(按点击重排候选);Amazon-Beauty 是 view/cart/purchase 漏斗 + 富商品标题(预测下一次购买,60 个 ASIN 候选);REES46 只有 view — electronics.smartphone 这类品类码,结构上就把 LLM 的"分解成 facet"这一步封死了。
Table 6:窗口构造
| MIND (news) | Amazon-Beauty | REES46 | |
|---|---|---|---|
| Domain | news reading | e-commerce | e-commerce |
| Target | candidate click | next-item slate | session purchase |
| Windows generated | 1,557 | 650 | 498 |
| History length | median 19, mean 23.6 | median 5 | median ~9 |
| Slate size (cap) | 40 candidates | 20 candidates | —(二分类) |
| sparse rule | $n_{\text{hist}}\le 5$ | $n_{\text{hist}}\le 5$ | $n_{\text{hist}}\le 5$ |
| multi rule | $\ge 8$ distinct cats | $\ge 2$ distinct subcats | (多为单品类) |
| Content richness | high(multi-topic) | high(titles) | low(87.9% single-cat) |
MIND 用 1,600 条 impression 的 cohort、stride 5、40 候选 slate 上限构造,为 1,557 个窗口生成假设。每个结果的 N 单独报告(ada-002 late-fusion N=1263,LSA backbone 研究 N=1411;Amazon 650;REES46 498),因为空 slate 或缺假设的窗口会被丢弃——但绝不按结果丢窗口。
3. 方法:Structured Hypothesis Embeddings (SHE)¶
3.1 结构化假设¶
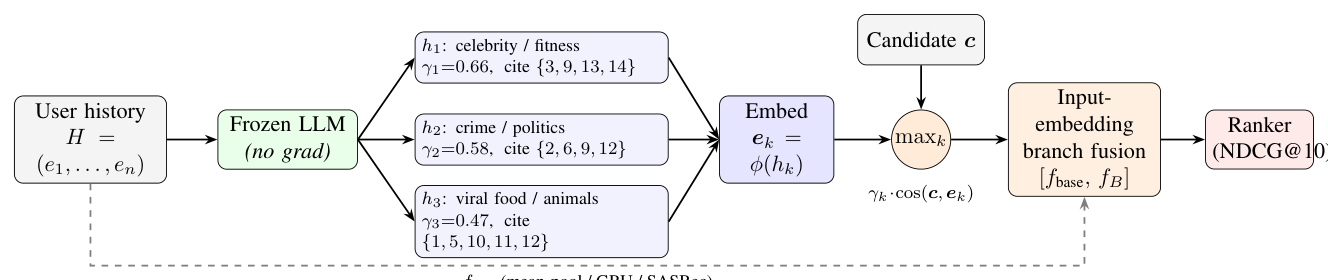
给定用户历史 $H=(e_1,\dots,e_n)$,一个冻结的 LLM 被提示产出 $K$ 条意图假设。每条 $h_k$ 是一句关于潜在兴趣的自然语言陈述,携带 (i) 可校准置信度 $\gamma_k\in[0,1]$,(ii) 一组证据下标 $E_k\subseteq\{1,\dots,n\}$,引用支持它的历史事件。本文取 $K=3$。这种 "Scheme B" 结构化输出与 "Scheme A" 单摘要基线相对照。
3.2 嵌入与打分¶
每条假设被嵌入 $e_k=\phi(h_k)$ 到固定文本嵌入空间($\ell_2$ 归一化,相似度即余弦)。对嵌入为 $c$ 的候选,SHE 分支产出一个小特征向量,主坐标是置信度加权的最佳 facet 匹配:
$$f^{\max}_B(c) \;=\; \max_{k\in\{1,\dots,K\}} \gamma_k \cos(c, e_k) \tag{3}$$
max-over-facets 这个聚合是全文的机关:它让候选匹配用户任意一个不相交的兴趣而非混合均值——这恰是单摘要(Scheme A)无法表达的:
$$f_A(c) = \cos\bigl(c,\ e_{\text{summary}}\bigr) \tag{4}$$
完整 SHE 特征块是一个无学习参数的固定宽度向量:
$$\Bigl[\underbrace{f^{\max}}_{\max_k \cos(c,e_k)},\ \underbrace{f^{\gamma}_{\max}}_{\max_k \gamma_k \cos(c,e_k)},\ \underbrace{f^{\text{mean}}}_{\frac{1}{K}\sum_k \cos(c,e_k)},\ \underbrace{\gamma_{k^\star}}_{\text{最佳 facet 的置信度}}\Bigr] \tag{5}$$
SHE 以 input-embedding 分支接入:下游模型收到 $[\,f_{\text{base}}(c),\ f_B(c)\,]$,$f_{\text{base}}$ 是廉价 backbone(mean-pool 历史相似度、ID 流行度特征,或有序序列模型的状态)。融合是 late 的,分支是冻结的,没有任何梯度回传进 LLM。
3.3 编码器 $\phi$ 的实例化¶
方法对编码器选择不敏感,论文刻意把结果表述在固定 $\ell_2$ 归一化空间而非具体模型上。MIND 与 REES46 用 text-embedding-ada-002($d=1536$,返回即归一化);Amazon-Beauty 用本地 256 维 TF-IDF + TruncatedSVD (LSA)(bigram TF-IDF,词表 $\le$ 20k,$\min_{df}=2$,sublinear tf)——因为 embedding-API 的 ACL 限制。同一数据集内候选物品、K 条假设、Scheme-A 摘要永远走同一个 $\phi$;论文从不跨空间比余弦值。
3.4 为什么"结构化"和"有据可依"重要¶
证据下标 $E_k$ 给出可检验的忠实度概念(§4):假设应与它引用的历史事件更相似、与没引用的更不相似;置信度 $\gamma_k$ 让人能校准、原则上也能门控。这两点都是结构的性质,而非某个具体嵌入模型的性质。
3.5 Agent 配置与 prompt 设计(附录 A)¶
Table 4:两种 scheme 的配置
| Scheme A(summary) | Scheme B(SHE, Top-3) | |
|---|---|---|
| Model | GPT-5.4 | GPT-5.5 |
| Reasoning effort | low | high |
| Output | {"summary": ...} |
{"hypotheses": [...]} |
| # hypotheses | 1(自由句) | 恰好 3,rank-ordered |
| Per-item fields | — | hypothesis, confidence, evidence indices |
| Fine-tuned? | 否(zero-shot) | 否(zero-shot) |
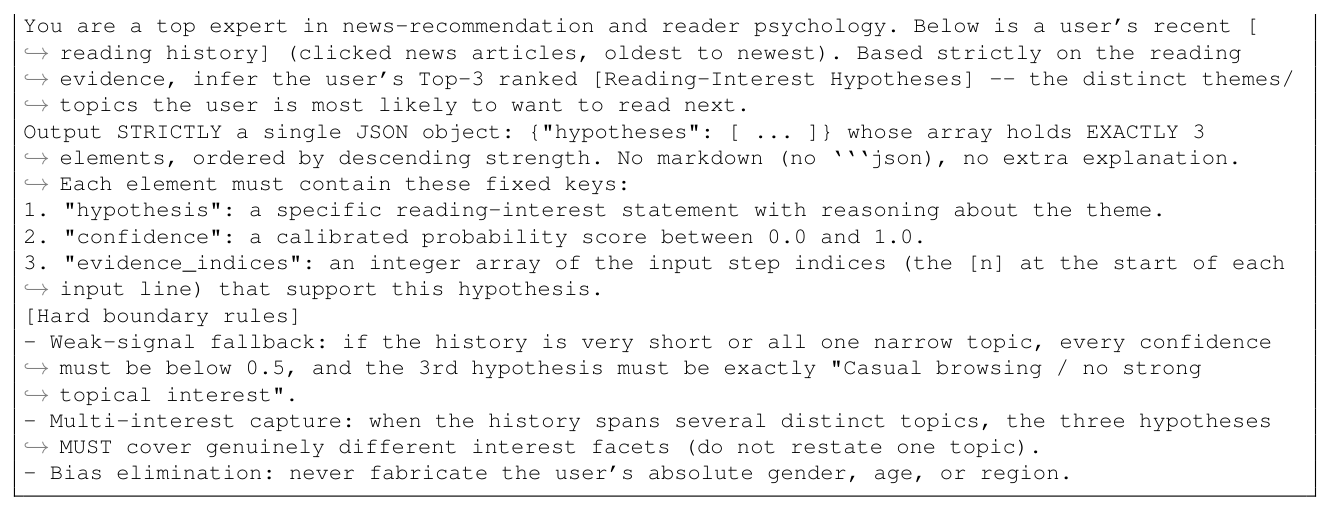
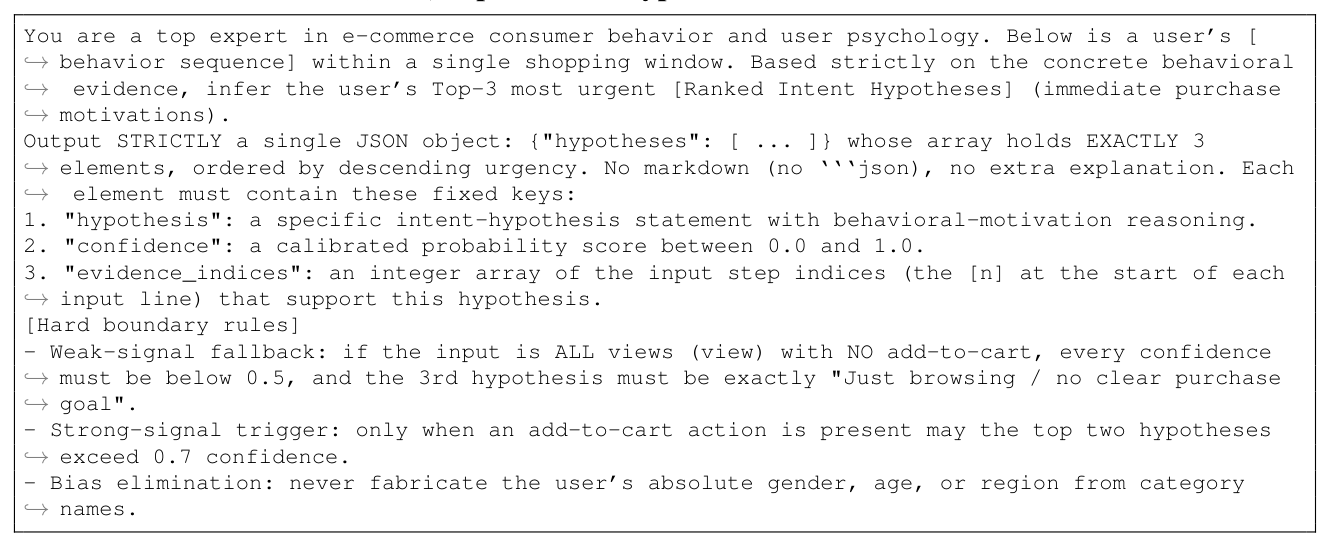
输入序列化:行为窗口被渲染成带编号的纯文本列表(电商 [i] <action>, category: <category_code>,新闻是"标题 + 品类"、从旧到新),使返回的 evidence indices 可被直接解释并对照被引步骤检查(即 §4 的忠实度测量)。
三条先验边界规则(同一 domain 内跨数据集一致):(1) 弱信号回退——窗口无信息时(全是 view 无 add-to-cart,或极短单主题历史),所有置信度必须低于 0.5,且第三条假设必须是固定字符串(电商 "Just browsing / no clear purchase goal",新闻 "Casual browsing / no strong topical interest");(2) 强度门——只有强行为触发(add-to-cart;新闻是多个不同主题)才允许把 top 假设推过 0.7,且多条假设必须覆盖真正不同的 facet;(3) 偏见消除——绝不能从品类名推断用户的绝对性别、年龄或地域。论文明确指出:正是这三条规则导致原始置信度"可用但过度自信"因而可被廉价后验校准,也让 Scheme B 产出不相交的证据 facet。
3.6 一个真实的定性例子¶
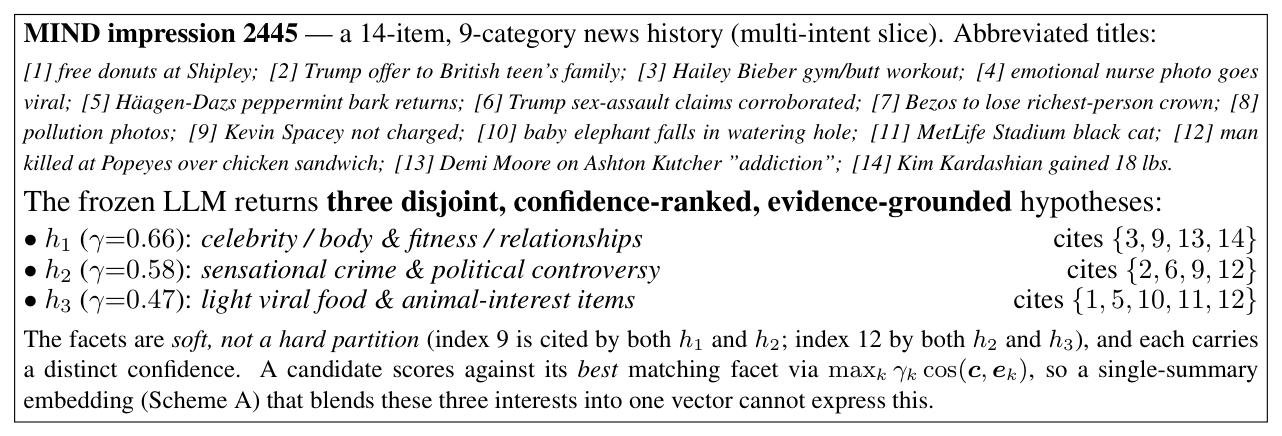
MIND impression 2445 是一段 14 条、9 品类的新闻历史,冻结 LLM 返回三条不相交、按置信度排序、有证据引用的假设:
- $h_1$($\gamma=0.66$):celebrity / body & fitness / relationships,引用 $\{3,9,13,14\}$
- $h_2$($\gamma=0.58$):sensational crime & political controversy,引用 $\{2,6,9,12\}$
- $h_3$($\gamma=0.47$):light viral food & animal-interest items,引用 $\{1,5,10,11,12\}$
facet 是软的而非硬划分(下标 9 被 $h_1,h_2$ 共引,12 被 $h_2,h_3$ 共引),且各带不同置信度。候选按 $\max_k \gamma_k\cos(c,e_k)$ 对最佳匹配 facet 打分,因此把三种兴趣混成一个向量的单摘要嵌入(Scheme A)无法表达这件事。
4. Agent 侧:假设本身的质量¶
在问"SHE 是否帮到推荐器"之前,论文先问"这些假设按自己的标准算不算好"。本节数字在 MIND 与 REES46 上算,指标是 $\ell_2$ 归一化嵌入上的余弦。
4.1 有据可依的忠实度(grounded faithfulness)¶
定义为一条假设与其被引历史事件 vs 未被引历史事件之间的配对余弦差:
$$\text{Faithfulness} = \mathbb{E}_{h_k}\Bigl[\ \overline{\cos(e_k, e_j)}\big|_{j\in E_k} \;-\; \overline{\cos(e_k, e_j)}\big|_{j\notin E_k}\ \Bigr] \tag{6}$$
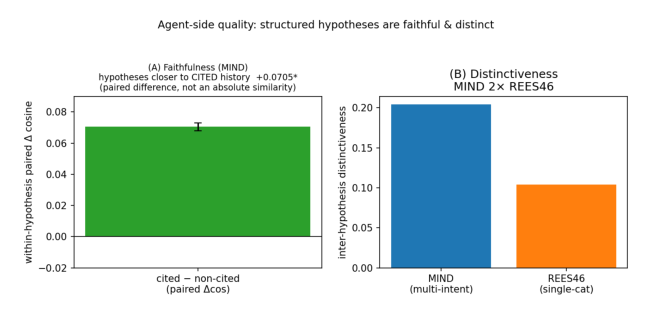
MIND 上这个配对差是 +0.0705(95% CI [+0.068, +0.073]):假设确实追踪它引用的证据。REES46 上(87.9% 窗口单品类)该差 $\approx 0$——符合预期,那里根本没有东西可分解。论文特别说明 Figure 5 刻意画成单个配对 $\Delta$ 柱 + CI 而非两根绝对相似度柱,以避免"未被引相似度为零"的常见误读。
4.2 区分度(distinctiveness)¶
在假设两两之间算 $1-\cos$:MIND 0.204 vs REES46 0.104。
$$\text{Distinctiveness} = \frac{2}{K(K-1)}\sum_{k<l}\bigl(1-\cos(e_k, e_l)\bigr) \tag{7}$$
在真正多意图的历史上,SHE 产出不相交的 facet(约薄内容数据集的 2×)。
4.3 校准(calibration)¶
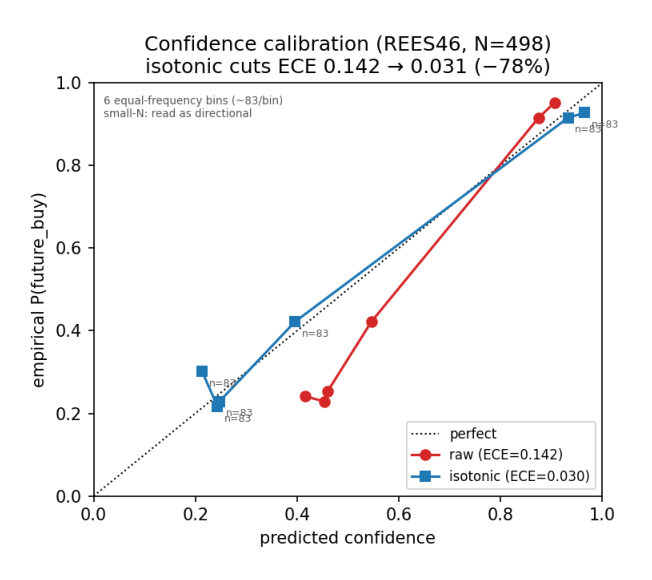
原始 top-1 置信度过度自信(REES46 上 ECE 0.142,Brier 0.166)。cross-fit isotonic 映射把 ECE 降到 0.031(−78%)——标准、诚实、可部署的后验修正。论文报告每 bin 计数(等频,约 83/bin)并标注该分析为小 N、方向性。
5. 下游价值是 backbone- 与 regime-conditional 的¶
SHE 能否改进推荐器?答案取决于它被融合到什么之上。
5.1 沿基线强度的冗余梯度¶
把 SHE 融合到逐级增强的 base 特征阶梯上,测 NDCG@10 的 +SHE 增益(GroupKFold-by-impression,class-balanced pointwise 逻辑回归,per-impression bootstrap CI)。MIND 上增益随 base 变强而单调下降:
| 阶梯 | Base 特征 | +SHE 的 NDCG@10 增益 | 显著性 |
|---|---|---|---|
| L0 | subcategory popularity | +0.0161 | 显著(*) |
| L1 | ID pair | +0.0146 | 显著(*) |
| L2 | ID + text | +0.0100 | 显著(*) |
| L3 | strong mean-pooled text | +0.0094 | ns(不显著) |
sparse 切片在阶梯弱端的起点约为全体的 3×。
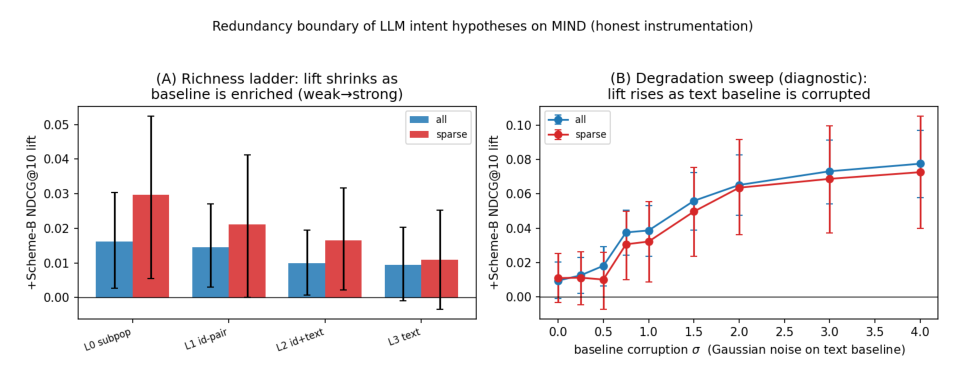
论文称之为"冗余边界"的诚实内核:SHE 的边际价值在强内容基线前缩小,但不会消失,且恰在行为信号欠定处最大。受控退化扫描(附录 D)佐证该梯度:往 base 特征注入 $\mathcal{N}(0,\sigma^2)$ 后重测 +SHE 增益,从 $\sigma=0$ 的 +0.0094(ns)平滑升到 $\sigma=4$ 的 +0.0775;论文标注为诊断性受控腐蚀,不是真实世界提升。
5.2 受控的 ordered vs unordered 测试¶
为专门问"有序序列访问是否让 SHE 变冗余",论文在 MIND 上跑 2×2(干净测试床:长的多主题历史,median $n=19$),固定 split、slate、labels 与 late-fusion ranker,只变两因子:(mean-pool vs GRU)×(no LLM vs +SHE)。因为 MIND 历史长且多主题,有序 GRU(0.3992)确实强于 mean-pool(0.3701)——这才是干净的 ordering 测试;Amazon-Beauty(median history 5,GRU 反弱于 mean-pool)无法隔离 ordering,只作附加检查放在附录 E。
Table 2:MIND 2×2(NDCG@10,N=1263;95% bootstrap CI)
| Quantity | Estimate | 95% CI | p |
|---|---|---|---|
| Mean-pool base (A) | 0.3701 | — | — |
| Ordered GRU base (C) | 0.3992 | — | — |
| +SHE over mean-pool | +0.0109 | [−0.0046, +0.0277] | 0.165 |
| +SHE over ordered GRU | +0.0114 | [+0.0030, +0.0209] | 0.005 |
| Redundancy gap (interaction) | −0.0005 | [−0.0164, +0.0150] | 0.919 |
对 Table 2 的解读刻意谨慎:有序访问并未全局吸收 LLM 信号——SHE 在有序 GRU 之上有显著增益(+0.0114,p=0.005),交互/冗余间隙统计上与零不可区分(−0.0005,p=0.919)。真正真实的是一个 regime split:
$$\text{Redundancy gap} \;=\; \bigl[R(\text{mean-pool}+\text{SHE}) - R(\text{mean-pool})\bigr] - \bigl[R(\text{GRU}+\text{SHE}) - R(\text{GRU})\bigr] \tag{8}$$
- sparse / short 历史上间隙为正(+0.033 / +0.022):吸收(absorption)——有序 backbone 已经把那点稀少的意图捕获了;
- long / multi-intent 历史上间隙反号(−0.006 / −0.005):互补(complementarity)——SHE 贡献了序列模型无法归并的语义结构。
因此 SHE 的价值是 backbone 强度 × 历史 regime 的函数,而非 ordering 本身。
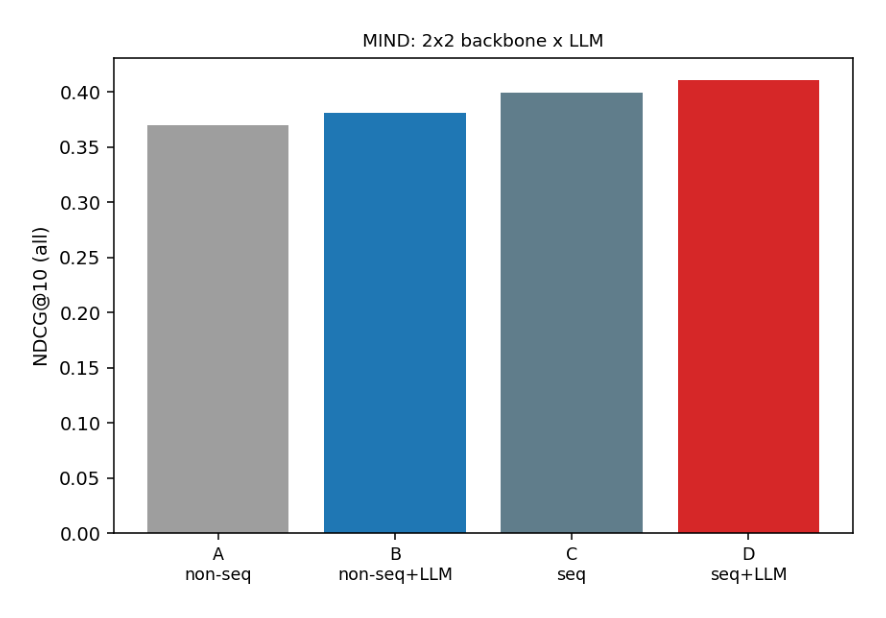
Figure 8 的四根柱(A 0.3701 / B 0.3810 / C 0.3992 / D 0.4106)把 2×2 直接可视化。
5.3 五项稳健性检查 B1–B5¶
| 编号 | 检查 | 结果 |
|---|---|---|
| B1 | 5-seed 扫描 | 每个 seed 都有 GRU > mean-pool,且 SHE 对 GRU 增益显著(+0.011 到 +0.023) |
| B2 | 退化扫描(full/truncate/shuffle/mean-pool) | SHE 增益稳定,只在有序 backbone 上可靠显著 |
| B3 | 残差化(SHE 投影到序列状态、只留残差) | 保留 101% 增益(raw +0.0114 → resid +0.0115);序列状态解释 SHE 特征的 $R^2\approx 0.00\text{–}0.01$,即 SHE 基本正交 |
| B4 | 冗余探针(用序列状态预测 SHE) | 所有切片 $R^2 \le 0.010$ |
| B5 | 结构不同的有序 backbone SASRec | 复现同样模式:SHE 对有序 SASRec 增益 +0.0179 [+0.0076, +0.0281],同样的 regime split |
论文对 B5 加了限定:SASRec 只是附加检查,不是一致更强的 backbone(0.3713 与 mean-pool 持平、低于 GRU;$N\approx 1.4$k 时注意力过拟合)。
5.4 Amazon-Beauty 的 backbone 检查(附录 E)¶
Amazon-Beauty(median history 5)上 GRU(0.4104)弱于 mean-pool(0.4777),有序访问没让 backbone 变强,故不能干净隔离 ordering。它与"富度梯度"一致:SHE 在弱的有序 GRU 上显著、在强 mean-pool 上冗余。
6. 学习"何时获取"在所有粒度上都失败¶
推荐器结果讲的是"永远获取 SHE"的平均价值。现在问获取问题:能否学一个逐样本策略,把固定预算花在 SHE 帮助最大的 impression 上?三个数据集、整条粒度轴上答案都是否定的。
6.1 Per-impression 粒度¶
学出来的 out-of-fold 策略(从廉价特征预测 $\Delta_i$,样本外行动)在任何预算下都不优于随机获取;uncertainty 与 sparse 启发式也不行。唯一的"赢家"是按实现 $\Delta_i$ 排序的 in-sample oracle——而匹配矩的 i.i.d. 噪声安慰剂复现了它表面收益的 $\ge 100\%$(MIND:+0.0518 = +0.0518)。它是噪声的顺序统计量,不是可利用的结构。
6.2 Cluster / regime / tree 粒度¶
论文测试了表征聚类(序列状态向量上 KMeans,$K=4,8,16,32,64$)、手工叉乘 regime、honest uplift tree,每种都配 per-fold EB-shrunk 簇均值与无标签的测试期分配。
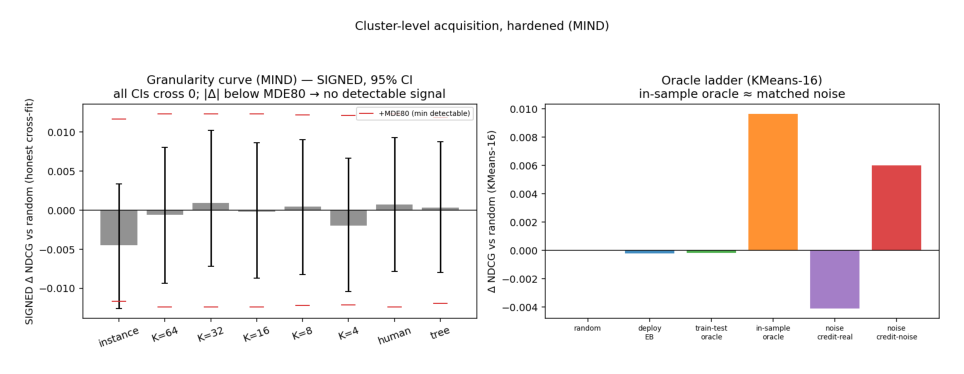
Figure 9 左图是 signed 粒度曲线:instance / K=64…K=4 / human / tree 的 95% CI 全部跨零,且 $|\Delta|$ 都低于各自 MDE80(红线约 ±0.0115)。右图是 KMeans-16 的 oracle 阶梯:random $\approx 0$、deploy EB $\approx -0.0003$、train-test oracle $\approx -0.0002$、in-sample oracle +0.0096、noise credit-real $-0.0040$、noise credit-noise +0.0060——匹配噪声能造出与 oracle 同量级的"收益"。
6.3 正对照:这不是流水线坏了¶
关键在正对照(附录 G):保持真实 folds/base/features 不变,只把 lift 换成可控 cluster-SNR 的合成信号,同一条可部署流水线在 cluster-SNR $\ge 0.20$(MIND)/ 0.35(Amazon)时确实能恢复信号;真实数据落在 0.075 / 0.056,低一个数量级。人工 regime 与随机旋转真簇的变体会移动阈值,但真实数据仍远低于所有阈值。功效分析进一步确认观测到的 $|d|$ 低于每种粒度自己的 MDE80,所以论文把结论表述为"在这些 N 下不可检测"而非"不可能"。
6.4 什么是可实现的¶
regime cell 均值合理且一致:dense-single $\approx -0.001$;multi-intent +0.0112;cold-start +0.0109。因为池化把 reward 噪声按 $\sqrt{n}$ 平均下去,一个设计期子系统切分(SHE 用在 cold-start / multi-intent、dense-single 跳过)可实现,即便逐样本策略不可实现。这就是可落地的单位。
7. 机制:三数据集的 reward-SNR 故事¶
为什么获取会坍缩?因为逐样本 reward 效应被埋在噪声里。跨 domain × content-richness 的三个数据集,reward SNR 都很小,结论一致:
- MIND(富内容新闻):微小的正向 per-impression 增益(+0.0094),$\rho=0.048$;
- REES46(贫内容电商):$\approx 0$ / 负的 per-window 增益(−0.0158;ROC-AUC 0.840 → 0.833,即 LLM 有害),$\rho=0.138$;
- Amazon-Beauty(富内容电商):接近零的增益(+0.0012),$\rho=0.014$(三者最低)。
三者都是:没有任何可部署的逐单元策略优于随机,且 in-sample oracle 间隙都被噪声安慰剂复现。 因此获取极限是一个机制(低 per-unit reward SNR),而非 MIND 特有的怪癖。论文同时提醒:它没有声称 MIND 上全局 backbone 冗余显著——全局间隙与零不可区分,只有切片提示 regime 依赖的吸收/互补。
Table 5:主控跨数据集汇总(MDE80 = 80% 功效下最小可检测效应;noise-repro% = 噪声安慰剂复现 in-sample oracle 的比例;pos-ctrl thr = 流水线能恢复合成信号的 cluster-SNR)
| Dataset | N | $\rho$ | instance $d$ | MDE80 | noise-repro% | pos-ctrl thr | real clust-SNR |
|---|---|---|---|---|---|---|---|
| MIND | 1263 | 0.048 | −0.0044 | 0.0124 | 62% | 0.20 | 0.075 |
| Amazon-Beauty | 650 | 0.014 | −0.0003 | 0.0075 | 242% | 0.35 | 0.056 |
Amazon-Beauty 上 noise-repro 高达 242%——噪声安慰剂造出的"收益"是 in-sample oracle 的 2.4 倍,把"oracle 间隙 = 可利用结构"这个直觉彻底证伪。
8. Reward–SNR 可检测性地板¶
8.1 命题¶
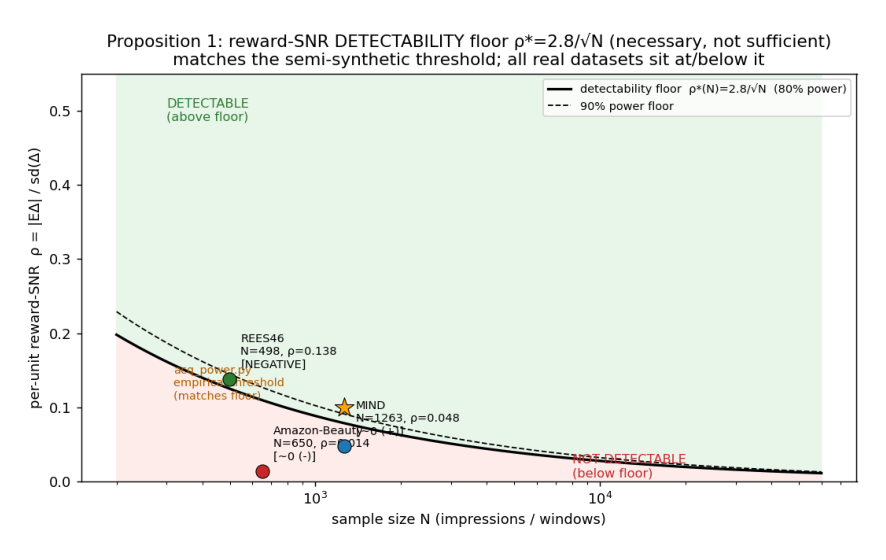
Proposition 1(reward–SNR 可检测性地板):在显著性 $\alpha$ 与功效 $1-\beta$ 下,从 $N$ 个样本、逐样本 SNR $\rho=\mu/\sigma$,检测昂贵观测对 reward 的逐样本效应 $\Delta_i$ 均值为正,要求:
$$\rho \;\ge\; \rho^\star(N) \;=\; \frac{z_{1-\alpha/2}+z_{1-\beta}}{\sqrt N} \;\approx\; \frac{2.8}{\sqrt N} \tag{9}$$
$$N \;\ge\; N_{\min}(\rho) \;=\; \left(\frac{z_{1-\alpha/2}+z_{1-\beta}}{\rho}\right)^{2} \;=\; \left(\frac{2.8}{\rho}\right)^{2} \tag{10}$$
在 $\alpha=0.05$、$1-\beta=0.8$ 时,$z_{1-\alpha/2}+z_{1-\beta}\approx 1.96+0.84=2.8$。
这是标准的单样本均值检测界,力量在于解释性:一个学习"何时获取"的策略至少必须先检测到它所条件的 reward 里有信号;连平均效应都在地板之下时,条件在同一噪声 reward 上的异质策略更加不可检测(a fortiori)。论文非常明确:式 (9) 是必要的均值可检测性条件,不是充分的策略学习/regret 界,也不是不可能性定理。
8.2 两条独立路线的一致性¶
两条独立路线对地板的估计在 1.3× 以内吻合:闭式给出 $\rho^\star(1263)=0.079$;半合成可学性扫描(注入特征可预测的效应、控制 SNR、测被捕获的 tau-oracle 比例)把阈值定位在 0.10 附近。
8.3 数据集落点¶
Table 3:数据集对照可检测性地板(论文刻意报告精确的数据集特定差距,而非"数量级"口号)
| Dataset | N | $\rho$ | $\rho^\star_{80}(N)$ | $N_{\min}$ | $\rho^\star/\rho$ | Effect |
|---|---|---|---|---|---|---|
| MIND | 1263 | 0.048 | 0.0788 | 3403 | 1.64 | $\approx 0$(正) |
| Amazon-Beauty | 650 | 0.014 | 0.1098 | 40000 | 7.85 | $\approx 0$(负) |
| REES46 | 498 | 0.138 | 0.1255 | 412 | 0.91 | 显著为负 |
MIND 在自己的 SNR 地板下方 1.64×(需约 2.7× 更多数据,$N_{\min}\approx 3400$);Amazon-Beauty 在下方 7.85×(需约 60× 更多数据)。REES46 是唯一 powered 的情形($\rho=0.138 > \rho^\star=0.126$)——而恰恰在那里效应显著为负。 论文强调这对诚实性至关重要:获取坍缩不只是"功效不足"的借口——唯一有足够功效的数据集显示获取的信号是净负的。
8.4 充分性一侧的检查:HTE-SNR(附录 H)¶
为堵上"更聪明的异质策略仍能赢"的漏洞,论文做了充分性侧检查:$\operatorname{corr}(\hat s_i,\Delta_i)$、out-of-fold $R^2$、以及对 200 抽置换零分布算的 heterogeneity-SNR,在两个数据集上全部落在零带内:
| Dataset | $\operatorname{corr}(\hat s_i,\Delta_i)$ | out-of-fold $R^2$ |
|---|---|---|
| MIND | −0.012 | −0.010 |
| Amazon-Beauty | +0.001 | −0.005 |
结论:没有可利用的可学异质性。
9. 部署处方、成本与超参数¶
9.1 四步 recipe¶
不要从有噪声的离线 reward 里学逐样本获取。 改用预先指定的设计期 regime gate:把 SHE 路由到 (a) 冷启动/欠定历史(吸收型价值),(b) 长的多意图历史(互补型价值)。这正是 §5 找到价值的两个 regime,且它们在设计期可寻址,因为池化会把 reward 噪声平均下去——逐 impression 的策略做不到。
具体四步:(1) 估计 $\rho$ 并用地板 $N_{\min}=(2.8/\rho)^2$ 检查,若 $N<N_{\min}$ 就不要尝试学逐样本 router(它只会拟合噪声顺序统计量);(2) 改为从廉价无标签的切片特征(历史长度、distinct-category 数、稀疏度)预先指定少量 gate,而不是从 reward 里学;(3) 只在上述两个价值 regime 内部启用昂贵信号;(4) 在 pooled-regime 层面用 out-of-fold 95% CI 验证 gate,永不在逐样本层面验证。
这把不可学的 routing 问题变成一次统计上被支持的一次性子系统放置决策。
9.2 设计期 gate 的实测结果(附录 L)¶
在 MIND(N=1263,强内容基线 $[f_{\text{hist}}]$ 之上):gate 对 86.4% 的窗口调用模型,与"到处都花"打平:
| 配置 | NDCG@10 | 相对 spend-everywhere | 相对 base ranker |
|---|---|---|---|
| base ranker($f_{\text{hist}}$) | 0.4458 | — | — |
| spend-everywhere(全量 SHE) | 0.4552 | — | +0.0094 [−0.0013, +0.0199] |
| design-time regime gate | 0.4554 | +0.0001 [−0.0038, +0.0042] | +0.0096 [−0.0004, +0.0194] |
论文在此非常克制:它并不声称有精度收益——在这个强基线上,设计期 gate 唯一被实现的收益是约 14% 的昂贵调用削减且无精度损失;它相对 $f_{\text{hist}}$ 的不显著本身就与地板一致。真正显著的价值结果是 §5 对有序 GRU 的增益(+0.0114,p=0.005)与 §4 的 agent 质量收益。
9.3 生成成本与延迟(附录 L)¶
LLM 每窗口只调用一次且从不微调,整套方法的成本就是这一趟生成,下游全是 CPU 秒级。这种不对称正是把"一条假设"当作昂贵语义观测的动机:问题不是要不要训练,而是这观测值不值得买。
Table 8:实测生成成本
| Scheme A | Scheme B | Per window (A+B) | |
|---|---|---|---|
| Model | GPT-5.4 | GPT-5.5 | — |
| Reasoning effort | low | high | — |
| Latency / call | ~2–3 s | ~6–17 s | — |
| MIND | — | — | ~19–23 s/win |
| Amazon-Beauty | 3.0 s (mean) | 8.6 s (mean) | 26.3 s/win |
端到端:Amazon-Beauty 的 650 个窗口在单 worker 上花 284.8 分钟;MIND 的 1,557 个窗口用 8 并行 worker 生成(约 63 分钟墙钟)。下游分析全部从缓存假设出发、CPU 秒级完成。
9.4 全部超参数(附录 K)¶
Table 7:下游超参数(ranker、backbone、LSA 空间均先验固定;GRU/SASRec 的输入是冻结的 LSA item 向量,只有序列组合参数被学习;所有 CI 用同一个 impression 级 bootstrap)
| Component | Setting | Value |
|---|---|---|
| Late-fusion ranker | model | logistic regression (pointwise) |
| regularization $C$ | 1.0 | |
| max iterations | 2000 | |
| class weighting | balanced | |
| feature scaling | StandardScaler,只在 train fold 上拟合 | |
| Evaluation | cross-fit | GroupKFold(5),按 impression 分组 |
| prediction | out-of-fold click probability → rank | |
| metrics | NDCG@10, Recall@10, MRR(per impression) | |
| confidence interval | bootstrap 95%,2000 次 impression 重采样 | |
| Item text space (LSA) | encoder | TF-IDF + TruncatedSVD |
| dimensions | 256(random state = 0) | |
| GRU backbone | hidden size | 64 |
| optimizer | Adam, lr $10^{-2}$, weight decay $10^{-4}$ | |
| epochs | 15, cross-fit (OOF) | |
| SASRec backbone | attention | 2 heads, 1 layer, max length 50 |
| hidden size | 64 | |
| optimizer | Adam, lr $10^{-3}$, weight decay $10^{-4}$ | |
| epochs | 15, cross-fit (OOF) | |
| Robustness (B1–B5) | seeds | $\{0,1,2,3,4\}$ |
卫生:没有任何东西回传进 $\phi$ 或 LLM;标准化统计量只在训练 fold 上拟合(cross-fit),REES46 的 1536 维假设嵌入在低 N 探针前先做 PCA 降维。
10. 核心贡献总结¶
- 概念层:把"检测均值效应"与"学习逐样本获取策略"显式分开,指出后者的可估计性由 reward SNR 决定;这个区分适用于任何"付费思考(pay to think)"的流水线,不限于推荐。
- 理论层:$\rho^\star(N)\approx 2.8/\sqrt N$ 是极廉价的 pre-flight 检查——只需 $\mu,\sigma,N$ 三个数就能在做任何 routing 工程前判断值不值得试。
- 证伪方法层:匹配矩噪声安慰剂——任何 in-sample oracle 的表面收益都应先跟同均值同方差的纯噪声比一比。
-
排除法层:正对照堵死"null 是因为流水线坏了"这一辩护;叠加 MDE80 功效分析,把结论限定为"在这些 N 下不可检测"而非"不可能"。
-
工程处方层:把不可学的逐样本 routing 换成设计期 regime gate,配四步 recipe 与 pooled-regime 验证协议。
- 载体层:SHE 给出一个可校准、可做忠实度检验的结构化 LLM 特征块,及 cited-vs-non-cited 配对差这一可复用的忠实度指标。
与已归档相关工作的对比¶
FGPD FGPD: From Understanding to Action(快手 / 华中农业大学 / 复旦,2026-07-30)¶
关系:独立并发(本文未引用 FGPD,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇标题几乎是同一句话的两种写法。FGPD 把"LLM 能理解用户在找什么,但这不等于知道该推什么"命名为 Understanding–Action Gap;本文的论点是"检测到信号平均有用,不等于学会逐样本该不该用它"。同一个 root cause:语言上合理的 LLM 语义产物与结果层面可执行的决策之间,隔着一道必须用 outcome 反馈才能跨过的鸿沟。
- 相近的技术骨架:LLM 侧产物几乎同构——FGPD 的 policy agent 从历史前缀—后继转移生成 $K$ 条个性化策略假设(各带推荐方向与拒绝边界),本文 Scheme B 产出恰好 3 条排序、带置信度、带证据下标的意图假设。两者都把 LLM 限制在离线 teacher 角色,都用冻结语义编码器把假设映射进固定空间后算余弦。
- 本文的差异与推进:分歧点正落在 FGPD 的关键步骤上。FGPD 的 advantage-based policy evaluation 用 $A_{u,k}=\cos(\mathcal{E}(\widehat M_{u,k}),\mathcal{E}(M_u^+))-R_{u,0}$ 筛假设,只保留相对 intent-only baseline 实测增益为正的候选,再取 $\arg\max_k A_{u,k}$ 进入下一轮。本文的核心结论恰恰是:当逐样本 reward 效应 SNR 低于 $\rho^\star(N)$ 时,"按实测增益挑最好候选"本身就是在拟合噪声顺序统计量——本文的 in-sample oracle 正是这种 $\arg\max$,噪声安慰剂能复现它 62%–242% 的表面收益。本文因此给这类范式加了一道必须先过的功效前提。
- 可比的方法/实验差异:FGPD 用语义相似度而非 Recall@K/NDCG@K 做筛选 reward(排名指标对迭代精炼太稀疏),实际上是在提高 reward 分辨率、降低 $\sigma$,与本文处方同向,只是 FGPD 从未量化自己的 $\rho$;且它有快手本地生活广告 7 天线上 A/B(Revenue +4.506%、ADVV +4.621%),样本量远超本文的 $N=498\text{–}1263$,可能天然处于地板之上。
AdaGRPO AdaGRPO: Adaptive Loss Balancing for Noise-Robust GRPO(JD.com / 早稻田 / 电子科大,2026-06-07)¶
关系:独立并发(本文未引用 AdaGRPO,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇都拒绝"设计更强的信号",转而问"这个信号什么时候可信"。AdaGRPO 的点睛句是"中心挑战不在设计更强的奖励,而在辨别奖励信号何时可被信任";本文是"瓶颈不在 LLM 能不能推理,而在下游 reward 是否携带足够信号"。root cause 都是逐样本 reward 信号质量的异质性,而非模型容量。
- 相近的技术骨架:两者都造一个逐样本二值门决定昂贵/有风险的信号是否被采纳。AdaGRPO 的目标是 $L_i=L_{\mathrm{NLL}}^{(i)}+\lambda\alpha_i L_{\mathrm{GRPO}}^{(i)}$,$\alpha_i\in\{0,1\}$ 由 policy-side difficulty $f_1$ 与 reward-model discriminability $f_2$ 两个 rank-based 诊断合取给出,不通过者退化为纯监督更新;本文的 $\pi:x_i\mapsto\{0,1\}$ 决定是否为昂贵 LLM 观测付费,不获取者退化为纯 base backbone。连"退化到一个稳定锚"的结构都一致。
- 本文的差异与推进:关键分野是门控信号从哪来。AdaGRPO 的诊断完全从当前样本自己的 rollout group($K$ 条 rollout + $M=5$ 条对比负例)现算,等于为每个样本做一次小规模重复测量,实例内部就有多个观测把噪声压下去;本文的获取门只能从离线日志里每样本一条带噪 reward 估计,$\Delta_i$ 无法重复测量,整条估计链被 $\rho$ 与 $N$ 卡死。推进在于:同一个"逐样本门"的想法,成败取决于能否在实例层面把 $\sigma$ 降下来。
- 可比的方法/实验差异:AdaGRPO 的门是无成本的(复用已物化的 rollout group),本文的门本身就是为了省下 6–17 秒/次的 LLM 调用——AdaGRPO 有本钱去测信号质量,本文场景里"测信号质量"和"使用信号"同样昂贵,这正是获取问题比训练门控更难的结构原因。
How Far Can Unsupervised RLVR Scale LLM Training? How Far Can Unsupervised RLVR Scale LLM Training?(清华 / 上海 AI Lab / SJTU 等,ICLR 2026,2026-03-09)¶
关系:独立并发(本文未引用该工作,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇都是"先证伪、再给廉价判据"的负结果论文,root cause 同构:当驱动学习的信号里没有足够新信息时,优化会去放大噪声/先验,早期的表面收益是假的。 URLVR 那篇证明所有 intrinsic reward 本质上在最小化同一个 sharpening loss 因而必然 rise-then-fall;本文证明地板之下的 oracle 收益是噪声顺序统计量。两者都在反对同一种误读——"指标涨了,所以这里有可学的结构"。
- 相近的技术骨架:核心交付物都是一个廉价的 pre-flight 指标,在投入昂贵训练/工程之前预测这条路能不能学。URLVR 那篇提出 Model Collapse Step(intrinsic URLVR 训练时 Reward Accuracy 首次跌破 1% 的步数),比全量 RL 的 GT Gain 便宜 5.6× 且无需 ground truth;本文是 $\rho$ 对 $\rho^\star(N)$ 的对照,只需三个数。两者也都配了结构性替代方案而非止步唱衰:前者指向 external reward,本文指向设计期 regime gate。
- 本文的差异与推进:URLVR 那篇的指标是经验相关性(7 个模型上 Collapse Step 与 AIME24 GT Gain 秩序强相关:OLMo-2-7B 34 步/+0.42,Qwen3-8B-Base 383 步/+17.08),需要真跑一段 RL 才能读数;本文的地板是闭式的,且两条独立路线交叉验证到 1.3× 以内(闭式 $\rho^\star(1263)=0.079$ vs 半合成扫描的 0.10),并多做了正对照证明 null 不是流水线坏了。反过来,URLVR 那篇给出了本文缺的东西:一个为什么信号会失效的生成式解释(sharpening),而本文的地板只是功效层面的必要条件,不解释 $\rho$ 为什么这么低。
- 可比的方法/实验差异:URLVR 那篇发现"小数据集($\le 128$ 样本)不会崩,适合 test-time training",是规模下界式安全区;本文的 $N_{\min}$ 是规模上界式门槛。合起来是个张力:对 intrinsic-reward RL 样本少反而安全,对离线 acquisition policy 样本少直接判死刑——前者失败模式是过度优化,后者是把噪声当结构。
被剔除的近似候选:[2608.08889] Netflix 主观任务 RLVR(问题很近且也做 reasoning routing,但解法是奖励整形 + 人格路由,无功效机器,root cause 是"rubric 主观"而非"SNR 低于 N 能分辨");[2608.00816] Exp-RSFT(共享离线带噪 reward 设定且有显式 noise cost 项,但 recipe 是训练目标——在噪声中照样学,而非先检验能不能学);[2604.05309] SSS 可复现性研究(人为产物来自评测协议泄漏而非 reward 噪声,无 SNR/功效机制);[2604.07851] ReRec / [2605.17648] SAPO(仅"reward 设计"这层宽泛共性,方向相反)。
讨论与局限性¶
核心贡献与值得借鉴的设计¶
这篇论文最大的价值不在 SHE,而在于它给"LLM 作为昂贵特征"这一整类流水线立了一条必须先过的功效关卡。近两年大量工作的叙事都是"让 LLM 产出语义信号 → 它平均提升了指标 → 因此再学一个 router 只在有用处调用它",本文指出这条链的第三环有一个隐含前提,而它在小样本离线评测里几乎总是不成立。三个可直接搬走的工具:
- 匹配矩噪声安慰剂:任何 in-sample oracle 的收益都必须先和同均值同方差的纯噪声比一比。Amazon-Beauty 上 242% 的复现率说明"oracle 看起来有 0.0X 空间"在低 SNR 下完全没有信息量。
- 正对照:在真实 folds/base/features 上注入可控 SNR 的合成信号,测出流水线能恢复信号的阈值(MIND 0.20 / Amazon 0.35),对照真实值(0.075 / 0.056)——远比单纯报告 "p > 0.05" 有力。
- $N_{\min}=(2.8/\rho)^2$ 的餐巾纸计算:写任何 routing 代码前先算这个数——$\rho=0.05$ 需约 3.1k 样本,$\rho=0.014$ 需 4 万样本。
还有一处特别诚实的做法:作者在设计期 gate 那节明确写下"我们不声称这里有精度收益",只承认 14% 的调用削减,并指出这个不显著本身就与地板一致——把自己的正面结果也放在同一把尺子下称。
存在的局限与争议¶
- 地板本身是已知的一阶统计结论。式 (9) 就是标准单样本 $z$ 功效公式,论文自己也承认 "its force here is interpretive"。真正的贡献是把它挂到 acquisition policy 语境上并做实证证伪,而非数学新意;审稿人完全可以质疑一条标准功效公式能否撑起论文的核心命题。
- 必要条件与充分条件之间有真实缝隙。"均值检测不到 ⇒ 异质策略更检测不到"的 a fortiori 论证直觉上成立但非严格定理——原则上可构造均值为零而异质性很强(正负各半)的分布。论文用附录 H 的 HTE-SNR 检查在这两个数据集上堵住了漏洞,但那是实证的、不是理论的。
- 样本规模全线偏小,单作者、无工业验证。$N=498/650/1263$。论文的核心主张恰恰是"$N$ 不够就学不出来",而它自己所有实验也都在这个量级上——"获取不可学"与"这个实验太小"很大程度上是同一件事的两种说法。它用 REES46(唯一 powered、效应显著为负)反驳"这只是功效借口",但REES46 恰是三者中内容最薄的(87.9% 单品类),SHE 在那里本就没有可分解的东西,论据说服力被数据集选择削弱。
- 跨编码器空间不一致。Amazon-Beauty 因 API ACL 改用本地 256 维 LSA 空间。论文 flag 了并禁止跨空间比余弦,但这意味着它极低的 $\rho=0.014$ 可能部分来自更弱的编码器而非更弱的信号,直接影响"62× 数据缺口"这个最惊人的数字。
- SASRec 的角色被弱化。$N\approx 1.4$k 上 SASRec(0.3713)低于 GRU(0.3992),论文诚实地降级为"附加检查",但这说明 backbone 阶梯的强度天花板受限于数据规模——若更大数据上 SASRec 真的更强,§5.2 的冗余间隙结论未必稳定。
- 动机来自未受控的生产观测。全文最有商业吸引力的主张(冷启动子系统该上 SHE)并没有被本文实验证实——§6.4 的 regime cell 均值(cold-start +0.0109、multi-intent +0.0112)统计上同样落在噪声带里,只是因为池化才"可实现"。
- 可扩展性上无明显瓶颈,但也没有 scaling 叙事。SHE 分支冻结、无学习参数、late fusion,不阻碍下游 backbone 扩容;但它也不会随 backbone 变大而更有价值——§5.1 的冗余梯度恰恰显示 base 越强边际价值越低。长期上限取决于 LLM 假设能否表达强 backbone 学不到的东西,本文的答案是"只在长多意图历史这一个 regime 里能"。
对工程实践的直接含义¶
对任何做 LLM 信号路由、级联取舍、"按需调用大模型"的团队,本文的约束可操作:先用生产历史数据估 $\mu,\sigma$,算 $N_{\min}=(2.8/\rho)^2$,再决定要不要立"学一个 router"这个项目。 工业场景通常远大于 1263,所以结论不应读成"逐样本 router 永远学不出来",而应读成"在你手上这份离线评测集上,你以为验证过的那个 router 很可能只是在拟合噪声"。被证伪的不是 routing,而是用小规模离线 reward 数据去验证 routing 的做法。