X-MoD: Practical Scaling Laws for Sparse-Depth Routing Beyond Mixture-of-Depths
清华大学 + 天津大学,arXiv 2609.34212v1 [cs.LG],2026-09-28 提交(CC BY 4.0)。共同一作 Bowen Dong(清华)、Yilong Fan(天大);通讯作者 Jianyong Wang(清华)。匿名代码:anonymous.4open.science/r/X-MoD/。
版本说明:arXiv 对这篇论文只提供 HTML 版,PDF 与源码入口都返回 "File unavailable"。本目录的 document.pdf 是用无头 Chrome 把官方 HTML 渲染出来的版本;图片直接取自 HTML 原件(Figure 1/3/5 是 SVG,转成了 PNG;Figure 2/4 是原始 PNG)。精读以 HTML 正文为准,公式取自其中的 LaTeX alttext。
研究动机与背景
扩大模型容量一直是提升语言模型最可靠的手段之一。稠密 Transformer 的 scaling law(Kaplan et al., 2020;Hoffmann et al., 2022)说明模型规模、数据量与训练算力之间有很规整的关系。MoE(Shazeer et al., 2017;GShard;Switch;DeepSeekMoE)则证明总参数量与每样本计算量不必同步增长:每个输入只激活一部分参数,就能在 FLOPs 不成比例增加的前提下大幅扩容。作者由此对「沿深度方向的 token 路由」提出两个问题:
Can sparse-depth architectures achieve a similar decoupling between total and active capacities? Can we derive practical scaling laws that guide their design?
Mixture-of-Depths(MoD,Raposo et al., 2024)在深度方向做条件计算:每个稀疏层只让一部分 token 进入,其余 token 通过恒等路径跳过。原论文效果最好的配置是稀疏层与稠密层交替。作者认为这恰恰从根本上限制了稀疏深度的扩展:层大小相同时,总参数与激活等效参数之比始终小于 2,没法像 MoE 那样激进地扩总容量。要打破这个上限,就得把更多稀疏层连着堆起来,这又带来两个新问题:
- 更新集中:长稀疏栈会让参数更新反复落在一小撮 token 上(token collapse);
- 上下文缩减:token 稀疏度越高,每个稀疏层里能参与注意力的上下文越少。
所以作者认为,扩展稀疏深度同时需要一个可训练的架构和一条在容量与上下文之间取舍的规则。
本文与相邻方向的分界划得比较清楚:多模态模型里的 MoD 式视觉 token 稀疏化(MoMa、p-MoD 等)、微调或推理期的 token 跳过与层剪枝(LayerSkip、Shortened LLaMA、D-LLM)、稀疏注意力、循环/递归深度(Mixture-of-Recursions、Inner Thinking Transformer、TRM 等)以及 null-expert 式 token 跳过(MoE++、LongCat-Flash),在作者看来都是减少或复用计算,而不是研究「固定激活等效预算下如何扩大稀疏深度的总容量」。MoE 方面已有不少区分总参数与激活参数的 scaling law(Clark et al., 2022;Krajewski et al., 2024;Abnar et al., 2025;Ludziejewski et al., 2025 等),稀疏深度的 scaling 则基本空白。
三条贡献:
- 架构:X-MoD 把 token 稀疏度 $K$ 与锚点步长 $A$ 变成两个可以独立调节的量,推广了 MoD,使总参数与激活等效参数之间的差距可以拉得大得多;
- Scaling law:把稀疏深度路由表述为一个条件架构设计问题,用「相对 FLOP 匹配稠密基线的残差」建立实用 scaling law,刻画总容量、稀疏层上下文与锚点步长;
- 实证:用留出的 scaling-law 预测、试点选出的配置、消融、下游评测,以及与 Dense / MoD / 代表性 MoE 的比较来验证架构和定律。
核心方法:X-MoD 架构
原始 MoD 的结构上限
原始 MoD 严格地稠密–稀疏交替:
$$([Sparse(K)]+[Dense])_{\times N} \tag{1}$$
其中 $[Sparse(K)]$ 表示只处理 top-$\frac{1}{K}$ 比例 token 的稀疏层,其余 token 经恒等路径绕过该层。
这种设计对训练稳定很有效:每个稀疏层后面紧跟一个稠密层,恢复全 token 之间的通信,缓解稀疏路由沿深度堆叠时的 token 失衡与梯度不稳定。但同一个交替结构也卡住了稀疏化的上限:每个稀疏–稠密对里,每个 token 平均激活 $1+\frac{1}{K}$ 层,而总参数是 2 层,所以总/激活比为
$$\frac{2}{1+1/K}=\frac{2K}{K+1} \tag{2}$$
$K$ 再大,这个比值也到不了 2。Raposo et al. 在这一受限设定下报告的最优值约为 $K=8$,对应比值 $16/9\approx1.78$。于是和 MoE 不同,固定一稀疏一稠密模式的 MoD 没法在激活容量大致不变的前提下持续增加总容量,预训练可扩展性受限。
X-MoD:把 token 稀疏度 K 与锚点步长 A 解耦
作者把 MoD 推广成一个稀疏度与稀疏深度密度都能独立控制的层级结构:
$$[Dense]_{\times N_{0}}+\left([Sparse(K)]_{\times AK}+[Dense]\right)_{\times N_{1}} \tag{3}$$
- $N_0$:开头的稠密前缀层数;
- $N_1$:稀疏–稠密块的个数;
- $A$:锚点步长(anchor stride),稠密层充当「锚点」。
直观地说,$A$ 控制一个 token 在相邻两个稠密锚点之间平均会被稀疏层精炼多少次:每个稀疏层只激活 $\frac{1}{K}$ 的 token,两个锚点之间放 $AK$ 个稀疏层,平均每个 token 在一个块里得到 $AK\cdot\frac{1}{K}=A$ 次稀疏更新。
记一个稠密 Transformer 层的参数量为 $N_{\mathrm{layer}}$,X-MoD 的总参数量为
$$N(K,A)=N_{\mathrm{layer}}\bigl(N_{0}+N_{1}(1+AK)\bigr) \tag{4}$$
激活等效参数量(一个 token 平均经过的参数量)为
$$N_{\mathrm{act}}=N_{\mathrm{layer}}\bigl(N_{0}+N_{1}(1+A)\bigr) \tag{5}$$
总/激活比 $N(K,A)/N_{\mathrm{act}}$ 在 $A$ 固定、稀疏主干占主导时近似随 $K$ 线性增长。这就是 X-MoD 能进入原始 MoD 够不到的稀疏深度区间的核心性质。
主对比里的两个配置都把激活等效深度定在 28 层(与 28 层稠密骨干相同):A4K8 物理上有 161 层,A3K16 有 298 层。以 936M 规模为例,总参数分别是 4.52B 和 8.24B,是激活等效参数的 4.8 倍和 8.8 倍;原始 MoD 只有 1.48B(1.58 倍)。
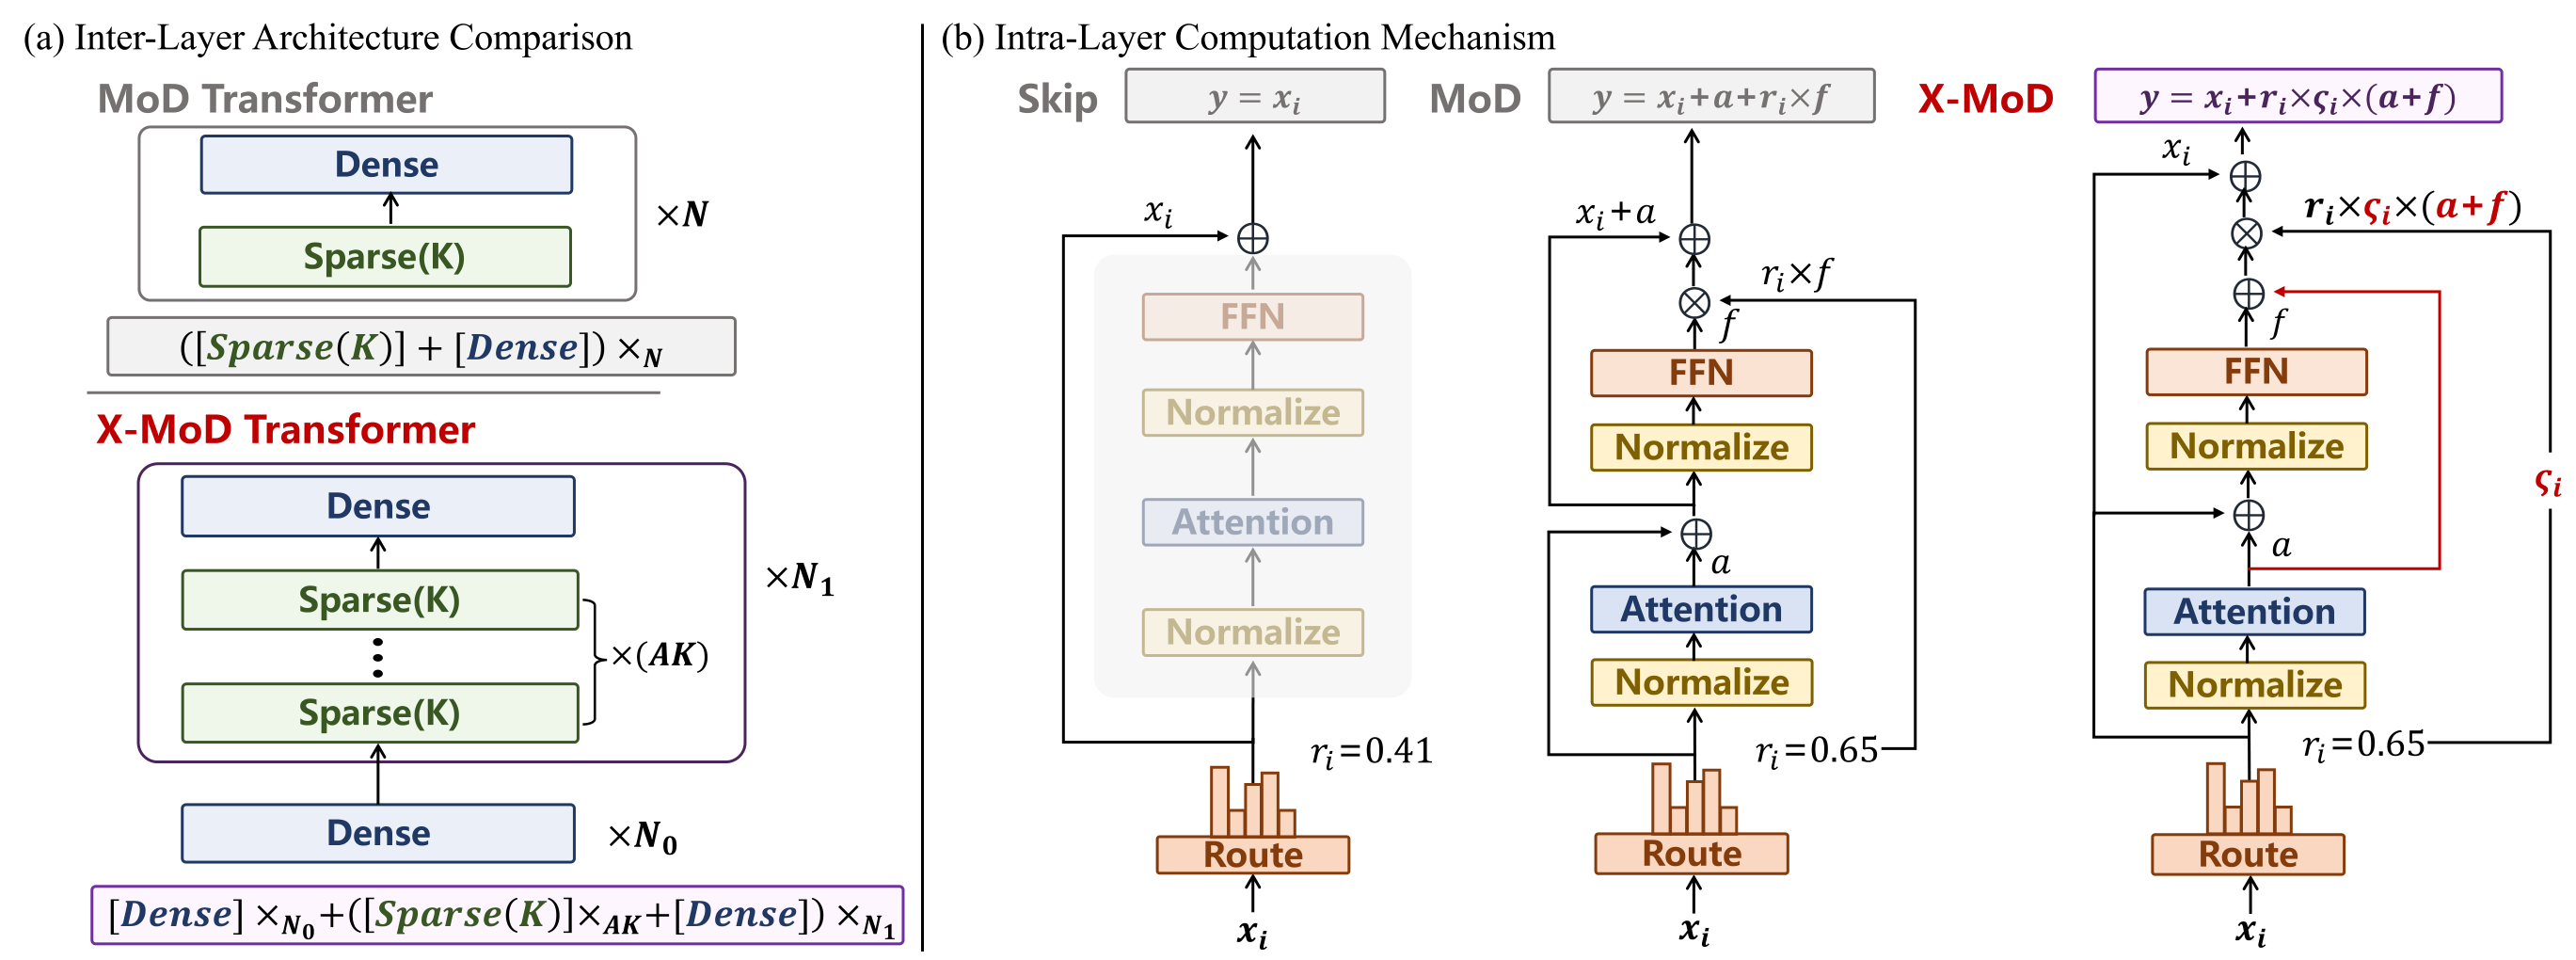
图 1(a) 对比了两种层间结构:MoD 是 $([Sparse(K)]+[Dense])_{\times N}$,X-MoD 是稠密前缀 $\times N_0$ 加上 $N_1$ 个「$AK$ 个 $Sparse(K)$ + 1 个 Dense」块。图 1(b) 对比了层内计算:Skip 路径 $y=x_i$;MoD 是 $y=x_i+a+r_i\times f$,路由分数只乘在 FFN 输出上;X-MoD 是 $y=x_i+r_i\times\varsigma_i\times(a+f)$,路由分数和可学习缩放一起乘在整层残差上。
让深层稀疏堆叠可训练的三个稳定器
总/激活比越大,X-MoD 越可扩展;但在稠密锚点之间堆很多稀疏层,会带来优化不稳定和 token 路由失衡。作者加了三个轻量稳定器,再加上稠密锚点本身,消融时一共是四个组件。
(i) 带方差缩放的逐层门控。记 $x_i^{\ell}$ 为稀疏层 $\ell$ 选中的 token,$a_i^{\ell}$、$f_i^{\ell}$ 分别为注意力残差与 FFN 残差,$r_i^{\ell}$ 为路由分数。原始 MoD 只用路由分数给 FFN 残差加门控,注意力残差不缩放直接注入:
$$x_{i,\text{MoD}}^{\ell+1}=x_{i}^{\ell}+a_{i}^{\ell}+r_{i}^{\ell}\odot f_{i}^{\ell} \tag{6}$$
X-MoD 改成给整个被选中层的残差加门控,并乘一个逐层可学习标量 $\varsigma^{\ell}$:
$$x_{i,\text{X-MoD}}^{\ell+1}=x_{i}^{\ell}+\varsigma^{\ell}\,r_{i}^{\ell}\odot(a_{i}^{\ell}+f_{i}^{\ell}) \tag{7}$$
这样被路由的计算在注意力与 FFN 两部分上口径一致;几十上百个稀疏层叠加时,$\varsigma^{\ell}$ 负责稳住残差流的方差。
(ii) 深度方向的 token 均衡(token-choice bias)。稀疏深度堆叠的第二种失败模式是 token collapse:连续的稀疏层反复选中同一小撮 token。为抑制这一点,作者在一个稀疏–稠密块内跨稀疏层传播一个 token 级偏置。记 $s_i^{(\ell)}$ 为 token $i$ 在稀疏层 $\ell$ 的路由 logit,在做 top-$\frac{1}{K}$ 选择之前把它调整为
$$r_{i}^{(\ell)}=\mathrm{sigmoid}\!\left(s_{i}^{(\ell)}-\tau b_{i}\right) \tag{8}$$
每当 token $i$ 被选中,$b_i$ 就增加,到下一个稠密锚点时清零。这样能抑制重复选择,又不强制均匀路由。(正文和附录都没有给出 $b_i$ 每次的增量和 $\tau$ 的取值。)
(iii) 非对称层级。前 $N_0$ 层保持稠密,只在更深的层引入稀疏深度路由。依据是经验观察:浅层主要构建稳定的词法、句法表示,深层更适合做条件计算和针对个别 token 的精炼。主对比配置里 $N_0=4$。
训练时 top-k、评估时因果阈值
沿用 MoD 的做法,MoD 与 X-MoD 在训练时用非因果的 top-$k$ 路由:需要看整条序列的路由分数才能排序,自回归部署时用不了。评估时换成可部署的因果阈值规则:一个 token 的路由概率不低于 0.5 就进入稀疏层。为了让训练期的 top-$k$ 决策与这个阈值对齐,作者在 top-$k$ 选择目标和阈值预测之间加了一个二元交叉熵辅助损失:
$$\mathcal{L}_{\mathrm{route}}=-\frac{1}{n}\sum_{i}\left[q_{i}\log p_{i}+(1-q_{i})\log(1-p_{i})\right] \tag{9}$$
其中 $q_i\in\{0,1\}$ 表示 token $i$ 是否被 top-$k$ 选中,$p_i=\sigma(s_i)$ 是路由概率。系数在 $\{10^{-2},10^{-3},10^{-4},10^{-5}\}$ 中扫描:太大会压过语言建模目标、损失变差,太小则训练和评估的路由差距偏大,最终按初步实验里的训练/验证 LM 损失选了 $10^{-4}$。论文报告的所有验证损失都用这个阈值规则计算;两种掩码的一致率见 Table 10。
实用 Scaling Law
把路由配置选择写成条件设计问题
X-MoD 的实际目标是给稀疏深度路由提供一条设计规则。给定训练算力 $C$、序列长度 $L$ 和激活等效骨干规模 $N_{\mathrm{act}}$,要找使最终损失最小的稀疏度 $K$ 和锚点步长 $A$:
$$(K^{*},A^{*})=\arg\min_{K,A}\mathcal{L}_{\mathrm{X\mbox{-}MoD}}(K,A;C,L,N_{\mathrm{act}}) \tag{10}$$
之所以叫「条件」设计问题,是因为 $N_{\mathrm{act}}$ 由期望的激活容量或部署预算事先定下,scaling law 只回答在这个预算内路由配置怎样影响性能。为了把稀疏深度效应从稠密骨干里分离出来,作者定义了 matched-FLOPs 残差:
$$\Delta(C,L,N_{\mathrm{act}},K,A)=\mathcal{L}_{\mathrm{X\mbox{-}MoD}}(C,L,N_{\mathrm{act}},K,A)-\widehat{\mathcal{L}}_{\mathrm{dense}}(C,L,N_{\mathrm{act}}) \tag{11}$$
其中 $\widehat{\mathcal{L}}_{\mathrm{dense}}$ 是在相同 FLOPs、相同序列长度和相同骨干族下对稠密验证曲线做插值得到的。减掉这个参照之后,要建模的就只剩与稀疏深度设计相关的残差变化。
四个候选机制与经验规律
作者为残差律考虑了四个候选机制:
- 容量奖励:总稀疏容量从 $N_{\mathrm{act}}$ 增加到 $N(K,A)$ 应当降低损失;
- 暴露修正:稀疏模型的有效 token 暴露量可能与 matched-FLOPs 的稠密基线不同;
- 上下文缩减:稀疏层只看到被路由的子序列,定律需要刻画稀疏层上下文的缩减;
- A–K 交互:锚点步长只有在稀疏路由生效时才起作用,因此应当以 $A$–$K$ 交互项的形式出现。
图 2 的扫描给出了一致的权衡。
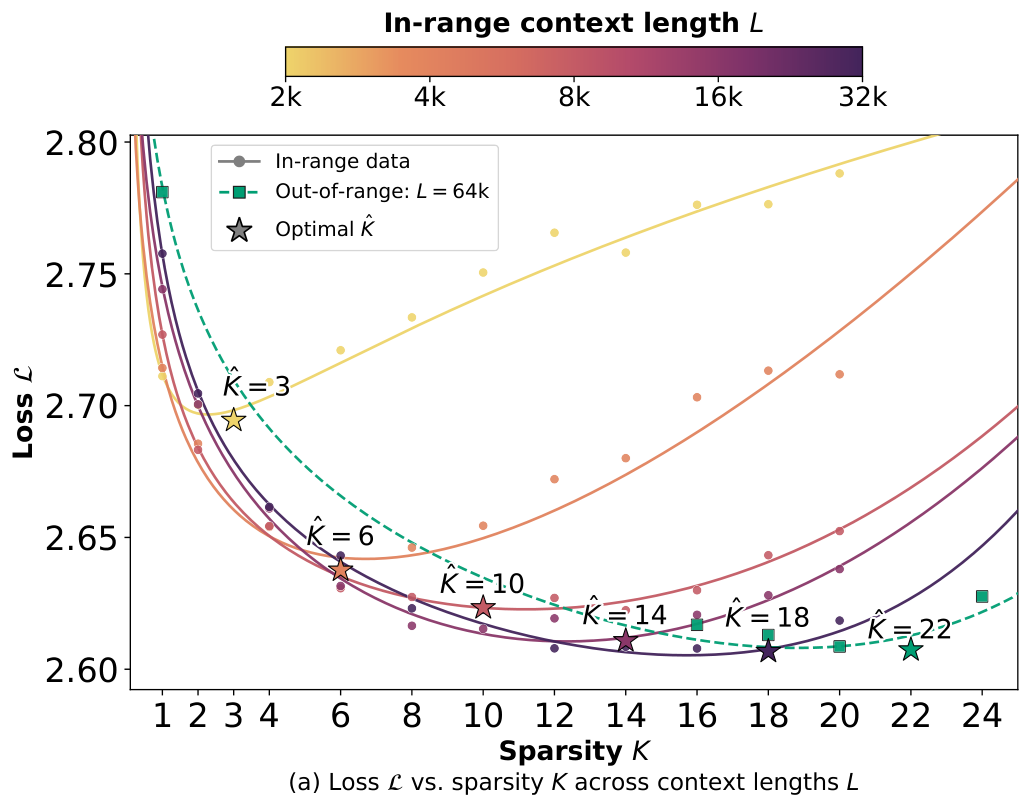
(a) 损失随 $K$ 呈 U 形,最优点随 $L$ 右移($N_{\mathrm{act}}=556$M,$A=1$)。标出的最优 $\hat{K}$:$L$ = 2k / 4k / 8k / 16k / 32k 时分别为 3 / 6 / 10 / 14 / 18,预设外推的 $L$ = 64k 为 22。U 形说明定律既要奖励总稀疏容量的增加,也要惩罚每个稀疏层看到的上下文缩减。另外值得注意曲线深度的差别(读图):$L$ = 2k 时从 $K=1$(即稠密)的约 2.71 降到 $\hat{K}=3$ 的约 2.695,收益只有约 0.015;$L$ = 32k 时从约 2.758 降到约 2.607,收益约 0.15,差了一个数量级。
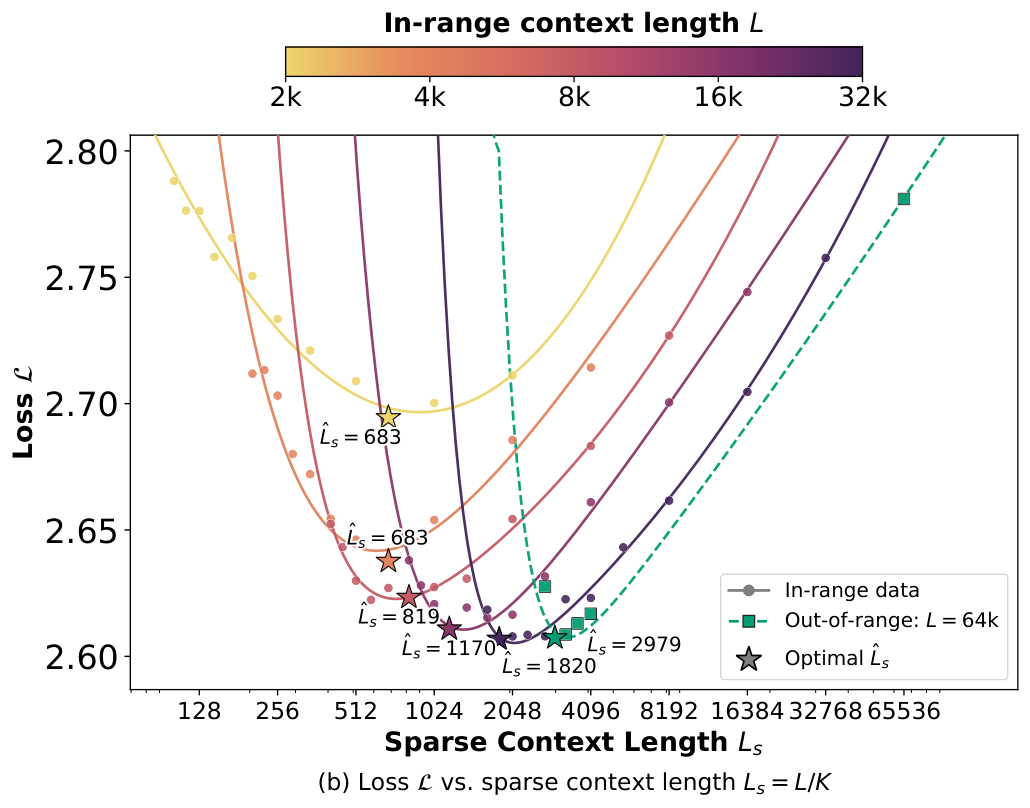
(b) 换成稀疏上下文长度 $L_s=L/K$ 作横轴,同样能看到最优点移动:$\hat{L}_s$ = 683(2k)、683(4k)、819(8k)、1170(16k)、1820(32k)、2979(64k,外推)。也就是说,稀疏层的最优上下文并不固定,而是随全长 $L$ 缓慢增长。
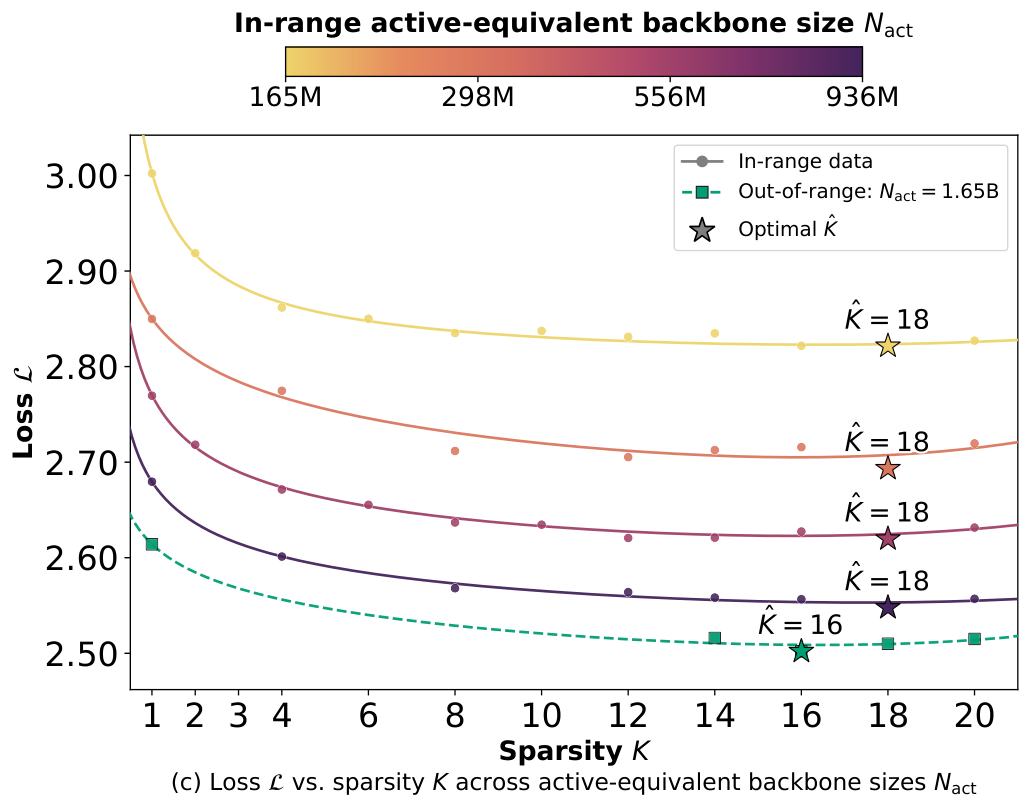
(c) $N_{\mathrm{act}}$ 对最优 $K$ 影响很弱($L$ = 32k,$A=1$):165M / 298M / 556M / 936M 四个区间内规模的 $\hat{K}$ 全部是 18,预设外推的 1.65B 为 16。所有曲线在 $K\gtrsim8$ 之后都很平坦,例如 936M 从 $K=8$ 到 $K=18$ 只降了约 0.02(读图)。
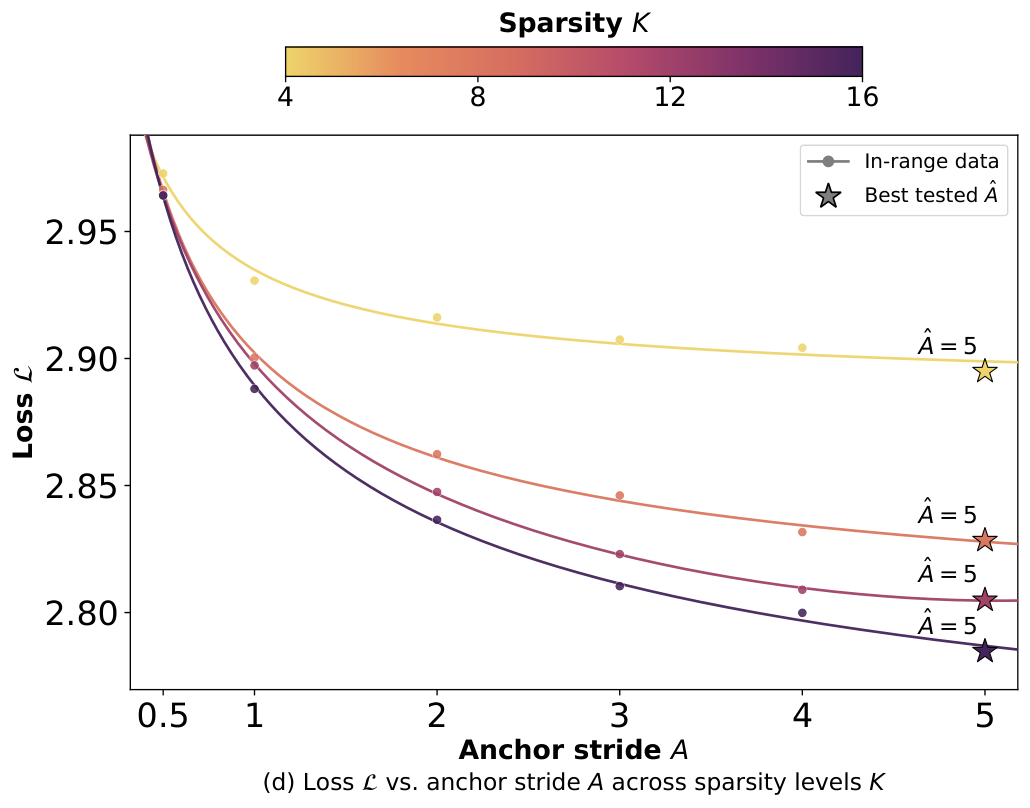
(d) 锚点步长 $A$ 与 $K$ 交互($N_{\mathrm{act}}=165$M,$L$ = 32k):在测试范围 $A\in\{0.5,1,2,3,4,5\}$ 内,四个 $K$ 的损失都随 $A$ 单调下降,最优测试值 $\hat{A}=5$ 都落在网格边界。作者明确说明 $\hat{A}=5$ 只是「最佳测试值」,不主张测试范围之外存在极小值。$K$ 越大,$A$ 带来的收益越大($K=16$ 从 $A=0.5$ 的约 2.965 降到 $A=5$ 的约 2.785;$K=4$ 只降到约 2.895)。
$L$ = 64k 与 $N_{\mathrm{act}}$ = 1.65B 两个设置超出了构造定律所用的范围,定性趋势一致。需要说明:图 2 中的平滑曲线只是逐条扫描的一维描述性拟合,不是下文 Eq.(21) 的预测。
各项的参数化
参照 Hoffmann et al. (2022) 和 Abnar et al. (2025),作者把容量奖励和稀疏上下文修正参数化为
$$R_{N}=N_{\mathrm{act}}^{-\eta_{N}}\left[1-\left(\frac{N(K,A)}{N_{\mathrm{act}}}\right)^{-\rho_{N}}\right] \tag{12}$$
$$P_{L}=L^{-\eta_{L}}\left[\left(\frac{L_{s}}{L}\right)^{-\rho_{L}}-1\right],\qquad L_{s}=L/K \tag{13}$$
$R_N$ 在 $N(K,A)=N_{\mathrm{act}}$(没有稀疏扩容)时为 0,总/激活比越大越趋近上限 $N_{\mathrm{act}}^{-\eta_N}$,前面的 $N_{\mathrm{act}}^{-\eta_N}$ 让奖励幅度可以随骨干规模变化。$P_L$ 在 $K=1$ 时为 0,稀疏层上下文 $L_s$ 相对 $L$ 越短,惩罚越大;$L^{-\eta_L}$ 让同样的相对缩减在长上下文下惩罚更小。$N_{\mathrm{act}}$ 按参数个数、$L$ 按 token 数代入,单位被拟合系数 $u$ 和 $w$ 吸收。
锚点步长的稀疏份额(附录 A.1 推导)。考虑 $N_{\mathrm{act}}$ 固定的 $A$ 扫描。$A$ 变化时通过改变块数来保持激活等效预算不变。令
$$H=\frac{N_{\mathrm{act}}}{N_{\mathrm{layer}}}-N_{0} \tag{14}$$
为非前缀部分分到的激活等效深度。每个块给每个 token 贡献 $A$ 次稀疏更新和 1 次稠密锚点更新,所以块数为
$$N_{1}(A)=\frac{H}{A+1} \tag{15}$$
激活等效深度中的稀疏部分为
$$\ell_{\mathrm{sp}}(A)=A\,N_{1}(A)=\frac{A}{A+1}H \tag{16}$$
稠密锚点部分为
$$\ell_{\mathrm{anc}}(A)=N_{1}(A)=\frac{1}{A+1}H \tag{17}$$
两者之和恒为 $H$,与 $A$ 无关。也就是说,在这组受控扫描里改变 $A$,只是在稀疏精炼和稠密锚点之间重新分配非前缀的激活路径,总激活预算不变。稀疏等效份额为
$$s(A)=\frac{\ell_{\mathrm{sp}}(A)}{\ell_{\mathrm{sp}}(A)+\ell_{\mathrm{anc}}(A)}=\frac{A}{A+1} \tag{18}$$
以 $A=1$ 为基准归一化:
$$\omega(A)=\frac{s(A)}{s(1)}=\frac{2A}{A+1} \tag{19}$$
$\omega(A)$ 单调、饱和,$A=1$ 时为 1,$A\to\infty$ 时趋近 2。作者选它而不是直接用原始的 $A$,是因为它的含义明确:激活等效计算中分给稀疏精炼的比例。由于这部分收益只在稀疏路由生效时出现,交互项定义为
$$R_{A,K}=\left(K^{\rho_{K}}-1\right)\left[\omega(A)^{\rho_{A}}-1\right],\qquad\omega(A)=\frac{2A}{A+1} \tag{20}$$
$K=1$ 或 $A=1$ 时该项为 0。作者强调,每个保留下来的特征都对应一个具体的稀疏深度机制,并锚定在相应的稠密参照点上。
主律
正文采用的残差律为:
$$\boxed{\begin{aligned} \Delta(C,L,N_{\mathrm{act}},K,A)&\approx e-u\,N_{\mathrm{act}}^{-\eta_{N}}\left[1-\left(\frac{N(K,A)}{N_{\mathrm{act}}}\right)^{-\rho_{N}}\right]\\ &\quad+w\,L^{-\eta_{L}}(K^{\rho_{L}}-1)-z\,(K^{\rho_{K}}-1)\left[\left(\frac{2A}{A+1}\right)^{\rho_{A}}-1\right]\end{aligned}} \tag{21}$$
其中 $u,w,z>0$。第二项(容量奖励)为负,第三项(上下文惩罚)为正,第四项(锚点步长交互)为负;注意 $P_L$ 代入 $L_s=L/K$ 后恰好化简成 $L^{-\eta_L}(K^{\rho_L}-1)$。拟合出的系数见 Table 8:
| 定律组件 | 参数 | 估计值 |
|---|---|---|
| 残差偏置 | $e$ | 0.01848 |
| 稀疏容量奖励 | $u$ | 0.93519 |
| $\eta_N$ | 0.07784 | |
| $\rho_N$ | 1.19538 | |
| 稀疏上下文修正 | $w$ | 105.21108 |
| $\eta_L$ | 0.92624 | |
| $\rho_L$ | 0.48494 | |
| 锚点步长交互 | $z$ | 0.07455 |
| $\rho_K$ | 0.79900 | |
| $\rho_A$ | 0.28293 |
两阶段约束拟合用了全部 109 个区间内观测,解释了 matched-dense 残差方差的 98.5%($R^2_\Delta=0.9853$)。这是不加权的样本内统计,预设的外推观测($L$ = 64k 与 $N_{\mathrm{act}}$ = 1.65B)既不参与拟合,也不计入该统计。
从系数能直接读出几点(下面是按 Table 8 做的换算):
- $\eta_N=0.078$ 很小:从 165M 到 936M,容量奖励的前置因子只变为 $(936/165)^{-0.078}\approx0.87$。所以在区间内,这条定律基本认为稀疏容量的收益与骨干规模无关,和图 2(c) 四个规模的 $\hat K$ 都是 18 相符。
- $\eta_L=0.926$ 接近 1:上下文惩罚大致与 $1/L$ 成比例,所以在长上下文下稀疏化几乎不受上下文缩减的惩罚。
被舍弃的暴露修正项
参照 Hoffmann et al. 和 Abnar et al.,作者先评估了完整的候选形式:
$$\Delta\approx e-uR_{N}+vP_{D}+wP_{L}-zR_{A,K},\qquad u,v,w,z\geq 0 \tag{22}$$
其中暴露修正项为
$$P_{D}=D_{\mathrm{dense}}^{-\eta_{D}}\left[\left(\frac{D_{\mathrm{sparse}}/K}{D_{\mathrm{dense}}}\right)^{-\rho_{D}}-1\right] \tag{23}$$
$P_D$ 用来检验稀疏模型与稠密模型之间 token 暴露量的差异,能否在容量项和上下文项之外提供额外信息。
算力与 token 预算的关系(附录 A.2)。用简化的每 token FLOPs 模型:$\lambda_p$ 是 token 线性投影和 FFN 项的常数,$\lambda_m$ 是注意力矩阵乘法项的常数。对序列长度 $L$、宽度 $d$、稀疏度 $K$、步长 $A$ 的 X-MoD:
$$\phi_{\mathrm{X\mbox{-}MoD}}(L,K,A)=\lambda_{p}d^{2}\bigl[N_{0}+N_{1}(1+A)\bigr]+\lambda_{m}Ld\left[N_{0}+N_{1}\left(1+\frac{A}{K}\right)\right] \tag{24}$$
第一项是 token 线性投影和 FFN:$AK$ 个稀疏层各只处理 $1/K$ 的 token,平均每个 token 相当于经过 $A$ 个激活层。第二项是注意力矩阵乘法:稠密前缀层和锚点层在全序列上做注意力,稀疏层只在被路由的子集上做,于是贡献 $N_1A/K$。激活等效深度相同($N_0+N_1(1+A)$)的稠密基线为
$$\phi_{\mathrm{dense}}(L,A)=\lambda_{p}d^{2}\bigl[N_{0}+N_{1}(1+A)\bigr]+\lambda_{m}Ld\bigl[N_{0}+N_{1}(1+A)\bigr] \tag{25}$$
训练算力 $C$ 固定时
$$D_{\mathrm{sparse}}(C,L,K,A)=\frac{C}{\phi_{\mathrm{X\mbox{-}MoD}}(L,K,A)},\qquad D_{\mathrm{dense}}(C,L,A)=\frac{C}{\phi_{\mathrm{dense}}(L,A)} \tag{26}$$
每个稀疏层只看到 $1/K$ 的 token,所以稀疏参数的有效暴露量正比于 $D_{\mathrm{sparse}}/K$,暴露比可以写成
$$\frac{D_{\mathrm{sparse}}/K}{D_{\mathrm{dense}}}=\frac{1}{K}\frac{\phi_{\mathrm{dense}}(L,A)}{\phi_{\mathrm{X\mbox{-}MoD}}(L,K,A)} \tag{27}$$
这个解析式只用来构造候选项;实际拟合时 $D_{\mathrm{sparse}}$、$D_{\mathrm{dense}}$ 和 $C$ 都取自日志里的真实 token 数与 FLOPs。
比较结果:在同一套协议下,约化律($v=0$)的区间内合并拟合 RMSE 为 0.008758,完整候选律为 0.01349,作者据此在实用律中省略 $P_D$。(这里有个内部矛盾:完整律包含 $v=0$ 这一特例,按理样本内 RMSE 不应高于约化律,见「讨论」复核三。)
Eq.(24) 还有一层含义,后面的讨论会反复用到:X-MoD 的 FFN/投影 FLOPs 与同 $N_{\mathrm{act}}$ 的稠密模型完全相同(第一项一致),$\phi$ 的下降全部来自第二项,即注意力矩阵乘法。
近似最优稀疏度
为了单独研究容量与上下文的权衡,先固定 $A=1$,此时锚点交互项为 0。在大 $K$ 区间 $N(K,A)/N_{\mathrm{act}}\propto K$,把常数吸收进 $c_N,c_L>0$,得到
$$\Delta_{K}\approx\frac{c_{N}}{N_{\mathrm{act}}^{\eta_{N}}K^{\rho_{N}}}+\frac{c_{L}K^{\rho_{L}}}{L^{\eta_{L}}} \tag{28}$$
第一项随 $K$ 递减,第二项随 $K$ 递增:$K$ 先通过增加总稀疏容量改善性能,过度稀疏后每个稀疏层接收的上下文太少,性能又变差。令 $\partial\Delta_K/\partial K=0$:
$$-\frac{c_{N}\rho_{N}}{N_{\mathrm{act}}^{\eta_{N}}}K^{-\rho_{N}-1}+\frac{c_{L}\rho_{L}}{L^{\eta_{L}}}K^{\rho_{L}-1}=0 \tag{29}$$
于是
$$K^{\rho_{N}+\rho_{L}}=\frac{c_{N}\rho_{N}}{c_{L}\rho_{L}}\frac{L^{\eta_{L}}}{N_{\mathrm{act}}^{\eta_{N}}} \tag{30}$$
$$\hat{K}\propto L^{\eta_{L}/(\rho_{N}+\rho_{L})}N_{\mathrm{act}}^{-\eta_{N}/(\rho_{N}+\rho_{L})} \tag{31}$$
也就是说,最优稀疏度强烈依赖上下文长度,对激活等效规模只有很弱的依赖,这与图 2 一致。$A$ 项则在更多激活预算分给稀疏精炼时偏向更大的稀疏度,收益经 $2A/(A+1)$ 饱和。
代入 Table 8 的系数:$\rho_N+\rho_L=1.680$,所以 $\hat{K}\propto L^{0.551}N_{\mathrm{act}}^{-0.046}$。从 2k 到 32k(16 倍),这个指数预测 $\hat K$ 扩大 $16^{0.551}\approx4.6$ 倍,实测是 3 → 18(6 倍),方向一致。作者也说明这只是渐近的设计直觉,主对比用的配置是靠 Fig. 4 的等预算试点网格选出来的。
实验设置
数据、评测与训练配方
- 数据:全部模型都在 FineWeb-Edu 上预训练,用 GPT-2 tokenizer(词表 50,257);
- 验证损失:在约 0.2B 个留出 token 上计算,所有架构用同一批 shard,所以损失比较是配对的。作者说主对比和关键消融在必要时可以用更大的留出集核实小差距,但没有说明实际对哪些结果做过;
- 下游评测:zero-shot,用 lm-evaluation-harness,任务为 HellaSwag、ARC-Easy、ARC-Challenge、PIQA、LAMBADA、BoolQ。它们只作为预训练质量的迁移性检查,不做任何针对架构的下游调参;
- 学习率调度:1% warmup,然后 cosine 衰减到峰值的 10%;
- 每步 token 数在不同序列长度下保持大致固定:
$$\texttt{global\_batch\_size}\times L\approx 2.5\mathrm{M} \tag{32}$$
- 优化器选择:在稠密基线上对比 AdamW 与 Muon,各扫 8 个几何间隔的峰值学习率
$$\left\{2^{0},2^{1},2^{2},2^{3},2^{4},2^{5},2^{6},2^{7}\right\}\times10^{-4} \tag{33}$$
峰值学习率 $3.2\times10^{-3}$ 的 Muon 给出最好的稠密验证损失,用于所有主实验(Table 5)。超参只在稠密基线上调过,MoD、MoE、X-MoD 都直接沿用。
Table 5:Muon 优化器配置
| 超参 | 值 |
|---|---|
| Peak learning rate | $3.2\times10^{-3}$ |
| Momentum coefficient $\beta$ | 0.95 |
| Newton–Schulz steps | 5 |
| Nesterov momentum | True |
| RMS match | 0.2 |
| AdamW betas | (0.9, 0.95) |
| AdamW epsilon | $10^{-8}$ |
| Weight decay | 0.1 |
- 硬件:NVIDIA A100 80GB + PyTorch DDP;只有 1.65B 规模的 MoE 8:128 和 X-MoD A3K16 用了 TP=8。最大的实验用到 8 节点 × 8 卡。
骨干配置
所有模型都用 GQA 注意力。Dense、MoD、X-MoD 用标准 FFN,MoE 把 FFN 换成路由专家加共享专家。556M 和 1.65B 两档分别沿用 Qwen3-0.6B 和 Qwen3-1.7B 的结构配置,其余规模只改隐藏维、head 维和 FFN 中间维。
Table 4:骨干配置
| $N_{\mathrm{act}}$ | Dim | Head dim | Layers | Heads | KV heads | FFN dim |
|---|---|---|---|---|---|---|
| 165M | 512 | 64 | 28 | 16 | 8 | 1536 |
| 298M | 768 | 64 | 28 | 16 | 8 | 2304 |
| 556M | 1024 | 128 | 28 | 16 | 8 | 3072 |
| 936M | 1536 | 128 | 28 | 16 | 8 | 3840 |
| 1.65B | 2048 | 128 | 28 | 16 | 8 | 6144 |
基线与 X-MoD 的层级构造
- Dense:28 层。
- MoD:按原论文推荐的一稀疏一稠密、稀疏比 1:8。为了匹配 28 层激活等效的稠密骨干,用
$$[Dense]+([Sparse(8)]+[Dense])_{\times 24} \tag{34}$$
激活等效 $1+24+24/8=28$ 层,物理 49 层。
- MoE:细粒度专家 + 共享专家(DeepSeekMoE 设计),「8:64」表示每 token 激活 6 个路由专家 + 2 个共享专家、共 64 个路由专家。路由器参照 Qwen3 与 Kimi K3 的负载均衡设计,同时用辅助负载均衡损失和 auxiliary-loss-free 的专家偏置更新;不用 router z-loss;专家分发没有容量上限、不设 capacity factor,不丢 token。
- X-MoD A4K8:先一个较短的稀疏–稠密段,再接四个 A4K8 段:
$$[Dense]_{\times 4}+\left([Sparse(8)]_{\times(3\cdot 8)}+[Dense]\right)+\left([Sparse(8)]_{\times(4\cdot 8)}+[Dense]\right)_{\times 4} \tag{35}$$
激活等效 $4+5+(3\cdot8+4\cdot4\cdot8)/8=28$ 层,物理 161 层。
- X-MoD A3K16:
$$[Dense]_{\times 4}+\left([Sparse(16)]_{\times(3\cdot 16)}+[Dense]\right)_{\times 6} \tag{36}$$
激活等效 $4+6+(6\cdot3\cdot16)/16=28$ 层,物理 298 层。
主对比配置
训练算力分别为 $C=10^{20}$(556M)、$1.5\times10^{20}$(936M)、$2.5\times10^{20}$(1.65B)FLOPs;所有模型都用 $L=32768$。每个规模内,Dense、MoD、MoE、X-MoD 在相同总训练算力下比较。
Table 6:主对比的详细配置(Experts 记为「激活路由专家 : 总路由专家 + 共享专家」,$d_e$ 为专家 FFN 维,FLOPs/token 按 $L$ = 32768 计)
| $N_{\mathrm{act}}$ | $C$ | Model | Layers | Experts | $d_e$ | $N$ | FLOPs/tok. | Exec. |
|---|---|---|---|---|---|---|---|---|
| 556M | $10^{20}$ | Dense | 28 | – | – | 0.54B | $8.4\times10^{9}$ | DDP |
| MoD | 49 | – | – | 0.87B | $7.7\times10^{9}$ | DDP | ||
| MoE 8:64 | 28 | 6:64+2 | 384 | 2.46B | $8.4\times10^{9}$ | DDP | ||
| X-MoD A4K8 | 161 | – | – | 2.64B | $3.9\times10^{9}$ | DDP | ||
| MoE 8:128 | 28 | 6:128+2 | 384 | 4.58B | $8.4\times10^{9}$ | DDP | ||
| X-MoD A3K16 | 298 | – | – | 4.79B | $3.9\times10^{9}$ | DDP | ||
| 936M | $1.5\times10^{20}$ | Dense | 28 | – | – | 936M | $9.0\times10^{9}$ | DDP |
| MoD | 49 | – | – | 1.48B | $8.3\times10^{9}$ | DDP | ||
| MoE 8:64 | 28 | 6:64+2 | 480 | 4.51B | $9.0\times10^{9}$ | DDP | ||
| X-MoD A4K8 | 161 | – | – | 4.52B | $4.6\times10^{9}$ | DDP | ||
| MoE 8:128 | 28 | 6:128+2 | 480 | 8.48B | $9.0\times10^{9}$ | DDP | ||
| X-MoD A3K16 | 298 | – | – | 8.24B | $4.5\times10^{9}$ | DDP | ||
| 1.65B | $2.5\times10^{20}$ | Dense | 28 | – | – | 1.65B | $1.0\times10^{10}$ | DDP |
| MoD | 49 | – | – | 2.67B | $9.6\times10^{9}$ | DDP | ||
| MoE 8:64 | 28 | 6:64+2 | 768 | 9.28B | $1.0\times10^{10}$ | DDP | ||
| X-MoD A4K8 | 161 | – | – | 8.31B | $5.9\times10^{9}$ | DDP | ||
| MoE 8:128 | 28 | 6:128+2 | 768 | 17.16B | $1.0\times10^{10}$ | TP=8 | ||
| X-MoD A3K16 | 298 | – | – | 14.73B | $5.8\times10^{9}$ | TP=8 |
FLOPs 口径:所有比较都按日志里记录的训练 FLOPs 对齐。计数器按实际模型配置计算,包括序列长度、宽度、注意力类型、FFN 或 MoE 配置以及稀疏层路由比例;X-MoD 的稀疏层按被路由的 $1/K$ 计,MoE 按每 token 激活的专家计;四类模型用同一套实现。论文没有提到是否用了文档级注意力掩码,FLOPs 按 $L$ = 32768 全长报告。
Scaling law 扫描网格
- $K$–$L$ 扫描:$N_{\mathrm{act}}=556$M、$A=1$,$L\in\{2\mathrm{k},4\mathrm{k},8\mathrm{k},16\mathrm{k},32\mathrm{k}\}$,每个 $L$ 内在 matched compute 下比较;在 2k 额外测了 $K=3$ 以定位它较浅的极小值。拟合前就指定 $L$ = 64k 为外推组,测 $K\in\{1,16,18,20,22,24\}$,$K=1$ 作为稠密参照。
- 规模扫描:$L$ = 32k、$A=1$,$N_{\mathrm{act}}\in\{165\mathrm{M},298\mathrm{M},556\mathrm{M},936\mathrm{M}\}$;预设 $N_{\mathrm{act}}$ = 1.65B 为外推组,测 $K\in\{14,16,18,20\}$。
- 锚点扫描:$A\in\{0.5,1,2,3,4,5\}\times K\in\{4,8,12,16\}$,$L$ = 32k,$N_{\mathrm{act}}$ = 165M。
每个区间内实验在各自的目标训练算力下贡献一个验证损失观测,共 109 个。外推组的全部稀疏配置都不参与拟合。
拟合与样本外验证协议
作者用分组留出而不是随机点级留出,理由是同一条扫描内的点高度相关,随机留点基本只是在已观测扫描内部插值;分组留出检验的是定律能否迁移到没见过的上下文长度、锚点步长或规模。
- leave-one-$L$-out / leave-one-$N_{\mathrm{act}}$-out:拿掉某个 $L$(或某个 $N_{\mathrm{act}}$)的全部稀疏 run,在其余组上重拟合基础律,再预测被拿掉的组;
- leave-one-$A$-out:两阶段。先用 $A=1$ 的 $K$–$L$ 与规模扫描拟合基础残差律,再在去掉一个非基准 $A$ 组的受控锚点扫描上标定 $A$ 交互项。$A=1$ 时 $R_{A,K}=0$,所以 $A=1$ 的观测定义零交互基线,不作为留出组;
- 优化:残差偏置不设约束,奖励和修正系数约束非负;非线性指数用 differential evolution 最小化均方残差,给定指数后的线性系数用约束最小二乘求解。全数据拟合和每次分组重拟合都用这套流程。
外推评估用拟合全部区间内观测得到的单一定律,参数冻结后再去预测 $L$ = 64k 和 $N_{\mathrm{act}}$ = 1.65B。报告原始损失时,把预测残差加回 matched 稠密参照(受控 $A$ 扫描则加回共同的稠密水平):
$$\widehat{\mathcal{L}}_{i}=\widehat{\mathcal{L}}_{\mathrm{dense},i}+\widehat{\Delta}_{i} \tag{37}$$
留出或外推设置下的稠密观测只用来定义 matched-FLOPs 参照,不参与稀疏残差律的拟合。原始损失的校准用 RMSE 和 MAE 衡量:
$$\mathrm{RMSE}_{\mathcal{L}}=\sqrt{\frac{1}{n}\sum_{i=1}^{n}\left(\widehat{\mathcal{L}}_{i}-\mathcal{L}_{i}\right)^{2}} \tag{38}$$
$$\mathrm{MAE}_{\mathcal{L}}=\frac{1}{n}\sum_{i=1}^{n}\left|\widehat{\mathcal{L}}_{i}-\mathcal{L}_{i}\right| \tag{39}$$
主要实验结果
留出与外推预测
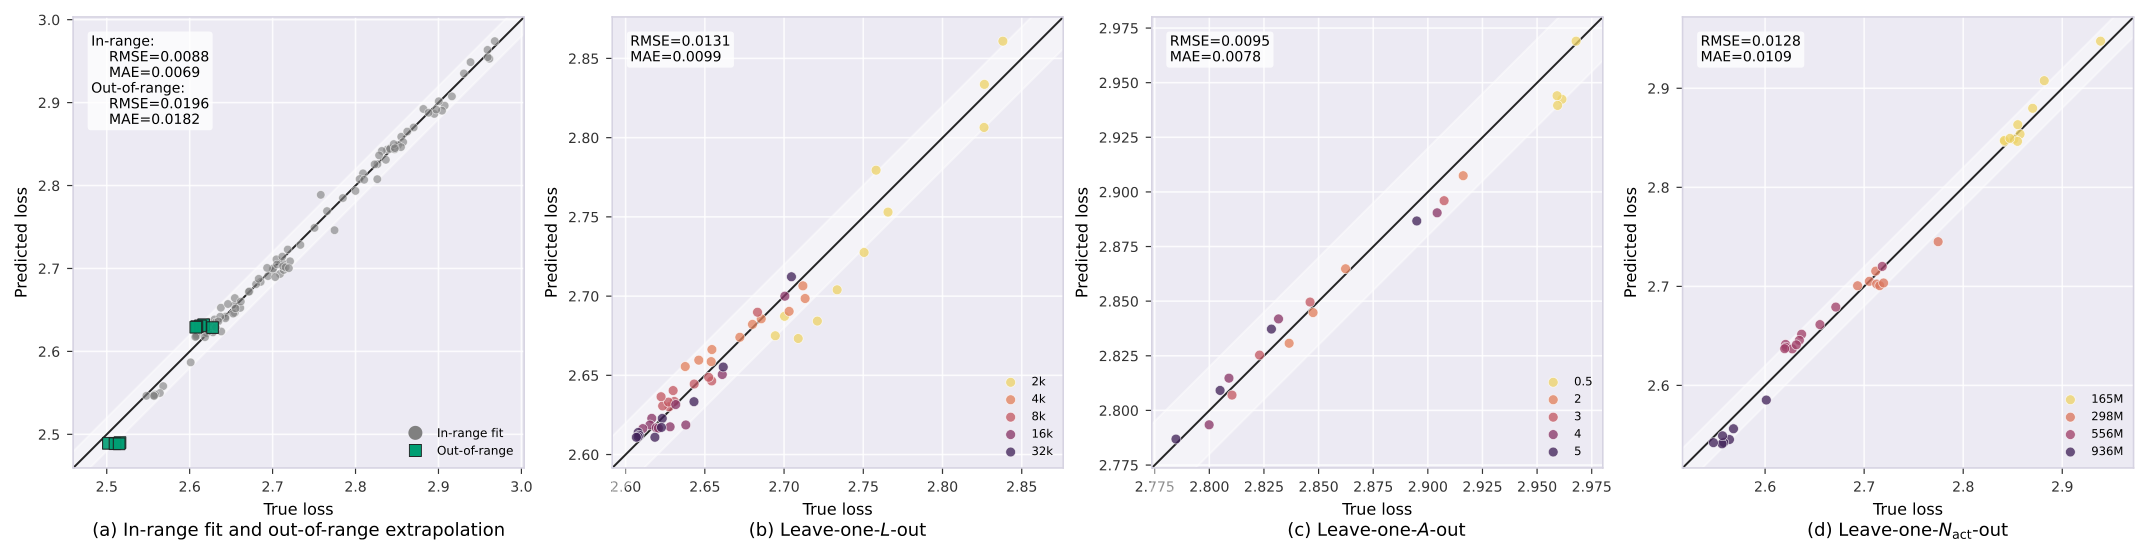
| 评估 | RMSE | MAE |
|---|---|---|
| (a) 区间内拟合(109 点) | 0.0088 | 0.0069 |
| (a) 预设外推($L$ = 64k 与 1.65B 共 9 个配置) | 0.0196 | 0.0182 |
| (b) leave-one-$L$-out | 0.0131 | 0.0099 |
| (c) leave-one-$A$-out | 0.0095 | 0.0078 |
| (d) leave-one-$N_{\mathrm{act}}$-out | 0.0128 | 0.0109 |
图中阴影带表示绝对误差 0.02,只是视觉参考,不是置信区间。作者的结论是:无论在拟合范围内,还是在更长上下文和更大模型的外推点上,预测与实测都吻合得很好;分组留出也保持这一精度,说明定律捕捉到了可迁移的结构。
几点补充观察:
- 外推误差是区间内的两倍多(RMSE 0.0196 vs 0.0088),MAE 与 RMSE 几乎相等(0.0182 vs 0.0196),说明外推误差主要是系统性偏移,不是个别离群点。读图 3(a):1.65B 的几个方块真值约 2.50–2.52,预测约 2.49,定律在更大规模上偏乐观;64k 的方块集中在 2.61–2.63 一带。
- leave-one-$L$-out 中 2k 组(黄色)最散,个别点误差约 0.03–0.04(读图)。2k 恰好是稀疏收益最浅的区间。
- 外推只延伸了 2 倍($L$:32k → 64k)和 1.76 倍($N_{\mathrm{act}}$:936M → 1.65B)。
与 Dense / MoD / MoE 的主对比
MoE 是与 X-MoD 最接近的稀疏容量方案:两者都把总容量与激活计算解耦,只是 MoE 沿宽度路由,X-MoD 沿深度路由。作者先在 $N_{\mathrm{act}}$ = 165M、等训练算力下网格搜索 MoE 的稀疏度和专家粒度,选出各自稀疏度组内损失最低的 MoE 8:64 和 8:128;再为每个 MoE 基线在试点网格里挑出 $N_{\mathrm{act}}$ 与名义稀疏度 $K$ 相同、总参数不超过该 MoE 的最低损失 X-MoD 配置,得到 A4K8 和 A3K16(见下一节 Fig. 4)。更大规模沿用这两个设置,并对齐 $N_{\mathrm{act}}$ 和 $C$。
Table 1:等激活等效规模、等训练算力下的主结果($\phi/\phi_D$ 为相对同 $N_{\mathrm{act}}$、同序列长度稠密模型的每 token 训练 FLOPs;下游任务为百分比)
| $N_{\mathrm{act}}$ | Model | $N$ | $\phi/\phi_D$↓ | Loss↓ | Hella.↑ | ARC-e↑ | ARC-c↑ | PIQA↑ | LAMB.↑ | BoolQ↑ | Avg.↑ |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 556M | Dense | 0.54B | 1.00 | 2.773 | 30.42 | 51.93 | 23.21 | 63.80 | 18.47 | 60.52 | 41.39 |
| MoD | 0.87B | 0.92 | 2.692 | 34.00 | 58.75 | 25.94 | 66.43 | 21.33 | 51.99 | 43.07 | |
| MoE 8:64 | 2.46B | 1.00 | 2.564 | 36.62 | 62.25 | 27.30 | 68.99 | 26.37 | 60.95 | 47.08 | |
| X-MoD A4K8 | 2.64B | 0.47 | 2.549 | 38.30 | 62.08 | 27.56 | 68.34 | 29.19 | 58.62 | 47.35 | |
| MoE 8:128 | 4.58B | 1.00 | 2.528 | 38.57 | 64.98 | 30.38 | 70.18 | 27.25 | 56.30 | 47.94 | |
| X-MoD A3K16 | 4.79B | 0.46 | 2.503 | 38.00 | 64.31 | 28.41 | 70.13 | 30.49 | 60.49 | 48.64 | |
| 936M | Dense | 936M | 1.00 | 2.635 | 35.18 | 59.85 | 26.71 | 67.52 | 24.16 | 59.85 | 45.54 |
| MoD | 1.48B | 0.92 | 2.570 | 36.67 | 62.04 | 26.54 | 68.72 | 26.14 | 60.89 | 46.83 | |
| MoE 8:64 | 4.51B | 1.00 | 2.445 | 40.62 | 67.76 | 32.34 | 71.22 | 33.11 | 60.80 | 50.97 | |
| X-MoD A4K8 | 4.52B | 0.51 | 2.427 | 41.26 | 68.69 | 33.45 | 71.22 | 33.55 | 60.43 | 51.43 | |
| MoE 8:128 | 8.48B | 1.00 | 2.412 | 41.30 | 70.16 | 33.96 | 70.78 | 34.23 | 60.06 | 51.75 | |
| X-MoD A3K16 | 8.24B | 0.50 | 2.402 | 42.07 | 67.80 | 33.79 | 72.03 | 34.64 | 60.67 | 51.84 | |
| 1.65B | Dense | 1.65B | 1.00 | 2.531 | 37.66 | 63.30 | 28.50 | 69.64 | 28.45 | 61.22 | 48.13 |
| MoD | 2.67B | 0.93 | 2.502 | 40.69 | 65.36 | 29.10 | 70.08 | 29.46 | 60.89 | 49.26 | |
| MoE 8:64 | 9.28B | 1.00 | 2.367 | 42.43 | 67.51 | 33.79 | 72.31 | 35.28 | 61.41 | 52.12 | |
| X-MoD A4K8 | 8.31B | 0.57 | 2.359 | 42.99 | 69.02 | 33.19 | 72.03 | 34.45 | 62.02 | 52.28 | |
| MoE 8:128 | 17.16B | 1.00 | 2.333 | 43.56 | 70.66 | 35.32 | 72.96 | 35.47 | 61.62 | 53.27 | |
| X-MoD A3K16 | 14.73B | 0.56 | 2.322 | 43.47 | 71.25 | 35.32 | 72.58 | 37.45 | 61.04 | 53.52 |
作者的结论:在所有评测规模上,X-MoD 稳定优于 Dense 和原始 MoD;在总参数和训练算力相近时,与代表性 MoE 基线相当或更好,同时每 token FLOPs 大幅更低;下游均分大体跟随验证损失,说明收益不只局限于预训练指标。据此,作者认为稀疏深度是扩大模型容量时替代稀疏宽度的有效选择。
逐项拆解:
- 对 Dense:损失降 0.17–0.27,下游均分涨 4.2–7.3 分(556M:+5.96 / +7.25;936M:+5.89 / +6.30;1.65B:+4.15 / +5.39)。A3K16 的损失优势随规模收窄:0.270 → 0.233 → 0.209。
- 对 MoD:损失降 0.14–0.19,三个规模都很稳定。
- 对配对 MoE,这是论文最关键的比较:
| $N_{\mathrm{act}}$ | 配对 | MoE Loss | X-MoD Loss | ΔLoss | MoE Avg | X-MoD Avg | ΔAvg | X-MoD 总参 / MoE 总参 |
|---|---|---|---|---|---|---|---|---|
| 556M | 8:64 vs A4K8 | 2.564 | 2.549 | −0.015 | 47.08 | 47.35 | +0.27 | 1.07 |
| 556M | 8:128 vs A3K16 | 2.528 | 2.503 | −0.025 | 47.94 | 48.64 | +0.70 | 1.05 |
| 936M | 8:64 vs A4K8 | 2.445 | 2.427 | −0.018 | 50.97 | 51.43 | +0.46 | 1.00 |
| 936M | 8:128 vs A3K16 | 2.412 | 2.402 | −0.010 | 51.75 | 51.84 | +0.09 | 0.97 |
| 1.65B | 8:64 vs A4K8 | 2.367 | 2.359 | −0.008 | 52.12 | 52.28 | +0.16 | 0.90 |
| 1.65B | 8:128 vs A3K16 | 2.333 | 2.322 | −0.011 | 53.27 | 53.52 | +0.25 | 0.86 |
六组全胜,但领先幅度只有 0.008–0.025,而且都是单种子、在 0.2B token 的验证集上测得。下游均分差 +0.09 到 +0.70,逐任务结果有输有赢:556M 上 A4K8 的 BoolQ 比 MoE 8:64 低 2.3 分,A3K16 的 ARC-c 比 MoE 8:128 低 2.0 分;1.65B 上 A4K8 的 LAMBADA 输给 MoE 8:64。LAMBADA 在其余 5 组里都是 X-MoD 领先,这是最稳定的一项。
- 每 token FLOPs:X-MoD 的 $\phi/\phi_D$ 为 0.46–0.57,MoE 为 1.00。在等训练算力下,这意味着 X-MoD 多处理了约 1.75–2.2 倍的训练 token(936M 的精确值见 Table 7:$D/D_D$ = 1.96 / 2.00)。这一点决定了怎样解读上面的领先,见「讨论」复核一、二。
试点配置选择(附录 C.2)
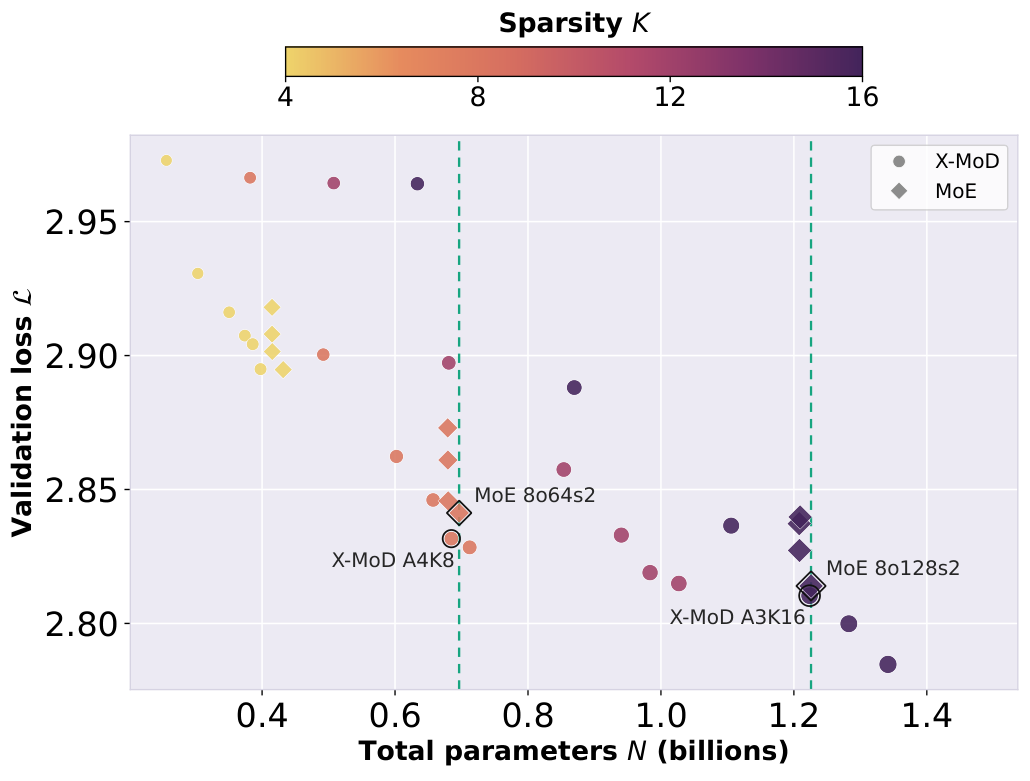
等预算试点比较了 24 个 X-MoD 配置($A\in\{0.5,1,2,3,4,5\}\times K\in\{4,8,12,16\}$)和 12 个 MoE 配置($K\in\{4,8,16\}$,专家粒度 $G\in\{2,4,8\}$,$G=8$ 时可以不带或带两个共享专家)。MoE 的 $K$ 是配置名里的名义比例(如 $64/8=8$),激活专家数包括共享专家。在 $K=8$ 和 $K=16$ 组内,MoE 8:64(图中 8o64s2)和 8:128(8o128s2)损失最低;X-MoD A4K8 和 A3K16 是在不超过对应 MoE 总参数预算的前提下、同 $K$ 里损失最低的配置。
读图:A4K8 约 2.832,MoE 8o64s2 约 2.841;A3K16 约 2.810,8o128s2 约 2.814。在选配置的这个试点规模上,两者差距本来就不到 0.01。图右下还有总参数 1.28–1.34B 的 X-MoD 点(约 2.785–2.80),它们超出了 MoE 的参数预算,所以没被选中;这和图 2(d) 中 $A$ 越大越好、最优点在网格边界是一致的。
系统效率(附录 C.5)
测量协议:936M 激活等效规模,单节点 8 × A100 80GB,PyTorch DDP,$L$ = 32k,每卡 microbatch 1,全局 batch 80 条序列。训练吞吐取 2,000 个优化步(约 5.24B token)的平均,不含评估和存 checkpoint 的时间。验证前向吞吐取对 0.2B token 验证集完整跑四遍的平均,包含路由、token 搬运、全词表投影和损失计算。所以这是验证前向基准,不是 KV-cache prefill 或自回归解码基准。
Table 11(a):规模、计数 FLOPs 与训练峰值显存
| Model | Layers | $N$ | FLOPs/token↓ | Peak memory (GB/GPU)↓ |
|---|---|---|---|---|
| Dense | 28 | 936M | 9.0G | 32.08 |
| MoD | 49 | 1.48B | 8.3G | 46.62 |
| MoE 8:64 | 28 | 4.51B | 9.0G | 55.46 |
| X-MoD A4K8 | 161 | 4.52B | 4.6G | 55.72 |
| MoE 8:128 | 28 | 8.48B | 9.0G | 71.96 |
| X-MoD A3K16 | 298 | 8.24B | 4.5G | 73.33 |
Table 11(b):实测吞吐与配对加速比(加速比相对总参数大致匹配的相邻 MoE)
| Model | Train throughput (M tok/s)↑ | Val.-forward throughput (M tok/s)↑ | Train speedup vs. MoE↑ | Val.-forward speedup vs. MoE↑ |
|---|---|---|---|---|
| Dense | 0.041 | 0.226 | ||
| MoD | 0.046 | 0.234 | ||
| MoE 8:64 | 0.027 | 0.176 | 1.00× | 1.00× |
| X-MoD A4K8 | 0.052 | 0.305 | 1.93× | 1.73× |
| MoE 8:128 | 0.023 | 0.153 | 1.00× | 1.00× |
| X-MoD A3K16 | 0.039 | 0.217 | 1.70× | 1.42× |
作者的结论:在显存峰值相当的前提下,X-MoD 的训练吞吐和前向推理吞吐都高于总参数大致匹配的 MoE。
值得肯定的是,这些加速比是实测的,不是按 FLOPs 估算的。但表里还有三个事实没被强调:
- MoE 基线本身很慢:同样的每 token FLOPs(9.0G),MoE 8:64 的训练吞吐只有 Dense 的 0.66 倍、前向 0.78 倍,MoE 8:128 分别只有 0.56 倍和 0.68 倍,说明这个 DDP 实现(没有专家并行)有明显的路由和分发开销。X-MoD 对 MoE 的加速比里,有一部分来自 MoE 实现本身的低效。
- 与 Dense 相比,FLOPs 的优势大部分没有兑现:A4K8 的 FLOPs 是 Dense 的 0.51 倍,训练吞吐却只有 Dense 的 1.27 倍,前向 1.35 倍;A3K16 的 FLOPs 是 0.50 倍,训练吞吐反而是 Dense 的 0.95 倍,前向 0.96 倍,比 Dense 还慢。
- 显存没有优势:X-MoD 与 MoE 总参数相当,峰值显存也相当(55.72 vs 55.46;73.33 vs 71.96),都比 Dense 高 1.7–2.3 倍。
消融与分析
机制对照:条件容量 vs 注意力上下文
两个反事实对照都在 936M 参考规模上做,$L$ = 32768,使用相同的留出 shard 和共同的 $C=1.5\times10^{20}$ FLOPs checkpoint:
- Routed-FFN:在两个稠密锚点之间重复 $A$ 组「全序列注意力 + $K$ 个路由 FFN 精炼」,即 $([\mathrm{FullAttn}]+[\mathrm{Routed\mbox{-}FFN}]_{\times K})_{\times A}$。只有 FFN 被路由,注意力始终看全序列。模型共保留 28 个全序列注意力模块;A4K8 / A3K16 变体分别有 152 / 288 个路由 FFN 精炼层,$\phi/\phi_D$ 都是 1.00,总参数 3.26B / 5.68B。
- Selected-Q/full-KV:保留对应 X-MoD 的路由器、被选中的 query、总深度和总参数,但每个稀疏层里所有 token 都提供 key 和 value。由于每个 token 都要算 K/V 投影,它不严格满足激活等效匹配。在固定训练算力下,它处理的训练 token 只有完整 X-MoD 的 46.8%(A4K8)和 42.0%(A3K16)。作者明确说这个对照检验的是固定算力下的完整架构,不能隔离「等 token 暴露下全上下文」的作用。
Table 2:X-MoD 的机制对照(936M 参考骨干)
| Variant | Total $N$ | $\phi/\phi_D$ | Loss↓ | Hella.↑ | ARC-e↑ | ARC-c↑ | PIQA↑ | LAMB.↑ | BoolQ↑ | Avg.↑ |
|---|---|---|---|---|---|---|---|---|---|---|
| Dense | 936M | 1.00 | 2.635 | 35.18 | 59.85 | 26.71 | 67.52 | 24.16 | 59.85 | 45.54 |
| MoD | 1.48B | 0.92 | 2.570 | 36.67 | 62.04 | 26.54 | 68.72 | 26.14 | 60.89 | 46.83 |
| Routed-FFN A4K8 | 3.26B | 1.00 | 2.508 | 37.97 | 64.27 | 28.92 | 70.29 | 29.79 | 60.95 | 48.70 |
| Routed-FFN A3K16 | 5.68B | 1.00 | 2.482 | 40.71 | 65.61 | 30.38 | 69.15 | 29.89 | 60.37 | 49.35 |
| Full X-MoD A4K8 | 4.52B | 0.51 | 2.427 | 41.26 | 68.69 | 33.45 | 71.22 | 33.55 | 60.43 | 51.43 |
| Selected-Q/full-KV A4K8 | 4.52B | 1.09 | 2.564 | 38.44 | 61.66 | 27.65 | 68.01 | 28.90 | 57.71 | 47.06 |
| Full X-MoD A3K16 | 8.24B | 0.50 | 2.402 | 42.07 | 67.80 | 33.79 | 72.03 | 34.64 | 60.67 | 51.84 |
| Selected-Q/full-KV A3K16 | 8.24B | 1.19 | 2.558 | 38.35 | 62.04 | 27.56 | 68.28 | 29.13 | 58.62 | 47.33 |
Table 7:机制对照的配置($D/D_D=(\phi/\phi_D)^{-1}$ 为相对 Dense 的 token 暴露量)
| Model | Routed computation | KV context | Depth | $N$ | $\phi/\phi_D$ | $D/D_D$ |
|---|---|---|---|---|---|---|
| Dense | None | Full | 28 | 936M | 1.00 | 1.00 |
| MoD | Attention + FFN | Selected subset | 49 | 1.48B | 0.92 | 1.09 |
| Routed-FFN A4K8 | FFN only | Full every $K$ refinements | 161 | 3.26B | 1.00 | 1.00 |
| Routed-FFN A3K16 | FFN only | Full every $K$ refinements | 298 | 5.68B | 1.00 | 1.00 |
| Selected-Q/full-KV A4K8 | Q/O + FFN | Full sequence | 161 | 4.52B | 1.09 | 0.92 |
| Selected-Q/full-KV A3K16 | Q/O + FFN | Full sequence | 298 | 8.24B | 1.19 | 0.84 |
| X-MoD A4K8 | Attention + FFN | Selected subset | 161 | 4.52B | 0.51 | 1.96 |
| X-MoD A3K16 | Attention + FFN | Selected subset | 298 | 8.24B | 0.50 | 2.00 |
(Routed-FFN 的深度按 FFN 层计。)
作者的解读:
- 条件容量:两个 Routed-FFN 变体在相同激活等效规模、相同每 token FLOPs、相同训练算力下都优于 Dense,容量更大的变体收益更多。这说明即使没有稀疏层注意力上下文选择,条件参数容量的增加本身也有贡献。
- 注意力上下文:Selected-Q/full-KV 让所有 token 提供 K/V,额外的 K/V 投影提高了激活计算量和每 token FLOPs。在固定 $C$ 的目标下,完整 X-MoD 比扩大稀疏层 KV 上下文更有效地分配了计算。
补充解读:Table 7 的 $D/D_D$ 一列是本文最有信息量的数据之一,作者主动给出了它。把它和 Table 1 放在一起看:
- 在相同 token 暴露下,纯深度方向的条件容量不如 MoE:Routed-FFN($D/D_D=1.00$)为 2.508 / 2.482,同规模、同样 $D/D_D=1.00$ 的 MoE 8:64 / 8:128 为 2.445 / 2.412,Routed-FFN 落后 0.063 / 0.070。Routed-FFN 的总参数只有对应 MoE 的 72% / 67%,所以这不是完全对等的比较;但这个差距是 X-MoD 对 MoE 领先幅度(0.018 / 0.010)的 4–7 倍。
- 从 Routed-FFN 到完整 X-MoD:损失再降 0.081 / 0.080,与此同时 token 暴露从 1.00 升到约 2.0,总参数也增加(3.26B → 4.52B,5.68B → 8.24B)。正是这一步把「落后 MoE 0.06–0.07」翻成了「领先 0.01–0.02」。
- Selected-Q/full-KV 让稀疏层看到完整上下文,但 token 降到 0.92 / 0.84,损失退到 2.564 / 2.558,与原始 MoD(2.570)相当。
这三组对照指向同一个结论:在 $L$ = 32k 的设定下,X-MoD 能压过 MoE,关键在于稀疏层只在子集内做注意力,把省下的 FLOPs 换成了约 2 倍的训练 token,而不在于深度方向稀疏容量本身比宽度方向更高效。详见「讨论」复核二。
稳定器消融
四个组件的消融都以 X-MoD A1K16 为完整参考,逐个移除,设置为 $N_{\mathrm{act}}=936$M、$L=32768$、$C=1.5\times10^{20}$ FLOPs。
Table 3:X-MoD 稳定机制的消融(ΔLoss 相对完整 X-MoD)
| Variant | Loss↓ | ΔLoss | Hella.↑ | ARC-e↑ | ARC-c↑ | PIQA↑ | LAMB.↑ | BoolQ↑ | Avg.↑ |
|---|---|---|---|---|---|---|---|---|---|
| Dense reference | 2.635 | +0.159 | 35.18 | 59.85 | 26.71 | 67.52 | 24.16 | 59.85 | 45.54 |
| Full X-MoD A1K16 | 2.476 | 0.000 | 40.64 | 66.08 | 30.80 | 71.27 | 30.58 | 61.31 | 50.12 |
| w/o dense anchors | 2.579 | +0.103 | 36.35 | 62.63 | 28.33 | 69.53 | 26.59 | 58.96 | 47.06 |
| w/o gated residual scaling | 2.492 | +0.016 | 40.62 | 65.19 | 29.27 | 69.31 | 29.73 | 60.58 | 49.12 |
| w/o token-choice bias | 2.657 | +0.181 | 34.59 | 59.85 | 26.54 | 67.52 | 22.01 | 59.11 | 44.94 |
| w/o dense prefix | 2.487 | +0.011 | 40.41 | 65.19 | 30.20 | 69.70 | 29.69 | 61.01 | 49.37 |
作者的解读:每个机制都对稀疏深度训练有贡献。去掉稠密锚点会大幅退化,说明堆叠很多稀疏层时,周期性的全 token 同步很重要。去掉深度方向的 token-choice bias 退化最大,印证了 token 集中是稀疏深度路由的主要失败模式。门控残差缩放通过稳定被选中层的残差带来较小但一致的提升,稠密前缀改善早期表示学习。去掉四者中任何一个,验证损失都会上升,下游均分都会下降。
补充观察:
- 去掉 token-choice bias 后,模型(2.657)比 Dense(2.635)还差,下游均分 44.94 也低于 Dense 的 45.54。所以没有这个偏置,X-MoD 的深层稀疏堆叠根本不成立。
- 消融参考 A1K16 本身(2.476)输给同规模的 MoE 8:64(2.445)和 8:128(2.412),也不是 Table 1 的主配置,所以这组降幅无法直接换算成「A4K8 / A3K16 相对 MoE 的领先里有多少归功于哪个组件」。与领先幅度的逐项对照见「讨论」复核五。
路由诊断
诊断在 936M 参考规模、$L=32768$、每卡评估 batch 1、$C=1.5\times10^{20}$ 的 checkpoint 上进行。覆盖率、相邻层重叠和稀疏更新次数都由阈值驱动的前向,在被稠密层隔开的连续稀疏层区间上统计:A1K16 和 A3K16 分别用 16 层和 48 层的区间,A4K8 只用完整的 32 层区间。
- 覆盖率:一个区间内至少被选中一次的 token 比例;
- 相邻层重叠:相邻两层所选 token 集合的 Jaccard 指数,先在每个「序列–区间」观测内对并集非空的层对取平均,再对有定义的观测取平均;
- 掩码一致率:单独做以 top-$k$ 驱动的前向,在每个稀疏层用同一组路由分数同时计算 top-$k$ 掩码和阈值掩码,统计全部 token–层位置上二值决策的一致比例(共同选中和共同跳过都算),不比较两条分别传播的路由轨迹。
两个解析参照都用名义选择率 $p=1/K$ 和区间长度 $T$:「重复同一子集」的覆盖率为 $p$、Jaccard 为 1、更新次数以概率 $1-p$ 为 0、以概率 $p$ 为 $T$;「独立随机子集」的期望覆盖率为 $1-(1-p)^T$,大序列下 Jaccard 近似 $p/(2-p)$,更新次数服从 $\mathrm{Binomial}(T,p)$。
Table 10:路由覆盖率、相邻层重叠与掩码一致率(936M,均为百分比)
| Model | 重复同一子集 Coverage | 重复同一子集 Jaccard | 独立随机 Coverage | 独立随机 Jaccard | 阈值路由 Coverage | 阈值路由 Jaccard | 阈值 / top-k 一致率 |
|---|---|---|---|---|---|---|---|
| X-MoD A1K16 | 6.250 | 100.0 | 64.39 | 3.226 | 52.24 | 14.51 | 98.63 |
| A1K16 w/o token-choice bias | 6.250 | 100.0 | 64.39 | 3.226 | 58.59 | 80.66 | – |
| X-MoD A4K8 | 12.50 | 100.0 | 98.61 | 6.667 | 99.99 | 1.947 | 96.62 |
| X-MoD A3K16 | 6.250 | 100.0 | 95.49 | 3.226 | 97.50 | 2.940 | 98.25 |
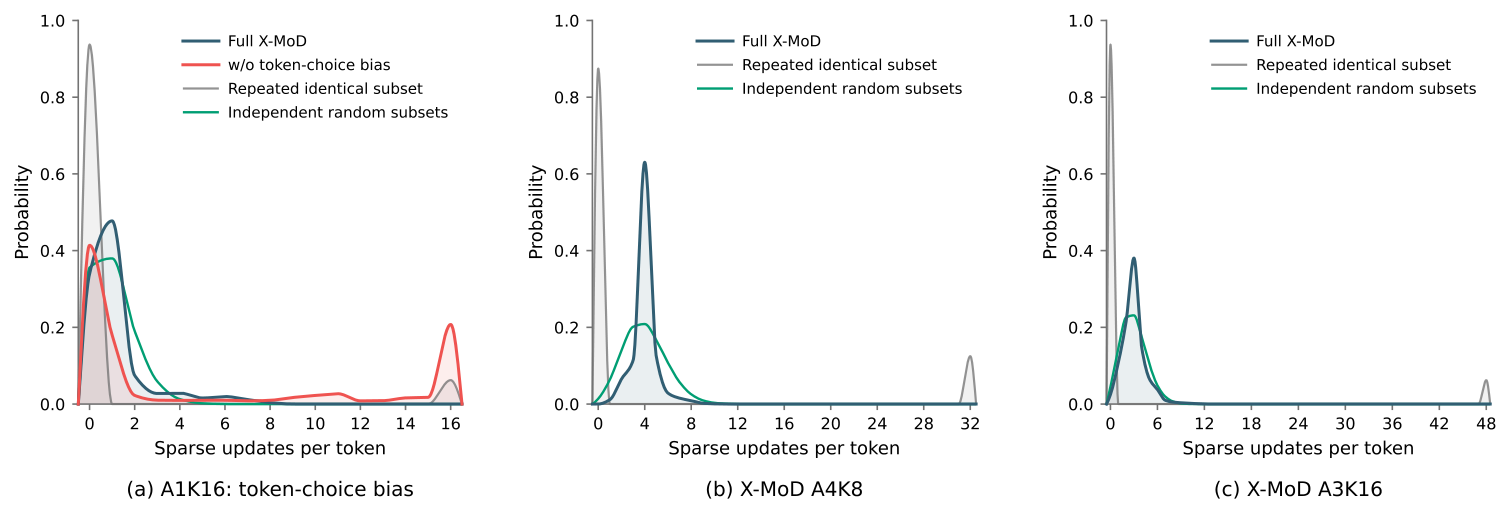
图中曲线是穿过离散概率点的保形三次插值,只有整数处的高度代表概率,填充面积没有概率含义。
解读:
- A1K16 去掉 token-choice bias 后,路由塌缩到一个持续的 token 子集:相邻层 Jaccard 从 14.51% 飙到 80.66%,图 5(a) 的红线在「16 层全部被更新」处有约 0.2 的概率质量。有意思的是,塌缩版的覆盖率(58.59%)反而高于完整版(52.24%),所以塌缩的含义是「同一批 token 被反复精炼」,而不是「很多 token 从没被选中过」。
- A4K8 与 A3K16 做到近乎完整的区间覆盖(99.99% / 97.50%)和很低的相邻层重叠。A4K8 的 Jaccard 1.947% 甚至低于独立随机子集的 6.667%,说明 bias 让相邻层倾向于挑不同的 token,接近轮转;图 5(b) 中更新次数分布在 4 处有约 0.63 的尖峰,比二项分布窄得多。A3K16 的分布集中在 3 附近,接近随机参照。
- 掩码一致率 96.62–98.63%。由于共同跳过的位置也算作一致,而跳过本来就占 $1-1/K$,这个指标偏宽松。按两种掩码选中数量相等粗略换算,不一致位置 1.37% / 3.38% / 1.75% 对应被选中 token 中约 11% / 14% / 14% 在两种规则下不同。作者据此认为训练期和可部署的选择规则高度对齐,这个结论需要打折扣看。
总深度扩展
这组模型用 165M 骨干的宽度($d=512$,head 维 64,16 个 query head,8 个 KV head,FFN 1536),把激活等效深度从 28 层加到 52 层,$N_{\mathrm{act}}=256$M,在 $C=4\times10^{19}$ FLOPs 下比较 Deep Dense 与 Deep X-MoD A1K4 / A1K8 / A1K12 / A1K16。所有 Deep X-MoD 都带稠密锚点、门控残差缩放和 token-choice bias。
Table 9:X-MoD 的总深度扩展
| Variant | Total $N$ | $N/N_{\mathrm{act}}$ | Total layers | $\phi/\phi_D$ | Val. loss↓ |
|---|---|---|---|---|---|
| Deep Dense | 256M | 1.00 | 52 | 1.00 | 3.084 |
| Deep X-MoD A1K4 | 552M | 2.16 | 124 | 0.67 | 3.047 |
| Deep X-MoD A1K8 | 939M | 3.67 | 220 | 0.62 | 3.034 |
| Deep X-MoD A1K12 | 1.29B | 5.04 | 316 | 0.60 | 3.023 |
| Deep X-MoD A1K16 | 1.67B | 6.52 | 412 | 0.59 | 3.011 |
所有 Deep X-MoD 都优于 Deep Dense,损失随配置单调下降(−0.037 / −0.050 / −0.061 / −0.073),412 层总深度下仍能稳定训练。作者也坦承,这组实验里 $K$、总参数、每 token FLOPs 和训练 token 暴露(1.5–1.7 倍)是一起变化的,所以只能算「等激活容量、等算力的总深度扩展」,不是单因素的深度消融。它的主要价值在于可训练性:四百多层的稀疏深度栈没有发散。
核心贡献总结
- 结构上限的清晰刻画:Eq.(2) 用一行式子说明了为什么一稀疏一稠密交替的 MoD 总/激活比永远小于 2,给「稀疏深度能否像 MoE 那样扩容」提供了明确的起点。
- K–A 解耦的稀疏深度层级:稠密锚点之间放 $AK$ 个稀疏层,平均每 token 精炼 $A$ 次,把总/激活比推到 4.8–8.8 倍,物理深度达到 161 / 298 层,并在 412 层时仍可训练。
- 一组必要的稳定器:整层残差门控加可学习缩放,深度方向的 token-choice bias(没有它模型比 Dense 还差),以及稠密前缀。
- 相对 FLOP 匹配稠密的残差律:把「选 K、A」写成给定 $(C,L,N_{\mathrm{act}})$ 的条件设计问题,用容量奖励 + 上下文修正 + A–K 交互三项拟合 109 个配置($R^2_\Delta$ = 0.985),推出 $\hat K\propto L^{0.55}$ 且几乎与规模无关。
- 协议上的卫生:外推组在拟合前预设;用分组留出而不是随机点级留出;在对照表里主动报告 token 暴露 $D/D_D$;实测训练和前向吞吐,而不是只报 FLOPs。
与已归档相关工作的对比
SMELT SMELT: Scaling Laws for Compute-Matched MoE Looped Transformers (Tsinghua University, 2026-09-01)
关系:独立并发(本文未引用 SMELT,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇都在问:如果换一种方式使用深度这个维度,在与 MoE 预算对齐的前提下,能不能赢过 MoE? 两者也都需要一条拟合出来的定律,把逐点比较变成设计规则。它们在「参数—FLOPs」平面上方向恰好相反:SMELT 用循环让同一组参数被访问两次,每参数花更多 FLOPs;X-MoD 用稀疏深度让每 FLOP 背后有更多参数。
- 相近的技术骨架:都是「在 Transformer 深度方向做结构改造 + 与 MoE 预算对齐的比较 + 拟合一条定律」。SMELT 把中间 50% 的层循环两次,收窄隐藏维来支付多出的 FLOPs,再加专家补回总参数;X-MoD 在稠密锚点之间插入 $AK$ 个稀疏层,保持 $N_{\mathrm{act}}$ 和 $C$ 对齐。
- 本文的差异与推进:X-MoD 的定律是一个条件残差面,只覆盖 $(K,A,L,N_{\mathrm{act}})$,没有 $C$/$D$ 维度;SMELT 为两种架构各自独立拟合 Chinchilla 式曲面,在共同的 $(C,S)$ 坐标上比较,给出「算力最优前沿上节省 6.8–18.0% 训练 FLOPs」这种可外推的数字。X-MoD 没有给出类似的前沿算力倍率。
- 可比的方法 / 实验差异:两者预算对齐的严格程度差别最大。SMELT 同时对齐每 token FLOPs(残余差 <4%)、总参数(<1%)和 KV cache(<4%),配对模型在完全相同的 token 序列上训练,用 segment-level 注意力掩码,FLOPs 按平均文档长度计。X-MoD 对齐了 $N_{\mathrm{act}}$ 和训练 $C$;KV cache 其实也隐含对齐了(每 token 缓存的层当量为 $9+152/8=28$ 和 $10+288/16=28$,与 Dense/MoE 相同,这是我的推算);但 token 暴露差了约 2 倍,也没有说明是否用文档掩码,FLOPs 按 32k 全长计。按 SMELT 的口径,X-MoD 靠注意力 FLOPs 获得的 $\phi$ 优势会大幅缩水。SMELT 这篇本身就在批评「只对齐一种预算、把额外算力记成架构胜利」的做法;X-MoD 对齐了 FLOPs,却把 token 暴露上的差异当成了架构收益,属于同一类记账问题。
Compute-Optimal Is Not Cluster-Optimal: Systems-Aware Scaling for Sparse Mixture-of-Experts Compute-Optimal Is Not Cluster-Optimal: Systems-Aware Scaling for Sparse Mixture-of-Experts (Amazon AGI Foundations, 2026-08-11)
关系:独立并发(本文未引用 MOSAIC)· 已加载对方精读
- 共同关注的问题:两篇都针对一种总参数与激活参数解耦的稀疏架构,用一条拟合出来的定律来选稀疏配置:MOSAIC 选 MoE 的稀疏度 $S$ 和粒度 $G$,X-MoD 选 $K$ 和 $A$。
- 相近的技术骨架:都在大量从零训练的 run 上拟合带稀疏旋钮的参数化 loss 定律(MOSAIC 是 $L(N_{\text{tot}},S,D,G)$,约 150 个 run;X-MoD 是 $\Delta(C,L,N_{\mathrm{act}},K,A)$,109 个观测),然后在定律上求最优配置。
- 本文的差异与推进:X-MoD 的 $K$ 在纯 FLOPs 预算下就有内点最优(U 形),因为上下文惩罚项会随 $K$ 增长。MOSAIC 发现纯 model-FLOPs 预算下 MoE 的 loss 随 $S$ 单调下降,最优点总是贴在数据边界,只有加入集群系统约束后才出现内点。X-MoD 的 $A$ 维度出现了与 MOSAIC 完全相同的现象:$\hat A=5$ 落在网格边界。
- 可比的方法 / 实验差异:MOSAIC 的核心论点正好击中 X-MoD 的一个软肋:FLOPs 最优不等于墙钟最优。X-MoD 自己的 Table 11 就说明了这一点:A3K16 的 FLOPs 是 Dense 的一半,训练吞吐却只有 Dense 的 0.95 倍。X-MoD 的定律没有 MFU 或「可交付 FLOPs」这一层,所以它按 FLOPs 选出的 $K^*$(如 32k 时约 18)不一定是墙钟意义上的最优点。深度方向的稀疏还有 MoE 没有的系统代价(数百层的串行 kernel、逐层的 token 收集和散回),更需要一个 MOSAIC 式的系统感知阶段。
讨论与局限性
复核一:对比口径——训练 FLOPs 对齐,推理 FLOPs 与 KV 更省,但 token 暴露没有对齐
MoD 类方法常见的问题是训练算力对齐了、推理成本却没对齐,或者反过来。X-MoD 的情况是:
| 维度 | X-MoD vs Dense / MoE | 是否对齐 |
|---|---|---|
| 激活等效参数 $N_{\mathrm{act}}$ | 相同(28 层当量) | ✓ |
| 训练总算力 $C$ | 相同 | ✓ |
| 每 token 推理 FLOPs | 约 0.46–0.57 倍 | X-MoD 更省 |
| 每 token KV cache(层当量) | 28 = 28(我的推算) | ✓(隐含对齐) |
| 总参数(vs MoE) | 0.86–1.07 倍 | ≈ |
| 训练 token 数 | 约 1.75–2.2 倍 | ✗ |
| 物理深度 | 161 / 298 层 vs 28 层 | ✗ |
所以按 FLOPs 计,X-MoD 在训练侧和推理侧都占优,没有「训练赢、推理输」的问题。真正的问题是:等训练 FLOPs 意味着 X-MoD 多看了约一倍的数据,Table 1 里对 MoE 的领先,需要回答它来自架构还是来自数据量。
复核二:收益来源——32k 注意力 FLOPs 的节省,而非稀疏深度容量本身
按 Eq.(24)/(25),X-MoD 与同 $N_{\mathrm{act}}$ 的稠密模型投影和 FFN 的 FLOPs 完全相同,只有注意力矩阵项不同。记 $f$ 为稠密模型每 token FLOPs 中注意力矩阵项所占的比例,$r_{\text{attn}}$ 为 X-MoD 注意力项相对稠密的比例,则
$$\frac{\phi_{\mathrm{X\mbox{-}MoD}}}{\phi_{\mathrm{dense}}}=(1-f)+f\cdot r_{\text{attn}} \tag{40}$$
每个稀疏层只让 $1/K$ 的 query 去看 $L/K$ 个 key,平均每 token 相当于 $1/K^2$ 个稠密注意力层。A4K8 有 9 个稠密层和 152 个稀疏层:$r_{\text{attn}}=(9+152/64)/28=0.406$。A3K16 有 10 个稠密层和 288 个稀疏层:$r_{\text{attn}}=(10+288/256)/28=0.397$。代入 Table 1 的 $\phi/\phi_D$ 反解 $f$:
| $N_{\mathrm{act}}$ | A4K8 $\phi/\phi_D$ → $f$ | A3K16 $\phi/\phi_D$ → $f$ | 用该 $f$ 验算 MoD 的 $\phi/\phi_D$(实测) |
|---|---|---|---|
| 556M | 0.47 → 0.89 | 0.46 → 0.90 | 0.92(0.92) |
| 936M | 0.51 → 0.83 | 0.50 → 0.83 | 0.92(0.92) |
| 1.65B | 0.57 → 0.72 | 0.56 → 0.73 | 0.93(0.93) |
(MoD 的 $r_{\text{attn}}=(25+24/64)/28=0.906$。)两种 X-MoD 配置反解出的 $f$ 彼此吻合,用它反推 MoD 的 $\phi/\phi_D$ 也与实测一致,说明这个分解是自洽的。结论是:在本文的 FLOPs 口径下,$L$ = 32k 时注意力矩阵乘法占稠密每 token FLOPs 的约 72–90%,X-MoD 的每 token FLOPs 减半几乎全部来自稀疏层只在路由子集内做注意力。MoE 的稀疏化只作用在剩下 10–28% 的投影和 FFN 上,对占大头的注意力完全没动。
有几条独立证据都指向「注意力 FLOPs 节省 → 更多 token」才是 X-MoD 胜过 MoE 的主因:
- 同 token 的纯容量对照输给 MoE:Routed-FFN 在 $D/D_D=1.00$ 时落后 MoE 0.063 / 0.070(见 Table 2 的补充解读)。
- 图 2(a) 的上下文依赖:$L$ = 2k 时稀疏化的最大收益只有约 0.015,$L$ = 32k 时约 0.15。上下文越短,注意力占的 FLOPs 越少,X-MoD 可省的也越少。
- Selected-Q/full-KV:让稀疏层看完整上下文、失去注意力节省后,损失退到与 MoD 相当。
论文把 $L$ 依赖解释为「稀疏上下文修正」(长上下文下稀疏层少看点上下文也没关系),并用一个自相矛盾的嵌套模型比较舍弃了暴露项 $P_D$(见复核三)。但在固定 $C$ 下,$D_{\mathrm{sparse}}/D_{\mathrm{dense}}=\phi_D/\phi_X$ 本身就强烈依赖 $L$,$P_L$ 与 $P_D$ 高度共线,而数据无法区分这两种解释。这正是「引入新信号 ≠ 收益来源」的一个典型案例:论文引入的新东西是「深度方向的稀疏容量」,Table 1 对 MoE 的领先却主要由另一件事驱动,即注意力 FLOPs 转换成的训练 token。
另外还有一个论文没有交代的变量:文档掩码。FineWeb-Edu 的文档普遍远短于 32k,如果把多篇文档打包进 32k 序列而不加文档级掩码,大部分注意力计算发生在互不相关的文档之间,砍掉它们的代价很小(图 2(b) 的最优稀疏上下文只有 683–2979 个 token)。如果像 SMELT 那样用 segment 级掩码、按平均文档长度计 FLOPs,稠密模型的 $f$ 会小得多,X-MoD 的 $\phi$ 优势和 token 暴露优势都会大幅缩水。
结论:「稀疏深度可以作为稀疏宽度的有效替代」这一论断,只在「32k 长上下文预训练、注意力按全长计算」这一特定条件下得到了支持。要证明深度方向的容量本身更好,至少需要以下之一:MoE 加上同等程度的注意力稀疏化(如稀疏或滑窗注意力)再比较;在短上下文下与 MoE 比较;或在等 token 暴露下比较。
复核三:Scaling law——比「2–3 个点连线」强,但只是一个设计面拟合
做得好的地方:不是 2–3 个点连一条曲线。$L$ 有 5 个区间内取值、$N_{\mathrm{act}}$ 有 4 个、$A$ 有 6 个,共 109 个观测;外推组在拟合前预设,没有事后挑选;样本外检验用分组留出,而不是随机点级留出。这套做法在同类工作里算规范。
局限:
- 没有 $C$/$D$ 维度。定律写成 $\Delta(C,L,N_{\mathrm{act}},K,A)$,右边却没有任何 $C$ 项,$C$ 只通过稠密参照 $\widehat{\mathcal{L}}_{\mathrm{dense}}(C)$ 进入。每条扫描都在各自固定的算力下做,所以定律隐含假设稀疏收益与训练预算无关,而这一点没有被检验。名字叫 scaling law,实际上是一个条件设计面,没法回答「算力翻十倍时稀疏收益会变成多少」。
- 外推范围窄:$N_{\mathrm{act}}$ 区间内只跨 5.7 倍(165M–936M),外推只多 1.76 倍;$L$ 只外推 2 倍。$\eta_N=0.078$ 意味着定律在这个范围里基本认为规模不影响稀疏收益,而 Table 1 里对 Dense 的收益(0.270 → 0.233 → 0.209)以及图 3(a) 中 1.65B 外推点的乐观偏差,都暗示规模效应可能被低估了。
- 外推误差与架构领先幅度同量级:外推 RMSE 0.0196,X-MoD 对 MoE 的领先是 0.008–0.025。所以这条定律无法用来预测更大规模上 X-MoD 是否仍然胜过 MoE,它能指导的只是 X-MoD 内部 $K$、$A$ 怎么选。
- A–K 交互只在一个点上拟合:锚点扫描只在 165M、32k 一个组合上做,$\rho_A$、$\rho_K$、$z$ 三个参数都来自这一个切片;leave-one-$A$-out 检验的也只是这个切片内部的迁移,而且最优 $A$ 落在网格边界。
- 嵌套模型的矛盾:完整候选律(含 $v\ge0$ 的 $P_D$ 项)包含约化律($v=0$)这一特例,样本内拟合 RMSE 本不应更高(0.01349 > 0.008758)。出现这个结果,说明 differential evolution 加约束最小二乘的两阶段流程在完整律上没有收敛到 $v=0$ 的解,或者两者的「合并 RMSE」口径不同。无论哪种情况,「$P_D$ 不必要」这个结论的依据都很弱,而它又正好对应复核二中最关键的混杂因素。
- 预测需要目标设置下的稠密参照:Eq.(37) 要把预测残差加回同设置的稠密损失,所以在新规模或新上下文长度上,仍需先训练稠密模型或借助稠密 scaling law,才能得到 X-MoD 的预测损失。
- 自由度与相关性:10 个参数拟合 109 个点,但作者自己也指出同一扫描内的点高度相关,有效样本量远小于 109,$R^2_\Delta=0.985$ 需要结合这一点来看。
复核四:FLOPs vs 墙钟——加速是实测的,但主对比没有按墙钟对齐
Table 11 的吞吐是在 2,000 步训练和四遍完整验证上实测的,这值得肯定。但主对比按 FLOPs 对齐。用 Table 7 的 $D/D_D$ 和 Table 11 的训练吞吐,可以推算出等 FLOPs 主实验各自需要的相对墙钟时间(936M;以 Dense 为 1):
$$T\propto\frac{D/D_D}{\text{throughput}} \tag{41}$$
| 模型 | $D/D_D$ | 训练吞吐(M tok/s) | 等 $C$ 所需相对墙钟 | vs 配对 MoE |
|---|---|---|---|---|
| Dense | 1.00 | 0.041 | 1.00 | — |
| MoE 8:64 | 1.00 | 0.027 | 1.52 | 1.00 |
| X-MoD A4K8 | 1.96 | 0.052 | 1.55 | 1.02 |
| MoE 8:128 | 1.00 | 0.023 | 1.78 | 1.00 |
| X-MoD A3K16 | 2.00 | 0.039 | 2.10 | 1.18 |
也就是说,X-MoD 在 Table 1 里的训练花掉的墙钟与 MoE 基本持平(A4K8),甚至多 18%(A3K16),是 Dense 的 1.55–2.1 倍。如果按墙钟对齐,X-MoD 对 MoE 的领先不会扩大,对 Dense 的比较也会变得不利于 X-MoD(Dense 能在同样时间里多训 55–110% 的算力)。
推理侧:验证前向对 MoE 快 1.73× / 1.42×,这是真实的推理优势;但对 Dense 只有 1.35× 和 0.96×,而且:
- MoE 基线是 DDP、没有专家并行,同 FLOPs 下只有 Dense 吞吐的 0.56–0.78 倍(8:64 训练 0.66、前向 0.78;8:128 训练 0.56、前向 0.68),相对加速被这个实现放大了;
- 没有测 prefill 和自回归解码。A3K16 有 298 个物理层,解码时每一步都要逐层串行地做路由判断;阈值路由下 batch 内不同请求走不同的层,批处理也不规整。解码延迟很可能是这类架构最大的系统短板,但论文没有覆盖。
复核五:消融降幅 vs 对最强基线的领先
按归档的常规做法,把各组件的消融降幅与 X-MoD 对最强基线的领先幅度对照。936M 规模下,X-MoD 对配对 MoE 的领先为 0.010–0.018。
| 被移除组件(A1K16) | ΔLoss | 与 0.010–0.018 的领先相比 | 解读 |
|---|---|---|---|
| token-choice bias | +0.181 | 远超(10–18 倍) | 可训练性的必要条件;去掉后比 Dense 还差 |
| 稠密锚点 | +0.103 | 远超(6–10 倍) | 可训练性的必要条件 |
| 门控残差缩放 | +0.016 | 同量级 | 与领先幅度无法区分 |
| 稠密前缀 | +0.011 | 同量级 | 与领先幅度无法区分 |
要分开看两类组件:
- token-choice bias 和稠密锚点是「让深层稀疏堆叠成立」的必要条件,降幅远大于领先幅度,结论稳健。但必要不等于收益来源,它们是稳定器;X-MoD 相对 MoE 的优势来自哪里,复核二已经分析过。
- 门控残差缩放和稠密前缀的降幅与领先幅度同量级。消融是单种子,没有置信区间,而且做在 A1K16 上(它本身就输给 MoE),没有在 A4K8 / A3K16 上复现。所以无法判断:去掉这两个组件中的任何一个之后,A4K8 / A3K16 是否仍然胜过 MoE。
其他局限与值得借鉴之处
局限:
- 规模小:最大激活 1.65B、总参 17B、训练算力 $2.5\times10^{20}$ FLOPs,属于学术规模;只用 FineWeb-Edu 一个语料和 GPT-2 tokenizer,从零开始用 32k 上下文预训练,这在实际做法里不常见。
- 统计:全部单种子;验证集 0.2B token;多数关键差距只有 0.01–0.02。
- 超参只在 Dense 上调:Muon 的学习率在 Dense 上选出后直接给 MoD、MoE、X-MoD 共用。深达 298 层的 X-MoD 与细粒度 MoE 的最优学习率可能都不同,偏向谁无法判断。
- 实现细节缺失:token-choice bias 的增量和 $\tau$ 没有给出;「w/o dense anchors」的具体层级也没有说明。
- 系统侧:解码、prefill、流水线并行和专家并行下的表现都没有测。作者在局限一节也承认,需要专门的 kernel、调度和并行方案,X-MoD 才能在更大规模上实用。
值得借鉴:
- 「相对 FLOP 匹配稠密的残差」建模:把稠密骨干当作稳定参照、只对架构特有的残差建模,比直接拟合原始 loss 更容易解释,也更容易迁移,可以用在任何新架构的设计律上。
- 协议卫生:外推组事先预设,样本外用分组留出,对照表主动报告 token 暴露 $D/D_D$,吞吐实测而不是估算。Table 7 的 $D/D_D$ 列值得所有等 FLOPs 比较照搬,它让读者能自行判断收益是不是来自多看的数据。
- 深度方向的 token 均衡:随选中次数递增、到锚点清零的偏置,是一个便宜且有效的防塌缩手段(Jaccard 从 80.66% 降到 14.51%),可以迁移到任何多层 token 路由的场景。
- top-k 训练与阈值推理的对齐损失,加上一致率诊断:这是 MoD 类方法走向可部署的必要一环。
对推荐系统的启示:长用户行为序列的排序模型同样是注意力占大头。X-MoD 的做法本质上是「只让一部分 token 进入廉价的稀疏层,并且只在这个子集内做注意力」,可以借鉴到时延受限、需要扩参的长序列 ranker 上。但本文的教训同样适用:这种做法的收益主要来自注意力计算的节省,所以对照组应该是稀疏注意力、线性注意力、序列压缩这类方法,而不只是 MoE。