VARG:把业务价值序刻进 SID 第三位 token 的天猫搜索生成式召回—粗排一体化系统¶
Xiaopeng Chu, Jianbo Zhu, Mingmin Jin, Jing Wang, Xing Fang*, Wenyi Zhang(中国科学技术大学 + 南开大学 + 阿里巴巴淘天集团,2026-09-13,arXiv:2609.14493,工业电商搜索)
研究动机与背景¶
电商搜索的主流工程形态是 recall → pre-rank → rank 级联漏斗:召回阶段从亿级商品库里捞出候选,粗排(pre-ranking)用一个轻量模型把候选压到最终排序器(final ranker)能吃下的规模。这套结构的根本约束是 下游排序器无法恢复被上游丢掉的商品,所以候选选择环节必须在严格的延迟与算力预算下尽可能保住高质量商品。
生成式检索(Generative Retrieval, GR)把候选选择重述为「从上下文直接生成标识符」,从文档检索(DSI、NCI、SEAL)一路延伸到层次化物品 ID(TIGER),近年工业界又把它推向「检索—排序统一」(OneRec、OneRec-V2)与「意图增强搜索」(OneSearch-V2)。它的吸引力在于:query 语义、用户偏好、行为上下文被联合建模,物品选择与候选优先级都由生成概率一次性表达。
本文的系统设定与多数工作不同:不是端到端替换级联,而是"召回—粗排一体化"(recall-and-pre-ranking integration)。VARG 作为一条额外的生成式通道,生成的候选通过一个 预留配额(reserved quota)绕过 item 级粗排,直接进入线上已有的最终排序器,与常规多路召回的结果合并去重后一起排序(Figure 1)。
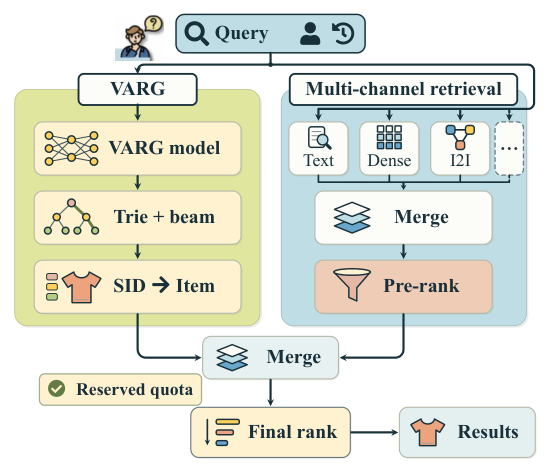
绕过粗排意味着生成的候选必须自己在有限配额内同时保证相关性、个性化与商业价值。作者据此拆出三个互相纠缠的挑战:
挑战一:item 级选择能力与寻址稳定性。 簇级标识符(cluster-level identifier,如同团队前作 CQ-SID)通过让多个 item 共享 SID 提升生成阶段的覆盖率,但共享标识符使模型无法区分簇内单个 item;一旦 item 级粗排被绕过,相关性更弱、价值更低的 item 就会白白占掉预留槽位。业务排序型标识符(CRID 一类)能提供更细的地址与价值先验,但转化率估计带噪 + 每日重排会改变已有 item 的地址,破坏模型已学会的寻址关系;而学习新品又有遗忘旧知识的风险(DSI++)。
挑战二:面向上下文检索的监督学习。 模型既要记住 item→标识符映射,又要按 query 意图和用户偏好挑 item。难点在于把「物品记忆」延伸到「query 语义检索」和「个性化检索」的同时,让监督信号反映标识符本身编码的语义层级与簇内序关系。
挑战三:业务价值与排序对齐。 同一 item 的转化倾向随 query 和用户变化,而仅从「观测到的目标 item」学习,对如何比较其他候选的质量与价值几乎没有指导。策略优化是一条路,但点击/购买匹配极稀疏,难以区分未观测候选;训练反馈还应覆盖候选相关性与下游排序表现,同时防止非法输出拿到正向 credit。
四点贡献:(1) VARG-ID——初始构造即无碰撞的层次标识符,双向 Q2I 对比学习把搜索相关性注入语义前缀,稳定的经验贝叶斯转化率(EB-CVR)序把业务价值编进第三位 token,并配套每日刷新机制;(2) 三阶段 SFT 流水线,从物品记忆递进到 query 语义检索与个性化检索,Stage 3 叠加 Q2I 价值加权、SID 层级加权、上下文扩展与 LO-SFT 局部序监督;(3) Prefix-GRPO——门控多源奖励(SID 合法性 / 用户行为 / 排序器优势 / 搜索相关性)+ 前缀感知 token 加权;(4) 天猫 App 14 天 20% 流量线上 A/B,GMV +1.45%。
核心方法 / 模型架构¶
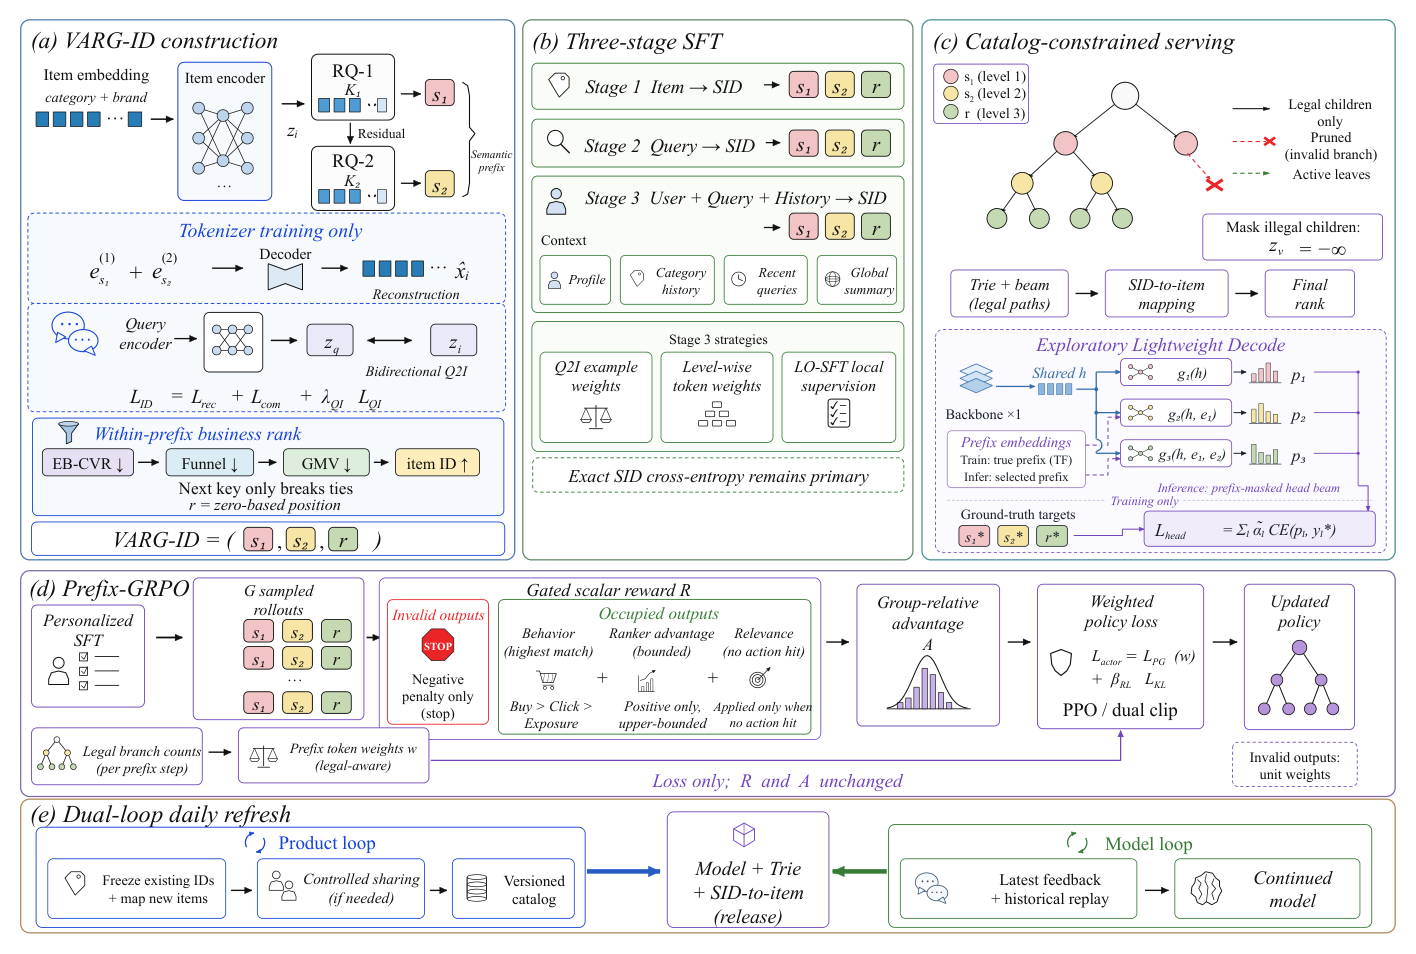
问题形式化。 给定 query $q$、用户画像 $u$、历史 $h$,一个 Transformer 以上下文 $x=(q,u,h)$ 为条件,自回归生成三段式物品标识符 $y=(s_1,s_2,r)$。推理时用 Trie 约束的 beam search 产出 $K$ 个 SID 的有序候选列表 $\mathcal{Y}_K$,经 SID-to-item 映射展开成商品候选,直接作为额外召回通道送进已有最终排序器。
3.1 VARG-ID:先语义,后稳定价值¶
VARG-ID 由语义前缀和价值序 token 两部分组成:query 对齐的前缀负责语义路由,第三位 token 提供前缀内细粒度 item 地址与业务价值先验。
语义前缀构造。 物品 embedding $x_i \in \mathbb{R}^{d_x}$ 融合类目与品牌属性,经 item encoder $E_I$ 映射到 $z_i \in \mathbb{R}^{d_z}$;query encoder $E_Q$(仅在 tokenizer 训练阶段使用)把配对的搜索 query 映射到 $z_q \in \mathbb{R}^{d_z}$。两个大小为 $K_1$、$K_2$ 的码本顺序做残差量化:
$$s_{1,i} = \arg\min_k \|z_i - e^{(1)}_k\|_2^2,\quad \delta^{(1)}_i = z_i - \mathrm{sg}(e^{(1)}_{s_{1,i}}),\quad s_{2,i} = \arg\min_k \|\delta^{(1)}_i - e^{(2)}_k\|_2^2,\quad z^q_i = e^{(1)}_{s_{1,i}} + e^{(2)}_{s_{2,i}} \tag{1}$$
其中 $\mathrm{sg}$ 为 stop-gradient。解码器使用直通估计 $z^{ST}_i = z_i + \mathrm{sg}(z^q_i - z_i)$:前向值等于 $z^q_i$,而重构梯度流回 item encoder。
Query 对齐的 tokenizer 目标。 联合优化重构、承诺(commitment)与双向 query–item 对比损失:
$$\mathcal{L}_{\text{rec}} = \|D(z^{ST}_i) - x_i\|_2^2 \tag{2a}$$
$$\mathcal{L}_{\text{com}} = \frac{1}{2}\Big( \|z_i - \mathrm{sg}(e^{(1)}_{s_{1,i}})\|_2^2 + \|\delta^{(1)}_i - \mathrm{sg}(e^{(2)}_{s_{2,i}})\|_2^2 \Big) \tag{2b}$$
$$\mathcal{L}_{\text{QI}} = \frac{1}{2}\big( \mathrm{CE}(S, I) + \mathrm{CE}(S^\top, I) \big),\quad S_{ab} = \frac{\bar z_{i,a}^\top \bar z_{q,b}}{\tau_{\text{QI}}} \tag{2c}$$
$$\mathcal{L}_{\text{ID}} = \mathcal{L}_{\text{rec}} + \mathcal{L}_{\text{com}} + \lambda_{\text{QI}} \mathcal{L}_{\text{QI}} \tag{2d}$$
重构保留物品 embedding 信息,承诺项把 encoder 输出拉向离散码字,双向 InfoNCE 在量化之前把配对 query 与 item 表征在连续空间里拉近,从而把搜索相关性注入语义前缀。$\tau_{\text{QI}} > 0$ 为对比温度,$\lambda_{\text{QI}} > 0$ 为权重;对比矩阵 $S$ 的对角线是正样本对,标签 $I = (0,\dots,N-1)$,同一 local minibatch 内其余合法 query–item 组合作为负样本。无 query 的样本只优化重构与承诺损失。 码本用确定性 K-means 初始化、EMA 更新。
前两位码构成语义前缀 $c(i) = (s_{1,i}, s_{2,i})$,第三位 token $r_i$ 表示该 item 在此前缀内的价值排名位置,三者一起在初始构造时给出唯一物品地址:
$$y_i = (s_{1,i},\, s_{2,i},\, r_i),\qquad 0 \le r_i < K_3 \tag{3}$$
$r_i$ 是 zero-based,$K_3$ 为 rank token 词表大小。
价值序物品地址。 设 $b_i$、$a_i$、$c_i$ 为固定统计窗内 item 的购买、加购、点击次数,令 $v_i = b_i + \eta_a a_i$,用经验贝叶斯平滑估计转化价值:
$$p_0 = \frac{\sum_i v_i}{\sum_i c_i},\qquad \hat p_i = \frac{v_i + \alpha_{\text{ID}}\, p_0}{c_i + \alpha_{\text{ID}}} \tag{4}$$
再定义行为分 $V^{\text{funnel}}_i = \gamma_b b_i + \gamma_a a_i + \gamma_c c_i$,在每个前缀内按下述漏斗规则(字典序比较多个 key,后一个 key 只用于破平局)排序:
$$\hat p_i \downarrow \;\longrightarrow\; V^{\text{funnel}}_i \downarrow \;\longrightarrow\; \mathrm{GMV}_i \downarrow \;\longrightarrow\; \mathrm{ID}_i \uparrow \tag{5}$$
其中 $0 < \eta_a < 1$、$\alpha_{\text{ID}} > 0$、$\gamma_b > \gamma_a > \gamma_c > 0$,反映「购买 > 加购 > 点击」的行为优先级。经验贝叶斯平滑抑制低频噪声同时保留转化价值信息——§4.2 会用实验说明它的序比原始点击序、成交量序更稳定。
设计动机解读:这一步把「语义重构」与「业务转化」两个目标在标识符内部做了分工——前两位只管语义路由,第三位只管前缀内的价值消歧。既然 SID 空间总要有一层做细粒度区分,不如直接把这一层的编码目标换成业务价值序,一举拿到「无碰撞 + 价值先验」。
3.2 双环每日刷新(Dual-Loop Daily Refresh)¶
商品环(product loop)。 在同一个 primary SID 版本内,冻结 RQ-VAE 与 SID 词表,保留已有 item 的 SID 不变。落在已有语义前缀里的新品按其簇内价值排名复用历史槽位;新出现的前缀从 0 开始分配地址。
举例:某前缀下已有 A、B、C 三个 item,第三位 token 分别是 0、1、2。若新品 D 按价值排在 A 与 B 之间,则 D 复用槽位 1、与 B 共享同一个 SID,而 A、B、C 的地址全部保持不变。
形式化:对前缀 $c=(a,b)$,令 $C^{(t)}_c = C^{(t)}_{ab}$ 为快照 $t$ 时被占用的不同 rank 槽位数;已占用前缀的最大 rank 为 $M_t(c) = C^{(t)}_c - 1$,未见过的前缀容量为零。令 $\rho_t(i)$ 为新品 $i$ 在快照 $t$ 按 Eq. (5) 与同前缀所有新旧 item 联合排序后的 zero-based 位置,则其分配的 rank 为:
$$r_t(i) = \begin{cases} \min\{\rho_t(i),\; M_{t-1}(c(i))\}, & C^{(t-1)}_{c(i)} > 0,\\[2pt] \min\{\rho_t(i),\; K_3 - 1\}, & C^{(t-1)}_{c(i)} = 0. \end{cases} \tag{6}$$
Eq. (6) 把超出可用槽位范围的新品映射到最后一个槽位;对新前缀,最大槽位索引为 $K_3-1$。分配后的地址在同一 primary 版本内固定不变,共享槽位的 item 在 serving 时一起展开成候选交给下游排序。
模型环(model loop)。 每天用「行为发生时生效的 SID 映射」给最新点击/购买数据打标签;在同一 primary SID 版本内,从上次被采纳的个性化生成模型继续训练 $E_{\text{day}} \in \mathbb{N}^+$ 个 epoch,并按比例 $0 \le \lambda_{\text{replay}} \le 1$ 混入历史回放(replay),既吸收新反馈又保住已学的寻址关系。验证通过后,模型、Trie、item map 作为一个兼容的版本组合原子发布。
月度重建引入新的 primary 版本:训练标签、SID 编码的历史、回放数据全部重新编码,检索模型重训后与新版本联合部署,被采纳的模型再初始化下一轮日更周期。
3.3 三阶段 SFT¶
在 Qwen2.5-0.5B-Instruct 的词表上为 SID 第 $\ell$ 层新增 $K_\ell$ 个专用 token。给定上下文 $x$,模型自回归生成目标标识符:
$$p_\theta(y \mid x) = \prod_{\ell=1}^{3} p_\theta(y_\ell \mid x, y_{<\ell}) \tag{7}$$
三个阶段顺序串联(后一阶段从前一阶段 checkpoint 继续):
- Stage 1 Item→SID:从商品内容学物品地址记忆;
- Stage 2 Query→SID:学 query 语义检索;
- Stage 3 User+Query+History→SID:学个性化检索。
Stage 3 的最终 checkpoint 同时初始化 Prefix-GRPO 的可训练策略 $\pi_\theta$ 与固定参考策略 $\pi_{\text{ref}}$。
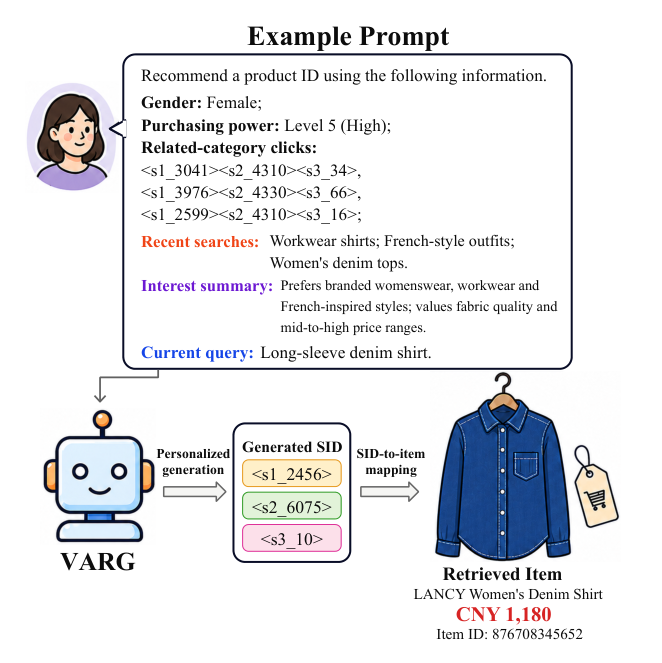
用户上下文扩展。 个性化输入为 $x = (q, u, h_{\text{cat}}, h_{\text{recent}}, g)$:$q$ 为当前 query,$u$ 为含性别与购买力的用户画像,$h_{\text{cat}}$ 是用历史 SID 表示的相关类目点击历史,$h_{\text{recent}}$ 是最近 $L_{\text{recent}}$ 条搜索 query,$g$ 是从跨域行为蒸馏出的全局兴趣摘要。最近 query 提供短期意图信号,全局摘要通过总结类目、品牌、价格偏好表示长期兴趣。
Q2I 样本加权。 为刻画不同 query–item 对的转化差异,用固定历史窗内的购买/点击统计构造样本权重。设 $b_j$、$c_j$ 为 query–item 对 $j$ 的购买与点击数:
$$p_{0q} = \frac{\sum_j b_j}{\sum_j c_j},\quad \hat p_j = \frac{b_j + \alpha_q p_{0q}}{c_j + \alpha_q},\quad \tilde w_j = \mathrm{clip}\Big(\frac{\hat p_j}{p_{0q}},\, w_{\min},\, w_{\max}\Big),\quad w_j = \frac{\tilde w_j}{\mathbb{E}[\tilde w]} \tag{8}$$
$\alpha_q > 0$ 为先验强度,裁剪边界满足 $0 < w_{\min} < 1 < w_{\max}$。平滑后的转化率与全局先验之比被裁剪并按均值归一,从而给转化倾向更高的 query–item 对更大权重。该信号只在 Stage 3 激活,Stage 1–2 保持等权,以学到无偏的物品记忆与 query 语义。
层级感知 token 加权。 三个目标位置的决策角色不同:$s_1$ 选粗粒度语义区域,$s_2$ 选细粒度语义前缀,$r$ 只有在前缀正确后才真正定位 item。作者用一个关键观测来定权:在 Trie 约束的 Top-1000 评测下,L1 与 L1+L2 之间的 HR gap 是 16.94 个百分点,而 L1+L2 与完整 SID 之间只有 3.80 个百分点——说明第二层才是主要预测瓶颈。令 $\ell_{j,t} = -\log p_\theta(y_{j,t}\mid x_j, y_{j,<t})$ 为逐 token 交叉熵,$m_{j,t}$ 为 response mask,$\lambda(y_{j,t})$ 为 token 所属层级:
$$\mathcal{L}^{\text{level}}_j = \frac{\sum_t m_{j,t}\, \alpha_{\lambda(y_{j,t})}\, \ell_{j,t}}{\sum_t m_{j,t}\, \alpha_{\lambda(y_{j,t})}} \tag{9}$$
层级系数满足 $\alpha_2 > \alpha_1 > \alpha_3 > 0$ 以强化前两层监督;非 SID 的 response token 保持单位权重。与 Q2I 样本权重结合即得 Stage 3 训练目标:
$$\mathcal{L}_{\text{SFT3}} = \frac{\sum_j w_j\, \mathcal{L}^{\text{level}}_j}{\sum_j w_j} \tag{10}$$
局部序监督(LO-SFT)。 标准交叉熵把 rank token 当成互不相关的离散类别,完全没利用它们之间的序数距离。LO-SFT 从训练好的 Stage-3 SFT Base checkpoint 继续微调,在目标位置周围加一圈基于价值排名的局部监督。对槽位容量 $C = C_{ab} \ge C_{\min}$ 的前缀,构造一个以真实 rank $r^*$ 为中心、随距离衰减的局部目标分布,同时保留精确 token 损失:
$$q(r \mid r^*) = \frac{\exp(-|r - r^*| / \tau_{\text{LO}})}{Z(r^*)}\, \mathbb{I}[\,|r - r^*| \le R_{\text{LO}}\,] \times \mathbb{I}[\,0 \le r < C\,] \tag{11a}$$
$$\mathcal{L}_{\text{LO}} = \mathcal{L}_{\text{exact}} - \lambda_{\text{LO}} \sum_{r=0}^{C-1} q(r \mid r^*)\, \log p_\theta(r \mid x, s_1, s_2) \tag{11b}$$
$C_{\min}$ 是最小前缀容量阈值,$R_{\text{LO}}$ 是邻域半径,$\tau_{\text{LO}} > 0$ 控制距离衰减,$\lambda_{\text{LO}} > 0$ 是辅助损失权重,$Z(r^*)$ 是合法邻域上的归一化常数。精确损失监督目标 SID,辅助项引导模型学会 EB-CVR 序编码的局部序关系。
3.4 Prefix-GRPO¶
在监督学习基础上,Prefix-GRPO 按奖励调整候选生成概率,把候选优先级进一步对齐到业务价值与排序目标。用 group-relative policy optimization,每个 prompt 采样 $G$ 条 response,$(T_{\text{roll}}, p_{\text{roll}}, k_{\text{roll}})$ 分别控制采样温度、nucleus 采样与 top-$k$ 截断。
Response 契约与门控奖励。 去掉控制 token 后,response 必须恰好是 $y = \langle s_1 a\rangle \langle s_2 b\rangle \langle s_3 r\rangle$,且 $0 \le a < K_1$、$0 \le b < K_2$、$0 \le r < K_3$。在 RL 训练快照里,满足 $C_{ab} > 0$ 且 $0 \le r < C_{ab}$ 的 SID 对应一个已占用槽位。只有格式正确且已占用的 SID 才参与后续奖励计算,其余输出只拿对应的负奖励。
设 $\mathcal{P}_x$、$\mathcal{C}_x$、$\mathcal{E}_x$ 分别为请求 $x$ 匹配到购买、点击、曝光行为的 SID 集合,行为奖励取「购买 > 点击 > 曝光」优先级下最高匹配的那一档:
$$R_{\text{UA}}(x,y) = \begin{cases} \beta_{\text{buy}}, & y \in \mathcal{P}_x,\\ \beta_{\text{clk}}, & y \notin \mathcal{P}_x,\ y \in \mathcal{C}_x,\\ \beta_{\text{exp}}, & y \notin \mathcal{P}_x \cup \mathcal{C}_x,\ y \in \mathcal{E}_x,\\ 0, & \text{otherwise.} \end{cases} \tag{12}$$
排序器优势奖励偏好那些在同一请求下分数高于候选均值的 item。令 $f_x(y)$ 为生产排序器的最终分,$\mu^f_x$、$\sigma^f_x$ 为该请求下所有映射召回候选的均值与标准差:
$$a_x(y) = \frac{f_x(y) - \mu^f_x}{\sigma^f_x},\quad \tilde a_x(y) = \begin{cases} a_x(y), & 0 < a_x(y) < \infty,\\ 0, & \text{otherwise},\end{cases}\quad R_{\text{adv}}(x,y) = \beta_{\text{adv}} \tanh\!\Big(\frac{\tilde a_x(y)}{\tau_{\text{adv}}}\Big) \tag{13}$$
注意这里做了两重保守化:只取正优势(低于均值的不惩罚),且用 $\tanh$ 做有界压缩。
对已占用但没有匹配到任何用户行为的 SID,用相关性等级 $g_x(y)$ 提供补充反馈:
$$R_{\text{rel}}(x,y) = \begin{cases} \beta^{(3)}_{\text{rel}}, & g_x(y) = 3,\\ \beta^{(2)}_{\text{rel}}, & g_x(y) = 2,\\ -\beta^{(1)}_{\text{rel}}, & g_x(y) = 1,\\ 0, & \text{otherwise.}\end{cases} \tag{14}$$
令 $\mathcal{F}$ 为格式错误或越界输出,$\mathcal{U}$ 为结构合法但未占用的输出,$\mathcal{H}_x = \mathcal{P}_x \cup \mathcal{C}_x \cup \mathcal{E}_x$,完整奖励为:
$$R(x,y) = \begin{cases} -\beta_{\mathcal{F}}, & y \in \mathcal{F},\\ -\beta_{\mathcal{U}}, & y \in \mathcal{U},\\ R_{\text{UA}} + R_{\text{adv}}, & y\ \text{occupied},\ y \in \mathcal{H}_x,\\ R_{\text{adv}} + R_{\text{rel}}, & y\ \text{occupied},\ y \notin \mathcal{H}_x. \end{cases} \tag{15}$$
其中 $\beta_{\mathcal{F}} > \beta_{\mathcal{U}} > 0$,$\beta_{\text{buy}} > \beta_{\text{clk}} > \beta_{\text{exp}} > 0$,$\beta_{\text{adv}}, \tau_{\text{adv}} > 0$,$\beta^{(3)}_{\text{rel}} > \beta^{(2)}_{\text{rel}} > 0$,$\beta^{(1)}_{\text{rel}} > 0$。相关性奖励只对无行为匹配的 SID 生效,避免相关标签被重复计数。
前缀感知 token 加权。 不同前缀下合法 token 备选数量差异极大,作者用这个计数给 token 级策略损失定权——分支越多的决策权重越高。在 RL 训练快照中,第二、三层的合法子 token 数为:
$$n_2(a) = \sum_{b=0}^{K_2-1} \mathbb{I}[C_{ab} > 0],\qquad n_3(a,b) = C_{ab} \tag{16}$$
令 $N_2 = \max_a n_2(a)$,$N_3 = \max_{a,b} n_3(a,b)$,用下式把合法子 token 数映射到 $[d, 1]$:
$$\phi(n; N) = \begin{cases} d + (1-d)\dfrac{\log n}{\log N}, & N > 1,\\ d, & N = 1,\end{cases}\qquad 0 < d \le 1 \tag{17}$$
对已占用路径,token 权重为:
$$w_{s_1} = 1,\quad w_{s_2} = \phi(n_2(a); N_2),\quad w_{s_3} = \phi(n_3(a,b); N_3),\quad w_{\text{ctrl}} = d \tag{18}$$
第一层权重固定为 1,后续层按当前前缀下合法备选数加权;只有一个合法选项的分支以及 EOS / 控制 token 用下界 $d$。对格式错误或未占用的 response,所有合法 token 用单位权重。 这些权重只进策略损失(Eq. 20),不改变奖励 $R$ 与优势 $A$。
加权 GRPO 优化。 令 $R_{x,g}$ 为 prompt $x$ 第 $g$ 条 response 的奖励,$\bar R_x$、$s_x$ 为该 prompt 下 $G$ 条 response 奖励的均值与样本标准差。通过标准化、whitening、裁剪构造优势:
$$\hat R_{x,g} = \mathrm{clip}\Big(\frac{R_{x,g} - \bar R_x}{s_x + \varepsilon_{\text{num}}},\, -c_R,\, c_R\Big),\qquad A_{x,g} = \mathrm{clip}\big(\mathrm{Whiten}(\hat R_{x,g}),\, -c_A,\, c_A\big) \tag{19}$$
$\varepsilon_{\text{num}} > 0$ 提供数值稳定性,$c_R, c_A > 0$ 为裁剪阈值;同一条 response 的所有合法 token 共享同一个优势 $A_{x,g}$。
采用 PPO 式裁剪目标:令 $\rho = \pi_\theta(y_t\mid x,y_{<t}) / \pi_{\text{old}}(y_t\mid x,y_{<t})$,$\bar\rho = \mathrm{clip}(\rho, 1-\epsilon_{\text{PPO}}, 1+\epsilon_{\text{PPO}})$,代理目标 $J = \min(\rho A, \bar\rho A)$;当 $A < 0$ 时进一步施加 dual clipping $\max(J, c_{\text{dual}} A)$($c_{\text{dual}} > 1$),否则保留 $J$,记结果为 $J^{\text{dual}}_{x,g,t}$。对包含 $B$ 条采样 response 的 minibatch,前缀加权策略损失为:
$$\mathcal{L}_{\text{PG}} = -\frac{1}{B}\sum_{x,g} \frac{\sum_t m_{x,g,t}\, w_{x,g,t}\, J^{\text{dual}}_{x,g,t}}{\sum_t m_{x,g,t}\, w_{x,g,t}} \tag{20}$$
加上相对固定 SFT 参考策略的 KL 正则得最终目标:
$$\mathcal{L}_{\text{actor}} = \mathcal{L}_{\text{PG}} + \beta_{\text{KL}} \mathcal{L}_{\text{KL}} \tag{21}$$
$\mathcal{L}_{\text{KL}}$ 先在每条 response 的合法 token 上平均裁剪后的 KL 散度估计,再跨 response 平均。
3.5 Serving¶
推理时模型在扩展上下文条件下用 Trie 约束的 beam search 生成 Top-$K$ SID 路径,Trie 由已发布的 SID 集合构建。令 $\mathcal{T}(p)$ 为部分路径 $p$ 之后的合法子 token 集合,每次 beam 扩展前对 logits 做掩码:
$$\tilde z_v(p) = \begin{cases} z_v(p), & v \in \mathcal{T}(p),\\ -\infty, & v \notin \mathcal{T}(p).\end{cases} \tag{22}$$
第三层只允许满足 $0 \le r < C_{ab}$ 的已占用 rank token。掩码在 beam 扩展前剪掉非法分支,使生成的完整 SID 一定能映射回有效 item。Trie 由商品刷新环重建,并与 SID-to-item map 保持版本一致。
3.6 探索性轻量解码器¶
标准自回归解码每步都要过一次 Transformer。为降低推理成本,作者只计算一次 prompt 末位隐状态 $h$,再用轻量的、以前缀为条件的分类头逐层预测 SID token:
$$p_1(s_1\mid h) = \mathrm{softmax}(g_1(h)),\quad p_2(s_2\mid h,s_1) = \mathrm{softmax}(g_2([h; e_1(s_1)])),\quad p_3(s_3\mid h,s_1,s_2) = \mathrm{softmax}(g_3([h; e_1(s_1); e_2(s_2)])) \tag{23}$$
$e_l$ 是第 $l$ 层 SID token 的 embedding,$g_l$ 是对应预测头。训练用 teacher forcing,二、三层头以真值上层 token 为条件。对 $L=3$ 层,归一化损失系数 $\alpha_l > 0$:
$$\tilde\alpha_l = \frac{L\,\alpha_l}{\sum_{j=1}^{L}\alpha_j},\qquad \mathcal{L}_{\text{head}} = \sum_{l=1}^{L}\tilde\alpha_l\, \mathrm{CE}(p_l, s_l) \tag{24}$$
推理时在各预测头之间做层次化 beam 扩展,前缀掩码只保留已占用的 VARG-ID 子 token。骨干只前向一次,后续决策全部由小预测头完成,消除了重复的 Transformer 前向。作者明确声明:这条路线仍属探索性质,未用于 VARG 主线上服务链路。
实验设置¶
数据。 全部实验基于天猫 App 真实搜索日志。VARG-ID 覆盖 51.43M 商品,tokenizer 在 query–item 对与纯 item 样本上训练。三阶段生成模型的训练样本量:Item2SID 51.43M、Query2SID 48.00M、个性化 User–Query2SID 105.69M。Prefix-GRPO 从请求级数据采样出约 1.03M 条训练池。个性化评测与 SID 重排审计用 3.85M 样本;轻量解码在单独的 180,324 条 query-only 集合上评测。
指标。
- $\mathrm{HR}@K$:目标 SID 是否出现在 top-$K$ 去重预测中;
- $\mathrm{NDCG}@K$:排序质量;
- GMV Recall:命中覆盖的评测样本价值占比,按 item 的 30 天 GMV 加权;
- Q2I-GMV Recall:同上,但按 query–item 对的 14 天 GMV 加权——这是本文最看重的「头部价值召回」指标;
- 线上 A/B:固定候选配额直接准入,14 天、20% 搜索流量,报告相对生产对照组的相对变化。
实现细节。 在 Qwen2.5-0.5B-Instruct 上扩展 SID token,128 卡全参数 SFT。学习率:Stage 1 为 $10^{-4}$,Stage 2–3 为 $4\times10^{-5}$,LO-SFT 为 $5\times10^{-6}$。SFT 各策略在匹配的 epoch 预算下评测。 Prefix-GRPO 在 64 卡上以学习率 $10^{-6}$ 训练,每 prompt 采样 8 条 response,每个 rollout batch 1,024 个 prompt。
超参数。 VARG-ID 两个语义码本与第三层 rank 词表都是 8,192($K_1=K_2=K_3=8192$)。重构与承诺损失各取单位权重;双向 Q2I 对比损失 $\lambda_{\text{QI}} = 0.001$、温度 $\tau_{\text{QI}} = 0.1$,每个 local minibatch 最多采 128 个合法 query–item 对。SFT 侧:Q2I 先验强度 $\alpha_q = 5$,意图扩展取最近 3 条 query($L_{\text{recent}}=3$);LO-SFT 用 $R_{\text{LO}}=3$、$\tau_{\text{LO}}=1.0$、$\lambda_{\text{LO}}=0.02$。Prefix-GRPO 侧:格式错误与未占用输出奖励分别为 $-2.0$ 与 $-1.0$;购买/点击/曝光奖励为 $3.0 / 1.0 / 0.1$;排序器优势用 $\beta_{\text{adv}}=0.2$、$\tau_{\text{adv}}=1.5$;相关性等级 3/2/1 对无行为匹配的已占用 SID 分别贡献 $+0.08 / +0.03 / -0.10$;前缀权重下界 $d=0.1$(EOS 与控制 token 同用),KL 系数 $\beta_{\text{KL}}=0.8$。
主要实验结果¶
4.2 SID 观测:什么样的标识符适合召回—粗排一体化¶
Table 1(a) 初始标识符容量与碰撞
| Identifier | Tokens | Unique | Exclusive | Collision | Avg. | P99 / Max |
|---|---|---|---|---|---|---|
| RQ-VAE-3 | 3 | 16.73% | 8.75% | 91.25% | 5.98 | 76 / 7,580 |
| RQ-VAE-4 | 4 | 51.84% | 38.42% | 61.58% | 1.93 | 15 / 2,364 |
| RQ+OPQ | 5 | 81.21% | 71.62% | 28.38% | 1.23 | 5 / 968 |
| VARG prefix(仅前两位) | 2 | 10.74% | 4.32% | 95.68% | 9.31 | 129 / 4,221 |
| VARG-ID | 3 | 100% | 100% | 0% | 1.00 | 1 / 1 |
(注:$N$ 个 item、$U$ 个被占用 SID 时,Unique $=U/N$,Avg. $=N/U$;Exclusive 是拥有独占 SID 的 item 比例,Collision $=1-$ Exclusive;P99/Max 是每个被占用 SID 下 item 数的 99 分位与最大值。)
结论分析: 增加语义量化层数确实能降碰撞(RQ-VAE-3 的 91.25% → RQ+OPQ 的 28.38%),但代价是解码路径变长(3→5 token),且仍有 item 共享标识符。VARG-ID 保留两级语义前缀(该前缀自身碰撞率高达 95.68%,平均每前缀 9.31 个 item),再用价值序第三位 token 在前缀内区分,在初始构造上把碰撞降到 0,同时只用 3 个 token。两个语义码本都被充分利用,rank 词表容量(8192)足以覆盖观测到的最大 item 簇(P99/Max 为 129/4221 < 8192)。
Table 3 SFT Base 模型的 Q2I-GMV Recall(绝对值为百分比,gain 为百分点)
| Method | @1 | @10 | @20 |
|---|---|---|---|
| RQ-VAE-3 | 20.62 | 81.53 | 97.13 |
| VARG-ID SFT Base | 36.12 | 95.18 | 98.06 |
| Δ (pp) | +15.50 | +13.65 | +0.93 |
结论分析: 这是全文唯一一条跨标识符方案的检索质量对比。VARG-ID 在 RL 之前就已在头部价值召回上大幅领先三级 RQ-VAE 标识符,@1 提升 15.50pp、@10 提升 13.65pp,而 @20 只差 0.93pp——说明增益高度集中在 beam 头部,正契合「配额受限时优先高价值 item」的系统诉求。但需要注意一个混淆:RQ-VAE-3 的碰撞率是 91.25%,也就是说这条对比同时改变了两件事——(i) 从簇级共享地址变成 item 级独占地址,(ii) 第三位 token 的排序准则从语义量化变成业务价值序。论文没有做「VARG-ID + 任意(非价值)第三位序」的对照,因此无法把 15.50pp 归因到「价值序」这一机制本身。
Table 1(b) 全量重排稳定性
| Policy | Change | Avg. shift | P90 | P99 | Top20 keep |
|---|---|---|---|---|---|
| EB-CVR | 69.54% | 22.00 | 51 | 291 | 93.31% |
| Click | 77.61% | 26.58 | 61 | 395 | 91.29% |
| Volume | 76.93% | 26.99 | 59 | 389 | 91.97% |
| Frozen update | 0.00% | 0.00 | 0 | 0 | 100.00% |
(Change 是第三位 token 发生变化的 item 比例;Avg. shift 是平均绝对 rank 位移;Top20 keep 是旧 Top-20 item 保留在同前缀新 Top-20 中的比率。)
结论分析: EB-CVR 是三种价值排序策略里最稳的——比原始 Click 序更少的第三位 token 变化(69.54% vs 77.61%)、更小的位移、更高的 Top-20 保留率。经验贝叶斯平滑通过把低频 item 的转化率往全局先验拉,抑制了小样本噪声引起的名次剧烈抖动。但即便是最稳的 EB-CVR,每日全量重排仍会改掉近七成 item 的地址——这正是「冻结更新」这一行的意义:它不是一个可比的排序策略,而是本文的解决方案(把 Change 强行压到 0)。
冻结模型 + 全量重排的对照实验(正文,无编号表): 保持 SFT 模型参数不变、把所有 item 在其语义前缀内重排后,
- L1 HR@100 基本不动:92.08% → 92.00%;
- L1+L2 HR 基本稳定:71.80% → 71.56%;
- 完整 SID HR@100 下降 14.45 个百分点;
- 第三位 token 的 teacher-forcing 准确率从 36.75% 崩到 21.24%。
结论分析(这是全文信息量最大的一个实验): 语义前缀对重排完全免疫,崩掉的全部是第三位 token。这说明模型对第三位 token 学到的是记忆式的绝对地址,而不是「rank $r$ = 簇内第 $r$ 有价值的 item」这种可泛化的序数语义——否则重排后语义不变,性能不该塌。作者据此采用冻结式增量更新,这个工程选择是正确的;但同一份证据也反过来削弱了「第三位 token 提供业务价值先验」这一机制性主张:模型主要在背地址,价值只是分配地址时用的排序准则。
Table 1(c) Trie 约束解码
| Method | Legal rate (%) | ΔHR@20 | ΔHR@100 | ΔHR@1000 | Inference time Δ | Memory Δ |
|---|---|---|---|---|---|---|
| Trie | 93.73 → 100 | +0.0915 | +0.2343 | +0.3857 | +3.16% | +0.13 GiB |
结论分析: Trie 约束把 SID 合法率从 93.73% 提到 100%,HR 全线提升(幅度随 $K$ 增大,因为更大的 beam 里非法路径占比更高),代价只是 +3.16% 推理时间与 +0.13 GiB 峰值显存。这是一个低成本高确定性的工程收益。
4.3 SFT 策略消融¶
Table 2(a) Plain HR:SFT Base 绝对值(%)与各策略的增益(pp)
| Direction | Method | @1 | @10 | @20 | @50 | @100 | @1000 |
|---|---|---|---|---|---|---|---|
| Baseline | SFT Base(绝对值 %) | 6.39 | 26.33 | 34.68 | 46.19 | 54.59 | 72.84 |
| Value | Q2I weight + level loss | −0.01 | +0.05 | +0.10 | +0.13 | +0.18 | +0.16 |
| Hierarchy | Level-weighted loss | −0.02 | 0.00 | +0.02 | +0.05 | +0.08 | +0.15 |
| Intent | Recent queries + global summary | +0.10 | +0.26 | +0.30 | +0.31 | +0.28 | +0.23 |
| Ordering | LO-SFT | +0.06 | +0.13 | +0.12 | +0.14 | +0.12 | +0.07 |
Table 2(b) 价值加权 recall(%),对应 Q2I + level 加权 checkpoint
| $K$ | GMV Recall Base | GMV Recall Q2I+level | Δ | Q2I-GMV Recall Base | Q2I-GMV Recall Q2I+level | Δ |
|---|---|---|---|---|---|---|
| 1 | 30.88 | 33.06 | +2.18 | 36.12 | 42.35 | +6.23 |
| 10 | 92.96 | 94.42 | +1.46 | 95.18 | 97.01 | +1.83 |
| 20 | 97.57 | 97.73 | +0.16 | 98.06 | 99.06 | +1.00 |
| 50 | 99.35 | 99.36 | +0.01 | 99.81 | 99.83 | +0.02 |
结论分析:
- 价值 + 层级监督:在 plain HR 上几乎无效(@1 甚至 −0.01pp),但在价值加权 recall 的头部效果显著——GMV Recall@1 +2.18pp、Q2I-GMV Recall@1 +6.23pp,而到 Top-50 时增益几乎归零。这符合机制预期:Q2I 加权本质是「按转化倾向重新分配样本权重」,它不改善能不能召回,只改善先召回谁。这是一个诚实且清晰的效应刻画。
- 层级加权单独看:几乎无效(@1/@10 为负或零,只在大候选预算下有 +0.05 ~ +0.15pp)。作者用 L1→L1+L2 的 16.94pp gap 论证第二层是瓶颈,但把权重挪向第二层带来的实际收益非常有限。
- 意图扩展:是 SFT 侧收益最大的单项(HR@20 +0.30pp、HR@50 +0.31pp,且各 $K$ 全线为正)。值得注意:这一项的本质是引入新信息(最近 3 条 query + 跨域全局兴趣摘要),而不是训练技巧。
- LO-SFT:几乎可忽略。HR@50 从 46.19% 到 46.33%(+0.14pp),NDCG@100 从 20.91% 到 21.00%(+0.09pp),给定真值两级语义前缀后的第三位 token top-1 准确率从 36.74% 到 37.02%(+0.28pp)。LO-SFT 是全文唯一直接测试「模型是否学到了第三位 token 的序数语义」的实验,而它的答案是:显式教这个序,几乎学不到额外的东西。结合前述重排崩塌实验,这两条证据共同指向同一结论——第三位 token 的价值语义并没有被模型内化。
4.4 Prefix-GRPO 总体结果¶
Table 4 Prefix-GRPO 整体效果(绝对值为百分比,Δ 为百分点)
| Plain metric | SFT | Prefix-GRPO | Δ | Value metric | SFT | Prefix-GRPO | Δ | |
|---|---|---|---|---|---|---|---|---|
| HR@1 | 6.39 | 6.44 | +0.05 | GMV Recall@1 | 30.88 | 36.35 | +5.47 | |
| HR@10 | 26.33 | 26.46 | +0.13 | GMV Recall@10 | 92.96 | 95.20 | +2.24 | |
| HR@20 | 34.68 | 34.85 | +0.17 | GMV Recall@20 | 97.57 | 98.06 | +0.49 | |
| HR@50 | 46.19 | 46.30 | +0.11 | Q2I-GMV Recall@1 | 36.12 | 38.60 | +2.48 | |
| NDCG@10 | 15.15 | 15.30 | +0.15 | Q2I-GMV Recall@10 | 95.18 | 97.21 | +2.03 | |
| NDCG@20 | 17.26 | 17.44 | +0.18 | Q2I-GMV Recall@20 | 98.06 | 99.39 | +1.33 |
行为分层 HR@1
| Stratum | SFT | Prefix-GRPO | Δ |
|---|---|---|---|
| Buy HR@1 | 13.51 | 13.87 | +0.36 |
| Click HR@1 | 5.97 | 6.00 | +0.03 |
结论分析: RL 阶段的 plain HR 增益非常小(@1 +0.05pp、@20 +0.17pp,相对提升不到 0.5%),真正的收益体现在价值加权指标的头部:GMV Recall@1 +5.47pp。行为分层结果与之一致——购买标签请求上的 HR@1 提升(+0.36pp)远大于点击标签(+0.03pp),说明奖励确实把概率质量往「更可能被买」的候选上挪了。这个效应的方向是对的,但注意它本质上就是行为奖励把购买样本的权重提上去,与 SFT 阶段 Q2I 加权是同一类操作的 RL 版本。
4.5 奖励与前缀加权的渐进消融(关键)¶
Table 5 奖励信号与前缀感知 token 加权的渐进消融(百分比,最优加粗)
| Method | HR@1 | HR@10 | HR@20 | Q2I-GMV Recall@1 | Q2I-GMV Recall@10 | NDCG@10 |
|---|---|---|---|---|---|---|
| SFT Base | 6.39 | 26.33 | 34.68 | 36.12 | 95.18 | 15.15 |
| Behavior GRPO | 6.43 | 26.39 | 34.76 | 38.31 | 96.82 | 15.18 |
| Multi-source GRPO | 6.43 | 26.45 | 34.81 | 38.52 | 97.12 | 15.29 |
| Full Prefix-GRPO | 6.44 | 26.46 | 34.85 | 38.60 | 97.21 | 15.30 |
三个 RL 配置都保留合法性门控。Behavior GRPO 只对已占用 SID 用用户行为奖励;Multi-source GRPO 追加排序器优势与相关性奖励;Full Prefix-GRPO 再打开前缀感知 token 加权。前两个配置在策略损失中对合法 response token 用单位权重。
结论分析(本文最值得警惕的一张表): 把总增益拆开看:
| 增量来源 | Q2I-GMV Recall@1 | 占 RL 总增益 |
|---|---|---|
| 纯行为奖励 GRPO(标准做法) | +2.19pp | 88.3% |
| + 排序器优势 + 相关性奖励(本文新增之一) | +0.21pp | 8.5% |
| + 前缀感知 token 加权(本文新增之二) | +0.08pp | 3.2% |
| 合计(SFT Base → Full Prefix-GRPO) | +2.48pp | 100% |
也就是说,"Prefix-GRPO"这个名字所指的两项创新——门控多源奖励中"行为之外"的部分,以及前缀感知加权——加起来只贡献了 RL 总增益的 11.7%(0.29pp / 2.48pp);剩下 88% 来自「用行为奖励跑 GRPO」这一已在 OneRec / EG-GRPO 等工作中成熟的标准配方。在 plain HR 上,前缀加权带来的 HR@20 +0.04pp、HR@1 +0.01pp 更是接近噪声量级,论文也没有提供多 seed 方差或显著性检验。作者自己的措辞是克制的("prefix weighting provides small but consistent additional gains"),但摘要与贡献列表把 Prefix-GRPO 摆在与 VARG-ID 并列的位置,权重是不匹配的。
4.6 线上 A/B 测试¶
Table 6 14 天 20% 搜索流量的线上 A/B(相对生产对照组的相对变化)
| Setting | GMV | IPV/user | Exp. PV/user | UCTR | UCTCVR | PCTR |
|---|---|---|---|---|---|---|
| VARG | +1.45% | +0.22% | −0.09% | +0.13% | +0.13% | +0.31% |
VARG 使用 Trie 约束解码,逐层 beam 宽度为 (20, 50, 500);生成候选绕过粗排,通过预留配额直接进入已有最终排序器。
结论分析: GMV +1.45% 在天猫的体量上是可观的业务价值,PCTR +0.31%、IPV/user +0.22% 也与之方向一致;曝光 PV/user 微降 0.09% 说明不是靠多曝光堆出来的量,效率确有提升。但这个数字支持的命题是「加一条绕过粗排、带预留配额的生成式召回通道有效」,而不是「价值序 token + Prefix-GRPO 这套机制有效」——对照组是不含该通道的生产系统,实验里没有任何一个"VARG 机制被拿掉但通道仍在"的线上臂(例如用任意序第三位 token,或只做 SFT 不做 RL)。论文自己在 Table 7 里已经有一个 "Gen. baseline (DA)" 生成式直通基线,却没有把它拉进 A/B 做 GMV 对比。
Table 7 AI 导购 query 的相关性 Good rate(%),两轮独立评测
| System | Eval. 1 | Eval. 2 |
|---|---|---|
| Orig. pipeline(最大配额) | 76.71 | 76.81 |
| Orig. pipeline(削减配额) | 75.77 | 75.73 |
| Gen. baseline (DA) | 75.57 | – |
| Gen. baseline (DA, 更大配额) | 75.90 | 76.03 |
| VARG (DA, 更小配额) | 76.77 | 76.58 |
(DA = direct admission,直接准入最终排序器、绕过粗排。评测集为 6K+ AI 导购 query。)
结论分析: 削减原流水线配额会让 Good rate 掉约 1pp(76.71→75.77),说明配额确实是相关性的约束。VARG 在更小配额下达到 76.77 / 76.58,比生成式直通基线高 0.87 / 0.55pp,比削减配额的原流水线高约 1pp。但与最大配额的原流水线相比:Eval.1 是 +0.06pp、Eval.2 是 −0.23pp——两轮方向相反,实质是打平。作者用 "comparable to or slightly higher" 描述,稍偏乐观;更准确的读法是「VARG 能在显著更小的配额下不丢相关性」,这本身是有价值的结论(配额是线上算力成本),但不是相关性上的胜利。
4.7 效率—效果权衡¶
用 PyTorch + Transformers(未接额外推理引擎)对比标准自回归解码与 §3.6 的轻量解码器:
| 指标 | 标准自回归 | 轻量解码器 | 变化 |
|---|---|---|---|
| 平均延迟 | 10.41 ms | 0.94 ms | −91% |
| 单卡 QPS | 1× | ≈11.1× | +1010% |
| HR@1 | — | — | −1.13 pp |
| HR@20 | — | — | −8.38 pp |
| HR@100 | — | — | −10.77 pp |
结论分析: 11.1× 的吞吐提升代价是 HR@20 掉 8.38pp(相对 SFT Base 的 34.68% 是掉了约四分之一),完全不可接受。根因也清楚:Eq. (23) 的分类头只看 prompt 末位隐状态 $h$ 和上层 token embedding,丢掉了自回归解码中「已生成 token 回流进骨干」的全部交互。作者如实标注该方案未上线、需进一步改进——这种负面结果的公开是加分项。
4.8 Case Study¶
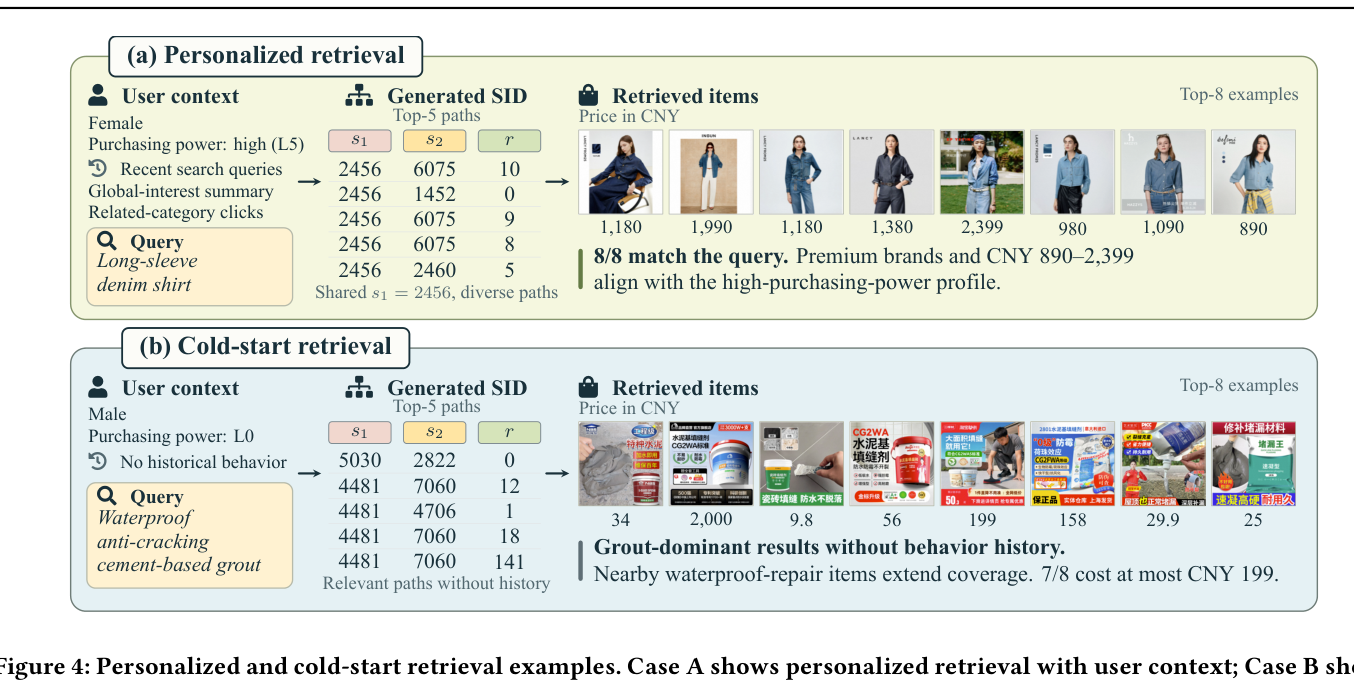
- Case A(个性化):女性、购买力 L5(高),query「长袖牛仔衬衫」。Top-5 SID 路径共享 $s_1=2456$ 但 $s_2$/$r$ 发散((2456,6075,10)、(2456,1452,0)、(2456,6075,9)…),展开的 8 件商品全部匹配 query,价格 CNY 890–2,399、多为高端品牌,与高购买力画像一致。
- Case B(冷启动):男性、购买力 L0、无历史行为,query「防水抗裂水泥基填缝剂」。Top-5 路径为 (5030,2822,0)、(4481,7060,12) 等,检索结果以填缝剂为主并延伸到相邻的防水修补品,8 件中 7 件价格 ≤ CNY 199。说明在无行为历史时生成仍能保持 query 语义对齐。
这两个 case 直观展示了「同一 $s_1$ 下靠 $s_2$/$r$ 发散」的检索行为,但都是正例挑选,无统计意义。
核心贡献总结¶
- VARG-ID:两级语义前缀(双向 Q2I 对比学习注入搜索相关性)+ EB-CVR 价值序第三位 token,初始构造即 100% 无碰撞、仅 3 个 token,把「细粒度寻址」与「业务价值先验」合并到同一层编码里。
- 量化了价值序标识符的稳定性代价:EB-CVR 是最稳的价值排序策略(Change 69.54% vs Click 77.61%),但任何全量重排都会让完整 SID HR@100 掉 14.45pp、第三位 token teacher-forcing 准确率从 36.75% 崩到 21.24%——据此改用冻结槽位的增量更新,配合双环日更与月度重建。这是本文最有实操价值、也最被低估的结论。
- 三阶段 SFT + Stage 3 三件套(Q2I 价值加权、层级加权、LO-SFT 局部序监督)与上下文扩展,其中上下文扩展(最近 query + 全局兴趣摘要)是 SFT 侧收益最大的单项。
- Prefix-GRPO:合法性门控 + 行为/排序器优势/相关性多源奖励 + 前缀分支数感知的 token 加权。
- 完整的工业落地:51.43M 商品、128 卡 SFT / 64 卡 RL、Trie 约束 serving(beam 宽度 20/50/500)、版本化 catalog 原子发布,14 天 20% 流量 A/B GMV +1.45%。
与已归档相关工作的对比¶
CRID CRID: Beyond Semantic IDs — Encoding Business-Value Ranking into Document Identifiers(淘天集团,2026-07-13)¶
关系:显式引用但原文未展开对比(仅在 Introduction 与 Related Work 各一句带过,无方法层或指标层对照)· 已加载对方精读
- 共同关注的问题:两文指向完全同一个 root cause——生成式检索的 DocID/SID 完全由语义重构目标构造,与系统实际优化的业务转化目标结构性错位,导致同一语义簇内转化率相差数量级的 item 拿到相邻甚至相同的标识符;同时纯语义量化在亿级语料上必然碰撞。
- 相近的技术骨架:两者的标识符构造是同一个配方——保留前 $L-1$ 级语义码本(且都用 query–item 对比学习训练 item embedding 以注入搜索相关性),把最后一级 token 换成簇内业务价值的序数排名,从而同时拿到「天然无碰撞」与「价值先验」,并都声称支持无需重训码本的增量更新。CRID 还给出 $P_\theta(i\mid q,h) = P_\theta(\mathbf{c}_s\mid q,h)\cdot P_\theta(r\mid \mathbf{c}_s,q,h)$ 的因子分解,与 VARG 的 Eq. (7) 三段式分解同构。
- 本文的差异与推进:(1) 排序统计量:CRID 直接用转化率排序,VARG 用经验贝叶斯平滑后的 EB-CVR 加「$\hat p \to V^{\text{funnel}} \to \mathrm{GMV} \to \mathrm{ID}$」漏斗式多键字典序(Eq. 4–5),Table 1(b) 实证 EB-CVR 比原始 Click/Volume 序更稳。(2) 增量更新策略上两者正面冲突——CRID 主张「新品按 embedding 距离进最近簇,再按每日业务统计簇内重排」,VARG 的实验恰恰证明这条路会让完整 SID HR@100 掉 14.45pp,因而改用冻结已有地址 + 新品复用槽位(可控共享)的 Eq. (6)。VARG 实际上是对 CRID 增量更新主张的一次实证反驳,但论文完全没有这样定位自己。(3) VARG 额外叠了三阶段 SFT 与 Prefix-GRPO,CRID 刻意只改 DocID 一处、不碰解码器也不引入 RL。
- 可比的方法 / 实验差异:CRID 在 300M 淘宝搜索语料上把 in-search HR@1000 从 FORGE 的 72.50% 提到 82.25%(+9.75pp),全流量部署 +1.06% GMV;VARG 在 51.43M 天猫商品上把 Q2I-GMV Recall@1 从 RQ-VAE-3 的 20.62% 提到 36.12%,20% 流量 14 天 +1.45% GMV。两者数据域与指标口径不同,不可直接对齐;但机制层高度重叠,意味着 VARG-ID 的"新颖性"实际上落在 EB-CVR 平滑与冻结更新两点上,而非"用价值序做最后一级 token"本身。论文既未引用 CRID 的实验数字,也未做任何同条件对照,这是本文实验设计上最大的缺口。
TSGR TSGR: Taobao Search Generative Retrieval(浙江大学 + 淘天集团,2026-07-21)¶
关系:独立并发(本文未引用 TSGR,两者殊途同归且系统设定几乎相同)· 已加载对方精读
- 共同关注的问题:两文都指向「召回阶段对业务价值无感知」这一同构瓶颈,且都采取同一个系统姿态——把生成式检索同时当作召回与粗排,生成候选绕过常规粗排直接前送最终排序器。TSGR 把这两个局限命名为 "Value-insensitive SID construction" 与 "Value-unaware candidate ranking",与 VARG 摘要里的三大挑战几乎一一对应。
- 相近的技术骨架:TSGR 的 efficiency codebook 与 VARG-ID 的第三位 token 是同一机制——在每个语义簇内按物品价值排序,把高价值物品分到更靠前的 token 索引,从而让生成似然与业务价值对齐;两者的前两级都是语义码本,都用 Qwen 系小模型做骨干,都用前缀约束解码,都以 HR@K 为离线主指标。
- 本文的差异与推进:(1) 价值随 query 变化的处理位置不同——VARG 在 intro 里把「item 的转化倾向随 query/用户变化」列为引入 Prefix-GRPO 的动机,即放在 RL 层解决;TSGR 则直接把它做进标识符层(QP-SID:每簇除默认点击序外,再按 top-3 代表性 term 各构造一组 query 条件序,共 4 条并行路径,serving 时按 query 选序)。(2) 对"生成概率 ≠ 业务价值"这一 gap 的补救不同——TSGR 加了一个与生成目标联合优化的 Value-aware Ranking Module(复用骨干隐状态作用户表征,cross-attention 融合 item side-info 重排 beam 候选);VARG 完全靠奖励塑形,不引入任何可读取 item side-info 的排序模块。(3) VARG 的稳定性工作(EB-CVR、冻结更新、版本化发布)是 TSGR 没有覆盖的,这是 VARG 的实质增量。
- 可比的方法 / 实验差异:最刺眼的交叉验证在 RL 上——TSGR 同样试了 RL 做候选重排,报告 HR@1000 仅 +0.55%(0.8222→0.8277),并明确因「幅度属边际」未在实际部署中采用;相比之下他们的 VRM 拿到 HR@1000 +3.73%。VARG 的 Prefix-GRPO 在 plain HR 上的量级同样是边际的(HR@20 34.68→34.85,相对 +0.49%),却被摆成与标识符设计并列的核心贡献。两文对同一件事得出的评价差异,主要不是结论矛盾,而是指标选择:VARG 换用价值加权的 Q2I-GMV Recall@1(+2.48pp)来展示 RL 收益,TSGR 则始终用 HR@K。线上侧,TSGR 在淘宝搜索 1% 流量跑 38 天,用 TSGR 单模型替代常规检索 + 粗排两阶段,取得 +0.43% IPV / +1.12% 成交单量 / +1.64% GMV;VARG 在天猫 20% 流量跑 14 天,作为增量通道取得 +1.45% GMV。两者量级相当,但 TSGR 的实验设定(替代而非增量)对「生成式一体化」的支持更强。
CQ-SID CQ-SID: Efficient Generative Retrieval for E-commerce Search with Semantic Cluster IDs and Expert-Guided RL(淘天集团,2026-05-14)¶
关系:显式引用([35],作为簇级标识符与 EG-GRPO 的代表被提及),且为同团队、同平台(天猫 App 搜索)的直接前代系统;原文未给出任何指标层对比 · 已加载对方精读
- 共同关注的问题:同一个团队、同一个系统。CQ-SID 与 VARG 的作者列表高度重叠(Jianbo Zhu、Xing Fang、Jing Wang、Mingmin Jin 同时出现在两篇上),都把生成式检索定位为天猫 App 搜索链路中的一条通道,都要在亿级商品库与严格延迟预算下产出高质量候选。
- 相近的技术骨架:VARG 的三阶段 SFT(Item→SID / Query→SID / User+Query+History→SID)就是 CQ-SID 四阶段流水线(Item2SID → Query2SID → User+Query2SID → EG-GRPO)的直接延续;双向 Q2I 对比学习注入 tokenizer、Qwen2.5-0.5B 骨干、Trie/前缀约束解码、GRPO 做排序对齐,这些部件两文完全一致。
- 本文的差异与推进:标识符哲学发生了 180 度反转,而这个反转是被系统设定倒逼的。CQ-SID 明确论证「碰撞在亿级电商库中不是缺陷而是必要的设计选择」——主动放弃唯一性,让语义相近的 item 共享 SID,把 beam search 复杂度从 $O(N_{\text{items}})$ 降到 $O(N_{\text{clusters}})$,并借聚合解决长尾覆盖;其码本为 $2048\times1024\times1024$ 且第一层按 1711 个类目 bin 强制对齐。VARG 则走向对立面:因为系统设定从「召回阶段的补充」升级为「召回—粗排一体化、绕过 item 级粗排」,簇级共享地址会让低价值 item 白占预留槽位,所以必须回到 item 级独占寻址——码本改为 $8192\times8192\times8192$,第一层不再做类目约束,第三层换成价值序。RL 侧也从 EG-GRPO(往 group 里注入 ground-truth SID 作伪响应以缓解稀疏奖励)换成 Prefix-GRPO(门控多源奖励 + 前缀加权)。
- 可比的方法 / 实验差异:CQ-SID 报告离线 hitrate 相对 RQ-VAE 基线提升 26.76%(语义)/ 11.11%(个性化),线上 两周 A/B GMV +1.15%、UCTVR +0.40%,并称该生成式召回链路当时已贡献全平台 50.25% 曝光 / 58.96% 点击 / 72.63% 购买。VARG 的 14 天 A/B 是 GMV +1.45%、UCTCVR +0.13%。关键的不确定性在于:VARG 的"生产对照组"是否已经包含 CQ-SID 这条通道,论文没有说明。 若包含,则 +1.45% 是在一条已贡献七成购买的生成式通道之上的纯增量,含金量很高;若 VARG 是替换 CQ-SID 上线,则两者更接近同一位置的版本迭代,+1.45% vs +1.15% 的可比性就大打折扣。这一句说明的缺失,直接影响对本文最重要业务数字的解读。
(另有若干近似候选被剔除:GrowthGR GrowthGR——同为淘天电商搜索生成式检索,但其 root cause 是新品冷启动的长期价值(counterfactual ItemLTV),解法是 LTV 估计 + 成长感知奖励,与「配额内价值寻址」非同构;OneSearch-V2 OneSearch-V2——同为工业电商搜索 GR 且同样用 GRPO,但瓶颈定位在 query 意图理解(latent reasoning + 自蒸馏),标识符层无改动;UniVA UniVA / GEM-Rec GEM-Rec——同属「价值感知 GR」,但 UniVA 把商业属性离散化进无序分桶、GEM-Rec 把价值放在解码时的 logit 调制,都不是「最后一级换成簇内价值序数」这条路径;AdaSID AdaSID / QuaSID QuaSID——同样处理 SID 碰撞(与 VARG-ID 的无碰撞主张部分重叠),但解法是码本层的碰撞松弛/资格感知学习,缺少业务价值这一半。)
讨论与局限性¶
核心贡献与值得借鉴的设计¶
最值得借鉴的不是标题里的两个名词,而是 §4.2 那组稳定性实验。 「价值序标识符」这个想法在 2026 年的工业 GR 里已经被 CRID、TSGR、UniVA 等多条线独立发现,不再稀缺;但没有人像本文这样把「价值序会随统计漂移、而模型把 rank 当绝对地址背下来」这件事量化出来——冻结模型 + 全量重排后 L1/L1+L2 HR 纹丝不动、完整 SID HR@100 掉 14.45pp、第三位 token teacher-forcing 准确率从 36.75% 崩到 21.24%。这组数字对任何想把动态业务统计塞进 ID 的团队都是直接可用的告警,配套的 Eq. (6) 冻结槽位分配、版本化 catalog + Trie + SID-to-item 的原子发布、月度 primary 版本重建,构成了一套完整可抄的工程方案。
Prefix-GRPO 的合法性门控设计也值得单独提:把「格式错误 / 结构合法但未占用 / 已占用」三态分开给奖励,并规定只有已占用输出才进入后续奖励计算(Eq. 15),从机制上杜绝了非法输出拿正 credit;相关性奖励只对无行为匹配的 SID 生效以避免相关标签重复计数(Eq. 14);排序器优势只取正、再用 $\tanh$ 有界压缩(Eq. 13)。这些都是踩过坑之后才会写出来的细节。
轻量解码器的负面结果(11.1× QPS / HR@20 −8.38pp,明确标注未上线)也是诚实披露,在工业论文里不多见。
存在的局限与争议¶
(1) 核心机制从未被单独消融,且现有证据指向它不是收益来源。 全文关于 VARG-ID 的唯一检索质量对比是 Table 3 的 RQ-VAE-3(碰撞率 91.25%)→ VARG-ID(碰撞率 0%),Q2I-GMV Recall@1 +15.50pp。但这条对比同时改变了「簇级共享 → item 级独占」和「语义量化 → 价值序」两件事,缺少最关键的对照组:VARG-ID 结构不变、第三位 token 改用任意序(随机 / item ID 序)。而两条内部证据都指向价值序本身贡献有限:其一,LO-SFT 显式教模型学第三位 token 的序数语义,第三位 top-1 准确率只从 36.74% 涨到 37.02%(+0.28pp),HR@50 只涨 0.14pp;其二,全量重排会摧毁第三位 token 的预测能力——如果模型真学到了「rank $r$ = 簇内第 $r$ 有价值」,重排后语义不变,性能不该塌。最合理的解释是:15.50pp 主要来自"无碰撞的 item 级独占寻址",而非"价值序"这个先验。 这不否定 VARG-ID 的工程价值(唯一寻址本身就是本文系统设定的硬需求),但它确实否定了论文对机制的归因。
(2) Prefix-GRPO 的两项署名创新加起来只占 RL 增益的 11.7%。 Table 5 的拆解很清楚:纯行为奖励 GRPO 拿走 +2.19pp(88.3%),多源奖励再加 +0.21pp,前缀加权再加 +0.08pp,总计 +2.48pp。也就是说,这一阶段的绝大部分收益来自「用行为奖励跑标准 GRPO」这一已被 OneRec / EG-GRPO 反复验证的配方。在 plain HR 上,整个 RL 阶段只把 HR@20 从 34.68% 推到 34.85%(相对 +0.49%),且没有 matched-compute 的"多跑等量 SFT"对照组,也没有多 seed 方差或显著性检验——这个量级的差异难以排除训练预算和随机性的贡献。对照 TSGR 在同一问题上测得 RL 仅 +0.55% HR@1000 并因此放弃部署,本文对 Prefix-GRPO 的定位明显偏高。
(3) 线上 +1.45% GMV 无法归因到本文主张的机制。 A/B 对照组是「不含该生成通道的生产系统」,而 VARG 是一条带预留配额、绕过粗排的新增通道——配额分配的改变本身就是强干预,任何质量尚可的新召回源在这个位置都会有正收益。论文在 Table 7 里已经有 "Gen. baseline (DA)" 这个现成的同类对照,却没有把它拉进 A/B 做 GMV 比较;也没有「VARG 通道在但价值序/RL 被拿掉」的线上臂。更关键的是,同团队 CQ-SID 的簇级生成召回通道在同一个天猫 App 上已经拿到 +1.15% GMV,而论文从未说明 VARG 的对照组是否已包含 CQ-SID 通道——这一句话的缺失,使得读者无法判断 +1.45% 是「在已有生成通道之上的纯增量」还是「同位置的版本迭代」。这是对本文最重要业务数字的解读障碍。
(4) 相关性结论被略微高估。 Table 7 中 VARG(更小配额)76.77 / 76.58 vs 原流水线最大配额 76.71 / 76.81,两轮方向相反(+0.06 / −0.23),实质是打平。准确的表述应是「在更小配额下不丢相关性」,而非 "comparable to or slightly higher"。
(5) 与最相关的前置/并发工作缺乏对照。 CRID(同集团,2026-07)用的是同一个「语义前缀 + 簇内价值序数」配方,本文只用两句话引用,无任何指标或方法层对照;TSGR(同集团淘宝搜索,2026-07)的 efficiency codebook 与本文第三位 token 机制相同、系统设定(绕过粗排直通排序器)也相同,本文完全未引用。在这个背景下,VARG-ID 的真实增量收敛为:EB-CVR 平滑作为排序统计量,以及冻结槽位式增量更新——这两点都有价值,但都是既有路线上的改良。
(6) 「无碰撞」只在初始构造成立。 Eq. (6) 明确允许新品复用已有槽位与旧 item 共享 SID("controlled sharing"),且超出容量的新品一律压到最后一个槽位($K_3-1$ 或 $M_{t-1}$),意味着随着日更累积,碰撞会单调回升、且集中堆在尾部槽位上。论文没有给出运行一段时间后的碰撞率曲线或尾部槽位拥塞度,也没说明月度重建的触发条件与这个退化速度的关系。
(7) 方法论可扩展性的结构性隐患。 tokenizer(RQ-VAE + 价值排序)与检索模型是完全解耦的两阶段:码本一旦冻结,下游表征空间即被锁死;价值序还依赖外部的行为统计与每日重排流程。参数量 scaling 时,「如何表征物品」这条路径无法与「如何建模序列」同步扩容——扩大骨干不会让 SID 空间变得更有表达力,而扩大码本又要触发 primary 版本重建与全量重训(论文明确说月度重建要重编码所有标签、历史与回放数据并重训模型)。这正是评分标准里点名的「显式多阶段解耦 + 核心组件固化」隐患。此外骨干仅 0.5B,论文也未给出任何 scaling 趋势。
(8) 复现性。 全部实验基于天猫私有数据,无公开数据集结果、无代码;论文还是 ACM 模板未填写状态("© 2018"、"Conference acronym 'XX"),部分表格(如 Table 1(c))只有单行、无方差。
与已有工作的定位¶
把 VARG 放回谱系里:它 = CRID 的标识符构造(语义前缀 + 簇内业务价值序数,换成 EB-CVR 平滑 + 漏斗多键序)+ CQ-SID 的渐进式 SFT 流水线与 Qwen2.5-0.5B 骨干(把簇级共享翻转为 item 级独占)+ 标准行为奖励 GRPO(外挂排序器优势 / 相关性奖励与前缀加权)+ 一套原创且扎实的 ID 稳定性诊断与冻结式日更工程。前三项是组合与改造,第四项是本文真正的原创贡献。对想在电商搜索落地生成式召回的团队,这篇的工程附录价值高于其方法论新意:beam 宽度 (20,50,500)、128 卡 SFT / 64 卡 RL、各项奖励的具体数值、EB-CVR vs Click vs Volume 的稳定性数字、Trie 约束的 +3.16% 延迟代价,都是可以直接拿去做预算估算的参数。