The Disconnect Between Better Descriptive Reasoning Trace Quality and Recommendation Effectiveness¶
作者:Gustavo Penha、Juan Elenter、Claudia Hauff、Hugues Bouchard、Paul Bennett、Mounia Lalmas —— 全部来自 Spotify(美国 / 荷兰 / 西班牙 / 英国四地)
ArXiv:2608.23154 · 2026-08-24 · GenAI-eCom: Agentic and Generative AI for E-Commerce Workshop @ RecSys 2026
一句话:这是一篇受控证伪论文。它把「显式推理链质量」与「传统离线推荐效果」拆成两个独立测量的量,用 2×2 因子实验证明:把推理轨迹写得更好(更 grounded、更可解释)本身并不能带来更好的推荐效果——两者是推荐系统的不同属性。论文本身不提出任何新模型。
1. 研究动机与背景¶
1.1 生成式推荐的推理转向¶
生成式推荐把「预测下一个 item」重述为自回归 token 生成:给定用户交互历史,语言模型逐 token 解码下一个 item 的多 token 标识符(TIGER [1])。主流做法是把 item 表示成 semantic ID (SID)——用残差量化(RQ-VAE)从 item 内容里学出来的离散标识符。SID 已经从研究原型走进了服务百万用户的生产系统(Spotify 播客生成式检索 [2]),并且已经被证明可以在超过 1000 万 item 的目录上统一搜索、推荐与推理 [3]。
SID 站稳脚跟之后,研究重心从「改进 item 表示」转向了「给推荐模型加显式自然语言推理轨迹」:模型先描述用户历史、推断偏好、给出推荐理由,然后才预测下一个 item。多阶段训练、强化学习、对齐技术都被用来提升这些轨迹的质量,reasoning-augmented 生成式推荐已经成为一条独立的研究路线(SIDReasoner [4]、OneRec-Think [5]、HoloRec [6]、PROMISE [7])。
1.2 对齐税 (alignment tax)¶
但在 SID 上做推理,比在自然语言上做推理需要多得多的训练。因为 SID token 是不透明的学出来的标识符,不在 LLM 的预训练词表里,模型必须先学会这些标识符代表什么,才谈得上在它们之上生成有意义的轨迹。论文把这份额外开销命名为 alignment tax(对齐税):为了把不透明 item 标识符桥接到 LLM 原生语言理解上所需的训练阶段、辅助目标与模型容量。
现有系统印证了这份代价:
- SIDReasoner [4] 专门辟出一个对齐阶段,配 8 个辅助目标;
- OneReason [8] 把「语义 grounding 不足」认定为前人方法的关键瓶颈;
- Zhang et al. [9] 显示当 grounding 不充分时,推理甚至会把推荐准确率拉低 25%(他们诊断为 "linguistic inertia":CoT 把注意力从协同 SID 证据挪向自然语言上下文)。
1.3 一个天然的受控实验设定¶
自然语言 item 表示提供了一条绕开对齐的替代路线:LLM 本来就懂 "strategy game"、"wireless headphones" 这些词,原则上可以直接在 item 描述上推理,不需要先学会新标识符 token 的语义。反过来,往词表里塞几百个不透明 SID token,可能会挤占预训练获得的语言能力 [10],包括支撑 chain-of-thought 的那部分。
于是论文提出核心问题:
如果自然语言标题和充分的 SID 对齐都能提升推理轨迹质量,这些提升会转化成更好的推荐效果吗?
这个设定的妙处在于:item 表示(Title vs SID) 和 语义 grounding 强度(lean vs 八任务 extensive 对齐) 这两个因子可以被独立操纵,从而干净地拆开两个此前被混淆的变量。
1.4 三项贡献¶
- 首次做出跨 semantic ID 与自然语言标题的受控推理轨迹对比,在同一实验框架内隔离 item 表示与语义 grounding 的效应;
- 证明两个能显著提升轨迹描述质量的独立干预——自然语言标题与充分 SID 对齐——在本文研究的训练目标下都不足以稳定改善传统离线推荐效果;
- 证明更丰富的 RL 目标能部分恢复传统离线效果,说明优化目标与描述性推理轨迹同等重要。
论文明确界定了「传统离线评测」的含义:按用户切分训练/测试,每个用户只留一个 held-out 交互作为唯一 ground truth。它同时提示了替代范式——Cranfield 式带 pooled judgment 的相关性集合 [11, 12]、LLM-as-a-judge 评测 [13],二者都能提供比单一 ground-truth item 更丰富的相关性信号。
2. 实验框架:2×2 因子设计¶
论文做的是一个受控 2×2 因子实验,两个因子是 (1) item 表示(SID vs Title)与 (2) 显式推理(No Reasoning vs Reasoning),产出四种模型配置,其余流水线完全共享。推理模型分别在 SFT 后和 RL(GRPO)后各评一次。这种设计让 item 表示与显式推理可以独立变化,而推荐任务、模型架构、监督信号全部固定。
2.1 问题设定¶
把生成式推荐形式化为 next-item prediction。给定用户交互历史 $\mathcal{H}_u = [i_1, i_2, \ldots, i_t]$,任务是预测下一个 item $i_{t+1}$。生成式推荐器建模 $P(i_{t+1} \mid \mathcal{H}_u)$,方式是自回归生成 item 标识符 $\mathrm{id}(i_{t+1})$——要么是 semantic ID,要么是自然语言标题。
2.2 两种 item 表示¶
Semantic IDs (SID):直接复用 SIDReasoner [4] 释出的 RQ-VAE semantic ID——三层残差量化,每层码本大小 256,在 item 标题与描述的 E5-large embedding 上训练。每个 item 是一个三 token 编码,如 <s0_42><s1_17><s2_203>。这 $3 \times 256 = 768$ 个特殊 token 被加入 LLM 词表。
Titles (Title):每个 item 用它的原始标题表示,截断到 32 token。推理时,生成出来的标题通过在 item 索引上做 BM25 检索解析回目录 item。
2.3 推理的接入方式¶
No reasoning:模型直接从交互历史预测下一个 item 的标识符,训练样本格式为 The user interacted with [id(i1)], [id(i2)], ... Predict the next item:。
With reasoning:复用 SIDReasoner [4] 释出的推理轨迹,避免为每个域约 49K 训练序列重新生成 teacher 轨迹。每条轨迹是一段自然语言解释,说明为什么 $i_{t+1}$ 会跟在 $\mathcal{H}_u$ 后面,涉及 item 属性、类目、用户偏好模式。
为了隔离 item 表示对推理轨迹的影响,论文从同一条轨迹派生出两个表示专属版本,只替换其中的 item 指代:
- SID 版:item 提及被替换成 SID token 序列(如 "the strategy RPG" →
<s0_42><s1_17><s2_203>); - Title 版:item 提及被替换成对应的 item 标题。
这保证了推理内容在两种配置下完全一致,只有轨迹内的 item 表示与预测目标不同。 模型用格式 [history] <think> [reasoning trace] </think> [id(i_{t+1})] 微调。
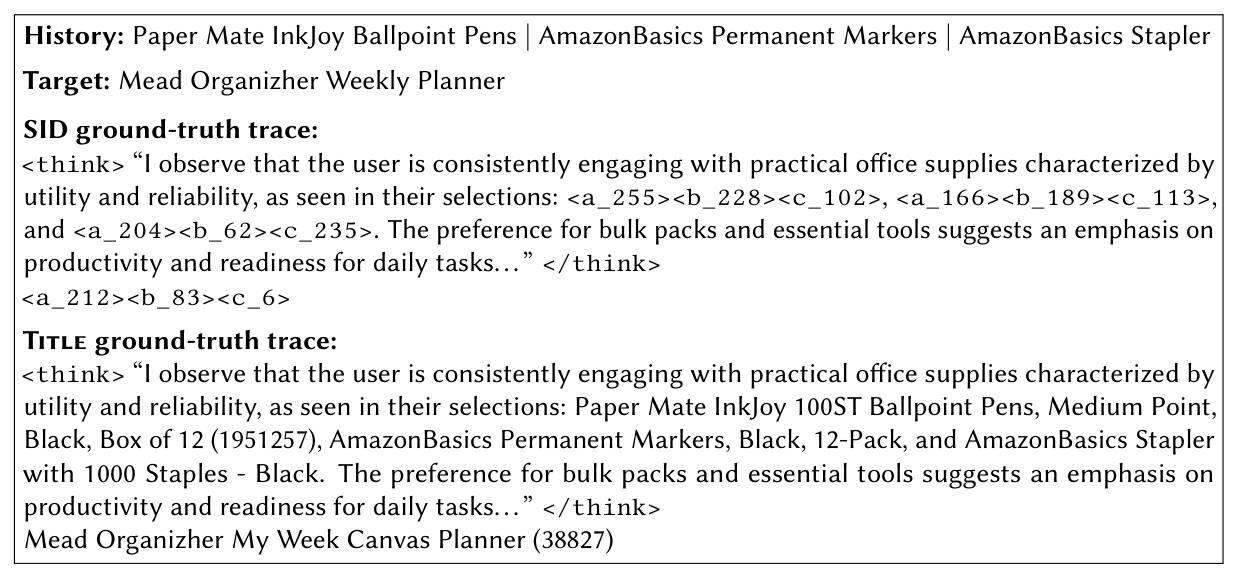
如 Figure 1 所示,同一个办公用品用户(Paper Mate 圆珠笔 | AmazonBasics 记号笔 | AmazonBasics 订书机 → 目标 Mead 周计划本),两条 teacher 轨迹的叙事文字一模一样,区别只在于「实用办公用品」这句判断后面跟的是 <a_255><b_228><c_102> 还是 "Paper Mate InkJoy 100ST Ballpoint Pens, Medium Point, Black, Box of 12 (1951257)"。
2.4 三阶段训练流水线¶
两种表示走同一条三阶段流水线(follow SIDReasoner [4],但为了受控对比做了几处修改)。除非特别说明,所有模型都用 Qwen3-1.7B,以验证集 Recall@10 早停(patience 3)。SID 配置往词表加 768 个特殊 token;Title 配置用原始词表,配左截断(max_seq=512)以保住长历史里的预测目标。
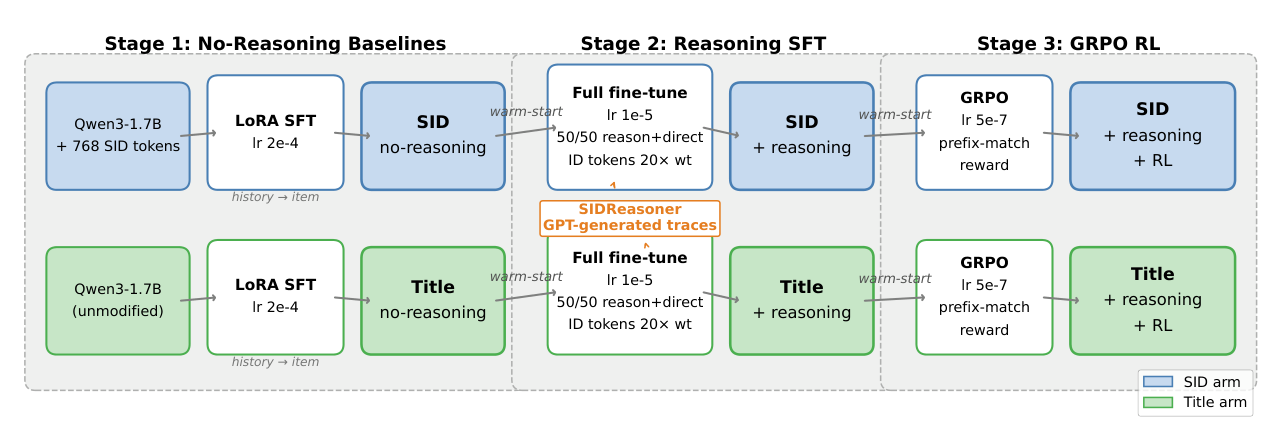
Stage 1:No-Reasoning 基线。用直接的 history→item 预测,为每种表示训一个无推理基线。LoRA(rank 16, $\alpha = 32$),学习率 $2 \times 10^{-4}$,有效 batch size 128。
Stage 2:Reasoning SFT。从对应的 Stage 1 检查点热启动,全参数微调(学习率 $10^{-5}$),用 SIDReasoner 释出的 GPT 生成推理轨迹。每个 batch 50% 推理样本 + 50% 直接 history→item 样本,这个混合保住底层推荐任务;推理样本里 item-ID token 的 loss 权重是推理 token 的 20 倍,以优先保证 item 预测准确。
Stage 3:GRPO RL。从 Stage 2 检查点出发,用 Group Relative Policy Optimization 优化推荐质量。每个 prompt 采样 16 条 completion,计算组内相对优势。奖励用有序前缀匹配:对 SID,匹配上三个层次编码的前 $k$ 个得奖励 $k/3$;对 title,匹配上前 $k$ 个空格分词得奖励 $k/n$。因为奖励只依赖预测出来的 item,策略梯度只作用在 item token 上,推理 token 被 mask 掉——这保住了 Stage 2 学到的推理行为,同时让 RL 去优化推荐质量。
与 SIDReasoner 的三点差异(论文脚注 2):(1) Stage 1 用 LoRA 而非全参微调,得到轻量无推理基线;(2) 训练独立的无推理模型,而不是把推理模型放在 "non-thinking mode" 下评测——这样 reasoning delta 才真正隔离了「加推理」这一个变化;(3) Stage 2 混 50/50 样本并对 item-ID token 加 20× loss 权重。
2.5 关键指标:Reasoning Delta¶
对每种表示 $r \in \{\text{SID}, \text{Title}\}$,定义 reasoning delta 为加入 chain-of-thought 推理带来的推荐效果变化:
$$\Delta_r = \mathrm{Metric}(r, \text{reasoning}) - \mathrm{Metric}(r, \text{no reasoning}) \tag{1}$$
待检验的假设:如果对齐税是 SID 推理的主要瓶颈,那么应该有 $\Delta_{\text{Title}} > \Delta_{\text{SID}}$——不需要标识符对齐的自然语言标题,应该从推理中获益更多。
3. 实验设置¶
3.1 数据集¶
用 SIDReasoner 释出的 Amazon Reviews 2018 划分,保证与前作直接可比。全部 5-core 过滤(只保留至少 5 次交互的用户与 item),按时序 8:1:1 划分训练/验证/测试,滑窗历史最长 10。
| 数据集 | 用户数 | Item 数 | 交互数 |
|---|---|---|---|
| Amazon Video Games | 9,053 | 3,858 | 61,417 |
| Amazon Office | 7,638 | 3,459 | 48,656 |
| Amazon Industrial | 6,842 | 3,686 | 45,325 |
Table 1:预处理后的数据集统计。
3.2 评测协议¶
在全量 item 目录上评测(不采样负例)。SID 配置用 beam search + trie 约束解码;Title 配置生成不受约束的文本,再用 BM25 映射回目录 item——目的是做 item 级对比而非精确字符串生成评测。论文坦承这个解码不对称是一个潜在混淆因子:推理引起的生成风格漂移可能独立于推荐质量地损害 BM25 匹配。为量化这一点,论文在附录 F 专门测了带/不带推理时的标题解析率(见第 8 节)。
所有指标在 item 级计算(对比目标与预测的 ASIN),而非标识符级。因为 SID 由向量量化产生,不同 item 偶尔会共享同一标识符;当多个 item 共享一个标识符时,预测出的 SID 会被展开成所有匹配 item,占据连续排名位(如 rank 1 的三路碰撞占据 rank 1–3)。因此命中必须是正确的 item,防止碰撞人为抬高检索指标。实践中 SID 碰撞很罕见(< 1%)。
报告 $k \in \{5, 10\}$ 的 Recall@$k$ 与 nDCG@$k$,显著性用配对 bootstrap 重采样(1000 次迭代,$\alpha = 0.05$)。
4. 主要实验结果:2×2 对比¶
Table 2:三个 Amazon 域上的完整 2×2 结果(Stage 2 = 在 GPT 轨迹上 SFT;Stage 3 = 带前缀匹配奖励的 GRPO RL;† 表示与无推理基线有显著差异,$p < 0.05$):
| Repr. | Stage | VG R@5 | VG R@10 | VG N@5 | VG N@10 | Off R@5 | Off R@10 | Off N@5 | Off N@10 | Ind R@5 | Ind R@10 | Ind N@5 | Ind N@10 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| SID | 1: No reasoning | .0497 | .0728 | .0356 | .0430 | .1360 | .1595 | .1123 | .1198 | .1013 | .1361 | .0791 | .0902 |
| SID | 2: Reasoning SFT | .0454 | .0689 | .0309 | .0384 | .1334 | .1589 | .1056 | .1138 | .1013 | .1324 | .0761 | .0862 |
| SID | 3: GRPO RL | .0451 | .0682 | .0314 | .0388 | .1317 | .1591 | .1037 | .1125 | .1008 | .1332 | .0761 | .0866 |
| Δ SFT% | −9% | −5% | −13% | −11% | −2% | −0% | −6% | −5% | 0% | −3% | −4% | −4% | |
| Δ RL% | −9% | −6% | −12% | −10% | −3% | −0% | −8% | −6% | −0% | −2% | −4% | −4% | |
| Title | 1: No reasoning | .0510 | .0783 | .0354 | .0443 | .1350 | .1587 | .1107 | .1185 | .1094 | .1253 | .0800 | .0852 |
| Title | 2: Reasoning SFT | .0412† | .0627† | .0274† | .0343† | .1192† | .1416† | .0927† | .1001† | .1059 | .1240 | .0765 | .0825 |
| Title | 3: GRPO RL | .0391† | .0614† | .0269† | .0341† | .1188† | .1397† | .0915† | .0985† | .1032 | .1233 | .0744 | .0811 |
| Δ SFT% | −19% | −20% | −23% | −23% | −12% | −11% | −16% | −16% | −3% | −1% | −4% | −3% | |
| Δ RL% | −23% | −22% | −24% | −23% | −12% | −12% | −17% | −17% | −6% | −2% | −7% | −5% |
He et al. [4] 的参考数值(同划分、全参微调、SID 级评测,非本文的 item 级):
| 模型 | VG R@5 | VG R@10 | VG N@5 | VG N@10 | Off R@5 | Off R@10 | Off N@5 | Off N@10 | Ind R@5 | Ind R@10 | Ind N@5 | Ind N@10 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| SASRec | .0489 | .0535 | .0293 | .0293 | .0860 | .0952 | .0664 | .0741 | .0724 | .0847 | .0523 | .0598 |
| TIGER | .0489 | .0763 | .0300 | .0402 | .1270 | .1429 | .1037 | .1121 | .1003 | .1325 | .0823 | .0924 |
| SIDReasoner | .0710 | .1031 | .0460 | .0563 | .1373 | .1648 | .1119 | .1208 | .1109 | .1438 | .0905 | .1010 |
4.1 结论:假设被证伪,而且方向相反¶
Table 2 不支持 $\Delta_{\text{Title}} > \Delta_{\text{SID}}$ 的预测:
- 在三个数据集上,引入显式推理都降低了传统离线推荐效果,两种表示的 reasoning delta 无一例外为负或为零;
- 退化对 SID 反而始终更小。没有一个 SID 退化达到统计显著($p > 0.05$),而 Title 在 Video Games 和 Office 上的退化是显著的(Table 2 中的 †)。可靠的惩罚是 Title 专属的,且只在三分之二的域上出现。
这与对齐税假设的预测完全相反:本该"不用交税"的 Title 反而伤得更重。
4.2 GRPO 为什么救不回来¶
Stage 3 的 GRPO 直接通过策略梯度优化推荐质量,但没有恢复这个退化。所有 SID 配置下,GRPO 停留在其 SFT 热启动点的 ±0.001 R@10 之内;Title 在 Video Games 上 GRPO 的 Δ 是 −22% R@10,与 SFT 的 −20% 惩罚基本没变。所有数据集上最佳验证检查点都出现得很早(100–400 训练步)而后性能平台化,暗示单靠改变优化目标不足以修复当前推理表述引入的退化。
为理解 GRPO 为何失效,论文分析了生成 completion 的多样性与奖励分布:对每个 prompt 从 SFT 与 GRPO 两个检查点各采 16 条 completion(与 GRPO 训练配置一致),用训练奖励打分。结果反直觉——GRPO 的生成得到的平均奖励比 SFT 更低(Games/Title 上 0.001 vs 0.044),说明策略优化是在偏离 SFT 解,而不是在其之上改进。
根因是奖励稀疏:
- 70%–96% 的 prompt,其 16 条生成全部拿到零奖励,优势为零,因而完全没有学习信号;
- Games/Title 上只有 7.8% 的 SFT 生成能拿到部分匹配,推理几乎完全坍缩——平均轨迹长度从 SFT 的 69.6 词跌到 GRPO 的 1.1 词,模型收敛到空的
<think>块; - Industrial/Title 因为部分匹配率较高(25.5%)而避开了坍缩,梯度足够维持推理行为。
5. 支付完整的对齐税(SID-A)¶
一个自然的解释是:本文轻量的 Stage 1 提供的语义 grounding 不够。SIDReasoner [4] 在推理之前有一个八任务对齐阶段,专门把 semantic ID grounding 到自然语言。如果对齐税只是"没交够",那么交足了就该恢复推理的收益。
论文在三个域上完整复现了 SIDReasoner 的 Stage 1(记为 SID-A):对齐阶段组合八个目标,覆盖 next-item prediction、双向 title↔SID 翻译、跨表示推荐、item 与序列 grounding、通用推理;随后套用与全文相同的 Stage 2 / Stage 3。
Table 3:跨表示与 RL 变体的 R@10(GRPO (acc) 为纯前缀匹配奖励;GRPO+Judge 为复合 LLM-judge 奖励;SID-A 为八任务对齐 Stage 1):
| Repr. | Stage | Games | Office | Industrial |
|---|---|---|---|---|
| SID | 1: No reasoning | .0728 | .1595 | .1361 |
| SID | 2: Reasoning SFT | .0689 | .1589 | .1324 |
| SID | 3: GRPO (acc) | .0682 | .1591 | .1332 |
| SID | 3: GRPO+Judge | .0705 | .1646 | .1401 |
| SID-A | 1: No reasoning | .0624 | .1609 | .1416 |
| SID-A | 2: Reasoning SFT | .0519† | .1239† | .1134† |
| SID-A | 3: GRPO (acc) | .0344† | .1200† | .1165† |
| SID-A | 3: GRPO+Judge | .0361† | .1254† | .1169† |
| Title | 1: No reasoning | .0783 | .1587 | .1253 |
| Title | 2: Reasoning SFT | .0627† | .1416† | .1240 |
| Title | 3: GRPO (acc) | .0614† | .1397† | .1233 |
| Title | 3: GRPO+Judge | .0697 | .1395 | .1255 |
分析:
- 八任务对齐确实改善了底层表示——在三个数据集里的两个上,SID-A 的无推理模型强于轻量基线(Office R@10 .1609 vs .1595;Industrial .1416 vs .1361)。Video Games 上略弱(.0624 vs .0728)但仍有竞争力;
- 但一旦引入推理,性能大幅恶化:相对其自身的对齐无推理基线,SID-A 的 Stage 2 在三个域上损失 17–23% R@10,GRPO 进一步降级(Games 掉到 .0344);
- 在完全对齐的模型上做推理,一致地比在轻量基线上做推理更差:R@10 掉到 .0519 / .1239 / .1134,而对应的精简配置是 .0689 / .1589 / .1324。
这组结果定位了退化的来源:因为完全对齐的基线与轻量基线相比有竞争力甚至更强,失败不能归因于"模型看不懂 semantic ID"。改善语义 grounding 强化了底层推荐模型,但没有改善从显式推理里拿到的收益。
6. 用 LLM-Judge 奖励恢复性能¶
上面的分析指向前缀匹配奖励太稀疏。而且这个奖励对"相关但不同于唯一 held-out ground-truth item"的推荐不给任何信用 [11]。论文因此把纯准确率奖励换成一个复合目标,把推荐准确率与 LLM-judge 对推理质量、推荐相关性的评估结合起来:
$$R = 0.5 \cdot R_{\text{acc}} + 0.25 \cdot R_{\text{trace}} + 0.25 \cdot R_{\text{rel}} \tag{2}$$
其中 $R_{\text{acc}}$ 是原来的前缀匹配奖励,$R_{\text{trace}}$ 打分推理轨迹质量(groundedness 与 coherence),$R_{\text{rel}}$ 打分推荐相关性。两个 judge 分数都由 GPT-4o-mini(temperature 0)对每条采样 completion 计算,1–5 分经 $(s-1)/4$ 归一化到 $[0,1]$。与纯准确率变体不同,GRPO+Judge 把策略梯度同时施加到推理 token 和 item token 上,让模型可以优化被 judge 评估的推理行为。
结果(Table 3):
- SID:GRPO+Judge 在三个域中的两个上拿到最好 R@10,超过了无推理基线——Office .1646 vs .1595(+3.2%)、Industrial .1401 vs .1361(+2.9%);Video Games 上恢复了约 41% 的差距(.0705 vs .0728),但无推理基线仍最优;
- Title:GRPO+Judge 在 Industrial 上最好(.1255 vs .1253),在 Games 上恢复约 45% 的差距(.0697 vs .0783),但在 Office 上没能恢复(.1395 vs .1587);
- judge 奖励对 SID 的帮助大于 Title:SID 在两个域上拿到最佳效果,Title 只在一个域上做到。
6.1 便宜的稠密奖励也一样管用:reward density 才是操作变量¶
论文进一步问:LLM judge 的语义理解是必需的吗?还是一个更便宜的稠密奖励就够?于是把两个 judge 分量换成单一的 embedding 相似度奖励——预测 item 与 ground-truth item 的 E5 embedding [39] 余弦相似度:
$$R = 0.5 \cdot R_{\text{acc}} + 0.5 \cdot R_{\text{sim}}, \qquad R_{\text{sim}} = \max\big(0,\ \cos(e_{\text{pred}}, e_{\text{target}})\big) \tag{3}$$
这个变体训练时不需要任何 LLM 调用,而且与 GRPO+Judge 不同,它把策略梯度限制回 item token(embedding 奖励对推理 token 不提供信号)。
Table 6:三种 RL 奖励变体的 R@10:
| Repr. | Stage | Games | Office | Industrial |
|---|---|---|---|---|
| SID | 2: Reasoning SFT | .0689 | .1589 | .1324 |
| SID | 3: GRPO (acc) | .0682 | .1591 | .1332 |
| SID | 3: GRPO+Judge | .0705 | .1646 | .1401 |
| SID | 3: GRPO+Emb | .0682 | .1640 | .1399 |
| Title | 2: Reasoning SFT | .0627 | .1416 | .1240 |
| Title | 3: GRPO (acc) | .0614 | .1397 | .1233 |
| Title | 3: GRPO+Judge | .0697 | .1395 | .1255 |
| Title | 3: GRPO+Emb | .0615 | .1478 | .1273 |
Embedding 奖励在 SID/Office(.1640 vs .1646)与 SID/Industrial(.1399 vs .1401)上几乎追平 judge,在 Title/Office(.1478 vs .1395)与 Title/Industrial(.1273 vs .1255)上甚至超过 judge;只有在所有奖励变体都吃力的 Games 上,它退回到与纯准确率 GRPO 持平。
这是全文最锋利的一刀:因为 GRPO+Emb 只改了奖励密度(保留 item-token-only 的梯度),却仍能追平 GRPO+Judge,所以 reward density 才是操作变量——不是"梯度是否流经推理 token",也不是"judge 的语义理解"。换句话说,GRPO+Judge 的恢复效果并非来自它让模型想得更好。
7. 推理轨迹质量评测¶
上一节说明显式推理并不能稳定改善传统离线推荐效果。本节反过来问:提升轨迹的描述质量能解释这个结果吗?
评测方法:从 reasoning-SFT 模型用贪心解码(最多 320 token)在每个数据集 100 个测试用户上生成轨迹(每种表示 300 条)。一个 LLM judge(Gemini 2.5 Pro)连同用户交互历史和被推荐 item 一起,在六个质量维度上给 1–5 分并附一句理由。为保证评的是描述性推理轨迹质量而不是 token 可读性,所有 SID 编码在送给 judge 之前都被解码成人类可读标题。推荐相关性单独评测(对 top-10 推荐 item 的人类可读形式打分)。
用 Gemini 而不用 GPT,是因为推理轨迹由 GPT 蒸馏的模型生成,避免循环评测;每个维度单独一次 API 调用以避免跨维度锚定;跨模型族一致性在 15% 子集上用 GPT-4o 复核。
六个维度:Groundedness(推理主张是否被用户历史支撑)、Specificity(是否引用具体 item 属性而非泛泛之词)、Logical Coherence(是否形成从历史到推荐的一致链条)、Preference Extraction(是否正确识别用户偏好)、Recommendation Justification(是否解释了被推荐 item 为何由这些偏好导出)、Interpretability(人类能否理解并验证)。
Table 4:LLM judge 分数(1–5),在三个数据集上 pooled(每种表示每阶段 $n = 300$ 条轨迹)。SID⁰:轻量单任务 Stage 1;SID-A¹:八任务对齐 Stage 1;Title²:基于标题。上标表示在同一阶段内显著高于所标注的模型($p < 0.05$,单边 Mann-Whitney $U$,6 维度 Bonferroni 校正):
| 维度 | SFT: SID⁰ | SFT: SID-A¹ | SFT: Title² | +Judge: SID⁰ | +Judge: SID-A¹ | +Judge: Title² |
|---|---|---|---|---|---|---|
| Groundedness | 1.58 | 3.97⁰ | 4.07⁰ | 1.43 | 3.99⁰ | 4.24⁰ |
| Specificity | 4.02 | 4.65⁰˒² | 4.41⁰ | 4.10 | 4.66⁰˒² | 4.44⁰ |
| Logical Coherence | 1.15 | 2.37⁰˒² | 1.92⁰ | 1.42 | 2.40⁰˒² | 2.10⁰ |
| Preference Extr. | 1.48 | 3.77⁰˒² | 3.36⁰ | 1.61 | 3.76⁰ | 3.56⁰ |
| Rec. Justification | 1.08 | 1.39⁰ | 1.29⁰ | 1.15 | 1.33⁰ | 1.19 |
| Interpretability | 4.03 | 4.93⁰ | 4.94⁰ | 3.68 | 4.93⁰ | 4.92⁰ |
| Aggregate | 2.22 | 3.51 | 3.33 | 2.23 | 3.51 | 3.41 |
| Rec. Relevance | 3.64 | 3.71 | 3.88⁰ | 3.95¹ | 3.64 | 3.85¹ |
7.1 SFT 轨迹¶
Title 在全部六个维度上都显著高于原味 SID 模型,即便 SID 编码已经被解码成人类可读标题。最大的差距在 groundedness(1.58 → 4.07):原味 SID 轨迹频繁幻觉出用户历史里根本不存在的 item 和偏好。
支付完整对齐税弥合了这个差距:SID-A 拿到最高的聚合轨迹质量 3.51,超过 Title 的 3.33,并在 specificity、logical coherence、preference extraction 上显著更高。这证实八任务对齐成功地把 semantic ID grounding 到了自然语言。
但两种表示在 logical coherence(1.15–2.40)与 recommendation justification(1.08–1.39)上都接近下限,说明这些蒸馏出来的推理轨迹更像似是而非的旁白(plausible commentary),而不是有效的推理链条。
7.2 GRPO+Judge 轨迹¶
与传统离线推荐效果形成尖锐对比,描述性轨迹质量在 GRPO+Judge 下几乎没有变化:SID 从 2.22 到 2.23,SID-A 保持 3.51,Title 只从 3.33 微升到 3.41。Title 相对 SID 的优势也被保留(六个维度里五个显著)。
这构成了论文最强的证据:
- judge 奖励让 SID 的推荐效果在两个域上超过了无推理基线,却没有改善它的推理轨迹(2.22 → 2.23);
- 反过来,SID-A 拿到最高的推理质量(3.51),却拿到最差的推荐效果(Table 3 里 GRPO 后掉到 .0344/.1200/.1165)。
7.3 推荐相关性是第三个不同的量¶
Rec. Relevance 一行评的是另一件事:不评推理轨迹本身,只评把所有输出转成人类可读标题之后推荐结果的语义相关性,因此与底层 item 表示无关。
SFT 模型上,Title 的推荐被判定为显著比原味 SID 更相关(3.88 vs 3.64,$p < 0.05$),SID-A 落在中间(3.71,与两者都不显著)。GRPO+Judge 大幅收窄这个差距:原味 SID 从 3.64 升到 3.95,成为所有配置里最高;而 SID-A 掉到 3.64,显著低于原味 SID($p < 0.01$)和 Title($p < 0.05$)。
于是论文得到三分结论:描述性推理轨迹质量、LLM 判定的推荐相关性、传统离线推荐效果,三者刻画的是推荐系统的不同属性,不必同向移动。
8. 排查混淆因子:BM25 解析(附录 F)¶
因为 Title 配置生成不受约束的文本再事后用 BM25 解析回目录,Title 更大的推理惩罚可能只是"推理引起的标题生成漂移损害了 BM25 匹配",而不是模型 item 偏好真的变了。论文用三步把这个混淆因子按死。
(a) 忠实生成率。因为 item 阶段被限制在 32 token(Office 有 28% 的标题超过这个预算),逐字匹配率主要测的是标题长度,所以论文改测 prefix-faithful rate:生成结果在 BM25 索引的归一化之后逐字匹配某个目录标题、或匹配其截断前缀的比例。
| Domain | Verbatim (rank-1) 无推理 / 推理 | Pref.-faithful (rank-1) 无推理 / 推理 | Pref.-faithful (all beams) 无推理 / 推理 |
|---|---|---|---|
| Video Games | .966 / .962 | .981 / .984 | .928 / .926 |
| Office Products | .541 / .524 | .980 / .980 | .889 / .862 |
| Industrial & Sci. | .427 / .419 | .960 / .975 | .674 / .736 |
推理在任何域上都没有降低 prefix-faithful 率(Office 完全相同 .980 vs .980,Games 与 Industrial 甚至略高)。混淆因子的前提——"推理降低了生成标题的可解析性"——不成立。
(b) Oracle 解析上界。为界定"任何更好的解析器最多能贡献多少",论文用一个 oracle 解析器重新打分:只要生成字符串与目标标题的 E5 embedding 相似度超过阈值,就把任何漂移生成映射到目标 item。因为 oracle 偷看了答案,它上界了一切可部署的解析器(含稠密检索)。
| Domain | Arm | BM25 | Oracle.95 | Oracle.90 |
|---|---|---|---|---|
| Video Games | No Reasoning | .079 | .079 | .087 |
| Video Games | Reasoning | .063 | .064 | .071 |
| Office | No Reasoning | .166 | .175 | .198 |
| Office | Reasoning | .149 | .155 | .176 |
| Industrial | No Reasoning | .111 | .187 | .268 |
| Industrial | Reasoning | .120 | .196 | .246 |
在 Video Games 与 Office 上,任何阈值下 oracle 都原封不动地保留了推理差距;在 Industrial 上(Table 2 的 reasoning delta 本就不显著)oracle 甚至略微偏向推理臂。没有任何解析器改进能补上推理的亏空。
(c) 漂移生成的成分分析。把 rank-1 beam 归一化后不能精确匹配任何目录标题的生成定义为"漂移",再分成六类:trace leak(推理风格散文而非标题)、history echo(历史 item 的近似复制)、other-item near-miss(真实但不同 item 的轻微拼错,BM25 能安全解析)、target near-miss(目标的改写措辞——唯一可能藏着解析混淆的类别)、hallucinated product、degenerate。
| Domain | Arm | Drifted | Trace leak | Hist. echo | Other item | Target near | Halluc. | Other |
|---|---|---|---|---|---|---|---|---|
| Video Games | No Reasoning | 118 (1.9%) | 0 | 69 | 29 | 2 | 8 | 10 |
| Video Games | Reasoning | 99 (1.6%) | 4 | 46 | 40 | 3 | 6 | 0 |
| Office | No Reasoning | 97 (2.0%) | 0 | 56 | 9 | 12 | 18 | 2 |
| Office | Reasoning | 97 (2.0%) | 3 | 57 | 16 | 7 | 13 | 1 |
| Industrial | No Reasoning | 181 (4.0%) | 0 | 68 | 107 | 6 | 0 | 0 |
| Industrial | Reasoning | 114 (2.5%) | 10 | 66 | 12 | 25 | 1 | 0 |
漂移量在两臂之间对称(Office 97 vs 97)或推理臂更低(Industrial 114 vs 181),主要由 history echo 和错 item near-miss 构成。Target near-miss 全局罕见——最多 25/4533 = 0.55%(Industrial 推理臂)。Trace leakage 可以忽略(4/3/10 例),与"推理轨迹在预算内终止"一致(任何域上撞到 512-token 上限的轨迹最多 2.9%)。
结论:SID 臂与 Title 臂之间的解码不对称无法解释 Table 2 里 Title 的推理亏空。这个亏空反映的是模型 item 预测本身的变化。
9. 生产级设定下的推理(§5.3,工业属性的关键证据)¶
上面的受控对比是在小目录(约 3.5K item)的学术 benchmark 上做的。论文接着问:这些发现能否推广到生产级系统——模型必须在一个大得多的目录上服务多个任务?
论文在 Spotify 的歌单续接(playlist continuation)任务上评测 SID 上的推理,用的是专有数据集:$\mathcal{O}(10^6)$ 条歌单、$\mathcal{O}(10^8)$ 首曲目的目录。给定歌单标题和前 $N$ 首曲目,模型生成可能的续接曲目。每个训练实例由一个 teacher 语言模型提供一条合理的、target-informed 的推理轨迹,采用简洁的两行 schema:
<think>
Clues: this is a dreamy and calm playlist with indie and alternative styles; artists include the strokes and loathe.
Plan: bridge into a related style; favor bedroom pop with a dreamy mood, prioritizing the strokes, lana del rey, and malcolm todd.
</think>
Clues 概括输入可见的 mood、genre、代表艺人;Plan 给出续接策略 + target-informed 的风格、情绪、艺人线索。
表示与训练:与单任务 Amazon 模型不同,这个模型面向多任务共享同一骨干的生产设定。输入把文本元数据与 SID token 交错,推理用自然语言表达,被推荐曲目以 SID token 生成。用 Qwen3 1.7B 架构,先做目录 grounding 目标的持续预训练(跨多任务对齐 SID 与文本 token,类比 §5.1.2 的八任务对齐),再在带推理轨迹的歌单续接任务上做两个 epoch 的全参数微调(等价于 Stage 2 Reasoning SFT)。
Table 5:固定 held-out panel 上的歌单续接质量(Rank aggregation 取无推理与推理两路候选的并集,按倒数排名之和给每首曲目打分):
| Method | HR@30 | NDCG@30 |
|---|---|---|
| No Reasoning | 0.6337 | 0.1364 |
| Reasoning SFT | 0.6343 | 0.1329 |
| Rank aggregation | 0.6515 | 0.1380 |
结论:HR@30 与 NDCG@30 基本持平(推理 SFT 的 HR 微升 0.0006、NDCG 微降 0.0035)。但推理确实引入了无推理输出里没有的合适曲目——rank aggregation 捕获了这个互补信号,在两个指标上都拿到最强值。
这把受控 Amazon 实验的核心观察扩展到了生产级多任务设定:即便有多任务模型、大目录、充分的目录 grounding,在(已对齐的)semantic ID 上做推理能产出连贯、目录 grounded 的轨迹并能引导推荐,却不能可靠地改善聚合推荐效果——推理引入了有用候选,同时也挤掉了数量相当的候选。一个可能的解释是 SID→text→SID 的往返:目录证据必须先被言语化,再被映回标识符。
附录 E 的正负例把机制说得很清楚:
- 正例:输入是 Nirvana / KISS / Black Sabbath / Offspring / Limp Bizkit / System Of A Down / TOOL / Godsmack,目标偏向 Deftones。轨迹里显式的 Deftones 线索把 My Own Summer (Shove It) 和 Change (In the House of Flies) 拉到 rank 1、2(无推理版这两首都不在 top-10);
- 负例:输入混合了说唱与舞曲流行(Travis Scott / Yeah Yeah Yeahs / Pitbull / Charli xcx),目标主要走流行分支,但 Plan 却优先了 Travis Scott / A$AP Rocky / Kanye West,模型照做,产出纯说唱续接,把相关的流行候选挤了出去。
推理改变的是"哪些候选被浮现出来",而不是简单地改善或降级传统离线效果。
10. 定性案例:SID 轨迹在幻觉什么(附录 D)¶
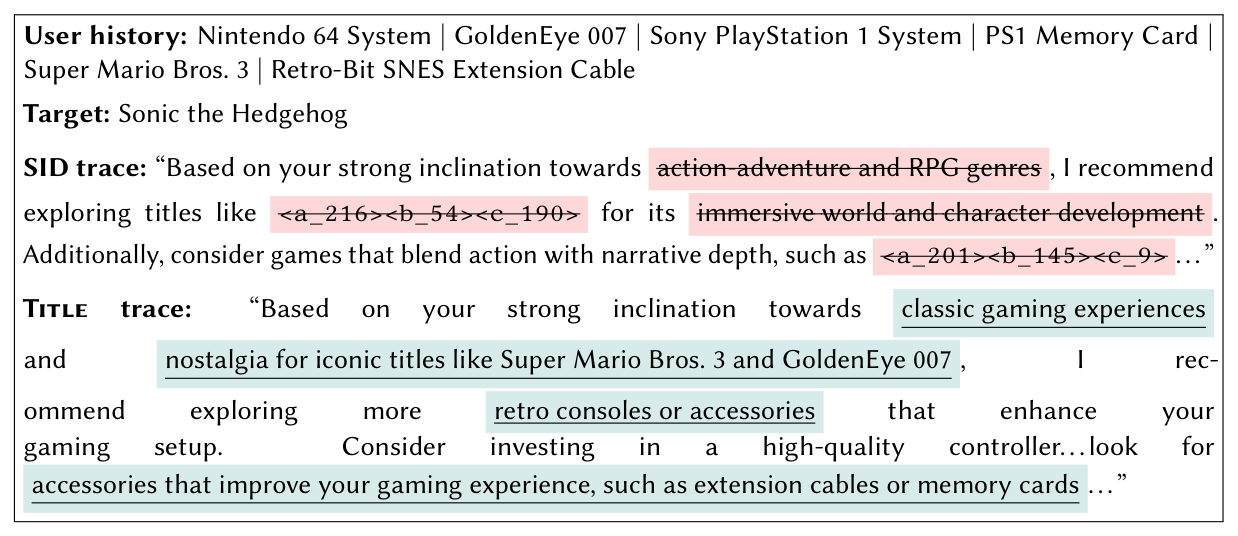
Video Games 上的一个代表案例:用户历史全是复古游戏——N64 主机、GoldenEye 007、PS1 主机 + 记忆卡、Super Mario Bros. 3、SNES 延长线,目标是 Sonic the Hedgehog。
- Title 轨迹正确识别出这是复古与经典游戏模式:"classic gaming experiences and nostalgia for iconic titles like Super Mario Bros. 3 and GoldenEye 007",并推荐匹配的复古配件;
- SID 轨迹读不懂自己的不透明 token,于是退化到训练数据里最常见的模板:"a strong inclination towards action-adventure and RPG genres",然后推荐
<a_216><b_54><c_190>和<a_201><b_145><c_9>(分别是 Zelda: Breath of the Wild 与 The Witcher 3)——完全错过复古模式的现代开放世界游戏。
SID 轨迹在 groundedness 与 preference extraction 上都得 1 分,Title 轨迹都得 5 分。这种"SID 轨迹产出听着合理但无法验证的通用叙事"的模式在整个数据集上反复出现。
而关键的反讽在于:Title SFT 产出更高质量的轨迹(3.33),却承受更大的排序惩罚(Games N@10 −23% vs SID 的 −11%)。
11. 核心贡献总结¶
- 首个跨 semantic ID 与自然语言标题的受控推理轨迹对比:共享 Qwen3-1.7B 骨干、相同数据划分、相同 teacher 轨迹,把 item 表示与语义 grounding 拆成两个可独立操纵的因子。
- 证伪"轨迹质量 → 推荐效果"的因果链:两个独立干预(自然语言标题、八任务充分对齐)都显著提升描述性轨迹质量,但在本文研究的训练目标下都不能稳定改善传统离线推荐效果;SID-A 拿最高轨迹质量(3.51)+ 最差推荐效果,SID GRPO+Judge 拿最好推荐效果 + 不变的轨迹质量(2.23),两个方向都成立。
- 把失败机制定位到奖励密度:70–96% 的 prompt 全组零奖励导致零优势;Games/Title 上推理坍缩到 1.1 词的空
<think>;换成复合 judge 奖励可部分甚至完全恢复(SID 在 Office/Industrial 上超过无推理基线 +3.2%/+2.9%);而纯 embedding 稠密奖励几乎追平 LLM judge,证明 reward density 而非 trace semantics 才是操作变量。 - 严密排除混淆因子:用 prefix-faithful 率、oracle 解析上界、漂移生成六分类三重证据,证明 Title 臂的 BM25 解码不对称不能解释其推理亏空。
- 生产级证据:在 Spotify $\mathcal{O}(10^6)$ 歌单 / $\mathcal{O}(10^8)$ 曲库、生产级多任务共享骨干(目录对齐持续预训练 + 全参 SFT)上复现同一结论,并给出 rank aggregation(HR@30 0.6337/0.6343 → 0.6515)作为"推理浮现互补候选"的正面证据。
- 术语上的警醒:论文明确站到 Kambhampati et al. [37] 一边——中间 token 更适合被理解为学到的 prompt 增强而非"推理",其任务效用与语义内容无关;本文的 reward-density 发现与 trace-quality/效果解耦,正是 prompt-augmentation 框架下应当预期的结果。
12. 与已归档相关工作的对比¶
PauseRec PauseRec: Implicit Reasoning for LLM-based Generative Recommendation(University of Virginia × Snap Inc.,2026-06-12)¶
关系:独立并发(本文未引用 PauseRec,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇论文问的是同一个 root cause 问题——在 SID 生成式推荐里,显式自然语言 CoT 到底有没有用,如果没用是为什么。两者都发现:在纯 SFT(无昂贵 RL)条件下,加显式推理反而不如朴素的 next-item SFT。PauseRec 在 Amazon Beauty 上测了 7 种 rationale 变体(模板、Gemini 3.1 Flash-Lite/Pro free-form、两种拒绝采样、格式受限),全部跑不赢 next-item SFT 基线(Hit@5 0.0533);本文在三个 Amazon 域上测 SID/Title × SFT/GRPO,reasoning delta 无一例外为负或为零。两者甚至用了同一个骨干 Qwen3-1.7B 和同源的 Amazon 数据。
- 相近的技术骨架:都是「先诊断、再对比」的受控解剖式设计——固定骨干与数据,只切换"推理以什么形式插入 SID 预测",然后用探针实验定位失败机制,而不是直接堆一个新架构。
- 本文的差异与推进:PauseRec 的三大根因是表示与解码侧的(世界知识言语化受损:CoT SFT 后 MMLU text-match 从 57.6 崩到 0.10 而 logit-based 仍有 55.2;文本-SID 嵌入几何分离,并给出 Theorem 1 上界 $|\Delta(z_y - z_s)| \le B(\rho\|\Delta_{\text{text}}\| + \epsilon)$;rationale 脆弱性:删掉目标类目 Hit@5 从 0.1165 腰斩到 0.0540)。本文的根因是测量与优化侧的:轨迹质量与推荐效果本就是两个不同的量(SID-A 质量最高 3.51 / 效果最差;SID+Judge 效果最好 / 质量不变 2.23),失败的可操作变量是奖励密度(70–96% 全零组)而非轨迹语义。两者互补:PauseRec 解释了"为什么显式 rationale 在 SID logit 上使不上劲",本文解释了"为什么把 rationale 写得更好也没用"。
- 可比的方法 / 实验差异:PauseRec 的解法是绕开——用可训练
<pause>token 做隐式 latent 推理,不要 teacher CoT 也不要 RL,训练 GPU 时数降 65%、推理快约 3.5×,在 10/12 指标上超过 RL-based 的 OneRec-Think。本文没有提出替代方案,而是把 RL 目标本身当作变量,发现 GRPO+Judge / GRPO+Emb 可以把退化补回来(SID Office .1589→.1646 超过无推理基线)。值得注意的是,PauseRec 的"绕开显式文本"与本文的"reward density 才是操作变量、trace 语义无关"指向同一个更深的结论:显式自然语言轨迹的语义内容并不是推荐收益的来源。
ReCast ReCast: Recasting Learning Signals for RL in Generative Recommendation(Huawei,2026-04-24)¶
关系:独立并发(本文未引用 ReCast,两者对同一机制给出独立量化)· 已加载对方精读
- 共同关注的问题:两篇论文独立地量化了同一个 GRPO 失效机制——稀疏命中场景下,组内所有 rollout 全部拿零奖励,advantage 归零,整个 group 不构成可学习单元。ReCast 在 OpenOneRec RL 设置下测得:训练 20K 步后仍有约 85% 的 group 是 all-zero、13% single-hit、只有 2% multi-hit,样本粒度上约 96% 的响应是 zero-reward。本文测得:70%–96% 的 prompt 其 16 条生成全部零奖励,且在 Games/Title(部分匹配率仅 7.8%)上推理坍缩到平均 1.1 词的空
<think>,而 Industrial/Title(部分匹配率 25.5%)因梯度足够而幸免。两组数字的量级与结论高度一致。 - 相近的技术骨架:两者的方法流程图在"诊断"这一节完全重合——固定 rollout 采样与外层 KL 正则策略梯度,只去检查 within-group 的奖励分布是否构成可学习优化事件,并据此重新设计 advantage 的来源。
- 本文的差异与推进:ReCast 把结论推到「瓶颈不是奖励稀疏而是 group 可学性退化」,解法是 repair-then-contrast:全零组用 ground-truth 派生的 anchor 替换掉结构分数 $u_i$ 最低(最不 informative)的那条响应,恢复最小可学状态;再用「最强正例 + 最难 near-miss」的常数尺寸边界对比替代全组归一化。本文的解法是换奖励函数本身:把二值前缀匹配换成复合 LLM-judge 奖励(式 2)或 E5 embedding 相似度奖励(式 3),直接把零奖励区间填成连续值。ReCast 是"修组",本文是"加密度",但攻击的是同一个零优势病灶。
- 可比的方法 / 实验差异:ReCast 用层次化匹配核 $\phi(p,t) \in \{1, 0.1, 0.01, 0\}$ 引入 SID 结构相似度,但只用于组内排序,不进入外层奖励;本文的 $R_{\text{sim}}$ 与 $R_{\text{trace}}/R_{\text{rel}}$ 则直接进入奖励。本文额外提供的独立信息是消融了"稠密性 vs 语义性":GRPO+Emb 只改奖励密度、把梯度限制回 item token,却仍几乎追平 GRPO+Judge,说明 ReCast 那类不依赖 LLM 语义的结构化稠密信号已经足够——这为 ReCast 的低成本路线提供了一个来自 Spotify 的旁证。
GR2 GR2: Generative Reasoning Re-Ranker(Meta AI,2026-06-30)¶
关系:显式引用但原文未展开对比(仅在 related work 以 "Ranking-oriented methods such as GR2 [21]" 一笔带过,无方法或指标层比较)· 已加载对方精读
- 共同关注的问题:两篇都在问「teacher 蒸馏出来的显式 CoT 能否转化为推荐/排序收益」。而且两者对同一个嫌疑犯给出了判决——answer-conditioned(target-informed)teacher 轨迹。本文在讨论章节把它列为退化的候选 root cause:Stage 2 的轨迹是答案条件的(GPT 同时看到历史和已知目标,构造出被答案引导的偏好叙事),而测试时模型必须在不知道目标的情况下先写轨迹;这与 Table 4 里 logical coherence(1.15–2.40)与 recommendation justification(1.08–1.39)逼近下限的观察一致——轨迹流畅地描述偏好,却不形成能可靠指向具体 item 的推理链。GR2 独立地把这一点写死在方法动机里:targeted sampling 让 teacher condition 在答案上,产出的轨迹"倾向编码事后的、label-aware 的捷径,student 记成流畅但非因果的推理"。
- 相近的技术骨架:SID mid-training / 对齐 → teacher 推理轨迹蒸馏 SFT → 可验证奖励 RL,这条三段式骨架与本文的 Stage 1/2/3 逐段对应;连"推理 token 与 item token 用不同 loss 权重"这一细节都同构(GR2 的 $\mathcal{L}_{\text{SFT}} = -\lambda_r \sum \log P(r_i \mid \cdot) - \lambda_o \sum \log P(o_j \mid \cdot)$ 且 $\lambda_r < \lambda_o$,对应本文的 item-ID token 20× loss 上权)。
- 本文的差异与推进:GR2 的解法是换掉蒸馏方式——用 On-Policy Distillation(GRPO 式循环,student 从自身分布采样,teacher 只贡献 token log-prob 作为逐 token reverse-KL anchor)替代在静态 teacher 语料上做 behavior cloning 的 SFT,因为后者在工业规模会崩溃;1.7B 的 OPD student 用 5% 参数量恢复了 32B teacher 增益的约 82%,最终在工业流量上拿到 +18.7% R@1 / +9.6% N@3。本文没有换蒸馏方式(直接复用 SIDReasoner 释出的 GPT 轨迹),而是把这一点作为已声明的局限留给未来工作——这恰好说明本文的负面结论范围受限于 answer-conditioned 蒸馏这一个选择。
- 可比的方法 / 实验差异:最有价值的交叉验证在于 GR2 §6.4 从相反方向独立观察到了同一个 disconnect:在 zero-shot 检查点上直接上 RL,排序指标能追平 RL-OPD(R@1 0.2236 vs 0.2300),但推理质量在全部五个 rubric 上都落后(OVERALL 0.28 vs 0.56,Depth 甚至跌到 1.02 的下限)——即 "RL alone 学会排得好却不会想得好"。本文的镜像结论是 "GRPO+Judge 让 SID 排得更好却没想得更好"(2.22 → 2.23)。两篇论文一正一反地确认:排序指标与轨迹质量可以彼此脱钩地移动。此外 GR2 用的是工业 multi-positive slate 奖励,本文用的是单 ground-truth 前缀匹配奖励——本文自己也指出,单 ground-truth 离线评测提供的相关性标签严重不完整 [11],可能高估了推理的真实代价,而 GR2 的 multi-positive 设定天然规避了这个问题。
13. 讨论与局限性¶
13.1 三条更广的启示¶
(1) 优化目标实质性地决定了显式推理的影响。 三个域上,监督推理与纯准确率 GRPO 都无法改善传统离线效果——每个 reasoning delta 都是负或零,纯准确率 GRPO 也基本停在 SFT 热启动点。论文把这个失败归因于奖励稀疏(70–96% 的 prompt 全组无信号)。换成复合 LLM-judge 奖励后画面大变:SID 推理在三个域中的两个上超过无推理基线,Games 上两种表示都恢复了相当比例的差距。生产级歌单实验给出进一步证据:虽然单纯的 reasoning SFT 不改善聚合效果,但 rank aggregation 在两个指标上都拿最佳,说明推理浮现了无推理模型检索不到的互补候选。
(2) 描述性轨迹质量、推荐相关性、传统离线效果刻画的是不同属性。 这是全文最一致的发现。自然语言标题大幅提升轨迹质量却不改善离线效果;支付完整对齐税产出最高轨迹质量却不是最强推荐;反过来,用 LLM-judge 奖励优化大幅提升推荐相关性、部分恢复离线效果,却几乎不改变轨迹质量。
(3) 对齐税是真的,但它主要体现在描述性推理轨迹上,而不是传统离线推荐效果上。 直觉会预期 SID 因为需要额外对齐而承受更大的推荐惩罚——结果相反:原味 SID 轨迹质量更低但惩罚更小;支付完整对齐税后模式反转(SID-A 轨迹质量最高 3.51、推荐效果最差,GRPO 还在进一步恶化一个已被削弱的推理模型)。充分对齐成功教会了模型在 SID 上产出高质量描述性轨迹,但这些提升不转化为更好的离线效果,甚至可能把模型推离无推理训练中学到的、已校准的 next-item 分布。
13.2 一个可能的机制解释:表示干扰¶
论文提出 representational interference(表示干扰) 假说:在 Title 配置里,推理轨迹与预测目标共享同一套自然语言词表,所以生成推理轨迹可能把输出分布推向"貌似合理但错误"的 item;相反,SID token 占据一个与推理文本不相交的词表,在推理与预测之间形成天然隔离。这可以解释为什么 LLM-judge 奖励对 SID 的帮助大于 Title——SID 上轨迹的改善可以转化为更好的推荐,而不直接干扰 item 预测。
13.3 局限性(论文自陈 + 精读补充)¶
论文自陈三点:
- 单一骨干:只评了 Qwen3-1.7B,更大容量模型上轨迹质量与离线效果的关系可能不同;
- teacher 轨迹的初始化偏置:Stage 2 从 GPT 生成的 teacher 轨迹初始化而非模型自身推理。虽然 Stage 3 从自生成轨迹优化,监督初始化仍可能约束推理风格;OneRec-Think [5] 这类不靠 teacher 蒸馏发展推理的端到端方法可能表现不同;
- 完全离线:轨迹质量、推荐相关性、传统离线效果三者的关系是否转化为用户满意度,需要在线评测才能回答。
精读补充的几点:
- 负面结论的作用域比标题窄。全部三个 Amazon 域的推理轨迹都来自同一个来源(SIDReasoner 释出的 GPT 轨迹),且是 answer-conditioned 的。GR2 的经验(见 §12)表明这类轨迹在工业规模上做 behavior-cloning SFT 本来就会崩,换成 on-policy distillation 就能拿到 +18.7% R@1。所以"显式推理降低离线效果"更准确的表述是"在 answer-conditioned teacher 轨迹上做 off-policy SFT 会降低离线效果"。
- 纯准确率 GRPO 的设计选择限制了它能做的事。Stage 3 的策略梯度被 mask 到只作用于 item token,理由是"保住 Stage 2 学到的推理行为";但这也意味着 RL 无法调整推理行为本身。GRPO+Judge 一旦把梯度放开到推理 token,效果就恢复了——虽然 GRPO+Emb 的对照说明真正起作用的是密度而非梯度流向,但这个混杂在纯准确率变体里没有被单独拆开(即"item-token-only 梯度 + 稠密奖励"直到 GRPO+Emb 才出现)。
- Title 臂的评测虽然被严密辩护,仍不是完全对称的。SID 用 trie 约束 beam search(结构上不可能生成非法 item),Title 用无约束生成 + BM25。附录 F 的三重证据(prefix-faithful 率、oracle 上界、漂移六分类)已经把这个混淆因子压到很小,但两条解码路径的搜索空间形状终究不同。
- 主实验目录只有约 3.5K item,与生产级 $\mathcal{O}(10^8)$ 曲库差 5 个数量级;§5.3 的 Spotify 复现在方向上支持了结论,但那里只有 reasoning SFT,没有 RL,所以"更丰富的奖励能恢复性能"这条正面结论尚未在生产规模上被验证——论文自己也把它列为有前景的方向。
- 评分反思:本文的方法论价值高(干净的因子设计 + 独立测量 + 严密的混淆排除 + 生产级复现),但没有新架构、没有线上 A/B 收益,且是 workshop 论文;负面结论的适用范围受限于单骨干与单一 teacher 轨迹来源。综合给 7 分。
13.4 值得借鉴的设计¶
- 把"中间产物质量"与"最终任务效果"当作两个必须分别测量的量。本文最可复用的方法论是:不要用 trace 的可读性/groundedness 当作功能效用的代理。对任何"加一段中间推理/摘要/意图描述"的推荐改造,都应该同时准备两套指标,并预期它们可能反向移动。
- 用"奖励密度 vs 奖励语义"的对照实验切开归因。GRPO+Emb(零 LLM 调用、item-token-only 梯度)几乎追平 GRPO+Judge,是一个极其便宜且极其有说服力的消融——它把"LLM judge 有效"这个含糊结论压缩成"稠密奖励有效",直接给出了低成本落地路径。
- 为不对称的评测协议准备 oracle 上界。当两条实验臂的解码方式不同时(约束解码 vs 生成后检索),用"偷看答案的 oracle 解析器"给出可部署解析器的上界,是一个干净利落的排除手段。
- rank aggregation 作为推理落地的中间形态。生产实验里,推理路与无推理路的候选做倒数排名融合就拿到了两个指标上的最佳值——在推理还不能稳定超过基线的阶段,把推理当作互补召回路而不是替代品,是一条现实的工程路线。