T-RoPE:让旋转位置编码按"事件何时发生"而不是"排第几个"来旋转¶
Shopify / MIT / Liquid AI · arXiv 2609.30576(v1,2026-09-24)
研究动机与背景¶
大规模推荐系统正在照搬大语言模型的"序列生成式"配方:把用户行为表示为动作序列,自回归地预测下一个 item、动作或语义 ID(TIGER、LETTER、HLLM、ActionPiece、OneRec 系列、GR2 等),HSTU 已在工业负载上驱动线上推荐。论文认为这种迁移"有效但不完美"——为文本设计的归纳偏置未必适合推荐,其中最典型的就是 RoPE(Rotary Position Embedding)。
RoPE 按整数位置索引旋转 query 与 key。对文本来说这是天然坐标,因为 token 偏移承载了注意力所需的大部分结构;但对推荐而言,交互索引只记录"谁先谁后",完全不说明间隔是几秒、几周还是几个季节。论文把这个"位置编码缺口"拆成三类未被表示的时间信号:
- 真实时间间隔被抹掉:一个六个月前的 key 与昨天的 key,只要序列偏移相同,在位置上就完全相同;
- 多尺度周期性缺失:用户行为含小时、周、月、季节等多种节律,但基于索引的 RoPE 没有任何"挂钟频率"结构;
- 绝对日历相位不可达:索引注意力只依赖相对偏移 $m-n$,因此是时间平移不变(time-translation invariant)的——同一段历史放在季节周期的不同位置上,会得到完全相同的注意力模式。
已有时间感知方法只补上了一部分(论文 Table 1):
Table 1:各位置编码方法显式提供的时间机制
| 方法 | Timestamp | Learnable | Multiscale | Shifted | Non-stationary |
|---|---|---|---|---|---|
| Standard RoPE (Su et al., 2024) | × | × | × | × | × |
| TiSASRec (Li et al., 2020) | Partial | × | × | × | × |
| TO-RoPE (Wei et al., 2025) | ✓ | Partial | ✓ | × | × |
| T-RoPE (ours) | ✓ | ✓ | ✓ | ✓ | ✓ |
(Multiscale 指显式覆盖多个周期的连续频率库;Learnable 指编码内部的可学习时间系数,而非泛指模型参数;Partial 指有限或间接地具备该性质。)
- TiSASRec 把离散化的时间间隔作为自注意力的加性偏置,只捕捉 recency,没有连续多尺度周期与日历相位;
- HSTU 的 time-based RAB(Relative Attention Bias)把分桶的时间差映射成可学习标量加到注意力 logits 上,能锐化 recency 权重,但不触碰 query/key 的几何,且仍然离散化时间;
- TO-RoPE(Time-and-Order RoPE)把时间戳放进 RoPE 旋转角,但其 query 与 key 的联合几何仍是时间平移不变的——能捕捉时间距离,却无法区分"同一段历史在不同日历相位下被查询"。
论文的核心立场是:时间不能只是作为额外特征或偏置"坐在 RoPE 旁边",必须从结构上改变 RoPE 旋转 query 与 key 的方式。据此提出 T-RoPE(Time-aware RoPE),保留 RoPE 的高效接口,但用五个部件替换"仅按索引旋转":时间戳旋转角、可学习时间系数、多尺度频率库、shifted query 对齐、非平稳(non-stationary)key 旋转。
论文列出的四项贡献:
- 面向生成式推荐的时间感知 RoPE,在单一旋转编码内表示经过时间、多尺度周期与日历相位;
- 理论分析:证明 query 与 key 用同一时间戳函数旋转会得到时间平移不变的注意力(覆盖"时间戳上的标准 RoPE"与 TO-RoPE 的时间戳分量),而 T-RoPE 的非平稳 key 可证明地打破这种不变性;
- 五个公开 benchmark + 超过 60 亿交互的工业数据集 + Shop app 线上 A/B;
- 前向/反向算法与代价分析,额外开销对序列长度与 head 维度线性。
预备知识:RoPE 的相对位置性质¶
生成式推荐的输入是用户按时间排序的带时间戳事件序列 $\{(i_1,t_1),\ldots,(i_L,t_L)\}$,$t_1<t_2<\cdots<t_L$,其中 $i_m$ 为 item,$t_m\in\mathbb{R}_{>0}$ 为以秒计的 Unix 时间戳(也可带交互类型或语义 ID)。模型自回归地预测下一个事件,论文取预测目标为下一个 item $i_{L+1}$。
Transformer 编码器把每个 item $i_m$ 映射成 $q_m,k_m,v_m\in\mathbb{R}^D$。标准 RoPE 作用在 $D/2$ 个二维旋转平面上,平面 $d\in\{1,\ldots,D/2\}$ 中的切片 $[q_{m,2d-1},q_{m,2d}]^\top$ 乘以旋转矩阵
$$R(\phi_m)=\begin{bmatrix}\cos\phi_m & -\sin\phi_m\\ \sin\phi_m & \cos\phi_m\end{bmatrix} \tag{1}$$
旋转后 query 与 key 在平面 $d$ 上的点积为
$$(q'_{m,d})^\top k'_{n,d}=(q_{m,d})^\top R(\phi_n-\phi_m)\,k_{n,d} \tag{2}$$
它只依赖角度差 $\phi_n-\phi_m$。整数索引下 $\phi_m=m\theta_d$($\theta_d$ 为平面 $d$ 的固定角频率),于是角度差变成 $(n-m)\theta_d$,点积只依赖相对偏移 $n-m$。这就是后文"平移不变性"的根源。
核心方法:T-RoPE 的五个部件¶
T-RoPE 保持 RoPE 的计算接口,但改变旋转的"含义":把用户历史看作带时间戳的事件序列,而非类文本列表。五个部件依次叠加。
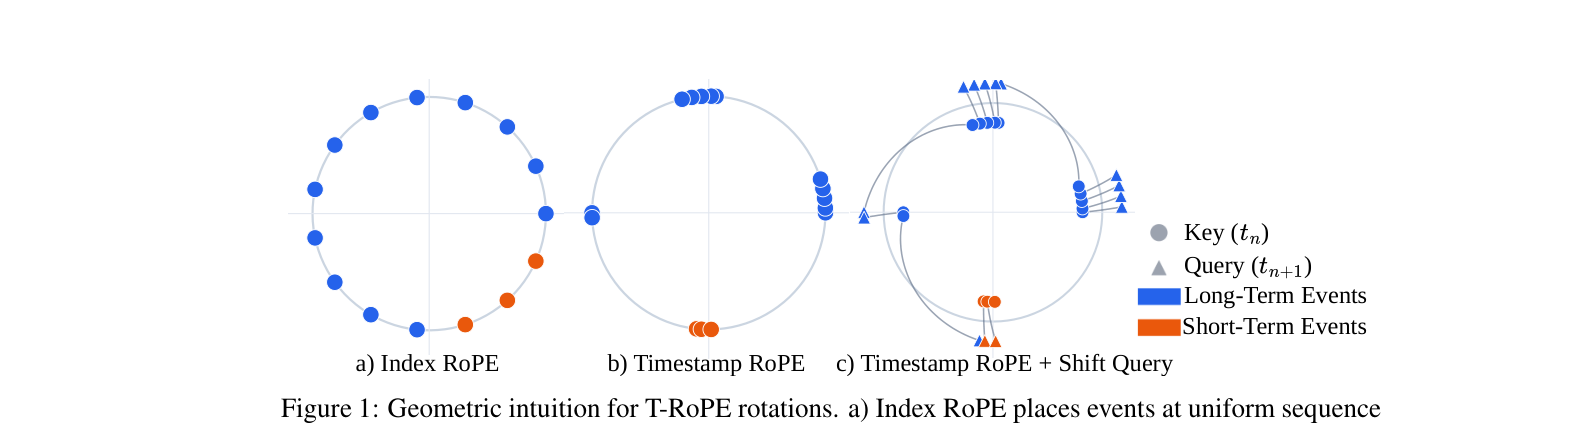
3.1 时间戳旋转(Timestamp-based rotation)¶
相邻序列位置在时间上并不等距:相邻两个事件可能相隔几秒、几天或几个月,但索引 $m$ 把每个间隔都当成"一个位置"(Figure 1a)。T-RoPE 因此用绝对 Unix 时间戳 $t_m$(秒)替换整数索引,且在旋转前不做中心化或归一化。如 Figure 1b 所示,序号相邻但时间相隔很远的事件不再占据相邻相位,突发(bursty)事件则仍聚在一起。对维度 $d$,角度为 $\phi_{m,d}=t_m/\beta_d$,$\beta_d$ 为基础时间频率。于是两事件的相对相位变成真实时间差的函数:
$$(q'_{m,d})^\top k'_{n,d}\propto\cos\left(\frac{t_n-t_m}{\beta_d}\right) \tag{3}$$
因此即便在截断历史中相邻,只要 $|t_n-t_m|$ 很大,注意力也会减弱。
3.2 可学习时间系数(Learnable temporal coefficients)¶
并非所有时间尺度同等重要:主导周期因领域而异、在同一模型的不同层之间也不同——杂货购买可能遵循 7 天或 30 天周期,时尚需求可能是季节性的,市场活动可能跟随发薪日或促销间隔。T-RoPE 学习每个周期的强度而非固定它,为 query 与 key 分别引入可学习系数 $\alpha^q_d,\alpha^k_d\in\mathbb{R}$:
$$\phi^q_{m,d}=\alpha^q_d\cdot\frac{t_m}{\beta_d},\qquad \phi^k_{n,d}=\alpha^k_d\cdot\frac{t_n}{\beta_d} \tag{4}$$
独立的 query/key 系数本可允许非对称特化,但论文实际观察到相反的现象:多数维度上学到的 query 与 key 系数在符号和幅度上都对齐(Figure 3a),即两者强调相同的时间频带。但这种对齐不跨层:Figure 2a 中每层系数的 RMS 幅度差异很大,Figure 2b 中同一序列上的时间注意力在所选层之间明显变化——每层学习自己的时间敏感度,而非共享一个偏置。
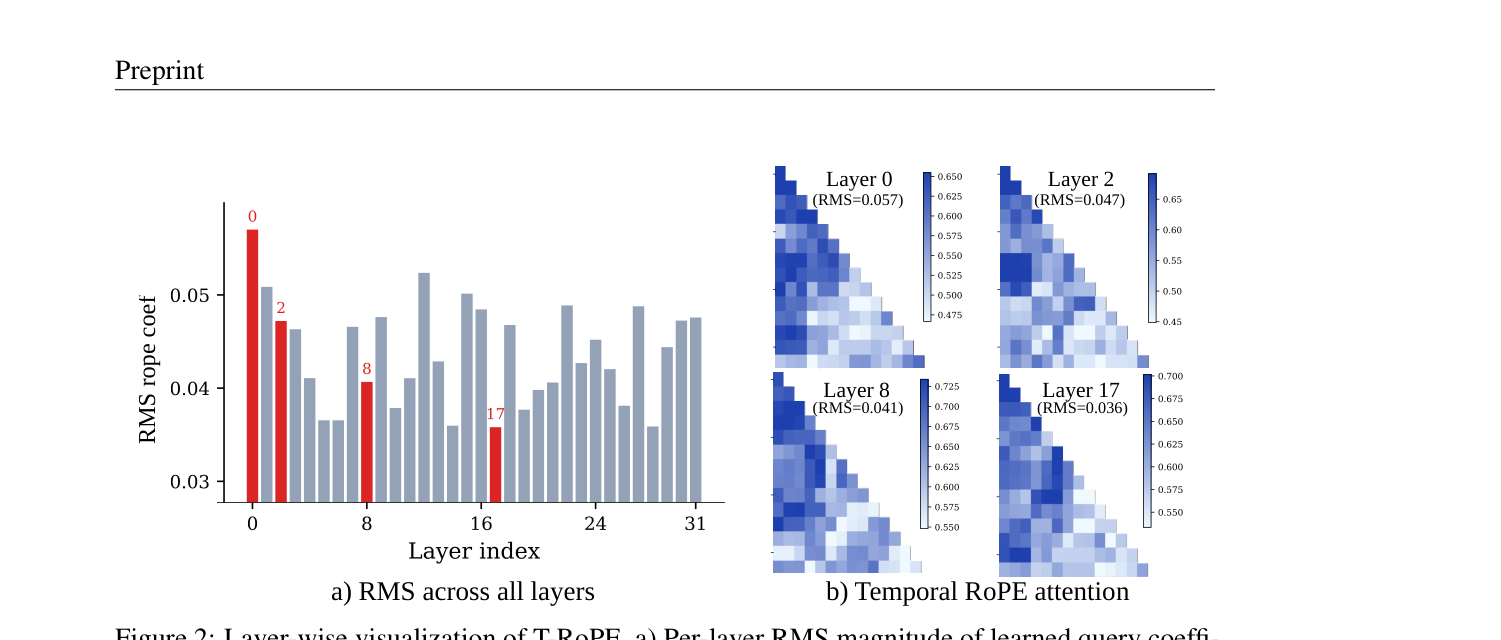
3.3 多尺度频率库(Multiscale frequency bank)¶
单一基础频率只能分辨一个时间尺度,而用户行为跨越分钟级浏览会话、周/月级家庭采购到年级季节需求。T-RoPE 用几何间隔为每个旋转平面分配不同的基础频率:
$$\beta_d=\exp\left(\log\beta_{\min}+\frac{d-1}{D/2-1}\left(\log\beta_{\max}-\log\beta_{\min}\right)\right),\quad d=1,\ldots,D/2 \tag{5}$$
其中 $\beta_{\min},\beta_{\max}$ 为超参数(默认 $10^2$ 与 $10^8$ 秒),得到从 $10^{-2}$ 到 $10^{-8}$ rad/s 的对数频率库。频率库固定了可用频率,可学习系数决定每个频率的贡献强度。Figure 3a 显示在单层内训练只上调少数频带而非均匀加权所有频率;Figure 3b 显示不同频率锁定不同的用户周期(30 天、90 天、年度维度与重复周期对齐)。论文据此称:学到的系数调整多尺度频率库,使时间戳编码无需显式编码"圣诞节"这类具名日历事件也能表示周期模式。
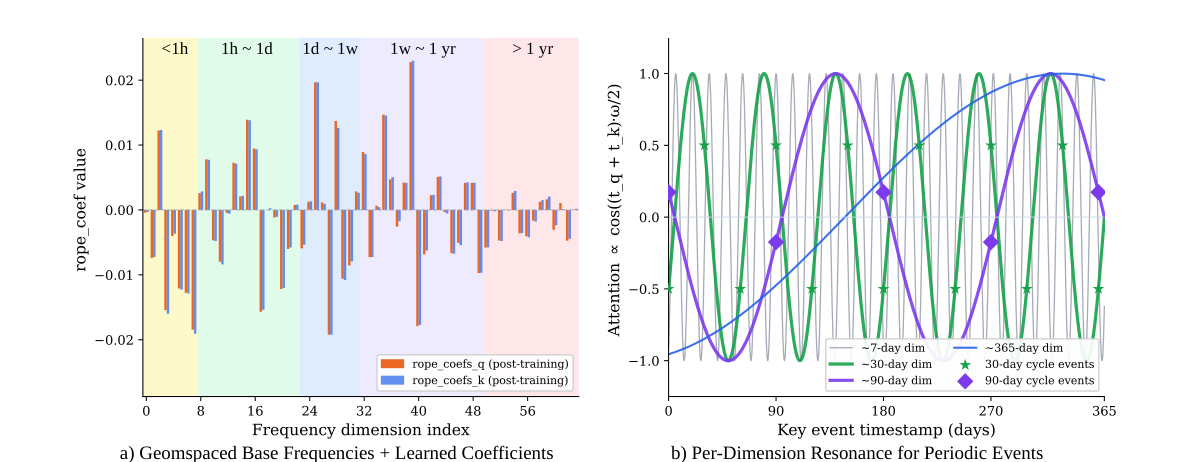
值得注意的一个细节(来自 Figure 3a 的纵轴):训练后的系数量级只有约 $0.005$–$0.023$,而附录 B.1 称系数从 $\mathcal{N}(0,1)$ 初始化。这意味着有效角频率 $\omega_d=\alpha_d/\beta_d$ 比 $1/\beta_d$ 小 50–200 倍,图中按 $\beta_d$ 标注的"<1h""1h~1d"等频带,其实际有效周期要长得多(例如 $\beta=100$ s、$\alpha\approx0.012$ 时有效周期 $2\pi\beta/\alpha\approx 14.5$ 小时)。论文没有讨论这一点。
3.4 Shifted query 对齐(Shifted query alignment)¶
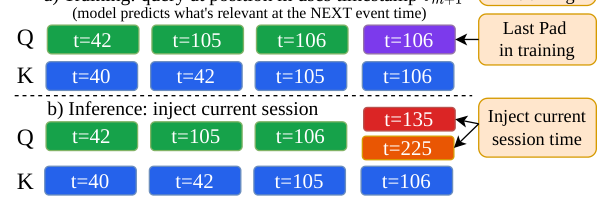
到目前为止旋转编码的是"历史事件何时发生",而不是"被预测的事件何时发生"。由于位置 $m$ 被监督去预测 $t_{m+1}$ 时刻的事件(部署模型在推理时拿到当前时间 $t_{\text{now}}$),论文借鉴 HSTU 的 RAB 做法,把 query 旋转到目标时间而非历史时间:位置 $m$ 的 query 使用 $t_{m+1}$,key 保留各自的时间戳:
$$\phi^q_{m,d}=\alpha^q_d\frac{t_{m+1}}{\beta_d},\qquad \phi^k_{n,d}=\alpha^k_d\frac{t_n}{\beta_d} \tag{6}$$
实现上就是时间戳角度张量沿序列维做一步平移。训练时最后一个位置保留自己的时间戳(它只作为 label 使用);推理时最后一个 query 槽接收当前会话时间 $t_{\text{now}}$,于是同一段 item 历史可以在不同"预测季节"下被评估(如节日季 vs 日常补货),无需改架构。
3.5 非平稳 key 编码(Non-stationary key encoding)¶
前四个部件给了 RoPE 真实时间戳、多尺度和预测时刻的 query,但保留了标准 RoPE 的一个对称性:因为 query 与 key 以相同方式旋转,点积只依赖角度差 $\phi^q_m-\phi^k_n=(t_{m+1}-t_n)/\beta_d$(在共享系数时),常数时间平移不改变它——模型能知道"某 item 发生在 query 之前 7 天",却不知道"query 落在日历周期的哪个位置"。
T-RoPE 对 key 施加标准旋转矩阵的转置:对平面 $d$ 与 key 时间戳 $t_n$,$k'_{n,d}=R(-\phi^k_{n,d})k_{n,d}=R(\phi^k_{n,d})^\top k_{n,d}$。由于二维旋转满足 $R(-\phi)=R(\phi)^\top$,这保留了相同的保范旋转原语,但改变了注意力内部的相位关系:
$$(q'_{m,d})^\top k'_{n,d}=q^\top_{m,d}R(-\phi^q_{m,d})R(-\phi^k_{n,d})\,k_{n,d}=q^\top_{m,d}R\left(-(\phi^q_{m,d}+\phi^k_{n,d})\right)k_{n,d} \tag{7}$$
角度现在依赖和 $(t_{m+1}+t_n)/\beta_d$ 而非差,因此同一段历史落在不同日历区间时注意力会改变。
3.6 完整 T-RoPE 公式¶
组合全部部件,每个 head 获得时间戳感知、多尺度、预测时刻对齐、非平稳的旋转:
$$q'_m=\bigoplus_{d=1}^{D/2}R(\phi^q_{m,d})\,q_{m,d},\qquad k'_n=\bigoplus_{d=1}^{D/2}R(-\phi^k_{n,d})\,k_{n,d} \tag{8}$$
其中 $\bigoplus$ 表示跨平面拼接,注意力分数为
$$a_{mn}=\sum_{d=1}^{D/2}q^\top_{m,d}\,R\!\left(-\frac{\alpha^q_d t_{m+1}+\alpha^k_d t_n}{\beta_d}\right)k_{n,d} \tag{9}$$
即预测时间戳 $t_{m+1}$ 与历史时间戳 $t_n$ 在所有平面上的可学习线性组合,论文称这使 T-RoPE 同时表示局部 recency 与重复的时间结构。
理论分析¶
论文要孤立的性质是:当同一段相对历史被整体搬到另一个日历时间时,注意力分数能否改变——只看时间差的模型能学 recency,但无法区分处于同一年周期不同相位的两个 query。
定义 1(时间平移不变性):若对所有固定的 item 向量 $q,k$ 与所有常数偏移 $c\in\mathbb{R}$,有 $\mathrm{Attn}(q,k;t_{m+1},t_n)=\mathrm{Attn}(q,k;t_{m+1}+c,t_n+c)$,则称该位置编码时间平移不变。
定理 1(共享系数的时间戳 RoPE 是时间平移不变的):设 RoPE 使用任意固定基础频率 $\{\beta_d\}$ 与任意可学习共享系数 $\alpha_d=\alpha^q_d=\alpha^k_d$,角度为 $\phi^q_{m,d}=\alpha_d t_{m+1}/\beta_d$、$\phi^k_{n,d}=\alpha_d t_n/\beta_d$,key 使用标准旋转 $k'_{n,d}=R(\phi^k_{n,d})k_{n,d}$,则 $\mathrm{Attn}(q,k;t_{m+1},t_n)$ 只依赖 $t_{m+1}-t_n$。
证明(附录 A.1):
$$(q'_{m,d})^\top k'_{n,d}=q^\top_{m,d}R(\phi^k_{n,d}-\phi^q_{m,d})\,k_{n,d}=q^\top_{m,d}R\!\left(\frac{\alpha_d(t_n-t_{m+1})}{\beta_d}\right)k_{n,d} \tag{10}$$
只依赖 $t_n-t_{m+1}$,跨平面、跨 head 求和保持不变性。若标准 key 旋转使用独立系数,相位为 $(\alpha^k_d t_n-\alpha^q_d t_{m+1})/\beta_d$,全局平移 $c$ 使相位改变 $(\alpha^k_d-\alpha^q_d)c/\beta_d$——所以这个标准 RoPE 家族只在 $\alpha^q_d=\alpha^k_d$ 的活跃平面上不变,符号相反的非零系数依赖时间戳之和,并非平移不变。
Remark 1(独立的标准 RoPE 系数):同样的相位分析表明,不相等的系数也能打破对称性,所以定理条件不是唯一途径;论文的主张仅是"非平稳 key 是一种 RoPE 兼容的、直接打破不变性的充分机制"。
Remark 2(与 TO-RoPE 的关系):TO-RoPE 的时间戳分量在 query/key 之间共享一个系数,只依赖 $\tau_m-\tau_n$,因此时间平移不变,单靠它无法表示季节偏移。
定理 2(带非平稳 key 的 T-RoPE 具有绝对时间敏感性):T-RoPE 下 (9) 式每个平面的被加项旋转角为 $-(\alpha^q_d t_{m+1}+\alpha^k_d t_n)/\beta_d$。若训练所得模型对某维 $d$ 满足 $\alpha^q_d+\alpha^k_d\neq0$,则 T-RoPE 不是时间平移不变的:对任意满足 $(\alpha^q_d+\alpha^k_d)c/\beta_d\notin2\pi\mathbb{Z}$ 的平移 $c$,存在时间戳与 query/key 使 $\mathrm{Attn}(t_{m+1},t_n)\neq\mathrm{Attn}(t_{m+1}+c,t_n+c)$。
证明(附录 A.2)利用旋转群性质 $R(a)R(b)=R(a+b)$:
$$(q'_{m,d})^\top k'_{n,d}=\left(R(\phi^q_{m,d})q_{m,d}\right)^\top R(-\phi^k_{n,d})k_{n,d}=q^\top_{m,d}R(-\phi^q_{m,d}-\phi^k_{n,d})\,k_{n,d} \tag{11}$$
平移后角度改变 $(\alpha^q_d+\alpha^k_d)c/\beta_d$;两个不同的旋转矩阵定义不同的双线性型,故存在非退化向量使点积改变,构成对"普遍相等"的反例。
Remark 3(可学习的退化与时间尺度选择):条件 $\alpha^q_d+\alpha^k_d\neq0$ 确实必要。若训练收敛到对所有 $d$ 都 $\alpha^q_d=-\alpha^k_d$,T-RoPE 退化为平移不变情形。论文认为这不纯是失败模式:逐维可学习系数让模型选择哪些时间尺度保持平稳、哪些对绝对时间敏感;在其部署模型中未出现退化,学到的系数诱导了可见的层相关时间偏置(Figure 2)。
推论 1(季节性可表示性):设周期 $P>0$(如 365 天),定义有效 query 角频率 $\omega^q_d=\alpha^q_d/\beta_d$。若存在维度 $d$ 与非零整数谐波 $r$ 使 $\omega^q_d=2\pi r/P$,则 T-RoPE 能表示对预测时刻日历相位的周期为 $P$ 的正弦依赖。证明(附录 A.3)把单维注意力展开为
$$f_d=(q_1k_1+q_2k_2)\cos\!\left(\frac{\alpha^q_dt_{m+1}+\alpha^k_dt_n}{\beta_d}\right)+(q_2k_1-q_1k_2)\sin\!\left(\frac{\alpha^q_dt_{m+1}+\alpha^k_dt_n}{\beta_d}\right) \tag{12}$$
固定 $t_n$ 时 key 项只是常数相位偏移,当 $\omega^q_d=2\pi r/P$ 时正余弦项都关于 $t_{m+1}$ 以 $P$ 为周期。
实现细节与计算代价¶
前向与反向算法(附录 B.1)¶
每层维护几何频率库 $\beta\in\mathbb{R}^{D/2}$ 和两个可训练系数向量 $\alpha^q,\alpha^k\in\mathbb{R}^{D/2}$,默认 $\beta_{\min}=10^2$ s、$\beta_{\max}=10^8$ s,系数从 $\mathcal{N}(0,\sigma^2)$、$\sigma=1.0$ 独立初始化。
Algorithm 1(T-RoPE 前向),输入 $Q,K\in\mathbb{R}^{B\times L\times H\times D}$、时间戳 $t\in\mathbb{R}^{B\times L}$、系数 $\alpha^q,\alpha^k\in\mathbb{R}^{D/2}$:
- $\beta\leftarrow\mathrm{geomspace}(10^2,10^8,D/2)$
- $\Phi^q\leftarrow\mathrm{FP32}(\alpha^q)\cdot t/\beta$(广播)
- $\Phi^q\leftarrow\mathrm{RollLeft}(\Phi^q,\text{dim}=1)$(shifted query)
- $\Phi^q[:,L,:]\leftarrow\mathrm{FP32}(\alpha^q)\cdot t[:,L]/\beta$(最后一个 query 保留自己的时间戳)
- $\Phi^k\leftarrow\mathrm{FP32}(\alpha^k)\cdot t/\beta$
- $Q'\leftarrow\mathrm{ApplyRotFromTheta}(Q,\Phi^q,\text{standard})$
- $K'\leftarrow\mathrm{ApplyRotFromTheta}(K,\Phi^k,\text{nonstationary})$
Algorithm 2(ApplyRotFromTheta):$C\leftarrow\cos\Phi$,$S\leftarrow\sin\Phi$,把 rotary 维切成平面 $(x_0,x_1)$;standard 时 $y_0=x_0C-x_1S,\ y_1=x_0S+x_1C$;nonstationary 时 $y_0=x_0C+x_1S,\ y_1=-x_0S+x_1C$;非 rotary 尾部维度原样保留。非平稳旋转与标准旋转算术量相同,只是符号不同。
Algorithm 3(可学习角度的反向):standard 时 $dx_0=g_0C+g_1S$,$dx_1=-g_0S+g_1C$,$d\Phi=g_0(-x_0S-x_1C)+g_1(x_0C-x_1S)$;nonstationary 时 $dx_0=g_0C-g_1S$,$dx_1=g_0S+g_1C$,$d\Phi=g_0(-x_0S+x_1C)+g_1(-x_1S-x_0C)$;最后 $d\Phi$ 跨 head 求和。固定 RoPE 的反向只需 $dX$(对上游梯度施加共轭旋转),T-RoPE 还要返回 $d\Phi$,这是与原始 RoPE 的主要计算差异。系数梯度为
$$\frac{\partial\mathcal{L}}{\partial\alpha^q_d}=\sum_{b,l}\frac{\partial\mathcal{L}}{\partial\Phi^q_{b,l,d}}\frac{t^q_{b,l}}{\beta_d},\qquad \frac{\partial\mathcal{L}}{\partial\alpha^k_d}=\sum_{b,l}\frac{\partial\mathcal{L}}{\partial\Phi^k_{b,l,d}}\frac{t_{b,l}}{\beta_d} \tag{13}$$
其中 $l<L$ 时 $t^q_{b,l}=t_{b,l+1}$,$t^q_{b,L}=t_{b,L}$。因为 $t$ 是以秒计的 Unix 时间戳(量级 $10^9$),梯度通常很大,必须裁剪或重缩放才能稳定训练。同理,由于时间戳量级约 $10^9$,即使外围模型用 BF16,$\Phi^q,\Phi^k$ 也必须用 FP32 计算,三角函数算完后再转回模型精度。
参数与 FLOP 开销(附录 B.2)¶
记 $N=BL$,$H$ 为 head 数,$D$ 为每 head 维度,$P=D/2$ 为旋转平面数,$M$ 为使用 T-RoPE 的层数。每个 T-RoPE 模块有独立的 query/key 系数,增加 $2P=D$ 个参数,全模型增加 $MD$ 个;论文 HSTU 实验中($M=2$,$D=128$)仅 256 个额外参数。
| 操作 | 算术 FLOPs | 超越函数 |
|---|---|---|
| 构造 $\Phi^q,\Phi^k$ | $4NP$ | – |
| 旋转 $Q,K$ | $12NHP$ | $2NP$ 个 sin 与 $2NP$ 个 cos |
| 固定 RoPE 反向 $dQ,dK$ | $12NHP$ | $2NP$ 个 sin 与 $2NP$ 个 cos |
| 额外的可学习角度 $d\Phi$ | $18NHP+2NP(H-1)$ | – |
| 系数梯度 | $\approx4NP$ | – |
相对于带预计算旋转缓存的原始 RoPE,T-RoPE 前向多出构造时间戳角度的 $4NP$ FLOPs,外加在线计算 sin/cos 的开销;训练时额外开销是 $d\Phi$ 的计算与归约及系数梯度链。这些项都对序列长度与 head 维度线性,而自注意力本身仍是二次的。
静态吞吐(附录 B.3,Table 5)¶
| 数据集 | 模型 | 训练 it/s | 验证 it/s |
|---|---|---|---|
| Pixel1M | Baseline HSTU | 17.58 ± 0.01 | 58.59 ± 0.87 |
| Pixel1M | HSTU + TO-RoPE | 16.84 ± 0.05 | 57.33 ± 0.74 |
| Pixel1M | HSTU + T-RoPE | 16.95 ± 0.01 | 57.06 ± 0.44 |
| Shop | Baseline HSTU | 37.19 ± 0.20 | 92.66 ± 0.69 |
| Shop | HSTU + TO-RoPE | 32.17 ± 0.35 | 82.62 ± 0.92 |
| Shop | HSTU + T-RoPE | 32.91 ± 0.05 | 86.05 ± 0.71 |
分析:论文称开销"modest"且与 TO-RoPE 相当。按表中数字计算,Pixel1M 上训练吞吐下降约 3.6%,而 Shop 上训练吞吐下降约 11.5%(37.19→32.91)、验证下降约 7.1%——"线性开销"在理论上成立,但在工业配置下实测并非可忽略。另一个值得注意的点:Shop 上报告了 TO-RoPE 的吞吐,却没有报告 TO-RoPE 在 Shop 上的精度(见后文)。
实验设置¶
公开数据集(附录 C,Table 6)¶
| 数据集 | #User | #Item | #Interaction |
|---|---|---|---|
| ML-20M | 138,493 | 26,744 | 20,000,263 |
| Amazon Books | 776,370 | 495,063 | 9,488,297 |
| Pixel200K | 200,000 | 96,282 | 3,965,656 |
| Pixel1M | 1,001,822 | 100,541 | 19,886,579 |
| Pixel8M | 8,886,078 | 407,082 | 158,488,682 |
Baseline¶
- SASRec(无时间编码);
- TiSASRec(时间间隔注意力偏置);
- HSTU(仅位置 RAB);
- HSTU + Time RAB(时间 + 位置 RAB);
- HSTU + TO-RoPE(Time+Pos RAB + TO-RoPE);
- HSTU + T-RoPE(本文)(Time+Pos RAB + T-RoPE)。
所有方法在同一 PyTorch 训练框架中实现,共享相同的 item-ID 输入、预处理过滤、最大序列长度、leave-one-out 协议、候选评估流程与训练超参数。指标:HR@10、HR@50、NDCG@10、NDCG@50、MRR。
超参数(附录 D,Table 7)¶
| 方法 | d | H | A | RAB | Bkts | RoPE |
|---|---|---|---|---|---|---|
| SASRec | 512 | 4 | — | — | — | — |
| TiSASRec | 512 | 4 | — | — | — | — |
| HSTU | 512 | 4 | 128 | Pos | — | — |
| HSTU+Time RAB | 512 | 4 | 128 | T+P | 128 | — |
| HSTU+TO-RoPE | 512 | 4 | 128 | T+P | 128 | TO-RoPE |
| HSTU+T-RoPE | 512 | 4 | 128 | T+P | 128 | T-RoPE |
所有模型 2 个 Transformer block、128 个 in-batch 负样本;AdamW,学习率 $10^{-3}$,betas (0.9, 0.98),weight decay 0.001,batch size 128,seed 42,所有 dropout 0.2;训练 10–100 epoch,按验证 HR@10 做 ReduceLROnPlateau;损失为 SampledSoftmaxLoss(128 个采样负例,温度 0.05);最大序列长度 ML-20M 为 200,其余为 50;全部在单张 H100 上跑。
注意:baseline 里没有"HSTU + 标准索引 RoPE"——所有 HSTU 变体都不带 RoPE。这意味着论文标题里"替换为文本设计的 RoPE"这一对照,在实验中其实并不存在。
工业数据集 Shop¶
Shopify 内部电商数据集,约 1.5 亿用户、480 万 item、超过 60 亿交互,跨多年。模型:128 维 embedding、12 个 HSTU block、8 个注意力头、每头 32 维注意力、最大序列长度 512。采用一天的时间留出(在留出日之前的交互上训练,留出日所有有意义的交互都算正例),因用户可能有多个相关交互,报告 Recall@K 而非 HR@K。
主要实验结果:公开 benchmark¶
Table 2:序列推荐结果(%)。括号内为 T-RoPE 相对第二名的提升。
| 数据集 | 指标 | SASRec | TiSASRec | HSTU | HSTU+Time RAB | HSTU+TO-RoPE | HSTU+T-RoPE |
|---|---|---|---|---|---|---|---|
| ML-20M | HR@10 | 31.36 | 31.97 | 30.87 | 32.05 | 31.19 | 32.37 (+1.0%) |
| HR@50 | 56.87 | 57.50 | 56.19 | 58.01 | 56.69 | 58.55 (+0.9%) | |
| NDCG@10 | 18.04 | 18.38 | 17.84 | 18.47 | 17.93 | 18.62 (+0.8%) | |
| NDCG@50 | 23.68 | 24.04 | 23.44 | 24.20 | 23.57 | 24.42 (+0.9%) | |
| MRR | 15.42 | 15.68 | 15.31 | 15.79 | 15.32 | 15.91 (+0.8%) | |
| Amazon Books | HR@10 | 2.97 | 3.19 | 5.88 | 6.89 | 6.69 | 7.65 (+11.0%) |
| HR@50 | 7.26 | 7.66 | 12.40 | 14.27 | 13.30 | 15.45 (+8.3%) | |
| NDCG@10 | 1.57 | 1.71 | 3.33 | 3.93 | 3.96 | 4.40 (+11.1%) | |
| NDCG@50 | 2.50 | 2.68 | 4.75 | 5.54 | 5.40 | 6.11 (+10.3%) | |
| MRR | 1.41 | 1.53 | 2.94 | 3.46 | 3.51 | 3.87 (+10.3%) | |
| Pixel200K | HR@10 | 4.72 | 4.65 | 4.22 | 7.21 | 4.16 | 7.41 (+2.8%) |
| HR@50 | 10.85 | 10.86 | 10.26 | 16.82 | 10.09 | 17.37 (+3.3%) | |
| NDCG@10 | 2.65 | 2.61 | 2.33 | 4.08 | 2.30 | 4.15 (+1.7%) | |
| NDCG@50 | 3.98 | 3.93 | 3.63 | 6.14 | 3.58 | 6.30 (+2.6%) | |
| MRR | 2.39 | 2.35 | 2.12 | 3.70 | 2.11 | 3.76 (+1.6%) | |
| Pixel1M | HR@10 | 7.12 | 7.16 | 6.89 | 12.46 | 6.81 | 13.35 (+7.1%) |
| HR@50 | 15.62 | 15.77 | 15.31 | 26.16 | 15.14 | 27.44 (+4.9%) | |
| NDCG@10 | 4.04 | 4.05 | 3.88 | 7.22 | 3.83 | 7.81 (+8.2%) | |
| NDCG@50 | 5.88 | 5.92 | 5.70 | 10.19 | 5.64 | 10.88 (+6.8%) | |
| MRR | 3.61 | 3.62 | 3.46 | 6.42 | 3.43 | 6.95 (+8.3%) | |
| Pixel8M | HR@10 | 4.89 | 4.96 | 5.01 | 9.14 | 4.99 | 11.47 (+25.5%) |
| HR@50 | 10.69 | 10.82 | 10.93 | 18.87 | 10.86 | 23.02 (+22.0%) | |
| NDCG@10 | 2.75 | 2.79 | 2.82 | 5.36 | 2.82 | 6.85 (+27.8%) | |
| NDCG@50 | 4.00 | 4.06 | 4.11 | 7.47 | 4.09 | 9.35 (+25.2%) | |
| MRR | 2.44 | 2.48 | 2.51 | 4.78 | 2.50 | 6.11 (+27.8%) |
论文的解读:HSTU + T-RoPE 在所有数据集的所有 5 个指标上最优,且提升随数据中时间结构的多少而变化——在历史较规律的稠密 ML-20M 上提升温和但一致(约 +1%);在稀疏/商业数据上更明显:Amazon Books 上相对 HSTU + Time RAB 各指标 +8–12%,PixelRec 各切分上相对 TO-RoPE HR@10 +78–130%、HR@50 +72–112%。论文把最大差距归因于"绝对日历相位在稀疏与商业数据上携带最多信号"。
需要校正的几点:
- 摘要的措辞有误。摘要写"improving over the strongest baseline by 78–130% in HR@10 on the sparse PixelRec data",但 PixelRec 上最强 baseline 是 HSTU + Time RAB,不是 TO-RoPE。T-RoPE 相对最强 baseline 的 HR@10 提升在 Pixel200K / Pixel1M / Pixel8M 上分别只有 +2.8% / +7.1% / +25.5%;78–130% 是相对 TO-RoPE 的数字,正文表述是对的,摘要把它挂在了"strongest baseline"上。
- TO-RoPE 这个 baseline 明显异常。HSTU + TO-RoPE 与 HSTU + Time RAB 用同样的 T+P RAB,只多加了一个 TO-RoPE,但在三个 PixelRec 切分上 HR@10 比 HSTU + Time RAB 低 42–45%,几乎回落到只有位置 RAB 的纯 HSTU 水平(4.16 vs 4.22、6.81 vs 6.89、4.99 vs 5.01)。"多加一个时间组件,反而把 Time RAB 的全部收益抹掉",更像是实现或训练问题(例如时间戳量级/精度处理),而不是 TO-RoPE 方法本身的上限。论文没有讨论这一反常现象,因此"大幅超越 TO-RoPE"不能当作对 TO-RoPE 的有效比较。
- 真正有信息量的对照是 T-RoPE vs HSTU + Time RAB(两者都有时间信号、都有 T+P RAB,差别只在是否加 T-RoPE,参数差 256 个)。这组比较表明:在已有时间信号的前提下,把时间做进旋转几何确实有增益,ML-20M 约 +1%、Pixel200K 约 +2–3%、Amazon Books 约 +10%、Pixel8M 约 +25%。但所有结果都是单 seed(42)、无方差,ML-20M 与 Pixel200K 上 1–3% 的差距是否超出 seed 噪声无从判断。
- 公开实验只用 2 层、序列长度 50(ML-20M 为 200),属于小模型设定。
消融与分析:Shop 工业数据集¶
Table 3:Shop 数据集消融(%)。第 1 行为完整 T-RoPE;第 2–5 行累积移除组件直到 HSTU + Time RAB 骨干;第 6–8 行从完整模型中单独移除一个组件。括号为相对完整模型的变化。
| # | 配置 | Recall@50 | NDCG@50 | Recall@200 | NDCG@200 | MRR |
|---|---|---|---|---|---|---|
| 1 | T-RoPE | 31.41 | 22.94 | 41.77 | 24.82 | 23.14 |
| 2 | − Non-Stationary (§3.5) | 30.97 (−1.40%) | 22.02 (−4.01%) | 40.49 (−3.06%) | 23.29 (−6.16%) | 21.88 (−5.45%) |
| 3 | − shifted (§3.4) | 30.90 (−1.62%) | 20.59 (−10.24%) | 40.92 (−2.03%) | 22.55 (−9.15%) | 20.90 (−9.68%) |
| 4 | − multiscale freq. bank (§3.3) | 25.36 (−19.26%) | 13.23 (−42.33%) | 36.98 (−11.47%) | 15.42 (−37.87%) | 11.96 (−48.31%) |
| 5 | − abs. time embedding (§3.1+§3.2) = HSTU + Time RAB | 25.68 (−18.24%) | 13.81 (−39.80%) | 37.00 (−11.42%) | 15.96 (−35.70%) | 12.70 (−45.12%) |
| 6 | − Shifted Query RoPE | 30.87 (−1.72%) | 21.54 (−6.10%) | 40.50 (−3.04%) | 23.42 (−5.64%) | 22.46 (−2.94%) |
| 7 | − Key RoPE | 31.19 (−0.70%) | 20.58 (−10.29%) | 41.90 (+0.31%) | 22.63 (−8.82%) | 20.90 (−9.68%) |
| 8 | − Time RAB | 29.08 (−7.42%) | 20.76 (−9.50%) | 39.69 (−4.98%) | 22.95 (−7.53%) | 16.89 (−27.01%) |
完整 T-RoPE 相对 HSTU + Time RAB 骨干(行 5):Recall@50 +22.3%、NDCG@50 +66.1%、Recall@200 +12.9%、NDCG@200 +55.5%、MRR +82.2%——即摘要中"13–82%"的来源。
论文的逐项结论:
- 多尺度频率库与 shifted query 提供核心收益。多尺度库影响最大:比较行 3 与行 4,移除它使 NDCG@50 下降 36%(反过来说,加上它 NDCG@50 +56%,即摘要里的"+56%")。论文解释为多尺度旋转把原始时间戳变成可用的频率结构;没有它时间戳"只是噪声",行 4 的单频时间嵌入甚至比行 5 骨干低约 4%。shifted query 次之:比较行 2 与行 3,NDCG@50 +7%。
- 非平稳 key 带来绝对时间敏感性,并与 key/query 旋转互补。加入非平稳 key(行 1 vs 行 2)五个指标全部提升,Recall@200 +3.2%、NDCG@50 +4.2%。由于 key 旋转与 query 旋转各自都能携带绝对时间敏感性(Remark 1),论文又逐一移除:移除 shifted-query 旋转(行 6)Recall@200 −3.0%,移除 key 旋转(行 7)主要伤排序精度(NDCG@50 −10.3%,而 Recall@200 反而 +0.31%)。论文结论:两者互补,非平稳 key 结合两侧走得最远。
- Time RAB 与 T-RoPE 互补。从完整模型移除 Time RAB(行 8)全部指标下降,MRR 降幅最大(−27.0%),说明 RAB 仍捕获 T-RoPE 未覆盖的相对 recency 信号;但即便没有 RAB,T-RoPE 仍比骨干 NDCG@50 高约 50%,两种机制独立贡献、组合最好。
我的分析——收益到底从哪来("引入新信号 ≠ 收益来源"):
- Shop 上的骨干已经有时间信号(Time RAB),所以 T-RoPE 的增益不是"有没有时间戳"带来的,而是"时间如何进入注意力几何"带来的——这一点比很多"加个时间特征就涨"的论文干净。
- 但把增益按行拆开:行 3(可学习系数 + 多尺度频率库的时间戳 RoPE,无 shift、无非平稳 key)相对骨干已有 Recall@50 +20.3%、NDCG@50 +49.1%、MRR +64.6%;本文真正独有的两个部件(shifted query + 非平稳 key,行 3→行 1)只再贡献 Recall@50 +1.7%、NDCG@50 +11.4%、Recall@200 +2.1%、MRR +10.7%。也就是说,大头来自"几何间隔频率库上的时间戳 RoPE"这一已有思路(TO-RoPE 的时间分量、ReST 的 RoTE、ClockRoPE 都属此类),而 shifted query 本身是论文自述的借鉴 HSTU RAB 的做法。
- Shop 上没有任何外部时间 RoPE baseline。既没有 TO-RoPE(尽管 Table 5 里在 Shop 上测过 TO-RoPE 的吞吐),也没有"时间戳上的标准 RoPE"或索引 RoPE。行 3 是最接近"标准时间戳 RoPE"的对照,但它是论文自己实现的内部变体,不等于先前方法。因此"T-RoPE 优于已有时间 RoPE"在工业尺度上没有被直接检验。
- "多尺度 +56%"是对一个没人会用的设计的消融。行 4 是"单一基础频率"的时间戳 RoPE——任何 RoPE 变体默认都是多频率的,把它拿掉当然崩。这组数字说明的是"单频不行",不能作为 T-RoPE 设计新颖性的证据。
- 非平稳 key 的消融需要谨慎解读。在独立系数的参数化下,非平稳 key $R(-\alpha^k_d t_n/\beta_d)$ 与标准 key $R(\alpha^k_d t_n/\beta_d)$ 只差 $\alpha^k_d$ 的符号;由于 $\alpha^k_d$ 可学习且从对称的 $\mathcal{N}(0,1)$ 初始化,两者张成的函数族和初始化分布完全相同——论文自己的 Remark 1 与 A.1 末段也承认独立系数的标准 RoPE 同样不是平移不变的。若行 2 保留独立系数,那么行 1 与行 2 在数学上是同一个模型的不同参数化,−1.4%~−6% 的差异只能来自优化路径/随机性;若行 2 退回共享系数,则它混淆了"共享 vs 独立系数"与"转置旋转"两个因素。论文没有说明行 2 用哪一种,也没有给出方差,"非平稳 key 贡献 +4%"这一归因不可靠。
- 消融降幅 vs 相对最强 baseline 的差距:Shop 上唯一的 baseline 就是骨干,所以"最强 baseline"的差距就是 +22%/+66%,远大于任一单部件消融降幅——这一层面上结论成立;但细粒度部件(非平稳 key 的 −1.4% Recall@50、行 7 的 Recall@200 反而上升)落在单 seed 下无法判定的范围内。
线上 A/B 实验¶
论文在 Shop app 推荐中部署 T-RoPE,在离线架构基础上扩大规模但保持 T-RoPE 设计不变。对照组是"不带 T-RoPE 的相同模型"(即生产的 HSTU 类骨干)。
Table 4:Shop app 线上 A/B(相对对照组)
| 指标 | 定义 | 相对提升 | P 值 |
|---|---|---|---|
| CVR | 转化率 | +0.33% | 0.037 |
| Shop orders | Shop app 下单数 | +0.63% | 0.094 |
论文解读:CVR 信号最强(p = 0.037),说明时间感知召回把更多会话转化为交互;下单数 +0.63%(p = 0.094)作为下游价值的方向性证据。
分析:对照组设定是干净的(同一模型、只差 T-RoPE),且给出了 p 值——这比很多工业论文强。但:(1)只有 CVR 在 0.05 水平显著,下单数 p = 0.094 不显著;(2)没有流量比例、实验时长、线上模型规模("scaling up the offline architecture"没有给具体配置)、线上延迟/成本数据;(3)Figure 2 中"deployed model"至少有 18 层(出现 Layer 17),与 Shop 离线的 12 个 HSTU block、附录 B.2 的"$M=2$ 层、$D=128$"都对不上,文中对不同实验使用的规模描述前后不一致。这是真实的工业证据(Shopify 作者 + 自家 Shop app 线上 A/B),但证据量比较薄。
附加可视化¶
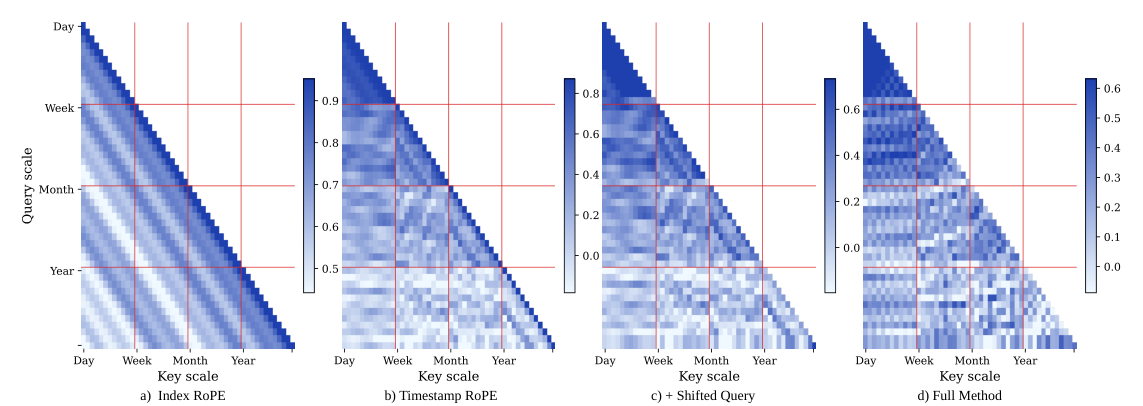
随着部件逐个加入,日/周/月/年尺度的事件块越来越按真实时间间隔分组,完整 T-RoPE 能干净地按经过时间分离各块。这是合成数据上的定性展示,不构成定量证据。
核心贡献总结¶
- 把"时间"做进 RoPE 旋转几何的一个完整配方:时间戳角度 + 几何频率库 + 逐维可学习 query/key 系数 + shifted query + 转置 key 旋转,全部保持 RoPE 的 elementwise 旋转接口,只增加 $MD$ 个参数(论文设定下 256 个),可与 FlashAttention 类 kernel 兼容。
- 形式化了"时间平移不变性"这一限制:共享系数的时间戳 RoPE(含 TO-RoPE 的时间分量)只看时间差,无法表示依赖绝对日历相位的偏好;非平稳 key 让相位依赖 $t_{m+1}+t_n$,可在 $\alpha^q_d+\alpha^k_d\neq0$ 时表示绝对时间敏感性。
- 公开 + 工业 + 线上三层验证:五个公开数据集全指标第一(相对 HSTU + Time RAB +1%~+28%);60 亿交互 Shop 数据相对骨干 +13%~+82%;Shop app A/B CVR +0.33%(p = 0.037)。
- 给出可学习角度的完整反向实现与 FP32 角度计算、梯度裁剪等工程要点。
与已归档相关工作的对比¶
ClockRoPE ClockRoPE: Random Fourier Rotations for Temporal Routine Modeling(YouTube / Google DeepMind,2026-07-29)¶
关系:独立并发(本文未引用 ClockRoPE,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇都认为 RoPE 在推荐里的"频率调度"是从语言模型照搬来的错误先验——ClockRoPE 说 log-linear 频率把注意力调制锁死成单调长程衰减、表达不了周期性;T-RoPE 说索引旋转抹掉了真实间隔、多尺度周期和日历相位。root cause 一致:RoPE 的旋转坐标与频率谱应当由推荐的时间结构决定,而不是由文本的 token 偏移决定。
- 相近的技术骨架:都用 Unix 时间戳替换位置索引作为旋转坐标,都只改"旋转角从哪来"、前向实现与标准 RoPE 逐行一致、可复用 RoPE kernel,都声称零或近零新增参数,也都在工业生成式召回/检索上线。
- 本文的差异与推进:路线在"频率从哪来"上截然相反。ClockRoPE 从先验出发——指定周期核(日/周周期高斯),用 Bochner/Herglotz 从其傅里叶变换采样固定频率,并在附录 B 用负结果论证"可学习频率反而更差(0 初始化 −1.44%)";T-RoPE 用几何频率库 + 逐维可学习系数(等价于学习有效频率 $\alpha_d/\beta_d$),让数据决定强调哪些周期。另一个差异在不变性:ClockRoPE 的调制核 $f(p_m-p_n)$ 仍是平移不变的相对编码(它通过"时间差接近 $kT$"来匹配同一时刻),而 T-RoPE 明确追求打破平移不变性以获得绝对日历相位。值得指出的是,由于推理时 query 取 $t_{\text{now}}$、历史固定,相对周期编码本身已经能让"今天的 query 注意到去年同期的 item";T-RoPE 的非平稳 key 额外带来的只是"整段历史 + query 一起平移时注意力也变",这部分增益在本文消融里只有 1–6%,且存在上文所述的参数化等价问题。
- 可比的方法 / 实验差异:ClockRoPE 零公开数据集、只报相对百分比,但与"RoPE-only"对照做了正交组合实验(+2.39% MAP@1);T-RoPE 有五个公开 benchmark 与绝对数值,但没有任何索引 RoPE 对照,工业消融也只对自身部件。两者都缺少彼此的对照:一个自然的实验是在 Shop 上把 T-RoPE 的可学习频率库换成 ClockRoPE 式的固定周期采样,检验"可学习 vs 先验"之争。线上量级:ClockRoPE valued engagement +0.08% 且 TPU 成本 −0.63%;T-RoPE CVR +0.33%(p = 0.037),但离线训练吞吐 −11.5%。
ReST ReST: From Language to Behavior — Scaling Sequence Transformers for Industrial Recommendation Ranking(ByteDance,2026-09-01)¶
关系:独立并发(本文未引用 ReST;两者的 RoTE / T-RoPE 部件同构)· 已加载对方精读
- 共同关注的问题:ReST 把"行为发生在不规则物理时间上、相同序号距离对应完全不同的 recency、纯序号编码无法刻画多尺度时间邻近性"列为序列 scaling 的两大 root cause 之一,与 T-RoPE 的"真实时间间隔被抹掉 + 多尺度周期缺失"几乎同一表述。
- 相近的技术骨架:ReST 的 RoTE 同样把物理时间戳放进 RoPE 旋转,并用多粒度覆盖从秒到年的尺度(按 head 分配 $\tau_h\in$ {秒, 分, 时, 天, 周, 季, 年},对应 T-RoPE 的几何频率库),也保留一个 head 给序号 RoPE(对应 T-RoPE 保留 Time RAB 的"互补"结论)。
- 本文的差异与推进:ReST 先减去序列起始时间 $\tilde t_i=t_i-t_1$ 再分桶——主动放弃了绝对时间,是严格平移不变的;T-RoPE 反其道而行,直接用未归一化的绝对 Unix 时间戳并用非平稳 key 保留日历相位。ReST 的尺度是固定的、按 head 划分;T-RoPE 是按旋转平面几何分布 + 可学习系数。T-RoPE 还加入 shifted query(ReST 无)。
- 可比的方法 / 实验差异:ReST 的 RoTE 只是一个大系统中的子部件,其消融(AUC:+RoPE +0.04%,+单粒度 RoTE +0.08%,+多粒度 RoTE +0.12%)显示"多粒度"是时间编码里的主要增益——与 T-RoPE 行 3→行 4"多尺度频率库贡献最大"的结论一致。两篇在不同公司、不同任务(ByteDance 判别式排序 vs Shopify 生成式召回)上独立得到"多尺度时间戳旋转 > 单尺度 > 仅序号"的相同排序,互相印证了这一部分;而 T-RoPE 独有的"绝对相位"部件,在两篇的证据里都不是主要收益来源。
讨论与局限性¶
值得借鉴的设计
- "时间进入注意力几何"而不是"时间作为特征/偏置"。在骨干已有 Time RAB 的前提下仍有显著增益(Shop NDCG@50 +66%),且移除 RAB 后 T-RoPE 单独也有 +50%,说明"旋转式时间编码"与"加性时间偏置"互补。这对任何 HSTU 类骨干都是低成本可迁移的改动。
- shifted query 的训练/推理一致性处理:训练时 query 用 $t_{m+1}$、推理时用 $t_{\text{now}}$,最后一个训练位置保留自身时间戳,这是时间戳 RoPE 落地必须想清楚的细节,Algorithm 1 给了可直接照抄的实现。
- 工程细节诚实:FP32 计算角度、梯度需要裁剪、可学习角度需要自定义反向,这些都是真正复现时会踩的坑。
局限与争议
- 理论贡献较浅。定理 1、定理 2 都是 $R(a)R(b)=R(a+b)$ 的一行推论;定理 1 针对的是"共享系数"情形,而论文自己的 §3.2 默认就是独立系数,Remark 1 也承认独立系数的标准旋转同样打破不变性。在独立、对称初始化的系数下,"非平稳 key(转置旋转)"只是 $\alpha^k_d$ 的符号重参数化,与标准旋转张成同一函数族。论文把它作为五个核心部件之一并列在 Table 1 "Non-stationary"列里,是把一个参数化选择包装成了机制。
- baseline 的完整性与可信度:(a)没有任何"HSTU + 索引 RoPE"对照,与论文开篇"推荐照搬了文本 RoPE"的叙事不匹配;(b)HSTU + TO-RoPE 在 PixelRec 上比 HSTU + Time RAB 低 42–45%,几乎等于没有时间信号的 HSTU,高度可疑,而摘要里的"78–130%"正是建立在这个异常 baseline 上,并被错误地表述为"相对最强 baseline";(c)工业数据上没有任何外部时间 RoPE 对照。
- 统计严谨度不足:公开实验与 Shop 消融都是单 seed、无方差;ML-20M、Pixel200K 上 +1%~+3% 的差距以及非平稳 key 的 −1.4% Recall@50,都无法判断是否超出噪声。
- 可学习系数的实际行为与叙事不完全吻合:系数从 $\mathcal{N}(0,1)$ 初始化,训练后却只有约 0.005–0.023(Figure 3a),有效周期比图中标注的频带长 50–200 倍,"<1h""1h~1d"频带实际工作在更长的周期上。此外以秒计的 Unix 时间戳在 FP32 下分辨率约为 128 秒,初始化时 $\alpha\approx1$、$\beta=100$ s 的平面相位量级约 $1.7\times10^7$ rad,FP32 下每一步量化约 2 rad,几乎是随机相位——系数被推向很小值可能部分是优化在"逃离数值噪声"。论文对这些都未讨论。
- 规模描述前后不一致:公开实验 2 层(d=512、H=4、A=128),Shop 离线 12 个 HSTU block(每头 32 维),附录 B.2 称"HSTU 实验 $M=2$、$D=128$",Figure 2 的"部署模型"至少 18 层;线上"扩大规模"的具体配置未给出。scaling 行为(模型变大后 T-RoPE 的相对增益是否保持)完全没有研究。
- 实测开销不可忽略:Shop 上训练吞吐 −11.5%、验证 −7.1%,而文中称"modest"。线上延迟与成本未报告。
- 方法论可扩展性:作为逐元素旋转的位置编码,T-RoPE 不引入两阶段解耦或固化码本,参数量 scaling 时不构成架构瓶颈;但其贡献是组件级的,不改变"如何表征历史"或"如何建模序列"的主干路线。
工业落地价值
Shopify 在自家 Shop app 推荐(生成式召回)上做了干净的 A/B:对照组为不带 T-RoPE 的同一模型,CVR +0.33%(p = 0.037),下单数 +0.63%(p = 0.094,不显著)。改动只涉及 query/key 旋转、参数增量可忽略,工程上容易接入已有 HSTU 类系统;代价是可学习角度需要自定义反向、角度需 FP32 计算且梯度要裁剪,实测训练吞吐下降约 7–12%。工业署名与线上 A/B 是真实的,但证据主要集中在"时间戳多尺度旋转"这一已有思路上,本文独有部件(非平稳 key、shifted query)的增益在工业尺度上只有 1–11%,且未与 TO-RoPE、ClockRoPE、RoTE 等同类方法在同一工业数据上对照。