ClockRoPE:用随机傅里叶旋转把"作息周期"写进注意力¶
研究动机与背景¶
Transformer 与 scaling law 在语言建模、图像生成上的成功,正在把生成式推荐(generative recommendation)推向 transformer-style 的序列建模架构。但推荐与语言建模有一个根本差异:时间是推荐场景中原生且关键的信号,而不是语言里那种仅由 token 顺序隐含的量。已有工作尝试过多种方式把时序信号注入 transformer:把时间差作为输入特征、在注意力里加加性时间偏置(HSTU 一类)、以及在注意力内部使用相对时间嵌入。
另一条线是 RoPE(Rotary Position Embedding)。RoPE 凭借平移不变性与长程衰减(long-term attention decay)两个特性在语言模型中被广泛采用,并已被推广到多维连续坐标场景。自然地,近期若干工作尝试把 RoPE 扩展到序列推荐中以编码时间:一类工作沿用与标准 RoPE 相同的 log-linear 频率间隔,只是把"位置"替换为相对某个锚点时间戳的 timestamp delta;ROTE 则先对时间戳间隔取 log 再据此构造旋转角以捕捉时间邻近性。这两类做法的共同点是:都在强调"用时间戳配合顺序来编码 recency(近因性)"。
论文指出,这恰恰漏掉了用户行为里一个极其重要的特征——周期性(periodicity)。发生在一天中的同一时刻或一周中的同一天的交互往往具有很高的相关性(早晨通勤听播客、午休刷游戏视频、周末看长视频)。然而标准 RoPE 的 log-linear 频率调度 $\theta_i = 10000^{-2i/d}$ 是专门为产生长程衰减而设计的,它只能表达"距离越远相关性越低"这一种单调模式,无法表达更复杂的距离-相关性结构,周期性就是其中之一。
这就是本文锁定的 root cause:RoPE 把"频率如何分布"这件事硬编码成了一个特例(log-linear ⇒ 单调衰减),因而丧失了对任意距离-相关先验的表达能力。论文的应对不是再设计一个 trick,而是回到理论问一个更本质的问题:一般的 query/key 旋转到底能表达多强的注意力调制?
论文的三项贡献:
- Random Fourier Rotations (RFR):一个通用采样方法,证明任意归一化的连续正定注意力调制函数都能被 query/key 旋转无偏逼近——只要从该函数自身的傅里叶变换中采样旋转频率。
- ClockRoPE:把 RFR 应用到周期性调制函数上,得到面向用户作息(routine)建模的时间周期编码。
- 生产级评估:在某大型视频平台的生产级生成式召回系统中验证并已上线部署。
核心方法¶
3.1 动机的形式化:RoPE 的长程衰减是一种"过度简化"¶
RoPE 的每个特征对做一个 2d 旋转,本身是周期性的。但当把这些 2d 旋转与标准的 log-linear 频率调度
$$\theta_i = 10000^{-2i/d}, \quad i \in [0, 2, \ldots, d/2-1] \tag{1}$$
组合起来时,RoPE 就强制注意力分数上界随相对距离衰减,呈现"单调下降 + 随机振荡"的形态,如 Figure 1 所示。这一性质在原论文中被称为 long-term decay。
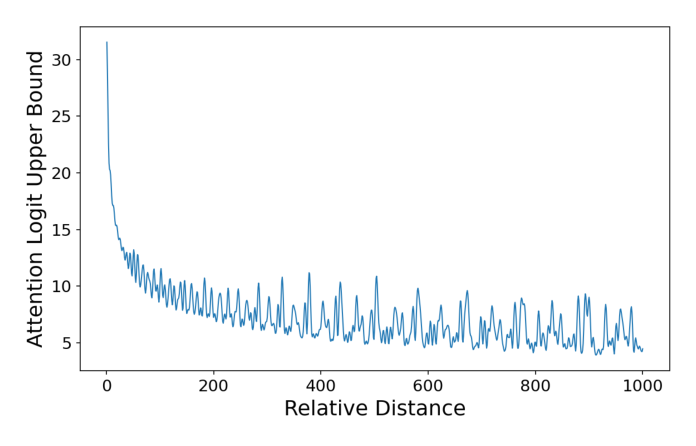
论文的判断是:长程衰减契合语言建模的本质,但在具有天然周期性的领域(如生成式推荐)中,它过度简化了"距离如何影响相关性"。§4.4.1 的 Figure 2 后来从实证上确认了这一点——标准 RoPE 把注意力集中到了最近的交互上,反而掩盖了日周期模式。
理想的频率调度应当做到:让"时刻相近(同一 hour-of-day / day-of-week)"的交互对获得更高的注意力分数上界,而不是让"时间上更近"的交互对获得更高上界。
3.2 通过随机傅里叶旋转调制注意力 logits¶
设想我们希望把标准注意力 logits 调制成:位于位置 $p_m$ 的 query $q_m$ 与位于位置 $p_n$ 的 key $k_n$ 的相似度,被一个满足 $f(0)=1$ 的正定核 $f: \mathbb{R}\to\mathbb{R}$ 加权:
$$q_m^\top k_n \rightsquigarrow q_m^\top k_n f(p_m - p_n) \tag{2}$$
其中 $p_m, p_n \in \mathbb{R}$ 是连续位置(这里就是时间戳)。$f$ 可以是高斯 $f(x) = e^{-x^2}$、拉普拉斯 $f(x) = e^{-|x|}$ 或三角函数 $f(x) = \cos(x)$。
论文的核心断言是:任意连续正定调制函数,都可以通过从其自身的傅里叶变换分布中采样 RoPE 频率来无偏逼近。
命题 3.1(随机傅里叶旋转估计量)¶
设 $\xi_0, \xi_1, \ldots, \xi_{d/2-1} \overset{\text{i.i.d.}}{\sim} \tau(\xi)$,其中 $\tau$ 是满足 $f(0)=1$ 的连续正定核 $f$ 的傅里叶变换。记 $q_m^{(j)} = [q_{m,2j}, q_{m,2j+1}]^\top \in \mathbb{R}^2$、$k_n^{(j)} = [k_{n,2j}, k_{n,2j+1}]^\top \in \mathbb{R}^2$ 为 query $q_m \in \mathbb{R}^d$ 与 key $k_n \in \mathbb{R}^d$ 的第 $j$ 个连续特征对,$j = 0, \ldots, d/2-1$。则随机傅里叶旋转估计量
$$\hat{g}(q_m, k_n, p_m, p_n) = \sum_{j=0}^{d/2-1}\left(R_m^{(j)} q_m^{(j)}\right)^\top \left(R_n^{(j)} k_n^{(j)}\right) \tag{3}$$
其中
$$R_m^{(j)} = \begin{bmatrix} \cos(2\pi\xi_j p_m) & -\sin(2\pi\xi_j p_m) \\ \sin(2\pi\xi_j p_m) & \cos(2\pi\xi_j p_m) \end{bmatrix} \tag{4}$$
$$R_n^{(j)} = \begin{bmatrix} \cos(2\pi\xi_j p_n) & -\sin(2\pi\xi_j p_n) \\ \sin(2\pi\xi_j p_n) & \cos(2\pi\xi_j p_n) \end{bmatrix} \tag{5}$$
是 $q_m^\top k_n f(p_m - p_n)$ 的无偏估计:
$$\mathbb{E}_{\xi_0, \ldots, \xi_{d/2-1} \sim \tau(\xi)}\left[\sum_{j=0}^{d/2-1}\left(R_m^{(j)}q_m^{(j)}\right)^\top\left(R_n^{(j)}k_n^{(j)}\right)\right] = q_m^\top k_n f(p_m - p_n) \tag{6}$$
(论文脚注说明:$f(0)=1$ 是为了满足 Bochner 定理中的归一化条件。)
证明思路。由 Bochner 定理,$f$ 连续正定且 $f(0)=1$,故其傅里叶变换
$$\tau(\xi) = \int_{\mathbb{R}} f(x) e^{-i2\pi\xi x} dx$$
是一个合法的概率密度函数:$\tau(\xi) \geq 0$ 且 $\int_{\mathbb{R}}\tau(\xi)d\xi = f(0) = 1$。这允许把 $f$ 写成关于 $\xi \sim \tau$ 的期望(与 RFF 的推导同构):
$$f(p_m - p_n) = \int_{\mathbb{R}} e^{i2\pi\xi(p_m - p_n)}\tau(\xi)d\xi = \mathbb{E}_{\xi\sim\tau(\xi)}\left[e^{i2\pi\xi(p_m-p_n)}\right] \tag{7}$$
把 query/key 特征分成 $d/2$ 对:
$$q_m^\top k_n f(p_m-p_n) = \sum_{j=0}^{d/2-1}\left(q_m^{(j)}\right)^\top k_n^{(j)} f(p_m-p_n) \tag{8}$$
用 2d 向量的复数表示 $q_m^{(j)} \mapsto q_{m,2j} + i q_{m,2j+1}$、$k_n^{(j)} \mapsto k_{n,2j} + i k_{n,2j+1}$,以及性质
$$q_m^{(j)\top} k_n^{(j)} = \mathrm{Re}\left[q_m^{(j)} k_n^{(j)*}\right] \tag{9}$$
($k_n^{(j)*}$ 为复共轭),得到
$$q_m^\top k_n f(p_m-p_n) = \mathrm{Re}\left[\sum_{j=0}^{d/2-1} q_m^{(j)} k_n^{(j)*}\, \mathbb{E}_{\xi\sim\tau(\xi)}\left[e^{i2\pi\xi(p_m-p_n)}\right]\right] \tag{10}$$
另一方面,估计量的期望为
$$\mathbb{E}\left[\sum_j \left(R_m^{(j)}q_m^{(j)}\right)^\top\left(R_n^{(j)}k_n^{(j)}\right)\right] = \mathbb{E}\,\mathrm{Re}\left[\sum_j q_m^{(j)}k_n^{(j)*} e^{i2\pi\xi_j p_m} e^{-i2\pi\xi_j p_n}\right] = q_m^\top k_n f(p_m-p_n) \tag{11}$$
两者相等,证毕。这里的关键洞察是:RoPE 的 2d 旋转在复数视角下就是乘以 $e^{i\theta}$,而 query 与 key 的旋转在内积中自动相消为相对相位 $e^{i2\pi\xi(p_m-p_n)}$——这正好是 Bochner 表示里的被积函数。于是"随机采样频率"这一 RFF 的经典手法,被从特征映射(feature map)迁移到了旋转算子(rotation operator)上,同时完整保留了 RoPE 的乘性结构和高效实现。
命题 3.2(RFR 估计量的收敛性)¶
在命题 3.1 的设定下,对任意 $\epsilon > 0$:
$$P\left(\left|\frac{1}{d/2}\sum_{j=0}^{d/2-1}\left(R_m^{(j)}q_m^{(j)}\right)^\top\left(R_n^{(j)}k_n^{(j)}\right) - \frac{1}{d/2}q_m^\top k_n f(p_m-p_n)\right| \geq \epsilon\right) \leq 2\exp\left(-\frac{\epsilon^2 d^2}{8\sum_{j=0}^{d/2-1}\left(\|q_m^{(j)}\|\,\|k_n^{(j)}\|\right)^2}\right) \tag{12}$$
特别地,当 $\sum_{j}\left(q_m^{(j)\top}k_n^{(j)}\right)^2$ 随 $d$ 线性增长时(例如训练初期),命题 3.2 保证估计量以关于 $d$ 指数级快的速度收敛,也就是说从训练一开始,注意力调制先验 $f$ 就被有效施加了。
附录 A.1 用 McDiarmid 不等式给出证明:定义 $h(\xi_0,\ldots,\xi_{d/2-1}) = \sum_j \mathrm{Re}\left[q_m^{(j)}k_n^{(j)*}e^{i2\pi\xi_j(p_m-p_n)}\right]$,单个 $\xi_j$ 改变时 $h$ 的变化被界为
$$\left|h(\ldots,\xi_j,\ldots) - h(\ldots,\xi_j',\ldots)\right| \leq \left|q_m^{(j)}k_n^{(j)*}\right| \cdot \left|e^{i2\pi\xi_j(p_m-p_n)} - e^{i2\pi\xi_j'(p_m-p_n)}\right| \leq 2\left\|q_m^{(j)}\right\|\left\|k_n^{(j)}\right\| \tag{13}$$
最后一步用到"单位圆上任意两点距离最大为 2"。记 $c_j = 2\|q_m^{(j)}\|\|k_n^{(j)}\|$ 应用 McDiarmid 即得。附录 A.2 进一步说明:当 query/key 投影矩阵按方差与 $d$ 无关的 i.i.d. 方式初始化时,$X_j = \|q_m^{(j)}\|\|k_n^{(j)}\|$ 在初始化时跨 $j$ 独立同分布且 $\mathbb{E}[X_j^2]$ 不随 $d$ 变化,由大数定律 $\sum_j X_j^2 = \Theta(d)$,代入命题 3.2 即得关于 $d$ 的指数收敛。
Algorithm 1:Random Fourier Rotations for Attention Modulation¶
输入:连续正定注意力调制先验 $f$($f(0)=1$)、嵌入维度 $d$、连续位置 $p_m, p_n \in \mathbb{R}$ 输出:旋转矩阵 $R_m^d, R_n^d$,使得 $(R_m^d q_m)^\top (R_n^d k_n) \approx q_m^\top k_n f(p_m - p_n)$
- 计算 $f$ 的傅里叶变换 $\tau(\xi) = \int_{\mathbb{R}} f(x)e^{-i2\pi\xi x}dx$
- 抽取 $d/2$ 个 i.i.d. 样本 $\xi_0, \ldots, \xi_{d/2-1} \sim \tau(\xi)$
- 对每个特征对 $j$ 构造 $R_m^{(j)}, R_n^{(j)}$,按块对角方式堆叠成 $R_m^d$、$R_n^d$
3.2.1 周期函数情形:Herglotz 定理¶
推论 3.3(周期情形,经由 Herglotz 定理)¶
设 $f$ 为周期 $T$ 的连续正定核,$f(0)=1$。$f$ 的复傅里叶级数为
$$\sum_{k=-\infty}^{\infty}\alpha_k e^{i2\pi k x/T} \tag{14}$$
其中
$$\alpha_k = \frac{1}{T}\int_0^T f(x)e^{-i2\pi kx/T}dx = \frac{1}{T}\int_0^T f(x)\cos(2\pi kx/T)\,dx \tag{15}$$
由 Herglotz 定理,傅里叶系数 $\{\alpha_k\}_{k=-\infty}^{\infty}$ 满足 $\alpha_k \geq 0$ 且 $\sum_{k=-\infty}^{\infty}\alpha_k = f(0) = 1$,因此它在离散谐波 $\{\xi_k = k/T\}$ 上构成一个合法的概率质量函数。于是命题 3.1、3.2 可以直接套用,频率从
$$P(\xi) = \sum_{k=-\infty}^{\infty}\alpha_k \delta\left(\xi - \frac{k}{T}\right) \tag{16}$$
中采样。这是全文的技术枢纽:连续情形下 Bochner 给出概率密度,周期情形下 Herglotz 给出概率质量函数——周期性调制因此从"连续频率积分"退化为"离散谐波上的分类采样",工程上极其容易实现。
3.3 ClockRoPE:用于捕捉用户作息¶
要捕捉周期为 $T$ 的用户作息,论文考虑两种注意力调制核。
3.3.1 余弦先验(Cosine Prior)¶
最简单的对称周期函数:
$$f(t) = \cos\left(\frac{2\pi t}{T}\right) \tag{17}$$
套用推论 3.3,得到 RFR 频率的二值分布:
$$P(\xi) = \frac{1}{2}\delta\left(\xi - \frac{1}{T}\right) + \frac{1}{2}\delta\left(\xi + \frac{1}{T}\right) \tag{18}$$
即只在 $\pm 1/T$ 两个频率上取值——这相当于把 RoPE 的整条 log-linear 频率谱塌缩成单一周期谐波。
3.3.2 周期高斯先验(Periodic Gaussian Prior)¶
为了对时间感受野有更精细的控制,论文引入周期高斯:
$$f(t) = e^{-\frac{1}{2}\left(\frac{t}{\sigma}\right)^2}, \quad t \in \left[-\frac{T}{2}, \frac{T}{2}\right], \qquad f(t) = f(t+T) \tag{19}$$
$\sigma$ 越大,注意力峰越宽,允许时间上相距更远的交互仍保持相关;$\sigma$ 越小,注意力越锐利、越局部化。
当 $\sigma \ll T/2$ 时 $f$ 正定,可应用推论 3.3。谐波 $k/T$ 的傅里叶系数为
$$\alpha_k = \frac{1}{T}\int_{-T/2}^{T/2} e^{-\frac{1}{2}\left(\frac{t}{\sigma}\right)^2}\cos(2\pi kt/T)\,dt \approx \frac{\sigma\sqrt{2\pi}}{T}e^{-\frac{2\pi^2\sigma^2k^2}{T^2}} = \frac{1}{\sigma^*\sqrt{2\pi}}e^{-\frac{1}{2}\left(\frac{k}{\sigma^*}\right)^2}, \quad \sigma^* = \frac{T}{2\pi\sigma} \tag{20}$$
这是一个漂亮的对偶:时域上标准差为 $\sigma$ 的高斯,其谐波系数在频域上也是高斯,标准差为 $\sigma^* = T/(2\pi\sigma)$——时域越窄,频域越宽,反之亦然。
论文用两条脚注严格论证了正定性与近似的合法性:正定性要求所有 $\alpha_k \geq 0$,由 (20) 式显然成立;$\sigma \ll T/2$ 保证 $f$ 的周期延拓光滑,即 $f(\pm T/2) = \exp(-T^2/8\sigma^2)\approx 0$,使 $f$ 在每个周期内表现为真正的高斯。对本文选取的 $\sigma \leq 2$ 小时、$T = 24$ 小时,$f(\pm 12\text{hr}) = \exp(-18)\approx 10^{-8}$,在数值精度意义上确认了正定性,同时也说明 (20) 中把积分限从 $[-T/2, T/2]$ 外推到 $(-\infty, \infty)$ 的近似是精确的。
系数按 $k^2$ 指数衰减,保证截断级数快速收敛,因此实践中可以用很小的截断尺寸 $s$。截断到 $\{k/T\}_{k=-s}^{s}$ 并重新归一化 PMF 后,采样:
$$k_0^{(\ell)}, \ldots, k_{d/2-1}^{(\ell)} \sim \mathrm{Categorical}\left(\frac{\alpha_k}{\sum_{u=-s}^{s}\alpha_u}\right)_{k=-s}^{s}, \quad \ell = 1, \ldots, L \tag{21}$$
并在每个注意力层 $\ell$ 中令 $\xi_j^{(\ell)} \leftarrow k_j^{(\ell)}/T$($j = 0,\ldots,d/2-1$)。截断尺寸 $s$ 与方差 $\sigma$ 的消融见 §4.3.1。
3.3.3 折叠频率分布带来的方向感知(Direction Awareness)¶
至此推导出的频率分布(余弦先验、周期高斯先验)都是对称的。论文论证:从折叠后的非负分布采样,既能保持与对称版本相同的调制效果,又额外获得方向感知能力。折叠操作定义为
$$P_{\text{fold}}(x) = \begin{cases} 2P(x) & x > 0 \\ P(x) & x = 0 \\ 0 & \text{otherwise} \end{cases} \tag{22}$$
Table 1: ClockRoPE 采样分布
| Distributions | Form | Parameters |
|---|---|---|
| cosine-sym | $\frac{1}{2}\delta\left(\xi-\frac{1}{T}\right) + \frac{1}{2}\delta\left(\xi+\frac{1}{T}\right)$ | 无参数 |
| gaussian-sym | $\mathrm{Categorical}\left(\frac{\alpha_k}{\sum_{u=-s}^{s}\alpha_u}\right)_{k=-s}^{s}$ | 截断尺寸 $s$、高斯标准差 $\sigma$ |
| cosine-fold | $\delta\left(\xi - \frac{1}{T}\right)$ | 无参数 |
| gaussian-fold | $\mathrm{Categorical}\left(\frac{\beta_k}{\sum_{u=0}^{s}\beta_u}\right)_{k=0}^{s}$,$\beta_k = 2\alpha_k\ (k>0)$;$\beta_k = \alpha_k\ (k=0)$ | 截断尺寸 $s$、高斯标准差 $\sigma$ |
为什么折叠不破坏调制效果? 把注意力 logit 调制项完整展开:
$$\left(R_m^{(j)}q_m^{(j)}\right)^\top\left(R_n^{(j)}k_n^{(j)}\right) \tag{23}$$
$$= \left(\begin{bmatrix} \cos(2\pi\xi_j p_m) & -\sin(2\pi\xi_j p_m) \\ \sin(2\pi\xi_j p_m) & \cos(2\pi\xi_j p_m)\end{bmatrix}\begin{bmatrix}q_{m,2j}\\ q_{m,2j+1}\end{bmatrix}\right)^\top \begin{bmatrix} \cos(2\pi\xi_j p_n) & -\sin(2\pi\xi_j p_n) \\ \sin(2\pi\xi_j p_n) & \cos(2\pi\xi_j p_n)\end{bmatrix}\begin{bmatrix}k_{n,2j}\\ k_{n,2j+1}\end{bmatrix} \tag{24}$$
$$= \left(q_{m,2j}k_{n,2j} + q_{m,2j+1}k_{n,2j+1}\right)\cos\left(2\pi\xi_j(p_m-p_n)\right) \tag{25}$$
$$\quad + \left(q_{m,2j}k_{n,2j+1} - q_{m,2j+1}k_{n,2j}\right)\sin\left(2\pi\xi_j(p_m-p_n)\right) \tag{26}$$
与 RoPE 一样,ClockRoPE 的设计目标是调制注意力 logit 的上界:压低"其他时刻"的 logit 上界,使得经过 softmax 之后,更多注意力能集中到一天中相近时刻或一周中相近日的 token 上。而当 query 与 key 大致对齐时 logit 才接近上界,此时有
$$\left|q_{m,2j}k_{n,2j+1} - q_{m,2j+1}k_{n,2j}\right| \ll \left|q_{m,2j}k_{n,2j} + q_{m,2j+1}k_{n,2j+1}\right|$$
即 (25)(26) 中占主导的余弦项不依赖于频率的符号($\cos$ 是偶函数)。因此可以把所有负频率替换为其相反数(折叠),而保持信号调制效果不变。
折叠的额外收益是:调制变得方向感知(directional aware)——$\sin$ 项是奇函数,符号统一后 $p_m - p_n$ 的正负会带来不同的旋转方向;同时所有特征对共享一致的旋转朝向,这种一致性有助于投影矩阵学到关于时间因果性的统一表示。
Algorithm 2:ClockRoPE for Routine Modeling¶
// 网络初始化:逐层采样频率 1.
for每个注意力层 $\ell = 1, \ldots, L$do2. 设 $seed_\ell \leftarrow seed_{base} + \ell$ 3. 用 $seed_\ell$ 抽取 $d/2$ 个 i.i.d. 样本:$\xi_1^{(\ell)},\ldots,\xi_{d/2}^{(\ell)} \sim$ ClockRoPE 采样分布 4. 构造旋转频率向量 $\Theta^{(\ell)} \leftarrow \left(\xi_1^{(\ell)}, \xi_2^{(\ell)}, \ldots, \xi_{d/2}^{(\ell)}\right)$ 5.end for// 前向:施加 ClockRoPE 旋转(RoPE 式高效实现) 6.
for每层 $\ell = 1,\ldots,L$do7. 计算旋转角 $2\pi\Theta^{(\ell)}p_m$、$2\pi\Theta^{(\ell)}p_n$,将每个元素重复两次扩展为 $r_m^{(\ell)}, r_n^{(\ell)} \in \mathbb{R}^d$ 8. 定义 $\mathrm{rotate\_pair}(v) \leftarrow (-v_2, v_1, -v_4, v_3, \ldots, -v_d, v_{d-1})$ 9. $q_m^{(\ell)} \leftarrow q_m^{(\ell)} \otimes \cos\left(r_m^{(\ell)}\right) + \mathrm{rotate\_pair}\left(q_m^{(\ell)}\right)\otimes\sin\left(r_m^{(\ell)}\right)$ 10. $k_n^{(\ell)} \leftarrow k_n^{(\ell)} \otimes \cos\left(r_n^{(\ell)}\right) + \mathrm{rotate\_pair}\left(k_n^{(\ell)}\right)\otimes\sin\left(r_n^{(\ell)}\right)$ 11.end for
注意 Algorithm 2 的第 7–10 步与标准 RoPE 的实现完全一致——ClockRoPE 唯一改动的是频率向量 $\Theta^{(\ell)}$ 从哪个分布采样。这意味着零额外推理开销、零额外参数、零额外输入特征,是它能在生产系统低成本落地的直接原因。
3.3.4 组合多个周期¶
要同时捕捉日周期与周周期,有两种做法:(1) 用加权和组合各自的 pmf;(2) 按各周期的重要性对特征分片(shard),对每组特征施加对应的采样分布。论文实验采用第二种(更简单)。此外,在多头注意力中,ClockRoPE 频率是逐 head 独立采样的。
实验设置¶
实验在某大型视频平台的生产级生成式召回(generative retrieval)任务上进行。ClockRoPE 与各基线方法都搭建在一个 transformer-style 基座模型之上,该模型根据用户历史交互序列预测其下一次交互。这个基座模型同时驱动观看页和主页的 top-k 召回(从海量视频库中检索),并作为下游更精细的排序模型的上游。
论文希望回答三个问题:
- ClockRoPE 如何影响注意力分布?
- 注意力分布的改变是否带来观看者满意度的提升?
- ClockRoPE 与 RoPE 如何相互作用?
注意:本文全部实验均在工业专有数据上进行,未使用任何公开学术数据集,且只报告相对生产基线的百分比提升,不给出绝对指标值。 离线指标为 MAP@1 与 MAP@50。
主要实验结果¶
4.1.1 实验组 1:无位置编码¶
该组所有变体都使用绝对时间戳嵌入且不使用位置嵌入。对 ClockRoPE-gaussian 系列,用参数扫描选择截断尺寸与方差。
- Control:hour-of-the-day 与 day-of-the-week 输入特征 $\left[t \bmod T_d,\ \left\lfloor \frac{t}{T_d}\right\rfloor \bmod \frac{T_w}{T_d}\right]$。这是生产基线。
- Arm 1(Fourier Features):日/周傅里叶输入特征 $\left[\cos\left(\frac{2\pi t}{T_d}\right), \sin\left(\frac{2\pi t}{T_d}\right), \cos\left(\frac{2\pi t}{T_w}\right), \sin\left(\frac{2\pi t}{T_w}\right)\right]$。这种周期编码具有平移不变性的良好性质——由余弦差公式,两个此类特征向量的点积只依赖于相对时间距离。
- Arm 2(ClockRoPE-cosine-sym):把全部特征二等分,对两半分别施加日周期和周周期的 ClockRoPE-cosine-sym。
- Arm 3(ClockRoPE-cosine-fold):同 Arm 2,改用 cosine-fold 采样分布。
- Arm 4(ClockRoPE-gaussian-sym):同 Arm 2,改用 gaussian-sym 采样分布。
- Arm 5(ClockRoPE-gaussian-fold):同 Arm 2,改用 gaussian-fold 采样分布。
Table 2:实验组 1(无位置嵌入),相对 control 的 MAP 百分比提升
| Method | MAP@1 | MAP@50 |
|---|---|---|
| Arm 1 (Fourier Features) | +0.43% | +0.29% |
| Arm 2 (ClockRoPE-cosine-sym) | +1.89% | +1.25% |
| Arm 3 (ClockRoPE-cosine-fold) | +1.96% | +1.37% |
| Arm 4 (ClockRoPE-gaussian-sym) | +3.19% | +2.12% |
| Arm 5 (ClockRoPE-gaussian-fold) | +3.61% | +2.25% |
结论分析:
- 把周期性做进"旋转"远好于做进"输入特征"。Arm 1 的傅里叶输入特征虽然也具备平移不变性,却只有 +0.43%/+0.29%;而最简单的 ClockRoPE 变体(Arm 2)就达到 +1.89%/+1.25%,是前者的 4 倍以上。这印证了论文的立论:周期性先验应当作用在注意力的 logit 调制上,而不是塞进输入表示里让模型自己去发现。
- gaussian 系列一致优于 cosine 系列。论文给出的解释非常清晰,落在两个先验的值域上:高斯先验非负,随时间距离 $t$ 趋近 $T/2$ 而平滑衰减到 0;余弦先验则取值于 $[-1, 1]$,在 $t = T/2$ 处达到 $-1$——它对最大反相(maximally out-of-phase)的交互对不是"抑制",而是主动把注意力 logit 的符号翻转了。这种符号反转会向注意力分布注入额外噪声。
- fold 一致优于 sym(cosine:+1.96 vs +1.89;gaussian:+3.61 vs +3.19),验证了 §3.3.3 关于方向感知的论证。
论文从组 1 中挑出表现最好的变体,进入下一节与 RoPE 组合。
4.1.2 实验组 2:与 RoPE 组合¶
该组所有变体同时使用绝对时间戳嵌入和标准 RoPE 作为位置嵌入。组合方式为:对一半隐藏特征施加 RoPE,对另一半施加 ClockRoPE。其他组合方式在 §4.3.2 消融。
- Control:hour-of-the-day / day-of-the-week 输入特征 + 标准 RoPE。
- Arm 1(ClockRoPE-cosine-fold):全部特征二等分,前一半施加 RoPE;后一半再均分为两组,分别施加日周期和周周期的 ClockRoPE-cosine-fold。
- Arm 2(ClockRoPE-gaussian-sym):同 Arm 1,改用 gaussian 采样分布。
- Arm 3(ClockRoPE-gaussian-fold):同 Arm 1,改用 gaussian-fold 采样分布。
Table 3:实验组 2(与 RoPE 组合),相对 RoPE-only control 的 MAP 百分比提升
| Method | MAP@1 | MAP@50 |
|---|---|---|
| Arm 1 (ClockRoPE-cosine-fold) | +1.02% | +1.17% |
| Arm 2 (ClockRoPE-gaussian-sym) | +2.18% | +1.91% |
| Arm 3 (ClockRoPE-gaussian-fold) | +2.39% | +2.00% |
结论分析:ClockRoPE-gaussian-fold 在有无 RoPE 两种设定下都是最优。更重要的是,即便基线已经用了标准 RoPE(一个更强的基线),ClockRoPE 仍能再叠加 +2.39%/+2.00%——说明 ClockRoPE 捕捉的周期性信息与 RoPE 捕捉的近因性信息是正交的、互补的,而不是彼此替代。
4.2 线上 A/B 实验¶
Table 4:RoPE 与 ClockRoPE 各自独立提升站点级 valued engagement,二者组合效果最佳
| Method | Engagement | Valued Engagement |
|---|---|---|
| RoPE Only | +0.04% | +0.06% |
| ClockRoPE Only | +0.03% | +0.05% |
| RoPE + ClockRoPE | +0.08% | +0.08% |
线上 A/B 跑了 14 天,每个变体分配 1% 总流量。本实验采用离线评估中的最优配置:ClockRoPE-gaussian-fold,与 RoPE 的组合方式同 §4.1.2(各作用于一半特征)。
结论分析:RoPE 与 ClockRoPE 互补——单独施加任一者都能提升站点级 valued engagement;二者组合取得最佳结果,同时利用了 RoPE 的长程衰减与 ClockRoPE 的周期感知。注意 Engagement 上 RoPE+ClockRoPE 的 +0.08% 恰好等于 0.04% + 0.03% 略超的近似可加性,这是"两者信息正交"最直接的线上证据。
消融与分析¶
4.3.1 ClockRoPE-Gaussian 的截断尺寸与方差¶
以单周期 $T = 24$ 小时的 ClockRoPE-gaussian-fold 为对象,同时消融截断尺寸 $s$ 与方差 $\sigma$。
Table 5:相对生产 control 的 MAP 百分比提升(不同截断尺寸与方差)
| Method | MAP@1 | MAP@50 |
|---|---|---|
| $s=6,\ \sigma=1.0$ hr | +0.95% | +0.65% |
| $s=6,\ \sigma=1.5$ hr | +1.51% | +0.85% |
| $s=6,\ \sigma=2.0$ hr | +2.12% | +2.05% |
| $s=6,\ \sigma=2.5$ hr | +1.95% | +1.84% |
| $s=3,\ \sigma=2.0$ hr | +1.59% | +1.12% |
| $s=9,\ \sigma=2.0$ hr | +1.88% | +1.41% |
| $s=12,\ \sigma=2.0$ hr | +2.01% | +1.94% |
结论分析:调方差的影响远大于调截断尺寸。$\sigma$ 从 1.0 到 2.0 小时,MAP@1 从 +0.95% 升到 +2.12%(翻倍以上),继续到 2.5 小时则回落——存在一个明确的最优时间感受野宽度(约 2 小时,符合直觉:人的作息时点大致有 ±2 小时的抖动)。而截断尺寸方面,只要 $s$ 足够大(本例中 6 即可),继续增大不带来额外收益——这与 §3.3.2 中"系数按 $k^2$ 指数衰减、级数快速收敛"的理论预测完全吻合,是理论指导超参选择的一个漂亮闭环。
4.3.2 RoPE 与 ClockRoPE 的不同组合方式¶
对比两种方案:
- Feature-wise division(特征维度划分):一半隐藏特征用 RoPE 旋转,另一半用 ClockRoPE。
- Head-wise division(注意力头划分):一半 head 的全部特征用 RoPE,另一半 head 用 ClockRoPE。
Table 6:相对 RoPE-only control 的 MAP 百分比提升
| Method | MAP@1 | MAP@50 |
|---|---|---|
| Feature-wise division | +2.39% | +2.00% |
| Head-wise division | +1.94% | +1.87% |
结论分析:特征维度划分略优于头维度划分。一个合理的解释是:feature-wise 划分让每一个 head 内部同时具备近因性与周期性两种调制,可以在单个 head 内做联合推理;而 head-wise 划分把两种能力隔离在不同 head 中,只能在后续的 output projection 处融合,交互更晚、更弱。
4.4.1 ClockRoPE 与 RoPE 如何相互作用(周尺度可视化)¶
Figure 2 展示了在 0–168 小时时间距离范围内的注意力分布,对每个小时桶内的注意力概率取平均。此对比使用仅日周期的 ClockRoPE-gaussian-fold。
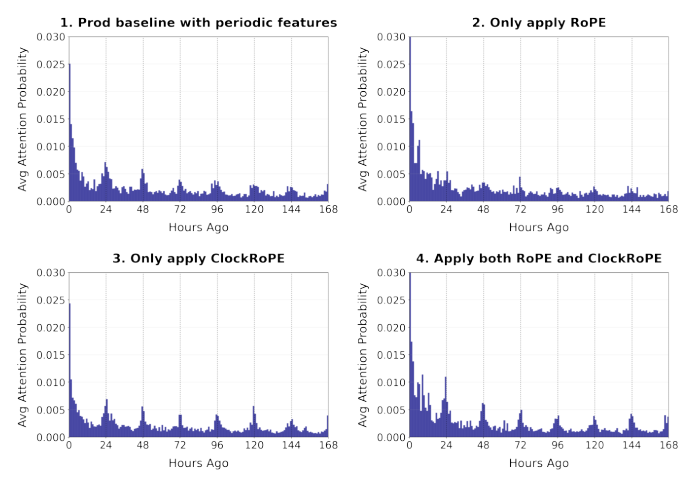
四张子图的读法:
- 子图 1(生产基线 + 周期性输入特征):注意力高度集中在最近几小时,周期结构微弱。
- 子图 2(仅 RoPE):直接确认了 §3.1 的动机——log-linear 频率调度的长程衰减主导了整个注意力模式,压制了 ClockRoPE 试图恢复的周期信号。
- 子图 3(仅 ClockRoPE):注意力在每 24 小时处出现明显的尖峰,日周期被清晰地刻画出来。
- 子图 4(RoPE + ClockRoPE):长程衰减与清晰日周期同时保留。这正好解释了为什么组合方案在 §4.2 的线上实验中取得最佳收益。
论文特别说明:在小时级粒度上,Gaussian-symmetric 与 Gaussian-fold 产生的模式相似,故此处不做区分。
4.4.2 对称 vs 折叠频率分布(日尺度可视化)¶
当按天为桶聚合注意力概率(Figure 3)时,折叠分布与其对称版本的差异才开始显现。
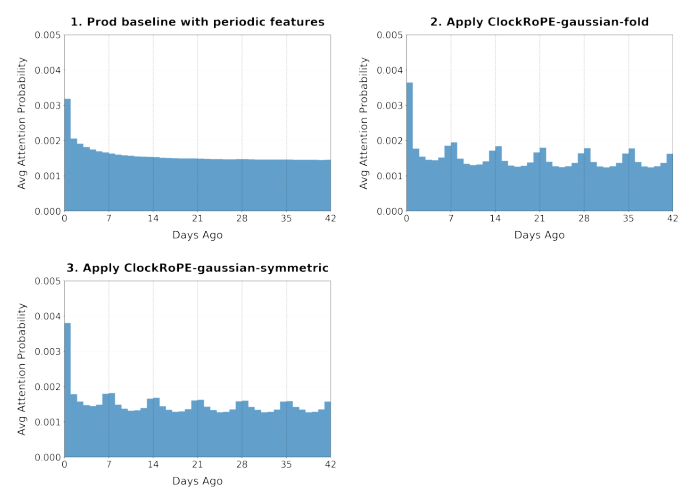
关键观察:
- ClockRoPE 引入了基线中并不显式存在的周周期注意力峰。
- ClockRoPE-gaussian-fold 分配给周周期标记点之前一天的注意力,多于之后一天。
- ClockRoPE-gaussian-symmetric 在周周期标记点前后两天之间的注意力分配均匀得多。
机制解释:如 §3.3.3 所述,折叠频率分布让模型能通过不同方向的旋转区分"周周期标记点之前一天"与"之后一天"的交互;而在 gaussian-symmetric 下,只要到周周期标记点的时间距离相同,前后两天会产生相同的旋转,因而无法区分。Figure 3 子图 2 表明:凭借方向感知能力,当把所有交互投影到同一个"周圆环"上时,模型学会了给之前的交互分配更多注意力——例如周一的交互会更多地关注上个周日(8 天前)而非上个周二(6 天前)。这为 ClockRoPE-gaussian-fold 优于对称版本给出了一个可解释的原因:它能捕捉带因果关系的作息模式。
4.5 生产部署结果¶
Table 7:核心部署指标
| Core Deployment Metrics | Results |
|---|---|
| Valued Engagement Time | +0.08% |
| Homepage Triggered Engagement Time | +0.11% |
| Homepage Views | -0.51% |
| Daily Unique Impressed Videos | -0.19% |
| TPU Serving Cost | -0.63% |
| Serving Latency | Neutral |
ClockRoPE 已与 RoPE 一起部署到某大型视频平台的主页和观看页,服务延迟中性。
结论分析:这张表最有意思的地方在于三个负向指标其实是正向信号。日均独立曝光视频数(-0.19%)与主页浏览量(-0.51%)下降,同时主页触发的互动时长(+0.11%)与整体 valued engagement time(+0.08%)上升——这意味着用户现在需要更少的滑动和点击就能找到满意的内容。更少的浏览量直接转化为更低的服务量,最终节省 0.63% 的 TPU 服务成本。也就是说,ClockRoPE 是一个同时提升用户价值和降低服务成本的改动,这在工业推荐系统中相当罕见(通常两者互为代价)。
Table 8:作息相关指标
| Routine-related Metrics | Online Lift |
|---|---|
| Engaged Vod Topics | +0.05% |
| Repeat Engaged Topics | +0.03% |
| Gaming-Related Content Valued Engagement | +0.08% |
| News Valued Engagement | +0.17% |
| Learning Content Valued Engagement | +0.15% |
结论分析:Table 8 是归因证据而非单纯的效果证据。收益最大的三类内容——新闻(+0.17%)、学习(+0.15%)、游戏(+0.08%)——恰恰是作息性最强的消费品类(固定时间看新闻、固定时段学习、下班后打游戏)。这与论文最初"提升序列推荐的作息感知能力"的动机首尾呼应,说明线上收益确实来自模型学到了周期性,而不是某种无关的正则化副作用。
附录 B:旋转频率可以被学习吗?¶
论文额外做了一组实验:把旋转频率与网络权重联合优化。
Table 9:相对生产 control 的 MAP 百分比提升(可学习频率)
| Method | MAP@1 | MAP@50 |
|---|---|---|
| Learnable frequencies initialized from 0.0 | -1.44% | -1.40% |
| ClockRoPE-cosine-fold | +1.96% | +1.37% |
| + Learnable frequencies | +2.01% | +1.45% |
| ClockRoPE-gaussian-fold | +3.61% | +2.25% |
| + Learnable frequencies | +3.23% | +2.16% |
结论分析:这张表的信息量很大。
- 从 0 初始化的可学习频率是负收益(-1.44%)——比生产基线还差。说明频率不是能靠梯度自己学出来的东西:注意力 logit 关于频率是高度非凸的振荡函数,随机/零初始化会陷在坏的局部解。
- 用 ClockRoPE 初始化显著改善(从 -1.44% 到 +2.01%/+3.23%)——初始化(即先验)才是真正起作用的部分。
- 可学习频率与固定频率表现相当(cosine-fold 略升 +1.96→+2.01,gaussian-fold 略降 +3.61→+3.23)。这反过来强化了论文的核心主张:ClockRoPE 采样分布给出的频率已经接近最优,梯度下降在其附近找不到实质更好的解。因此生产中直接用固定频率即可,省去可学习参数与训练复杂度。
核心贡献总结¶
- 理论层面:证明了 query/key 旋转的表达能力远超 RoPE 的既有用法——任意归一化连续正定注意力调制函数都能被从其自身傅里叶变换采样的随机旋转无偏逼近(Bochner 定理),且收敛速度关于特征维度 $d$ 指数级快(McDiarmid)。周期情形下由 Herglotz 定理退化为离散谐波上的分类采样。这把 RoPE 从"一种位置编码"提升为"一族可设计的注意力先验注入机制",log-linear 长程衰减只是其中一个特例。
- 方法层面:ClockRoPE 以周期高斯为先验,通过折叠频率分布额外获得方向感知,不增加任何输入特征、模型维度或推理开销(前向实现与标准 RoPE 逐行一致,仅频率来源不同)。
- 工程层面:在某大型视频平台的生产级生成式召回系统中完成部署,离线 MAP@1 +3.61%,线上 valued engagement +0.08%,且同时降低 0.63% TPU 服务成本、延迟中性。
与已归档相关工作的对比¶
Pro-GEO Pro-GEO: Birds of a Feather Cluster Nearby — a Proximity-Aware Geo-Codebook(BUPT / Meituan / BIT,2026-04-25)¶
关系:独立并发(本文未引用 Pro-GEO,两者殊途同归)· 已加载对方精读
-
共同关注的问题:两篇论文诊断出的是同一个 root cause——RoPE 把"旋转角 = 序列位置的线性函数 + log-linear 频率调度"当作了不可动摇的结构,于是它所能表达的距离-相关性模式被锁死为"单调长程衰减"。可一旦离开语言建模,领域里真正重要的那个连续量(ClockRoPE 的时间、Pro-GEO 的地理位置)其相关性结构根本不是单调衰减:时间上是周期的(同一时刻高度相关),空间上是各向异性且有硬可达性约束的(Pro-GEO 统计出超过 50% 的 POI 与同 SID 下其他 POI 相距 >40 km)。两篇都明确指出,把这个量当作辅助输入特征 concat 进去只是 weak regularizer、会被高维语义信号淹没——必须把它写进旋转里。
-
相近的技术骨架:两者的方法流程图可以抽象重合为同一条——保留 RoPE 的 Givens 旋转 + 内积自动相消为相对量这一核心结构,但把"旋转角从哪来"整个替换掉。ClockRoPE 把 $\theta = \theta_i \cdot p$(log-linear 频率 × 序列位置)替换为 $2\pi\xi_j t$,其中 $\xi_j$ 从周期核的傅里叶谐波 PMF 中采样;Pro-GEO 把 $\theta$ 直接替换为地理量 $\theta_p \in \{d_p, \sigma_p\}$(相对簇质心的 Haversine 半径与方位角)。两者也都刻意处理了"对称 vs 有向"这一自由度:Pro-GEO 用前向+反向的镜像对偶结构 $[\mathcal{R}(\sigma_p)r; \mathcal{R}(-\sigma_p)r]$ 让余弦差只依赖相对角差 $\Delta\sigma$(即刻意保住平移不变性);ClockRoPE 则反其道而行,用折叠频率分布刻意打破对称性以换取方向感知(区分"周期标记点之前一天"与"之后一天")。同一个设计轴上的相反选择,恰恰因为两个领域对"方向"的语义需求相反——地理邻近本质无向,而时间因果本质有向。
-
本文的差异与推进:最大的差异在理论层级。Pro-GEO 是实例级构造:它挑了地理量塞进旋转角,再用附录 Lemma A.1 事后证明该构造的余弦距离变化可分解为"空间因子 × 语义因子"(其 Eq. 11)。ClockRoPE 则给出了生成式的一般框架:先写下你想要的注意力调制核 $f$,Bochner/Herglotz 定理直接告诉你该从哪个分布采频率,Pro-GEO 那样的具体设计原则上是这个框架下的一个可推导实例。此外 ClockRoPE 还给了收敛速率(关于 $d$ 指数快,保证先验从训练第一步就生效),Pro-GEO 没有对应结果。另一处差异是作用位置:ClockRoPE 作用在每一层注意力内部(逐层、逐 head 独立采样频率),是运行时的 logit 调制;Pro-GEO 作用在tokenizer/码本构建阶段(第三层 SID 的 K-means 聚类前),是离线的表示预处理,旋转后的嵌入并不进入注意力。
-
可比的方法/实验差异:Pro-GEO 有公开数据集结果(附录 D)与工业数据集,主指标是 Hit@50(+1.87%)与平均地理聚类距离(-45.6%);ClockRoPE 完全没有公开数据集实验,只报告工业 MAP@1/MAP@50 的相对提升(+3.61%/+2.25%)与线上 A/B(valued engagement +0.08%)。两者因此无法直接数值比较。可比的是超参哲学:Pro-GEO 用 $\alpha, \beta$(默认各 0.5)加权方位角与半径两路旋转;ClockRoPE 则通过特征分片把日周期与周周期分配到不同特征组,并用 $(s, \sigma)$ 控制谐波截断与时间感受野,其中 $\sigma$ 的影响远大于 $s$。ClockRoPE 更强的一点是它把超参选择接回了理论——"$s=6$ 之后无额外收益"直接由傅里叶系数按 $k^2$ 指数衰减预测得到,而 Pro-GEO 的 $\alpha, \beta$ 只能靠扫参。
讨论与局限性¶
值得借鉴的设计
- "先写下你想要的先验,再反解出实现"这一方法论是本文最可迁移的部分。它把位置编码设计从"试各种频率调度"变成了"选一个正定核 $f$,然后查它的傅里叶变换"。这个框架不限于时间:任何具有已知距离-相关性结构的连续量(地理、价格、年龄、传感器读数)都能套用,甚至在 LLM 场景中也可用于注入非单调的距离先验。
- 零成本落地。Algorithm 2 的前向与标准 RoPE 逐行一致,改的只是频率向量的来源。这意味着任何已有 RoPE 实现(含 FlashAttention 等高效算子)无需改动即可支持——这是它能进生产系统的关键,也是相对"加性时间偏置"类方案(需要物化 logits 矩阵)的结构性优势。
- "互补而非替代"的定位。论文没有声称 ClockRoPE 应当取代 RoPE,而是明确论证并实验验证两者正交、应当组合(特征对半分)。这种克制的定位反而让它更容易被采纳。
- 附录 B 的可学习频率实验很有价值:它用负结果(0 初始化 -1.44%)证明了先验的价值恰恰在于它不可学,这是对"什么都交给梯度"这一惯性思维的有力反例。
局限与争议
- 完全没有公开数据集实验。全部结果都在专有工业数据上,且只报相对百分比、不给绝对指标,外部无法复现、无法与任何已发表方法横向比较。对于一篇以理论贡献为主要卖点的论文,缺少哪怕一个公开 benchmark(如 MovieLens / Amazon 上带时间戳的序列推荐)是明显的短板——RFR 的普适性主张因此只在一个系统上被验证过一次。
- 线上收益的绝对量级很小。valued engagement +0.08%、engagement +0.08%,这在 1% 流量、14 天的 A/B 中是否显著,论文未给出置信区间或 p 值。Table 7、Table 8 中 +0.03% ~ +0.17% 的诸多指标同样缺少统计显著性说明。考虑到平台体量,这些数字可能确实有意义,但论文没有提供判断依据。
- "某大型视频平台"的匿名化与作者单位(YouTube)构成公开的矛盾,属于工业论文的惯例,但也意味着基座模型的规模、层数、序列长度、$d$ 等关键配置全部缺失——而命题 3.2 的收敛速率恰恰依赖于 $d$,读者无法判断在自己的 $d$ 下逼近质量如何。
- 周期 $T$ 需要人工指定(日 24 小时、周 168 小时)。这对人类作息是合理的先验,但论文未讨论如何处理未知周期或用户个性化周期(例如轮班工作者的作息周期并非 24 小时对齐)。§3.3.4 提到可以用加权和组合多个周期分布,但实验中采用的是更简单的特征分片,多周期的加权组合方案未被实验验证。
- 组 1 与组 2 的 control 不同(前者是无位置编码的生产基线,后者是 RoPE-only),这本身合理,但导致 Table 2 与 Table 3 的数字不可直接相加或比较,论文对此没有额外提示,容易被误读。
- 方向感知的解释偏事后。§4.4.2 关于"周一更关注上周日而非上周二"的观察很有意思,但这是从可视化中读出来的现象,论文并未设计针对性实验(如构造有向/无向作息的合成数据)来证实"捕捉因果作息"是 fold 优于 sym 的真正原因。论文自己也用了 "a potential reason" 的措辞。
工业落地价值
本文的部署细节是其最强的部分之一:已在某大型视频平台的主页与观看页同时上线,作为生成式召回基座模型的一部分(该基座是下游精排的上游)。收益结构相当理想——用户侧:valued engagement time +0.08%、主页触发互动时长 +0.11%,且作息性最强的新闻/学习/游戏品类收益最高(+0.17%/+0.15%/+0.08%);成本侧:因用户更快找到满意内容,主页浏览量 -0.51%、日均独立曝光视频 -0.19%,直接带来 TPU 服务成本 -0.63%,延迟中性。"效果涨 + 成本降 + 延迟不变 + 零新增参数" 这个组合在工业推荐系统中非常少见,也是这篇论文最有说服力的落地证据。