SPARC: Sequence-aware Progressive Attribute Routing and Compression Framework for Generative Recommendation
阿里巴巴集团(Alibaba Group, Beijing)· arXiv:2607.25339v1 · 2026-07-28
研究动机与背景
生成式推荐(Generative Recommendation, GR)近年来在学术界和工业界都获得了大量关注。与传统判别式推荐从预定义候选集中打分不同,生成式推荐把推荐建模为 item token 的自回归生成:先用 item tokenizer 把候选 item 离散化为 Semantic ID(SID)序列,再把用户交互历史转成对应的 SID 序列,最后用 Transformer 骨干预测目标 item 的 SID。这个范式把 item 表征、用户建模、候选召回统一进了一个序列生成框架里,从而支持在超大 item 空间上端到端预测,具备长尾泛化能力和工业可用性。
在这个范式下,SID 的质量直接决定了后续用户建模与目标 item 生成的效果。早期方法从 item 标题、描述中抽连续语义表征,再通过聚类、向量量化或残差量化离散化;后续工作把类目、品牌、结构化属性、视觉内容等通过多模态对齐、属性重建、辅助预测目标一并纳入;更近的工作还把协同关系、行为序列、时间信号融进 SID 学习,或者显式地在输入序列里插入 behavior token / time token。
但论文指出,这些改进都没有解决一个根本性问题:绝大多数已有方法给每个 item 分配的是一个全局共享的静态 SID。 无论 tokenizer 训练时融入了多少文本、视觉、结构化、协同或序列信息,同一个 item 在不同用户、不同交互场景下拿到的 token 都是完全相同的。这就无法刻画一次具体的历史交互。
而真实工业系统里,一次交互除了 item 本身还带着大量异构信息:
- 稳定属性:类目(category)、品牌(brand)、卖家(seller)
- 动态状态:价格(price)、库存(inventory)、促销状态(promotion status)
- 交互级上下文:行为类型(behavior type)、时间戳(timestamp)
其中动态状态与交互上下文是绑定在交互发生的那一刻的,本质上无法被一个静态分配的 SID 可靠编码。
一个直接的做法是把每个附加字段都表示成独立 token,把所有字段 token 一起喂进生成式骨干。这确实保留了完整信息,但会大幅扩张输入上下文:对一条包含 $L$ 次交互的历史,用多个字段 token 表示每次交互会让有效序列长度按字段数成比例增长——从 $L$ 涨到约 $LF$。由于自注意力的计算和显存开销随序列长度近似二次增长,这种扩张带来极高的训练与推理成本,同时降低了模型能处理的历史交互条数。已有的追加属性 token / 行为 token / 时间 token 的方法都面临同样的可扩展性问题。
另一条路是在喂进生成式骨干之前,把每次行为的 item 属性、动态特征、交互上下文聚合成一个紧凑表示。但论文指出,在字段之间还没有充分交互之前就直接压缩异构字段,会造成过早的信息瓶颈(premature information bottleneck)。更关键的是:
字段的重要性不仅取决于字段内容本身,还取决于周围的行为序列。
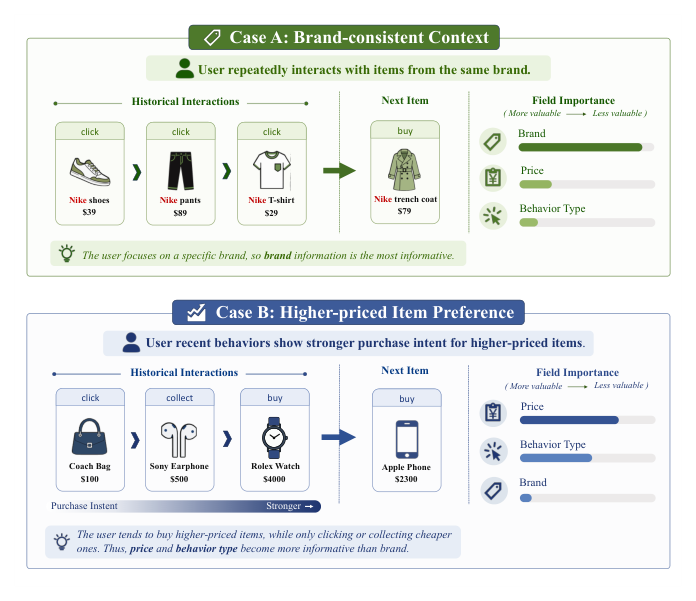
Figure 1 给出了两个对照案例:
- Case A(品牌一致的上下文):用户反复与同一品牌的商品交互(Nike 鞋 → Nike 衣 → Nike 鞋),此时 brand 信息变得高度可预测,字段重要性排序是 brand > price > behavior type。
- Case B(更高价位的偏好):用户近期行为对高价商品表现出更强的购买意图(对高价商品下单,对便宜商品只是点击 / 收藏),此时 price 和 behavior type 比 brand 更有信息量。
因此,压缩过程中应该保留哪些信息,必须以当前的序列上下文为条件。
这就构成了一个根本性的权衡:完全展开异构字段并把字段交互交给大骨干去做,能保住信息,但上下文与计算成本高得难以承受;直接压缩而不做充分交互,效率高但可能不可逆地丢掉上下文相关的信号。关键挑战因此是:以低成本在压缩之前把多维行为信息上下文化,同时保证每次历史交互最终只占据骨干里的一个 token。
为此论文提出 SPARC(Sequence-aware Progressive Attribute Routing and Compression)。它不去重构目标 item 的 SID,而是聚焦于丰富生成式模型的历史 item 表征:用一个轻量前置模块把异构行为信息上下文化并渐进压缩,保证每次历史交互由一个骨干 token 表示。SPARC 因此在不增加生成式骨干输入长度的前提下,保留了更丰富的行为信号。
SPARC 由三个阶段构成:
- Field-wise Context Modeling (FCM) —— 把同一字段类型的表征沿用户历史组织成序列并建模,产出每个字段的上下文感知表征;
- Context-aware Attribute Routing (CAR) —— 联合考虑原始字段表征、上下文化表征和字段身份,把异构字段路由到固定数量的中间 slot,在受限表征预算下保留互补信息;
- Sequence-level Token Consolidation (STC) —— 把所有历史交互的中间 token 重排成细粒度序列,做轻量跨交互建模,再把每次交互的 token 压成一个紧凑表示。
论文把这一原则概括为 "interacting before compressing"(先交互再压缩)/ "contextualizing before compression"(先上下文化再压缩)。
主要贡献:
- 指出工业生成式推荐里一个根本的表征挑战:静态分配的 SID 无法完整刻画动态 item 状态与交互特定上下文,而显式把这些信息 token 化又会造成显著的上下文扩张;
- 提出 SPARC,一个序列感知的渐进式属性路由与压缩框架,在压缩前把异构行为信号上下文化,并在固定 item token 预算内保留上下文相关信息;
- 在工业 Taobao 数据集与两个公开 Amazon 数据集上做了实验,SPARC 稳定优于强 baseline;进一步与静态压缩变体的对比以及路由分析验证了上下文条件化的信息保留才是收益来源。
预备知识与问题形式化
生成式推荐
生成式推荐把 item 推荐建模为离散 item token 上的自回归生成问题。给定 item 集合 $\mathcal{I}$ 中的 item $i$,item encoder 先用 item 内容、结构化特征或协同信号把它映射为连续表征 $\mathbf{h}_i$。item tokenizer 再把 $\mathbf{h}_i$ 离散化为一串 SID:
$$\mathbf{s}_i = (s_i^1, s_i^2, \ldots, s_i^K), \tag{1}$$
其中 $K$ 是 SID 长度,每个 $s_i^k$ 从一个离散码本中选出。已有方法通过聚类、向量量化、残差量化或可学习的 tokenization 目标获得这些离散 token。
给定用户行为序列 $\mathcal{S}_u = (i_1, i_2, \ldots, i_L)$,生成式推荐器把每个历史 item 转成 SID 序列,把拼接后的 token 序列送进 Transformer 骨干,自回归地预测下一个 item $i_{L+1}$ 的 SID:
$$p_\theta(\mathbf{s}_{i_{L+1}} \mid \mathcal{S}_u) = \prod_{k=1}^{K} p_\theta\!\left(s_{i_{L+1}}^k \mid \mathbf{s}_{i_1}, \ldots, \mathbf{s}_{i_L}, s_{i_{L+1}}^{<k}\right), \tag{2}$$
其中 $\theta$ 是生成式推荐器的参数,$s_{i_{L+1}}^{<k}$ 表示第 $k$ 步之前已生成的目标 SID token。模型在所有用户上最小化目标 SID 序列的负对数似然:
$$\mathcal{L}_{\text{rec}} = -\sum_{u} \sum_{k=1}^{K} \log p_\theta\!\left(s_{i_{L+1}}^k \mid \mathbf{s}_{i_1}, \ldots, \mathbf{s}_{i_L}, s_{i_{L+1}}^{<k}\right). \tag{3}$$
在这个范式里,SID 充当传统稠密 item ID 特征的离散替身,提供生成式推荐器引用历史 item 与目标 item 的主要身份信号,因此在用户序列建模中对保持稳定的 item identity 至关重要。这一点是理解 SPARC 后面"为什么 SID 字段不参与路由而被直接保留"的关键。
多字段历史压缩问题
工业推荐场景下,每次历史交互除了 item SID 还包含多个异构字段。对第 $t$ 次交互,其字段表征记为:
$$\mathbf{E}_t = [\mathbf{e}_t^1, \mathbf{e}_t^2, \ldots, \mathbf{e}_t^F] \in \mathbb{R}^{F \times d}, \tag{4}$$
其中 $F$ 是字段数,$d$ 是表征维度,$\mathbf{e}_t^f$ 是第 $f$ 个字段的表征。这些字段可以包括 SID token、类目、品牌、卖家、价格、行为类型、时间戳等 side information。若某字段包含多个原始 token,则先做 token embedding 再做 mean pooling 或其他轻量字段编码器聚合成 $\mathbf{e}_t^f$。
把所有信息喂进骨干最直接的方式是把所有交互的所有字段 token 都送进去:
$$\mathbf{H}_u^{\text{full}} = [\mathbf{E}_1, \mathbf{E}_2, \ldots, \mathbf{E}_L]. \tag{5}$$
这种表示保留了细粒度字段信息,也允许骨干直接建模字段级交互,但把输入长度从 $L$ 个 item 级表征扩张到约 $LF$ 个字段级表征,大幅增加 Transformer 生成式推荐器的计算和显存成本。
因此论文研究异构历史交互的 item 级压缩。令 $\mathbf{E}_{1:L} = \{\mathbf{E}_1, \mathbf{E}_2, \ldots, \mathbf{E}_L\}$ 表示整段历史的字段表征。目标是在喂进骨干前把每次多字段交互压缩成一个紧凑表示:
$$\mathbf{z}_t = C_\psi(\mathbf{E}_t, \mathbf{E}_{1:L}) \in \mathbb{R}^{d}, \tag{6}$$
其中 $C_\psi$ 是由 $\psi$ 参数化的压缩函数。压缩后的用户序列写作:
$$\mathbf{H}_u^{\text{comp}} = [\mathbf{z}_1, \mathbf{z}_2, \ldots, \mathbf{z}_L], \tag{7}$$
长度与传统 item 级历史相同,但每个 token 携带更丰富的多字段信息。
已有的 item-wise 压缩方法(如 mean pooling、MLP-based 压缩)采用的是静态、与上下文无关的形式:
$$\mathbf{z}_t = C_\psi^{\text{static}}(\mathbf{E}_t), \tag{8}$$
保留的信息只依赖当前交互的字段。而本文关注动态的、以上下文为条件的压缩:
$$\mathbf{z}_t = C_\psi^{\text{context}}(\mathbf{E}_t, \mathbf{E}_{1:L}), \tag{9}$$
即每次交互的压缩可以根据周围的行为序列进行调整。在这个形式化下,核心问题变成:如何在保留 SID 提供的稳定 item identity 的同时,以序列上下文为条件选择性地保留有用的 side information。
核心方法:SPARC 框架
总体架构
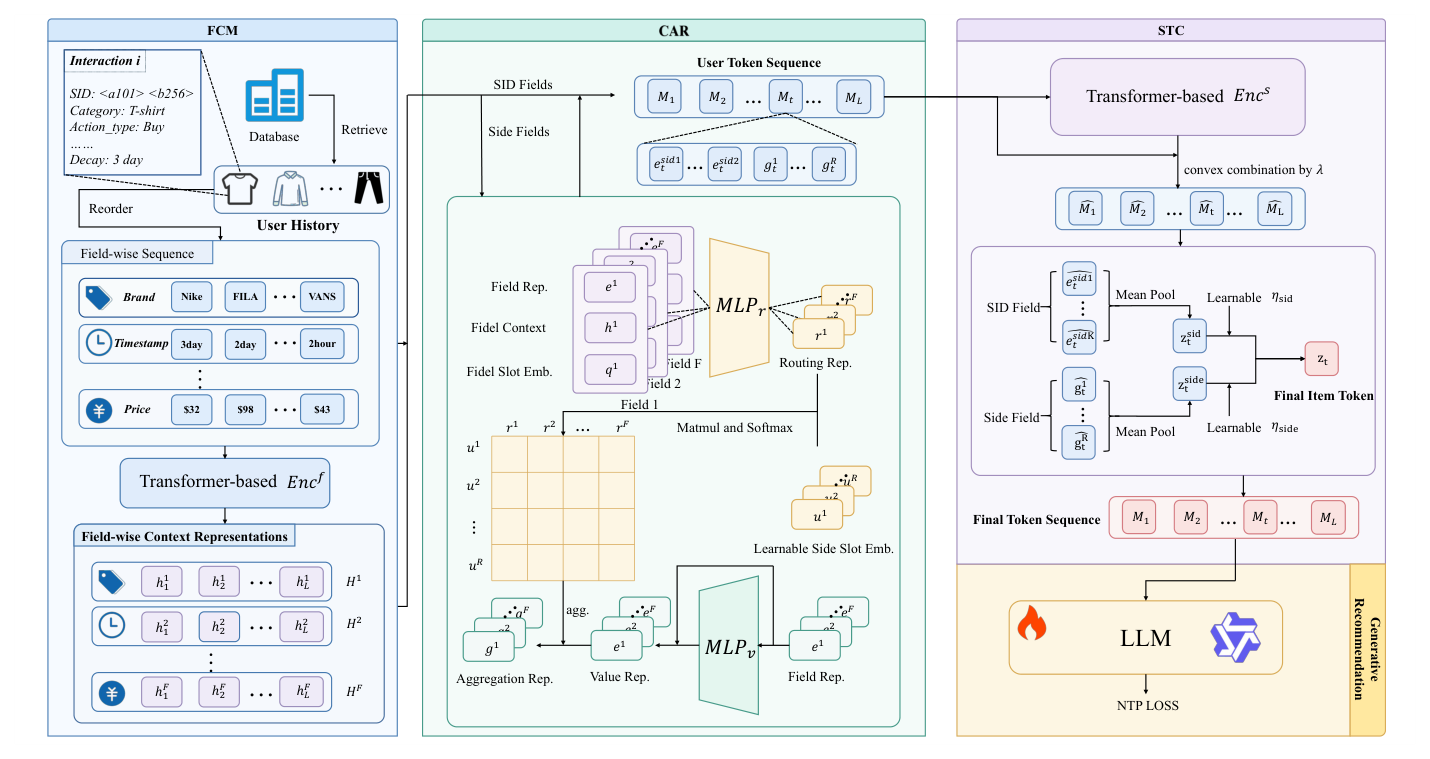
SPARC 是一个放在生成式推荐骨干之前的轻量上下文条件压缩器。给定用户历史的多字段表征,SPARC 依次:
- 通过 FCM 建模每个字段类型的序列上下文;
- 通过 CAR 保留基于 SID 的 item identity,并把上下文化的 side 信息路由进中间 token;
- 通过 STC 把这些中间 token 合并成每次交互一个紧凑 token。
这样,SPARC 用上下文相关的 side information 丰富了历史 item 表征,同时保持骨干输入长度不变、目标 SID 生成目标不变。
Field-wise Context Modeling (FCM)
FCM 的作用是在 item 级压缩之前,捕捉字段特有的、以序列为条件的模式。
给定历史字段表征 $\mathbf{E}_{1:L}$,SPARC 先把同一字段类型的表征沿用户历史分组。对第 $f$ 个字段,字段维序列定义为:
$$\mathbf{X}^f = [\mathbf{e}_1^f, \mathbf{e}_2^f, \ldots, \mathbf{e}_L^f]. \tag{10}$$
随后对每条字段维序列施加一个轻量序列编码器 $\text{Enc}^{\text{f}}$:
$$\mathbf{H}^f = [\mathbf{h}_1^f, \mathbf{h}_2^f, \ldots, \mathbf{h}_L^f] = \text{Enc}^{\text{f}}(\mathbf{X}^f), \tag{11}$$
其中 $\mathbf{H}^f$ 是该字段的上下文化序列,$\mathbf{h}_t^f$ 是字段 $f$ 在位置 $t$ 的上下文化表征。
设计动机:这一步在压缩异构字段之前先引入了序列上下文。与直接在一次交互内部混合不同字段不同,FCM 首先建模每个字段类型如何沿用户历史演化(例如 brand 是否反复出现、price 区间是否漂移),从而让后续的路由既能考虑原始字段表征 $\mathbf{e}_t^f$,也能考虑它的上下文感知对应物 $\mathbf{h}_t^f$。这正是 Figure 1 中"字段重要性取决于序列上下文"的直接实现。
实现上,$\text{Enc}^{\text{f}}$ 是一个 2 层 Transformer 编码器。
Context-aware Attribute Routing (CAR)
CAR 把每次交互的异构字段压缩成一小组中间 token。字段被划分为两个不相交的组:SID 字段 $\mathcal{F}_{\text{sid}}$ 和 side 字段 $\mathcal{F}_{\text{side}}$。
由于 SID token 在生成式推荐中提供主要的 item identity 信号,SPARC 显式地保留它们,而不是在路由中把它们与 side 字段混在一起。对每次交互,identity token 构造为:
$$\mathbf{I}_t = [\mathbf{e}_t^f]_{f \in \mathcal{F}_{\text{sid}}}. \tag{12}$$
对 side 字段,CAR 执行上下文条件化的路由。对每个 side 字段 $f \in \mathcal{F}_{\text{side}}$,把原始表征、上下文化表征和字段 embedding 拼起来构建一个路由表征:
$$\mathbf{r}_t^f = \text{MLP}_{\text{r}}\!\left(\left[\mathbf{e}_t^f; \mathbf{h}_t^f; \mathbf{q}^f\right]\right), \tag{13}$$
其中 $[\cdot\,;\cdot]$ 表示拼接,$\text{MLP}_{\text{r}}(\cdot)$ 是路由网络,$\mathbf{q}^f$ 是编码字段 $f$ 身份的可学习 embedding。三路输入分别对应"字段内容是什么"($\mathbf{e}_t^f$)、"这个字段在序列里怎么演化"($\mathbf{h}_t^f$)、"这是哪个字段"($\mathbf{q}^f$)。
给定 $R$ 个可学习的 side slot $\{\mathbf{u}_1, \ldots, \mathbf{u}_R\}$,从 side 字段 $f$ 到 slot $r$ 的路由权重通过在所有 side 字段上归一化得到:
$$\alpha_{t,r}^f = \frac{\exp\!\left((\mathbf{r}_t^f)^\top \mathbf{u}_r\right)}{\sum_{g \in \mathcal{F}_{\text{side}}} \exp\!\left((\mathbf{r}_t^g)^\top \mathbf{u}_r\right)}. \tag{14}$$
这里 $\alpha_{t,r}^f$ 度量 side 字段 $f$ 在交互位置 $t$ 对第 $r$ 个 side slot 的贡献,$g$ 是在 side 字段上的求和索引。注意归一化是在 $\mathcal{F}_{\text{side}}$ 上做的(即每个 slot 在所有字段上做 softmax),而不是在 slot 上做——这意味着每个 side slot 在当前序列上下文下自适应地从不同 side 字段中选取信息,形成 slot 之间的"分工"而非字段之间的竞争。
第 $r$ 个 side token 通过聚合 side 字段的 value 得到:
$$\mathbf{g}_t^r = \sum_{f \in \mathcal{F}_{\text{side}}} \alpha_{t,r}^f \mathbf{v}_t^f, \tag{15}$$
其中 $\mathbf{v}_t^f$ 是 side 字段 $f$ 的 value 表征,定义为残差投影:
$$\mathbf{v}_t^f = \mathbf{e}_t^f + \text{MLP}_{\text{v}}(\mathbf{e}_t^f), \tag{16}$$
$\text{MLP}_{\text{v}}(\cdot)$ 是一个轻量的 value 投影网络。这个残差设计让 side token 的 value 保持贴近原始字段表征,使 CAR 主要学习"如何路由 side 信息"而不是"从零重写字段空间"。 这是一个重要的归纳偏置:把"选择"与"重写"解耦,避免压缩模块引入不必要的表征扭曲(后面消融里 w/ Modulated 变体的失败正好印证了这一点)。
CAR 的输出是中间 token 集合:
$$\mathbf{M}_t = [\mathbf{I}_t; \mathbf{g}_t^1, \ldots, \mathbf{g}_t^R], \tag{17}$$
其中 $\mathbf{M}_t$ 是交互 $t$ 的中间 token 集合,由被保留的 SID identity token 与 $R$ 个被路由的 side token 组成。因此 CAR 通过 SID token 保持稳定 item identity,同时用序列感知的路由在有限 token 预算内保留互补的 side information。
论文实现中 $|\mathcal{F}_{\text{sid}}| = 2$、$R = 2$,共 9 个字段(2 个 SID 字段 + 7 个 side 字段),因此每次交互在合并前由 4 个中间 token 表示。
Sequence-level Token Consolidation (STC)
经过 CAR 后,每次交互由多个中间 token 表示。STC 进一步建模它们的跨交互依赖,并把它们合并成单个骨干 token。
首先把所有历史交互的中间 token 拼接成一条细粒度 token 序列:
$$\mathbf{M}_{1:L} = [\mathbf{M}_1, \mathbf{M}_2, \ldots, \mathbf{M}_L], \tag{18}$$
其中 $\mathbf{M}_{1:L}$ 是用户历史中所有中间 token 集合按序排成的序列。尽管这些中间 token 被临时展平以做序列级交互,交互边界仍被保留,供最后的交互内合并使用。
对展平后的序列施加一个轻量序列编码器 $\text{Enc}^{\text{s}}$:
$$\overline{\mathbf{M}}_{1:L} = \text{Enc}^{\text{s}}(\mathbf{M}_{1:L}), \tag{19}$$
其中 $\overline{\mathbf{M}}_{1:L}$ 是序列增强后的中间 token。位置 embedding 与 token 类型 embedding 被用来区分交互位置与中间 token 角色。
为避免对压缩 token 空间造成不稳定的剧烈改变,STC 引入一个门控残差更新做序列级交互:
$$\widehat{\mathbf{M}}_{1:L} = \mathbf{M}_{1:L} + \lambda\left(\overline{\mathbf{M}}_{1:L} - \mathbf{M}_{1:L}\right), \tag{20}$$
其中 $\widehat{\mathbf{M}}_{1:L}$ 是更新后的中间 token,$\lambda$ 是可学习的残差门。这个设计让 STC 能渐进地吸收跨交互信息,同时保住原始的中间表征。实现上 $\lambda$ 被初始化为 logit $-5$(即初始门控值约 $0.0067$,几乎等同于恒等映射),使 STC 的精炼在优化早期才被逐步引入,以稳定训练。
最后,STC 分别汇总 identity token 与 side token:
$$\mathbf{z}_t^{\text{id}} = \text{Pool}_{\text{id}}(\widehat{\mathbf{M}}_t), \qquad \mathbf{z}_t^{\text{side}} = \text{Pool}_{\text{side}}(\widehat{\mathbf{M}}_t), \tag{21}$$
其中 $\widehat{\mathbf{M}}_t$ 是交互 $t$ 对应的更新后中间 token 集合,$\text{Pool}_{\text{id}}(\cdot)$ 与 $\text{Pool}_{\text{side}}(\cdot)$ 分别在同一次交互内汇总更新后的 identity token 与 side token(实现为 mean pooling)。STC 随后把两者融合成最终的历史 token:
$$\mathbf{z}_t = \eta_{\text{id}} \mathbf{z}_t^{\text{id}} + \eta_{\text{side}} \mathbf{z}_t^{\text{side}}, \tag{22}$$
其中 $\eta_{\text{id}}$、$\eta_{\text{side}}$ 是可学习的融合权重(初始化时两者相等)。最终压缩历史序列记为 $\mathbf{Z}_{1:L} = [\mathbf{z}_1, \ldots, \mathbf{z}_L]$,长度与原始 item 级历史相同,但每个 token 同时含有被保留的 SID identity 与上下文条件化的 side 信息。
训练流程
SPARC 与生成式推荐骨干联合优化,而 item tokenizer 与目标 SID 空间保持不变。对每个 mini-batch,SPARC 先把多字段历史输入转换成上下文条件化的 item 级 token,再由骨干用它们预测目标 SID 序列。
Algorithm 1(SPARC 训练流程):
Require: 历史字段 E_{1:L},目标 SID s_y = (s_y^1, ..., s_y^K),参数 ψ, θ
Ensure: 优化后的 ψ, θ
 1: for each mini-batch do
      ▷ FCM
 2:     由 Eq.(10) 构建 {X^f}_{f=1}^F
 3:     由 Eq.(11) 编码 {H^f}_{f=1}^F
      ▷ CAR
 4:     由 Eq.(12) 保留 I_{1:L}
 5:     由 Eqs.(13)-(14) 计算 r_t^f 与 α_{t,r}^f
 6:     由 Eqs.(16)-(15) 计算 v_t^f 与 g_t^r
 7:     由 Eq.(17) 构成 M_{1:L}
      ▷ STC
 8:     由 Eq.(18) 展平 M_{1:L}
 9:     由 Eq.(19) 编码 M̄_{1:L}
10:     由 Eq.(20) 更新 M̂_{1:L}
11:     由 Eqs.(21)-(22) 融合 Z_{1:L}
      ▷ Generation
12:     对 k = 1, ..., K 预测 p_θ(s_y^k | Z_{1:L}, s_y^{<k})
13:     L ← -Σ_{k=1}^K log p_θ(s_y^k | Z_{1:L}, s_y^{<k})
14:     关于 L 优化 ψ, θ
15: end for
具体地:FCM 先按字段类型重组历史字段并对每条字段维序列编码,得到上下文化字段表征;CAR 把 SID 字段保留为 identity token,并按上下文感知的路由权重把 side 字段路由到中间 token;STC 进一步建模中间 token 序列,把 identity 与 side 摘要融合成压缩历史序列 $\mathbf{Z}_{1:L}$;最后骨干在 $\mathbf{Z}_{1:L}$ 条件下预测目标 SID token,SPARC 与骨干的参数通过最小化自回归推荐损失联合更新。
因此,SPARC 只改变历史交互的表征方式,不改变目标 SID 生成目标——这是它可以作为即插即用前置模块套在已有生成式骨干上的关键。
实验设置
论文围绕四个研究问题组织实验:
- RQ1:SPARC 相比已有生成式推荐方法表现如何?
- RQ2:对多字段历史建模,上下文条件化压缩是否比静态压缩策略更有效?
- RQ3:CAR 的各个 slot 之间是否存在分工?
- RQ4:同一个 item 的 CAR slot 权重在不同上下文下是否真的不同?
数据集
| Dataset | #Users | #Items | #Interactions | Sparsity |
|---|---|---|---|---|
| TaoBao | 21 million | 0.27 billion | 26 billion | 99.99% |
| Beauty | 22363 | 12101 | 198502 | 99.93% |
| Toys | 19412 | 11924 | 167597 | 99.93% |
- TaoBao(工业数据集):从淘宝生产环境采集 6 月 16 日一天 的真实交互数据,规模达 210 亿用户 / 2.7 亿 item / 260 亿交互。
- Beauty / Toys(公开数据集):Amazon Review 数据集的两个子集。按常见做法做 5-core 过滤,用 leave-one-out 划分:每个用户最后一次交互做测试,倒数第二次做验证,之前所有交互做训练。序列构造时最大历史长度设为 50,短序列 padding,长序列截断保留最近交互。
Baseline
传统推荐方法:
- YouTubeDNN:对历史 item embedding 做平均得到紧凑用户向量做高效候选召回
- SASRec:用 Transformer 自注意力建模序列用户行为
- BERT4Rec:用 BERT 式掩码预测目标做序列推荐,通过重构用户序列中的掩码 item 学习上下文化 item 表征
- Caser:在用户交互序列上施加卷积滤波器,捕捉局部模式与更广的序列信号
- NextItNet:用扩张卷积捕捉长程序列依赖
- CORE:通过 item embedding 的线性加权聚合学习 session 表征,把 session 与 item 表征对齐到同一隐空间
生成式推荐方法:
- HSTU:把召回形式化为序列转导任务,利用特征冗余提升计算效率
- TIGER:代表性生成式检索方法,用 semantic identifier + seq2seq 建模生成用户下一个交互 item
- FORGE:在 semantic identifier 生成中考虑协同信息与 ID 碰撞问题,提升 SID 的有效性与利用率
- RankGR:用 listwise 直接偏好优化建模层次化用户偏好,并用轻量打分模块基于用户行为序列精修 top-ranked 候选
评估指标
对工业 TaoBao 数据集,沿用 RankGR 的做法采用 Hit Rate (HR) 作为主要召回指标。给定 top-$K$ 召回集合 $\mathcal{I}_u^K$ 与用户 $u$ 的真实交互 item 集合 $\mathcal{I}_u^{\text{truth}}$:
$$\text{HR}@K = \frac{1}{|\mathcal{U}|} \sum_{u \in \mathcal{U}} \frac{\left|\mathcal{I}_u^K \cap \mathcal{I}_u^{\text{truth}}\right|}{\left|\mathcal{I}_u^{\text{truth}}\right|}, \tag{23}$$
其中 $\mathcal{U}$ 是用户集合。为在不同行为级反馈信号下评估模型,论文分别报告 click 与 pageview 行为下的 HR,记作 $\text{HR}^{\text{Click}}@K$ 与 $\text{HR}^{\text{PV}}@K$,取 $K = 20$ 与 $K = 1000$。公开数据集上报告 HR@20、HR@50、HR@100、HR@500。
实现细节
- 所有 baseline 遵循 RankGR 的实现与实验设置以保证公平比较;
- SPARC 建在 RankGR 生成式推荐骨干之上,RankGR 同时作为骨干与最强 baseline;
- 每次历史交互用 9 个字段表示:2 个 SID 字段 + 7 个 side 字段;
- 2 个 SID 字段直接保留为 identity token,7 个 side 字段路由到 $R = 2$ 个 side slot,因此每次交互在序列级合并前由 4 个中间 token 表示;
- FCM 的字段维上下文编码器与 STC 的序列级编码器均实现为 2 层 Transformer 编码器;
- 为稳定训练,序列级残差门初始化为 logit $-5$,让 STC 的精炼在优化早期被逐步引入;
- identity 与 side 摘要的融合权重初始化为相等;
- 除非特别说明,所有数据集使用相同的 SPARC 超参数。
主要实验结果(RQ1)
Table 1: Overall performance comparison between baselines and SPARC. SPARC 建在 RankGR 之上。粗体为最佳,下划线为次佳。
| Dataset | Metric | YouTubeDNN | SASRec | BERT4Rec | Caser | NextItNet | CORE | HSTU | TIGER | FORGE | RankGR | SPARC |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| TaoBao | $\text{HR}^{\text{click}}@20$ | 0.0337 | 0.0496 | 0.0503 | 0.0429 | 0.0487 | 0.0557 | 0.0570 | 0.1008 | 0.1283 | 0.1568 | 0.1669 |
| TaoBao | $\text{HR}^{\text{click}}@1000$ | 0.1164 | 0.1670 | 0.1676 | 0.1567 | 0.1644 | 0.2012 | 0.2022 | 0.3604 | 0.4666 | 0.5777 | 0.5883 |
| TaoBao | $\text{HR}^{\text{PV}}@20$ | 0.0149 | 0.0218 | 0.0181 | 0.0167 | 0.0172 | 0.0224 | 0.0323 | 0.1023 | 0.1335 | 0.1562 | 0.1670 |
| TaoBao | $\text{HR}^{\text{PV}}@1000$ | 0.1183 | 0.2160 | 0.2266 | 0.2039 | 0.2071 | 0.2309 | 0.2490 | 0.4171 | 0.4896 | 0.6228 | 0.6319 |
| Beauty | HR@20 | 0.0357 | 0.0372 | 0.0370 | 0.0355 | 0.0351 | 0.0302 | 0.0374 | 0.0209 | 0.0435 | 0.0466 | 0.0794 |
| Beauty | HR@50 | 0.0671 | 0.0706 | 0.0711 | 0.0664 | 0.0661 | 0.0669 | 0.0714 | 0.0496 | 0.0761 | 0.0784 | 0.1311 |
| Beauty | HR@100 | 0.0919 | 0.0976 | 0.0979 | 0.0909 | 0.0902 | 0.0919 | 0.0993 | 0.0590 | 0.1088 | 0.1117 | 0.1843 |
| Beauty | HR@500 | 0.1967 | 0.2119 | 0.2121 | 0.1953 | 0.1956 | 0.2135 | 0.2167 | 0.1312 | 0.2250 | 0.2289 | 0.3571 |
| Toys | HR@20 | 0.0340 | 0.0353 | 0.0351 | 0.0338 | 0.0334 | 0.0287 | 0.0355 | 0.0199 | 0.0414 | 0.0443 | 0.0743 |
| Toys | HR@50 | 0.0629 | 0.0662 | 0.0667 | 0.0622 | 0.0620 | 0.0627 | 0.0669 | 0.0465 | 0.0714 | 0.0735 | 0.1279 |
| Toys | HR@100 | 0.0834 | 0.0886 | 0.0888 | 0.0826 | 0.0819 | 0.0834 | 0.0901 | 0.0535 | 0.0988 | 0.1014 | 0.1795 |
| Toys | HR@500 | 0.1886 | 0.2032 | 0.2034 | 0.1873 | 0.1875 | 0.2047 | 0.2078 | 0.1258 | 0.2158 | 0.2195 | 0.3605 |
结论分析:
- SPARC 在所有数据集所有指标上都取得最佳性能,验证了上下文条件化历史压缩的有效性。论文特别指出,TaoBao 上的提升相对温和(如 $\text{HR}^{\text{click}}@20$ 从 0.1568 到 0.1669,+6.4%),原因很可能是其海量交互规模本身已经缓解了表征瓶颈;而更稀疏的公开数据集从自适应信息保留中获益更多——Beauty HR@20 从 0.0466 涨到 0.0794(+70.4%),Toys HR@20 从 0.0443 涨到 0.0743(+67.7%)。这个"稀疏数据获益更大"的解释符合直觉:数据越稀疏,单纯靠海量交互统计弥补表征损失的余地越小。
- SPARC 相对 RankGR 骨干的稳定增益直接验证了压缩框架本身的价值。 由于 SPARC 就建在 RankGR 上,两者之差是干净的增量归因:更好的历史交互表征能在不改变骨干的前提下进一步增强生成式检索。
- 生成式方法总体优于传统方法,尤其在更大的截断处(如 HR@500 / HR@1000)。论文归因于基于 SID 的生成引入了编码先验语义或协同信息的结构化 item token,改善了长尾泛化,也支持更全局的 token 级判别。注意 TIGER 是个例外:它在两个公开数据集上反而低于所有传统 baseline(Beauty HR@20 仅 0.0209),说明纯语义 SID 而不引入协同信号在这些数据上并不占优,这与 FORGE 强调协同信息的动机一致。
消融实验(RQ2)
为验证 SPARC 的设计动机,论文把它与 RankGR 以及若干建在同一生成式骨干上的静态压缩受控变体做对比。这些变体引入不同的静态压缩策略处理多字段历史交互,从而检验"是否只要压缩器更强就够了"。
具体变体:
- w/ MLP:把每次交互的字段表征拼接起来,通过一个 MLP-based 压缩器变换成单个历史 token;
- w/ QFormer:采用轻量的 query-based Transformer 压缩器,可学习的 query token 通过 cross-attention 与字段表征交互,产出压缩表征;
- w/ Modulated:把每个 content 字段投影到专属子空间,用交互的 context 字段(如 recency、behavior type)通过学习到的缩放因子调制拼接后的 content 表征,再投影进压缩 token。
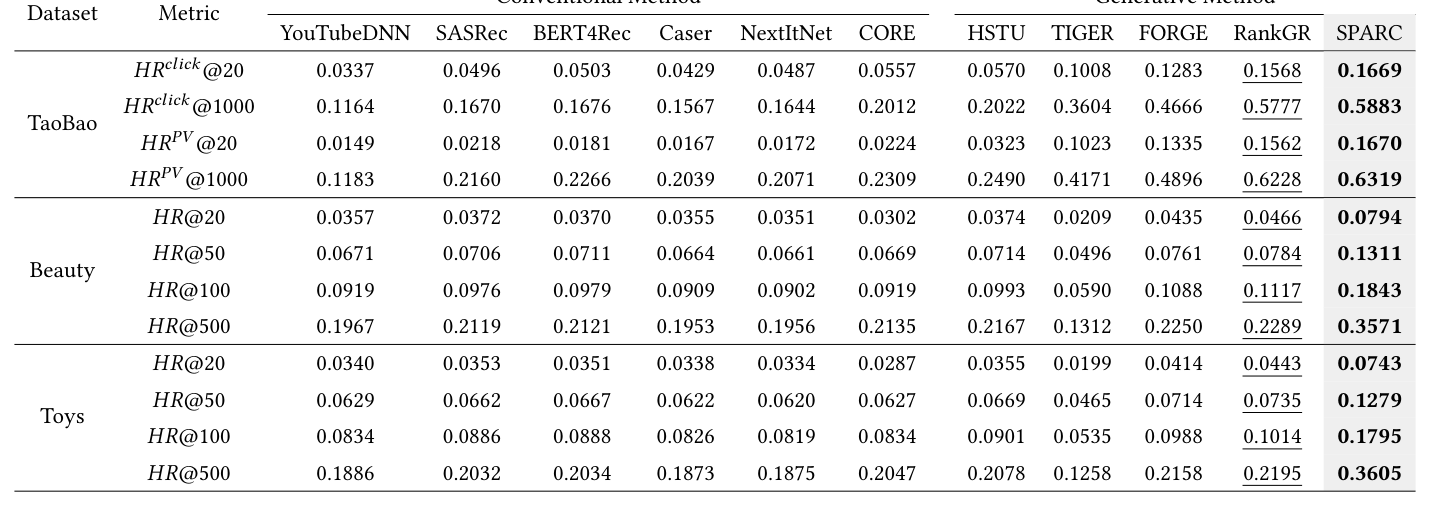
Table 2: SPARC 在 TaoBao 数据集上的消融实验
| Method | $\text{HR}^{\text{click}}@20$ | $\text{HR}^{\text{click}}@1000$ | $\text{HR}^{\text{PV}}@20$ | $\text{HR}^{\text{PV}}@1000$ |
|---|---|---|---|---|
| SPARC | 0.1669 | 0.5883 | 0.1670 | 0.6319 |
| RankGR | 0.1568 | 0.5777 | 0.1562 | 0.6228 |
| w/ MLP | 0.1576 | 0.5796 | 0.1604 | 0.6269 |
| w/ QFormer | 0.1609 | 0.5835 | 0.1633 | 0.6302 |
| w/ Modulated | 0.1560 | 0.5762 | 0.1585 | 0.6234 |
结论分析:
- 静态压缩带来的提升有限。 相比 RankGR,部分静态变体确实取得更好性能(如 w/ QFormer 的 $\text{HR}^{\text{click}}@20$ 0.1609 vs 0.1568),说明改进压缩函数本身对多字段历史建模是有帮助的。但收益相对较小且在不同设计间不一致,说明压缩器容量本身不是关键因素。
- 更复杂的压缩不保证更好的结果。 静态变体中 QFormer 表现最好,而 MLP 与 Modulated 只带来边际收益甚至在部分指标上轻微退化(w/ Modulated 的 $\text{HR}^{\text{click}}@20$ 0.1560 已低于 RankGR 的 0.1568,$\text{HR}^{\text{click}}@1000$ 0.5762 也低于 0.5777)。这表明当压缩过程不由序列上下文引导时,用更强的静态压缩器直接变换多字段表征可能引入不必要的扭曲。w/ Modulated 的失败尤其说明问题:它已经用了 context 字段(recency、behavior type)去调制 content 字段,但这种调制只用了当前交互内部的上下文,没有沿序列的上下文,反而不如什么都不做。
- SPARC 稳定优于所有静态变体,且在所有指标上最优。 由于所有变体都建在同一生成式骨干上,SPARC 的优越性验证的是上下文条件化信息保留的有效性,而非仅仅增大压缩模块的表达能力。这是本文消融设计上最值得肯定的一点:它明确排除了"提升只是因为多加了参数"这一竞争解释。
深入分析:路由行为(RQ3 & RQ4)
由于 SID 字段被显式保留为 identity token、不参与 side 字段路由,分析集中在 side 字段的路由分布上。论文做了两项分析:slot 级路由分析(不同 side slot 是否学到差异化的字段偏好)与同一 item 跨上下文的 case study(路由分布是否随用户上下文改变)。
Slot 级路由模式
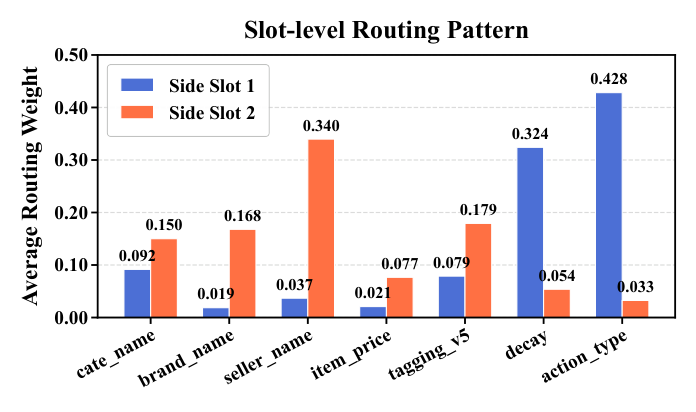
对每个 side slot,把它在评估集上所有交互的路由权重取平均,得到该 slot 的字段级路由分布。7 个 side 字段分别是 cate_name(类目)、brand_name(品牌)、seller_name(卖家)、item_price(价格)、tagging_v5(标签)、decay(时间衰减 / recency)、action_type(行为类型)。
平均路由权重(Figure 3):
| Side Field | Side Slot 1 | Side Slot 2 |
|---|---|---|
| cate_name | 0.092 | 0.150 |
| brand_name | 0.015 | 0.168 |
| seller_name | 0.037 | 0.340 |
| item_price | 0.021 | 0.077 |
| tagging_v5 | 0.079 | 0.179 |
| decay | 0.324 | 0.054 |
| action_type | 0.428 | 0.033 |
结论分析:
- 两个 side slot 学到了明显不同的路由模式。 Side Slot 1 给
action_type(0.428)与decay(0.324)分配了远大的权重,而 Side Slot 2 主要关注seller_name(0.340),并给brand_name(0.168)、tagging_v5(0.179)、cate_name(0.150)相对更高的权重。这说明两个可学习的 side slot 没有坍缩成冗余副本,而是发展出保留互补 side 信息的、有意义的分工——Slot 1 承担"交互上下文"(何时、何种行为),Slot 2 承担"item 属性"(谁卖的、什么品牌类目)。 - 上下文相关与卖家相关的字段获得主导路由权重。 在所有 side 字段中,
action_type、decay、seller_name得到最显著的路由权重。这说明 CAR 倾向在压缩时保留行为上下文信号与卖家相关信息。论文认为这与直觉一致:行为类型与 recency 描述的是当前交互上下文,而卖家在工业推荐场景中是区分 item 的重要属性信号。反过来看,item_price在两个 slot 上的平均权重都很低(0.021 / 0.077),与 Figure 1 中"价格在特定上下文下很重要"的动机形成一定张力——说明价格的重要性可能高度依赖上下文,平均后被稀释。
同一 item 的上下文相关路由
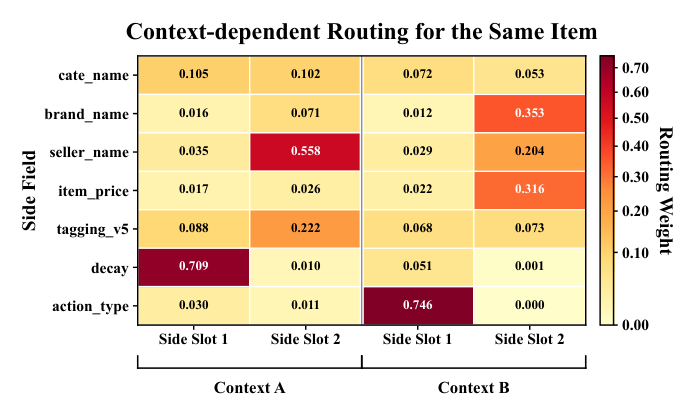
为验证 CAR 是否真的对同一 item 在不同用户历史下产生不同路由,论文挑选一个出现在两段差异显著的历史上下文中的 item,可视化它在每个上下文下的 side slot 路由权重。
路由权重(Figure 4):
| Side Field | Ctx A / Slot 1 | Ctx A / Slot 2 | Ctx B / Slot 1 | Ctx B / Slot 2 |
|---|---|---|---|---|
| cate_name | 0.105 | 0.102 | 0.072 | 0.053 |
| brand_name | 0.016 | 0.071 | 0.012 | 0.353 |
| seller_name | 0.035 | 0.558 | 0.029 | 0.204 |
| item_price | 0.017 | 0.026 | 0.022 | 0.316 |
| tagging_v5 | 0.088 | 0.222 | 0.068 | 0.073 |
| decay | 0.709 | 0.010 | 0.051 | 0.001 |
| action_type | 0.030 | 0.011 | 0.746 | 0.011 |
结论分析:
- 同一 item 的路由分布随上下文变化。 尽管 item 身份固定,其 side slot 路由权重在不同用户历史下差异巨大。例如 Side Slot 1 在 Context A 中主要关注
decay(0.709),在 Context B 中却转向action_type(0.746)。这说明 CAR 不是给 item 分配一个静态的 side 信息表征,而是根据周围的行为序列动态调整保留哪些字段——这正是本文相对静态 SID 的核心主张的直接证据。 - 同一上下文内不同 slot 表现出不同的字段偏好。 在同一用户上下文下,两个 side slot 也关注不同字段。Context A 中 Slot 1 聚焦
decay,Slot 2 给seller_name(0.558)、tagging_v5(0.222)更高权重;Context B 中 Slot 1 聚焦action_type,Slot 2 则强调brand_name(0.353)、item_price(0.316)、seller_name(0.204)。这表明 side slot 学到的是互补角色而非冗余的路由模式,与 Figure 3 的统计结论一致。特别值得注意的是 Context B 中item_price的权重从 Context A 的 0.026 跃升到 0.316,恰好复现了 Figure 1 Case B 的动机场景。
核心贡献总结
- 问题诊断:明确指出生成式推荐中静态分配的 SID 无法编码动态 item 状态与交互级上下文,而显式 token 化又造成 $O(LF)$ 的上下文扩张;把关键矛盾归结为"字段重要性依赖序列上下文"这一可验证的命题(Figure 1 / Figure 4)。
- "先上下文化再压缩"原则:把压缩过程拆成"沿字段维引入序列上下文(FCM)→ 上下文条件化路由(CAR)→ 跨交互精炼与合并(STC)"三个渐进阶段,用低成本在压缩前完成上下文化。
- SID 与 side 字段的显式解耦:SID 字段被直接保留为 identity token 不参与路由,side 字段才走 softmax 路由,从而在压缩中同时保住稳定 item identity 与自适应的 side 信息。
- 两个正确的归纳偏置:CAR 的 value 残差投影(Eq. 16)让模块学"如何路由"而非"如何重写";STC 的门控残差(Eq. 20,$\lambda$ 初始化为 logit $-5$)让跨交互精炼渐进引入,避免早期破坏压缩 token 空间。
- 排除竞争解释的消融设计:把 SPARC 与 MLP / QFormer / Modulated 三种静态压缩变体在同一骨干上对比,证明收益来自上下文条件化而非压缩模块容量增大。
- 可解释的路由证据:slot 级统计与同 item 跨上下文 case study 共同说明 slot 学到了分工且路由确实随上下文变化。
- 即插即用:SPARC 只改变历史表征方式,不改变 item tokenizer 与目标 SID 生成目标,可套在已有生成式骨干(本文为 RankGR)之上并与之端到端联合训练。
与已归档相关工作的对比
IAT IAT: Instance-As-Token Compression for Historical User Sequence Modeling (ByteDance, 2026-04-10)
关系:独立并发(本文未引用 IAT,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇论文指向同一个 root cause——序列里的每个历史 token 只装得下一次交互的极小信息子集。IAT 的诊断是工业排序模型的行为序列特征是从候选特征集中人工挑出的稀疏子集,受存储与计算约束,细粒度特征(价格、频率等)被排除在外,构成"信息瓶颈";SPARC 的诊断是静态 SID 无法编码动态 item 状态与交互上下文,而把字段全展开又会把序列长度放大 $F$ 倍。二者都把矛盾归结为"固定 token 预算 vs 单次交互的完整多字段语境",也都选择了同一个出口:把一次历史交互压缩成一个 token,而不是加长序列。
- 相近的技术骨架:两者的方法流程图高度重合——(1) 取一次历史交互的多字段/全量特征;(2) 经一个压缩模块降到单个 $d$ 维向量;(3) 用一个跨交互的 Transformer 在这些压缩 token 之间做序列建模;(4) 把结果送进下游主模型。IAT 的 InsEmb($D = 64$)对应 SPARC 的 $\mathbf{z}_t$;IAT 的 Source Instance Transformer (SIT) 对应 SPARC 的 STC(都是在压缩 token 序列上加一层轻量 Transformer,且都强调不能只做逐样本独立压缩)。更巧的是,IAT 论文自己也发现了"逐样本独立压缩不够":其 Temporal-Order Source Model 逐条独立压缩,性能有轻微下降,因此才提出 User-Order Source Model 引入 SIT 让同一用户的历史实例之间信息流动——这与 SPARC 消融中"静态压缩(w/ MLP / w/ Modulated)收益有限甚至退化"的结论是同一现象的两次独立发现。
- 本文的差异与推进:(1) 场景不同:IAT 面向判别式 CTR/CVR 排序(BCE 损失、AUC/LogLoss 指标),SPARC 面向生成式推荐(自回归 SID 生成、HR 指标),因此 SPARC 必须额外处理"SID 作为 item identity 不能被稀释"这一约束,方案是把 SID 字段排除在路由之外直接保留(Eq. 12),IAT 没有这个约束也就没有对应设计。(2) 上下文化的位置不同:IAT 的 SIT 是在压缩之后对已成型的 InsEmb 做跨实例交互,压缩本身仍是逐样本静态的(Eq. 4 只吃 $h$);SPARC 的 FCM 是在压缩之前沿字段维引入序列上下文,路由权重 $\alpha_{t,r}^f$ 直接依赖上下文化表征 $\mathbf{h}_t^f$。换言之 IAT 是"压缩→上下文化",SPARC 是"上下文化→路由压缩→再上下文化",后者的字段选择本身就是上下文相关的。(3) 端到端性不同:IAT 是显式两阶段架构,InsEmb 由 source model 产出后写入 Parameter Server,下游模型再检索使用,历史 InsEmb 只做前向不回传梯度(stop-gradient);SPARC 与骨干完全联合优化,不存在离线固化的中间表征。按精读评分标准里"参数量 scaling 时表征能力与序列建模能力能否一起增长"的判据,SPARC 在这条轴上明显优于 IAT/SIF 那一派的两阶段解耦范式。
- 可比的方法 / 实验差异:IAT 有完整的工业线上收益(多个字节广告场景,离线 AUC +0.24%~+0.31%、LogLoss 最高降 0.67%,并给出参数量与 FLOPs 开销),而 SPARC 完全没有线上 A/B,只有一天的 Taobao 离线数据,且未报告任何计算开销。反过来,SPARC 提供了 IAT 缺乏的可解释性证据(slot 级路由统计 + 同 item 跨上下文 case study),能直接展示"保留了什么、为什么";IAT 的 InsEmb 是黑箱压缩向量,无法回答这个问题。两者在消融的严谨度上各有取舍:IAT 有 Temporal-Order vs User-Order 的组件级对照,SPARC 有静态 vs 上下文条件化的对照,但SPARC 缺少 FCM / CAR / STC 三个模块各自的消融。
SIF SIF: Sample Is Feature — 从 Item-Level 到 Sample-Level 的统一大规模推荐模型 (Meituan, 2026-04-17)
关系:独立并发(本文未引用 SIF,两者殊途同归)· 已加载对方精读
- 共同关注的问题:SIF 的问题陈述与 SPARC 几乎逐句对应——历史 token 只保留 bare item embedding 或少量人工挑选特征,大量原始样本语境被丢弃;SIF 举的例子是"凌晨优惠券激活时的点击"与"正午吃饭高峰的点击"在 bare item ID 下完全一致但真实请求上下文天差地别,这与 SPARC Figure 1 中"同一 item 在 Case A / Case B 两种历史下字段重要性完全不同"是同一个论证。两者都认定瓶颈不在数据可得性而在表征方式,都要在不炸掉序列长度的前提下把每次交互的多字段语境塞进一个 token。
- 相近的技术骨架:SIF 的流程是 Sample Tokenizer(把 Raw Sample 压成 Token Sample)→ SIF-Mixer(token 级 + 样本级分解注意力),SPARC 的流程是 FCM/CAR(把多字段压成中间 token)→ STC(跨交互 + 交互内合并)。两者甚至在分组策略上撞车:SIF 把 Raw Sample 按语义切成 $G = 4$ 组(user / item / ctx / cross),并强调高基数强 ID 应独占一组"以确保其判别信号不会被共享码本里的低基数特征稀释";SPARC 把字段切成 $\mathcal{F}_{\text{sid}}$ 与 $\mathcal{F}_{\text{side}}$ 两组,并把 SID 完全排除在路由之外——这是同一条设计原则(强身份信号必须隔离保护)在两套系统里的独立实现。两者也都用"先压成少量 sub-token / 中间 token,再在其上做两级注意力"的分层结构。
- 本文的差异与推进:(1) 压缩机制根本不同:SIF 用离线量化(HGAQ:组内自适应 sub-token 划分 + 每 sub-token 独立码本的 $M$ 层 RVQ,$V = 256$、$d_0 = 16$),在线只存 int 索引查表;SPARC 用在线可微路由(softmax 权重 $\alpha_{t,r}^f$ 在所有 side 字段上归一化),没有码本也没有离散化。这带来一个关键差别:SIF 的 Token Sample 一旦离线量化就固定了,同一条历史样本在任何后续上下文下都是同一串码;SPARC 的 $\mathbf{z}_t$ 随所在序列上下文变化(Figure 4 直接展示了这一点)。SIF 是静态压缩(对应 SPARC 消融里被否定的那一类),SPARC 是上下文条件化压缩——若 SPARC 的消融结论成立,它恰好是对 SIF 这条路线的一个反驳性论据。(2) 端到端性:与 IAT 同理,SIF 的 Sample Tokenizer 是离线的,压缩器与下游模型无法联合优化;SPARC 全程联合训练。(3) 任务形态:SIF 服务判别式 CTR 排序(GAUC 指标),SPARC 服务生成式 SID 检索。
- 可比的方法 / 实验差异:SIF 有完整工业闭环——相对 HyFormer 最多 +0.88% GAUC,线上 A/B +2.03% CTR / +1.21% CVR / +1.35% GMV/session,已部署到美团外卖排序管线;SPARC 没有任何线上结果。SIF 也更认真地处理了工程可行性(离线量化保证在线只需查表,存储成本明确),而 SPARC 的 STC 需要在长度为 $4L$ 的展平中间 token 序列上跑一个 2 层 Transformer——这个序列比骨干自己的 $L$ 还长,论文却完全没有讨论这部分开销,是它相对 SIF/IAT 最薄弱的地方。反过来,SPARC 在方法论上更"干净":不引入离散码本,不存在码本固化限制下游表征空间的问题。
讨论与局限性
值得借鉴的设计
- "先上下文化再压缩"是一个可迁移的原则。 论文最核心的贡献不是某个具体模块,而是把"压缩"从一个静态的降维操作重新定义为一个上下文条件化的选择过程。这个原则不限于生成式推荐——任何需要在固定 token 预算内塞进多源异构信息的场景(多模态输入压缩、长文档摘要 token、Agent 上下文压缩)都适用。
- 强身份信号必须隔离保护。 SID 字段被排除在路由外直接保留(Eq. 12),避免了 item identity 被 side 信息稀释。SIF 用"高基数 ID 独占码本组"独立得出了同一原则。这个模式值得作为一条经验法则记住:做特征混合/压缩时,判别性最强的那个字段应当走旁路而不是走混合路径。
- 残差化的两处设计。CAR 的 value 残差投影(Eq. 16)把"选择"与"重写"解耦;STC 的门控残差 + logit $-5$ 初始化(Eq. 20)让新引入的跨交互模块从近似恒等开始渐进生效。后者是训练稳定性上很实用的技巧,尤其适用于往一个已收敛的骨干上加前置模块的场景。
- 消融要排除竞争解释。 SPARC 没有只做 "w/o CAR" 式的自我消融,而是构造了三个参数量相当甚至更大的静态压缩对照(MLP / QFormer / Modulated),从而把"提升来自上下文条件化"与"提升来自加了参数"这两个解释分开。这是本文实验设计上最专业的一笔。
局限与争议
-
完全没有线上 A/B 实验。 这是一篇来自阿里、用淘宝生产数据的工业论文,却只报告离线指标。对一个宣称解决工业场景表征瓶颈的方法,缺少线上收益让"工业价值"这一维度基本无法验证。且 TaoBao 数据只取了一天(6 月 16 日),无法反映跨天/跨周的分布漂移,而 SPARC 恰恰声称要捕捉的
decay、action_type这类时间敏感信号在单日窗口内变化范围有限。 -
缺少模块级消融,三个贡献从未被单独验证。 论文提出 FCM / CAR / STC 三个模块,但 Table 2 只对比了 SPARC 整体 vs 静态压缩变体,没有 w/o FCM、w/o CAR、w/o STC 的结果。因此无法回答:收益主要来自 FCM 的字段维上下文建模,还是 CAR 的路由,还是 STC 的跨交互精炼?考虑到 STC 本身就是一个跑在 $4L$ 长序列上的 2 层 Transformer,一个合理的怀疑是部分收益可能仅来自这个额外的序列模块本身,而与"路由"无关。同样缺失的还有:side slot 数 $R$ 的敏感性分析(论文只用了 $R = 2$)、编码器层数的影响、字段数 $F$ 的影响。
-
完全没有效率分析,而这恰是论文的立论基础。 SPARC 的核心卖点是"不增加生成式骨干的输入长度",这一点成立。但论文全文没有任何 FLOPs、参数量、训练时间或推理延迟的数字。而 SPARC 引入的开销并不小:FCM 要对 $F = 9$ 条长度为 $L$ 的字段维序列各跑一个 2 层 Transformer,STC 要在长度 $4L$ 的展平序列上再跑一个 2 层 Transformer——STC 的输入序列是骨干输入的 4 倍长。论文在引言里花了大量篇幅论证全展开方案的 $O((LF)^2)$ 注意力成本不可接受,却对自己方案的实际成本只字不提,这是论证上的明显不对称。省下的是骨干的 token 预算,付出的是前置模块的算力,净收益如何完全未知。
-
公开数据集上的提升幅度异常巨大且未被解释。 Beauty HR@20 从次佳的 0.0466 提升到 0.0794(+70.4%),Toys 从 0.0443 到 0.0743(+67.7%),HR@500 更是接近翻倍(0.2289 → 0.3571)。对一个"只改变历史表征方式、骨干不变"的前置压缩模块,这个量级远超合理预期(TaoBao 上的同类提升只有 +6% 量级)。论文只用"稀疏数据集从自适应信息保留中获益更多"一句带过,缺乏进一步证据。更棘手的是:Amazon Beauty / Toys 数据集并不天然具备 9 个字段(尤其是
seller_name、decay、action_type、tagging_v5这些在 Figure 3 中获得最高路由权重的字段),而论文声明"除非特别说明,所有数据集使用相同的 SPARC 超参数",却从未说明公开数据集上这 9 个字段具体是什么、如何构造。若这些字段是从 Amazon metadata 或时间戳派生出来的额外信息,那么 SPARC 相对 baseline 就存在信息不对等——baseline 只看到 item 序列,SPARC 额外看到了多个 side 字段,这足以解释异常大的增益,也就意味着 Table 1 的公开数据集部分不是干净的受控对比。这是本文最需要补充说明的地方。 -
路由分析只有定性证据。 Figure 3 / Figure 4 说明路由分布随上下文变化且 slot 有分工,但没有量化"这种差异化到底贡献了多少性能"。例如可以做的实验:把路由权重冻结成全局平均(消除上下文依赖)后重跑,看指标掉多少。此外 Figure 4 只挑了一个 item、两个上下文,样本量为 1,说服力有限。另有一处细节张力:Figure 3 显示
item_price的平均路由权重在两个 slot 上都很低(0.021 / 0.077),而 Figure 1 的动机故事恰恰是以 price 为主角的 Case B——论文没有解释这个不一致(合理解释是 price 的重要性高度上下文相关,平均后被稀释,Figure 4 的 Context B 中 price 权重确实跃升至 0.316,但论文自己没有把这两张图串起来讲)。 -
路由归一化方向的设计未被论证。 Eq. 14 的 softmax 在字段维上归一化(每个 slot 在所有 side 字段上分配注意力),而非在 slot 维上归一化。这意味着单个字段可以同时被多个 slot 高权重吸收,也可能有字段被所有 slot 忽略(
item_price在 Figure 3 中就接近这个状态)。另一种自然的设计是在 slot 维归一化(每个字段决定去哪个 slot,即标准 MoE 式路由)。论文没有比较两种方向,也没有加任何负载均衡正则来防止字段被完全忽略。 -
写作与投稿状态。 论文使用的是未填充的 ACM 会议模板("Conference acronym 'XX"、"© 2018 Copyright"、"Received 20 February 2007"),Figure 3 与 Figure 4 的物理排版顺序与编号相反,属于未经打磨的预印本。此外 Table 3 中 TaoBao 的 "#Users 21 million / #Items 0.27 billion / #Interactions 26 billion" 与正文描述的"一天数据"之间量级关系存疑(260 亿交互 / 2100 万用户 ≈ 每人每天 1238 次交互),至少需要说明这里统计的是 impression 还是 click。
与已有工作的定位
SPARC 处在"多字段历史交互的 token 级压缩"这条 2026 年上半年快速升温的赛道上。这条线的共同起点是:工业推荐的序列 token 太"瘦"(只有 item embedding),而把它变"胖"的代价是序列变长。已归档的 IAT(ByteDance)、SIF(Meituan)与本文(Alibaba)在三个月内独立给出了三套方案,都收敛到"一次交互 = 一个压缩 token"这个共同答案,但在压缩何时发生上分道扬镳:IAT 与 SIF 都是"离线/先压缩,再在下游建模"(IAT 存 InsEmb 到 PS,SIF 存 RVQ 码本索引),SPARC 是"在线、上下文条件化、与骨干联合训练"。
SPARC 在方法论可扩展性上是这三者中最好的——没有离线固化的中间表征,压缩器与骨干可以一起 scaling,不存在码本一旦训好就限制下游表征空间的问题。但它也是工程落地证据最弱的一个:另外两篇都有明确的线上 A/B 收益与部署描述,SPARC 一个都没有,而且它的在线成本($4L$ 长度的 STC)恰恰是另外两篇通过离线化刻意规避掉的那部分。换句话说,SPARC 选了一条方法上更优雅、但工程上更难的路,而论文并未证明这条路在工业系统里跑得动。
从与骨干的关系看,SPARC 相对 RankGR 是纯增量的前置模块,与 FORGE、TIGER 这类改造 tokenizer / SID 生成的工作是正交的:前者改"历史怎么表示",后者改"item 怎么编码",理论上可以叠加。论文自己也强调 "SPARC 不去重构目标 item 的 SID",这个定位是清晰且诚实的。
未来工作方向论文提到两点:自适应的 token 预算分配(当前 $R$ 是固定的,可以让信息量大的交互拿更多 slot)与更丰富的行为特征空间。前者尤其值得做——Figure 4 已经显示不同上下文下字段重要性差异巨大,固定 $R = 2$ 显然不是最优。