MuSeR: Scalable Long-sequence Recommendation with Multi-interest Modeling¶
Baidu 百度(北京)× 香港城市大学 × 香港中文大学,arXiv:2609.23677v1,cs.IR,2026-09-20,正文 10 页(IEEE 双栏)。 作者:Yongkang Fu, Beining Bao, Yu Jiang, Xiangyu Zhao, Hongyang Wei, Guangxing Chen, Zuodong Yang, Shantao Li, Zonggang Wu, Yuqi Lu, Shouke Qin, Hanmeng Liu, Maolin Wang(通讯,CityU HK)。第一作者及多数作者署名 Baidu。
一句话总结¶
MuSeR 是百度 APP 信息流召回侧的一次系统级集成:在已部署的 MGS(一个 NANN 风格、基于 HNSW 的多目标检索系统)之上,叠加三件既有技术——(i) 把超长行为序列按「近期原样 / 中期 16 倍池化 / 早期 64 倍池化」压进固定服务预算的分层时间压缩;(ii) 带正交正则的 $M$ 个可学习 query 多兴趣抽取;(iii) 用 ERNIE-4.0-Turbo 生成商品文本摘要、蒸馏到 ERNIE-Speed、再经 BGE 编码的多模态语义对齐——配合异步用户表示刷新 + 自适应缓存 + 分层 beam-search 检索完成线上落地,百度 APP 首页信息流 A/B 报 DAU +0.26%、总时长 +0.89%。作者自述「不提出新的建模原语,贡献是系统级集成」。
但精读后必须先说结论:这篇论文的实验设计无法支撑它的标题性主张。公开数据集把序列截断到长度 50,分层时间压缩在该设定下根本不起作用;工业数据集上唯一的大幅增益来自「给自家模型加了 baseline 没有的 LLM 文本特征」这个新信号——消融显示去掉多模态后 MuSeR 的 Recall@500 反而低于它自己的最强 baseline NANN(Home Feed 0.1636 vs NANN 0.1982)。而分层压缩本身在消融里是负贡献(相对不压缩 -0.0119)。详见「消融与分析」与「讨论与局限性」。
一、研究动机与背景¶
1.1 超长行为序列的「价值 vs 预算」张力¶
论文的出发点是工业推荐里一个被反复陈述的事实:在百度 APP 的首页「推荐」流、发现页信息流与短视频场景中,数亿 DAU 常年累积,单用户可积累到 $10^5$ 量级的跨模态行为(新闻、问答、短视频)。这些超长日志编码了稳定、细腻的长期偏好;但受限于在线延迟(作者给出的生产 SLA 是 < 300 ms)与资源,现网系统通常只截断到最近几百条行为,长期兴趣被系统性浪费。
作者把「难以部署超长序列建模」拆成四个挑战:
- 计算可扩展性:Transformer 随输入长度二次增长,$10^5$ 长度在生产 SLA 下不可行;
- 兴趣多样性与时间漂移:用户跨异构模态持有多个、有时相互冲突的兴趣;长期偏好演化慢、短期意图切换快,需要统一机制同时表达稳定性与新鲜度;
- 稀疏 ID 与多模态内容之间的对齐鸿沟:主流方法只用稀疏 item embedding,未利用文本/视频语义,序列压缩会进一步丢语义,冷启动与短视频场景尤甚;
- 工程与部署约束:必须在异步计算、缓存、负载自适应服务之间取得平衡。
1.2 与既有路线的自我定位¶
论文在 Related Work 里把既有工作分为两类并逐一指出「留在桌上的价值」:
- 两阶段检索式压缩(SIM、TWIN):先按 target 相关性检索子序列,再在过滤后的历史上做精细 attention。作者的批评是:保留下来的历史最终仍被汇总成单一用户表示,并发且冲突的兴趣只能被弱分离。
- 规模化长序列架构(LONGER):把 Transformer 式建模推到更长序列,但异构兴趣与 ID–内容语义鸿沟在在线延迟下仍难调和。
- 经典序列模型(GRU4Rec、SASRec、BERT4Rec):面向较短序列,纯 ID 表示对长程依赖与稀疏物品乏力。
- 多兴趣建模:MIND(动态路由抽取兴趣胶囊)、ComiRec 式可控框架、Re4(对比目标锐化兴趣边界)、target interest distillation、disentanglement、capsule、multi-granularity、query-aware 一脉。
- 高容量架构(KuaiFormer、HSTU):精度强但推理成本难以在实时召回里吸收。
- 语义对齐(VISTA、BGE-M3):语义表示更强,但不为序列推荐设计,也没有刻画兴趣随时间演化的机制。
- 系统侧(MARM、HNSW):MARM 研究严格 SLA 下缓存中间表示的内存–计算权衡,但假设每用户只有一个缓存状态;多兴趣服务要维护每用户多个 embedding,且各兴趣漂移速度不同、刷新节奏理应不同。HNSW 的固定相似度度量与生产排序准则可能背离。
作者的定位句是:先前工作通常只优化三个轴(压缩 / 多兴趣 / 语义对齐)中的一个,MuSeR 把三者耦合进一个端到端框架。这也是本文最诚实的一句自述——它承认自己的新意在「组合 + 落地」而非「原语」。
二、核心方法:MuSeR 框架¶
2.1 总体流程与形式化¶
MuSeR 建立在百度已部署的 MGS(Multi-target Graph-based Search) 检索框架之上。论文对 MGS 的描述只有一句:「可视为一个基于 HNSW 的 NANN 风格检索系统,支持多目标索引与搜索」,实现细节未展开(原文所引的参考文献 [13] 是 DIEN,见「讨论与局限性」的引文问题)。
系统采用离线–在线混合计算:离线模块异步把用户长期行为序列编码成多个兴趣 embedding,在线模块持续更新短期 session 行为做实时召回。
给定用户 $u$ 的交互序列 $S_u = [i_1, i_2, \ldots, i_T]$,$i_t \in \mathcal{I}$,学习目标是估计匹配函数
$$\hat{y}_{ui} = F_\Theta(S_u, i) \tag{1}$$
其中 $F_\Theta$ 把超长序列映射为用户表示 $u$,并预测 $u$ 与物品 $i$ 的交互概率。
2.2 分层时间压缩(Hierarchical Temporal Compression)¶
这是论文的第一根支柱,动机是:超长历史($10^4$–$10^5$)信息丰富但对 Transformer 过于昂贵,因此需要在保留多尺度时间信息的同时维持可计算性。
时间分段。完整序列按时间切成三段:
$$S_u = [S_u^{(r)},\, S_u^{(m)},\, S_u^{(e)}] \tag{2}$$
分别对应近期(recent)、中期(mid-term)、早期(early)行为。近期段保持原样以维持高分辨率动态,越早的段以越大的 stride 逐级池化以抑制冗余。
渐进池化。对不同时间区域施加不同下采样率:
$$S_u^{(r)} = [i_1, \ldots, i_{N_r}] \tag{3}$$
$$S_u^{(m)} = \mathrm{Pool}_{16}\big(i_{N_r+1:N_m}\big) \tag{4}$$
$$S_u^{(e)} = \mathrm{Pool}_{64}\big(i_{N_m+1:T}\big) \tag{5}$$
其中 $\mathrm{Pool}_k(\cdot)$ 表示对 $k$ 个相邻物品做 sum pooling 或 attentive pooling(论文没有说明生产中用的是哪一种,也没有对二者做消融)。压缩后的有效序列长度为
$$L_c = N_r + \frac{N_m - N_r}{16} + \frac{T - N_m}{64} \tag{6}$$
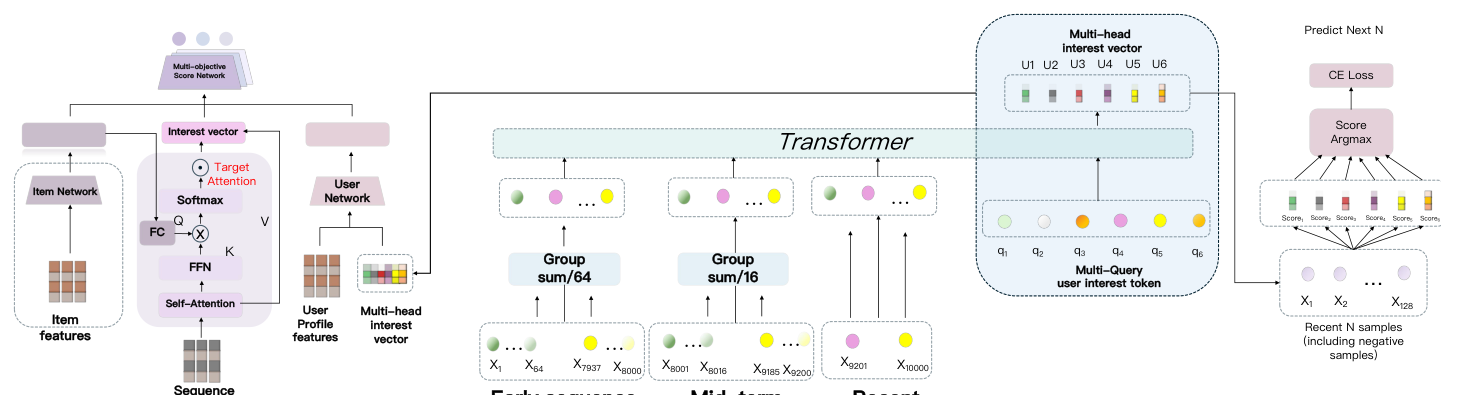
这条公式是全文最值得算一遍的地方。论文选定的生产配置是 $N_r = 800$、$N_m = 2000$,并称最优 $L_c = 1000$。代回 (6):$800 + \frac{2000-800}{16} + \frac{T-2000}{64} = 800 + 75 + \frac{T-2000}{64} = 1000$,解得 $T = 10{,}000$。Figure 2 的示意图也完全吻合:$X_1 \ldots X_{8000}$ 走 "Group sum/64"(8000/64 = 125 个 token)、$X_{8001} \ldots X_{9200}$ 走 "Group sum/16"(1200/16 = 75 个 token)、$X_{9201} \ldots X_{10000}$ 为 recent 段(800 个 token),合计 $125 + 75 + 800 = 1000$。
也就是说:摘要、引言与结论反复强调的「$10^4$–$10^5$ 交互」,在实际评估与部署配置里对应的是 $T = 10^4$。若真取 $T = 10^5$,由 (6) 得 $L_c \approx 2406$,远超论文自己扫出的最优点 1000,而 Figure 5(b) 已显示 $L_c$ 从 1000 到 1500 只有 0.0006–0.0007 的增益。$10^5$ 是一个没有被任何实验触碰过的数字。
(另注:(3) 把 recent 段写成序列开头的 $i_1 \ldots i_{N_r}$,而 Figure 2 把 recent 段画在序列末尾 $X_{9201} \ldots X_{10000}$,两处的时间方向相反。不影响理解,但反映了公式与图的校对不够。)
序列编码。每个 token 表示为物品 embedding 与位置 embedding 之和:
$$x_t = E_{\text{id}}(i_t) + E_{\text{pos}}(t) \tag{7}$$
再送入一个轻量 Transformer encoder:
$$H_u = \mathrm{TransformerEnc}\big([x_1, \ldots, x_{L_c}]\big) \tag{8}$$
输出 $H_u \in \mathbb{R}^{L_c \times d}$。
2.3 多查询兴趣抽取(Multi-Query Interest Extraction)¶
第二根支柱。动机是同一用户可能同时消费新闻、购物、短视频,意图天然多面。
$M$ 个可学习 query 向量 $\{q_1, \ldots, q_M\}$ 通过缩放点积 attention 读取上下文状态:
$$u_m = \mathrm{softmax}\!\left(\frac{q_m H_u^{\top}}{\sqrt{d}}\right) H_u, \qquad m = 1, \ldots, M \tag{9}$$
每个 $u_m$ 编码一个由不同时间或上下文模式导出的行为切面。离线训练时所有 $\{u_m\}$ 联合预测未来行为;在线推理时,检索系统按候选物品 embedding $e_i$ 自适应地组合最相关的兴趣向量:
$$\alpha_m = \frac{\exp\big(\mathrm{sim}(u_m, e_i)/\tau\big)}{\sum_n \exp\big(\mathrm{sim}(u_n, e_i)/\tau\big)}, \qquad u = \sum_m \alpha_m u_m \tag{10}$$
$\mathrm{sim}(\cdot)$ 为余弦相似度,$\tau$ 为控制兴趣锐度的温度。
这里有一处表述与公式不一致:正文说在线推理「adaptively selects the most relevant interest vector」(选择最相关的那一个兴趣向量),而 (10) 实际做的是对全部 $M$ 个兴趣做 softmax 加权求和。二者在服务侧的含义完全不同:前者是 $M$ 路 ANN 查询后合并,后者是一个 candidate-conditioned 的用户向量。更关键的是,(10) 依赖候选 $e_i$ 才能算出 $u$,这与「先有 query 向量、再查 ANN 索引」的检索流程相矛盾——在 HNSW 图上你必须先有查询向量才能找邻居。论文没有解释这个循环依赖如何解开(合理推测是只用于 §III.B 分层 beam-search 的重打分阶段,而初始种子检索用别的向量),但这是召回系统的核心环节,被完全跳过了。
2.4 多模态语义对齐(Multimodal Semantic Alignment)¶
第三根支柱,也是事后看真正贡献数字的那一根。
纯 ID 表示缺乏语义泛化、对冷启动与稀疏物品表现差。MuSeR 的做法是三段式流水线:
- 每个物品的文本描述先由 ERNIE-4.0-Turbo 经 chain-of-thought prompting 生成凝练且信息丰富的语义视角;
- 把该过程蒸馏到轻量变体 ERNIE-Speed 以规模化地降本;
- 用 BGE embedding 模型把摘要投影成稠密语义向量(实验中为 BGE-base-en,768 维;跨模态时用 Visualized-BGE / VISTA)。
最后融合内容与 ID embedding:
$$e_i = W_1 e_i^{(\text{id})} + W_2 e_i^{(\text{sem})} \tag{11}$$
融合权重初始化为 0.7 / 0.3 并端到端学习。该投影把用户意图向量与物品语义映射到统一共享空间。
2.5 训练目标¶
MuSeR 优化 next-$K$ 行为预测目标。给定正样本集 $\mathcal{P}_u$ 与采样负样本集 $\mathcal{N}_u$,损失由对比检索项与正交正则项组成:
$$\mathcal{L}_{\text{pred}} = -\sum_{m=1}^{M} \sum_{i^+ \in \mathcal{P}_u} \log \frac{\exp\big(\mathrm{sim}(u_m, e_{i^+})/\tau\big)}{\exp\big(\mathrm{sim}(u_m, e_{i^+})/\tau\big) + \sum_{i^- \in \mathcal{N}_u} \exp\big(\mathrm{sim}(u_m, e_{i^-})/\tau\big)} \tag{12}$$
$$\mathcal{L}_{\text{orth}} = \frac{1}{M^2} \sum_{m \neq n} \big\| u_m^{\top} u_n \big\|_2^2 \tag{13}$$
$$\mathcal{L} = \mathcal{L}_{\text{pred}} + \lambda\, \mathcal{L}_{\text{orth}} \tag{14}$$
第一项最大化兴趣表示与真实正样本之间的互相似度;第二项鼓励不同兴趣头之间去相关以保证多样性。训练使用 Adam + warm-up + dropout + 混合精度。
注意 (13) 中 $u_m^{\top} u_n$ 是标量,外面再套 $\|\cdot\|_2^2$ 是记号冗余(实际就是内积平方)。另外,Figure 2 的训练侧标注了 "Predict Next N / CE Loss / Score Argmax",与 (12) 的 InfoNCE 形式对不上,论文正文也没有解释 Figure 2 里 "Multi-objective Score Network" 的监督信号从何而来——多目标打分网络的训练方式在全文中是缺失的。
三、线上部署架构¶
3.1 超长序列的异步计算¶
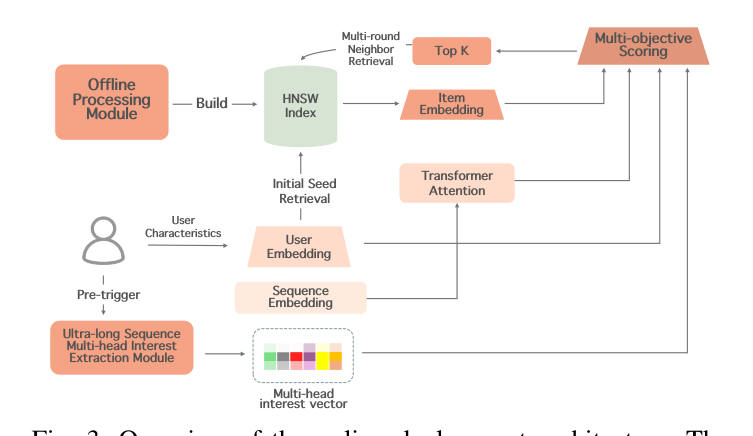
工业环境里行为序列常达数万条,实时建模不可行。MuSeR 部署一套异步缓存计算框架:超长序列 encoder 与多头兴趣抽取模块运行在双频机制下——近期短序列高频更新,长期兴趣 embedding 低频异步刷新。
具体地,用户表示 $\{u_1^{(\text{long})}, \ldots, u_M^{(\text{long})}\}$ 离线计算或按流量负载周期性刷新,存入分布式缓存供在线推理复用。实时请求只触发短期序列 encoder 输出 $u^{(\text{short})}$ 的快速计算,再用加权聚合器动态融合:
$$u^{(\text{final})} = \beta(t)\, u^{(\text{short})} + \big[1 - \beta(t)\big]\, u^{(\text{long})} \tag{15}$$
其中融合权重 $\beta(t)$ 由自适应负载监控与服务并发度决定。系统据此动态节流异步更新的 QPS,在模型效果与计算成本之间取得权衡。论文称该异构频率计算流水线「减少至多 60% 的冗余编码」。
对这一节有三个必须指出的问题:
- $\beta(t)$ 由系统负载驱动,意味着模型精度会随流量峰值静默劣化,而论文没有任何实验量化这种劣化(例如不同 $\beta$ 下的 Recall@500 曲线,或高峰/低谷时段的指标差异)。这是一个把「质量」挂到「负载」上的设计,值得专门度量,却完全没有。
- (15) 的维度不自洽:长期表示是 $M$ 个向量 $\{u_m^{(\text{long})}\}$,短期表示是单个 $u^{(\text{short})}$,融合式里却写成一对一相加。是逐头广播、还是先聚合成单向量再融合,论文未说明。
- 「减少至多 60% 冗余编码」没有任何测量支撑——无基线定义、无表格、无度量口径。
3.2 多目标检索与高效向量索引¶
在线检索服务在标准 MGS 之上扩展出受 HNSW 启发的多目标搜索范式:以欧氏距离为主相似度准则构建多层分层向量索引图;检索时由一个复杂的 DNN 打分网络联合评估多目标(语义相关性、用户互动概率、商业转化潜力)。
核心问题是建索引的度量(欧氏距离)与多目标模型的排序度量不一致,导致召回损失。MuSeR 的解法是把检索过程重设计为分层 beam-search:每层用 top-$k$ anchor 扩展候选节点,再用细粒度目标重打分;beam 宽度与扩展比例通过参数探索自适应调整,使图拓扑与模型打分对齐。
硬件侧:图索引构建跑在大容量 CPU 集群;实时向量遍历与打分跑在 GPU 或百度昆仑 NPU上,混合精度加速。论文称该策略相对传统 flat HNSW 索引降低端到端检索延迟 27%、降低整体工程部署成本 35% 以上。
(此处与 §IV.D 的消融存在张力:Figure 4(c) 显示 HNSW 是三种检索策略里最快的,只是召回质量有牺牲;而正文又说 beam-search 相对 flat HNSW 降低 27% 延迟。若 "flat HNSW" 指的是非分层图而非 Figure 4(c) 里的 HNSW 基线,论文没有区分清楚。两个数字同样没有任何测量表格。)
3.3 表征与跨模型融合¶
检索架构把双塔与深度交叉网络的优点合进一个统一系统:文档塔充分利用 side information(类目、语义、多模态信号)产出紧凑 embedding 以支撑高吞吐检索;用户塔配备多头兴趣抽取,提供多样的高分辨率行为向量;多目标打分模型内的 DNN 交互层捕获历史–语义对齐等跨特征依赖。
3.4 生产部署与在线 A/B¶
- 上线时间:§III.D 称「2025 年初」首先上线首页推荐流,再扩展到发现页与短视频流;而 §I 引言称「自 2025 年 8 月起已全量部署」。两处时间互相矛盾。
- 实验方法:live traffic 上做 user-level 分桶,桶由 user ID 哈希分配并在实验窗口内固定;对照组与实验组只在被测召回通路上不同,下游排序与混排完全一致。每个实验连续运行数周,每桶每日数千万用户;报告的提升在双侧检验下显著。
- 结果:在首页信息流的同一个实验中,MuSeR 把 feed DAU 提升 +0.26%、总时长提升 +0.89%(摘要补充 $p < 0.05$)。
- 作者的辩护:在这个流量规模、且信息流已由成熟的多路召回集成服务的前提下,单条召回通路带来这个量级的增益是有意义的改进。这个辩护本身是合理的。
论文进一步论述 MuSeR 改善召回质量的两个机制:其一,缓解长历史未被利用——以时间感知、信息保留的方式压缩超长序列;生产中长期用户表示在服务路径之外计算并缓存,超长历史从不进入请求时的计算预算;其二,缩小稀疏 ID 表示的语义鸿沟——多模态对齐让召回器在语义层面捕获内容相似度与用户意图,对新发布物品、富媒体内容与跨域消费尤其有用。
四、实验设置¶
公开数据集。Amazon 2023 review data 的三个子集:Instruments、Video Games、Industrial & Scientific。做 5-core 过滤,构建按时间排序的序列并截断/填充到长度 50,按时间顺序 70% / 10% / 20% 划分训练 / 验证 / 测试。
⚠️ 这一句是整篇论文实验有效性的分水岭:序列长度 50 意味着 $T = 50 \ll N_r = 800$,分层时间压缩的 (4)(5) 两段恒为空,$L_c = T$。也就是说 Table I 的全部数字与本文第一根支柱(分层时间压缩)完全无关,也与「$10^4$–$10^5$ 超长序列」这一核心命题无关。
工业数据集。百度信息流的大规模私有数据,一个月真实用户–物品交互日志,约 100M 用户、10M 物品、约 5B 日交互;前 29 天训练、第 30 天测试。评估两个场景:Home Feed(个性化长期互动)与 Discovery / Short-Video(快速漂移的短期意图)。
模型配置:
| 项 | 设置 |
|---|---|
| Transformer encoder | 6 层,$d = 512$,8 头,dropout 0.1 |
| 兴趣抽取 | 6 个 query,温度 $\tau = 0.07$ |
| 位置编码 | 正弦式,最大长度 10k |
| 文本语义 | 蒸馏 ERNIE-4.0-Turbo 摘要 + BGE-base-en(768 维);跨模态时用 Visualized-BGE / VISTA |
| 融合权重 | 初始化 0.7 / 0.3,端到端学习 |
| 正交正则系数 | $\lambda = 0.01$ |
| 压缩配置 | $N_r = 800$、$N_m = 2000$、$k_1 = 16$、$k_2 = 64$ |
优化:AdamW,初始学习率 $1\mathrm{e}{-4}$,weight decay $1\mathrm{e}{-5}$,cosine-annealing + 1k warm-up steps,梯度裁剪 1.0,batch size 256(公开)/ 4096(工业),可用时启用混合精度。每个方法跑 5 个随机种子,双侧 t 检验 $p < 0.05$。
Baselines:Caser、GRU4Rec、SASRec、BERT4Rec、FMLP-Rec、S³-Rec、TIGER、NANN(正文列出);Table I 里还额外出现了 HGN、FDSA、SID、CID、TIGER-SAS、LETTER,这 6 个在正文的 baseline 段落中从未被介绍。
基础设施:PyTorch 1.13.1、HuggingFace Transformers、Horovod + NCCL;长序列 encoder 推理跑 NVIDIA A10(18 卡)+ TensorRT FP16;训练用 A100×4 与百度昆仑 P800 NPU,大规模训练扩展到 H20×8 或昆仑 P800×16;检索用昆仑 R200(293+151)+ PaddlePaddle/PaddleInference 服务;异步计算流水线用 Redis 做分布式缓存、Kafka 做流式、Consul 做服务发现。
指标:Recall@K、NDCG@K,另称还报告 MRR、HR、Coverage;工业场景「进一步跟踪 CTR、CVR 以及 dwell time、session duration 等互动信号」。
⚠️ 实际上全文没有报告任何一个 MRR / HR / Coverage / CTR / CVR / dwell time 数值。承诺的指标体系与兑现的指标体系之间差距很大。
五、主要实验结果¶
5.1 公开数据集(Table I)¶
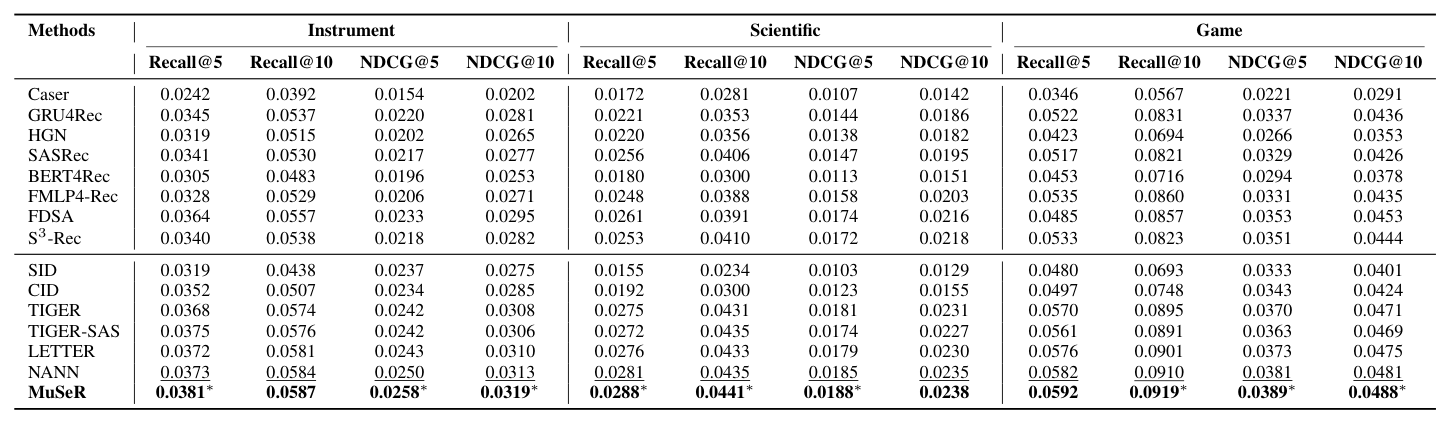
| Methods | Instr. R@5 | Instr. R@10 | Instr. N@5 | Instr. N@10 | Sci. R@5 | Sci. R@10 | Sci. N@5 | Sci. N@10 | Game R@5 | Game R@10 | Game N@5 | Game N@10 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Caser | 0.0242 | 0.0392 | 0.0154 | 0.0202 | 0.0172 | 0.0281 | 0.0107 | 0.0142 | 0.0346 | 0.0567 | 0.0221 | 0.0291 |
| GRU4Rec | 0.0345 | 0.0537 | 0.0220 | 0.0281 | 0.0221 | 0.0353 | 0.0144 | 0.0186 | 0.0522 | 0.0831 | 0.0337 | 0.0436 |
| HGN | 0.0319 | 0.0515 | 0.0202 | 0.0265 | 0.0220 | 0.0356 | 0.0138 | 0.0182 | 0.0423 | 0.0694 | 0.0266 | 0.0353 |
| SASRec | 0.0341 | 0.0530 | 0.0217 | 0.0277 | 0.0256 | 0.0406 | 0.0147 | 0.0195 | 0.0517 | 0.0821 | 0.0329 | 0.0426 |
| BERT4Rec | 0.0305 | 0.0483 | 0.0196 | 0.0253 | 0.0180 | 0.0300 | 0.0113 | 0.0151 | 0.0453 | 0.0716 | 0.0294 | 0.0378 |
| FMLP-Rec | 0.0328 | 0.0529 | 0.0206 | 0.0271 | 0.0248 | 0.0388 | 0.0158 | 0.0203 | 0.0535 | 0.0860 | 0.0331 | 0.0435 |
| FDSA | 0.0364 | 0.0557 | 0.0233 | 0.0295 | 0.0261 | 0.0391 | 0.0174 | 0.0216 | 0.0485 | 0.0857 | 0.0353 | 0.0453 |
| S³-Rec | 0.0340 | 0.0538 | 0.0218 | 0.0282 | 0.0253 | 0.0410 | 0.0172 | 0.0218 | 0.0533 | 0.0823 | 0.0351 | 0.0444 |
| SID | 0.0319 | 0.0438 | 0.0237 | 0.0275 | 0.0155 | 0.0234 | 0.0103 | 0.0129 | 0.0480 | 0.0693 | 0.0333 | 0.0401 |
| CID | 0.0352 | 0.0507 | 0.0234 | 0.0285 | 0.0192 | 0.0300 | 0.0123 | 0.0155 | 0.0497 | 0.0748 | 0.0343 | 0.0424 |
| TIGER | 0.0368 | 0.0574 | 0.0242 | 0.0308 | 0.0275 | 0.0431 | 0.0181 | 0.0231 | 0.0570 | 0.0895 | 0.0370 | 0.0471 |
| TIGER-SAS | 0.0375 | 0.0576 | 0.0242 | 0.0306 | 0.0272 | 0.0435 | 0.0174 | 0.0227 | 0.0561 | 0.0891 | 0.0363 | 0.0469 |
| LETTER | 0.0372 | 0.0581 | 0.0243 | 0.0310 | 0.0276 | 0.0433 | 0.0179 | 0.0230 | 0.0576 | 0.0901 | 0.0373 | 0.0475 |
| NANN(次佳) | 0.0373 | 0.0584 | 0.0250 | 0.0313 | 0.0281 | 0.0435 | 0.0185 | 0.0235 | 0.0582 | 0.0910 | 0.0381 | 0.0481 |
| MuSeR | 0.0381* | 0.0587 | 0.0258* | 0.0319* | 0.0288* | 0.0441* | 0.0188* | 0.0238 | 0.0592 | 0.0919* | 0.0389* | 0.0488* |
结论分析。 论文的叙述是「MuSeR 在三个数据集上全面最优、相对最强 baseline NANN 在多数指标上统计显著」。把数字换算成相对提升后,图景要冷静得多:
| 数据集 | R@5 | R@10 | N@5 | N@10 |
|---|---|---|---|---|
| Instrument | +2.1% | +0.5%(无 *) | +3.2% | +1.9% |
| Scientific | +2.5% | +1.4% | +1.6% | +1.3%(无 *) |
| Game | +1.7%(无 *) | +1.0% | +2.1% | +1.5% |
即:相对最强 baseline 的边际是 0.5%–3.2%,12 个格子里有 3 个连显著性都没拿到。这是典型的「同一量级、略好一点」而非「换代」。更重要的是,如前所述,在长度 50 的序列上,MuSeR 与 NANN 的差别只剩「多模态语义特征 + 多 query 兴趣」两项——超长压缩根本没有参与,因此 Table I 既不能支持标题里的 "Scalable Long-sequence",也不能支持摘要里「优于强长序列与多兴趣 baseline」的说法:公开实验里一个长序列 baseline(SIM / TWIN / ETA / SDIM / LONGER)都没有,一个多兴趣 baseline(MIND / ComiRec / Re4 / PinnerSage)也没有。全部 13 个 baseline 都是短序列单兴趣模型或 SID 生成式检索模型。
5.2 工业私有数据集(Table II / III)¶
Home Feed 场景:
| Method | Recall@100 | Recall@500 |
|---|---|---|
| SASRec | 0.0389 | 0.1176 |
| NANN | 0.0714 | 0.1982 |
| TIGER | 0.0511 | 0.1654 |
| KuaiFormer | 0.0524 | 0.1701 |
| Ours (MuSeR) | 0.0870 | 0.2232 |
Discovery & Short-Video 场景:
| Method | Recall@100 | Recall@500 |
|---|---|---|
| SASRec | 0.0569 | 0.1372 |
| NANN | 0.1012 | 0.2287 |
| TIGER | 0.0721 | 0.1881 |
| KuaiFormer | 0.0818 | 0.1932 |
| Ours (MuSeR) | 0.1377 | 0.2534 |
结论分析。 工业数据上的相对提升确实比公开数据大得多:Home Feed 相对 NANN,Recall@100 +21.8%、Recall@500 +12.6%;Discovery 相对 NANN,Recall@100 +36.1%、Recall@500 +10.8%。论文把这归功于「统一的分层压缩 + 多 query 兴趣 + 多模态对齐同时保住了长时行为覆盖与高分辨率短期意图」。
但这组对比的公平性存疑:论文没有说明 SASRec / NANN / TIGER / KuaiFormer 这些 baseline 是否也获得了 ERNIE + BGE 的多模态语义 embedding,以及是否也吃到了同样长度的历史。结合下一节的消融,答案几乎肯定是「没有」——这使 Table II / III 的增益在很大程度上是「有多模态特征 vs 没有多模态特征」的对比,而不是「MuSeR 架构 vs NANN 架构」的对比。
六、消融与超参分析¶
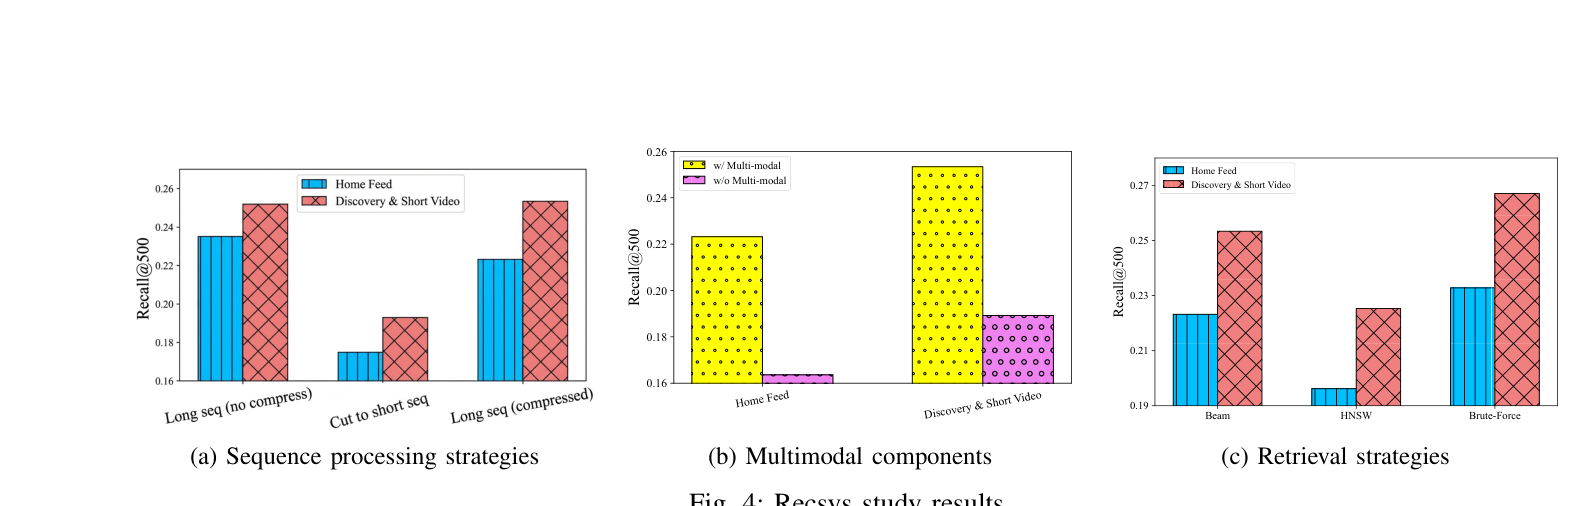
6.1 序列处理策略(Fig. 4a)¶
| 策略 | Home Feed R@500 | Discovery R@500 |
|---|---|---|
| Long seq (no compress) | 0.2351 | ≈0.2520 |
| Cut to short seq(截断) | 0.1749 | ≈0.1925 |
| Long seq (compressed,本文) | 0.2232 | 0.2534 |
分析。 论文自己的叙述很诚实:截断导致 -0.0602 的巨大下滑,说明保留长期信号至关重要;而压缩相对不压缩有 -0.0119 的轻微下降,是「可接受的精度–效率折中」。
但把这组数字放进本档案的标准框架里看,结论要更尖锐:
- 分层时间压缩在效果维度上是负贡献(Home Feed -0.0119,相对 -5.1%)。它的价值纯粹在成本侧,而成本侧没有任何测量数据(无延迟表、无显存表、无 QPS 表)。
- 真正的增益来自「使用长历史」本身(0.1749 → 0.2232,+0.0483),这是 SIM / TWIN / LONGER 一脉早已确立的结论,不是本文的新发现。
- 「分层」这个设计从未被单独验证。论文没有对比任何更简单的压缩基线——均匀池化(全程 stride $k$)、随机下采样、只保留最近 $L_c$ 条、按时间指数衰减采样——因此「近期细、中期 16 倍、早期 64 倍」这个三段式切分相对朴素方案有没有优势,完全未知。三段边界 $N_r = 800$、$N_m = 2000$ 与两个 stride 16 / 64 也都是拍定的,只扫了合成量 $L_c$。
- Discovery 场景下压缩后(0.2534)甚至略高于不压缩(≈0.2520)——论文正文只讨论了 Home Feed 的数字,对这个反常现象未置一词。若属实,说明压缩在该场景起的是正则化/去噪作用而非信息保留作用,机制解释完全不同,值得讨论却被略过。
6.2 多模态组件(Fig. 4b)—— 全文最关键的一张图¶
| 场景 | w/o Multi-modal | w/ Multi-modal | 相对提升 |
|---|---|---|---|
| Home Feed | 0.1636 | 0.2232 | +36.4% |
| Discovery & Short Video | 0.1892 | 0.2534 | +33.9% |
论文对此的评价是「remarkable gains,证实了用语义信号丰富稀疏 ID embedding 能显著提升推荐质量」。
把它和 Table II / III 并排看,结论是灾难性的:
| Home Feed R@500 | Discovery R@500 | |
|---|---|---|
| NANN(最强 baseline) | 0.1982 | 0.2287 |
| MuSeR w/o 多模态 | 0.1636 | 0.1892 |
| MuSeR(完整) | 0.2232 | 0.2534 |
去掉多模态语义这一个新输入信号,MuSeR 在两个场景上都跌到了自己最强 baseline NANN 之下(Home -17.5%、Discovery -17.3%)。也就是说:MuSeR 相对 NANN 的全部优势(Home +0.0250、Discovery +0.0247)都被这个 -0.0596 / -0.0642 的消融幅度吞没了 2.4 / 2.6 倍。
按本档案的标准判据——「引入新信号 ≠ 收益来源」,且每项消融跌幅都要与相对最强公开基线的边际对照——这里的判定是明确的:MuSeR 报告的工业离线增益,其主导来源是「给自己加了 LLM 文本摘要 + BGE 语义向量」这个 baseline 没有的输入特征,而不是标题与摘要主打的分层时间压缩与解耦多兴趣建模。 一个只把同样的 ERNIE/BGE 特征拼进 NANN 的对照实验就能澄清这一点,论文没有做。
6.3 检索策略(Fig. 4c)¶
| 策略 | Home Feed R@500 | Discovery R@500 |
|---|---|---|
| Beam search(部署方案) | 0.2232 | 0.2534 |
| HNSW | ≈0.1950 | ≈0.2250 |
| Brute-Force | 0.2328 | 0.2671 |
分析。 Brute-Force 召回最高但成本不可接受;Beam search 保住了大部分效果;HNSW 最快但召回质量有「moderate sacrifice」。
值得单独指出:HNSW 档(Home ≈0.1950)同样低于 NANN 的 0.1982。也就是说 MuSeR 相对 NANN 的边际,不仅依赖多模态信号,还依赖把检索方式从标准 HNSW 换成更贵的分层 beam-search。两个「贵一点的选项」叠加起来才换到 +12.6%。而 Table II/III 里的 NANN 用的是什么检索方式,论文没有说明。
6.4 超参分析(Fig. 5)¶
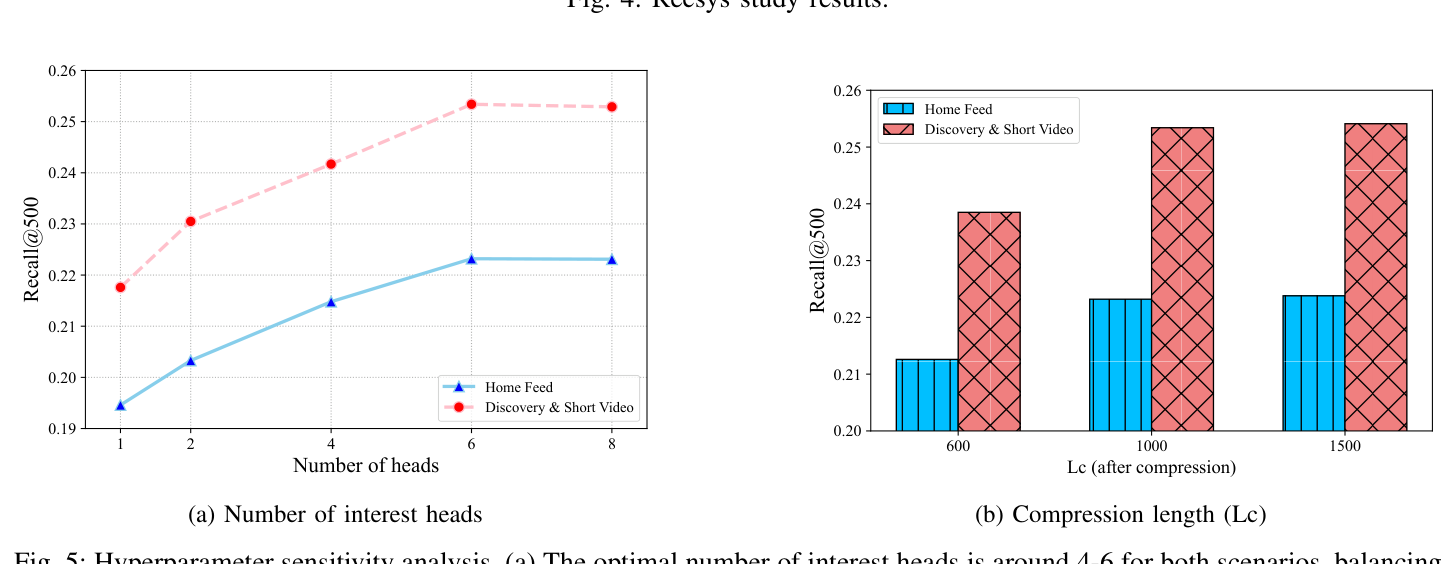
(a) 兴趣头数量:$M \in \{1, 2, 4, 6, 8\}$。多头一致优于单头;最优为 6 头(Home 0.2232、Discovery 0.2534)。从 1 头到 6 头,Home Feed +0.0286(0.1944 → 0.2232,+14.7%)、Discovery +0.0358(0.2176 → 0.2534,+16.5%)。Discovery 受益更大,与其内容多样性更高、意图切换更快一致。超过 6 头后性能持平或轻微下降,说明过细的兴趣分解会增加优化难度并引入冗余。
对照边际:多兴趣的贡献(+0.0286 / +0.0358)确实超过了相对 NANN 的边际(+0.0250 / +0.0247),所以多 query 兴趣抽取是真有效的组件。但要注意它的绝对水位——单头 MuSeR(Home 0.1944)同样低于 NANN 0.1982。三个组件(多模态、多兴趣、beam 检索)任意去掉一个,MuSeR 就不再优于 NANN;论文里没有任何一项单独构成对 NANN 的优势。
(b) 压缩长度 $L_c$:固定 $k_1 = 16$、$k_2 = 64$,通过调 $N_r$、$N_m$ 改变 $L_c$。
| $L_c$ | Home Feed R@500 | Discovery R@500 |
|---|---|---|
| 600 | 0.2126 | 0.2385 |
| 1000(选定) | 0.2232 | 0.2534 |
| 1500 | ≈0.2238 | ≈0.2541 |
600 → 1000 有清晰增益(说明中等长度上下文仍带来额外信号,尤其是刻画复现偏好与跨 session 转移);1000 → 1500 只剩 0.0006–0.0007,已到平台期。论文据此选定 $N_r = 800$、$N_m = 2000$ 的「sweet spot」。
这条曲线同时也是对「$10^5$ 交互」主张的反证:在当前压缩粒度下,$L_c$ 越过 1000 后收益即消失,而 $T = 10^5$ 对应 $L_c \approx 2406$。要么论文在生产里用的是 $T \approx 10^4$(与 Figure 2 一致),要么 $10^5$ 的历史大部分被 64 倍池化压成了对指标无贡献的噪声。
七、核心贡献总结¶
- 系统级集成:在已部署的 MGS / NANN 风格 HNSW 检索系统上,把长序列压缩、多兴趣抽取、多模态语义对齐三条此前各自为战的技术线同时落到一个生产召回通路里,并给出配套的异步刷新 + 自适应缓存 + 分层 beam-search 工程实践。
- 分层时间压缩的工程配方:近期 800 条原样、中期 1200 条 16 倍池化、早期 8000 条 64 倍池化 → $L_c = 1000$,把 $10^4$ 级历史压进固定服务预算,且长期表示完全移出请求时计算路径。
- 诚实的折中报告:明确承认压缩相对不压缩有 -0.0119 的精度损失、beam search 相对 brute-force 有损失,而不是粉饰成「压缩还更好」。这一点值得肯定。
- 真实的线上验证:百度 APP 首页信息流 user-level 分桶、数周、每桶数千万 DAU 的 A/B,报 DAU +0.26%、总时长 +0.89%($p<0.05$),并对「单路召回在成熟多路集成中的增益量级」给出了合理的语境说明。
八、与已归档相关工作的对比¶
ChronicleRec ChronicleRec: Pre-training Temporally Anchored Tokens for Lifelong User Modeling(Tencent × UNSW,2026-09-11)¶
关系:独立并发(本文未引用 ChronicleRec,两者殊途同归且时间相差 9 天)· 已加载对方精读
- 共同关注的问题:两者指向完全相同的 root cause——终身/超长行为历史对效果有确定性价值,但把它放进请求时计算路径在工业 SLA 下不可行;截断便宜却静默丢掉长程信号。两篇都拒绝了 SIM/TWIN 式 target-attention 检索,理由也一致:target-dependent 表征必须按候选重算,成本被候选数乘一遍,且最终仍被汇总成单一用户表示,并发冲突的兴趣被弱分离。
- 相近的技术骨架:近细远粗的时间分段压缩 + 可学习 query token + 每用户缓存、异步回写,三段骨架逐一对应。ChronicleRec 的 C1「recency-aware 多粒度合并」(近 100 条 1:1、中 400 条 kernel/stride 8/4、远段 10/10)与 MuSeR 的 (3)(4)(5)(近 800 条原样、中 1200 条 stride 16、早 8000 条 stride 64)是同一个设计的两种参数化;ChronicleRec 的 $P=11$ 个可学习 query token 与 MuSeR 的 $M=6$ 个 query 向量同源;两者都把压缩后的用户表征按用户缓存、异步写回(ChronicleRec 写 KV cache,MuSeR 写 Redis 分布式缓存),把超长编码彻底移出在线打分路径。
- 本文的差异与推进:MuSeR 用在召回(HNSW 图 + 多目标 beam-search),ChronicleRec 用在排序(pCVR / GAUC);MuSeR 额外引入了 LLM 文本摘要的多模态对齐,ChronicleRec 没有这条语义线。
- 可比的方法/实验差异(对本文不利):ChronicleRec 把 MuSeR 一笔带过的几个设计点都做成了论证。(a) 因果性:ChronicleRec 用因果 mask 把 query token 交织进合并后的序列,使每个 token 有良定义的时间感受野(其 C2);MuSeR 的 (9) 是 $M$ 个 query 对整条 $H_u$ 做双向 attention,正是 ChronicleRec 批评 VISTA 的「无序 bag、每个 query 都能窥视整条时间线,产出冗余而非互补」——MuSeR 只用正交正则 (13) 事后补救,没有结构性的互补保证。(b) 多时间视野:ChronicleRec 用 $B=5$ 条分支分别 mask 掉最近 $\{0,100,300,600,1000\}$ 条行为来覆盖互补视野;MuSeR 单趟压缩,无对应机制。(c) 压缩质量的证据:ChronicleRec 报「在 KuaiRand-27K 上 0.5580 GAUC,恢复 full-attention(0.5601)增益的 92.9%」,把压缩损耗量化成一个可比数字;MuSeR 只有一张柱状图(0.2232 vs 0.2351),且没有任何简单压缩基线做对照。整体看,MuSeR 在这条共同路线上处于更工程、更少论证的一端。
UxSID UxSID: Semantic-Aware User Interests Modeling for Ultra-Long Sequence(Kuaishou,2026-05-09)¶
关系:独立并发(本文未引用 UxSID)· 已加载对方精读
- 共同关注的问题:超长序列(快手侧单周可达 10,000 条)在毫秒级延迟约束下无法在线全量建模;两者都选择「离线压缩 + 在线 $O(1)$ 读缓存」这条路,把序列长度增长与在线延迟解耦。
- 相近的技术骨架:UxSID 的 IAIC(Item-Agnostic Interest Compression) 与 MuSeR 的多 query 兴趣抽取几乎是同一个模块:一组可学习 anchor / query 通过 cross-attention 把长序列压成 $K$ 个兴趣向量,再用正交损失防止塌缩。UxSID 的 $\mathcal{L}_{ortho} = \|\mathbf{P}\mathbf{P}^\top / \|\mathbf{P}\|_2^2 - \mathbf{I}\|_F$ 与 MuSeR 的 (13) 是同一约束的两种写法。服务侧两者也同构:UxSID 按 $\mathrm{Hash}(UID \oplus SID)$ 做 $O(1)$ 点查,MuSeR 从 Redis 拉缓存的 $\{u_m^{(\text{long})}\}$。
- 本文的差异与推进:分歧点在「压缩的组织轴」。UxSID 按语义轴分组(用 RQ-VAE/Res-KmeansFSQ 的第一层 SID 作为语义探针,让语义相近的 item 共享一份压缩兴趣,并用 target SID 在线把兴趣拉成 target-aware);MuSeR 按时间轴分段(近/中/早三段不同 stride)。UxSID 的兴趣记忆是 target-aware 的,MuSeR 的长期兴趣缓存是 target-agnostic 的,只在 (10) 里用候选 embedding 做一次 softmax 加权——这也让 MuSeR 面临 (10) 与 ANN 检索流程的循环依赖问题,而 UxSID 因为服务在排序侧不存在这个矛盾。此外 UxSID 额外引入了 PFFN(每个 anchor 一套独立 FFN 参数)来强化 anchor 的独立表达,MuSeR 的 $M$ 个 query 共享后续网络。
- 可比的方法/实验差异:UxSID 在 XLong、KuaiRec-Big 两个公开长序列 benchmark 上对比了 DIN、SIM、ETA、SDIM、MIRRN、TWIN、C-Former 等长序列专用 baseline,并给出序列从 1k 扩到 10k 的 scaling 曲线与 +0.16 ms 的延迟增量;MuSeR 的公开实验用长度 50 的 Amazon 子集、零个长序列 baseline、零个延迟测量。在线增益量级则各有侧重:UxSID 报快手广告 Exposure +0.111% / Cost +0.231% / Revenue +0.337%,MuSeR 报百度 feed DAU +0.26% / 时长 +0.89%——MuSeR 的用户侧指标更大,但缺少延迟与成本的实测表来兑现它反复声称的 -27% 延迟、-35% 成本。
SetMIR SetMIR: Multi-Interest Retrieval as Set Prediction(Snap Inc.,2026-08-31)¶
关系:独立并发(本文未引用 SetMIR)· 已加载对方精读
- 共同关注的问题:两者都在召回这一层解决同一个结构性瓶颈——单一用户 embedding 对多面兴趣过粗,平均化表示偏向占比最大的类目、抹掉窄众短时兴趣;解法都是「每用户产出 $K$($M$)个兴趣 embedding 去查 ANN 索引」。两者也都保持 item 侧单向量,以便复用现成 ANN 索引(SetMIR 显式对比 ColBERT 式多向量检索并说明这个取舍,MuSeR 沿用 HNSW/MGS)。
- 相近的技术骨架:跨用户共享的可学习 query bank + transformer 读取用户历史 + 每 query 一个检索 embedding。SetMIR 的 $K$ 个可学习 query 经 $M$ 层 decoder(query 自注意力与对历史的交叉注意力交替)产出 $L_2$ 归一化的 $e_k$;MuSeR 的 (9) 是同一思想的最小实现(单层 cross-attention,无 query 间自注意力)。
- 本文的差异与推进:SetMIR 把这条线做成了一个形式化问题(DETR 式集合预测 + 匈牙利匹配 + presence 头),直接针对多兴趣召回的两个遗留病灶:兴趣坍缩(argmax 分配让未被选中的 query 收不到梯度)与静态派发(无条件对全部 $K$ 个 embedding 各发一次 ANN,把召回预算摊在冗余 query 上)。MuSeR 对这两个病灶的应对要弱得多:坍缩只靠正交正则 (13);派发侧 (10) 用候选相似度做加权而非学到的 per-query 质量信号,且没有「本次请求该激活几个兴趣」的机制——SetMIR 明确指出这正是 Re4 一类辅助正则项没有解决的部分,而 MuSeR 恰好停在辅助正则项这一档。此外 SetMIR 的 $\alpha$ 门控(事件类型 embedding 从 0 增益起步,避免随机初始化的事件 embedding 污染已训好的内容表示空间)是 MuSeR (7) 的朴素相加所没有的细节。
- 可比的方法/实验差异:两者的兴趣头数量结论相近(MuSeR 最优 6 头且 8 头后持平回落;SetMIR 用可变激活数的 presence 头把这个超参变成了 per-request 自适应量)。SetMIR 对自身与 KuaiFormer / DCM 的关系有逐条机制级说明;MuSeR 虽把 KuaiFormer 列为工业数据集 baseline(Home 0.1701 vs MuSeR 0.2232),却没有任何机制层面的对比说明,也没说明 KuaiFormer 复现是否同样吃到了多模态特征。
被剔除的近似候选(记录以防门槛放水):
- [2609.08443] SequenceO1(ByteDance):问题同构(100K 超长序列的存储/通信/计算系统性瓶颈、产出固定尺寸 target-agnostic 用户 sketch),但解法是替换注意力算子(全局共享可学习 prototype + prototype-wise softmax),属「换算子」而非「按时间轴分段池化」,方法流程图无法抽象重合。
- [2608.03692] SITA(USTC + 工业):同样是「离线把行为序列压成少量兴趣 token 并缓存、在线按 target 拉取」,但组织轴是语义分区(N 个并行均衡量化码本定义语义组,target SID 硬索引),与 MuSeR 的时间分区正交;且服务在排序侧。与 UxSID 高度重合,保留 UxSID 一篇代表这条路线即可。
- [2608.11015] SONA(Yandex):History Compression 把 7 层深栈只花在最近 2048 个事件、仅一层跨全部 8192 事件,本质也是「近期高分辨率、久远低分辨率」的非均匀容量分配,动机与 MuSeR 的分层压缩重合度很高;但 SONA 分配的是网络深度而非序列 token 数,且整篇的主线是生成式推荐单模型替换级联(tokenizer + teacher 蒸馏 + beam search),问题陈述的落点是「一个模型替掉整条级联」,与 MuSeR 的「召回通路加长历史」实质偏离。
- [2608.07055] TM20K(ByteDance):同样处理 20K 超长电商序列的效果–效率冲突,但结论是「序列 scaling 需要 full attention 而非 target attention」,解法是一次性 teacher 缓存 logits 蒸馏给在线 student,走的是蒸馏而非压缩,属本档案明列的「一方靠蒸馏、一方靠量化/压缩」反例类型。
- [2604.15650] SIF(Meituan)/ [2604.08933] IAT(ByteDance):同为「先离线压缩再在线建模」范式,但压缩单位是历史训练样本(sample-level token),目标是突破手工特征的信息瓶颈,问题陈述落在特征工程而非序列长度预算,解法路径(分层分组自适应量化 / 两阶段实例压缩)与时间分段池化不同构。
补记(非孪生对比,仅作背景):同一天(2026-09-20)百度另投了 arXiv:2609.23718 UNIQUE,同样部署在百度 APP 首页信息流 / 发现页 / 短视频三场景,做的是单层平面量化下的检索–排序统一框架。两篇是同一业务线的姊妹系统论文(UNIQUE 报 watch duration +0.96% / 分发量 +1.08%,并给出 89 ms P99 与 44.23% MFU 的服务实测),但问题与解法均不同构,不计入本节。值得注意的是 UNIQUE 给出了 MuSeR 完全没有给的服务侧实测数字。
九、讨论与局限性¶
9.1 值得借鉴的地方¶
- 「把超长历史彻底移出请求时计算预算」这个部署原则本身是对的,并且 MuSeR 给出了一套完整的工程配方:双频刷新(短期高频、长期低频)、Redis 分布式缓存、Kafka 流式、按 QPS 与并发自适应节流、CPU 建图 + GPU/昆仑 NPU 遍历打分的异构分工。这些细节在同类论文里常被略过。
- 分层 beam-search 对「索引度量 ≠ 排序度量」的处理思路清晰:不改索引的欧氏度量,而是在每层用 top-$k$ anchor 扩展后用细粒度多目标重打分,把图拓扑与模型打分对齐。这是把 ANN 索引与复杂打分器缝合的一个实用范式。
- 对折中的诚实:Fig. 4a 明确给出压缩的精度代价、Fig. 4c 明确给出 beam 相对 brute-force 的差距,没有粉饰。
- 对增益量级的合理语境化:作者主动说明「在成熟多路召回集成中,单条通路 +0.26% DAU 是有意义的」,这比不加说明地堆 A/B 数字要好。
9.2 核心问题:主张与证据严重错位¶
这是评分的决定性因素,按严重程度排列:
(1) 收益来源与标题主张不一致(最严重)。 消融显示去掉多模态语义后,MuSeR 的 Recall@500 跌到 0.1636 / 0.1892,低于最强 baseline NANN 的 0.1982 / 0.2287。单兴趣头版本(0.1944 / 0.2176)同样低于 NANN;换成标准 HNSW 检索(≈0.1950)也低于 NANN。因此 MuSeR 相对 NANN 的 +12.6% / +10.8% 边际,在很大程度上是「MuSeR 拿到了 ERNIE + BGE 的 LLM 语义特征而 baseline 没有」造成的,而不是标题里的分层时间压缩与解耦多兴趣建模。缺失的关键对照实验只有一个:把同样的多模态 embedding 拼给 NANN。论文没做。按「引入新信号 ≠ 收益来源」的判据,本文的归因是不成立的。
(2) 公开实验与论文命题脱节。 三个 Amazon 子集的序列被截断到长度 50,这直接使分层时间压缩($N_r=800$)恒等于不压缩。Table I 因此无法为「Scalable Long-sequence」提供任何证据。与此同时,公开实验里没有任何长序列 baseline(SIM/TWIN/ETA/SDIM/LONGER)和任何多兴趣 baseline(MIND/ComiRec/Re4),而摘要明确宣称「outperforms strong long-sequence and multi-interest baselines」——这句话在论文内部找不到支撑。工业侧也只有 KuaiFormer 一个多兴趣对照,长序列对照仍为零。
(3) 「分层」这一设计从未被证伪性地验证。 没有均匀池化、随机下采样、只保留最近 $L_c$ 条等任何简单基线;stride 16/64、分段点 800/2000 全部是拍定值;sum pooling 与 attentive pooling 的选择也没有消融。所以本文第一根支柱在方法论上只是一个未经检验的工程默认值。
(4) $10^5$ 的主张与实际配置不符。 由 (6) 和 Figure 2 反推,部署配置对应 $T = 10^4$、$L_c = 1000$;$T = 10^5$ 会给出 $L_c \approx 2406$,而 Fig. 5(b) 显示 $L_c$ 超过 1000 后收益已消失。摘要/引言/结论四处出现的 $10^5$ 没有任何实验落点。
(5) 工业署名 ≠ 工业证据。 论文反复给出三个工程数字——「减少至多 60% 冗余编码」「降低端到端检索延迟 27%」「降低部署成本 35% 以上」——三个都是裸断言,没有任何表格、基线定义或测量口径。Metrics 一节承诺报告 MRR / HR / Coverage / CTR / CVR / dwell time,正文一个都没有。在线 A/B 只有两个数字,且未按场景拆分(摘要暗示三场景,§III.D 明确说是首页信息流的同一个实验),没有置信区间、没有桶数、没有多重比较校正说明。对一篇「贡献是系统级集成」的论文来说,系统侧证据的密度明显不足。
(6) 方法描述的内部矛盾与缺口。
- (10) 正文说「select 最相关的兴趣向量」,公式做的是 softmax 加权求和;且 (10) 需要候选 $e_i$ 才能算出查询向量,与 ANN 检索的因果顺序冲突,论文未解释如何在 HNSW 图上落地。
- (15) 的 $u^{(\text{short})}$(单向量)与 $\{u_m^{(\text{long})}\}$($M$ 向量)维度不自洽。
- $\beta(t)$ 由服务负载决定,意味着模型质量随流量静默漂移,全文没有任何对该漂移的度量或上界分析。
- Figure 2 标注的 "CE Loss / Score Argmax" 与 (12) 的 InfoNCE 对不上;"Multi-objective Score Network" 的训练方式全文缺失。
- (3) 与 Figure 2 的时间方向相反;(13) 对标量套 $\ell_2$ 范数。
(7) 参考文献质量问题。 至少三处硬错误:
- §II.A 称「Building upon the industrial MGS framework mentioned in [13]」,而 [13] 是 DIEN(Zhou et al., AAAI 2019,阿里的 CTR 模型),与百度的 MGS 检索系统无关——全文对自己所基于的底座系统的唯一引用是错的。
- TIGER 被引用两次且两条都不对:[31] 写成 "Tiger: Transferable interest graph embedding for recommendation, WWW 2023",[36] 写成 "Tiger: A deep-learning-based recommender system for large-scale e-commerce platforms, arXiv:2307.03789"。真正的 TIGER 是 Rajput et al., Recommender Systems with Generative Retrieval, NeurIPS 2023(arXiv:2305.05065)。Table I 用 [31]、Table II/III 用 [36],两张表引的是同一个模型的两条错误条目。
- [19] 把 C-Pack 标成 arXiv:2307.09288,而该编号是 Llama 2;C-Pack 实为 arXiv:2309.07597。
(8) 时间线自相矛盾:§I 称「Since August 2025 fully deployed」,§III.D 称「In early 2025 rolled out」。
(9) 方法论可扩展性隐患。 MuSeR 属于本档案评分标准明确点名的「先离线压缩再在线建模」两阶段解耦范式(与 SIF / IAT 同类):压缩器(超长序列 encoder + 多头兴趣抽取)与在线多目标打分网络无法端到端联合优化,长期兴趣表示一旦落盘缓存即被冻结到下次刷新;扩参时「如何表征历史」(离线侧)与「如何建模序列/打分」(在线侧)两条路径无法同步增长。加上 $\beta(t)$ 由负载而非学习决定,这条路线的长期上限存疑。
9.3 复现与借鉴价值¶
如果只取一条可迁移经验,是「长期用户表示离线算 + 缓存 + 异步刷新,在线只算短序列并融合」这套服务拓扑,以及分层 beam-search 缝合 ANN 索引与多目标打分器的做法——这两点即使脱离本文的具体模型也成立,且与 ChronicleRec / UxSID 的做法相互印证。相反,本文的建模贡献(三段式 stride 压缩、$M$ query + 正交正则)不建议直接照搬:前者从未与更简单的压缩基线比较过,后者在 SetMIR / ChronicleRec 里都有论证更完整、机制更强的版本。至于「加 LLM 文本摘要能大幅涨点」这个真正带来数字的结论,本文没有把它作为主张提出,也没有给出公平的对照实验来支撑它——这恰恰是全文最可惜的地方:它手里握着一个 +34~36% 的强结论,却把论文写成了另外两件事的故事。