MARCO:用点击意图分解修复广告转化预估的分组校准
MARCO: Click-Intent Decomposition for Calibrated Ads Conversion Prediction Shiwen Shen, Xiru Huang, Liang Luo, Jianbo Sun, He Lyu, … , Wenlin Chen, Santanu Kolay, Qin Huang, Ellie Wen(Meta AI, Menlo Park) arXiv:2608.10562v1 · cs.LG · 2026-08-11
一句话:不是所有点击都相等。工业广告排序把 impression 转化率拆成 CTR×CVR,却把所有点击当成同一种事件;实际上同一条广告上不同 UI 交互类型(CTA 点击 vs. 社交互动)转化率相差近 4 倍。单头 CVR 被迫在混合点击总体上拟合一个标量,必然低估高意图、高估低意图,而两个方向相反的误差在聚合口径互相抵消,于是整体 calibration 看起来接近完美,分组内部的严重畸变完全不可见。MARCO 用日志里免费的点击类型标签把点击划成 K 个意图分层,每层训练独立的 CTR/CVR 头,serving 时按 CTR 头预测的意图分布重新组合。K=2 部署在 Meta 广告平台,分组校准修到约 100%,每次点击转化 +2.80%、大盘累计 +0.98%。
研究动机与背景
标准分解与它的盲区
工业广告排序估计一次曝光的转化概率,靠一个精确的边缘分解:
$$\Phi_{\text{std}}(x) = \lambda(x)\cdot\mu(x), \tag{1}$$
其中 $\lambda(x):=P(\text{click}\mid \text{imp}, x)$ 是 CTR,$\mu(x):=P(\text{conv}\mid \text{click}, x)$ 是点击后 CVR,$\Phi_{\text{std}}(x):=P(\text{conv}\mid\text{imp},x)$ 是拍卖排序用的转化分。每个因子由专用模型估计——这套组合式方案已是行业标准十余年。
真正棘手的是 CVR:把异质的点击混合物压成一个标量预测,引入了任何有限容量模型都消不掉的 group-conditional bias。反过来划成同质意图分层能提升估计效率——这正是后分层估计(post-stratified estimation)的经典原理。但有个关键差别:意图分层是 post-impression 结果,打分时根本观测不到。MARCO 的应对是推理时预测意图分布,把各层估计通过它路由出去。
免费的行为监督信号
现代社交广告的 UI 天然带着分层标签:CTA 点击会跳出平台去落地页,社交互动(点赞、评论)只是平台内的轻量参与。传统架构把它们折叠成一个 click 标签,白白扔掉了一个零成本监督信号;经验上高意图 CTA 点击的转化率接近社交动作的 4 倍。后果是单个 CVR 头被迫拟合两条截然不同的转化漏斗,高意图被低估、低意图被高估,直接损害排序——被抬高的低意图分数会在拍卖里挤掉真正更容易转化的候选。而两个方向相反的误差在聚合层面互相抵消,标准监控报出的整体 calibration 一片健康,内部畸变被完全掩盖。作者把这种沉默的失效模式命名为 click-intent heterogeneity。
与已有工作的定位
- 纵向漏斗方法(ESMM、ESM²、ESCM²、DCMT)分解的是点击之后的用户旅程(点击→加购→下单),不是点击本身的异质性;
- 多任务学习与 MoE(MMoE、PLE、PEPNet)优化共享专家之间的路由,最终仍把表征混合成对混合点击总体的单一预测。专家门控改变的是架构容量而非监督目标;
- 后验校准(Platt scaling、isotonic regression 及近期的 maximization-bias / semantic-aware grouping 校准)无法条件于点击意图,因为交互类型是推理时不可观测的 post-impression 事件;
- 意图模型(IntentRec)丰富的是特征表征,预测组合公式本身没变。
也就是说,没有任何已有框架去重构 CTR–CVR 的组合公式来隔离异质点击总体。四项贡献:(1) 把 click-intent heterogeneity 识别为 root cause 并证明单输出的可观测性极限;(2) 用日志点击类型作零成本行为监督,消融证明单输出架构消不掉分组错标定而输出层分解能消掉 >99%;(3) 端到端生产系统设计(归因 + 跨流水线一致性),K=2 部署于 Meta 广告平台;(4) 把意图分解形式化为类扩张,证明弱占优与泛型正 headroom,引入路由效率 $\eta$。
问题形式化与可观测性壁垒
把点击空间划成 K 个互斥且完备的意图类别,按历史点击类型的转化似然分组。意图路由严格只依赖日志里的交互类型、不依赖转化结果,杜绝目标泄漏。定义
$$\lambda_k(x):=P(\text{click}_k\mid\text{imp},x),\quad \mu_k(x):=P(\text{conv}\mid\text{click}_k,x),\quad \pi_k(x):=P(k\mid\text{click},x). \tag{2}$$
由全概率公式,MARCO 估计的 impression 级转化概率是
$$\Phi_{\text{MARCO}}(x)=\sum_{k=1}^{K}\lambda_k(x)\,\mu_k(x). \tag{3}$$
并且有恒等式
$$\mu=\sum_{k=1}^{K}\pi_k\mu_k,\qquad \lambda_k=\lambda\pi_k,\qquad \sum_k\lambda_k=\lambda,\qquad \pi_k=\lambda_k/\lambda. \tag{4}$$
公式 (3) 对任意 K 成立,但评测与部署都聚焦二元实例化(K=2),捕捉「站外 CTA 点击 vs 站内社交参与」这个主导对比。
评价预测质量用的是 calibration ratio(预测转化率 / 观测转化率)。传统架构在每一个排序环节上都对 per-intent 偏差结构性失明(图 1 灰色路径):归因系统join 点击与转化时不区分交互类型;模型训练在混合点击流量上优化单一损失;校准服务只依赖 impression 时刻特征,未观测的 post-impression 意图在聚合抵消下保持错标定;预测组合按公式 (1) 把单点击偏差传播进拍卖分。
这是结构性的可观测性壁垒,不是容量约束。 只要排序系统在交互被观测之前输出单标量 $\mu$,任何额外容量、架构门控或后验重校准都不可能同时达成分组条件校准。
命题 1(点击发生前,单一输出无法达成 per-intent 校准) 在 proper scoring rule 与固定 impression 时刻特征集下,若各意图 CVR $\mu_k$ 互不相等,则任何只输出单个 $\mu$ 的模型都不可能对所有意图同时校准;它至多等于其中一个 $\mu_k$。
证明初等但结论刚性:对意图 $k$ 校准意味着 $\mu=\mu_k$,同时对全部 K 类校准要求它对每个 $k$ 成立,而一个标量至多等于一组互异实数中的一个。严格 proper scoring rule 下风险最小的单输出恰是 pooled 条件均值 $\sum_k\pi_k\mu_k$——聚合校准,却作为凸组合至多与一个 $\mu_k$ 重合。
理论分析
MARCO 把意图分解框架化为总体层面的类扩张 $\mathcal F\subseteq\mathcal G$,建立三条保证:弱占优、泛型性(严格改进几乎处处成立)、路由单调性(扩大 CTR 容量可证明地兑现更大比例理论空间)。
类扩张与 headroom
令 $\mathcal F$ 为单个 pooled 转化头的假设类,
$$\mathcal G=\Big\{g=\sum_{k=1}^{K}\pi_k f_k:\ f_k\in\mathcal F\Big\}, \tag{5}$$
分解打开的理论 headroom 是最优 pooled 与最优分解模型之间的风险差:
$$\Delta_{\mathcal F}:=\inf_{f\in\mathcal F}R(f)-\inf_{g\in\mathcal G}R(g). \tag{6}$$
包含关系(引理 4):取 $f_k\equiv f$ 即得 $\sum_k\pi_k f=f$,故 $\mathcal F\subseteq\mathcal G$。这一步纯集合论——因此弱占优 $\Delta_{\mathcal F}\ge 0$ 对任何骨干、特征表征、损失函数普遍成立,改进是结构性的而非容量效应。
贝叶斯等价(引理 1):真实条件概率下 $\Phi_{\text{MARCO}}=\sum_k\lambda\pi_k\mu_k=\lambda\mu=\Phi_{\text{std}}$。总体最优分数完全不变——全文最重要的认识论声明:任何实际收益都严格是有限容量下的估计与校准效应,而非「模型更强了」。
超额风险恒等式(引理 2/3):平方损失下 $R(f)=R(\mu)+\|f-\mu\|^2$,下确界在 $L^2(\rho)$ 投影处取到(交叉项因 $\mathbb E[Y-\mu\mid X]=0$ 消失):
$$R(f)=\mathbb E[(Y-\mu)^2]+2\,\mathbb E[(Y-\mu)(\mu-f)]+\mathbb E[(\mu-f)^2]; \tag{7}$$
交叉熵下对 $(0,1)$ 取值的 $f$(Bregman 散度,$\psi(p)=p\log p+(1-p)\log(1-p)$):
$$R(f)=R(\mu)+\mathbb E_X\big[\mathrm{KL}(\mathrm{Bern}(\mu)\,\|\,\mathrm{Bern}(f))\big]. \tag{8}$$
归一化熵 $\mathrm{NE}(f)=R(f)/H(\bar y)$ 只差一个正常数。论文特意点出:按 calibration–refinement 分解,per-intent 校准把每层内的 calibration 项打到零,分解攻击的是 refinement 项——log-loss gap 与 per-intent 校准是同一对象在每个意图切片上的度量。
平方损失下的精确 headroom(命题 3):取 $\mathcal F$ 为 $L^2(\rho)$ 的有限维线性子空间,则 $\mathcal G=\mathrm{span}\{\pi_k e_j\}$ 也是子空间(维数至多 $KD$),且
$$\Delta_{\mathcal F}=\|\mu-P_{\mathcal F}\mu\|^2-\|\mu-P_{\mathcal G}\mu\|^2=\|P_{\mathcal G}\mu-P_{\mathcal F}\mu\|^2\ \ge 0, \tag{9}$$
证明用嵌套子空间的勾股恒等式。Headroom 就是 $\mu$ 在「意图调制方向中正交于 $\mathcal F$ 那部分」上的能量。 命题 2 补了个反直觉细节:非常数路由是 $\mathcal G\supsetneq\mathcal F$ 的必要但不充分条件。
归一化熵下没有闭式(引理 6):交叉熵下 $\mathcal F$ 不能是线性子空间(有限维子空间必含取值落在 $(0,1)$ 外的函数)。logit 空间建模 $f=\sigma(z)$ 会让 $\sum_k\pi_k\sigma(z_k)$ 变成 mixture of experts,$\mathcal G$ 不再是子空间。因此 $\Delta_{\mathcal F}$ 只能实测——用同架构同容量下最优 pooled 与最优分解模型的 held-out NE 差来估。
泛型性(命题 4/5):使 $\Delta_{\mathcal F}=0$ 的参数配置构成 Lebesgue 零测集。但作者诚实地补了引理 8:部署系统是单个未知真值 $\theta^\ast$,完全可能就落在零测集上(粗意图分桶、对称性、稀疏性正是这类结构化配置)。对部署有约束力的是实测 headroom,不是先验。
责任门控占优定理(定理 1):对任意单专家类 $\mathcal F$ 与监督的责任门 $\pi_k$,(i) $\inf_{\mathcal G}R\le\inf_{\mathcal F}R$;(ii) 泛型严格更优;(iii) 不是 BMA——BMA 权重随后验一致性坍缩到单模型(是选择而非组合),而 $\pi_k$ 对 $n$ 恒定、随 $x$ 变化。作者澄清:MARCO 的独特之处不在「组合 vs 选择」(那是 MoE 的定义性质),而在于门是从日志点击类型读出的、被监督的可观测责任——这让每个专家都能被暴露并单独校准。
实际增益是一个带符号的分解
$\Delta_{\mathcal F}$ 是总体最优量。部署模型用的是估计路由 $\hat\pi$、有限样本头、分层训练目标。论文给出一个精确的望远镜恒等式:
$$R(\hat f)-R(\hat g)=\Delta_{\mathcal F}+\underbrace{\big(R(\hat f)-\inf_{\mathcal F}R\big)}_{\mathrm{est}_{\mathcal F}\ge 0}-\underbrace{\big(R(g_{\text{strat}})-\inf_{\mathcal G}R\big)}_{\varepsilon_{\text{couple}}\ge 0}-\underbrace{\big(R(\hat g)-R(g_{\text{strat}})\big)}_{\varepsilon_{\text{route}}}, \tag{10}$$
其中 $g_{\text{strat}}=\sum_k\pi_k P_{\mathcal F}\mu_k$ 是「每个头只在自己那片分层上拟合、按真实 $\pi$ 路由」的分层预测器。三项符号固定:$\Delta_{\mathcal F}\ge 0$ 是弱占优,$\mathrm{est}_{\mathcal F}\ge 0$ 是 pooled 模型自身的估计误差,$\varepsilon_{\text{couple}}\ge 0$ 是分头独立训练而非联合最小化的代价。实际增益是 $\Delta_{\mathcal F}$ 被 pooled 估计误差抬高、被耦合与路由惩罚压低——可以超过 $\Delta_{\mathcal F}$,也可以变成负的。 部署系统里分解头共享骨干、只增加不到 $10^{-7}\%$ 参数,所以 $\mathrm{est}_{\mathcal F}$ 与 $\varepsilon_{\text{route}}$ 的估计部分都很小,而非 K 个独立模型那种 K 倍膨胀——这正是实测增益为正而没被方差淹没的原因。
路由效率与 CTR 容量
$\Delta_{\mathcal F}$ 是 CVR 侧的量,能有多少传导到推理取决于 CTR 模型预测的意图分布 $\hat\pi_k=\hat\lambda_k/\hat\lambda$。定义路由效率
$$\hat\eta:=1-\frac{\varepsilon_{\text{route}}}{\Delta_{\mathcal F}}, \tag{11}$$
而路由代价满足异质性加权的界(引理 11):
$$\varepsilon_{\text{route}}\le\mathbb E\big[\|\hat\pi-\pi\|^2 s^2\big],\qquad s^2=\sum_k(\mu_k-\mu)^2. \tag{12}$$
证明是把 $\delta=\sum_k(\hat\pi_k-\pi_k)\mu_k$ 减去 $\mu\sum_k(\hat\pi_k-\pi_k)=0$,再对 $k$ 用 Cauchy–Schwarz。意图同质处($s=0$)路由代价恒为零,无论路由错得多离谱;代价严格集中在各意图转化率发散的地方。 命题 7 进一步证明:随 CTR 容量增长,可实现路由类 $\Pi(c)$ 嵌套扩大,$\varepsilon^\star_{\text{route}}$ 单调不增、$\eta^\star$ 单调不减。
分数级 headroom 的 $\lambda^2$ 压缩(命题 6):在 impression 层面、假设两模型共享同一 CTR 估计 $\hat\lambda=\lambda$,平方损失下
$$\inf_{\mathcal F_\mu}R_{\text{score}}-\inf_{\mathcal G_\mu}R_{\text{score}}=\big\|P_{\mathcal G_\mu}\mu-P_{\mathcal F_\mu}\mu\big\|^2_{\lambda^2\rho_{\text{imp}}}. \tag{13}$$
即分数级 headroom 等于转化头 headroom,但在点击量级加权测度 $\lambda^2\rho_{\text{imp}}$ 下计算。由于 $\lambda\ll 1$,impression 空间收益相对 on-click 收益被几何压缩——这直接解释了「线下 +0.223% vs 线上 +2.80%」的落差。引理 9 还指出:没有独立的 CTR 近似 headroom(因为 $\sum_k\lambda_k=\lambda$),但两个头构造上都必需。引理 10 划定理论适用范围:对并集稠密的嵌套类 $\Delta_{\mathcal F}\to 0$——headroom 是严格的有限容量现象。
MARCO 模型
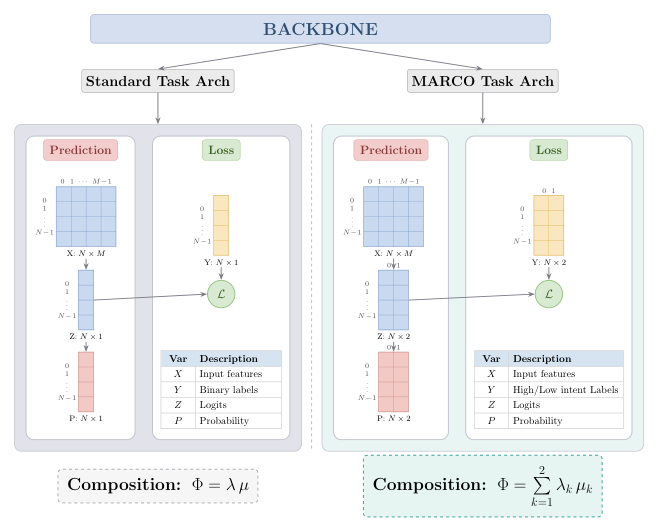
免费行为监督
MARCO 把日志里的用户交互类型当作零成本监督目标:意图标签直接从物理 UI 行为导出,不需人工标注。训练时每个 per-intent CVR 头 $\mu_k$ 只在属于意图 $k$ 的点击上训练;serving 时因为真实意图不可观测,MARCO 评估全部 per-intent CVR 头,用 $\hat\pi_k=\hat\lambda_k/\hat\lambda$ 加权算期望 CVR。
向量头架构与开销
如图 2,MARCO 用多输出任务头实现分解,不改动底层特征表征与模型骨干:共享 embedding 与 DNN 表征原样保留,在标量投影旁追加一个 K 维向量头($\mathbb R^d\to\mathbb R^K$),CTR 头输出 $(\lambda_1,\dots,\lambda_K)$、CVR 头输出 $(\mu_1,\dots,\mu_K)$。原有标量输出被保留,严格用作自动回退的运维基线。 图 2 的对比很直观:标准架构里 logits $Z$、概率 $P$、标签 $Y$ 都是 $N\times 1$;MARCO 里三者都变成 $N\times 2$,标签从二值 label 变成高/低意图 label,组合公式从 $\Phi=\lambda\mu$ 变成 $\Phi=\sum_{k=1}^{2}\lambda_k\mu_k$。
构造 K 个独立模型会显著膨胀参数、内存与延迟,造成严重的模型碎片化。而向量头方案相对模型总容量只增加不到 $10^{-7}\%$ 的参数;由于表征层与 embedding lookup 全部共享,serving 延迟完全不受影响。
归因设计与系统工程
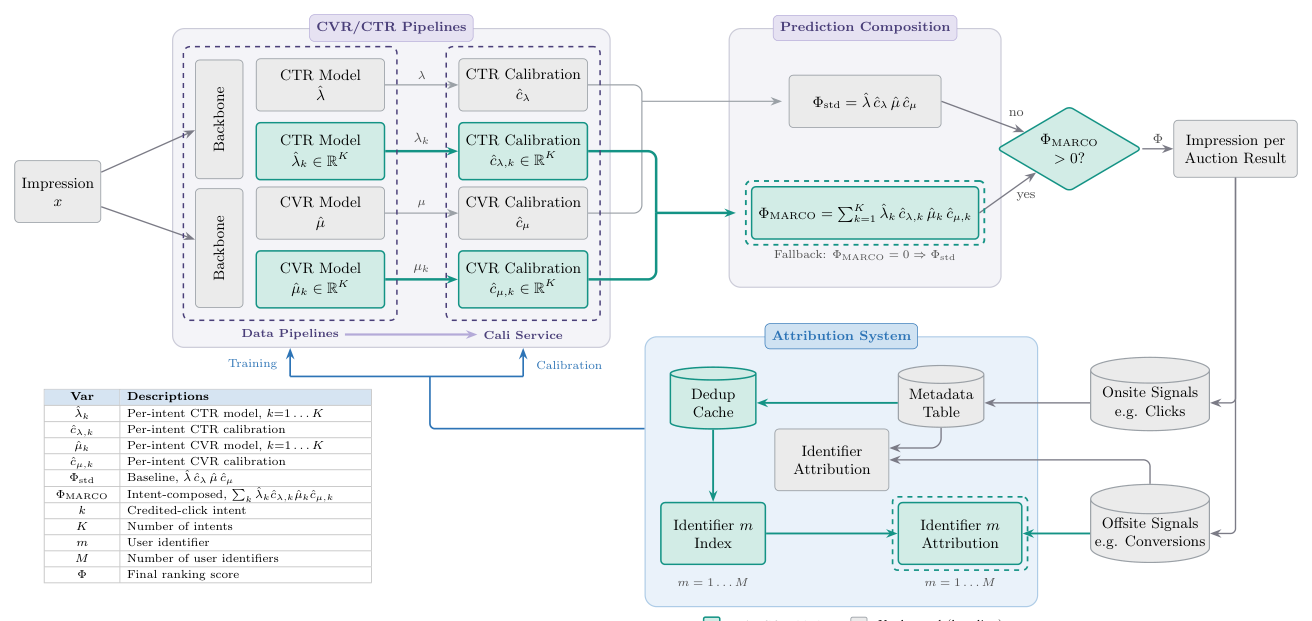
信用分配框架
用户在转化前的旅程横跨多次曝光与多点触达。把轨迹建模为 $n$ 次曝光的有序历史 $H$,第 $i$ 次曝光在渲染时刻 $\tau_i$ 记录,含 $m_i\ge 0$ 次曝光内点击的多重集 $C_i$:
$$H=\big\{(\text{imp}_i,\tau_i,C_i)\big\}_{i=1}^{n}\longrightarrow \text{conv},\qquad C_i=\big\{(\text{click}_{i,j},t_{i,j})\big\}_{j=1}^{m_i}, \tag{14}$$
满足 $\tau_1<\dots<\tau_n$ 与 $\tau_i\le t_{i,1}\le\dots\le t_{i,m_i}$。因为同一个广告单元可产生一串异质交互(如先点赞、再点 CTA),信用归因必须同时给出跨曝光权重 $w_i$ 与曝光内点击权重 $v_{i,j}$,转化结果按 $w_i\cdot v_{i,j}$ 分配到训练样本:
$$\bar\Phi(H)=\sum_{i=1}^{n}w_i\sum_{j=1}^{m_i}v_{i,j}\cdot P(\text{conv}\mid\text{imp}_i,\text{click}_{i,j}), \tag{15}$$
并强制 $\sum_i w_i=1$、$\sum_j v_{i,j}=1$ 保证转化质量守恒。
偏差-方差权衡与 RL 类比:选择 $(w_i,v_{i,j})$ 是结构性的偏差-方差权衡,与 RL 的时序差分回报估计同构。两条轴因果角色不同:曝光轴(控偏差)——曝光是外部刺激,权重压到最后一次曝光($w_n=1$)隔离出因果上最邻近、直接触发转化的上下文(类比 Monte Carlo);点击轴(控方差)——曝光内的一串点击是随机探索过程,选第一次点击($v_{i,1}=1$)捕捉后续点击注入噪声之前的即时意图签名(类比 TD(0))。
表 1:归因设计空间与定性权衡(偏差、方差、实时可行性、RL 类比)
| 方案 | 曝光 | 点击 | 偏差 | 方差 | 可行性 | RL 类比 |
|---|---|---|---|---|---|---|
| First-touch | First | First | High | Low | Deterministic | TD(0) |
| Last-touch | Last | Last | Low | High | Req. buffering | Monte Carlo |
| Time-decay | Wtd. | Wtd. | Low | Med. | Req. full hist. | GAE(λ) |
| MARCO | Last | First | Low | Low | Deterministic | – |
生产可行性约束:一致性条件要求信用意图必须确定性、无需事件缓冲即可即时解析,这直接排除 last-click 与 time-decay,只留下 first-click;作者论证经验风险极小(绝大多数曝光上首次与后续点击属于同一意图类别)。
跨流水线一致性条件与生产系统工程
CTR/CVR 的训练与校准是四个独立分布式服务,必须对每个 impression $i$ 解析出完全相同的信用意图 $\kappa(i)$:训练一致性 $\kappa^{\text{train}}_{\text{CTR}}=\kappa^{\text{train}}_{\text{CVR}}$、校准一致性 $\kappa^{\text{cali}}_{\text{CTR}}=\kappa^{\text{cali}}_{\text{CVR}}$、端到端不变量要求四者全等。前两条只在各自阶段内部对齐、并不把训练与校准连起来;共享单源 dedup cache 提供这条链接,由构造保证不变量成立。
- 并发点击归因:交互事件跨分布式边缘服务器并发到达时,引擎在 Deduplication Cache 上执行原子的 first-write-wins 检查,把最后一次被归因曝光内最早的点击登记为 $\kappa(i)$,后续点击标记去重。
- Schema 无关的转化归因:站外转化经异步流水线到达、标识 schema 各异;查找时手头有哪个标识就用哪个,由于所有标识路径都解析到点击处理时建立的同一条底层缓存条目,所有下游消费者观测到一致的意图标签。
- 组合层回退护栏:为在并发 A/B 环境下保护投放不受模型稀释或上游中断影响,内置零延迟回退算子:
$$\Phi=\Phi_{\text{MARCO}}+\mathbb I(\Phi_{\text{MARCO}}=0)\cdot\Phi_{\text{std}}. \tag{16}$$
若实验稀释导致意图专属预测消失,系统退回标准标量分,保证不劣于基线。
- 冷启动协议:(1) 未见点击类型默认归入低意图组,低风险,因为高意图动作对应既有的高转化导航路径;(2) 未预热的校准服务存在循环依赖(校准器需要预测流量才能起来,MARCO 上线又要求校准器就绪),用两阶段哑组合破解:
$$\Phi_{\text{phase1}}=\Phi_{\text{std}}+0\cdot\Phi_{\text{MARCO}}. \tag{17}$$
Phase 1 分数与生产基线完全相同,意图头生成影子预测预热校准服务;校准方差收敛后(典型 2–3 天)Phase 2 才激活完整组合,投放零扰动。
实验设置
评测覆盖线下日志基准与 Meta 生产广告平台的大规模线上 A/B,全部在二元意图粒度(K=2) 下实例化。线上实验跨多周窗口、覆盖数亿用户、用户级随机化;所报收益全部 $p<0.05$ 显著;自动回退在 <0.1% 流量上触发。四个研究问题:RQ1 可观测性壁垒在实践中成立吗(辅助任务/历史特征/MoE 门控是否仍无法降低分组错标定)?RQ2 能否改进端到端 post-impression 预测,实证是否与 $\Delta_{\mathcal F}$、$\hat\eta$ 吻合?RQ3 恢复分组校准能否改进早期候选检索保真度?RQ4 真实拍卖里的大盘影响与分数分离机制?
主要实验结果
RQ1:post-click 的 per-intent 校准
对照四种逐步增强、但都止步于结构性分解的范式:Baseline(pooled CVR)——ESMM 式纵向漏斗,在所有点击上拟合单个转化头;+ 辅助意图任务——追加预测 per-intent 分布的辅助头;+ 历史意图特征——把历史意图分布作为 impression 时刻输入特征,这是交互发生前可观测的最强意图信号;+ 基于历史意图的 MoE——检验架构门控能否消除子群体偏差。
表 2:相对 pooled 基线的分组校准误差下降幅度(%),越高越好
| Model | High intent | Low intent |
|---|---|---|
| Baseline (pooled) | 0% | 0% |
| + Auxiliary intent task | 0% | 0% |
| + Historical intent feature | 1% | 3% |
| + MoE on historical intent | 2% | 8% |
| MARCO (decomposition) | > 99% | > 99% |
结论分析:辅助任务带来的额外容量让分组校准纹丝不动(0%);历史意图特征与 MoE 门控只带来边际改进($\le 8\%$)。原因不是模型不够强,而是它们对混合点击总体只发射一个输出 $\mu$,命题 1 施加了严格的观测上界。MARCO 基本消除全部误差,比最接近的替代方案高一个数量级以上。作者也补了边界说明:任何带 per-intent 输出头的架构都能绕过这道壁垒,MARCO 提供的是工业规模下所需的最小、零延迟设计。
RQ2:组合后的 post-impression NE
post-impression 评测在全局 impression 空间上评价端到端预测 $\Phi$,基线按公式 (1)、MARCO 按公式 (3) 组合,在生产数据上跨 7 天窗口进行。评测矩阵系统变动三维:CTR 骨干容量(Base、Large 5×、以及用真实 $P(k\mid\text{click})$ 路由但仍用预测点击率的 Oracle router)、组合架构(MARCO vs CTR-split-only)、校准策略(None / 仅 CVR / 仅 CTR / 联合)。
表 3:组合模型 post-impression NE 增益(%),越高越好,95% 置信区间相对标准组合
| Related RQ | Composition Logic | Calibration Adjustment | NE Gain (%) [95% CI] |
|---|---|---|---|
| Ablation Analysis (Base Model) | |||
| 2.1 | MARCO | None | +0.054 [+0.043, +0.067] |
| 2.1, 2.2 | MARCO | CTR & CVR | +0.223 [+0.210, +0.235] |
| 2.2.1 | MARCO | CVR only | +0.181 [+0.168, +0.194] |
| 2.2.2 | MARCO | CTR only | +0.097 [+0.088, +0.110] |
| 2.3 | CTR-split-only | None | +0.002 [−0.020, +0.007] |
| Capacity Scaling & Theoretical Bound | |||
| 2.4 | MARCO (Large CTR, 5×) | None | +0.092 [+0.067, +0.112] |
| 2.4 | MARCO (Oracle Router) | None | +2.268 [+2.235, +2.302] |
四条结论:
- RQ2.1 实证弱占优:MARCO 在所有容量与校准设置下都严格优于 pooled 基线(Base CTR 下 +0.054%),实证验证了定理 1(i)——结构性分解扩大假设类而不抬高总体风险。
- RQ2.2 校准服务的协同:pre-calibration 增益经过线上校准服务后跳升 4 倍以上(+0.054% → +0.223%)。仅 CVR 校准贡献大头(+0.181%),仅 CTR 校准贡献 +0.097%。把 per-intent 输出解混后,CVR 校准器才能对着同质子群体分别调每个意图头。这是全文最有工程价值的发现:分解本身的直接收益不大,真正的杠杆是它让下游校准服务重新变得可用。
- RQ2.3 估计耦合偏差 $\varepsilon_{\text{couple}}$:CTR-split-only 的增益统计上可忽略(+0.002%,区间跨零)。因为 $\sum_k\lambda_k=\lambda$(引理 9),只拆 CTR 头提供零 CVR headroom还引入耦合偏差,确证 CVR 侧分解是捕获 post-impression 收益的严格必要条件。
- RQ2.4 路由效率扩张 $\hat\eta$:CTR 容量 1×→5×,pre-calibration NE 增益 +0.054%→+0.092%。Oracle router($\hat\pi=\pi$)下达 +2.268%,作为可实现 headroom 的经验上界;以此为分母,实测路由效率从 Base 的 2.38% 升到 Large 的 4.06%——验证命题 7。
RQ3:pre-impression 漏斗召回
在离线生产日志上跨 3 天窗口、把候选集在 $O(10^2)$ 的早期漏斗规模上截断,用价值加权召回(截断列表交付价值 / 理想列表价值)度量,MARCO 相对 pooled 基线 +0.38%——恢复分组校准改善了漏斗早期的序保真度。
RQ4:线上业务影响
MARCO 通过多次连续上线增量部署,每次都是互不相交流量段上的独立实验、各自对照并发 holdback,每次都取得正向收益,合计覆盖 Meta 广告流量的相当大一部分。全局口径下交付 +0.98% 大盘指标累计提升(95% CI: [+0.86%, +1.12%],跨批次 bootstrap 百分位区间);在一个主要广告位的多周 holdback 中取得 每次点击转化 +2.80%(95% CI: [+2.50%, +3.10%])。
线上 (+2.80%) 远超线下 impression 空间 NE 增益 (+0.223%) 的两个结构性机制:(1) 概率空间压缩——按命题 6,impression 级风险差按 $\lambda^2$ 缩放,而 $\lambda\ll 1$,故 impression 空间指标相对 on-click 收益经历几何压缩;(2) 拍卖重分配动力学——实时拍卖是赢者通吃机制,消除分组条件错标定后 MARCO 取得更好的分数分离,让高意图候选系统性赢下拍卖、压制低转化流量,把预算动态重分配到更高转化机会上,非线性放大校准收益。
预测分布分析
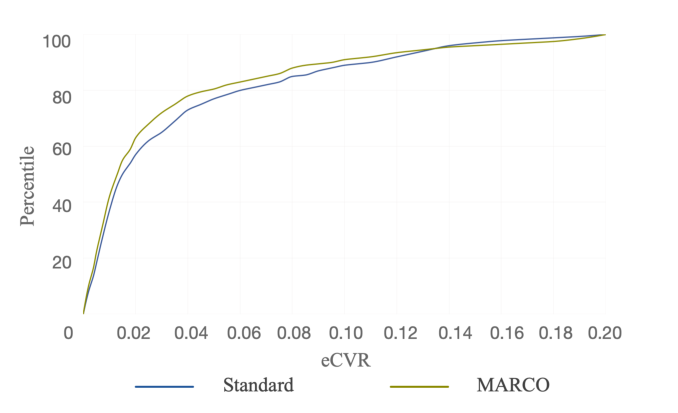
对倾向产生低意图点击的 impression,MARCO 压低期望转化分,使处理组 CDF 在低 eCVR 区(< 0.04)上升更快;对倾向产生高意图 CTA 点击的 impression,MARCO 放大分数,使处理组 CDF 在高 eCVR 区(> 0.08)落在基线之下。这种分数分离给拍卖提供了高保真转化信号。注意两条曲线在 eCVR ≈ 0.135 附近交叉后重新贴合——重分配主要发生在分布中低段,尾部高分候选的排序基本没变。
核心贡献总结
- 命名并形式化一个此前隐形的失效模式:click-intent heterogeneity——聚合校准近乎完美却掩盖分组内的系统性双向偏差,并用命题 1 抬升为结构性可观测壁垒而非容量问题。
- 把 UI 交互类型识别为免费的行为监督信号:不需新标注或隐私敏感画像,logged click type 直接就是意图的 pretext label。
- 最小侵入的架构改动:标量头 → K 维向量头,参数增量 < $10^{-7}\%$、零延迟、与既有 CVR 架构正交可组合。
- 完整理论骨架:类扩张弱占优、精确投影能量 headroom、交叉熵下无闭式的诚实说明、泛型性、实际增益的带符号分解、路由效率的异质性加权界与单调性。
- 可复制的生产工程配方:last-impression/first-click 归因论证、四流水线一致性不变量、first-write-wins dedup cache、schema 无关归因、零延迟回退算子、两阶段冷启动预热。
与已归档相关工作的对比
DUET DUET:为站外转化预估设计的双用户嵌入 Transformer(Meta, 2026-06-08)
关系:独立并发(本文未引用 DUET,两者同公司同任务却殊途同归)· 已加载对方精读
- 共同关注的问题:同一个 root cause——广告转化预估的训练信号里混着统计机制截然不同的子流,被单一无差别模块统一处理,必然被密度高的那一支主导。DUET 是「点击流稠密、站外转化流稀疏且长延迟,单个上游编码器被点击主导」;MARCO 是「CTA 与社交点击的转化漏斗不同,单个 CVR 头被迫拟合混合总体」。二者都强调这是结构问题而非容量问题,都以「统计同质性」作切分依据。
- 相近的技术骨架:按日志中免费可得的事件语义把数据路由成同质流 → 为每条流配专用模块 → 在下游重新组合。DUET 切成点击流与站外转化流、各训 ClickAUE / ConvAUE 编码器、冻结后由下游 ranker 联合消费;MARCO 把点击切成高/低意图、各训一对 $(\lambda_k,\mu_k)$ 头、serving 时按 $\hat\pi_k$ 组合。两者都严守 serving 延迟预算,都用 NE 作线下主指标并报出亚 1% 量级收益(DUET 至多 0.38% NE 下降,MARCO +0.223%)。
- 本文的差异与推进:DUET 切在上游用户表征层、维度是事件类型、组合方式是把冻结嵌入当特征拼给下游;MARCO 切在输出头与预测组合公式层、维度是单次点击内部的意图类型、组合方式是全概率公式重组。这带来 DUET 没有的性质:MARCO 每个分层输出都能单独送进校准服务,正是它 4 倍收益放大的来源。反过来 DUET 处理的转化标签稀疏与不可归因是 MARCO 明确不碰的。
- 可比的方法/实验差异:DUET 报线上 CVR +0.66%/+0.15%,MARCO 报每次点击转化 +2.80%。两者天然互补可叠加——MARCO 的 $\varepsilon_{\text{route}}$ 分析指出「扩 CTR 侧意图预测容量是最高杠杆方向」,DUET 式强用户表征正是提升 $\hat\pi$ 精度的现成手段。同出 Meta 广告体系却互不引用,是这次检索里最典型的独立并发。
FSM-MMoE-VST FSM-MMoE-VST:新鲜信号与延迟信号分离的直播多目标排序(Twitch, 2026-08-05)
关系:独立并发(本文未引用,发表仅相差 6 天)· 已加载对方精读
- 共同关注的问题:把统计性质不同的监督信号塞进一个统一模型会被主导信号带偏,且损害在聚合指标上不显形。 Twitch 版本:SMP 这类即时稠密目标与 chat/follow/spend 这类稀疏延迟目标性质完全不同,塞进统一 MTL 模型会把 LMP 打垮 4.2%–4.6%;MARCO 版本:高/低意图点击塞进一个 CVR 头会产生互相抵消的双向校准误差。两篇都在推翻同一个工业直觉——「上更强的多任务/MoE 架构就能解决」。
- 相近的技术骨架:按信号内在性质做模型级分离 → 各自在同质数据上训练 → 在最终打分处用一组权重重组。Twitch 的 $F=\sum_a w_a p_a$ 与 MARCO 的 $\Phi=\sum_k\lambda_k\mu_k$ 是同一线性重组骨架,差别只在权重来源:前者是离线选定的分层条件人工权重,后者是模型预测出来的意图分布(因而带上路由误差这个 MARCO 独有的分析对象)。两篇还给出同一负面结论的两个版本:Twitch 发现训练时对 Early 观众加权无效、只能靠推理时分层加权;MARCO 发现训练时加辅助意图任务对校准零改善、只能靠输出层分解。
- 本文的差异与推进:Twitch 的分离在多目标之间、分层维度是用户侧可观测的 Early/Dedicated;MARCO 的分离在单一目标内部、分层维度是打分时不可观测的 post-impression 事件,必须引入预测分布做概率路由——这正是 MARCO 全部理论负担的来源。反过来 Twitch 给出了 MARCO 缺失的证据:对比 MMoE / Shared-Bottom / CGC 三种骨干,配上独立 FSM 后三者几乎一致(LMP NDCG@6 0.2462–0.2463),证明分离本身而非骨干选型才是主导驱动力——与 MARCO 表 2「MoE 门控只降 2%/8%、结构分解降 >99%」是同一论断的两次独立验证。
- 可比的方法/实验差异:Twitch 用离线 NDCG@6 + 三次 14 天 A/B(DAV +0.09%、capped ARPU +0.56%、follows +0.27%)与 p99 <110ms 的工程账。Twitch 明确把 ESMM/AITM 这类序列转化模型排除在基线外(直播动作无固定顺序),而 MARCO 的 pooled 基线恰是 ESMM 式漏斗——取舍相反,勾勒出各自场景边界。
HA-MoE HA-MoE:工业级异构 feed 排序的案例研究(Google Discover, 2026-07-30)
关系:独立并发且解法路径直接对立(MARCO 表 2 的第 4 行消融就是 HA-MoE 这条路线)· 已加载对方精读
- 共同关注的问题:单一共享表征被迫服务结构性异质的子群体,导致少数/低密度分段被主导分段盖过,而全局聚合指标看不出来。 HA-MoE 的表述是「主要按全局 CTR 优化的模型会不成比例地偏好 click-bait 文章而牺牲视频与 UGC」,并造 DL-AUC(Micro-AUC 与 unweighted Macro-xAUC 加权混合)作抗 gaming 的分组感知指标——与 MARCO 造 per-intent calibration ratio 替代整体 calibration ratio 是完全同构的动作:都意识到聚合指标本身是共谋者,必须先换指标才能看见问题。
- 相近的技术骨架:把日志里现成的显式异质性标签 $h$ 注入模型,让模型对分层条件化。HA-MoE 的 $h$ 是
content_type加上下文元数据,MARCO 的 $h$ 是 logged click type;两者都零采集成本、都在固定预算内做最小侵入改造(HA-MoE <5% 体积 / <0.5% 延迟,MARCO <$10^{-7}\%$ 参数 / 零延迟)。 - 本文的差异与推进:注入点截然相反,这正是最有价值的对照。 HA-MoE 把 $h$ 注入门控输入($g_t=\mathrm{Softmax}(W_t\Phi(x,h)+b_t)$)与专家输出的 FiLM 式调制($\tilde E_n=\gamma_n(h)\odot E_n(x)+\beta_n(h)$),但每个任务仍只输出一个标量;MARCO 的命题 1 断言这条路线有硬上界,表 2「+ MoE on historical intent」一行(降 2%/8%)就是直接实证反驳。但两个结论并不真矛盾,边界在目标指标:HA-MoE 优化 cross-type 排序正确性(Vid⁺/Web⁻ xAUC gap 0.141→0.060),序关系可靠条件化容量改善;MARCO 追 per-intent 概率校准,那是更强的点值约束,条件化容量原理上够不着。正确姿势是:异质性门控/调制能修排序、修不了校准;要修校准必须把输出拆开。
- 可比的方法/实验差异:HA-MoE 线上 DAU +0.22%、Diverse Engagement Rate +0.54%(1% 流量),MARCO 每次点击转化 +2.80%;量级差主要来自 MARCO 处在竞价拍卖这个赢者通吃放大器里。HA-MoE 还配了 LENS/PIEM 的 label-free 专家特化诊断,MARCO 无对应工具。
讨论与局限性
伦理、泛化性与一个可先行诊断的判据
合规部分三条:数据隐私——只依赖标准流水线里已记录的物理 UI 交互;广告主间的统计公平——恢复子群体校准消除了以直接转化为目标的广告主所遭受的不公平拍卖惩罚;目标无关性——按广告主自定义目标动态路由候选价值,不硬编码「直接销售优于品牌参与」。这一段值得学习:意图分解天然会引出「是否在系统性打压轻互动型广告主」的质疑,作者主动把它转化为公平性收益来论证。
结构性分解的原则超出点击意图本身:只要一个单一监督目标聚合了下游成功率结构性异质的事件,单输出模型就会继承被聚合校准掩盖的子群体偏差。 代表场景:app 安装(有机归因 vs 广告驱动,7 日留存完全不同)、电商漏斗(quick-add vs considered-add)、视频平台(预览播放 vs 全屏观看)。更有工程价值的是作者给出的先行诊断:评估候选交互分层上的 impression 加权 KL 散度扩散度,可直接从历史日志估出 $\Delta_{\mathcal F}$——把「要不要做意图分解」变成离线跑数就能回答的问题。
局限与未来方向
作者自陈三条:(1) 分类法扩展——K 可沿深度(细分 CTA 子导航类型)与广度(纳入 dwell time、观看百分比、有机参与)扩张,由于弱占优对任意划分成立,更细分类法永不劣化总体风险;(2) 路由效率杠杆——实际收益由 $\hat\eta$ 支配,而路由误差集中在各意图转化率发散处,扩 CTR 意图预测器容量而非 CVR 容量才是最高杠杆方向;(3) 稀疏分层校准基础设施——K 增大后罕见交互类别面临样本稀疏导致的校准方差,长尾分布下鲁棒实时收敛的动态校准器仍是未解的系统工程挑战。
我补充的几点批评:
- 实测路由效率只有 2.38%–4.06%,97% 以上的理论 headroom 没有兑现。 论文把它当作「未来还有空间」的乐观叙事,但换个角度读同样成立:MARCO 的收益几乎全部来自校准服务解耦而非分解本身的估计增益,真正起作用的机制更接近「让实时校准器重新拿到同质子群体」。
- Oracle router 被当作 $\Delta_{\mathcal F}$ 的经验代理,但两者不是同一个量:它用真实 $\pi$ 却仍用预测点击率,给出的是路由误差为零时的分数级增益,而 $\Delta_{\mathcal F}$ 是 CVR 侧最优类间的风险差。用 +2.268% 当分母算出的 $\hat\eta$ 混了口径。
- 表 3 中 CTR-split-only 一行的置信区间有瑕疵:点估计 +0.002 落在 [−0.020, +0.007] 内却严重偏离中心(中点 −0.0065),暗示区间构造与其他行不一致。表 2 也只给相对下降百分比、不给绝对校准比;「大盘指标」全文未命名,+0.98% 无法横向比较。
- 理论原创度低于篇幅暗示的水平:附录 A 主体是 $L^2$ 投影定理、勾股恒等式、Bregman 散度、实解析零集定理的直接应用;真正属于本文的是引理 11 的路由界与公式 (10) 的带符号分解。
- 完全没有公开数据集实验,结论全部建立在 Meta 内部数据与匿名相对指标上。不过「点击类型分层」在公开 CTR/CVR 数据集里不存在,这更像问题属性而非作者疏漏。
- 方法论可扩展性存在隐含瓶颈:收益上限被 $\Delta_{\mathcal F}$ 界住,而引理 10 已证明它随容量增长趋于零——这是一条随骨干变强而自动收窄的路线,是当下有限容量工业模型的高性价比补丁,而非能随参数量一起 scaling 的长期路线;补救之一「扩 K」又直接撞上作者自己承认尚未解决的稀疏分层校准问题。
值得借鉴的设计
三处工程智慧可直接迁移:(1) 先换指标再改模型——监控口径本身会掩盖问题时,模型迭代只是在噪声里摸索;(2) 把「分解」的收益点定位在校准服务而非模型——它真正的价值是让下游统计校正模块拿到同质总体;(3) 零延迟回退算子加两阶段哑组合冷启动,把「替换线上打分公式」变成可逐步验证、随时可退的操作。