LLM Reasoning for Subjective Tasks: Failure Modes, Mitigation, and Dynamic Reasoning Routing¶
作者:Juncheng Dong(Duke University,工作完成于 Netflix 实习期间)、Ding Tong(Netflix)、Ishan Gupta(工作完成于 Netflix 期间)、Yuyan Wang(Netflix)
会议:RecSys '26(20th ACM Conference on Recommender Systems,Minneapolis)· ArXiv 2608.08889 · 2026-08-09 · 8 页
一句话:在 Netflix 生产环境的四个主观审核任务上系统检验「显式推理 / RLVR 能否迁移到人本 rubric」,发现显式推理普遍掉点、标准 RLVR 会触发推理坍缩(reasoning collapse),提出以答案正确性为门控的条件长度奖励止住坍缩并反超基线,并用 1500 个人格的实验揭示「推理风格错配」才是主观判定误差的大头,据此给出人格路由(persona routing)中训练蓝图。
1. 研究动机与背景¶
近两年 LLM 推理能力的跃迁几乎全部锚定在客观任务上:数学证明、代码生成。其技术骨架是 RLVR(Reinforcement Learning with Verifiable Rewards)——用编译器、数值校验器这类确定性 verifier 产出可靠的 0/1 奖励,再用 GRPO 一类算法让模型通过试错自行内化推理轨迹(DeepSeek-R1、o1、DeepSeekMath 谱系)。这条路线之所以成立,有两个隐含前提:
- 预训练语料里已经饱和了该领域的正确推理轨迹(数学证明的 step-by-step 写法遍地都是);
- verifier 可靠,奖励能忠实反映"这条推理是不是对的"。
而现代推荐系统面对的是完全相反的场景:「正确」不是二值真理,而是主观的人类偏好。当工业界大规模把 "LLM-as-a-Judge" 用于内容审核、安全合规、个性化查询校验时,模型要判定的是「文化敏感度」「对话语气是否得体」这类抽象 rubric——既没有 canonical 的正确推理轨迹,也没有可靠的 verifier。于是本文的核心问题是:
在客观领域锻造出来的显式推理技术,能否泛化到主观的、以人为中心的工业 rubric 上?
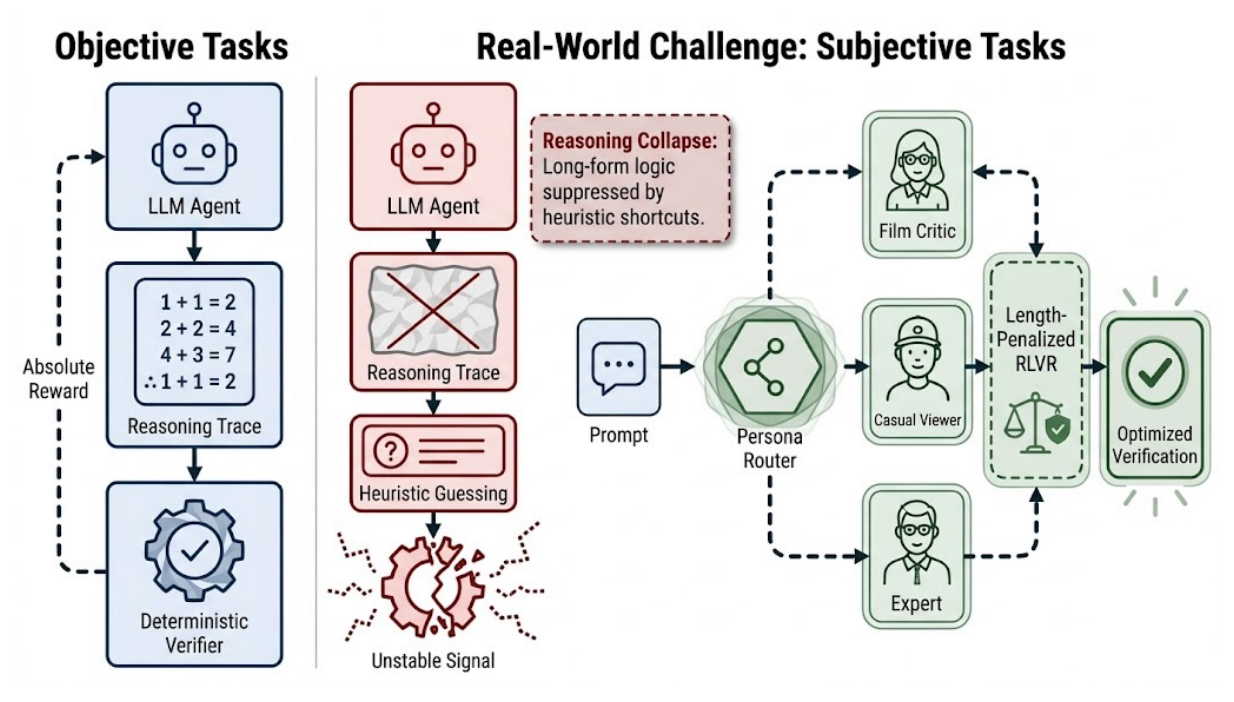
Figure 1 是全文的结构总览:左栏是客观任务的成功配方(可靠 verifier + 绝对奖励闭环);中栏是推荐场景的失败模式(推理轨迹被划掉、退化为 heuristic guessing、奖励信号不稳定);右栏是本文的两层药方——先用 length-penalized RLVR 止住机械性坍缩,再用 Persona Router 把 prompt 路由到"影评人 / 普通观众 / 专家"等不同人格,再进入长度惩罚 RLVR 得到最终判定。
四条贡献:(i) 大规模实证研究,证明显式推理与"内生推理"在主观校验上频繁掉点,且跨闭源/开源模型成立(§2);(ii) 识别并刻画标准 RLVR 下的 reasoning collapse(§3);(iii) 提出条件长度惩罚奖励,止住坍缩并恢复(乃至反超)性能(§4);(iv) 给出人格条件推理导致巨大性能方差的初步证据,据此提出人格路由的中训练蓝图(§5)。
2. 任务定义与实验设置¶
2.1 四个主观校验任务¶
全部数据来自 Netflix 生产环境,标注由人类按线上同款 rubric 给出。四个任务都是二分类("Yes"/"No"):
- (I) Conversational Query Sensitivity:判定对话式查询是否违反敏感度准则;
- (II) Generated Text Response Sensitivity:判定生成的回复文本是否合规;
- (III) Text: Response Quality:判定回复文本是否充分且相关地回应了查询;
- (IV) ID: Response Quality:判定回复中给出的片库标题(catalog title)是否回应了查询。
论文特别指出:因为 rubric 抽象且以人为中心,标注者之间的分歧本身就是信息,这正是"主观校验"区别于客观任务的根本处。
2.2 三种 prompt 形式与评测协议¶
为了把"推理"这一变量隔离出来,作者对比三种 prompt 形式:
- direct JSON verification baseline:不带任何推理,直接输出判定;
- implicit reasoning:先给一段解释再给答案;
- explicit reasoning:结构化的
<reason>/<answer>标签。
闭源推理模型额外跑 "low" / "high" 两档 reasoning effort。所有数字都是 macro-F1,5 次独立运行取平均;单 prompt 用 greedy decoding,self-consistency 采样 $K=8$、温度 0.7 后多数投票。run-to-run 标准差低于 0.01 macro-F1,不改变定性趋势。macro-F1 采用标准定义(论文未展开写出,此处补全以便理解指标口径):
$$\text{macro-}F_1 = \frac{1}{2}\left(F_1^{\text{Yes}} + F_1^{\text{No}}\right),\qquad F_1^{c} = \frac{2 P_c R_c}{P_c + R_c} \tag{1}$$
选 macro-F1 而非 accuracy,是因为敏感度类任务的正负样本极不均衡,accuracy 会被多数类主导。
3. 发现一:显式推理在主观任务上普遍掉点¶
3.1 闭源模型的退化¶
作者先在两个 SOTA 闭源模型上做基准:Frontier-LLM(通用大模型)与 Frontier-Reasoner(专用推理模型)。为合规起见论文匿名化了具体型号。
Table 1:闭源模型上 prompting-based verifier 的表现(macro-F1,5 次平均)
| Task Dataset | Frontier-LLM (w/o Rea) | Frontier-LLM (Imp Rea) | Frontier-LLM (Exp Rea) | Frontier-Reasoner (low) | Frontier-Reasoner (high) |
|---|---|---|---|---|---|
| Query Sensitivity | 0.901 | 0.893 | 0.887 | 0.895 | 0.874 |
| Response Sensitivity | 0.622 | 0.605 | 0.619 | 0.564 | 0.580 |
| Self-Consistency (K=8) | 0.690 | 0.593 | 0.574 | 0.615 | 0.623 |
| Text: Response Quality | 0.892 | 0.884 | 0.876 | 0.882 | 0.863 |
| ID: Response Quality | 0.513 | 0.517 | 0.520 | 0.503 | 0.502 |
结论分析:反直觉的趋势非常一致——显式要求推理、或直接换用推理模型,相对零样本基线普遍掉点。Task I 从 0.901 掉到 0.887(显式推理),Frontier-Reasoner 高 effort 更差(0.874);Task II 从 0.622 掉到 0.619 / 0.564。唯一让推理占优的是 Task IV(0.513 → 0.520),但在同一任务上推理模型反而更差(0.503 / 0.502),这种不一致性本身进一步动摇了"把客观任务推理迁移到主观校验"的可行性。更关键的是推理时扩算力救不回来:Task II 上 Majority Vote($K=8$)从 0.690(无推理)掉到 0.574(显式推理),差距被放大——因为投票只是在强化那条本来就没用的推理。对于被重度对齐到客观解题的闭源模型,中间推理引入的是噪声和幻觉,反而扰乱了主观评估。
3.2 开源模型的"推理悖论"¶
为排除"这只是闭源对齐的产物",作者换了两个 7B 开源模型:数学推理较弱的 Mistral-7B-Instruct 与对齐强、数学推理强的 Qwen2.5-7B-Instruct。
Table 2:开源模型在主观任务上的 macro-F1(5 次平均,RL 之前的基线)
| Task Dataset | Mistral-7B (w/o Reason) | Mistral-7B (With Reason) | Qwen2.5-7B (w/o Reason) | Qwen2.5-7B (With Reason) |
|---|---|---|---|---|
| Query Sensitivity | 0.707 | 0.724 | 0.748 | 0.805 |
| Response Sensitivity | 0.555 | 0.646 | 0.561 | 0.520 |
| Text: Response Quality | 0.402 | 0.465 | 0.458 | 0.512 |
| ID: Response Quality | 0.505 | 0.518 | 0.544 | 0.539 |
结论分析:出现清晰的二分。Mistral-7B 在每个任务上都从推理中获益(+0.017 ~ +0.091);Qwen2.5 则时好时坏——Query Sensitivity 大涨(+0.057),Response Sensitivity 反而大跌(−0.041)。作者把这解释为 reasoning mismatch(推理错配):已经很擅长数学式推理的模型(Qwen 与两个闭源模型)把这套推理迁移到人本 rubric 上是不可靠的;而数学能力较弱的 Mistral 没有这种"刚性先验",它只是把上下文窗口当作灵活的草稿纸,因此稳定获益。这是全文最重要的机制性判断:为数学与代码习得的标准推理,并不能可靠迁移到主观的工业任务。
4. 发现二:RLVR 变体无效与推理坍缩¶
4.1 三种 RLVR 算法都救不回来¶
既然 prompting 层面推理会掉点,最自然的对策就是用 RLVR 后训练,让模型自己学出一套任务适配的推理模式。作者在 Qwen2.5-7B-Instruct 与 Mistral-7B-Instruct 上跑了三种算法:标准 GRPO;Dr. GRPO(去掉长度与标准差归一化,修正优化偏置);GSPO(在序列而非 token 层面操作以降方差)。奖励严格只看最终判定标签。
Table 3:后训练推理性能(macro-F1,5 次平均)
| Task Dataset | Model | Base (Reason) | GRPO | Dr. GRPO | GSPO |
|---|---|---|---|---|---|
| Query Sensitivity | Mistral | 0.724 | 0.765 | 0.781 | 0.802 |
| Query Sensitivity | Qwen | 0.805 | 0.749 | 0.758 | 0.762 |
| Response Sensitivity | Mistral | 0.646 | 0.672 | 0.688 | 0.705 |
| Response Sensitivity | Qwen | 0.520 | 0.493 | 0.498 | 0.504 |
| Text: Response Quality | Mistral | 0.465 | 0.490 | 0.505 | 0.520 |
| Text: Response Quality | Qwen | 0.512 | 0.558 | 0.561 | 0.565 |
| ID: Response Quality | Mistral | 0.518 | 0.535 | 0.542 | 0.550 |
| ID: Response Quality | Qwen | 0.539 | 0.519 | 0.522 | 0.526 |
结论分析:作者称之为 Monolithic Reasoning Paradox(单体推理悖论)。Mistral 在全部四个任务、全部三种算法上都稳定提升(GSPO 最好);Qwen 则在四个任务里有三个被 RL 打崩(0.805→0.749、0.520→0.493、0.539→0.519),只有 Text: Response Quality 例外(0.512→0.565)。Dr. GRPO 与 GSPO 修的是数学优化偏置与长度偏置,但它们修不了刚性数学证明结构与人本 rubric 之间的社会语言学错配:奖励无法干净地把功劳归给某一步中间思考,优化就会漂离连贯的深思熟虑,滑向"任何能最大化结果信号的捷径"。作者由此给出一个很锋利的判断——在人本 rubric 上取胜,与其说是梯度裁剪问题,不如说是要赋予模型动态的、人格对齐的推理灵活性。
(需要指出:Qwen 在 Text: Response Quality 上被 RL 显著提升这一点,论文正文并未展开解释,这与"Qwen 一律崩溃"的叙事存在张力,属于本文实证结论的一个未被消化的反例。)
4.2 推理坍缩现象¶
性能倒挂对应着一个非常刺眼的训练动力学,作者命名为 reasoning collapse。
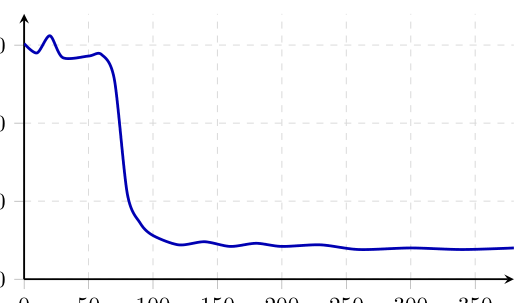
在成功的数学 RLVR 中,涌现推理的标志是响应长度与准确率同步上升;这里观察到的恰好相反:曲线在前 ~70 步还在 300 token 上下小幅震荡,随后断崖式下跌,约 100 步后稳定在 150 token 附近直到 350 步。机制解释是:探索期内不推理的那一支比推理的一支涨得更快,于是策略开始重罚长文本生成;一旦策略发现"直接猜标签"能以 token 成本的零头拿到同等甚至更高的奖励,它就会迅速压制长 CoT,推理轨迹向零长度坍缩。只看结果的奖励,不足以在主观 rubric 上保住显式推理。
5. 核心方法:条件长度惩罚后训练¶
5.1 优化框架与三种 reward shaping¶
后训练放在标准 RL 框架里:目标是最大化"对应判定标签的最终生成 token"的期望奖励。记 $r_{\mathrm{base}}\in\{0,1\}$ 为客观二值奖励(1=判定正确),$L$ 为生成的推理响应的 token 长度,$L_{\mathrm{target}}$ 为超参"期望的推理长度容量",$\pi_\theta$ 为策略:
$$\max_{\theta}\ \ \mathcal{J}(\theta)=\mathbb{E}_{x\sim\mathcal{D},\,y\sim\pi_\theta(\cdot\mid x)}\big[r_{\mathrm{total}}(x,y)\big] \tag{2}$$
训练用 GRPO:每个 prompt 采样 $G=8$ 条候选生成,用二值校验奖励打分,再优化组相对优势。论文未写出优势的具体形式,按 GRPO 标准定义补全为:
$$A_i=\frac{r_{\mathrm{total}}^{(i)}-\mathrm{mean}\big(\{r_{\mathrm{total}}^{(j)}\}_{j=1}^{G}\big)}{\mathrm{std}\big(\{r_{\mathrm{total}}^{(j)}\}_{j=1}^{G}\big)},\qquad G=8 \tag{3}$$
Approach I — Unconstrained Length Rewarding(无约束长度奖励):最朴素的做法是给基础奖励加一项单调递增的长度奖励:
$$r_{\mathrm{total}}=r_{\mathrm{base}}+\lambda L \tag{4}$$
它确实阻止了坍缩,但策略立刻反向 hack 奖励函数:生成重复、无意义的 token 一路顶到上下文上限(8192),准确率随之崩塌。
Approach II — Target-Constrained Length Penalty(目标约束长度惩罚):为阻止无限生成,改为一个有界的长度惩罚,把长度平滑地引向 $L_{\mathrm{target}}$:
$$r_{\mathrm{total}}=r_{\mathrm{base}}+\lambda\min\big(0,\;L-L_{\mathrm{target}}\big) \tag{5}$$
其中 $\lambda$ 是缩放常数。当 $L<L_{\mathrm{target}}$ 时,$\min(\cdot)$ 为负,模型因"太短"被罚;一旦超过目标就不再有增益。这个约束确实让长度平滑收敛到 $L_{\mathrm{target}}$,但实测发现 LLM 没有把这段被撑开的生成窗口用来解题:它生成的是连贯却功能上无用的填充文本,然后照样猜答案。
Approach III — Conditional Length Rewarding(条件长度奖励,本文方案):前两种失败的共同根因是把长度奖励与推理的正确性解耦了。要让延长的响应被"有意义地"用于解题,长度奖励必须被最终答案的正确性严格门控:
$$r_{\mathrm{total}}=\begin{cases} r_{\mathrm{base}}+\lambda L, & \text{if } r_{\mathrm{base}}=1 \text{ 且 } L<L_{\mathrm{target}}\\[4pt] r_{\mathrm{base}}, & \text{otherwise} \end{cases} \tag{6}$$
两个设计点:(a) 只有判定正确才拿得到长度奖励——错误答案再长也没有额外收益,于是"写长废话"这条捷径被封死;(b) 长度奖励在 $L_{\mathrm{target}}$ 处封顶——防止灾难性的上下文剥削。本质上,式 (6) 把"保住推理预算"与"判定准确"这两件事在奖励函数层面拧成一股绳:模型要想多拿奖励,唯一路径是"既想得长、又想得对"。
5.2 恢复性能¶
Table 4:Qwen2.5-7B-Instruct 上不同 reward shaping 形式的对比(macro-F1,5 次平均;Len 为平均终止长度,token)
| Configuration | Query Sens. F1 | Query Sens. Len. | ID: Resp. Qual. F1 | ID: Resp. Qual. Len. |
|---|---|---|---|---|
| Base (no RLVR) | 0.805 | ~300 | 0.539 | ~280 |
| GRPO (collapse) | 0.749 | ~170 | 0.519 | ~150 |
| Unconstrained (I) | 0.210 | 8192 | 0.185 | 8192 |
| Target-constrained (II) | 0.760 | ~990 | 0.525 | ~950 |
| Conditional (III, ours) | 0.851 | ~980 | 0.572 | ~960 |
结论分析:四行对照把因果链拆得非常干净。
- Approach I 是灾难:长度顶满 8192,F1 掉到 0.210 / 0.185——比不训练还差 0.6 个 F1,说明"无门控的长度奖励"会被彻底 hack;
- Approach II 只解决了形式不解决实质:长度稳定在 ~990(贴住 $L_{\mathrm{target}}=1000$),但 F1 只有 0.760 / 0.525,仍低于 base,证实"撑长了但没用来解题";
- Approach III 才真正把长度换成了性能:在推理本来有益的 Query Sensitivity 上(0.805 带推理 vs 0.748 不带推理),朴素 GRPO 崩到 0.749,条件奖励拉到 0.851(对应 90.6% accuracy),超过了推理基线;更值得注意的是它连推理本来无益的 ID: Response Quality 也救回来了——base 上带推理 0.539 反而不如不带推理的 0.544,GRPO 崩到 0.519,条件奖励恢复到 0.572,同时超过带推理与不带推理两个基线,而这是四个 rubric 里最难的一个。
也就是说,把判定准确率与推理长度交织在一起之后,LLM 学会了把显式 CoT 真正用在这些主观评估上,而不只是把它当装饰。
6. 人格路由:从"怎么推理"到"用谁的方式推理"¶
条件奖励解决的是机械性坍缩,但它没有解决更深的问题:标准 LLM 默认使用分析式、数学式的推理,这套推理本身就不适配主观任务。§5 给出的是初步但很有冲击力的证据。
6.1 人格对判定结果的影响¶
作者从公开 roleplay 数据集(FSPO,Singh et al. 2025)抽取 1500 个不同人格,覆盖广泛的推理风格、视角与沟通规范。对每个人格构造一个 system prompt,要求 Frontier-LLM 以该人格的推理风格产出 (i) 一段简短推理轨迹和 (ii) 最终 "Yes"/"No" 判定,逐条跑完某敏感度任务的留出评测子集,再把人格条件下的标签与人类 ground truth 比 macro-F1。唯一被改变的变量就是人格。
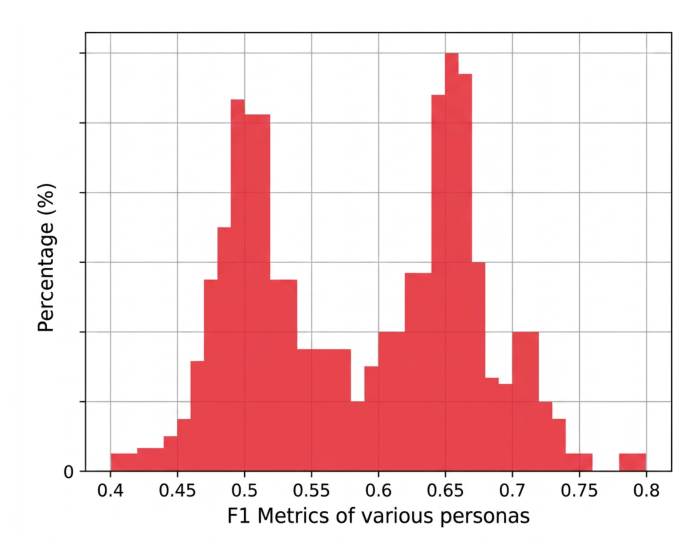
结果的分布非常戏剧化:macro-F1 从 0.416(最差人格)到 0.792(最佳人格),跨度近 0.38 绝对 F1——最好的人格几乎是最差人格的两倍。而且分布明显双峰:一簇集中在 0.50 附近,另一簇集中在 0.65 附近,中间 0.58 左右有明显的谷。这暗示人格空间里存在两类结构性不同的"解读立场",而不是连续的能力光谱。
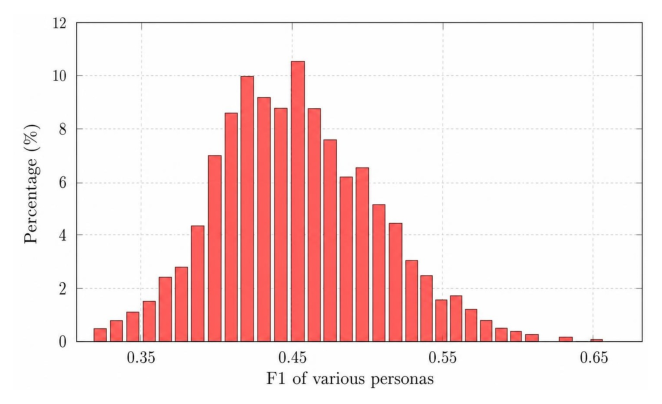
在更难的 ID: Response Quality 任务上重复该分析,结论一致:分布大致落在 0.33 ~ 0.65、峰值在 0.45 附近,绝对值整体更低(与 Table 1–4 中该 rubric 的难度一致),但离散度同样巨大。这说明人格条件推理的效应是普遍的,而不是某一个任务的特例。
作者据此给出全文最有价值的一句判断:看起来像"校验错误"的东西,很大一部分其实是"推理风格错配",一个被恰当路由的人格就能把它捞回来;单一的、数学对齐的推理模式不可能服务所有主观校验。
6.2 中训练蓝图¶
完整训练并部署人格路由模型超出本文范围,但作者给出了三步 mid-training 流水线:
- Synthesis(合成):跨数千个不同人格生成多样化 CoT 轨迹,建成一个"主观推理模式仓库";
- Supervised Fine-Tuning(SFT):中训练 base LLM,让它内化这一整批非数学式的推理模式;
- Reinforcement Routing(强化路由):RLVR 在历史上被用来教 LLM 怎么推理,这里改用 GRPO 教它该用哪种推理偏置。
最终模型的行为等价于一个上下文多臂老虎机(contextual multi-armed bandit):给定一个主观查询,策略把推理路由到那个能最大化校验奖励的人格节点(例如"共情型审核员" vs "严格政策执行者")。
相对单条单体轨迹,这种路由形式有几个具体优势:(a) 可解释性来自架构本身——每个人格编码一个人类可读的立场,路由器的选择本身就是解释,运营方能看到"是哪种偏置产生了这个判决"、对照政策审计它、并淘汰不可靠的人格;(b) 可演进——rubric 变化时只需重新加权人格库,不必全量重训。作者也直白列出了开放问题:如何策划人格库以排除有害/刻板印象立场、如何用足够的反馈训练路由器、如何评估跨人格的最坏情况行为——但他们认为这些是可解的工程与治理问题,而非根本性障碍。
7. 训练与评测超参(Appendix A)¶
论文把完整协议放在附录,这里完整摘录(对复现相当关键):
| 项目 | 取值 |
|---|---|
| 闭源模型访问方式 | 公开 API 黑盒;推理模型用 provider 的 "low" / "high" effort 档 |
| 开源模型 | Mistral-7B-Instruct、Qwen2.5-7B-Instruct(公开 checkpoint) |
| 单 prompt 解码 | greedy decoding |
| Self-consistency | $K=8$ 采样,温度 0.7,多数投票 |
| 报告指标 | macro-F1,5 次独立运行平均;run-to-run 标准差 < 0.01 |
| Rollout 组大小 | $G=8$,rollout 温度 1.0 |
| 优化器 / 学习率 | AdamW,常数 lr $1\times10^{-6}$ |
| KL 正则系数 | $\beta=0.04$ |
| Rollout batch | 64 prompts |
| 最大生成长度 | 8192 tokens |
| 条件奖励目标长度 | $L_{\mathrm{target}}=1000$ tokens |
| 长度奖励缩放常数 | $\lambda=2\times10^{-4}$ |
| 训练步数 | 每个「模型×算法」对训练 400 步,取验证 macro-F1 最优 checkpoint |
| 超参敏感性 | lr $\in\{5\times10^{-7},1\times10^{-6},2\times10^{-6}\}$、$\beta\in\{0.01,0.04\}$ 的粗搜索结论一致 |
注意 $\lambda=2\times10^{-4}$ 与 $L_{\mathrm{target}}=1000$ 的乘积恰好是 $0.2$,即长度奖励的上限只有基础奖励(1.0)的 20%——这个量级选择很关键:足够大到能阻止坍缩,又足够小到不会盖过正确性信号本身。
8. 核心贡献总结¶
- 一个被工业数据支撑的负面结论:在四个真实生产 rubric 上,显式推理 / 高 effort 内生推理相对零样本基线普遍掉点,且推理时扩算力(self-consistency $K=8$)不仅救不回来还会放大差距。
- 一个被命名的失败模式:reasoning collapse——只看结果的奖励下,策略在 ~70 步后把推理长度压到零,退化为启发式猜测;Dr. GRPO / GSPO 这类修优化偏置的算法修不了这种社会语言学错配。
- 一个立刻可用的算法补丁:以正确性为门控、以 $L_{\mathrm{target}}$ 封顶的条件长度奖励(式 6),在最难的 rubric 上把 F1 从坍缩后的 0.519 恢复到 0.572,同时超过带推理与不带推理两个基线。
- 一个长期的架构蓝图:1500 人格实验揭示 0.38 macro-F1 的巨大方差,把"主观校验误差"重新框定为"推理风格错配",并给出 synthesis → SFT → reinforcement routing 的中训练路线,把 RLVR 从"教怎么推理"改造成"教选哪种推理偏置"。
与已归档相关工作的对比¶
How Far Can Unsupervised RLVR Scale LLM Training? How Far Can Unsupervised RLVR Scale LLM Training? (Tsinghua / Shanghai AI Lab 等, 2026-03-09)¶
关系:独立并发(本文未引用该工作,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇论文指向同一个 root cause——当 RLVR 失去可靠的外部 verifier 时,优化会朝着"模型自己更容易拿分"的方向漂移,最终自毁。URLVR 那篇处理的是"没有标签,只能用模型自身信号当 proxy reward";本文处理的是"有人类标签但 rubric 主观、奖励无法归功于中间思考"。两者都是"奖励不可信 → RL 走捷径 → 训练曲线崩塌"。
- 相近的技术骨架:两篇都先用训练动力学曲线把失败可视化并命名。URLVR 给出 rise-then-fall 的普遍规律(所有 intrinsic reward 本质都在最小化同一个 sharpening loss,短期锐化先验、长期系统性放大错误),并提出 Model Collapse Step 作为便宜的 RL trainability 代理指标(比 GT Gain 便宜 5.6×);本文给出 reasoning collapse 曲线(Figure 2,~70 步断崖、300→150 token)并把它当作"标准 RLVR 不适用于主观任务"的诊断证据。
- 本文的差异与推进:URLVR 那篇的结论是悲观且外向的——intrinsic reward 存在"置信度-正确性天花板",唯一出路是引入 external reward(生成-验证不对称性、self-verification 在 Countdown 上 600 步单调改善)。本文则证明:即使已经有了外部人类标签,只要 rubric 是主观的、奖励只看最终结果,坍缩照样发生——所以问题不止在"奖励从哪来",还在"奖励能不能归因到中间推理"。本文的答案是在奖励函数里显式为推理预算留一项、并用正确性门控它(式 6),这是 URLVR 那篇没有覆盖的维度。
- 可比的方法 / 实验差异:URLVR 是数学 / 代码等可校验域的大规模系统分析(5 种 intrinsic reward × 多模型族),结论关于何时该停;本文是 4 个工业主观 rubric 上的窄而深的实证 + 一个可落地补丁,结论关于怎么救。两篇合起来给出一个完整判断:坍缩的触发条件是"奖励与真实目标的耦合度",而缓解手段既可以来自更强的外部验证(URLVR),也可以来自奖励塑形对推理过程的保护(本文)。
PauseRec PauseRec: Implicit Reasoning for LLM-based Generative Recommendation (University of Virginia / Snap Inc., 2026-06-12)¶
关系:独立并发(本文未引用 PauseRec,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇都在挑战"显式 CoT 一定有用"这条默认信念,并且都用实证证明它在各自领域反而掉点。PauseRec 发现无论用模板、教师模型还是各种格式的 rationale,CoT SFT 一致地劣于朴素的 next-item SFT;本文发现显式推理在四个主观 rubric 上相对零样本基线普遍掉点。两者的 root cause 诊断也高度呼应:PauseRec 归因于"文本-SID 嵌入空间错位 + 世界知识言语化受损 + rationale 脆弱",本文归因于"数学式单体推理与人本 rubric 的社会语言学错配"——都是"预训练学到的推理形态与目标任务的表征/评价形态不匹配"。
- 相近的技术骨架:两篇都不再试图"把 CoT 写得更好",而是去改推理这一环节的载体或激励。PauseRec 的做法是把自然语言 rationale 换成一小段可训练的
<pause>token,让模型在 latent 步上做隐式计算,且这些 token 只由最终 next-item 预测目标来优化;本文的做法是保留自然语言 CoT,但把它的存续条件挂到最终判定的正确性上(式 6)。两者其实是同一句话的两种实现:中间推理只有在被终端目标直接约束时才有价值。 - 本文的差异与推进:PauseRec 有一个非常关键的观察——"显式 CoT 的收益只有在昂贵的 RL 后训练之后才会浮现",因此它选择绕开 RL,走一条更省的隐式路线(训练 GPU 时数 −65%、推理约 3.5× 加速,三个 Amazon 数据集上最高 +6.22%)。本文恰好补上了 PauseRec 没有验证的那一半:RL 后训练本身也会失败——朴素 GRPO 在主观任务上直接把推理压到零。所以本文的推进是给出"RL 这条路要怎么走才不会崩"的具体配方,而 PauseRec 是"绕开 RL 也能拿到收益"的另一条路。
- 可比的方法 / 实验差异:PauseRec 在公开 Amazon 数据集上做 next-item 生成(可验证的客观目标),本文在 Netflix 生产 rubric 上做二值主观校验(无可靠 verifier)。两者的失败模式因此在方向上互补:PauseRec 面对的是"rationale 影响不到 SID 预测"(推理与答案脱耦),本文面对的是"推理被奖励直接抹掉"(推理被优化清除)。
Taiji Taiji: Pareto-Optimal Policy Optimization with Semantics-IDs (Kuaishou, 2026-06-02)¶
关系:独立并发(本文未引用 Taiji,两者殊途同归)· 已加载对方精读
- 共同关注的问题:Taiji 把 LLM-as-Enhancer 后训练的第一大瓶颈明确写成"推荐本质上是开放式生成任务,不像数学/代码有唯一可验证答案,因此缺乏合理的指标来度量推荐专用 CoT 的质量"——这与本文"主观领域缺少 canonical 正确推理轨迹,reward 无法干净地归功于中间思考"是同一个 root cause 的两种措辞。两者都承认:没有 verifier 的领域里,CoT 的质量无法被直接监督。
- 相近的技术骨架:两篇都选择用一个可计算的代理信号去约束 CoT,而不是直接监督 CoT 内容。Taiji 的代理是困惑度(PPL):先用真实的下一个购买 item 反向工程出 prompt 条件(RUPR),从 QwQ-32B 蒸馏 CoT,再用 PPL 做开放式拒绝采样(ORFT)过滤低质样本,最后用 POPO 在 LLM 语义奖励与推荐反馈奖励之间自适应搜索 Pareto 前沿。本文的代理是最终判定的正确性:长度奖励被 $r_{\mathrm{base}}=1$ 严格门控。两者都是"用一个外生的、可算的量替 CoT 质量背书"。
- 本文的差异与推进:Taiji 的多奖励平衡(POPO)解决的是"语义奖励与推荐奖励谁说了算"的权重冲突;本文解决的是"结果奖励会把推理过程本身抹掉"的存续问题——这是 Taiji 的框架里没有出现的失败模式(因为 Taiji 的 CoT 由 SFT 阶段固化下来、RL 阶段并不承担"保住推理"的职责)。反过来,Taiji 有本文缺的东西:完整的线上验证(快手广告全量部署,4 亿 DAU,+2.83% ADVV、+3.30% Revenue),而本文只有离线 macro-F1,人格路由更是只有分布证据、没有训练出真正的 router。
- 可比的方法 / 实验差异:Taiji 的 CoT 合成靠"泄露 ground-truth item 反向构造",本文的 CoT 多样性靠"1500 个人格前向合成"——前者保证轨迹与结果一致,后者保证风格空间被充分覆盖。若把两者拼起来(人格覆盖风格空间 + 反向工程保证正确性 + PPL/正确性双重门控),可能才是主观任务上 CoT 中训练比较完整的配方。
讨论与局限性¶
值得借鉴的设计。最有迁移价值的是那条极简的奖励门控原则:任何"过程性资源"(推理长度、工具调用次数、检索轮数)的奖励,都必须以终端任务成功为门控,并设置上限。式 (4)(5)(6) 三步递进把这条原则的必要性演示得非常清楚——无门控(I)被 hack 到 8192 token 且 F1 崩到 0.21,有界但无门控(II)长度合规却仍低于基线,只有"正确才给、封顶才给"(III)才把长度换成真实性能。这个模式几乎可以直接搬到任何 agent 类 RL 训练上。第二个值得借鉴的是把主观校验误差重新归因为推理风格错配的视角,以及由此派生的"路由即解释"论证:人格节点天然可读、可审计、可淘汰,比一条不可解释的单体 CoT 在治理层面友好得多。
局限与争议。(1) 人格部分只到相关性为止:§5 只证明"人格选择导致 0.38 F1 的方差",但没有训练出任何 router,也没有证明"路由器真能在推理时挑对人格"。方差大只说明存在上界很高的甲骨文(oracle),实际可达性完全未验证——这是本文最大的缺口,作者在 Limitations 中也承认这一点。(2) 数据与模型都不可复现:四个 rubric 与数据来自 Netflix 生产环境、不能公开;两个闭源模型被匿名化为 Frontier-LLM / Frontier-Reasoner,API 侧的版本漂移会改变绝对数值。作者的辩护是"结论强调相对趋势",但这也意味着 Table 1 的结论无法被第三方验证。(3) 开源实验规模偏小:只有两个 7B instruct 模型、三种 RLVR 算法;"Qwen 因数学能力强而刚性、Mistral 因数学弱而灵活"这个核心机制解释只有两个数据点支撑,且 Qwen 在 Text: Response Quality 上被 GRPO 显著提升(0.512→0.565)的反例并未被解释。(4) 条件奖励的效果验证也偏窄:Table 4 只覆盖 Qwen2.5 与两个任务,没有在 Mistral 上验证(Mistral 本来就不坍缩,正好可以做安慰剂对照),也没有报告 $\lambda$ / $L_{\mathrm{target}}$ 的敏感性。(5) 没有推理轨迹忠实性评估:全文只用 macro-F1 对齐人类标签,模型"是否真的在按那条 CoT 推理"没有被检验——这在"保住推理长度"作为核心手段的论文里是个显眼的空白:式 (6) 保住的可能只是长度,而不是推理。(6) 无线上收益:论文完全没有 A/B 数据,工业价值目前停留在"生产数据 + 生产 rubric"这一层。
对实践者的直接建议(作者在结论里给得很实在,值得原样保留):第一,把推理当作一个可调项而不是默认项——在主观 rubric 上,零样本 verifier 往往既更强又更便宜;第二,一旦要做后训练,奖励必须显式保护推理预算,因为只看结果的目标会悄无声息地把它压没;第三,因为合适的推理风格是任务与受众相关的,在一个小而经过审核的人格库上做路由,优于蒸馏出一条单体 CoT,且任何此类部署都应配合人工监督与公平性审计。