HGenPush:把"视频"和"作者"塞进同一个生成式推荐架构,并且不再自回归¶
Xiao Liang*、Jiali Feng*、Xin Feng、Yiqing Wang、Baolin Ye、Siyao Feng、Zhihui Deng、Cunyi Zhang、Huajin Sun、Xuanping Li†、Kaiqiao Zhan、Yanan Niu、Kun Gai —— 全员 Kuaishou Technology(快手,北京)。*共同一作,†通讯作者。 arXiv:2607.03362v1,2026-07-03。KDD '26(第 32 届 ACM SIGKDD,2026-08-09~13,济州岛),9 页。DOI: 10.1145/3770855.3818429。 已全量部署于快手推送(Push Notification)系统,日活跃用户超 4 亿,线上 A/B 取得 DAU +0.181%。
研究动机与背景¶
用户要的不只是"好内容",还有"信得过的人"¶
论文开篇给出的观察非常具体:在短视频平台上,用户被吸引的对象同时包括视频内容本身与作者的人格魅力("users are drawn not only to remarkable video content but also to the personalities of authors")。作者进一步指出这个现象具有跨平台普遍性——新闻读者既追热点事件也追信得过的媒体,电商用户既买想要的商品也会去信任的商家那里逛新品。因此,"同时推荐高质量内容与可信来源"的异构推荐系统具有明确的实际价值。
这个动机决定了整篇论文的形状:它要在一个模型里同时产出两类本体不同的对象——视频(内容)与作者(来源)。
现有生成式推荐范式的两个结构性缺口¶
论文把近年生成式推荐的进展梳理为一条线:TIGER 首创用 RQ-VAE 把 item 的内容信息编码成语义 ID(Semantic ID, SID),让相似 item 之间共享知识;OneRec 提出用 reward model 对齐用户偏好的生成式推荐方案;随后 OneSug、EGA、OneLoc 等针对各自场景做适配增强,把生成式范式推进到工业系统。
但在作者看来,这条线上的方法都卡在两个地方:
- 同质内容的局限:现有方法主要聚焦单一类型的 item,难以联合推荐视频与作者这类异构内容。
- 自回归生成的效率上限:主流做法是自回归(autoregressive, AR)地逐个生成语义 ID token,推理速度受限、算力消耗大,直接限制了生成式推荐模型在生产系统中的部署。
第二点在推送场景下尤为致命——推送是主动触达通道,请求量大、时延预算紧,AR 解码需要 $L_v$ 轮串行前向,这个代价在 4 亿 DAU 的量级上无法承受。
HGenPush 的三个模块¶
HGenPush 采用 decoder-only 结构,输入用户行为序列与重要静态特征,经异构生成式推荐模块产出与用户兴趣对齐的视频与作者。三个核心模块:
- Hybrid User Behavior Understanding(混合用户行为理解)。考虑到推送与 feed 推荐之间的协同效应,融合多视角行为:长期 + 短期 feed 行为建立基础兴趣,push click 序列建模推送场景特有的行为模式,push send 序列保证推荐结果的有效性(避免重复推送)。
- Heterogeneous Generative Recommendation(异构生成式推荐)。提出 Chained Multi-Token Prediction(Chained-MTP),用"用户兴趣表征作稳定上下文 + 前序语义 ID 的累加 embedding 建模层级依赖"替代自回归计算。视频分支用多模态编码出的 SID 表示视频;作者分支则通过表征对齐学习"捕捉用户行为偏好"的作者编码,再离散成 SID 用于生成。
- User Consumption Preference Alignment(UCPA,用户消费偏好对齐)。点击只反映初始兴趣,不反映内容价值或满意度,因此遵循 RLVR(Reinforcement Learning with Verifiable Rewards)范式,用真实用户反馈生成的 reward 持续优化模型。受 CISPO 与 GSPO 启发,提出 GSISPO(Group Sequence Importance Sampling Policy Optimization),用序列级 reward 与重要性采样权重防止语义碎片化,并通过对重要性采样权重做裁剪来保留小众但高价值行为的梯度信号。
论文自述的四点贡献:系统总结用户在内容消费中的两类需求并提出联合推荐视频与作者的端到端异构生成架构;提出轻量的 Chained-MTP;设计用户消费偏好对齐模块;在快手推送系统完成部署。
整体架构¶
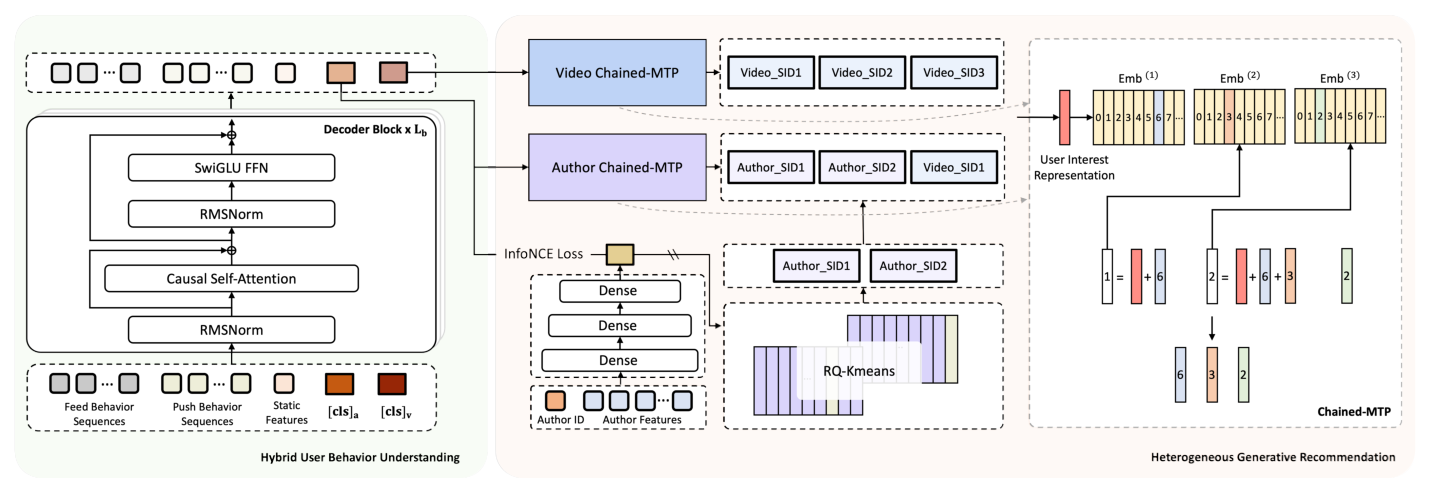
Figure 1 分三块。左侧绿色区是 Hybrid User Behavior Understanding:底部输入 Feed Behavior Sequences、Push Behavior Sequences、Static Features,以及两个特殊 token $[\text{cls}]_a$ 与 $[\text{cls}]_v$;这些表示送入堆叠 $L_b$ 层的 Decoder Block(每层为 RMSNorm → Causal Self-Attention → 残差 → RMSNorm → SwiGLU FFN → 残差)。右侧橙色区是 Heterogeneous Generative Recommendation:上半部两条并行分支——Video Chained-MTP 产出 (Video_SID1, Video_SID2, Video_SID3),Author Chained-MTP 产出 (Author_SID1, Author_SID2, Video_SID1);中间是作者侧的表征对齐通路(Author ID + Author Features → 三层 Dense → RQ-Kmeans → Author_SID1/2),InfoNCE Loss 挂在用户兴趣表征与作者表征之间,并且图中用 "\\" 标出了停止梯度;最右侧展开了 Chained-MTP 的计算细节:User Interest Representation 作为公共起点,第 1 个 head 直接由它出,第 2 个 head 的输入是"它 + 第 1 层 Emb",第 3 个 head 的输入是"它 + 第 1 层 Emb + 第 2 层 Emb",三个 head 并行出 token。
值得注意的是图中 InfoNCE 通路上的 stop-gradient 标记:作者表征对齐的梯度不回流到用户兴趣主干(或反之),这是把"学作者编码"与"学用户兴趣"两个目标解耦、防止对比损失污染主干的常见工程手段(论文正文未展开解释)。
混合用户行为理解模块(§3.1)¶
特征表示¶
记用户行为序列为 $S$,包含 feed 序列 $S_{feed}$ 与推送序列 $S_{push}$。$S_{feed}$ 由长期序列 $S_{long}$ 与短期序列 $S_{short}$ 组成,建模基础用户兴趣;$S_{push}$ 包含推送点击序列 $S_{click}$(捕捉推送场景特有的行为模式)与推送下发序列 $S_{send}$(保证推荐有效性)。
每个视频 $v$ 由其多模态 embedding 生成的语义 ID 表示,生成方法与 OneRec 一致。定义语义 ID 为 $s_v = (s_v^1, s_v^2, \cdots, s_v^{L_v})$,其中 $L_v$ 为码本层数、每层码本大小为 $N$。
先把每个语义 token 转成稠密 embedding 并拼接得到视频语义表示 $e^v_{semantic} = [e_{s_v^1}; e_{s_v^2}; \cdots; e_{s_v^{L_v}}]$,再引入额外特征以区分视频之间的影响差异。
对长期序列 $S_{long}$ 中的每个视频,引入作者标识(aid)、话题标签(tag)与播放时长(playtime),把特征 embedding 拼接后映射到统一维度 $d_h$:
$$h^i_{v_{long}} = \sigma\left(\text{Dense}\left(\left[e^{v^i_{long}}_{semantic}; e^{v^i_{long}}_{aid}; e^{v^i_{long}}_{tag}; e^{v^i_{long}}_{playtime}\right]\right)\right) \tag{1}$$
其中 $\sigma(\cdot)$ 为激活函数。长期序列整体表示为:
$$h_{long} = \{h^1_{v_{long}}, h^2_{v_{long}}, \cdots, h^{L_{long}}_{v_{long}}\} \tag{2}$$
$L_{long}$ 为 $S_{long}$ 长度,$h_{long} \in \mathbb{R}^{L_{long} \times d_h}$。这一路主要用于构建稳定而全面的用户兴趣偏好。
短期序列 $S_{short}$ 由用户近期主动交互的视频构成,反映变化中的兴趣,生成流程与上式一致:
$$h^i_{v_{short}} = \sigma\left(\text{Dense}\left(\left[e^{v^i_{short}}_{semantic}; e^{v^i_{short}}_{aid}; e^{v^i_{short}}_{tag}; e^{v^i_{short}}_{playtime}\right]\right)\right) \tag{3}$$
$$h_{short} = \{h^1_{v_{short}}, h^2_{v_{short}}, \cdots, h^{L_{short}}_{v_{short}}\} \tag{4}$$
推送场景下的用户行为直接反映其对通知的偏好与习惯,因此引入推送点击序列,并额外加入通知类型(type)特征,学习用户更倾向点击哪类内容:
$$h^i_{v_{click}} = \sigma\left(\text{Dense}\left(\left[e^{v^i_{click}}_{semantic}; e^{v^i_{click}}_{aid}; e^{v^i_{click}}_{type}\right]\right)\right) \tag{5}$$
$$h_{click} = \{h^1_{v_{click}}, h^2_{v_{click}}, \cdots, h^{L_{click}}_{v_{click}}\} \tag{6}$$
注意这里把 playtime 换成了 type:推送点击行为的落点是"点没点开这条通知",播放时长的信息含量让位于通知形态。
此外引入推送下发序列构造上下文信息,提升生成的合理性(即避免推荐用户已被下发过的内容):
$$h^i_{v_{send}} = \sigma\left(\text{Dense}\left(\left[e^{v^i_{send}}_{semantic}; e^{v^i_{send}}_{aid}; e^{v^i_{send}}_{type}\right]\right)\right) \tag{7}$$
$$h_{send} = \{h^1_{v_{send}}, h^2_{v_{send}}, \cdots, h^{L_{send}}_{v_{send}}\} \tag{8}$$
用户静态特征则充当兴趣建模的"稳定器"(stabilizer)——当用户行为稀疏时提供可靠信号。引入年龄、性别等补充特征,拼接 embedding 后映射到 $d_h$:
$$h_{static} = \sigma\left(\text{Dense}\left(\left[e_{age}; e_{gender}; \cdots\right]\right)\right) \tag{9}$$
最后拼接所有表示得到完整输入表示:
$$h_f = [h_{long}; h_{short}; h_{click}; h_{send}; h_{static}; h_{[\text{cls}]_a}; h_{[\text{cls}]_v}] \tag{10}$$
关键设计在于序列特征与静态特征之后追加了两个特殊 token $h_{[\text{cls}]_a}$ 与 $h_{[\text{cls}]_v}$,分别服务于作者推荐分支和视频推荐分支。这两个 token 用于汇总用户兴趣、为 decoder 提供初始上下文。
兴趣理解¶
模块堆叠多个结构相同的 block,每块由因果自注意力与前馈网络构成,辅以残差连接稳定梯度。定义初始层输入 $h^{(0)} = h_f$:
$$h^{(l+1)}_{attn} = \text{CausalSelfAttn}\left(\text{RMSNorm}\left(h^{(l)}\right)\right) \tag{11}$$
$$h^{(l+1)}_{add} = h^{(l)} + h^{(l+1)}_{attn} \tag{12}$$
$$h^{(l+1)} = h^{(l+1)}_{add} + \text{FFN}_{\text{SwiGLU}}\left(\text{RMSNorm}\left(h^{(l+1)}_{add}\right)\right) \tag{13}$$
用 RMSNorm 提升训练稳定性、用 SwiGLU FFN 提升表达能力(即当代 LLM 的标准 pre-norm 配方)。堆叠 $L_b$ 层后得到 $h^{(L_b)}$,归一化后得到最终输出 $h' = \{h'^{1}_{v_{long}}, h'^{2}_{v_{long}}, \cdots, h'_{[\text{cls}]_a}, h'_{[\text{cls}]_v}\}$。
由于采用因果自注意力且两个 cls token 位于序列末尾,$h'_{[\text{cls}]_a}$ 与 $h'_{[\text{cls}]_v}$ 作为"具有全局视野的序列端点",既编码了静态特征、又综合了全部前序行为,形成时序感知的兴趣表征,因而被送入后续的异构生成式推荐模块。
异构生成式推荐模块(§3.2)¶
该模块同步优化视频与作者两条推荐分支。
视频推荐分支与 Chained-MTP¶
视频分支的目标是从内容视角生成匹配用户兴趣的结果,使用从用户行为序列学到的全局兴趣表征 $h'_{[\text{cls}]_v}$ 做生成,该表征同时编码了视频语义特征与时序演化模式。
Chained Multi-Token Prediction。 主流生成式推荐依赖多次前向传播,推理低效,阻碍了在资源受限场景的部署。受 RQ-Kmeans(OneRec、QARM)启发,作者提出链式多 token 预测:既保持语义依赖、又避免多轮解码。
具体地,设目标视频 $v_t$ 的语义 ID 为 $s_{v_t} = (s^1_{v_t}, s^2_{v_t}, \cdots, s^{L_v}_{v_t})$,以 $h'_{[\text{cls}]_v}$ 作为稳定的兴趣锚点,在每一步计算前序语义 ID 的累加 embedding来建模跨语义层级的条件依赖:
$$p_{s^k_{v_t}} = \text{softmax}\left(\text{FFN}^{(k)}\left(h'_{[\text{cls}]_v} + \sum_{j<k}\text{Emb}^{(j)}\left(s^j_{v_t}\right)\right)\right)_{s^k_{v_t}} \tag{14}$$
其中 $p_{s^k_{v_t}}$ 是第 $k$ 个语义 token $s^k_{v_t}$ 的生成概率,$k \in \{1, 2, \cdots, L_v\}$。模型维护一组可学习的层级码本 embedding 表 $\{\text{Emb}^{(k)}\}_{k \in \{1,2,\cdots,L_v\}}$,其中 $\text{Emb}^{(k)} \in \mathbb{R}^{N \times d_h}$ 编码第 $k$ 层的语义 token,从而刻画不同粒度的语义空间。
这条公式是全文的技术核心,值得逐项拆解其设计动机:
- 为什么不用自回归:AR 需要 $L_v$ 次完整的 decoder 前向;Chained-MTP 只需一次主干前向 + $L_v$ 个并行小 FFN head,把串行深度从 $O(L_v)$ 压到 $O(1)$。
- 为什么要"锚点"$h'_{[\text{cls}]_v}$:如果 head 只看前序 token embedding,生成过程容易脱离用户兴趣发生兴趣漂移(interest drift);把兴趣表征作为公共加性基线,保证每一层的预测都锚在同一个用户上下文上。
- 为什么要"累加"而非"拼接/注意力":$\sum_{j<k}\text{Emb}^{(j)}(s^j_{v_t})$ 是对 RQ-Kmeans 残差量化结构的直接模仿——残差量化中 item 表示恰是各层质心之和,因此"前 $k-1$ 层码字之和"正是当前残差之前已被解释掉的那部分表示。用加法把它注入第 $k$ 个 head,等价于告诉 head"前面已经定位到哪儿了",从而在不引入 Transformer 复杂计算的前提下保留层级语义依赖。
- 每层独立的 $\text{FFN}^{(k)}$ 与 $\text{Emb}^{(k)}$:显式承认了 SID 各层槽位不是同质的(第 1 层是粗粒度类目、末层是细粒度属性),必须独立参数化。
训练阶段用交叉熵优化,视频分支损失为:
$$\mathcal{L}_{v-MTP} = -\frac{1}{B}\sum_{b=1}^{B}\sum_{k=1}^{L_v}\log\left(p_{s^k_{v_b}}\right) \tag{15}$$
$B$ 为 batch size,$p_{s^k_{v_b}}$ 是样本 $b$ 第 $k$ 个语义 token 的生成概率。训练样本基于推送系统中的用户点击数据构造。
作者推荐分支¶
作者分支识别可能维持用户长期参与的作者,并推送其视频。论文的关键论断是:用户对作者的信任强烈体现在行为中——即便两个作者属于相似品类,用户也可能只偏爱其中一个,这种偏好无法从内容本身推断。因此作者分支被设计成"带行为表征对齐的端到端生成架构",同时学习偏好感知的作者编码与可信作者生成。
Behavior-based Representation Alignment(基于行为的表征对齐)。 仅从作者特征生成的语义 ID 难以区分品类相似作者之间的用户偏好。解法是用用户点击数据把作者表征与用户兴趣表征对齐,从而学到用户与作者之间的双向受众信息。先把目标作者特征(如作者标识与多模态 embedding)编码为隐向量 $h'_a$,再把用户兴趣表征 $h'_{[\text{cls}]_a}$ 与作者表征 $h'_a$ 投影到统一特征空间得到 $h_u$ 与 $h_a$,用 InfoNCE 对比损失对齐:
$$\mathcal{L}_{align} = -\frac{1}{B}\sum_{b=1}^{B}\log\frac{\exp\left(\cos\left(h_{u_b}, h_{a_b}\right)/\tau\right)}{\sum_{b'=1}^{B}\exp\left(\cos\left(h_{u_b}, h_{a_{b'}}\right)/\tau\right)} \tag{16}$$
$\tau$ 为温度系数,$\cos(\cdot)$ 为余弦相似度,负样本取自 batch 内其他作者。
Author Semantic IDs Construction(作者语义 ID 构建)。 为高效生成可信作者,把对齐后的作者 embedding 离散成语义 ID,采用 RQ-Kmeans 算法并在模型训练中同步更新码本。设 $L_a$ 为作者码本层数、$N$ 为每层码本大小、$h_{a_t}$ 为目标作者 $a_t$ 的 embedding。第一层初始残差 $\boldsymbol{r}^1_{a_t} = h_{a_t}$,第 $l$ 层最近质心索引为:
$$s^l_{a_t} = \arg\min_{n}\left\|\boldsymbol{r}^l_{a_t} - \boldsymbol{c}^n_l\right\|^2_2 \tag{17}$$
$\boldsymbol{c}^n_l$ 是第 $l$ 层码本第 $n$ 个质心的 embedding,$l \in \{1, 2, \cdots, L_a\}$。得到 $s^l_{a_t}$ 后,下一层残差由 $r^{l+1}_{a_t} = r^l_{a_t} - \boldsymbol{c}^{s^l_{a_t}}_l$ 生成。迭代计算得到作者语义 ID $s_{a_t} = (s^1_{a_t}, s^2_{a_t}, \cdots, s^{L_a}_{a_t})$。
采用 SimVQ 策略进一步稳定离散化过程、防止码本坍缩(codebook collapse)。此外,用每层残差与其最近质心 embedding 的欧氏距离作为损失以在训练中持续更新码本:
$$\mathcal{L}_{codebook} = \frac{1}{B}\sum_{b=1}^{B}\sum_{l=1}^{L_a}\left\|\text{sg}\left(\boldsymbol{r}^l_{a_b}\right) - \boldsymbol{c}^{s^l_{a_b}}_l\right\|^2_2 \tag{18}$$
$\text{sg}(\cdot)$ 为 stop-gradient——即残差侧不回传梯度,只更新质心,这与 Figure 1 中标注的停止梯度一致。
Mixed Semantic IDs Generation(混合语义 ID 生成)。 由于作者分支最终推荐的仍是可信作者的视频,作者提出以"混合语义 ID"作为生成目标:把作者语义 ID 与目标 item 的第一层视频语义 ID 拼接,构成
$$s_{m_t} = \left(s^1_{a_t}, s^2_{a_t}, \cdots, s^{L_a}_{a_t}, s^1_{v_t}\right),\quad L_m = L_a + 1$$
仍基于 $h'_{[\text{cls}]_a}$ 应用 Chained-MTP 高效生成,作者分支损失为:
$$\mathcal{L}_{a-MTP} = -\frac{1}{B}\sum_{b=1}^{B}\sum_{x=1}^{L_m}\log\left(p_{s^x_{m_b}}\right) \tag{19}$$
这个"混合 SID"设计是本文一个相当精巧的点:它让作者分支的输出天然可落地——生成的不是一个抽象的作者,而是"某个可信作者的某一类视频",既完成了作者级推荐,又建模了"用户偏爱该作者的哪类视频",直接产出可下发的候选。
用户消费偏好对齐(UCPA,§3.3)¶
监督训练能带来稳定的推荐能力,但只依赖点击数据无法捕获内容质量与用户满意度,会导致标题党(clickbait)推荐。实际上用户在 App 内的消费行为不仅提供更丰富的兴趣信号,也帮助模型识别内容的内在价值。因此设计遵循 RLVR 范式的 UCPA 模块:用点击后 session 的反馈作为 reward,通过 GSISPO 优化模型。
奖励信号¶
定义点击后 session 中消费的 $G$ 个视频为 $V = \{v_1, v_2, \cdots, v_G\}$,对每个视频 $v_g$ 按固定规则量化用户消费行为得到 reward $r_g$:
$$r_g = \begin{cases} r_g + 2 & \text{if } \text{label}_g \in \{\text{valid\_play},\ \text{enter\_profile},\ \text{comment\_stay}\} \\ r_g + 1 & \text{if } \text{label}_g \in \{\text{like},\ \text{follow},\ \text{share},\ \text{comment}\} \\ r_g - 2 & \text{if } \text{label}_g \in \{\text{short\_play}\} \\ r_g - 5 & \text{if } \text{label}_g \in \{\text{dislike}\} \\ r_g - 10 & \text{if } \text{label}_g \in \{\text{report}\} \end{cases} \tag{20}$$
$r_g$ 初始化为 0,并累加所有被命中条件的奖励。这个奖励结构激励生成有吸引力的内容,同时通过负反馈抑制低质或用户不喜欢的视频。
规则本身透露了快手对内容生态的价值排序:有效播放、进入个人主页、评论区停留($+2$)被赋予比点赞、关注、分享、评论($+1$)更高的权重——即深度消费行为的价值高于轻交互行为;而举报($-10$)与不喜欢($-5$)的惩罚远重于短播($-2$),说明系统对显式负反馈极度敏感。注意"enter_profile(进入作者主页)"被列入最高档,这与作者推荐分支的目标形成呼应。
GSISPO¶
设 $R = \{r_1, r_2, \cdots, r_G\}$ 为视频集合 $V$ 的奖励。先归一化得到每个视频在组内的相对优势:
$$\hat{A}_g = \frac{r_g - \text{mean}(r_1, r_2, \cdots, r_G)}{\text{std}(r_1, r_2, \cdots, r_G)} \tag{21}$$
由于 Chained-MTP 基于前序结果的累加 embedding 生成下一个语义 ID 以保证整条序列的语义连贯,作者参考 GSPO 计算序列级重要性采样权重与生成概率,避免破坏序列的完整语义、增强训练稳定性;同时由于相对优势是针对视频而非单个语义 ID 定义的,序列级计算也与优化目标一致。此外遵循 CISPO,把裁剪操作移到重要性采样权重上,保留小众但高价值行为的梯度信号。最终优化目标为:
$$\mathcal{L}_{\text{GSISPO}}(\theta) = -\frac{1}{G}\sum_{g=1}^{G}\text{sg}\left(w_g(\theta)\right)\hat{A}_g\log\pi_\theta\left(s_{v_g}\mid h'_{[\text{cls}]_v}\right) \tag{22}$$
其中 $s_{v_g} = \{s^1_{v_g}, s^2_{v_g}, \cdots, s^{L_v}_{v_g}\}$ 为视频 $v_g$ 的语义 ID,$w_g(\theta)$ 与 $\pi_\theta(s_{v_g}\mid h'_{[\text{cls}]_v})$ 分别为序列级重要性采样权重与模型生成概率。$w_g(\theta)$ 的计算为:
$$w_g(\theta)' = \left(\frac{\pi_\theta\left(s_{v_g}\mid h'_{[\text{cls}]_v}\right)}{\pi_{\theta_{old}}\left(s_{v_g}\mid h'_{[\text{cls}]_v}\right)}\right)^{\frac{1}{L_v}} = \exp\left(\frac{1}{L_v}\sum_{k=1}^{L_v}\log\frac{\pi_\theta\left(s^k_{v_g}\mid h'_{[\text{cls}]_v}, s^{<k}_{v_g}\right)}{\pi_{\theta_{old}}\left(s^k_{v_g}\mid h'_{[\text{cls}]_v}, s^{<k}_{v_g}\right)}\right) \tag{23}$$
$$w_g(\theta) = \text{clip}\left(w_g(\theta)', 1-\epsilon, 1+\epsilon\right) \tag{24}$$
式 (23) 的 $\frac{1}{L_v}$ 次方是 GSPO 的长度归一化:把整条 SID 序列的似然比开 $L_v$ 次方,使权重量纲不随序列长度漂移。式 (22) 中 $w_g(\theta)$ 外包了 $\text{sg}(\cdot)$——这是 CISPO 的关键动作:重要性采样权重只作为标量系数参与前向,不贡献梯度,梯度全部来自 $\log\pi_\theta$ 项。这样即使某个样本的权重被裁剪到边界(在 PPO 里意味着该样本梯度被完全屏蔽),它的 $\log\pi_\theta$ 梯度仍然按裁剪后的系数保留下来——这正是"保留小众但高价值行为的梯度信号"的机制。
由于 $\mathcal{L}_{\text{GSISPO}}$ 与 $\mathcal{L}_{v-MTP}$ 共同引导参数更新,而 $\mathcal{L}_{v-MTP}$ 保证了模型的稳定性,强化学习目标不额外引入 KL 散度。这是一个务实的工程选择:用监督损失充当隐式的信任域约束,省掉参考模型的一份显存与前向开销。
联合训练与推理(§3.4)¶
HGenPush 联合优化视频推荐、作者推荐、作者码本构建与用户消费偏好对齐,总损失为四项直接相加、无加权系数:
$$\mathcal{L} = \mathcal{L}_{v-MTP} + \mathcal{L}_{a-MTP} + \mathcal{L}_{codebook} + \mathcal{L}_{\text{GSISPO}} \tag{25}$$
推理阶段,视频与作者两条分支都用 Beam Search 生成多个候选。线上系统遵循标准的级联推荐架构(retrieval → pre-ranking → ranking),但与传统召回方法不同,HGenPush 生成的候选跳过 pre-ranking 阶段,直接进入 ranking 模型。这个部署细节值得注意:它意味着团队认为生成式召回的候选质量已高到不需要粗排过滤,同时也省下了一层线上计算。
实验设置(§4.1)¶
数据集。 在快手推送系统上实验,该系统记录日均超 4 亿活跃用户的交互,提供大规模真实数据用于训练与评估。模型用系统产生的在线流式数据持续训练(continuous / streaming training)。离线评估时加载各模型同一时刻保存的 checkpoint,在从线上系统采集的同一数据集上评估,以保证可比性与可靠性。全文没有使用任何公开学术数据集。
Baseline。
- SASRec:单向 Transformer 架构,通过自注意力有效建模用户序列以预测下一个 item。
- TIGER:用 RQ-VAE 生成的层级语义 ID 替代 item ID,并用自回归生成实现序列推荐。
评估指标。 模型通过 Beam Search 一次生成多个候选,定义 HitRate@100 为评估指标——计算真实语义 ID 出现在 top-100 候选中的样本比例:
$$\text{HitRate@100} = \frac{1}{S}\sum_{i=1}^{S}I\left(s_i \in C^i_{100}\right) \tag{26}$$
$S$ 为样本数,$s_i$ 为第 $i$ 个样本的真实语义 ID,$C^i_{100}$ 为模型为第 $i$ 个样本生成的 top-100 候选,$I(\cdot)$ 为二值指示函数。
实现细节。 稠密参数用 Adam、稀疏参数用 AdamW,两者学习率均为 $1\times10^{-4}$;weight decay $1\times10^{-4}$;batch size 64;训练在 NVIDIA L20 GPU 上进行。decoder 层数 $L_b = 16$,统一表示维度 $d_h = 512$。视频码本数 $L_v = 3$、每层码本大小 $N = 8192$;作者码本数 $L_a = 2$、每层码本大小同为 8192。强化学习阶段限制每组视频数不超过 50。
主要实验结果¶
离线性能对比(§4.2,Table 1)¶
| Model | HitRate@100 (Video Branch) | HitRate@100 (Author Branch) |
|---|---|---|
| SASRec | 0.3093 | 0.3495 |
| TIGER | 0.3802 | 0.4677 |
| HGenPush | 0.3915 | 0.4848 |
结论分析。 HGenPush 与 TIGER 都优于 SASRec,验证了语义 ID 与生成式推理的有效性(TIGER 相对 SASRec 在视频分支 +22.9%、作者分支 +33.8%——语义 ID 带来的共享知识在这两个任务上收益都很大)。HGenPush 在两个任务上均取得最优:
- 视频分支(0.3802 → 0.3915,+2.97%):论文归因于更适配的 decoder-only 架构与 Chained-MTP 的组合,使其在效果与效率上同时超越基于 encoder-decoder 的 TIGER。
- 作者分支(0.4677 → 0.4848,+3.66%):归因于两点——其一,基于行为的表征对齐让作者语义 ID 能捕获用户对具体作者的细微偏好;其二,混合语义 ID 不仅实现作者级推荐,还建模了用户偏爱该作者的哪类视频,结果更精确。
批评性观察:baseline 只有 2 个,且都不是同代的生成式推荐工业方案(如 OneRec 系列本身)。作为 KDD 工业论文,缺少与自家 OneRec 或其他非自回归 SID 生成方法的正面对比,是这组实验最明显的短板。
架构设计验证(§4.3)¶
由于两条分支采用完全相同的架构组件,论文以视频推荐任务的 HitRate@100 作为代表性效果指标(作者任务趋势一致),同时汇报完整双分支模型的模型规模与推理吞吐(QPS)以反映实际部署情况。
主架构:decoder-only vs encoder-decoder(Table 2)¶
在 encoder-decoder 变体中,encoder 输入序列特征(不含 push send 序列)与静态特征,decoder 以 encoder 输出与 push send 序列为条件生成语义 ID。
| Architecture | Model Size | HitRate@100 | Loss |
|---|---|---|---|
| Encoder-Decoder | 0.026B | 0.3400 | 11.73 |
| Decoder-Only | 0.016B | 0.3432 | 12.12 |
结论分析。 decoder-only 以更少参数(0.016B vs 0.026B,−38.5%)取得可比甚至略优的效果(+0.94%),参数减少直接转化为更低显存占用与更快推理时延,故最终选定 decoder-only。
这里有一处值得警惕的不一致:decoder-only 的 HitRate 更高,但 Loss 反而更高(12.12 vs 11.73)。论文未做任何解释。合理猜测是两种架构的损失并非在同一目标/归一化下计算(encoder-decoder 变体的 send 序列进了 decoder 侧,条件信息分布不同),因此 Loss 列在这张表里其实不可跨行比较;论文却把它与 HitRate 并列呈现,容易误导。
多 token 预测方法(Table 3)¶
对比两个 baseline:
- Parallel-MTP:独立预测所有语义 ID,不建模语义依赖。
- DeepSeek-MTP:采用基于 Transformer 的层级级联结构生成语义 ID。
| Method | HitRate@100 | Max QPS per Device |
|---|---|---|
| Parallel-MTP | 0.1150 | 2.40k |
| DeepSeek-MTP | 0.3954 | 1.27k |
| Chained-MTP | 0.3915 | 1.70k |
结论分析。 这是全文最有信息量的一张表:
- Parallel-MTP 效果崩塌(0.1150,仅为 Chained-MTP 的 29.4%),证明建模语义 ID 之间的依赖是必需的。这条结论很硬——完全并行、各层独立预测的朴素方案在 $N=8192$ 的大码本上根本不工作。
- DeepSeek-MTP 用效率换效果:其 Transformer 级联结构把效果拉到 0.3954(最高),但吞吐相对 Parallel-MTP 下降 47.09%(1.27k vs 2.40k QPS)。
- Chained-MTP 是折中的赢家:效果与 DeepSeek-MTP 基本持平(0.3915 vs 0.3954,仅低 0.99%),吞吐却高出 33.86%(1.70k vs 1.27k)。
论文把 Chained-MTP 的平衡归因于两个设计选择:(1) 用用户兴趣表征作为稳定的全局上下文基线以防止兴趣漂移;(2) 计算前序语义 ID 的累加 embedding,在不引入 Transformer 复杂计算的前提下保留语义依赖。
换个角度看这张表:从 Parallel-MTP 到 Chained-MTP,加入"前序码字累加"这一个加法操作就把 HitRate 从 0.1150 拉到 0.3915(+240%),代价是吞吐从 2.40k 降到 1.70k(−29.2%)。这个投入产出比极高,也说明 Chained-MTP 的价值不在于复杂度,而在于用最便宜的算子恢复了层级依赖。
Scaling Law 分析(§4.4)¶
模型分两阶段放大:先把 decoder 层数从 8 增到 16、隐层维度从 256 增到 512,规模从 0.016B 到 0.064B;再用稀疏 MoE 模块替换稠密 FFN,把规模从 0.064B 推到 0.170B(以可控的计算开销高效提升模型容量)。
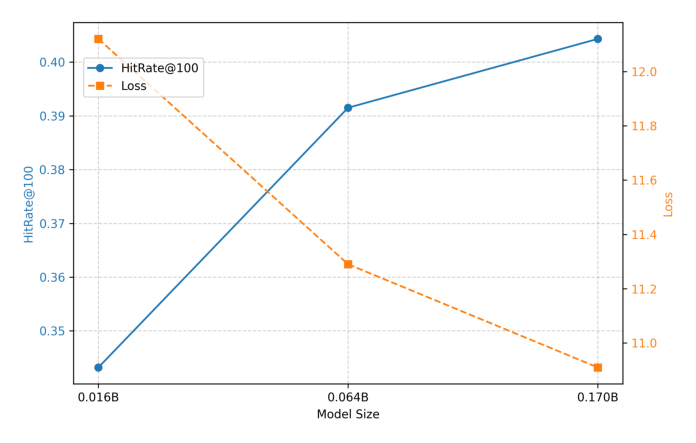
| Model Size | HitRate@100 | 相对上一档提升 |
|---|---|---|
| 0.016B | 0.3432 | — |
| 0.064B | 0.3915 | +14.07% |
| 0.170B | 0.4043 | +3.27% |
图中蓝色实线(HitRate@100)单调上升、橙色虚线(Loss)从约 12.1 单调下降到约 10.9,两条曲线走势互为镜像,说明扩容确实带来了拟合能力的提升而非过拟合噪声。
结论分析。 HGenPush 在整个区间展现出良好的扩展性质。第一阶段取得 14.07% 的显著相对提升,第二阶段仅 3.27%,体现收益递减规律。这组结果验证了 HGenPush 能有效利用增大的模型容量提升推荐质量。
需要指出:线上部署的是 0.064B 版本(Table 1/3 中 HGenPush 的 0.3915 即该配置),而非效果最好的 0.170B——论文未说明原因,但推送场景的 QPS 与时延约束是合理解释。同时,最大规模仅 0.170B,相对当代生成式推荐(OneRec 系列已到数十亿参数)仍属小模型,"scaling law"的说服区间有限。
强化学习效果(§4.5)¶
离线对比(Table 4)¶
| Training Strategy | HitRate@100 | Loss |
|---|---|---|
| Base (Click Labels Only) | 0.3964 | 11.22 |
| Base + Sample Reweighting | 0.3394 | 12.31 |
| Base + UCPA | 0.3915 | 11.29 |
结论分析。 首先尝试基于用户观看时长做样本重加权,希望提升高参与度视频的权重;但这种直接重加权策略严重冲击了主训练目标,导致 HitRate@100 大幅下降(0.3964 → 0.3394,−14.4%)。
相比之下,UCPA 的做法是:把用户在推送点击后 session 内的视频消费行为分组,计算组内相对优势分用于强化学习。这个设计引入了远更丰富的消费信号,同时保持接近基线的表现——HitRate@100 仅小幅下滑(0.3964 → 0.3915,−1.24%)。
这里的逻辑链条是诚实的:UCPA 不是为了提升 HitRate,而是在几乎不损失点击命中率的前提下引入内容质量信号。作者也明说了要靠在线 A/B 进一步验证 UCPA 的有效性。
在线消费指标(Table 5)¶
加入 UCPA 模块相对纯点击基线的消费指标提升:
| Metric | Improvement |
|---|---|
| Push Play Duration | +0.43% |
| Valid Play Rate | +0.37% |
| Long Play Rate | +0.57% |
| Complete Play Rate | +0.90% |
| Like Rate | +0.75% |
| Forward Rate | +7.57% |
结论分析。 UCPA 在所有消费指标上取得一致提升,证明其在推广高价值内容上的有效性。值得注意的是 Forward Rate(转发率)提升 7.57%,说明用户更愿意把被推荐的内容分享给他人——转发是内容质量最强的隐式背书之一。Complete Play Rate 与 Like Rate 也有可观增长,验证 UCPA 成功地把模型引导向用户满意度与长期价值更高的内容。
从指标结构看,提升幅度呈现清晰的梯度:越"重"的行为提升越大(Forward 7.57% ≫ Complete Play 0.90% > Like 0.75% > Long Play 0.57% > Valid Play 0.37%),这与式 (20) 的奖励设计意图高度吻合——奖励函数偏爱深度消费,线上结果也确实在深度消费侧兑现最多。
在线 A/B 实验(§4.6,Table 6)¶
对照组是快手推送系统现有的多级级联架构(成熟的生产基线)。核心指标:DAU(日活跃用户)、CTR(一天内收到的所有通知的点击率)、App Usage Duration(每日 App 总使用时长)。
| Model Variant | DAU | CTR | App Usage Duration |
|---|---|---|---|
| (v1) Video Branch w/ Chained-MTP | +0.126% (p=0.00) | +0.998% (p=0.00) | +0.095% (p=0.01) |
| (v2) v1 + UCPA | +0.153% (p=0.00) | +1.075% (p=0.02) | +0.145% (p=0.05) |
| (v3) HGenPush (v2 + Author Branch) | +0.181% (p=0.04) | +1.577% (p=0.11) | +0.148% (p=0.75) |
结论分析。 三个版本呈现一致的递进式收益:
- v1(仅视频分支 + Chained-MTP)在所有指标上显著优于生产系统,验证视频推荐分支能准确捕获用户对视频内容的兴趣;
- v2 集成 UCPA 后进一步获益,论文归因于 UCPA 利用消费信号强化了生成式推荐与下游 ranking 模块之间的对齐,使高质量候选更容易被识别,最终改善体验与参与度;
- v3 完整 HGenPush 再加入作者推荐分支做异构生成,取得额外提升,证明其在发现用户对作者的信任、满足关注偏好上的有效性。
最终 HGenPush 相对生产系统取得 +0.181% DAU、+1.577% CTR、+0.148% App Usage Duration。考虑到平台规模与生产基线的成熟度,论文认为这些提升具有显著业务价值。
必须指出的统计问题:括号中是 p 值。v1 与 v2 的三项指标 p 值都在 0.05 及以下,可信;但 v3 的 CTR(p=0.11)与 App Usage Duration(p=0.75)均未达到常规显著性水平,DAU 的 p=0.04 也只是勉强越过阈值。也就是说,"加入作者分支带来额外收益"这一结论在统计上远不如 v1/v2 的结论稳固——尤其 App Usage Duration 从 v2 的 +0.145%(p=0.05) 到 v3 的 +0.148%(p=0.75),指标几乎没动而显著性大幅劣化。论文正文完全没有讨论这一点,摘要仍直接宣称 "a significant 0.181% increase in daily active users"。读者应把作者分支的线上价值视为证据偏弱的结论。
核心贡献总结¶
- 异构生成式推荐范式:首次在生成式推荐范式中实现视频与作者两类异构内容的联合推荐,其中"混合语义 ID"(作者 SID + 首层视频 SID)的设计让作者级推荐直接产出可下发候选。
- Chained-MTP:一个极轻量的非自回归 SID 生成方法——以用户兴趣表征为稳定锚点、以前序语义 ID 的累加 embedding 保留层级依赖,效果逼近 Transformer 级联的 DeepSeek-MTP(−0.99%)而吞吐高出 33.86%。
- UCPA / GSISPO:以点击后 session 消费行为为可验证奖励,融合 GSPO 的序列级重要性采样与 CISPO 的权重裁剪,在几乎不损失点击命中率(−1.24%)的前提下换来全线消费指标提升(转发率 +7.57%)。
- 完整工业落地:在 4 亿 DAU 的快手推送系统全量部署,生成候选跳过粗排直入精排。
与已归档相关工作的对比¶
MBGR MBGR: Multi-Business Prediction for Generative Recommendation at Meituan(Meituan,2026-04-03)¶
关系:独立并发(MBGR 早于本文 3 个月,本文未引用)· 已加载对方精读
- 共同关注的问题:两文指向同一个 root cause——生成式推荐的用户理解可以共享,但生成目标是异构的,把多类目标压进同一条 NTP 通路会互相污染。MBGR 把它拆成"跷跷板效应"(不同业务行为差异大,单一 NTP 框架抓不住跨业务模式)与"表征混淆"(多业务共享统一 SID 空间导致梯度耦合,生成时分不清业务语义);HGenPush 的表述是"现有方法聚焦同质内容,难以联合推荐视频与作者这类异构内容"。二者都不是"多任务学习"这种宽泛描述,而是精确指向共享 SID 生成头无法承载异构目标。
- 相近的技术骨架:流程图高度重合——共享一条用户序列理解主干 → 用"目标类型"条件化 → 每类目标一条参数隔离的 SID 生成头。MBGR 用 business embedding $\mathbf{b}_i$ 注入 encoder/decoder(式 3–8),再用参数共享的 MoE 把通用 item 表征转成业务特定表征 $\mathbf{e}^b$(式 9–11),并为每个业务配独立预测头;HGenPush 则在序列尾部挂两个特殊 token $[\text{cls}]_a$ / $[\text{cls}]_v$ 作为两类目标各自的兴趣锚点,分别驱动两条独立的 Chained-MTP(式 14、19),作者分支还额外自建对齐 + RQ-Kmeans 码本。两者都把"类型条件"放在主干之后、生成头之前这个位置上。
- 本文的差异与推进:MBGR 的异构性是业务域(外卖/团购/娱乐/医疗,本体仍是 item),HGenPush 的异构性是实体类型(视频 vs 作者,本体不同)——后者更难,因为作者没有现成的内容侧 SID 可用。HGenPush 为此补了两块 MBGR 不需要的东西:用 InfoNCE 把作者表征与用户兴趣表征对齐(式 16),从用户行为而非作者内容特征里学出偏好感知的作者编码;以及"混合语义 ID",把作者 SID 与首层视频 SID 拼接,使作者分支的输出直接可落地。另一方面 MBGR 有 HGenPush 没有的东西:Label Dynamic Routing 把稀疏的多业务标签补成稠密标签(式 13),而 HGenPush 的两条分支各自都有充足监督,不需要这套。
- 可比的方法/实验差异:MBGR 仍是自回归框架(原文明确"以自回归方式生成 Semantic ID token 序列"),完全没有触及本文关心的 AR 效率瓶颈;HGenPush 则用 Chained-MTP 把两条分支的解码都变成并行。训练目标上,MBGR 用 InfoNCE + 重建损失(式 14–16),HGenPush 用交叉熵 + InfoNCE + 码本损失 + RL 四项直加(式 25)。两者线上收益不可直接比较(MBGR +3.98% CTCVR 于美团多业务,HGenPush +0.181% DAU 于快手推送),但都属"共享主干 + 分支生成"配方在各自异构维度上的验证。
PAD-Rec PAD-Rec: Position-Aware Drafting for Inference Acceleration in LLM-Based Generative List-Wise Recommendation(中国科学技术大学,2026-04-30)¶
关系:独立并发(PAD-Rec 早于本文 2 个月,本文未引用,且本文正文完全未提及 speculative decoding 路线)· 已加载对方精读
- 共同关注的问题:两文的 root cause 陈述几乎逐字对应——SID 的自回归解码步数就是延迟本身。PAD-Rec 把它量化到具体数字:每个 item 用 $K=4$ 个码本层 token 表示,生成 top-10 列表约需 $m(K+K')\approx 59$ 个解码步,1B 模型上单 query 约 700ms,"远不能满足实时推荐场景";HGenPush 的表述是"主流自回归语义 ID 生成限制推理速度、消耗大量算力,制约生成式推荐模型在生产系统的部署"。两者都不是泛泛地说"模型慢",而是精确归因到逐 token 的串行依赖。
- 相近的技术骨架:抽象流程图重合在"用一个便宜的轻量提议器替代 $L$ 次昂贵的完整前向"这一层,且两文都独立发现了同一个非平凡的结构事实——SID 的各层槽位不是同质的,必须按槽位独立参数化。PAD-Rec 为此引入 Item Position Embedding,显式编码 within-item slot("第一个 token 表示 high-level 类目,第四个表示细粒度属性"),并明说现有 draft 模型"把所有 token 同质看待,没有任何 slot identity 编码"是一个 gap;HGenPush 则为每一层码本维护独立的 $\text{Emb}^{(k)} \in \mathbb{R}^{N\times d_h}$ 与独立的 $\text{FFN}^{(k)}$(式 14),原文解释是"刻画不同粒度的语义空间"。两者对"槽位异质性"的诊断完全一致,只是一个把它做成 draft 的额外输入信号,一个把它做成生成头的参数分解。
- 本文的差异与推进:解法在终点上分岔——PAD-Rec 是无损加速,target LLM 完全冻结,draft 提议后由 target 一次 batched forward 校验、接受最长前缀,因此严格保持原 AR 分布,"几乎不损失推荐质量";HGenPush 是有损替换,直接删掉 AR 循环,用累加 embedding 做一阶近似,Table 3 显示它相对 Transformer 级联的 DeepSeek-MTP 掉了 0.99% HitRate@100。换来的是 PAD-Rec 给不了的东西:PAD-Rec 的加速上限受接受率约束(最高 3.1×,相对 HASS 平均 5% 额外收益),且仍需维护 draft + target 两套模型;HGenPush 单模型单前向,把串行深度直接压到 $O(1)$,因此能扛住推送场景的 QPS。
- 可比的方法/实验差异:PAD-Rec 在四个公开数据集上做 wall-clock 加速评测,模块参数仅占 draft backbone 的 ~0.01%,对原 SD 框架零侵入;HGenPush 只有快手内部数据与线上 A/B,唯一的效率数字是 Max QPS per Device(1.70k)。一个直接的、两文都没做的对照是:Chained-MTP 与 speculative decoding 其实正交可叠——完全可以把 Chained-MTP 当作 draft 提议器再挂一层 verify,用 PAD-Rec 式的槽位/深度位置信号提升接受率,从而在保留并行度的同时把有损变无损。
DaV-Gen DaV-Gen: End-to-End Generative Retrieval via Draft-and-Verify(HUJING / 阿里巴巴,2026-07-09)¶
关系:同期工作(本文 2026-07-03,DaV-Gen 2026-07-09,本文早 6 天;双方投稿窗口重叠、均未引用对方)· 已加载对方精读
时序说明:DaV-Gen 晚于本文 6 天上传 arXiv,因此本文结构上不可能引用它,其"未被引用"不构成任何独立性证据;反向 DaV-Gen 也不可能看到本文。下述对比仅作为同一时间窗内两条技术路线的并置。
- 共同关注的问题:DaV-Gen 对 root cause 的表述与本文几乎同构,且更形式化——它写出 AR 目标 $\mathcal{L}_{\text{AR}}=-\sum_t\sum_l \log P(c_l^{(t)}\mid i_1,\dots,i_{t-1},c_{<l}^{(t)})$,指出该形式"强制逐 item 顺序解码,第 $t$ 步严格等待第 $t-1$ 步完成——这正是高推理延迟的根源",并把目标明确定为"把 AR 解码的 $O(L)$ 复杂度替换为 $O(1)$ 的并行打分"。这与本文"discard the complex autoregressive paradigm and significantly reduce computations through parallel feedforward network" 是同一句话的两种写法。
- 相近的技术骨架:两者的推理流程图可以抽象重合成同一张——上下文侧一次前向算出一个可复用的稳定表示 → 一次并行操作产出全部结果。HGenPush 的稳定表示是 $h'_{[\text{cls}]_v}$(作为所有 $L_v$ 个 head 的公共加性锚点),并行操作是 $L_v$ 个 $\text{FFN}^{(k)}$;DaV-Gen 的稳定表示是广播式前缀缓存 $\text{Cache}(H_u)$(上下文 KV 只算一次、广播给全部 $N$ 个候选),并行操作是一次融合打分前向。两者都刻意避免让上下文编码随输出规模重复。
- 本文的差异与推进:分歧在于"还生不生成"。DaV-Gen 实际上放弃了候选的生成——候选由 ANN 检索起草($\mathcal{C}_u=\text{ANN}(e_q,\mathcal{E}_\mathcal{I},N)$,"这一步非生成式"),生成能力退化为一个验证用的打分信号 $\mathcal{L}_{\text{gen}}$,因此它得到了确定性的列表长度控制,代价是候选集上限被 ANN 索引锁死。HGenPush 仍然真正在生成 SID(Beam Search 出候选),只是把生成本身并行化了,因此保留了生成式召回"不受既有索引约束"的特性,也保留了对新 item 的组合泛化能力。另一处差异是异构性:DaV-Gen 只处理单一 item 类型,HGenPush 同时产出视频与作者两类目标。
- 可比的方法/实验差异:DaV-Gen 报告端到端视频搜索延迟降至约 70ms(相对级联 2.5×)与线上 Avg Time Spent +2.09%;HGenPush 报告 Max QPS per Device 1.70k 与 DAU +0.181%,两套效率口径不可直接换算。表征侧路线也不同:DaV-Gen 用混合稀疏-稠密表示 $e_i^{\text{hyb}}=\text{LayerNorm}(e_i^{\text{spr}}+\text{MLP}(v_i^{\text{den}}))$ 保留量化前的连续信号,HGenPush 则全程在离散 SID 空间内工作、靠 $\text{Emb}^{(k)}$ 累加恢复层级信息——一个"补回连续信息",一个"在离散空间内重建依赖",是同一时期对"SID 量化损失"两种互补的应对。
讨论与局限性¶
核心贡献与值得借鉴的设计¶
Chained-MTP 是本文最值得借鉴的一点,而且它便宜得出奇。 式 (14) 的全部内容就是"把前 $k-1$ 层码字的 embedding 加到兴趣锚点上,再过一个该层专属的 FFN"。没有注意力、没有额外的 Transformer 层、没有 draft/verify 两套模型。但 Table 3 表明这一个加法把 HitRate 从 Parallel-MTP 的 0.1150 拉到 0.3915。它之所以成立,是因为它精确复刻了 RQ-Kmeans 的代数结构——残差量化中 item 表示本就是各层质心之和,所以"前序码字之和"天然就是当前层应当条件化的那个量。这个"让近似结构与 tokenizer 的代数结构对齐"的思路,可以迁移到任何基于残差量化的 SID 系统上。
"混合语义 ID"解决了异构推荐的落地闭环。 作者级推荐的天然难题是"推荐了一个作者之后推什么",本文用 $(s^1_{a_t},\dots,s^{L_a}_{a_t}, s^1_{v_t})$ 一步给出答案,让作者分支的输出直接是可下发的内容候选,而非需要二次检索的抽象实体。
"跳过粗排直入精排"的部署决策值得工业读者注意:这是对生成式召回候选质量的一次强表态,也意味着整条链路少了一层计算与一次目标错配。
GSISPO 的组合是务实的:序列级重要性采样(GSPO)匹配"优势定义在视频而非 token 上"这一事实,权重裁剪外置 + stop-gradient(CISPO)保住小众高价值样本的梯度,再用监督损失 $\mathcal{L}_{v-MTP}$ 顶替 KL 项充当隐式信任域,省掉一份参考模型开销。
局限与争议¶
-
在线证据比摘要宣称的弱。 Table 6 中 v3 的 CTR(p=0.11)与 App Usage Duration(p=0.75)都不显著,DAU 的 p=0.04 也只是勉强过线。也就是说,本文最核心的卖点——异构生成(作者分支)带来的增量——在线上只有一个勉强显著的 DAU 数字支撑。而 App Usage Duration 从 v2 的 +0.145%(p=0.05) 到 v3 的 +0.148%(p=0.75),几乎是指标未动而显著性崩塌。论文对此只字未提。
-
Baseline 过于单薄。 离线只对比 SASRec(2018)与 TIGER(2023),没有任何同代工业生成式推荐系统——尤其缺少与自家 OneRec 的正面对比,而 §3.1 明确说视频 SID 的生成方法"与 OneRec 一致",本可以做到公平对照。
-
消融不完整。 全文最大的空白是混合用户行为理解模块从未被消融。长期序列、短期序列、push click 序列、push send 序列、静态特征这五路输入,论文用了大量篇幅(式 1–10)论证其必要性,却没有任何一个实验说明去掉某一路会掉多少。同理,作者分支的 InfoNCE 表征对齐(式 16)、SimVQ、混合 SID 的"拼上首层视频 SID"这个设计,都没有单独的消融数据支撑——§4.2 对作者分支优势的两条归因完全是文字论证。
-
Chained-MTP 的表达力天花板是结构性的。 它对 AR 依赖的近似是一阶且顺序无关的($\sum_{j<k}$ 是无序求和,交换前序码字的顺序不改变第 $k$ 层的条件),而真正的 AR 条件分布对前序排列敏感。Table 3 已经显示它落后 DeepSeek-MTP 0.99%;随着码本层数 $L_v$ 增加或码本变大,这个差距是否会放大,论文没有验证(本文 $L_v$ 仅为 3,是一个相当宽松的设定)。
-
RL 部分缺少对照。 UCPA 只与"样本重加权"和纯点击基线比较,没有与 GRPO / GSPO / CISPO 原版做消融对比,因此 GSISPO 中"序列级 + 权重裁剪"这两个组合项各自贡献多少无从判断。奖励规则(式 20)的具体权重(+2/+1/−2/−5/−10)也没有敏感性分析。
-
规模仍小、scaling 结论区间有限。 最大 0.170B、线上部署 0.064B,而第二阶段扩容的边际收益已降到 +3.27%。在当代生成式推荐已推进到数十亿参数的背景下,本文的 scaling 分析更像是"容量还没吃满"的初步验证,不足以支撑"HGenPush 路线可持续 scaling"的强结论。
-
可复现性为零。 无公开数据集、无代码、评估指标 HitRate@100 定义在内部语义 ID 空间上,外部读者无法验证任何数字。
工业落地价值¶
对做推送/召回的工业读者,本文有三处可直接搬用:(a) Chained-MTP 作为 AR 解码的低成本替代,尤其适合码本层数少($L_v\le4$)、QPS 高的场景;(b) push send 序列作为上下文输入这个细节——它以极低成本解决了推送场景特有的"避免重复下发"问题,比在后处理里做去重更早地把约束注入了生成;(c) 点击后 session 消费奖励(式 20)的档位设计,把"深度消费 > 轻交互"和"显式负反馈重罚"的生态价值观直接编码进 RL 目标,其线上结果(转发率 +7.57%)显示这套奖励确实能把模型推向高质量内容而非标题党。