RecoChain:把 SIM 式目标感知检索接进生成式推荐的自回归链¶
Yu Liu(NJUST,南京理工大学)、Jiangxia Cao*(Kuaishou Technology,通讯作者),arXiv 2604.25787v1,投稿 2026-04-28。全文 6 页短文,实验仅在公开数据集 TAOBAO-MM 上完成,无线上 A/B、无工业部署数据。
一、研究动机与背景¶
1.1 生成式推荐的现状¶
沿着 NLP/CV 在 GPU 时代由 Transformer 带来的架构革命,推荐系统社区把 next-item prediction 重新表述为「以自回归方式生成下一个物品的 Semantic ID(SID)」。这一问题形式在数据 / 参数 / 计算 / 序列四个维度上都展现出可扩展性,基于 SID 的生成式推荐器(Generative Recommender, GR)已经在 next-item 任务上取得有竞争力的表现。
论文把 GR 的技术栈拆成两块来回顾:
- Item Tokenizer(把 item embedding 量化成若干整数,如 8192 × 3):TIGER 的 RQ-VAE、QARM 的 RQ-Kmeans、QARM V2 的 RQ-Kmeans-FSQ、LLaDA-Rec 的 Product Parallel;
- 落地系统:短视频的 OneRec、电商的 OneMall、直播的 OneLive。
1.2 真正的痛点:generation ↔ ranking 的能力鸿沟¶
工业推荐系统通常是两阶段流水线:
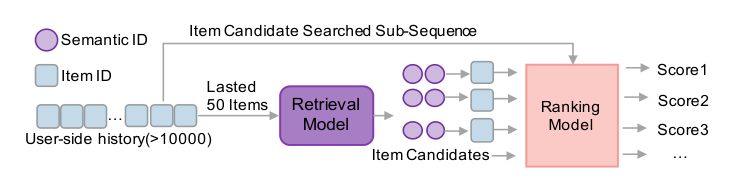
- Retrieval(召回):给定用户历史兴趣序列,预测一批候选(如 256 个),问题形式是 $P(\text{next item} \mid \text{user feature})$;
- Ranking(排序):在这 256 个候选上,排序模型可以使用更多特征逐个打分,最终选出 top-10 推给用户,问题形式是 $P(\text{probability} \mid \text{user feature}, \text{item feature})$。
作者的核心观察是:现有生成式推荐研究几乎全部聚焦于召回侧的模型设计,而忽略了排序过程。用摘要里的原话说,next-item-agnostic 的预测范式「could beam out some next potential items via Semantic IDs but hard to estimate which items are better from them, e.g., select the top-10 from beam-256 items」——能 beam 出候选,却判不出优劣。
为了缓解这个问题,已有工作采取了一条折中路线:把排序知识蒸馏进 GR 模型,思路类似强化学习——把排序模型当作 reward model,教 GR 骨干哪些 SID 能拿到更高的正向行为分。论文认为,这种「不得不靠外部 reward 来补课」的现象本身,恰恰暴露了 GR 与 ranking 之间存在明确的能力鸿沟,并留下一个未被充分探索的问题:能否把召回与排序统一进同一个 Transformer 骨干?
1.3 归因:GR 缺的是「目标感知的检索式序列建模」¶
论文接着做了一次工业召回 / 排序模型的技术路线对照,这是全文最有价值的一段论证:
| 召回模型的研究主线 | 排序模型的研究主线 | |
|---|---|---|
| 用户最近序列建模 | ✅ 双塔 ANN(DSSM 的 MLP)、用户侧 Transformer(SASRec / Kuaiformer) | ✅ DIN |
| 目标物品感知的检索式子序列建模 | ❌ 无 | ✅ SIM / TWIN |
| 计算 scaling | ✅ Beam search 系(TIGER / OneRec) | ✅ RankMixer / Wukong / HSTU |
结论一目了然:「用户最近序列建模」与「计算 scaling」这两条已经被 GR 模型吸收了,唯独「target-item aware searched sequence modeling」这一支在现有 GR 里完全缺席。因此 GR 缺少被证明对排序精度至关重要的细粒度目标感知交互——作者主张这才是近期蒸馏类工作所观察到的 GR-ranking 能力鸿沟的 root cause。
1.4 贡献¶
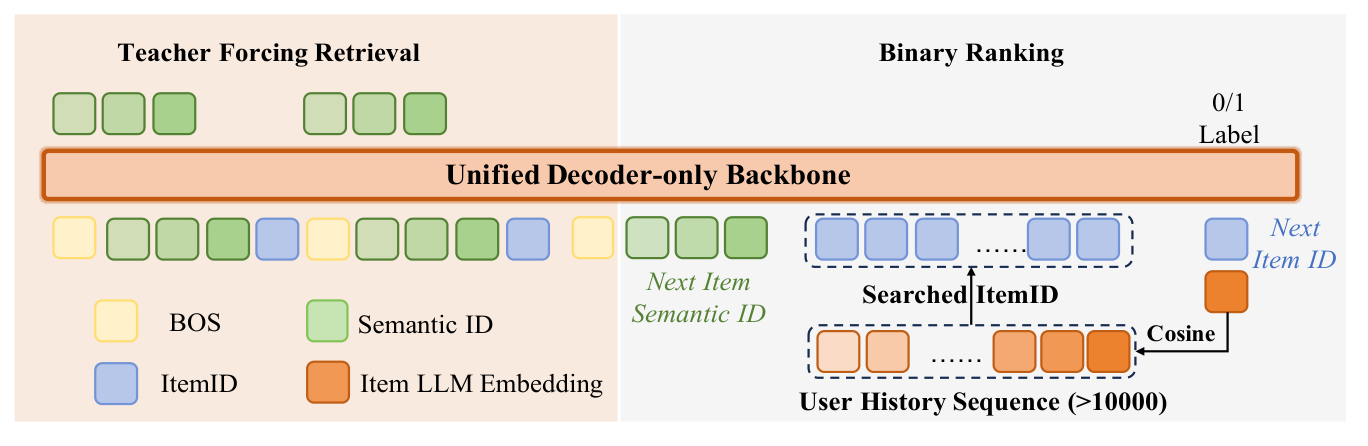
据此提出 RecoChain:一条统一的自回归工作流,让单个生成式骨干同时承担候选生成与排序打分。关键在于,候选一旦被 GR 骨干生成出来,同一个 Transformer 就可以被以 target-aware 模式再次调用,针对该生成目标做检索式序列建模,从而在不引入额外排序组件的前提下统一召回与排序。召回 / 排序过程共享同一份 KV cache 与同一套复杂计算 scaling 单元,训练与推理效率最大化。
具体贡献两条:
- 提出 RecoChain 这一统一自回归工作流,使单个生成式模型同时服务候选生成与排序分估计;
- 在大规模真实数据 TAOBAO-MM 上做大规模研究,显著提升预测精度。
二、核心方法 / 模型架构¶
2.1 总览¶
考虑工业界常见的推荐设定,给定用户历史交互序列
$$\text{User Log}: \{(x_n, \mathbf{m}_n), \ldots, (x_1, \mathbf{m}_1), (x_0, \mathbf{m}_0)\}$$
其中 $x_i$ 是 item ID,$\mathbf{m}_i$ 是该 item 的 LLM 多模态 embedding。RecoChain 的推理链条分三步。
第一步,SID 召回:只喂最近的 $L$ 个(如 50)行为,让骨干生成下一个候选:
$$\text{Next}\,(x, \mathbf{m}) \leftarrow \text{Backbone}\big((x_L, \mathbf{m}_L), \ldots, (x_1, \mathbf{m}_1), (x_0, \mathbf{m}_0)\big) \tag{1}$$
第二步,GSU 检索:基于生成出来的候选 $x$,在全量超长历史(>10000)里检索与之相关的子序列:
$$\{(x^s_g, \mathbf{m}^s_g), \ldots, (x^s_0, \mathbf{m}^s_0)\} = \text{Cos-Sim}\big(\mathbf{m}, \{(x_n, \mathbf{m}_n), \ldots, (x_0, \mathbf{m}_0)\}\big) \tag{2}$$
其中 Cos-Sim 是在多模态 embedding 空间 $\mathbf{m}$ 上的余弦相似度函数,$g$ 是控制检索子序列长度的超参。这一步就是 SIM 的 GSU(General Search Unit)思路被原样搬进 GR 链条。
第三步,排序打分:把检索到的子序列继续喂给同一个骨干,估计一个二值 0/1 的排序分:
$$\text{RankScore} \leftarrow \text{Backbone}\Big(\{(x_L, \mathbf{m}_L), \ldots, (x_0, \mathbf{m}_0)\},\ \{(x^s_g, \mathbf{m}^s_g), \ldots, (x^s_0, \mathbf{m}^s_0)\},\ x\Big) \tag{3}$$
最终用 RankScore 对不同候选排序。
2.2 Item Tokenizer¶
对多模态 embedding 做残差 $k$-means 量化,得到三层语义 ID:
$$(s_1, s_2, s_3) \leftarrow \text{RQ-Kmeans}(\mathbf{m}) \tag{4}$$
为了规避码字冲突(code conflict)问题,再追加一个随机 ID $s_4$,保证 SID 模式与 item ID 之间的一对一映射。因此每个 item 的 SID 形如 $(s_1, s_2, s_3, s_4)$,其中 $s_4$ 是随机整数。
这是一个值得注意的设计选择:它用 TIGER 式的「额外去重 token」把碰撞问题一次性消掉,代价是第 4 位没有任何语义,模型只能靠前 3 位真正做语义泛化,而 beam 在第 4 层实际上是在一个纯随机的分支上做选择。
2.3 序列组织与骨干¶
用户历史按时间顺序把这些 SID 组拼接成序列。实现上用 BOS token 标记 item 边界,需要做候选级匹配时再额外插入 item ID token(细节见 Figure 2)。
骨干是一个 decoder-only Transformer,其上挂两个任务头:
- SID head:负责 next-item SID 生成;
- reranking head:负责候选相关性估计。
2.3.1 Stage I:SID 生成预训练¶
第一阶段用 teacher forcing 自回归预测每个 item 的 SID 序列。监督只定义在 SID 目标上,item ID 位置不计入 loss。对每个 item $t$,自回归顺序是
$$\text{BOS} \rightarrow s^1_t \rightarrow s^2_t \rightarrow \cdots \rightarrow s^4_t \rightarrow \text{ItemID}$$
完整 SID 生成后,序列里追加一个 item ID token 作为辅助的 item 级 token 来丰富输入信息。记 $\hat{P}(x_n \mid x_{<n})$ 为解码器在位置 $n$ 的 next-token 分布,Stage-I 目标为
$$\mathcal{L}_{\text{SID}} = -\sum_{t=1}^{T} \sum_{h=1}^{4} \log \hat{P}\big(s^h_t \mid x_{< \text{pos}(t,h)}\big) \tag{5}$$
其中 $\text{pos}(t,h)$ 是展平序列中预测目标 $s^h_t$ 所对应的位置。
2.3.2 Stage II:Generate–Retrieve–Rerank 联合训练¶
与只优化 SID 生成的 Stage I 不同,Stage II 在统一的解码流水线内、以 KV-cache 复用的方式联合执行候选生成与候选感知的重排。
给定序列化的用户历史前缀 $X_{<T}$,解码器先做一次前向初始化隐状态与 KV cache;随后做层次化 beam search 自回归生成下一个 item 的 SID:
$$\{\tilde{\mathbf{s}}^{(c)}\}_{c=1}^{C}, \qquad \tilde{\mathbf{s}}^{(c)} = [\tilde{s}^{(c),1}, \ldots, \tilde{s}^{(c),4}]$$
在解码步 $\ell$,模型为每个 beam 预测第 $\ell$ 个 SID token,同时复用此前步骤的 KV cache。对每个 beam 候选 $c$,生成分为
$$\log P(\tilde{\mathbf{s}}^{(c)} \mid X_{<T}) = \sum_{\ell=1}^{4} \log \hat{P}(\tilde{s}^{(c),\ell} \mid \tilde{\mathbf{s}}^{(c),<\ell}, X_{<T}) \tag{6}$$
生成完成后,每条 SID 序列 $\tilde{\mathbf{s}}^{(c)}$ 被确定性地映射回对应的候选 item ID $\tilde{i}^{(c)}$(这正是 $s_4$ 随机去重位的作用)。
对每个生成候选 $\tilde{i}^{(c)}$,基于冻结语义 embedding 的余弦相似度,从用户历史交互中检索 top-$M$ 最相似的 item:
$$\text{sim}(i, j) = \frac{\mathbf{e}_i^{\top} \mathbf{e}_j}{\|\mathbf{e}_i\| \|\mathbf{e}_j\|} \tag{7}$$
检索按相似度选取,但拼接顺序遵循用户历史中的原始时间序——这个细节保证了子序列仍携带时序信息。记
$$\mathcal{N}^{(c)} = [i^{(c)}_1, i^{(c)}_2, \ldots, i^{(c)}_M]$$
为 beam 候选 $c$ 检索到的 item ID 列表。为估计候选点击概率,解码器把检索到的 item ID token 连同一个最终候选 item ID token 一起续写:
$$\big[X_{<T},\ \tilde{\mathbf{s}}^{(c)} \,\|\, i^{(c)}_1, \ldots, i^{(c)}_M \,\|\, \tilde{i}^{(c)}\big] \tag{8}$$
其中最后那个候选 item ID token 位置就是专用的打分位。
关键在于:重排不是把整条序列从头重新编码,而是解码器在追加 token 上继续增量计算,复用候选生成阶段产生的隐状态与 KV cache。因此 Stage II 只需 $H$ 步增量解码(SID 生成)加一次额外前向(重排)。
记 $\mathbf{h}^{(c)}_{\text{rank}}$ 为最后追加的候选 item ID 位置的隐状态,beam $c$ 的点击概率为
$$\hat{y}^{(c)} = \sigma\big(\text{RankHead}(\mathbf{h}^{(c)}_{\text{rank}})\big) \tag{9}$$
2.3.3 Beam 级重排监督¶
重排监督定义在 beam 级别:
$$y^{(c)} = \begin{cases} 1, & \text{if } \tilde{\mathbf{s}}^{(c)} = \mathbf{s}_T \\ 0, & \text{otherwise} \end{cases} \tag{10}$$
即:只有 SID 与 ground-truth 完全一致的那条 beam 才是正样本。重排损失是所有 beam 候选上的二元交叉熵:
$$\mathcal{L}_{\text{rank}} = -\sum_{c=1}^{C} \Big[ y^{(c)} \log \hat{y}^{(c)} + (1 - y^{(c)}) \log(1 - \hat{y}^{(c)}) \Big] \tag{11}$$
Stage-II 总目标就是两项直接相加(无权重系数):
$$\mathcal{L} = \mathcal{L}_{\text{SID}} + \mathcal{L}_{\text{rank}} \tag{12}$$
2.4 推理¶
推理流程与 Stage II 完全一致,只是不更新参数:前向初始化 → 层次 beam search 生成 $C$ 条候选 SID → 确定性映射回 item ID → 按 item 的语义 embedding 做 top-$M$ 历史检索 → 追加 item ID token 并用 KV-cache 复用继续解码 → 得到重排分。
候选 $c$ 的最终排序分是生成分与重排分之和:
$$\text{score}(c) = \log P(\tilde{\mathbf{s}}^{(c)} \mid X_{<T}) + \log \hat{y}^{(c)} \tag{13}$$
所有候选按 $\text{score}(c)$ 排序形成最终推荐列表。注意这里与「彻底丢弃 beam likelihood」的做法不同:RecoChain 保留了生成分,重排分只是乘性地(对数域加性)修正它。
三、实验设置¶
3.1 数据集¶
TAOBAO-MM(出自 MUSE,arXiv 2512.07216):8.79M 用户、35.4M item、99M 交互,每个用户最长 1000 条行为序列,并提供由图文内容导出的 128 维多模态 item embedding。论文遵循 TAOBAO-MM 官方 train/validation/test 划分,不再做序列级切分。
由于 TAOBAO-MM 原本是为 CTR 预估构建的、带曝光标签的数据集,作者把它改造成序列推荐设定:保留用户交互历史、丢弃曝光标注,用得到的序列做 next-item prediction。
3.2 实现细节¶
| 项 | 值 |
|---|---|
| 框架 | PyTorch Lightning |
| 骨干 | 共享的 decoder-only Transformer(生成与重排共用) |
| 层数 / 隐层 / FFN / 头数 | 2 层 / 1024 / 4096 / 16 |
| 优化器 | AdamW |
| 学习率 | $1 \times 10^{-5}$,cosine decay |
| weight decay | $1 \times 10^{-4}$ |
| warmup / 总步数 | 20,000 / 120,000 |
| 精度 | bf16 混合精度 |
| per-device batch size | 32(梯度累积 4) |
| 默认输入序列长度 | 32 |
| 默认 beam size | 20 |
| 默认检索长度 $M$ | 10 |
评估指标为 Recall@5/10 与 NDCG@5/10,分别报告重排前(Base)与重排后(Rank)的数值。消融时分别变动 beam size、输入序列长度、检索长度,其余固定。
需要指出:全文没有任何外部 baseline(无 SASRec / TIGER / OneRec / HSTU 对照),所有"提升"都是同一模型自身的「重排前 vs 重排后」对比。
四、主要实验结果¶
4.1 总体有效性¶
结论一句话:重排稳定优于直接 beam 生成,在几乎所有设置下增益都为正。
4.2 Table 1:Beam size 的影响(序列长 32、检索长 10)¶
| Beam | Recall@5 Base | Recall@5 Rank | Recall@10 Base | Recall@10 Rank | NDCG@5 Base | NDCG@5 Rank | NDCG@10 Base | NDCG@10 Rank |
|---|---|---|---|---|---|---|---|---|
| 10 | 0.2384 | 0.2411 (+1.14%) | 0.2422 | 0.2422 (+0.00%) | 0.2323 | 0.2352 (+1.21%) | 0.2336 | 0.2355 (+0.82%) |
| 20 | 0.2384 | 0.2459 (+3.14%) | 0.2431 | 0.2475 (+1.78%) | 0.2324 | 0.2379 (+2.37%) | 0.2339 | 0.2384 (+1.92%) |
| 30 | 0.2383 | 0.2476 (+3.87%) | 0.2430 | 0.2495 (+2.67%) | 0.2323 | 0.2387 (+2.76%) | 0.2338 | 0.2394 (+2.37%) |
| 40 | 0.2384 | 0.2492 (+4.53%) | 0.2434 | 0.2517 (+3.39%) | 0.2324 | 0.2397 (+3.17%) | 0.2340 | 0.2406 (+2.80%) |
分析:beam 越大,重排增益越大——单调从 +1.14% 涨到 +4.53%(Recall@5)。作者的解释是 beam 越大提供的候选越多,排序模块可发挥的空间越大。这条曲线其实是对全文论点最直接的支撑:如果 GR 的 beam likelihood 本身就足以判优,扩大 beam 不应该让重排的边际收益单调上升;收益随 beam 增大而上升,说明 beam 打分在候选池扩大后失准得更厉害,正是「beam-256 里选 top-10」的痛点。
值得注意的是 beam=10 时 Recall@10 增益为 +0.00%:beam 只有 10 个候选,Recall@10 相当于把全部候选都取出,重排只改变顺序不改变集合,故命中率不可能变——这也侧面确认了实验实现的自洽性。
⚠ 文本与表格不一致:正文 §3.2 写「Recall@5 gain increases from +0.27% at beam size 10 to +1.08% at beam size 40, while the NDCG@10 gain rises from +0.19% to +0.65%」,但 Table 1 里对应数字是 +1.14% → +4.53% 与 +0.82% → +2.80%。两组数字对不上,疑为正文沿用了旧版实验结果未同步更新。本报告以表格为准。
4.3 Table 2:输入序列长度的影响(beam 20、检索长 10)¶
| Seq Len | Recall@5 Base | Recall@5 Rank | Recall@10 Base | Recall@10 Rank | NDCG@5 Base | NDCG@5 Rank | NDCG@10 Base | NDCG@10 Rank |
|---|---|---|---|---|---|---|---|---|
| 32 | 0.2384 | 0.2459 (+3.14%) | 0.2431 | 0.2475 (+1.78%) | 0.2323 | 0.2379 (+2.37%) | 0.2339 | 0.2384 (+1.92%) |
| 64 | 0.2515 | 0.2586 (+2.82%) | 0.2583 | 0.2615 (+1.25%) | 0.2398 | 0.2454 (+2.35%) | 0.2419 | 0.2463 (+1.82%) |
| 128 | 0.2708 | 0.2733 (+0.92%) | 0.2743 | 0.2754 (+0.42%) | 0.2518 | 0.2537 (+0.76%) | 0.2529 | 0.2544 (+0.58%) |
分析:这是一个反向趋势——序列越长,Base 绝对性能越好(Recall@5 从 0.2384 涨到 0.2708),但重排增益反而衰减(+3.14% → +0.92%)。作者给出两条解释:(1) 更长的行为序列本身已经提供了更强的时序信号,留给重排的空间变小;(2) 在检索长度固定的前提下,检索上下文的相对贡献也被稀释。
这个现象对方法论有直接含义:RecoChain 的收益来自「补上目标感知信息」,当召回侧输入本身已经足够丰富时,这块补丁的边际价值下降。换句话说,论文所主张的 root cause 在短序列设定下更突出——而工业 GR 恰恰在往长序列走,这一点作者没有展开讨论。
4.4 Table 3:检索长度的影响(beam 20、序列长 32)¶
| Retrieval Len | Recall@5 Base | Recall@5 Rank | Recall@10 Base | Recall@10 Rank | NDCG@5 Base | NDCG@5 Rank | NDCG@10 Base | NDCG@10 Rank |
|---|---|---|---|---|---|---|---|---|
| 0 | 0.2380 | 0.2383 (+0.12%) | 0.2433 | 0.2435 (+0.08%) | 0.2322 | 0.2322 (+0.02%) | 0.2339 | 0.2340 (+0.03%) |
| 5 | 0.2384 | 0.2451 (+2.79%) | 0.2433 | 0.2472 (+1.62%) | 0.2323 | 0.2371 (+2.06%) | 0.2339 | 0.2378 (+1.67%) |
| 10 | 0.2384 | 0.2459 (+3.14%) | 0.2432 | 0.2475 (+1.78%) | 0.2324 | 0.2379 (+2.37%) | 0.2339 | 0.2384 (+1.91%) |
| 20 | 0.2382 | 0.2466 (+3.51%) | 0.2429 | 0.2473 (+1.80%) | 0.2323 | 0.2385 (+2.68%) | 0.2339 | 0.2388 (+2.11%) |
分析:这是全文最关键的一张表。检索长度为 0 时(即只在候选 item ID 位置挂一个 RankHead、不注入任何 GSU 检索到的子序列),增益几乎归零(+0.12% / +0.08% / +0.02% / +0.03%);一旦引入检索上下文,增益立刻跳到 +2.79% 并随长度继续增长,检索长 20 时最优。
这条消融精确地验证了论文的因果主张:增益不是来自「多挂了一个排序头」,而是来自「目标物品感知的检索式子序列」这一 SIM 式机制本身。如果没有 GSU 检索,那个额外的 RankHead 看到的信息与生成阶段完全相同,自然给不出正交的判别信号。
4.5 最优配置¶
绝对指标最好的一档并不在默认配置,而是 Table 2 的序列长 128:Recall@5 0.2733 / Recall@10 0.2754 / NDCG@5 0.2537 / NDCG@10 0.2544。默认配置(序列长 32、beam 20、检索长 10)的重排结果为 Recall@5 0.2459 / Recall@10 0.2475 / NDCG@5 0.2379 / NDCG@10 0.2384。
五、核心贡献总结¶
- 一次干净的归因:把 GR 与 ranking 的能力鸿沟归因到「target-item aware searched sequence modeling(SIM/TWIN 这一支)在 GR 中缺席」,而非泛泛的「生成式表达力不足」。这个归因是可证伪的,而 Table 3 的 retrieval-len=0 消融正是对它的直接检验。
- 一条极简的架构改造:不加任何新模块,只是让同一个 decoder 在 beam 出候选之后,把 GSU 检索到的子序列 token + 候选 item ID token 继续续写在 KV cache 后面,用最后一个位置出 CTR 分。召回与排序共享骨干、共享 KV cache、共享 scaling 单元。
- 明确的失效边界:Table 2 与 Table 3 一起给出了方法生效的条件——短召回序列 + 大 beam + 长检索上下文时收益最大。
六、与已归档相关工作的对比¶
OneRanker OneRanker(Tencent,2026-03-03)¶
关系:独立并发(本文未引用 OneRanker,两者殊途同归;OneRanker 早本文约 8 周发表)· 已加载对方精读
- 共同关注的问题:两篇论文对 root cause 的措辞几乎重合。OneRanker 把传统 generate-then-rank 架构的病灶总结为「三重断裂」——表示不一致、计算冗余、误差传播——并单列一条「生成过程的 Target-Agnostic 局限:现有生成式模型的用户表示在生成过程中保持静态,无法根据候选物品的特征动态调整」。RecoChain 的诊断是同一件事的另一种说法:GR 缺少 SIM/TWIN 那条「目标物品感知的检索式序列建模」支线。
- 相近的技术骨架:两者的方法流程图可以抽象重合为「生成阶段的 KV 直接传给排序阶段 → 候选 item token 作为打分位 → 生成损失与排序损失联合优化」。OneRanker 用 Key/Value pass-through 机制让 R-Decoder 复用 Step 1/Step 2 的输出作 Key/Value,候选 item token 之间用对角掩码保证打分独立,输出经轻量 MLP 得标量分;RecoChain 则更彻底——不新增 decoder,直接在同一条自回归序列上增量续写,用最后一个 item ID 位置的隐状态过 RankHead。
- 本文的差异与推进:RecoChain 独有的是 GSU 检索——排序位看到的不只是候选本身,还有「用该候选的多模态 embedding 从 >10000 条超长历史里捞出来的、按时序重排的 top-$M$ 子序列」。OneRanker 的目标感知是粗粒度的:32 个 K-means 聚类中心构成 fake item tokens,提供的是物品语义空间上的 soft attention,而非针对具体候选的真实历史证据。反过来,OneRanker 比 RecoChain 完整得多:value-aware 多任务解耦(interest tokens + value token + 因果掩码)、Distribution Consistency Loss(把排序器当 teacher,用 KL 的有监督代理把梯度回传给生成器),RecoChain 的联合损失只是 $\mathcal{L}_{\text{SID}} + \mathcal{L}_{\text{rank}}$ 无权重相加,没有任何一致性约束。
- 可比的方法 / 实验差异:OneRanker 面向广告(排序标签是 eCPM 商业价值,pairwise BPR),已在微信视频号广告全量部署;RecoChain 面向自然推荐(标签是 beam 级 0/1 是否命中 ground-truth SID,pointwise BCE),只有 TAOBAO-MM 离线结果。两者的实验证据强度差距很大,指标不可直接比较。
UniRec UniRec: Bridging the Expressive Gap between Generative and Discriminative Recommendation via Chain-of-Attribute(Shopee,2026-04-14)¶
关系:独立并发(本文未引用 UniRec,两者仅相隔 14 天、殊途同归)· 已加载对方精读
- 共同关注的问题:UniRec 把生成式推荐的结构性代价表述为「在看到任何 item 侧信号之前就必须承诺一条生成路径」,并用贝叶斯定理证明按 $p(y \mid \mathbf{f}, u)$ 排序等价于按自回归展开的 $p(\mathbf{f} \mid y, u)$ 排序——差距只来自特征覆盖,而非范式的固有不对称。RecoChain 说的是同一个 root cause 的工程版本:GR 的解码链上没有任何 target/item 侧的证据可用,所以判不出 beam 内部的优劣。
- 相近的技术骨架:两者都选择了「把缺失的 item/target 侧信息作为额外 token 续进同一条自回归链,并在链末端挂一个 Rank Head」这条路,而不是外挂一个独立排序模型。UniRec 的 Chain-of-Attribute 在 SID token 之前投机性地生成粗粒度类目 token(L2→L3),使每一步解码都获得严格为正的条件熵下降 $\delta H_l = I(a; s_l \mid s_{<l}, u)$,从而衰减 beam search 的级联误差;RecoChain 则在 SID token 之后追加 GSU 子序列与候选 item ID token。一个在链前补 item 属性,一个在链后补目标感知的历史证据——同一条链的两端。
- 本文的差异与推进:UniRec 补的是 item 静态属性(类目 / 店铺 / 品牌),RecoChain 补的是 user × target 的交互证据(针对该候选检索出的历史子序列)。前者提升的是生成路径本身的准确性(让 beam 少走错子树),后者不改变 beam 的生成,只在生成之后重新判优——因此 UniRec 能提升 Base 召回,RecoChain 的 Base 恒定不变、只动排序。另外 UniRec 用 Capacity-constrained SID(曝光加权容量约束)解决码字分布的马太效应,RecoChain 只用一个随机 $s_4$ 硬性去重,在语义利用率上明显更粗糙。
- 可比的方法 / 实验差异:UniRec 在 Shopee 生产日志上比 OneRec-V2 高 +9.9 点 HR@50(+22.6% 相对),线上 A/B 拿到 +5.37% PVCTR / +4.76% 订单 / +5.60% GMV,端到端延迟 110ms(传统多阶段 266ms);RecoChain 只有 TAOBAO-MM 上自身 Base-vs-Rank 的 +0.9%~+4.5% 相对增益,无线上验证、无外部 baseline。UniRec 还做了 RFT + DPO 的业务目标对齐,RecoChain 的排序监督停留在「是否命中 ground-truth SID」这一自监督代理上,未接任何真实业务目标。
Gryphon Gryphon: A Unified Architecture for Semantic-ID Generation and Item-Level Scoring(Yandex,2026-06-07)¶
关系:问题陈述高度同构,但 Gryphon 晚于本文约 6 周发表——本文不可能引用它,这是时序使然而非"未引用的并发工作";反过来看,Gryphon 可视作同一论点在工业场景的独立验证 · 已加载对方精读
- 共同关注的问题:Gryphon 把问题命名为结构性错配(structural mismatch):beam search 给 semantic ID(token 序列) 打分,而推荐质量取决于给 concrete item 打分。它列出两个失败模式:序列似然失准(teacher forcing 与自回归推理的暴露偏差,早期 token 错误把 beam 推入别的子树)与 SID 碰撞(共享 SID 的 item 拿到完全相同的分数,见其式 (3))。RecoChain 的「beam 出候选却判不出优劣、select the top-10 from beam-256」正是第一个失败模式的通俗版。
- 相近的技术骨架:两者都是「beam 生成 SID → 解析回具体 item → 用共享用户表示对具体 item 重新打分 → 用新分数决定最终 top-K」,且都强调复用同一份用户编码(Gryphon 复用共享 encoder 状态 $E_u$,RecoChain 复用 KV cache)、联合训练(Gryphon $\mathcal{L} = \mathcal{L}_{\text{gen}} + \lambda \mathcal{L}_{\text{NIP}}$,RecoChain $\mathcal{L} = \mathcal{L}_{\text{SID}} + \mathcal{L}_{\text{rank}}$)。
- 本文的差异与推进:三处实质分歧。(1) 是否保留 beam likelihood:Gryphon 明确「beam likelihood 只用于决定哪些 SID 进入候选集,不作为最终 item 分数」,有意与可能失准的序列似然解耦;RecoChain 反而把两者相加 $\text{score}(c) = \log P(\tilde{\mathbf{s}}^{(c)} \mid X_{<T}) + \log \hat{y}^{(c)}$,保留了失准项。(2) 碰撞处理:RecoChain 用随机 $s_4$ 做 TIGER 式去重 token;Gryphon 恰恰点名批评这种做法——唯一化的终止 token 把解析词表绑死在目录上,在 item 持续涌入的动态目录下这一层必须无限增长并反复重拟合,是部署的严重障碍。这是两篇论文在同一决策点上的正面分歧。(3) 打分器的输入:Gryphon 的 ILSM 是 item-to-user 的轻量 cross-attention,item 侧特征来自 item tower(SID + item ID hash + 元数据 + 内容特征);RecoChain 的打分位看到的是 GSU 检索出的历史子序列,不引入 item 侧原生特征。
- 可比的方法 / 实验差异:Gryphon 在工业音乐服务上取得最高的 item 级 Recall@1000(较 vanilla GR +3.7%),并在 7 天 A/B 中作为唯一候选源替代了 15+ 个召回通路与整个 pre-ranking 阶段而收听时长无显著变化;RecoChain 只有公开数据集上的相对增益。两者数据集与指标口径完全不同,不可直接比较。
七、讨论与局限性¶
7.1 值得借鉴的设计¶
- 把排序机制而非排序模型搬进 GR。业界的主流做法是「用排序模型当 reward model 蒸馏 GR」,RecoChain 反其道而行:不搬模型,搬机制——SIM 的 GSU 检索。这个视角转换很干净,且 Table 3 的 retrieval-len=0 对照证明了机制本身(而不是多加一个头)才是收益来源。
- 打分位选在候选 item ID token 上。这让排序打分成为自回归链的自然延续,无需任何跨模块的表示对齐,KV cache 天然复用,是全文工程上最优雅的一笔。
- 检索按相似度选、按时序拼。保留了子序列的时间结构,避免了 GSU 常见的「打乱时序」问题。
7.2 局限性¶
- 完全没有外部 baseline。全文三张表都是同一模型的 Base vs Rank,既没有 SASRec / TIGER / OneRec 这类召回对照,也没有「GR + 独立排序模型」这个最该比的两阶段基线。因此「统一进一个骨干」相对于「分开两个模型」到底好在哪,实验上是空白的——论文声称的效率优势(共享 KV cache、共享 scaling 单元)没有任何延迟 / 吞吐 / FLOPs 数据支撑。
- 正文与表格数字不一致(§4.2 已标注),说明稿件未经充分校对,属于典型的 preliminary report。
- 模型规模是玩具级的:2 层 decoder、隐层 1024。论文的核心论点之一是「计算 scaling 已被 GR 吸收」,但自身完全没做 scaling 实验,无法回答加深骨干后重排增益是否仍然存在。
- 评估协议缺失。35.4M item 的语料上 Recall@5 ≈ 0.24 是异常高的数值;论文既未说明是否在采样候选集上评估,也未说明 beam 生成的候选如何去重、Recall 的分母如何定义。这使得绝对数值难以与其他 TAOBAO-MM 结果横向对齐(该数据集在归档中已有 SITA / MUSE / TWIN 等判别式 AUC 口径的结果,与本文口径完全不同)。
- 排序监督是自监督代理,不是真实业务目标。$y^{(c)} = 1$ 当且仅当该 beam 的 SID 与 ground-truth 完全相同——这既不是点击标签也不是转化标签,而是「是否命中下一个 item」。这意味着 RankHead 学的其实是「哪条 beam 更可能是对的」,而非论文摘要所说的 "click possibility"。摘要中的 "estimate the click possibility" 与实际实现之间存在措辞落差。同时 beam=20 时每条样本至多 1 个正例、19 个负例,BCE 面临严重的正负不平衡,论文未做任何处理或讨论。
- 随机 $s_4$ 的代价未评估。第 4 位纯随机意味着 beam 在最后一层做的是无信息选择,既浪费了一层解码算力,也让 $\log P(\tilde{\mathbf{s}}^{(c)})$ 混入了随机项。论文未讨论去掉 $s_4$(改用碰撞组 + item 级打分,即 Gryphon 路线)会怎样。
- 方法论可扩展性存疑。收益随输入序列变长而衰减(Table 2:+3.14% → +0.92%),而工业 GR 的演进方向恰恰是更长的用户序列;同时 GSU 依赖冻结的多模态 embedding 做余弦检索,这个检索器无法与骨干端到端联合优化,属于典型的「核心组件固化」瓶颈——参数量 scaling 时,「如何检索历史」这条路径不会跟着一起增长。
7.3 工业落地价值:需要澄清¶
尽管通讯作者来自 Kuaishou、论文动机完全建立在 OneRec/OneMall/OneLive 这条工业主线上,本文并未提供任何工业落地证据:没有线上 A/B、没有内部数据集、没有部署规模或延迟数据、没有 OPEX 对比。实验全部在公开学术数据集 TAOBAO-MM 上完成,模型规模为 2 层。因此这篇论文应当被定位为一份提出方向的学术短文(position + preliminary evidence),而非工业系统报告。它真正的价值在第 1.3 节那张技术路线对照表所给出的归因,以及 Table 3 对该归因的干净验证;其余部分都还停留在概念验证阶段。
对照来看,同期 / 稍后的 OneRanker(微信视频号广告全量)、UniRec(Shopee 线上 +5.60% GMV)、Gryphon(Yandex 以单模型替代 15+ 召回通路)都给出了完整的工业闭环——RecoChain 提出的这条「把 SIM 搬进 GR 链条」的路线本身是成立且有价值的,但要判断它相对于这些已落地方案的真实优劣,还需要一份带线上实验的完整版本。