GRACE: Generative Recommender Acceleration Engine for Real-Time Ads Retrieval¶
Zhou Fang, Yuhang Huang, Ang Zhang, Yihan He, Ruichao Xiao, Chao Li, Yavuz Yetim, Sibyl Yang, Xiaohan Wei, Fei Tian, Liang Wang, Chonglin Sun, Liyuan Li, Nathan Yan, Gaoxiang Liu · Meta Platforms · arXiv:2608.00938v2 · 2026-08-02(v2: 2026-08-04)
一句话总结¶
GRACE 是 Meta 把生成式检索真正推上实时广告链路时写下的服务系统论文:它指出生成式广告检索有两个此前无人正面处理的上线障碍——合规性(eligibility)(广告主定向规则是请求级、个性化的,而生成模型只学到一个稳定的 SID 空间,生成完再过滤会大量白做)与算力(compute)(宽 beam、短序列的 encoder-decoder 解码器形状与 FlashAttention 这类为长序列设计的通用 kernel 严重错配)。前者用 Generative Target Matching (GTM) 解决:在 STATIC 式 catalog-valid 受限解码 trie 的每个节点上挂 subtree-union 的 bitmask / Bloom matcher,解码每一步把不可能包含合格广告的前缀直接掩成 $-\infty$,广告级定向通过率从 23.55% 提到 40.42%;后者用一整套解码器改造解决:cross-attention 的 beam-as-query 布局、短序列 coalesced self-attention Triton kernel、paged 自注意力 KV cache、动态 per-step beam size,在 NVIDIA GH200 上相对 FA2/FA3 中更快者把 cross-attention 压到 1/68、self-attention 压到 1/23.4–1/25.8,解码器整体 P99 从 197.7 ms 降到 17.8 ms(11.1×)。
1. 研究动机与背景¶
1.1 广告检索比通用推荐多一道硬约束:Target Matching¶
大规模广告推荐系统普遍采用级联(cascade)架构:快速的召回阶段把庞大广告库收窄成小候选集,更重的排序模型再给这些候选打分(Covington et al., 2016; Gallagher et al., 2019)。但广告比自然内容推荐多一条硬性的合规要求:广告主可以对地理、人口属性以及其他请求信号指定定向规则(targeting rules),界定他们想触达的人群。对每一次用户请求,广告候选生成必须先执行这些规则,只有对该用户合格(eligible)的广告才能进入召回。论文把这道合格性检查称为 Target Matching。
传统流程里 Target Matching 是前置的:先从请求属性出发查定向索引拿到一批合格广告,再交给召回模型打分。Meta 自家的 Andromeda(Sun et al., 2024)就是这条路线的代表——深度召回模型加分层索引,在数千万广告候选上搜索。
1.2 生成式检索把这条流程颠倒了,于是 eligibility 成了第一个服务难题¶
生成式检索改变了数据流。按 TIGER(Rajput et al., 2023)的范式,每个 item 被表示为一个 Semantic ID (SID)——一小段离散 token 序列,Transformer decoder 以用户为条件自回归地直接吐出 SID,而不是给别人送来的候选打分。对广告场景,这造成了一个根本性的服务错配(serving mismatch):
定向规则是动态变化的、对每个请求界定不同的合格广告子集;而生成模型学到的是一个稳定的 SID 空间,它只会直接预测高概率的标识符。
当然可以先生成再过滤:把生成的 SID 展开成广告,然后跑 Target Matching。但这样大量生成出来的广告会在进入下游排序前就被丢弃——算力白花,有效候选被稀释。
关键在于,catalog-valid 的受限解码本身解决不了这件事。STATIC(Su et al., 2026)能高效地保证每个生成的 SID 属于给定的目录,但那是一条有效性(validity)约束:解码被限制在目录里存在的 SID 上,可以支撑新鲜度、地域、类目、库存这类与请求无关的业务规则。广告要的是另一种约束——个性化的合格性约束:生成的 SID 必须至少代表一条定向规则与该用户匹配的广告。因此,eligibility 必须在解码过程中检查,而不能只在 SID 展开回广告之后检查。
1.3 第二个服务难题:宽 beam、短序列的解码器形状¶
实时广告检索需要每个请求生成数千条广告,同时满足严格的延迟与算力成本要求。这促使 GRACE 把服务设计建立在轻量 encoder-decoder Transformer(Vaswani et al., 2017; Rajput et al., 2023)之上,而不是 LLM。但它的解码器形状与 FlashAttention / FlashInfer(Dao et al., 2022; Dao, 2024; Shah et al., 2024; Ye et al., 2025b)针对的长序列场景截然不同:
- beam search 制造了一个非常宽的有效 batch($B\cdot M = 16\times1024 = 16384$ 行);
- 自注意力序列只有几个 SID token 长($L_{\text{SID}}=4$),不像 decoder-only LLM 那样有长 prompt 前缀;
- encoder 输出在所有 beam 之间共享,作为 cross-attention 的 context。
这种「宽 batch、短序列」的形状让通用注意力 kernel 严重欠利用:压力来自成千上万个微小的注意力操作、访存合并行为和 beam 重排,而不是长序列注意力。这与常见 LLM 服务场景形成鲜明对照——prefill 是长 query 长 key 的高算术强度,decode 是单 token query 打很长的 KV cache、被访存带宽主导。
1.4 三条贡献¶
- 指出 catalog-valid 受限解码与广告受众定向匹配之间的鸿沟,提出 GTM 在 Transformer 解码内部做个性化合格性测试;
- 为 encoder-decoder 生成式检索器的宽 beam、短序列注意力定制 kernel,在该工作负载形状上大幅超越 SOTA 通用注意力 kernel;
- 给出一套广告生成式检索的端到端服务设计,含多阶段流水线推理与 beam search 优化。
2. GRACE 服务架构¶
2.1 推理流程¶
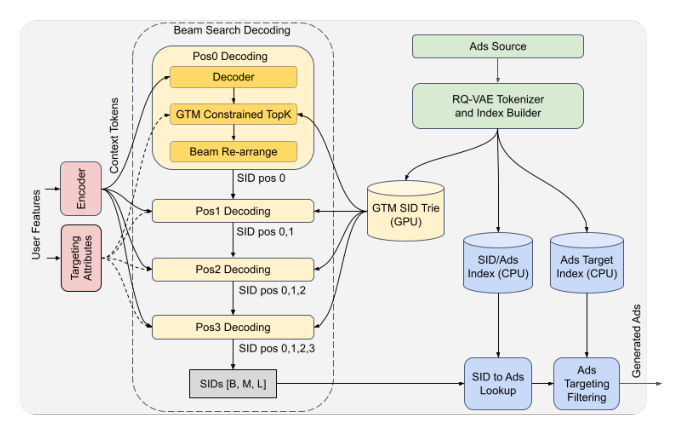
在线推理分四步:
- Encoder:把请求侧用户特征转成 context tokens;
- 自回归 beam search 循环:在每个 SID 位置,decoder 为当前 beams 产出 next-token logits;一个融合的约束 kernel 同时施加 CD 与 GTM 过滤,删掉非法或不合格的 next token。对每个存活的 next token,把新 token 的对数概率加到前缀累积对数概率上更新 beam 分数;beam top-$k$ 挑出得分最高的前缀并为下一步重排 beam 状态;
- SID→广告展开:完成的 SID 通过 SID-to-ad 索引展开成广告 id;
- 广告级精确定向过滤:展开的广告过 CPU 侧 exact target matcher,剩下的广告进入下游召回与排序栈。
2.2 三个物理索引¶
三个索引都是从实时在线流周期性、异步构建的:
- GTM SID trie(GPU):基于 trie 的受限解码索引,沿用 STATIC(Su et al., 2026),并为 SID 前缀和完整 SID 增挂定向 matcher。低基数定向属性(国家、年龄、性别)用 bitmask matcher;高基数定向属性(细粒度地理位置)用 Bloom filter matcher。这是解码循环内 GTM kernel 唯一读取的索引。
- SID-to-ad 索引(CPU):从完成的 SID 到广告 id 的映射。因为 CD 保证了所有生成的 SID 都是 catalog-valid 的,所以每个生成的 SID 至少能展开出一条广告。
- Ads targeting 索引(CPU):广告级精确 matcher,施加与 GTM 相同的 bitmask/Bloom 定向语义,但在精确的单广告粒度上。
为什么 CPU 侧的后置匹配仍然必需? 因为 GTM 是 SID 粒度的过滤器,而每个 SID 是一簇广告。一个「合格的 SID」只保证簇里至少有一条广告对该请求合格,同簇的其他广告仍可能不合格,必须由精确的广告级过滤剔除。有了 GTM 之后,这个后置阶段拿到的 SID 已经通过了解码期的个性化合格性检查,因此通过率远高于只做广告级 target matching。
2.3 Encoder-Decoder 模型¶
GTM 对 encoder-decoder 与 decoder-only 的 SID 生成式检索器都适用,而本文的算力优化聚焦 encoder-decoder。
Encoder:GRACE 对 encoder 选型不敏感,只要它能吐出供 decoder cross-attention 用的 context tokens。TIGER 演示了这种 encoder-decoder 模式;对异构推荐特征,InterFormer(Zeng et al., 2025)提供了把非序列特征(用户画像、上下文)与行为序列(点击、转化)通过特征交互与注意力层结合的 encoder 设计。本文评测采用 InterFormer 式 encoder,输出 $T_{\text{ctx}}=128$ 个 context token。
Decoder:beam search 解码中,同一请求的所有 beam 共享 encoder 输出,因此 cross-attention 可以跨 beam 复用同一份 KV。decoder 为 cross-attention 与 self-attention 各维护一份 KV cache:
- Cross-attention KV:每个请求从 encoder context tokens 算一次,该请求的所有 beam 在整个解码过程中共享;
- Self-attention KV:存每层生成前缀的 key/value,每个自回归步随部分 SID 增长而更新。因为只含生成的 SID 前缀而不是长 prompt,序列非常短。
本文研究的模型配置:SID 定长 $L_{\text{SID}}=4$;decoder 三层、$H=16$ 头、头维 $d_h=128$、词表 $|\mathcal{V}|=512$。固定 beam size $M=1024$ 时,每请求 533 GFLOPs。
2.4 动态 per-step beam size¶
beam search 在这个工作负载上有两块算力开销:(a) beam 倍增的解码器算力——每个自回归步要为每条 beam 跑一遍 decoder,解码器 FLOPs 随该步预配置的 beam size 线性增长;(b) beam 重排——CD+GTM 过滤后 top-$k$ 从打分候选里挑出下一批前缀,生成 token、累积分数、自注意力 KV 状态都要跟着新的 beam 顺序走,这是解码循环里的访存开销。
动态 per-step beam size。标准 beam search 每步用固定 $M$。GRACE 改用 $(M_1,\dots,M_{L_{\text{SID}}})$:第 $t$ 步 decoder 只在 $M_t$ 行 beam 上跑,每行产出 $|\mathcal{V}|$ 维 logits。第一步 $M_1=1$(解码从单一初始状态出发);中间步 top-$k$ 选出 $\text{topk}_t=M_{t+1}$ 条 beam,末步选出生成的 SID。
动机很直接:$|\mathcal{V}|=512$,所以第一步最多只能产出 512 个不同前缀,配 1024 的 beam 是纯浪费;CD+GTM 过滤还会进一步收窄——实验测得首位平均只有 492.6 条唯一合格 beam。从第二步起 $M_t\cdot|\mathcal{V}| \gg M_{t+1}$,top-$k$ 正常能填满下一层 beam。因此 GRACE 用 $(M_1,M_2,M_3,M_4)=(1,512,1024,1024)$。解码器算力近似与 beam size 线性相关,每请求算力从 533 GFLOPs 降到 446 GFLOPs,降幅 16.2%。
Paged beam 重排。每次 top-$k$ 之后,beam 重排要把选中前缀的 token、分数和 KV 状态洗牌成新 beam 状态再追加新 token。token 和分数很轻,真正吃力的是自注意力 KV cache 的数据搬运:稠密实现要把选中 beam 的历史前缀 KV 复制进每个新 beam 行——在 $B\cdot M=16384$ 时,这份稠密 KV 拷贝搬动约 1.6 GB、每步约 1.79 ms。GRACE 改用 paged-attention 风格的 block table:每个 block 存一个 beam 行、一个 token 的自注意力 KV(跨所有头)。beam 重排只复制历史位置的 block id,下一步 decoder 把当前 token 写进一个新 block;共享前缀的 children 因此可以复用同一批历史 block id。
2.5 多阶段流水线推理¶
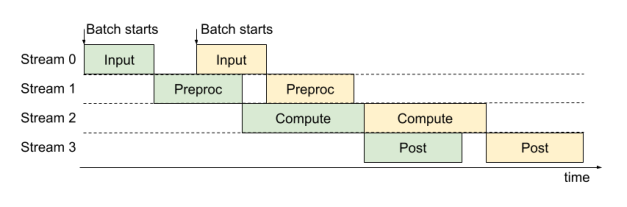
GRACE 把推理流程实现为四个并发运行的运行时阶段,各自跑在独立 Python 线程 + 专属 CUDA stream 上:
- Input:请求批处理与 host→GPU 传输;
- Feature preprocessing:embedding-heavy 的特征准备(embedding bag、序列/非序列预处理);
- Compute-intensive:encoder 的特征交互与注意力计算,随后是带 GTM 的完整解码循环;
- Post:SID→广告查找与广告级精确定向过滤。
Python GIL 争用通过把热路径移出解释器来缓解:TorchScript、CUDA graph、以及 post 阶段的 C++ 实现。
对单个 batch,四阶段按序执行;跨 batch 则在不同 stream 上错开并行。论文用 MFU(Model FLOPs Utilization)= 实测计算吞吐 / 硬件理论峰值算力来度量。特征预处理阶段 MFU 低,compute-intensive 阶段 MFU 高且主导算力。因为不同阶段压的是硬件不同部位,compute-intensive 阶段可以背靠背连续跑,同时把低 MFU 阶段藏在同一时间窗内,从而在不改变模型计算、也不引入可测退化的前提下提升端到端 GPU 效率。
3. Generative Target Matching (GTM)¶
3.1 问题形式化¶
论文严格区分四个概念:
- valid SID:目录里存在、且至少映射到一条广告的 SID;
- eligible ad:定向规则与用户/请求匹配的广告;
- eligible SID:至少含一条 eligible ad 的 SID;
- eligible SID prefix:其子树至少含一条 eligible ad 的前缀。
传统 Target Matching 从请求属性出发查定向索引返回一批广告,再把幸存广告交给召回模型。生成式模型没有这样的「预匹配广告输入」:在第 $t$ 步,它唯一能控制的就是允许 beam search 探索哪些 next SID token。GTM 因此把传统的目标过滤契约翻译成这个 token 级控制问题:一个 token 可行,当且仅当它构成的前缀仍然包含至少一条可能通过该请求目标过滤的广告。
设第 $t$ 步当前 beam 前缀为 $p$(SID trie 中的一个节点),$v$ 为一个候选 next token。受限解码接纳 $v$ 当且仅当拼接前缀 $p\|v$ 是某个合法 SID 的前缀:
$$\mathbf{CD}_t[v] = \mathbb{1}[v \in \text{children}(p)] \tag{1}$$
GTM 为每个候选 token 定义合格性指示 $\mathbf{TM}_t[v]$。记 Target Matching 用到的请求属性为 $u$(国家、年龄、性别、地理位置等)。若以 $p\|v$ 为根的 SID 子树中至少含一条对请求属性 $u$ 合格的广告,则接纳 $v$:
$$\mathbf{TM}_t[v] = \text{match}(u,\, p\|v) \tag{2}$$
decoder 把两条约束同时施加到候选 token 的对数概率上:
$$\mathbf{L}_t[v] \leftarrow \begin{cases} \mathbf{L}_t[v], & \mathbf{CD}_t[v]\,\mathbf{TM}_t[v] = 1,\\[2pt] -\infty, & \text{otherwise.} \end{cases} \tag{3}$$
$\mathbf{TM}_t[v]$ 用两类 matcher 实现:低基数属性用 bitmask matcher,高基数属性用 Bloom filter matcher。
3.2 低基数属性的 Bitmask 匹配¶
对低基数约束,bitmask 编码国家、年龄、性别等定向属性。每个属性占一段定长 bit range,每个 bit 位对应一个可能取值。记 $\text{bitmask}(a)$ 编码广告 $a$ 的定向规则允许的取值,$\text{bitmask}(u)$ 编码用户实测的属性取值。完整 bitmask 把各属性段拼接成一个 packed 向量,存成定长的 64-bit 整数数组;必要时 pad 到 64-bit 字边界,从而支持 CPU 侧 SIMD 向量化位运算。
GRACE 为 SID 前缀和完整 SID 都物化这类 bitmask。记 $\mathcal{A}(p)$ 为 trie 节点 $p$ 代表的广告集合:对完整 SID 是该 SID 对应的广告簇;对内部前缀是所有后代 SID 下广告的并集。存储的 bitmask matcher 是这些广告 bitmask 的按位或:
$$\text{bitmask}(p) = \bigvee_{a \in \mathcal{A}(p)} \text{bitmask}(a) \tag{4}$$
解码时候选 token $v$ 指向子节点 $p\|v$,$\mathbf{TM}_t[v]$ 在 $\text{bitmask}(u)$ 与存储的节点 matcher $\text{bitmask}(p\|v)$ 之间做 bitmask 匹配。packed 测试在「用户属性 bit 全部出现在节点 matcher 中」时通过:
$$\big(\text{bitmask}(p\|v) \wedge \text{bitmask}(u)\big) = \text{bitmask}(u) \tag{5}$$
这个测试是保守的(conservative),会引入假阳性:因为存储的 matcher 是前缀下所有广告的 OR,不同广告可能贡献不同的匹配属性 bit,从而让某个节点通过测试,尽管该节点下没有任何单条广告真正合格。
论文给了一个 bit 级玩具例子。设 toy mask 有两个属性:country bits [US, CA, UK]、age bits [18–24, 25–34]。若某 trie 节点含一条定向「US + 18–24」的广告和另一条定向「CA + 25–34」的广告,则节点并集 matcher 为
$$\text{bitmask}(p) = \underbrace{\texttt{110}}_{\text{country}}\ \underbrace{\texttt{11}}_{\text{age}} \tag{6}$$
来自美国、30 岁的用户请求为
$$\text{bitmask}(u) = \underbrace{\texttt{100}}_{\text{country}}\ \underbrace{\texttt{01}}_{\text{age}} \tag{7}$$
于是每个属性都相交($\texttt{100}\wedge\texttt{110}\ne 0$,$\texttt{01}\wedge\texttt{11}\ne 0$),节点被保留——尽管两条广告没有一条单独合格:US 那条年龄不符,25–34 那条国家不符。
3.3 k-way partition:缓解 OR 造成的假阳性¶
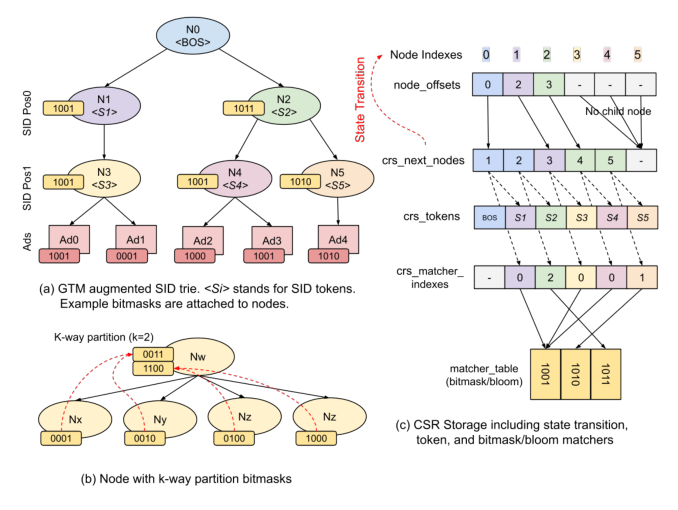
k-way partitioning 把 trie 节点下的后代分成 $k$ 组,每组存一个并集 matcher;请求只有在至少一组匹配全部属性时才通过。论文定义 matcher fill rate 为存储的并集 matcher 行中置 1 bit 的比例:fill 越低说明并集位图越不饱和、matcher 越有选择性,越不容易保留子树并集造成的假阳性前缀。代价是每个节点要存和查更多 matcher(前缀被保留只需任一分区 matcher 通过)。
- Static k-way:每个解码位置用固定的 $k$。构建时每个 SID 被分配到「加入后 post-union fill rate 最小」的那个分区;
- Dynamic k-way:为每个 trie 节点(即每个 SID 前缀)独立选 $k$。构建器不断增大该节点的 $k$,直到并集 fill rate 达到 best-effort 目标或触及 $k_{\max}$。
需要强调:GTM 始终是 SID 级过滤器,生成的 SID 在 SID→广告查找之后仍要过 CPU 侧的精确广告级 matcher。因此论文用精确广告级通过率作为评估 SID 级 GTM 的指标。
3.4 高基数属性的 Bloom 匹配¶
对位置这类高基数约束,取值空间太大无法编成稠密 bit range,且每条广告或每个请求都可能携带多个取值。GRACE 因此用 Bloom filter matcher。以位置为例:广告主可能定向以字符串表示的细粒度地理(城市、地区、局部区域),而请求携带用户侧位置字符串。
每条广告把它的目标位置集合编码成一个定宽 $w$-bit Bloom filter $\text{bloom}(a)$;本文评测用 $w=256$ bit,存成 4 个 64-bit 整数。一个带 $N_{\text{loc}}$ 个用户侧位置 $\{\ell_1,\dots,\ell_{N_{\text{loc}}}\}$ 的请求把每个位置分别编码为 $\{\text{bloom}(\ell_1),\dots,\text{bloom}(\ell_{N_{\text{loc}}})\}$。Bloom 包含测试为:
$$\text{contains}(B, \ell_j) = \mathbb{1}\big[(\text{bloom}(\ell_j) \wedge B) = \text{bloom}(\ell_j)\big] \tag{8}$$
只要存在至少一个用户位置 $\ell_j$ 使 $\text{contains}(\text{bloom}(a),\ell_j)=1$,位置约束即视为匹配(ANY-of-many 语义)。
GRACE 为与 bitmask matcher 相同的 SID 前缀和完整 SID 物化 Bloom matcher,同样是子树内广告 Bloom filter 的按位或:
$$\text{bloom}(p) = \bigvee_{a \in \mathcal{A}(p)} \text{bloom}(a) \tag{9}$$
解码时 $\mathbf{TM}_t[v]$ 用与 bitmask 相同的子节点查找模式,但谓词是 ANY-of-many:一旦某个请求位置 $\ell_j$ 满足 $\text{contains}(\text{bloom}(p\|v),\ell_j)=1$ 就保留 $p\|v$。与 3.2 节同理,子树 OR 是保守的会带来假阳性;Bloom 哈希碰撞又叠加了第二重假阳性来源。3.3 节的 k-way partitioning 同样适用于 Bloom matcher。因为 SID 级 Bloom 过滤仍是保守的,GRACE 仍要跑精确的广告级 Bloom 过滤来剔除不合格广告。
3.5 存储布局与查找¶
沿用 STATIC 引入的受限解码索引,GRACE 把合法 SID 序列存成前缀 trie。解码时每条活跃 beam 对应一个 trie 前缀/节点,除了已解码的 token 和累积分数外,还额外携带该前缀的整数节点 id。
trie 的孩子用 CSR(compressed sparse row)存储:node_offsets 把每个 trie 节点映射到一段连续的 child-entry 区间;对区间内每个 child-entry id $j$,csr_tokens 给出候选 SID token,csr_child_nodes 给出候选存活时要携带的子节点 id,bitmask_index / bloom_index 指出用于合格性检查的 matcher 行。Appendix A 给出的具体布局是:
GTM SID Trie
  vocab_size:      int
  sid_length:      int
  num_nodes:       int                       # trie 节点数
  node_offsets:    int32[num_nodes + 1]      # 节点 i 的孩子: [node_offsets[i], node_offsets[i+1])
  csr_child_nodes: int32[num_child_entries]  # 每个 child entry 的子节点 id
  csr_tokens:      int16[num_child_entries]  # 到达该子节点的 SID token
  bitmask_index:   int32[num_child_entries]  # matcher 表行 id
  bloom_index:     int32[num_child_entries]
  bitmask_table:   uint64[num_bitmask_rows][W_bm]   # packed、去重后的 matcher 行
  bloom_table:     uint64[num_bloom_rows][W_bl]

Lookup(node_id, user_bitmask, user_blooms):
  start = node_offsets[node_id]
  end   = node_offsets[node_id + 1]
  for j in [start, end):
      child_node = csr_child_nodes[j]
      token      = csr_tokens[j]
      bm = bitmask_table[bitmask_index[j]]
      bl = bloom_table[bloom_index[j]]
      bitmask_ok = match(user_bitmask, bm)
      bloom_ok   = any(match(q, bl) for q in user_blooms)
      if bitmask_ok and bloom_ok:
          emit(token, child_node)
运行时 GPU 把这段查找与匹配跨活跃 beam、跨 child entry 并行化。
去重的 bitmask/Bloom 存储是一个关键的工程点:实践中大量 child entry 共享完全相同的 matcher 行,因此 GRACE 把 matcher 存储去重——CSR 区间读到的 matcher-table id 指向唯一 matcher 行组成的共享表。
Table 1. 索引概况与按解码位置的 GTM matcher 存储(p1/p2/p3 表示前缀长度 1/2/3 之后的非根 trie 转移层;$L_{\text{SID}}=4$ 时 p3 到达完整 SID。存储值为「去重前/去重后」,单位 MB)
| Metric | Quantity |
|---|---|
| SIDs | 30M |
| Ads/SID p50/p90/p99 | 1 / 2 / 11 |
| Bitmask width | 7 int64 values |
| Bloom width | 4 int64 values |
| Bitmask storage p1/p2/p3 | 11/10, 620/175, 1645/228 |
| Bloom storage p1/p2/p3 | 6/5, 354/112, 940/162 |
分析:最大的节省出现在 p3(完整 SID 转移层)——bitmask 存储从 1645 MB 降到 228 MB(7.2× 压缩),Bloom 存储从 940 MB 降到 162 MB(5.8× 压缩)。这正是「一个 SID 平均只挂 1 条广告(p50=1)」的直接后果:叶子层大量 matcher 行完全相同,去重收益最大;而 p1 只有 512 个转移,本来就没多少可去重的。如果没有去重,仅 GPU 上的 matcher 表就要 2.6 GB,会直接挤爆 GH200 的显存预算。
k-way partitioning 用同样的去重表格式,但一个 trie 节点可存一个或多个 matcher id:static k-way 的分区数由解码位置固定,因此用定宽 per-node 布局;dynamic k-way 每个节点分区数不同,因此用 CSR 风格的 jagged 格式(扁平 matcher id 数组 + 每行 offset)。
4. 解码器 kernel 设计¶
解码器 kernel benchmark 用 batch size $B=16$。固定 beam $M=1024$ 时,第一步有 $B$ 个活跃行,之后每步 $B\cdot M=16384$ 行。这个宽 beam、短序列的形状与通用 SDPA kernel 极不匹配:cross-attention 是大量共享请求 KV 的单 token beam query;self-attention 是打在很短的部分 SID 前缀上的单 token query。
GRACE 同时降低 kernel 周边的框架开销:用 torch.compile max-autotune 让编译器尽量自动融合周边 PyTorch 算子;整个定长 SID 解码循环(decoder forward、CD+GTM、top-k、beam 重排)被捕获成一张 CUDA graph。
4.1 Cross-attention 的 beam-as-query 布局¶
在 reshape 之前,通用 SDPA 布局会是:
$$Q \in \mathbb{R}^{BM \times H \times 1 \times d_h}, \qquad K, V \in \mathbb{R}^{BM \times H \times T_{\text{ctx}} \times d_h} \tag{10}$$
这把解码当成 $BM$ 个互不相干的单 query 注意力操作,完全错过了 beam search 的结构:同一请求的 $M$ 条 beam query 各不相同,但它们 attend 的是同一份用户 context KV。GRACE 把 cross-attention 的 $K,V$ 保持在请求级的自然布局 $\mathbb{R}^{B\times H\times T_{\text{ctx}}\times d_h}$,只置换 $Q$:
$$Q: \mathbb{R}^{BM \times H \times 1 \times d_h} \;\longrightarrow\; \mathbb{R}^{B \times H \times M \times d_h} \tag{11}$$
于是一个请求的各条 beam 变成了 query-sequence 维度。注意力调用从「$M$ 次不相关的单 query 调用」变成「$M$ 条 beam query 打一份共享用户 context」。这次 reshape 只保留一份请求 KV,构造出形状更好的注意力操作,并让同一请求所有 beam 复用同一份 user-context KV 加载。
第 $t$ 步($T_q=1$)的完整 reshape 为:
$$\begin{aligned} q &= \text{view}(Q, [B, M_t, H, T_q, d_h]),\\ q &= \text{permute}(q, [0,2,1,3,4]) \to [B, H, M_t, T_q, d_h],\\ q &= \text{reshape}(q, [B, H, M_tT_q, d_h]),\\ x &= \text{SDPA}(q, K, V) \to [B, H, M_tT_q, d_h],\\ x &= \text{reshape}(x, [B, H, M_t, T_q, d_h]),\\ x &= \text{permute}(x, [0,2,1,3,4]) \to [B, M_t, H, T_q, d_h],\\ X &= \text{reshape}(x, [BM_t, H, T_q, d_h]). \end{aligned} \tag{12}$$
Appendix B 的正确性论证:假设扁平化的 beam 行是 request-major 的,即行 $r=bM_t+m$ 对应请求 $b$、beam $m$。前向 reshape 映射为
$$Q_{bM_t+m,\,h,\,\tau,\,:} \;\mapsto\; q_{b,\,h,\,mT_q+\tau,\,:} \tag{13}$$
于是对每个请求 $b$,SDPA 把 $M_tT_q$ 个 beam-query 位置看作一条 query 序列,attend 到同一份请求级 $K_{b,h,:,:}$ 与 $V_{b,h,:,:}$。逆 reshape 映射为
$$x_{b,\,h,\,mT_q+\tau,\,:} \;\mapsto\; X_{bM_t+m,\,h,\,\tau,\,:} \tag{14}$$
恢复了原始扁平 beam 行顺序。因此该变换只改变 SDPA 看到的张量布局,不混合请求、也不重排最终 beam 输出——是一次纯 layout 变换。
4.2 合并访存的短序列 self-attention¶
self-attention 同样是单 token query,但它的 $K,V \in \mathbb{R}^{BM\times H\times T_{\text{self}}\times d_h}$ 是beam-specific 的(每条 beam 有不同的生成前缀),所以 cross-attention 的 KV 广播技巧不适用。这里可利用的结构是:大量扁平化的 batch/beam 行拥有相同的短序列长度。
GRACE 用一个为该解码形状定制的 Triton SDPA kernel:把多条 beam 行合并(coalesce)进同一个 kernel tile,计算一个更大的注意力 tile,并施加块对角 mask 让每一行只 attend 自己缓存的前缀。例如一个 tile 合并 $G=4$ 条 beam 行、$T_{\text{self}}=3$:这本是四个独立的 $1\times 3$ 注意力,但 Triton kernel 求值一个 $4\times12$ 的 tile 并 mask 掉跨行项。实现中 $G$ 由 Triton autotuning 从一小组候选合并因子里挑。
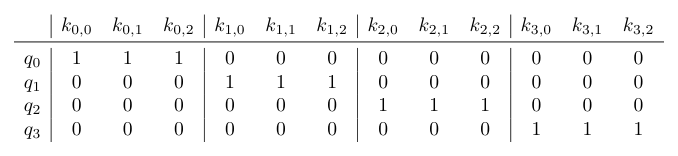
这不是因果 mask——因果性已经由「只暴露 beam 前缀 $0,\dots,t$」保证了;这个 mask 只用来阻止不同 beam 行互相 attend。该变换多花了算术:有用比例只有 $1/G$。但它仍是净赚,因为 $T_{\text{self}}$ 只有几个 SID token,而 baseline 要执行许多微小的 $1\times T_{\text{self}}$ 注意力,occupancy 差、访存事务小、tensor core 利用率弱;合并把它们变成更少、更大、更规整的 tile,访存也更连续。
Kernel 融合。在更高优化级别,decoder 进一步融合自注意力的非 GEMM 中段:QKV 投影和输出投影仍留给 cuBLAS GEMM,而融合后的 Triton kernel 直接消费 QKV 投影输出、把当前 token 的 $k,v$ 写进 cache、gather 短的缓存前缀、计算带 mask 的块对角注意力并返回输出——避免了分离的 cache-write、reshape、SDPA 与 context 物化步骤。
4.3 Paged 自注意力 KV cache¶
沿用 PagedAttention(Kwon et al., 2023),GRACE 把 KV block 存在一个扁平池里,用 block table $P \in \mathbb{Z}^{BM_t \times L_{\text{SID}}}$ 把逻辑 beam 行与 SID 位置映射到物理 KV block。一个 block 存一条 beam 行、一个生成 token 的自注意力 KV,即 $P_{i,t}$ 把逻辑 beam 行 $i$、SID 位置 $t$ 映到该 token 的物理 KV block。
设 $p_i$ 为 beam $\text{topk}_t$ 为新 beam 行 $i$ 选中的父行。稠密实现会把父行缓存的 KV 字节复制进第 $i$ 行;GRACE 只复制父行已有前缀的 block id:$P^{\text{new}}_{i,j}=P_{p_i,j}$($0\le j<t$),并把当前 token 的 KV 写进一个新 block。注意力时 kernel 按前缀顺序跟着 block id 去 gather 物理 KV block。这让 KV 读取不如稠密重排后的 cache 连续,但把大块 KV cache 拷贝换成了小的整数表拷贝;共享父行的 beam 也共享同一批历史 block id。
4.4 GTM kernel¶
CD+GTM kernel 实现 3.5 节的解码期查找路径。论文特意用 CUDA kernel 而不是 Triton,为的是对共享内存 staging、per-candidate 线程分配和 early exit 行为有更细的控制。
- 每个 CUDA block 处理一条 beam,block 内线程并行处理该 beam 的 child-entry 区间;
- 由于同一用户请求扩展出的所有 beam 共享同一份用户侧定向属性,kernel 把 beam 行映射回批量用户属性张量的对应行,把这些 mask 在共享内存里 stage 一次,该 beam 的所有 next-token 候选都复用这份 staged mask,而不是反复重新加载;
- 谓词求值顺序被刻意安排以减少工作量:先查 bitmask matcher,逐个比较 packed int64、在第一个失败的 int64 比较处退出;只有通过 bitmask 检查的候选才跑 Bloom 匹配。Bloom 匹配时 kernel 扫描缓存的请求 Bloom 行(每个用户侧位置 $\ell_j$ 一行),对每个位置逐 int64 比较、一旦某个必需的 int64 不被包含就停止内层扫描;外层扫描一旦有任一用户位置被候选 matcher 包含就停止(ANY-of-many 语义下一个匹配位置就够了)。
论文也坦承 early exit 的局限:它减少了指令数与 matcher 访存流量,但一个 CUDA block 的完成时间仍被其线程处理的最慢候选所界定。
5. 实验设置¶
评测跑的是 3.1 节的完整推理流程,分两部分:
- 效果:测量生成的 SID 展开、并被 CPU 侧广告级 matcher 过滤后的精确广告级 target matching 通过率——这评估 SID 级 GTM 在最终广告级合格性检查下的有效性;
- 性能:kernel 微基准 + 完整推理路径的端到端延迟。
数据:过滤研究使用模型评测数据集提供用户特征、合成的用户位置数据(每用户 64 个随机位置)、以及 Table 1 中的 30M-SID 索引。性能测量使用 2.3 节的模型配置,硬件为 NVIDIA GH200 Grace Hopper Superchip。
四种解码期过滤模式:
- CD only:只做 catalog-valid 受限解码,关闭 SID 级定向;
- CD+GTM:启用 bitmask + Bloom matcher,不做 k-way 分区(每个 trie entry 每种 matcher 类型各一个并集 matcher,按 3.5 节的去重格式存储);
- Static k-way:bitmask 与 Bloom 都用 $k=(64,64,32,8)$(对应四个解码位置);
- Dynamic k-way:每个 trie 节点独立选 $k$,$k_{\max}=32$,best-effort 目标 fill rate 为 0.25。
延迟预算:端到端推理 P99 < 100 ms,其中约 30 ms 用于攒 16 个用户的 batch,留给四个运行时阶段约 70 ms。
6. 主要实验结果¶
6.1 GTM matcher fill rate¶
Table 2. 按解码位置的平均 GTM matcher fill rate(fill rate = bitmask/Bloom matcher 中 1 bit 的比例,越低越有选择性)
| Mask | Method | Root | Pos1 | Pos2 | Pos3 |
|---|---|---|---|---|---|
| Bitmask | CD+GTM | 0.734 | 0.283 | 0.139 | 0.128 |
| Bitmask | Static k-way | 0.563 | 0.097 | 0.010 | 0.016 |
| Bitmask | Dynamic k-way | 0.627 | 0.283 | 0.142 | 0.128 |
| Bloom | CD+GTM | 0.979 | 0.475 | 0.069 | 0.048 |
| Bloom | Static k-way | 0.933 | 0.070 | 0.004 | 0.006 |
| Bloom | Dynamic k-way | 0.976 | 0.333 | 0.080 | 0.048 |
分析:fill rate 随解码位置单调下降——越靠近叶子,子树越小,并集 matcher 越不饱和,这符合直觉。根节点的 Bloom fill 高达 0.979(几乎全 1,等于毫无选择性),说明在 trie 根上 Bloom 过滤基本不起作用,GTM 的选择力主要来自 Pos1 之后。Static k-way 大幅降低了两类 matcher 的饱和度(Bloom Pos2 从 0.069 降到 0.004,接近 17× 更稀疏);而 dynamic k-way 基本无效——因为它常常选出很小的 $k$(best-effort 目标 fill 0.25 一旦达成就停止增大 $k$,而并集本身在深层已经低于 0.25,于是 $k$ 停在 1)。
6.2 广告级 target matching 通过率¶
为了分析通过率变化的来源,论文按「SID→广告查找之后、广告级过滤之前的生成广告数」把请求分桶。
Table 3. 分桶的广告级通过率对比(Users = 该桶内的请求占比;Bitmask / Bloom / Final 为各级通过率)
| Method | Users | Bitmask | Bloom | Final |
|---|---|---|---|---|
| < 5k generated ads/user | ||||
| CD only | 50.78% | 57.72% | 36.09% | 20.83% |
| CD+GTM | 31.84% | 76.82% | 73.33% | 56.33% |
| Static k-way | 31.84% | 76.34% | 72.90% | 55.65% |
| Dynamic k-way | 31.84% | 76.09% | 73.44% | 55.88% |
| 5k–9.9k generated ads/user | ||||
| CD only | 36.72% | 54.91% | 39.92% | 21.92% |
| CD+GTM | 39.06% | 64.14% | 65.17% | 41.80% |
| Static k-way | 38.09% | 64.98% | 65.63% | 42.65% |
| Dynamic k-way | 38.87% | 64.58% | 64.88% | 41.90% |
| 10k+ generated ads/user | ||||
| CD only | 12.50% | 62.28% | 45.95% | 28.62% |
| CD+GTM | 29.10% | 56.02% | 63.46% | 35.55% |
| Static k-way | 30.08% | 55.44% | 63.29% | 35.09% |
| Dynamic k-way | 29.30% | 56.12% | 63.67% | 35.73% |
| All requests | ||||
| CD only | 100.00% | 57.81% | 40.74% | 23.55% |
| CD+GTM | 100.00% | 61.52% | 65.70% | 40.42% |
| Static k-way | 100.00% | 61.31% | 65.68% | 40.27% |
| Dynamic k-way | 100.00% | 61.58% | 65.69% | 40.45% |
分析(why,不只是 what):
- 主结论:全量请求上最终通过率从 23.55% → 40.42%(相对提升 71.6%)。这意味着同样一次解码,GRACE 生成的广告里有效比例几乎翻倍,下游排序拿到的合格候选显著变多。
- 收益主要来自 Bloom(位置)这一级:全量上 bitmask 通过率只从 57.81% 提到 61.52%(+3.7 pt),而 Bloom 通过率从 40.74% 暴涨到 65.70%(+25 pt)。这说明位置这类高基数定向是「先生成后过滤」范式下最大的漏斗损失点,也正是把约束下推进解码最值钱的地方。
- 收益在中低量桶最大:
< 5k桶 20.83% → 56.33%(2.7×),5k–9.9k桶 21.92% → 41.80%(1.9×),而10k+桶只有 28.62% → 35.55%(1.24×)。低量桶意味着该用户的合格广告本来就稀疏,CD-only 解码几乎是在随机撞;GTM 把 beam 直接引向稀疏的合格区域,边际收益最大。 - 一个必须注意的分布漂移:CD+GTM 把请求从
< 5k桶推到了更大的桶——< 5k占比从 50.78% 降到 31.84%,10k+占比从 12.50% 升到 29.10%。也就是说,解码期定向让精确过滤前的生成广告总量也变多了,因为 GTM 选中的 SID 与 CD-only 选中的 SID 根本不是同一批。这提醒读者:40.42% 这个数字既包含「通过率提高」也包含「生成分布改变」,两者叠加,不能简单等同于纯粹的过滤精度提升。 - k-way partitioning 是一个负结果:尽管 Table 2 显示 static k-way 把 matcher fill 压得很低、单个分区 matcher 更有选择性,最终通过率却没有实质提升(40.27% vs 40.42%,甚至略低)。论文给出的机制解释很关键:解码只要任一分区匹配就保留前缀,多个 matcher 的结果是被 union 起来的,选择性的收益在 union 处被抵消了。考虑到多分区带来的额外存储与 kernel 开销,未分区的 CD+GTM 才是首选工作点。这是一个诚实且有价值的负结果。
6.3 Kernel 级性能¶
Table 4. GH200 上的 cross-attention Q-reshape 基准(延迟单位 ms,$R=16\times1024$)
| Layout | Q | K, V | FA2 | FA3 |
|---|---|---|---|---|
| Before | [R, 16, 1, 128] | [R, 16, 128, 128] | 9.6 | 6.9 |
| After | [16, 16, 1024, 128] | [16, 16, 128, 128] | 0.097 | 0.101 |
| Speedup | – | – | 98.5× | 68.0× |
分析:这是全文单点收益最大的优化,而且纯粹是 layout 变换、零精度损失(Appendix B 已证明)。为什么能快两个数量级?因为 Before 布局把同一份 128-token 用户 context KV 物化了 16384 份副本,FA2/FA3 把它们当作 16384 个独立 batch 元素,无法跨 beam 复用同一份物理 KV;每次 KV tile 加载只摊到 1 个 query token 上,算术强度极低。After 让每次 KV tile 加载摊到 1024 条 beam query 上,直接把访存受限变成算力受限。
Table 5. GH200 上的 self-attention 微基准(P50 ms;Coalesced / Fused / Paged 括号内为相对 FA2 的加速比——该形状下 FA3 比 FA2 更慢。下半区为 $t=3$ 处的代表性 NCU 计数器,HBM(%) 为实测 HBM 带宽占峰值比例)
| t | FA2 | FA3 | Coalesced | Fused | Paged |
|---|---|---|---|---|---|
| 0 | 5.563 | 5.998 | 0.474 (11.7×) | 0.222 (25.1×) | 0.216 (25.8×) |
| 1 | 5.565 | 6.024 | 0.480 (11.6×) | 0.223 (25.0×) | 0.224 (24.9×) |
| 2 | 5.578 | 5.986 | 0.488 (11.4×) | 0.235 (23.8×) | 0.233 (24.0×) |
| 3 | 5.566 | 5.983 | 0.501 (11.1×) | 0.269 (20.7×) | 0.238 (23.4×) |
| TFLOP/s | 0.096 | 0.090 | 1.072 | 1.994 | 2.254 |
| HBM (%) | 2.38 | 2.22 | 29.36 | 75.52 | 84.46 |
| Instr. | 2.48B | 2.13B | 57.7M | 35.8M | 43.8M |
| Occ. (%) | 12.19 | 14.06 | 91.24 | 36.67 | 36.44 |
分析:NCU 计数器把机制讲得非常清楚。
- FA2 在 $t=3$ 执行 24.8 亿条指令却只跑出 2.38% 的 HBM 带宽、0.096 TFLOP/s——这是典型的「被 launch 与调度开销淹没的一堆微小 kernel」,算力和带宽两头都没用上。
- Coalesced 把指令数从 2.48B 砍到 57.7M(43×),occupancy 冲到 91.24%,说明合并 tile 直接解决了 occupancy 与访存事务粒度问题;但 HBM 带宽只到 29.36%,说明还有大量中间张量的读写没被消除。
- Fused 把指令数进一步降到 35.8M、HBM 带宽提到 75.52%,代价是 occupancy 掉到 36.67%(tile 更大、寄存器/共享内存压力更高,驻留 CTA 更少)——但这恰恰说明此时瓶颈已经从 occupancy 转移到了带宽,低 occupancy 不再是问题。
- Paged 在 $t=0$–$t=2$ 与 Fused 基本持平甚至互有胜负,真正的差距出现在 $t=3$(0.269 → 0.238 ms)。原因很直白:前缀越长,稠密实现要复制的历史 KV 越多,paged 的「只拷 block id」优势才显现。Paged 的指令数(43.8M)反而比 Fused(35.8M)更高——block table 间接寻址是有代价的——但它把 HBM 带宽推到 84.46%,净收益为正。
6.4 端到端延迟¶
Table 6. batch size 16 下的解码器端到端延迟(Full / Decoder 列为 P50/P99,单位 ms;Full 含 2.5 节全部运行时阶段,Decoder 只隔离解码循环)
| Case | Increment | Full | Decoder |
|---|---|---|---|
| $M_t = [1,1024,1024,1024]$,0.533 TFLOPs/request | |||
| L0 | Baseline FA2 | 214.8/220.1 | 196.7/197.7 |
| L1 | + cross-attn reshape | 86.5/87.9 | 69.3/69.4 |
| L2 | + self-attn opt. | 38.5/40.8 | 20.3/20.4 |
| L3 | + self-attn fusion | 39.3/45.2 | 20.4/20.5 |
| L4 | + paged KV cache | 34.3/40.5 | 17.8/17.8 |
| $M_t = [1,512,1024,1024]$,0.446 TFLOPs/request | |||
| D0 | L4 with dynamic beams | 34.9/35.8 | 15.5/15.8 |
| D1 | + CD + SID to Ads Lookup | 38.9/40.9 | 16.4/16.5 |
| D2 | + GTM bitmask | 41.4/45.0 | 16.6/16.8 |
| D3 | + GTM bitmask + Bloom | 51.0/53.6 | 25.0/27.3 |
分析:
- 收益排序:cross-attn reshape 是单步最大的贡献(解码器 P50 196.7 → 69.3 ms,占掉总收益的 71%),self-attn kernel 优化第二(69.3 → 20.3 ms),paged KV 第三(20.4 → 17.8 ms)。固定 beam 下解码器总加速 11.1×(197.7 → 17.8 ms P99)。
- L3(self-attn fusion)单看几乎没收益(Full P50 甚至从 38.5 涨到 39.3,P99 从 40.8 涨到 45.2;Decoder 20.3 → 20.4)。这与 Table 5 的微基准(Fused 明显快于 Coalesced)看似矛盾——说明在端到端路径里,此时瓶颈已不在自注意力 kernel 本身,融合省下的时间被别处吃掉了。融合的真正价值是为 L4 的 paged KV 铺路(融合 kernel 才能直接消费 block table)。
- 动态 beam(D0)几乎是免费午餐:算力从 0.533 降到 0.446 TFLOPs/request(-16.2%),解码器 P50 从 17.8 降到 15.5 ms(-12.9%),与算力降幅基本吻合,验证了「解码器算力近似线性于 beam size」的假设。
- GTM 的成本要分开看:加 CD + SID→广告查找(D1)只多 0.9 ms,加 bitmask GTM(D2)只多 0.2 ms——bitmask 匹配几乎免费;但加上 Bloom GTM(D3)解码器从 16.6 跳到 25.0 ms(+50.6%)、Full P99 从 45.0 跳到 53.6 ms。这是全文最大的一笔隐性代价:高基数属性的 ANY-of-many Bloom 扫描(每用户 64 个位置 × 4 个 int64)是 GTM 真正的算力税,而它恰恰又是效果收益最大的那一半(6.2 节 Bloom 通过率 +25 pt)。
- 仍在预算内:D3 的 Full P99 = 53.6 ms,落在攒批之后 70 ms 计算窗口内,还留有余量。
6.5 MFU 分析¶
论文用每请求模型 FLOPs、batch size 与批次平均解码器延迟计算解码器 MFU:
$$\text{MFU} = \frac{\text{FLOPs}_{\text{req}} \cdot B}{t_{\text{mean}} \cdot \text{peak}} \tag{15}$$
用 Table 6 的动态 beam FLOP 数(0.446 TFLOPs/request)与 GH200 Hopper GPU 的 BF16 峰值 989 TFLOP/s:D0 对应 46.6% 的解码器 MFU;带 GTM 匹配的那一行模型 FLOPs 完全相同,但在解码循环里加入了不计入 FLOPs 的 GTM 匹配工作,把解码器 MFU 拉低到 28.8%。配合 2.5 节的流水线设计,这个 compute-intensive 解码阶段在自己的 stream 上背靠背运行,能把低 MFU 阶段藏起来,同时主导整体加速器利用率。
这是一个诚实但值得警惕的指标:28.8% 的 MFU 不代表 GPU 空转,而是 GTM 的位运算/访存工作在 MFU 的分子里不被计入。换句话说,MFU 在「模型算力 + 索引匹配」混合负载上不再是一个好的效率代理指标。
7. 核心贡献总结¶
- 概念层面:第一次把「catalog validity(请求无关)」与「ads eligibility(请求相关、个性化)」明确切开,并论证后者必须在解码循环内部表达。这是一个此前被生成式推荐社区整体忽略的问题——大家都在做 tokenization、训练、对齐、召回质量,没人处理「生成出来的东西必须对这个具体请求合法」。
- 方法层面:GTM 用「trie 节点上的 subtree-union matcher + 保守测试 + 下游精确复核」这一套,把一个本质上是集合成员查询的问题塞进了 GPU 解码循环,且保证无漏(no false negative)——保守性只产生假阳性,不会误杀合格前缀,因此不损害召回上限。
- 系统层面:一整套针对「宽 beam、短序列、共享 encoder context」形状的解码器优化,其中 cross-attention beam-as-query 是零成本纯 layout 变换却带来 68–98.5× 加速,可迁移性极强——任何 beam search 解码 + encoder-decoder 的生成式检索系统都能直接抄。
- 工程层面:matcher 去重(2.6 GB → 390 MB)、CUDA graph 捕获整个定长解码循环、四阶段流水线 + C++ post 阶段绕开 GIL,都是真实上线才会遇到并解决的问题。
8. 与已归档相关工作的对比¶
ROCS ROCS: Request-Oriented Compute Sharing for Efficient Large-Scale Recommendation (Meta AI, 2026-07-30)¶
关系:独立并发(本文未引用 ROCS,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇论文攻击的是同一个 root cause——推荐推理中存在一批request 级、在所有下游对象(ROCS 的候选 / GRACE 的 beam)上完全相同的张量,而朴素实现会把它物化 $N$ 份,让 GPU kernel 把它们当作彼此独立的 batch 元素处理。ROCS 的说法是「request 侧特征在 N 个候选上完全相同,却被重复计算 N 次」;GRACE 的说法是「$M$ 条 beam 有不同 query 但 attend 同一份用户 context KV,通用 SDPA 布局完全错过了 beam search 结构」。
- 相近的技术骨架:两者都落到同一个 kernel 层动作上——让 request 侧张量保持在自己的自然 batch size,在消费它的 attention kernel 内部解析 request→下游的映射,从而不物化 broadcast。ROCS 的 IKBO 开发了「直接消费 $B_r$ 尺寸的 $K,V$ 加一个映射 $\mathbf{m}$」的特化 FlashAttention kernel;GRACE 的 beam-as-query 则把 $K,V$ 留在 $\mathbb{R}^{B\times H\times T_{\text{ctx}}\times d_h}$、只置换 $Q$ 成 $\mathbb{R}^{B\times H\times M\times d_h}$。ROCS 精读里那句诊断几乎可以逐字搬到 GRACE 上:「被物化的副本占据不同的内存地址,FlashAttention 因而把它们当作独立 batch 元素,无法跨候选复用同一份物理 K/V 数据」。
- 本文的差异与推进:ROCS 需要改模型结构才能暴露可复用的 request 子图(Generalized Layer Masking 的块下三角约束、Deep Cross Attention 的 request-only 序列编码器),因此付出了「候选不能影响 request 侧」的建模代价,并要用 RRR 把省下的算力回投才能保住质量;GRACE 则不需要动模型一根汗毛——beam search 的 encoder-decoder 结构天然保证了 cross-attention KV 跨 beam 相同,所以 beam-as-query 是一次纯 layout 变换(Appendix B 给了逐元素的等价性证明),零质量损失、零训练成本。反过来说,GRACE 的适用面也窄得多:它只在「共享 encoder context + 宽 beam」这一种形状上成立,而 ROCS 的算子级契约在复合下封闭,能覆盖任意深度的排序网络。
- 可比的方法 / 实验差异:ROCS 报告特化 attention kernel 把延迟从 0.55 ms 降到 0.23 ms(约 2.4×)、LCB kernel 延迟 -75.2%、生产 replay QPS +47%–196%;GRACE 报告 cross-attention 从 6.9/9.6 ms 降到 0.097–0.101 ms(68.0×/98.5×)。加速比差两个数量级不代表 GRACE 的 kernel 更强,而是两者的 baseline 浪费程度完全不同:ROCS 的候选侧 query 有 32 个 token,KV tile 尚能摊到一定 query 量上;GRACE 的 baseline 是 16384 个单 query注意力,摊销分母是 1,浪费到了极致。另一处有意思的分工:ROCS 用 TLX 写 persistent、warp-specialized kernel,而 GRACE 只把 TLX 列为 future work(§7 明确提到 Guan et al., 2026)——同公司、几乎同时期,一个已经用上、一个还在计划,说明这套工具链正在 Meta 内部横向扩散。
UniVA UniVA: Unified Value Alignment for Generative Recommendation in Industrial Advertising (Tencent, 2026-05-07)¶
关系:独立并发(本文未引用 UniVA,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇都在处理「广告生成式推荐的解码器只被 likelihood 主导,而广告业务侧的硬/软约束进不去解码循环」这一 root cause。UniVA 把它叫做 Value Inconsistency 的第三层——「value-unaware online serving:线上 beam 扩张仍依赖语义相似度和启发式过滤,在 full SID space 上 expand 还会浪费大量算力到违反库存/定向的非法候选上,传统补丁是再加一个外置 value ranking 模块」。这句话与 GRACE 引言里「post-generation filter 会让大量生成广告在进入下游排序前就被丢弃」指的是同一件事。
- 相近的技术骨架:两者的服务侧解法抽象后是同一张流程图——「在全局 SID trie 之上,按当前请求施加一层过滤,把 beam 扩张限制在请求合法的 SID 路径内」。UniVA 的 Personalized Trie 写作 $\mathcal{T}_u=\Gamma(u)(\mathcal{T})$,合法 next-token 集为 $\mathcal{V}(s_{<l};\mathcal{T}_u)$,明确说「把定向、库存、创意规则应用到全局 trie 得到个性化子树」;GRACE 的 GTM 写作 $\mathbf{TM}_t[v]=\text{match}(u, p\|v)$,两者在数学形式上几乎一一对应。
- 本文的差异与推进:差别全在「个性化子树怎么落地」上。UniVA 把 $\Gamma(u)$ 当作一个抽象算子一笔带过,没有回答「30M SID 的全局 trie 怎么可能对每个请求实时物化出一棵个性化子树」这个真正的工程难题;GRACE 的全部技术含量恰恰在这里——不物化子树,而是在 trie 节点上预存 subtree-union 的 bitmask/Bloom matcher,把「子树里是否还有合格广告」这个存在性查询压缩成常数时间的位运算,再用去重(2.6 GB → 390 MB)、CSR 布局、CUDA kernel 内共享内存 staging + early exit 把它塞进解码循环,代价只有 D2 的 +0.2 ms(bitmask)与 D3 的 +8.4 ms(Bloom)。反过来,UniVA 覆盖了 GRACE 完全没碰的另一半:商业价值对齐(Commercial SID、dual-head generation-as-ranking、eCPM-aware RL、value-guided beam scoring)。GRACE 的 GTM 只管「合不合法」这个 0/1 硬约束,对「哪条合法广告更值钱」毫无表达;UniVA 则把 value 做成融合 logits 参与 token 级竞争。两者严格互补:把 UniVA 的 fused value logits 接到 GRACE 的 GTM kernel 之后、beam top-k 之前,就是一套完整的广告 GR 解码器。
- 可比的方法 / 实验差异:UniVA 报告 offline HR@100 +37.04%、online GMV +1.50%(腾讯微信视频号),是效果与商业指标;GRACE 报告的是通过率 23.55%→40.42% 与延迟 197.7→17.8 ms,是合规率与系统指标,且完全没有线上 A/B 或收入数据。这个差异本身很说明问题:UniVA 证明了「把业务信号放进解码有商业价值」,GRACE 证明了「把请求级合规放进解码在工程上可行且不破延迟预算」,但没有任何一方证明「GTM 带来的通过率提升最终转化成了多少收入」——这正是 GRACE 最明显的评估缺口。
DaV-Gen DaV-Gen: End-to-End Generative Retrieval via Draft-and-Verify (Alibaba, 2026-07-09)¶
关系:独立并发(本文未引用 DaV-Gen,两者殊途同归)· 已加载对方精读
- 共同关注的问题:自回归 SID 解码的串行延迟是生成式检索上线的首要障碍。DaV-Gen 的表述是「AR 逐 token 解码带来了难以承受的推理延迟」,GRACE 的表述是「实时广告检索需要每请求生成数千条广告,同时满足严格延迟与算力成本要求」——同一个 root cause 的两种说法。
- 相近的技术骨架:两者都独立发现了同一个关键优化点:请求侧上下文的 KV 只算一次、在所有下游对象间共享。DaV-Gen 的 Broadcasted Prefix Caching 把上下文 $H_u$ 的 KV 计算一次并广播成所有 $N$ 个候选共享的内存前缀,把上下文编码复杂度从 $O(N\cdot|H_u|)$ 降到 $O(|H_u|)$;GRACE 的 cross-attention KV「每请求算一次、该请求所有 beam 在整个解码过程中共享」是完全同构的设计。
- 本文的差异与推进:分歧点在于要不要保留自回归。DaV-Gen 选择放弃 beam search:用 ANN 向量检索「起草」定长候选集,再用一次并行前向「验证」,把 $O(L)$ 的串行复杂度换成 $O(1)$ 的并行打分,附带收获了对结果列表长度的确定性控制;代价是必须重新设计表示(Hybrid Sparse-Dense)、重新设计训练(对比 + 生成 + pairwise 复合损失把起草与验证的目标对齐),是一次模型层重构。GRACE 选择保留 beam search 不动,纯粹从 kernel、KV 布局、beam size 调度上榨性能,是一次系统层重构。有意思的是二者的终点数字很接近:DaV-Gen 把视频搜索延迟压到 ~70 ms(相对级联 2.5×),GRACE 的 Full P99 是 53.6 ms——说明「换范式」与「不换范式只优化实现」在这个量级上可以到达同一个终点,而后者不需要重训模型、不改变召回质量分布,工程风险低得多。
- 可比的方法 / 实验差异:DaV-Gen 有线上 A/B(+2.09% Avg Time Spent)与质量指标,能证明范式切换不损害效果;GRACE 只有系统指标,从头到尾没有报告过 GTM 是否改变了检索质量(Recall/NDCG 或任何相关性度量)。考虑到 GTM 会把 beam 主动引向「合格但可能次优」的 SID 前缀(Table 3 显示生成广告的分布确实被显著改变了),这个缺失是实质性的。另外 DaV-Gen 的 draft-and-verify 范式与 GTM 并不冲突:ANN 起草阶段同样需要施加定向规则,GRACE 的 bitmask/Bloom matcher 完全可以下沉到向量索引的过滤条件里——这是一条两篇论文都没走的合并路线。
9. 讨论与局限性¶
9.1 值得借鉴的设计¶
- 「保守测试 + 下游精确复核」是把复杂业务规则塞进 GPU 解码循环的通用范式。GTM 之所以敢在 trie 节点上存 OR 并集,是因为保守性只产生假阳性、不产生假阴性——不会误杀任何合格前缀,因此不损害召回上限;假阳性由下游 CPU 精确 matcher 兜底。任何「规则复杂、精确判定昂贵、但存在廉价保守上界」的约束(预算、库存、频控、黑名单)都能套这个模式。
- beam-as-query 布局是所有 encoder-decoder 生成式检索系统的免费午餐。它不需要改模型、不需要改训练、有严格的等价性证明,收益却是 68–98.5×。任何跑 beam search 的 SID 生成系统(TIGER/OneRec/PLUM 谱系)都应该先检查自己的 cross-attention 是不是在物化 $BM$ 份请求 KV。
- matcher 去重是被低估的一步:2.6 GB → 390 MB,本质上利用了「p50=1 ads/SID」的长尾结构。工业索引里这类「大量条目共享同一份属性行」的结构极其常见。
- 诚实报告负结果:k-way partitioning 花了整整两节篇幅描述(static/dynamic 两种变体、fill rate 定义、构建算法),最后实验结论是不值得用,并给出了机制解释(多分区结果被 union 抵消)。这在工业论文里不多见。
9.2 局限与争议¶
- 完全没有线上 A/B 与业务指标。全文最强的效果数字是「广告级定向通过率 23.55% → 40.42%」,但通过率是一个中间代理指标,没有任何证据说明它转化成了广告收入、填充率或用户体验的改善。对一篇 Meta 的广告系统论文,这个缺失很突兀。
- 没有任何检索质量评估。GTM 主动改变了 beam 的搜索轨迹(Table 3 显示生成广告量的分布被显著推高),但论文从未报告 Recall@K / NDCG 或任何相关性指标,也没有讨论「被 GTM 掩掉的高分 SID 里是否有更相关的广告」。理论上 GTM 只是把注定要被下游丢弃的候选提前剪掉,不应损害最终质量;但这需要实验证明,而不是论证。
- 通过率提升的归因不干净。CD+GTM 相对 CD only 不仅通过率变了,生成广告的分布也变了(
<5k桶占比 50.78%→31.84%)。40.42% 这个全量数字是在一个已经漂移的请求分布上算出来的,与 23.55% 并非严格同条件对比。分桶表提供了一定的透明度,但论文没有做「固定生成量」的受控对比。 - 位置数据是合成的。过滤研究用的是「每用户 64 个随机位置」的合成用户位置数据。Bloom matcher 的效果与代价高度依赖用户位置的数量与分布(ANY-of-many 的外层扫描长度就是位置数),随机合成显然无法反映真实地理分布的聚集性,Bloom 通过率 +25 pt 与 D3 的 +8.4 ms 延迟都建立在这个合成假设上。
- Bloom GTM 的延迟代价没有被充分讨论。D2→D3 解码器延迟 +50.6%(16.6 → 25.0 ms),解码器 MFU 从 46.6% 掉到 28.8%。论文用「仍在预算内」轻轻带过,但这意味着未来加入更多高基数约束时余量会迅速耗尽——而 §7 的 future work 恰恰就是「加更多类别的 bitmask 与 Bloom 约束」。这条扩展路径与延迟预算之间存在直接张力。
- 模型侧零新意,可迁移性受限于形状假设。GRACE 不提出任何新模型,全部贡献在系统侧。而系统侧优化又强依赖具体形状:$L_{\text{SID}}=4$、$|\mathcal{V}|=512$、3 层 decoder、$T_{\text{ctx}}=128$、$B=16$。一旦 SID 变长(如变长 SID 方案)、词表变大、或换成 decoder-only LLM 骨干,coalesced 短序列 kernel 与动态 beam 调度的收益都需要重新评估——论文自己在 §7 也承认「把 GRACE 扩展到 LLM-based 生成式推荐器」是一个尚未解决的长期方向。
- 不可复现。30M-SID 索引、模型评测数据集、InterFormer 式 encoder 全部是 Meta 内部资产,没有公开数据集实验,也没有开源 kernel。学界只能借鉴思想,无法验证数字。
9.3 与已有工作的定位¶
GRACE 明确把自己定位为与 TIGER / LC-Rec / PLUM / OneRec 这条「tokenization + 训练 + 对齐 + 召回质量」主线互补的服务侧工作,并把 STATIC 作为直接前置:STATIC 解决了 catalog validity(请求无关),GRACE 补上了 ads eligibility(请求相关)。相对 FlashAttention / FlashInfer / vLLM 这条通用推理优化主线,GRACE 的差异在于工作负载形状——宽 beam、短序列、共享 encoder context、外加解码期 CD+GTM 匹配,这四条组合在通用 LLM 服务里都不存在,因此通用 kernel 在这里的表现(FA2 只跑出 2.38% HBM 带宽)差到了触目惊心的地步。这篇论文最持久的价值,可能是它用 NCU 计数器把「通用 kernel 在推荐系统解码形状上到底浪费了多少」这件事量化了出来。