GateDiffInt:用「转化任务」把序列去噪和意图抽取绑到同一个目标上
小红书(Xiaohongshu Inc.)+ 复旦大学,2026-08-19,arXiv 2608.18764,cs.IR。代码:https://github.com/chen667/GateDiffInt
研究动机与背景
CVR 序列里纠缠着两样东西
转化率(CVR)预估吃的是用户在信息流里产生的行为序列,而这种序列天生混着两类成分:
- 噪声:随机浏览、误点击、从众性交互;
- 意图:在多个时间尺度上并行演化的需求——稳定的长期偏好、被事件触发的短期需求、反复比价却不下单的潜在意图,以及临门一脚的转化意图。
现有工作大多把「去噪」和「意图抽取」当成两个可以分开处理的子问题:一条线直接从含噪序列里抽意图,指望噪声被越来越强的 encoder 隐式吸收掉;另一条线在通用重建目标下把序列洗干净,把意图丢给下游任务。论文指出,两条线都漏掉了一个更本质的性质:在 CVR 序列里,噪声和意图不是独立的,而是互相强化的——噪声持续稀释、扭曲真实意图;而缺少结构化的意图先验,去噪就没有任何判据来区分「信息量弱但重要的信号」和「可丢弃的噪声」。
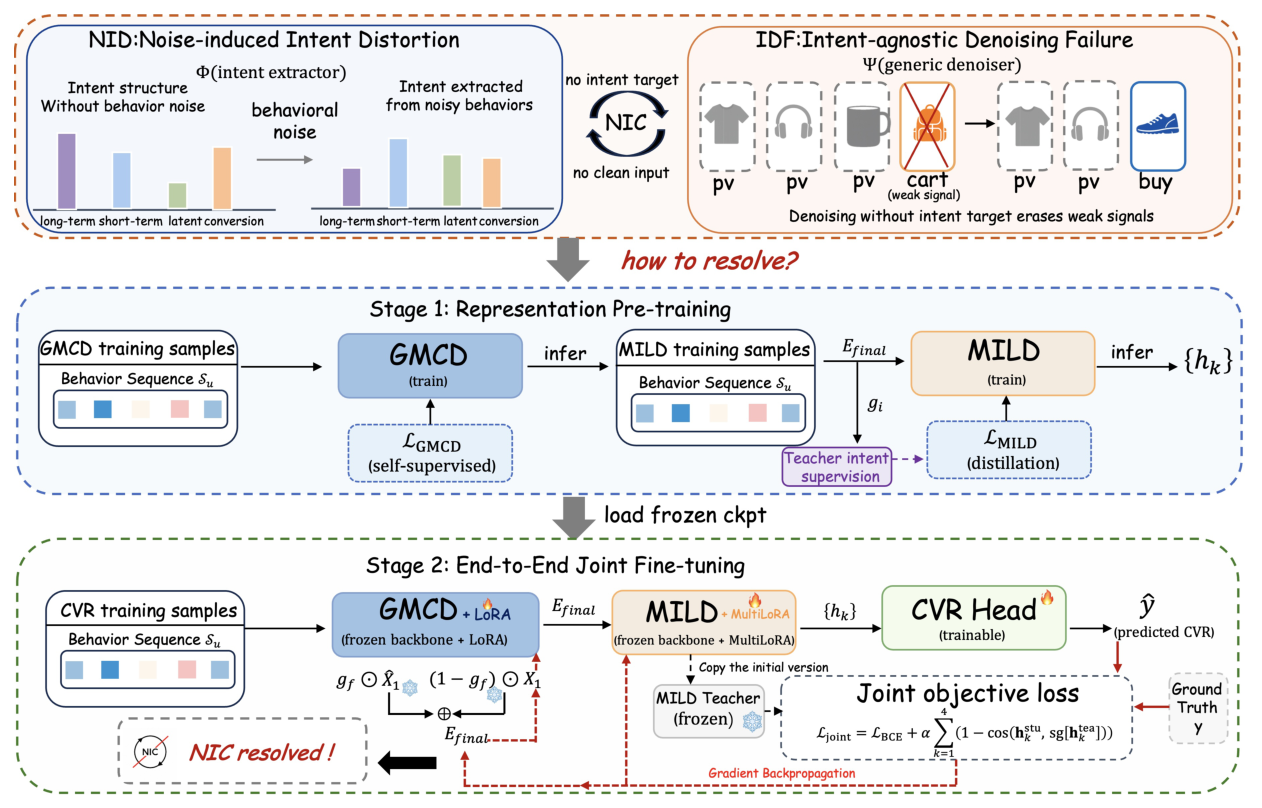
作者把这个现象命名为 Noise–Intent Coupling(NIC,噪声–意图耦合)。一句话直觉:没有干净输入的意图抽取没有原料,没有意图目标的去噪没有靶心。
NIC 的形式化与两个可测子现象
论文给 NIC 一个刻意轻量、不假设任何具体噪声生成模型的形式化:设 $I^\star$ 是用户潜在的意图结构,把观测序列概念性地分解为 $S = S^\star \oplus N$(真信号 $S^\star$ 加噪声成分 $N$),$\Phi$ 与 $\Psi$ 分别是意图抽取器和去噪器。NIC 表现为 $\Phi$ 与 $\Psi$ 的互相条件性劣化,可以拆成两个能分别测量的子现象:
- NID(Noise-induced Intent Distortion,噪声诱导的意图扭曲):随着 $N$ 增大,无论是基于注意力的还是基于 LLM 的抽取器,$\Phi(S)$ 都会系统性地漂向高频但浅层的信号,偏离 $I^\star$——短期意图和潜在意图占据主导,而稳定的长期偏好被稀释。
- IDF(Intent-agnostic Denoising Failure,意图无关的去噪失败):主流扩散式推荐器按设计优化的是通用重建目标,不以 $I^\star$ 为条件,因此没有「该保留什么」的判据:一个弱但有信息量的信号(例如很早之前的一次比价加购)可能被和无意义的浏览一起抹平;反过来,系统性噪声也可能被保留下来。
从 NID/IDF 视角重看已有工作
作者用这两把尺子把相关工作重新排了一遍,结论是每条线只关掉了闭环的一端:
- 序列 / 多兴趣模型(DIN、DIEN、DSIN、BST、HSTU、MIND、ComiRec、DMIN 等)用注意力或多向量增强原始序列的表征,直面 NID,但它们全部直接作用在原始含噪序列上,隐含假设「噪声可以被 encoder 吸收」,且其兴趣是在共现层面涌现的,没有对齐到任何语义结构;
- 扩散式推荐器(DiffRec、DiffuRec 及其引导式、课程式、条件式变体)在通用重建目标下去噪,直面 IDF,但前向加噪和重建目标基本是位置无关的,缺乏与行为重要性、意图结构对齐的细粒度控制;
- LLM 增强的推荐器(TALLRec、P5、LLaRA 等)注入了更强的语义先验,但仍然消费未净化的原始序列,且主流做法瞄准生成式推荐或事后解释,在线延迟高,也很少直接产出排序模型可消费的结构化意图;
- 扩散–多兴趣混合工作(DiffuMIN [22]、InDiRec [36])虽然两边都碰到了,但只是用单次前向把「先去噪、再抽意图」串起来,缺少让两者互相纠正的双向中介。
没有任何已有框架提供一个任务接地(task-grounded)的共享信号,让去噪和意图抽取朝最终目标互相塑形。 这就是 GateDiffInt 的切入点。
核心方法 / 模型架构
问题定义
设 $\mathcal{U}$、$\mathcal{V}$、$\mathcal{A}$ 分别是用户、物品、交互类型集合。对每个用户 $u$,取最近 $L$ 次交互按时序构成行为序列
$$S_u = \big\{(i_\ell, a_\ell, \Delta t_\ell)\big\}_{\ell=1}^{L}, \tag{1}$$
其中 $i_\ell \in \mathcal{V}$ 是物品,$a_\ell \in \mathcal{A}$ 是行为类型,$\Delta t_\ell \in \mathbb{R}_{\ge 0}$ 是该行为距当前时刻的时间间隔;不足 $L$ 的序列做左填充。给定候选物品 $v_{\mathrm{tgt}}$,CVR 预估估计购买概率
$$\hat{y} = f_\Theta\big(S_u, v_{\mathrm{tgt}}, u\big) \in [0, 1], \tag{2}$$
用 $\hat y$ 与真值 $y \in \{0,1\}$ 的二元交叉熵优化。
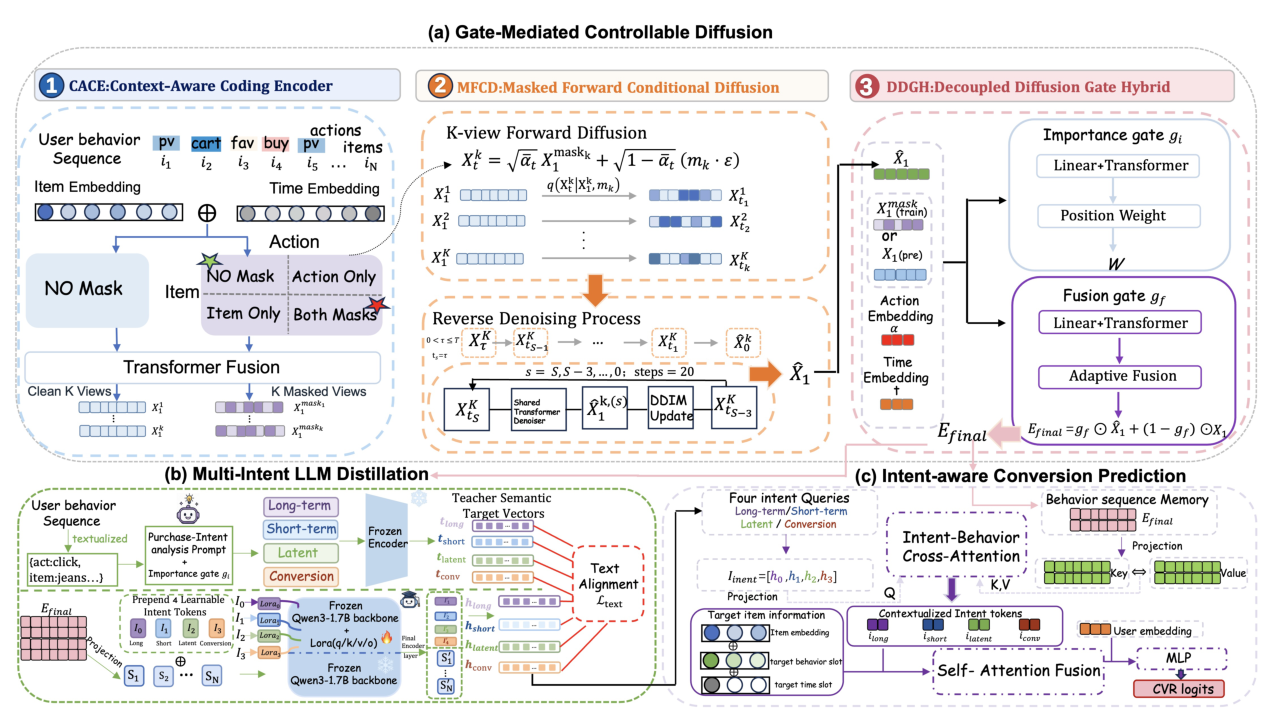
GateDiffInt 由三个协作模块组成,整体数据流是 $S_u \rightarrow (E_{\mathrm{final}}, g_i) \rightarrow \{h_k\} \rightarrow \hat y$。
(a) GMCD:Gate-Mediated Controllable Diffusion
出发点:用户行为序列可以看成真实偏好的含噪观测——浅层行为(如 pv)噪声重,深层行为(如 buy)虽稀疏但信号强。 GMCD 在隐空间里做可控去噪,输出位置对齐的融合表征 $E_{\mathrm{final}} \in \mathbb{R}^{L \times d}$ 作为下游 MILD 的主序列表征,同时额外吐出一个可解释的重要性信号 $g_i$ 供 MILD 的 teacher 参考。三个级联子模块:
CACE:Context-Aware Coding Encoder
对每个位置 $\ell$,把 item embedding 和时间 embedding 线性投影后,与一个可学习的 fusion token 拼接,送入一个位置内共享的 Transformer——注意它只在位置内部做注意力,从不跨位置,从而把「特征融合」和「序列建模」解耦。输出为融合表征 $z_\ell$,干净视图为
$$X_1 = [z_1, \dots, z_L] \in \mathbb{R}^{L \times d}. \tag{3}$$
对每个非填充位置,CACE 独立采样两种 Bernoulli 掩码:用于 item 级重建的 item mask,以及由行为可靠性决定的 action mask——浅层行为(pv)掩码概率高,强行为(buy)掩码概率低:
$$M^{\mathrm{item}}_\ell \sim \mathrm{Bernoulli}(p_{\mathrm{item}}), \qquad M^{\mathrm{act}}_\ell \sim \mathrm{Bernoulli}\big(\pi[a_\ell]\big). \tag{4}$$
被掩物品替换成可学习的 <MASK> token 后重新编码(保留时间信息),得到掩码视图 $X^{\mathrm{mask}}_1$。填充位置永不被掩;两种掩码共同决定后续前向扩散的逐位置噪声强度。训练时每条序列采 $K=2$ 个掩码视图;推理时不加掩码,直接用 $X_1$ 作为反向采样起点。
MFCD:Masked Forward Conditional Diffusion
MFCD 在 CACE 的隐空间里跑扩散,训练与推理共享同一个去噪网络 $f_\theta$。采用 DDPM 参数化 + cosine schedule,并以 $X_1$ 为重建目标,每个掩码视图按下式加噪:
$$X^k_t = \sqrt{\bar\alpha_t}\, X^{\mathrm{mask}_k}_1 + \sqrt{1-\bar\alpha_t}\cdot\big(m_k(\ell)\,\varepsilon\big), \qquad \varepsilon \sim \mathcal{N}(0, I), \tag{5}$$
其中噪声乘子 $m_k(\ell)$ 由位置 $\ell$ 的掩码状态决定(无掩码取基线值,双掩码最强),所以被掩越多的位置吃到越强的噪声。这正是「可控」二字的落点:噪声注入不再是位置无关的,而是被行为可靠性调制的。
时间步与位置条件化的 $f_\theta$ 直接预测 $x_0$,给出重建损失
$$\mathcal{L}_{\mathrm{denoise}} = \frac{1}{K}\sum_{k=1}^{K}\big\|\hat X^k_1 - \mathrm{sg}[X_1]\big\|_2^2. \tag{6}$$
另加一个作用在两个掩码视图去噪输出之上的 InfoNCE 正则,增强序列级判别性:
$$\mathcal{L}_{\mathrm{cl}} = -\frac{1}{K(K-1)B}\sum_{b=1}^{B}\sum_{\substack{p,q=1 \\ p \neq q}}^{K} \log \frac{\exp\big(\mathrm{sim}(z^{(p)}_b, z^{(q)}_b)/\tau\big)}{\sum_{b'=1}^{B}\exp\big(\mathrm{sim}(z^{(p)}_b, z^{(q)}_{b'})/\tau\big)}, \tag{7}$$
其中 $z^{(k)} = \phi(\mathrm{Pool}(\hat X^k_1))$,$\mathrm{sim}$ 为余弦相似度。
推理时不从纯噪声起步,而是从中间步 $s = \lfloor \rho T \rfloor$ 开始(partial-start):
$$X_s = \sqrt{\bar\alpha_s}\, X_1 + \sqrt{1-\bar\alpha_s}\,\varepsilon, \tag{8}$$
然后沿 $t_1 > t_2 > \cdots > t_{K'} = 0$($t_1 = s$)做确定性 DDIM 更新($\eta = 0$):
$$\hat\varepsilon_{t_i} = \frac{X_{t_i} - \sqrt{\bar\alpha_{t_i}}\,\hat X^{(t_i)}_1}{\sqrt{1-\bar\alpha_{t_i}}}, \qquad X_{t_{i+1}} = \sqrt{\bar\alpha_{t_{i+1}}}\,\hat X^{(t_i)}_1 + \sqrt{1-\bar\alpha_{t_{i+1}}}\,\hat\varepsilon_{t_i}. \tag{9}$$
实现上前向从 1 到 1000 均匀采样时间步,反向从 timestep 700 起步、共 20 步 DDIM(Figure 2 中标注为 $s = S, S-3, \dots, 0$)。「确定性 + 部分起步 + 20 步」这三件事都是为在线延迟服务的:既避免了随机采样的方差,也把反向过程的算力压到可接受范围。
DDGH:Decoupled Diffusion Gate Hybrid
DDGH 用两个架构相同但参数独立的门把 $\hat X_1$ 和 $X_1$ 融合起来。把 $[\hat X_1; X^{\mathrm{mask}}_1; e_a; e_t]$ 拼接后过一个轻量 Transformer 产生门值:
$$g = \sigma\Big(\mathrm{MLP}\big(\mathrm{Trans}_{\mathrm{gate}}([\hat X_1; X^{\mathrm{mask}}_1; e_a; e_t])\big)\Big) \in [0,1]^L. \tag{10}$$
融合门 $g_f$ 做逐位置加权融合:
$$E_{\mathrm{final}} = g_f \odot \hat X_1 + (1-g_f) \odot X_1. \tag{11}$$
重要性门 $g_i$ 不参与融合,它只产出一个可解释的位置重要性信号交给下游 MILD 的 teacher 当参考——这是全文最巧的一处结构设计:它把「去噪器学到的什么位置可信」显式外化成一个可被意图抽取器消费的信号,从而搭起 $\Psi \rightarrow \Phi$ 的第一条通道。
两个门都用自生成目标做 BCE 监督。记逐位置去噪误差 $u_\ell = \|\hat X_{1,\ell} - X_{1,\ell}\|_2^2 / d$,序列内归一化后记作 $\tilde u$;$g_f$ 用 $1-\tilde u$ 监督,$g_i$ 则进一步混入行为先验 $b_\ell$($\lambda$ 平衡先验与重建误差):
$$t^{(i)}_\ell = \mathrm{clip}\big(\lambda b_\ell + (1-\lambda)\tilde u_\ell,\ [t_{\min}, t_{\max}]\big), \tag{12}$$
$$\mathcal{L}_{\mathrm{fusion}} = \mathrm{BCE}\big(g_f,\ \mathrm{sg}[1-\tilde u]\big), \qquad \mathcal{L}_{\mathrm{imp}} = \mathrm{BCE}\big(g_i,\ \mathrm{sg}[t^{(i)}]\big). \tag{13}$$
GMCD 的总目标:
$$\mathcal{L}_{\mathrm{GMCD}} = \mathcal{L}_{\mathrm{denoise}} + \lambda_{\mathrm{cl}}\mathcal{L}_{\mathrm{cl}} + \lambda_f \mathcal{L}_{\mathrm{fusion}} + \lambda_i \mathcal{L}_{\mathrm{imp}}. \tag{14}$$
(b) MILD:Multi-Intent LLM Distillation
四类意图的心理学依据
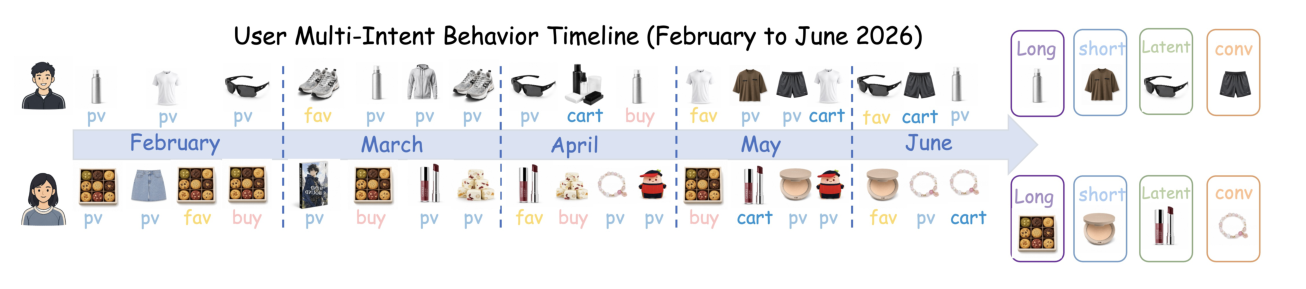
论文没有拍脑袋定意图数量,而是引用 Goal Systems Theory(Kruglanski 等)及后续消费者行为研究,区分四类意图:
- 长期意图(long-term):根植于身份认同与生活方式,跨情境稳定;
- 短期意图(short-term):由事件或状态变化在明确时间窗内触发;
- 潜在意图(latent):表现为反复浏览与比较但不转化;
- 转化意图(conversion):给定既有信号与当前上下文,最可能立刻发生的购买决策。
教师侧
MILD 用一个冻结的 Gemini 3.5 Flash(API 调用)作为 teacher,从用户行为序列生成四类意图的文本描述作为语义监督。GMCD 的重要性信号 $g_i$ 会和序列一起喂给 teacher 作为位置重要性提示,让 teacher 在生成描述时更关注可靠行为——这就是前面说的 $\Psi \rightarrow \Phi$ 通道的实际落地方式。
学生侧
学生是冻结的 Qwen3-1.7B 骨干 + per-intent LoRA 路由;teacher 文本由 Qwen3-Embedding-8B 编码进语义空间作为对齐目标。
具体地,$K=4$ 个可学习的 intent token $\{I_0,\dots,I_{K-1}\}$ 被前置,$E_{\mathrm{final}}$ 投影进 LLM 隐空间后拼接:
$$H^{(0)} = \big[I_0, \dots, I_{K-1},\ \mathrm{Proj}(E_{\mathrm{final}})\big], \tag{15}$$
其中 $\mathrm{Proj}$ 把维度 $d$ 映射到 $d_{\mathrm{LLM}}$。这里有一套精心设计的 2D 注意力掩码:
- 每个 intent token 只能看到自己和全部行为位置;
- intent token 之间互相不可见(防止四个头塌缩成一个意图);
- 行为位置遵循因果掩码,且不能注意到任何 intent token(保证行为侧表征不被意图查询污染)。
适配时 LoRA 只注入 $\{q,k,v,o\}$ 投影;第 $k$ 个 intent token 只激活第 $k$ 条独立的 LoRA 路径,行为 token 不接受任何 LoRA 更新。取前 $K$ 个位置的 hidden state 作为意图向量:
$$[h_{\mathrm{long}}, h_{\mathrm{short}}, h_{\mathrm{latent}}, h_{\mathrm{conv}}] = \mathrm{Backbone}\big(H^{(0)}, M\big)[:, :K, :]. \tag{16}$$
teacher 描述经 Qwen3-Embedding-8B 编码为目标 $t^{\mathrm{tea}}_{b,k}$;学生意图经投影头 $\mathrm{Head}(\cdot)$ 映射到 teacher 嵌入空间,用带掩码的余弦距离对齐:
$$\mathcal{L}_{\mathrm{MILD}} = \frac{1}{\sum_{b,k} m_{b,k}} \sum_{b,k} m_{b,k}\Big(1 - \cos\big(\mathrm{Head}(h_{b,k}),\ t^{\mathrm{tea}}_{b,k}\big)\Big), \tag{17}$$
其中 $m_{b,k} \in \{0,1\}$ 标识该 (样本, 意图类别) 上是否有有效监督,无监督位置被排除在损失之外(teacher 并不总能对四类意图都给出有效描述)。
这套设计的工程动机很明确:把 LLM 摆在离线 teacher 的位置,通过蒸馏得到轻量 student,既注入 LLM 的世界知识先验,又满足工业排序的在线延迟约束——这与直接把 LLM 当推荐器的范式(TALLRec / P5 / LLaRA)是本质不同的。
(c) Intent-aware Conversion Prediction
给定 $E_{\mathrm{final}}$ 和四个意图向量 $\{h_k\}_{k=1}^{4}$,本模块把它们与候选物品信息融合产出 $\hat y$。
以意图为 query、行为序列为 key/value 做 cross-attention。序列侧把 $E_{\mathrm{final}}$ 与行为 embedding 拼接后归一化;意图侧经线性变换 + 非线性激活得到 query,再走多头交叉注意力得到上下文化意图:
$$e^{\mathrm{new}}_\ell = \mathrm{LN}\big([W_e E_{\mathrm{final},\ell};\ e^{\mathrm{beh}}_\ell]\big), \tag{18}$$
$$\mathbf{i} = \mathrm{LN}\big(\phi(W_i \mathbf{h})\big), \tag{19}$$
$$\mathbf{i}^{\mathrm{out}} = \mathrm{LN}\Big(\mathbf{i} + \mathrm{CrossAttn}(Q=\mathbf{i},\ K=V=e^{\mathrm{new}})\Big). \tag{20}$$
上下文化意图 $\{\mathbf{i}^{\mathrm{out}}_k\}_{k=1}^{4}$ 与候选物品特征拼接后过自注意力得到融合表征 $T_{\mathrm{out}}$,再与用户 embedding 一起送入 MLP:
$$\hat y = \sigma\Big(\mathrm{MLP}\big([\mathrm{flatten}(T_{\mathrm{out}});\ e^{\mathrm{user}}]\big)\Big), \tag{21}$$
以 $\mathcal{L}_{\mathrm{BCE}}$ 优化。
两阶段优化:NIC 到底是怎么被「解开」的
这是全文的方法论核心,值得单独讲清楚。
Stage 1(表征预训练):GMCD 与 MILD 分开预训练。GMCD 在行为重要性差异化的掩码与前向噪声驱动下,学会保留可靠信号、抑制噪声(缓解 IDF);MILD 则在已增强的表征之上蒸馏四类结构化意图(缓解 NID)。注意顺序:MILD 的训练样本是 GMCD 推理出来的 $E_{\mathrm{final}}$ 和 $g_i$,而不是原始序列。
Stage 2(端到端联合微调):加载冻结 checkpoint,挂上 CVR head 联合微调。此时——
- GMCD 主干冻结,只在 encoder 的 fusion Transformer 里注入低秩 LoRA;
- MILD 保留 per-intent MultiLoRA;
- CVR head 完全可训练;
- 为保住蒸馏得到的意图几何结构,引入 teacher-anchoring 正则:
$$\mathcal{L}_{\mathrm{joint}} = \mathcal{L}_{\mathrm{BCE}} + \alpha \sum_{k=1}^{4}\Big(1 - \cos\big(h^{\mathrm{stu}}_k,\ \mathrm{sg}[h^{\mathrm{tea}}_k]\big)\Big), \tag{22}$$
其中 $h^{\mathrm{tea}}_k$ 来自第一阶段结束后 MILD 的冻结副本,$\alpha$ 为平衡系数。
有一个梯度路径的细节很关键:由于 DDIM 反向采样不传梯度、且融合门在此阶段被冻结,CVR 梯度只能通过 $(1-g_f) \odot X_1$ 这一支到达 encoder 的 LoRA。也就是说,任务信号是沿着「未被去噪替换掉的那部分原始表征」回流的,这既保证了微调足够轻量、不破坏预训练的去噪能力,也让 encoder 能够在保持重建/增强能力的前提下进一步下调不重要位置的权重。
于是闭环成立:转化任务的监督信号同时精修序列编码与意图抽取,让 $\Phi$ 和 $\Psi$ 朝同一个目标对齐,这就是论文声称的「用任务接地的共享信号解开 NIC」。
实验设置
数据集
| 数据集 | 规模 | 特征数 | 说明 |
|---|---|---|---|
| Taobao | 1.67M 训练 / 0.53M 测试 | 5 | 约 100 万用户 2017-11-25 ~ 12-03 的 click / cart / favorite / buy 日志;正样本为真实 buy,负样本按 1:1 采样,优先取「交互过但未购买」的难负样本 |
| Amazon-Electronics | 1.56M / 0.30M | 9 | 评论记录;item embedding 直接由 LLM 从评论文本得到;评分 $\ge 4$ 视为正,负样本按 $\mathrm{popularity}^{0.75}$ 从未交互物品中采 |
| Industrial | 20M / 2M | 56 | 亿级 DAU 推荐系统的点击日志;一整天做训练/验证,次日子集做测试 |
防泄漏设计:三个数据集都预留了互不相交的用户集专供 GMCD 预训练和 MILD 蒸馏使用,剩余用户在 leave-one-out 协议下构成 CVR 评估集。这一点做得比较干净——否则 teacher 见过评估用户的行为就会构成语义泄漏。
Baseline
统一在 CVR 排序任务下对比:
- DIN / DIEN / DSIN:目标注意力与兴趣演化;
- BST / HSTU:Transformer 自注意力建模长程依赖;
- DMIN:多向量建模兴趣多样性。
论文明确不把扩散式 / LLM 式推荐器当独立 baseline,理由是它们瞄准 top-$k$ 或生成式推荐,与目标条件化的 pointwise CVR 排序任务不对齐;转而通过组件级消融来隔离可控扩散与多意图 LLM 蒸馏的各自增益。所有 baseline 遵循 FuxiCTR 的实现实践,使用与本文相同的输入特征和序列长度,均用 BCE 优化;由于 Taobao 特征太少,额外为其训练了一个 item encoder。
评估指标
AUC、GAUC、LogLoss(离线),GMV(线上 A/B 业务指标)。GAUC 定义:
$$\mathrm{GAUC} = \frac{\sum_{u=1}^{U} \#\mathrm{samples}(u) \times \mathrm{AUC}_u}{\sum_{u=1}^{U} \#\mathrm{samples}(u)}. \tag{24}$$
论文引用已有结论指出 GAUC 与线上表现的一致性更好。
实现细节
所有方法沿用原论文骨干。Adam,学习率 $5\times10^{-4}$;最多 15 epoch,early stopping(patience = 4);batch size:baseline 2048,GateDiffInt 公开数据集 96、生产数据集 64(注意这个巨大的 batch size 差距,后文讨论)。最大序列长度:Taobao 128(均长 ≈101)、Amazon-Electronics 32(均长 ≈9)、生产数据集 1024。扩散前向从 1 到 1000 均匀采样时间步,反向从 700 起步做 DDIM 采样。PyTorch 实现。
NIC 诊断实验:先证明问题存在
这是本文实验部分最有价值的一节——它把 NIC 从概念抽象变成了可测量的现象。在公开 Taobao 上做,3 个随机种子,报告 mean±std。
NID 诊断
向每条测试序列注入替换噪声,比例 $\gamma \in \{0, 0.1, \dots, 0.5\}$:把 $\gamma$ 比例的非填充、非购买位置替换成按流行度采样的随机物品,同时保护目标位与强行为。以干净输出($\gamma=0$)为参照,度量意图漂移:
$$D(\gamma) = \frac{1}{K}\sum_{k=1}^{K}\Big(1 - \cos\big(h_k(S_0),\ h_k(S_\gamma)\big)\Big). \tag{23}$$
结果:无去噪变体(w/o GMCD)随噪声增大急剧且单调漂移;GateDiffInt 则明显稳定,漂移在所有 $\gamma$ 上一致低约 6.5 倍。这同时确认了 NID 的存在及本文任务接地去噪对它的缓解。
IDF 诊断
在弱信号子集上做(加购/收藏发生在最终购买前、间隔超过中位数的那些交互,$N_w \approx 1.8\times10^5$),把本文的可控扩散与一个「encoder 与训练数据完全相同、但剥掉全部任务接地」的 vanilla 扩散(纯 DDPM,无门控/无条件化)对比,报告弱信号重建保真度 $\cos(\hat X_{\mathrm{denoised}}, X_{\mathrm{clean}})$。
结果:vanilla 扩散只有 0.44——它的意图无关去噪严重扭曲了编码后的弱信号;GateDiffInt 忠实保留到 0.98,2.2 倍提升。论文诚实地补了一句:由于弱信号位置只占每条序列的一小部分,这个巨大的保真度差距被稀释成了 Table 3 中相对温和的 AUC 差距(0.8515 vs 0.8326)——这个自我校准是加分项。
主要实验结果
公开数据集
Table 1:公开数据集性能对比(粗体为最优;相对最强 baseline 的提升在成对 $t$ 检验下 $p < 0.01$ 显著)
| Model | Taobao AUC | Taobao GAUC | Taobao LogLoss | Amazon-Elec AUC | Amazon-Elec GAUC | Amazon-Elec LogLoss |
|---|---|---|---|---|---|---|
| DIN | 0.8068±0.0039 | 0.7919±0.0035 | 0.5353±0.0039 | 0.7141±0.0105 | 0.6996±0.0106 | 0.6228±0.0091 |
| DIEN | 0.8388±0.0011 | 0.8152±0.0010 | 0.4974±0.0031 | 0.7523±0.0037 | 0.7399±0.0037 | 0.6002±0.0058 |
| DSIN | 0.8254±0.0073 | 0.8033±0.0061 | 0.5134±0.0078 | 0.7612±0.0021 | 0.7489±0.0025 | 0.5915±0.0049 |
| BST | 0.8378±0.0021 | 0.8126±0.0012 | 0.5005±0.0015 | 0.7619±0.0050 | 0.7491±0.0048 | 0.5889±0.0077 |
| DMIN | 0.8397±0.0013 | 0.8174±0.0039 | 0.4963±0.0040 | 0.7636±0.0033 | 0.7527±0.0026 | 0.5878±0.0068 |
| HSTU | 0.8304±0.0032 | 0.8075±0.0031 | 0.5064±0.0043 | 0.7829±0.0016 | 0.7681±0.0019 | 0.5693±0.0047 |
| GateDiffInt | 0.8515±0.0014 | 0.8275±0.0013 | 0.4836±0.0018 | 0.8016±0.0076 | 0.7792±0.0033 | 0.5414±0.0046 |
结论分析:
- 序列模型在两个数据集上都稳定优于 DIN,且序列建模能力越强结果越好——这条趋势本身是健康的。
- HSTU 的表现高度依赖数据形态:在 Taobao 上(只有 5 个特征、序列偏短)它反而输给 DIEN/DMIN;到 Amazon-Electronics 上(有基于评论的丰富 embedding)它跃升为最强 baseline。这说明 HSTU 这类大容量 Transformer 需要足够的特征维度与序列长度才能兑现容量。
- GateDiffInt 在两个数据集全部指标上最优。相对最强 baseline,Taobao AUC +1.41%(0.8397→0.8515),Amazon-Electronics AUC +2.39%(0.7829→0.8016);LogLoss 的改善(Amazon 上 0.5693→0.5414,−4.90%)比 AUC 更显著,说明结构化意图不仅改善排序,还明显改善了概率校准——这对 CVR 这种要被下游出价/生态调控直接消费的分数来说很重要。
生产数据集
Table 2:生产数据集性能对比($p < 0.01$)
| Model | AUC | GAUC | LogLoss |
|---|---|---|---|
| DIN | 0.7682 ± 0.0026 | 0.7053 ± 0.0029 | 0.6078 ± 0.0034 |
| DIEN | 0.7712 ± 0.0033 | 0.7111 ± 0.0024 | 0.5915 ± 0.0027 |
| DSIN | 0.7843 ± 0.0021 | 0.7246 ± 0.0017 | 0.5883 ± 0.0011 |
| BST | 0.7978 ± 0.0014 | 0.7352 ± 0.0018 | 0.5626 ± 0.0016 |
| DMIN | 0.8026 ± 0.0022 | 0.7398 ± 0.0014 | 0.5437 ± 0.0013 |
| HSTU | 0.8239 ± 0.0019 | 0.7476 ± 0.0024 | 0.5118 ± 0.0015 |
| GateDiffInt | 0.8486 ± 0.0020 | 0.7612 ± 0.0012 | 0.4974 ± 0.0014 |
相对 HSTU:AUC +3.00%、GAUC +1.82%、LogLoss −2.81%。与 Taobao 上不同,HSTU 在生产数据上是最强 baseline,受益于更长的序列(1024)和更丰富的特征(56 维)——这与前面的分析自洽。
值得注意的是:AUC 的相对提升(3.00%)明显大于 GAUC(1.82%)。这意味着增益里有相当一部分来自跨用户的区分度改善(例如把「有转化意图的用户」整体抬高),而用户内部的排序改善相对温和。考虑到论文自己引用了「GAUC 与线上更一致」的结论,这个差值某种程度上预告了线上收益的量级会比离线 AUC 看起来的小。
线上 A/B 与部署
GateDiffInt 已部署在某亿级 DAU 大型工业平台首页信息流的排序阶段。系统采用两阶段范式:
- GMCD 与 MILD 每周预训练更新一次——因为序列增强与意图抽取捕捉的是相对稳定的模式;
- 与 CVR 模型的 LoRA 联合微调每天进行一次——用于适配最新数据分布。
服务时,最新用户行为被实时拉取,依次经过 GMCD → MILD student → CVR head 产出最终分数。
14 天线上 A/B 对比生产基线:首页信息流场景 GMV +1.13%(统计显著);后续推广到同场景内其它业务后,信息流场景累计 GMV 增益 +5.13%。
消融与分析
Table 3:Taobao 上的消融实验
| Variant | AUC | GAUC | LogLoss | ΔAUC |
|---|---|---|---|---|
| GateDiffInt | 0.8515 | 0.8275 | 0.4836 | — |
| w/ Vanilla Diffusion | 0.8326 | 0.8158 | 0.5112 | −0.0189 |
| w/o GMCD & MILD | 0.7154 | 0.6295 | 0.7128 | −0.1361 |
| w/o GMCD | 0.8313 | 0.8139 | 0.5241 | −0.0202 |
| w/o MILD | 0.8278 | 0.8037 | 0.5092 | −0.0237 |
| w/o Fusion Gate | 0.8358 | 0.8170 | 0.5073 | −0.0157 |
| w/o Importance Gate | 0.8424 | 0.8215 | 0.4983 | −0.0091 |
| w/o Multi-LoRA | 0.8467 | 0.8253 | 0.4981 | −0.0048 |
| w/o Multi-Intent | 0.8374 | 0.8133 | 0.5022 | −0.0141 |
逐项分析:
- 两个模块都去掉损失最大(AUC 0.8515→0.7154,跌 0.136),此时模型退化为一个只有 CVR head 的弱基线。
- 单独去掉任一模块都掉点,且 MILD 更关键(−0.0237 vs −0.0202)——这与论文的立场一致:噪声的危害最终要通过意图表达出来,缺了结构化意图,去噪本身也失去了消费者。
- 联合掉点(0.1361)远大于两个单项掉点之和(0.0202 + 0.0237 = 0.0439),这是本文最强的一个数据点:它说明两个模块是互补而非冗余的,去掉一个之后另一个还能兜住大部分,但两个都没有时表征彻底塌掉。(需要注意的是,「w/o GMCD & MILD」实际上把整个序列建模主干都拿掉了,所以这个超加性有一部分是基线过弱造成的,不能完全归因于 NIC 闭环。)
- GMCD 内部:把可控扩散换成 vanilla 变体掉 0.0189,禁用融合门掉 0.0157,禁用重要性门掉 0.0091。融合门贡献最大——即「逐位置决定信多少去噪结果、信多少原始表征」这件事比「把重要性外化给 teacher」更值钱。但重要性门 0.0091 的贡献也不小,且它是 $\Psi \rightarrow \Phi$ 通道的唯一载体,说明这条通道确实在起作用。
- MILD 内部:四条 per-intent LoRA 塌成一条掉 0.0048;四类意图塌成单一类型掉 0.0141。「意图类型的多样性」比「参数路径的独立性」重要得多——也就是说,真正的收益来自把意图按时间尺度/强度分槽这件事本身,per-intent LoRA 只是保住分槽不塌缩的一个(相对次要的)手段。
意图解耦的定性证据
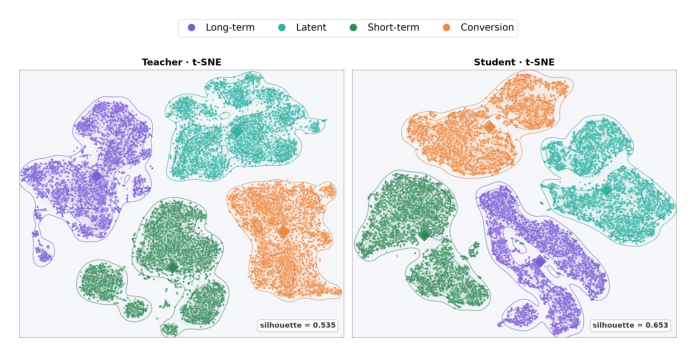
四类蒸馏意图向量在 t-SNE 上形成分离良好的簇。论文用词很克制("qualitatively suggest"),没有把 t-SNE 当作定量证据——这个分寸感是对的,但也意味着意图解耦目前只有定性支持,缺少像 SHE 那样的 distinctiveness / faithfulness 量化指标。
超参数敏感性
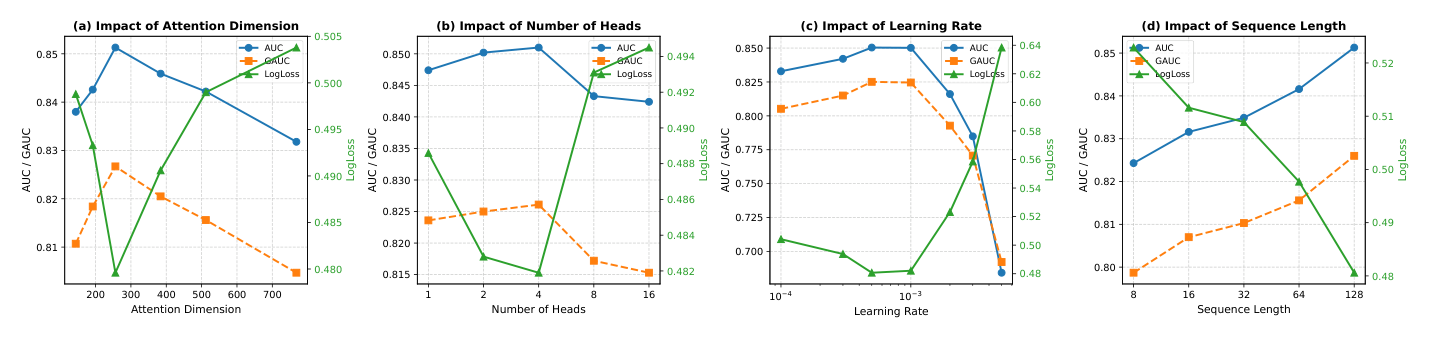
- 学习率最敏感:最佳区间 $5\times10^{-4} \sim 1\times10^{-3}$;更低欠拟合,$\ge 2\times10^{-3}$ 训练不稳定(图中 AUC 从 0.85 崩到 0.70 左右)。
- 注意力维度呈倒 U 型,在 256 达峰。
- 头数相对鲁棒,4 最好。
- 序列长度上性能稳步提升(8→128 单调上升),说明模型能吃下更长的序列——这与生产环境用到 1024 的设置一致。
默认配置(dim=256, heads=4, lr=$5\times10^{-4}$)落在有利区间。
核心贡献总结
- 识别并实证刻画了 Noise–Intent Coupling(NIC):首次显式指出「噪声劣化意图」与「无结构意图劣化去噪」之间的互相强化,把它分解为 NID 与 IDF 两个可分别测量的子现象,并用注入噪声下的意图漂移(6.5× 差距)与弱信号重建保真度(0.44 vs 0.98)两个诊断实验坐实。
- 提出用任务接地的共享信号解 NIC 的两阶段框架:先分别预训练 GMCD(行为重要性差异化的可控扩散 + 双门控融合)与 MILD(冻结 LLM teacher → per-intent LoRA 学生蒸馏四类结构化意图),再冻结主干、仅用 LoRA 做端到端联合微调 + teacher-anchoring 正则,让 $\Phi$ 与 $\Psi$ 朝转化目标共同对齐。
- 在 benchmark 与工业规模双重验证:两个公开数据集 + 一个亿级 DAU 生产数据集上一致超过 DIN/DIEN/DSIN/BST/DMIN/HSTU;组件级消融隔离出各模块贡献;14 天线上 A/B 首页信息流 GMV +1.13%,推广后场景累计 +5.13%,已服务主流量。
与已归档相关工作的对比
AIR AIR: Atomic Intent Reasoning(香港理工大学 + Kuaishou,2026-06-09)
关系:独立并发(本文未引用 AIR,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇都在回答同一个 root cause——工业排序模型把用户意图隐式编码在参数/隐状态里,无法显式解耦出结构化意图;而能提供这种结构的 LLM 又因为在线延迟无法直接用。AIR 把它拆成「实时推理代价」和「行为序列又长又脏」两道坎,GateDiffInt 把它拆成 NID 和 IDF;两者对「序列噪声会让意图抽取失真」这一点的判断完全一致(AIR 原文:「把原始行为序列直接喂给模型不仅放大语义噪声,还带来巨大计算开销」)。
- 相近的技术骨架:两者的方法流程图可以抽象重合成同一张——LLM 离线抽结构化意图 → 落成可高效服务的轻量形态 → 用注意力融合进 CTR/CVR 排序塔。AIR 是「LLM 离线生成原子行为-意图对 → 意图知识库 → 在线意图树 + 目标感知检索 → MHA 融合 → MMoE/XTR 塔」;GateDiffInt 是「LLM 离线生成四类意图文本 → Qwen3-Embedding 编码为目标 → 蒸馏进 Qwen3-1.7B student 的四个 intent token → cross-attention 融合 → MLP CVR head」。两者都把 LLM 成本 100% 留在离线,在线彻底 LLM-free。
- 本文的差异与推进:(i)「轻量形态」的选择不同——AIR 走检索/缓存路线(原子意图对落库,在线组装意图树),GateDiffInt 走参数化蒸馏路线(把 teacher 语义压进一个 1.7B student 的 LoRA 路径)。AIR 的方案更新更即时、可解释性更强(每个节点有显式证据),GateDiffInt 的方案对未见行为组合的泛化更好,但更新只能靠周级重训。(ii)GateDiffInt 多做了一件 AIR 没做的事:显式的序列去噪,并且把去噪器的位置重要性 $g_i$ 反过来喂给意图 teacher。AIR 的去噪是隐式的(靠目标感知检索天然过滤掉不相关证据,外加时间衰减/相似度阈值这类启发式),没有形成「去噪↔意图」的双向通道。这正是 GateDiffInt 声称的对「单向 denoise-then-extract」的推进。(iii)AIR 的意图结构是层级类目树(内容→电商的跨域语义路径),GateDiffInt 的意图结构是心理学驱动的四类固定槽位(长期/短期/潜在/转化)——前者细粒度可扩展,后者维度固定但语义对齐 CVR 任务更紧。
- 可比的方法 / 实验差异:AIR 报告 Kuaishou 电商线上 GMV +3.446%、相对在线 LLM 约 400× 吞吐;GateDiffInt 报告首页信息流 GMV +1.13%(14 天 A/B)、场景累计 +5.13%,但没有给出任何延迟/吞吐数字,而它在线要跑一次 20 步 DDIM 反向采样 + 一次 1.7B student 前向,这个开销远高于 AIR 的「查表 + MHA」。GateDiffInt 缺失的服务成本数据是它相对 AIR 最明显的报告短板。
SHE SHE: Structured Hypothesis Embeddings(UC San Diego,2026-08-11)
关系:独立并发(本文未引用 SHE,同期同构且结论互补)· 已加载对方精读
- 共同关注的问题:两篇都在做同一件事的两半——用冻结 LLM 把用户历史分解成若干条结构化、可区分的意图,作为一个额外表征分支注入推荐器。GateDiffInt 问「怎么做得更好」,SHE 问「这件事到底值多少、什么时候值」。
- 相近的技术骨架:骨架几乎逐项对应。SHE:冻结 LLM → $K=3$ 条排序的、带置信度 $\gamma_k$、带证据引用的意图假设 → 文本嵌入 $e_k$ → 以 late fusion 的冻结 input-embedding 分支接入下游模型,无梯度回传进 LLM。GateDiffInt/MILD:冻结 Gemini teacher → $K=4$ 条语义类型固定的意图描述 → Qwen3-Embedding 编码 → student 的四个 intent token(intent token 互相不可见)→ cross-attention 分支接入 CVR head,teacher 全程冻结。连「防止多个意图塌成一个」这个具体顾虑都一样:SHE 靠 max-over-facets 聚合和 prompt 里的「多条假设必须覆盖真正不同的 facet」规则,GateDiffInt 靠 2D 注意力掩码 + per-intent LoRA 路由。
- 本文的差异与推进:(i)GateDiffInt 把 LLM 侧从「在线特征」变成「离线 teacher」——SHE 每个样本都要调一次冻结 LLM(这正是它研究「该不该为这次调用付费」的前提),GateDiffInt 蒸馏之后在线完全不调 LLM,从根上绕开了 SHE 全篇讨论的成本-收益问题。(ii)GateDiffInt 额外接了一个扩散去噪前置,SHE 完全没有去噪环节。(iii)反过来,SHE 做了 GateDiffInt 没做的意图质量量化:grounded faithfulness(被引 vs 未被引证据的配对余弦差 +0.0705)、distinctiveness($1-\cos$ 两两平均,MIND 0.204 vs 薄内容数据集 0.104)、置信度校准(ECE 0.142→0.031)。GateDiffInt 对四类意图的解耦只给了 t-SNE 定性图(Figure 4),没有任何可比的定量刻画。
- 可比的方法 / 实验差异:SHE 的核心发现对 GateDiffInt 构成一个值得警惕的对照——SHE 报告结构化意图的下游价值是 backbone- 与 regime-conditional 的:相对有序 GRU 只 +0.0114($p=0.005$),全局冗余 gap −0.0005(与零无异),在稀疏历史上被吸收、只在长的多意图历史上互补;且薄内容数据集(REES46,87.9% 单品类)上 faithfulness ≈ 0,「根本没有东西可分解」。GateDiffInt 在 Taobao 上把「四类意图塌成一类」的掉点报到 −0.0141 AUC,量级远大于 SHE 观察到的效应——差异可能来自任务(CVR vs slate NDCG)、数据规模(1.67M vs 1263 窗口)与 backbone 强度(SHE 的 base 是廉价 mean-pool/GRU),但 GateDiffInt 没有按用户历史长度/多意图程度做分层分析,因此无法排除它的增益同样集中在某个 regime 上。SHE 给出的处方(部署设计期 regime gate 而非逐样本路由)恰好是 GateDiffInt 这种「对全流量无条件跑 LLM 蒸馏路径」的方案可以直接借鉴的降本方向。
FGPD FGPD: Feedback-Grounded Policy Discovery(Kuaishou 等,2026-07-30)
关系:独立并发(本文未引用 FGPD,蒸馏骨架高度同构)· 已加载对方精读
- 共同关注的问题:两篇的问题陈述在同一句话上收敛——推荐模型只被 item-level 的行为监督训练,语义/意图只能隐式编码,训练目标本身没有把结构化的高层信息显式分离出来。GateDiffInt 说「typically encode intent signals implicitly in model parameters or hidden states, making it difficult to explicitly disentangle structured intents」,FGPD 说「训练目标本身并没有把需求理解与推荐决策显式分开」。两者也都把「LLM 在线 serving 成本」当作必须绕开的硬约束,因而都选择把 LLM 放到离线 teacher 位。
- 相近的技术骨架:LLM 离线 teacher → 把知识切成 $K$ 个语义上互不相同的结构化槽位 → 每个槽位对应一个前置的可学习 token → 用对齐损失把 teacher 语义蒸馏进轻量 student 的这些 token → 在线 LLM-free 推理。GateDiffInt 是 4 个槽位(长期/短期/潜在/转化),对齐方式是与 teacher 文本嵌入的余弦距离(式 17);FGPD 是 2 个槽位(Intent Token / Policy Token),对齐方式是双空间关系蒸馏(对齐一阶用户关系与高阶邻域结构,刻意不做直接 embedding 匹配)。两者对「student 和 teacher 表征空间不同」的处理策略正好构成对照。
- 本文的差异与推进:(i)槽位的语义轴不同——GateDiffInt 沿时间尺度与意图强度切(Goal Systems Theory),FGPD 沿理解 vs 行动切(intent knowledge vs policy knowledge)。FGPD 的核心论点是「知道用户在找什么 ≠ 知道该给哪个候选」,这恰好是 GateDiffInt 完全没有触及的一个维度:GateDiffInt 的四类意图全都停在「用户想要什么」,包括所谓 conversion intent 也只是「最可能立刻发生的购买决策」,没有把「在意图一致的候选之间如何取舍」显式建模。如果 FGPD 的论点成立,GateDiffInt 的意图向量在细粒度候选区分上仍会留有系统性缺口——这一点在它 AUC 提升(3.00%)显著大于 GAUC 提升(1.82%)上或许有所反映。(ii)FGPD 用反馈驱动的双 agent 循环验证策略假设(只保留相对 intent-only baseline 有可验证正增益的假设),GateDiffInt 的 teacher 输出没有任何验证或过滤环节,只靠 $m_{b,k}$ 掩掉「无有效监督」的位置——teacher 幻觉出来的意图描述会被无条件蒸馏进 student。(iii)GateDiffInt 多了扩散去噪,且把去噪的位置重要性反馈给 teacher;FGPD 无此环节。
- 可比的方法 / 实验差异:FGPD 在三个 Amazon 数据集上报 Recall@10 相对 TIGER/LETTER +19.8%~+39.6%,并给出明确的 serving 成本对比(0.032 vs 4.437 秒/样本);线上 Kuaishou 本地生活广告 7 天 A/B Revenue +4.506% / ADVV +4.621%。GateDiffInt 的任务是判别式 CVR 排序(AUC/GAUC/LogLoss),与 FGPD 的生成式 SID 检索指标不可直接比较;但FGPD 报了蒸馏后的 serving 时延而 GateDiffInt 没有,这一点与 AIR 的对比里指出的是同一个短板。
讨论与局限性
值得借鉴的设计
- 把「问题诊断」做成可测量实验。NIC 本可以只是一个漂亮的名词,但作者用两个独立诊断(噪声注入下的意图漂移 6.5×、弱信号重建保真度 0.44→0.98)把它坐实了,而且主动指出这个巨大的保真度差距会被稀释成温和的 AUC 差距。这种自我校准在工业论文里少见,也让后续工作有了可复用的度量方式。
- 把去噪器的中间信号外化给意图抽取器。重要性门 $g_i$ 不参与融合、只作为「位置重要性提示」喂给 LLM teacher,这是一个非常轻但方向正确的设计:它让 teacher 在生成意图描述时不必被浅层噪声牵着走。消融显示它值 0.0091 AUC,不算大但确实在起作用。
- 两阶段 + 冻结主干 + LoRA 的工程分层,与线上更新节奏严格对应。GMCD/MILD 周级更新(稳定模式)、LoRA 联合微调日级更新(分布漂移),这个「按变化速率给模块分层」的做法本身就是很实用的工业模式。
- 梯度只能从 $(1-g_f)\odot X_1$ 支路回流这个约束是被有意识地讲清楚的,而不是当作副作用。它让第二阶段的微调天然轻量、不会破坏预训练的去噪能力。
局限与争议
- 完全没有报告服务成本。这是最严重的缺口。在线路径要跑 20 步 DDIM 反向采样 + 一次 Qwen3-1.7B 前向,序列长度 1024,这在毫秒级的排序阶段绝非可忽略的开销。论文只字未提 QPS、时延、GPU 成本,也没有和 baseline 做等算力对比。相比之下同期的 AIR 给了 400× 吞吐、FGPD 给了 0.032 s/样本。在缺少这些数字的情况下,无法判断表 2 里对 HSTU 的 +3.00% AUC 是不是「用几倍算力换来的」。
- batch size 差异带来的可比性疑虑。baseline 用 2048,GateDiffInt 用 96(公开)/64(生产)。作者没有解释这个 20~30 倍的差距(大概率是 1.7B student 的显存约束),也没有做 batch size 对齐的对照。小 batch 在 CTR/CVR 任务上常常本身就带来更好的泛化,这让「提升全部来自方法」的归因打了折扣。
- teacher 输出无验证。MILD 无条件蒸馏 Gemini 生成的意图文本,只用 $m_{b,k}$ 掩掉「无有效监督」的位置,没有任何幻觉过滤、一致性检验或质量度量。对照 FGPD 的「只保留相对 intent-only baseline 有可验证增益的假设」和 SHE 的 faithfulness/calibration 度量,这是方法论上的明显缺环。四类意图的解耦也只有 t-SNE 定性支持。
- 模型版本引用存疑。正文写 teacher 是「frozen Gemini 3.5 Flash (via API)」,但对应的参考文献 [44] 是 Gemini 2.5 技术报告。这大概率是笔误或版本更新未同步,但对一篇依赖 teacher 能力的论文来说,teacher 到底是哪个模型是需要精确的。
- baseline 集合偏保守。论文明确不把扩散式/LLM 式推荐器当独立 baseline,理由(任务不对齐)站得住;但它自己在 related work 里点名的 DiffuMIN、InDiRec 这两个「扩散–多兴趣混合」工作,恰恰是最直接的对照——把它们改造到 CVR 设定下对比,才能证明「双向中介」相对「单向 denoise-then-extract」的增量。目前这个论点只有消融(w/ Vanilla Diffusion)间接支撑。
- 缺少分层分析。参照 SHE 的结论(结构化意图的价值是 regime-conditional 的,在稀疏历史上被吸收、只在长的多意图历史上互补),GateDiffInt 没有按用户历史长度、意图多样性、行为稠密度做任何分层。它的 AUC 提升显著大于 GAUC 提升,也提示增益可能不均匀分布。如果收益确实集中在某个用户子群,那么「对全流量无条件跑完整 LLM 蒸馏路径」就存在明显的降本空间。
- 方法论可扩展性:GMCD 与 MILD 是显式两阶段解耦的——GMCD 预训练完就冻结主干,MILD 消费的是已经固化的 $E_{\mathrm{final}}$,第二阶段只有 LoRA 在动。这意味着扩参数时,「如何表征历史」(GMCD 容量)与「如何抽取意图」(student 容量)不能被同一个任务目标联合优化到底;student 换成更大的 LLM 也无法反向改善去噪器的表征空间。四类意图槽位的固定维度同样构成一个天花板——意图结构一旦按 Goal Systems Theory 定死为 4 类,就无法随规模扩展出更细的语义分辨率(对比 AIR 的层级意图树在这一点上更有余地)。
工业落地价值
这篇的工业属性是扎实的:亿级 DAU 平台首页信息流排序、14 天 A/B、GMV +1.13% 且已推全主流量、场景累计 +5.13%,还给出了周级/日级双节奏的更新方案和明确的在线数据流(GMCD → MILD student → CVR head)。对于「想把 LLM 语义塞进判别式 CVR 排序但受制于延迟」的团队,MILD 这条「冻结 teacher 生成结构化意图文本 → 嵌入空间对齐 → 前置 intent token + per-intent LoRA 蒸馏进小 LLM」的路子是可以直接复用的模板,且四类意图的划分有心理学依据、比拍脑袋定 K 更有说服力。真正需要补齐的是成本侧数据:在没有时延/吞吐数字的情况下,这套方案的实际可复制性要打一个问号。