AutoLR:把「研究 → 上线评审」整条路径交给受治理的自治 harness(网易 DASHEN)¶
Qi Zhang、Yanlin Chen、Wenchao Xiao · NetEase, Inc.(网易) · arXiv 2609.04871v1 · 2026-09-04 · cs.AI · 正文 12 页 + 参考文献
AutoLR 不是一篇推荐模型论文。它既不提出新的排序架构,也不改动线上打分逻辑,而是一份工业推荐「研发流程自动化」的生产部署 + 日志审计报告:把算法工程师原本手工穿越的那条长路径——查文献、提假设、改生产代码、训练、离线评估、打包候选——交给一组 LLM agent 执行,而把「什么算证据、哪个指标权威、什么时候能改动持久化状态」的权力全部留给确定性控制器。论文的落点在 Launch Review(网易内部的全流量放量闸门),故名 Auto Launch Review。
论文最值得读的地方不在系统本身(作者自己承认流水线长度与权限划分都不新),而在两件事:一是它对自己几个月的实验账本做了一次路径感知审计,把 4,250 条物理日志一步步剔到 1,586 次完整评估,每一步的剔除量与理由都写在图里;二是它命名并证据化了一个自进化 harness 的结构性失效模式——KEEP 棘轮(KEEP ratchet):一旦某次离线单跑越过阈值就被写回主干,后续所有实验都拿这个可能是噪声的主干当基线,于是错误不再只是一次噪声测量,而是改变了未来所有比较的参照系。
一、研究动机与背景¶
1.1 瓶颈不在任何单步,而在反复交接¶
论文开篇的判断很克制:工业推荐系统靠反复实验前进,一个候选在全流量放开之前,工程师要走完一条长路——文献调研、业务分析、论文复现、假设生成、代码实现、训练、离线评估、小流量在线 A/B、最终归因。在 DASHEN,这些产物最后汇总到 Launch Review,用离线证据、线上效果、业务护栏、实现就绪度四类材料决定是否放全量。
The bottleneck is not any one step. It is the repeated handoff among research, code, training platforms, logs, metrics, and business decisions.
瓶颈不是任何一步,而是研究、代码、训练平台、日志、指标、业务决策之间反复的交接。论文补了一条随系统成熟而恶化的动力学:预期收益越来越小,而看似合理的想法越来越多。算力可以支持更多并行试验,但一个团队能探索的想法范围仍被人的注意力、工程时间、以及「能否把上一次实验的教训带到下一次」所限制。
1.2 已有工作停在哪里¶
论文承认 LLM 已能读任务规约、写训练代码、跑实验、依据验证结果迭代(MLE-bench、AIDE、MLE-STAR),也已被推到研究假设生成与算法搜索(The AI Scientist、AlphaEvolve)。工业推荐这条线上,论文点名了四个系统:
- Google Self-Evolving Recommendation System:Offline Agent(Fast Loop)用代理指标生成并筛假设,Online Agent(Slow Loop)用延迟的北极星指标验证,报告了 YouTube 上若干次上线;
- Kuaishou AgentX:提案生成 → 生产代码实现 → 受护栏约束的在线 A/B → 从执行轨迹进化 harness,四阶段闭环;
- RecHarness:把「编辑方向选择」与「具体代码变异」解耦,验证驱动的 Thompson 采样在预定义 edit arm 间分配试验,LLM 只在选定方向内生成可执行修改;
- Meta Ranking Engineer Agent (REA):planner–executor 架构,管理跨多日到多周的异步广告排序实验。
论文由此提出一个关键论断:主要的设计问题比「选一个更强的基座模型」宽得多。
A capable LLM does not by itself determine which proposal deserves the next trial, whether a patch respects a living repository, when a failure should be retried, which metric is authoritative, or when an observed improvement is strong enough to change persistent state.
一个能干的 LLM 本身并不能决定:哪个提案值得下一次试验、一个补丁是否尊重了活的代码仓库、什么样的失败该重试、哪个指标是权威的、以及一个观察到的提升何时强到足以改变持久状态。长时程自治因此依赖显式状态与有界、可审计的接口。
1.3 可变基线:论文的理论骨架¶
§2.3 是全文最有分量的相关工作段,它把三个可靠性风险叠成一条链:
- 自适应过拟合:反复在同一份留出集上看结果再挑新假设,会过拟合评估集、使普通统计结论失效(Dwork et al. 的 Reusable Holdout、Blum & Hardt 的 Ladder、Always Valid Inference、在线 FDR 控制都是为此设计的);
- 胜者诅咒 / 优化者诅咒:即便评估数据是新鲜的,从大量含噪试验里挑最好的那个,也会系统性地选中「恰好被有利噪声眷顾」的候选;这一效应在工业在线对照实验中已被观察到(Lee & Shen, 2018);
- 有状态放大:自治实验系统会把上面两类错误变成持久的。当一个候选被接受并成为后续实验的基线时,一次错误的「提升」不再只是一次含噪测量——它改变了后续候选被生成和被评估时所对着的那个工作仓库。
论文把第三条命名为 KEEP 棘轮。它与 Ladder 的类比很贴切但更狠:Ladder 只限制「更新一个被维护的参考分数」,而 AutoLR 的一次 KEEP 改写的是后续实验所用的代码仓库产物,不只是一个上报数字。
论文的实证覆盖 DASHEN 两个核心推荐场景:支持单列/双列布局的标准推荐 feed,以及沉浸式视频 feed。
1.4 四点贡献(原文自述)¶
- 受治理的、以生命周期为中心的 harness:结构化「研究 → Launch Review」这条路径,并自治执行其上游各阶段(证据检索、提案生成、仓库 grounded 实现、验证、训练、离线评估、候选打包),同时把在线 A/B 与全流量放量的权限保留给人;
- 证据驱动的提案与试验分配:角色特化的多专家委员会独立生成、辩论、对抗式评审候选方向;一个确定性的、证据加权的探索—利用选择器结合历史实验结果与委员会重排来分配有限试验;
- 分层知识与实验记忆:外部研究 + 生产系统事实 + DASHEN 领域知识(游戏社区结构、玩家画像、内容交互模式)+ 从既往配置/补丁/日志/失败/离线结果累积的后验证据;
- 生产规模评估与可靠性发现:1,586 次完整评估、9 条 Launch Review 记录、低成本模型迁移,以及 KEEP 棘轮的刻画。
二、系统设计¶
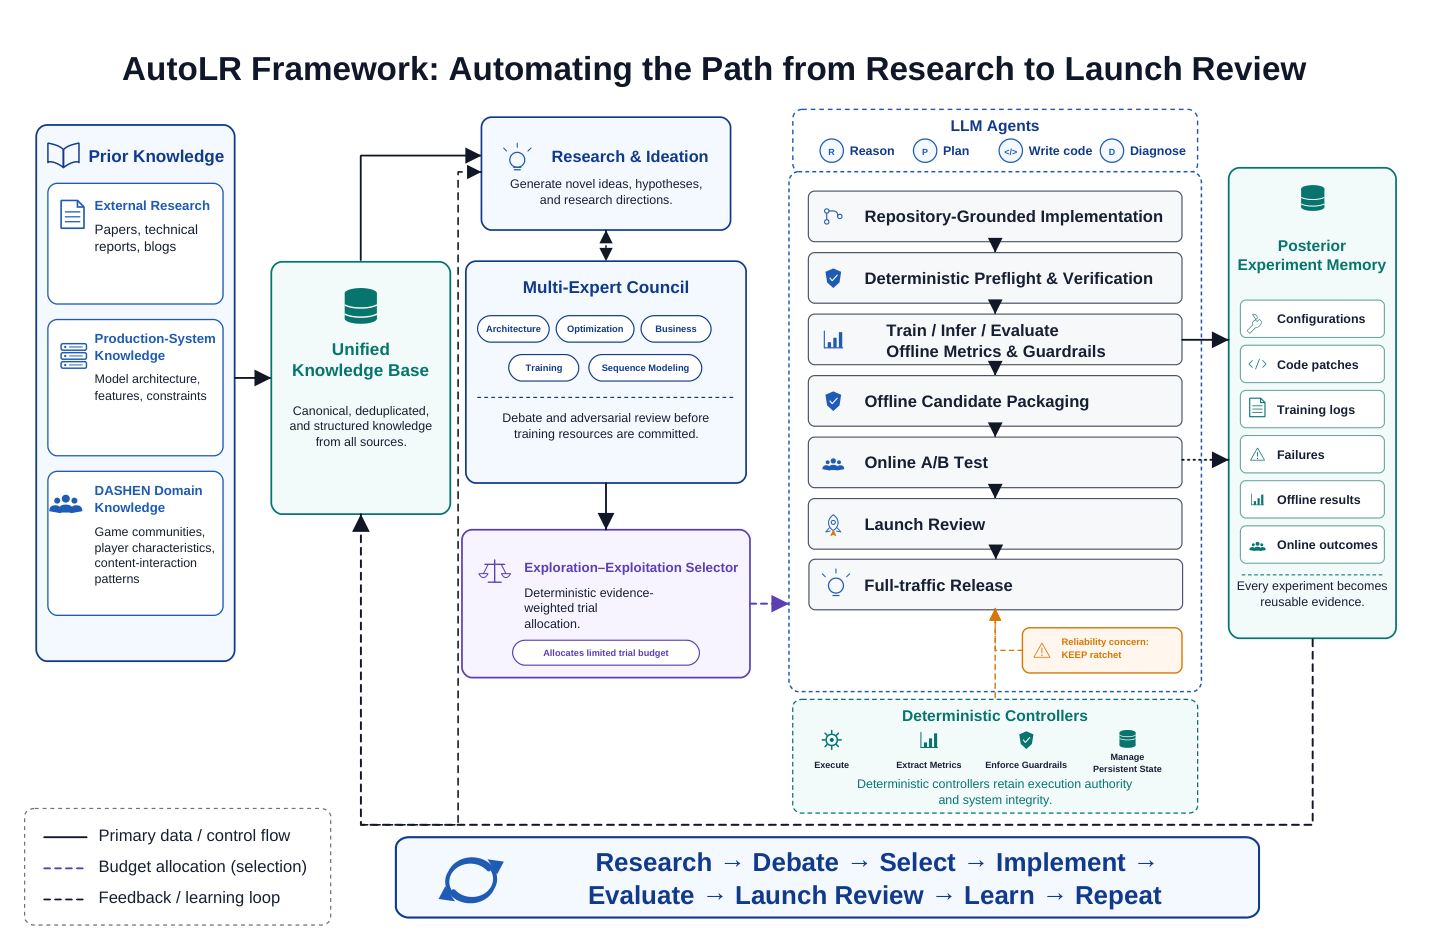
2.1 生命周期状态与权限的不对称¶
AutoLR 自治覆盖「研究 → 离线候选打包」。给定一个业务驱动的优化请求、一份固定的离线评估契约、以及仓库约束,系统检索证据、提案与评审、选实验、改仓库、起训练与评估、诊断结果、打包候选。在线 A/B 准入与全流量放量仍由人把关。
论文用如下路径描述长期目标(原文式 (1)):
$$ \begin{aligned} &\text{Research} \to \text{Debate} \to \text{Select} \to \text{Implement} \to \text{Verify} \to \text{Train} \\ &\to \text{Offline Evaluate} \to \text{Package} \to \text{Engineer Review} \to \text{Online A/B} \\ &\to \text{Launch Review} \to \text{Rollout} \to \text{Learn} \to \text{Repeat} \end{aligned} \tag{1} $$
在第 $t$ 轮,设 $T_t$ 为当前活跃主干(active trunk),$K_t$ 为可用知识与实验记忆,$H_t$ 为实验历史,$B_t$ 为剩余试验预算。生命周期为:
$$ a_t = S(T_t, K_t, H_t, B_t),\quad p_t = G(a_t, T_t, K_t, H_t),\quad \pi_t = I(p_t, T_t),\quad (\mathbf{bm}_t, \ell_t) = E(T_t \oplus \pi_t) \tag{2} $$
其中 $a_t$ 是本轮选中的研究方向;$p_t$ 是该方向内经委员会评审的具体提案;$\pi_t$ 是实现该提案的仓库 grounded 代码补丁;$\mathbf{bm}_t$ 是离线指标向量;$\ell_t$ 包含验证结果、训练状态、checkpoint、失败诊断等执行证据。$S$ 是方向选择器,$G$ 生成并评审具体提案,$I$ 把提案转成合法的仓库修改,$E$ 是确定性的训练—离线评估协议。
权限是刻意不对称的:LLM agent 负责文献综合、假设生成、辩论、仓库理解、代码生成、定性诊断;确定性控制器掌管仓库检查、作业执行、超时、指标提取、护栏、git 状态转移、持久化离线状态。论文一句话点题:
LLM outputs are proposals, not state transitions.
LLM 的输出是提案,不是状态转移;每一次权威转移都要求一个机器可验证的产物——已验证提案、commit、checkpoint、指标记录或晋升裁决。
2.2 多专家提案委员会¶
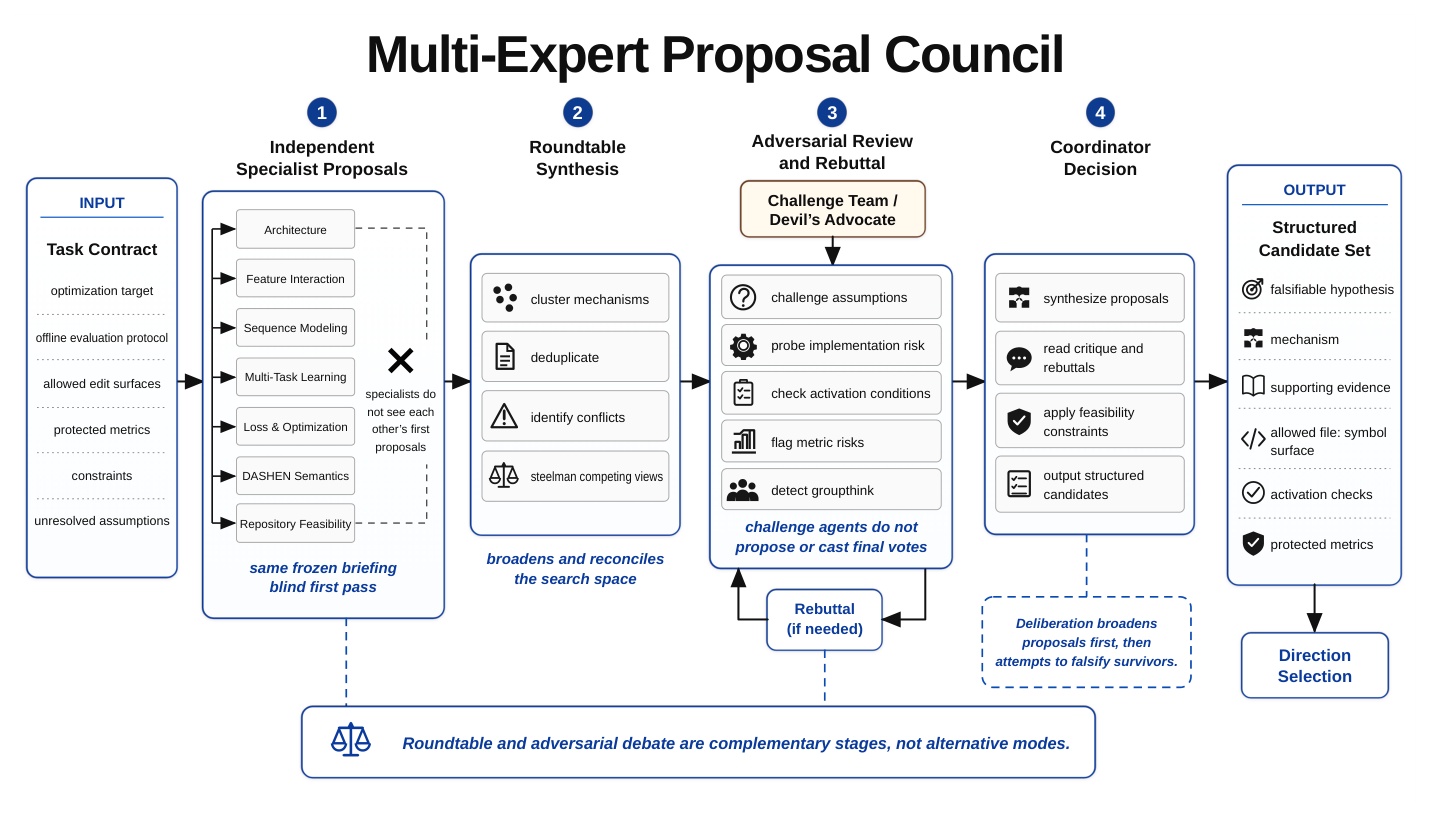
一个推荐优化请求通常规定了目标指标与离线评估协议,但没有规定该怎么改模型。设计空间很宽:模型架构、特征交互、样本利用、多目标学习、长短期行为建模、损失设计、训练策略。AutoLR 因此先把请求转成一份结构化的 task contract(任务契约),包含:优化目标、评估协议、允许的编辑面(allowed edit surfaces)、硬约束、受保护指标、相关证据、未解决假设。
委员会分四阶段处理:
- 独立专家提案:角色特化 agent 在同一份冻结简报下独立分析,互相看不到对方的首轮提案。典型角色覆盖模型架构、特征交互、序列建模、多任务学习、损失与优化、DASHEN 业务语义、仓库可行性、对抗评审。这一步的目的是鼓励假设多样性、抑制早期锚定;
- 圆桌综合(roundtable synthesis):聚类相似机制、去冗余、识别真实分歧,并在否决前先把竞争观点强化(steelman);
- 对抗评审(adversarial review):专门的挑战 agent 搜寻无支撑假设、实现不可行、缺失激活条件、指标风险、群体思维。高风险提案可触发原提案专家的反驳(rebuttal),需辅以具体证据或一个可证伪的验证探针。挑战 agent 不提案、不投终票;
- 协调者(Coordinator):把提案、批评、反驳、历史证据、可行性约束综合成一个结构化候选集。每个候选必须给出:可证伪的假设与机制、支持证据、意图中的模型或训练改动、允许的 file:symbol 编辑面、预期可观测量与激活检查、受保护指标。硬约束是非补偿性的——不可行的提案无论多新颖、预期收益多高都直接否决。
论文强调圆桌与对抗是互补的两阶段而非二选一的两种模式:前者拓宽并调和搜索空间,后者试图证伪幸存者。
2.3 证据加权的方向选择¶
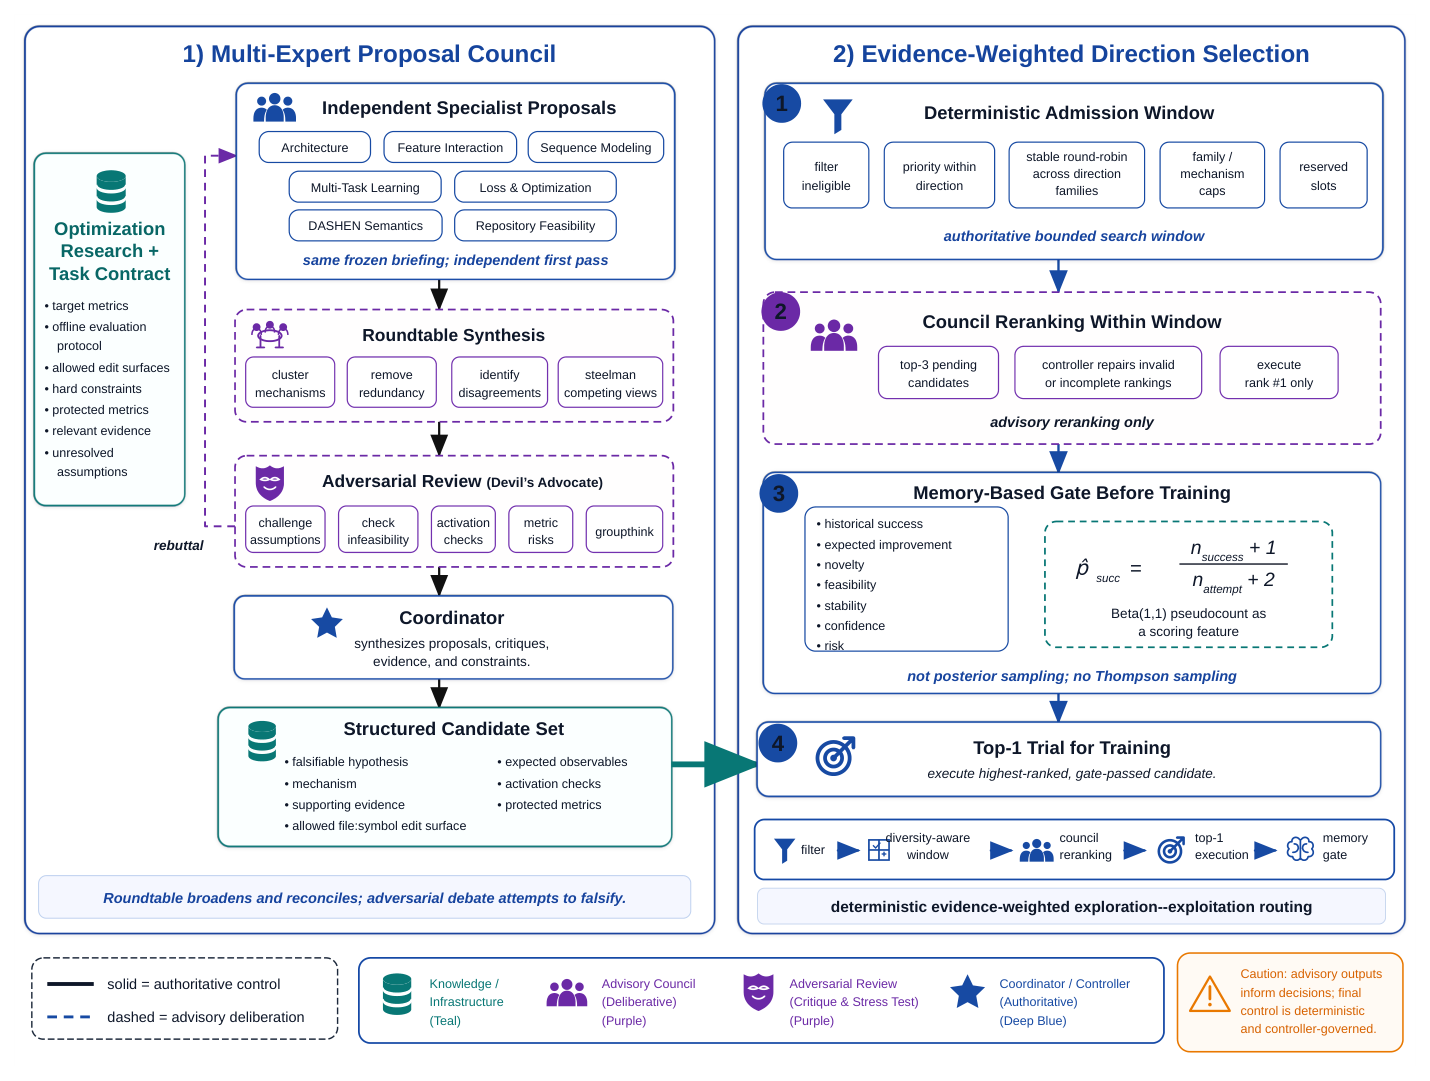
设 $\mathcal{A} = \{a_1, \dots, a_K\}$ 为一组可解释的优化方向:序列建模、专家路由、特征交互、门控、任务加权、正则化、训练策略。方向选择决定去哪里搜;方向被准入后,委员会与实现 agent 决定在该搜索区域内具体改什么。
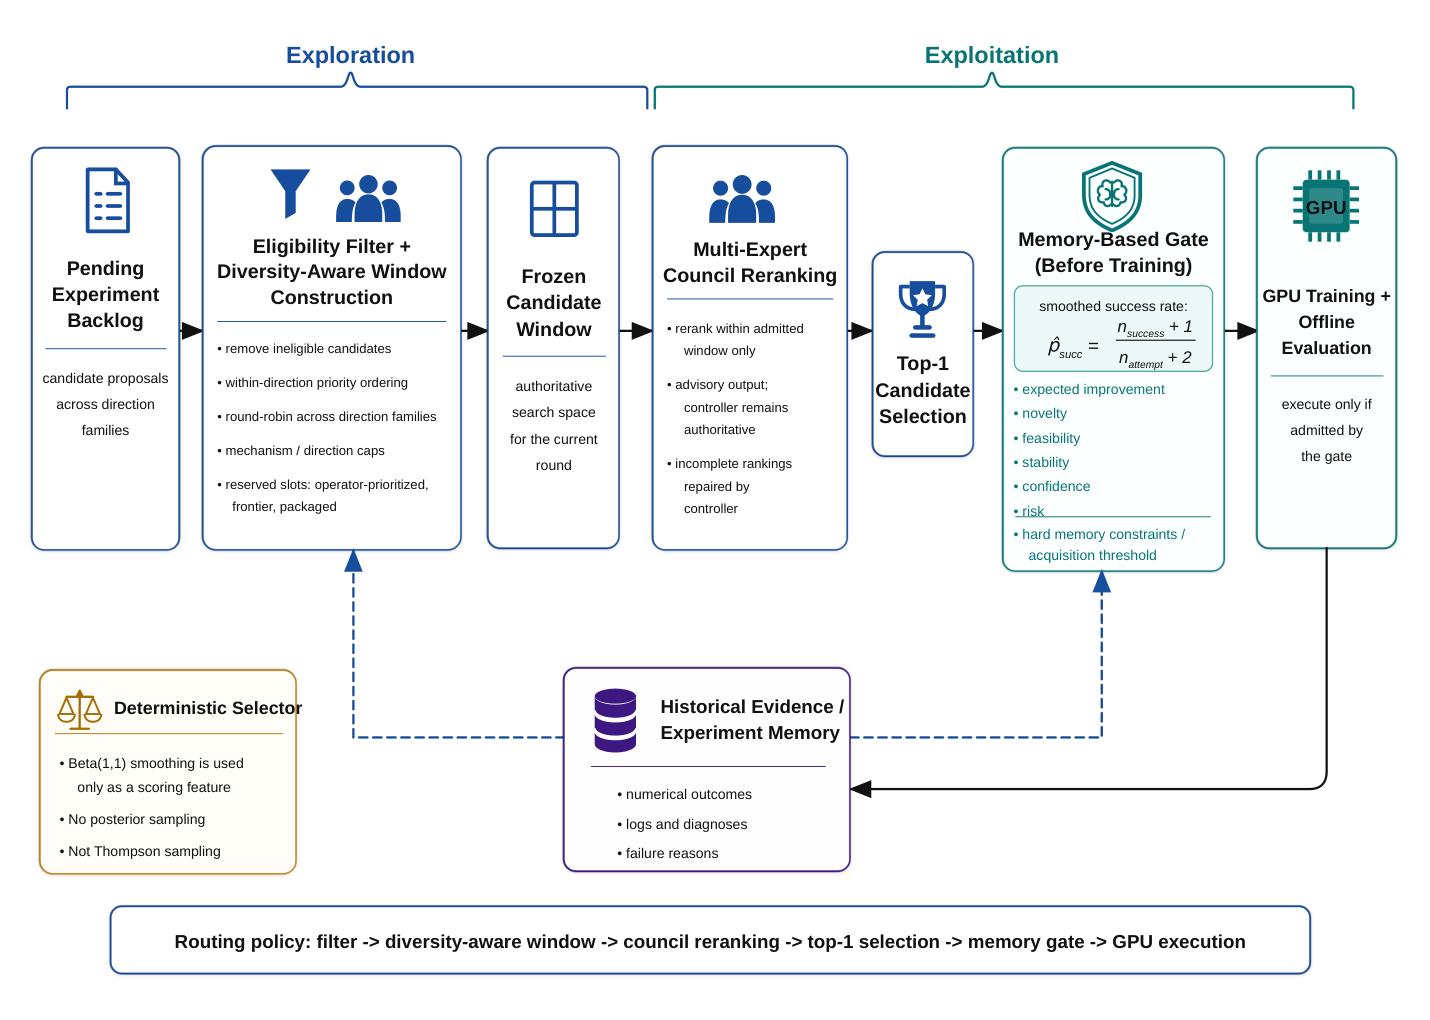
生产选择器是确定性的,分三阶段:
第一步,多样性感知的准入窗口。 控制器从待办实验 backlog 构造一个有界候选窗口:剔除不合格候选,按方向内优先级排序,用稳定的轮转(round-robin)调度把名额分配到各方向族;额外的机制级与方向级配额上限防止窗口被单一族群垄断,同时保留名额给运营指定、frontier、已打包的候选。这个冻结窗口即为本轮的权威搜索空间。
第二步,委员会在窗口内重排。 委员会返回最有希望的若干待办候选(图 4 标注为 top-3)的优先序,控制器把它们移到队首并只执行排名第一的那个。委员会输出是建议性(advisory)而非权威性的:窗口外的候选无法被选中,不完整的排序由控制器修复,运营指定的候选保留优先权。
第三步,训练前的记忆门(memory-based gate)。 候选质量用一组从既往实验导出的确定性特征打分:平滑后的历史成功率、期望改进、新颖度、可行性、稳定性、置信度、风险。历史成功项用 $\mathrm{Beta}(1,1)$ 伪计数:
$$ \hat p_{\text{succ}} = \frac{n_{\text{success}} + 1}{n_{\text{attempt}} + 2} \tag{3} $$
以避免过度加权观测极少的方向。论文在此处做了一个罕见的自我降调:
This quantity is only a scoring feature; AutoLR does not sample from a Beta posterior or maintain direction-level posterior state.
即:这只是一个打分特征,AutoLR 不从 Beta 后验采样,也不维护方向级后验状态。被硬记忆约束拦截或低于获取阈值的候选,在启动 GPU 训练前就被拒绝或重选。
路由策略可概括为:
$$ \text{filter} \to \text{diversity-aware window} \to \text{council reranking} \to \text{top-1 execution} \to \text{memory gate} $$
论文随即给出全文最诚实的一段限定:
Accordingly, we characterize AutoLR as a deterministic, evidence-weighted direction selector with diversity constraints and council reranking, rather than as Thompson sampling or a Bayesian bandit. The production corpus evaluates this selector only as part of the integrated AutoLR loop; it does not establish superiority over random, greedy, or direct LLM-based routing under a matched trial budget.
这个选择器不是 Thompson 采样也不是贝叶斯 bandit;生产语料只把它作为整个 AutoLR 闭环的一部分来评估,并未证明它在同等试验预算下优于随机、贪心或直接 LLM 路由。(这句话是后文核验点 3 与 4 的关键锚点。)
2.4 分层知识与实验记忆¶
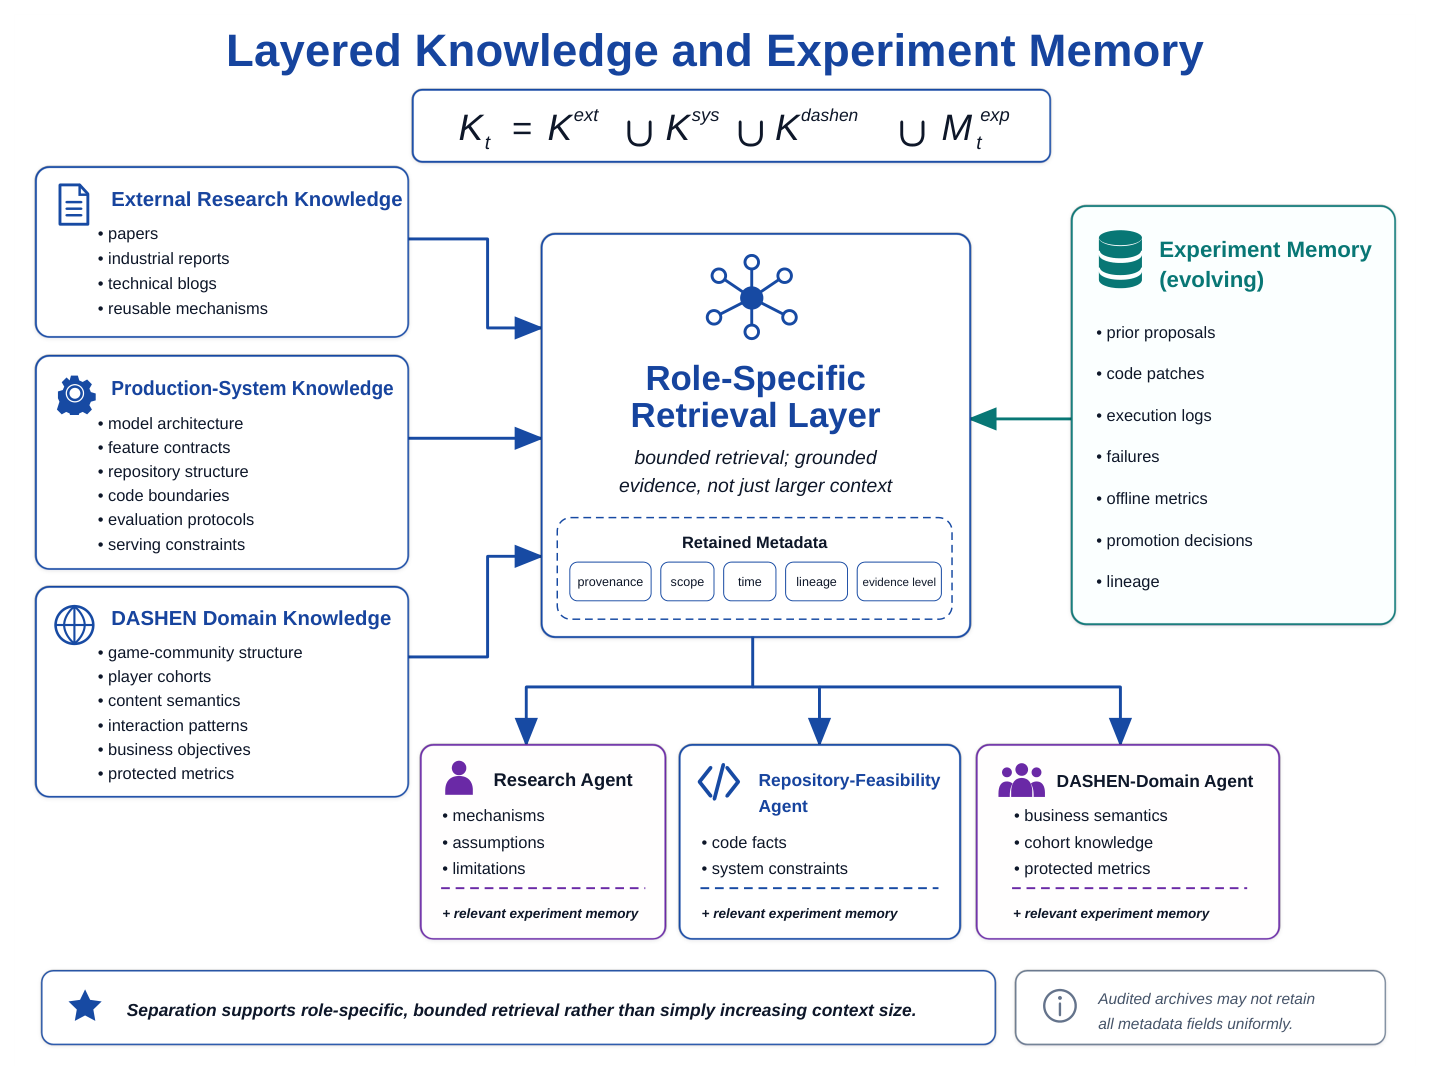
第 $t$ 轮可用知识为:
$$ K_t = K_{\text{ext}} \cup K_{\text{sys}} \cup K_{\text{dashen}} \cup M^{\text{exp}}_t \tag{4} $$
论文明确说式 (4) 的并集是概念性的:四个源保持分别索引、选择性检索,而不是拼进同一个上下文。
| 层 | 内容 | 作用 |
|---|---|---|
| $K_{\text{ext}}$ 外部研究 | 论文、工业报告、技术博客、可复用机制(架构 / 特征交互 / 序列建模 / 多任务 / 损失 / 优化) | 提供机制来源 |
| $K_{\text{sys}}$ 生产系统 | 当前模型架构、特征契约、仓库结构、代码边界、训练与评估协议、serving 约束 | 阻止理论上合理但与生产系统不兼容的提案 |
| $K_{\text{dashen}}$ 领域知识 | 游戏社区结构、玩家行为模式、内容语义、交互模式、业务目标、受保护指标 | 把通用建模想法接到目标场景的特性与目标上 |
| $M^{\text{exp}}_t$ 实验记忆 | 既往假设、提案、代码补丁、执行日志、失败、离线结果、晋升决策及其血缘 | 不仅记录什么起作用,也记录尝试过什么、失败了什么、为什么失败 |
检索是角色特化且有界的:研究 agent 主要收到既往工作的相关机制与局限;仓库可行性 agent 收到代码与系统事实;DASHEN 领域 agent 收到业务与行为知识;委员会检索实验记忆以识别已探索方向、已知失败模式、未解假设。目的是降低上下文稀释、避免重复探索等价想法。保留项还可携带 provenance、scope、time、lineage、evidence level 等元数据——但论文在图注里就先打了预防针:「Audited archives may not retain all metadata fields uniformly.」(被审计的归档未必均匀保留所有元数据字段,这一点在 §5.3 会兑现成硬伤。)
2.5 受约束的实现与执行¶
AutoLR 把实现当作受约束的代码修改而非无约束生成。编辑开始前,每个提案必须声明其意图机制、允许编辑面、预期可观测量、激活检查。
- 只读预飞(read-only preflight):验证被引用的文件与符号存在、所需特征可用、冻结的目标函数或评估逻辑未被修改。未过检的提案在任何长时训练作业启动前就退回修订;
- 实现 agent 只修改声明过的代码面,并产出机器可检查的证据,证明意图机制已被插入且已被激活;
- 确定性基础设施随后在显式超时下运行冒烟测试、训练、推理、指标提取、离线评估;
- 失败按成因分类处理:语义失败(无支撑假设、机制未激活)退回提案生成或实现;可复现的代码或配置失败不做原样重试;瞬时基础设施失败给有界重试。每一个终态(含失败)都被记为结构化实验事件,使后续 agent 能区分「假设无效」与「执行失败」。
2.6 离线晋升与 Launch Review 交接¶
AutoLR 不直接优化 Launch Review 所用的线上业务指标。每个实验会话使用工程师定义的固定离线评估契约:在本文的部署里,点击与观看时长相关的离线指标被合成一个标量代理,而在线 A/B 评估的是内容消费渗透率、总消费时长等下游业务结果。
设 $\mathbf{m}(T)$ 为仓库快照 $T$ 的离线指标向量,标量分数与候选改进为:
$$ s(T) = \mathbf{w}^\top \phi(\mathbf{m}(T)), \qquad \Delta_{s,t} = s(T_t \oplus \pi_t) - s(T_t) \tag{5} $$
其中 $\phi(\cdot)$ 对齐并归一化各构成指标,$\mathbf{w}$ 由会话级评估契约固定。
晋升还要求所有受保护指标满足护栏。设 $\mathcal{G}$ 为受保护指标集,$q_k \in \{-1, +1\}$ 表示指标 $k$ 的偏好方向,$\epsilon_k \ge 0$ 为其允许回退量,候选可行性为:
$$ \mathcal{F}_t = \mathbb{1}\left[\, q_k\big(m_k(T_t \oplus \pi_t) - m_k(T_t)\big) \ge -\epsilon_k, \quad \forall k \in \mathcal{G} \,\right] \tag{6} $$
给定证据完整的评估,控制器指派终态动作:
$$ d_t = \begin{cases} \textsc{Discard}, & \mathcal{F}_t = 0,\\[2pt] \textsc{Keep}_{E1}, & \mathcal{F}_t = 1,\ \Delta_{s,t} \ge \tau_{\text{keep}},\\[2pt] \textsc{Pack}, & \mathcal{F}_t = 1,\ \tau_{\text{pack}} \le \Delta_{s,t} < \tau_{\text{keep}},\\[2pt] \textsc{Discard}, & \text{otherwise}. \end{cases} \tag{7} $$
后缀 $E1$ 明确标记这是一次单跑的离线阈值越过,而非已确认的效应。KEEP 是唯一改写工作仓库的动作;PACK 保留候选及其血缘,DISCARD 拒绝:
$$ T_{t+1} = \begin{cases} T_t \oplus \pi_t, & d_t = \textsc{Keep}_{E1},\\ T_t, & \text{otherwise}. \end{cases} \tag{8} $$
论文补了一句重要的约定:式 (7) 只是对「标量与护栏证据完整」的行的决策契约;历史 payload 缺失不被当作合规。
控制器还实现了一个可选的方差感知 KEEP 边界:
$$ \tau^{\text{impl}}_t = \begin{cases} \max\left(\tau_{\text{keep}},\ \lambda_\sigma \hat\sigma_t\right), & \text{若存在可用的标定 profile},\\ \tau_{\text{keep}}, & \text{否则}, \end{cases} \tag{9} $$
其中 $\hat\sigma_t$ 由一个兼容的重复评估 profile 总结跑间波动。
但是——这是全文最关键的自曝:
In the audited configuration, noise calibration was disabled and no reusable version-matched profile was retained; the controller therefore used the fixed floor $\tau_{\text{keep}}$ rather than blocking KEEP.
在被审计的配置里,噪声标定是关闭的,也没有保留可复用的版本匹配 profile;控制器因此退回固定下限 $\tau_{\text{keep}}$,而不是阻止 KEEP。 论文提出一个更安全的未来协议:当没有兼容标定证据时应延迟持久化晋升,先取得协议匹配的重复评估再提交新主干;这可以用一个不可晋升的 CALIBRATION_REQUIRED 状态表示——但论文明说这是提议的保护措施,不是被审计控制器里已实现的状态。
最后,通过离线评审的候选连同代码、指标、血缘、支撑证据一起打包。工程师决定哪些包进入在线 A/B,Launch Review 仍是全流量的人工闸门。因为被审计的归档没有保留离线候选与在线包之间完整的不可变链路,离线证据与在线证据被分开分析。
三、生产评估¶
3.1 语料与审计方法¶
审计语料覆盖 DASHEN 两个推荐场景(单/双列 feed、沉浸式视频 feed),两者都使用固定的多目标离线评估协议。会话内 AutoLR 在受约束的编辑范围内操作:可以改指定的模型与配置代码,而训练与评估流水线保持固定;架构级改动以新增的、单独验证的模块形式引入,而不是覆写既有生产代码。
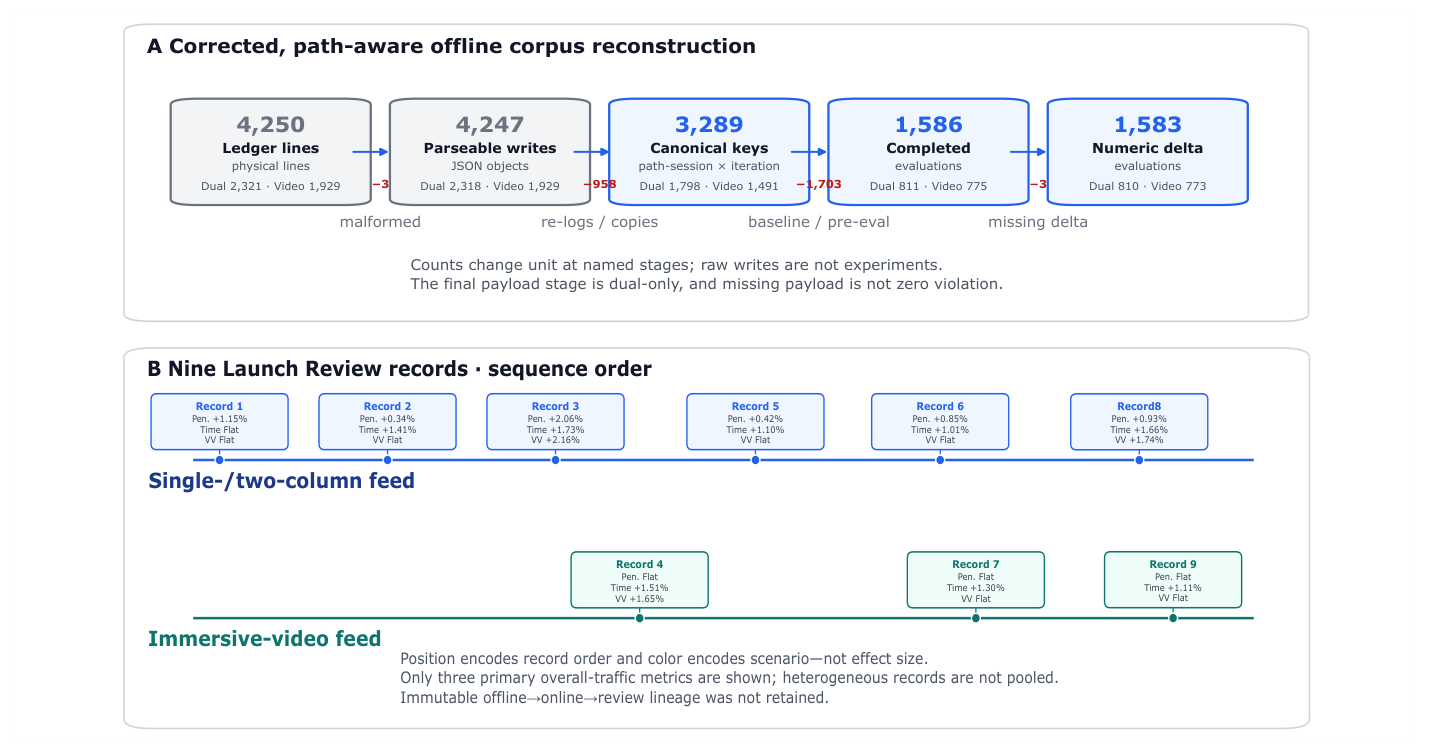
语料重建漏斗(图 7A)——这是本文方法论上最扎实的部分,每一级都标注了单位变化与剔除理由:
| 阶段 | 数量 | 单/双列 | 视频 | 剔除量与理由 |
|---|---|---|---|---|
| Ledger lines(物理行) | 4,250 | 2,321 | 1,929 | — |
| Parseable writes(JSON 对象) | 4,247 | 2,318 | 1,929 | −3,格式损坏 |
| Canonical keys(path-session × iteration) | 3,289 | 1,798 | 1,491 | −958,重复日志 / 拷贝 |
| Completed evaluations | 1,586 | 811 | 775 | −1,703,基线 / 预评估 |
| Numeric delta evaluations | 1,583 | 810 | 773 | −3,缺 delta |
图注里写着一句方法论警句:「Counts change unit at named stages; raw writes are not experiments.」(计数在具名阶段会换单位;原始写入不是实验。)这正是很多 agent harness 论文报「我们跑了 N 千次实验」时含混掉的东西。
不确定性处理:同一实验会话内的评估是相关的(可能共享数据窗口、活跃主干、实验历史),因此论文按场景内整会话重采样(resampling whole sessions)来算不确定性区间,而不是把单条评估行当独立样本。
3.2 三个评估问题¶
- RQ1:在受控制器治理的执行下,AutoLR 支撑了多大规模的常规模型迭代?人的职责与失败如何处理?
- RQ2:在可得的生产 Launch Review 记录中,工程师选中的包报告了什么线上变动?
- RQ3:当一次单跑离线结果就能改变后续实验的基线时,会出现什么可靠性风险?
LLM 成本分析被单独作为运营观察而非研究问题报告,理由是:harness 版本、模型族、任务组合、累积实验记忆在迁移期间一起变了,历史语料不支持把结果因果归因到任何单一因素。
3.3 RQ1:运行规模与常规生产使用¶
AutoLR 在两个场景完成 1,586 次评估。论文的定性判断是:在这两个场景里 AutoLR 已成为常规模型迭代的主要工作流——它执行提案落地、仓库 grounded 实现、训练、离线评估、实验状态更新,而确定性服务掌管「训练—推理—评估」这条关键路径。
工程师的角色被改变而非移除:定义优化目标、评估契约、受保护指标、代码边界;维护生产与领域知识;监督自治闭环;在模糊失败或业务需求变化时介入;保留在线 A/B 准入与全流量放量的权限。人的精力从重复执行转向方向设定、证据质量、系统治理、生产决策。
归档还记录了结构化的失败与恢复事件:不可行提案、机制未激活、冒烟测试失败、超时、训练崩溃。论文明确说明:由于一个候选可能产生多个重试或恢复事件,这些记录只用于刻画失败模式,不能用来估计候选级失败率。最后一句划定了结论边界:
This evidence demonstrates operational robustness, but not the superiority of individual components such as the council or direction selector.
3.4 RQ2:生产 Launch Review 结果¶
Table 1:DASHEN 两个主要推荐场景的九条生产 Launch Review 记录(按序号索引;值为相对同期对照的相对变化;只展示三个主要全流量指标;Flat 表示未报告全流量变动)
| No. | 场景 | 内容消费渗透率 | 总内容消费时长 | 有效内容播放(VV) |
|---|---|---|---|---|
| 1 | 单/双列 feed | +1.15% | Flat | Flat |
| 2 | 单/双列 feed | +0.34% | +1.41% | Flat |
| 3 | 单/双列 feed | +2.06% | +1.73% | +2.16% |
| 4 | 沉浸式视频 feed | Flat | +1.51% | +1.65% |
| 5 | 单/双列 feed | +0.42% | +1.10% | Flat |
| 6 | 单/双列 feed | +0.85% | +1.01% | Flat |
| 7 | 沉浸式视频 feed | Flat | +1.30% | Flat |
| 8 | 单/双列 feed | +0.93% | +1.66% | +1.74% |
| 9 | 沉浸式视频 feed | Flat | +1.11% | Flat |
| 算术加总 | — | +5.75% | +10.83% | +5.55% |
论文的原话是:「metrics not separately disclosed in a review are treated as flat. Under this convention, the arithmetic sums of the relative-lift values are +5.75%, +10.83%, and +5.55%」——未在评审中单独披露的指标按 flat 处理;在此约定下,相对提升值的算术和为 …。摘要里同时补了一句:「These sums are descriptive and are not pooled treatment effects.」(这些和是描述性的,不是合并处理效应。)第四节的核验会展开这句限定到底挡住了多少、又没挡住什么。
跨场景外溢:AutoLR 已迁移到 DASHEN 搜索、用户增长、商业化工作流。搜索与用户增长各完成一次 Launch Review 并有正向线上结果;商业化完成初步探索,取得明确的离线 AUC 提升,线上验证进行中。论文自己限定:更强的迁移有效性主张需要完整血缘与场景特定的在线评估。
3.5 RQ3:离线晋升的可靠性¶
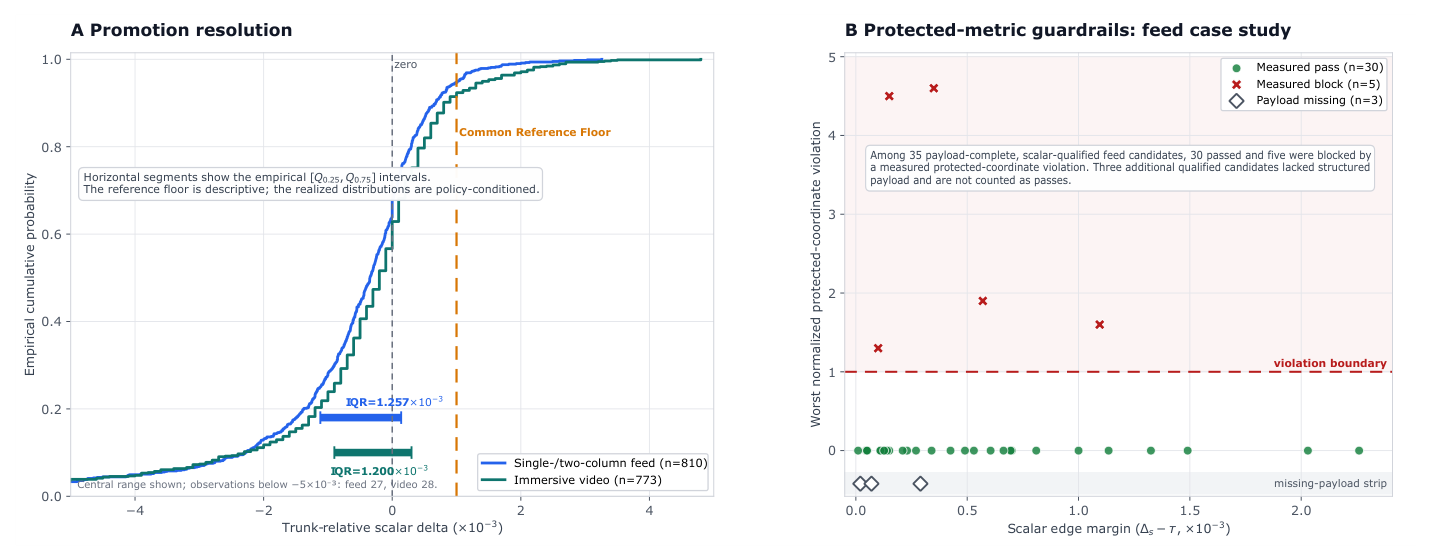
晋升分辨率与阈值来源。 因为历史阈值来源(threshold provenance)不完整,论文回放一个公共参考下限 $\tau_{\text{ref}} = 10^{-3}$,而不把它当作每次评估的实际操作阈值。对每个场景计算主干相对标量 delta 的经验四分位距:
$$ \mathrm{IQR}(\Delta_s) = Q_{0.75}(\Delta_s) - Q_{0.25}(\Delta_s) \tag{10} $$
Table 2:晋升分辨率统计
| 量 | 单/双列 feed | 沉浸式视频 |
|---|---|---|
| 数值标量 delta 数 | 810 | 773 |
| $\mathrm{IQR}(\Delta_s)$ | $1.257 \times 10^{-3}$ | $1.201 \times 10^{-3}$ |
| 参考下限越过率 | 4.7% | 8.5% |
| 观测 KEEP 比例 | 3.82% | 5.03% |
| 观测 PACK 比例 | 12.58% | 7.35% |
| 有记录的阈值来源 | 480 | 0 |
这张表是全文信息量最大的一张。 三点解读:
- 参考下限与候选 delta 分布的中心离散度同量级($10^{-3}$ vs $1.2\text{–}1.26 \times 10^{-3}$)。也就是说,晋升阈值坐落在候选结果分布的体内而非尾部。论文自己说:IQR 概括的是「异质候选结果的离散度」而非「协议特定的跑间噪声」,因此不能据此确立统计显著性、最优阈值、或无来源记录行的实际历史阈值;
- KEEP 比例(3.82% / 5.03%)低于参考下限越过率(4.7% / 8.5%),说明护栏与记忆门确实拦掉了一部分越线候选;但两者的接近也说明标量 delta 是晋升的主导因素;
- 沉浸式视频场景的阈值来源记录为 0。这意味着该场景 773 条 delta 的晋升分析完全建立在一个被回放的、无来源的参考下限之上——论文的谨慎措辞在这里落到实处,但也意味着一半的语料在晋升可靠性这个议题上几乎没有可审计的证据。
论文还提醒:观测到的 delta 分布是策略条件化(policy-conditioned)的,因为每一次被接受的 KEEP 都改变了后续候选被评估时所对的主干。
标定缺口与可变基线风险。 由于噪声标定被关闭且无版本匹配 profile,控制器退回固定下限。在这个配置下,一次单跑阈值越过就能在没有协议匹配确认跑的情况下更新实验主干。论文明确划定证据边界:归档确立了这个可变基线机制的存在,但无法识别观测到的进展或漂移中有多少来自真实模型改进、候选质量变化、收益递减、或累积的选择噪声。
受保护指标护栏(图 8B)。 结构化护栏 payload 只在单/双列 feed 归档的一个子集里可恢复,沉浸式视频没有等价结构化 payload。在可恢复子集内:35 个 payload 完整、标量合格的 feed 候选中,30 个通过,5 个被实测的受保护坐标违规拦下;另有 3 个合格候选缺结构化 payload,不计为通过。论文强调这是场景特定的案例研究而非全语料估计。
3.6 成本迁移(运营观察)¶
常规 AutoLR 迭代从 Claude Opus 级模型迁移到 DeepSeek-V4-Pro/Flash 混合栈,在每次迭代 RMB 3–4 的观测 LLM API 成本下稳定运行(不含模型训练算力与内部基础设施;按 2026 年 8 月 17 日之前生效的 API 价格计算)。
值得指出的是:这个数字在摘要、引言、§4.2、结论各出现一次,但正文没有任何一节展开它——没有 token 用量、没有按阶段(委员会 / 实现 / 诊断)的成本拆分、没有迁移前后的成本对照、也没有迁移是否影响了提案质量或成功率的任何数据。论文自己在 §4.2 与 §6.2 都承认这是观察性的、不支持因果归因。
四、消融与独立核验¶
4.1 本文没有任何消融实验¶
这一点需要单独说清:AutoLR 全文不包含一个消融实验,也不包含任何对照组。 论文在三处主动承认:
- §3.3:选择器「不能确立在同等试验预算下优于随机、贪心或直接 LLM 路由」;
- §5.1:证据「展示了运行鲁棒性,但不是委员会或方向选择器等单个组件的优越性」;
- §6.2:「The archive lacks matched-budget ablations, broad fixed-snapshot repeats, complete threshold and guardrail provenance, and immutable offline-to-online lineage.」(归档缺少同预算消融、广泛的固定快照重复、完整的阈值与护栏来源、以及不可变的离线到在线血缘。)
因此以下三个自然问题全部无解:委员会辩论相对单 agent 提案值多少?证据加权选择器相对随机选方向值多少?分层知识与实验记忆相对把所有上下文拼在一起值多少?
4.2 核验一:这是工程流程还是方法贡献?¶
判定:主体是工程与运营贡献,方法贡献只有一项且未经实现验证。
按「工业系统介绍/经验分享类若披露真实架构设计、踩坑经验、规模化细节可以高分」这条判据逐项对照:
真实披露的部分(加分):
- 委员会四阶段协议写到了角色清单、冻结简报、blind first pass、steelman、challenge agent 不投终票这一级;
- 选择器的五步路由策略(filter → 多样性窗口 → 委员会重排 → top-1 执行 → 记忆门)写到了轮转调度、机制/方向配额上限、保留名额这一级,并明确了「委员会只有建议权」的权限边界;
- 晋升契约用式 (5)–(9) 完整给出,包括 KEEP/PACK/DISCARD 三态与「PACK 保留候选但不改主干」这个降低棘轮风险的设计;
- 失败分类策略(语义失败退回、可复现失败不原样重试、瞬时失败有界重试)具体可操作;
- 语料重建漏斗把每一级剔除量和理由都列出来,并声明「原始写入不是实验」。
踩坑经验(本文最有价值的部分):KEEP 棘轮。而且论文不是把它当作一个抽象风险来讲,而是自曝自己的生产配置里噪声标定是关闭的,方差感知 KEEP 边界式 (9) 的 profile 分支从未被激活,控制器一直用固定下限。同时给出 Table 2 说明这个固定下限与候选 delta 分布的 IQR 同量级。一篇宣称流程自动化成功的论文,主动给出「我的晋升门槛可能落在噪声里」的证据,这在同类 harness 论文里是少见的。
没有披露的部分(扣分):
- $\tau_{\text{keep}}$、$\tau_{\text{pack}}$、$\lambda_\sigma$ 的具体数值一个都没有;
- 记忆门七个打分特征(历史成功率、期望改进、新颖度、可行性、稳定性、置信度、风险)的组合方式与权重完全未给,获取阈值也没给。因此式 (3) 之外,这个「证据加权选择器」的实际形式是不可复现的;
- 委员会用了几个 agent、每个用什么模型、上下文预算多少、单轮委员会耗时多少,都没有;
- $\phi(\cdot)$ 如何对齐归一化、$\mathbf{w}$ 是什么,没有;
- 迭代吞吐(每天/每周多少次评估)、单次迭代的 wall-clock,没有。
方法贡献的定位:论文自己写得很清楚——「We therefore do not claim that AutoLR introduces a uniquely long automation pipeline or a unique division of authority.」(我们并不主张 AutoLR 引入了一条独一无二的长自动化流水线或独特的权限划分。)它的实验记忆对应 Google 的 experiment journal 与 AgentX 的累积实验知识;它的选择器概念上对应 RecHarness 的「方向选择与具体变异解耦」;它的确定性控制器遵循 NOVA 与 PILOT 已有的「模型生成的提案必须过机器强制的门」原则。唯一称得上方法贡献的是 KEEP 棘轮的形式化与「fail-closed 标定」这一治理原则——而后者在被审计系统里没有实现(CALIBRATION_REQUIRED 是提议状态而非已实现状态)。
所以结论不是「没有新模型所以压分」,而是:在它自选的赛道(工业经验披露)上它表现良好,但它把自己的核心机制主张(委员会 + 证据加权选择器带来收益)完全建立在无对照的整体部署叙事上,而这两个机制恰恰是它列为贡献 (2) 的东西。
4.3 核验二:那些线上收益数字是「算术加总」——具体是什么意思、站不站得住¶
判定:是的,就是把 9 次不同实验的相对提升逐列直接相加;作为累计收益在统计上不成立,论文自己也不主张它是合并处理效应,但把它放进摘要加粗仍然是一个会诱导误读的呈现选择。
先复核算术本身(Table 1 逐列相加):
- 渗透率:$1.15 + 0.34 + 2.06 + 0 + 0.42 + 0.85 + 0 + 0.93 + 0 = 5.75$ ✓
- 消费时长:$0 + 1.41 + 1.73 + 1.51 + 1.10 + 1.01 + 1.30 + 1.66 + 1.11 = 10.83$ ✓
- VV:$0 + 0 + 2.16 + 1.65 + 0 + 0 + 0 + 1.74 + 0 = 5.55$ ✓
确认无误:这就是 9 次独立 Launch Review 记录的相对提升值的逐列直接求和。它站不住的理由有六条,按严重程度排:
- 跨场景相加。9 条记录里 6 条来自单/双列 feed,3 条(记录 4、7、9)来自沉浸式视频 feed。两个场景是不同的产品表面、不同的流量池、不同的分母。视频 feed 的 +1.51% 消费时长与 feed 的 +1.41% 不是同一个量的 1.41%,把它们加进同一个 +10.83% 里,这个和不对应任何一个可测量的业务量;
- 各实验基线不同,相对提升不可加。每条记录是对同期对照的相对变化,而这些同期对照分布在几个月里、彼此不同。第 $k$ 次上线的分母是已经包含了前 $k-1$ 次改动的线上系统。即便退一步用乘法复合($\prod(1+\delta_i) - 1 \approx 5.87\%$ 渗透率),也只在「各次效应独立且不交互」这个未经检验的假设下才有意义,而在成熟推荐系统里收益递减与效应重叠恰恰是常态;
- Flat 被当作精确的 0 补齐。论文的约定是「未在评审中单独披露的指标按 flat 处理」。渗透率列 9 格里 4 格是 Flat,VV 列 9 格里 5 格是 Flat。这是按约定的缺失值填补,不是测量结果——一个未披露的指标既可能真的持平,也可能是负向、或干脆没测。把它编码为 0 之后,这三个和一半以上的格子不是数据;
- 没有任何不确定性量化。论文 §6.2 自陈:「The available online evidence consists of summarized relative changes rather than full randomization records, confidence intervals, or candidate denominators.」——没有随机化记录、没有置信区间、没有候选分母。因此这三个和既没有联合置信区间,连每一项自己的置信区间都没有;
- 选择性报告(胜者诅咒)。展示的是 9 条已经进到 Launch Review的记录。有多少候选进了在线 A/B 却没能到 Launch Review?论文没给(「candidate denominators」正是它承认缺失的东西之一)。这是一个 selected-on-success 样本,其平均效应必然向上偏;
- 与离线证据之间没有链路。这一条最致命,见下节。
公允之处:论文确实在摘要、图 7B 图注、§5.2 三处标注了「descriptive」「not pooled treatment effects」「heterogeneous records are not pooled」。它没有在文字上主张这是累计收益。但它把三个加总数字用加粗放进摘要(+5.75% / +10.83% / +5.55%),这是全篇唯一以粗体呈现的量化收益;任何只读摘要的读者都会把它当作 AutoLR 带来的总体线上收益。免责声明与呈现方式在这里是背离的。
4.4 核验三:有没有对照组?¶
判定:完全没有。不仅没有人工评审的历史基线,甚至连前后对比都没有。
逐条核验可能的对照形式:
| 可能的对照 | 本文是否提供 | 证据 |
|---|---|---|
| 人工工程师历史基线(AutoLR 上线前每季度多少次上线 / 多少人时) | 无 | 全文未出现任何 AutoLR 之前的吞吐、人时或上线数字 |
| 简单前后对比(同一团队、同一场景、启用前 vs 启用后) | 无 | 论文只说「已成为常规迭代的主要工作流」,无任何时间序列或分期统计 |
| 组件消融(有/无委员会、有/无证据加权选择器、有/无分层知识) | 无 | §6.2 明言 lacks matched-budget ablations |
| 替代路由策略(随机 / 贪心 / 直接 LLM 路由)同预算对比 | 无 | §3.3 明言 does not establish superiority over random, greedy, or direct LLM-based routing under a matched trial budget |
| 与其他 harness(AgentX / NOVA / RecHarness)的可比实验 | 无 | 只在 related work 做定位性区分 |
| 离线固定快照重复跑(用于估计噪声、校准阈值) | 无 | §6.2 明言 lacks broad fixed-snapshot repeats |
因此,标题里的 "Automating the Path from Research to Launch Review" 所隐含的加速主张,在全文里没有被任何形式的比较量化过——不是「只有前后对比」这种弱证据,而是连前后对比都没有。这是一个单臂(single-arm)描述性报告。
更严重的是归因链的断裂:论文两次说明离线与在线证据被分开分析,原因是「the audited archive does not retain complete immutable linkage between offline candidates and online packages」,图 7B 图注也写着「Immutable offline→online→review lineage was not retained」。这意味着:
本文的两个头条数字——1,586 次离线评估、9 条 Launch Review 线上收益——在被审计的归档里无法互相归因。
即:无法验证那 9 次上线的候选,是不是由 AutoLR 的委员会 + 选择器 + 记忆门这套机制筛出来的那些离线候选。叙事上它们当然是(AutoLR 是这两个场景的主要工作流),但论文自己设立的审计标准恰恰不允许这个推断——它对自己的离线语料坚持「path-aware 去重、原始写入不是实验、缺 payload 不算合规」这种严格性,却在离线→在线这一跳上只能依赖叙事。这是全文最大的内部不一致:审计的严格性没有延伸到最关键的那条因果链上。
4.5 核验四:按「引入新信号 ≠ 收益来源」核验¶
本文的「新信号」是三件:委员会辩论、证据加权选择器(含记忆门七特征与式 (3) 的 Beta 平滑)、分层知识 + 实验记忆。按该判据核验:
- 三者与收益之间没有建立任何因果链接(4.1、4.4 已述),全部是打包在整体部署里的相关性叙事;
- 更进一步,连「离线标量 delta 提升 → 真实模型改进」这个更基础的一环都没有建立:$\tau_{\text{ref}} = 10^{-3}$ 与 delta 分布的 IQR 同量级($1.2\text{–}1.26 \times 10^{-3}$),噪声标定关闭,无重复评估 profile,因此无法区分一次 KEEP 是真改进还是有利噪声。论文自己承认无法估计假晋升率(false-promotion rate)。也就是说:驱动主干变更的那个信号,其有效性本身是未验证的;
- 成本迁移这个「运营新信号」同样被论文自己判定为不可归因:harness 版本、模型族、任务组合、累积记忆同时改变,RMB 3–4/iteration 无法归因到 DeepSeek 迁移这一因素;
- 反向证据的可信度反而更高:护栏案例研究(35 个标量合格候选中 5 个被受保护指标违规拦下)确实说明护栏在起作用——这是全文唯一一个有具体分子分母的机制级证据,但它只覆盖一个场景的一个子集,且论文明确说不是全语料估计。
结论:本文引入的三个机制都没有被证明是收益来源;而论文的诚实之处在于,它在三个不同章节主动说出了这一点,并没有把相关性包装成因果。
五、核心贡献总结¶
- 一份 Launch-Review 为终点的纵向生产研究:在网易 DASHEN 的两个核心推荐场景把「研究 → 离线候选打包」这段路径交给自治 harness,几个月运行、1,586 次完整评估、9 条 Launch Review 记录、并外溢到搜索 / 用户增长 / 商业化。
- 一套清晰的权限划分与晋升契约:LLM 只出提案、控制器独占状态转移;KEEP / PACK / DISCARD 三态 + 非补偿性护栏(式 (6)–(8)),其中 PACK 的设计(保留候选但不改主干)是对棘轮风险的直接缓解。
- KEEP 棘轮的命名与证据化,以及配套的 fail-closed 治理原则:无兼容标定证据时应延迟持久化晋升。这是本文最可迁移的贡献。
- 一套可借鉴的审计方法论:路径感知去重、按会话(而非按行)重采样算不确定性、「缺 payload 不算合规」、「原始写入不是实验」。
与已归档相关工作的对比¶
CORAL CORAL: An LLM-Native Harness for Production Recommender Systems(Meta AI, 2026-09-02)¶
关系:独立并发(本文未引用 CORAL,投稿相差两天,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两者对根因的诊断几乎逐字同构。CORAL 说「progress scales with the number of engineers and experiments rather than with the size of the opportunity」(进展随工程师人数与实验次数扩张,而非随机会空间扩张);AutoLR 说瓶颈是「research、code、training platforms、logs、metrics、business decisions 之间反复的交接」。两者都拒绝了「换更强基座模型」这个答案,都把答案定位在LLM 之外的那层 harness——上下文、工具、闭环、记忆、权限。两者也都把 LLM 移出用户请求路径,只让它在元层面动作。
- 相近的技术骨架:把两篇的方法流程图叠起来几乎重合——(i) 一个持久化记忆存放「我上次改了什么 / 结果如何」;(ii) LLM 在有界证据上提出一个受限的变更提案;(iii) 一个确定性组件对提案行使最终权力(CORAL 是把提案投影到预算可行集的约束优化器,AutoLR 是执行式 (6)–(8) 晋升契约的控制器);(iv) 实测结果写回记忆,闭合回路。连「LLM 输出是建议、控制流硬编码」这一条都相同:CORAL 每周期按固定顺序调工具而不把控制流交给模型,AutoLR 的委员会重排是 advisory、窗口外候选不可选。
- 本文的差异与推进:作用的对象不同,这个差异决定了风险结构。CORAL 动的是控制面参数(各召回源的候选预算份额、各人群的服务算力档位),改动可被下一周期覆盖、可逆、且被约束优化器按构造保证预算可行;AutoLR 动的是代码仓库主干,一次 KEEP 后所有后续候选都在新主干上生成与评估,不可逆且会污染未来所有比较。AutoLR 恰恰因此产出了 CORAL 结构上不会遇到的洞见(KEEP 棘轮),并给出了 PACK 这个「保留候选但不改主干」的中间态。反过来,CORAL 的约束优化器给出了可证明的可行性保证,而 AutoLR 的方差感知阈值式 (9) 在被审计配置里根本没启用——同样是「确定性组件兜底」,CORAL 兜住了硬约束,AutoLR 该兜的那个统计约束是空的。
- 可比的方法 / 实验差异与证据强度:两篇的证据缺陷高度同构,都是零消融、零基线、无 p 值/CI。但错的方式不同:CORAL 的对照组是「久未复核的陈旧手工配置」(论文自陈系统会在两次干预之间漂离最佳工作点),所以它的收益至少可能来自「重新调过参」而非 LLM;AutoLR 连这样一个隐含对照都没有,是纯单臂描述。呈现上 CORAL 给出了两个部署的具名指标变动(watch time +0.15% / sessions +0.16%、年化数百万美元成本节省),每个都对应一次真实 A/B;AutoLR 给出的是 9 次 A/B 的跨场景算术和,可比性反而更差。另一方面 AutoLR 的架构披露度明显高于 CORAL(CORAL 连约束优化器是 LP、二次投影还是水填充都没写,所用 LLM 也未披露),且 AutoLR 的语料审计(4,250 → 1,586 逐级剔除)在认识论严格性上没有对应物。归档给 CORAL 的精读分是 6。
AgentX AgentX: Towards Agent-Driven Self-Iteration of Industrial Recommender Systems(Kuaishou, 2026-06-25)¶
关系:显式引用([18])但原文未展开对比(仅在 §1、§2.2 各一句定位)· 已加载对方精读
- 共同关注的问题:两者是本轴上最接近的一对——都要把工业推荐的 idea-to-launch 全闭环自动化,都把根因定位在「迭代吞吐被工程师人数与认知负载约束」,都强调线上 A/B 才是最干净的成功信号。
- 相近的技术骨架:AgentX 的 Brainstorm → Developing → Evaluation → Harness Evolution 与 AutoLR 的 Council → Selector → Implementation → Promotion 逐段对应。更细的对应也成立:AgentX 的 intake boundary(primary objective / allowed scope / forbidden changes / known guardrails)≈ AutoLR 的 task contract;AgentX 的 avoid set + 残差批循环 ≈ AutoLR 的实验记忆 + 多样性窗口;AgentX 坚持「指标由原始训练日志确定性提取而非 LLM 解读」≈ AutoLR 的「确定性控制器掌管指标提取」;AgentX 的 Model Research 层把论文分解为 typed claims 并用同一 schema 表示生产 baseline ≈ AutoLR 的 $K_{\text{ext}} + K_{\text{sys}}$ 分层。
- 本文的差异与推进:AutoLR 的自治止步于离线打包,在线 A/B 准入与 Launch Review 由人把关;AgentX 的 Evaluation Agent 自己管理灰度与流量分配、用 guardrail veto 判 A/B 结果,自治边界推得更远。反过来,AutoLR 在离线晋升的统计风险上想得更细:AgentX 的 incumbent 晋升同样存在可变基线问题,但它没有命名这个失效模式,也没有提出方差感知阈值或 fail-closed 标定;AutoLR 把它形式化为 KEEP 棘轮并给出 PACK 中间态。这是 AutoLR 相对 AgentX 唯一实质性的方法推进。
- 可比的方法 / 实验差异:证据强度上 AgentX 明显更强——它有可数的漏斗(三周三 worker 把 374 个想法转成 10 次上线)、有归因到单场景的线上收益(主 feed app 时长 +0.561%、生活服务年化收入超 1 亿元)、有 SGPO 的 paired replay 准入机制、有与单个人工工程师的对照(虽然样本小)。AutoLR 三者皆无:没有想法→上线的转化漏斗,没有单次上线的独立归因(只有跨场景加总),没有任何形式的对照。归档给 AgentX 的精读分是 8。
RecHarness RecHarness: A Bandit-Routed Agentic Harness for Self-Evolving Recommender Systems(Georgia Tech + Kuaishou, 2026-07-31)¶
关系:显式引用([21])但原文未展开对比(§1、§2.2 各一句,另在 §2.3 借它佐证棘轮可发生于任何 incumbent 晋升系统)· 已加载对方精读
- 共同关注的问题:两者都认为「在有限试验预算下,不能让 LLM 同时自由决定往哪个方向搜和该方向内具体改什么」,都把方向选择与代码变异解耦。这是两篇在方法层面最直接可比的一点,也正是 AutoLR 的贡献 (2)。
- 相近的技术骨架:RecHarness 的三级控制(人定义上下文 → Bandit Router 分配预算 → Experiment Skill + LLM 在选定 arm 内变异)与 AutoLR 的(task contract → 证据加权选择器 → 委员会 + 实现 agent 在选定方向内提案)一一对应。两者都维护「标量证据」与「文本证据」两条分离的回流通道:RecHarness 让标量分数更新 Beta posterior、文本教训只更新 Experiment Skill,并明确「文本总结不会暗中覆盖路由器积累的统计证据」;AutoLR 让数值结果更新历史证据、日志与失败原因条件化后续提案生成。
- 本文的差异与推进——这一处对 AutoLR 不利:RecHarness 用的是真正的 Thompson 采样(每个 arm 维护 $\mathrm{Beta}(\alpha_a, \beta_a)$,式 (11)–(13) 从后验采样取 Top-$G$),并配了组内归一化成功信号(式 (9)–(10),incumbent-conditioned,不假设 arm 成功率固定)与 basin-aware jump(式 (15)–(17),局部改进速率低于阈值才开放结构跳跃,且跳跃候选经最多 $R$ 轮局部重调后才裁决)。AutoLR 则明确声明自己不是 Thompson 采样、不从 Beta 后验采样、不维护方向级后验状态——式 (3) 的 $\mathrm{Beta}(1,1)$ 只是记忆门七个特征之一,而这七个特征如何组合、权重多少完全未披露。也就是说,在两篇共同的核心机制上,AutoLR 的版本是更弱、更不可复现的那个:一个不透明的确定性打分启发式,替代了一个有明确后验语义的 bandit。
- 可比的方法 / 实验差异:RecHarness 有跨两类任务、六个公开/工业数据集、八种骨干的完整实验,有路由消融与搜索效率分析,并有快手短视频广告 7 天 A/B(ADVV +2.084% / Revenue +0.534% / Exposure +0.559%),且线上收益能追溯到具体是哪个 jump arm(
sequence_encoder_upgrade)产出的哪个结构改动。AutoLR 既无公开数据集实验,也无路由消融,且线上收益无法追溯到任何具体候选。AutoLR 相对 RecHarness 的唯一优势是运行规模与真实生产语料的纵向长度(1,586 次评估、几个月、两个场景 + 三个外溢场景)。 归档给 RecHarness 的精读分是 8。
讨论与局限性¶
值得借鉴的设计¶
- 「LLM 的输出是提案,不是状态转移」。这条原则被贯彻到具体机制:委员会重排是 advisory、窗口外候选不可选、不完整排序由控制器修复、指标由确定性服务提取。这是长时程自治系统的正确骨架。
- PACK 这个中间态。大多数自进化 harness 只有「接受 / 拒绝」两态,因此一个边缘候选要么污染主干要么丢失。PACK 保留候选与血缘但不改主干,把「保存价值」与「改变参照系」这两件事解耦。这是一个成本极低、收益明确的设计。
- fail-closed 标定原则。「无兼容标定证据时,持久化晋升应当失败关闭」是可直接搬到任何 incumbent 晋升系统的治理规则——包括 RecHarness 的 incumbent 替换与 AgentX 的候选晋升。
- 审计方法论:路径感知去重(4,250 → 3,289 → 1,586)、按会话重采样、「缺 payload 不算合规」、「原始写入不是实验」。任何要报「我们跑了 N 次实验」的 harness 论文都应照此做一遍。
- 架构级改动以新增的、单独验证的模块引入,而非覆写既有生产代码——一条务实的生产工程约束。
局限与争议¶
- 零对照、零消融(4.1、4.4)。标题隐含的「加速研究到上线」这个主张,全文没有任何形式的比较量化,连前后对比都没有。委员会与选择器这两个自述贡献,其价值完全未经检验。
- 两个头条数字互不可归因(4.4)。1,586 次离线评估与 9 条线上 Launch Review 之间没有不可变血缘,论文只能分开分析。这与它对离线语料的严格审计标准自相矛盾。
- 算术加总的呈现问题(4.3)。跨两个场景、跨不同基线、Flat 按 0 补齐、无 CI、选择性报告——六重问题叠加。论文在文字上做了免责,但把加总数字加粗放进摘要,实际效果是诱导读者当作累计收益读。
- 驱动主干变更的信号本身未验证(4.5)。$\tau_{\text{ref}} = 10^{-3}$ 与 delta 分布 IQR 同量级、噪声标定关闭、无重复评估 profile → 无法估计假晋升率。KEEP 棘轮不只是一个被识别的风险,它在被审计的这套配置里是处于激活状态的。
- 关键超参与机制细节缺失:$\tau_{\text{keep}}$ / $\tau_{\text{pack}}$ / $\lambda_\sigma$ 的值、记忆门七特征的权重与获取阈值、$\phi$ 与 $\mathbf{w}$ 的形式、委员会 agent 数量与所用模型——全部未披露。「证据加权选择器」实际上不可复现。
- 半数语料在核心议题上无证据:沉浸式视频场景的阈值来源记录为 0,结构化护栏 payload 完全没有保留。护栏证据只是单场景 35 个候选的案例研究。
- 成本主张无正文支撑:RMB 3–4/iteration 出现四次但没有任何一节展开,无 token 用量、无阶段拆分、无迁移前后对照,且论文自陈不可因果归因。
- 方法论可扩展性的隐忧:AutoLR 的自治边界止于离线打包,向在线 A/B 与放量延伸的路径上,KEEP 棘轮的类比风险会升级为「自动放量棘轮」。论文自己也说,正因为在线准入仍由人把关,当前的直接风险只是「搜索有效性退化与试验预算浪费」而非自动上线劣化模型——这句话反过来说就是:一旦按论文的长期目标把自治推到 Rollout,现有的证据强度不足以支撑那一步。
与已有工作的差异(小结)¶
AutoLR 在这条轴上的定位是清晰的:它不是这条轴上最自治的(AgentX 已自管灰度与 A/B 裁决),不是机制最扎实的(RecHarness 的 bandit 路由有明确后验语义与消融),也不是唯一作用于生产系统的(CORAL 直接下发线上配置)。它的独特贡献是纵向长度 + 自审计诚实度 + 一个被命名并证据化的失效模式。如果把这条轴上的四篇当作一个整体来读,AutoLR 提供的是「治理」这一维的反面教材式实证:它把自己该做而没做的那件事(噪声标定)写了出来,并用 Table 2 说明了不做的后果有多大。 这份诚实的价值,恰好抵消了它在证据强度上的短板的一部分——但也仅仅是一部分。