TurboGR: An Accelerated Training System for Large-Scale Generative Recommendation¶
Huichao Chai, Zhixin Wu, Xuemiao Li, Shiqing Fan, Hengfeng Wang, Maojun Peng, Lu Xu, Yaoyuan Wang, Yibo Jin, Wei Guo, Yongxiang Feng(通讯作者)。Huawei。arXiv 2605.13433v1 [cs.DC],2026-05-13。
研究动机与背景¶
从 DLRM 到 GR:范式换了,瓶颈也换了¶
工业推荐系统长期受困于"一个场景一套模型"的架构碎片化:为适配具体业务,模型被堆上大量场景专用结构,既难以泛化,又把底层软件栈切得七零八落。这种复杂度进一步阻碍了硬件层面的效率优化,使传统深度学习推荐模型(DLRM)的 Model FLOPs Utilization(MFU)长期处于低位。
生成式推荐(Generative Recommendation, GR)以统一的 Transformer 架构取代场景专用结构,显著降低了场景工程量,并表现出 scaling-law 行为——模型质量随数据与算力系统性提升,论文给出的经验形式为:
$$Q(C) \approx Q(C_0) + s \log_4(C / C_0) \tag{1}$$
其中 $Q(C)$ 表示相对固定基线的 LogLoss 相对改进,$s$ 是算力复杂度每提升 $4\times$ 所带来的增益。由于 GR 主干(如 HSTU)本质是 Transformer,LLM 训练侧积累的优化手段(稀疏注意力、MoE、DeepSpeed 等)可以迁移过来,这使得 GR 的 MFU 在原理上比 DLRM 更容易优化。
但这条 compute-bound 的 scaling 路线反过来要求底层基础设施足够高效——而这正是问题所在。
Ascend NPU 上的两道硬件-软件鸿沟¶
论文指出,现有开源仓库与配套优化策略几乎全部是 GPU 导向的,直接搬到 Ascend NPU 上会严重掉性能,原因有二:
- 算子缺失:jagged tensor(变长张量)相关算子在 NPU 上没有高性能实现;
- 非稠密原语低效:sorting、top-k、masking 这类细粒度不规则并行原语在 GPU 上被高度优化,但 Ascend NPU 的架构是围绕稠密矩阵计算设计的,这些原语在其上效率低下。
换句话说,问题的 root cause 不是模型不好,而是不规则稀疏原语与稠密加速器架构之间的结构性失配。这些缺失与非稠密算子需要系统性的算法重构,才能把 NPU 的算力真正吃满。
三大挑战的量化刻画¶
论文在第 4 节开头把挑战形式化为三条,每条都给了实测数字:
Challenge 1:Vector-Bound 计算与 Jagged 冗余。 GR 训练中大量的 unique、gather、hash 算子用于稀疏计算,导致向量计算占总算子数的 80% 以上。同时用户序列服从长尾分布,jagged tensor 里塞满 padding,造成超过 50% 的计算冗余。在为稠密矩阵计算优化的 Ascend NPU 上,这类 vector-bound + 不规则操作使中小模型的 MFU 跌破 10%。
Challenge 2:稀疏-稠密通信瓶颈。 在 GR 中,稀疏参数与稠密参数都按 scaling law 一起增长。embedding 表通过模型并行切分到各设备,而稠密 Transformer 主干需要数据并行的梯度同步。这种耦合迫使系统同时承担复杂的集合通信(embedding 分发的 all-to-all、梯度交换)与多级缓存,在大规模集群训练中把分布式线性度压到 0.6 以下。
Challenge 3:内存密集的负采样。 长序列上的 token 级负采样要求每张 NPU 常驻一个巨大的负样本 embedding 张量。论文给的算例是:batch size 8、序列长度 8192、embedding 维度 1024、128 个负样本,则负样本 embedding 单独就吃掉
$$8 \times 8192 \times 1024 \times 128 \times 4\ \text{bytes} \approx 34\ \text{GB} \tag{2}$$
使 HBM 利用率低于 50%,在显存约束下严重限制可扩展性。
TurboGR 的定位由此确定:一个 Ascend-affinity 的 GR 训练系统,不改模型、只改承载模型的基础设施,并且是首个面向 Ascend NPU 开源的 GR 系统。
核心方法 / 系统架构¶
分层设计¶
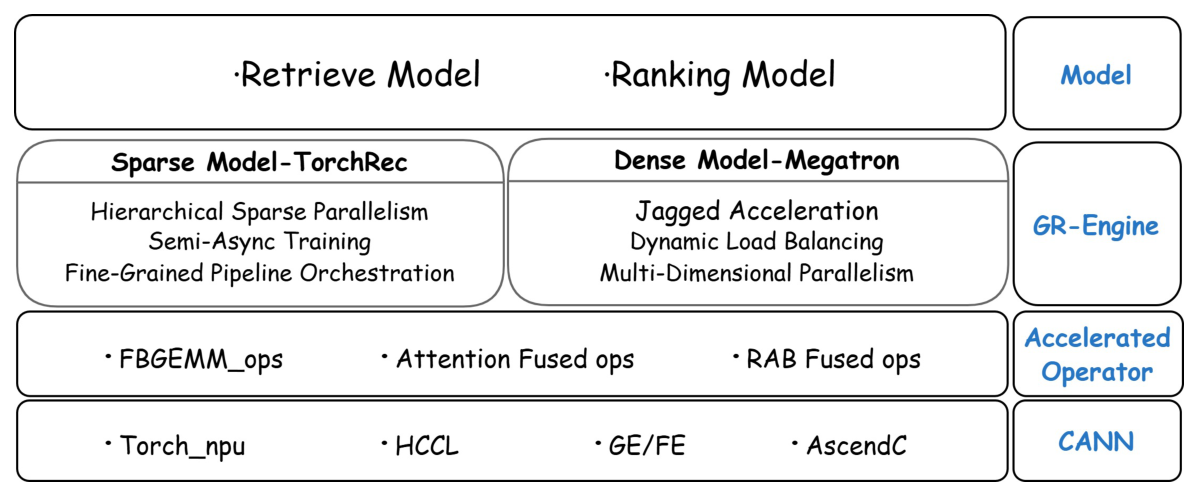
TurboGR 的整体架构(Figure 1)按模块化分层组织,自上而下为:
- GR-Engine:核心基础设施引擎,承载大规模分布式训练所需的各项优化。具体做法是把 TorchRec(稀疏模型并行)与 Megatron(稠密多维并行)移植到 Ascend NPU 环境,并改造其通信后端使之更贴合 Ascend 硬件特性。
- Accelerated Operators:一套为 Ascend NPU 定制的高性能算子,绕开标准算子库的限制。包括用于 attention 与 relative attention bias(RAB)计算的 jagged 融合算子、降低标量开销并改善 cache 局部性的 jagged embedding lookup kernel,以及其他 NPU 亲和的算子适配。这一层通过深度利用 Ascend 的硬件特性——tiling 策略、异步执行、计算单元间负载均衡——显著降低内存占用与延迟。
- CANN(Compute Architecture for Neural Networks):Ascend 平台的全栈底层软硬件接口,负责底层调度与内存分配。
系统的部署工作流分三阶段:(1) Data Pipeline Configuration,原始交互日志被预处理为序列化稀疏输入,分布式加载经过优化以消除 I/O 瓶颈;(2) Model and Topology Instantiation,硬件拓扑(多机多卡)与算法参数(Transformer 变体、QKV 维度、注意力头数)解耦并独立配置;(3) Component Extensibility,自定义融合算子、注意力掩码机制或新损失函数可以在不破坏底层已优化通信后端的前提下接入。
三大优化模块分别对应上述三个挑战:Ascend-affinity Jagged Acceleration(§4.1)、Distributed Communication Optimization(§4.2)、Negative-Sampling Optimization(§4.3)。
关键技术细节¶
4.1 Ascend-affinity Jagged 加速¶
4.1.1 Attention 与 RAB 的 Jagged 融合算子¶
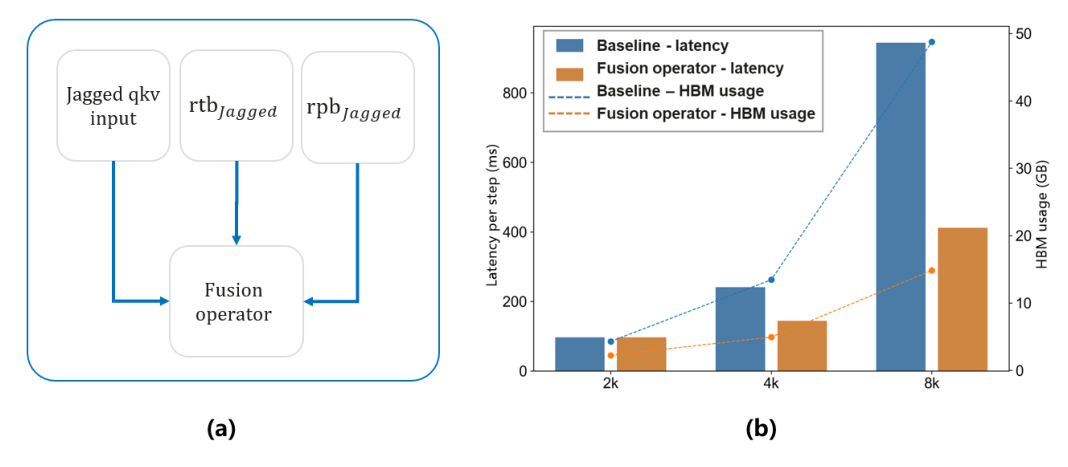
融合算子的通行思路是把多个计算步骤合进单个 kernel,以减少片外访存、提高片上内存利用率(FlashAttention 谱系)。TurboGR 沿这条路设计了 Ascend 亲和的 jagged 融合算子,输入包含 jagged qkv、relative time bias(rtb)与 relative position bias(rpb)三部分。三条关键优化:
-
消除不必要的格式转换。 jagged 格式与模型内部稠密表示之间的错配,会在每个算子边界上强制插入昂贵的 dense-to-jagged / jagged-to-dense 转换。TurboGR 统一内部表示,让整条 attention + RAB 流水线原生跑在 jagged 张量上,转换被完全移除,访存流量与 kernel 启动开销同时下降。
-
Tiling 策略与异步执行。 Ascend NPU 以 tile 为单位分块处理数据以平衡计算负载并高效利用片上 cache。TurboGR 按数据形状选择 tiling:大 attention 矩阵用矩形 tiling,较小的 RAB bias 张量用方形 tiling。同时利用 Ascend 的异步数据拷贝能力,把数据搬运与计算重叠以隐藏访存延迟(Ascend 的大批量拷贝不阻塞计算单元)。
-
设备内计算单元间的负载均衡。 RAB(附录中记为 RTB)的反向传播混合了规则的(数据并行)与不规则的(依赖索引的)操作,朴素实现会把标量计算单元压垮。TurboGR 把规则的数据并行计算卸载到向量单元,标量单元只保留不规则操作,代价仅是轻量的数据打包。这一设计显著提升了单个 AI Core 内部的并行度。
实测(FuXi-long,Figure 2(b)):在 8k 序列长度下,端到端延迟从 961.21 ms 降至 431.13 ms(约 2.2×),reserved memory 从 47.77 GB 降至 14.31 GB,即 70% 的显存开销削减。
4.1.2 Jagged Embedding Lookup 加速¶
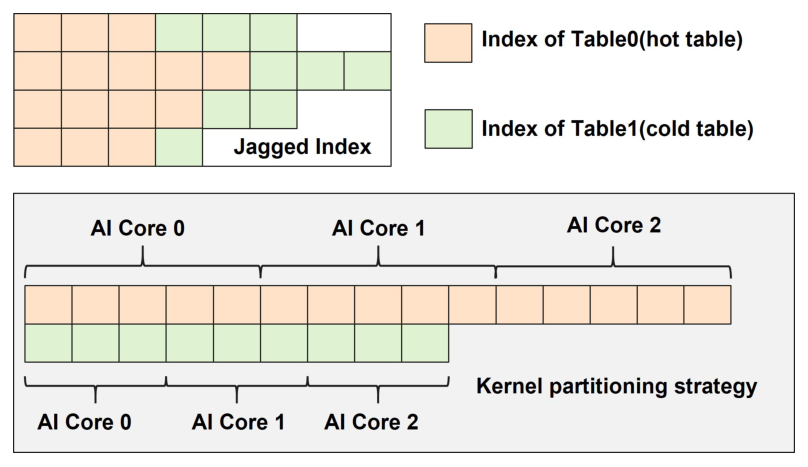
针对稀疏 embedding lookup 的低效,TurboGR 设计了 jagged 多表索引方案,核心是"只对有效索引做计算",从而大幅削减标量计算与控制流开销;同时在表级别重组 batch 数据并分发到各计算核,改善 cache 局部性并缓解冷热表带来的负载不均。两个子技术:
(1) 冗余移除与计算加速。 变长序列中的 padding 零会推高 embedding lookup 的计算开销。TurboGR 采用 TorchRec 的 KeyedJaggedTensor(KJT) 数据结构,只在有效索引上运算。但默认 KJT 实现仍需对零值做额外检查,引入冗余标量操作与条件分支。TurboGR 进一步用显式 jagged indices 替换输入 lengths,把 padding 引入的冗余彻底消除。
(2) Kernel 划分策略。 把有效索引朴素地平铺到各 AI Core,会产生"单 tiling block 多表查询"的访问模式;不同表的 embedding 通常散落在 HBM 中相距很远的离散位置,cache 命中概率因此下降、HBM 流量上升。TurboGR 的做法是先在表级别重构 batch 数据——把同一张表跨整个 batch 的数据聚到一起,再把每张表的数据均匀铺到所有 AI Core(Figure 3 下半部分)。这样各核在同一时刻处理相同的表,L2 cache 命中率提升,冷热表访问模式造成的负载不均也被摊平。
实测(Table 2):对 100 万个 ID 的 batch(其中 50.43% 是无效 padding 零):
| 策略 | Total Indices | Padded Zeros | Forward (ms) | Backward (ms) |
|---|---|---|---|---|
| Baseline | 1,064,960 | 537,019 | 18 | 36 |
| Jagged embedding lookup acceleration | — | — | 3 | 9 |
前向延迟降低 6 倍,反向延迟降低 4 倍。这说明 jagged embedding lookup 加速是支撑 GR 多表稀疏训练的必要条件,而非锦上添花。
4.1.3 动态 Jagged 负载均衡¶
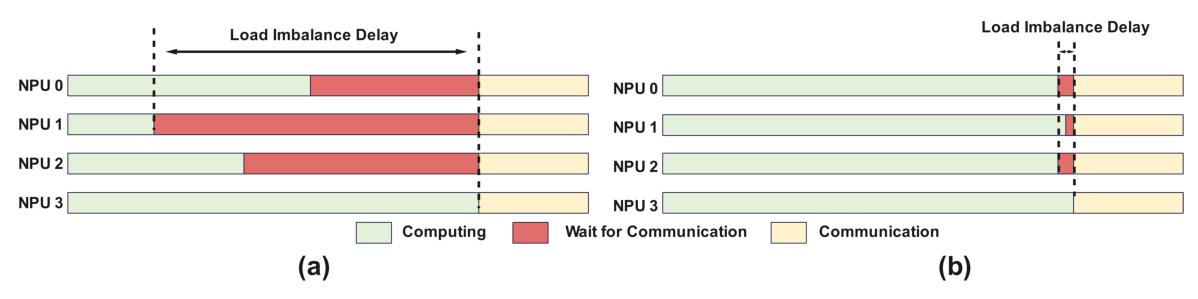
在数据并行的 GR 训练中,变长多特征序列造成各 worker 计算量不均,进而在集合通信屏障处引发严重的同步等待。Figure 4(a) 展示的多 NPU 训练时间线里,轻负载设备近乎一半的时间都在同步点空转,等待重负载设备。
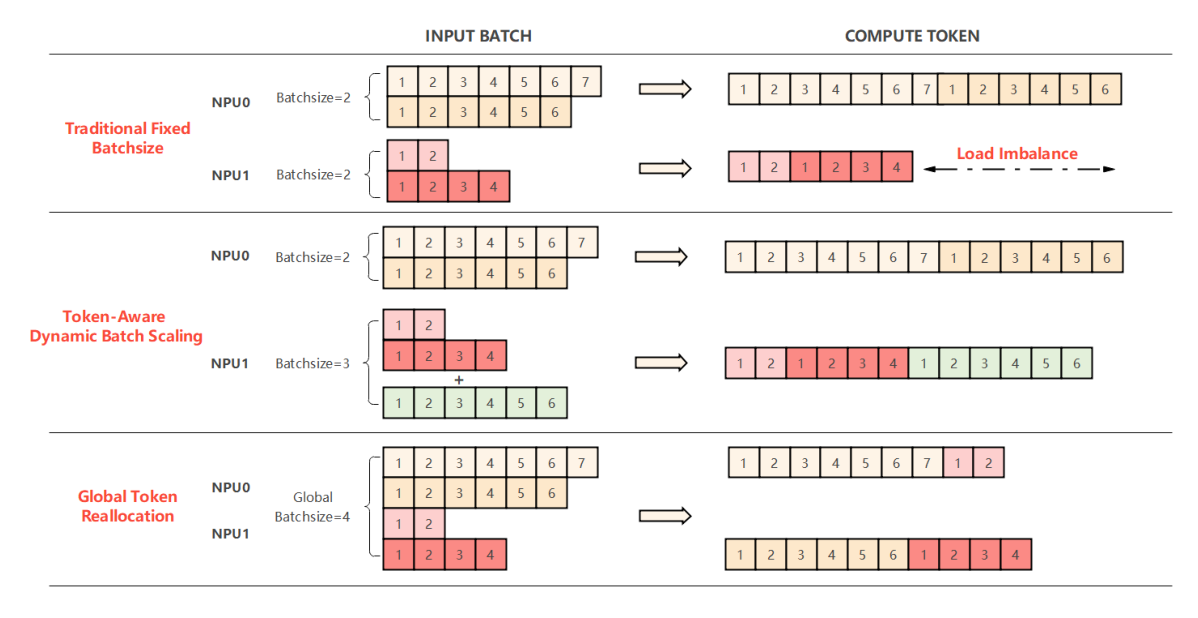
TurboGR 提出两条互补策略(Figure 5),分别针对短序列与长序列场景:
-
Token-Aware Dynamic Batch Scaling(面向短序列):batch size 不再按固定样本数确定,而是按 token 数确定。数据加载时,每张 NPU 依据从基线推导出的预设 token 阈值动态缩放自己的 batch size,使每张卡每步处理的有效 token 数大致相当。由于动态 batch 缩放会让每卡样本数不一致,论文进一步采用按样本数加权的梯度聚合策略,以保持各卡间优化行为的一致性。
-
Global Token Reallocation(面向长序列小 batch):在不破坏序列完整性的前提下把 token 铺平到各设备。做法是重构数据加载流程,跨所有 NPU 构造一个 global batch,按 token 数对样本排序,再用贪心负载均衡策略把样本指派给设备,使每张卡拿到的样本集合 token 总量相当。
实测(Table 3):短序列在 Amazon-all 上验证 dynamic batch scaling,长序列在 KuaiRand-27K 上验证 global token reallocation;为公平对比,所有设置都在相同的 16 张 NPU、相同训练步上随机采样 profile 数据。
| Dataset | Strategy | Max Token Count Diff | Single-step Latency (ms) | Load Imbalance Delay (ms) | Load Imbalance Ratio (%) |
|---|---|---|---|---|---|
| Amazon-all | Fixed Batchsize Baseline | 623 | 422 | 15 | 3.55 |
| Amazon-all | Token-Aware Dynamic Batch Scaling | 31 | 405 | 6.5 | 1.48 |
| KuaiRand-27K | Fixed Batchsize Baseline | 10,726 | 2,340 | 1,100 | 47.01 |
| KuaiRand-27K | Global Token Reallocation | 559 | 1,540 | 37 | 2.40 |
结论分析:长序列场景收益远大于短序列,这与直觉一致——序列越长,长尾分布的绝对方差越大(KuaiRand 上最大 token 差从 10,726 压到 559,约 19 倍),负载不均导致的通信等待占比从 47.01% 骤降到 2.40%,单步延迟随之从 2,340 ms 降到 1,540 ms(约 34%)。Figure 4(b) 给出了优化后训练时间线的直观对照:同步点前的空转带被基本抹平。值得注意的是,这里的收益并非来自更快的计算,而纯粹来自消除"最慢者拖累全体"的 straggler 效应。
4.2 分布式通信优化¶
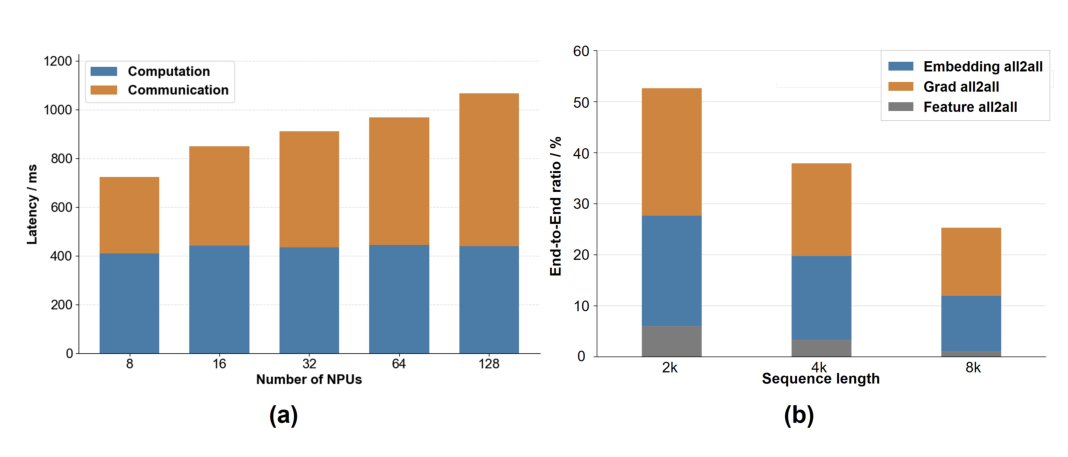
Figure 6(a) 表明,随集群规模扩大,分布式通信已成为制约整体训练吞吐的首要瓶颈。TurboGR 给出三层应对:分层稀疏并行、半异步训练、细粒度流水线编排。
4.2.1 自适应分层稀疏并行(HSP)¶
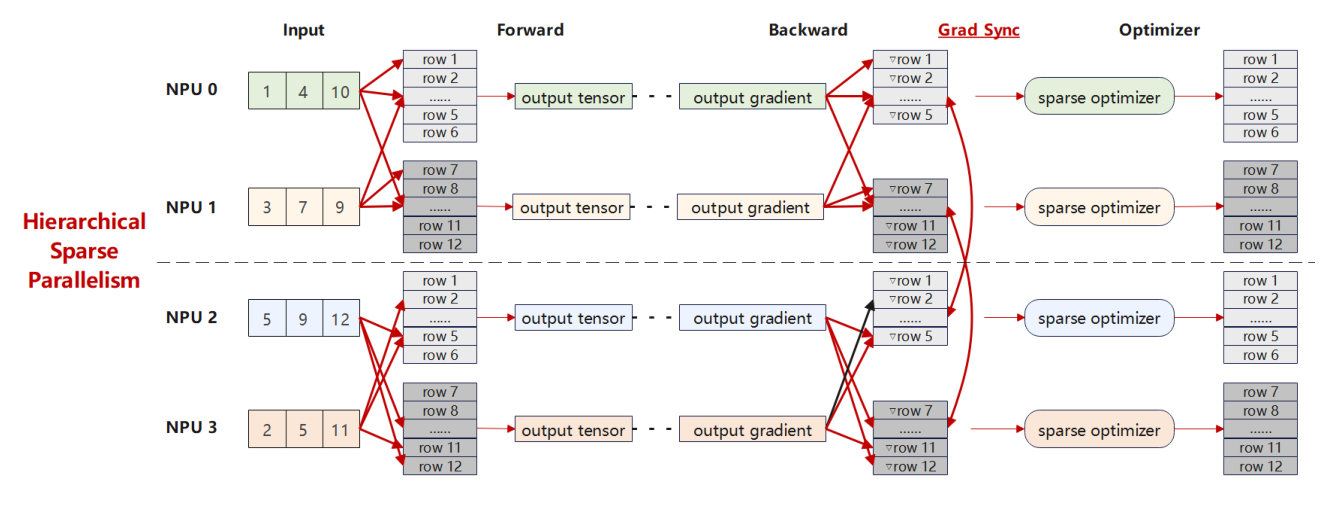
标准 TorchRec 实现把 embedding 表切分到所有设备上,需要两阶段的全局 all-to-all 集合通信来对齐输入特征与 embedding 查询结果。集群一大,通信开销就压倒一切。
TurboGR 的 Hierarchical Sparse Parallelism(HSP) 重构了 embedding 切分与通信架构:给定 $N$ 台设备,把它们组织成 $M$ 个并行组,每组含 $I = N/M$ 台设备。每个组维护一份完整的 embedding 表副本,副本在组内通过模型并行切分。训练时每组只为自己 local mini-batch 中出现的 ID 做 embedding 查询,all-to-all 通信被限制在组内。于是通信规模从 $O(N)$ 降到 $O(I)$,缓解了设备数增长带来的通信退化。
组间则施加数据并行。这里有个关键设计取舍:已有实现(如文献 [18] 的 2D sparse parallelism)通过修改 "moment scale" 来补偿权重同步引起的有效学习率下降;HSP 绕开这层算法复杂度,直接重构 embedding lookup 的反向算子:
- 第一,引入组间 all-reduce,在 update 之前完成梯度同步,保证所有并行组看到同一份聚合梯度 $G_t = \sum_{j=1}^{M} g_{j,t}$。在 AdaGrad 优化器下,第 $i$ 组第 $t$ 步的状态与参数更新为:
$$S_{i,t} = S_{i,t-1} + G_t^2, \qquad W_{t+1} = W_t - \frac{\eta}{\sqrt{S_{i,t}} + \varepsilon} \cdot G_t \tag{3}$$
由于初始状态 $S_{i,0}$ 相同且各组收到统一的聚合梯度 $G_t$,各组本地维护的优化器状态(二阶矩)演化完全一致,即 $S_{1,t} = S_{2,t} = \cdots = S_{M,t}$。因此全局优化轨迹与标准集中式训练在数学上等价,无需人工缩放学习率即可实现无损收敛。这是 HSP 相对文献 [18] 的核心简化。
- 第二,稀疏梯度交换:只传输被激活的梯度条目的索引与值,而非同步整张 embedding 表。该稀疏同步跑在专用 stream 上,与后续层的稠密计算异步重叠,避免同步本身变成新瓶颈。
实测(Table 4):
| Strategy | Single-step Latency (ms) | all-to-all Delay (ms) | Overall Communication Latency (ms) |
|---|---|---|---|
| Baseline | 1970 | 498 | 613 |
| HSP | 1790 | 120 | 373 |
all-to-all 通信延迟下降 75.9%,整体通信延迟下降 39.1%。结论分析:HSP 引入了额外的 all-reduce 与少量计算开销,但端到端仍净收益(单步 1970→1790 ms)——说明在这个规模下,把全局 all-to-all 换成"组内 all-to-all + 组间稀疏 all-reduce"是划算的交易。本质上 HSP 是用显存冗余(每组一份表副本)换通信域收缩,这也隐含了它的适用边界:当 embedding 表大到单组放不下时,$M$ 无法增大,收益会被压缩。
4.2.2 半异步训练策略¶
TorchRec 中 embedding 张量并行通过 all-to-all 实现,包含三个阶段:稀疏特征分发、embedding 向量交换、梯度同步。这些阶段是 latency-bound 的通信,导致计算资源严重闲置。Figure 6(b) 给出量化:稀疏通信在 2k 序列下占端到端时间的 53%,在 8k 序列下占 25%;在稀疏通信内部,embedding 传输与梯度同步是大头,2k 场景下分别贡献总时间的 22% 与 25%。由于标准执行流严格串行,这些通信无法与稠密计算重叠。
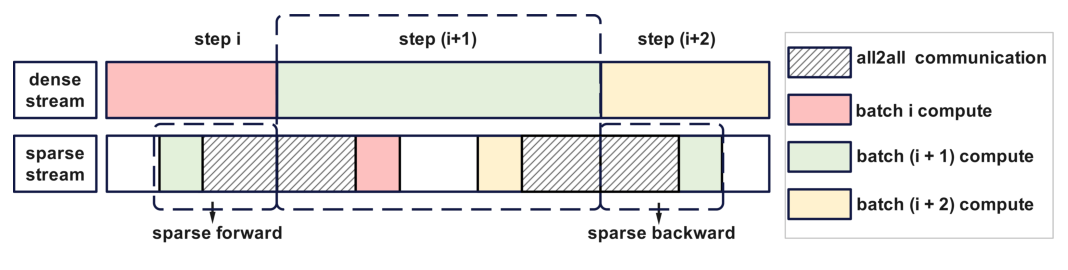
TurboGR 采用稀疏异步 + 稠密同步的半异步策略:稀疏异步解除了 batch $(i+1)$ 的稀疏前向对 batch $i$ 的稀疏反向的依赖,使 batch $(i+1)$ 的稀疏前向可以跑在 batch $i$ 的稀疏反向之前(Figure 8)。这相当于把稀疏执行整体提前一个 step,而稠密计算的原有跨 batch 依赖完全保留。
收敛性保证(附录 C)。论文引入两个量刻画该系统:样本稀疏度 $\alpha$(不同 step 的样本之间发生特征碰撞的概率;若所有特征等概率出现则 $\alpha = 1/N_{emb}$,$N_{emb}$ 为唯一特征总数;若某特征出现在每个样本中则 $\alpha$ 取最大值 1,表示该特征无稀疏性),以及稀疏模块异步的延迟步数 $\tau$(embedding 权重前向计算与反向更新之间相隔的步数)。半异步系统的收敛满足:
$$\frac{1}{T}\sum_{t=0}^{T-1} \mathbb{E}\left[\|\nabla f(w_t)\|^2\right] \le O\left(\frac{\sqrt{L}\sigma}{\sqrt{T}} + \frac{L}{T} + \frac{\alpha L \tau}{T}\right) \tag{4}$$
左端是 $T$ 次迭代上梯度范数平方的平均期望,是非凸优化中标准的驻点性度量。右端 $L$ 是梯度的 Lipschitz 常数,$\sigma$ 界定随机梯度方差;前两项恰是 vanilla SGD 的收敛率,第三项 $O(\alpha L \tau / T)$ 是异步 embedding 更新带来的延迟惩罚项。
这个界的物理含义很清楚:当 $\alpha \ll 1$(极度稀疏)时第三项可忽略,即使 $\tau$ 很大,只要 $\alpha$ 足够小,收敛就贴近同步版本。推荐系统的稀疏性本身成了异步的安全垫——不同 step 的样本很少碰同一个 embedding 行,延迟更新自然无害。TurboGR 中 $\alpha \ll 1$ 且 $\tau = 1$,理论上延迟惩罚可忽略;论文补充说明类似分析可推广到 AdaGrad 等优化器,且实测在 200 epoch 后相对基线的最大精度下降仅 0.26%。
该方案允许两种错位重叠:(1) batch $i$ 稠密模型的反向与 batch $(i+1)$ 稀疏模型的前向重叠;(2) batch $(i+2)$ 稠密模型的前向与 batch $(i+1)$ 稀疏模型的反向重叠。
实测(Table 5):
| Method | Unmasked Sparse Comm. Time (ms) | Ratio (%) | HR@10 | HR@200 | HR@2000 | NDCG@10 | NDCG@200 |
|---|---|---|---|---|---|---|---|
| Baseline | 459.29 | 24.12 | 0.0295 | 0.1757 | 0.4528 | 0.0151 | 0.0404 |
| Semi-Async | 29.37 | 2.19 | 0.0306 | 0.1779 | 0.4516 | 0.0159 | 0.0414 |
结论分析:未被掩盖的集合通信时间从 459.29 ms 降到 29.37 ms(占比 24.12% → 2.19%),embedding 与梯度通信基本被完全掩盖。推荐精度不仅没有下降,5 个指标里有 4 个还略有上升(HR@2000 微降 0.0012)——这与理论保证一致,也说明在 $\tau=1$ 这一保守设置下,异步引入的扰动在噪声范围内。
4.2.3 细粒度流水线编排¶
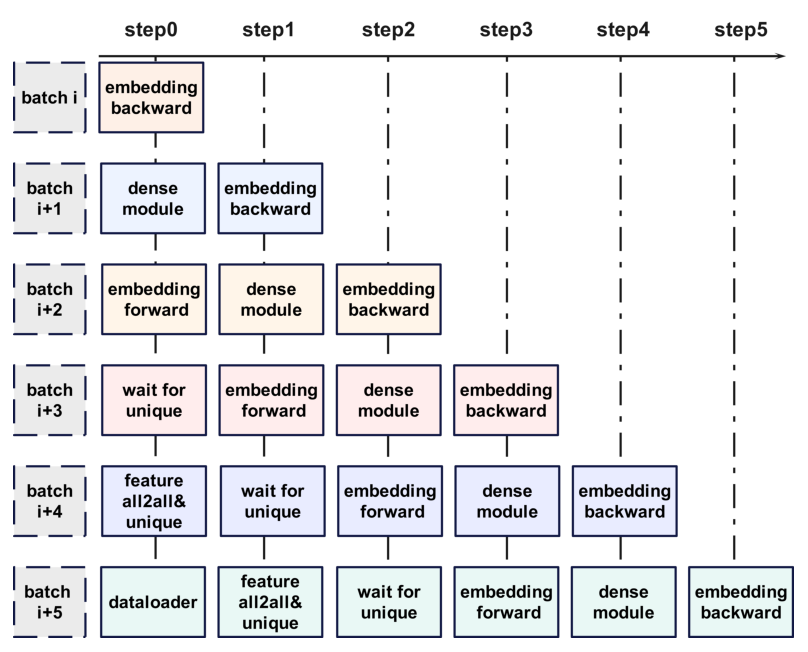
为把 NPU 利用率推到极限,TurboGR 设计了六批次(six-batch)细粒度流水线,整合 §4.2.1 与 §4.2.2 的优化。核心思路是解耦刚性的 CPU-NPU 同步依赖,让 CPU 与 NPU 操作重叠,从而维持 NPU 持续计算、消除空闲期。相比 TorchRec 原生实现,TurboGR 加深了流水线层数,把 NPU 计算派发与 CPU 侧数据处理、NPU 通信交织起来。训练步被划分为 6 个阶段:
dataloader → feature all-to-all & CPU unique → wait for unique → embedding forward → dense module(前向 + 反向)→ embedding backward
附录 D 补充:训练全程中跨设备传输(H2D 与 D2H)会引入强制同步点,TurboGR 把这些传输实现为异步,使 CPU 到 NPU 的指令派发非阻塞,从而避免流水线停顿。
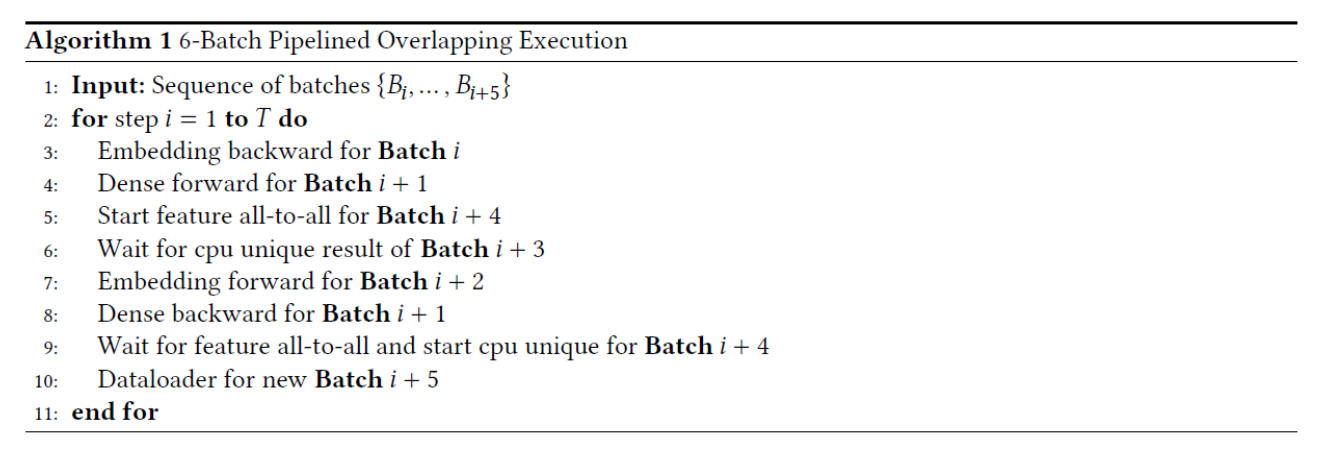
Algorithm 1 给出了流水线在稳态下的具体调度。输入是连续的 6 个 batch $\{B_i, \ldots, B_{i+5}\}$,每个 step $i$ 内按固定顺序执行 8 条指令:
- Batch $i$ 的 embedding backward
- Batch $i+1$ 的 dense forward
- 启动 Batch $i+4$ 的 feature all-to-all
- 等待 Batch $i+3$ 的 CPU unique 结果
- Batch $i+2$ 的 embedding forward
- Batch $i+1$ 的 dense backward
- 等待 Batch $i+4$ 的 feature all-to-all 并启动其 CPU unique
- 为新的 Batch $i+5$ 执行 dataloader
可以看到同一时刻在飞的 batch 跨度达到 6(从 $i$ 到 $i+5$),且每条指令属于不同的 batch——这正是"六批次"的含义。稠密前向(Batch $i+1$,第 2 行)与稠密反向(Batch $i+1$,第 6 行)之间夹着 embedding forward(Batch $i+2$)与两个等待点,使得 CPU 侧的 unique 计算、feature all-to-all 通信与 NPU 侧稠密计算三者天然错开,谁都不必等谁。半异步(§4.2.2)的作用在这里具体化为第 1 行与第 5 行的 batch 编号差:Batch $i$ 的 embedding backward 排在 Batch $i+2$ 的 embedding forward 之前,稀疏执行整体提前。
实测(Table 6,FuXi-large 与 FuXi-long):
| Method | Computing Latency (ms) / Ratio (%) | Communication Latency (ms) / Ratio (%) | Comm. Not Overlapped (ms) / Ratio (%) | Free Latency (ms) / Ratio (%) |
|---|---|---|---|---|
| FuXi-large | 656.39 / 94.25 | 326.56 / 46.89 | 38.78 / 5.57 | 1.27 / 0.18 |
| FuXi-long | 1712.00 / 94.29 | 436.71 / 24.04 | 97.88 / 5.39 | 5.91 / 0.33 |
结论分析:NPU 空闲时间被压到 1% 以下,未重叠通信低于 6%,NPU 计算占端到端时间的 94%。注意通信总量并不小(FuXi-large 上通信延迟 326.56 ms,占 46.89%),但其中 92% 被藏进了计算——这正是流水线编排的价值所在:不是减少通信,而是让通信不再出现在关键路径上。
4.3 负采样优化¶
在 GR 的召回(recall)训练中,每个正样本配一组独立采样的负样本,构成对比损失。但负采样一旦放大,系统瓶颈就由 embedding 相关成本主导:HBM 占用可超过 20 GB,损失计算贡献超过 30% 的端到端延迟,且 HBM 消耗随负样本数线性增长。TurboGR 给出三条正交的优化。
4.3.1 负采样的异步卸载¶
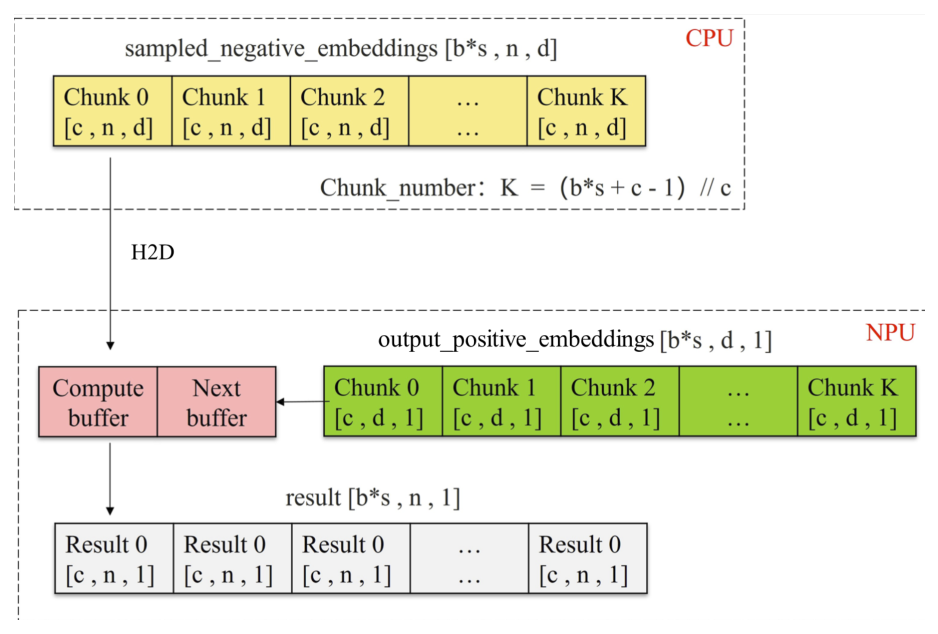
负样本 embedding 张量在单张 NPU 上可占数 GB,是首要显存消费者,而且在点积阶段之后依然常驻显存却不再被使用。TurboGR 利用了一个关键的代数性质:点积 logit 计算在 segment 之间是独立的——每个有效位置的 logit 只依赖它自己那一小片负样本 embedding,没有跨 segment 依赖;且负样本 embedding 构成规则的 3D 稠密张量,可以沿"有效位置"维度切分,事后把各段 logit 拼起来即可,无需额外簿记。
基于这一性质,TurboGR 采用 "CPU 卸载 + 分段取回":把负样本 embedding 从 NPU HBM 卸载到 CPU 内存,再按固定粒度(例如每段 100 个有效位置)逐段取回 NPU。NPU 侧采用双缓冲设计(compute buffer + prefetch buffer):当前段正在计算时,下一段异步传入 prefetch buffer,点积完成后换入。所有段处理完毕后拼接各段 logit,喂进原有损失流水线,从而彻底消除完整负样本 embedding 张量原先占据的 HBM 空间。
实测(Table 7,FuXi-large):
| # Negatives | Strategy | HBM Usage (GB) | HBM Ratio (%) |
|---|---|---|---|
| 32 | Baseline | 22.21 | 34.70 |
| 32 | Offloading | 17.42 | 27.22 |
| 64 | Baseline | 31.64 | 49.44 |
| 64 | Offloading | 23.44 | 36.63 |
| 128 | Baseline | 50.39 | 78.73 |
| 128 | Offloading | 34.27 | 53.55 |
对应的显存节省为 32 负样本下 7.30%、64 下 12.51%、128 下 24.59%。结论分析:节省幅度随负样本数超线性增长——这是合理的,因为被卸载的张量本身随负样本数线性膨胀,而其他显存项基本恒定,故其占比越来越大。尽管引入了额外的主机-设备传输开销,卸载仍是大负样本集召回训练的关键使能技术,它把 HBM 从硬约束变成了可调参数。
4.3.2 Jaggedness-aware 量化¶
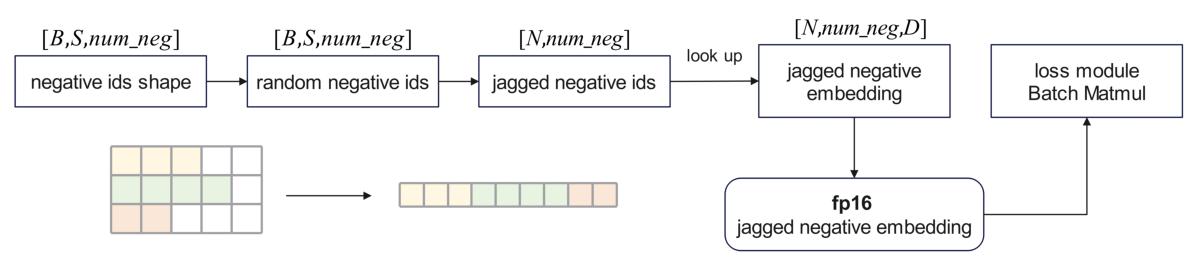
由于 §4.1 讨论的 jaggedness,不同用户的负样本数量差异显著,负样本序列本身也呈不规则长度结构。TurboGR 对负采样也采用 jagged 张量形式:数据加载时,先按 batch size、最大序列长度与预设负样本数从全局 item ID 池采样负样本 ID,形成稠密 ID 矩阵;随后套用 jagged 结构,过滤掉语义无效(padding)位置对应的 ID,构造 jagged ID 张量再做 embedding 查询。在保留原序列结构的同时移除无效条目,负采样的存储与计算开销同时下降。
在此之上再叠加量化:负样本 embedding 以 FP16 半精度存取。TorchRec 中正负样本被建模为不同 feature 但共享同一张 embedding 表,TurboGR 因此集成了一条仅对负样本触发的 FP16 查询路径,返回 FP16 embedding 向量,流水线其余部分保持不变。
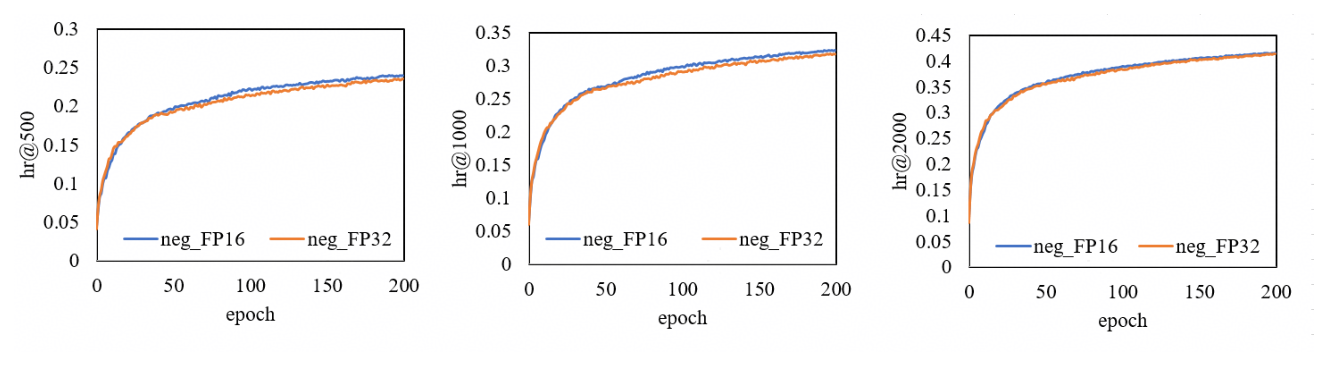
实测:相对基线,模型仅表现出边际差异——HR@2000 差 0.01%,HR@1000 差 0.05%,测量噪声很小,说明 FP16 负样本 embedding 的精度影响可忽略。论文给出的机理解释是:FP16 保留 10 位尾数,且量化误差被归一化以及"logit 由单次矩阵乘产生"这一事实进一步衰减——误差没有经过多层累积放大的机会。
4.3.3 基于 Logit 共享的信息增强负采样¶
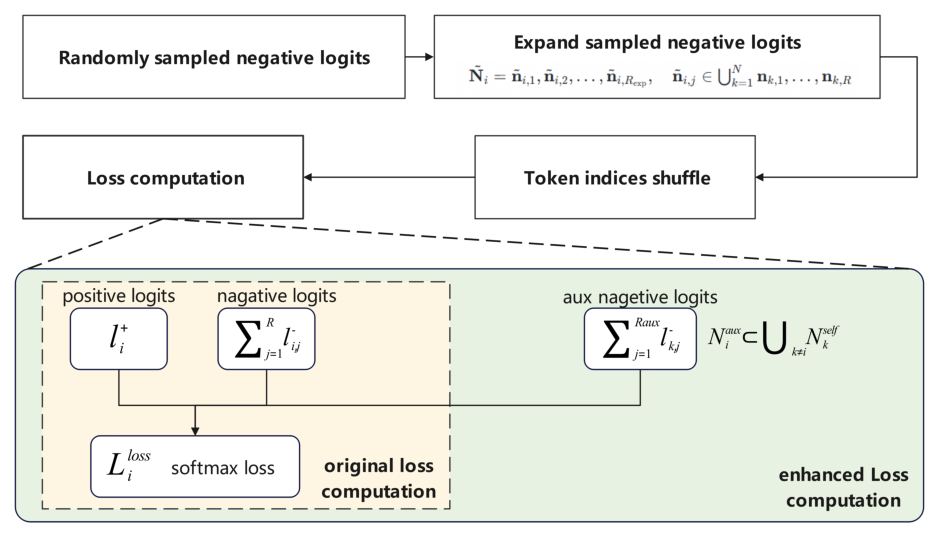
为进一步缓解大规模负采样下的显存消耗、负样本信息冗余与训练效率问题,TurboGR 提出信息增强负采样策略。核心思想是批内共享(intra-batch sharing):对每个目标 token,复用同 batch 内其他 token 已经算好的负样本 logit 作为辅助负样本。负样本 logit 本质是负样本 embedding 与模型输出 embedding 之间批量矩阵乘得到的相似度分数,把它们拼接起来即可在不额外查任何负样本 embedding 的前提下扩张有效负样本空间。为减少固定拼接顺序带来的冗余,TurboGR 对每个 token 的扩展负 logit 集合施加 token 级 shuffle,随机化重构后的集合,缓解 token 层面的冗余。
设 $N$ 为 token 总数、$R$ 为原始负样本数。对 token $i$,其负样本集合由自身负样本 $N_i^{self}$ 与来自其他 token 的辅助子集 $N_i^{aux} \subseteq \bigcup_{k \ne i} N_k^{self}$ 组成。信息增强后每个 token $i$ 的最终损失为:
$$\text{Loss} = -\log \left( \frac{\exp(l_i^{+})}{\exp(l_i^{+}) + \sum_{j=1}^{R} \exp\left(\frac{o_i^{\top} \cdot n_{i,j}}{\tau}\right) + \Delta} \right) \tag{5}$$
其中辅助负样本增强项为
$$\Delta = \sum_{j=1}^{R_{aux}} \exp\left(\frac{o_i^{\top} \cdot n_{k,j}}{\tau}\right), \quad k \in R_{aux},\ k \ne i \tag{6}$$
而 $l_i^{+} = \frac{o_i^{\top} \cdot p_{i,j}}{\tau}$ 与 $l_i^{-} = \frac{o_i^{\top} \cdot n_{i,j}}{\tau}$ 分别表示正样本 logit 与原始负样本 logit。这一损失形式让目标样本同时接受来自自身负样本的判别约束与来自跨样本辅助负样本的判别信号,从而强化全局候选空间的判别能力。
实验设置¶
- 硬件:Ascend 910B1 64GB NPU 集群,从 32 卡扩展到 128 卡(4 到 16 节点),CPU 为 Kunpeng-920 ARM。
- 数据集:KuaiRand-27K——KuaiRand 短视频推荐数据集中规模最大、使用最广的子集,包含 27,000+ 用户、数百万 item、数千万次用户-视频交互,采集自一个月周期。每条曝光记录含 watch time、click、like、follow、完成率等多信号反馈。相比其他 KuaiRand 变体,27K 版本提供显著更长的用户-物品交互历史与更大更真实的物品空间,适合评估长序列下的可扩展性。消融中另用短序列数据集 Amazon-all。
- 预处理:为召回任务,先剔除 (1) 用户明确表示不喜欢该视频、(2) 用户没有任何正向交互(正向定义为 click / like / follow / comment / forward / 长时观看至少其一)的交互;再做 5-core 过滤(每用户至少 5 次交互、每物品至少被 5 个用户交互);按用户分组并按时间排序,采用 leave-one-out 划分,每条序列除最后一个 item 外用于训练,最后一个作为召回评估的 ground truth。
- 模型:HSTU 与 FuXi(Fuxi-alpha),另在参数设置中提及 SASRec。每个模型构造 tiny / small / medium / large 四个尺度变体:item embedding 维度 128 / 256 / 512 / 1024,序列长度固定 2000;主干分别为 2 / 4 / 8 / 16 个堆叠 block,每块 8 个注意力头,QKV 投影维度 16 / 32 / 64 / 128。为验证超长序列能力,另引入 HSTU-long 与 FuXi-long,序列长度 4096,其余设置对齐各自的 large 变体。
- RAB 设置:显式建模时间与位置信息——HSTU 用分桶时间编码(32 桶),FuXi 用函数式时间编码(Fuxi-gamma);相对位置编码用于刻画交互序列顺序。
- 优化器:AdamW,学习率 $4 \times 10^{-3}$,无 weight decay;线性层 dropout $p = 0.5$;sampled softmax 配 128 个负样本;采用 TF32 精度与异步 embedding 更新。
主要实验结果¶
端到端系统效率(Table 1,KuaiRand-27K,Ascend 910B1 64GB):
| Model | Model Size (M) | Seq Len | Comp. Complexity (TFLOPs/step) | Throughput (sample/s) | MFU (%) | Linear Scalability |
|---|---|---|---|---|---|---|
| HSTU-tiny | 0.17 | 2048 | 0.13 | 3475.17 | 0.43 | 0.38 |
| HSTU-small | 1.33 | 2048 | 0.59 | 3508.59 | 1.96 | 0.58 |
| HSTU-medium | 10.52 | 2048 | 1.90 | 2896.00 | 8.00 | 0.70 |
| HSTU-large | 83.97 | 2048 | 4.33 | 1616.83 | 24.74 | 0.93 |
| HSTU-long | 83.97 | 4096 | 7.15 | 770.79 | 34.08 | 0.97 |
| FuXi-tiny | 0.41 | 2048 | 0.27 | 3441.32 | 0.88 | 0.35 |
| FuXi-small | 3.18 | 2048 | 1.18 | 3218.31 | 3.78 | 0.50 |
| FuXi-medium | 25.22 | 2048 | 3.13 | 2812.24 | 16.76 | 0.74 |
| FuXi-large | 201.55 | 2048 | 8.25 | 1156.26 | 39.34 | 0.94 |
| FuXi-long | 201.55 | 4096 | 11.54 | 574.39 | 54.71 | 0.97 |
结论分析(三条清晰趋势):
- MFU 随模型容量单调上升(HSTU:0.43% → 34.08%;FuXi:0.88% → 54.71%)。论文解释为更大的架构能更好地压满 NPU 张量核,并通过更优的计算-通信重叠提升流水线效率。反过来说,小模型的 MFU 低到近乎不可用(<1%),这恰恰印证了 Challenge 1:小模型里 vector-bound 的稀疏算子占比过高,稠密算力无处发挥。
- 序列越长 MFU 越高(HSTU 24.74% → 34.08%,FuXi 39.34% → 54.71%,模型参数不变、仅序列 2048→4096)。这直接归因于系统的端到端冗余削减与长度自适应加速能力——序列越长,jagged 优化摊薄的固定开销越多。
- FuXi 的 MFU 一致高于 HSTU(同尺度下 16.76% vs 8.00%、39.34% vs 24.74%),论文归因于 FuXi 架构对 Ascend 更亲和。
- 集群线性度:large 与 long 变体的线性度严格超过 0.9(最高 0.97),因为它们持续的计算负载提供了足够的延迟隐藏来掩盖分布式通信开销;而 tiny/small 变体线性度仅 0.35–0.58,说明计算量不足时通信必然主导——这为"系统优化的收益需要足够大的模型才能兑现"提供了直接证据。
注意一个容易误读的地方:吞吐(sample/s)随模型增大而下降(3475 → 574),MFU 却上升。二者不矛盾——MFU 衡量的是硬件算力被有效利用的比例,而非绝对样本速度。
消融与分析¶
论文的消融是逐技术给出的,已分别嵌在 §4.1–§4.3 各小节(Table 2/3/4/5/6/7 与 Figure 12),此处不再重复,仅补充负采样策略的精度消融。
Logit 共享的精度代价(Table 8,FuXi,$k$ 为扩张因子):
| Model | # Negatives | HR@100 | HR@1000 | NDCG@10 | NDCG@200 |
|---|---|---|---|---|---|
| FuXi-tiny | 128 (baseline) | 0.0633 | 0.2250 | 0.0059 | 0.0200 |
| FuXi-tiny | 64→128 (k=2) | 0.0619 | 0.2253 | 0.0061 | 0.0201 |
| FuXi-small | 128 (baseline) | 0.1020 | 0.3174 | 0.0114 | 0.0331 |
| FuXi-small | 64→128 (k=2) | 0.1060 | 0.3172 | 0.0128 | 0.0349 |
| FuXi-medium | 128 (baseline) | 0.1043 | 0.3148 | 0.0129 | 0.0343 |
| FuXi-medium | 64→128 (k=2) | 0.1059 | 0.3135 | 0.0125 | 0.0346 |
| FuXi-large | 128 (baseline) | 0.0235 | 0.3204 | 0.0123 | 0.0347 |
| FuXi-large | 64→128 (k=2) | 0.0238 | 0.3136 | 0.0123 | 0.0341 |
| FuXi-large | 64→256 (k=4) | 0.0257 | 0.3183 | 0.0134 | 0.0360 |
结论分析:对 tiny / small / medium 这类紧凑模型,把负 logit 扩张 $2\times$ 即可在基线附近取得精度持平(波动在统计合理误差内)——也就是说只查 64 个负样本的 embedding,却享受到 128 个负样本的判别信号,embedding 查询量直接减半。但 FuXi-large 需要 $k=4$ 才能追平基线。论文给出的机理是双重的:(1) 当 embedding 维度超过 1024(即 large 变体)时,batch size 必须按比例缩小,导致负采样集合内的数据量不足;(2) 高维 embedding 使众多负样本的 logit 之间产生信息冗余,实际有效的样本扩张维度低于配置的 $k$ 值。因此为保证负样本多样性,必须引入更高程度的随机扩张维度。
最小扩张因子推荐(Table 9,序列长度 2048、128 个总 logit):
| Model | Batch Size | # Negatives | 最小 $k$ |
|---|---|---|---|
| FuXi-tiny | 15 | 64 | 2 |
| FuXi-small | 8 | 64 | 2 |
| FuXi-medium | 5 | 64 | 2 |
| FuXi-large | 2 | 64 | 4 |
这张表把"batch size 越小 → 可共享的 token 越少 → 需要更大的 $k$ 来补足多样性"这条因果链坐实了:batch size 从 15 降到 2 时,所需 $k$ 从 2 翻到 4。
核心贡献总结¶
- Ascend-affinity jagged 加速:attention 与 RAB 的 jagged 融合算子(70% 显存削减、2.2× 延迟加速),jagged embedding lookup 加速(前向 6×、反向 4×),动态负载均衡(设备间不均衡 47% → 2.4%)。
- 分布式通信优化:HSP(all-to-all 延迟 −75.9%,且通过重构反向算子实现与集中式训练数学等价的无损收敛),带收敛保证的半异步训练(未掩盖通信占比 24.12% → 2.19%),六批次细粒度流水线(NPU 计算占比 94%、空闲 <1%)。
- 负采样优化:异步卸载(HBM 最多降 24.59%)、jaggedness-aware FP16 量化(精度损失 ≤0.05%)、批内 logit 共享(不增加 embedding 查询即扩张有效负样本空间)。
- 首个面向 Ascend NPU 开源的 GR 训练系统,在 0.2B 参数下达到 54.71% MFU 与 0.97 近线性扩展。
与已归档相关工作的对比¶
ULTRA-HSTU ULTRA-HSTU: Bending the Scaling Law Curve in Large-Scale Recommendation Systems (Meta, 2026-02-23)¶
关系:独立并发(本文发表于 2026-05-13,比 ULTRA-HSTU 晚约 2.5 个月,具备引用的时间条件但未引用)· 已加载对方精读
- 共同关注的问题:两篇都把"GR 的 scaling law 只有在基础设施跟得上时才兑现"作为出发点,并把瓶颈定位到同一处 root cause——HSTU 类模型的变长用户序列在分布式训练中天然不规则,padding 与 rank 间负载倾斜共同吃掉算力。ULTRA-HSTU 明确指出原始 HSTU 的 Stochastic Length 在各 rank 上独立采样,"导致输入/输出负载显著不均衡,降低同步训练效率";TurboGR 则实测出 KuaiRand-27K 上设备间最大 token 差 10,726、负载不均导致的通信等待占端到端 47.01%。这是同一个病,只是在不同硬件上被诊断了两次。
- 相近的技术骨架:抽象成流程图后有四处重合。(1) 按 token 计负载的 rank 级再均衡:ULTRA-HSTU 的 LBSL 把 rank 负载定义为 $\sum_u n_u^{\gamma}$ 并用加权无放回采样 + 贪心填充逼近全局目标负载 $\bar{\ell}$;TurboGR 的 Global Token Reallocation 构造 global batch、按 token 数排序、贪心指派给设备——同一个贪心装箱思路。(2) 全 jagged 训练消除 padding:ULTRA-HSTU 列出"全 jagged tensor 训练,消除 padding 为密集张量的需求",TurboGR 把整条 attention+RAB 流水线原生跑在 jagged 上。(3) 为非 NVIDIA 加速器手写 attention kernel:ULTRA-HSTU 为 AMD MI300x 做 XCD 感知调度、LDS 布局、显式 VMEM/MFMA 交错;TurboGR 为 Ascend 做矩形/方形 tiling 选择、异步拷贝、向量单元与标量单元的分工——都是在缺失 TMA / warp specialization 等 NVIDIA 原语的硬件上重建 FlashAttention 类算子。(4) 低精度换显存/带宽:ULTRA-HSTU 用 FP8 GEMM + INT4 embedding 通信,TurboGR 用 TF32 主干 + FP16 负样本 embedding。
- 本文的差异与推进:最本质的分野是是否动模型。ULTRA-HSTU 是算法-系统联合设计,它改了模型本身——Semi-Local Attention 把复杂度从 $O(L^2)$ 降到 $O((K_1+K_2)L)$、Attention Truncation 让深层只跑在最近片段上、Item-Action 合并把序列长度减半、MoT 拆分异质行为序列;这些改动带来 5× 训练 / 21× 推理 scaling efficiency,但也意味着模型质量需要重新验证(论文用 C-NE 退化幅度来论证 SLA 的两个窗口缺一不可)。TurboGR 则严格待在模型之下:HSTU 与 FuXi 都被当作不可改的负载,系统只负责把它们跑快,因此 §4.2.1 才要费力证明 HSP 的优化轨迹与集中式训练数学等价、§4.2.2 才要给半异步补一个收敛界 $O(\alpha L\tau/T)$——这些证明义务恰恰源于"不许改变模型语义"这条自我约束。
- 可比的方法 / 实验差异:ULTRA-HSTU 在 Meta 数十亿用户的视频推荐平台线上部署,线上消费指标 +4%–8%、Top-line +0.217%,并同时覆盖训练与推理;TurboGR 只做训练侧,且只在公开数据集 KuaiRand-27K 上离线评测,无线上 A/B。显存优化的量级也不同:ULTRA-HSTU 的选择性激活重物化以 5% 额外开销换每层 67% 显存(每层 7GB→2.3GB),针对的是 attention 前向激活;TurboGR 的卸载针对负样本 embedding,128 负样本下省 24.59%。两者优化的是显存里不同的大头,原则上可以叠加。
HLEM HLEM: One Pool, Two Caches — Adaptive HBM Partitioning for Accelerating Generative Recommender Serving (HKBU & Alibaba, 2026-05-06)¶
关系:独立并发(HLEM 早本文 7 天,实际同期,互相引用在物理上不可能)· 已加载对方精读
- 共同关注的问题:两篇都把 GR 系统里那一块有限的 HBM 认定为真正的稀缺资源,且都指出争抢它的是两类访问模式截然不同的张量。HLEM 的矛盾是 serving 侧的 EMB cache(避免 PCIe 拉取)与 KV cache(避免 attention 重算)抢同一块 HBM,静态划分会埋没 20–30% 的延迟优化空间。TurboGR 的矛盾是 training 侧巨大的负样本 embedding 张量(算例中单张卡 34 GB)挤压了其余一切,使 HBM 利用率低于 50%、大负样本召回训练不可行。同样是"一个池子,两个消费者",只是一个在推理、一个在训练。
- 相近的技术骨架:两者都拒绝"把张量整块留在 HBM"这一默认,转而把 HBM 当作慢速层(CPU DRAM,经 PCIe)之上的可管理窗口,并且都靠三件同构的事把慢速层藏起来:(1) 分页/分段抽象——HLEM 把 KV cache 组织为 vLLM 风格的 paged block pool、EMB cache 为 page 粒度 backing 的连续 LRU slab,边界调整只动页表元数据(1 µs 内完成、零 cudaMemcpy);TurboGR 沿"有效位置"维度把负样本 embedding 切成固定粒度(如 100 个有效位置)的段,靠的是点积 logit 的 segment-wise 独立性,因而"拼接各段 logit 无需额外簿记"。(2) 后台预取与计算重叠——HLEM 用带宽节流的 background refill 避免 H2D 流量挤压推理路径;TurboGR 用 compute buffer + prefetch buffer 的双缓冲,当前段计算时下一段异步传入。(3) 承认 H2D 是真瓶颈——HLEM 算出 4% 的 $\alpha$ 调整在 80GB GPU 上就意味着 3.2GB H2D refill,TurboGR 也坦承"尽管引入额外主机-设备传输开销"。
- 本文的差异与推进:分界在这个划分是被学出来的还是被推导出来的。HLEM 面对的 serving 负载在数十秒内剧烈波动(hot 用户比例 0%–80%、平均序列长 8–14 来回跳),最优 $\alpha^\*$ 随 workload 从 0.20 漂到 0.55,因此它不得不上一个三层控制器:离线 PPO 训练后冻结的基策略 + 在线残差 adapter + 3σ 触发的 Recovery Controller,用 MDP 形式化并以 SLO 满足率减 P99 超额作为奖励。TurboGR 的训练负载没有这种在线不确定性——每步的有效位置数在 data loading 阶段就精确已知,负样本张量的形状是确定的,于是它不需要任何控制器,直接用代数性质(点积的段间独立)给出静态分段方案。可以说 HLEM 的贡献是一个策略,TurboGR 的贡献是一次结构性观察;后者更简单也更可靠,代价是不具备 HLEM 那种跨 workload 自适应能力。
- 可比的方法 / 实验差异:HLEM 的收益以端到端 P99 延迟与 SLO 违规率计量,TurboGR 以 HBM 占用绝对值计量(128 负样本下 50.39 GB → 34.27 GB,占比 78.73% → 53.55%)。另一处值得注意的呼应:HLEM 明确指出 GR serving 与 LLM serving 的关键差异在于 GR 只有一次 forward pass、KV 无法像 LLM decode 那样与计算重叠,所以 KV CPU offloading 不可行;而 TurboGR 之所以能把负样本 embedding 卸载出去,正是因为它处在训练场景、且找到了一个天然可切分且用完即弃的张量——两篇论文一正一反,共同刻画了"GR 里什么能卸载、什么不能卸载"的边界。
CCD-Level and Load-Aware Thread Orchestration for In-Memory Vector ANNS on Multi-Core CPUs CCD-Level and Load-Aware Thread Orchestration for In-Memory Vector ANNS on Multi-Core CPUs (ECNU & Xiaohongshu, 2026-05-11)¶
关系:独立并发(早本文 2 天,同期投稿,互相引用不可能;且领域相隔较远——CPU chiplet 上的 ANNS 检索 vs NPU 集群上的 GR 训练)· 已加载对方精读
- 共同关注的问题:两篇给出的是同一句诊断的两个实例——"往并行机器上加计算单元,吞吐并不按比例增长,因为负载不规则且内存层级是分区的"。ANNS 论文实测 HNSW 从 16 核加到 96 核只有 9.9× 加速(96 核仅达理想吞吐 82%),IVF 超过 32 核后边际收益几乎归零,2–12 CCD 总加速比仅 1.6×–2.8×;TurboGR 实测集群扩张时线性度跌破 0.6、小模型 MFU 跌破 10%。两者归因也高度一致:(a) 工作量在任务间严重 skew(ANNS:per-table/per-cluster 搜索时间"陡头长尾",单表内存流量跨 1–4 个数量级;TurboGR:用户序列长尾分布,设备间最大 token 差 10,726),(b) 硬件的内存层级按单元分区(ANNS:每个 CCD 独占本地 L3,跨 CCD 不可见;TurboGR:不同 embedding 表散落在 HBM 相距很远的离散位置,朴素铺开会击穿 L2),(c) 朴素轮询派发对 skew 不敏感,反被跨单元偷任务进一步放大 cache 浪费。
- 相近的技术骨架:核心配方几乎逐条对应。(1) 冷热感知的任务-到-单元分组以保 cache 局部性:ANNS 的
pickCcd(id)遵循"黏性 + 反 hot-hot、亲 hot-cold"两条原则,把同一Mapping_ID的重复提交固定送回同一 CCD 以复用工作集,并刻意避免两张 hot 表撞进同一 CCD 触发 reciprocal eviction;TurboGR §4.1.2 的 kernel 划分策略先在表级别重构 batch 数据(把同一张表跨 batch 的数据聚齐再均匀铺到所有 AI Core),明确目标就是"提升 L2 cache 命中率并缓解冷热表访问模式导致的负载不均"——同一条"按数据身份而非按到达顺序分组"的原则。(2) 拓扑感知的负载再均衡:ANNS 用两级优先级(先 intra-CCD 偷、再 cross-CCD 偷)的 affinity task stealing;TurboGR 用按 token 数排序 + 贪心指派的 global token reallocation。(3) 最小侵入的 drop-in 接口:ANNS 强调统一submit()接口对 HNSW(inter-query)与 IVF(intra-query)都透明、"不修改索引实现";TurboGR 强调自定义融合算子与掩码机制"可在不破坏底层已优化通信后端的前提下接入",且对 HSTU 与 FuXi 一视同仁。 - 本文的差异与推进:分歧在负载信息是估计出来的还是精确已知的,这直接决定了两套系统的复杂度。ANNS 场景下 HNSW 与 IVF 都不暴露真实搜索内存流量,且 hot/cold 角色随时间窗口不断切换(论文 Figure 7),因此它必须推导轻量在线估计公式、维护 Workload Monitor 并周期性重映射——是一个闭环控制系统。TurboGR 的训练场景里,每个样本的 token 数在数据加载阶段就是精确已知的确定量,于是它可以一步到位地排序 + 贪心装箱,开环即可。另一处推进是 TurboGR 把均衡做在了两个层级上:设备间(global token reallocation / dynamic batch scaling)与设备内计算单元间(RAB 反向把规则计算卸给向量单元、标量单元只留不规则操作),而 ANNS 论文只在 CCD 这一个层级操作。
- 可比的方法 / 实验差异:度量口径不同但可换算——ANNS 报告加速比与 recall(HNSW 99%、IVF 95%),TurboGR 报告负载不均延迟占比(47.01% → 2.40%)与单步延迟(2340 ms → 1540 ms)。值得一提的是,ANNS 论文自陈其最相关的工业前驱是 Jain et al. (ASPLOS'25) 的 "Load and MLP-Aware Thread Orchestration for Recommendation Systems Inference on CPUs"——即推荐系统推理侧的线程编排;把这条线索与 TurboGR 放在一起看,"负载感知的任务编排"正在推荐系统的检索、推理、训练三个环节上各自独立地被重新发明,而 TurboGR 是其中训练侧、异构加速器上的那一版。
讨论与局限性¶
核心贡献与值得借鉴的设计¶
最值得借鉴的是三处"用结构性质换掉复杂机制"的设计。
第一是 HSP 对 2D sparse parallelism 的简化。文献 [18] 需要修改 "moment scale" 来补偿权重同步引起的有效学习率下降,这是一种事后补偿;HSP 转而重构 embedding lookup 的反向算子,引入组间 all-reduce 让所有组看到同一个 $G_t$,于是各组 AdaGrad 二阶矩自然同步演化,$S_{1,t} = \cdots = S_{M,t}$ 恒成立,优化轨迹与集中式训练数学等价。用一个不变量替掉一个补偿项,是系统论文里罕见的干净做法。
第二是 半异步的收敛界把"推荐数据稀疏"这一领域特性变成了系统设计的许可证。$O(\alpha L \tau / T)$ 这一项明确告诉工程师:延迟惩罚正比于特征碰撞概率 $\alpha$,而推荐场景 $\alpha \ll 1$ 是结构性事实,因此异步在这里比在稠密训练里安全得多。这条论证把"敢不敢异步"从经验判断变成了可估算的量。
第三是 负采样卸载对"段间独立性"的利用。识别出 logit 计算无跨段依赖、负样本 embedding 是规则 3D 稠密张量,是整个卸载方案能够零簿记开销的前提。相比之下,同期的 HLEM 因为 serving 侧负载不可预测而不得不上 PPO 控制器——两相对照更能看出识别代数结构的价值。
局限性与争议¶
1. 评测规模与论文主张之间存在落差。 摘要主打"large-scale generative recommendation",但最大模型只有 0.2B 参数(FuXi-large 201.55M),数据集是公开的 KuaiRand-27K(27,000 用户)。而 HSTU 原文谈的是 trillion-parameter 量级、ULTRA-HSTU 是 Meta 数十亿用户的生产系统。0.2B 在 GR 语境下并不算"large-scale",Challenge 2 所述"embedding 表按 scaling law 一起增长"的压力在这个规模上其实并未被真正施加——而这恰恰是 HSP 的假设最吃紧的地方(见下一条)。
2. HSP 用显存冗余换通信域收缩,其适用边界未被讨论。 HSP 要求每个并行组维护一份完整的 embedding 表副本。当 embedding 表真正达到工业规模(HLEM 论文提到生产规模 96TB Model-F、200TB+ Persia)时,"一组放得下一份完整表"这个前提直接失效,$M$ 无法增大,$O(N) \to O(I)$ 的收益也就无从谈起。论文既没有给出 $M$ 的选取准则,也没有讨论表规模上限,这是一个相当关键的缺口。
3. 缺少与 GPU 基线的横向对比。 全文所有"baseline"都是Ascend 上的朴素实现(native PyTorch 算子、vanilla TorchRec、fixed batchsize)。读者无法回答最自然的那个问题:同等成本下,TurboGR 在 Ascend 上的 54.71% MFU 相对成熟 GPU 方案处于什么位置?考虑到论文的动机段落大篇幅论述"GPU 优化搬到 NPU 会掉性能",最后不给一个跨硬件对照,说服力打了折扣。
4. 没有线上部署与 A/B 结果。 作为一篇华为出品的工业系统论文,全文没有任何生产环境部署、业务指标或线上稳定性数据,也未说明是否已在华为内部或客户侧承载真实流量。相比 ULTRA-HSTU(Meta 线上 +4%–8% 消费指标)、RecoGEM(快手线上 49% 延迟下降),TurboGR 更像一份框架发布 + 基准测试报告,工业落地的证据链是缺的。
5. Logit 共享的收益随规模衰减,且论文对此的处理是打补丁。 Table 8/9 显示 FuXi-large 需要 $k=4$ 而非 $k=2$ 才能追平基线,原因是高维 embedding 下 logit 间信息冗余使有效扩张维度低于配置的 $k$ 值。论文的应对是"提高 $k$",但没有回答更根本的问题:当模型继续放大(1B、10B)时 $k$ 是否会继续膨胀到抵消掉共享带来的节省?这条技术路线的 scaling 行为是未知的。
6. 部分实验设置披露不完整。 Table 5(半异步)的精度对比没有标明用的是哪个模型变体;Table 4(HSP)没有说明测试时的设备数 $N$ 与组数 $M$;Table 1 的 linear scalability 未说明是相对多少卡的基准计算的。对一篇系统论文而言,这些配置本应是可复现性的核心。
与已有工作的差异¶
TurboGR 在 GR 效率优化的谱系中占据一个明确且相对空白的生态位:算法侧不动、只做异构加速器上的训练基础设施。STAMP(2604.05329)同样加速 GR 训练,但走的是语义层的 token 剪枝与多步辅助监督,改变了被计算的内容;RankMixer(2507.15551)同样以 MFU 为核心指标(4.5% → 45%),但靠重新设计模型使其对硬件友好;ULTRA-HSTU 是算法-系统联合设计;RecoGEM(2603.11486)与 GRACE(2608.00938)都在推理侧。TurboGR 是唯一一篇把"模型不可改"当作硬约束、并因此必须为每项优化补上等价性或收敛性证明的。
工业落地价值¶
尽管缺少线上数据,TurboGR 的工程价值仍然明确:它是首个面向 Ascend NPU 开源的 GR 训练系统,对于因供应链或合规原因必须在国产加速器上训练 GR 模型的团队,这套 jagged 算子 + HSP + 六批次流水线的组合是可直接复用的起点。其中三项技术具备跨硬件可移植性——按 token 计的贪心负载再均衡、半异步的稀疏/稠密解耦、负采样的段式卸载——都不依赖 Ascend 特有指令,在 GPU 集群上同样成立。
未来方向(论文自陈)¶
论文列出三条:(1) 扩展支持 MoE 架构以进一步提升模型容量,同时引入专家级负载均衡与通信的新挑战;(2) 探索面向 Ascend NPU 定制的稀疏注意力机制,以解锁 16K–32K 的更长序列训练;(3) 集成自动并行搜索,在混合并行策略空间上联合优化,减少人工调参并提升跨集群配置的可移植性。这三条恰好指向前述局限中的规模瓶颈——尤其第三条,若能自动决定 HSP 的 $M$,将直接缓解局限 2。