Think-to-Personalize: 把「显式意图推理」和「稠密检索」压进同一个 LLM¶
机构:中国科学技术大学(USTC) + 美团(Meituan) · 会议:CIKM '26 · 代码:https://github.com/PhilipGAQ/ttp
1. 研究动机与背景¶
1.1 电商搜索里的 intent gap¶
稠密检索(dense retrieval)已经是现代电商搜索召回的基础设施:把 query 和 item 分别编码进语义向量空间,用 ANN 检索从千万级 item 池里捞候选。近年这条线的骨干正在从 encoder-only 架构(Contriever、Sentence-BERT、BGE)迁移到 LLM-based embedding 模型(NV-Embed、Llama2vec、Qwen3-Embedding)。
但论文指出,这些工作只是把 LLM 当成一个静态文本编码器(static text encoder),完全浪费了它的 chain-of-thought 推理能力。O1-Embedder、Search-R3、LREM 等近期工作开始纠正这一点——先让模型生成一段推理/查询扩展,再产出 reasoning-augmented 的 query embedding。
问题在于,这些方法仍然是 query-centric(以查询为中心)的。在本地生活电商(local-lifestyle e-commerce)场景里,用户 query 极度稀疏且歧义严重——本文自建测试集的平均 query 长度只有 6.2~10.1 个字符。这就造成了论文全篇的核心概念:
intent gap(意图鸿沟):query 的字面语义无法完整传达用户的潜在个性化意图,而这个意图恰恰藏在用户的历史行为里。
举例:用户搜「灌木(Shrub)」,字面上是植物;但如果他的历史订单里全是「悦咖啡」「枫叶咖啡」「花咖啡」这类精品咖啡馆,那么真实意图大概率是某个叫「Shrub」的咖啡品牌,而非园艺植物。
1.2 已有个性化检索路线的两条病¶
路线一:隐式历史建模(implicit history modeling)。UIA 用 cross-attention 按当前 query 动态聚合用户历史表征;Etsy 的 UEPPR 把短期行为(query、点击)和长期偏好(购买标签、地理偏好)统一进一个 Query-User Tower;快手的 OneSearch 把短期行为塞进 prompt、把长期偏好压成 RQ-OPQ 向量后直接生成 item ID。这些方法的共同问题是:依赖 embedding 层面的隐式交互,没有显式推理能力,无法从充满噪声的历史序列里把「与当前 query 相关的那一小撮证据」挑出来并做出可解释的意图判断。
路线二:生成式增强(generative-enhanced)。CoPS 给 LLM 配记忆机制做个性化搜索,PBR 用 LLM 基于历史生成伪 query 和推理链。这些方法的病更隐蔽——它们运行在一条 disjoint pipeline(脱节的流水线)上:LLM 作为一个外部改写器(external re-writer),优化目标是 causal language modeling(下一 token 预测),而不是下游的检索效用(retrieval utility)。于是生成出的 rationale 与检索目标之间存在系统性错配:改写得「像人话」不等于改写得「好检索」。
论文由此提炼出核心挑战:如何以端到端的方式,把显式意图推理与稠密检索统一起来,从而弥合字面 query 与潜在个性化意图之间的 intent gap。
1.3 贡献¶
- 提出 TTP(Think-to-Personalize),一个 reasoning-driven 框架,把 user-centric 意图推理与稠密检索统一进单个模型,产出动态的个性化 embedding;
- 提出 SFT + RL 两阶段训练策略,用 GRPO 把模型的推理能力与检索目标对齐;
- 完整的离线 + 在线实验,含大规模工业部署(美团本地生活平台)。
2. 核心方法 / 模型架构¶
2.1 框架总览与形式化¶
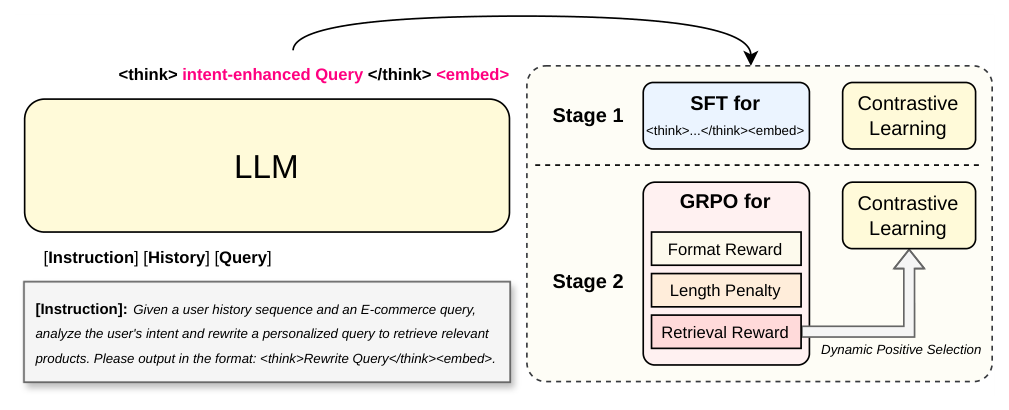
设 $\mathcal{U}$ 为用户集合、$\mathcal{I}$ 为 item 集合。对用户 $u$,观测到历史行为序列 $H_u = \{i_{u,1},\dots,i_{u,t}\}$(历史购买过的 item,每个 item 用其文本元数据表示:标题、品类、店名等)。给定 query $q$,目标是检索出最相关的目标 item $i^+ \in \mathcal{I}$。
与传统 query-centric 稠密检索只编码当前 query 不同,TTP 把用户历史与意图推理一并纳入 query 编码过程。query 侧输入构造为:
$$x = \texttt{[INST]} \oplus I_{task} \oplus H_u \oplus q \oplus \texttt{[/INST]} \tag{1}$$
其中 $I_{task}$ 是指令模板(Table 1),原文为:
Given a user history sequence and an E-commerce query, analyze the user's intent and rewrite a personalized query to retrieve relevant products. Please output in the format:
<think>Rewrite Query</think><embed>
模型随后生成被 <think> / </think> 包裹的 intent-enhanced query $r$,后接一个特殊的 <embed> token:
$$y = \texttt{<think>} \oplus r \oplus \texttt{</think>} \oplus \texttt{<embed>} \tag{2}$$
最终的 query embedding $\mathbf{e}_q$ 取自 <embed> token 的最后一层 hidden state。 item 侧同样把文本元数据序列化后追加同一个 <embed> token,用共享的同一个 encoder 抽出 $\mathbf{e}_i$。相关性分数为内积 $s(q,i) = \mathbf{e}_q^\top \mathbf{e}_i$。
这个设计是全文的机制核心:生成(think)与表征(embed)发生在同一次前向、同一套参数里,因此检索监督信号可以直接反向传播、塑造被生成的个性化意图文本——这正是 disjoint pipeline 做不到的事。由于 query 塔与 item 塔共享 encoder,两侧在训练中被对称更新。
2.2 推理增强的数据构造¶
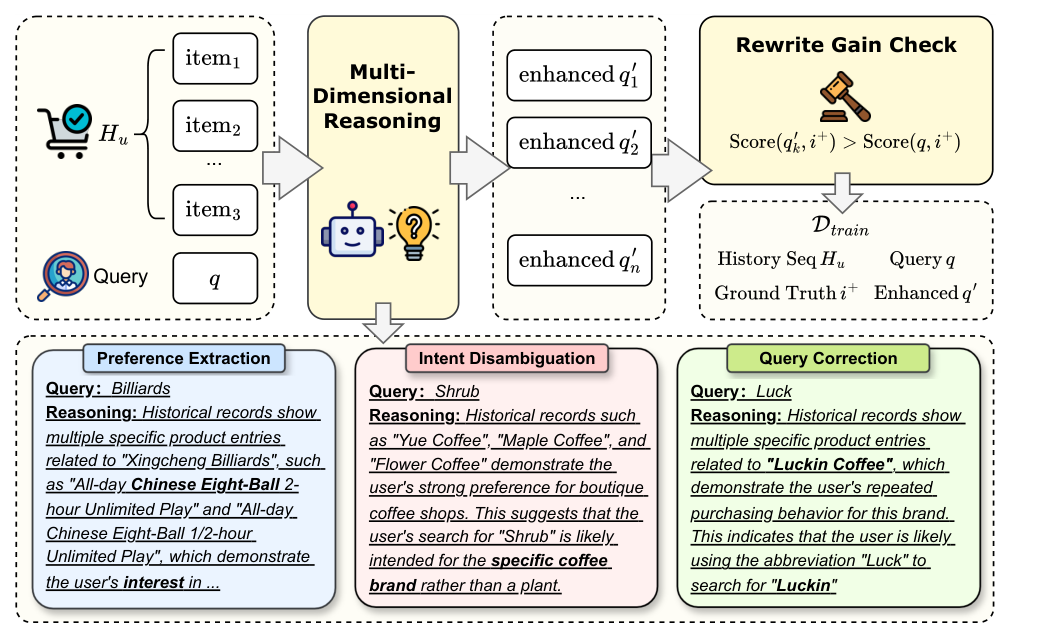
历史截断。先从过去一年的日志里过滤出用户购买记录构成 $H_u$,每个 item 按元数据字段(Title / Category / Menu)拼成文本串。对历史长度超过 $N$ 的用户,用开源的 bge-reranker-v2-m3 选出与当前 query 最相关的 top-$N$ 个 item,再按时间顺序重排作为最终截断历史。注意这里的两步顺序很关键:相关性做筛选、时序做排列。
教师生成。用 Qwen3-32B 构造推理增强数据集。给定 $I_{task}$、处理后的 $H_u$ 和 $q$,提示教师模型先做显式 CoT 推理再生成候选 intent-enhanced query。教师被要求在三个维度上做多维推理:
- Preference Extraction(偏好抽取):当前 query 意图已较清晰时,从历史中抽取与 query 相关的个性化偏好(品牌倾向、风格调性),在保持原意图的前提下细化 query;
- Intent Disambiguation(意图消歧):当 query 宽泛、模糊或欠指定时,用行为上下文推断最可能的意图并改写;
- Query Correction(查询纠错):基于历史上下文隐式纠正错别字、不完整输入、缩写,恢复精确检索意图。
此外还有第四类 No Rewrite:若历史没有提供清晰相关的证据,或个性化可能扭曲原意,则保持原 query 不变——这是防止 over-personalization 的显式约束。完整 teacher prompt 见下:
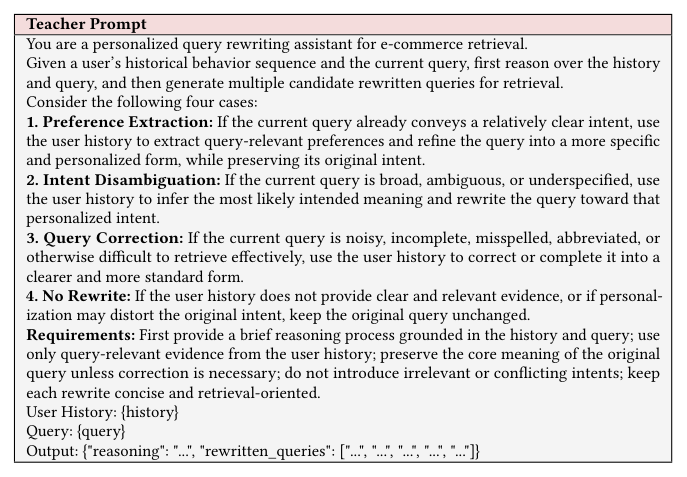
为降低学生模型的推理延迟,中间推理步骤被丢弃,只保留改写后的 query 作为训练目标。
质量过滤。每个样本用 Qwen3-32B 默认解码配置生成 $K=5$ 个候选改写;再用 bge-reranker-v2-m3 对每个改写相对 ground-truth 正样本 $i^+$(用户在当前 query 下最终购买的 item)打分;过滤掉相关性增益非正的改写,然后从按增益排序的 top-3 里均匀采样一个作为训练目标。为防止分布偏向「过度改写」,还会保留一定比例的中性样本(教师判定应保持原 query 的那些),让模型学会「什么时候不该改」。
2.3 Stage 1:Cold-Start SFT¶
第一阶段用 SFT 建立「严格遵循输入格式 + 产出有效 embedding」的能力。<think>、</think>、<embed> 被加入 tokenizer 的 special tokens。训练数据是 $(x, \hat{y})$ 对。
采用生成 + 对比的联合损失。其一是标准 NTP(Next Token Prediction)损失,作用于推理内容和特殊 token:
$$\mathcal{L}_{gen} = -\frac{1}{|\hat{y}|}\sum_{t=1}^{|\hat{y}|} \log P(\hat{y}_t \mid \hat{y}_{<t}, x) \tag{3}$$
其二是对比目标,从 <embed> token 的最后 hidden state 抽出 $\mathbf{e}_q$,用 InfoNCE:
$$\mathcal{L}_{cl} = -\log \frac{\exp(s(q,i^+)/\tau)}{\exp(s(q,i^+)/\tau) + \sum_{j\in\mathcal{N}}\exp(s(q,i_j^-)/\tau)} \tag{4}$$
其中 $\mathcal{N}$ 是 in-batch negatives 集合。Stage 1 总损失:
$$\mathcal{L}_{Stage1} = \lambda_{gen}\mathcal{L}_{gen} + \mathcal{L}_{cl} \tag{5}$$
实验中 $\lambda_{gen} = 0.5$,用来平衡「推理格式的结构学习」与「检索的语义对齐」。这一阶段是冷启动,让模型同时初始化生成能力与检索能力。
2.4 Stage 2:检索对齐的强化学习¶
SFT 给了好的初始化,但生成的推理未必对检索最优。Stage 2 用 GRPO 结合 InfoNCE 把推理生成与检索表现对齐。
2.4.1 复合奖励设计¶
总奖励为 $R = \lambda_{fmt}R_{format} + \lambda_{len}R_{length} + \lambda_{ret}R_{retrieval}$。
Format Reward(强制结构合法性):
$$R_{format} = \begin{cases} 0 & \text{若输出符合 <think> 格式} \\ -1 & \text{否则} \end{cases} \tag{6}$$
Length Penalty(防冗长、降延迟),惩罚超过阈值 $L$ 的输出:
$$R_{length} = -\max(0,\ |y| - L) \tag{7}$$
Retrieval Reward——全文最关键的设计。论文把冻结的 SFT 模型同时用作 KL 散度的 reference model 和检索 reward model。理由是:SFT 模型已经建立了强判别性检索能力,因此它是一个稳定的语义锚点(stable semantic anchor),本身就与最终检索目标内在对齐;冻结它可以保证策略优化被稳定可靠的检索信号引导,而不是被一个不断演化的奖励空间引导,从而避免 self-referential bias 与 reward drift。对生成的 intent-enhanced query $q'$,基于相关性增益计算:
$$R_{retrieval} = \alpha\cdot\Delta S_{pos} + \beta\cdot\Delta S_{margin} \tag{8}$$
其中 $\Delta S_{pos} = s(q',i^+) - s(q,i^+)$ 是对正样本的绝对增益;$\Delta S_{margin}$ 是相对负样本均值的 margin 提升:
$$\Delta S_{margin} = \bigl(s(q',i^+) - \bar{S}(q',\mathcal{N})\bigr) - \bigl(s(q,i^+) - \bar{S}(q,\mathcal{N})\bigr) \tag{9}$$
$\Delta S_{pos}$ 直接鼓励模型生成与目标 item 更相关的 query;$\Delta S_{margin}$ 则鼓励模型增强对负样本的判别力(光把正样本拉近不够,还得把负样本推开)。最终 $R_{retrieval}$ 被裁剪到 $[-1,1]$ 以稳定训练。
2.4.2 优化目标¶
GRPO 目标:对每个输入 $x$,从旧策略 $\pi_{\theta_{old}}$ 采样一组 $G$ 个输出 $\{y_1,\dots,y_G\}$。设概率比 $\rho_i = \frac{\pi_\theta(y_i|x)}{\pi_{\theta_{old}}(y_i|x)}$,GRPO 在没有 value network 的情况下最大化高奖励输出的优势:
$$\mathcal{L}_{GRPO} = -\frac{1}{G}\sum_{i=1}^{G}\Bigl[\min\bigl(\rho_i A_i,\ \mathrm{clip}(\rho_i, 1-\epsilon, 1+\epsilon)A_i\bigr) - \beta_{KL}D_{KL}\bigl(\pi_\theta(y_i|x)\,\|\,\pi_{ref}(y_i|x)\bigr)\Bigr] \tag{10}$$
其中 $A_i = \frac{R_i - \bar{R}}{\sigma_R}$ 是归一化优势。
Dynamic Positive Selection(动态正样本选择)——第二个关键设计。若把 group 里采样出的所有 rollout 都拿去做对比学习,噪声极大。TTP 只从组内挑出最优 rationale:
$$y^* = \mathop{\arg\max}_{y_i\in\{y_1\dots y_G\}} R_{retrieval}(y_i) \tag{11}$$
然后有条件地更新 embedding 空间:若 $R_{retrieval}(y^*) > 0$,用 $y^*$ 的 embedding 作为正样本 query 表征;否则回退到原始 query $q$ 的 embedding。这一步等于在对比学习信号上做去噪——只有当改写确实带来检索增益时才让它进入表征学习。$\mathcal{L}_{cl}$ 用这个被选中的 embedding 计算。
Stage 2 总目标:
$$\mathcal{L}_{Stage2} = \mathcal{L}_{GRPO} + \lambda_{cl}\mathcal{L}_{cl} \tag{12}$$
3. 实验设置¶
3.1 数据集与评估指标¶
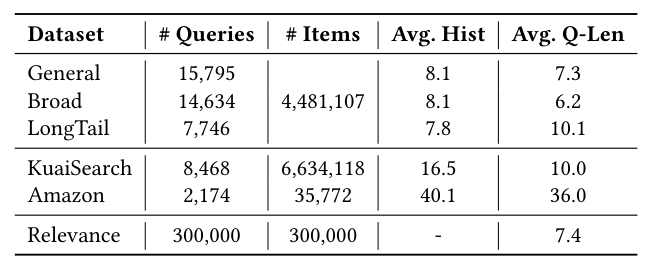
| 数据集 | # Queries | # Items | Avg. Hist | Avg. Q-Len |
|---|---|---|---|---|
| General | 15,795 | 4,481,107 | 8.1 | 7.3 |
| Broad | 14,634 | (同上) | 8.1 | 6.2 |
| LongTail | 7,746 | (同上) | 7.8 | 10.1 |
| KuaiSearch | 8,468 | 6,634,118 | 16.5 | 10.0 |
| Amazon | 2,174 | 35,772 | 40.1 | 36.0 |
| Relevance | 300,000 | 300,000 | - | 7.4 |
专有测试集(四个):
- General:从线上搜索日志采样的 1.5 万+ query,配对用户历史购买序列与真实购买 item 作为 ground truth;
- Broad:聚焦歧义/欠指定 query,专门评估意图消歧能力;
- LongTail:真实 query 分布尾部 10% 的低频 query;
- Relevance:无用户历史的相关性测试集,30 万 query-item 对,由内部领域自适应的 13B 相关性 LLM 标注三档相关性等级。
公开基准(两个):KuaiSearch(用 lite recall 版本,历史由点击 + 购买构成)与 Amazon(用广泛采用的 PersonalWAB 合成 query 版本,基于 Amazon Reviews 构造,历史来自过往购买序列)。论文明确说明为何不用 JDSearch 和 KuaiSAR:这两个数据集只提供加密或 ID 化的 token 文本而非自然语言 item 内容,不适合评估意图推理。
指标:General / Broad / LongTail 报 Recall@K($K=10,20,100$)与 MRR@100;Relevance 报模型打分与相关性标签的 Spearman 相关系数;公开基准遵循其原始评测协议。
3.2 Baseline¶
分三类:
- 通用检索器:BM25、BERT-base、Qwen-Embedding(后两者分别基于 BERT-base 和 Qwen2.5-3B-Instruct 的双塔稠密检索器,仅用对比学习训练);
- 隐式历史建模:UIA、History-Aware、MAPs、CoPPS。其中 History-Aware 是历史拼接 baseline——把序列化用户历史用与 TTP 相同的策略前置到 query 上,但只用对比学习训练(即:有历史、无推理);
- 生成式增强:HyDE、P-PRF、Decoupled-Stage。所有生成式 baseline 用 Qwen2.5-3B-Instruct 作生成器、Qwen-Embedding 作检索器。Decoupled-Stage 是最强的 rewrite-then-retrieve baseline:改写器在与 TTP 完全相同的 SFT 数据上微调后冻结,用它生成改写 query 去训练一个独立的检索器,检索监督也与 TTP 一致。这是全文最关键的对照组——它把「数据/监督相同、只是 pipeline 脱节」这一个变量隔离了出来。
3.3 实现细节¶
- 骨干:Qwen2.5-3B-Instruct;embedding 维度 2048;query/item 输入均截断到 512 token(超长时优先截断历史序列,保留指令、当前 query 与核心 item 内容)。
- 数据规模:专有平台用 Qwen3-32B 生成并清洗 100 万条 intent-enhanced 训练样本;全量清洗数据用于 SFT,按改写增益排序取 top 30% 用于 RL(让 RL 聚焦在「改写质量对检索影响最大」的样本上)。KuaiSearch 训练集 287,093 条,Amazon(PersonalWAB)6,896 条,SFT/RL 分配比例与专有场景一致。
- 元数据序列化:
key:value用[SEP]分隔。专有平台字段为 title / product / menu / geolocation;KuaiSearch 为 brand name / title / category / seller;Amazon 为 title / main category / features。 - SFT:LoRA($r=16$, $\alpha=32$),per-device batch size 64,lr $1\text{e-}4$,$\lambda_{gen}=0.5$,InfoNCE 温度 $\tau=0.02$;query 塔与 item 塔共享骨干并同步更新。所有对比目标(SFT / RL / 蒸馏)均用 in-batch negatives。
- RL:基于 VeRL 框架;GRPO group size $N=8$;训练 3 epoch,lr $2\text{e-}7$,total batch size 128。奖励权重 $\lambda_{fmt}=0.5$、$\lambda_{len}=0.5$(阈值 $L=64$ tokens)、$\lambda_{ret}=2.0$;$R_{retrieval}$ 用 $\alpha=2.0$、$\beta=1.0$ 并裁剪到 $[-1,1]$;$\lambda_{cl}=0.1$。
- 硬件:8× NVIDIA A100。
4. 主要实验结果¶
4.1 四个专有测试集总表(Table 4)¶
指标单位为 %。最优加粗,次优加下划线(此处以文字标注)。
| Method | Gen R@10 | Gen R@20 | Gen R@100 | Gen MRR | Broad R@10 | Broad R@20 | Broad R@100 | Broad MRR | LT R@10 | LT R@20 | LT R@100 | LT MRR | Relevance Spearman |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| General Retrievers | |||||||||||||
| BM25 | 31.01 | 42.37 | 61.96 | 13.28 | 31.46 | 42.04 | 58.80 | 12.65 | 22.48 | 29.15 | 42.50 | 11.14 | - |
| BERT-base | 31.77 | 42.83 | 63.82 | 12.84 | 33.01 | 42.65 | 60.39 | 12.83 | 21.86 | 28.36 | 42.89 | 9.52 | 45.70 |
| Qwen-Embedding | 33.25 | 44.20 | 64.55 | 14.01 | 31.89 | 41.27 | 58.15 | 13.42 | 23.14 | 29.76 | 45.08 | 10.66 | 48.51 |
| Implicit History Modeling | |||||||||||||
| UIA | 31.06 | 42.19 | 62.87 | 14.14 | 33.45 | 42.25 | 57.67 | 15.79 | 24.28 | 32.18 | 46.44 | 11.61 | - |
| History-Aware | 33.23 | 42.47 | 61.18 | 15.27 | 33.70 | 42.39 | 58.08 | 15.82 | 25.29 | 32.66 | 46.86 | 12.44 | - |
| MAPs | 33.31 | 45.76 | 66.03 | 14.92 | 34.62 | 45.57 | 61.01 | 16.18 | 25.45 | 33.84 | 47.19 | 13.25 | - |
| Generative-Enhanced | |||||||||||||
| HyDE | 27.93 | 36.86 | 53.81 | 12.76 | 24.61 | 31.29 | 44.17 | 11.43 | 23.14 | 29.76 | 45.08 | 10.66 | - |
| P-PRF | 33.78 | 43.06 | 64.96 | 14.82 | 34.85 | 43.76 | 60.99 | 15.01 | 25.73 | 32.91 | 46.12 | 12.31 | - |
| Decoupled-Stage | 34.54 | 45.89 | 65.03 | 14.76 | 36.14 | 45.08 | 60.70 | 16.21 | 27.57 | 35.18 | 51.13 | 13.41 | - |
| Our Method | |||||||||||||
| TTP (SFT Only) | 34.64 | 45.38 | 65.01 | 15.34 | 36.43 | 45.66 | 61.06 | 16.33 | 27.96 | 35.70 | 51.67 | 13.89 | 49.43 |
| TTP (SFT+RL) | 36.64 | 47.52 | 68.02 | 16.78 | 39.31 | 48.74 | 65.12 | 17.91 | 30.30 | 38.65 | 54.47 | 15.04 | 50.09 |
TTP(SFT+RL) 相对最优 baseline 的提升在 $p<0.05$ 下统计显著。Relevance 集无用户历史,故依赖历史的 baseline 无结果。
五条结论:
- 历史上下文的重要性。所有引入用户历史的方法(隐式建模、生成式增强、本文)都一致优于只用当前 query 的通用检索器。这验证了 intent gap 在电商场景确实普遍存在。
- 整体优越性。TTP(SFT+RL) 在每个指标上都超过所有 baseline。在 General 上比最强隐式 baseline MAPs 高 +1.76% R@20、+1.99% R@100;比最强脱节 pipeline Decoupled-Stage 高 +1.63% R@20、+2.99% R@100。后一条尤其重要——Decoupled-Stage 用的是同一份 SFT 数据、同一份检索监督,唯一差别就是「改写器与检索器是否统一」,因此这 1.63/2.99 个点可以直接归因于端到端统一框架本身。
- 弥合 intent gap。TTP 的优势在高歧义场景最显著:Broad 上相对 Qwen-Embedding 的 R@20 提升高达 +7.47%,远高于 General 上的 +3.32%;LongTail 上相对 Decoupled-Stage 提升 +3.47% R@20,也高于 General 上的 +1.63%。这说明query 越稀疏模糊,用户潜在意图就越根植于历史,显式挖掘的收益越大。
- RL 对齐的有效性。SFT Only → SFT+RL 在所有指标上一致提升(General R@10 从 34.64% 到 36.64%)。关键是 Relevance 集上 Spearman 从 49.43 升到 50.09——这个集没有用户历史,说明 RL 阶段不仅精炼了个性化推理,还保住了模型的基础语义判别能力,在冷启动场景下依然鲁棒。这一点回应了「个性化会不会伤害通用相关性」的常见质疑。
- HyDE 是全表唯一负向的方法(General R@20 36.86 < BM25 的 42.37)。它做的是零样本假设文档生成,完全不看用户历史,在短 query 电商场景下反而引入噪声。
4.2 公开基准(Table 5)¶
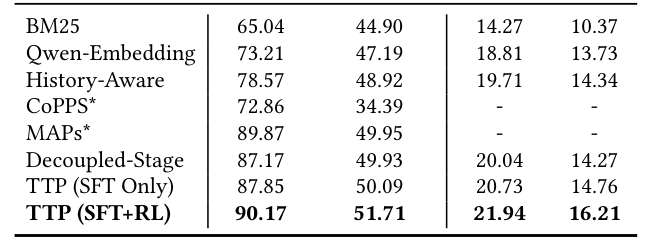
| Method | Amazon HR@20 | Amazon nDCG@20 | KuaiSearch HR@20 | KuaiSearch R@20 |
|---|---|---|---|---|
| BM25 | 65.04 | 44.90 | 14.27 | 10.37 |
| Qwen-Embedding | 73.21 | 47.19 | 18.81 | 13.73 |
| History-Aware | 78.57 | 48.92 | 19.71 | 14.34 |
| CoPPS* | 72.86 | 34.39 | - | - |
| MAPs* | 89.87 | 49.95 | - | - |
| Decoupled-Stage | 87.17 | 49.93 | 20.04 | 14.27 |
| TTP (SFT Only) | 87.85 | 50.09 | 20.73 | 14.76 |
| TTP (SFT+RL) | 90.17 | 51.71 | 21.94 | 16.21 |
带 * 的数值引自原论文。在 Amazon 上 TTP(SFT+RL) 超过 CoPPS、MAPs 与 Decoupled-Stage;在 KuaiSearch 上同样最优。值得注意的是 MAPs 在 Amazon HR@20 上是最强 baseline(89.87),TTP 只领先 0.30 个点,但在 nDCG@20 上领先 1.76 个点——说明 TTP 的增益更多体现在把正确 item 排得更靠前而非单纯捞回来。这组结果说明 TTP 的收益不局限于自家专有平台。
4.3 定性分析¶
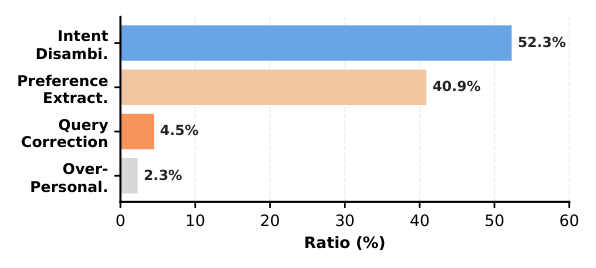
随机采样 200 个 broad query,请人工专家把生成的 intent-enhanced query 标注为五类。全部样本中有 34.0% 被保持原样(Keep Original)——这符合预期,因为并非所有历史行为都对当前 query 有用,在历史无清晰证据时保留原 query 才是正确行为。
在被改写的样本内部,分布为:
| 改写类型 | 占比 |
|---|---|
| Intent Disambiguation | 52.3% |
| Preference Extraction | 40.9% |
| Query Correction | 4.5% |
| Over-Personalization(有害) | 2.3% |
也就是说,当 TTP 决定改写时,93.2% 的干预落在两种最有价值的方式上(消歧 + 注入个性化偏好),而有害的过度个性化被压在 2.3%。
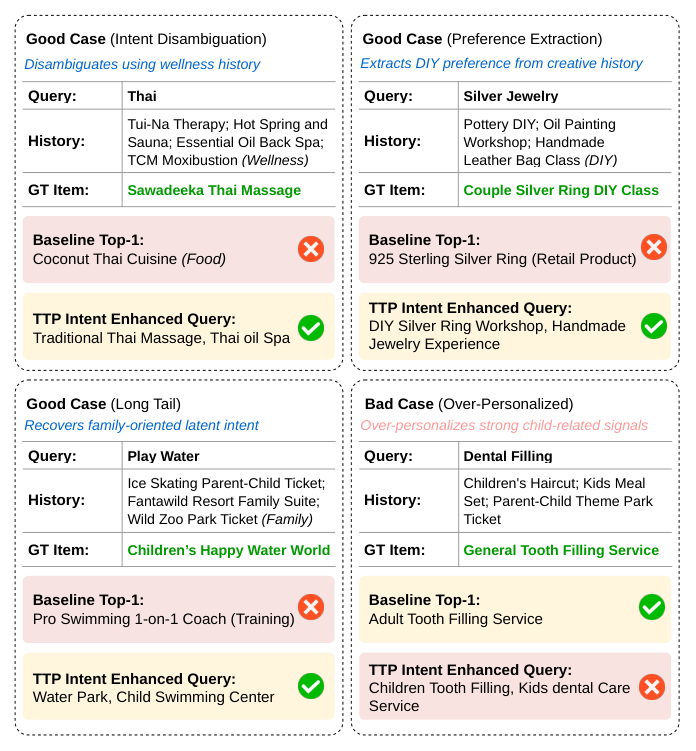
三个成功案例 + 一个失败案例:
| 类型 | Query | 历史(代表性关键词) | Baseline Top-1 | TTP 改写 | GT Item |
|---|---|---|---|---|---|
| 意图消歧 | Thai | 推拿理疗、温泉桑拿、精油背部 SPA、中医艾灸 | Coconut Thai Cuisine(餐饮) | Traditional Thai Massage, Thai oil Spa | Sawadeeka Thai Massage |
| 偏好抽取 | Silver Jewelry | 陶艺 DIY、油画工坊、手工皮具课 | 925 纯银戒指(零售商品) | DIY Silver Ring Workshop, Handmade Jewelry Experience | 情侣银戒 DIY 课程 |
| 长尾 | Play Water | 亲子滑冰票、方特度假区家庭套房、野生动物园门票 | 专业游泳 1 对 1 教练(培训) | Water Park, Child Swimming Center | 儿童欢乐水世界 |
| 失败(过度个性化) | Dental Filling | 儿童理发、儿童套餐、亲子主题乐园票 | 成人补牙服务 | Children Tooth Filling, Kids dental Care Service | 普通补牙服务 |
失败案例暴露了模型的局限:在强烈且一致的历史家庭信号下,TTP 会过度泛化过往偏好,把「补牙」扩成儿童专属的口腔意图。这是「个性化强度」与「意图保真度」之间无法回避的张力——注意 baseline 在这个 case 上反而是对的。
5. 消融与分析¶
5.1 核心组件消融(Table 6)¶
| Method | General R@20 | Broad R@20 | LongTail R@20 | Avg. R@20 |
|---|---|---|---|---|
| Qwen-Embedding | 44.20 | 41.27 | 29.76 | 38.41 |
| Decoupled-Stage | 45.89 | 45.08 | 35.18 | 42.05 |
| TTP (SFT) | 45.38 | 45.66 | 35.70 | 42.25 |
| TTP (SFT) w/o Intent-Q | 44.48 | 43.68 | 33.66 | 40.61 |
| TTP (SFT+RL) w/o Intent-Q | 44.81 | 44.93 | 34.30 | 41.35 |
| TTP (SFT+RL) w/o Dynamic Sele. | 41.39 | 41.02 | 30.71 | 37.71 |
| TTP (SFT+RL) | 47.52 | 48.74 | 38.65 | 44.97 |
三条结论:
- 仅 SFT 后 TTP 已在 Broad/LongTail 上超过 Decoupled-Stage(42.25 vs 42.05 平均),说明共享 encoder 联合建模推理与检索本身就有收益——检索目标可以直接塑造被生成的意图表征,减少改写与检索之间的错配。
- 检索时把 intent-enhanced query 换回原 query(w/o Intent-Q),三个测试集一致掉点(SFT: 42.25→40.61;SFT+RL: 44.97→41.35)。这证实显式意图推理是提升的主要来源,而不是一个附带的生成步骤。
- 移除 Dynamic Positive Selection 造成最大退化(44.97→37.71),甚至低于纯 SFT 的 42.25——即「做了 RL 反而更差」。这说明 GRPO 的 rollout 过程频繁产生噪声/低质 query,随机拿它们做对比学习的正样本会引入严重噪声。
5.2 Intent-Enhanced Query 的增益(Figure 5)¶
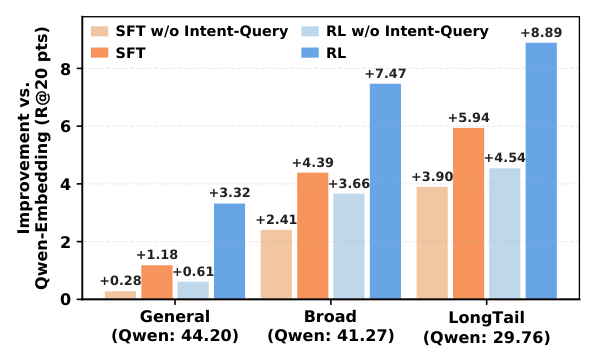
相对 Qwen-Embedding 的 R@20 绝对提升(单位:点):
| 变体 | General(Qwen 44.20) | Broad(Qwen 41.27) | LongTail(Qwen 29.76) |
|---|---|---|---|
| SFT w/o Intent-Query | +0.28 | +2.41 | +3.90 |
| SFT | +1.18 | +4.39 | +5.94 |
| RL w/o Intent-Query | +0.61 | +3.66 | +4.54 |
| RL | +3.32 | +7.47 | +8.89 |
三条观察:
- 显式生成的 intent-enhanced query 在两个训练阶段、三个测试集上都带来正增益;
- RL 之后 intent-enhanced query 带来的增量显著变大。以 Broad 为例,SFT 阶段的额外收益是 $4.39-2.41 = +1.98$ 点,RL 之后扩大到 $7.47-3.66 = +3.81$ 点。这说明 RL 不只是提升了生成质量,更重要的是把生成的意图与下游检索效用对齐了;
- Broad 与 LongTail 上的增益一致大于 General,再次印证显式意图推理对模糊与稀疏 query 尤其有用。
5.3 RL 训练策略消融(Table 7)¶
| Method | General R@20 | Broad R@20 | LongTail R@20 | Avg. R@20 |
|---|---|---|---|---|
| TTP (SFT Only) | 45.38 | 45.66 | 35.70 | 42.25 |
| w/o Dynamic Selection | 41.39 | 41.02 | 30.71 | 37.71 |
| w/ Unfrozen Reward Model | 32.48 | 33.74 | 22.36 | 29.53 |
| w/o Positive Gain ($\alpha$) | 45.18 | 45.75 | 35.29 | 42.07 |
| w/o Margin Gain ($\beta$) | 46.82 | 47.16 | 37.73 | 43.90 |
| TTP (SFT+RL) | 47.52 | 48.74 | 38.65 | 44.97 |
- w/ Unfrozen Reward Model 是全文最触目惊心的数字:平均 R@20 崩到 29.53%,比不做任何 RL 的 SFT(42.25)低 12.7 个点,甚至低于 Qwen-Embedding(38.41)。让训练中的 policy model 给自己打分会产生严重的 self-referential bias,模型转而去利用自己打分函数的漏洞(reward hacking),而不是优化真实相关性。冻结的 SFT 模型作为稳定语义锚点,是整个 RL 阶段能否成立的前提。
- 移除 positive gain($\alpha$)掉到 42.07,移除 margin gain($\beta$)掉到 43.90——两者都有贡献,但 positive gain 更关键。前者直接鼓励相对原 query 提升相关性,后者进一步把正样本从负样本中区分开。
5.4 历史序列长度(Figure 6)¶
用 bge-reranker-v2-m3 从完整历史中选 top-$N$,变化 $N\in\{5,10,15,20\}$:
| $N$ | General | Broad | LongTail | Avg. |
|---|---|---|---|---|
| 5 | 46.85 | 47.89 | 37.71 | 44.15 |
| 10 | 47.52 | 48.74 | 38.65 | 44.97 |
| 15 | 47.40 | 48.77 | 38.33 | 44.80 |
| 20 | 47.18 | 48.49 | 38.05 | 44.57 |
性能在 $N=10$ 达到峰值,更长的历史引入噪声、收益递减。(Broad 上 $N=15$ 略高 0.03 点,属噪声范围。)这与 §5.1 的整体叙事一致:TTP 的价值不在于「看得多」,而在于「从相关的少量证据里推出正确意图」。
6. 部署与在线结果¶
6.1 混合在线服务框架¶
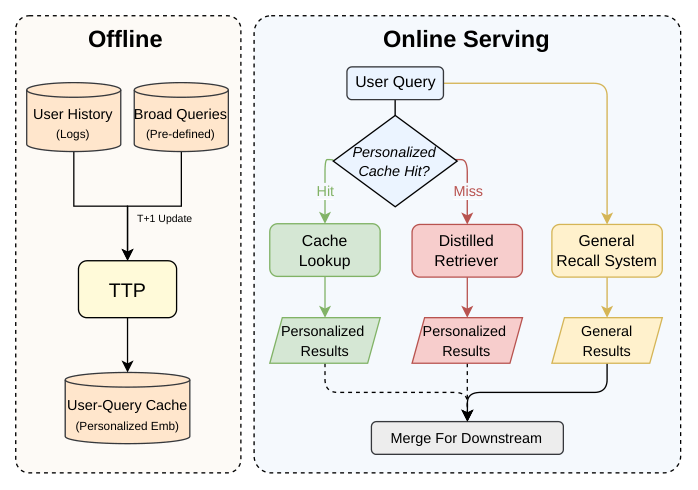
3B LLM 无法直接扛住线上召回的 QPS,论文设计了离线个性化缓存 + 轻量蒸馏检索器的混合框架:
离线个性化缓存。通过 T+1 日更,完整的 LLM 版 TTP 为「活跃用户 × 预定义 broad query」对预计算 intent-enhanced query embedding。缓存命中时直接用存储的 embedding 做 ANN 检索。这条命中路径覆盖 10.59% 的 query volume (QV) 与 11.80% 的 user volume (UV);未命中走蒸馏检索器。
蒸馏实时检索。对缓存 miss,把 TTP 的个性化改写能力用 InfoNCE 蒸馏进一个 encoder-only 的 305M 双编码器。构造原始 query 视图 $q$ 与 intent-enhanced 视图 $q_r$(用相同的 instruction + history + query 模板),正样本 item 记为 $p^+$。模型以 1:1:1 等权联合优化 $\langle q, p^+\rangle$、$\langle q_r, p^+\rangle$、$\langle q, q_r\rangle$ 三个目标,均用 in-batch negatives。
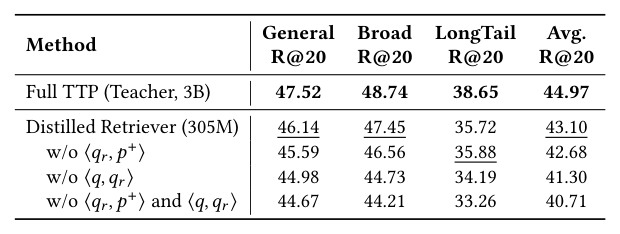
| Method | General R@20 | Broad R@20 | LongTail R@20 | Avg. R@20 |
|---|---|---|---|---|
| Full TTP (Teacher, 3B) | 47.52 | 48.74 | 38.65 | 44.97 |
| Distilled Retriever (305M) | 46.14 | 47.45 | 35.72 | 43.10 |
| w/o $\langle q_r, p^+\rangle$ | 45.59 | 46.56 | 35.88 | 42.68 |
| w/o $\langle q, q_r\rangle$ | 44.98 | 44.73 | 34.19 | 41.30 |
| w/o $\langle q_r, p^+\rangle$ 和 $\langle q, q_r\rangle$ | 44.67 | 44.21 | 33.26 | 40.71 |
305M 学生保住了 3B 教师 95.8% 的平均 R@20(43.10 vs 44.97),模型缩小近 10 倍。 后两项目标(尤其是 $\langle q, q_r\rangle$ 这条视图对齐目标,移除后掉 1.80 点)把个性化改写语义迁移进了原始 query 的表征——学生在线上并不真的生成改写,而是让原 query 的 embedding 直接「带上」改写后的语义,这是整个蒸馏方案的巧妙之处。
6.2 吞吐-效果权衡¶
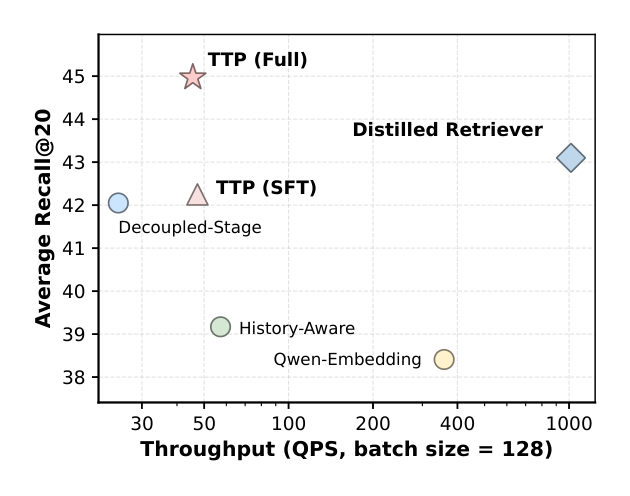
单卡 A100 80GB、batch size 128 下测吞吐。完整 TTP 比脱节的两阶段 pipeline(Decoupled-Stage)更高效——因为后者要跑两次模型(先改写器、再检索器),而 TTP 一次前向同时完成推理与编码。蒸馏检索器则在实时服务场景取得最优的效果-效率折中(吞吐接近 1000 QPS 量级,同时平均 R@20 仍在 43 附近)。
6.3 在线 A/B 实验¶
7 天线上 A/B:把 TTP 作为额外的个性化召回通道接入,保持通用召回系统、候选预算、下游排序链路不变。
| Metric | Relative Lift |
|---|---|
| QV CXR | +0.41% |
| UV CXR | +0.29% |
| Order Volume | +0.46% |
| Avg. Latency | +0.15 ms |
所有效果指标在 $p<0.05$ 下显著。仅 0.15 ms 的端到端额外延迟得益于缓存/蒸馏设计与「与通用召回并行执行」。系统已在平台上线。
7. 核心贡献总结¶
- 把 intent gap 定位为「query-centric 范式的结构性缺陷」而非数据问题,并给出了 Broad / LongTail 两个针对性测试集来量化它。
<think>…</think><embed>这一 token 级接口:让同一个 LLM 在同一次前向里既生成个性化改写、又输出用于 ANN 的稠密向量,检索监督得以直接反向传播塑造生成内容。Decoupled-Stage 这一严格对照组把「统一 vs 脱节」的收益隔离为 +1.63/+2.99 点。- 用冻结 SFT 模型同时充当 reference model 与 reward model:既省掉独立奖励模型,又提供了与检索目标内在对齐的稳定锚点。消融显示解冻它会让性能崩塌 12.7 个点。
- Dynamic Positive Selection:把 GRPO rollout 与对比学习桥接起来,只让检索增益为正的最佳 rollout 进入表征学习,否则回退原 query。这是让「RL + 表征学习」联合训练不发散的关键。
- 可落地的服务方案:离线缓存(覆盖 10.59% QV)+ 305M 蒸馏双编码器,把 3B LLM 的个性化能力压进 +0.15 ms 的延迟预算里。
8. 与已归档相关工作的对比¶
RPORec RPORec: Reinforced Preference Optimization for Reasoning-Augmented Recommendations (City University of Hong Kong, 2026-05-21)¶
关系:独立并发(本文未引用 RPORec,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇论文诊断出的 root cause 高度一致——LLM 的显式推理过程无法与下游的 item 检索目标对齐。RPORec 把它拆成两条病:路线一(hidden-state 耦合联合训练,如 R²ec)会让推荐梯度侵蚀 backbone 的推理能力;路线二(生成式,如 ReRe / LatentR³)掉进「文本 → item」的语义鸿沟。TTP 诊断的是同一个硬币的另一面:LLM 改写器按 causal LM 目标优化,而非按检索效用优化,于是 rationale 与检索目标错配。
- 相近的技术骨架:两者的 RL 阶段几乎可以画成同一张图——用一个冻结的检索模块作为 verifier / reward model,把它给出的稠密排序信号(RPORec 用 NDCG@k,TTP 用 $\Delta S_{pos} + \Delta S_{margin}$)通过 GRPO 反传去精炼生成的推理文本,并都用 format reward + 长度类惩罚约束输出结构。两者也都采用两阶段训练(先把检索侧训稳、再冻结它去打分)。
- 本文的差异与推进:最大的分歧在架构方向上,且恰好相反。RPORec 刻意解耦——用文本作为 backbone 与轻量 Rechead 之间的接口,理由是「直接在 hidden state 上优化推荐目标会破坏推理能力」;TTP 刻意统一——让同一个 encoder 的
<embed>hidden state 直接充当 query 向量,理由是「脱节 pipeline 让 rationale 与检索目标错配」。TTP 用 Decoupled-Stage 这个对照组给出了统一方向的经验证据(+1.63% R@20),而 RPORec 的 Rechead 门控与主表征回退机制则给出了解耦方向的鲁棒性证据。有趣的是两者都发现「原始生成内容有噪声、必须过滤」:RPORec 用 soft adapter 门控抑制离题 CoT,TTP 用 Dynamic Positive Selection 在 rollout 层面丢弃负增益改写。 - 可比的方法/实验差异:RPORec 的推理是
<think>+<answer>(用标题与属性描述推荐 item),落在推荐场景(三个 Amazon 数据集 + 4000 万用户广告 A/B,Revenue +1.348%);TTP 的推理是一段改写后的 query,落在搜索召回场景(美团本地生活 + KuaiSearch/Amazon-PersonalWAB,Order Volume +0.46%)。RPORec 额外引入了 CoT 质量奖励(摘要一致性 $r_{sim}$、压缩比 $r_{comp}$、熵奖励 $r_{ent}$)来直接优化推理轨迹本身,TTP 则完全不评价推理的「好坏」,只用检索增益这一个终端信号——这是两者奖励设计上最实质的分野。
OneSearch-V2 OneSearch-V2: 潜在推理增强的自蒸馏生成式搜索框架 (Kuaishou Technology, 2026-03-25)¶
关系:独立并发(本文引用了 OneSearch-V1 但未引用 V2)· 已加载对方精读
- 共同关注的问题:两篇都在解决电商搜索里「2-3 个关键词的短 query 无法表达真实意图」这一结构性瓶颈,且都明确指出必须结合用户上下文做个性化意图推理——OneSearch-V2 的动机 §1.2 直接写道 V1 依赖历史共现与 log-fitting 目标,「不可避免地产生浅层匹配,无法进行深层个性化推理」,这与 TTP 对 implicit history modeling 的批评是同一句话的两种说法。两者也都把复杂/长尾 query 单列为重灾区(OneSearch-V2:复杂 query 占三分之一 PV 但转化率仅 8%;TTP:Broad / LongTail 两个专门测试集)。
- 相近的技术骨架:骨架高度重合——大教师 LLM 生成 CoT/关键词 → 蒸馏进服务模型 → 用 GRPO 变体按下游效用做偏好对齐 → 工程上想办法把推理成本压掉。OneSearch-V2 用 LLM 三步流程(Query Analysis → Keyword Extraction → Preference Calibration,最后一步显式用用户 profile 与行为历史校准)生成关键词;TTP 用 Qwen3-32B 在三个维度(偏好抽取 / 意图消歧 / 查询纠错)上生成 intent-enhanced query。两者的教师数据都要经过质量过滤,都保留「不改写」的样本。
- 本文的差异与推进:分歧点极具信息量。OneSearch-V2 做了一个消融:在解码 SID 前先输出完整 CoT 文本会让性能严重退化(Order HR@n 从 0.2046 崩到 0.0898),原因是「文本 CoT 与数值 SID 的异质性」对小模型是灾难,因此它选择用自蒸馏把推理内化进权重、推理时不产出任何 CoT。TTP 则必须显式产出 intent-enhanced query 才能拿到增益(w/o Intent-Q 一致掉点)。二者不矛盾,而是被下游表示形式决定的:OneSearch-V2 的下游是离散 SID token(跨模态异质),TTP 的下游是同一空间里的 dense embedding(同质),所以显式文本对 TTP 是纯增益,对 OneSearch-V2 是纯负担。 这几乎可以当成一条设计准则:想在生成式检索里保留显式 CoT,检索目标最好留在文本/向量空间而非离散 ID 空间。
- 可比的方法/实验差异:OneSearch-V2 的 RL 是 TPMA-GRPO(token-position marginal advantage,做位置级信用分配),奖励来自用户行为反馈的复合信号;TTP 的 RL 是标准 GRPO + 冻结 SFT 模型给出的检索增益奖励,创新点落在 reward 来源与 Dynamic Positive Selection 而非 advantage 估计。在线收益上 OneSearch-V2 报 +3.98% Item CTR / +2.11% Order volume(替换整条召回链路),TTP 报 +0.46% Order Volume(作为额外的并行召回通道接入,不改动原有系统)——量级差异主要来自介入深度而非方法优劣。
Improving Item Discoverability in e-Commerce Search via Related Intent Generation Improving Item Discoverability in e-Commerce Search via Related Intent Generation (Instacart, 2026-07-29)¶
关系:独立并发(本文未引用,两者殊途同归)· 已加载对方精读
- 共同关注的问题:都认定 query 的字面形式是用户意图的不完整表达,都选择「用 LLM 生成一段意图文本去扩展召回」这条路。Instacart 把它形式化为 discovery-augmented search(替代 / 互补 / 主题三类隐式意图),TTP 形式化为 intent gap(偏好抽取 / 意图消歧 / 查询纠错三类改写)。两者的三类划分甚至在结构上对仗。
- 相近的技术骨架:服务架构近乎同构——都用「离线缓存头部/宽泛 query + 蒸馏小模型兜长尾/未命中」的两级成本结构来规避 LLM 的在线开销。Instacart 用离线 feature store 覆盖约 1 万条头部 query(占 60% 流量,GPT-3.5 Turbo 标注),长尾用 GPT-5.1 蒸馏出的 LoRA 微调 Qwen3-30B 实时服务,覆盖率从 60% 提到 80%;TTP 用 T+1 离线缓存覆盖活跃用户 × broad query(10.59% QV),miss 走 305M 蒸馏双编码器。两者都用「强教师标注 → 小学生蒸馏」构造训练数据。
- 本文的差异与推进:架构选择上二者明确对立,而这正是最有价值的对照。Instacart 论文原文强调它「刻意把生成与检索解耦」——LLM 只负责高层语义推理、只吐出 carousel 标题与意图词,真正的商品检索交给遗留引擎去 hydrate,好处是品牌幻觉会退化成「静默的空结果轮播」而非错误商品。TTP 走的是完全相反的方向:把生成与检索压进同一个模型、同一次前向,并用实验论证脱节 pipeline(Decoupled-Stage)比统一框架差 1.63~2.99 个点。两者的取舍差异可以用「幻觉容忍度」解释:Instacart 面向发现型扩展召回(错了只是少一个轮播),TTP 面向主搜精准召回(错了直接损失订单),因此后者必须把生成牢牢焊在检索目标上。TTP 的 Over-Personalization 只占改写样本的 2.3%,正是这种「焊死」带来的可控性。
- 可比的方法/实验差异:Instacart 完全不做个性化(无用户历史,query-centric),这恰好落在 TTP 批评的阵营里;反过来 Instacart 覆盖了 TTP 不碰的互补/主题关系(TTP 的改写始终要「保持原 query 核心语义」)。评测上 Instacart 自陈没有线上 A/B、也没有非 LLM baseline,只有会话共购派生的购买预测 benchmark + LLM-as-a-judge;TTP 有完整的 7 天 A/B 与 12 个 baseline 的离线对比,实证强度明显更高。
9. 讨论与局限性¶
9.1 值得借鉴的设计¶
(a)用冻结的自身副本当奖励模型。 这是本文最值得迁移的一招。传统做法要么训独立 RM(成本高、易分布偏移),要么用规则奖励(信号稀疏)。TTP 观察到「SFT 后的模型已经是一个训练好的检索器」,于是把它冻结后一鱼两吃:既做 KL 的 reference,又做 reward 的 scorer。Table 7 里解冻后崩 12.7 个点的对照,把「稳定语义锚点」这个抽象说法坐实成了一个可复现的数字。
(b)Dynamic Positive Selection 作为 RL 与表征学习的桥。 当 GRPO 与 InfoNCE 同时训练时,rollout 是策略的输出、又要当表征学习的输入,天然存在「用噪声教自己」的风险。TTP 的处理很干净:按 reward 取组内最优,且只在 reward 为正时才采用,否则回退原 query。这个「有条件采纳 + 安全回退」的模式可以直接搬到任何「生成物同时作为表征输入」的系统里。
(c)$\langle q, q_r\rangle$ 视图对齐蒸馏。 学生模型线上并不生成改写,而是通过对齐「原 query 视图」与「意图增强视图」,把改写语义直接烧进原 query 的表征。移除这一项掉 1.80 点,是三个蒸馏目标里最重要的。这解决了「LLM 能力如何在不付出生成延迟的前提下落地」的普遍难题。
9.2 局限与争议¶
-
过度个性化无解且无机制约束。论文承认 2.3% 的改写属于有害的 over-personalization,Figure 4 的失败案例(把「补牙」改成「儿童补牙」)显示:当历史信号强烈一致时,模型会把长期偏好错误投射到一个中性 query 上。当前唯一的防线是训练数据里保留的中性样本和教师 prompt 里的「No Rewrite」指令——没有任何推理时的置信度门控或 abstain 机制。工业系统里这类错误的代价是不对称的(改错一个高意图 query 的损失 > 改对一个模糊 query 的收益)。
-
线上收益幅度偏小且介入方式保守。+0.46% 订单量、+0.41% QV CXR 是相当温和的数字,且 TTP 是作为额外并行召回通道接入、不改动原有链路。更关键的是离线缓存只覆盖 10.59% QV,也就是说 89% 的流量实际上由 305M 蒸馏模型服务——论文报告的所有离线 SOTA 数字来自 3B 完整模型,而线上真正跑的主要是那个平均 R@20 43.10 的学生。离线-在线之间存在这层未被充分讨论的落差。
-
Relevance 测试集的标注来自内部 13B LLM,不是人工标注。用「LLM 标注的相关性」去验证「LLM 生成的改写没有损害相关性」,存在方法论上的循环风险,尽管 Spearman 的绝对提升(49.43→50.09)本来也很小。
-
公开基准上的优势不如专有平台显著。Amazon HR@20 上 TTP 只比 MAPs 高 0.30 点(90.17 vs 89.87),且 MAPs 的数字是引自原论文而非重跑,可比性存疑。KuaiSearch 上没有 MAPs/CoPPS 的结果。真正拉开差距的 Broad/LongTail 是自建的专有测试集,「TTP 擅长模糊查询」这个核心论点主要建立在无法被外部复现的数据上。
-
缺少与 query-centric reasoning 检索器的直接对比。论文在 related work 里把 O1-Embedder、Search-R3、LREM 列为最相关的一条线(它们同样是「reason-then-embed」,只是不看用户历史),但实验表里一个都没有。最接近的对照 P-PRF 和 HyDE 都不是这条线的代表作。因此「从 query-centric reasoning 扩展到 user-centric reasoning」这一核心贡献缺少最直接的实验支撑。
-
成本未完整披露。100 万条 Qwen3-32B 教师数据 + 每条 5 个候选 + bge-reranker 打分,这套数据构造的算力开销、以及 T+1 全量刷缓存的日常成本,论文都没有给出数字。
9.3 工业落地价值¶
论文的工程部分(§5)比方法部分更有可复用性。「T+1 离线缓存宽泛 query 的个性化 embedding + 蒸馏小模型兜底 + 与通用召回并行执行」这套组合拳,把一个 3B LLM 的能力压进 +0.15 ms 的延迟预算,是把 LLM 推理引入召回层的一个相当务实的模板。特别是「只给 broad query 建缓存」这个选择——把最贵的资源花在最需要个性化推理的那部分流量上——体现了对 §4.2 结论(Broad 增益 +7.47% 远高于 General 的 +3.32%)的直接工程转化。这种「离线实验结论 → 在线资源分配策略」的闭环,是本文作为工业论文最扎实的部分。