SSR-GRPO: Integrating Supervision and Semantic IDs into Reinforcement Learning for Dense Retrieval in E-commerce 精读¶
Alibaba Group(Taobao / Tmall),杭州。CIKM '26(Rome, Italy, 2026-11-07~11)。作者 Guangxin Song, Xing Fang, Mingmin Jin, Jing Wang, Bokang Wang, Zhentao Song, Junjie Bai, Jianbo Zhu。全员阿里邮箱(taobao.com / alibaba-inc.com)。
1 研究动机与背景¶
稠密检索(dense retrieval,又称 embedding-based retrieval, EBR)是现代电商搜索的地基:把 query 与 item 编码进同一个嵌入空间,用余弦相似度/内积在十亿级商品池中做近邻召回。早期方案是 encoder-only 的 BERT / RoBERTa,近年转向以 LLM 作为骨干(Gemini Embedding、Qwen3-Embedding、RepLLaMA 等),配合难负样本挖掘与 LLM 合成数据。但作者尖锐地指出:这些方法在训练范式上仍停留在 BERT 时代——本质是"造好一批 (q, d⁺, d⁻) 三元组,然后跑对比学习",缺乏处理复杂/隐式语义(如「2026 新款时尚防晒面罩女跑步」这种多属性复合意图)的稳健机制。
近期出现了把强化学习引入检索的一条路线。DeepRetrieval 用 RL 训 LLM 做 query 生成/改写;Zeng et al. 把相关性建模重构成推理任务用 RL 训练。在电商稠密检索侧,Retrieval-GRPO(R-GRPO,即淘宝搜索的 TaoSearchEmb,arXiv 2511.13885) 把 GRPO 搬到了向量检索上:每个训练 step 从当前 batch 里检索 top-K 最相似商品作为一个 group,用多目标奖励(相关性 + 质量 + 排他性)算组内相对优势来更新策略,从而免除人工难负样本挖掘、并缓解多目标优化的跷跷板效应。
本文的出发点正是 R-GRPO 暴露出的两个结构性缺陷,而且这两个缺陷都指向同一个 root cause——GRPO 的组内信号本身是脏的:
缺陷一:top-K 候选池带噪。 R-GRPO 的 group 是从当前 batch 里检索出来的 top-K 商品。但一个 batch 内的商品只是全量商品池极小的一个子集,没有任何保证说这个 top-K 里的每一条都有价值——里面往往混进大量"易负样本"(easy negative),它们在语义上离 query 很远,对策略几乎不提供梯度信息,反而把组内均值和方差搅乱,给优势估计 $A_i$ 注入噪声与误导。作者明确类比了 LLM 侧的同类问题:DeepSeek-V3.2 提出的 Off-policy Sequence Masking,就是靠屏蔽掉导致策略发散的序列来稳定训练的。
缺陷二:奖励模型有偏且昂贵。 R-GRPO 的相关性奖励依赖 TaoSR1(一个 42B-MoE 的电商相关性思考模型)。这带来两个代价:(1) 训练期间要额外跑一个高参数量模型做推理,算力开销巨大;(2) 更致命的是 TaoSR1 本身就是用一个和 R-GRPO 高度相似的 RL 框架、针对 query-item 语义匹配训练出来的——同源训练使它的相关性判断与策略模型高度相关(correlated),无法提供无偏、有区分度的裁判信号。这是一个典型的"裁判和运动员是同一个教练教出来的"问题。
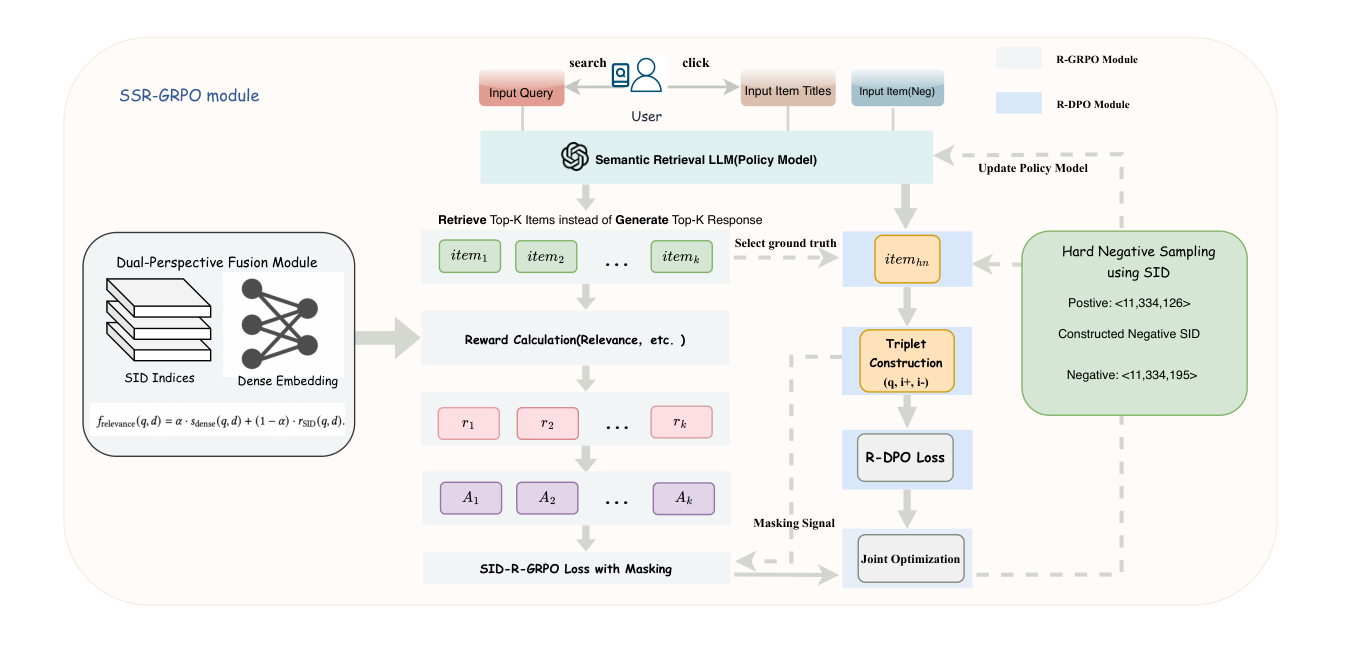
针对这两点,本文提出 SSR-GRPO(Supervised Retrieval-GRPO with Semantic Identifiers),核心思路是引入离散语义标识符(Semantic Identifiers, SID)作为一个与稠密表征正交的「稀疏视角」,同时充当裁判和难负样本的挖掘器:
- 稠密-稀疏双视角相关性奖励:稠密侧用多模态相关性 LLM 的表征内积;稀疏侧用 RQ-VAE 为 item 生成 SID、用 next-token-prediction 为 query 生成 SID,按 query-item SID 的层级前缀匹配深度打分。两者融合替代单一 LLM 裁判。
- 基于 SID 层级关系的难负样本挖掘,挖出的难负样本一物两用:(1) 作为质量基准构造 masking 函数,把组内 relevance reward 低于难负样本的条目直接屏蔽掉;(2) 构造 Retrieval-DPO(R-DPO) 的正负样本对,从 pair-wise 视角补充细粒度语义监督。
- 两条 loss 用基于不确定性的动态加权联合优化,避免梯度冲突和手工调权。
作者宣称的两个"首次":首次用 RQ-VAE 生成的 SID 来挖掘稠密检索的难负样本;首次把 SID 匹配集成进强化学习的奖励计算。
2 核心方法 / 模型架构¶
2.1 预备:稠密检索的形式化¶
给定 query $q_i$ 与商品集合 $\mathcal{D}$,用双塔模型 $f_\theta(\cdot)$ 编码:
$$\mathbf{q}_i = f_\theta(q_i), \quad \mathbf{d}_j = f_\theta(d_j) \in \mathbb{R}^D. \tag{1}$$
query 与 item 嵌入都做 L2 归一化到单位向量($\|\mathbf{q}_i\|_2 = 1$,$\|\mathbf{d}_j\|_2 = 1$),此归一化下内积即余弦相似度:
$$s(q_i, d_j) = \langle \mathbf{q}_i, \mathbf{d}_j \rangle, \tag{2}$$
系统随后取 top-K:
$$\mathcal{D}_{q_i} = \mathrm{TopK}_{d_j \in \mathcal{D}}\, s(q_i, d_j). \tag{3}$$
2.2 第一阶段:SFT¶
整体是两阶段训练:SFT → SSR-GRPO。SFT 用 $(q, d)$ 正样本对配 in-batch negatives,以 InfoNCE 把 query 表征拉近相关 item、推远无关 item:
$$\mathcal{L}_{\text{InfoNCE}} = -\log \frac{\exp\big(s(q_i, d_j^{+})/\tau\big)}{\sum_{d_j \in \mathcal{B}} \exp\big(s(q_i, d_j)/\tau\big)}, \tag{4}$$
其中 $\mathcal{B}$ 是 in-batch 负样本集合,$\tau$ 为温度参数,用于平滑拟合的数据分布。
2.3 SSR-GRPO 的奖励函数骨架¶
SSR-GRPO 沿用 R-GRPO 的多目标奖励形式,由相关性、质量、排他性三部分组成:
$$r = f_{\text{relevance}}(q, d) + g_{\text{quality}}(d) + h_{\text{exclusivity}}(q, d). \tag{5}$$
其中 $g_{\text{quality}}$ 与 $h_{\text{exclusivity}}$ 完全沿用 R-GRPO 不改,本文只重做 $f_{\text{relevance}}$:把它换成 (1) 多模态嵌入内积的稠密信号 $s(\mathbf{e}_q, \mathbf{e}_d)$ 与 (2) 基于 SID 层级匹配深度的稀疏信号 的融合。
2.4 Item SID:query-bridged 对比 RQ-VAE¶
作者采用一个 query 桥接的对比量化框架学习层级 SID。起点是从大规模交互数据训出的双塔模型给出的相关性嵌入 $\mathbf{e}_q = \mathrm{RelevanceEmb}_q(q)$、$\mathbf{e}_d = \mathrm{RelevanceEmb}_d(d)$;再用轻量 MLP encoder 投影到共享潜空间:$\mathbf{z}_q = \mathrm{Enc}_q(\mathbf{e}_q)$,$\mathbf{z}_d = \mathrm{Enc}_d(\mathbf{e}_d)$。一个共享的 RQ-VAE($L$ 层码本,实现中 $L=3$,$\{C_1, C_2, \ldots, C_L\}$)对 item 表征做残差量化:
$$\mathbf{r}_0 = \mathbf{z}_d, \quad c_\ell = \arg\min_{e \in C_\ell} \|\mathbf{r}_{\ell-1} - e\|_2^2, \quad \mathbf{r}_\ell = \mathbf{r}_{\ell-1} - c_\ell, \tag{6}$$
得到 item SID:$\mathrm{SID}_i = [k_1, k_2, \ldots, k_L]$。RQ-VAE 用承诺损失、重建损失与 InfoNCE 对比损失的联合目标优化:
$$\mathcal{L} = \lambda_{\text{infoNCE}}\mathcal{L}_{\text{InfoNCE}} + \lambda_{\text{commit}}\mathcal{L}_{\text{commit}} + \lambda_{\text{recon}}\mathcal{L}_{\text{recon}}. \tag{7}$$
关键设计动机:InfoNCE 项鼓励被同一个 query 共同召回的 item 共享一致的 SID,从而把纯几何聚类(vanilla RQ-VAE 的行为)转变为相关性感知的层级划分(relevance-aware hierarchical partitioning)。这一步是整套方案能成立的前提——如果 SID 只是几何聚类的产物,那么用前缀匹配深度当相关性裁判就没有依据。
2.5 Query SID:生成式 LLM 的 next-token-prediction¶
query 侧的 SID 生成被形式化为 NTP 任务,在一个自回归 LLM 上微调。训练数据来自历史搜索日志:每条 query 与发生过正向交互(点击、加购、购买)的 item 的 SID 配对,这些 item SID 就是 ground-truth target。最小化负对数似然:
$$\mathcal{L}_{\text{SFT}} = -\sum_{t=1}^{L} \log P(k_t \mid q, k_{<t}; \theta), \tag{8}$$
$k_t$ 是第 $t$ 层的码本索引,$\theta$ 是 LLM 参数。推理时用 beam search 生成 top-$K$ 个最可能的 SID 序列 $\{\mathrm{SID}_q^1, \ldots, \mathrm{SID}_q^K\}$。这个「一 query 生成多 SID」的设计天然刻画了 query→相关 item 簇的一对多映射,直接对症电商 query 的意图歧义问题。
2.6 双视角相关性奖励与 SID 融合¶
给定 query SID 集合 $\{\mathrm{SID}_q^j\}_{j=1}^K$ 与 item SID $\mathrm{SID}_i = [k_1^i, k_2^i, k_3^i]$,计算最大匹配深度:
$$\ell^*(q, d) = \max_{j=1}^{K} \max\Big\{\ell \in \{1, \ldots, L\} : k_t^{q,j} = k_t^i,\ \forall t \le \ell\Big\}, \tag{9}$$
即在所有 K 条 query SID 里取"与 item SID 共享前缀最长"的那一条的前缀长度。共享前缀越深,说明细粒度语义一致性越强。再把这个离散层级分映射成标量:
$$r_{\text{SID}}(q, d) = \begin{cases} 0.0 & \text{if } \ell^* = 0 \quad (\text{无匹配}) \\ 0.25 & \text{if } \ell^* = 1 \quad (\text{粗粒度匹配}) \\ 0.5 & \text{if } \ell^* = 2 \quad (\text{中粒度匹配}) \\ 1.0 & \text{if } \ell^* = 3 \quad (\text{细粒度匹配}) \end{cases} \tag{10}$$
注意这个映射是超线性的:从 $\ell^*=2$ 到 $\ell^*=3$ 跳 0.5,而前两级各只跳 0.25,等于显式地把奖励重心押在"全三级完全命中"上。最终相关性奖励是稠密与稀疏的凸组合:
$$f_{\text{relevance}}(q, d) = \alpha \cdot r_{\text{SID}}(q, d) + (1 - \alpha)\cdot s_{\text{dense}}(q, d). \tag{11}$$
$\alpha \in [0,1]$ 是平衡超参(实现中 $\alpha = 0.8$)。作者对这个双视角机制的解释是:稠密嵌入提供平滑连续的整体语义相似度,离散 SID 提供基于关键属性对齐的、锐利的层级判别力,二者互补形成更稳健也更准确的相关性奖励。
2.7 难负样本挖掘与 masking 机制¶
难负样本从两个互补视角挖:
Type I:商业表现型难负样本(Commercial Performance-based)。 锁定那些能稳定进入粗排(pre-ranking)但因后续排序阶段打分过低而拿不到最终曝光的商品。排序模型用了复杂交叉特征和序列建模,对转化效率的评估准确,所以低分商品通常确实转化差(低 CTR/CVR)。这类商品语义上与 query 相关,但商业表现弱。用它们做难负样本,能教模型区分"语义相关但卖不动"和"有强转化潜力"的商品。
Type II:语义细粒度型难负样本(Semantic Fine-grained)。 对一个正样本 item($\mathrm{SID}_{i^+} = [k_1, k_2, k_3]$),选取前两级 SID 相同($k_1, k_2$)但第三级 $k_3$ 不同的商品作为负样本。这构造出的负样本"粗粒度上语义邻近、细粒度属性上不同",迫使模型学到电商相关性所必需的精细语义边界。
Masking 机制。把挖到的难负样本 $d_{\text{hn}}$ 当作质量基准(quality benchmark),凡是 top-K 组内 relevance reward 低于这个基准的条目一律屏蔽:
$$M_i = \begin{cases} 0, & f_{\text{relevance}}(q, d_i) < f_{\text{relevance}}(q, d_{\text{hn}}) \\ 1, & \text{otherwise,} \end{cases} \tag{12}$$
$M_i$ 是二值函数。这一步的逻辑非常直白但有效:难负样本按定义已经是"难"的了,比它还差的必然是易负样本,对策略优化没有贡献,直接踢出组外。
2.8 SID-R-GRPO¶
把双视角奖励与 masking 合起来得到 SID-R-GRPO。训练时把语义检索 LLM 召回的 top-$K$ item 当候选,用集成了 SID 的奖励模型实时算奖励、惩罚低分条目以动态调整预测。候选跨设备汇聚成一个大 batch $\hat{B}$($k \ll \hat{B}$),从中选 top-$k$ 做奖励计算。同一 query 下 top-$K$ 之间的组内优势 $A_i$ 反映多视角的用户偏好。损失为:
$$\mathcal{L}_{\text{SID-R-GRPO}} = -\frac{1}{K}\sum_{i=1}^{K}\Big\{\min\big(\pi_\theta(s(q,d_i)\mid q,d_i)\hat{A}_i,\ \mathrm{clip}(\pi_\theta(s(q,d_i)\mid q,d_i), 1-\varepsilon, 1+\varepsilon)\hat{A}_i\big)\, M_i\Big\} + \beta\,\mathcal{L}_{\text{InfoNCE}}, \tag{13}$$
优势按组内标准化:
$$A_i = \frac{r_i - \mathrm{mean}(\mathbf{r})}{\mathrm{std}(\mathbf{r})}, \tag{14}$$
其中 $\mathbf{r} = \{r_1, \ldots, r_K\}$ 是组内 $K$ 个候选的奖励集合。
一处值得单独强调的设计:与常规 GRPO 不同,本文用 InfoNCE 而非 KL 散度作为语义正则项。理由是 token 级 KL 散度在连续嵌入空间里根本不适用(policy 的输出不是 token 分布而是相似度分值),而 InfoNCE 直接把学到的语义空间与检索目标对齐,因而对语义检索来说优化更稳定、更有效。这实际上也让 SFT 阶段的监督信号在 RL 阶段持续充当"锚"。
2.9 R-DPO Loss¶
作者引入一个检索专用的直接偏好优化目标 R-DPO,它把 DPO 框架适配到向量检索上,去掉了参考策略约束。正样本对 $(q_i, d_i)$ 取自真实用户点击日志,负样本 $d_{\text{hn}}$ 是 §2.7 挖出的 SID 难负样本:
$$\mathcal{L}_{\text{R-DPO}} = -\log\sigma\big(\beta\,(s(q_i, d_i) - s(q_i, d_{\text{hn}}))\big), \tag{15}$$
$s(q,d)$ 是相关性打分函数,$\sigma(\cdot)$ 是 sigmoid,$\beta$ 是控制 margin 强度的温度参数。与常规 DPO 用参考策略做正则不同,R-DPO 纯粹最大化正样本与难负样本之间的打分间隔——这恰好契合检索任务"显式拉开语义相似项之间的相关性差距"的诉求。
2.10 联合优化框架¶
把 SID-R-GRPO 与 R-DPO 合并即得最终损失。为缓解梯度冲突、免除手工调权,采用基于不确定性的动态加权(Kendall et al. 的多任务不确定性加权),引入可训练标量 $\sigma_1, \sigma_2 > 0$:
$$\mathcal{L}_{\text{SSR-GRPO}} = \frac{1}{2\sigma_1^2}\mathcal{L}_{\text{SID-R-GRPO}} + \frac{1}{2\sigma_2^2}\mathcal{L}_{\text{R-DPO}} + \log(\sigma_1\sigma_2). \tag{16}$$
$\frac{1}{2\sigma_i^2}$ 起自适应权重的作用:噪声更大/更难的任务($\sigma$ 更大)被降权以免梯度主导,$\log(\sigma)$ 项充当正则防止 $\sigma$ 无限增大。其机制意义是:动态平衡 SID-R-GRPO 的高方差 RL 信号与 R-DPO 的确定性监督梯度,把二者的优化轨迹对齐,且不引入超参敏感性。
2.11 完整流水线¶
- 候选样本选择:对 query 与 item 表征做近邻检索,取 top-$k$ 候选;
- 稠密-稀疏双视角奖励计算:按式 (5) 算多目标奖励,其中相关性奖励由 §2.6 的双视角分融合得到;
- R-DPO 数据构造:用层级 SID 挖出的难负样本 + "相关但未曝光"策略构造 R-DPO 样本对;
- Masking 计算:以难负样本为监督基准,按式 (12) 算 mask,过滤组内易负样本;
- SSR-GRPO 损失优化:最小化式 (16),联合更新模型参数 $\theta$ 与不确定性标量 $\sigma_{1,2}$。
3 实验设置¶
3.1 数据与指标¶
训练数据是 3 亿以上(0.3 billion)条天猫点击-购买日志作为正样本。两阶段训练:SFT 用完整三个月数据 + InfoNCE;SSR-GRPO 阶段只用最近 15 天的交互。
评估指标两个:
- Hitrate@4k(HR@4k):稠密检索模型召回的 top-4000 候选中命中 ground-truth item 的召回率,衡量系统"把所有相关商品捞回来"的能力;
- Goodrate@100(GR@100):top-100 检索结果中被标注为 "Good"(相关性打分为 1,即 "Related")的商品占比,衡量头部结果的相关性质量(本质是精确率)。
两个离线测试集:
- 通用检索测试集(General Retrieval Test Set):为避免过拟合,构建自另一个不同的电商场景的用户交互,含点击与购买商品,经相关性模型与人工标注过滤,超过 45 万 query、133 万 query-item 对;
- 长尾 query 测试集(Long-Tail Query Test Set):从其他电商场景的端到端搜索日志收集长尾 query,可视作分布外(OOD)数据,同样经相关性模型 + 人工标注 + 严格过滤,超过 3 万 query、9 万 query-item 对。
3.2 实现与部署细节¶
- 骨干:SFT 阶段用 Tbstars-3B(阿里内部 3B 参数模型)作 encoder;
- 算力:32 张 96GB 显存 GPU,batch size 140,AdamW,lr=1e-5,最大输入长度 100 tokens,输出 128 维 L2 归一化嵌入,训练 1 epoch;
- SSR-GRPO 阶段:15 天数据,学习率降到 5e-6,其余超参沿用 SFT;式 (13) 的 InfoNCE 权重 $\beta = 0.5$(该值性能最佳),训练 3 epochs;
- 式 (11) 的融合系数 $\alpha = 0.8$(偏重稀疏 SID 侧);
- 离线训练输入:item 侧输入商品标题 + 基础属性文本,query 侧输入搜索 query;
- 在线部署:训练好的 SSR-GRPO LLM 对全量商品池离线推理出嵌入并缓存;LLM 部署到生产环境,对用户实时 query 做在线推理生成 query 向量,与缓存的商品嵌入做 top-K 检索,结果送入下游模块。这是典型的"item 侧离线 + query 侧在线"的非对称部署,避免了对十亿级商品做实时推理。
3.3 Baseline¶
三类:天猫生产基线(Tbstars-3B SFT)、主要竞品 R-GRPO、以及若干 SOTA 文本嵌入模型。
- StructBERT:把语言结构先验(词序、句子连贯性)融入预训练的结构感知 encoder,0.1B 参数;
- Qwen3-0.6B:Qwen3-Embedding-0.6B,面向文本嵌入与排序任务;
- Qwen2.5-1.5B:Qwen2.5 系列 1.5B 版本,面向长文本生成与结构化数据理解;
- Tbstars-3B:基于内部闭源 Tbstars 3B 训练的稠密检索模型,改为双向注意力;
- Tbstars-3B SFT (base):在 Tbstars-3B 基础上用天猫搜索日志 + InfoNCE 微调,即 SSR-GRPO 的第一阶段。该模型已在线上服务数亿用户,是真正的生产基线;
- Tbstars-3B SFT + R-GRPO:SFT + R-GRPO 训练框架,是 SSR-GRPO 的直接消融对照。
4 主要实验结果¶
Table 1:不同方法在 HR@4k 与 GR@100 上的整体对比
| Model | HR@4k (General) | HR@4k (Long-Tail) | GR@100 (General) | GR@100 (Long-Tail) |
|---|---|---|---|---|
| StructBERT | 0.7166 | 0.4019 | 0.8837 | 0.5732 |
| Qwen2.5-1.5B | 0.7466 | 0.4189 | 0.8894 | 0.6415 |
| Qwen3-0.6B | 0.7495 | 0.4330 | 0.8958 | 0.6524 |
| Tbstars-3B | 0.7577 | 0.4506 | 0.9088 | 0.6583 |
| Tbstars-3B SFT (base) | 0.7872 | 0.4754 | 0.9174 | 0.6941 |
| Tbstars-3B SFT + R-DPO | 0.7916 | 0.5857 | 0.9261 | 0.7014 |
| Tbstars-3B SFT + R-GRPO | 0.8158 | 0.5857 | 0.9305 | 0.7126 |
| Tbstars-3B SFT + SSR-GRPO | 0.8218 | 0.5943 | 0.9372 | 0.7195 |
| Tbstars-3B R-GRPO only | 0.7616 | 0.4492 | 0.9213 | 0.6820 |
| Tbstars-3B SSR-GRPO only | 0.7628 | 0.4562 | 0.9230 | 0.6844 |
结论分析:
- SSR-GRPO 在全部四个评估格子上都拿到最优,验证了框架在"召回覆盖度"和"相关性质量"两个维度上的同时增强;
- baseline 之间:Tbstars-3B 全面优于 Qwen2.5-1.5B 与 Qwen3-0.6B,说明电商领域内部预训练模型的架构优势——即便 Qwen3-Embedding 是通用嵌入 SOTA,在电商垂域上仍不敌 3B 的内部模型;
- SFT 的价值:Tbstars-3B SFT (base) 相对 Tbstars-3B 有明显提升(General HR@4k 0.7577→0.7872,+3.9%),确认了在天猫搜索日志上做领域微调的必要性;
- RL 的增益:SFT+R-GRPO 相对 SFT base 提升显著(0.7872→0.8158),SSR-GRPO 进一步超过 R-GRPO——原文自述在 HR@4k 上有 0.6% 的相对增益、在 Long-Tail HR@4k 上有 0.86%;
- 最值得注意的一条:Tbstars-3B R-GRPO only / SSR-GRPO only(即跳过 SFT 直接上 RL)表现大幅退化(General HR@4k 只有 0.7616 / 0.7628,甚至低于 SFT base 的 0.7872)。这说明 SFT 阶段对本方法是不可或缺的——RL 只能在一个已经收敛到合理语义空间的策略上做精修,而不能从零建立表征。这一点与 AdaGRPO「保留监督 NLL 作为静止锚」的判断是同构的。
- 另有一条容易被忽略的数据:R-DPO 单独加在 SFT 上,Long-Tail HR@4k 从 0.4754 直接跳到 0.5857(+23.2% 相对提升),涨幅远大于它在 General 上的表现(0.7872→0.7916,仅 +0.6%)。这暗示 SID 挖出的细粒度难负样本主要在长尾/OOD query 上兑现价值——这恰恰是稠密检索最薄弱的地方。
5 消融与分析¶
5.1 组件消融¶
Table 2:SSR-GRPO 各组件贡献的消融(HR@4k 报通用评估集,GR@100 报长尾集,均为相对满配版的变化)
| Model | Hitrate@4k | GR@100 |
|---|---|---|
| SFT+SSR-GRPO (Full) | +0.00% | +0.00% |
| (w/o Dual-Perspective Reward) | -0.17% | -0.25% |
| (w/o R-DPO Loss) | -0.49% | -0.36% |
| (w/o Masking Function) | -0.12% | -0.08% |
| (w/o Dynamic Weights) | -0.15% | -0.17% |
逐项分析:
- 移除 R-DPO Loss 掉幅最大(HR@4k -0.49%),凸显难负样本挖掘的关键与不可替代性,也证明 R-DPO 与 R-GRPO 在任务上是互补而非重复的。作者的解释很到位:单纯依赖奖励计算的方法受高方差困扰,而 R-DPO 给训练过程提供了稳定且定义明确的梯度,从而有效约束整体优化轨迹;
- SID 融合(Dual-Perspective Reward)对两个指标都有稳定贡献,尤其利好相关性判断——移除后 GR@100 掉 0.25%,说明稠密 + 稀疏结合确实带来了更全面的语义理解;
- masking 机制贡献最小(HR@4k 仅 -0.12%),但作者补充了一个非指标层面的价值:它高效滤掉了不必要的易负样本,从而提升训练期的计算效率;
- 动态加权贡献 -0.15% / -0.17%,说明梯度冲突确实存在,但不是主要矛盾。
5.2 相关性奖励的消融¶
Table 3:Relevance Reward 的消融结果
| Model | HR@4k | GR@100 |
|---|---|---|
| R-GRPO (w TaoSR1) | 0.8152 | 0.7136 |
| R-GRPO (w Dense) | 0.8093 | 0.7108 |
| R-GRPO (w Sparse SID) | 0.8154 | 0.7143 |
| R-GRPO (w Dual-Perspective SID) | 0.8161 | 0.7165 |
这是全文最有说服力的一张表。结论有三层:
- 仅用 Sparse SID 的变体就已经追平甚至略超 42B 的 TaoSR1(HR@4k 0.8154 vs 0.8152)。这意味着"把 item 表示成离散语义簇"能为 GRPO 的奖励估计提供稳健且无偏的信号,在不引入 LLM 裁判偏置的前提下捕获粗粒度相关性——而代价从一个 42B-MoE 模型的实时推理降到一次前缀比对。这是本文的核心经济价值所在;
- 仅用 Dense 的变体能力有限(0.8093,是四者最低),说明连续嵌入内积作为裁判太"软",缺乏锐利的判别边界;
- 双视角融合进一步提升(0.8161 / 0.7165),说明稀疏 SID 提供的粗粒度层级判别与稠密嵌入提供的细粒度连续差异是互补的。实现中 $\alpha = 0.8$ 给出了"稠密语义平滑性"与"稀疏层级判别力"之间的最优权衡。
5.3 Case Study¶
作者用一条复杂多属性 query 做定性分析:"2026 new stylish UV protection face mask for women running"(2026 新款时尚防晒面罩女跑步)。
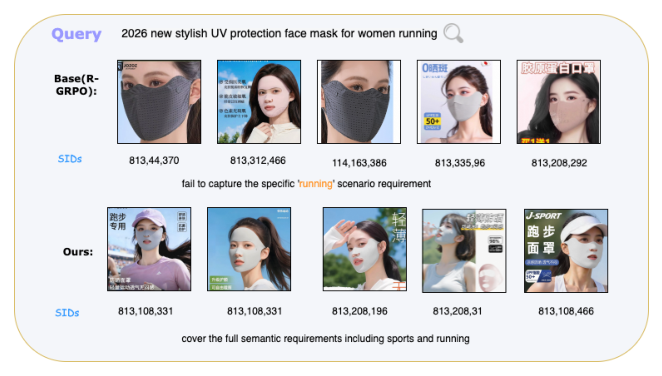
- R-GRPO 的召回:商品视觉上好看,但完全没抓住 "running"(跑步)这一场景约束。作者判断这是 Reward Hacking 的表现——当 top-K 候选池里根本没有完美匹配项时,R-GRPO 会退而求其次去优化那些容易拿高奖励的维度(这里是"时尚"),把场景需求丢掉;
- SSR-GRPO 的召回:全面覆盖语义需求,召回的面罩同时兼顾高颜值与跑步专用功能(透气性、贴合固定)。
最有意思的证据是召回结果的 SID 分布:baseline 的 SID 高度分散在不同语义簇(第二级索引在 335、208、163…之间大幅跳变),而 SSR-GRPO 的结果呈现强聚类一致性——第二级索引只集中在 208 和 108 两个值上。这直接印证了方法确实降低了语义噪声、把召回结果对齐到用户精确的多侧面意图上。作者把这归功于 SID 引导的优化机制:R-DPO 用层级 SID 构造难负样本,迫使模型学到细粒度语义区分、防止坍缩到粗粒度局部最优;masking 函数则滤掉平凡负样本。
6 线上 A/B 实验¶
模型部署在 TmallAPP(天猫 App,主流移动电商应用)的生产搜索链路中。关注的业务指标:
- UCTCVR:用户点击-转化率类综合指标;
- GMV:成交总额;
- Ex.Imp(Exclusive Impression):在多路召回框架下,仅由语义深度检索这一路独家召回的商品在用户可见商品中的占比——衡量该通道的不可替代性;
- Goodrate:从搜索日志采样 query 及对应商品得到的平均相关性比例。
Table 4:线上 A/B 结果(相对基线的相对提升)
| Model | UCTCVR | GMV | Ex. Imp. | Goodrate |
|---|---|---|---|---|
| Base | - | - | - | - |
| R-GRPO | +0.38% | +1.01% | +0.37% | +0.20% |
| SSR-GRPO | +0.99% | +1.40% | +0.48% | +0.61% |
线上 A/B 跑了两周以保证统计可靠性。相对强基线 R-GRPO,SSR-GRPO 取得统计显著的改进:UCTCVR +0.61pp、GMV +0.39pp(即 0.99%−0.38% 与 1.40%−1.01%)。Ex.Imp. 从 +0.37% 涨到 +0.48%,说明这一路召回带来的独家增量供给也在扩大,而不是简单地和其他召回路重合。Goodrate 从 +0.20% 到 +0.61%,相关性质量提升幅度是四个指标里相对最大的,与离线 GR@100 的结论一致。
7 核心贡献总结¶
- 双视角相关性奖励:首次把 RQ-VAE 生成的 SID 层级前缀匹配集成进 RL 奖励计算,与稠密嵌入内积融合,用一次前缀比对替代 42B-MoE LLM 裁判的实时推理,同时消除"裁判与运动员同源训练"带来的判断相关性偏置;
- 基于 SID 相似度的难负样本挖掘:首次用 RQ-VAE SID 为稠密检索挖难负样本(共享前两级、第三级不同),并与商业表现型难负样本互补,构成 R-DPO + R-GRPO 的联合训练范式;
- 难负样本驱动的 masking 函数:以难负样本为质量基准,屏蔽组内 reward 更低的易负样本,降低 GRPO 组内噪声并提升训练效率;
- 用 InfoNCE 替代 KL 作为 RL 正则:针对连续嵌入空间 token 级 KL 失效的问题给出的一个干净替代;
- 完整的工业验证:3 亿级天猫日志训练,45 万 query 通用测试集 + 3 万 query 长尾测试集离线评估,TmallAPP 两周线上 A/B 部署。
与已归档相关工作的对比¶
DSIRM DSIRM: Learning Query-Bridged Discrete Semantic Identifiers for E-commerce Relevance Modeling (Taobao & Tmall Group of Alibaba, 2026-06-03)¶
关系:独立并发/同门未引(本文发表于 2026-08-20,DSIRM 早 2.5 个月,同为阿里淘天团队,但本文参考文献中未引用)· 已加载对方精读
- 共同关注的问题:两篇都在攻同一个 root cause——连续嵌入把多个语义侧面纠缠在一起,在"仅差决定性属性"的同质化商品上判别力不足。DSIRM 说的是"仅在决定性属性上不同的商品在嵌入空间里被挤压得非常稠密",本文说的是"复杂和隐式语义处理机制不稳健",指向同一件事。两者的解都是引入一条与稠密表征正交的离散、层级、稀疏的语义通道。
- 相近的技术骨架:几乎是同一套配方——(1) item 侧用 query-bridged contrastive RQ-VAE(本文原文用词 "query-bridged contrastive quantization framework",与 DSIRM 的命名一致),用 query-item InfoNCE 把"被同一 query 共同召回的 item"绑到同一 SID;(2) query 侧用自回归 LLM 做 NTP 生成 query SID,beam search 出 top-K;(3) 两侧 SID 做层级前缀匹配,按最深匹配层级映射成离散分。本文式 (10) 的 {0.0, 0.25, 0.5, 1.0} 四档映射与 DSIRM 式 (16) 完全一致。
- 本文的差异与推进:SID 分数的用途根本不同。DSIRM 把 SID score 当作排序 DNN 的一个离散特征($\text{logit} = \text{DNN}(dm, mm\_dm, ct, qs, ss)$),是判别式相关性模型的特征增强,落在排序阶段;本文把同一个分数抬升为强化学习的奖励信号,落在召回阶段的策略优化里,并进一步把 SID 的层级结构复用为难负样本的挖掘器(DSIRM 完全没有这一步)。可以说本文是"DSIRM 的 SID 配方 × R-GRPO 的 RL 框架"的交叉产物。
- 可比的方法/实验差异:DSIRM 有一个本文没有的关键设计——category-aware codebook allocation,把类目体系强制编码进第一层码本并用 EMA 更新,专门缓解电商类目极端不平衡导致尾部类目表征弱的问题;本文的 RQ-VAE 描述里没有任何类目约束,第一层就是普通最近邻量化,这在长尾场景下可能是个隐患。实验侧 DSIRM 报的是排序 AUC(+1.54%)与线上 UCTR +0.13% / UCTCVR +0.25%,本文报的是召回 HR@4k / GR@100 与线上 GMV +1.40%,两者不可直接比较。
CQ-SID CQ-SID: Efficient Generative Retrieval for E-commerce Search with Semantic Cluster IDs and Expert-Guided RL (Taobao & Tmall Group of Alibaba, 2026-05-14)¶
关系:独立并发(本文发表于 2026-08-20,CQ-SID 早约 3 个月,同为阿里 TmallAPP 场景,本文未引用)· 已加载对方精读
- 共同关注的问题:两篇都在解 GRPO 用于电商检索时组内学习信号退化这一 root cause。CQ-SID 的诊断是"click/purchase 信号极稀疏,标准 GRPO 经常整组全 0 reward,advantage 全为 0 无梯度,少数命中又高方差";本文的诊断是"batch 内 top-K 混入大量易负样本,给优势估计注入噪声"。两者是同一枚硬币的两面:CQ-SID 抱怨组里"好的太少",本文抱怨组里"坏的太多"。
- 相近的技术骨架:(1) 都用 query-item 双向 InfoNCE 改造的 RQ-VAE 学 item SID;(2) 都用 LLM 从 query 生成 SID;(3) 都是通过手术式地改造 GRPO 的 group 构成来修复信号质量——CQ-SID 的 EG-GRPO 往 group 里注入 K 条 ground-truth SID 作为伪生成响应(做加法),本文的 masking 把 group 里 reward 低于难负样本基准的条目屏蔽掉(做减法);(4) 都跑在 TmallAPP 生产搜索、都做两周线上 A/B。
- 本文的差异与推进:CQ-SID 走的是生成式检索路线(LLM beam search 生成 SID,再经 SID→Items lookup 表还原成商品,SID 是预测目标),并主动接受 SID 碰撞以换 beam 效率;本文走的是稠密检索路线(SID 完全不参与推理,只在训练期充当奖励与负样本挖掘的工具,线上仍是向量 ANN)。因此本文的部署形态更轻——推理链路上没有任何 SID 组件,SID 的成本全部前置到训练期。另外本文多了 R-DPO 这条 pair-wise 监督支路和不确定性动态加权,CQ-SID 则多了类目引导的第一层量化与过大簇随机切分的后处理。
- 可比的方法/实验差异:CQ-SID 报的是相对 RQ-VAE 基线的 hitrate +26.76% / +11.11%(语义/个性化),线上 GMV +1.15% / UCTVR +0.40%;本文报的是相对 R-GRPO 强基线的 HR@4k +0.6%、线上 GMV +1.40% / UCTCVR +0.99%。CQ-SID 的相对涨幅大得多,但它的基线是纯 RQ-VAE 生成式召回(一个更弱的起点),本文的基线是已上线服务数亿用户的 SFT 模型加 R-GRPO,两者的"难度系数"完全不同。值得注意的是 CQ-SID 明确报告其生成式召回链路贡献了全平台 50.25% 曝光 / 72.63% 购买,而本文的 Ex.Imp. 只有 +0.48% 的增量——说明在同一家公司里,生成式召回与稠密召回是并行的两条通道而非替代关系。
AdaGRPO AdaGRPO: Adaptive Loss Balancing for Noise-Robust GRPO in Generative Recommendation (JD.com / 早稻田大学, 2026-06-07)¶
关系:独立并发(本文发表于 2026-08-20,AdaGRPO 早约 2.5 个月,跨公司、跨任务,本文未引用)· 已加载对方精读
- 共同关注的问题:两篇都把矛头指向 RL 微调中"奖励信号并非处处可信"这一 root cause,而且都识别出易负/易样本对梯度的污染。AdaGRPO 的核心判断是"RL 用于生成式推荐的中心挑战不是设计更强的奖励,而是辨别奖励信号何时可被信任",并量化出:在简单样本上 RM 打分聚得很紧、advantage 坍缩到 0,残余 RM 噪声主导梯度。本文的判断是 top-K 里的易负样本给优势估计注入噪声与误导,且 TaoSR1 作为同源训练的裁判本身有偏——"裁判不可信"+"组内样本不可信",两篇踩的是同一片雷区。
- 相近的技术骨架:都是"二值 detach mask 门控 RL 项 + 保留一个监督锚 + 动态平衡两者"这一三件套。AdaGRPO:$L_i = L_{\text{NLL}}^{(i)} + \lambda\,\alpha_i\,L_{\text{GRPO}}^{(i)}$,$\alpha_i \in \{0,1\}$ 是 detached 的实例级 clip;本文:式 (13) 里 $M_i \in \{0,1\}$ 门控每个候选的 GRPO 项,外加 $\beta\mathcal{L}_{\text{InfoNCE}}$ 作监督锚,再由式 (16) 的不确定性权重动态平衡 RL 与监督支路。两者都明确放弃了 KL 正则而改用任务原生的监督损失当锚(AdaGRPO 用 NLL,本文用 InfoNCE,理由是 token 级 KL 在连续嵌入空间失效)。
- 本文的差异与推进:mask 的粒度和判据完全不同。AdaGRPO 的 clip 是实例级(per-prompt)的,判据是两个 rank-based 诊断的合取——policy-side difficulty $f_1$(ground-truth 是否落在策略自身排序 top-$\tau$ 之外)与 reward discriminability $f_2$(RM 能否把 ground-truth 排进 top-$\tau$ 且把干扰项全压进 bottom-$\rho$),判据的信息全部来自 rollout 统计量,不引入外部模型;本文的 mask 是候选级(per-item-in-group)的,判据是一个绝对阈值——relevance reward 是否低于挖出的难负样本 $d_{\text{hn}}$ 的 reward,判据依赖一个外部构造的锚点(SID 挖掘 + 商业表现挖掘)。前者更精巧、无额外假设;后者更简单直接,且那个锚点本身还能一物两用去构造 R-DPO 对。
- 可比的方法/实验差异:AdaGRPO 做了本文完全没做的机制层实证——分层统计 RM 对 ground-truth 排名的影响 $\Delta$,证明全样本聚合下 $\Delta \approx 0$($K=50$ 时 +0.48,$K=128$ 时 −0.28),但在 HARD 分区上 $\Delta$ 高达 +11.41 / +30.77,两诊断合取后进一步翻倍到 +23.24 / +59.93(覆盖率仅剩 12–13%)。本文的 masking 完全没有这类量化证据支撑,其消融也显示 masking 是四个组件里贡献最小的(HR@4k 仅 -0.12%)——对照 AdaGRPO 的分析,一个合理的猜测是本文的绝对阈值 mask 过于粗糙,屏蔽掉的多是本来就不贡献梯度的样本(所以计算效率提升明显、指标提升微弱),而没有触及"简单样本上 RM 噪声主导梯度"这个更值钱的失效模式。
8 讨论与局限性¶
核心贡献与值得借鉴的设计:
- "用离散层级结构当免费裁判"是全文最值得借鉴的 insight。Table 3 表明,一个 3 层 RQ-VAE 的前缀匹配深度,作为 GRPO 的相关性奖励,效果就能追平一个 42B-MoE 的思考模型(0.8154 vs 0.8152)。这不只是省算力——更关键的是它打破了"裁判与运动员同源"的偏置闭环:SID 是从量化学习里独立长出来的结构,与策略模型的 RL 训练路径无关,天然更"无偏"。这个思路可以迁移到任何"奖励模型与策略模型同源"的场景。
- 一个锚点两处复用的工程性价比很高:挖出的难负样本既当 masking 的质量基准,又当 R-DPO 的 rejected 样本,一次挖掘摊到两条监督支路上。
- 用 InfoNCE 替代 KL 做 RL 正则是一个针对连续嵌入检索场景的干净适配,值得在同类"策略输出不是 token 分布"的 RL 任务里参考。
- 部署形态轻:SID 只在训练期存在,线上仍是标准 ANN 向量检索 + item 嵌入离线缓存 + query 侧实时推理,无需改造检索基础设施——这也是它能在生产链路上快速铺开的原因。
局限与争议:
- 增量幅度偏小,且论文自己的表述前后不一致。正文说 SSR-GRPO 相对 R-GRPO "在 HR@4k 上有 0.6% 的增益",但 Table 1 的绝对值是 0.8158→0.8218,绝对差 0.006,相对提升只有 0.74%;Long-Tail HR@4k 0.5857→0.5943 相对提升 1.47%(正文说 0.86%,那是绝对百分点)。论文在"绝对百分点"和"相对提升"之间来回横跳,读者需自行换算。整体上这是一次在已经很强的基线上做的增量改良,而非量级跃迁。
- Table 2 的消融是相对百分比而非绝对值,且量级都在 0.1%~0.5% 之间,没有给出方差/多次实验的置信区间。在这个量级上,masking(-0.12%)与 dynamic weights(-0.15%)的贡献是否显著于噪声,实际上无法从论文中判断。
- Table 1 与 Table 3 的数值口径不一致:Table 1 里 SFT+R-GRPO 的 General HR@4k 是 0.8158,Table 3 里 "R-GRPO (w TaoSR1)" 是 0.8152,且 Table 3 的 GR@100 报的是长尾集(0.7136),而 Table 1 里 SFT+R-GRPO 的长尾 GR@100 是 0.7126。数值接近但不完全对齐,论文未说明差异来源(可能是不同 run),这在只差 0.6% 的对比里是个不小的隐患。
- 完全没有公开数据集实验。全部离线评估都在内部天猫数据(3 亿日志、45 万 / 3 万 query 测试集)上完成,方法的可复现性与跨平台可迁移性无从检验。这也是本次归档 benchmark 交白卷的直接原因。
- SID 的类目不平衡问题未处理。同团队更早的 DSIRM 专门设计了 category-aware 第一层码本来对抗电商类目的极端长尾,本文的 RQ-VAE 描述中完全没有类似机制。考虑到本文最大的增益恰恰来自长尾测试集(R-DPO 让 Long-Tail HR@4k 涨 23%),第一层码本被高频类目主导的风险值得关注。
- masking 的阈值设计过于粗糙。用"单个难负样本的 relevance reward"作绝对阈值,意味着 mask 的严格程度完全取决于那一条被采到的 $d_{\text{hn}}$ 有多难,方差可能很大;论文既没讨论如何选 $d_{\text{hn}}$(是取一条还是取均值),也没做阈值敏感性分析。对照 AdaGRPO 的 rank-based 相对判据,这里显得随意。
- 方法论可扩展性上的隐患:SID 码本是离线预训练后固化的,量化器与检索策略模型无法端到端联合优化。一旦商品池分布漂移(电商是典型的高频上新场景),SID 的语义划分会逐渐失配,而奖励信号与难负样本都建立在这套固化的划分上。论文提到"商品嵌入离线缓存"但没有讨论 SID 的更新周期与漂移应对。参数量 scaling 时,策略模型可以变大,但作为裁判的 SID 空间($L=3$ 层码本)不会同步扩容——这是一个结构性的表征上限。
- 消融缺失:$\alpha=0.8$ 与 $\beta=0.5$ 都只报了"该值最佳",没有给出扫参曲线;两类难负样本(商业表现型 vs 语义细粒度型)的分别贡献也没有拆开消融,读者无法判断 R-DPO 的 -0.49% 增益里有多少来自 SID 挖掘、多少来自商业信号。
工业落地价值:明确且已验证。部署在 TmallAPP 生产搜索,两周线上 A/B,相对 R-GRPO 基线取得 UCTCVR +0.61pp、GMV +0.39pp、Ex.Imp +0.11pp、Goodrate +0.41pp;相对原始 base 则是 GMV +1.40%。部署形态为"item 嵌入全量离线推理并缓存 + query 侧 LLM 实时推理 + ANN 检索",工程改造面小。同时把奖励模型从 42B-MoE 换成 SID 前缀比对,直接砍掉了 RL 训练期最大的一块推理开销——这个成本收益在工业场景里比 0.6% 的指标提升更有说服力。