Scaling GNNs for Friend Recommendation:194M 用户 / 28B 边社交图上的多哈希 ID 嵌入与时序邻居采样(AI VK)¶
来自 AI VK(Maksim Utushkin、Andrei Ovsiannikov、Alexander D'yakonov,均在 AI VK, Moscow;VK 是俄罗斯最大的社交网络),CIKM 2026 已录用,2026-08-27 挂 arXiv(2608.27413v1,cs.IR / cs.LG / cs.SI)。这不是一篇"提出新 GNN 层"的论文,而是一篇把消息传递 GNN 真正推上 194M 用户 / 28B 边生产社交图的系统与建模决策报告:作者的立场很明确——在这个尺度上,"用哪种 message-passing layer"几乎不重要,真正决定成败的是两件被学术论文默认解决、在工业界却成为拦路虎的事:几亿个用户 ID 怎么进 GNN 的输入层(完整 embedding 表 >200 GB),以及怎么在不泄漏未来边的前提下把时序邻居采样的单次代价从 $O(\deg(v))$ 压到 $O(\log \deg(v))$(hub 用户 $\deg \sim 10^4$)。论文给出线上 A/B:好友添加 +16.0%、独立添加用户 +11.5%,并开源了完整的训练/推理框架(https://github.com/makut/VK-GNN)。
研究动机与背景¶
好友推荐在产品上通常叫 PYMK(People You May Know,"你可能认识的人"),是任何社交网络的核心机制:它驱动社交图本身的增长与连通性,并间接驱动下游的内容消费。工业实现一般是两阶段漏斗——candidate generation(候选生成)→ ranking(排序),同一个 ranker 服务于多个推荐位。本文只做排序阶段,把它当成 user–candidate pair 上的 learning-to-rank 问题。
作者的核心判断是:好友排序最重要的信号住在图结构里——谁和谁相连、一个用户局部邻域有多稠密、两个用户的邻域重合多少。GNN 天然契合,因为消息传递恰好把这种多跳信息聚合进节点表示。已有若干工业系统报告过 GNN ranker 的线上收益(LiGNN@LinkedIn、GraFRank@Snapchat、SSNet@Xbox、PinSage@Pinterest)。但作者强调,在他们这个尺度上,"用哪种消息传递层"远不如另外几个设计决策重要。
论文把生产环境的三条约束摆在最前面,全文的方法设计都是被这三条逼出来的:
- 规模(Scale):图约 194M 节点、28B 边,存储和采样本身就是独立的工程问题;
- 节点内容信号弱(Weak node content):用户 profile 属性携带的信号很少,但可训练的 per-user ID 表又负担不起——一张 $200\text{M} \times 256$ 的 float32 表本身就 $\approx 205$ GB;
- 动态图(Dynamic graph):训练样本是按时间排序的事件,若在"数据集末态的图"上做消息传递就会泄漏未来边;而最直观的修法(扫邻接表按时间戳过滤)在 $\deg \sim 10^4$ 的 hub 用户上会变成瓶颈。
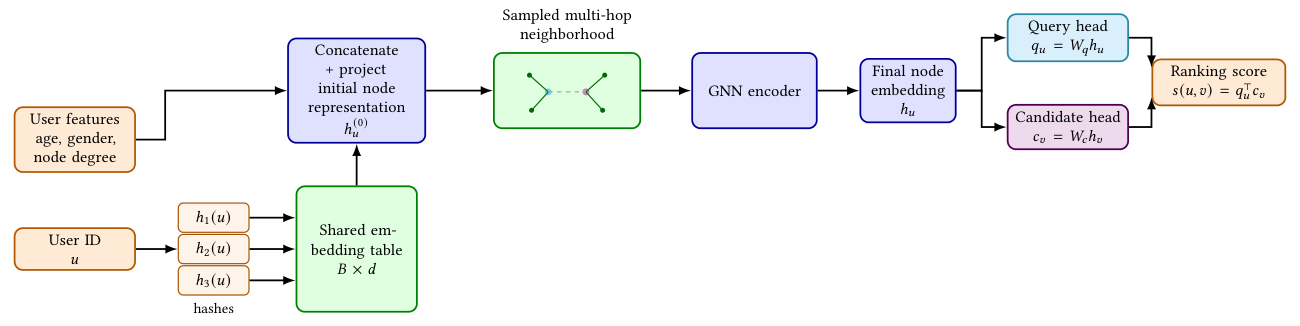
本文的解法:用户 ID 通过一个 multi-hash 层进入 GNN,把每个用户映射进一张 $B \ll |V|$ 的共享表,用有界的哈希碰撞换掉那张不可行的 $|V| \times d$ 表;时序邻居采样在按时间戳排序的 CSR 上用二分查找定位截断点,使采样几乎不比非时序采样更慢。编码器本身是 GATv2,出口接两个角色特化的 head(recipient / candidate),在曝光日志上以二分类训练。
贡献清单(原文自述)¶
- 把 multi-hash ID embedding 作为工业 GNN ranker 的一等输入层,把 ID embedding 表从 >200 GB 降到 2 GB(<1%),且质量与完整 $|V| \times d$ 表持平;
- 描述一个基于二分查找、跑在时间戳排序 CSR 上的时序邻居采样器,单次代价 $O(\log d_u + K)$ 对比主流 GNN 库的 $O(d_u + K)$,消除了训练期约 2.5× 的开销;
- 描述端到端流水线——CSR 存储、CPU 采样与 GPU 训练解耦、离线 embedding 刷新——使得 225 GB 图、28B 边的系统跑在单台 8 卡主机上;
- 报告隔离每个设计选择贡献的离线消融,以及生产社交网络上的线上 A/B(+16% 好友添加、+11.5% 独立添加用户);
- 开源训练与推理框架,含在大规模带时间戳 CSR 图上训练与刷新 GNN embedding 所需的组件。
问题形式化¶
图与任务¶
考虑大型社交网络的好友图 $G = (V, E)$:节点是活跃用户,无向边 $(u,v) \in E$ 表示 $u$ 与 $v$ 互为好友。图是动态的——每条边带一个时间戳 $t_{uv}$,记录好友关系建立的时刻。预处理阶段把用户重新索引到连续区间 $[0, |V|-1]$,因此同一个整数 ID 既作为 CSR 索引、又作为哈希函数的输入(这个细节很关键,它让 multi-hash 与 CSR 共用同一套 ID 空间,无需额外映射表)。
好友推荐出现在多个产品位(侧边栏、专门的 PYMK feed、新用户引导),都由同一条两阶段漏斗驱动:候选生成(产品特定的行为计数器、Adamic–Adar、以及学习式召回)→ 排序。本文聚焦排序:给定用户 $u$ 与上游候选集 $C_u \subset V$,模型为每个 pair $(u, v)$,$v \in C_u$ 打分。作者明确声明:本系统只排好友候选,不是内容 feed 排序栈的一部分;§6.6 里出现的 feed 指标仅作为图连通性改善的下游指示器。
训练目标¶
训练信号来自推荐曝光的交互日志 $D$,每条记录是四元组 $(u_i, v_i, y_i, \tau_i)$:$\tau_i$ 是曝光时间戳,$y_i$ 在"曝光导致了好友添加"时为正,在"无动作曝光"和"显式 hide 事件"时为负。
一个很重要的工程语境:GNN 的打分是被下游 GBDT(gradient-boosted ranker)当作特征消费的,而那个 GBDT 本身就是在同样形式的 impression-conditioned 标签上训练的;作者原样沿用这套标注,好让训练与线上服务面对同一个 pair 分布。
模型以标准交叉熵做二分类训练:
$$\mathcal{L} = -\frac{1}{|D|}\sum_{(u,v,y,\tau) \in D}\Big[ y \log f(u,v;\tau) + (1-y)\log\big(1 - f(u,v;\tau)\big) \Big] \tag{1}$$
其中 $f(u,v;\tau)$ 只使用 $\tau$ 时刻之前可得的信息——这一句就是后面整个时序采样机制存在的理由。
核心方法¶
GNN 编码器与双头打分¶
节点编码器是 $L$ 层堆叠的 GATv2 卷积。在第 $l$ 层,对顶点 $v$ 的每个邻居 $u$,注意力分数为
$$e^{(l)}_{vu} = a^{(l)\top}\,\mathrm{LeakyReLU}\Big(W^{(l)}_s h^{(l)}_v + W^{(l)}_t h^{(l)}_u\Big) \tag{2}$$
在 $v$ 的邻居集合上做 softmax 得到权重
$$\alpha^{(l)}_{vu} = \frac{\exp\big(e^{(l)}_{vu}\big)}{\sum_{k \in \mathcal{N}(v)} \exp\big(e^{(l)}_{vk}\big)} \tag{3}$$
下一层表示为
$$h^{(l+1)}_v = \sigma\Big(\sum_{u \in \mathcal{N}(v)} \alpha^{(l)}_{vu} W^{(l)}_t h^{(l)}_u\Big) \tag{4}$$
$L$ 层之后得到上下文表示 $h_v = h^{(L)}_v$,再经两个 head 投影:
$$z^q_u = f_q(h_u), \qquad z^c_v = f_c(h_v), \qquad s(u,v) = \big\langle z^q_u,\ z^c_v \big\rangle \tag{5}$$
为什么要两个 head:query(接收推荐的用户)与 candidate(被推荐的用户)这两个角色是不对称的——同一个用户在训练数据里既会作为 query 出现、也会作为 candidate 出现,用单一表示会把两种角色混为一谈。分头正是为了让模型能区别对待"我倾向于加什么样的人"与"我作为候选有多容易被加"。这一点也直接决定了线上打分能退化成内积(见 §6.2 与 §7.2 的部署讨论)。
时序邻居采样:从 $O(\deg)$ 到 $O(\log \deg)$¶
为什么必须采样:堆叠 GNN 下一个顶点的表示依赖它的 $L$ 跳邻域。在这张图上,$L$ 跳邻域因为高度数 hub 增长极快——即便 $L=2$,单个种子也能触达数千万节点。因此沿用标准做法,每跳对每个顶点采样有界的 $K$ 个邻居,把计算图规模限制在 $O(K^L)$。
为什么必须"时序":每条训练样本 $(u,v,y,\tau)$ 带事件时间戳 $\tau$;为避免从"当时还不存在的边"泄漏信息,消息传递被限制在时序邻域
$$\mathcal{N}_{<\tau}(u) = \{\, v \in \mathcal{N}(u) : t_{uv} < \tau - \Delta \,\} \tag{6}$$
其中 $\Delta \ge 0$ 是安全偏移量:排除 $[\tau - \Delta,\ \tau]$ 窗口内形成的边,以对生产流水线中延迟的边更新保持鲁棒(基线配置 $\Delta = 30$ 分钟)。
一个容易被做错的细节:同一个截断 $\tau$ 被传播到全部 $L$ 跳——当展开种子 $u$ 的某个采样邻居 $w$ 时,仍然限制在 $\mathcal{N}_{<\tau}(w)$,而不是按边时间戳 $t_{uw}$ 平移后的截断。用作者的话说:"是训练样本、而非中间那条边,固定了可见的历史"。
朴素做法为什么不行:从 $\mathcal{N}_{<\tau}(u)$ 抽 $K$ 个邻居,最直接的办法是扫一遍邻接表、按时间戳过滤、再采样——这正是主流开源 GNN 库(DGL、PyTorch Geometric)在被要求做 timestamp-aware 采样时的行为。对 $\deg(u)$ 达到数万的用户,这太慢了。
本文做法:对每个顶点 $u$ 存两个协同数组 $\mathrm{nbrs}_u = (v_1,\dots,v_{d_u})$ 与 $\mathrm{ts}_u = (t_{uv_1},\dots,t_{uv_{d_u}})$,按 $t_{uv_i}$ 升序排序。采样时二分查找前缀边界
$$p = \texttt{lower\_bound}\big(\mathrm{ts}_u,\ \tau - \Delta\big) \tag{7}$$
使得对所有 $i < p$ 都有 $t_{uv_i} < \tau - \Delta$,然后从合法前缀 $(v_1,\dots,v_{p-1})$ 中均匀采 $K$ 个。实现层面的差别一句话说清:朴素采样器要扫完整个邻接表来物化过滤后的候选集,优化采样器用一次 lower_bound 调用就拿到同一个候选前缀,然后直接在前缀上采样。
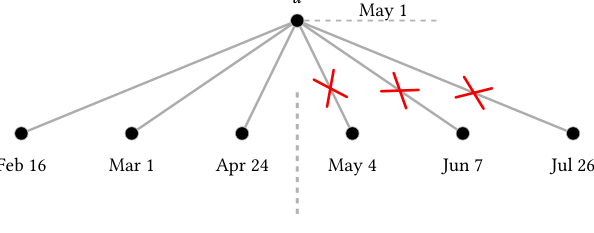
(上图为原文 Figure 2 的右半:邻居按时间戳排序后,二分切分出"合法的过去前缀"与"被划掉的未来后缀";左半是乱序邻居必须逐个扫描的对照。)
复杂度:令 $d_u = |\mathcal{N}(u)|$、$K$ 为请求的 fanout,则
$$\text{binary-search sampler: } O(\log d_u + K) \quad \text{vs.} \quad \text{naive scan: } O(d_u + K) \tag{8}$$
非时序采样的下界是 $O(K)$。这个 per-call 界依赖一次性预处理:构建 CSR 时,每个顶点的邻接表用标准比较排序按边时间戳排好,全图总代价
$$O\Big(\sum_u d_u \log d_u\Big) = O\big(|E| \log d_{\max}\big) \tag{9}$$
关键在于排好的顺序是快照的静态属性:它被每个训练 epoch、每次 embedding 刷新原封不动地复用,采样本身从不重排序。作者解释了为什么这个 per-call 的差距在大图上真的重要:少量超高度数顶点会被非常频繁地作为邻居访问到,$d_u$ 与 $\log d_u$ 的差距因此直接决定采样吞吐。
节点表示:tabular 特征 + multi-hash ID 嵌入¶
"往 GNN 底层喂什么"本身就是一个设计选择。作者把已有做法分为两派:经典论文(NGCF、LightGCN)用按 node ID 索引的可学习 embedding 表;工业工作(PinSage、GraFRank)常依赖预计算 embedding 或内容特征;而 LiGNN 的近期结果表明可学习 ID embedding 在工业图上价值很高。本文两者都用。
Tabular 特征:只用 $m = 3$ 个用户特征——性别、年龄、好友图上的度数。性别按类别特征处理;年龄与图度数先做分位数分桶再当类别特征,于是每个特征 $j \in \{1,\dots,m\}$ 取 $C_j$ 个离散值之一。每个特征表示成 one-hot 向量 $x_{u,j} \in \{0,1\}^{C_j}$,经特征专属线性层 $(W_j \in \mathbb{R}^{H \times C_j},\ b_j \in \mathbb{R}^H)$ 加 LayerNorm 投到编码器隐藏维 $H$(基线配置 $H = 512$),再逐特征求和:
$$z^{\mathrm{feat}}_{u,j} = \mathrm{LayerNorm}\big(W_j x_{u,j} + b_j\big) \in \mathbb{R}^H, \qquad z^{\mathrm{feat}}_u = \sum_{j=1}^{m} z^{\mathrm{feat}}_{u,j} \tag{10}$$
Multi-hash ID 嵌入:作者的判断是"本任务里结构信号通常强于特征信号",所以想在特征之上再加一个可训练的 per-user embedding;但如 §1 所述,$|V| \times d$ 的朴素表在这个尺度上用不了,而且一张这么大的 embedding 表会把服务栈推向复杂得多的领域。
于是采用 multi-hash(沿 feature hashing 与 hash embeddings 的路线):一张小的共享表 $T \in \mathbb{R}^{B \times d}$,$B \ll |V|$,由 $k$ 个独立哈希函数索引,$r_i(u) = h_i(u) \bmod B$,$i = 1,\dots,k$。取出的 $k$ 行拼接后投影:
$$e^{\mathrm{hash}}_u = T_{r_1(u)} \,\|\, T_{r_2(u)} \,\|\cdots\|\, T_{r_k(u)} \in \mathbb{R}^{kd} \tag{11}$$
$$z^{\mathrm{emb}}_u = \mathrm{LayerNorm}\big(W_h e^{\mathrm{hash}}_u + b_h\big) \in \mathbb{R}^H \tag{12}$$
底层节点表示即两者之和:
$$h^{(0)}_u = z^{\mathrm{feat}}_u + z^{\mathrm{emb}}_u \tag{13}$$
碰撞分析:在均匀哈希族下,两个固定用户在单个哈希上碰撞的概率是 $1/B$,因此完全碰撞($k$ 个哈希全撞)的概率是 $(1/B)^k$,随 $k$ 增大迅速衰减。部分碰撞很常见且可以接受:每次部分碰撞只影响 $k$ 个贡献行中的一行,而投影矩阵 $W_h$ 仍然能把"共享了部分哈希"的用户区分开。这是全文最核心的一个"用有界碰撞换 100× 内存"的论证。
训练与推理系统¶
两阶段流水线¶
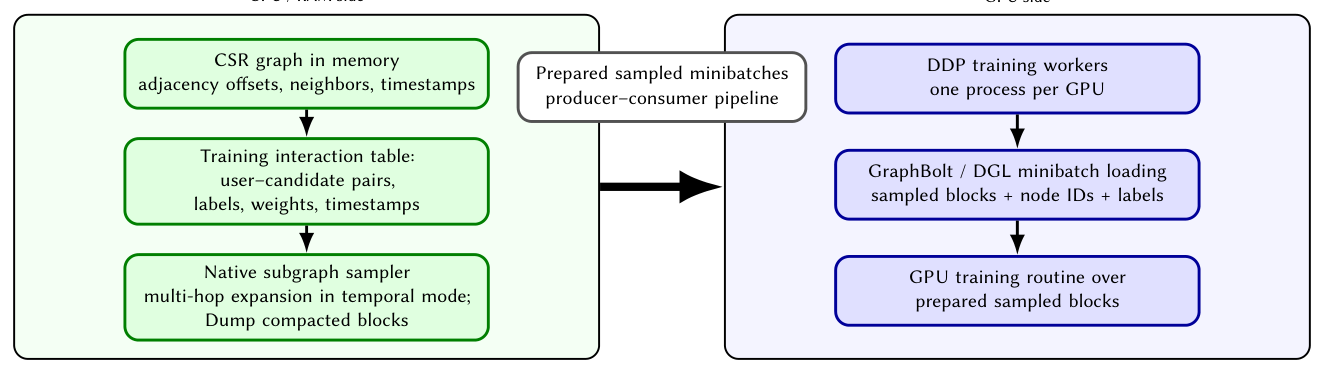
训练 GNN 有两类性质完全不同的负载:CPU-bound 的 batch 构建(多跳邻域采样、时序过滤,被随机 CSR 访问和内存带宽支配)与 GPU-bound 的训练。本文把两者解耦:
- 采样器(Java/C++ 实现 + Python 绑定)消费 CSR 图与 batch 种子,把 minibatch 序列化进一个有界队列;每个 minibatch 含:采样得到的消息传递 block(逐层的二部子图)、用于特征查表的压实后节点 ID、用于 multi-hash 查表的原始用户 ID、以及逐样本标签。
- 训练器(PyTorch + DGL/GraphBolt)从队列读取并跑优化器。
两级独立扩展:CPU worker 吸收采样积压,prefetch buffer 吸收 GPU 停顿。
硬件与运行时¶
训练与推理都跑在单台主机上:8 × NVIDIA A100 80 GB、512 GB 系统内存、64 CPU 核。CSR 图与 tabular 特征表放 CPU 侧;multi-hash 表、模型参数、优化器状态、激活值放 GPU 侧。基线配置下 multi-hash 表约 2 GB,整个 GPU 侧状态能舒服地塞进单卡并在 DDP 各 rank 间复制——这正是 multi-hash 设计带来的直接后果(若用完整表,就必须上 TorchRec row-sharding,见 §6.4.1)。
图存储:CSR 布局与位宽选择¶
图与交互日志分开存储。用户重索引到 $[0, |V|-1]$ 后,图以 CSR 布局保存:
- indptr — 每顶点在邻居数组中的偏移;
- indices — 拼接后的邻居 ID;
- timestamps — 与 indices 对齐的时间戳。
位宽推理很实在:indptr 的最大值被 $|E| - 1$ 界定,indices 被 $|V| - 1$ 界定。$|V|$ 在几亿量级,所以邻居 ID 能塞进 32 位整数;而 indptr 必须 64 位,因为总边数超过 $2^{32}$。用 32 位 indices 直接把那个最大数组的内存占用砍半。timestamps 也保持 32 位整数(带偏移的 Unix 秒)。
生产图上的具体 CSR 足迹:
| 组件 | 计算 | 大小 |
|---|---|---|
| indices | $28 \times 10^9 \times 4$ B | ≈ 112 GB |
| timestamps | $28 \times 10^9 \times 4$ B | ≈ 112 GB |
| indptr | $(\lvert V\rvert + 1) \times 8$ B | ≈ 1.5 GB |
| 合计 | ≈ 225 GB |
这正好塞进主机的 512 GB 内存——这也是他们能把整张图常驻进程的原因。时序采样所需的"邻接表内按时间戳升序"在建图时一次完成;同一套 CSR 格式在推理时复用。
推理与 embedding 刷新¶
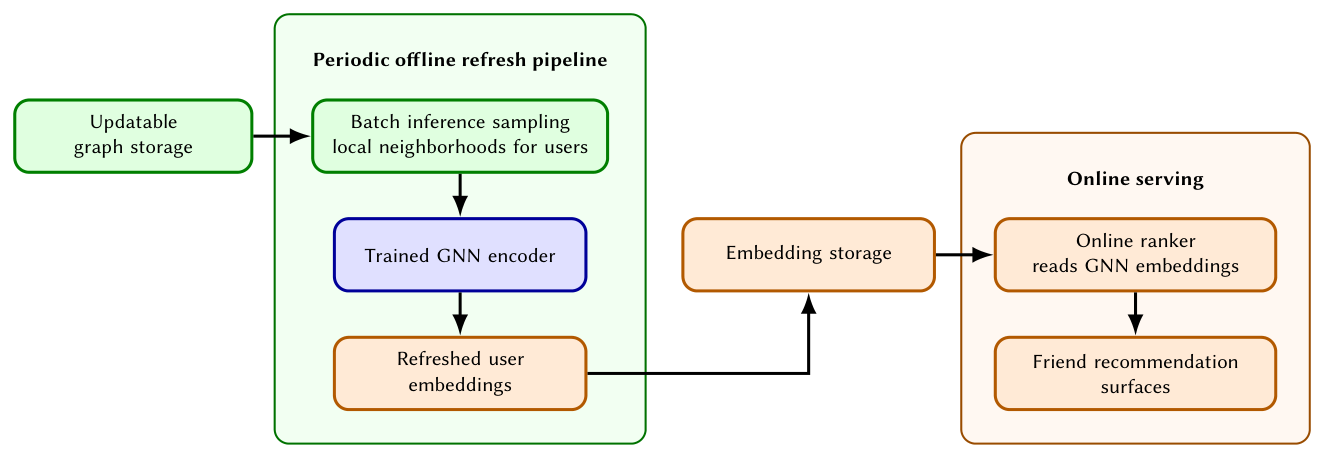
推理时复用同一套邻域展开:对一批用户物化采样局部子图、跑训练好的编码器,产出被生产 ranker 消费的用户 embedding。
刷新策略由 GNN 的依赖结构决定:与 two-tower 模型(用户 embedding 只依赖用户自身特征)不同,GNN 表示依赖一个采样邻域,因此单条新边可以影响很多个 embedding。作者不在线追踪这种级联,而是让编码器周期性地为一个大的活跃用户子集重算表示。模型本身也以同样的周期从头重训。
实验设置¶
数据规模(Table 1)¶
| Statistic | $\lvert V \rvert$ | $\lvert E \rvert$ | Train interactions | Test interactions |
|---|---|---|---|---|
| Value | 194M | 28B | 1.4B | 25M |
用的是生产好友图快照与配套曝光日志。交互按曝光时间戳做时序切分,最近三年用于训练。标签是二分类(见 §2.2)。
基线训练配置(Table 2)¶
除非另有说明,所有模型都用下表配置训练;消融一次只改一个参数,其余固定。
| 组件 | 设置 |
|---|---|
| GNN encoder | GATv2,$L = 2$ 层,8 个注意力头 |
| Hidden dimension | $H = 512$ |
| Head output dimension | 128(query / candidate) |
| Multi-hash slots | $k = 3$ |
| Shared hash table | $B = 2^{21}$ 行,维度 $d = 256$ |
| Hash function | 64-bit 整数乘法哈希 |
| Per-hop fanout | $K = 30$ |
| Temporal sampling | 二分查找截断,偏移 $\Delta = 30$ 分钟 |
| Optimizer | Adam,学习率 $1.5 \times 10^{-3}$ |
| Batch size | 每 GPU 1024 个 user–candidate pair |
| Parallelism | 8 × A100 上 DDP |
| Stopping rule | 按验证 ROC-AUC 早停 |
Baselines¶
三个基线,覆盖"无学习的流行度先验"到"上一代生产 ranker"的全谱:
- Top-pop:候选按其在好友图中的入度排序。无可学习参数,作为 sanity-check 下界。
- MF:矩阵分解,在与 GNN相同的交互日志上训练。
- WalkGNN:本公司上一代生产方案(Zamyatin, arXiv:2412.11888)。它通过在局部 ego-net 上下文上聚合 GNN 相关性估计来给 user–candidate pair 打分,是最强的生产基线。作者特别点出一个部署侧的对照:本文模型离线预计算用户 embedding,线上 pair 打分退化为一次内积,因此服务路径比"为每个被打分的 pair 现场构造 ego-subgraph"更简单也更便宜。
主要实验结果¶
离线排序质量(Table 3,per-user ROC-AUC)¶
| Top-pop | MF | WalkGNN | Ours | |
|---|---|---|---|---|
| ROC-AUC | 0.5050 | 0.5316 | 0.5572 | 0.6278 |
结论分析:这是一条逐级加信号的阶梯,每一级的语义都很清楚——MF 捕获协同模式(+0.0266 over Top-pop);WalkGNN 加入局部 ego-network 结构(+0.0256);本文模型贡献了最大的增量(+0.0706,相对 WalkGNN +12.7%),方式是把消息传递扩展到完整的多跳邻域。作者把这一步归因得很直接:这一步之所以可行,正是因为 multi-hash 与时序采样这两个选择(分别在 §6.4.1 与 §6.4.3 消融)。换句话说,本文真正的论点不是"GATv2 比 ego-net 聚合更强",而是"只有先解决表怎么放、采样怎么快,你才有资格把邻域开到多跳"。
值得注意的是绝对值本身都不高(0.50–0.63)——这是好友排序任务的固有难度:候选已经被上游召回筛过一轮,剩下的都是"看起来都还行"的人,而且标签是 impression-conditioned 的接受率,噪声很大。因此应当看相对差距而非绝对水平。
消融与分析¶
输入表示的消融(Table 4)¶
隔离 tabular 特征与 multi-hash ID embedding 各自的贡献,并额外对比一张完整 $|V| \times d$ 可训练 embedding 表作为高容量参考点。这张完整表在单机上放不下,是通过 TorchRec 在 8 张训练 GPU 上做 row-sharding 离线实现的;它不是一个可服务的选项,存在的意义只是量化 multi-hash 压缩的质量代价。
| ID scheme | Embedding table size | ROC-AUC |
|---|---|---|
| Features only | — | 0.5244 |
| Multi-hash IDs only (no features) | 2 GB | 0.5997 |
| Features + full table | 202.88 GB | 0.6246 |
| Features + multi-hash IDs (ours) | 2 GB | 0.6278 |
结论分析(原文给出两条,都很有分量):
- 结构信号单独用就大幅超过特征信号单独用(0.5997 vs 0.5244,+0.0753)——确认了对好友排序而言,图携带的信息比 profile 多。注意"multi-hash IDs only"里的 ID embedding 本身并不含语义,它之所以有用,是因为这些 ID 嵌入是在消息传递的框架里被训练的,最终学到的是"这个用户在图上的位置"。
- multi-hash 用不到完整表 1% 的内存,质量却与完整表持平——甚至略优(0.6278 vs 0.6246)。作者对这个"略优"给出的假说是:multi-hash 诱导的有界共享起到了隐式正则的作用,避免了在单个用户行上过拟合。这个解释很合理:194M 用户里绝大多数只有很少的曝光样本,一行专属 embedding 几乎必然过拟合;而强制若干用户共享同一行,等于施加了一个"相似度先验"。
这条结果的工业含义非常直白:那张 202.88 GB 的表不但换不来质量,还会把服务栈拖进分布式 embedding 存储的复杂度里。
共享表大小 $B$ 的扫描(Table 5)¶
固定 $k = 3$、$d = 256$,把 $B$ 从 $2^{17}$ 扫到 $2^{22}$:
| $B$ | $2^{17}$ | $2^{18}$ | $2^{19}$ | $2^{20}$ | $2^{21}$ | $2^{22}$ |
|---|---|---|---|---|---|---|
| Hash table memory | 128 MB | 256 MB | 512 MB | 1 GB | 2 GB | 4 GB |
| ROC-AUC | 0.5952 | 0.6044 | 0.6092 | 0.6184 | 0.6278 | 0.6310 |
结论分析:质量随 $B$ 单调增长,且在 $2^{22}$ 处仍未见平台。作者选 $B = 2^{21}$ 作为生产配置的理由是纯粹的性价比:$2^{22}$ 表大小翻倍,质量只动一点点(0.6278 → 0.6310,+0.0032,而 $2^{20} \to 2^{21}$ 是 +0.0094)。这张表也顺带说明了 multi-hash 方案的可调性:它不是一个二值开关,而是一条能按内存预算连续滑动的质量–内存曲线——这在工业环境里比"要么全表要么没有"有价值得多。
时序采样的消融(Table 6)¶
关掉时序采样会让模型聚合预测时刻尚不存在的边——这是一种标签泄漏。下表同时报告质量影响与每 batch 的采样开销(wall-clock,基线配置):
| Sampler | ROC-AUC | Sampling time |
|---|---|---|
| Non-temporal | 0.5907 | 581 ms |
| Temporal, naive scan | 0.6278 | 1473 ms |
| Temporal, binary search (ours) | 0.6278 | 595 ms |
结论分析(这是全文设计最漂亮的一张表,因为它把"正确性"与"代价"两个维度一次性钉死):
- 非时序模型比时序版低 0.0371 ROC-AUC——注意这是低,不是高。这一点值得展开:泄漏未来边通常会让离线指标虚高,但这里反而更差。合理的解读是,训练时看到未来边会让模型学到"两人已经是好友"这种在推理时根本不可得的捷径特征,于是训练–测试分布错配,最终在真正的 held-out 时序测试集上反而崩掉。这个数字因此量化的是"泄漏"的代价,而不是"泄漏"的收益。
- 两个时序采样器抽自同一个 $\mathcal{N}_{<\tau}(u)$,质量完全相同(都是 0.6278)——这是必须的对照:证明二分查找不是近似,而是同一分布的更快实现。
- 二分查找采样器的每 batch 代价(595 ms)几乎与非时序采样(581 ms)持平,只多 2.4%;而朴素扫描要 1473 ms,慢约 2.5×。也就是说,本文把"时序正确性"这件事的成本从"2.5 倍采样开销"降到了"近乎免费"。考虑到 §6.5 里每 epoch 43.4 小时的 wall-clock,这 2.5× 的差别在实践中就是"训得完"与"训不完"的差别。
系统可扩展性(Table 7)¶
基线配置下测得的端到端运营数字:
| 类别 | 指标 | 数值 |
|---|---|---|
| Training time | GPU step(每 batch 前向 + 反向) | 927 ms |
| Wall-clock time per epoch | 43.4 h | |
| Iterations to early stopping | 252 k | |
| Total training time to convergence | 63 h | |
| Inference & memory | 为全部 194M 用户计算 embedding | 6.57 h |
| CSR graph, CPU side | 225 GB | |
| Tabular feature tables, CPU side | 2.18 GB | |
| Multi-hash table, GPU side | 2 GB | |
| Model parameters + Adam state, GPU side | 6.03 GB |
结论分析:作者只用一句话点题——图占 225 GB,但可训练参数集合能塞进单张 GPU,这是 multi-hash 设计的直接后果。把几个数字放在一起看更清楚:GPU 侧总状态 $\approx 2 + 6.03 = 8.03$ GB,对 80 GB 的 A100 而言绰绰有余;若换成 202.88 GB 的完整表,仅参数就要跨 8 卡分片(TorchRec),还要承担 all-to-all 通信与更复杂的 checkpoint / 服务链路。此外,63 小时收敛、6.57 小时刷新全量 194M 用户 embedding,意味着"周期性从头重训 + 周期性全量刷新"这套看似粗暴的策略在时间预算上是可行的——这也反过来解释了 §7.1 里为什么冷启动可以靠"重训周期"兜底。
另一个隐含信息:252k 次迭代、每 batch 每卡 1024 pair、8 卡 → 约 $252\text{k} \times 1024 \times 8 \approx 2.06$B 个 pair,而训练集是 1.4B 交互,说明大致训了 1.5 个 epoch 左右就早停了(与"每 epoch 43.4 h、总计 63 h"一致)。在 1.4B 样本上不到两个 epoch 就早停,也侧面说明数据量相对模型容量是充裕的。
线上 A/B 实验(Table 8)¶
用 Table 2 配置训练的模型,作为排序特征部署进生产好友推荐流水线:实验组的 ranker 被 GNN 分数增强,对照组用上一代生产 ranker。实验在生产流量上跑了两周。
| Metric | Relative change |
|---|---|
| Friend additions from recommendations(推荐带来的好友添加) | +16.0% |
| Unique users adding a recommended friend(独立添加用户数) | +11.5% |
| Total time spent in content feed(内容 feed 总停留时长) | +0.28% |
| Ranker p50/p90/p99 latency | no regression |
结论分析:
- 两个直接的好友关系指标分别提升 +16.0% 与 +11.5%,均在 $p < 0.01$ 显著。两个数字的差值本身有信息量:添加总数的提升(16.0%)大于独立添加人数的提升(11.5%),说明收益不只是"更多人被激活",还有"已经在加好友的人加得更多"——即排序质量的提升让单个用户在一次 session 里能连续找到多个值得添加的人。
- feed 停留时长 +0.28% 也统计显著,作者明确把它定位为纯粹的下游效应:用户建立了更多连接 → 因此获得更多内容。这一点在 §2.1 就先做了防守性声明(本系统不参与内容 feed 排序),避免把这个提升记到 feed 模型头上。这是一处很克制、很可信的归因。
- 延迟无回退的机制解释非常关键:因为 GNN 信号是以预计算 embedding 的形式交付的,而不是请求时计算的,所以 ranker 延迟与对照组相比在噪声范围内。这条与 §6.2 里"WalkGNN 需要为每个被打分 pair 构造 ego-subgraph"形成对照——本文不仅质量更好,服务成本还更低。
核心贡献总结¶
- 把 multi-hash 提升为工业 GNN 的一等输入层:不是"高基数特征的一个技巧",而是节点表示的主通路;用有界碰撞把 202.88 GB 换成 2 GB(<1%),质量不降反升(0.6246 → 0.6278),并给出"共享即隐式正则"的解释。
- 让时序正确性变得几乎免费:时间戳排序 CSR +
lower_bound二分,把每次采样从 $O(d_u + K)$ 降到 $O(\log d_u + K)$,实测 1473 ms → 595 ms(≈2.5×),且产出分布与朴素扫描完全一致(ROC-AUC 都是 0.6278)。排序成本一次性摊进建图($O(|E|\log d_{\max})$),之后所有 epoch 与刷新复用。 - 一台 8 卡机跑 225 GB 图 / 28B 边的完整工程配方:32/64 位混合位宽的 CSR、CPU 采样与 GPU 训练用有界队列解耦、周期性全量 embedding 刷新(6.57 h / 194M 用户)。
- 真实的线上收益与开源:两周生产流量 A/B,好友添加 +16.0%、独立添加用户 +11.5%、p50/p90/p99 无回退;框架已开源。
与已归档相关工作的对比¶
Embedding Items at Scale: Comparing GNN-Based and ID-Based Item Embeddings in the Yandex Ecosystem Embedding Items at Scale: Comparing GNN-Based and ID-Based Item Embeddings(Yandex,2026-07-29)¶
关系:独立并发(本文未引用该工作,两者殊途同归、结论互补)· 已加载对方精读
- 共同关注的问题:两篇论文对着的是同一个 root cause——工业规模下高基数实体 ID 的可训练表示到底该怎么产出:完整的 per-entity embedding 表在几亿量级不可行,于是只剩两条路,要么用哈希把它压进一张共享小表并与主模型端到端一起学,要么另起一个独立的图表示学习阶段、把图结构烘焙进预训练 embedding 再冻结着喂给下游。两篇都在"排序模型 + 下游 GBDT"这同一套生产形态里回答它(本文的 GNN 分数进 gradient-boosted ranker,Yandex 的 transformer 分数进 CatBoost),也都来自俄罗斯的大平台(VK / Yandex),时间只差一个月。
- 相近的技术骨架:multi-hash ID embedding 是两篇共同的主角——同一个 ID 过 $k$ 个独立哈希、索引一张固定大小的共享表、取出的行做拼接(Yandex 也提到求和变体)后投影,全程与主模型联合训练。两篇也都把它与"图侧表示"放在同一条通路的同一个插拔点上做单变量对照:本文的 Table 4(features only / multi-hash only / full table / features+multi-hash),Yandex 的 Table 1(no embedding / TwHIN / MultiBiSage / ID / TwHIN+ID)。
- 本文的差异与推进:Yandex 的结论是否定式的——大规模下预训练 GNN embedding(TwHIN +0.790%、MultiBiSage +0.565%)全面输给端到端 multihash ID embedding(+1.238%),连微调过的 TwHIN(Music 上 +0.524%)也追不上纯 ID(+0.699%),因此"多加一个 embedding 预训练阶段不值那份成本"。本文则给出了这个否定结论的正确边界:Yandex 否定的是"把图信号打包成冻结的预训练 embedding"这个形态,而不是图信号本身。本文把 GNN 直接做成端到端模型的一部分、把 multi-hash 塞进它的输入层,于是两种信号不再是竞争关系而是叠加关系——Table 4 里"multi-hash only"0.5997 就已经把"features only"0.5244 甩开,而这 0.5997 恰恰是经过消息传递训练出来的 ID 表示。换句话说:Yandex 说"别单独训图",本文说"那就别单独训,把图训进主模型里",两者合起来才是完整的方法论。
- 可比的方法 / 实验差异:(a)图的角色不同——Yandex 的 GNN 产出 item 侧的冻结特征(LMDB 存 SSD),本文的 GNN 就是 ranker 本身,用户 embedding 离线刷新但由端到端训练的编码器产出;(b)碰撞的处理不同——Yandex 的 Music 实验刻意让 ID embedding 不用哈希($O(10^5)$ 热门曲目,每 item 独占一行)以排除碰撞干扰,本文则正面量化了碰撞代价($k=3$、$B=2^{21}$,完全碰撞概率 $(1/B)^3$,且 Table 5 给出质量随 $B$ 的单调曲线);(c)规模依赖的方向一致——Yandex 发现低资源 Lavka(3315 用户 / 25833 item)上预训练反而更好,本文的 194M 用户完全落在 Yandex 的"大规模"一侧,两者不冲突;(d)验证强度上本文更硬:Yandex 只有离线 CatBoost 增量 + 32 折 Wilcoxon,本文有两周生产流量 A/B(+16.0% / +11.5%,$p<0.01$)。
被剔除的近似候选(记录理由,防止门槛放水):
- AMBER AMBER(AI at Meta):确实也做"用更少的存储表示海量交互"(Matryoshka Dropout + INT8 QAT 服务在 INT4,8× 存储压缩),但问题不同构——AMBER 压的是缓存 event token 的服务侧物化成本(瓶颈在 feature materialization,不在参数表放不下),解法是"用一个双向 Transformer tokenizer 把几百个异构特征压成 1–2 个连续 token",与"用哈希碰撞换 embedding 表内存"在机制上没有重合。剔除。
- Language Models Without a Trainable Input Embedding Table: Learning from Fixed Minimal Binary Token Codes Language Models Without a Trainable Input Embedding Table:解法轴上最接近"去掉那张大表"(固定 $K=\lceil \log_2 V\rceil$ 比特二元码 + 零参数 tile lift 替换 67.1M 参数输入表),但问题 root cause 不同构——67.1M 参数在 LLM 里根本不是容量瓶颈,那篇要回答的是"可训练输入表是否架构必需"这个存在性问题,而本文是"205 GB 放不下"这个物理约束问题;而且它是零参数固定码,没有可学习共享表,也没有碰撞–质量的权衡曲线。剔除。
- IDProxy IDProxy(Xiaohongshu):同样在处理"ID embedding 不够用",但指向的是冷启动 item 没有可学 ID 表示,解法是用多模态 LLM 生成代理 ID embedding 再两阶段对齐——问题是信号缺失而非存储不可行,解法是外部语义注入而非哈希共享。剔除。
- G2Rec G2Rec(Meta):也是"图 + 工业推荐",但它构造的是 item–item 共参与图并做可微软模块度聚类得到兴趣原型 token 喂给 Llama2-13B,既不解决 ID 表规模问题、也不涉及时序采样,只是共享
graph标签。剔除。 - IID-Nav IID-Nav(Kuaishou):图上的多跳扩展这一点表面相近,但它把召回重构成有状态的目标驱动图导航(跨请求状态接力突破跳数上限),问题是召回深度受单请求延迟限制,与本文的训练期采样代价 / 时序泄漏不是同一件事。剔除。
讨论与局限性¶
冷启动与新用户(原文 §7.1)¶
multi-hash 方案与训练时见到的用户 cohort 绑定:快照之后才注册、或训练时不活跃的用户在图上没有关联边,因而拿不到学习信号。处理方式是周期性在新图上重训;两次重训之间,这类用户由上游候选生成服务,GNN 重排器退回到一个"ID 侧内容仅来自偶然哈希碰撞"的表示——§6.4.1 的 features-only 消融(0.5244)恰好为这个 fallback 给出了下界。这个自我定位很诚实:重训节奏直接决定了冷启动窗口的大小。作者列了若干兼容方向:对部分邻域做归纳式聚合(GraFRank)、两次训练之间用连续 memory 更新(TGN)、用合成边做图稠密化(LiGNN)、低秩 warm-start folding-in。
非实时服务(原文 §7.2)¶
GNN embedding 依赖 $L$ 跳采样邻域,在线产出一个就需要跑训练器在 CPU 上跑的那套多跳展开——塞不进 ranker 调用的延迟预算(two-tower 模型没有这个问题,因为每一侧的表示只依赖自身特征)。因此 GNN 被保持在离线:embedding 按固定周期刷新、以特征形式暴露给在线 ranker,不抬高 ranker 的 p99。代价是两次刷新之间的陈旧(staleness)。作者的辩护是场景相关的:好友关系相比 feed 式互动是缓慢变化的信号,因此这个折中对好友推荐有利;而在"session 内兴趣漂移"的场景上,代价更高的连续更新 memory 模块(TGN)会更合适。
迁移到异质图(原文 §7.3)¶
两个设计选择都能迁移到异质图(大量推荐部署都在异质图上):时序采样器完全不变——每种边类型各自维护一份按时间戳排序的 CSR,一次截断查询就是每种边类型上的一次二分,代价仍是 $O(\log d_u + K)$。multi-hash 的迁移更有选择性——它不必用在每种节点类型上;例如 user–item 二部图里,item 通常有很强的内容特征、user 只有很弱的 profile 属性,因此自然的做法是给 item 喂内容特征、给 user 喂 multi-hash。
我的评价:值得借鉴的设计¶
- "用有界碰撞换 100× 内存,而且质量不降" 这条结论在 194M 用户尺度上被扎实验证了(Table 4),且给出了可信的机制解释(隐式正则)。这对任何面临"ID 表放不下"的团队都是可直接抄的结论,而且它比"完整表 + 分布式 embedding 存储"的路线在服务栈上简单一个数量级。
- 把"正确性"的成本工程化到接近零(Table 6)。学术论文里"时序采样"通常一笔带过,本文把它变成一个有复杂度界、有 wall-clock 数、有质量对照的完整论证,而且证明了优化前后分布完全一致(同为 0.6278)——这种"更快且等价"的对照是系统论文里最有说服力的形式。
- 位宽与布局的具体推理(indices 32 位 / indptr 64 位,省下 112 GB 的一半)。这类细节通常只存在于内部文档里,写进论文很有价值。
- 归因的克制:feed 时长 +0.28% 被明确标为下游效应,并在 §2.1 提前声明系统不参与 feed 排序。
局限与争议¶
- 完全没有公开数据集实验。所有数字都来自 VK 内部图与内部曝光日志(194M / 28B / 1.4B / 25M),外部无法复现任何一条指标——虽然框架开源了,但没有配套的公开图 benchmark。这也是本篇无法向 benchmark 榜单提交任何条目的原因。
- 消融的"一次只改一个"策略掩盖了交互效应。例如 multi-hash 与时序采样是否有耦合(更小的 $B$ 是否会让时序泄漏的危害放大)没有被检验;Table 5 的 $B$ 扫描也是在固定 $k=3$、$d=256$ 下做的,$k$ 与 $d$ 的作用完全没有消融——而碰撞概率 $(1/B)^k$ 明明是 $B$ 与 $k$ 的联合函数,只扫 $B$ 不扫 $k$ 是这组消融最明显的缺口。
- "multi-hash 略优于完整表"的解释停留在假说层面。作者说"我们猜测有界共享起到了隐式正则作用",但没有做任何验证(例如按用户度数分桶看 ROC-AUC 差异、或对完整表加正则再比)。0.6278 vs 0.6246 的差距只有 0.0032,也没给方差或显著性检验——这个"不降反升"的结论其实脆弱,严格说只能宣称"持平"。
- 方法论可扩展性上有一个真实的结构瓶颈:GNN 表示无法在线计算(§7.2),因此整套方案被钉死在"离线刷新 + 在线读特征"的两阶段解耦形态上。参数量 scaling 时,$B$ 和 $H$ 可以一起长(Table 5 显示 $B$ 到 $2^{22}$ 还没饱和),但"如何刷新表示"这条路径不随之扩展——刷新一次 194M 用户已经要 6.57 小时,把模型放大只会让这个数字线性变差,而 staleness 窗口是产品可感知的。作者自己承认在"session 内兴趣漂移"的场景这套就不适用了。相比之下,two-tower / 序列模型能把用户侧表示做成请求时计算的,scaling 的收益能直接传导到线上。
- 与 baseline 的对照略显单薄。三个基线里 Top-pop 是 sanity check、MF 是弱基线,真正有意义的对照只有 WalkGNN 一个;而 §3 里点名的 GraFRank / SSNet / LiGNN 一个都没有实现对比(可以理解——它们都需要各自的工业数据),但这确实让"我们的 GNN 比别家 GNN 好"这个说法无从检验。本文能声称的严格结论是"比我们自己上一代生产系统好"。
工业落地价值¶
这是一篇部署证据非常完整的论文,落地细节的密度远超同类:
- 部署形态:GNN 分数作为一个排序特征注入生产好友推荐流水线,服务于侧边栏、PYMK feed、新用户引导等多个产品位;embedding 离线周期性刷新,在线只做内积。
- 业务收益(两周生产流量,$p < 0.01$):推荐带来的好友添加 +16.0%、独立添加用户 +11.5%、内容 feed 总停留时长 +0.28%;p50 / p90 / p99 延迟无回退。
- 资源画像:单台 8 × A100 80 GB / 512 GB RAM / 64 核;CSR 图 225 GB 常驻内存;GPU 侧总状态 8.03 GB;收敛 63 小时;全量 194M 用户 embedding 刷新 6.57 小时。
- 可复用性:框架已开源(含原生时序邻居采样器、multi-hash embedding 层、训练与推理流水线),是少数把"工业规模时序图训练"的实现细节真正放出来的工作。