SARA:把快手直播问卷里稀疏的「为什么喜欢/讨厌」扩成千万主播的排序特征¶
Kuaishou Technology(Haoke Xiao、Yueyang Liu、Yuhui Zhang、Xiang Chen 等 20 位作者;Project Lead: Xiang Chen;Advisor 含 Han Li、Kun Gai),arXiv:2609.17639v2,2026-09-15 首次提交(v2 于 2026-09-21),正文 23 页 + 附录。
一句话:用户说出来的偏好理由(Articulated User Rationales, AUR)是行为日志和内容描述都给不了的「why」信号,但它稀疏、质量参差、覆盖率极低。SARA 用一套问卷数据引擎在快手直播持续采集 AUR(185 天 191.6 万条候选 → Agent Judge 过滤后 18.75 万条 = SARA-HQ,覆盖 86,564 位主播),再用 SFT + Quality-Refining DPO 把 Qwen2.5-VL-7B 对齐成理由生成器 SARA-7B,为全部 1000 万主播按日生成正/负理由,最后以两条路径接入生产排序模型 SARA-Ranker:正理由做 token embedding + MIM 软对比约束用户-主播交互表示,负理由做 RQ 量化 SID 挂到用户的 Hate 历史上做 target attention。两组独立的 1% 流量 A/B:正理由路径观看时长 +0.986%,负理由路径 Hate −8.164%,全量上线 30 天以上。
⚠️ 阅读提示:本文的数据工程(问卷触发/动态投放/质量激励)与评测器工程(人标训练的 Agent Judge,对专家 MAE 0.20)扎实,但排序侧没有任何消融——两张结果表各只有一行「+本方法 vs 生产 base」,而每条路径都同时引入了新信号和新结构(UA 交互模块 + MIM 损失 + 门控残差;Hate 历史 target attention)。标题里的「Scaling」也值得细看:本文真正展示的是覆盖率从 8.6 万扩到 1000 万与一条 SFT 数据比例曲线,而不是模型尺寸或下游收益的 scaling。这两点在「消融与分析」「讨论与局限性」两章单独展开。
1. 研究动机与背景¶
1.1 行为信号只告诉你「做了什么」,不告诉你「为什么」¶
现代推荐系统主要从行为反馈(点击、观看时长、跳过、显式负反馈)及用户画像、交互历史中推断偏好。这些信号量大、易采,但只揭示用户做了什么,而不是为什么这么做:同一个观测行为可能出自完全不同的动机;一次 skip 或 dislike 也并不指明内容的哪一方面应该被规避。因此纯行为监督对建模细粒度、可迁移的偏好支撑有限。
业界的主流补法是引入多模态信号:视觉刻画物体、场景、外貌、动作;音频承载语音、音乐、嗓音、声学环境;文本提供高层语义与用户观点——hashtag 用来聚合相关内容,新闻/标题/商品描述刻画内容语义,评论与点评提供主观证据。MLLM 为统一处理这些异构信号提供了接口。
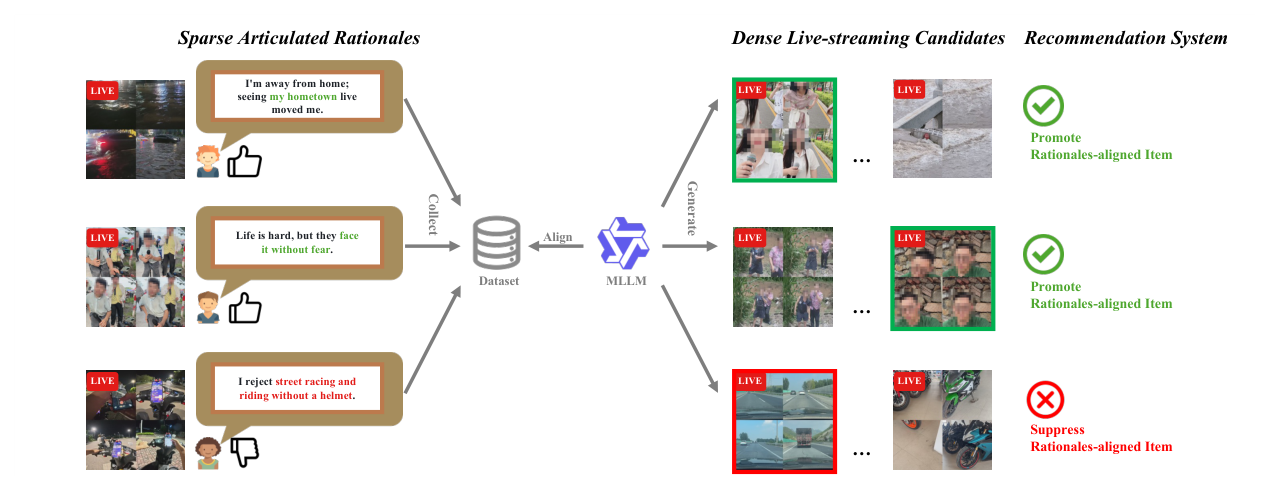
但作者指出一个本质缺口:更丰富的多模态表示并不等于揭示了「某个用户为什么喜欢/讨厌某个 item」。视觉和音频描述的是「内容里出现了什么」,hashtag 和元数据概括的是主题和属性;评论虽然有主观观点,却是在无约束的自我表达下产生的,不一定对应某一次具体的偏好决策。这个「内容理解 ↔ 用户偏好」之间缺失的连接,正是 AUR(articulated user rationales) 的动机——显式地记录用户为什么喜欢或不喜欢一个 item。
1.2 AUR 为何难以成为可规模化的推荐信号¶
作者归纳了三大挑战:
- R1 原生稀疏(Native sparsity):消费完一个 item,用户最自然的动作是划走、跳过或沉默。主动说明喜欢/不喜欢的原因是极低概率事件,覆盖率通常低于 1%(引 Nielsen 90-9-1 法则)。
- R2 表达质量普遍偏低:经 UI 输入的 AUR 往往口语化、碎片化、信息密度低,并带有自愿自报引入的情绪偏差。
- R3 通用 MLLM 的臆测式生成:用通用 MLLM 扩展 AUR 覆盖不可靠。即便辅以行为信号,MLLM 看到的是偏好结果而非背后原因,可能生成貌似合理但与用户真实表述无关的事后合理化(post-hoc rationalization)。
1.3 SARA 的三件套¶
SARA 把 AUR 通过一条标准的 collect – scale – integrate 流水线接到下游推荐:
- Data Engine:在 2.4 亿快手直播用户中持续征集 AUR 并做采后清洗。截至 2026 年 8 月,沉淀出 187,532 条精炼理由,构成 SARA-HQ;
- Rationale-Oriented Alignment:基于 SARA-HQ,用「大规模 SFT → Quality-Refining DPO」两阶段把通用 MLLM 改造成理由生成器 SARA-7B;
- Rationale-as-Feature Integration:用 SARA-7B 为 1000 万快手直播主播生成正/负理由,通过双分支架构接入生产排序模型——rationale-aware interaction modeling 做正向偏好匹配,rejection-memory modeling 让负反馈在语义相近的主播间泛化。所得排序模型称为 SARA-Ranker。
作者自称这是「首个把稀疏 AUR 规模化为生产级推荐信号、并在部署系统中证明其价值的工业框架」,并把 articulated rationales 定位为「工业推荐系统可消费的一类新文本信号」。
2. Data Engine:问卷采集 + 离线清洗¶
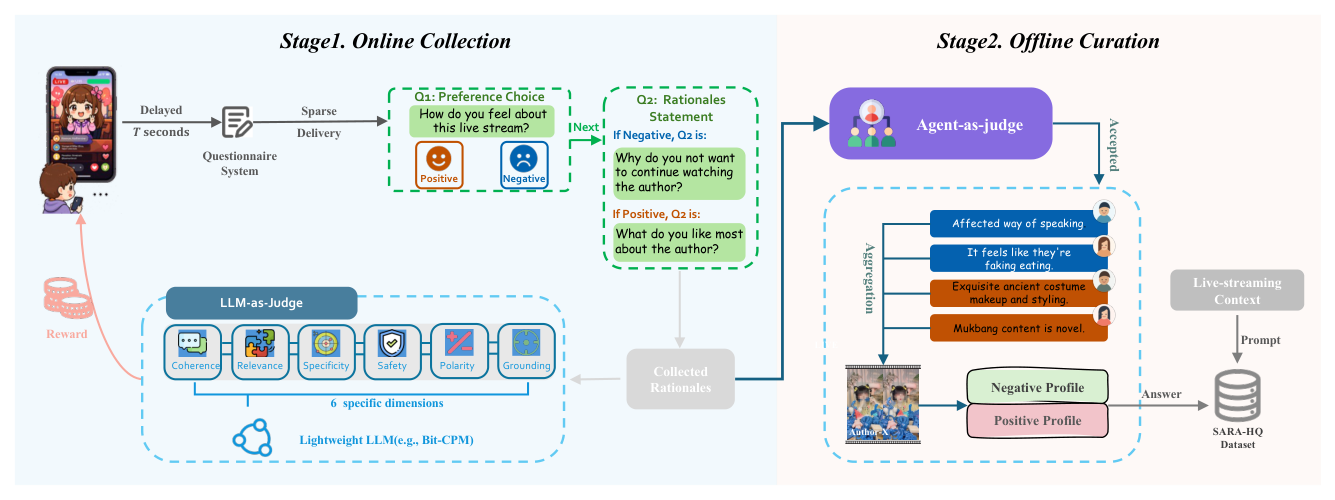
2.1 在线采集(Online Collection)¶
问卷系统在快手直播生态中无差别地对所有用户曝光,内容分两步:
- Preference Choice:根据当前直播上下文,用户在 Positive / Negative 之间选择极性;
- Articulated Rationales Statement:按所选极性动态追问开放题——选 Positive 问「你最喜欢这场直播的什么?」,选 Negative 问「你为什么对这场直播有负面感受?」。
为同时兼顾量与质,引入三项机制:
① 延迟触发机制(Delayed Triggering)。用户连续观看 $T$ 秒后才下发问卷。$T$ 太短,用户尚未形成稳定感知,回答随意;$T$ 太长,持负面态度的用户可能已离开,漏采负样本。工程折中取 $T = 10$ 秒。
② 稀疏投放机制(Sparse Questionnaire Delivery)。过于频繁的问卷会引发调查疲劳,降低作答意愿,疲劳状态下的回答边际价值也低。因此以小概率 $P$ 投放。基线概率经小流量 A/B 从 1%–20% 中选定为 5%,并按近期作答率动态调整:
$$P = \min\left(\max\left(p_0 \times \frac{r_{\text{obs}}}{r_{\text{target}}},\ p_{\min}\right),\ p_{\max}\right) \tag{1}$$
其中 $p_0 = 5\%$ 为基线概率,$r_{\text{obs}}$ 为过去 5 分钟滑窗内观测到的作答率,$r_{\text{target}} = 12\%$ 为目标作答率,$p_{\min} = 1\%$,$p_{\max} = 20\%$。含义:用户作答积极时提高曝光、作答意愿下降时收缩曝光,且被夹在合理区间内——采集集中在用户参与度高的时段,同时避免过度打扰。
③ 阈值式激励机制(Threshold-based Incentive)。部署一个轻量在线 LLM judge(如 BitCPM4-0.5B),对照可得的直播上下文实时评估每条回答,按 §4 的六维协议(coherence、relevance、specificity、safety、polarity consistency、grounding)打分,并在同一次推理中输出整体质量分 $\hat{G}_{\text{online}} \in \{1,2,3,4\}$。满足
$$\hat{G}_{\text{online}}(y) > 2 \tag{2}$$
的回答获得少量快币奖励。这种条件式正向奖励鼓励高质量反馈,实践中有效提升了作答意愿。
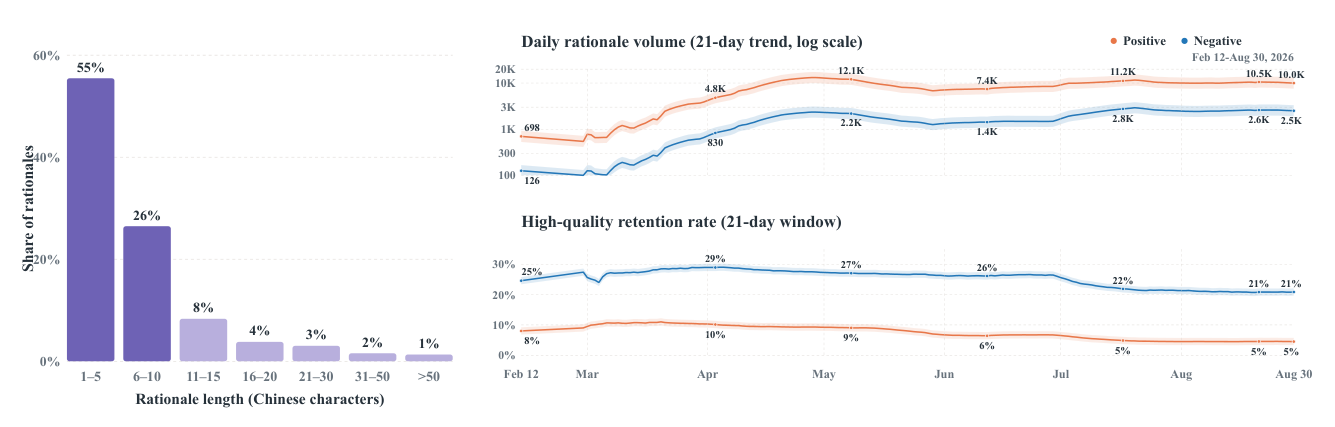
采集流水线上线后,在 2026-02-12 至 2026-08-30 的观察窗口内(185 个活跃日)共采集 1,915,718 条候选 AUR,日均约 10.4K 条。
2.2 采后清洗(Post Curation)¶
在线 judge 只用于实时发奖;离线质量过滤直接对原始回答跑更高保真的 Agent Judge,不使用在线分数作为过滤输入。六个 specialist 分别给维度分,Senior Reviewer 汇总出整体分 $\hat{G}_{\text{agent}}$;保留 $\hat{G}_{\text{agent}} > 2$ 的理由,并附加约束:relevance、safety、polarity consistency、grounding 任一出现关键缺陷,不能被其他维度的高分抵消。最终保留 187,532 条高质量理由,整体离线良率 9.8%。
从用户中心转向主播中心。由 187,532 条理由构造的 UA(user–author)矩阵为 141,461 × 86,564,极度稀疏且不对称:每个作答用户平均只贡献约 1.33 份问卷,而每个被覆盖主播平均收到约 2.17 位不同用户的回答。用户级覆盖不足以支撑可靠的用户级偏好理解;反之,把多个用户对同一主播的回答聚合,能揭示吸引或劝退观众的共性因素。因此按主播 × 极性分组,构造 86,564 个带极性的主播中心 profile。
原子语义标签归一化。单条回答通常很短(82% 不超过 10 个汉字),但往往表达了一个具体且自足的偏好因素,而不同用户常用口语或同义词描述同一因素。这种「语义原子性 + 表层形式多样」的组合非常适合标签化归一:把每个主播 × 极性下的理由转成原子语义标签,合并同义表达、去冗余,只保留被已验证回答支撑的标签。
训练实例构造。沿用 LiViBench 的多模态指令微调形式,但把目标从「合成 QA」改为「由真实问卷蒸馏出的偏好理由」。每个训练实例为 $(X_p, r_p)$:
$$X_p = (V,\ T_{\text{meta}},\ T_{\text{asr}},\ T_{\text{comment}},\ I_p) \tag{3}$$
$V$ 为采样的直播帧,$T_{\text{meta}}$、$T_{\text{asr}}$、$T_{\text{comment}}$ 分别为直播元数据、ASR 转写与观众评论;极性条件指令 $I_p$ 要求在 $p=+$ 时生成正理由、$p=-$ 时生成负理由。$r_p$ 是从对应高质量问卷回答蒸馏、归一化得到的目标答案。这 187,532 条带极性的实例构成最终的 SARA-HQ。
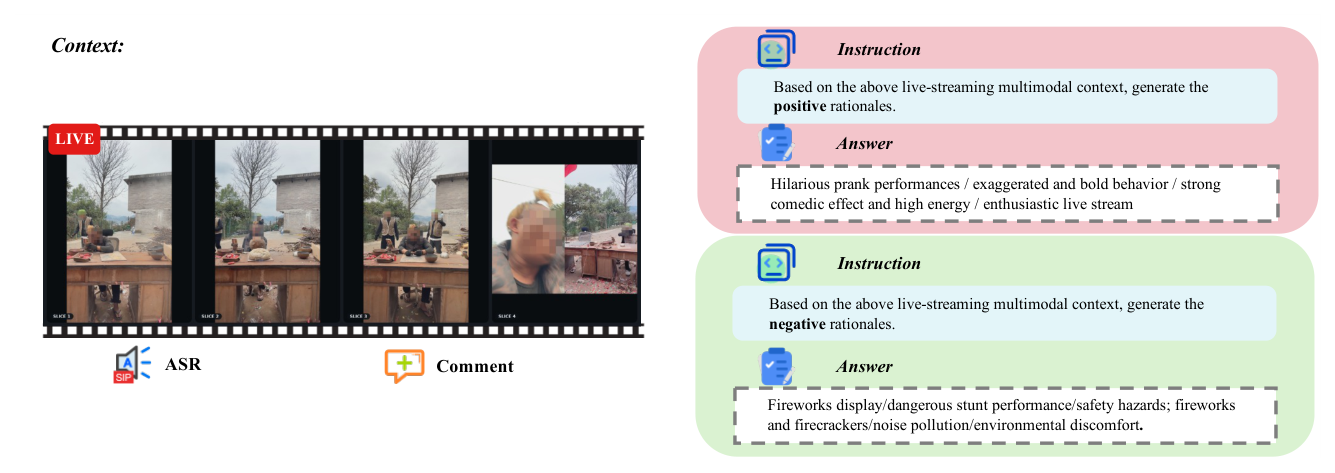
作者强调:同一个对齐好的直播上下文可支持可控的、按极性区分的理由生成,且问卷内容不会泄漏进上下文。
2.3 数据集统计¶
Table 1 数据引擎最新统计(HQ 指离线 Agent Judge 给出整体分 3–4 的回答):
| Stage / Subset | Candidate AURs | HQ AURs (Yield) | Role |
|---|---|---|---|
| Positive | 1,584,866 | 107,540 (6.8%) | 极性监督 |
| Negative | 330,852 | 79,992 (24.2%) | 极性监督 |
| All collected | 1,915,718 | 187,532 (9.8%) | 离线质量过滤 |
| Categorized HQ subset | – | 184,142 (98.2% of HQ) | 覆盖分析 |
| SARA-HQ | – | 187,532 | 最终训练监督 |
结论分析:
- 6,134 条用于长度分析的分段问卷理由里,82% 不超过 10 个汉字(中位数 5,均值 8.25)——单条 AUR 有信息但过于简短,不能单独作为稳定的主播描述,这直接支撑了「主播中心聚合 + 语义归一」的设计。
- 负向良率(24.2%)远高于正向(6.8%):负样本池更小、更聚焦于具体缺陷,因此更容易通过严格离线标准;大量正向反馈是泛泛的夸赞,在清洗中被剔除。这个观察本身有价值——「讨厌的理由」比「喜欢的理由」信息密度更高,与后文负理由路径的线上收益(Hate −8.16%)远大于正理由路径(观看时长 +0.99%)在方向上一致。
- 值得注意的是,正向 HQ 良率从 3 月约 10% 一路下滑到 8 月约 5%,负向从 29% 降到 21%——随着采集量放大,边际质量在下降,论文没有讨论这是激励机制被「刷」还是用户群体变宽。
Table 2 与公开直播数据集对比(节选关键列):
| Dataset | 出处 | 规模 | 监督来源 | Human | Preference | Polarity | Open-ended | Reason-level |
|---|---|---|---|---|---|---|---|---|
| LiveRec | RecSys'21 | 15.5M 用户、465K 主播、474.7M 交互 | 聊天共现日志 | ✓ | Implicit | ✗ | ✗ | ✗ |
| KuaiLive | SIGIR'26 | 23.8K 用户、452.6K 主播、5.36M 交互 | 多行为交互日志 | ✓ | Implicit | ✗ | ✗ | ✗ |
| KuaiLive-M3 | arXiv'26 | 21.9K 用户;35M 直播 + 111M 短视频交互;25.4K 问卷 | 多域行为 + 问卷 | ✓ | Explicit & implicit | ✓ | ✗ | ✗ |
| LiveCC | CVPR'25 | 5M 预训练片段、526K SFT 片段 | 时间对齐 CC/ASR | ✓ | – | ✗ | ✓ | ✗ |
| OmniStar | NeurIPS'25 | 20,137 条视频流 | 专家标注时序字幕与流式 QA | ✓ | – | ✗ | ✓ | ✗ |
| LiViBench | AAAI'26 | 3,168 视频、3,175 MCQ、49.1K 指令样本 | 模型出题 + 人工核验 | ✓ | – | ✗ | ✗ | ✗ |
| LiveLongBench | ACL Findings'26 | 967 条评测、每条约 97K tokens | 人工校正 ASR 上的 QA | ✓ | – | ✗ | ✓ | ✗ |
| SARA-HQ | Ours | 187.5K 质控理由、18 个一级域、141 个二级类 | Agent 评判的真实用户问卷 | ✓ | Explicit | ✓ | ✓ | ✓ |
作者的定位:推荐数据集有人类偏好证据但只以隐式行为表达(KuaiLive-M3 虽采了开放题 Q2,发布的 benchmark 只用 Q1 的类别标签);直播理解数据集语义丰富,但没有一个以用户偏好极性为条件、以「理由」为监督单元。SARA-HQ 占据了这个交集。但论文全文没有提到 SARA-HQ 是否会公开——表里标了「Ours」,却不是一个可复用的公共资源。
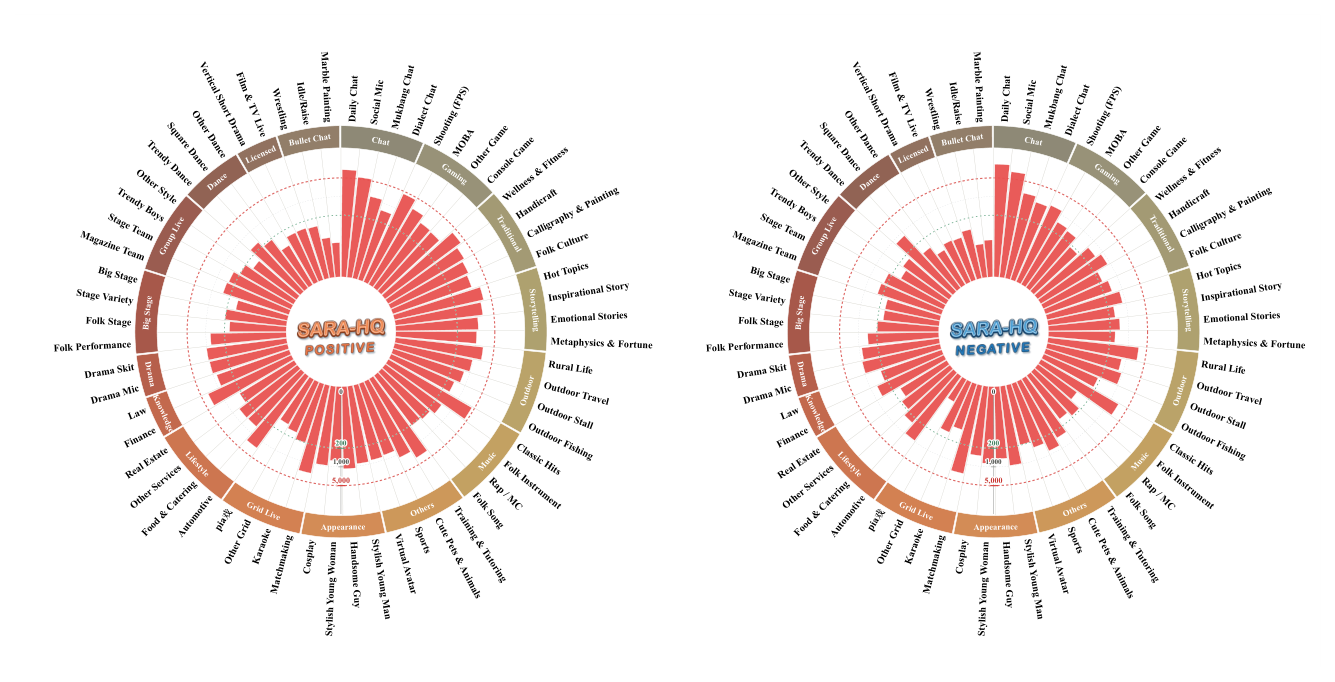
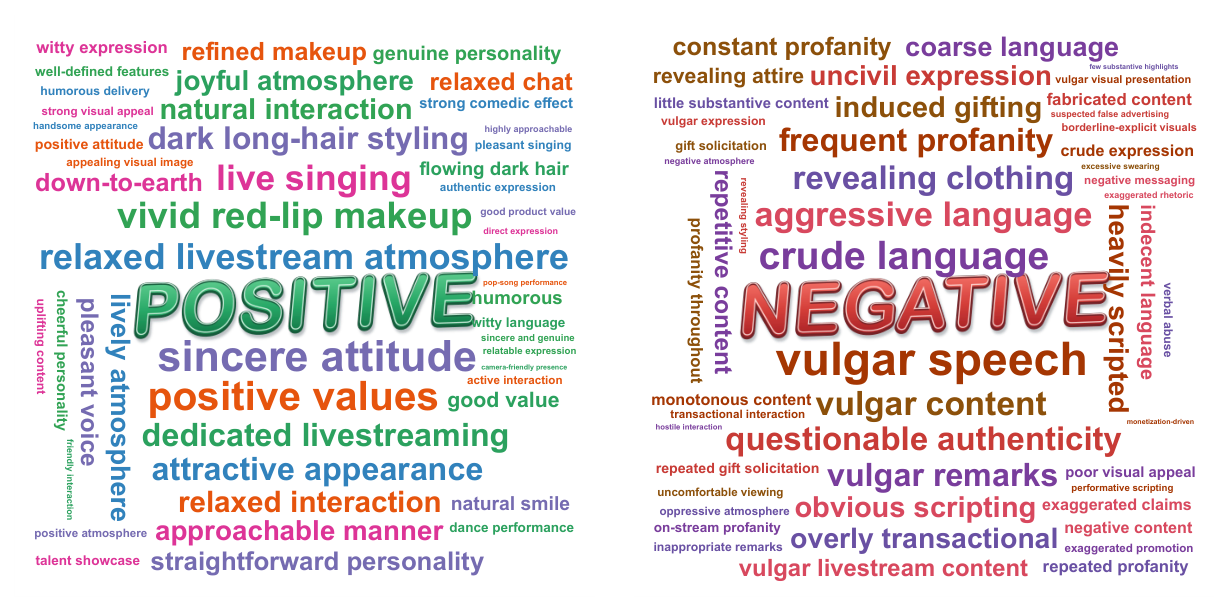
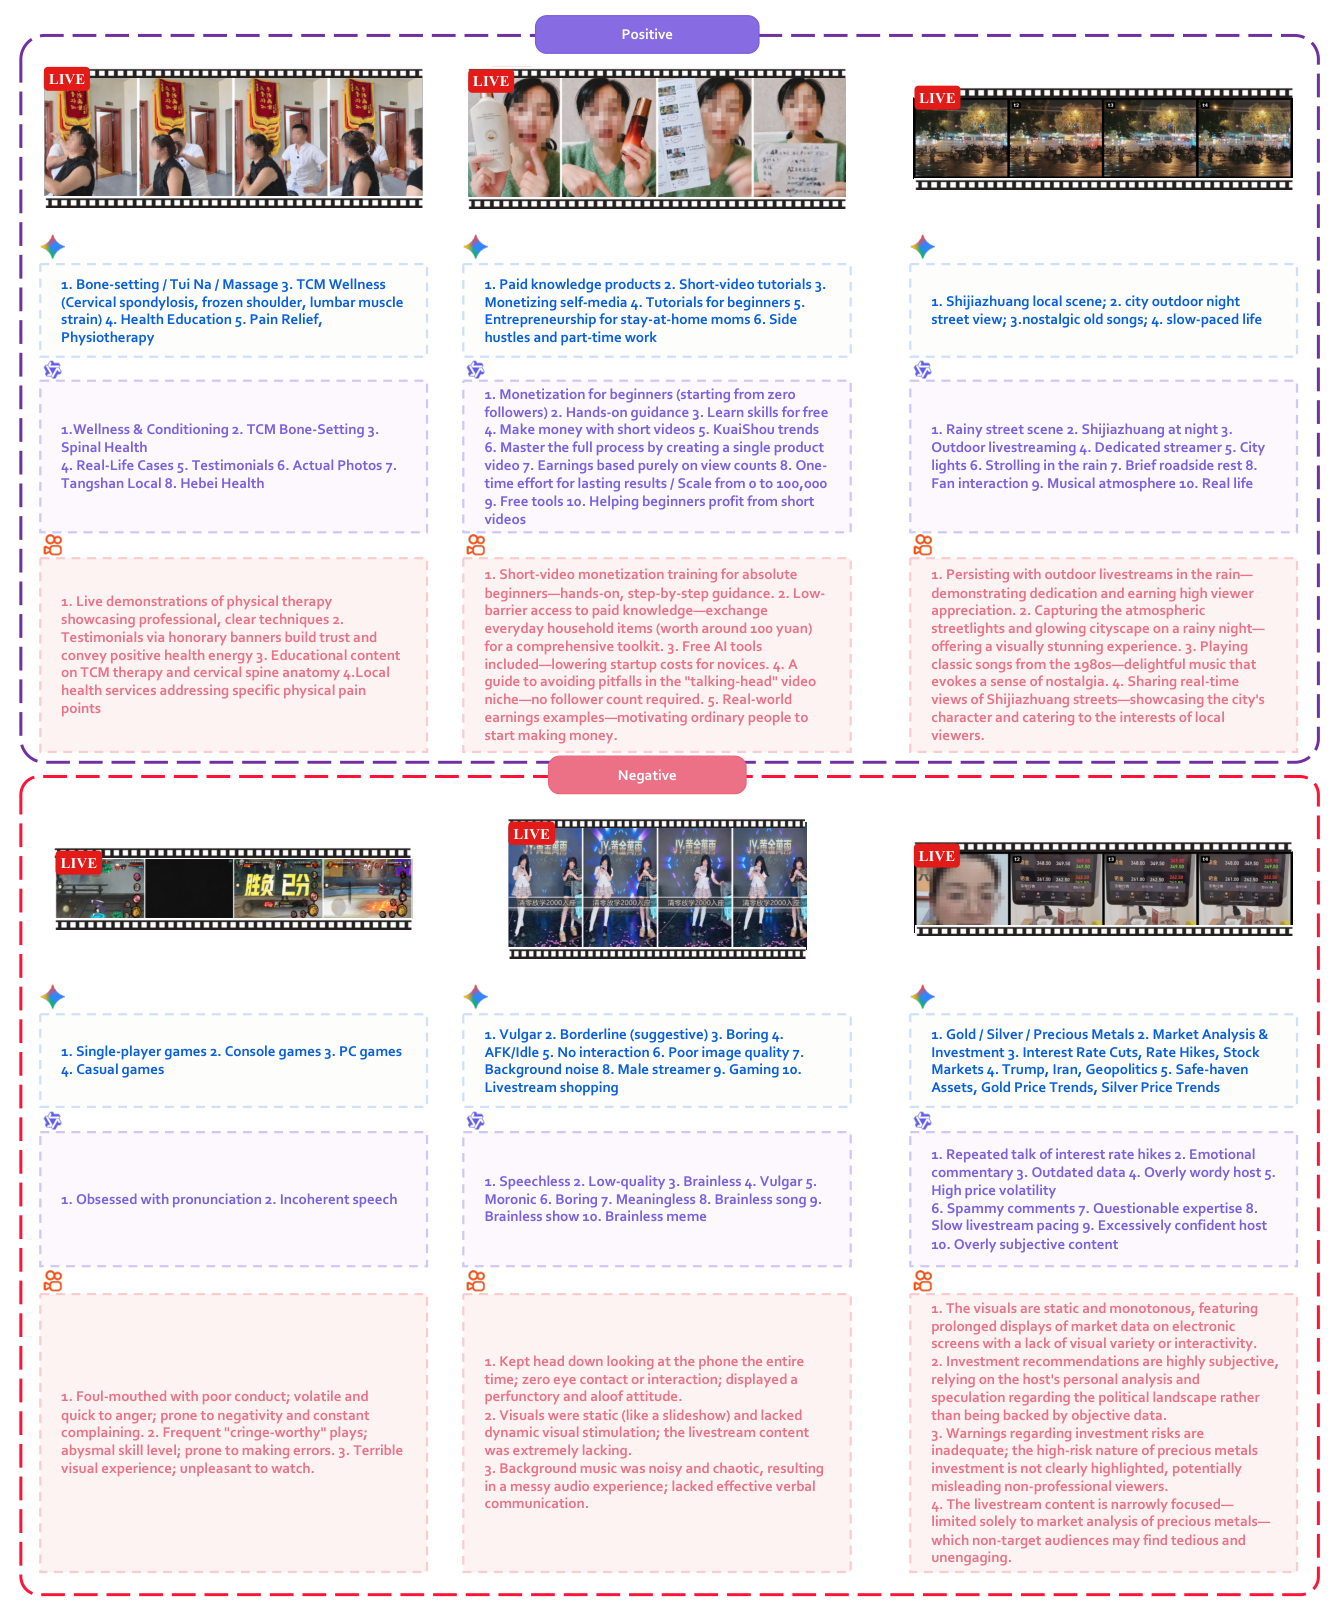
184,142 条理由获得有效语义类别,覆盖 18 个一级域、141 个二级类。图中展示的 60 个类别里,46 个正向类、37 个负向类超过 200 条,各有两个类别超过 5,000 条——严格过滤后长尾仍然显著。
3. Rationale-Oriented Alignment:SFT + QR-DPO¶
SARA-HQ 只覆盖 86,564 位主播,远少于全量直播主播。于是把通用 MLLM Qwen2.5-VL-7B 与 SARA-HQ 对齐,以便为全量主播生成理由。两阶段:大规模 SFT → Quality-Refining DPO,最终模型称 SARA-7B。
3.1 大规模 SFT¶
给定多模态上下文 $X = (V, T_{\text{meta}}, T_{\text{comment}}, T_{\text{asr}}, I)$($V$ 为直播视频,$T_{\text{meta}}$ 为标题与描述,$T_{\text{asr}}$ 为 ASR 转写,$T_{\text{comment}}$ 为评论流,$I$ 为指定极性 $p \in \{+,-\}$ 的任务指令),要求模型生成对应的正/负理由。把极性条件理由生成形式化为单轮条件生成,做全参数 SFT,使用标准自回归负对数似然:
$$\mathcal{L}_{\text{SFT}}(\theta) = -\frac{1}{N}\sum_{t=1}^{N} \log \pi_\theta(r_t \mid r_{<t}, X) \tag{4}$$
$N$ 为目标理由的长度,$r_t$ 为第 $t$ 个 token,$r_{<t} = (r_1, \dots, r_{t-1})$。
3.2 Quality-Refining DPO(QR-DPO)¶
受 self-improvement(STaR、V-STaR)启发,从 SFT 模型自身采样的回答中构造高/低质量偏好对做 DPO;该构造过程可以迭代,从前代模型逐步派生更好的模型。
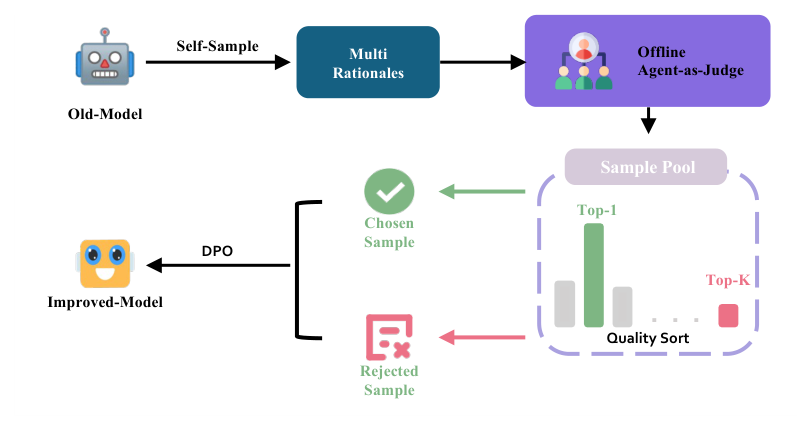
具体步骤:
- 从 SFT 训练集中采样 7K 个热门主播构造 QR-DPO 数据;
- 对每个训练实例 $X$,用 $\pi_{\text{SFT}}$ 在温度 $T$ 下采样 $K$ 条候选 $\{\hat{Y}^{(k)}\}_{k=1}^{K}$;
- 借鉴 agentic reward modeling,用 §4 的离线 Agent Judge 按六维 rubric 评估候选:各维度 specialist 对照多模态上下文与所问极性检查每条候选,Senior Reviewer 汇总分数与证据给出整体评价,得到排序 $\rho: \{1,\dots,K\} \to \{1,\dots,K\}$,$\rho(k)=1$ 为最优;
- 取 rank-1 为 chosen $y^+$、rank-$K$ 为 rejected $y^-$,得到 $\mathcal{D}_{\text{DPO}} = \{(X_i, y_i^+, y_i^-)\}_{i=1}^{N}$,$N = 7\text{K}$;
- 以 $\pi_{\text{SFT}}$ 初始化策略、同一 checkpoint 作为冻结参考策略,用标准 DPO 损失优化:
$$r_\theta(y \mid X) = \beta \log \frac{\pi_\theta(y \mid X)}{\pi_{\text{ref}}(y \mid X)} \tag{5a}$$
$$\mathcal{L}_{\text{DPO}}(\theta) = -\mathbb{E}_{(X, y^+, y^-) \sim \mathcal{D}_{\text{DPO}}} \log \sigma\left(r_\theta(y^+ \mid X) - r_\theta(y^- \mid X)\right) \tag{5b}$$
$\pi_\theta(y \mid X)$ 为当前模型对候选 $y$ 的概率,$\pi_{\text{ref}} = \pi_{\text{SFT}}$;$\beta$ 控制偏好优化强度;$r_\theta(y^+|X)$、$r_\theta(y^-|X)$ 分别是 chosen / rejected 相对参考模型的对数概率比;sigmoid 促使模型提高最优候选、压低最差候选的概率,把概率质量推向高质量区域。
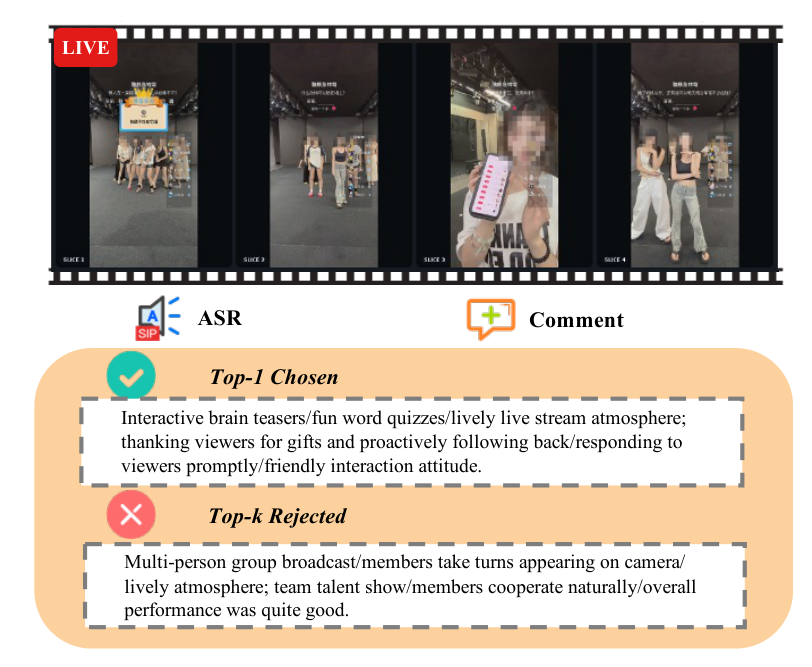
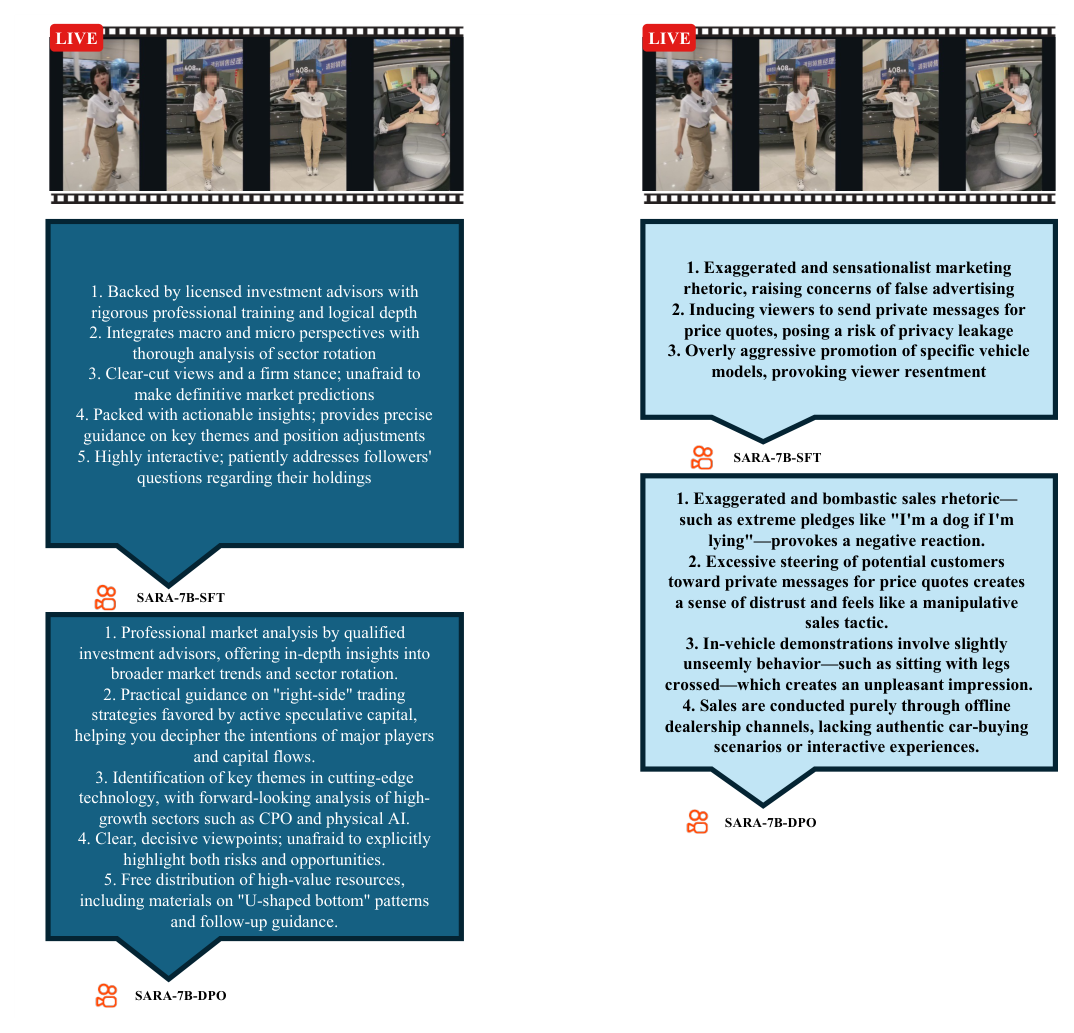
两条候选都对直播内容给出了貌似合理的理由,但 chosen 把脑筋急转弯活动与观众反应连到「感知到的乐趣与真诚」上,识别出更具体的偏好因素;rejected 更像是对内容的泛化描述。这种相对优势提供了超越 SFT 基线质量的细粒度偏好信号。
方法评注:QR-DPO 本质是「self-sample + 外部 judge 选 best/worst + 标准 DPO」,即 RLAIF 式的 best-of-K 偏好构造,是 2024 年以来 LLM 对齐里的常规做法。论文说它「可迭代」,但实验里只跑了一轮,没有迭代的证据。
4. Rationale Quality Evaluation Framework:同一套 rubric 的两种算力形态¶
4.1 统一的六维 + 整体分协议¶
质量评估贯穿 SARA 全流程:在线采集要判断是否发奖,离线清洗要剔除噪声 AUR,QR-DPO 要构造可靠的偏好对,最终评测要在一致标准下比较生成理由。作者因此建立统一的、以人工为锚的评估协议:对候选理由 $y$,以直播上下文 $X$ 和所问极性 $p$ 为条件,评估六个维度——coherence、relevance、specificity、safety、polarity consistency、grounding。每维四级:4 excellent、3 acceptable、2 deficient、1 poor;另给整体分 $G \in \{1,2,3,4\}$。
关键设计:整体分不是维度分的算术平均,维度之间不可补偿——语言质量再高也不能抵消不相关、极性相反、无依据的实质性断言或安全违规。
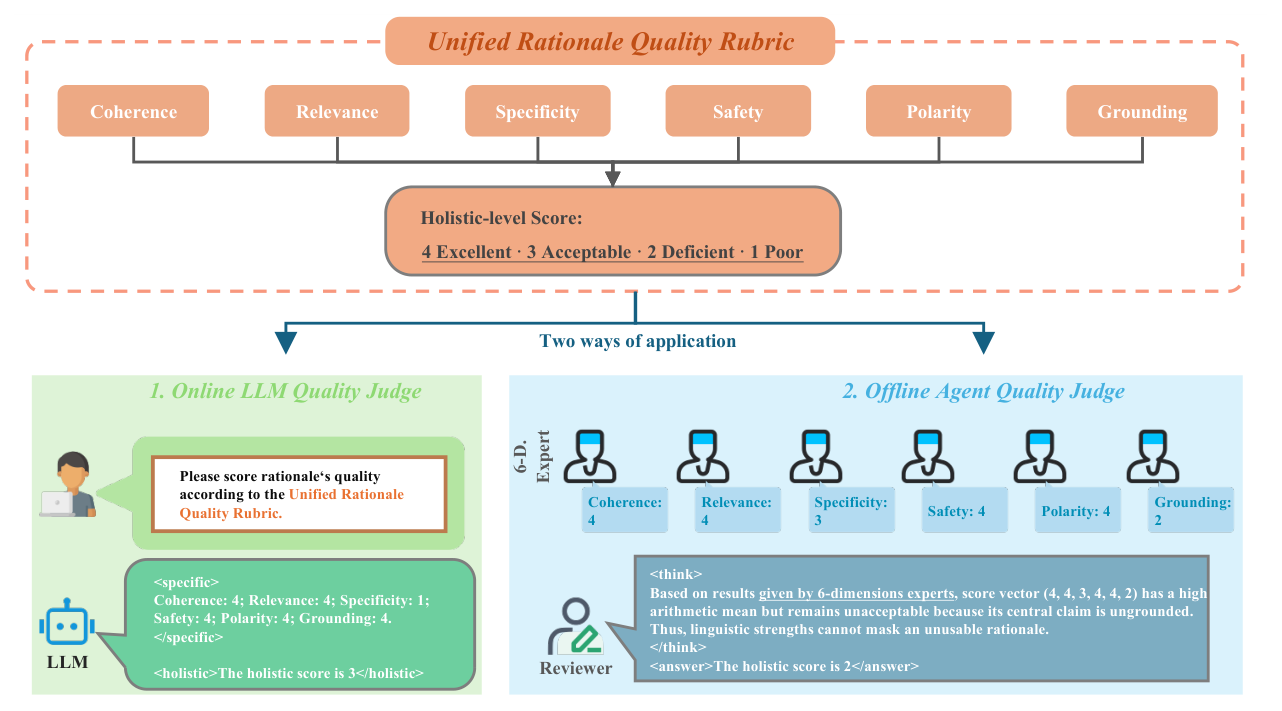
4.2 在线 LLM judge 与离线 Agent Judge¶
低延迟在线 judge:给定 $(X, p, y)$,一次前向同时预测六维分数与整体分:
$$(\hat{q}, \hat{G}) = J_{\text{online}}(X, p, y) \tag{6}$$
部署时当 $\hat{G} > 2$ 直接触发奖励。
维度专家(Dimension-specialized evaluators):单次评估须同时关注异构标准,容易让「流畅」这类整体印象影响「grounding」这类无关判断。因此每个维度 $d$ 实例化一个专门的评估器 $E_d$:
$$(q_d, e_d) = E_d(X, p, y; d) \tag{7}$$
$q_d$ 为四级分数,$e_d$ 为简要证据报告。
Senior Review:接收 specialist 报告 $S(y) = \{(q_d, e_d)\}_{d=1}^{6}$,输出整体分:
$$G = R(S(y)) \tag{8}$$
Reviewer 不是平均器,先在硬维度集合 $\mathcal{D}_{\text{hard}}$(relevance、safety、polarity consistency、grounding)上做关键缺陷检测:
$$\exists\, d \in \mathcal{D}_{\text{hard}},\ q_d \le 2 \ \Longrightarrow\ G \le 2 \tag{9}$$
只有无关键缺陷的候选才进一步区分 acceptable(3)与 excellent(4)。例如 $(4,4,4,4,4,1)$ 均值很高,但核心断言无依据,仍不可用。
4.3 Judge 语料与评估器训练¶
作者认为仅靠通用 LLM 无法可靠实例化上述两种评估器——它们未针对偏好理由校准,可能过度奖励流畅度而忽视直播特定上下文、所问极性或无依据断言。因此把 rubric 转成领域人工监督:
- 语料来源:生产日志中的原生 AUR、不同模型与训练 checkpoint 生成的理由、以及受控失败样本(针对上下文错配、极性反转、泛泛内容描述、注入无依据细节这四类缺陷刻意构造或改写);受控失败只作为候选困难样本,由领域专家核验并标注所有受影响维度,不把自动构造的标签当真值;
- 标注:对每个 $(X,p,y)$,专家给出六维分数 $q^* = (q_1^*, \dots, q_6^*)$ 与整体分 $G^*$;需上下文核验的维度,标注者还要从视频、ASR、元数据、评论中找出支撑或反驳证据;
- 防泄漏:按主播与直播上下文切分(在候选生成与增强之前切分),隐藏候选来源身份以减少来源偏差。
训练:在线 LLM 直接学习完整维度分向量与整体分:
$$\mathcal{L}_{\text{online}} = \mathcal{L}_{\text{dim}} + \mathcal{L}_{\text{holistic}} \tag{10}$$
每个 specialist 分别在其负责维度的人工分数与上下文证据上训练;Senior Reviewer 在人工维度报告集合 $\{(q_d^*, e_d^*)\}_{d=1}^{6}$ 与对应专家整体分 $G^*$ 上训练,学习人类评审如何把维度证据聚合为整体分;推理时把人工报告替换为 specialist 产出的同结构报告。
4.4 评估器验证¶
领域专家独立标注一个 held-out、主播不相交的测试集(含自然分布的回答和带孤立关键缺陷的困难样本)。用 MAE 统一评估:
$$\mathrm{MAE} = \frac{1}{N}\sum_{i=1}^{N} |\hat{s}_i - s_i^*| \tag{11}$$
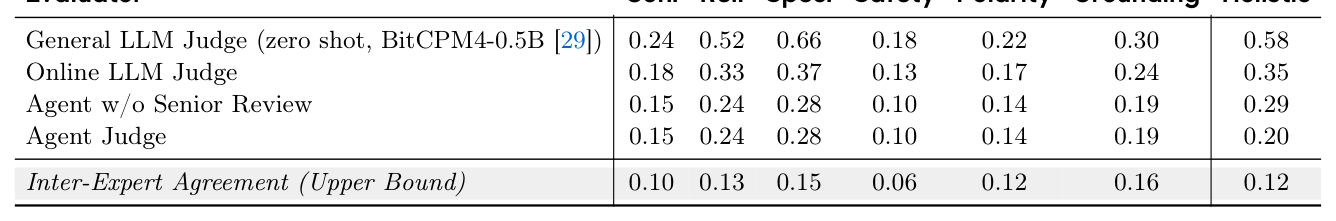
Table 3 评估器与专家标注的一致性(MAE ↓):
| Evaluator | Coh. | Rel. | Spec. | Safety | Polarity | Grounding | Holistic |
|---|---|---|---|---|---|---|---|
| General LLM Judge(zero-shot,BitCPM4-0.5B) | 0.24 | 0.52 | 0.66 | 0.18 | 0.22 | 0.30 | 0.58 |
| Online LLM Judge | 0.18 | 0.33 | 0.37 | 0.13 | 0.17 | 0.24 | 0.35 |
| Agent w/o Senior Review | 0.15 | 0.24 | 0.28 | 0.10 | 0.14 | 0.19 | 0.29 |
| Agent Judge | 0.15 | 0.24 | 0.28 | 0.10 | 0.14 | 0.19 | 0.20 |
| Inter-Expert Agreement(上界) | 0.10 | 0.13 | 0.15 | 0.06 | 0.12 | 0.16 | 0.12 |
结论分析:
- 零样本通用 judge 在 coherence、safety、polarity、grounding 上误差已不高,但在 specificity(0.66)与 relevance(0.52) 这两个领域敏感维度上与专家分歧大。在 judge 语料上训练后,整体 MAE 0.58 → 0.35,降幅主要集中在这两个维度——说明领域监督主要改善的是 rubric 校准。
- 分维度 specialist 进一步把整体 MAE 降到 0.29,且六个维度都有改善;在同样的 specialist 预测上加 Senior Review,整体 MAE 0.29 → 0.20,逼近专家间一致性 0.12。
- 这是全文最扎实的一组实证:它有独立人工真值、主播不相交、专家间一致性作上界。「Agent w/o Senior Review」与「Agent Judge」维度列完全相同是合理的(同一组 specialist),差异只在整体分的聚合方式——这个消融是干净的。
- 但要注意:在线 judge 的整体 MAE 仍有 0.35,而它决定是否发快币奖励——作者没有报告奖励误发/漏发率,也没有讨论奖励机制是否会诱导用户「写给 judge 看」的回答。
5. Rationale-as-Feature Integration:SARA-Ranker¶
用 SARA-7B 为主播生成正/负的主播中心理由作为推荐特征,补充行为信号与内容描述。作者聚焦判别式排序,把理由特征接入其排序模型 SARA-Ranker,探索两条互补的集成路径:
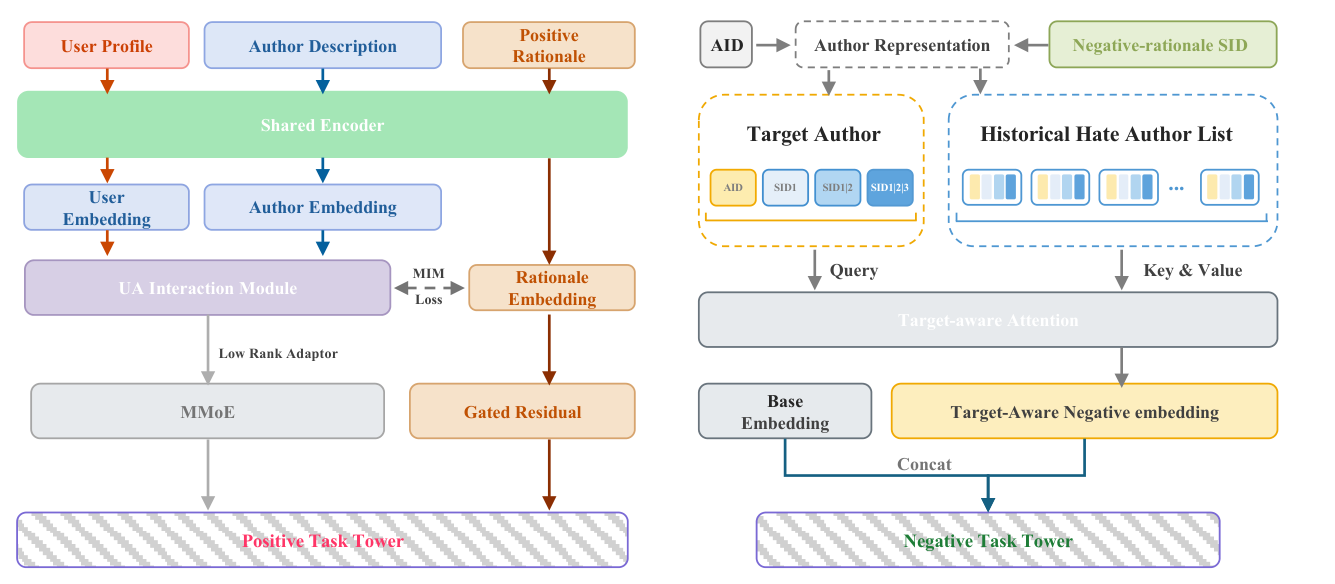
5.1 正理由:Rationale Embedding Integration¶
超越主播侧特征的个性化。沿用 SARM,把 token 化的主播语义接入排序模型。但单靠这一机制解决不了「主播侧内容描述」与「用户-主播偏好」之间的错配:两个都被描述为「颜值主播聊天」的主播,实际可能一个是古风歌舞、一个是高能斗舞;同一个主播也可能因表演、陪伴或互动吸引不同用户。UA 交互能捕捉「谁常看谁」,却捕捉不到偏好背后说出来的理由。
作者把 SARA-7B 为主播 $a$ 生成的正理由记为 $R_a^+$。注意:它是由主播多模态上下文 + 极性生成的,输入里没有特定用户,因此被该主播的所有观众共享。目标是把这一主播侧理由作为显式语义监督,去约束一个以用户为条件的 UA 交互表示。
Ranking-Aware Embedding Construction。沿用 SARM 的 ranking-aware 编码,在排序模型内部使用可训练 token embedding:把用户画像 $P_u$、MLLM 导出的主播描述 $D_a$、正理由 $R_a^+$ 分别 token 化;每路特征有独立的可训练稀疏查找表 $E_x$(64 维)。令 $X_u = P_u$,$X_a = D_a$,$X_r = R_a^+$:
$$(H_x,\ h_x^{\text{cls}}) = B_{\text{shared}}\left(E_x[\mathrm{Tok}(X_x)]\right),\quad x \in \{u, a, r\} \tag{12}$$
用户、主播、理由序列长度分别为 120、70、64 个 token。共享编码器为 4 层、hidden 64、每层 1 个注意力头、FFN 维度 64,输出上下文 token 状态 $H_x$ 与 CLS 表示 $h_x^{\text{cls}}$;对用户与主播 token 状态另做 mean pooling。稀疏查找表与共享编码器在排序模型内联合训练,由排序监督塑造表示。
Rationale-Guided UA Interaction。用双向 cross-attention 从 $P_u$ 与 $D_a$ 构造用户条件化的 UA 表示。残差 cross-attention 定义为
$$\mathrm{CA}(q, H) = \mathrm{MHA}(q, H, H) + q \tag{13}$$
两个方向的输出相加得到融合 UA 表示:
$$c_{u,a} = \mathrm{CA}(h_u^{\text{cls}}, H_a) + \mathrm{CA}(h_a^{\text{cls}}, H_u) \tag{14}$$
每个方向一层单头注意力:用户 CLS 关注主播 token,主播 CLS 关注用户画像 token。
仅用隐式行为反馈训练时,cross-attention 并不会显式约束 $c_{u,a}$ 编码「观看理由」。因此把正理由作为 $c_{u,a}$ 的语义锚点:对 UA 表示和理由 CLS 分别做线性投影 + $\ell_2$ 归一化,得到 batch 表示 $Z_{ua}$ 与 $Z_r$。令 $\rho(\cdot)$ 为逐行 softmax,$\tau = 0.07$:
$$S = Z_{ua} Z_r^\top / \tau,\qquad Q = \rho\left(Z_r Z_r^\top / \tau\right) \tag{15}$$
$S$ 是 UA–理由匹配 logits,$Q$ 是由理由之间相似度导出的软目标。受互信息最大化(MIM)启发,用对称软对比目标对齐:
$$\mathcal{L}_{\text{MIM}} = \frac{1}{2}\left(\mathrm{CE}(Q, \rho(S)) + \mathrm{CE}(Q, \rho(S^\top))\right) \tag{16}$$
与排序目标联合:
$$\mathcal{L} = \mathcal{L}_{\text{rank}} + \lambda_{\text{MIM}} \mathcal{L}_{\text{MIM}} \tag{17}$$
设计动机:与 one-hot 对比目标不同,软目标考虑了 batch 内理由之间的相似性,使语义相近的观看理由获得非零目标权重,而不是把每个非对角对都当负样本——这对「同一类型主播的理由高度相似」的直播场景是合理的,避免把同质主播强行推开。
最后,学到的 UA 表示与用户、主播、理由特征融合后送入 MMoE;另有一条门控残差把理由特征绕过 MMoE 直接送往任务塔。
结构评注:这里有一个细微但重要的点——$R_a^+$ 是主播侧、与用户无关的,每个主播只有一份。所以 MIM 实际做的是把「用户 × 主播」交互表示拉向「该主播的理由表示」,监督信号本质上是主播粒度的,并不包含「这个用户为什么喜欢」的个体信息。论文在 §5.3 对负理由明确写了「不把 $R_a^-$ 当作个体用户的具体拒绝原因」,但对正理由路径没有同等的自我界定。
5.2 负理由:Rationale SID Integration¶
层级 SID 构造。沿用 LARM 与 QARM,用 BGE 编码 $R_a$,做三级残差量化。设 $c_{l,k}$ 为第 $l$ 级第 $k$ 个码字,索引取自 $[K_l] = \{0,\dots,K_l - 1\}$。计算 $e_a = E_{\text{BGE}}(R_a)$,初始化 $r_{a,0} = e_a$,每级 $l = 0,1,2$ 选最近码字并更新残差:
$$s_{a,l} = \arg\min_{k \in [K_l]} \|r_{a,l} - c_{l,k}\|_2^2 \tag{18}$$
$$r_{a,l+1} = r_{a,l} - c_{l, s_{a,l}} \tag{19}$$
得到 $\mathrm{SID}(a) = (s_{a,0}, s_{a,1}, s_{a,2})$。三级使用相同码本大小 $K$。由于每级残差码只表示增量细化,而非前面各级累积的信息,构造累积前缀 ID(省略主播下标):
$$p_0 = s_0,\qquad p_1 = K s_0 + s_1,\qquad p_2 = K^2 s_0 + K s_1 + s_2 \tag{20}$$
这些 base-$K$ 编码在各自特征空间里唯一索引一级码、两级前缀、完整三级路径,每个前缀 ID 对应一个可训练 embedding。
跨主播迁移负向语义。Hate 指用户在直播上点击「不喜欢」按钮的显式负反馈。它识别出被拒的主播,却不说明原因。基于主播 ID 的历史能帮模型记住已拒主播,但主播 ID 本身不表达语义关系,无法把反馈迁移到未见过的候选上——例如一个用户可能因「强行带货」拒绝一场直播、因「危险行为」拒绝另一场,同一个二值标签区分不了这两种顾虑。
做法:给用户 Hate 历史里的每个主播挂上其负理由 SID。行为识别被拒的主播,SID 表达与该主播相关的负面理由语义。通过共享码本,被分配到相同 SID 或前缀的主播共享可训练 embedding,使对已拒主播的反馈能影响具有相关负面语义的候选(包括用户从未见过的)。作者明确界定:这一机制跨主播迁移问卷导出的负面语义,但不把 $R_a^-$ 当作某个用户表达的具体拒绝原因。
基于 SID 的偏好建模。把主播 ID embedding 与三个可训练 SID embedding 拼接(此处前缀由负理由 $R_a^-$ 构造):
$$x_a = E_{\text{aid}}[a] \,\|\, E_0[p_{a,0}] \,\|\, E_1[p_{a,1}] \,\|\, E_2[p_{a,2}] \tag{21}$$
对用户 $u$,令 $H_u^- = (a_{u,1}^-, \dots, a_{u,T}^-)$ 为按时间排序的 Hate 主播历史,$X_u^- = [x_{a_{u,1}^-}, \dots, x_{a_{u,T}^-}]$ 为对应表示。以目标主播表示为 query、历史主播表示为 key/value:
$$h_{u,a}^- = \mathrm{MHA}\left(x_a,\ X_u^-,\ X_u^-\right) \tag{22}$$
与均匀 pooling 不同,target attention 让不同候选关注同一历史的不同部分——「强行带货」类候选与「危险行为」类候选会关注不同的已拒主播子集。
把该表示接入负反馈任务塔。令 $b_{u,a}$ 为该塔原输入:
$$\hat{y}^{\text{Htr}}_{u,a} = f_{\text{Htr}}\left(b_{u,a} \,\|\, h_{u,a}^-\right) \tag{23}$$
作者总结:主播专属记忆 + 跨主播参数共享 + target-aware 聚合,使排序模型在预测负反馈时能考虑候选主播与已拒主播之间的语义关系。
结构评注:公式 (23) 表明 $h^-_{u,a}$ 是新拼进负反馈塔的输入,$b_{u,a}$ 是「原输入」。论文用「Compared with an author-ID-only history」作对照论述,但没有说明 base 模型是否已有 AID-only 的 Hate 历史 target attention。如果 base 本来没有这条历史建模分支,那么线上 −8.16% 同时包含了「引入 Hate 历史 target attention」与「在历史上挂 SID」两个因素,且没有实验把它们分开。
6. 实验设置¶
6.1 SARA-7B 评测设置¶
- 评测集:从更晚的生产日志中构造 5K 实例,与 SFT、DPO 训练主播不相交,极性均衡、类别均衡,并按主播热度分层,避免记忆与头部类别偏置;每个模型接收同样的多模态主播上下文与极性指令,要求生成简洁的用户视角理由。
- Baseline:闭源 Gemini-3.1-Pro、开源 Qwen3-VL-8B;另报告全量数据 SFT checkpoint 及其 QR-DPO 版本,以分离偏好精炼的贡献。
- 指标:冻结的离线 Agent Judge(参数与 rubric 在所有 checkpoint 与 baseline 间固定)给出的六维分 + 整体分(原始 1–4 量表的实例平均);以及与配对原始问卷回答的 BGE 语义相似度:
$$\text{BGE-Sim} = \frac{1}{N}\sum_{i=1}^{N} \frac{f_{\text{BGE}}(y_i)^\top f_{\text{BGE}}(r_i)}{\|f_{\text{BGE}}(y_i)\|_2\, \|f_{\text{BGE}}(r_i)\|_2} \tag{24}$$
$y_i$ 为生成理由,$r_i$ 为原始问卷回答,$f_{\text{BGE}}$ 为冻结 BGE 文本编码器(版本与 pooling 策略对所有系统固定)。BGE-Sim 作为补充的忠实度度量,而非 rubric 的替代。
6.2 SARA-Ranker 设置¶
- 数据:快手「精选直播」平台真实数据,30 秒滑窗采样;沿用生产流水线,最后一天日志为测试集,其余为训练;按日刷新的 AUR 覆盖评测窗口内推荐系统中的主播。
- Base:工业 MMoE 多任务系统,已集成 SARM(即已有 MLLM 导出的主播描述 token 等完整多模态栈),所有实验默认以此为基线。
- 离线指标:正向参与头(Click、Long-view、Gift)与负反馈头(Hate、Report)上的 AUC / GAUC,报告绝对 pp 增量。
- 线上:两条路径均部署到生产直播排序,分别以 1% 真实流量做独立 A/B;在原有延迟预算内服务,支持按日更新,全量运行超过 30 天。
未披露的关键超参:SFT 的学习率/epoch/batch、DPO 的 $\beta$ 与 $K$、采样温度 $T$、$\lambda_{\text{MIM}}$、SID 码本大小 $K$(Table 5 给了 $(8192)^3$ 的对比,但未明确线上用哪个)、A/B 时长与置信区间——全部缺失。
7. 主要实验结果¶
7.1 SARA-7B 理由生成质量¶
Table 4 5K 主播不相交评测集上的理由生成质量(越高越好):
| Category | Model | Coh. | Rel. | Spec. | Safety | Pol. | Ground. | Holistic | BGE-Sim |
|---|---|---|---|---|---|---|---|---|---|
| Closed-source | Gemini 3.1 Pro | 3.97 | 3.70 | 2.92 | 4.00 | 3.97 | 3.60 | 2.51 | 0.70 |
| Open-source | Qwen3-VL-8B | 3.92 | 3.51 | 2.67 | 3.98 | 3.98 | 3.73 | 2.37 | 0.69 |
| Ours | SARA-7B-SFT | 3.99 | 3.99 | 3.07 | 4.00 | 4.00 | 3.63 | 3.15 | 0.82 |
| Ours | SARA-7B-DPO | 4.00 | 3.99 | 3.32 | 4.00 | 4.00 | 3.75 | 3.33 | 0.82 |
结论分析:
- coherence、safety、polarity 三维所有模型都接近满分,区分度几乎为零;差异集中在 relevance、specificity、grounding 与整体分。
- SFT 相对通用 MLLM 提升 relevance(3.70 → 3.99)、整体分(2.51 → 3.15)与 BGE-Sim(0.70 → 0.82),作者据此论证「articulated-preference 监督的价值」。
- QR-DPO 在 SFT 基础上把 specificity 3.07 → 3.32、grounding 3.63 → 3.75、整体 3.15 → 3.33,BGE-Sim 维持 0.82。
- 批判性解读:
- 评估器与优化目标同源。同一个 Agent Judge 既用于筛选 SFT 训练数据($\hat{G}_{\text{agent}} > 2$),又用于为 DPO 选 chosen/rejected,最后还用于 Table 4 的评测。DPO 的 +0.18 整体分是在它被直接优化的那个评分器上测得的——这是 judge 循环。尽管该 judge 有独立人工验证(MAE 0.20),其误差仍与 DPO 带来的增量(0.18)同量级。
- 唯一独立于 judge 的指标 BGE-Sim,DPO 前后完全不变(0.82 → 0.82)。也就是说,在不受 judge 影响的度量上,QR-DPO 没有带来可见收益。
- SFT 相对 Gemini/Qwen3-VL 的 BGE-Sim 优势(0.82 vs 0.70)部分来自风格/格式对齐:SFT 目标就是问卷回答归一化后的短标签串,与参考文本同分布;零样本通用模型输出的是长段描述,余弦自然更低。更可疑的是 Figure 12 中 SFT 数据比例为 0 的起点,BGE-Sim 约 0.795,远高于 Table 4 里两个通用 MLLM 的 0.69–0.70——若该起点是未微调的 Qwen2.5-VL-7B,则 SFT 带来的 BGE-Sim 真实增量只有约 0.03,Table 4 中 0.12 的差距大部分是 baseline 的 prompt/输出格式差异造成的。论文没有说明这个 0 点的具体配置。
7.2 SFT 数据规模效应¶
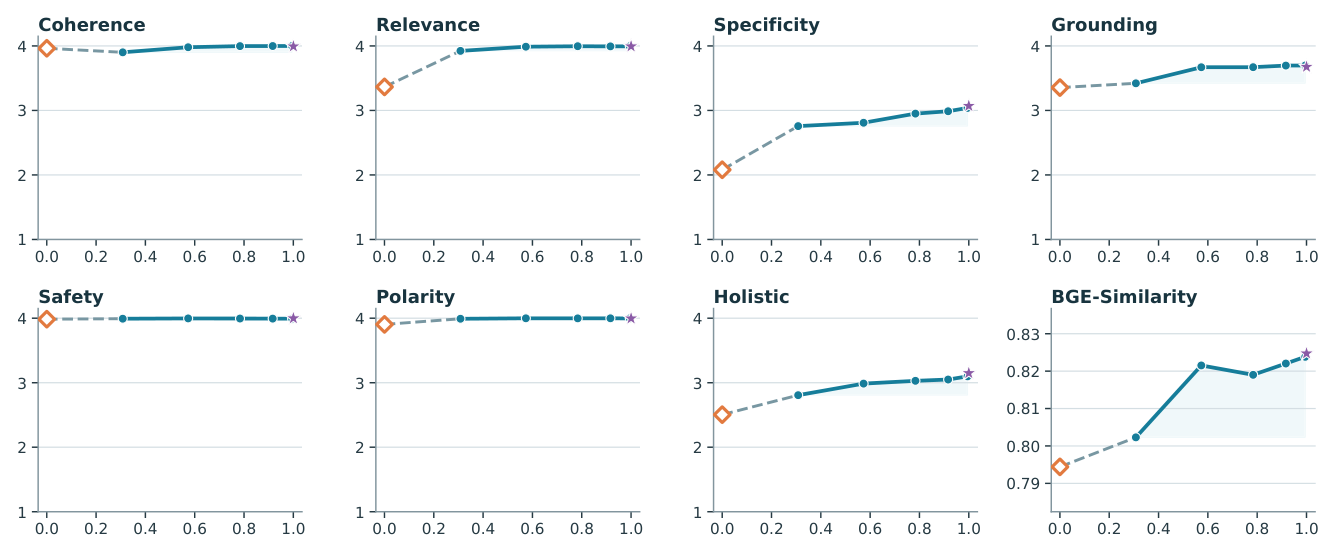
作者结论:coherence、safety、polarity 早早饱和,而 relevance、specificity、grounding 与整体质量随监督量持续提升——语言能力与指令遵循基本继承自预训练 MLLM,而学习细粒度、有依据的偏好因素需要大量领域监督;主播不相交评测上的一致提升说明扩大 SARA-HQ 能增强对未见主播的泛化;边际收益递减但未完全饱和。
这是本文唯一的「scaling」实验:它是一条 6 点的曲线(不是两点),但:(a) 只扫了 SFT 数据量这一个轴,模型只有 7B 一个尺寸,没有模型规模 scaling;(b) 纵轴全部是同一 Agent Judge 分数(外加 BGE-Sim),没有任何一个点把理由质量与下游排序收益挂钩——「理由更好 → 排序更好」这条因果链在全文中没有被验证;(c) specificity、holistic 曲线在 0.3 之后基本线性缓升,整体增量(holistic 从 0.3 处约 2.8 到 1.0 处 3.15)约 0.35 分。标题中的「Scaling」更准确的含义是覆盖率扩展(86,564 → 1000 万主播),而不是 scaling law 意义上的扩展。
7.3 QR-DPO 训练过程¶
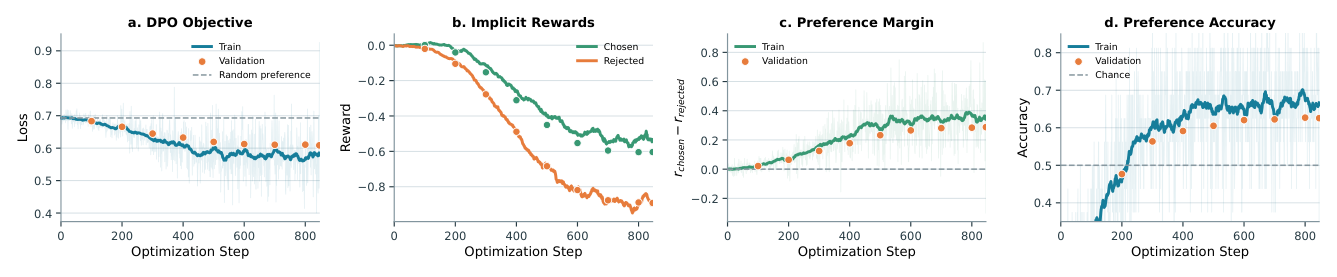
作者称 QR-DPO 稳定收敛、margin 增大、训练与验证准确率持续高于随机,说明学到的是可泛化的偏好。补充观察:(b) 中 chosen 的隐式奖励也在下降(约 −0.55),是 DPO 常见的「两者一起压低、rejected 压得更多」现象;验证集偏好准确率只有约 0.62,说明 judge 给出的 top-1/top-K 区分对模型而言并不容易学,与 Table 4 中 DPO 仅 +0.18 整体分的温和增量一致。
7.4 SID 码本分析¶
Table 5 不同语义输入、量化器与码本大小下的码字利用率(UR ↑)与碰撞率(CR ↓)(† 为引自 OneLive 的结果;OneLive IA embedding 含主播身份与协同交互监督,作为参考上界而非严格受控 baseline;R.-K. = Res-Kmeans,R.-V. = RQ-VAE):
| Type | Input | Quantizer | Size | UR L0 | UR L1 | UR L2 | UR L0×L1 | CR SID | CR Author |
|---|---|---|---|---|---|---|---|---|---|
| Semantic | OneLive MLLM† | R.-K. | $(512)^3$ | 100.0% | 99.6% | 97.7% | 53.8% | 28.1% | 63.8% |
| Semantic | OneLive MLLM† | R.-K. | $(8192)^3$ | 89.0% | 63.9% | 53.1% | 2.3% | 3.6% | 9.5% |
| Semantic | TagNex | R.-K. | $(8192)^3$ | 100.0% | 100.0% | 100.0% | 5.2% | 7.9% | 22.5% |
| Semantic | SARA | R.-K. | $(8192)^3$ | 100.0% | 100.0% | 100.0% | 7.3% | 1.5% | 3.3% |
| Collaborative | OneLive IA† | R.-V. | $(512)^3$ | 100.00% | 100.00% | 100.00% | 74.41% | 15.76% | 39.76% |
| Collaborative | OneLive IA† | R.-V. | $(8192)^3$ | 100.00% | 100.00% | 100.00% | 1.16% | 8.54% | 22.78% |
| Collaborative | OneLive IA† | R.-K. | $(512)^3$ | 100.00% | 100.00% | 100.00% | 93.98% | 9.72% | 23.03% |
| Collaborative | OneLive IA† | R.-K. | $(8192)^3$ | 100.00% | 100.00% | 100.00% | 4.50% | 0.66% | 1.76% |
结论分析:同为 Res-Kmeans + $(8192)^3$,SARA 与 TagNex 单级利用率都是 100%,SARA 把两级前缀利用率从 5.2% 提到 7.3%;SID 级与主播级碰撞率 1.5% / 3.3%,低于 TagNex(7.9% / 22.5%)和 OneLive MLLM(3.6% / 9.5%)。说明基于理由的表示产生更多样的离散分配、更少的跨主播碰撞。含协同监督的 OneLive IA 碰撞率更低(0.66% / 1.76%)。作者自己也承认这些只是「潜在有用性的结构性代理指标」——低碰撞不等于排序有用,而 TagNex / OneLive MLLM SID 在排序模型里的对比实验并没有做。
7.5 SARA-Ranker 离线 + 线上结果¶
Table 6 正理由集成结果(离线:相对 base 的 AUC/GAUC 绝对 pp 增量;线上:A/B 百分比变化):
| Method | Click AUC | Click GAUC | Long-view AUC | Long-view GAUC | Gift AUC | Gift GAUC | 线上 Click | 线上 Watch Time | 线上 Effective View | 线上 Follow |
|---|---|---|---|---|---|---|---|---|---|---|
| Embedding | +0.06 | +0.15 | +0.28 | +0.24 | +0.06 | +0.12 | +0.342% | +0.986% | +0.365% | +0.616% |
Table 7 负理由(Rationale-SID)集成结果:
| Method | Hate AUC | Hate GAUC | Report AUC | Report GAUC | 线上 Hate | 线上 Report | 线上 LT-7 |
|---|---|---|---|---|---|---|---|
| SID | +0.35 | +0.55 | +0.46 | +0.38 | −8.164% | −0.4396% | +0.027% |
作者的解读:即使在已有完整多模态栈的强工业基线上,正理由集成在所有目标上都带来一致增益,Long-view 增益最大,支持 MIM 对齐的理由感知 UA 表示的有效性;线上持续提升参与和留存。负理由集成离线 Report 头的 AUC 增益(+0.46)大于 Hate(+0.35)——Report 是最低频事件,主播级记忆最缺数据,理由级泛化帮助最大;线上 Hate 大降 8.16%,Report 作为更稀有事件下降 0.44%,两者都是净压制而非再分配,LT-7 留存呈正向趋势(+0.03%)。
批判性解读:
- A/B 的对照组是「已含 SARM 的生产 MMoE」,实验组是「base + 本文新增模块」。优点:base 已包含 MLLM 导出的主播描述 token($D_a$),所以正理由路径的增益不能简单归为「又加了一份 MLLM 特征」——这一点比一般「加 MLLM embedding」的工作要强。
- 但实验组同时引入了新信号 + 新结构 + 新损失:理由 token 流、UA 双向 cross-attention(从图 10 与 §5.2 行文看是新增模块)、MIM 软对比损失、绕过 MMoE 的门控残差。没有 w/o MIM、没有「只加 UA 交互模块不加理由」、没有「理由槽位换成同长度的通用 MLLM 描述 / Gemini 理由 / SFT 版理由」、也没有「SFT vs DPO 理由接入排序」的对比。因此「收益来自理由这一信号本身」这个核心论断在排序侧没有被证据隔离——引入新信号 ≠ 收益来源。
- 负理由路径同理:−8.16% 的 Hate 下降可能来自「引入 Hate 历史 target attention」本身,而论文唯一的对照论述(AID-only 历史)没有实验支撑。Table 5 显示 SARA SID 碰撞率低于 TagNex,但没有把 TagNex SID 放进同一个 Hate 历史模块做 A/B 或离线对比——恰恰这组实验能回答「理由 SID 是否优于普通语义 SID」。
- 两张表都只有一行,没有其他 baseline、没有消融,所以「消融降幅是否超过对最强 baseline 的 margin」这一问题在本文中无法检验。
- 线上只报点估计:1% 流量、未报告 A/B 时长、置信区间、显著性。观看时长 +0.986% 在 1% 流量下是否显著不得而知;LT-7 +0.027% 大概率在噪声范围内,作者也只称「positive trend」。
- 离线增益极小(Click AUC +0.06pp、Gift +0.06pp),与生产排序模型常见的日间波动同量级;Long-view 的 +0.28pp 相对可观。
- 正理由 Watch Time +0.99% 与负理由 Hate −8.16% 来自两个独立 A/B,论文没有报告两条路径叠加后的效果,也没有报告负理由路径对观看时长、正理由路径对 Hate 的交叉影响(Table 6 无 Hate 列、Table 7 无 Watch Time 列)。
8. 消融与分析(汇总)¶
| 组件 | 是否有消融 | 证据 | 评价 |
|---|---|---|---|
| 在线 judge vs Agent Judge vs 零样本 judge | ✓ | Table 3,人工真值 MAE | 干净,有专家间上界 |
| Senior Review | ✓ | Table 3,MAE 0.29 → 0.20 | 干净 |
| SFT 数据量 | ✓ | Figure 12,6 点曲线 | 只在 judge 分上,未连到下游 |
| QR-DPO | ✓(部分) | Table 4 SFT vs DPO | judge 循环;独立指标 BGE-Sim 无变化 |
| 问卷机制(延迟 T、动态 P、激励) | ✗(仅称经小流量 A/B 选定) | 无数据 | 无量化 |
| 主播中心聚合 / 标签归一 | ✗ | – | 无对比 |
| 理由 vs 通用 MLLM 描述(排序侧) | ✗ | – | 核心归因缺失 |
| MIM 损失 / 门控残差 / UA 模块 | ✗ | – | 无 |
| 理由 SID vs TagNex SID(排序侧) | ✗ | 仅 Table 5 结构指标 | 无下游对比 |
| 理由质量 → 排序收益 | ✗ | – | 链路断开 |
整体上,生成侧的消融比较充分,排序侧的消融为零。而论文最核心的主张——「articulated rationales 是一类新的、能带来线上收益的推荐信号」——恰恰落在排序侧。
9. 核心贡献总结¶
- 问卷式 AUR 数据引擎:延迟触发(T=10s)+ 基于作答率的动态投放概率(式 1)+ judge 门控的快币激励(式 2),185 天采集 191.6 万条候选、日均 10.4K,是一套可复用的「在生产环境持续征集显式偏好理由」的工程方案;负理由良率(24.2%)远高于正理由(6.8%)的观察有参考价值。
- 人工校准的非补偿式 Agent Judge:六维专家 + Senior Review,关键维度硬约束(式 9),对专家整体 MAE 0.20(专家间 0.12),并同时服务于激励、清洗、偏好对构造和评测四个环节。
- 主播中心的理由生成器 SARA-7B:把稀疏的「用户 × 主播」理由聚合到主播粒度,用 SFT + QR-DPO 让 7B MLLM 为 1000 万主播按日生成正/负理由。
- 两条排序接入路径:正理由作为 UA 交互表示的 MIM 软对比锚点;负理由量化成累积前缀 SID 挂到 Hate 历史上做 target attention,实现负反馈的跨主播语义迁移。线上观看时长 +0.99%、Hate −8.16%,全量 30 天以上。
与已归档相关工作的对比¶
RecoReward RecoReward: Recommender-Guided Multimodal Description Generation (Nankai University / Kuaishou, 2026-07-28)¶
关系:独立并发(本文未引用 RecoReward,两者殊途同归;作者团队有重叠,Yueyang Liu、Yuhui Zhang、Ruochen Yang、Shuang Yang 同时出现在两篇的作者表中)· 已加载对方精读
- 共同关注的问题:两篇都在快手直播场景,指出同一个 root cause——MLLM 从内容生成的主播/直播描述只回答「内容里有什么」,不回答「用户为什么会喜欢」,因此作为推荐特征时区分力有限;两篇也都坚持同一个服务约束:生成器推理时 content-only,每个主播/直播只产出一份被所有用户共享的 item 侧文本,可以离线缓存、按日刷新。
- 相近的技术骨架:都是「用户侧偏好信号只在训练期进入 MLLM 对齐 → 对齐后的 MLLM 只看多模态内容生成 item 侧文本 → 文本作为特征接入下游推荐模型」。两者都以 SARM 为直播排序侧的前置工作。
- 本文的差异与推进:偏好信号来源不同——RecoReward 用隐式行为(冻结 DSSM 的 RAS 分数,目标用户中心减 λ 倍非目标用户中心)作 GRPO 奖励;SARA 用显式问卷理由作 SFT 目标,再用人工校准的质量 judge 做 DPO。SARA 因此能区分正/负极性,并把负理由单独用于 Hate 历史建模,这是 RecoReward 没有的维度;代价是 SARA 的对齐目标是「像问卷回答」与「judge 认为质量高」,与推荐效用没有直接挂钩,而 RecoReward 的奖励本身就是推荐空间里的亲和度。
- 可比的方法 / 实验差异:RecoReward 的评测是「每个生成器重新生成描述 → 重训 DSSM(3 seeds)→ 次日召回」的 matched-tower 协议,13 个 baseline,直接回答「哪种描述对推荐更有用」;SARA 的生成质量评测全部在 judge 分与 BGE-Sim 上,排序侧只有「+本方法 vs base」一行,恰恰缺少 RecoReward 那种「换生成器、固定下游」的对比。线上:RecoReward 一周 A/B 关键页有效用户渗透 +0.265%;SARA 观看时长 +0.986%、Hate −8.164%,两者均未报告置信区间。两篇合读的启示是:SARA 的显式理由监督 + RecoReward 的推荐器奖励是天然互补的两个信号,把 RAS 类奖励加进 QR-DPO 的偏好构造,可以直接回应 SARA「对齐目标与推荐效用脱钩」的问题。
10. 讨论与局限性¶
10.1 值得借鉴的设计¶
- 「讨厌的理由」比「喜欢的理由」更值钱。良率 24.2% vs 6.8%、线上 Hate −8.16% vs 观看时长 +0.99%,两组独立证据方向一致:负反馈原本只有一个二值按钮,理由提供的语义增量远大于正向侧(正向侧本来就有丰富的行为信号)。对负反馈稀疏的场景,用语义 SID 把 Hate 历史从「记住这个 ID」扩展成「记住这类问题」是一个低成本、易复用的做法。
- 主播中心聚合。每用户 1.33 份问卷不足以做用户级理解,但每主播 2.17 位用户的回答可以聚合成主播画像——这是把极稀疏的「为什么」变成可用信号的关键一步,也是覆盖率能从 8.6 万扩到 1000 万的前提。
- 非补偿式评估 + 人工校准。硬维度一票否决、Senior Reviewer 学习人类聚合方式,并用独立专家集验证到 MAE 0.20,这套评估器设计可以直接迁移到任何「LLM 生成推荐文本」的质量控制场景。
- MIM 软目标。用理由之间的相似度构造软标签,避免把同类主播的理由当作硬负样本,在同质化严重的直播场景里是合理的细节。
10.2 局限与争议¶
- 排序侧零消融,收益来源未隔离。两条路径都同时引入新信号与新结构,却没有任何一组对照把「理由内容」与「新模块/新损失」分开。base 已含 SARM 的 MLLM 主播描述是一个加分点,但它只排除了「多加一份任意 MLLM 特征」的最粗糙解释,排除不了「新增的 UA 交互模块 / Hate 历史注意力本身带来收益」。
- Judge 循环。同一个 Agent Judge 负责 SFT 数据过滤、DPO 偏好对构造和最终评测;DPO 的 +0.18 整体分在它被优化的评分器上测得,而唯一独立指标 BGE-Sim 在 DPO 前后不变。评估器本身有人工校准是这里比 YouTube Music 那篇 prompt-tuning-by-same-judge 更好的地方,但循环结构没有变。
- 「Scaling」名不副实。只有一条 SFT 数据比例曲线、一个模型尺寸、纵轴全是 judge 分;理由质量与下游排序收益之间没有任何剂量-反应关系。标题的 scaling 实际是覆盖率扩展。
- 理由是主播粒度的。$R_a^\pm$ 由主播内容生成、与用户无关;正理由路径中 MIM 实际是把「用户 × 主播」表示拉向「该主播的共享理由」,并不包含个体用户的偏好理由。「用户为什么喜欢」在进入模型时已经退化成「这个主播通常因为什么被喜欢」。
- 统计与可复现性。1% 流量 A/B 只报点估计,无时长、无置信区间;SFT/DPO/MIM/码本等关键超参缺失;SARA-HQ 未说明是否公开。
- 数据引擎的潜在偏差。激励由在线 judge(MAE 0.35)决定,且正向 HQ 良率随采集量从约 10% 降到 5%,论文没有分析激励是否诱导了「迎合 judge」的回答,也没有分析作答人群(愿意填问卷的用户)与总体用户的偏差。
- 方法论可扩展性。这是一条典型的多阶段解耦路线:问卷 → judge 过滤 → 标签归一 → MLLM 生成文本 → BGE 编码 → RQ 量化 → 排序模型内 64 维 token embedding。MLLM 与排序模型之间只通过离线文本相连,排序监督无法回传到理由生成器;扩大 MLLM 的规模只能改善离线文本质量,排序侧的表征容量(4 层、hidden 64 的共享编码器)并不随之增长。
10.3 与 YouTube Music LLM 理由工作的对照(打分校准)¶
同期 Google 的 YouTube Music 工作 Explainable Recommendations at Scale: LLM Rationales for YouTube Music Artist Discovery 也用 LLM 离线生成「推荐理由」,但用途不同(展示给用户的文案,而非排序特征),且自身 holdback 显示收益全部来自理由文案而非 LLM 候选,只有一个同一 judge 打分的离线数字。SARA 相比之下:有训练(SFT + DPO)、有人工校准的评估器、有两条带公式的排序接入路径、有两个独立线上 A/B 且 base 已含 MLLM 特征——技术含量与证据链明显更完整;但在「收益到底来自理由本身」这一问题上,SARA 同样没有给出隔离证据,且 judge 循环问题同构。
10.4 工业落地价值¶
- 部署:1000 万主播按日刷新理由,排序侧在原延迟预算内服务,全量 30 天以上;
- 收益:观看时长 +0.986%、Click +0.342%、Effective View +0.365%、Follow +0.616%;Hate −8.164%、Report −0.44%、LT-7 +0.027%;
- 成本:论文未披露 SARA-7B 为 1000 万主播每日推理的算力成本,也未披露问卷快币激励的成本——这两项是评估这条路线 ROI 的关键缺项。
总评:SARA 把「问卷征集的显式理由 → MLLM 扩展 → 排序特征」这条链路完整地做进了生产,数据引擎与评估器是真正的工程贡献,负理由 SID 做 Hate 历史的思路简单有效。但方法本身(SFT + best-of-K DPO、RQ SID、target attention、软对比)全是成熟组件的组合,排序侧缺少任何能把收益归因到「理由」本身的对照,「scaling」也只停留在覆盖率层面。属于中规中矩偏上的工业系统论文。