CHAP:把 query 编码器拉进冻结的 item 量化流形,再用单趟残差级联替掉 beam search¶
机构:中国科学技术大学(USTC)+ 美团(Meituan) · arXiv:2608.30553 · 代码:https://github.com/zzzgm/CHAP
注意:arXiv 上的正式标题是 Preference Shapes Relevance: Cross-component Hierarchical Semantic Alignment for Personalized Generative Retrieval(本库入库时标题末段被记作 "Personalized Search")。全文的落脚点是生成式检索(Generative Retrieval, GR)的召回阶段**,不是排序,也不是端到端替代漏斗。
1. 研究动机与背景¶
1.1 生成式检索的三个卡点¶
传统 IR 走 "Index-Retrieve-Rank" 级联:稀疏侧 BM25 做词面匹配,稠密侧 DPR 做语义向量映射,两者都要维护一套外部索引(HNSW 之类)。生成式检索(GR)提出的替代路线是把检索变成序列生成——直接从 query 生成目标 item 的标识符(ItemID),索引被内化进模型参数,长尾 query 与冷启动上表现更好。
但作者指出,当前 GR 在工业个性化搜索里有三个并列的结构性卡点:
(a) 语义鸿沟(semantic gap)。 TIGER、HierGR 这一系的 SID 完全由 item 语料训练:RQ-VAE 的编码器 $E(\cdot)$ 只被 item 重建损失优化,从来没见过 query。于是 query 的潜在表示与 item 的量化路径根本不在同一个流形上,复杂 query 上泛化很差。这是全文的第一 root cause。
(b) 结构与粒度被浪费。 把量化出的 SID 当成一串扁平符号处理,忽略了残差量化天然的 "Coarse-to-Fine" 层级;同时只靠离散稀疏 ID,丢掉了连续向量里的细粒度细节,也就没法把用户行为序列干净地接进来。
(c) 解码延迟。 标准自回归 GR 在线上要为每个层级重复跑一遍重型 Transformer Decoder(尤其是昂贵的 Cross-Attention),$L$ 层就是 $L$ 趟,延迟在延迟敏感的工业系统里直接不可用。
1.2 论文的三条主张¶
对应三个卡点,CHAP(Cross-component Hierarchical semantic Alignment for Personalized generative retrieval)给出三件东西:
- Hierarchical Semantic Alignment(HSA):在冻结的 item 码本上,把 query 编码器拉进 item 的量化空间;
- Personalized Sequence Modeling:把 (稀疏 SID, 稠密向量) 双视图交错成用户行为序列喂 encoder-decoder;
- Residual Cascading Generation(RCG):Decoder 只跑一趟,逐层 SID 交给轻量残差块级联生成。
2. 预备:问题定义与 RQ-VAE¶
2.1 个性化 GR 的形式化¶
给定用户交互历史 $S=\{i_1,\dots,i_N\}$ 与当前 query $q$,目标是直接生成目标 item 的层级 SID $c=(c_0,\dots,c_{L-1})$:
$$P(i|q,S;\theta) = P(c|q,S;\theta) = \prod_{l=0}^{L-1} P(c_l\,|\,c_{<l}, q, S;\theta) \tag{1}$$
其中 $c_{<l}$ 是第 $l$ 层之前已生成的前缀 token。推理即求联合概率最高的那条 SID 路径。
2.2 RQ-VAE 生成 SID¶
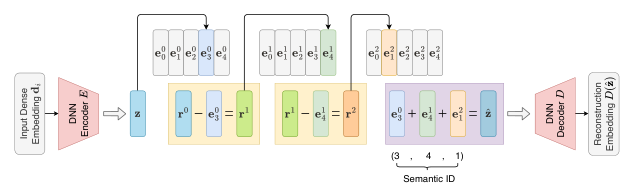
item $i$ 的文本先经预训练语言编码器得到稠密嵌入 $d_i$,再由 DNN 编码器映到潜表示 $z=E(d_i)$。量化用 $L$ 个残差层,每层配一个码本 $C_l=\{e^l_k\}_{k=1}^K$。第 $l$ 步选取离当前残差 $r_l$ 最近的码字($r_0=z$):
$$c_l = \arg\min_k \lVert r_l - e^l_k\rVert_2^2,\qquad r_{l+1} = r_l - e^l_{c_l} \tag{2}$$
$L$ 次迭代后得到 coarse-to-fine 的 SID $(c_0,\dots,c_{L-1})$,量化后的潜表示为码字之和 $\hat z = \sum_{l=0}^{L-1} e^l_{c_l}$。训练目标包含重建损失
$$\mathcal{L}_{\text{recon}} = \lVert d_i - D(\hat z)\rVert_2^2 \tag{3}$$
以及 split quantization 的两项(码本损失把码字拉向残差、承诺损失约束编码器输出):
$$\mathcal{L}_{\text{codebook}} = \sum_{l=0}^{L-1}\lVert \mathrm{sg}[r_l] - e^l_{c_l}\rVert_2^2 \tag{4}$$
$$\mathcal{L}_{\text{commit}} = \beta\sum_{l=0}^{L-1}\lVert r_l - \mathrm{sg}[e^l_{c_l}]\rVert_2^2 \tag{5}$$
$$\mathcal{L}_{\text{RQ-VAE}} = \mathcal{L}_{\text{recon}} + \mathcal{L}_{\text{codebook}} + \mathcal{L}_{\text{commit}} \tag{6}$$
其中 $\mathrm{sg}[\cdot]$ 为 stop-gradient,$\beta$ 平衡承诺损失。
3. 核心方法¶
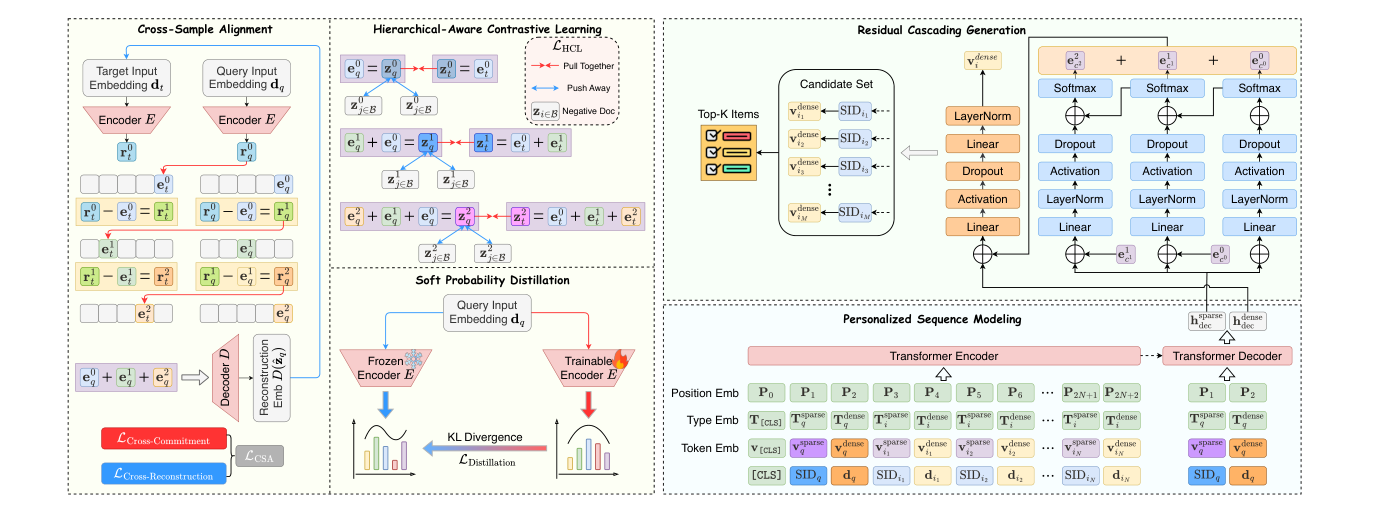
3.1 Hierarchical Semantic Alignment(HSA)¶
关键设计前提:冻结预训练码本。作者的理由是防止语义漂移和灾难性遗忘,强迫 query 的量化路径直接进入稳定的 item 流形。这个选择贯穿全文,也是后面局限性讨论的核心(§7.2)。
HSA 由三个模块叠加。
(1) Cross-Sample Alignment(CSA):把 RQ-VAE 损失的输入-目标对调¶
这是最巧的一手:复用 RQ-VAE 的损失形式,但把输入变量和目标变量互换。给定 query $q$ 与目标 item $t$,Cross-Commitment 损失强迫 query 的残差 $r^l_q$ 对齐目标 item 选中的码字 $e^l_{c_l}$:
$$\mathcal{L}_{\text{CC}} = \beta \sum_{l=0}^{L-1}\lVert r^l_q - \mathrm{sg}[e^l_{c_l}]\rVert_2^2 \tag{7}$$
Cross-Reconstruction 损失则要求从 query 的量化表示 $\hat z_q$ 重建出目标 item 的原始内容 $d_t$:
$$\mathcal{L}_{\text{CR}} = \lVert d_t - D(\hat z_q)\rVert_2^2 \tag{8}$$
合计 $\mathcal{L}_{\text{CSA}} = \mathcal{L}_{\text{CC}} + \mathcal{L}_{\text{CR}}$。物理含义:原版 RQ-VAE 是"item 重建 item",CSA 变成"query 重建 item"——把 query 当成 item 的一个噪声视图,逼它走同一条量化路。
(2) Hierarchical-Aware Contrastive Learning(HCL):逐层累积量化的对比¶
为了显式利用 coarse-to-fine 结构,HCL 在每一个深度 $l$ 上对齐 query 与 target 的部分累积量化表示 $\hat z^{(l)}_q = \sum_{i=0}^{l} e^i_{c^i_q}$、$\hat z^{(l)}_t = \sum_{i=0}^{l} e^i_{c^i_t}$:
$$\mathcal{L}_{\text{HCL}} = -\sum_{l=0}^{L-1}\log\frac{\exp(s^+_l/\tau)}{\sum_{j\in B}\exp(s_{lj}/\tau)},\quad s^+_l = \mathrm{sim}\bigl(\hat z^{(l)}_q, \mathrm{sg}[\hat z^{(l)}_t]\bigr),\quad s_{lj} = \mathrm{sim}\bigl(\hat z^{(l)}_q, \mathrm{sg}[\hat z^{(l)}_j]\bigr) \tag{9}$$
$B$ 是含正样本与负样本的 batch,$\tau$ 为温度。注意 target 侧全程 stop-gradient——只有 query 侧在动,码本不动。
(3) Soft Probability Distillation:软码字分配的 KL 蒸馏¶
硬量化的 argmax 会造成潜表示的剧烈跳变。为此把冻结的 item 侧量化路径的软码字分配分布,蒸馏给可训练的 query 编码器:
$$\mathcal{L}_{\text{Distill}} = \sum_{l=0}^{L-1}\mathrm{KL}\bigl(P_{\text{item}}(\cdot|t)\,\Vert\,P_{\text{query}}(\cdot|q)\bigr) \tag{10}$$
软分配概率由到残差的欧氏距离定义:
$$P(c_l=k|q) = \frac{\exp\bigl(-\lVert r^l_q - e^l_k\rVert_2^2\bigr)}{\sum_{j=1}^{K}\exp\bigl(-\lVert r^l_q - e^l_j\rVert_2^2\bigr)} \tag{11}$$
HSA 总目标为加权和:
$$\mathcal{L}_{\text{HSA}} = \mathcal{L}_{\text{CSA}} + \gamma\cdot\mathcal{L}_{\text{HCL}} + \delta\cdot\mathcal{L}_{\text{Distill}} \tag{12}$$
三者的分工:CSA 是"硬锚",把 query 钉在 item 流形上(重建 + 承诺);HCL 是"层级尺",保证粗层到细层每一级都对齐而不只是最终和向量对齐;Distill 是"软垫",防止训练中量化分配剧烈翻转。消融显示三者贡献极不均衡(§6.1)。
3.2 Personalized Sequence Modeling:双视图序列¶
每一次交互同时提供对齐后的离散 SID 与连续稠密向量,交错成输入序列:
$$X_{\text{in}} = [\,v_{[\text{CLS}]},\ v^{\text{sparse}}_q,\ v^{\text{dense}}_q,\ v^{\text{sparse}}_{i_1},\ v^{\text{dense}}_{i_1},\ \dots\,] \tag{13}$$
其中 $v^{\text{sparse}}$ 把聚合码字 $\sum_l e^l_{c_l}$ 映到统一稠密空间,$v^{\text{dense}}$ 就是原始语言模型嵌入。
训练-推理一致性设计:Decoder 只用 query 自己的双表示 $(v^{\text{sparse}}_q, v^{\text{dense}}_q)$ 初始化,不喂历史。这强迫 Decoder 通过 cross-attention "回头看" encoder 侧的历史来取个性化信息,从而避免 exposure bias。
混合优化。稀疏侧是逐层 SID 分类的交叉熵:
$$\mathcal{L}_{\text{sparse}} = -\sum_{l=0}^{L-1}\log\left(\frac{\exp(s^l_{c_l})}{\sum_{k=1}^{K}\exp(s^l_k)}\right) \tag{14}$$
$s^l\in\mathbb{R}^K$ 是第 $l$ 层的 logit 向量。稠密侧为避免 MSE 不稳定,用 InfoNCE 对比损失($B=\{v^+\}\cup B^-$):
$$\mathcal{L}_{\text{dense}} = -\log\frac{\exp(\mathrm{sim}(\hat v, v^+)/\tau)}{\sum_{v'\in B}\exp(\mathrm{sim}(\hat v, v')/\tau)} \tag{15}$$
联合目标 $\mathcal{L}_{\text{total}} = \mathcal{L}_{\text{sparse}} + \mathcal{L}_{\text{dense}}$。作者的解释是形成 curriculum learning 效应:稀疏的结构约束先把搜索空间收窄,稠密排序的优化随之变简单。
3.3 Residual Cascading Generation(RCG)与检索¶
级联分解¶
把目标 item 的生成概率分解为"$L$ 个层级语义 token 的联合概率" × "稠密向量的条件概率":
$$P(i|X) = \underbrace{\prod_{l=0}^{L-1} P(c^l_i\,|\,c^{<l}_i, X)}_{\text{Sparse Generation}}\cdot\underbrace{P(v_i\,|\,c^{0:L-1}_i, X)}_{\text{Dense Refinement}} \tag{16}$$
单趟残差生成¶
Transformer Decoder 只在 query 的输入 token 上执行一次。 记 $h^{\text{sparse}}_{\text{dec}}$、$h^{\text{dense}}_{\text{dec}}$ 分别为离散 query SID 位置与连续 query 嵌入位置对应的输出隐状态。以 $h^{\text{sparse}}_{\text{dec}}$ 作为全局结构上下文锚点,预测第 $l$ 层的后续状态由轻量残差块更新:
$$h^{(l+1)} = \mathrm{ResBlock}\bigl(\mathrm{Concat}[h^{\text{sparse}}_{\text{dec}},\,e^l_{c_l}]\bigr) + h^{(l)} \tag{17}$$
为把连续向量对齐到这条离散结构上,把重建量化 $\hat z=\sum_{l=0}^{L-1}e^l_{c_l}$ 注入以 $h^{\text{dense}}_{\text{dec}}$ 为条件的稠密预测头:
$$\hat v = \mathrm{PredHead}\bigl(\mathrm{Concat}[h^{\text{dense}}_{\text{dec}},\,\hat z]\bigr) \tag{18}$$
这就是全文最实用的一件东西:把"重历史意图路由"(Decoder + Cross-Attention,跑一次)与"层级码生成"(残差块,跑 $L$ 次但极轻)解耦。原本 $L$ 趟重型解码降为 1 趟。
候选打分¶
推理时用并行采样生成 $M$ 个候选 SID(而非 beam search)。稀疏信号 $S_{\text{sparse}}$ 是采样出的层级路径的累积对数概率;稠密信号 $S_{\text{dense}}$ 是预测稠密向量 $\hat v$ 与候选 item 原始向量 $v_i$ 的余弦相似度。两者各自在候选池 $\mathcal{I}_{\text{cand}}$ 上做温度缩放 Softmax 归一化:
$$N(S) = \frac{\exp(S/\tau)}{\sum_{j\in\mathcal{I}_{\text{cand}}}\exp(S_j/\tau)} \tag{19}$$
最终分数为两个视图的乘积(无参数融合):
$$S_{\text{final}}(i) = N\bigl(S_{\text{sparse}}(i)\bigr)\cdot N\bigl(S_{\text{dense}}(i)\bigr) \tag{20}$$
3.4 级联分解的熵下界证明(App. B)¶
论文给了一个信息论小定理支撑式 (16)。设独立双视图分解为
$$P_{\text{ind}}(C_i, V_i|X) = \prod_{l=0}^{L-1}P(C^l_i|X)\cdot P(V_i|X) \tag{21}$$
CHAP 的级联分解为
$$P_{\text{chap}}(C_i, V_i|X) = \prod_{l=0}^{L-1}P(C^l_i|C^{<l}_i, X)\cdot P(V_i|C_i, X) \tag{22}$$
则 $H_{\text{chap}}(C_i,V_i|X)\le H_{\text{ind}}(C_i,V_i|X)$ $\tag{23}$。证明是条件互信息非负的直接推论:
$$H_{\text{ind}} = \sum_{l=0}^{L-1}H(C^l_i|X) + h(V_i|X) \tag{24}$$
$$H_{\text{chap}} = \sum_{l=0}^{L-1}H(C^l_i|C^{<l}_i, X) + h(V_i|C_i, X) \tag{25}$$
$$H(C^l_i|X) - H(C^l_i|C^{<l}_i,X) = I(C^l_i; C^{<l}_i|X)\ge 0 \tag{26}$$
$$h(V_i|X) - h(V_i|C_i,X) = I(V_i;C_i|X)\ge 0 \tag{27}$$
$$H_{\text{ind}} - H_{\text{chap}} = \sum_{l=0}^{L-1}I(C^l_i;C^{<l}_i|X) + I(V_i;C_i|X)\ \ge 0 \tag{28}$$
等号成立当且仅当每层 SID 在给定 $X$ 下与其前缀条件独立、且 $V_i$ 在给定 $X$ 下与 $C_i$ 条件独立。评价:这个定理是正确的,但它证明的是"多加条件不会增加熵"这一教科书结论,对 CHAP 的具体设计(用哪个隐状态做锚点、残差块怎么接)没有约束力——它排除的是最朴素的独立分解,而不是任何竞争性的级联方案。
4. 实验设置¶
4.1 数据集¶
| Dataset | #Items | #Queries | #Q-I Pairs | Train Q / Q-I | Test Q / Q-I | Avg. Hist. |
|---|---|---|---|---|---|---|
| ESCI-us | 1,215,854 | 97,346 | 1,818,825 | 74,888 / 1,393,063 | 22,458 / 425,762 | — |
| KuaiSearch | 6,634,118 | 295,561 | 682,228 | 266,004 / 613,696 | 29,557 / 68,532 | 10.37 |
| Amazon (PersonalWAB) | 35,772 | 9,070 | 9,070 | 6,896 / 6,896 | 2,174 / 2,174 | 40.12 |
| Local-Life(工业私有) | 10,145,542 | 3,089,026 | 3,089,026 | 2,984,294 / 2,984,294 | 104,732 / 104,732 | 7.47 |
- ESCI-us:Amazon Shopping Queries 的英文子集,用的是 large 版本、原始 query/item 文本、官方划分,不做任何清洗(作者特意点名此前的 CAT-ID2、MERGE 用的是 small 版本 + 特定预处理)。四档相关性 E/S/C/I,序列建模时把 E 与 S 当正样本。
- KuaiSearch:快手的大规模电商搜索数据集(约 33 万用户 / 1800 万商品 / 250 万真实 query),不做流行度过滤,保留冷启动用户和长尾商品。本文只用 recall 子集,点击与购买均算正样本,按 9:1 随机划分。
- Amazon:来自 PersonalWAB(Personalized Web Agent Benchmark),人工合成的高度个性化自然语言指令 + 真实 Amazon 交互日志,平均历史长达 40.12,是四个集里个性化压力最大的。
- Local-Life:美团本地生活平台 30 天日志。关键差异是保留了原始自然语言文本(对比 KuaiSAR / JDSearch 只给加密 token ID,无法做语义核验)。覆盖餐饮、娱乐、旅行等场景与品牌搜索、模糊意图、精确搜索、长尾/冷启四类异构意图。前 29 天训练、最后 1 天测试。
4.2 Baseline(14 个,四类)¶
- 稀疏:BM25、Doc2Query、DeepCT
- 稠密:DPR、Sen-T5、MPNet
- 个性化:TEM、CoPPS
- 生成式:DSI、NCI、TIGER、LTRGR、MERGE、COBRA
4.3 指标¶
R@K(覆盖率宏观视角)、HR@K(单意图场景的命中率)、MRR@K(单目标数据集的严格位次质量)、NDCG@K(多目标 + 多级相关性)。公式为标准定义:
$$\mathrm{R@K}=\frac{1}{|Q|}\sum_{q\in Q}\frac{|R_q\cap \hat I_{q,K}|}{|R_q|},\quad \mathrm{HR@K}=\frac{1}{|Q|}\sum_{q\in Q}\mathbb{I}(|R_q\cap\hat I_{q,K}|>0) \tag{29,30}$$
$$\mathrm{MRR@K}=\frac{1}{|Q|}\sum_{q\in Q}\frac{1}{\mathrm{rank}^*_q},\quad \mathrm{DCG@K}=\sum_{i=1}^{K}\frac{2^{rel_i}-1}{\log_2(i+1)},\quad \mathrm{NDCG@K}=\frac{\mathrm{DCG@K}}{\mathrm{IDCG@K}} \tag{31,32,33}$$
4.4 实现细节¶
- 文本表征骨干:BERT-base(110M)/ 中文 Chinese-BERT-base(102M);GR 骨干:T5-base(220M)/ 中文 mT5-base(580M)。所有 GR baseline 用同容量骨干,因此效率对比反映的是框架级设计差异而非骨干规模。
- SID 学习阶段:AdamW,lr $1\times10^{-4}$,batch 1024,500 epochs,承诺权重 $\beta=0.5$;码本 $L=3$、$K=512$。
- 对齐 + 生成阶段:冻结 item 码本,微调 Transformer 骨干与对齐模块。AdamW,lr $1\times10^{-5}$,warm-up ratio 0.1,线性衰减,50 epochs;双视图行为序列最大长度截断到 512 token。
- 对齐权重 $\gamma=0.01$(HCL)、$\delta=0.001$(Distill);推理并行采样 $M=50$,归一化温度 $\tau=1.1$。
- 硬件:训练 8×A100(80G),推理 QPS 测量用单卡 A100(80G)。
4.5 公平性控制(App. F.2,值得单独表扬)¶
作者对"生成式方法候选池比稠密方法小"这一常见质疑做了明确处理:
- TEM / CoPPS 等双塔方法用 FAISS 做全库穷举向量检索,即在无界候选预算下评测;CHAP 反而受限于生成候选池;
- 所有 GR baseline 用完全相同的候选预算 $M=50$,且允许各自使用最优的 Constrained Beam Search(beam=50),而不是强行统一解码算法去人为压低 baseline;
- 任何模型都不加外部重排器(Cross-Encoder);CHAP 的两路信号融合是无参数的。
5. 主要实验结果(RQ1)¶
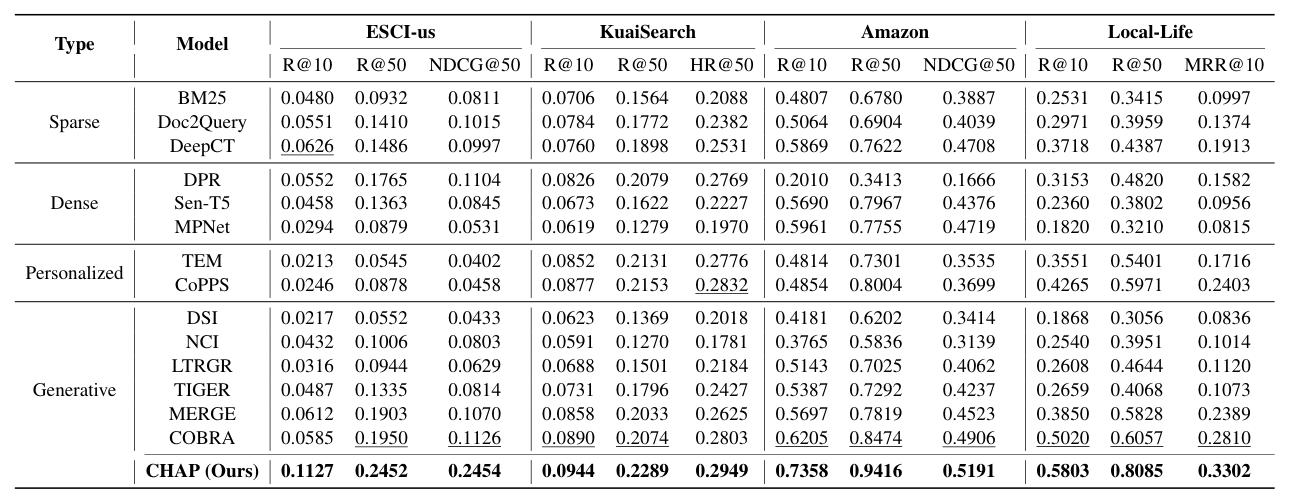
| Type | Model | ESCI R@10 | ESCI R@50 | ESCI NDCG@50 | Kuai R@10 | Kuai R@50 | Kuai HR@50 | Amz R@10 | Amz R@50 | Amz NDCG@50 | LL R@10 | LL R@50 | LL MRR@10 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Sparse | BM25 | 0.0480 | 0.0932 | 0.0811 | 0.0706 | 0.1564 | 0.2088 | 0.4807 | 0.6780 | 0.3887 | 0.2531 | 0.3415 | 0.0997 |
| Sparse | Doc2Query | 0.0551 | 0.1410 | 0.1015 | 0.0784 | 0.1772 | 0.2382 | 0.5064 | 0.6904 | 0.4039 | 0.2971 | 0.3959 | 0.1374 |
| Sparse | DeepCT | 0.0626 | 0.1486 | 0.0997 | 0.0760 | 0.1898 | 0.2531 | 0.5869 | 0.7622 | 0.4708 | 0.3718 | 0.4387 | 0.1913 |
| Dense | DPR | 0.0552 | 0.1765 | 0.1104 | 0.0826 | 0.2079 | 0.2769 | 0.2010 | 0.3413 | 0.1666 | 0.3153 | 0.4820 | 0.1582 |
| Dense | Sen-T5 | 0.0458 | 0.1363 | 0.0845 | 0.0673 | 0.1622 | 0.2227 | 0.5690 | 0.7967 | 0.4376 | 0.2360 | 0.3802 | 0.0956 |
| Dense | MPNet | 0.0294 | 0.0879 | 0.0531 | 0.0619 | 0.1279 | 0.1970 | 0.5961 | 0.7755 | 0.4719 | 0.1820 | 0.3210 | 0.0815 |
| Personalized | TEM | 0.0213 | 0.0545 | 0.0402 | 0.0852 | 0.2131 | 0.2776 | 0.4814 | 0.7301 | 0.3535 | 0.3551 | 0.5401 | 0.1716 |
| Personalized | CoPPS | 0.0246 | 0.0878 | 0.0458 | 0.0877 | 0.2153 | 0.2832 | 0.4854 | 0.8004 | 0.3699 | 0.4265 | 0.5971 | 0.2403 |
| Generative | DSI | 0.0217 | 0.0552 | 0.0433 | 0.0623 | 0.1369 | 0.2018 | 0.4181 | 0.6202 | 0.3414 | 0.1868 | 0.3056 | 0.0836 |
| Generative | NCI | 0.0432 | 0.1006 | 0.0803 | 0.0591 | 0.1270 | 0.1781 | 0.3765 | 0.5836 | 0.3139 | 0.2540 | 0.3951 | 0.1014 |
| Generative | LTRGR | 0.0316 | 0.0944 | 0.0629 | 0.0688 | 0.1501 | 0.2184 | 0.5143 | 0.7025 | 0.4062 | 0.2608 | 0.4644 | 0.1120 |
| Generative | TIGER | 0.0487 | 0.1335 | 0.0814 | 0.0731 | 0.1796 | 0.2427 | 0.5387 | 0.7292 | 0.4237 | 0.2659 | 0.4068 | 0.1073 |
| Generative | MERGE | 0.0612 | 0.1903 | 0.1070 | 0.0858 | 0.2033 | 0.2625 | 0.5697 | 0.7819 | 0.4523 | 0.3850 | 0.5828 | 0.2389 |
| Generative | COBRA | 0.0585 | 0.1950 | 0.1126 | 0.0890 | 0.2074 | 0.2803 | 0.6205 | 0.8474 | 0.4906 | 0.5020 | 0.6057 | 0.2810 |
| Ours | CHAP | 0.1127 | 0.2452 | 0.2454 | 0.0944 | 0.2289 | 0.2949 | 0.7358 | 0.9416 | 0.5191 | 0.5803 | 0.8085 | 0.3302 |
(下划线为次优,粗体为显著优于全部 baseline,paired t-test $p<0.05$。)
相对次优的提升幅度(本人计算):
| Dataset | 指标 1 | 指标 2 | 指标 3 |
|---|---|---|---|
| ESCI-us | R@10 +80.0% | R@50 +25.7% | NDCG@50 +117.9% |
| KuaiSearch | R@10 +6.1% | R@50 +6.3% | HR@50 +4.1% |
| Amazon | R@10 +18.6% | R@50 +11.1% | NDCG@50 +5.8% |
| Local-Life | R@10 +15.6% | R@50 +33.5% | MRR@10 +17.5% |
结论分析(why,不只是 what):
- 提升幅度极不均匀,KuaiSearch 上几乎打平。 KuaiSearch 三个指标只有 4–6% 的提升,是四个集里最小的;而 ESCI-us 与 Local-Life 提升巨大。KuaiSearch 的特点是 Q-I pair 稀疏(68 万对配 663 万 item,平均每 query 只有 2.3 个正样本)且 query 侧监督信号弱——CSA / HCL 都需要 (query, target) 配对才能训练,配对越稀疏,HSA 能榨出的对齐信号越少。这与 §6.2 的分段结论(HSA 在稀疏段贡献最大)表面矛盾,实则不然:分段实验里的稀疏指的是 item 稀疏(冷启动、长尾),而 KuaiSearch 稀疏的是训练用的 query-item 监督对本身。
- TIGER 在 ESCI-us 上被 BM25 打败(R@10 0.0487 vs 0.0480 基本持平、NDCG@50 0.0814 vs 0.0811 持平)。这正是作者要论证的:纯 item-only SID 在有否定词、属性约束的复杂 query 上根本没有语义理解能力。
- 传统个性化方法 TEM / CoPPS 在 ESCI-us 上崩掉(R@10 仅 0.0213 / 0.0246,远低于 BM25)——ESCI-us 没有历史序列(Avg. Hist. 为空),把历史当核心信号的模型在这里没有输入可用。反过来在 Local-Life / KuaiSearch 上它们又强于多数 GR 方法。作者称之为 relevance drift:历史行为盖过了当前搜索意图。
- ESCI-us 的 NDCG@50 = 0.2454 值得单独存疑。 其他所有模型的 NDCG@50 都落在自己的 R@10 与 R@50 之间(如 COBRA:0.0585 / 0.1126 / 0.1950),符合"分级增益被 $\log_2(i+1)$ 折损"的直觉。而 CHAP 的 NDCG@50(0.2454)与 R@50(0.2452)几乎完全相等(差 0.0002),同时 R@10 只有 0.1127——意味着一半以上的相关 item 排在第 11–50 位,却几乎没有被位次折损惩罚。这个数值组合在 $2^{rel}-1$ 的多级 NDCG 定义下很难自洽,要么归一化口径与 baseline 不一致,要么是个巧合。论文对 ESCI-us 上这个 +117.9% 的异常提升没有任何解释。
5.1 与 COBRA / MERGE 的机制差异(原文 §5.2)¶
- 对 COBRA:COBRA 强制生成多个稠密表示,训练成本与实时推理开销都很高;CHAP 直接复用 item 的原始表示做序列建模,不额外生成稠密向量。
- 对 MERGE:MERGE 重度依赖"同一 query 下多个正样本 + 多级相关性"的对齐,在单正样本或相关性等级均一的数据集上泛化受限;CHAP 的对齐范式针对的是"复杂多意图 query 与目标之间的鸿沟"。
6. 消融与分析¶
6.1 组件消融(Local-Life,RQ2 & RQ4)¶
| Variant | R@10 | R@50 | MRR@10 | QPS | ΔMRR |
|---|---|---|---|---|---|
| CHAP (Full Model) | 0.5803 | 0.8089 | 0.3302 | 78.9 | — |
| (A) Hierarchical Semantic Alignment | |||||
| w/o HSA(换回冻结的预训练编码器) | 0.5115 | 0.7488 | 0.2845 | 78.9 | −13.8% |
| w/o $\mathcal{L}_{\text{CSA}}$ | 0.5164 | 0.7602 | 0.2721 | 78.9 | −17.6% |
| w/o $\mathcal{L}_{\text{HCL}}$ | 0.5218 | 0.7534 | 0.2858 | 78.9 | −13.4% |
| w/o $\mathcal{L}_{\text{Distill}}$ | 0.5692 | 0.7895 | 0.3063 | 78.9 | −7.2% |
| (B) Sequence Modeling | |||||
| w/o Dense Refinement | 0.4352 | 0.6455 | 0.2241 | 81.2 | −32.1% |
| (C) Residual Cascading Generation | |||||
| w/o Residual Gen.(退化为自回归) | 0.5285 | 0.7610 | 0.2849 | 40.5 | −13.7% |
| w/o Self-Attention(只留 Cross-Attn) | 0.5712 | 0.8062 | 0.3237 | 84.8 | −2.0% |
| w/o Decoder(Pooling + MLP) | 0.4651 | 0.6836 | 0.2584 | 112.4 | −21.7% |
(变体定义见 App. G。注:Full Model 的 R@50 在 Table 3 记作 0.8089,Table 2 记作 0.8085,原文内部有 0.0004 的不一致。)
逐项分析:
- 最大的单点跌幅是 w/o Dense Refinement(MRR −32.1%,R@10 −25.0%),远超任何 HSA 相关变体。作者的解读是"稀疏 SID 只是粗检索的结构骨架,稠密向量才承载精确个性化匹配所需的细粒度语义"。这个解读没问题,但它的推论是:CHAP 增益的最大单一来源是"保留稠密视图",而这恰恰是 COBRA 已经提出的配方(cascaded sparse-dense),不是 CHAP 的原创点。
- w/o $\mathcal{L}_{\text{CSA}}$ 比 w/o HSA 整体还差(MRR 0.2721 < 0.2845)。这是个论文完全没讨论的反常现象,但机制是清楚的:
w/o HSA用的是冻结编码器(不训),w/o CSA用的是可训练编码器但只有 HCL + Distill 驱动。也就是说,没有 CSA 的重建/承诺锚,光靠对比与 KL 会把 query 编码器推离 item 流形,还不如干脆不训。CSA 那个"输入-目标对调"的重建项才是把 query 钉在流形上的真正力矩,HCL 和 Distill 是修饰。 - $\mathcal{L}_{\text{Distill}}$ 贡献最小(−7.2%),是三个子损失里可有可无的那个,其权重 $\delta=0.001$ 也是三者中最小的。
- RCG 的双重收益是真的:退回自回归后 QPS 从 78.9 腰斩到 40.5(−48.7%),同时 MRR 还掉 13.7%。即"更快"和"更准"同时成立,作者归因于缓解了逐层解码衰减(layer-wise decoding decay)。
- Decoder 的 Cross-Attention 不可省:去掉 Self-Attention 几乎无损(MRR −2.0%)且 QPS 还涨到 84.8,说明显式残差通路已经能替代 Self-Attention 做层级建模;但整个 Decoder 拿掉换成 Pooling+MLP 后 QPS 冲到 112.4,MRR 却塌了 21.7%——长用户序列上的动态历史路由必须靠 Cross-Attention。这条给出了明确的工程取舍点:想再快 7.5%,可以安全砍掉 Self-Attention。
6.2 SID 质量诊断(RQ2)¶
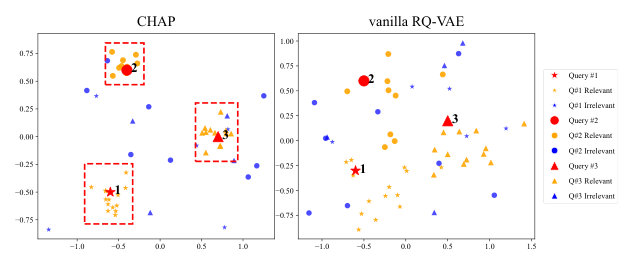
ESCI-us 上把 RQ-VAE DNN 编码器的潜空间 PCA 降维可视化:vanilla RQ-VAE 下相关 item(橙)与 query(红)明显分离、松散散布;CHAP 把相关 item 紧紧聚到对应 query 周围,同时把不相关 item(蓝)显式推远。
聚类量化诊断(App. I,1 万条 ESCI-us 采样,用商品类目做簇标签):
| Method | Silhouette ↑ | CH Index ↑ | DB Index ↓ |
|---|---|---|---|
| RQ-VAE | 0.218 | 612.4 | 1.684 |
| MERGE | 0.331 | 948.7 | 1.153 |
| CHAP | 0.387 | 1136.2 | 0.912 |
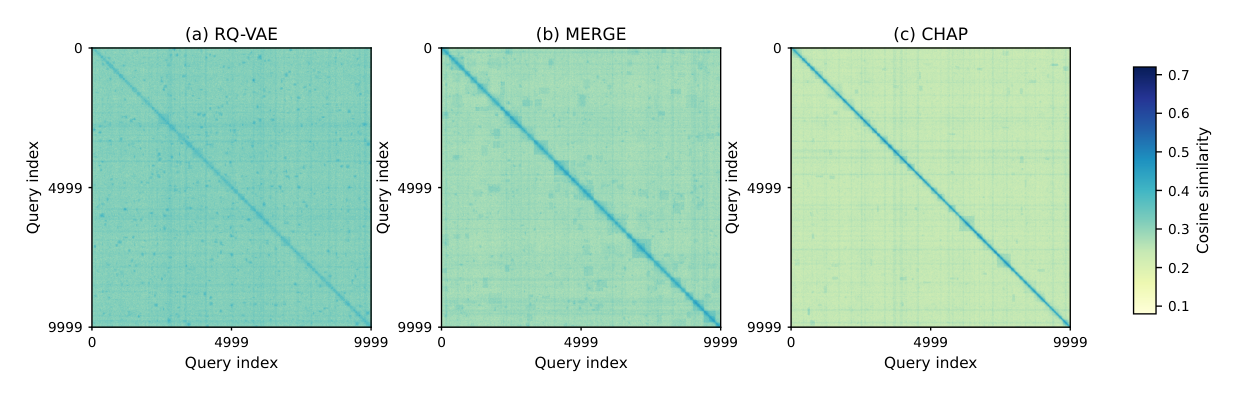
相似度矩阵视角:RQ-VAE 的非对角背景噪声明显(item-only 量化在不相关类目间留下残余相似度);MERGE 对角结构更清晰但仍有粗块(多级合并改善了局部一致性、保留了粗粒度语义纠缠);CHAP 对角更锐、背景更淡。
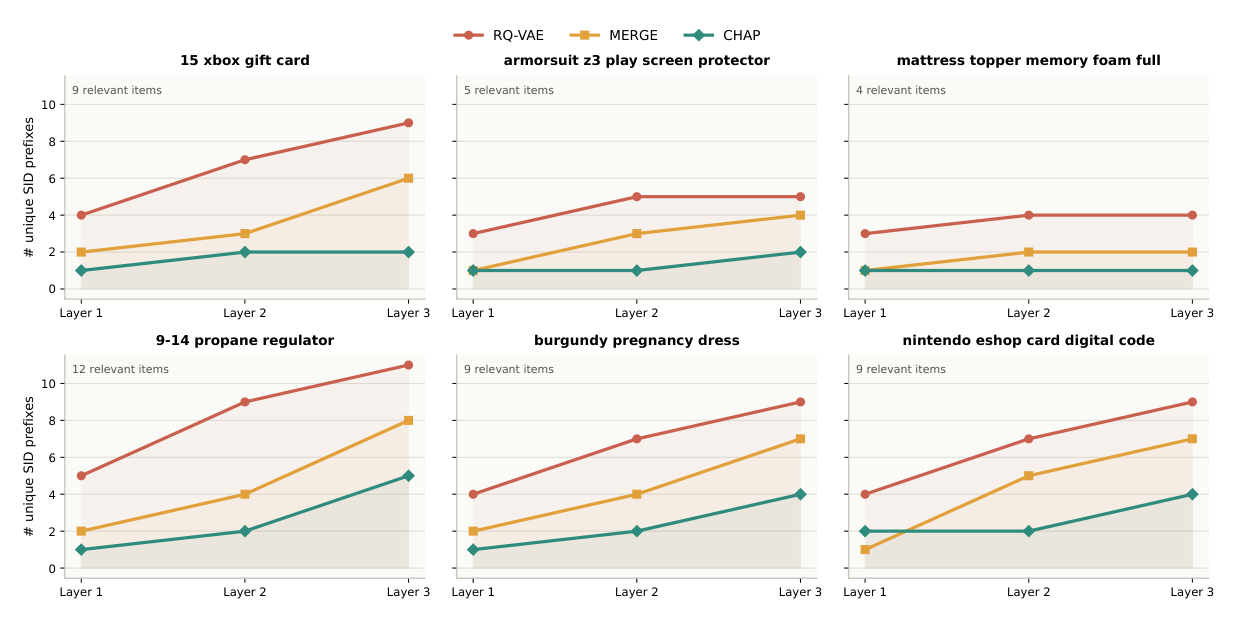
逐层 SID 集中度是我认为最有说服力的一张图:对每条 query,统计其相关 item 在每一层占据的唯一 SID 前缀数,越低说明相关 item 被归到越少的分支。CHAP 在六条代表性 query 上都比 RQ-VAE 和 MERGE 更集中,尤其在更深的 SID 层——说明 HSA 确实让 SID 层级按 query-conditioned relevance 组织,而不只是 item 侧的词面相似度。
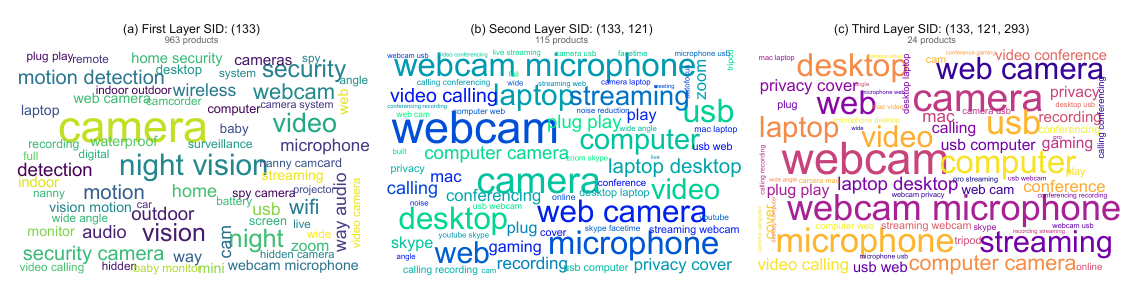
沿一条对齐后的相机类 SID 路径看关键词演化:第一层前缀 (133) 是 963 个商品的粗粒度"视觉设备"簇(camera / security camera / webcam / night vision / motion detection);第二层 (133, 121) 收窄到 115 个 webcam 与 USB 摄像头商品;第三层 (133, 121, 293) 进一步集中到 24 个带麦克风、面向桌面/笔记本/直播的 webcam。coarse-to-fine 语义确实成立。
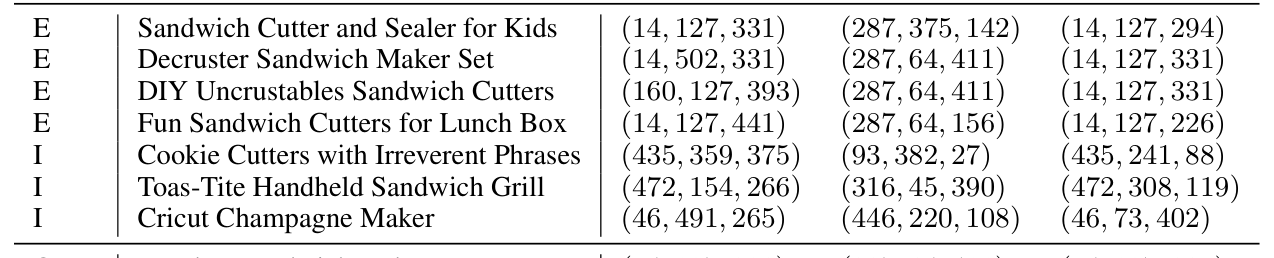
item 级例子(query "crustless sandwich maker"):因为 CHAP 是从 RQ-VAE 码本初始化并微调的,两者 SID 可直接逐 token 比较(MERGE 学的是独立码本,只能在自己空间内解释)。CHAP 把 "Decruster Sandwich Maker Set" 与 "DIY Uncrustables Sandwich Cutters" 都映到 (14, 127, 331)——与 query 自身的 SID 完全一致;而无关的 cookie cutter、手持三明治烤盘、Cricut 制作机保持分离。RQ-VAE 下这三个正样本分散在 (14,127,331) / (14,502,331) / (160,127,393)。
6.3 意图分段分析(RQ3)— 全文最关键的一张图¶
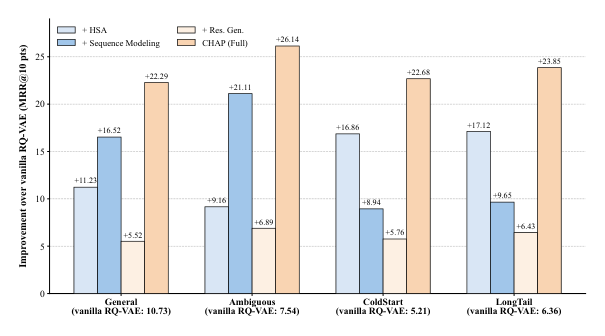
从 Local-Life 抽出四个意图分段(定义见 App. H;Ambiguous / ColdStart / LongTail 三段共用与 General 完全相同的 1000 万+ item 全库,不是缩小候选池的作弊):
- General:整个 Local-Life 全集,自然流量分布。
- Ambiguous:短且泛化的模糊 query("晚餐"、"附近景点"、"周末娱乐"),跨多品类映射到海量候选,考验 Personalized Sequence Modeling。
- ColdStart:只指向近 14 天新上架 item 的 query,点击日志极稀疏或为零,考验纯零样本语义匹配。
- LongTail:历史交互频次处于全站后 10% 的 query(特定长尾约束、小众店名、复杂否定条件)。
| Segment | #Queries | Avg. Hist. | vanilla RQ-VAE (MRR@10) | +HSA | +Sequence Modeling | +Res. Gen. | CHAP (Full) |
|---|---|---|---|---|---|---|---|
| General | 3,089,026 | 7.47 | 10.73 | +11.23 | +16.52 | +5.52 | +22.29 |
| Ambiguous | 10,000 | 6.21 | 7.54 | +9.16 | +21.11 | +6.89 | +26.14 |
| ColdStart | 5,000 | 5.74 | 5.21 | +16.86 | +8.94 | +5.76 | +22.68 |
| LongTail | 10,000 | 10.16 | 6.36 | +17.12 | +9.65 | +6.43 | +23.85 |
(数值为在 vanilla RQ-VAE 基线上单独加入各组件带来的 MRR@10 绝对点数提升。)
论文的解读:Sequence Modeling 在 Ambiguous 段最强(+21.11),证实模糊 query 需要稠密历史上下文做意图消歧;但在 ColdStart / LongTail 上贡献骤降(+8.94 / +9.65),因为冷实体本身缺交互历史。反过来 HSA 在这两段最强(+16.86 / +17.12),说明主动语义映射能为罕见 query 与新 item 补上表示鸿沟,且独立于流行度偏置。Res. Gen. 在四段上都是稳定的 +5.5~+6.9 的结构性底盘提升。
我的独立核算(这是本篇最重要的发现,详见 §7.1):把每段的三个单组件增益相加与 Full 对比——
| Segment | HSA + Seq + ResGen 之和 | CHAP (Full) | 交叉项 |
|---|---|---|---|
| General | 33.27 | 22.29 | −10.98 |
| Ambiguous | 37.16 | 26.14 | −11.02 |
| ColdStart | 31.56 | 22.68 | −8.88 |
| LongTail | 33.20 | 23.85 | −9.35 |
四段无一例外是次可加(sub-additive)的,交叉项全部为负、且量级接近 −9~−11 点。 全模型基本等于"最强单组件 + 5~6 点"。也就是说,三个组件之间没有任何协同增益,它们是三块互相高度重叠、只是各自在不同分段上更有效的补丁。论文自己用的词是 "revealing the orthogonal strengths of each module"——orthogonal(正交)恰恰是"互不相干",与标题里 "Preference Shapes Relevance" 所主张的因果塑形关系直接冲突。
6.4 效率分析(RQ4)¶
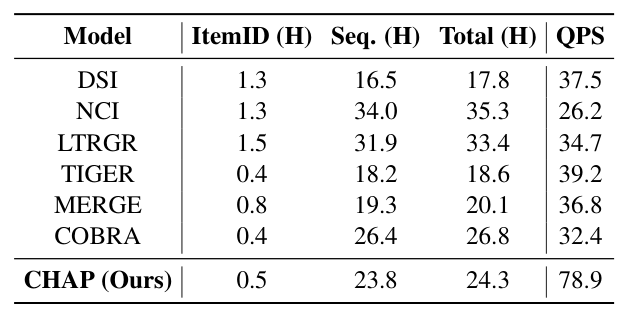
| Model | ItemID (H) | Seq. (H) | Total (H) | QPS |
|---|---|---|---|---|
| DSI | 1.3 | 16.5 | 17.8 | 37.5 |
| NCI | 1.3 | 34.0 | 35.3 | 26.2 |
| LTRGR | 1.5 | 31.9 | 33.4 | 34.7 |
| TIGER | 0.4 | 18.2 | 18.6 | 39.2 |
| MERGE | 0.8 | 19.3 | 20.1 | 36.8 |
| COBRA | 0.4 | 26.4 | 26.8 | 32.4 |
| CHAP | 0.5 | 23.8 | 24.3 | 78.9 |
CHAP 的 QPS 是 TIGER 的 2.01 倍、COBRA 的 2.44 倍,而训练总时长(24.3H)居中——比 TIGER/MERGE 慢,比 NCI/LTRGR/COBRA 快。NCI 和 LTRGR 的训练开销大分别源于大规模 query 增广与复杂 listwise 优化。这是全文最扎实、最可复用的一个结论:在骨干规模严格对齐的前提下,单趟解码 + 并行采样相对 beam search 拿到了 2 倍以上吞吐。
6.5 超参敏感性(RQ5)¶
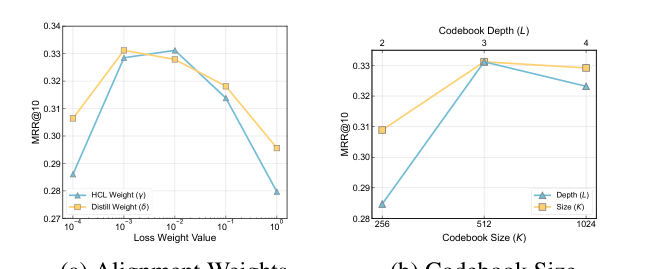
- 对齐权重呈倒 U:$\gamma=0.01$、$\delta=0.001$ 为峰值。权重太大会破坏主重建目标的稳定性。
- 码本规模:深度 $L=3$、大小 $K=512$ 为峰值。作者强调 CHAP 对码本结构参数异常鲁棒——极端设置只带来小幅波动,不会出现标准 GR 模型在次优码本分配下的性能坍塌。(这一点是冻结码本 + query 侧对齐的直接好处:码本再差,query 也被强行拉到同一个流形上。)
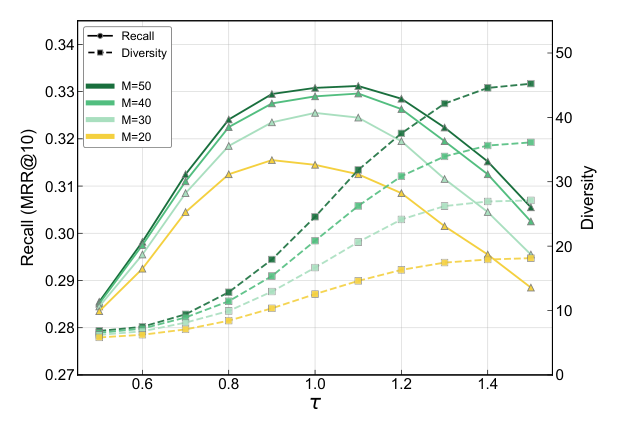
- 推理端用归一化温度 $\tau$ 调节精度-多样性平衡,跨不同并行采样数 $M$。精度呈倒 U:$\tau$ 太低分布过尖锐(过度自信),太高则探索噪声过大。最优点 $\tau=1.1$、$M=50$。
6.6 线上 A/B(RQ6)¶
在一个头部本地生活服务平台(美团)做了 14 天、覆盖 20% 用户流量的线上 A/B。部署方式是 NVIDIA Triton 做模块解耦以支撑高吞吐实时推理,而非依赖 query 缓存(这一句很关键——排除了"靠缓存刷指标"的可能)。对照组是已经高度优化的线上生产召回系统。
| Metric | Relative Improvement |
|---|---|
| UV-CTR(点击率) | +0.77% |
| UV-CXR(转化率) | +2.09% |
| Pay Orders(支付单量) | +2.98% |
全部指标 paired t-test $p<0.05$ 显著。
7. 与已归档相关工作的对比¶
DSIRM DSIRM: Learning Query-Bridged Discrete Semantic Identifiers(Taobao & Tmall of Alibaba, 2026-06-03)¶
关系:独立并发(本文未引用 DSIRM,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇指向完全相同的 root cause。DSIRM 的表述是"无监督量化无法指挥哪些 item 应该共享同一个 SID,因为 item 的相似性本身是 query-dependent 的";CHAP 的表述是"SID 仅由 item 内容导出,造成语义鸿沟,无法把动态 query 意图与静态 item 表示对齐"。两者都把矛头指向 TIGER 系 RQ-VAE 的"item-only 重建"这一条假设。
- 相近的技术骨架:都是"在残差量化里注入 query-item 监督"。DSIRM 用对称 InfoNCE($\mathcal{L}_{q\to i}+\mathcal{L}_{i\to q}$)把 query 与 item 的量化表示拉到一起,外加类目感知的第一层码本;CHAP 用 CSA(对调输入-目标的重建 + 承诺)+ HCL(逐层累积量化对比)+ KL 蒸馏。DSIRM 的 $\mathcal{L}_{\text{commit}}$ 里用的正是"累积到第 $\ell$ 层的部分量化和",与 CHAP 的 HCL 用同一个量($\hat z^{(l)}$)——两队独立想到了同一个逐层对齐的抓手。
- 本文的差异与推进:三处实质分歧。(1) 码本可训练性:DSIRM 的 RQ-VAE 是 query/item 共享且联合训练的;CHAP 冻结 item 码本、只训 query 编码器,理由是防语义漂移——但这也让 item 表示无法被 query 反馈更新(CHAP 自己在 Limitations 里承认)。(2) SID 的角色:DSIRM 明确把 SID 降级为排序侧的一个离散相关性特征($\text{logit}=\mathrm{DNN}(dm, mm\_dm, ct, qs, ss)$),增强而非替代连续表示,query SID 由独立微调的 LLM 生成后做层级前缀匹配;CHAP 保持 SID 为生成目标,走端到端召回。(3) 个性化:DSIRM 完全不建模用户历史,CHAP 的双视图序列建模是其核心组件之一。
- 可比的方法 / 实验差异:两者数据集不重叠(DSIRM 在天猫十亿级生产环境,CHAP 在 ESCI-us / KuaiSearch / PersonalWAB / Local-Life),无法直接比数。线上收益量级差异显著:DSIRM +0.13% UCTR / +0.25% UCTCVR,CHAP +0.77% UV-CTR / +2.09% UV-CXR——但两者作用的漏斗位置不同(DSIRM 改排序特征,CHAP 换召回通路),且基线系统不同,这个对比只能作为量级参考。
CQ-SID CQ-SID: Efficient Generative Retrieval with Semantic Cluster IDs and Expert-Guided RL(Alibaba Tmall, 2026-05-14)¶
关系:显式引用但原文未展开对比(仅 App. A 一句话带过,无方法/指标层比较)· 已加载对方精读
- 共同关注的问题:都是"item-only SID 缺乏 query 感知"+"工业电商搜索召回的延迟预算"这一对约束。CQ-SID 把后者说得更狠:追求 one-item-one-ID 意味着 beam size 必须开到数百才能召回足够多样的商品,直接撑爆 latency 预算。
- 相近的技术骨架:CQ-SID 的 SID 构造与 CHAP 的 HSA 高度同构——RQ-VAE + query-item 双向 InfoNCE(式 4)+ 码本 EMA 更新,只是 CQ-SID 额外把第一层码本按 1711 个类目 bin 强制对齐。
- 本文的差异与推进:降延迟的两条路线完全相反,这是最有信息量的对比。 CQ-SID 主动放弃 SID 唯一性换 beam 效率——语义相近的 item 共享同一 SID("碰撞在亿级库中不是缺陷而是必须的设计选择"),把 beam search 复杂度从 $O(N_{\text{items}})$ 降到 $O(N_{\text{clusters}})$,再用后处理把过大簇随机切分,最终把 beam size 减半以上。CHAP 保持 one-item-one-ID,转而消灭多步解码本身:Decoder 只跑一趟,$L$ 层码交给残差块,且用并行采样彻底替掉 beam search。前者压缩搜索空间,后者压缩解码次数。另外 CQ-SID 用 EG-GRPO 做召回-排序对齐(往 group 里注入 ground-truth SID 缓解稀疏奖励),CHAP 完全不用 RL。
- 可比的方法 / 实验差异:CQ-SID 报告离线 hitrate 相对 RQ-VAE 基线 +26.76%(语义)/ +11.11%(个性化),线上两周 GMV +1.15% / UCTVR +0.40%,且该生成式召回链路贡献了 TmallAPP 全平台 50.25% 曝光 / 58.96% 点击 / 72.63% 购买。CHAP 未报告自身召回链路的流量占比,仅报告增量指标——在"这套 GR 召回到底承接了多少流量"这个更能说明工业成熟度的维度上,CQ-SID 的披露远比 CHAP 完整。
TTP TTP: Think-to-Personalize(USTC + Meituan, 2026-08-19)¶
关系:显式引用但原文未展开对比(Related Work 一句话)· 同一作者团队 · 已加载对方精读
- 共同关注的问题:两篇是同一批人(Angqing Jiang 与 Gaoming Zhang 互为一二作,美团侧 Jianchun Song / Kena Qi / Dayao Chen / Wei Lin 与导师 Defu Lian 完全重合)在同一个业务问题上的两次尝试:美团本地生活搜索里 query 极短且歧义(TTP 报告平均 query 长度只有 6.2~10.1 字符),字面语义无法传达用户潜在个性化意图。TTP 叫它 intent gap,CHAP 叫它 semantic gap——前者强调"意图藏在历史里",后者强调"query 潜空间与 item 量化流形不重合"。问题部分同构:都是 query 侧表达不足,需要外部信号补齐。
- 相近的技术骨架:都把"用户历史 + 当前 query"一起送进编码过程,都做了 query 侧与 item 侧的表示对齐。
- 本文的差异与推进:两条对立的技术路线。 TTP 走稠密检索 + LLM 显式推理:让模型先生成一段被
<think>包裹的 intent-enhanced query,再从<embed>token 抽 embedding,用 GRPO + 检索感知奖励把推理与检索效用对齐(冻结的 SFT 模型同时充当 reference model 与 reward model)。CHAP 走生成式检索 + 离散 SID 对齐:不生成任何文本,直接把 query 编码器的量化路径拉到 item 码本上。TTP 的成本在于 LLM 生成延迟(所以它显式丢弃中间推理步骤、加 length penalty),CHAP 的成本则被 RCG 压到单趟。 - 可比的方法 / 实验差异(值得警惕的一点):两篇用了完全相同的两个公开数据集(KuaiSearch、Amazon-PersonalWAB),但 CHAP 没有把 TTP 列为 baseline,尽管 TTP 早 12 天上线且被 CHAP 引用。按本库已归档的 TTP 数据:PersonalWAB 上 TTP Hit@20 = 0.9017、NDCG@20 = 0.5171;CHAP 报告 R@50 = 0.9416、NDCG@50 = 0.5191(该集单目标,R@K 即 Hit@K)。CHAP 在 2.5 倍大的截断位置上,NDCG 仅高出 0.002。KuaiSearch 上 TTP Recall@20 = 0.1621,CHAP R@50 = 0.2289 / R@10 = 0.0944——同样无法在同一 K 上比较。两篇的数据处理未必一致(TTP 部分实验用自建测试集),所以这只是指示性而非严格对比;但同团队、同数据集、相隔 12 天却互不比较,是一个明显的实证空缺。
8. 讨论与局限性¶
8.1 核心存疑一:「越靠后的转化环节收益越大」,论文没有给出任何解释¶
三个线上数字的量级差异很大:UV-CTR +0.77%、UV-CXR +2.09%、支付单量 +2.98%,越往漏斗深处走,相对提升越大,最深处是最浅处的 3.9 倍。这在个性化搜索里不是理所当然的——通常越靠后的环节被越多召回之外的因素门控(价格、库存、配送时效、商家质量、优惠券),越难推动。
论文对此的全部说明是 §5.5 的一句:
"UV-CTR increased by 0.77%, demonstrating that HSA enhances semantic relevance. Moreover, conversion metrics saw substantial lifts, with UV-CXR rising by 2.09% and Pay Order Volume growing by 2.98%, showing that CHAP not only attracts user clicks but, crucially, accurately captures latent user intent to drive final purchasing decisions."
这是对现象的复述加一句归因断言,不是机制解释。三点具体问题:
- 口径本身不支持"漏斗放大"叙事。 UV-CTR 与 UV-CXR 都是 UV 归一化的(per unique visitor),后者不是"给定点击后的转化率"。因此这三个数不构成嵌套条件链,"点击涨 → 转化涨 → 单量涨"的因果读法无法从这三个数验证;论文却正是这么读的。
- 有一个论文没说但合理的机制假说:CHAP 换的是召回通路,下游排序级联未变。排序器本身就按 CTR 类目标重排,因此召回改动带来的 CTR 增益会被下游"吸收"掉一部分;但候选池整体购买价值的提升无法被 CTR 导向的排序器抵消,于是在转化侧显露得更完整。这与 §6.3 分段结论(HSA 在 ColdStart / LongTail 上贡献最大)也自洽——长尾与新品的召回改善更容易直接兑现为成单。但这是我的推断,论文一字未提,也没有做任何能验证它的实验(比如线上按意图分段的分指标拆解、或"仅换召回 vs 同时调排序"的对照臂)。
- 完全没有线上分段拆解。 离线做了 General / Ambiguous / ColdStart / LongTail 四段的精细分析,线上却只有三个全局数字,没有说明增益是否集中在某个流量切片。若增益主要来自长尾/冷启这类天然高转化意图的切片,那"转化收益更大"就是流量结构效应而非模型质量效应——这个可能性未被排除。
结论:论文没有解释,作为存疑点计入局限。
8.2 核心存疑二:「偏好塑造相关性」的因果方向没有被消融支撑¶
标题 Preference Shapes Relevance 主张的是一个因果塑形关系:用户偏好(preference)会重塑相关性(relevance)的表示空间。按本库"引入新信号 ≠ 收益来源"的判据核验,结论是该主张不成立,理由有四条,一条比一条硬:
(1) 偏好信号从未触碰相关性空间。 HSA 的三个模块——CSA(式 7、8)、HCL(式 9)、Distill(式 10、11)——的所有输入都是 (query $q$, target item $t$) 二元组,没有任何一项包含用户行为序列 $S$。也就是说,论文自己命名的"语义对齐"贡献,做的是 relevance shapes relevance(用 item 侧相关性信号去塑 query 侧相关性表示),偏好完全缺席。偏好只在 §4.2 以 $X_{\text{in}}$ 里的历史 token 形式出现,是喂给序列模型的并列条件输入,不是塑形算子。更关键的是,码本在整个对齐阶段是冻结的——item 的相关性表示在训练中根本不可能被偏好改写。论文自己在 Limitations 里承认了这点:"freezing the item-side codebook ... may also prevent item representations from being dynamically updated with collaborative filtering signals or query-side feedback."
(2) 消融显示三组件是次可加的,交叉项为负。 §6.3 的核算里,四个分段的"单组件增益之和 − Full"全部为 −9~−11 点。若"偏好塑造相关性"成立,应当看到 HSA(相关性侧)与 Sequence Modeling(偏好侧)合用时超可加——1+1>2。实际观察到的是 1+1<2,且 Full ≈ max(单组件) + 5~6 点。论文自己给这个现象的定性词是 "orthogonal strengths"(正交的优势),正交即互不相干,与标题的因果主张直接矛盾。按判据,增益既不来自"偏好塑造相关性"这一机制,也不来自偏好与相关性的正交叉项——它来自两块作用于不同 query 分段的、互相重叠的补丁。
(3) 偏好的贡献从未被单独隔离过。 Table 3 里根本没有 "w/o user history / w/o personalization" 这个变体。唯一的 (B) 类消融是 w/o Dense Refinement,它同时移除了稠密向量(在输入与生成目标两处),而 Figure 4 里的 "+ Sequence Modeling" 柱同样把"引入用户历史"与"引入稠密视图"捆在一起。于是:偏好信号本身的净贡献在全文没有任何一处被测量。而 Table 3 显示 w/o Dense Refinement 是最大的单点跌幅(MRR −32.1%),远大于任何 HSA 变体——很有理由怀疑 "+ Sequence Modeling" 那一大截增益的主体是稠密视图(COBRA 的配方),而非偏好。
(4) 稠密视图是 COBRA 已有的配方。 COBRA(本文的 baseline,Table 2 里四个数据集上的次优)正是"cascaded sparse-dense representations"。CHAP 相对 COBRA 的稠密侧改动是"复用 item 原始表示、不额外生成稠密向量"——一个效率优化,不是表示学习上的新机制。
综合按实际机制贡献重新归因,CHAP 的收益应当拆成三块,都与标题主张无关:
| 实际机制 | 归因 | 是否原创 |
|---|---|---|
| 在冻结码本上对齐 query 编码器(尤以 CSA 的重建锚为主) | 补 ColdStart / LongTail 的表示鸿沟 | 路线拥挤(CQ-SID / DSIRM / MERGE / TSGR 同期都在做),CHAP 的增量是"冻结码本 + 输入-目标对调"这一变体 |
| 保留稠密视图 + 拼接历史 token | 补 Ambiguous 段的意图消歧 | 稠密视图沿用 COBRA;历史拼接是常规做法;两者未被分离测量 |
| 单趟残差级联生成(RCG) | 2 倍 QPS + 13.7% MRR | 本文最扎实的原创贡献,但它与"偏好"和"相关性"都无关,纯粹是解码结构优化 |
一句话:标题应该叫 "Query Shapes Semantic IDs, and One-Pass Decoding Pays the Bill",而不是 "Preference Shapes Relevance"。
8.3 其他局限¶
方法论可扩展性(本库重点关注维度):CHAP 命中了两个明确的扩展性隐患。其一是显式两阶段解耦——RQ-VAE 先在 item 语料上独立预训练 500 epochs,随后码本被冻结,对齐与生成阶段无法反向影响量化器,压缩器与下游模型不可端到端联合优化。其二是核心组件固化——冻结的 $L=3$、$K=512$ 码本一旦定死就上限锁死下游表征空间。这直接决定了参数量 scaling 时"如何表征 item"与"如何建模序列"两条路径不能同步增长:把 T5-base 换成更大骨干,item 侧的离散表征容量一点不变。§6.5 那个"对码本超参异常鲁棒"的卖点其实是同一枚硬币的反面——鲁棒是因为 query 被强行拉到码本上,码本好坏都影响不大,代价是码本的表达能力也就此封顶。
论文自陈的局限(Limitations 章节,写得比多数工业论文诚实):
- 冻结码本虽给出稳定量化流形、防语义漂移,但阻断了 item 表示被协同过滤信号或 query 侧反馈动态更新,在高动态环境下限制个性化上限;
- 双视图序列建模只在 RQ-VAE 风格的层级 SID 上验证过,对词法标识符、learned atomic ID、树结构 SID 的泛化性未系统研究;
- RCG 的加速比在模型规模、码本深度、候选预算扩大时如何演化是开放问题;可能需要对残差生成块做蒸馏进一步压缩。
我补充的问题:
- ESCI-us 的 NDCG@50 数值不自洽(§5 第 4 点):NDCG@50 = 0.2454 ≈ R@50 = 0.2452,而 R@10 仅 0.1127,在多级 NDCG 的位次折损下难以自洽,且这正是全表最大的相对提升(+117.9%)。原文无任何说明。
w/o CSA差于w/o HSA(§6.1 第 2 点):一个子损失被移除后比整个模块被移除还差,论文完全没讨论。这其实是个有价值的机制发现——没有 CSA 的重建锚,HCL + Distill 会把 query 编码器推离 item 流形。- 未与同团队 12 天前的 TTP 做实验对比,尽管两篇共用 KuaiSearch 与 Amazon-PersonalWAB 两个公开集(§7 第三节)。
- Table 2 与 Table 3 的 Local-Life R@50 不一致(0.8085 vs 0.8089)。
- KuaiSearch 上仅 4~6% 的提升与其他三集的 15~118% 形成巨大反差,论文未做任何说明;我的判断是 query-item 配对稀疏限制了 HSA 的监督信号(§5 第 1 点)。
- App. B 的熵定理是空转的:它证明的是条件互信息非负这一教科书结论,排除的只是最朴素的独立分解,对 CHAP 的具体架构选择没有约束力。
8.4 值得借鉴的设计¶
抛开叙事问题,有三件东西是实打实可以拿走的:
- Residual Cascading Generation:把"重历史意图路由"与"层级码生成"解耦,Decoder 单趟 + 轻量残差块级联 + 并行采样替代 beam search。在骨干严格对齐的条件下拿到 2.0~2.4 倍 QPS,且精度不降反升。消融还给出了明确的进一步取舍点——砍掉 Decoder 的 Self-Attention 几乎无损(−2.0% MRR)还能再涨 7.5% QPS,但 Cross-Attention 绝不能动(−21.7% MRR)。
- Cross-Sample Alignment 的"输入-目标对调"技巧:不引入新损失形式,直接把 RQ-VAE 原有的重建/承诺损失的输入与目标互换,就把 query 钉进 item 流形。消融证明它是 HSA 三件套里唯一不可或缺的一件,且没有它时"训不如不训"。
- 逐层 SID 集中度(Figure 8)这个诊断指标:统计相关 item 在每层占据的唯一 SID 前缀数,比 t-SNE/PCA 可视化更定量,比 Silhouette/CH/DB 更贴近生成式检索的实际约束(beam/前缀剪枝效率直接取决于此)。值得作为 SID 质量的常规探针。
8.5 工业落地价值¶
判定为真部署,证据链完整:作者机构含美团(config 已在 companies 列表内);Local-Life 为美团本地生活平台 30 天日志,1014 万 item / 309 万 query;§5.5 报告 14 天、20% 流量的线上 A/B,对照组为"highly optimized online production retrieval system";部署经 NVIDIA Triton 模块解耦,且明确声明"rather than relying on query caching";致谢含 Meituan Research Fund;Ethical Considerations 提到 A/B 在平台标准安全合规协议下进行。可复现性也不错:代码开源(CC BY-NC-SA 4.0,明确禁止直接商用),四个数据集中三个公开且用官方划分。