POEM:偏序增强的实时序列建模召回框架¶
Kuaishou Technology · arXiv 2606.29946 · 2026-06-29 作者:Linxiao Che*, Yijia Sun*, Siyuan Lou, Shanshan Huang, Qiang Luo†, Ruiming Tang†, Han Li†, Kun Gai(* 同等贡献,† 通讯作者)
一句话总结¶
POEM(Partial-Order Enhanced Modeling)把召回阶段长期被忽视的一类信号——下游排序级联在上一次请求里对候选物品打出的多目标实时排序分(CTR/CVR/观看时长)——重新定位为构造召回模型「输入序列」的结构先验:用逆排名加权把多目标分融合成一个统一的偏序,再用分组随机采样把这个偏序「画」成一条动态序列 $S_r$,与传统历史点击序列 $S_h$ 双编码器融合成用户向量,配合「用户反馈正样本 + 系统偏好正样本 + Swing 图硬负样本」的分层目标训练,实现每个请求都能实时刷新的用户兴趣表征。在快手 4 亿日活短视频平台全量上线,人均使用时长在单列 +0.249%、极速版 +0.213%。
1. 研究动机与背景¶
精准、实时地建模用户兴趣,是短视频 feed、电商等信息流平台的核心。SASRec、BERT4Rec 等序列推荐模型用 Transformer/RNN 建模用户历史点击序列中的顺序依赖,已经成为主流。
但作者指出,这类模型与工业推荐流水线之间存在一个根本性的脱节:它们运行在过去点击的静态快照(static snapshot)之上,把推荐系统当作一个被动的「观察者」。而真实的推荐系统是一个主动参与者——它的各级排序阶段持续产出关于用户偏好的丰富、多面的估计(预测 CTR、CVR、观看时长……)。这些排序分形成了一个反映系统当下、上下文感知理解的偏序(partial order)。这份宝贵的监督信号在传统序列建模里基本没有被利用,模型只依赖被观测到的点击——而点击信号稀疏、滞后,且缺乏排序分所固有的细粒度偏好区分度。
由此引出两个关键局限:
- 系统智能的欠利用(Underutilization of System Intelligence):排序级联中蕴含的偏好信息被召回阶段忽略,限制了模型表达力。
- 实时建模的固有延迟(Inherent Latency in Real-Time Modeling):模型依赖新点击来更新它对序列的视图。在快节奏 feed 中,用户兴趣或上下文可能在一次新点击发生之前就已经漂移到了未曾见过的物品上,模型只能停留在一个陈旧的表征。
POEM 的核心论点(core thesis):来自系统的实时排序分本身就可以作为一种强监督信号,去构造输入序列本身,引导模型学到一个映射系统「当下、偏好感知视图」的表征。具体地,对每个用户请求,POEM 不是从用户过去的点击、而是从该用户上一次刷新请求里排名靠前的候选物品出发,按融合后的多目标排序分排序、分组,组内随机采样,得到一条偏序结构序列。一个特殊的 $[CLS]$ token 聚合这条序列形成用户的瞬时兴趣 embedding 用于检索。这样一来,用户表征在每个请求上都会被最新的上下文信号重新评估,即便没有新点击,也能做到请求级的实时建模。
为了从这种新序列范式里有效学习,POEM 还设计了一个互补的分层学习策略:正样本同时取「系统预测的高分物品」与「真实的用户反馈(如长播放视频)」,把学习目标同时对齐系统效率与用户满意;并用一个基于物品图的动态硬负采样进一步增强细粒度偏序学习的判别力。
2. 相关工作与定位¶
-
序列推荐:从 Markov 链、RNN 到 Transformer(SASRec、BERT4Rec),近期的 CL4SRec(对比学习)、MPFormer(异质多任务 Transformer)。建模兴趣演化的 DIN、DIEN、MIMN 设计专门结构捕捉兴趣漂移,SIM 检索长期相关行为——但它们都作用在静态、按时间排序的历史交互上,更新只由新点击触发。POEM 的不同之处:从实时排序分动态构造序列,即便没有新交互也能每个请求刷新用户表征。
-
上下文感知推荐:FM、DeepFM、xDeepFM 把时间/位置/设备等上下文作为辅助特征与用户、物品表征融合;MGSD-WSS 用弱监督信号给历史序列去噪。这些方法把上下文当作要与表征融合的辅助特征。POEM 则把实时多目标排序分当作更本质的、反映意图的上下文,用它来结构性地引导输入序列的构造本身。
-
在召回中利用排序信号:排序分长期是重排阶段的关键,近期被探索为增强早期阶段(如召回)的反馈——直接做监督(采样偏差校正、listwise loss 对齐)、知识蒸馏(把强 ranker 知识迁移到轻量召回模型)、或联合/迭代优化框架(算法集成排序、推理链引导生成、显式纳入实时出价信号、优化跨阶段一致性 COPR)。POEM 的关键区分点在于排序分被「结构性」利用的方式:它不把排序分当作下游监督信号或蒸馏来源,而是把实时排序分隐含的偏序当作结构先验,用来动态拼装输入序列——把排序分的角色从「优化目标」转变为「表征学习的生成式向导」。
定位(Table 1):
| 类别 | 序列输入 | 排序信号的使用 | 更新粒度 |
|---|---|---|---|
| 经典序列模型 | 静态时序交互历史 | 不利用 | 新用户交互时 |
| LTR-informed Retrieval | 静态时序交互历史 | 作为辅助 loss 或监督 | 模型重训 / 微调 |
| POEM(本文) | 交互历史 + 动态偏序序列 | 用于构造输入序列 | 每个用户请求 |
3. 核心方法 / 模型架构¶
POEM 旨在学习一个反映系统当下用户偏好理解的实时用户兴趣表征 $\mathbf{h}_u \in \mathbb{R}^d$,分训练与服务两个阶段。
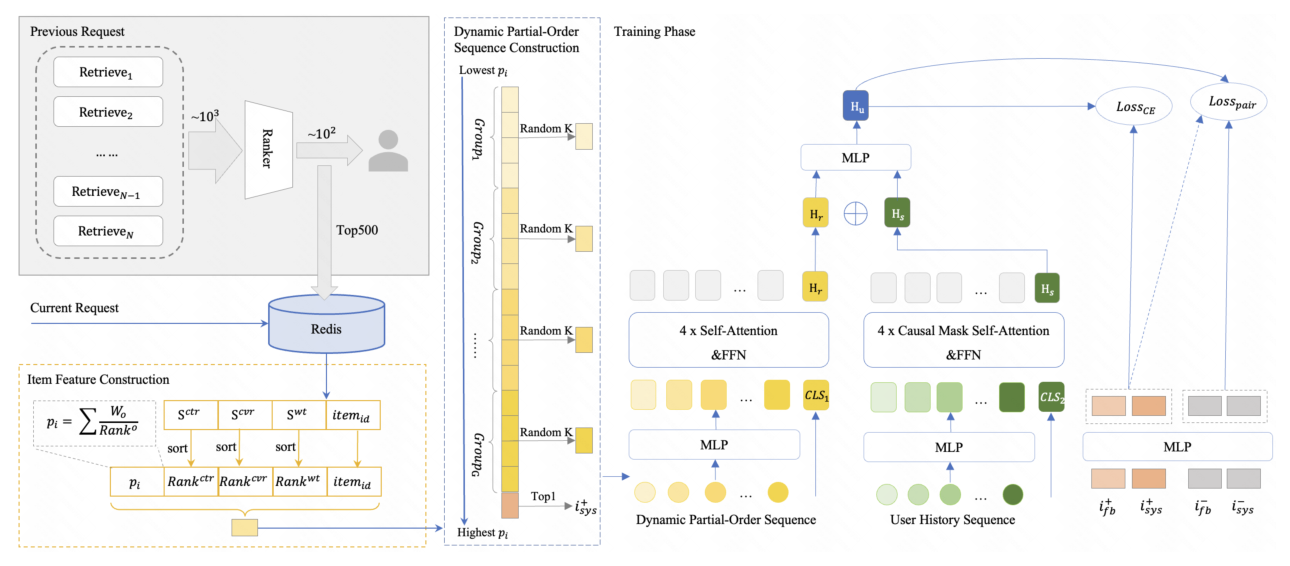
3.1 总体框架¶
- 训练阶段:对每个请求实例,POEM 处理两条互补序列——(1) 历史交互序列 $S_h$(用户过去交互),(2) 从同一用户上一次刷新请求的高排名候选物品构造的动态偏序序列 $S_r$。两条序列由独立的 Transformer 编码器编码,融合表征产生 $\mathbf{h}_u$,由分层目标优化。
- 服务阶段:对每个新请求,从上一次刷新请求的高排名候选构造 $S_r$,与 $S_h$ 一起编码生成 $\mathbf{h}_u$,用于实时 ANN 检索。这一设计保证了训练/服务的时序因果一致性,并让表征始终携带最新的用户兴趣信号。
3.2 动态偏序序列构造(核心创新)¶
$S_r$ 取自用户上一次刷新请求的高排名候选集 $C = \{i_1, i_2, \ldots, i_N\}$(保证训练/服务的时序因果)。对每个物品 $i$,从前置排序阶段拿到多个实时排序分:预测 CTR($s^{ctr}$)、CVR($s^{cvr}$)、观看时长($s^{wt}$),记排序分向量 $\mathbf{s}_i = [s_i^{ctr}, s_i^{cvr}, s_i^{wt}]$。
分数融合与排序。 直接对各目标分做平均不可取——量纲不一致、各目标重要性不同。作者提出基于排名再加权的融合:对每个目标 $o \in \{ctr, cvr, wt\}$,把候选集 $C$ 内所有物品按原始分 $s^o$ 降序排名(rank 1 为最高),记 $\text{rank}^o(i)$;定义每目标效用分为逆排名:
$$s^o(i) = \frac{1}{\text{rank}^o(i)} \tag{1}$$
由于候选集大小固定,$s^o(i)$ 在各目标间共享相同数值范围,无需额外归一化。最终融合分 $p_i$ 为加权组合:
$$p_i = \sum_{o \in \{ctr, cvr, wt\}} w^o \cdot s^o(i) \tag{2}$$
其中 $w^o$ 是目标 $o$ 的权重。候选集 $C$ 按 $p_i$ 排序产生最终偏序排名。
分组与采样。 为在保留偏序的同时兼顾多样性、控制长度,作者把排序列表切成 $G$ 个大小近似相等的连续分组,每组内不放回随机采样 $K$ 个物品,再把第 1 组到第 $G$ 组的采样结果拼接成序列 $S = [i_{(1,1)}, \ldots, i_{(1,K)}, i_{(2,1)}, \ldots, i_{(G,K)}]$。这样序列整体上尊重全局偏序(如 Figure 1 所示,优先级分最高的物品、乃至 Top1 的 $i_{fb}^+$ 落在序列末端、紧邻聚合 token),而组内引入随机性增加多样性、抗过拟合。实现中 $G = 8$、$K = 8$,序列长度 64。
序列表示。 序列中每个物品 $i$ 表示为一个五元组(quintuple):
$$\mathbf{r}_i = \big(\text{rank}^{ctr}(i),\ \text{rank}^{cvr}(i),\ \text{rank}^{wt}(i),\ p_i,\ \text{ID}(i)\big) \tag{3}$$
其中 $\text{ID}(i)$ 是物品唯一标识。为得到稠密 embedding $\mathbf{e}_i \in \mathbb{R}^d$,五元组经一个混合编码层投影——连续特征过线性层、离散 ID 查表后相加:
$$\mathbf{e}_i = \mathbf{W}_{feat} \cdot \big[\text{rank}^{ctr}(i),\ \text{rank}^{cvr}(i),\ \text{rank}^{wt}(i),\ p_i\big]^\top + \mathbf{E}_{embed}(\text{ID}(i)) \tag{4}$$
其中 $\mathbf{W}_{feat} \in \mathbb{R}^{d \times 4}$ 是连续特征的可学习权重,$\mathbf{E}_{embed}$ 是物品 embedding 表。所有嵌入物品构成 $\mathbf{S}_r = [\mathbf{e}_1, \mathbf{e}_2, \ldots, \mathbf{e}_L]$($L = G \times K = 64$),作为后续 Transformer 编码器的输入。这里值得注意的是:物品携带的不是它在该序列中的位置,而是它在系统排序里的三个排名 + 融合优先级分——序列建模的「位置语义」被替换成了「系统偏好语义」。
3.3 双序列用户表征学习¶
POEM 用两条互补序列学习综合用户表征:
- 历史交互序列 $S_h$:定长的近期交互序列,建模长期偏好;每个物品由物品 ID、内容标签、辅助信号等多种特征 embedding 拼接表示。
- 双序列编码:两个独立的 Transformer 编码器——$\text{Encoder}_h$ 处理历史序列、$\text{Encoder}_r$ 处理动态偏序序列,架构配置相同但参数不共享。值得注意的是 Figure 1 中,历史序列编码器用的是 Causal Mask 自注意力(4 层),偏序序列编码器用的是普通(双向)自注意力(4 层)——历史强调时序因果,偏序序列则允许组间全交互。
每个编码器在输入序列末尾追加一个特殊 token 来聚合序列级信息。记两个编码器对应特殊 token 的输出为 $\mathbf{h}_h \in \mathbb{R}^d$ 与 $\mathbf{h}_r \in \mathbb{R}^d$,经拼接后过 MLP 融合为用户表征:
$$\mathbf{h}_u = \text{MLP}\big([\mathbf{h}_h; \mathbf{h}_r]\big) \tag{5}$$
其中 $[\cdot;\cdot]$ 为向量拼接,MLP 为两层线性 + 中间非线性激活。
3.4 分层学习目标(Hierarchical Learning Objective)¶
目标是把用户表征 $\mathbf{h}_u$ 同时对齐「系统偏好」与「真实用户满意」。
正样本(两类):
- 用户反馈正样本 $i_{fb}^+$:候选集 $C$ 中真实曝光且收到正反馈的物品,把学习锚定在真实用户行为上。
- 系统偏好正样本 $i_{sys}^+$:候选集 $C$ 中融合优先级分 $p_i$ 最高的物品,代表系统认为用户最可能正向互动的物品。
$i_{fb}^+$ 稀疏且受选择偏差影响(数据集统计中平均每请求仅 1.2 个 $i_{fb}^+$);$i_{sys}^+$ 则充当来自精排阶段的蒸馏信号,让召回模型「级联感知(cascade-aware)」,生成更可能被下游 ranker 偏好的候选,从而提升整条流水线的最终曝光率。最终正样本集 $\mathcal{P} = \{i_{sys}^+, i_{fb}^+\}$。
Swing 图动态硬负采样。 Batch 内随机负样本往往太「容易」。作者用 Swing 算法离线构建全局物品-物品相似度图 $\mathcal{G}$(捕捉共现模式),对每个正样本 $i^+ \in \mathcal{P}$ 独立检索其在 $\mathcal{G}$ 中的 Top-$M$ 最相似邻居 $\mathcal{N}(i^+, M)$,构造位置条件化的物品到物品负样本对:围绕 $i_{fb}^+$ 挖到 $i_{fb}^-$、围绕 $i_{sys}^+$ 挖到 $i_{sys}^-$,与分层训练结构保持一致。为平衡硬度与多样性采用混合策略:以概率 $\rho$ 选取 $\mathcal{N}(i^+, M)$ 中相似度第三低的物品作为硬负 $i_{hard}^-$,否则从 $\mathcal{N}(i^+, M)$ 随机采。这些负样本「语义相关但在当前上下文中不被偏好」,且对每个训练实例动态挖掘,与具体偏序上下文对齐。
损失函数。 标准交叉熵 + margin-based pairwise loss 构成分层目标:
$$\mathcal{L} = \mathcal{L}_{CE} + \lambda \mathcal{L}_{pair} \tag{6}$$
其中 $\lambda$ 是平衡超参。交叉熵用 in-batch 负样本:
$$\mathcal{L}_{CE} = -\frac{1}{B} \sum_{b=1}^{B} \log \frac{\exp\big(\text{sim}(\mathbf{h}_u^b, \mathbf{e}_{i_b^+}) / \tau\big)}{\sum_{j \in N_b} \exp\big(\text{sim}(\mathbf{h}_u^b, \mathbf{e}_j) / \tau\big)} \tag{7}$$
其中 $\mathbf{h}_u^b$ 是第 $b$ 个实例的用户表征,$i_b^+$ 是从 $\mathcal{P}_b$ 采的正样本,$N_b$ 是该实例的 in-batch 负样本集,$\text{sim}(\cdot,\cdot)$ 为余弦相似度,$\tau$ 为温度;并引入采样偏差校正机制缓解流行度偏差。pairwise loss 显式在正样本与硬负样本之间施加 margin:
$$\mathcal{L}_{pair} = \frac{1}{B} \sum_{b=1}^{B} \max\Big(0,\ \gamma + \text{sim}(\mathbf{h}_u^b, \mathbf{e}_{i_{hard,b}^-}) - \text{sim}(\mathbf{h}_u^b, \mathbf{e}_{i_b^+})\Big) \tag{8}$$
其中 $\gamma > 0$ 为 margin,直接优化模型把正样本与有挑战性的替代项区分开。
3.5 实时服务架构¶
低延迟服务流水线严格遵守时序因果——当前请求的用户表征来自上一次请求的排序信号:
- 输入信号准备:取两类输入——(a) 用户历史交互序列 $S_h$;(b) 用户紧邻的上一次刷新请求里高排名物品及其多目标排序分 $\{s_i\}$,从低延迟缓存(Redis)取。
- 序列编码与推理:由上一次请求信号构造 $S_r$(§3.2),与 $S_h$ 一起编码生成 $\mathbf{h}_u$,针对毫秒级延迟深度优化。
- ANN 检索:以 $\mathbf{h}_u$ 为 query,在覆盖全量物品的预建 ANN 索引上检索最终候选集。
- 反馈闭环:当前请求的候选并行进入下游粗排/精排;所有召回源的最终高排名物品连同分数被缓存,这份缓存正是用户下一次刷新请求构造 $S_r$ 的输入——由此闭合实时适配回路。
4. 实验设置¶
- 数据集:来自全球级短视频推荐平台(4 亿+ 日活、500 亿+ 日交互)的大规模工业数据,取连续 6 天生产日志:前 5 天训练,第 6 天第一个小时测试,以贴合工业系统的实时特性。每个训练/测试实例对应一个用户请求;该请求的候选集(约 1000 物品)由用户上一次请求的高排名结果构成,真实反馈(点击、长播放)作为标签。
Table 3:数据集统计
| 指标(左) | 值 | 指标(右) | 值 |
|---|---|---|---|
| # Users | 108M | # Training Samples | 2.7B |
| # Items | 42M | # 1-hour Test | 13M |
| Avg. Seq. Length | 64 | # 1-day Test | 457M |
| Avg. Pos. $i_{fb}^+$ | 1.2 |
- Baseline:DSSM(经典非序列双塔,静态语义 embedding);SASRec(单向 Transformer 序列模型);CAIN(variant)(原为基于 TCN 做局部上下文建模的排序模型,作者适配到召回——只保留其 TCN 用户编码器,作为强上下文感知基线)。
- 指标:离线 Hit Rate(HR@K)、NDCG@K;在线 A/B。
- 实现:TensorFlow,AdamW,初始学习率 0.001,cosine annealing。Batch size 1024。POEM 的 Transformer 编码器 4 层、隐藏维 128、2 个注意力头。序列构造 $G=8$、$K=8$、长度 64。损失平衡 $\lambda=0.1$、margin $\gamma=0.2$。
5. 主要实验结果(RQ1 & RQ3)¶
Table 2:POEM 与基线在不同时间粒度测试集(1 小时 / 1 天)上的离线对比(相对增益对比各设置下的次优基线)
| Model | 1h HR@50 | 1h NDCG@50 | 1h HR@100 | 1h NDCG@100 | 1d HR@50 | 1d NDCG@50 | 1d HR@100 | 1d NDCG@100 |
|---|---|---|---|---|---|---|---|---|
| DSSM | 0.4703 | 0.1778 | 0.6070 | 0.1999 | 0.3951 | 0.1484 | 0.5132 | 0.1676 |
| SASRec | 0.5267 | 0.2092 | 0.6568 | 0.2303 | 0.4419 | 0.1746 | 0.5547 | 0.1929 |
| CAIN variant | 0.5749 | 0.2371 | 0.7008 | 0.2575 | 0.4700 | 0.1923 | 0.5791 | 0.2100 |
| POEM | 0.6661 | 0.3080 | 0.7725 | 0.3253 | 0.4879 | 0.2100 | 0.5833 | 0.2255 |
| Relative Gain | +15.9% | +29.9% | +10.2% | +26.3% | +3.81% | +9.19% | +0.72% | +7.37% |
结论分析:POEM 在所有指标上全面超越基线。相对优势在 1 小时测试集上远比 1 天测试集明显(1h HR@50 +15.9%、NDCG@50 +29.9%;1d 仅 +3.81% / +9.19%)。原因正是 $S_r$ 由前一次请求的高排名候选构造,对用户兴趣、内容、排序策略的实时漂移高度敏感——短窗评测能贴近系统当下状态,而天级评测跨越更长时段,期间推荐逻辑与用户分布漂移,稀释了信号精度。这恰好反向印证了 POEM 的卖点是「实时性」而非泛化记忆。
Table 4:POEM vs CAIN variant 在不同时间间隔上的细粒度时间性能(HR@50)
| Interval | POEM | CAIN Variant | Relative gain |
|---|---|---|---|
| [1h, 2h] | 0.6661 | 0.5749 | +15.9% |
| [2h, 4h] | 0.6259 | 0.5757 | +8.72% |
| [4h, 8h] | 0.5732 | 0.5239 | +9.35% |
| [8h, 12h] | 0.5376 | 0.4999 | +7.55% |
| [12h, 24h] | 0.4801 | 0.4694 | +2.29% |
随时间间隔增大,增益总体下降——缓存的排序信号与当前排序策略、用户兴趣分布越来越不对齐。[2h,4h] 与 [4h,8h] 之间的小波动归因于统计噪声。这直接量化了 POEM 实时适配能力是其优势的关键驱动,尤其在短延迟窗内。
Table 5:在线 A/B 结果(部署于快手主短视频平台,7 天 A/B;处理组 5% 流量用 POEM,对照组 5% 流量用生产模型 Kuaiformer;均统计显著)
| 应用场景 | 总 App 使用时长 | 人均使用时长 | 视频观看时长 |
|---|---|---|---|
| KS 单列(Single Page) | +0.254% | +0.249% | +0.237% |
| KS 极速版(Lite Page) | +0.158% | +0.213% | +0.335% |
6. 消融与分析(RQ2)¶
6.1 序列组成的影响(Table 6)¶
| Variant | HR@50 | NDCG@50 | HR@100 | NDCG@100 |
|---|---|---|---|---|
| Hist-Only | 0.5808 | 0.2531 | 0.6971 | 0.2720 |
| RankSig-Only | 0.6511 | 0.3238 | 0.7456 | 0.3391 |
| POEM(Hybrid) | 0.6661 | 0.3079 | 0.7725 | 0.3253 |
- Hist-Only(仅历史序列 $S_h$,类似 SASRec)线上收益最差——单次请求周期内「静态」,无法纳入上一次请求的细粒度排序信号。
- RankSig-Only(仅动态偏序序列 $S_r$)在离线和线上都显著优于 Hist-Only——候选的偏序蕴含丰富的实时「相对偏好」信息,对召回-排序对齐(Cascade Awareness)更关键。
- 融合的权衡(Fusion Trade-off):RankSig-Only 通过紧密模仿下游 ranker 偏好取得最高 NDCG(0.3238 / 0.3391),但 POEM 在 HR@50 与 HR@100 上更优。作者解释:融合历史交互锚定用户内在偏好,排序信号把 embedding 引向当前候选池——从而把召回覆盖拓宽到纯 ranker 模仿者达不到的范围。换言之,纯模仿 ranker 排得更准(NDCG 高)但召得更窄(HR 低),混合才是召回阶段更想要的。
6.2 分层学习目标的有效性(Table 7)¶
| Strategy | HR@50 | NDCG@50 | Online Gain | Delivery Rate |
|---|---|---|---|---|
| Only-FB | 0.5661 | 0.2434 | +0.161% | 1.052% |
| Only-Sys | 0.5966 | 0.2637 | +0.132% | 1.472% |
| w/o Hard-Neg | 0.6154 | 0.2774 | - | - |
| Dual-Pos(POEM) | 0.6661 | 0.3079 | +0.254% | 1.845% |
- Only-FB 的局限:$i_{fb}^+$ 是真实用户满意信号,但有严重选择偏差与稀疏性。它源自已曝光且被点击的物品,单靠它训练会让召回过拟合历史曝光策略,捕到高点击率但低多目标效用(如短观看时长)的物品,随后被下游 ranker 过滤——表现为最低的 Delivery Rate(1.052%),与整体系统目标对齐差。
- Only-Sys 的作用:纳入 $i_{sys}^+$ 提供级联感知,蒸馏排序阶段的多目标知识,虽略偏离原始点击,却显著提升 Delivery Efficiency(1.472%)与线上收益——证明与 ranker 对齐对候选「存活」至关重要。
- 硬负挖掘的影响:把硬负换成随机负(w/o Hard-Neg)使 HR@50 从 0.6661 跌到 0.6154、NDCG@50 同步下降。说明在全球级系统里随机负样本太「容易」、梯度信息不足;用 Swing 图挖掘语义相关但未交互的负样本,能在拥挤候选池里学到更精确的决策边界。
6.3 信号融合机制(Table 8)¶
三类排序信号——CTR(有效观看,观看时长超过阈值 A)、CVR(长观看,观看时长超过 B>A)、WT(原始观看时长)——五种融合策略对比:
| Variant | HR@50 | NDCG@50 | HR@100 | NDCG@100 |
|---|---|---|---|---|
| Single-CTR | 0.5690 | 0.2452 | 0.6891 | 0.2647 |
| Single-CVR | 0.5579 | 0.1781 | 0.6796 | 0.2348 |
| Single-WT | 0.5820 | 0.2507 | 0.6987 | 0.2697 |
| Multi-Avg | 0.5224 | 0.2257 | 0.6353 | 0.2440 |
| Multi-Rank(POEM) | 0.6661 | 0.3079 | 0.7725 | 0.3253 |
关键观察:简单平均(Multi-Avg, HR@50 0.5224)甚至劣于任意单信号(如 Single-WT 0.5820)——因为各目标量纲不齐、重要性不同,直接平均反而互相污染。这强有力地证明了 POEM 用逆排名再加权(Eq 1-2)处理量纲错配与目标重要性差异的必要性。
7. 案例研究¶
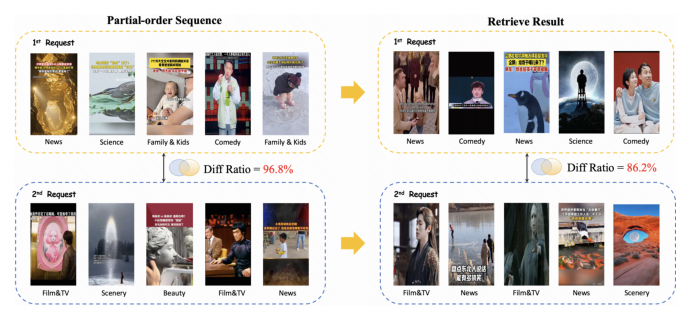
作者可视化了一个典型用户在两次连续刷新请求间构造的偏序序列。即便这段间隔内没有任何新点击,输入偏序序列 $S_r$ 的序列差异比(sequence diff ratio)仍高达 96.8%——这一变化由「演化的候选池 × 自适应采样策略」共同驱动,捕捉了前置排序阶段的最新信号。$S_r$ 的这一漂移有效地在向量空间「转向(steers)」了用户 embedding $\mathbf{h}_u$,导致最终检索结果有 86.2% 的差异,并捕捉到用户从「喜剧」到「影视」的细微兴趣迁移。这证明 POEM 即便在用户「被动」期也能跟上系统对用户的最新理解,而 SASRec 等静态序列模型在同样的无点击间隔内只会输出完全相同的结果。
8. 核心贡献总结¶
- 偏序引导的序列构造范式:用动态分组采样的偏序序列增广传统时序序列,基于实时排序分,实现请求级的兴趣重评估。
- 多目标信号融合机制:通过逆排名再加权把异质排序信号统一进一个五元组表示,解决量纲错配与目标重要性差异。
- 分层样本学习策略:把「系统偏好(top-ranked)」与「用户反馈(如长播放)」一并作为正样本,配合 Swing 图硬负样本与 margin-based pairwise loss,对齐系统预测与真实用户满意。
- 工业落地:在快手 4 亿日活平台端到端实现并全量上线,人均使用时长 +0.249% / +0.213%。
与已归档相关工作的对比¶
IID-Nav IID-Nav:From Extraction to Navigation(Kuaishou,2026-06-29)¶
关系:独立并发(同一团队同日的姊妹工作,两文互不引用,殊途同归)· 已加载对方精读
- 共同关注的问题:两文都攻击工业召回阶段被「单次请求的静态快照」范式锁死这一 root cause——召回与下游级联脱节、无法跟随实时意图。POEM 表述为「系统智能欠利用 + 实时建模延迟」;IID-Nav 表述为「单请求跳数/延迟上限造成的兴趣隧道 + 搜索漂移」。两者作者高度重叠(Linxiao Che、Yijia Sun、Shanshan Huang、Qiang Luo、Ruiming Tang、Han Li、Kun Gai 均同时署名)。
- 相近的技术骨架:(1) 跨请求状态接力——POEM 用 Redis 缓存上一次请求的高排名候选 + 排序分来构造 $S_r$,IID-Nav 用 Redis 缓存导航搜索状态实现「间接无限深度」,两者都靠 Redis 把单请求物理预算沿时间轴累积;(2) Swing 图 + 图硬负采样——双方都用 Swing 构图、都用「拓扑邻近但意图不相似」的图硬负样本对抗困难判别;(3) CE/InfoNCE + margin-based pairwise 的双目标损失结构几乎同构(POEM 的 Eq 6-8 与 IID-Nav 的 InfoNCE+PW 一一对应);(4) 都把下游排序判别力注入召回(POEM 用系统偏好正样本蒸馏,IID-Nav 用 target-aware 判别器路由)。
- 本文的差异与推进:POEM 改的是召回模型的输入序列(保留 embedding/双塔 + ANN 检索,只把排序分做成偏序序列喂进去),IID-Nav 改的是检索过程本身(用非双塔判别器在物品图上主动多跳导航,替代一次性 ANN 内积)。POEM 的跨请求接力传的是候选的排序分、目标是「每请求刷新兴趣」;IID-Nav 传的是导航前沿状态、目标是「沿时间累积探索深度」。一句话:同一团队在「打破单请求静态召回」这条主线上,POEM 走「序列输入侧」、IID-Nav 走「检索过程侧」。
- 可比的实验差异:两文都只在快手亿级工业数据上评测、都报告 HR/Recall 与使用时长正收益,但口径不同(POEM 报 HR@50/NDCG@50 与 +0.249% 人均时长;IID-Nav 报 Recall@500 +36.35%),无法直接数值对齐,互为「同问题不同解法」的并发参照而非 baseline 关系。
CS3 CS3:Efficient Online Capability Synergy(Kuaishou,2026-04-21)¶
关系:独立并发(问题同构、解法家族不同;POEM 未引用 CS3)· 已加载对方精读
- 共同关注的问题:两文共享 POEM 三大局限里的同一条——召回塔与下游精排存在结构鸿沟、排序级联的知识没有传到召回。CS3 把它明确列为「跨阶段一致性差」,POEM 称之为「系统智能欠利用」。都在快手广告/推荐召回场景、都强调在线学习/实时约束下解决。
- 相近的技术骨架:双方核心动作都是「把下游排序级联的知识导入召回」。CS3 的 Cascade-Model Sharing(CMS) 用 EMA 缓存下游 cascade 排序模型的中间表示 $s_u, s_v$ 注入双塔输入;POEM 用系统偏好正样本 $i_{sys}^+$(融合排序分最高的物品)把 ranker 偏好蒸馏进召回表征。两者都不重训 teacher、都走轻量旁路、都对齐召回与精排的「相关性假设空间」。
- 本文的差异与推进:CS3 导入的是排序模型的隐表征(EMA 缓存的 hidden),作为额外特征注入双塔 FC 输入,配合塔内自修正(CAS)、跨塔同步(CTS)三模块协同;POEM 导入的是排序的多目标分数,用来构造偏序输入序列 + 选正样本。即同一目标(cascade-aware 召回)下,CS3 是「表征注入/能力协同」路线、POEM 是「排序分构造序列 + 样本级蒸馏」路线。此外 POEM 多了一条 IID-Nav 也有的「实时性」叙事(每请求刷新),而 CS3 的重点是双塔在在线学习下的对齐稳定与跨阶段一致,不强调请求级实时漂移。两者方法骨架虽不同,但放在一起恰好勾勒出快手在「让召回吸收级联智能」上的两条互补技术路径。
被剔除的近似候选(门槛对照):
- UniPinRec(2606.00422, Pinterest):同样想弥合召回-排序,但解法是全栈架构统一(共享 backbone + Masked Action Modeling + KV-cache 复用),是「一个模型两阶段」,与 POEM「保留两塔召回、只喂级联信号」的解法家族不同 → 剔除。
- GrowthGR(2605.17994, Taobao):reward 融合了 cascade 信号(曝光/点击/购买),但问题是新品冷启动增长、解法是 GRPO 多值奖励的生成式检索,仅共享「cascade 信号」关键词,问题与解法均偏离 → 剔除。
- DIG(2605.14853, Meituan):让排序 BCE loss 驱动 SID 码本、一个模型同时服务排序与检索,确实「用排序信号改进检索」,但走的是生成式 SID/码本路线,与 POEM 的偏序序列 + ANN 召回解法骨架实质偏离 → 剔除。
9. 讨论与局限性¶
值得借鉴的设计:POEM 最有价值的 insight 是把「排序分」从优化目标/蒸馏来源,重新定义为构造召回输入序列的结构先验——序列建模里物品的「位置语义」被替换成「系统偏好语义」(三个排名 + 融合分),从而即便没有新点击也能请求级刷新用户兴趣。逆排名再加权(Eq 1-2)是一个朴素却有效的多目标融合 trick,消融里简单平均甚至劣于单信号,凸显量纲对齐的重要性。系统偏好正样本 $i_{sys}^+$ 把 Delivery Rate 从 1.052%(Only-FB)提到 1.845%,是「级联感知」最直接的工业证据。
局限与争议:
- 强级联耦合:$S_r$ 完全依赖上一次请求缓存的排序分,一旦上游排序策略变更、或排序分有噪声/偏差,召回会被直接带偏;作者也把「对噪声排序信号的鲁棒性」列为未来工作。这也意味着 POEM 难以离线复现——它的收益本质来自在线级联的实时反馈闭环。
- 评测口径有限:仅在快手单一工业数据集评测,baseline 只有 DSSM/SASRec/CAIN 三个,缺少与近期强序列召回(如 HSTU、Kuaiformer 的离线对比)正面较量;线上增益虽显著但绝对幅度温和(+0.21%~0.25%)。
- 形式化略粗糙:preprint 带占位会议模板,部分公式未给完整推导(如 Eq 4 的混合编码层、Eq 2 后「升序/降序」与 Figure 1 的分组方向存在表述张力,需以图为准)。
- 可扩展性:方法不含「先压缩再建模」式的两阶段瓶颈,双编码器随 Transformer 自然 scaling;但硬负样本依赖离线冻结的 Swing 图,码本/图一旦固化会限制硬负质量,且偏序序列长度固定为 64、组数 8,scaling 时「如何表征系统偏好」与「如何建模序列」两条路径能否同步增长尚未验证。
总体上,POEM 是一篇 insight 清晰、有真实全量 A/B 的扎实工业工作:它把召回从「读用户点击」升级为「读系统对用户的实时判断」,与同团队同日的 IID-Nav(改检索过程)、以及更早的 CS3(注入排序表征)共同构成快手「让召回吸收级联智能」的一组互补探索。