PIT-SUN:用经验边际变换 + 期望一致恢复实现推荐回归的可部署校准框架
Mingyu Zhao(Renmin University of China,快手实习期间工作)、Zhaohan Li、Zhenxiong Miao、Xu Zhang、Dewei Leng、Yanan Niu、Kun Gai(Kuaishou Technology),arXiv 2607.08202,2026-07-09。
研究动机与背景
值驱动推荐里的回归目标
现代推荐系统的优化目标正从 CTR 这类二值即时信号,转向以连续业务价值为核心的回归目标——观看时长(dwell time / watch time)、GMV、LTV(用户生命周期价值)。这些目标直接支撑排序、流量分配与多目标决策:观看时长度量用户对内容的沉浸程度,GMV / LTV 支撑价值驱动的营销与预算分配。准确估计这些目标的原始空间条件期望 $\mathbb{E}[Y\mid X=x]$ 是值驱动推荐的核心任务。
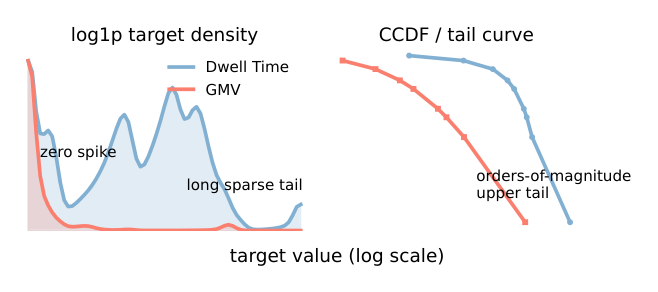
问题在于:这些目标的边际分布又稀疏、又重尾、又多峰、又受上下文调制。观看时长长尾(大量快速划走 + 少量深度观看),GMV 更是既零膨胀(大量零购买)又极端重尾(少量高额订单,尾部跨越数个数量级)。论文的 Figure 3 用匿名工业诊断直观展示了这一点:Dwell Time 是长尾但尾部相对连续,GMV 则更稀疏、更集中在尾部(零峰 + 长稀疏尾)。
稳定性 vs 期望一致性的两难(Regression Dilemma)
设 $X\in\mathcal{X}$ 为特征向量,$Y\in\mathbb{R}_{\ge 0}$ 为非负目标,原始空间条件期望记 $m(x):=\mathbb{E}[Y\mid X=x]$。论文把回归的根本困境凝练为一句话:
- 原始空间 MSE:统计上与 $m(x)$ 对齐($m(x)$ 就是 MSE 的贝叶斯最优解),但梯度在有限样本下不稳定——重尾、零膨胀、多峰的标签让梯度被极端大值或零平台主导,出现「均值坍缩」(mean collapse)或「尾部收缩」(tail shrinkage),正确的目标反而难以可靠优化。
- 变换空间学习:对目标做单调变换 $T$(log / sqrt / Box-Cox),把标签压到一个良态坐标系里,梯度稳定了——但直接逆变换恢复期望会引入偏差(retransformation bias):$T^{-1}(\mathbb{E}[T(Y)\mid x]) \ne m(x)$。
这不是实现层面的疏忽,而是结构性的:论文指出,如果直接逆变换要对所有条件分布都保持期望一致,$T^{-1}$ 必须是仿射(affine)的——这就排除了任何非线性的尾部压缩。换言之,「良态坐标」和「无偏恢复」这两个诉求在单个标量变换里天然冲突。既有的期望恢复方法(TranSUN / GTS)虽然恢复了期望一致性,却仍然依赖人工选择变换后的目标和恢复基(recovery base)。
缺失的东西:一个可部署的「闭包」
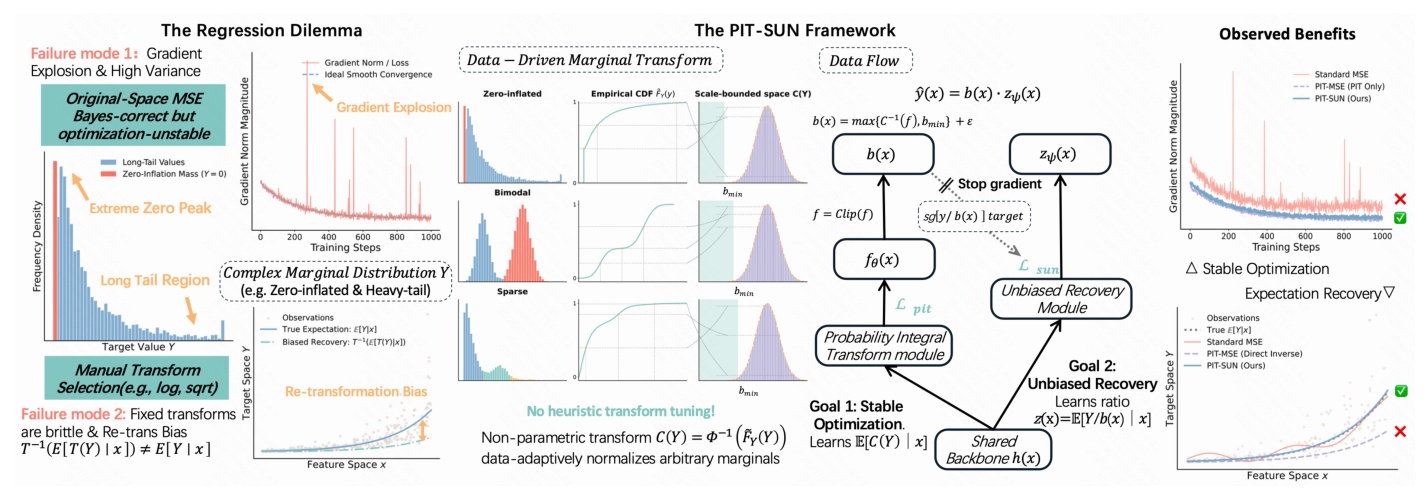
论文的核心论点是:真正缺的不是「又一个标量变换」,而是一个可部署的经验边际恢复闭包(deployable empirical marginal recovery closure)——由一张经验边际表(empirical marginal table)同时定义四件事:稳定坐标、逆查找、恢复基、以及漂移监控(drift monitor),并保持 $m(x)=\mathbb{E}[Y\mid x]$。这解释了为什么标准变换、纯 PIT 预测、以及人工变换恢复三者各自都不完整。作者用 Probability-Integral-TranSformed Unbiased recovery(PIT-SUN) 来实例化这个闭包,框架概览见 Figure 1。
主要贡献
- 不可能性引导的形式化(Impossibility-guided formulation):证明非线性稳定坐标不可能通过直接逆变换普遍保持期望一致,从而论证需要的是「坐标–基–恢复」三位一体的闭包,而不是又一个标量变换。
- PIT-SUN 闭包:用一张 CDF 表定义 PIT 坐标、逆查找、逆分位恢复基、以及漂移监控;带 lower-bound 稳定化和 stop-gradient 隔离。
- 经验验证:在合成分布、公开基准、大规模工业离线与在线场景验证 PIT-SUN,并用 PIT-TranSUN 和各组件诊断隔离「为什么必须要完整闭包」。
核心方法:PIT-SUN 框架
PIT-SUN 由两个分支耦合而成:经验 PIT 分支(把任意边际映到一个尺度有界的正态分数坐标,供表征学习用)和 SUN 恢复分支(把学到的坐标映回原始空间条件期望)。两者通过一张共享的经验 CDF 表联系,并用 stop-gradient 隔离梯度。
变换 MSE 的一般化困境(Preliminaries)
对单调变换 $T$,变换后的 MSE 目标为:
$$\mathcal{L}_{T\text{-MSE}} = \mathbb{E}_{(x,y)}\big[(f(x)-T(y))^2\big] \tag{1}$$
其总体最优解是:
$$f_T^*(x) = \mathbb{E}[T(Y)\mid x] \tag{2}$$
这能产生一个条件良态得多的学习坐标,但直接逆变换给出的是 $T^{-1}(f_T^*(x))$ 而非 $m(x)$。困境的本质不是 log / sqrt / PIT 的具体选择,而是非线性压缩会改变被估计的期望。因此原始尺度有正确目标但优化不稳,变换尺度有稳定坐标但恢复有偏。
条件线性恢复(Conditionally Linear Recovery)
基于恢复的方法通过让最后一步在 $Y$ 上条件线性来解决期望这一侧。给定学到的表征 $f_T(x)$ 和一个条件于 $x$ 固定的正基函数 $b(x)$,恢复分支学一个比例目标 $z(x)\approx \mathbb{E}[\frac{Y}{b(x)}\mid x]$,最终预测:
$$\hat y(x) = z(x)\,b(x) \tag{3}$$
于是在总体最优点 $\hat y(x)=m(x)$。这一原理说明:不放弃良态学习坐标,也能恢复期望一致性。但它没有指定该学哪个坐标、用哪个基 $b(x)$——而这些选择恰恰决定了在稀疏、重尾边际下恢复是否数值稳定。PIT-SUN 因此把坐标和恢复基当作一个耦合的设计问题,从一张经验边际表里同时导出,并加上部署所需的稳定化。
经验 PIT:尺度有界的学习坐标
经验 PIT 分支用一个数据驱动的坐标替换人工解析变换。设 $\hat F_Y$ 为经验 CDF,$\Phi$ 为标准正态 CDF,$\delta$ 为边界裁剪概率。定义:
$$\bar F_Y(y) = \text{clip}\big(\hat F_Y(y),\,\delta,\,1-\delta\big),\qquad C(y) = \Phi^{-1}\big(\bar F_Y(y)\big) \tag{4}$$
其广义逆由经验分位表实现:
$$C^{-1}(w) = \hat F_Y^{-1}\big(\Phi(w)\big) \tag{5}$$
PIT 分支 $f_\theta(x)$ 用如下损失训练:
$$\mathcal{L}_{\text{PIT}} = \mathbb{E}_{(x,y)}\big[(f_\theta(x) - C(y))^2\big] \tag{6}$$
这一模块直接对付第一个回归困难:不管原始目标尺度如何,裁剪后的 PIT 满足 $|C(Y)|\le a_\delta = \Phi^{-1}(1-\delta)$,把重尾振幅折进有界的正态分数坐标里,同时保持边际序(marginal order)。这就是「尺度有界学习空间」。
逆分位基与 SUN 恢复
PIT 分支本身不作最终预测,因为 $C^{-1}(\mathbb{E}[C(Y)\mid x])$ 仍然是 $m(x)$ 的有偏估计(这是后面 Theorem 2 的核心结论)。取而代之,把预测的 PIT 坐标转成一个原始尺度的恢复基。令 $\bar f(x)=\text{clip}(f_\theta(x),-a_\delta,a_\delta)$:
$$b(x) = \max\Big(C^{-1}(\bar f(x)),\,b_{\min}\Big) + \varepsilon \tag{7}$$
这个逆分位基弥合了稳定 PIT 坐标和原始业务尺度之间的鸿沟。它是一个条件化的装置,不是又一个变换:它把学到的边际排名映射成一个原始尺度的分母,而 $b_{\min}$(正目标的 $q_b$ 分位)防止零平台上的分母坍缩、控制恢复标签方差。
SUN 恢复分支在梯度隔离下学比例目标:
$$\mathcal{L}_{\text{SUN}} = \mathbb{E}_{(x,y)}\Big[\big(z_\psi(x) - \tfrac{y}{\text{sg}[b(x)]}\big)^2\Big] \tag{8}$$
其中 $\text{sg}[\cdot]$ 表示 stop-gradient。实现时停掉分母路径的梯度:比例标签取 $r = y/\text{sg}[b(x)]$,恢复损失不回传穿过逆分位查找、裁剪、$b_{\min}$ floor,只有比例头 $z_\psi$ 可训练。这一分支对付第二个回归困难:在恢复一条到 $m(x)$ 的条件线性路径的同时,防止高方差的比例标签污染 PIT 几何。若没有这层隔离,高方差比例残差会通过分母路径扭曲 PIT 坐标,加大后面 Theorem 3 分析的联合训练间隙。
训练与推理
完整目标为:
$$\mathcal{L}_{\text{PIT-SUN}} = \mathcal{L}_{\text{PIT}} + \lambda\,\mathcal{L}_{\text{SUN}} \tag{9}$$
推理时,把学到的恢复比例乘上逆分位基:
$$\hat y(x) = z_\psi(x)\,b(x) \tag{10}$$
对非负目标,比例头用非负输出链接(softplus 或 clipped ReLU),保证 $\hat y(x)\ge 0$。整个估计器同时保留了原始空间 MSE 的期望目标(贝叶斯目标是 $m(x)$)和优化收益(有界坐标)。部署开销仅限于一张滑动窗口分位表加两个轻量回归头。完整流程见 Algorithm 1:
Algorithm 1: PIT-SUN 训练与推理
输入:训练数据 {(x_i,y_i)},测试数据 X_test,裁剪概率 δ,分位数 q_b,权重 λ
 1. 从 {y_i} 构造经验 CDF  \hat F_Y
 2. 定义  C(y) = Φ^{-1}(clip(\hat F_Y(y), δ, 1-δ))
 3. 构造逆查找表  C^{-1}(w) = \hat F_Y^{-1}(Φ(w))
 4. 设  b_min 为正目标的 q_b 分位
 5. for 每个 minibatch (x,y) do
 6.    c ← C(y)
 7.    f ← f_θ(x),   \bar f ← clip(f, -a_δ, a_δ)
 8.    b ← max(C^{-1}(\bar f), b_min) + ε      {全程使用 floor 约定}
 9.    r ← y / sg[b]                            {只停基/查找路径梯度}
10.    L_PIT ← ||f - c||²,   L_SUN ← ||z_ψ(x) - r||²
11.    最小化  L_PIT + λ L_SUN  更新 θ, ψ
12. end for
13. 推理(x ∈ X_test):
14.    f ← f_θ(x),  \bar f ← clip(f, -a_δ, a_δ)
15.    b ← max(C^{-1}(\bar f), b_min) + ε
16.    return  \hat y = z_ψ(x) · b
稀疏与并列目标的处理(Ties & Zero-inflation)
GMV 目标里重复零值和并列(ties)很常见。PIT-SUN 用一个广义 PIT 处理这些原子(atoms):
$$\bar F_Y(y) = \hat F_Y(y^-) + \rho\big(\hat F_Y(y) - \hat F_Y(y^-)\big),\quad \rho\in[0,1] \tag{11}$$
默认用确定性 mid-rank($\rho=0.5$),仅在可选的 tie-breaking 变体里用随机 rank。这让稀疏目标落在稳定的分位区间内,而不需要手工平滑变换。对极端零膨胀,用 PIT-SUN-ZI 变体:一个 hurdle 分支估计 $P(Y>0\mid x)$,另一个 SUN 分支在正样本上估计 $\mathbb{E}[Y\mid x, Y>0]$,最终预测 $\hat y(x)=P(Y>0\mid x)\,\mathbb{E}[Y\mid x, Y>0]$(对应正文式 (39))。
理论证明(Theoretical Justification)
论文给出四条主要结论和两个推论,形式化地论证「为什么完整闭包是必需的」。
Theorem 1(不可能有非线性直接逆)
设 $T$ 在包含 $Y\mid x$ 支撑的区间 $\mathcal{I}$ 上严格单调,$g=T^{-1}$ 可测且局部有界。若直接逆满足
$$g\big(\mathbb{E}[T(Y)\mid x]\big) = \mathbb{E}[Y\mid x] \tag{12}$$
对每个在 $\mathcal{I}$ 上有有限均值的条件分布 $Y\mid x$ 都成立,则 $g$ 必须在 $T(Y)$ 支撑的每个凸子区间上是仿射的。
这条定理确立了:任何非线性尾部压缩变换本质上都损失了普遍期望一致性,因而必须有一条独立的恢复路径。证明见附录 A.1,用 Jensen-affine 论证:仿射函数在每条弦上保持期望,而可测局部有界的 Jensen-affine 函数就是仿射。
Theorem 2 与 Corollary 1(纯 PIT 逆是有偏的)
设 $C_0(y)=\Phi^{-1}(F_Y(y))$ 为未裁剪的连续 PIT 映射,$\mu_C = \mathbb{E}[C_0(Y)\mid x]$。在局部二阶可微下,PIT-MSE 得到 $f^*(x)=\mu_C$。直接逆的偏差由二阶 Taylor 展开给出:
$$m(x) - C_0^{-1}(\mu_C) = \tfrac{1}{2}(C_0^{-1})''(\mu_C)\,\text{Var}\big(C_0(Y)\mid x\big) + R_3(x) \tag{13}$$
局部曲率 $(C_0^{-1})''$ 决定系统误差方向。Corollary 1(裁剪经验 PIT 误差分解)进一步说明:对基于经验 $\hat F_Y$ 的裁剪经验映射 $C_\delta$,逆关系 $C_\delta^{-1}(C_\delta(Y))=Y$ 只在内部成立;总的经验逆误差被 DKW 一致误差 $\eta$、分位函数的局部 Lipschitz 常数 $L_Q$、加上边界裁剪质量 $\alpha_\delta$ 和并列原子质量控制。这些局部常数在零峰和重尾附近会变得极端,使得任何在裸查找表上的直接逆结构上不可靠——这就是 SUN 恢复分支必需的形式化理由。
Theorem 3(固定基 SUN 恢复)
设 $\text{Var}(Y\mid x)<\infty$。若 $b(x)>0$ 条件于 $x$ 固定,则 SUN 分支估计器恰好恢复贝叶斯目标:
$$z^*(x) = \frac{m(x)}{b(x)},\qquad \hat y^*(x) = z^*(x)\,b(x) = m(x) \tag{14}$$
在联合优化里,stop-gradient 算子强制 $r = y/\text{sg}[b(x)]$,为恢复损失保留了这个固定基性质。
Proposition 1(有限样本条件化 via $b_{\min}$)
在 $b(x)=\max(C^{-1}(\bar f(x)), b_{\min})+\varepsilon$ 的定义下,恢复标签 $R_b = Y/b(x)$ 满足:
$$\text{Var}(R_b\mid x) \le \frac{\text{Var}(Y\mid x)}{(b_{\min}+\varepsilon)^2} \tag{15}$$
此外输出裁剪强制 $|f(x)|\le a_f$ 和 $|C_\delta(Y)|\le a_\delta$,一致地界住每个 PIT-MSE 样本梯度。这说明 $b_{\min}$ 和裁剪不是任意启发式,而是在零膨胀区严格控制方差、在重尾区防止梯度爆炸的机制。
与 TranSUN/GTS 的定位对比
论文用 Table 1 和 Table 7 把 PIT-SUN 放在变换恢复方法谱系里:
| Method | 坐标来源 (Coord. source) | 恢复路径 (Recovery path) | 部署对象 (Deploy. object) | 问题 (Issue) |
|---|---|---|---|---|
| T-MSE | 人工 $T$ | 无(直接逆 $T^{-1}(\mathbb{E}[T(Y)\|x])$) | 变换规则 | 有偏 |
| TranSUN | 人工 $T$ | 条件线性 | $T$ + 基 | 人工选择 |
| PIT-MSE | 经验 CDF | 直接逆 $C^{-1}(\mathbb{E}[C(Y)\|x])$ | CDF 表 | 有偏 |
| PIT-SUN | 经验 CDF | SUN + 逆分位 | 共享 CDF 表 | CDF 刷新 |
核心差异:T-MSE 和 PIT-MSE 都有稳定学习目标但直接逆有偏;TranSUN/GTS 通过条件线性恢复了期望一致性,但常数依赖人工选择的变换。PIT-SUN 保留同样的恢复原理,但坐标和基都从经验边际分布导出,唯一的运维负担是 CDF 刷新(drift)。
实验设置
数据集
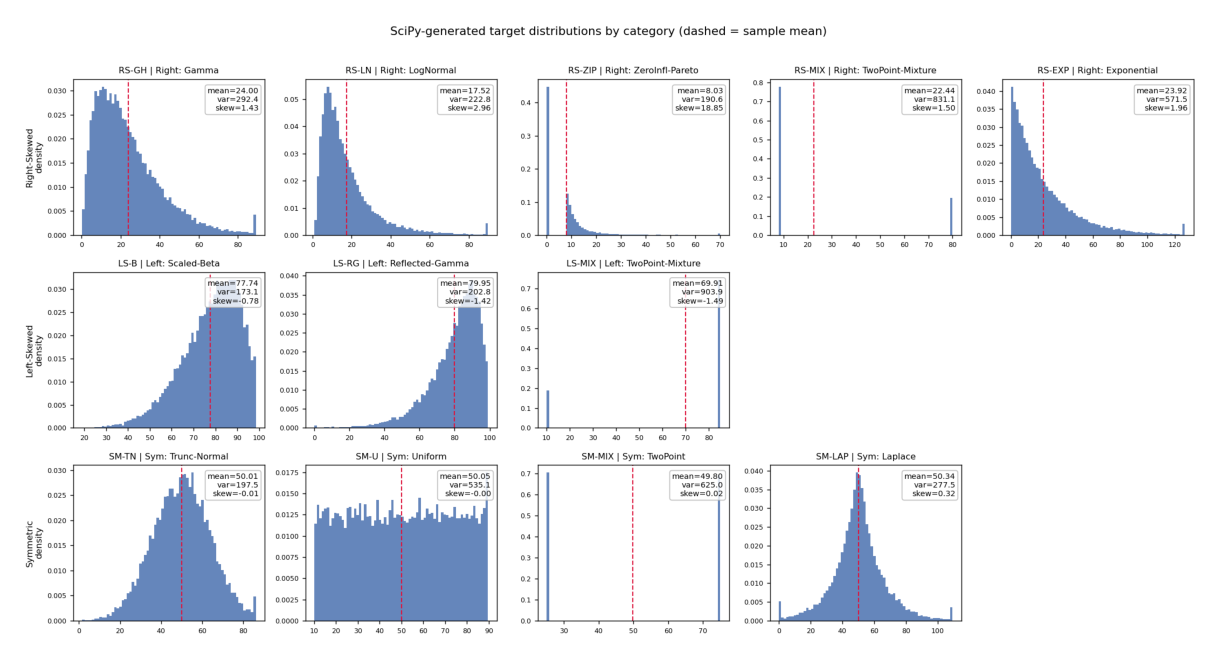
- 12 个合成数据集:覆盖右偏重尾(RS-:Gamma / LogNormal / ZeroInfl-Pareto / TwoPoint-Mixture / Exponential)、左偏有界(LS-:Scaled-Beta / Reflected-Gamma / TwoPoint-Mixture)、对称/近对称(SM-:Trunc-Normal / Uniform / TwoPoint / Laplace)三类边际。每个数据集先采样协变量 $X\sim\mathcal{N}(0,I_d)$,定义已知条件均值 $m(X)=\text{softplus}(w^\top X+c)$(或 MoE 均值),再从条件分布采样目标。$N_{\text{train}}=80{,}000$,$N_{\text{test}}=20{,}000$,$d=8$。特征不含 $Y$ 的经验 rank*——这样评测的是原始空间期望估计误差,不是从 rank 特征重建。合成数据集统计见 Table 10 / 边际分布见 Figure 5。
- 两个公开基准:CIKM16(在线搜索会话的 dwell time 预测,310,302 会话,122,991 items,4:1 划分)、DTMart(营销活动每单交易额预测,985,033 订单,15,546 items,4:1 划分)。
- 两个大规模工业数据集:Dwell Time(长尾)、Zero-inflated GMV(稀疏),千万级、超 1000 维特征,严格按时间划分(训练窗口早于验证/测试窗口,CDF 表只从训练标签或验证选定训练窗口构建,测试标签绝不用于查找构建)。工业匿名统计见 Table 11:Dwell Time 零率 0.150、CV 1.56、偏度 2.75、超峰度 19.71;GMV 零率 0.299、CV 5.40、偏度 60.58、超峰度 $1.08\times10^4$,Top 1% Share 0.339。
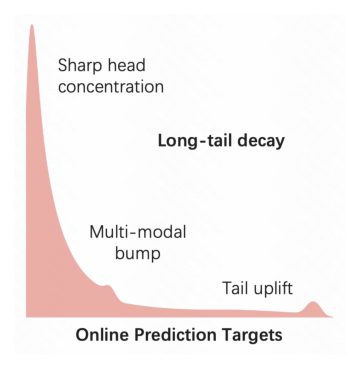
- 一个在线 A/B 测试:部署在激励分配(incentive allocation)系统里的在线目标。在线目标分布见 Figure 4:尖锐头部集中 + 长尾衰减 + 多模态凸起 + 尾部提升。
Baselines
MSE、T-MSE(log / sqrt / $y^2$)、人工变换恢复方法(TranSUN / GTS),以及专门的长尾 / 零膨胀模型:ZILN、WLR、MDME、TPM、CREAD、EGMN、GR、CCOR-Net。此外把 PIT-only(纯 PIT 直接逆)和 PIT-TranSUN(把经验 PIT 塞进 TranSUN 模板但用裸逆查找 $C^{-1}(\bar f(x))+\varepsilon$ 作基,无 $b_{\min}$ 稳定化)作为诊断插件基线。
评价指标
- 点误差:NMAE、NRMSE(都用目标均值 $\bar y$ 归一化,便于跨域比较,式 (40)(41))。
- 聚合校准:SRE(Signal Relative Error,聚合预测信号 vs 真信号的绝对相对偏差,式 (42))、TRE(总残差质量,式 (43))、MRE(instance-wise 相对误差)、PGR(Prediction Gain Ratio,保留聚合预测增益的符号以诊断整体高估/低估,式 (44))。
- 排序质量:xAUC(对高价值连续目标的 pairwise 排序正确率,式 (45))、Normalized Gini、Spearman $\rho$。多种子均值 + 配对检验($p<0.05$)。
工业离线共享训练协议见 Table 12:合成 lr 1e-3 / batch 1024 / 80 epoch / 分位表 $K=4000$;工业 Dwell/GMV lr 5e-4 / batch 8192 / 5 epoch / 分位表 $K=20000$;PIT 裁剪 $\delta=10^{-4}$,$b_{\min}$ 用正目标 $P_{10}$,$\lambda=1.0$。
主要实验结果
合成边际上的稳健性
12 个合成数据集的 SRE 完整结果见 Table 13(正文 Figure 2 是雷达图)。PIT-SUN 在无需逐数据集选变换的前提下展现出最稳定的校准剖面,随着目标形状变化仍然一致可靠。
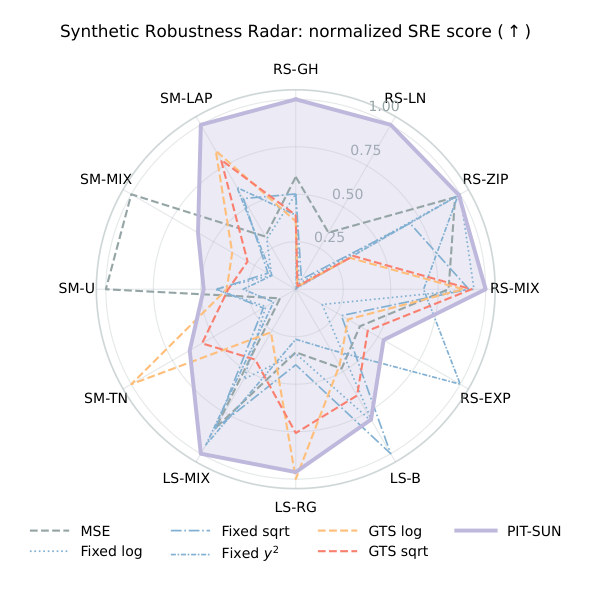
Table 13 摘录(SRE↓,越小越好;粗体最优,下划线次优):
| Model | RS-GH | RS-LN | RS-ZIP | RS-MIX | RS-EXP | LS-B | LS-RG | LS-MIX | SM-TN | SM-U | SM-MIX | SM-LAP |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| MSE | 0.0473 | 0.0090 | 0.0518 | 0.0589 | 0.0341 | 0.0087 | 0.0235 | 0.0126 | 0.0512 | 0.0064 | 0.0085 | 0.0334 |
| TranSUN(ln) | 0.0558 | 0.0904 | 0.0502 | 0.0505 | 0.0828 | 0.0052 | 0.0230 | 0.0194 | 0.0269 | 0.0151 | 0.0579 | 0.0350 |
| GTS(ln) | 0.0783 | 0.1899 | 0.1521 | 0.0537 | 0.0419 | 0.0091 | 0.0405 | 0.0180 | 0.0049 | 0.0176 | 0.0220 | 0.0127 |
| PIT-SUN | 0.0280 | 0.0031 | 0.0506 | 0.0474 | 0.0249 | 0.0053 | 0.0081 | 0.0106 | 0.0076 | 0.0132 | 0.0143 | 0.0107 |
结论:PIT-SUN 在多数右偏和左偏数据集上取得最优或次优 SRE,且没有单一 baseline 能像它一样跨所有分布形状保持稳定。固定变换(log/sqrt/$y^2$)在与其匹配的分布上表现尚可,一旦分布形状改变就崩掉——这正是「数据驱动经验坐标」相对「人工固定变换」的价值。Table 14 进一步显示:PIT-SUN 的平均 SRE(0.0191)甚至逼近oracle recovery transform(0.0249,允许看到每个数据集后再挑最佳恢复变换),平均秩 1.92 接近 oracle 的 1.83——即它无需人工选变换就接近事后最优。
公开基准上的泛化
Table 2 在 CIKM16(D1)和 DTMart(D2)上评测($p<0.05$,粗体最优,下划线次优):
| Model | NRMSE↓ D1 | NRMSE↓ D2 | NMAE↓ D1 | NMAE↓ D2 | xAUC↑ D1 | xAUC↑ D2 |
|---|---|---|---|---|---|---|
| ZILN | 0.647 | 0.515 | 0.469 | 0.221 | 0.681 | 0.935 |
| TPM | 0.571 | 0.509 | 0.441 | 0.223 | 0.683 | 0.935 |
| CREAD | 0.568 | 0.443 | 0.438 | 0.265 | 0.683 | 0.930 |
| TranSUN | 0.557 | 0.449 | 0.437 | 0.225 | 0.678 | 0.936 |
| GR | 0.601 | 0.452 | 0.482 | 0.265 | 0.688 | 0.927 |
| CCOR-Net | 0.574 | 0.426 | 0.449 | 0.275 | 0.680 | 0.930 |
| PIT-only | 0.612 | 0.461 | 0.474 | 0.244 | 0.672 | 0.922 |
| PIT-TranSUN | 0.563 | 0.436 | 0.447 | 0.238 | 0.682 | 0.937 |
| PIT-SUN | 0.547 | 0.412 | 0.424 | 0.207 | 0.695 | 0.943 |
结论:PIT-SUN 在点误差和排序质量上全面超越分布模型(ZILN、EGMN)、离散/结构化模型(TPM、CCOR-Net)、人工恢复基线(TranSUN/GTS)以及 PIT 插件变体(PIT-only、PIT-TranSUN)。关键对比是 PIT-only(0.612/0.474 NRMSE/NMAE on D1)远弱于 PIT-SUN(0.547/0.424),证明改进不是来自「经验 PIT」本身,而是来自「PIT 坐标 + 稳定恢复」的耦合。
大规模工业 Dwell Time 预测
Table 3 是工业 Dwell Time 结果($p<0.05$;PIT-TranSUN 是用经验 PIT 替换 TranSUN 人工变换、恢复基用裸 $C^{-1}(\bar f(x))+\varepsilon$、无 $b_{\min}$ 的强插件基线;灰底为诊断变体):
| Model | NMAE↓ | NRMSE↓ | TRE↓ | MRE↓ | PGR→0 | xAUC↑ | Norm_Gini↑ | Spearman↑ |
|---|---|---|---|---|---|---|---|---|
| TranSUN(sqrt) | 0.622 | 1.158 | 0.207 | 1.453 | 0.207 | 0.894 | 0.831 | 0.798 |
| GTS(sqrt) | 0.504 | 0.988 | 0.149 | 1.253 | 0.099 | 0.878 | 0.858 | 0.823 |
| CREAD | 0.531 | 0.926 | 0.097 | 0.878 | 0.097 | 0.904 | 0.865 | 0.843 |
| CCOR-Net | 0.487 | 0.927 | 0.166 | 1.198 | -0.166 | 0.893 | 0.838 | 0.837 |
| PIT-TranSUN | 0.801 | 1.086 | 0.083 | 1.030 | -0.168 | 0.837 | 0.837 | 0.808 |
| PIT-SUN | 0.477 | 0.885 | 0.051 | 0.818 | 0.054 | 0.921 | 0.878 | 0.852 |
| PIT-SUN-w/o SUN | 0.496 | 0.905 | 0.054 | 1.025 | -0.062 | 0.918 | 0.872 | 0.835 |
| PIT-SUN-w/o sg | 0.524 | 0.908 | 0.060 | 0.942 | 0.099 | 0.917 | 0.843 | 0.817 |
| PIT-SUN w/ rand-rank | 0.545 | 0.972 | 0.062 | 0.997 | 0.060 | 0.913 | 0.852 | 0.810 |
结论:PIT-SUN 在 NMAE / NRMSE / TRE / xAUC / Gini / Spearman 上全线最优,且 PGR 最接近 0(无系统性高估/低估)。注意 PIT-TranSUN 的 NMAE(0.801)反而是最差之一——它把经验 PIT 塞进 TranSUN 模板但用裸逆查找作基,在零平台和稀疏值附近分母坍缩,说明「经验 PIT 不能简单替换人工变换」,收益来自完整闭包(有界坐标 + 稳定逆分位基 + 条件线性恢复),而不是 PIT 单独。
大规模工业零膨胀 GMV 预测
Table 4($p<0.05$;PIT-SUN-ZI 是零膨胀扩展;灰底为诊断变体):
| Model | NMAE↓ | NRMSE↓ | TRE↓ | MRE↓ | PGR→0 | xAUC↑ | Norm_Gini↑ | Spearman↑ | Zero-AUC↑ | Pos. Recall↑ |
|---|---|---|---|---|---|---|---|---|---|---|
| GTS(sqrt) | 0.719 | 4.431 | 0.172 | 1.387 | -0.072 | 0.871 | 0.873 | 0.768 | 0.866 | 0.652 |
| CREAD | 0.646 | 3.988 | 0.185 | 1.324 | -0.174 | 0.893 | 0.859 | 0.788 | 0.871 | 0.641 |
| GR | 0.733 | 4.465 | 0.354 | 2.049 | -0.357 | 0.898 | 0.874 | 0.763 | 0.863 | 0.649 |
| PIT-SUN | 0.623 | 3.853 | 0.071 | 1.143 | 0.027 | 0.909 | 0.902 | 0.808 | 0.884 | 0.663 |
| PIT-SUN-ZI | 0.719 | 3.973 | 0.098 | 1.279 | -0.098 | 0.906 | 0.898 | 0.807 | 0.902 | 0.681 |
| PIT-SUN-w/o SUN | 0.688 | 4.118 | 0.347 | 1.673 | -0.120 | 0.884 | 0.875 | 0.785 | 0.872 | 0.651 |
| ZI w/o Amt-SUN | 0.689 | 4.272 | 0.250 | 1.886 | -0.194 | 0.878 | 0.781 | 0.762 | 0.897 | 0.676 |
结论:单轨 PIT-SUN 仍是最强的端到端价值估计器(NMAE / NRMSE / xAUC / Gini 最优);PIT-SUN-ZI 则在占用诊断(Zero-AUC 0.902)和零–正解耦(Pos. Recall 0.681)上更强。当零占用监控是运维关键指标时选 ZI,当价值估计和校准主导时选默认单轨 PIT-SUN。关键诊断行 ZI w/o Amt-SUN(去掉正金额分支的 SUN 恢复)显示 NMAE / xAUC 明显退化,证明正金额分支仍然需要 SUN 恢复来校准,PIT-SUN-ZI 只负责把零占用从正金额里分出来。
组件诊断(消融)
正文和 Table 3/4 灰底行系统检验了 PIT-SUN 链条的四个环节:
- Coordinate without recovery(PIT-SUN-w/o SUN):保留经验 PIT 坐标但去掉条件线性恢复,直接逆式预测。这是「纯 PIT 有偏」结论的诊断——有界标签帮助表征学习,但直接逆本身定义不出原始空间条件均值(PGR 掉到负值,NMAE / MRE 变差)。
- PIT plug-in without base stabilization(PIT-TranSUN):把 $T(y)=C(y)$ 塞进 TranSUN/GTS 模板、用 $C^{-1}(\bar f(x))+\varepsilon$ 作基。它隔离「经验 PIT 能否简单替换人工变换」的问题——答案是不能,其在零平台/稀疏尾附近分母坍缩,NMAE 反而最差。
- Gradient isolation(PIT-SUN-w/o sg):允许恢复残差回传更新逆分位路径。去掉 stop-gradient 后 $\Delta b$ 漂移和梯度干扰上升,Gini / Spearman 退化,验证了固定基解释。
- Zero-positive factorization(PIT-SUN-ZI):只在零占用监控是部署目标一部分时才有用。
大规模在线 A/B 测试
PIT-SUN 部署在在线激励分配系统里,估计复杂目标以指导预算受限的分配策略。在线流数据长尾、稀疏、有噪,需要稳定回归。部署了两种 PIT-SUN 引导的 reward 配置:Dwell Time 单目标,和 Multi-Objective Mixture(观看时长 + engagement 深度 + 商业价值)。Table 5 报告 7 天连续 A/B 平均相对提升(user-level bootstrap,$*$ 表示 $p<0.05$):
| Strategy (Reward) | DAU | Watching Time | Video View Cnt | Ad Revenue | Deeply Engaged Users |
|---|---|---|---|---|---|
| Single-Obj (Time) | 0.010% | 0.318%* | 0.265%* | 0.148% | 0.195%* |
| Multi-Obj (Time, Revenue, etc.) | 0.003% | 0.330%* | 0.273%* | 0.216% | 0.064%* |
结论:在观看时长、视频观看数、深度参与用户上取得统计显著提升,DAU 和广告营收保持稳定(置信区间含零,解读为中性护栏 / 方向性正向而非统计确认的增益)。整体解读为「显著的参与度改善 + 中性护栏 + 方向性正向的商业信号」。
部署开销
Table 6 对比训练/推理开销:
| Model | Training Time | Inf. P50 | Inf. P99 |
|---|---|---|---|
| T-MSE(with Expect-aligned) | 40min 04s | 17.93 ms | 23.67 ms |
| Two-stage | 55min 17s | 20.01 ms | 25.17 ms |
| PIT-SUN (Multi-obj) | 36min 24s | 14.61 ms | 18.35 ms |
| PIT-SUN (Single-obj) | 31min 33s | 15.62 ms | 20.05 ms |
结论:PIT-SUN 相对既有基线缩短训练时间、降低推理延迟,支持高 QPS 部署。开销只是一张滑动窗口分位表 + 两个轻量回归头。
关键附录诊断补充
- 合成固定/oracle 变换稳定性(Table 14):PIT-SUN 平均 SRE 0.0191 优于所有固定变换(fixed log 0.2062 / sqrt 0.1468 / $y^2$ 0.2957),逼近 oracle recovery(0.0249),无需人工选变换或逐数据集后验选择。
- 超参敏感性(Table 16-20):裁剪概率 $\delta=10^{-4}$、分位表 $K=20000$、$b_{\min}$ 用 $P_{10}$、$\lambda=1.0$ 都是稳健甜点;去掉 $b_{\min}$(none)会让 Ratio Var 爆炸(Dwell 18.72 vs $P_{10}$ 的 3.84),过高 floor 又用 base 失真换方差,$P_{10}$ 平衡二者。
- 时序漂移诊断(Table 21):CDF 表若冻结(frozen)会随流量漂移退化(Quantile KS 0.118,worst-block TRE 0.104);滑动窗口刷新(sliding)把 KS 压到 0.041、接近 oracle,且不改模型或推理路径。工业里滑动窗 KS 稳在约 0.04,触发刷新用「验证校准的告警带」而非通用阈值。
- 桶级校准(Table 22):PIT-SUN 在各真值分位桶([0,50%]/[50%,90%]/[90%,99%]/top 1%)上系统性改善高价值区,说明聚合增益来自尾部整流而非低价值桶的误差抵消。
- 恢复基选择(Table 25):PIT-only 基(0.061 SRE,biased inverse)、Const-mean SUN(0.044,non-adaptive)、Learned-base SUN(0.033,less stable)、PIT-TranSUN(0.030,bare lookup)都不如 PIT-SUN(0.019,stable base),证明贡献是「坐标–逆查找–恢复基–稳定化」的耦合设计。
- 两阶段 vs 联合训练(Table 24):联合训练 + stop-gradient 近似保持了固定基解释($\Delta b$ P95、PIT-grad share 都低于去 sg 版本),且训练时间 31min33s 远低于两阶段的 48min36s。
- 子群异质性(Table 26):全局 PIT-SUN 已优于 PIT-only / PIT-TranSUN;当有可靠 segment 标签且每段样本足够时,group-wise CDF 表能进一步改善少数尾校准(All SRE 0.024 vs global 0.026),作为条件扩展而非默认。
核心贡献总结
- 不可能性定理引导的方法论:Theorem 1 证明非线性稳定坐标不可能通过直接逆普遍保持期望一致,把问题从「找更好的标量变换」重新框定为「构造坐标–基–恢复三位一体的闭包」。这是本文最有价值的概念贡献。
- 一张经验边际表定义整个闭包:PIT 坐标、逆查找、逆分位恢复基、漂移监控全部从同一张经验 CDF 表导出,避免人工变换选择和逐数据集调参。
- 稳定化机制有理论支撑:$b_{\min}$(Proposition 1 的方差控制)和 stop-gradient(Theorem 3 的固定基性质)不是启发式,而是分别在零膨胀区控方差、在联合训练里保持固定基解释。
- 完整的多层验证 + 组件诊断:合成 12 分布 + 公开 2 基准 + 工业离线 + 在线 A/B,且用 PIT-only / PIT-TranSUN / w/o SUN / w/o sg 等诊断变体逐一隔离「为什么需要完整闭包」,说服力强。
- 可部署:开销只是滑动窗分位表 + 两个轻量头,训练/推理都比既有基线更快,支持高 QPS。
与已归档相关工作的对比
本文聚焦「重尾/零膨胀/多峰的连续推荐目标(观看时长、GMV、LTV)在原始空间 MSE 下优化不稳、而任何非线性变换又破坏期望一致」这一 root cause,用「经验边际 CDF 坐标 + 逆分位恢复」的路径解决。文档库里有三篇在问题(观看时长/价值目标的重尾-分布性偏差)与/或解法骨架(用经验边际 CDF/分位坐标 + 乘性恢复)上高度同构的近期工作,且均未被本文引用(本文参考文献止于 Zheng 2022,PEARL/FlowTime/DADF 都晚于或并发于本文),构成典型的「独立并发/殊途同归」。
被剔除的近似候选(记录以防门槛放水):PEARL 的前作 RAD(Relative Advantage Debiasing) 与本文的 CREAD/TranSUN 等 baseline 属显式引用/baseline 关系,交给 DAG 处理,不再做叙事对比;CARD(2604.26427)虽也用「可逆非均匀变换(Kumaraswamy CDF)把偏斜 embedding 重映到近均匀」,但目标是 semantic-ID tokenizer 的 codebook 均衡,与本文的原始空间期望回归 root cause 不同构,剔除;BLADE(2605.04559)虽也「用 Beta-Binomial 共轭替换经验 CDF」构造自演化分位奖励,但服务的是 LLM4Rec 的 BoN 对齐奖励建模,问题与解法都偏离连续价值期望回归,剔除。
DADF DADF: Distribution-Aware Debiasing Framework for Watch-Time Regression (Kuaishou, 2026-05-18)
关系:独立并发(本文未引用 DADF,两者殊途同归,且同属快手)· 已加载对方精读
- 共同关注的问题:观看时长标签既长尾又多峰,直接回归会均值坍缩;两文都明确指出「直接回归乘性校正因子 $b=y/\hat y_0$ 不稳定,因为该比值继承了 $Y$ 的重尾」——这正是 PIT-SUN 的 SUN 分支要控制的 $\text{Var}(Y/b(x)\mid x)$,DADF 在附录 A.1 也给出了同一命题的严格证明。
- 相近的技术骨架:两者最终预测都是乘性恢复 $\hat y = \text{(基)}\times\text{(比值)}$——DADF 是 $\hat y_0\cdot\hat b$(冻结首阶段预测 × 校正因子),PIT-SUN 是 $b(x)\cdot z_\psi(x)$(逆分位基 × 比例头);且都通过「把重尾比值标签映到紧凑目标空间」来稳定回归。
- 本文的差异与推进:(1)DADF 是事后修正,在一个不可替换的冻结预测器上外挂二阶残差网络;PIT-SUN 是端到端训练的完整闭包。(2)DADF 用人工选择的 group-specific Box-Cox 变换 + duration 分组硬路由把比值标签压对称;PIT-SUN 用数据驱动的经验 PIT 坐标避免任何人工变换/分组选择(这正是它相对 TranSUN 谱系的卖点)。(3)PIT-SUN 提出了「非线性直接逆不可能保期望一致」的不可能性定理作为立论基础,DADF 没有这一层理论。(4)DADF 复用首阶段 engagement 辅助头作为推理时可见信号,是工程上的巧劲;PIT-SUN 的基 $b(x)$ 完全由 PIT 坐标经逆分位查找生成,不依赖外部辅助任务。可以说 DADF 是「冻结预测器 + 人工分组变换」路线,PIT-SUN 是「经验边际闭包 + 端到端」路线,两者对同一 root cause 给出互补答案。
PEARL PEARL: Unbiased Percentile Estimation via Contrastive Learning (TikTok, 2026-05-20)
关系:独立并发(本文未引用 PEARL,两者殊途同归)· 已加载对方精读
- 共同关注的问题:观看时长的绝对量级不可比、重尾/异质,直接拟合绝对值会被高活跃/高价值样本主导,损害鲁棒性。两文的共同 insight 是用经验边际 CDF/分位(PIT)作为稳定、跨样本可比的学习坐标,而不是直接回归原始重尾量级。
- 相近的技术骨架:PEARL 的目标是 $p=F_a(y)=P(Y_a\le y)$(用户特定 CDF 分位),PIT-SUN 的 PIT 坐标是 $C(y)=\Phi^{-1}(\hat F_Y(y))$(全局经验 CDF 经正态 CDF 逆映射)——两者本质都是把标签换成经验 CDF rank;且都指出直接在有界的 $[0,1]$ 分位/正态分数上回归比在原始重尾量级上回归更稳定(PEARL 强调分位边界处 MSE 不稳、PIT-SUN 强调裁剪 PIT 把重尾振幅折进有界坐标)。
- 本文的差异与推进:最锋利的差异在于终点是否停在分位空间。PEARL 的预测目标就是分位数 $\hat p\approx F_a(y)$,服务的是跨用户可比的排序/偏好信号(用对比学习绕开显式维护分布和直接回归分位的困难),它不回到原始尺度的期望。PIT-SUN 则明确证明纯 PIT/分位坐标是 $\mathbb{E}[Y\mid x]$ 的有偏估计(Theorem 2 / Corollary 1),因此在 PIT 坐标之上必须再加 SUN 恢复把预测映回原始空间条件期望——这正是本文相对「只做 PIT/分位」路线的核心增量。换言之:PEARL 要的是无偏分位(排序场景够用),PIT-SUN 要的是无偏期望(价值估计场景必需),后者证明了前者的坐标不能直接当作值预测。此外 PEARL 用 user-keyed reservoir + 多样本对比器隐式估计分位,PIT-SUN 用一张全局经验 CDF 表显式查找,工程路径不同。
FlowTime FlowTime: Continuous Generative Watch-Time Prediction (Kuaishou/Fudan, 2026-05-31)
关系:独立并发(本文未引用 FlowTime,两者殊途同归,且同属快手观看时长)· 已加载对方精读
- 共同关注的问题:观看时长条件分布重尾、多峰、异质,逐点 MSE 回归会均值坍缩到低密度区。两文的动机分析高度重合——FlowTime 用命题 1 形式化了「峰越分离,MSE 解越是真实数据里几乎不出现的值」,PIT-SUN 则称之为 mean collapse / tail shrinkage,都把它当作原始空间回归的核心痛点。
- 相近的技术骨架:两者都不满足于一个标量点预测,都要绕开固定离散化/量化的启发式词表问题(FlowTime 批评 CREAD 类序回归和 GR 类离散 AR,PIT-SUN 也把 TPM/CREAD/GR 列为要超越的对象)。
- 本文的差异与推进:解法路径分岔明显。FlowTime 走生成式密度建模——用一步式 VAE + flow-based 个性化先验把高斯 warp 成多峰流形,目标是学整个条件密度 $p(y\mid x)$,从中可采样/取期望,代价是一个更重的生成骨架。PIT-SUN 走判别式期望恢复——不建整个分布,只用经验 PIT 坐标稳定表征、再用逆分位基 + 比例头直接恢复条件期望这一个标量,骨架极轻(一张 CDF 表 + 两个头),部署开销和延迟都更小(Table 6)。可以概括为:FlowTime 用「建全分布」对付多峰,PIT-SUN 用「稳坐标 + 恢复期望」对付重尾,前者表达力强但重、后者针对期望估计更省。两文同出快手观看时长场景、同期发布、互不引用,是一组清晰的独立并发对照。
讨论与局限性
核心贡献与可借鉴设计:本文最大的价值是把「目标变换」从工业界的启发式预处理(试 log 还是 sqrt)提升为一个有理论闭包的可部署框架,并用不可能性定理干净地论证「PIT 坐标必须配恢复、恢复基必须稳定、稀疏区必须控方差」三件事缺一不可。「一张经验边际表同时承担坐标/逆查找/恢复基/漂移监控」的设计非常适合工业落地——运维只需刷新一张滑动窗分位表,不改模型和推理路径,且有可观测的 Quantile KS 作为漂移告警。stop-gradient 隔离固定基、$b_{\min}$ 控比值方差这两个机制都有对应的定理/命题背书,不是拍脑袋加的 trick。组件诊断(PIT-only / PIT-TranSUN / w/o SUN / w/o sg)做得很扎实,逐一隔离了每个环节的必要性,特别是「PIT-TranSUN 反而最差」这个反直觉结果,有力地证明了「经验 PIT 不能简单替换人工变换」。
方法论可扩展性:PIT-SUN 是一个针对回归目标校准的模块,不是表征/序列建模骨架,其可扩展性讨论应放在「它是否限制上游 backbone」这个角度。好的一面是它对 backbone 无侵入(PIT 分支和 SUN 分支都接在共享表征上),参数量 scaling 时上游怎么扩都不受影响;论文结尾还提出一个有意思的方向——把观看时长/GMV/LTV 这些数量级差异巨大的连续目标先映到可比的正态分数坐标 $[-a_\delta, a_\delta]$,再各自恢复,从而作为多任务学习的尺度对齐器,缓解多目标训练里的梯度冲突和 loss 权重失衡(这是 MMoE 类系统的真实痛点)。潜在瓶颈是它依赖一张全局经验 CDF 表:(1)表本身是静态的经验估计,强子群异质下需要 group-wise 表(Table 26 承认这一点,但受限于每段样本量);(2)目标漂移剧烈(大促、节假日)时需要刷新表,虽然论文用滑动窗 + KS 监控缓解,但这引入了一条 CDF 刷新的运维闭环。
局限与争议:(1)在线 A/B 的 DAU 和广告营收都不显著(置信区间含零),论文诚实地把结论限定为「参与度显著改善 + 商业信号方向性正向」,没有夸大商业增益。(2)方法主要为「重尾/稀疏/异质尺度让原始 MSE 难优化」的 regime 设计,当目标本身已良态或样本量太小以致尾部分位不可靠时,收益有限,且此时需要 pool/smooth 经验表。(3)默认用全局边际 CDF,牺牲了子群级别的精细校准(除非有可靠 segment 标签和足够样本才启用 group-wise 表)。(4)相比 FlowTime 这类建全分布的方法,PIT-SUN 只恢复期望这一个标量,若下游需要分布/不确定性(如风险敏感的预算分配),本文框架不直接提供。
工业落地价值:本文有明确的工业落地:部署在快手激励分配系统,观看时长 +0.318%、视频观看数 +0.265%、深度参与用户 +0.195%(均显著),训练/推理都比基线更快,部署开销只是一张滑动窗分位表 + 两个轻量头。对任何需要在重尾/零膨胀连续目标上做稳定值估计的工业推荐场景,这是一个开销低、有理论支撑、可直接嵌入现有 backbone 的校准方案。