PinEqualizer:Pinterest 的全漏斗内容探索与去偏系统
PinEqualizer: Full Funnel Content Exploration and Debiasing System at Pinterest(Pinterest, Inc.,KDD '26 Applied Data Science Track,arXiv 2607.22518v1,2026-07-24)
研究动机与背景
内容冷启动(cold-start)是所有工业级搜索与推荐系统(RecSys)的核心难题。Pinterest 是一个服务超过 5 亿用户、内容库为数十亿到数千亿量级 Pin 的视觉发现引擎,其内容语料在持续演化,因此冷启动问题尤为尖锐:新内容因缺乏历史曝光而难以获得流量牵引。
冷启动本身已被广泛研究,工业界最有效的手段是「基于内容的匹配」(content-based matching)——用内容特征去弥补交互稀疏。Pinterest 的现有系统已经重度依赖内容信号与其独特的 pin-board 图结构:例如用 random walk(Pixie,文献 [8])在候选生成阶段拉取用户 board 上相关的 Pin,用 graph-optimized 内容 embedding(PinSage,[23])与对应的用户 embedding([11, 23])作为排序模型的最有效信号,以及用户活动序列(TransAct,[21])。
然而随着内容采集(content acquisition)不断演化,大量新内容与用户产生的 pin-board 图连接不足,冷启动问题愈发严重,并开始侵蚀内容生态的健康度:形成一个 rich-get-richer(富者愈富) 的反馈回路——已建立地位的内容提供者相对新入场者获得越来越大的优势。
针对这些挑战,作者构建并部署了一套跨 Pinterest 三大产品面(Homefeed、Related Pins、Search,合计承载 92% 的内容曝光)的端到端解决方案。相比已有工作,本文的贡献与创新体现在三个方面:
(1)全漏斗方法(Full-funnel approach):工业级 RecSys 通常是多阶段系统。本文的方案在整个漏斗上创新——从语料选择(corpus selection)、检索(retrieval)到后期排序与效用(late stage ranking and utility),并能同时泛化到搜索和推荐两类产品面,还构建了搜索专属优化以保证强语义相关性。
(2)对既有内容去偏(Debiasing existing content):作者发现整个漏斗中普遍存在偏向既有旧内容的 bias,因此关键不是只关注探索机制,而是要减少这种 bias。去偏让模型能对所有内容(新旧)做出更准确的预测,从而减少与大量显式内容探索相关的短期收益权衡(explicit exploration,即通过 UCB / Thompson Sampling 换取的短期 engagement 折损)。
(3)可扩展的度量框架(Scalable measurement framework):提出一套全面的度量框架,在生产中持续测量全漏斗内容探索与去偏改进的长期价值。此外,作者识别出一批与长期结果相关、但能通过 user-segmented A/B 快速测量的短期实验指标,大幅加快了工程团队构建与验证新改进的速度。这套设置相比前作(Su et al., [17])更简单,并成功解决了工业级生产系统中若干限制。
作者自 2024 年起迭代式构建并成功部署了整套系统的各个部分,累计为平台带来 350% 的新鲜内容曝光增长,并在用户 engagement 与内容生态健康(如内容提供者多样性)上取得显著的长期改善。
核心方法:度量框架(Measurement & Metrics)
由于冷启动的收益本质上是长期的(短期探索有 engagement 成本,长期回报体现在留存与生态健康),作者首先建立了一套「既能测长期价值、又能支持快速实验」的度量框架,分为三层。
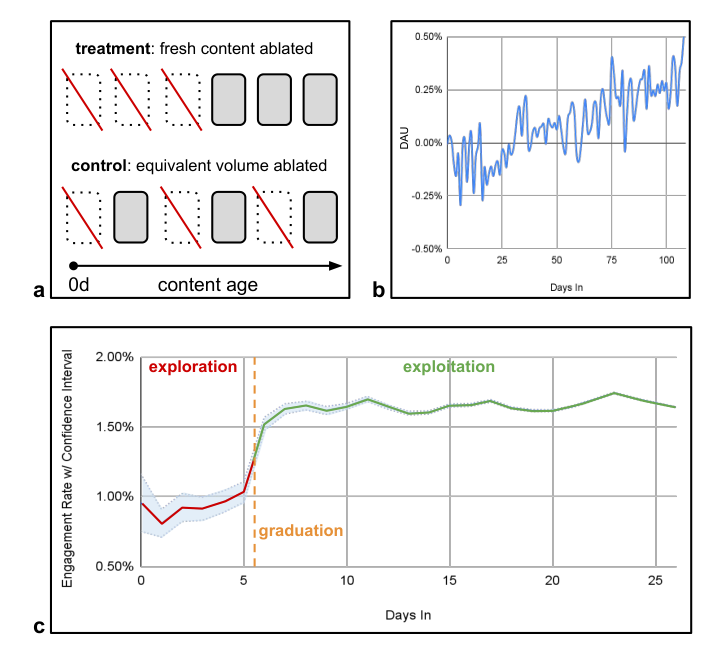
2.1 Fresh Content Value(North Star / 北极星指标)
全漏斗内容探索的目标是最大化新摄入内容产生的长期用户价值。作者通过一个跨所有主要发现面(Homefeed、Related Pins、Search)一致施加的长期 fresh content holdout 来测量它。
设计要点(见 Figure 1.a):holdout 组只包含实验开始之前创建的内容(即冻结在实验前的存量语料),而 production 组则纳入实验期间新创建的内容。为消除「更大候选池」本身带来的固有优势,作者在 production 组里随机移除等量的内容(基于 content ID hash,确保所有请求一致地移除同一批内容),如 Figure 1.a 所示。于是观测到的 engagement delta(Figure 1.b)就量化了新创建并被探索的内容所带来的增量收益。
与前作 [17] 的差异:[17] 已经充分证明了「更大的被探索语料 → 更高用户 engagement」,本文的主要目标转向证明最新鲜的被探索语料相对于陈旧(已被充分探索)的存量语料具有增量价值(holdout 里的存量语料本身是一个规模可观、已被充分探索的语料库)。
理论上的内容级泄漏(content level leakage):该设置理论上仍可能存在泄漏——treatment 组更好的探索可能导致 under-explored 内容在 control 组也获得流量。但作者观察到这种影响是极小的,原因有二:(1) 一旦 treatment 加速了内容 graduation,毕业后的内容在次日就不再计入该指标;(2) 用户在 control 与 treatment 组看到的内容通常各不相同,尤其在实验流量较低时。
2.2 Content Graduation Corpus Metrics(内容毕业语料指标)
长期 holdout 提供了新鲜内容价值的 ground truth,但存在显著的反馈延迟——探索的累计收益常常延续到初始干预窗口之外很久。因此作者定义了一个内容毕业(content graduation)指标作为鲁棒的中间代理。
其思想基于观察:成功的探索会把内容从高方差的 "exploration" 阶段转移到稳定的 "exploitation" 阶段(见 Figure 1.c)。形式化定义:
- content graduation(内容毕业):在摄入后 $Y$ 天内累计到 $X$ 次正向 engagement 的新摄入内容的数量(及占比)。其中阈值 $X$ 是作者根据经验数据识别出的、engagement rate 方差显著下降处的累计 engagement 阈值(Figure 1.c)。
此外,为避免把流量浪费在低 engagement 潜力的内容上,作者定义:
- explored low-engaging content(已探索低 engagement 内容):engagement rate 的置信上界(upper confidence bound)都低于某阈值 $Z$ 的、已被充分探索的内容的数量。
结合两者,正式定义:
- under-explored content(欠探索内容):既没有「毕业」,也不属于「explored low-engaging」的内容——即价值尚不确定、仍需继续探索的内容。
2.3 Under-Explored Content Engagement Volume(实验指标)
前作 [17] 指出:user-segmented(用户分桶)A/B 实验无法评估内容级指标,因为实验两臂之间共享内容语料(content-level leakage)。本文改用 under-explored content engagement(欠探索内容 engagement 量) 作为指标——定义为在传统 user-segmented A/B 中、由 under-explored 内容收到的正向 engagement 的总量。
该实验设计的四大优势: 1. 与 content graduation 强相关:对 under-explored 内容更多的 engagement 直接导致其毕业; 2. 用 positive engagement 而非 impressions:成功标准鼓励那些「高相关 + 低 engagement 权衡」的探索算法(即不靠硬塞曝光刷量); 3. 可自信评估整体用户级 engagement 权衡:做上线决策时能一并评估用户级 engagement tradeoff; 4. 实验速度最大化:因为是标准的 user A/B 设置,实验吞吐最大。
为何不用前作 [17] 的 user-corpus 联合双臂(codiverted)设计:作者评估了 [17] 的 user-corpus codiverted 实验设计——它虽能解决测量内容级指标时的实验泄漏问题,但在生产环境中存在三大挑战:(1) 三大产品面各有多个候选生成器、且语料各异(图片、视频、产品),全局把内容切成桶的成本极高;(2) 当实验只在 $x\%$ 语料上做时,结果只基于 $x\%$ 语料,无法准确测量用户级指标(生产中必须用全量语料测用户级指标);(3) 把语料限制到 $x\%$ 会伤害用户指标,从而限制可并行的实验数、拖慢实验速度。
核心方法:系统概览(System Overview)
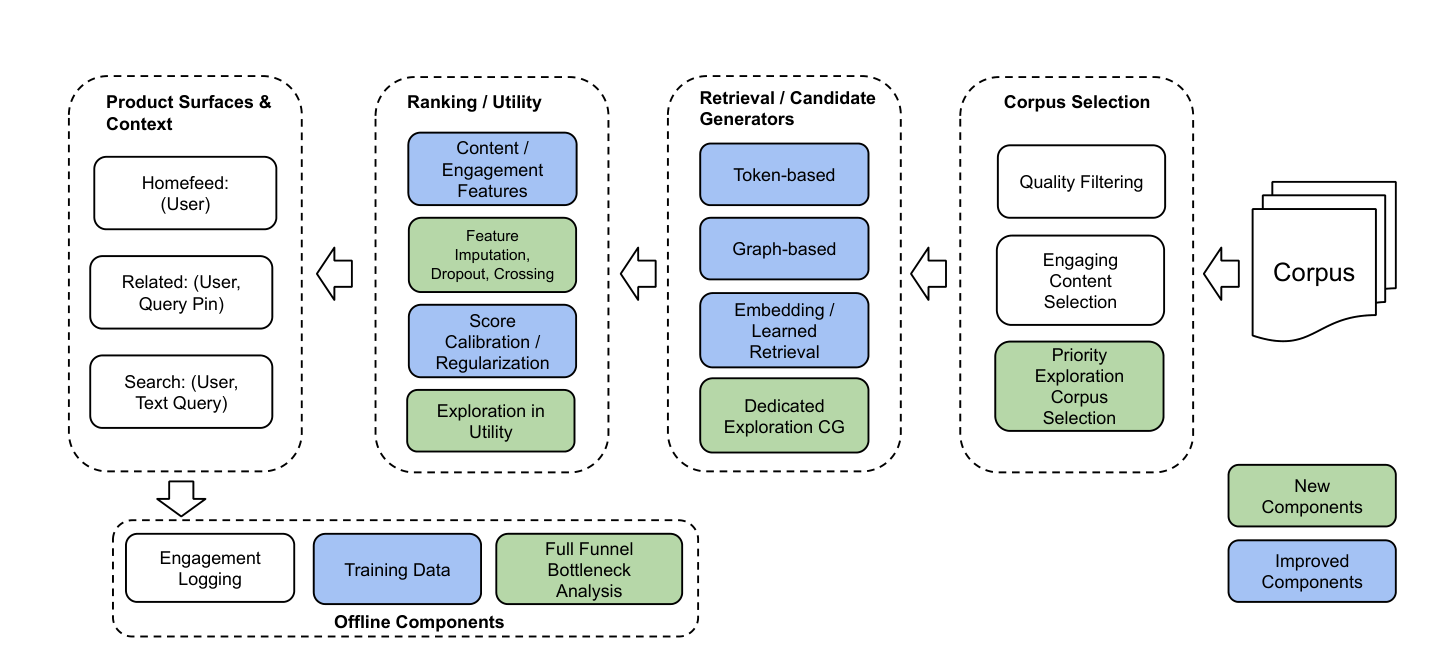
作者把典型的工业级多阶段漏斗按产品面上下文组织:Homefeed 只用用户信息作为 query 输入;Search 额外用当前 query 保证结果相关性。核心发现与贡献:要成功引入并为冷启内容收集反馈,整个漏斗需要逐阶段(stage-by-stage)改进——任何单一阶段都可能成为瓶颈从而扼流。关键认知是:冷启内容必须在每个阶段的排序与选择过程中都能有效地与既有内容竞争,而降低系统对旧内容的整体 bias 对于确保新内容有公平机会至关重要。
各阶段职责:
- Corpus selection(语料选择):从全量语料中选出要索引和服务的活跃语料,剔除低质/违规内容。这里新建组件以高效选出最有希望的新鲜内容去探索——因为在基础设施和 engagement 两方面「探索每一条新内容」都代价高昂。
- Retrieval(检索):多种候选生成器基于上下文 query 拉取最相关内容,如 token-based(结构化查询)、graph random-walk([8])、embedding / 双塔架构。本文改进既有机制并新建针对冷启内容的候选生成器。
- Full ranking stage(全排序阶段):主要目标是降低模型对新旧内容的 bias,改进涉及特征、架构、损失函数、校准,以及最终效用函数中的探索优化。
- Offline components(离线组件):改进训练数据采样,并部署全漏斗分析以识别瓶颈、指导后续开发优先级。
3.2 Full-funnel Bottleneck Analysis(全漏斗瓶颈分析)
多层漏斗各阶段高度相互依赖:某一阶段(如 ranking)的实际改进效果会受前置阶段状态(如 corpus selection 与 retrieval)的约束。因此维护一个跨整个漏斗的、面向瓶颈与最高 ROI 干预点的全景视图至关重要。作者用全漏斗日志与瓶颈分析,对每个阶段考察冷启 vs 既有内容的输入构成与输出存活率:
- Input availability(输入可得性):$Y$ 天内被摄入且欠探索内容占输入的比例;
- Output survival rate(输出存活率):欠探索与新创建内容在 top-k 结果中存活的概率。
直觉:当新鲜内容在输入中充分存在、但输出中存活率很低时,某阶段就成了瓶颈或效率低下。由于不同产品面特性各异、底层生产系统状态不同,这些低效在各面之间会变化,使得全漏斗视角对于有效地排序工作序列(sequencing)至关重要。
分析得到的示例洞见:
- Related Pins 面:某个时刻观测到上层漏斗(corpus 和 retrieval)不再是主要约束——新鲜内容以可比速率被召回,但排序阶段发生显著跌落:大部分新鲜内容在最终输出中排名跌到 $k$ 名之外。这促使团队把焦点转向 ranking 改进。
- Search 面:同一时段发现瓶颈始于 retrieval 阶段。鉴于搜索有强相关性门槛,作者进一步验证:对小样本 query 过量召回远大于生产系统的内容子集并跑相关性模型,确认了语料层面存在足够相关内容,从而证实瓶颈在 retrieval。
关键技术细节:各漏斗组件(Components)
4.1 Corpus Selection(语料选择)
由于每日上传的 Pin 量巨大、无法全量索引与探索,作者构建了一条语料选择流水线,高效识别一个高潜力新鲜物品子集去探索。通过维护一个专用的 exploration corpus 并优先服务最有希望的新鲜物品,系统学习得更快、同时减少浪费在低 engagement 潜力内容上的流量。
Thompson Sampling(汤普森采样):首个方案是用 Thompson sampling 这一经典 explore/exploit 手段。对每个物品,从后验 engagement rate 分布 $Beta(\alpha + e,\ n - e)$ 中采样,其中 $e$ 是正向 engagement 数,$n$ 是曝光数,$\alpha$ 是基于内容提供者整体 engagement 的先验。然后挑选采样得分最高的物品。此外还叠加了其他业务逻辑,例如保证内容提供者多样性。
Model-based Prior(基于模型的先验):随时间推移希望把更多信号(如图片质量、平台外信息)纳入先验。为此构建一个 ML 模型,基于内容和平台外信号预测每个物品的经验 engagement rate。该模型把每个物品的 engagement rate 预测为 $\alpha$,再与经验 engagement rate 结合,用如下后验做最终选择:
$$\hat{r} = \frac{\alpha N + e}{N + n} \tag{1}$$
其中 $e$ 是观测到的 engagement 数,$n$ 是曝光数,$N$ 控制先验的强度。式 (1) 是一个带先验伪计数 $N$ 的 Beta-Binomial 后验均值——冷启内容($n$ 小)时后验被先验 $\alpha$ 主导,随着曝光累积逐步收敛到经验值。
Selection(选择策略):每次流水线刷新时,按后验得分 $\hat{r}$ 选取 top-$K$ 物品。exploration corpus 动态更新以对齐「ungraduated 内容」的定义:满足以下任一条件的物品被从探索中退休(retired)——(1) 累计到足够正向 engagement 而毕业,或 (2) engagement 的置信上界低于阈值。这一「刷新-替换(refresh-and-replace)」策略把探索容量优先分配给最有希望的新鲜内容。
4.2 Feature Improvements(特征改进)
拥有正确的特征对于给 ML 模型去偏至关重要。这些特征改进大多可同时应用于检索模型(如双塔学习检索)和最终排序模型。
Advanced Content Understanding Signals(先进内容理解信号):内容特征在 Pinterest 已被重度利用,本文进一步改进:
- Content-only Embeddings(纯内容 embedding):既有系统重度依赖为 pin-board 图或内容共 engagement 优化的 embedding(如 PinSage [23]、ItemSage [2])。但由于大量新鲜内容与图连接不足,依赖这些 embedding 会 bias against 新鲜内容。因此加入基于纯内容的额外 embedding,如 Unified Visual Embedding([24]),以及更近期基于大型视觉-语言模型(VLM)与 CLIP 视觉文本对齐的新 embedding(PinCLIP [3])。
- Semantic ID(语义 ID):更近期 semantic id 被提出作为一种新颖的内容表示([14]);与 content-only embedding 类似,作者发现把 semantic id 作为额外特征加入既有模型,也有助于新鲜内容。
Feature Imputation(特征插补):先进内容 embedding 的生成常需重度 ML 推理,意味着内容创建后不会立即可得。简单地把缺失特征当作某默认值会给新鲜内容带来显著惩罚。作者发现简单插补即可缓解:具体地,对 embedding 每一维独立从一个正态分布采样填补,该分布的参数基于内容语料中该维度的经验分布估计。
Engagement Feature Dropout(engagement 特征 dropout):在传统协同过滤(CF)推荐模型中,dropout([18])已被提出作为冷启动的有效技术。Pinterest 这类工业级系统用的不是传统 CF,而是一个含各种特征表示用户/物品及其交互的深度神经网络。物品的历史 engagement 计数与比率常常对未来 engagement 有很强预测性,naive 模型可能过拟合并过度依赖这些特征,导致对新鲜内容 under-predict、对旧内容 over-predict。为缓解,作者在训练时对历史物品 engagement 特征施加 dropout,迫使模型更好地泛化、更依赖内容信号。评估两种 dropout 策略:(1) Uniform dropout(统一 dropout):所有物品 engagement 特征同时丢弃;(2) Individual dropout(独立 dropout):每个物品 engagement 特征独立丢弃。经验上 individual dropout 一致地表现更好。特征重要性分析证实其有效性:用 individual dropout 训练的模型在 engagement 特征上放的重要性更少、把权重更多转向内容与上下文特征。作者发现不宜对用户级历史 engagement 特征做 dropout,因此用户级个性化不受影响。
Feature Crossing(特征交叉):特征 dropout 只会让模型全局上更少依赖 engagement 特征,但原则上排序模型应当动态地对冷启物品更多利用内容特征、对有历史的物品更多利用 engagement 历史。为在深度神经网络中实现这种特征交互,作者发现把内容特征与历史 engagement 特征加入一个显式特征交叉模块 DCNv2([20]) 是有效的。
Off-platform Engagement Data(平台外 engagement 数据):内容在上传到 Pinterest 之前可能已存在很久,因此新到 Pinterest 的物品可能已有可利用的丰富平台外历史。例如对可购买产品,许多商家会发送 Pinterest 历史交易数据。用这些额外数据源为物品和内容提供者构建强先验(如各商家的顶级卖家、热门商家)对提升新鲜内容表现非常有效。
Near Realtime Engagement Features(近实时 engagement 特征):若能用 Flink 等数据流框架近实时计算物品 engagement rate,模型就能相比日级批处理更快反应——这对内容仍处早期探索阶段时尤其重要。因此作者搭建了针对新鲜内容的近实时物品 engagement 流水线,同时对老化内容仍用批处理以降低基础设施成本。
4.3 Retrieval(检索)
采用三种检索策略:Token Retrieval、Graph Retrieval、Embedding Retrieval。
Token Retrieval(词元检索):term-matching 检索,文档索引进倒排索引、query 表达为结构化查询树。如 Corpus Selection 所述,作者产出一个只含未探索内容的专用语料;对 token retrieval,为该 exploration corpus 建单独的倒排索引,检索时从该索引取一定量候选,其余候选从含充分探索、高 engagement 内容的常规语料取。这条专用探索检索通道保证在后期阶段仍有一股探索性物品的稳定流。
Graph Retrieval(图检索):Pixie 是一族图候选生成器([8]),沿 bipartite Pin-Board 图从 query 节点做 random walk,返回访问到的 Pin 节点作为候选。该图天然偏向被保存到更多 board 的 Pin(连接更多)。为给这些候选生成器去偏、返回更多未探索内容,作者修改图遍历算法为带权 random walk——连接到未探索 Pin 的边被赋予更高权重。
Embedding Retrieval(embedding 检索):通常用两种策略——(1) 基于能同时表示 query 和 content 的预训练内容 embedding(如 PinCLIP [3]);(2) 用产品面上的 engagement 数据训练双塔网络(一塔 query、一塔 content)。为有效探索,作者开发了以下方法:
- Dedicated Exploration Channel(专用探索通道):可为 exploration corpus 用预训练内容 embedding 建专用 ANN 索引;对 learned retrieval,可训练一个移除所有 engagement 相关特征的专用模型以最小化 bias(类似 [19])。
- Unified Learned Retrieval Model(统一学习检索模型):训练专用探索模型虽能最小化 bias,但随时间会带来显著的基础设施与运维成本。因此作者开发了同时处理冷启与既有内容的统一学习检索模型——通过利用前述更好的特征与去偏技术,观测到该方案能有效返回足够多的新鲜内容、同时显著降低 bias(更保守)。
- Debiasing the Query Tower(query 塔去偏):在 Related 面,query 是(Pin, User, 额外上下文)。当 query 是一个既有 Pin 时,query 侧特征会引入 bias 使模型偏好结果中的旧内容。改进办法:不在深层网络里过早地把内容特征与 engagement 特征交叉,而是先为各特征类型(内容特征、engagement 特征)学独立 embedding,再在后期做 late fusion / crossing。这确保最终 query embedding 更多编码内容特征,从而有效降低结果中的 bias。
4.4 Final Ranking and Utility Layer(最终排序与效用层)
搜索与推荐漏斗的后期是典型设置:一个或多个多任务重排序模型用最先进架构与特征预测物品对用户的各种奖励(如 save 概率、click、relevance score),最终一个效用层(utility layer)把这些奖励与其他全局因素(如多样性)结合,形成呈现给用户的最终顺序。这一阶段有两大关键挑战。
挑战一:预测偏置。 由于冷启物品在训练数据中稀疏等因素,排序模型倾向对新鲜内容 under-predict、对旧内容 over-predict。除前述特征改进外,作者还开发了以下去偏技术:
- Content-type-aware Calibration(内容类型感知校准):校准层把模型预测分与经验行为概率对齐,让效用层能准确平衡各种奖励。但 naive 的全局校准无法有效降低特定内容类型(如新鲜内容或其他 under-represented 类型)的校准问题。为缓解,作者把重要内容类别作为类别信号纳入校准模型,确保模型在所有主要内容 cohort 上都被良好校准。
- Score Regularization and Training Data Augmentation(分数正则化与训练数据增强):在损失函数中引入额外正则项,鼓励模型对具有相似内容表示的新鲜 vs 旧内容对齐分数分布。为处理冷启 vs 旧物品可能不同的特征值分布,还用技术生成混合特征空间的增强训练数据(细节见 [7])。注意:由于不同产品面特性不同,这些数据增强或损失函数的技术可能需跨面显著调整。例如此处的正则化改进最初为 Related Pins 开发,但在 Search 上实验时发现强正则化会显著降解 pin-query 相关性,因此需要保守得多。
挑战二:反馈回路(feedback loop)。 训练数据来自实际用户 engagement 历史,而这又取决于生产系统一开始决定展示什么。若生产系统严重 under-predict 新鲜内容,那么新鲜内容上的训练数据量会被进一步压缩,简单的 up-sampling 或 off-policy correction 不足以解决。为此作者在效用层开发了若干技术来允许对冷启物品做更多探索:
- UCB with Real-time Impressions(基于实时曝光的 UCB):UCB([1])是经典 explore-exploit 手段,根据物品价值估计的不确定性给出乐观加成。在大规模系统里准确估计方差/不确定性并不 trivial,因此用一个简单启发式——用实时曝光计数估计不确定性:曝光越少,不确定性越高。具体:
$$\mathrm{UCB}_i = \frac{\alpha}{\sqrt{1 + \beta \cdot \mathrm{impressions}_i}} \tag{2}$$
其中 $\alpha$ 控制探索强度、$\beta$ 决定加成随累积曝光衰减的速度。作者试了两种集成方式:(1) 把 UCB 项作为 logit 调整直接加进排序模型;(2) 作为效用层里的显式项。两者都在降低选择偏置、改善训练数据质量上表现强劲,但效用层集成提供了更大的独立调优灵活性(无需重训模型)。
- Neural Linear UCB(NLB):impression-based UCB 完全忽略了内容特征空间。Neural Linear UCB([22])是一个简单可扩展的方案,把神经网络的最后一层隐表示 $\phi(x)$ 作为特征表示(从原始模型输入 $x$ 派生),与目标奖励近似线性关系 $y = \phi(x)^T \theta$。于是用 LinUCB 算法([9])计算样本 $i$ 的上界:
$$\hat{y}_i = \phi(x_i)^T\theta + \alpha\sqrt{\phi(x_i)^T\Sigma\phi(x_i)} \tag{3}$$
协方差矩阵 $\Sigma = H^{-1}$ 由设计矩阵派生:
$$H = \sum_{i=1}^{N}\phi(x_i)\phi(x_i)^T + \lambda I \tag{4}$$
集成到排序模型的训练分两步:(1) 用大量采样训练数据做大规模主模型训练,学到特征表示 $\phi(x)$;(2) 用较小的无偏采样集做轻量校准,用最新数据更新协方差矩阵 $\Sigma$。对天然二值的任务(click / save 预测),类似 [17],避免显式计算岭回归参数 $\theta$,而是复用预训练二值预测的 logit 作为 mean reward 的廉价代理。另一个实践问题:式 (4) 中设计矩阵 $H$ 的量级大致随样本量 $N$ 线性增长,因此后验不确定性界大致正比于 $1/\sqrt{N}$;由于第 (2) 步的样本量 $N$ 独立于预训练过程变化,这会无意中让探索量随时间波动。为此在式 (3) 的 $\alpha$ 参数上加一个缩放项 $\alpha = \sqrt{\frac{N_o}{N}}\,\alpha_o$,其中 $N_o$ 设为参考 batch size 以维持稳定性。
- Role of Relevance in Search Utility(相关性在搜索效用中的作用):搜索面 query 与结果间的语义相关性门槛高得多,因此搜索栈用一个主要基于内容特征的先进相关性模型,它是最终效用的重要贡献者。由于相关性模型用了多得多的内容特征,其对新鲜内容的 bias 远小于 engagement 模型,且对相关性模型的改进也常惠及新鲜内容。基于此,搜索面有若干专属优化:(1) 提高相关性权重,确保高相关的新鲜内容尽管 engagement 模型 under-predict 也能排到高位;(2) 在 UCB 中应用最低相关性阈值并用相关性缩放探索项 $\mathrm{UCB}_i' = \mathrm{relevance}_i^{\gamma}\cdot\mathrm{UCB}_i$,确保低相关内容不获得大的探索优势。
主要实验结果
作者自 2024 年起部署并迭代改进整套系统,观测到对用户 engagement 与内容生态健康的显著影响。
5.1 Overall Impact(整体影响,Table 1)
Fresh Content Holdout(新鲜内容 holdout):北极星指标,测量新创建并被探索的内容对站点级用户 engagement(内部定义的成功 session 数)的增量影响。注意 2025 vs 2024 的对比并未捕捉全部影响,因为 2024 vs 2023 也有显著增长。影响横跨北美与国际优先市场。购物 session 尤其受益:2025 content holdout 数据显示总购物 session 增益达 18.5%,是整体非购物 session 增益的 5.3×(北美)和 8.3×(国际)。这表明购物内容分布尤其重度依赖新物品——事实上购物内容常面临更尖锐的冷启挑战,因其来自商家目录的大量批量上传、与用户策展的 pin-board 图缺乏连接。
Table 1:整体站点级影响
| 指标 | 相对提升 |
|---|---|
| Fresh Content Holdout 增量 session 增益(YoY 2025 vs 2024) | |
| - Overall Successful Session(North America) | +24% |
| - Overall Successful Session(i18n 国际) | +49% |
| - Shopping Session(North America) | +63% |
| - Shopping Session(i18n 国际) | +29% |
| Graduated Content Corpus(28-day)YoY 2025 vs 2024 | +41% |
| Cumulative Gain Site-wide Under-explored Content Engagement Volume | |
| - Homefeed Surface Holdout | +37% |
| - Search Surface Holdout | +13% |
| - Related Surface Holdout | +27% |
| Number of Successful Content Providers(YoY 2025 vs 2024) | +99% |
分析(why):三层度量框架自洽地闭环验证——欠探索内容 engagement 量的增长(+13%~+37%)推动了 graduated content corpus 的增长(+41%),进而带来 fresh content holdout 中整体用户 engagement 的增益(+24%~+63%)。这印证了作者鲁棒三层度量框架的实际有效性。内容提供者数量 +99% 是生态健康的直接证据:通过削弱 rich-get-richer 效应,系统让更多内容提供者(其内容站点级 engagement 份额超过某阈值即视为「成功」)取得成功。
5.2 Component-level Impact & Insights(组件级影响,Table 2)
为提供更有意义的洞见,作者选取单一推荐面(Related Pins) 报告,其他面的发现方向一致。注意 Table 2 与 Table 1 不同:这里只是聚合各次单独上线(自 2024 起)的实验指标增益(surface-level 短期长期指标),而非 Table 1 的 surface-level 长期整体增益。所有实验都跑了对整体 engagement tradeoff 的严格护栏(strict guardrail),衡量的是全部新鲜内容(all fresh,created < N days)以及欠探索内容的 engagement lift。
Table 2:Related Pins 面组件级 A/B 实验综合影响(Engagement Volume Lift)
| 组件 | All fresh | Underexplored |
|---|---|---|
| Corpus Selection and Retrieval | - | - |
| - Exploration Corpus | +7.75% | +16.92% |
| - Graph Retrieval | +3.91% | +3.71% |
| Feature improvements | - | - |
| - Retrieval | +2.48% | +3.97% |
| - Ranking | +5.57% | +18.52% |
| Model architecture | - | - |
| - Retrieval | +5.95% | +5.52% |
| - Ranking | +8.63% | +6.57% |
| UCB exploration | - | - |
| - Impression-based Heuristic | +2.95% | +3.12% |
| - Neural Linear (over heuristic) | +5.83% | +5.32% |
分析(why): 1. 各组件均有统计显著增益,覆盖全漏斗(corpus/retrieval/ranking/utility)。 2. 专用 exploration corpus + ranking 特征改进对 under-explored 内容的提升尤为悬殊(+16.92% 与 +18.52%),说明「dedicated corpus + 排序去偏」是把欠探索内容拉进正反馈循环的最强杠杆。 3. UCB 探索对比:Neural Linear Bandit(NLB,式 3)相比 impression-based 启发式(式 2)取得增量增益(+5.83% vs +2.95% all-fresh)。但由于启发式更简单、更易解释,作者选择在某些生产场景(如 Related Pins 的轻量早期漏斗 ranker)用启发式,只在最先进的最终排序模型里用 NLB——简单性与可解释性在生产权衡里胜过复杂性。
最重要的实践教训——排序与优先级(sequencing and prioritization):多阶段生产系统中,选对「聚焦哪个阶段」至关重要。团队起初重点投入 corpus 与 retrieval,确保足够新鲜内容送到排序阶段,即使排序阶段次优也能实现显著影响;后来通过全漏斗分析观测到排序阶段瓶颈变得更显著,于是转向更多 ranking 改进。而在 ranking 内部,又要权衡「feature/架构改进」 vs 「效用层显式 UCB 探索」——取决于冷启内容在训练数据中的可得性。
核心贡献总结
- 全漏斗视角(full-funnel):不同于只在单一阶段(如检索或排序)做冷启探索的前作,PinEqualizer 在 corpus selection → retrieval → ranking → utility 的每个阶段同时做去偏与探索,并用全漏斗瓶颈分析动态定位最高 ROI 的干预点。
- 去偏优先于显式探索:核心 insight 是「整个漏斗都 bias against 新鲜内容」,因此减少对旧内容的系统性 bias(feature dropout、content-type-aware calibration、score regularization、content-only/VLM embedding、feature imputation)比单纯堆显式探索(UCB/Thompson)更能提高预测准确性、减少短期 engagement 折损。
- 可扩展三层度量框架:长期 fresh content holdout(北极星)→ content graduation corpus(中间代理)→ under-explored content engagement volume(可用 user-segmented A/B 快速测量),三者相关且逐级闭环,既能测长期价值又能加速实验;相比前作 [17] 的 user-corpus codiverted 设计更简单、更适合大规模生产。
- 两年工业部署验证:累计 350% 新鲜内容曝光增长,fresh content holdout 增量 session +24%~+63%、graduated corpus +41%、成功内容提供者数 +99%。
与已归档相关工作的对比
MESH MESH: Scaling Up Retrieval with Heterogeneous Content Unification (Pinterest, 2026-07-14)
关系:独立并发(本文未引用 MESH,两者同出 Pinterest 团队、殊途同归)· 已加载对方精读
- 共同关注的问题:两篇论文指向完全相同的 root cause——Pinterest(尤其 Related Pins 面)系统性地 bias against 新鲜/长尾内容,形成 rich-get-richer 反馈回路,新内容因与 pin-board 图连接不足、engagement 历史稀疏而被边缘化。MESH 把它命名为「异构性 Scaling Bias」,PinEqualizer 直接称之为 rich-get-richer。
- 相近的技术骨架:两者都把 engagement/流行度信号视为对新鲜内容的污染源,都用「结构化隔离 + 门控去偏」来保护稀疏内容的信号——MESH 用模块化子塔为稀疏实体开辟「受保护的梯度路径」并用 Residual Gated Bias Correction 分离内在语义匹配与外源互动偏置;PinEqualizer 在 ranking/query 塔层面用 late fusion(先学独立 embedding 再后期交叉)、feature dropout、content-type-aware calibration 达到类似「把内容信号与 engagement 偏置解耦」的目的。两者都强调用 content-only/纯内容 embedding 弥补图连接不足。
- 本文的差异与推进:MESH 是单阶段(retrieval)的深度架构方案,聚焦「scaling 公平性」——让更大模型的容量增益公平惠及 fresh 内容(fresh repins +5.5%,2.87× 吞吐)。PinEqualizer 是全漏斗系统,把 retrieval 去偏只当作一个组件,额外覆盖 corpus selection(Thompson/UCB exploration corpus)、ranking utility(NLB/impression-UCB)与一整套长期度量框架。可以理解为:MESH 深挖 PinEqualizer 漏斗中「retrieval + ranking 架构」这一格子的机制,PinEqualizer 提供把各阶段串起来的系统蓝图与度量方法论。
- 可比的方法 / 实验差异:两者都用 Pinterest Related Pins 十亿级数据、都做 fresh/evergreen 分层评估、都用 in-batch negatives + logit correction 缓解流行度偏置。MESH 报告离线 scaling law 指数 + 在线 fresh repins/funnel efficiency/retention;PinEqualizer 报告两年累计的 fresh content holdout session 增益与 graduated corpus 增益。两文互为「机制层」与「系统层」的极佳互补,且明确未互相引用(同期独立工作)。
GrowthGR GrowthGR: Towards Sustainable Growth (Taobao Search, 2026-05-18)
关系:独立并发(本文未引用 GrowthGR,问题同构但解法路径分叉)· 已加载对方精读
- 共同关注的问题:两篇都把工业冷启动的 root cause 定位在「系统天然为历史 engagement 优化 → Matthew effect / rich-get-richer → 新品被概率性遗忘」,且都强调现有系统缺乏对新内容长期价值的量化测量——不能只看即时 CTR/CVR,要衡量一次早期交互对未来生命周期的「涟漪」贡献。这一「长期价值测量」的问题陈述高度同构。
- 相近的技术骨架:抽象层面都是「先量化长期价值信号,再据此重新分配流量给高潜力新内容」。GrowthGR 用 counterfactual causal inference(ItemLTV,估计一次 click 在 T+30 后 7 天窗口的 transaction uplift)作为长期价值信号;PinEqualizer 用长期 fresh content holdout(北极星)+ content graduation corpus 作为长期价值 ground truth 与中间代理。
- 本文的差异与推进:解法路径显著分叉。GrowthGR 是单阶段生成式检索方案,把长期价值作为 reward 注入一个 TIGER-style SID 自回归 backbone,用 GRPO 变体 MoPO + Clipped Importance Weighting 做 RL 对齐;PinEqualizer 不用 RL、不用生成式检索,而是走「全漏斗经典去偏 + explore/exploit(Thompson/UCB/NLB)+ 度量框架」路线,跨 corpus/retrieval/ranking/utility 四阶段。因此二者是「同一冷启问题、同一长期价值测量诉求」下两条差异很大的技术路线,对比价值在于路径对照而非机制复用。
- 可比的方法 / 实验差异:GrowthGR 报告淘宝搜索 +5.39% 新品 GMV、item-side T+30 后 7 天 GMV +20.0%;PinEqualizer 报告 Pinterest 全站 fresh content holdout session +24%~+63%、graduated corpus +41%。两者都用「item-side / 长期窗口」度量长期生态价值,度量哲学一致但指标口径不同(一为 GMV uplift,一为 session/graduation)。
被剔除的近似候选(防门槛放水): - Next-User Retrieval Next-User Retrieval(ByteDance):同为冷启物品分发,但走「为冷启物品预测 next-user」的单点生成式检索,无全漏斗、无去偏体系、无长期度量框架——解法骨架实质偏离。 - Shallow-RHS Shallow-RHS(Tubi):item 冷启视为归纳式图补全(graph completion)+ 两塔 link prediction,是「用内容塔补图」的单一召回机制,非漏斗级去偏+探索系统。 - IDProxy IDProxy(小红书):用 MLLM 生成 proxy ID embedding 喂给 CTR 模型解冷启,属单点「特征/表示补全」,不涉及跨漏斗探索、长期价值 holdout 或 rich-get-richer 生态叙事。
讨论与局限性
核心贡献与借鉴价值:
- 全漏斗瓶颈分析方法论(input availability × output survival rate 逐阶段刻画冷启内容流失)是本文最可迁移的工程资产——它把「该先修哪个阶段」从直觉变成可测量的决策,对任何多阶段工业 RecSys 都有参考价值。
- 「去偏优先于显式探索」的立场是一个有价值的反直觉洞见:与其用 UCB/Thompson 硬付出短期 engagement 成本去探索,不如先修好模型对旧内容的系统性偏置,从而在更少短期折损下让新内容自然获得公平竞争机会。
- 三层度量框架的自洽性(under-explored engagement → graduation → holdout session)以及用 user-segmented A/B 快速测内容级代理指标的做法,解决了工业界「长期价值反馈延迟 vs 快速实验」的经典矛盾。
局限性与争议:
- 无公开可复现实验:所有数值均为 Pinterest 内部 A/B 相对增益,无公开学术 benchmark(作者也说明冷启内容级指标本就依赖生产语料,公开数据集无法承载),因此外部无法复现或直接比较绝对水平。
- 方法论深度浅、工程广度大:本文更像一份「系统与方法论工程实践报告」,多数技术组件(Thompson sampling、UCB、LinUCB、DCNv2、feature dropout、content-only embedding)均为已有技术的组合与工程化,单点技术新颖性中等;真正的贡献在于系统性地把它们编排进全漏斗 + 一套可落地的度量框架。
- content-level leakage 未被完全消除:作者承认 fresh content holdout 理论上仍有内容级泄漏,只是论证其影响极小;graduation 阈值 $X$/$Y$/$Z$ 的选择依赖经验数据,跨平台迁移性存疑。
- 跨面调参成本高:多次强调「为 Related Pins 开发的正则化/数据增强在 Search 上会伤相关性、需大幅调整」,说明该系统的很多组件不是即插即用,跨产品面落地需要大量定制。
工业落地价值:本文是一份高价值的工业部署报告——两年真实生产迭代、跨三大产品面(92% 曝光)、明确的业务收益(350% 新鲜内容曝光、成功内容提供者 +99%、购物 session 显著增益)。对任何面临「新内容分发难、rich-get-richer、如何测量冷启长期价值」的工业 RecSys 团队,本文提供了可直接借鉴的系统架构模板、度量框架与「先去偏后探索、按瓶颈排序优先级」的工程决策哲学。