ANGLE:用「商业意图 × 广告摘要」两级文本代替语义 ID 的腾讯搜索广告一步式生成召回¶
Tongtong Liu, Renyu Zhang, Jiayu Ding, Hongchao Guo, Xintao Yang, He Wei, Zhaoyu Li, Haiyang Wu(Tencent Inc.),arXiv:2609.18296v1,2026-09-16,工业搜索广告(已部署于两个匿名搜索场景 WTS / QBS)
研究动机与背景¶
多级级联架构(MCA)的三个毛病¶
搜索广告检索系统要在海量广告库里,高效地挑出既满足用户搜索意图、又满足广告主投放要求、还能带来平台收入的广告。工业界的标准形态是 多级级联架构(Multi-stage Cascading Architecture, MCA):候选依次经过召回(retrieval)→ 定向过滤(target filtering)→ 相关性(relevance)→ 粗排(pre-ranking)→ 精排(ranking),每一级以上一级的输出为输入,最终选出 top-k 广告展示。作者列出 MCA 的三个问题:
- 误差逐级传播:前序阶段的错误或遗漏会传到后续阶段,限制最终结果质量;
- 各模块独立训练、缺乏联合优化,难以达到全局最优;
- 每级都要处理大量候选,计算成本高、响应慢。
已有工作(GemNN、协同 retriever-ranker、粗排再思考等)试图缓解这些问题,但作者认为它们仍没有跳出 MCA 框架。
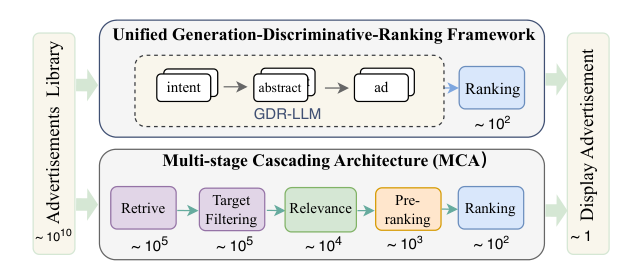
Figure 2 给出两条链路的量级对比:MCA 从广告库出发,召回约 $10^5$ → 定向过滤约 $10^5$ → 相关性约 $10^4$ → 粗排约 $10^3$ → 精排约 $10^2$ → 展示约 1 条;ANGLE 则由 GDR-LLM 依次生成 intent → abstract → ad,直接产出约 $10^2$ 量级候选送进精排。(图中广告库标为 $\sim 10^{10}$,而附录 A 称候选广告数「可达数千万」,两处量级不一致,图应视为示意。)
基于 SID 的 LLM 生成式召回的两个局限¶
LLM 兴起后,生成式方法开始直接为用户产出候选。多数工作(OneSearch、OneRec 等)用 RQ-VAE 生成的 离散语义标识符(Semantic ID, SID) 表示候选文档/广告:收到 query 后 LLM 生成一组 SID,再用 SID 取回广告;并用轻量奖励模型(如 CTR 预估器)反馈相关性与效果。作者认为这条路线有两个局限:
- SID 不是基座 LLM 学过的东西。每条广告靠唯一离散 ID 刻画,LLM 必须从零学习 SID↔广告映射,没法充分利用自身的文本生成能力,可解释性也差;映射泛化差,新文档/新广告要重新建映射;SID 与广告一一对应还导致解码低效。
- 依赖小模型当奖励。靠一个或多个轻量模型(如 pCTR)指导 LLM 优化,限制了 LLM 自身评估广告商业价值的潜力。
因此作者主张:一步式生成框架要发挥 LLM 能力,必须设计更有效的广告表示和更有效的奖励机制。
ANGLE 的方案与贡献¶
作者提出 ANGLE(A uNified Generation-discriminative-ranking reaL-time rEtrieval framework):
- 用一对分层语义文本——意图(intent)+ 摘要(abstract)——表示广告:intent 是宽泛、表达意图的文本,abstract 是精确、取自广告本身的文本;离线为每条广告生成 int-abs pair 并建立 int-abs → 广告的倒排索引;
- 在基座 LLM 中同时注入判别(相关性)与排序(商业价值)能力,得到 GDR-LLM(Generation-Discriminative-Ranking LLM);
- 线上收到 query 后,GDR-LLM 先推断 query 意图,再生成与之对齐的广告摘要,通过倒排索引取回广告,跳过相关性与粗排直接送精排。
作者声明的四点贡献:(1) 框架:端到端实时框架,在千万级生产环境验证;(2) 表示:用分层语义文本表示广告,解决 SID 的可解释性与泛化问题;(3) 模型:把判别与排序能力统一进一个 LLM;(4) 评测:线上 A/B 消耗 +1.81%、GMV +2.16%、点击 +1.5%,离线对比 7 个基线在 HR、MAP、ACR 上全部最优。
相关工作中的定位¶
作者把 LLM 检索中的文档表示分为三类:
- SIDs:用 RQ-VAE 等把广告内容编码成离散语义标识(OneRec-Think、GPR 等);
- STerms(semantic term sets):直接从候选内容中抽取的代表性词项集合,如 SEAL 用文本 n-gram 表示文档;
- SText(semantic compressed text):语义压缩后的文本,如 RARE(同一第一作者 Tongtong Liu 的前作,arXiv:2504.01304)用商业意图(commercial intent, CI)表示广告,实现一步式 query-to-ad 检索;GRAM 以 code 形式做商品检索。
ANGLE 的定位是把 SText(intent)与 STerm(abstract)组合成分层文本表示。需要指出:ANGLE 本质上是 RARE 的直接延续——在「意图文本作广告标识」之上加了一层摘要、动态约束解码和多任务训练;但实验中没有把 RARE 作为基线。
问题定义(附录 A)¶
给定用户 query $q$ 与大规模候选广告集 $A=\{a_1,\dots,a_n\}$($n$ 可达千万级),检索系统的目标是选出满足用户意图并最大化平台商业价值的广告。传统四级级联(召回、相关性、粗排、精排)各自独立优化,导致目标不一致与误差累积。ANGLE 要统一召回、相关性与排序,直接生成最终的高质量广告集合。GDR-LLM 的训练数据来自线上日志:对每个 query 收集用户在线点击过的广告,取出它们的 int-abs pair,构成 (query, int-abs pairs) 训练对。
核心方法 / 模型架构¶
3.1 端到端生成框架¶
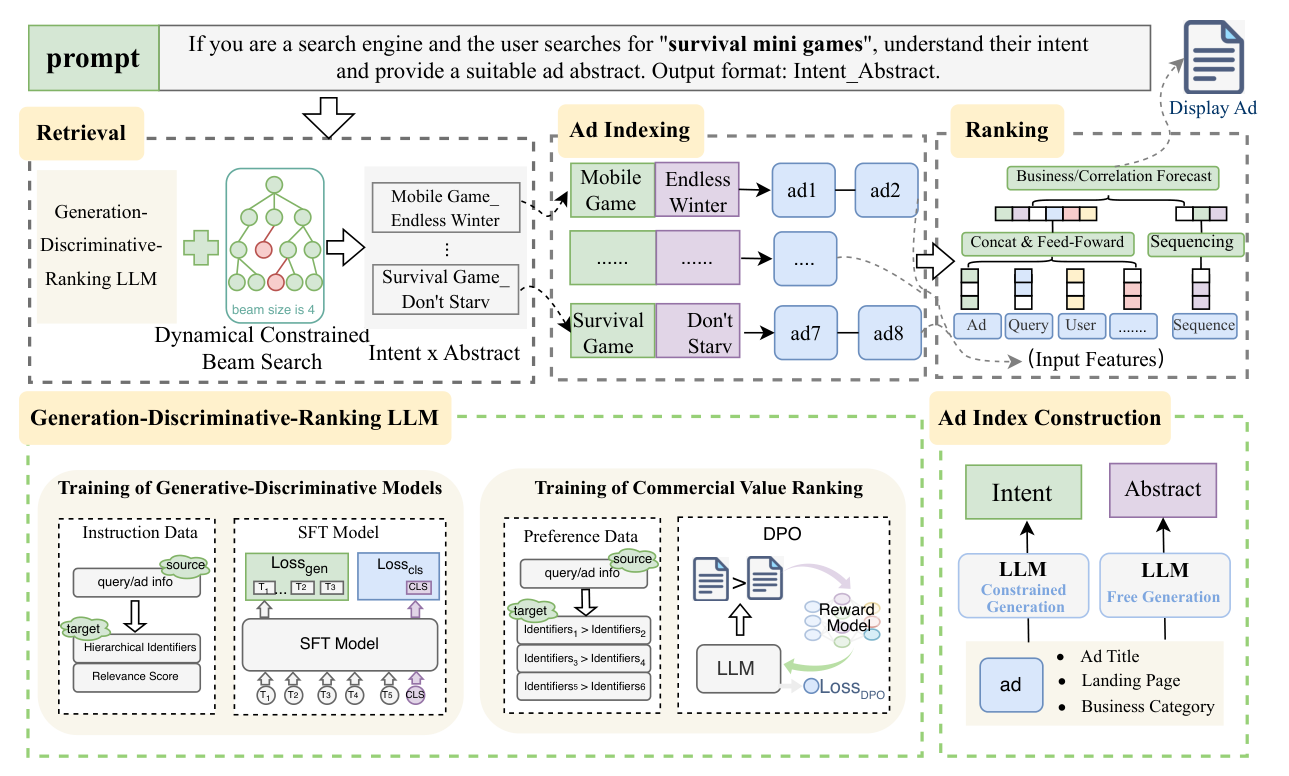
Figure 1 由五块组成:
- Retrieval:prompt 形如「If you are a search engine and the user searches for "survival mini games", understand their intent and provide a suitable ad abstract. Output format: Intent_Abstract.」,GDR-LLM + 动态约束 beam search(图中标注 beam size is 4)生成若干 Intent_Abstract,如
Mobile Game_Endless Winter、Survival Game_Don't Starv; - Ad Indexing:倒排表把 (Intent, Abstract) 映射到广告列表,如 (Mobile Game, Endless Winter) → ad1, ad2;(Survival Game, Don't Starv) → ad7, ad8;
- Ranking:已有的精排模型——Ad / Query / User 等特征拼接过前馈网络,外加用户行为 Sequence 分支,输出「Business/Correlation Forecast」后展示广告。这是一个独立于 LLM 的现有排序模型;
- GDR-LLM 训练:左半「Training of Generative-Discriminative Models」用指令数据(source = query/ad info,target = Hierarchical Identifiers + Relevance Score)做 SFT,输出 token 上算 $\text{Loss}_{\text{gen}}$,输入末尾的 CLS 上算 $\text{Loss}_{\text{cls}}$;右半「Training of Commercial Value Ranking」用偏好数据(Identifiers$_1$ > Identifiers$_2$ 等)做 DPO;
- Ad Index Construction:以广告的 Ad Title / Landing Page / Business Category 为输入,LLM 约束生成 Intent、自由生成 Abstract。
线上流程分三步:GDR-LLM 产出兼具商业价值与相关性的 int-abs pairs(retrieval)→ 查广告索引取回广告(ad indexing)→ 绕过传统相关性与粗排模块,直接送精排(ranking)。
3.2 GDR-LLM:生成、判别、排序三合一¶
GDR-LLM 主要依靠三个损失 $\mathcal{L}_{\text{gen}}$、$\mathcal{L}_{\text{dis}}$、$\mathcal{L}_{\text{dpo}}$ 训练。
Learning to Generate。 目标是生成用户搜索意图与广告摘要的自然语言表示。训练数据主要来自线上用户点击的 query-ad 对。用标准交叉熵:
$$\mathcal{L}_{\text{gen}} = -\sum_{t=1}^{T} \log P(y_t \mid y_{<t}, x) \tag{1}$$
其中 $T$ 为生成 token 数,$y_t$ 为目标序列第 $t$ 个 token,$y_{<t}$ 为其之前的所有 token,$x$ 为模型输入,$P(y_t\mid y_{<t},x)$ 为给定输入与已生成前缀时正确预测 $y_t$ 的概率。
Learning to Discriminate。 目标是判断用户 query 与 LLM 生成的 int-abs 之间的相关性,以提升生成结果的准确性。做法是在输入 prompt 末尾追加特殊 token [CLS],取其输出表示 $h_{[\text{CLS}]}\in\mathbb{R}^d$,经 MLP $f:\mathbb{R}^d\to\mathbb{R}$ 得到标量相关性分:
$$s = f(h_{[\text{CLS}]}) \tag{2}$$
相关性真值 $y\in\{0,1\}$ 取自线上点击-曝光日志。训练时把 $s$ 视为 logit,经 sigmoid 得预测概率:
$$\hat{p} = \sigma(s) = \frac{1}{1+e^{-s}} \tag{3}$$
用二元交叉熵:
$$\mathcal{L}_{\text{dis}} = -\big[\, y\log(\hat{p}) + (1-y)\log(1-\hat{p}) \,\big] \tag{4}$$
两点值得注意:其一,「相关性」标签实为点击与否,把点击行为当相关性,混入了位置、创意、出价等与语义相关性无关的因素;其二,
[CLS]放在「输入 prompt 末尾」时它看不到生成出的 int-abs,若要给「query 与每个 int-abs」打分,必须把 int-abs 拼进输入重新前向——论文没有说明推理时判别头如何接入、是否对 beam 中每个候选额外前向,这直接影响线上延迟。
Learning to Rank。 目标是让商业价值更高的广告排在前面。采用 DPO,训练数据为三元组 $(x, y_w, y_l)$:$x$ 为上下文,$y_w$、$y_l$ 分别为表现更好/更差的广告。策略 $\pi_\theta$ 在 $x$ 条件下给每个广告 $y$ 分配生成概率,$\pi_{\text{ref}}$ 为参考策略:
$$\mathcal{L}_{\text{dpo}}(\pi_\theta;\pi_{\text{ref}}) = -\left[\log\sigma\!\left(\beta\log\frac{\pi_\theta(y_w\mid x)}{\pi_{\text{ref}}(y_w\mid x)} - \beta\log\frac{\pi_\theta(y_l\mid x)}{\pi_{\text{ref}}(y_l\mid x)}\right)\right] \tag{5}$$
$\sigma(\cdot)$ 把两个对数概率比之差映到 $(0,1)$,$\beta>0$ 控制比较的锐度。最小化该损失使模型给「赢家」广告分配显著更高的相对概率,从而让生成顺序偏向商业价值更高的广告。偏好对的构造依据是线上实际消耗(expenditure)。
总损失:
$$\mathcal{L}_{\text{model}} = \alpha\mathcal{L}_{\text{gen}} + \beta\mathcal{L}_{\text{dis}} + \gamma\mathcal{L}_{\text{dpo}} \tag{6}$$
$\alpha,\beta,\gamma$ 为超参。(式 (5) 的 DPO 温度与式 (6) 的判别损失权重都记作 $\beta$,符号冲突;三个权重的取值、DPO 的 $\beta$、是否分阶段训练、学习率与步数,论文均未给出。)
Training Data 的组织。 对 query $q$,从线上日志取两组广告:有点击的相关集 $A=\{a_1,\dots,a_n\}$ 与不相关集 $B=\{b_1,\dots,b_n\}$。生成模型只用 $A$ 训练 $\mathcal{L}_{\text{gen}}$;$\mathcal{L}_{\text{dis}}$ 与 $\mathcal{L}_{\text{dpo}}$ 同时用 $A$ 和 $B$。具体做法:
- 取 $C = A\cup B$,按商业价值降序排列(这个顺序即 $\mathcal{L}_{\text{dpo}}$ 要学的排序);
- 对每个 $c_i\in C$:若 $c_i\in A$,生成损失 mask $m_i=1$、相关性标签 $1$;若 $c_i\in B$,$m_i=0$、标签 $0$(这些标签即 $\mathcal{L}_{\text{dis}}$ 的监督);
- 最终生成损失为 mask 与 $\mathcal{L}_{\text{gen}}$ 的逐元素乘积,即 $\sum_i m_i\,\mathcal{L}_{\text{gen}}^{(i)}$。
这意味着 GDR-LLM 的三个能力共享同一批 (query, 候选) 数据,只是监督信号不同:生成只模仿被点击的,判别区分点/不点,DPO 按消耗排序。
3.3 广告索引(Ad Indexing)¶
分层标识符:Intent × Abstract。 每条广告由两种互补文本联合表示:
- 语义意图(intent,SText):压缩文本,给出广告商业意图的高层概括;
- 文本摘要(abstract,STerm):从广告展示标题中抽取的 n-gram,保留具体事实细节与关键短语。
二者组合(SText × STerm)既有意图带来的宽泛概念理解,又有摘要带来的精确、有依据的信息。
Table 1:一条广告的 int-abs pair 示例(宽泛意图捕获潜在需求,精确摘要传达产品信息)
| Ad Information | Commercial Intents | Ad Abstract |
|---|---|---|
| Title: In Endless Winter, as long as the fire burns well, there are no worries about life in the apocalypse! | Role-playing Games | Endless Winter |
| Post-apocalyptic Mobile Games | Endless Winter | |
| Survival Challenge Game | Endless Winter |
以游戏《Endless Winter》为例:intent 指其宽泛商业品类或玩法类型(「Role-playing Game」「Survival Challenge Game」),abstract 只限于广告中出现、与标题直接相关的关键词(「Endless Winter」)。一条广告可以挂多个 intent,形成多条 int-abs pair。
索引构建。
- 用 LLM 为库中所有广告生成语义意图,按行业去重清洗,得到约 70 万个粗粒度商业意图类目;
- 在这 70 万意图类目上对广告库做约束 beam search,为每条广告生成落在类目集合内的 intent(Figure 1 的 Ad Index Construction 模块);
- LLM 为每条广告自由(无约束)生成文本摘要,构成 intent × abstract 分层表示;
- 以 int-abs pair 为 key 建倒排索引。
新广告:先在约束下生成 intent,再无约束生成 abstract,直接入索引,不需要重训模型或重新学习表示到广告的映射。
描述上的不一致:§3.3 把 abstract 定义为「从广告展示标题抽取的 n-gram」,而索引构建步骤说 abstract 由 LLM「自由生成」,附录 Table 5 的蒸馏 prompt 又把 abstract 规定为「Brand/Core Service」(品牌或核心服务名)。三者可以大致调和(LLM 生成的品牌/核心服务名通常就出现在标题里),但论文没有给出抽取式与生成式的明确界定。
3.4 检索(Retrieval)¶
动态约束 beam search(Dynamical Constrained Beam Search, DCBS)。 DCBS 用一个动态建树模块保证生成的广告都属于预定义的有效集合。
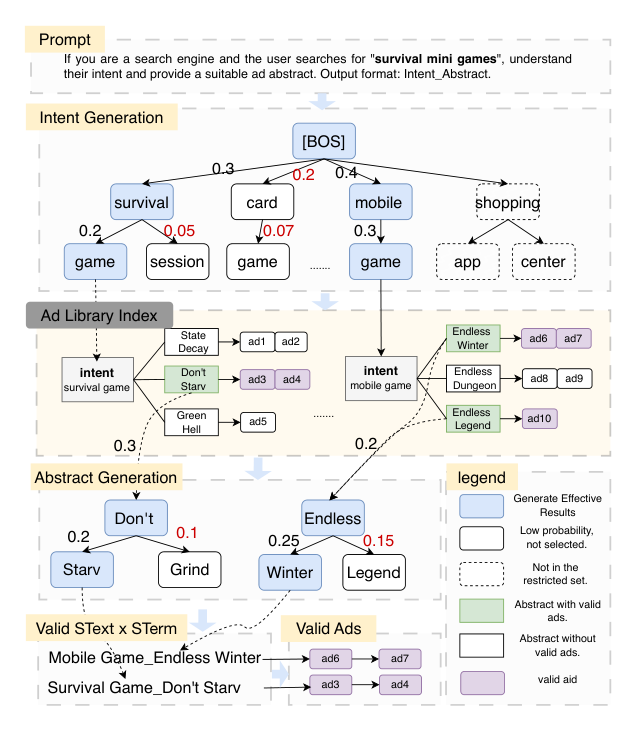
Figure 3(beam size = 2 的示意)的过程:
- Intent 生成:从
[BOS]出发在 intent 前缀树上解码。第一步候选 survival(0.3) / card(0.2) / mobile(0.4) / shopping(不在受限集合中,虚线框);第二步 survival → game(0.2) / session(0.05),mobile → game(0.3),card → game(0.07)。低概率分支(红色概率)不被选中,最终保留 intent「survival game」与「mobile game」; - 查 Ad Library Index:survival game 下挂的摘要有 State Decay(ad1, ad2)、Don't Starv(ad3, ad4)、Green Hell(ad5);mobile game 下有 Endless Winter(ad6, ad7)、Endless Dungeon(ad8, ad9)、Endless Legend(ad10)。只有对应「有效广告」的摘要(绿色)被保留——图中 Don't Starv 与 Endless Winter、Endless Legend 有有效广告,其余摘要的广告对当前用户无效;
- Abstract 生成:把保留的摘要动态重组为新的约束树,LLM 在其上继续解码:Don't(0.3) → Starv(0.2) / Grind(0.1);Endless(0.2) → Winter(0.25) / Legend(0.15);
- 输出:有效的 SText × STerm 为
Mobile Game_Endless Winter、Survival Game_Don't Starv,对应有效广告 ad6, ad7 与 ad3, ad4。
关键点在于「有效」是用户相关的:同一 query,不同用户可投放的广告集合不同(例如只定向女性用户的广告对男性搜索者无效),因此有效 int-abs pairs 要按用户特征动态生成。若某 intent 下所有摘要都无效,该 intent 也被丢弃、终止该路径。
与 MCA 的对比动机。 把全量广告组织成一棵约束树能保证任何广告都「有机会」被召回,但其中大量广告对当前用户无效;MCA 依赖定向过滤模块事后剔除,导致很多满足相关性和商业标准的候选最终白生成。DCBS 把有效性约束直接并入生成过程,实时剪掉无效 int-abs pair,作者称这既保证候选全部对目标用户有效,又减少下游检索与过滤的浪费。
检索流程。 收到 query 后,GDR-LLM 先做约束生成得到一束候选意图 → DCBS 过滤掉不对应任何有效广告的摘要 → 有效摘要重组为约束树、LLM 继续生成 → 生成完所有有效 int-abs pair 后,判别头给出 query 与每个 int-abs pair 的相关性分,「用于评估生成结果的质量」。用步骤化伪代码概括:
输入: query q, 用户 u, 倒排索引 Index: (intent, abstract) -> ads
1. ValidAds(u)  <- 按 u 的定向属性得到的可投放广告集合
2. IntentTrie   <- 只含 ∃abstract 使 Index(intent, abstract) ∩ ValidAds(u) ≠ ∅ 的 intent
3. beams_I      <- ConstrainedBeamSearch(GDR-LLM, prompt(q), IntentTrie, B)   # intent ≤ 3 tokens
4. for each intent i in beams_I:
       AbsTrie_i <- { a | Index(i, a) ∩ ValidAds(u) ≠ ∅ }                      # 动态重建
5. pairs        <- ConstrainedBeamSearch(GDR-LLM, prompt(q)+i, ∪AbsTrie_i, B) # abstract ≤ 4 tokens
6. scores       <- DiscriminatorHead(q, pairs)        # 相关性分,论文未说明是否用于过滤/重排
7. ads          <- ∪ Index(pair) ∩ ValidAds(u)  -> 直接送入精排
论文没有交代:ValidAds(u) 如何在线计算、约束树是否每请求重建及其开销、一个 int-abs pair 对应多条广告时这些广告之间如何排序(这决定 HR@10 的计算)、判别分是否参与截断。
关键技术细节¶
训练数据(§4.1、附录 B、Table 5)¶
- 广告侧(ad-side):用基座 LLM。数据来自 ChatGPT 等「开源模型」(原文如此):把线上广告信息(标题、落地页)输入模型生成每条广告的 int-abs pair,清洗后得到约 5,000 条训练样本。附录 B 说明:对每个广告标题先让模型生成广告意图,再要求生成简洁摘要,二者经严格清洗后组合成同一标题下的多条 int-abs pair。
- 查询侧(query-side):用 GDR-LLM。SFT 数据来自近一个月线上点击日志,加入负样本后共 430,000 条;再按线上实际消耗对每个 query 关联的广告做商业排序,训练 DPO。
Table 5:微调数据细节
| Model Used | Prompt(摘要) | Output(摘要) | Data Size |
|---|---|---|---|
| GDR-LLM(query-side) | 「作为搜索系统,当用户输入 query = "12306",先分析用户搜索意图,再基于该意图推荐合适广告并生成对应的广告摘要信息」 | 来自线上点击日志:Train Ticket Booking_12306 Official; High-Speed Rail Ticket_12306 Official; Online Ticketing_12306 Official; Travel Services_12306 Official…… | 5k |
| Base LLM(ads-side) | 任务:根据用户搜索 query 生成广告标题并为每个标题抽取摘要,格式为「Commercial Intent_Brand/Core Service」;正例「Organic Vegetables_Meituan Grocery」,反例「Organic Vegetables_Direct from Source」(卖点而非品牌/服务);商业点须直接反映搜索意图、避免模糊词;摘要须含品牌名或核心服务名;分 5 步:识别商业点 → 为每个商业点生成广告标题 → 抽取合规摘要 → 组合 → 最后一行分号拼接 | ChatGPT 等的分步输出:商业点分析(火车票预订 / 高铁折扣 / 在线票务 / 出行服务)→ 广告标题生成 → 标题摘要抽取 → 最终输出 4 条 Business Point_Brand/Core Service | 430k |
数据规模与正文矛盾:§4.1 说广告侧约 5k、查询侧 430k,Table 5 却把 5k 标在 GDR-LLM(查询侧)、430k 标在 Base LLM(广告侧)。此外 Table 5 广告侧 prompt 的输入是用户 query(「根据 query 生成广告标题」),与 §4.1「把线上广告标题、落地页输入模型」的说法也不一致。论文未澄清。
模型与在线实现(§4.1 Implementation、附录 D)¶
- 广告侧:用 Hunyuan-13B 为广告生成分层文本(离线,每小时更新索引);
- 查询侧:因线上时延严格,用 Hunyuan-1B(即 ANGLE-1B),beam size = 64;
- 长度上限:为保证线上稳定,intent 最多 3 个 token、abstract 最多 4 个 token;
- 时延:Hunyuan-1B 每 token 约 8 ms,生成一个 int-abs pair 的总时间「被限制在 90 ms 以内」,满足线上要求;
- 索引更新:广告索引每小时更新,新广告快速生成 int-abs pair 入索引,过期广告及时剔除;
- 推理集群(附录 D):专用 GPU 集群由数百张 L40 组成,负载分配与峰值利用率优化后 GPU 利用率接近 90%;模型转 FP8,每张 L40 约处理 30 QPS;对输入预处理、模型推理、输出后处理与网络传输逐项优化,「确保每个请求在 60 ms 内完成」。
时延口径自相矛盾:正文说 int-abs 生成限制在 90 ms 内,附录说端到端 60 ms 内。按 3+4=7 个 token × 8 ms ≈ 56 ms 推算,60 ms 更像是「解码 token 数 × 单 token 时延」的预算估算,而不是测得的端到端分布。
实验设置¶
评测数据集。 收集一个月线上曝光与点击数据,选 1 万个 query 及其被点击广告;每个 query 最多纳入 1k 候选广告;为增加难度,从广告库随机采样无关广告加入候选池;最终约 22 万条广告候选。(22 万 / 1 万 ≈ 平均每 query 22 条,与「每 query 最多 1k」一起读,说明多数 query 远达不到上限;更关键的是,论文没说 ANGLE 的 DCBS 离线时约束在哪个集合上——若约束集就是这 22 万候选的 int-abs,而基线要在全量关键词库里做 HNSW 映射,两者的检索空间并不对等。)
基线(7 个)。
- Semantic-based:用 BERT 或 SimBert-v2(RoFormer-Sim) 分别为 query 与关键词(bidword)生成语义 embedding,ANN 检索与 query 相关的关键词。两者都是 12 层 Transformer、hidden 768、12 头,约 1.1 亿参数;训练时线上点击日志作正样本,batch 内随机采样作负样本。表中 SimBert-v2-R 归入此组;
- Generative Retrieval:SimBert-v2-G、T5-base,直接从 query 生成商业关键词;
- LLM-based Generative Retrieval:Qwen-1.8B、Hunyuan-2B、DSI-1B,同样直接生成商业关键词。因无约束解码可能产出不对应任何真实广告的关键词,统一用 HNSW 在已有库中找最相似关键词作最终输出。
基线的检索目标是「关键词」,ANGLE 的目标是「int-abs pair」,二者最终都要落到广告级 HR,但论文没说明关键词→广告的展开与排序规则。更重要的是:7 个基线里没有任何一个 RQ-VAE 式 SID 生成式召回(TIGER / OneSearch 类),也没有同作者的 RARE。DSI-1B 名义上是 ID 类方法,但正文说它也「直接生成商业关键词」,其 HR@10 仅 0.0320,协议不清。
评测指标(附录 C)。
- ACR(Ad Coverage Rate):正文描述为「系统能从广告池中召回的不重复广告占全部可用广告的比例」,越高代表用户能接触到更多样的广告、对广告主更公平;但公式定义为请求级覆盖率。AdPV 为有广告召回的请求数,PV 为总请求数:
$$\text{ACR} = \text{AdPV}/\text{PV} \tag{7}$$
- HR@K(Hit Ratio):top-K 结果中属于真值集的相关广告占比,Hits@K 为 top-K 中命中真值集的广告数,GT 为真值广告集合:
$$\text{HR@K} = \frac{\text{Hits@K}}{|\text{GT}|} \tag{8}$$
- MAP(Mean Average Precision):对所有 query 的 AP 取平均:
$$\text{MAP} = \frac{1}{Q}\sum_{q\in Q}\text{AP}_q \tag{9}$$
其中 $\Omega_q$ 为真实相关项集合,$p_{qj}$ 为广告 $ad_j$ 在输出列表中的排名位置,$p_{qj}<p_{qi}$ 表示 $ad_j$ 排在 $ad_i$ 之前:
$$\text{AP}_q = \frac{1}{|\Omega_q|}\sum_{i\in\Omega_q}\frac{\sum_{j\in\Omega_q} h(p_{qj}<p_{qi}) + 1}{p_{qi}} \tag{10}$$
ACR 的文字定义(广告级多样性)与公式 (7)(请求级「有无召回」)是两个不同的量。按公式,ACR 只衡量「请求有没有召回到广告」,约束解码天然保证每次都有有效输出,因此 ACR 高主要反映「不会空召回」,而非准确性——DSI-1B 的 HR@10 只有 0.0320,ACR 却是基线中最高的 55.49%,正说明 ACR 与命中质量几乎无关。
主要实验结果¶
离线对比¶
Table 2:ANGLE 与基线的离线对比
| 类别 | Method | HR@10 | HR@50 | HR@100 | MAP | ACR |
|---|---|---|---|---|---|---|
| Semantic-based | Bert | 0.1313 | 0.2384 | 0.3075 | 0.3910 | 47.70% |
| Semantic-based | SimBert-v2-R | 0.1339 | 0.2265 | 0.2830 | 0.3966 | 47.71% |
| Generative Retrieval | SimBert-v2-G | 0.1294 | 0.2374 | 0.3095 | 0.3852 | 36.89% |
| Generative Retrieval | T5-base | 0.0981 | 0.1880 | 0.2495 | 0.2910 | 29.15% |
| LLM-based GR | Qwen-1.8B | 0.0960 | 0.1887 | 0.2524 | 0.3138 | 47.27% |
| LLM-based GR | Hunyuan-2B | 0.1153 | 0.2184 | 0.2889 | 0.3519 | 42.51% |
| LLM-based GR | DSI-1B | 0.0320 | 0.0830 | 0.1058 | 0.2831 | 55.49% |
| Ours | ANGLE-1B | 0.1961 | 0.4834 | 0.5273 | 0.4834 | 69.17% |
逐指标的「最强基线 → ANGLE」:
| 指标 | 最强基线 | 基线值 | ANGLE | 绝对差 | 相对提升 |
|---|---|---|---|---|---|
| HR@10 | SimBert-v2-R | 0.1339 | 0.1961 | +0.0622 | +46.5% |
| HR@50 | Bert | 0.2384 | 0.4834 | +0.2450 | +102.8% |
| HR@100 | SimBert-v2-G | 0.3095 | 0.5273 | +0.2178 | +70.4% |
| MAP | SimBert-v2-R | 0.3966 | 0.4834 | +0.0868 | +21.9% |
| ACR | DSI-1B | 55.49% | 69.17% | +13.68pp | — |
分析。
- 最强基线是 1.1 亿参数的 BERT/SimBert 双塔,而不是 LLM。三个 LLM 生成式基线(1B~2B)全面弱于 110M 语义模型:Hunyuan-2B 的 HR@10 0.1153 低于 SimBert-v2-R 的 0.1339,Qwen-1.8B 更低。这说明「LLM 生成关键词 + HNSW 事后映射」本身就是一个吃亏的协议——生成的关键词偏离库内词、映射引入噪声。ANGLE 与这些 LLM 基线的差距(对 Hunyuan-2B:HR@10 +70.1%、HR@50 +121.3%、HR@100 +82.5%、MAP +37.4%)很大程度上是在对比「有约束解码」和「无约束 + 事后映射」。
- HR@50 翻倍而 HR@10 只 +46.5%:ANGLE 的优势主要在深位置覆盖。一个 int-abs pair 会展开成多条广告,beam 64 × 每 pair 多广告,在 K=50/100 时天然能覆盖更多真值;而 K=10 更依赖精确排序,优势小得多。
- ANGLE 的 HR@50 与 MAP 同为 0.4834,Table 2 与 Table 4 两处一致。Table 4 的四个消融行里 MAP 与 HR@50 相差 0.005~0.098,没有一行完全相等,疑为制表时抄错了其中一个数,结论需打折。
- 论文只给单次点估计,无方差、无显著性检验。
线上 A/B¶
Table 3:ANGLE 在真实搜索系统中的应用
| Online Scenarios | Consumption | GMV | Clicks | Conversions | Exposure |
|---|---|---|---|---|---|
| WTS (anonymous) | +1.81% | +2.16% | +1.50% | +1.44% | +2.49% |
| QBS (anonymous) | +6.57% | +5.01% | +6.11% | +0.72% | +7.82% |
正文:用 20% 流量做了 5 天 A/B,「消耗显著提升 1.18%、GMV 提升 2.16%」,转化与点击均有不同程度提升。ANGLE 目前已全量应用于 WTS 与 QBS,作为排序队列的补充(as a supplement to the ranking queue)。作者据此认为 ANGLE 有效缓解了 MCA 的目标不一致问题。
分析。
- 数字不一致:摘要与 Table 3 为消耗 +1.81%,正文写成 +1.18%;QBS 一行在正文中完全没有描述(实验时长、流量、对照组均未知)。
- 收益是量驱动而非质驱动。从 Table 3 推算单位效率(实验组相对对照组的比值):
| 场景 | 消耗/曝光 | 点击/曝光(CTR) | 转化/点击(CVR) | 消耗/点击(CPC) |
|---|---|---|---|---|
| WTS | −0.66% | −0.97% | −0.06% | +0.31% |
| QBS | −1.16% | −1.59% | −5.08% | +0.43% |
两个场景都是曝光涨幅 > 点击涨幅 > 消耗涨幅,单位曝光的点击与消耗都在下降,QBS 的 CVR 甚至降了约 5%。这与「作为排序队列的补充」完全吻合:新增一条通道把更多广告送进精排,填充了原本无广告或广告少的请求,总量上去了,但单条广告质量并未更好。这与离线 ACR(请求级有无召回)大涨 13.68pp 也相互印证。 3. 对照组没有定义。从「supplement」的措辞看,对照组应是不含 ANGLE 通道的生产 MCA,实验组是「MCA + ANGLE 通道」,并不是标题与 Figure 2 暗示的「用一步式 LLM 替换 MCA」。
消融与分析¶
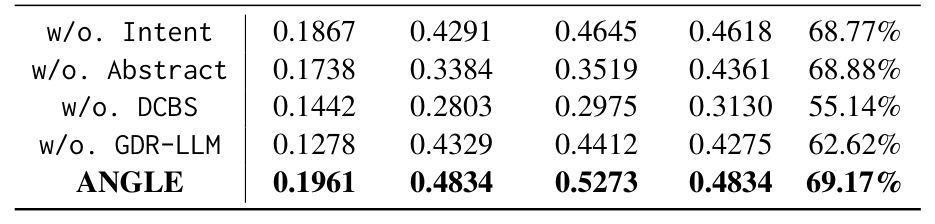
Table 4:ANGLE 消融
| Method | HR@10 | HR@50 | HR@100 | MAP | ACR |
|---|---|---|---|---|---|
| w/o. Intent | 0.1867 | 0.4291 | 0.4645 | 0.4618 | 68.77% |
| w/o. Abstract | 0.1738 | 0.3384 | 0.3519 | 0.4361 | 68.88% |
| w/o. DCBS | 0.1442 | 0.2803 | 0.2975 | 0.3130 | 55.14% |
| w/o. GDR-LLM | 0.1278 | 0.4329 | 0.4412 | 0.4275 | 62.62% |
| ANGLE | 0.1961 | 0.4834 | 0.5273 | 0.4834 | 69.17% |
变体定义:w/o Intent 仅用 abstract 表示广告;w/o Abstract 仅用商业意图表示广告(≈ RARE 式单层意图标识);w/o DCBS 去掉动态约束解码,让 LLM 自由生成 int-abs 再用 ANN 找相似 int-abs 取广告;w/o GDR-LLM(正文误写为 GDC-LLM)用「base LLM」做约束生成——base LLM 是否经过仅含 $\mathcal{L}_{\text{gen}}$ 的 SFT,论文没说。作者结论:去掉任何模块都会损害整体性能。
把消融退化放到「相对最强基线的总优势」里看(退化量 ÷ ANGLE 相对最强基线的绝对优势;>100% 表示该变体已跌破最强基线):
| 变体 | HR@10 | HR@50 | HR@100 | MAP | ACR |
|---|---|---|---|---|---|
| w/o Intent | −4.8%(占优势 15%) | −11.2%(22%) | −11.9%(29%) | −4.5%(25%) | −0.40pp(3%) |
| w/o Abstract | −11.4%(36%) | −30.0%(59%) | −33.3%(81%) | −9.8%(54%) | −0.29pp(2%) |
| w/o DCBS | −26.5%(83%) | −42.0%(83%) | −43.6%(106%) | −35.3%(196%) | −14.03pp(103%) |
| w/o GDR-LLM | −34.8%(110%) | −10.4%(21%) | −16.3%(40%) | −11.6%(64%) | −6.55pp(48%) |
逐项分析。
- DCBS 是承重组件。去掉它后 HR@10/HR@50 只比最强基线高 7.7%/17.6%,HR@100(0.2975 < 0.3095)、MAP(0.3130 < 0.3966)、ACR(55.14% < 55.49%)全部跌破最强基线。也就是说,ANGLE 对基线的绝大部分优势来自「在有效集合上约束解码」,而不是来自标识方式或多任务训练。而「w/o DCBS = 自由生成 + ANN 映射」恰好是与 LLM 基线协议最接近的变体:拿它和 Hunyuan-2B(自由生成关键词 + HNSW)比,HR@10 +25.1%、HR@50 +28.3%、HR@100 +3.0%、MAP −11.1%、ACR +12.63pp——在协议对齐后,「int-abs 文本标识 + GDR 训练 + 1B」对「关键词 + 基座 SFT + 2B」只有有涨有跌的中等差异。
- 离线的 DCBS 收益主要是「目录有效性」而非「用户定向有效性」。离线评测集是 query → 点击广告,并无按用户定向剔除广告的设定,所以 w/o DCBS 的大幅退化反映的是「约束到库内存在的 int-abs」(与 TIGER 类 Trie 约束同理),而不是论文重点宣传的「按用户动态剪枝」。后者的收益没有被任何实验单独度量。
- GDR-LLM 主要改善头部排序。去掉后 HR@10 −34.8% 且跌破最强基线,但 HR@50 只 −10.4%、仍比最强基线高 81.6%。这与 DPO(学商业序)+ 判别头(学点击)的作用一致:它们改变的是候选的先后顺序,而不是能否覆盖到。反过来说,在 HR@50/HR@100 上,不经 GDR 训练的「文本标识 + DCBS」已拿到 79%/60% 的总优势,「生成-判别-排序统一进一个 LLM」这一署名贡献主要体现在 HR@10 上。
- 分层表示中 abstract 贡献远大于 intent。去掉 abstract(只剩意图,≈RARE 式表示)HR@100 −33.3%,去掉 intent 只 −11.9%。ANGLE 相对「w/o Abstract」的 HR@100 +49.8%、HR@50 +42.8%、HR@10 +12.8%——这是论文里唯一能间接说明「相对前作 RARE 的推进」的证据,但它是在同一套 GDR-LLM + DCBS 下只换标识,并非与真正的 RARE 系统对比。
- ACR 对表示层级几乎不敏感(去 intent/abstract 均 <0.4pp),只对 DCBS(−14.03pp)和 GDR-LLM(−6.55pp)敏感,再次说明 ACR 衡量的是「能否产出有效召回」,与标识设计关系不大。
核心主张的证据核查¶
1. 文本标识 vs 语义 ID 的收益是否被隔离?——没有¶
全文不存在任何 SID 臂:没有 RQ-VAE/RQ-KMeans SID 的生成式召回基线,更没有「同一个 Hunyuan-1B、同样的 GDR 三损失、同样的约束解码,只把 int-abs 换成 SID」的对照。Table 2 中 ANGLE 相对基线同时改变了:(a) 标识方式(关键词 → int-abs);(b) 解码协议(无约束 + HNSW → 有效集约束);(c) 训练目标(单一生成 → gen + 判别 + DPO);(d) 模型与规模(BERT 110M / Qwen 1.8B / Hunyuan 2B → Hunyuan 1B)。消融只在「文本标识内部」拆 intent/abstract,从未把文本换成 SID。第 1 节「SID 需要记忆映射、泛化差、解码低效」的核心论点完全没有实验支撑;新广告泛化也没有专门评测(如按广告上线时间切分的冷启动子集)。
可作参照的外部受控证据显示标识方式本身的效应量并不大:OneRetrieval 在相同布局/训练/评测下只换编码范式,关键词对齐编码相对 RQ-VAE 的 Order HR@350 +7.4%、Click HR@350 +9.4%;Spotify 在同一 Qwen3-1.7B 上比较 Title 与 SID,无推理时 R@10 在三个域上为 +7.6% / −0.5% / −7.9%。两者都是个位数百分比,与 ANGLE 相对基线 +46%~+103% 的 HR 差距不在一个量级——ANGLE 的离线优势很难主要归因于「文本而非 SID」。
2. 线上收益归因——归不到标识设计上¶
A/B 对照组没有定义,部署形态是「作为排序队列的补充」,即新增一条 LLM 召回通道。没有「同一通道换 SID」臂,没有「通道保留但去掉 DPO/判别头」臂,也没有「只关掉通道」之外的任何机制拆分。Table 3 显示两个场景曝光涨幅都大于消耗与点击涨幅,单位曝光效率下降(WTS 消耗/曝光 −0.66%,QBS −1.16%,QBS CVR −5.08%),收益形态是「增量供给/填充率」而非「更好的匹配」。另外 5 天、无显著性、正文 1.18% 与表 1.81% 矛盾、QBS 无任何实验描述。线上结果能证明的只是「加一条 LLM 生成式召回通道有增量」,不能证明「分层文本标识」或「三合一 GDR-LLM」的有效性。
3. 「Real-Time」是否被测量——只有预算口径,没有测量¶
论文给出的时延信息全是估算或上限:「每 token 约 8 ms」「int-abs 生成限制在 90 ms 内」「每个请求 60 ms 内完成」「每张 L40 FP8 约 30 QPS」「数百张 L40、利用率近 90%」。缺失:P50/P99 分布;DCBS 每请求计算有效广告集并重建约束树的开销;判别头是否对 beam 中每个 int-abs 额外前向;与 MCA 原有召回+相关性+粗排链路的时延/算力对比;w/o DCBS 的时延对照。90 ms 与 60 ms 两个口径也互相矛盾。30 QPS/卡意味着「数百张 L40」只能承载数千到两万余 QPS,算力成本与 +1.81% 消耗之间的 ROI 未做任何讨论。标题中的「Real-Time」更多指小时级索引更新与按用户动态约束,而非经过测量的延迟保证。
4. 消融退化幅度 vs 相对最强公开基线的总优势¶
「最强公开基线」都是作者在内部数据上复现的,没有公开数据集结果。在内部离线集上:去掉 DCBS 抹掉 83%~196% 的总优势(HR@100、MAP、ACR 跌破最强基线);去掉 GDR-LLM 抹掉 HR@10 上 110% 的优势(跌破最强基线),但只抹掉 HR@50 上 21%;去掉 abstract 抹掉 HR@100 上 81%;去掉 intent 只抹掉 15%~29%。结论:总优势 ≈ 约束解码(主)+ abstract 层(次)+ GDR 训练对头部排序的修正;intent 层与「按用户动态」这两个名义卖点贡献最小或未被测量。
核心贡献总结¶
- 把 RARE 的「商业意图文本作广告标识」扩成两级「intent × abstract」:约 70 万个行业去重意图类目提供粗粒度路由,品牌/核心服务级摘要提供细粒度定位;新广告只需离线生成 int-abs 即可入索引,不需重训查询侧模型。
- 动态约束 beam search:先在意图树上解码,再按当前用户的可投放广告动态重建摘要约束树,把定向有效性前移到解码过程中。
- GDR-LLM:在同一个 1B LLM 上叠加生成交叉熵、
[CLS]+MLP 判别头(点击标签)与按消耗排序的 DPO,用一个 $\mathcal{C}=A\cup B$ 的候选列表同时产出三种监督。 - 工业部署:Hunyuan-13B 离线造标识、Hunyuan-1B FP8 在线生成,数百张 L40,作为补充通道全量上线 WTS/QBS。
与已归档相关工作的对比¶
UniGD UniGD: A Unified Generative-Discriminative Framework for Industrial Search Advertising (Kuaishou, 2026-08-04)¶
关系:独立并发(本文未引用 UniGD,两者殊途同归)· 已加载对方精读
- 共同关注的问题:搜索广告中「生成式召回 + 外部相关性模型」的级联导致目标割裂——相关但生成概率低的广告在 top-K 截断时就被丢掉,外部模型还带来额外时延;两者也都把「新广告能否立刻可用」当作核心约束(UniGD 报告新广告占日流量 36.9%)。
- 相近的技术骨架:同一个生成骨干上联合训练「自回归生成标识符」与「query-广告相关性判别头」,生成的候选不再经过单独的相关性模块,直接进下游;标识→广告靠独立于模型的索引,新广告增量入索引。
- 本文的差异与推进:ANGLE 的标识是 LLM 生成的文本 int-abs(倒排索引),判别头为 prompt 末尾
[CLS]+ MLP、用点击标签做 BCE,并额外加入按消耗排序的 DPO;UniGD 的标识是冻结多模态码本上的 RQ-KMeans SID,判别侧用 CAM(按 SID 取码字求和重建广告表征)+ query 均值池化 + 适配器,监督来自人工标注或离线 teacher(Qwen2-VL-7B)的归一化相关性分,并用 CAGE 梯度手术协调两个目标、三阶段训练;ANGLE 只是 $\alpha,\beta,\gamma$ 加权求和,未报告任何梯度冲突分析。UniGD 还按素材类型(视频/商品/直播)分码本与生成头。 - 可比的方法 / 实验差异:UniGD 的线上 A/B 设置了「生产级联 / GR+RelToken / UniGD-Gen(保留生成组件但判别换回生产相关性模型)/ UniGD」四臂,单独隔离出「把判别搬进模型内部」一步的收益(收入 +3.54%→+5.78%、时延 12.9→8.7 ms),并实测相关性违规率(6.79%→5.81%);ANGLE 恰恰缺少这种「机制拿掉、其余不变」的线上臂,也没有不相关率之类的相关性线上指标。两篇合看,「相关性内化进生成模型」是 2026 年搜索广告生成式召回的共同方向,而 SID 与文本标识两条路线都能做到新广告即入即用——ANGLE 所谓「SID 泛化差」的论断并不必然成立。
OneRetrieval OneRetrieval: Unifying Multi-Branch E-commerce Retrieval with an Editable Generative Model (Kuaishou, 2026-06-11)¶
关系:独立并发(本文未引用 OneRetrieval,两者殊途同归)· 已加载对方精读
- 共同关注的问题:闭码本 SID(RQ-VAE 等)的码槽绑死在量化 embedding 上、没有自然语言语义锚,导致不可解释、新词/新物料无法在不重训的情况下接入。
- 相近的技术骨架:让生成式召回的标识符承载自然语言语义,利用预训练语言模型先验;标识→物品为一对多查表映射,新物料通过更新索引/字典接入而非重训策略。
- 本文的差异与推进:OneRetrieval 保留整数码,但把 6 个位置分别对齐到 108 万属性词的合并组(ECOM6),编码用 Aho-Corasick 确定性匹配,另留预留槽供运营绑定新词,BART-base、无约束 beam 512;ANGLE 直接生成原始文本 token(intent ≤3、abstract ≤4),用约束解码保证落在库内。OneRetrieval 明确批评开放词表文本标识(SEAL、GRAM 一类)「新词能否被路由到目标物品完全依赖模型泛化,没有显式绑定机制」——这一批评同样适用于 ANGLE 的 abstract 层:新品牌摘要虽能入索引,但查询侧 1B 模型从未见过它时能否生成出来,ANGLE 没有给任何新广告评测。
- 可比的方法 / 实验差异:OneRetrieval 做了 ANGLE 缺失的受控对照——固定 L6 布局、共享 Stage 1–3 训练与评测,只换编码范式,关键词对齐编码 Order HR@350 0.5452 对 RQ-VAE 0.5075(+7.4%),Click 0.6033 对 0.5516(+9.4%);线上还有「只移除旧分支、不启用新模型」臂(无显著变化),把增益归到新模型本身。这给出了标识方式效应量的一个量级参照:个位数百分比,远小于 ANGLE 对基线的 HR 差距。
GRACE GRACE: Generative Recommender Acceleration Engine for Real-Time Ads Retrieval (Meta, 2026-08-02)¶
关系:独立并发(本文未引用 GRACE;与 ANGLE 的 DCBS 与实时服务部分同构)· 已加载对方精读
- 共同关注的问题:广告主定向规则是请求级、个性化的,而生成式模型只在稳定的标识空间上预测高概率标识;「先生成再过滤」会让大量生成结果在进入排序前被丢弃,白花算力、稀释有效候选。
- 相近的技术骨架:在前缀树上做约束 beam search,每一步把「子树中不含任何对当前用户合格的广告」的分支剪掉,把定向过滤从解码后移到解码中。
- 本文的差异与推进:GRACE 明确区分「目录有效性」(catalog-valid,STATIC 式)与「个性化合格性」,在 SID trie 每个节点离线挂 subtree-union 的 bitmask(低基数属性)与 Bloom filter(高基数属性),解码时由融合 GPU kernel 与 CD 约束一起施加;ANGLE 的 DCBS 在文本 int-abs 两级树上「按用户有效广告动态重建约束树」,但有效集如何计算、是否每请求重建、代价多少均未描述,离线消融也没有把目录约束与用户定向约束分开。
- 可比的方法 / 实验差异:GRACE 量化了合格性约束本身的效果(广告级定向通过率 23.55%→40.42%)和逐项时延代价(P50/P99 表:Bloom 匹配使解码器 16.6→25.0 ms,端到端 P99 53.6 ms,落在 70 ms 计算窗口内),解码器相对 FlashAttention 基线 P99 197.7→17.8 ms;ANGLE 在「Real-Time」这一标题主张上只有「每 token 8 ms」「60/90 ms 以内」「30 QPS/卡」的预算口径。GRACE 选择轻量 encoder-decoder 而非 LLM、宽 beam(16×1024),ANGLE 选择 1B LLM、beam 64、每卡 30 QPS——两者代表「生成式广告召回实时化」的两种算力取舍,ANGLE 没有给出支撑其取舍的测量。
讨论与局限性¶
值得借鉴的设计¶
- 两级文本标识的粒度切分:粗粒度意图类目离线收敛成一个有限集合(约 70 万),细粒度摘要保留品牌/服务名,相当于用文本做了一个「语义前缀 + 实体后缀」的层次标识。消融显示 abstract 层对深位置召回贡献很大(HR@100 +49.8%),这比单层意图(RARE)更适合搜索广告里「query 常常直接包含品牌」的特点。
- 标识生成与查询模型解耦:广告侧用 13B 离线造标识、查询侧 1B 在线生成,新广告无需重训查询侧模型即可入索引,工程上对小时级新陈代谢的广告库友好。
- 把定向约束前移到解码:思路正确,与 GRACE 独立得出同一结论,是生成式广告召回走向生产的必要条件。
- 用同一批 $A\cup B$ 候选同时构造生成 mask、判别标签与 DPO 顺序,数据组织简洁。
局限与争议¶
- 核心论点无对照:全文围绕「文本标识优于 SID」展开,却没有任何 SID 基线或同模型换标识的对照,也没有新广告泛化评测;同作者前作 RARE 未作为基线。
- 基线协议不对等:所有生成式基线都是「无约束生成关键词 + HNSW 事后映射」,而 ANGLE 用约束解码;消融显示去掉约束解码后 ANGLE 的优势基本消失。离线约束集与基线检索空间是否一致也未交代。
- 数值与描述矛盾多:消耗 +1.81% vs +1.18%;ANGLE 的 HR@50 与 MAP 同为 0.4834;训练数据 5k/430k 在正文与 Table 5 中对调;时延 90 ms vs 60 ms;beam size 在 Figure 1(4)、Figure 3(2)、实现(64)不一;ACR 的文字定义与公式不符;abstract 是抽取还是生成说法不一;广告库量级 $10^{10}$ vs 千万级;变体名 GDR-LLM / GDC-LLM 混用。
- 关键实现缺失:$\alpha,\beta,\gamma$、DPO 温度、学习率、训练步数、是否分阶段均未给出;判别头推理时如何接入、是否参与截断未说明;一个 int-abs 对应多条广告时的广告间排序未说明;DCBS 有效集的在线计算方式未说明。
- 「One-Step」有夸大:精排仍是独立的现有模型(Limitations 自己承认没法去掉排序),GDR-LLM 实际替代的是召回 + 相关性 + 粗排;线上部署形态是「补充通道」而非替代 MCA。
- 「相关性」即点击:判别头学的是点击与否,不是语义相关性;搜索广告对相关性要求很高,但论文没有任何相关性违规率或人工评测。
- 线上收益形态:曝光涨得比消耗、点击快,单位曝光效率下降,QBS CVR 约 −5%;收益更像增量供给而非匹配质量提升。
- 可扩展性:查询侧受时延所限只能用 1B、intent ≤3 token、abstract ≤4 token;意图类目集合需要行业级人工清洗;每卡 30 QPS 的吞吐使扩大模型的边际成本很高。LLM 先验这条路线原则上可随模型变大受益,但本文没有任何规模实验。
工业落地价值¶
ANGLE 在腾讯两个搜索广告场景全量上线(作为补充通道),WTS 消耗 +1.81%、GMV +2.16%,QBS 消耗 +6.57%、GMV +5.01%;推理侧 FP8 + 数百张 L40、每卡约 30 QPS。对做搜索广告生成式召回的团队,这篇文章的参考价值主要在「文本分层标识 + 用户级约束解码 + 小时级索引更新」这套系统形态上;但方法论层面的结论(文本优于 SID、三合一训练的必要性、实时性)都需要读者自己补做对照实验才能采信。与同期 UniGD(有机制隔离的线上四臂实验)、OneRetrieval(只换编码范式的受控对照)、GRACE(逐项 P50/P99 时延分解)相比,ANGLE 的实验证据明显单薄。