Native Multimodal Representation Learning:先证伪端到端,再用 Mine-Then-Train 造 CTR 原生多模态表征¶
来自 Taobao & Tmall Group of Alibaba(Chao Yi、Feifan Yang 共同一作,Jiawei Feng 为中科大,Sishuo Chen、Zhangming Chan、Xiang-Rong Sheng、Han Zhu 通讯,均在阿里北京团队),CIKM '26 正会论文(8 页),2026-08-25 挂 arXiv(2608.24091v1,cs.IR)。这篇论文的结构非常"反常":前一半是一个负结果——在淘宝展示广告这种已经跑着强预训练多模态编码器的系统上,把编码器与 CTR 模型端到端联训(E2EM)不但不涨点,反而掉点;后一半才是修复方案 Mine-Then-Train:先用一个"多模态标注模型"从 CTR 日志里挖出可被多模态语义解释的高质量三元组,再用这批干净数据去微调多模态编码器。最终线上长期 A/B 拿到 CTR +1.5%、RPM +0.5%,且因为只改编码器不改其它模块,可以直接复用 SCL 编码器已有的部署管线。
研究动机与背景¶
工业推荐模型长期依赖离散 ID 特征(Wide&Deep、DIN、DIEN、YouTubeDNN 一脉)。ID 范式的两个结构性短板是众所周知的:数据稀疏场景下泛化差(长尾/新品的 ID embedding 训不熟),以及看不懂 item 的多模态内容语义。因此近年工业界普遍把 item 的多模态表征引入 ID 模型。
绝大多数做法遵循两阶段范式:
- 预训练阶段:从对应业务场景采集多模态数据,用对比学习(MoCo)、掩码建模(MAE)或生成式任务(CoCa)训练一个多模态编码器,使其具备该业务场景下的语义理解与表征能力;
- 应用阶段:用这个编码器抽取 item 的多模态表征,再以多种方式接入推荐模型——当作 Semantic ID(QARM、OneRec)、用来算 item 间语义相似度(SCL),或者直接作为特征融进排序模型。
问题在于:预训练阶段完全不知道下游任务(CTR 预估)的数据分布和优化目标。预训练任务与下游任务之间横着一条 gap,这条 gap 限制了多模态表征在工业推荐系统里的效果天花板。
本文因此提出要做 CTR 任务的原生多模态表征学习(Native Multimodal Representation Learning),聚焦电商场景。最自然的想法是端到端多模态训练(End-to-End Multimodal Training, E2EM):把多模态编码器直接塞进推荐模型,整体端到端训,指望编码器自动学到下游相关的知识。
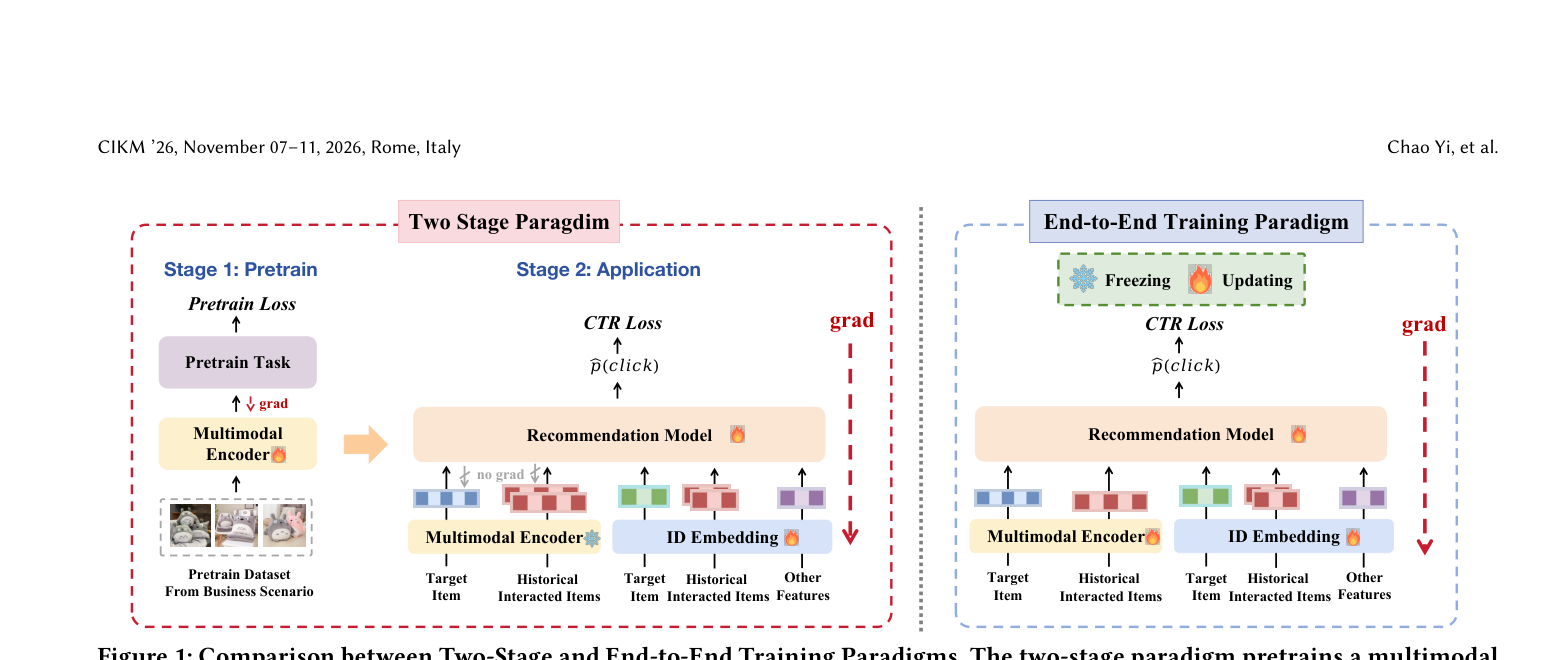
于是全文的第一个问题被明确提出:
"在一个高质量、已充分预训练的多模态编码器之上,E2EM 还能为电商场景的 CTR 预估带来额外收益吗?"
这个问题之所以关键,是因为在很多工业场景里两阶段范式已经产出了很强的编码器。以淘宝展示广告为例,团队采用的是在大规模高质量电商数据上预训练的 SCL Encoder,把它抽的多模态表征接进 CTR 模型带来了百分点级的 GAUC 提升——要知道在这种量级的系统里,0.1% 的 GAUC 提升已经算是很有说服力的结果了。
论文给出的答案是:E2EM 不但没有额外收益,甚至导致性能下降。
三点主要贡献:
- 在全球最大电商平台之一淘宝的展示广告场景上,在一个已充分预训练的多模态编码器之上做 E2EM 实验,结果显示 E2EM 不带来性能增益;
- 论证 CTR 数据中的用户行为只有部分可归因于多模态语义,因而提供的是含糊监督(ambiguous supervision),并导致编码器更新方向不一致;
- 提出 Mine-Then-Train:先从 CTR 数据中挖掘与用户点击偏好对齐的高质量训练数据,再用它训练多模态编码器,实现面向 CTR 预估的原生多模态表征学习。
预备:两阶段范式的形式化¶
第一阶段,通用多模态编码器 $E$ 在采集到的场景特定训练数据 $D_{train}$ 上,通过预训练任务 $\mathcal{T}_{pretrain}$ 适配,得到语义表征能力增强的编码器 $\hat{E}$:
$$\hat{E} = \mathcal{T}_{pretrain}(E,\, D_{train}). \tag{1}$$
第二阶段,$\hat{E}$ 从 item 的多模态内容(图像/标题)中抽取多模态表征,并接入 CTR 预估模型 $F$:
$$MMRep = \hat{E}(Item_{MMInfo}),\qquad pCTR = F(IDFeat,\, MMRep). \tag{2}$$
这些表征确实给 CTR 预估带来了增量收益,但仍然次优,原因是两条错配:(1) 预训练任务 $\mathcal{T}_{pretrain}$ 偏离 CTR 任务 $\mathcal{T}_{ctr}$;(2) 预训练数据 $D_{train}$ 与 CTR 数据 $D_{ctr}$ 分布不同。原生多模态学习范式因此进一步在 $D_{ctr}$ 上微调 $\hat{E}$:
$$\tilde{E} = \mathcal{T}_{ft}(\hat{E},\, D_{ctr}). \tag{3}$$
期望 $\tilde{E}$ 产出的表征与 CTR 任务更对齐,带来进一步提升。全文剩下的部分就是在回答:$\mathcal{T}_{ft}$ 到底应该长什么样。
第一问:E2EM 能否在强两阶段基线之上带来增益?¶
实验设置¶
数据集。从淘宝采集,包含 84M 用户一周内的点击/非点击行为数据,涉及 88M 商品、1.9B 样本。每条样本形如 <用户特征, 目标 item 特征, 点击标签>。用户特征包括年龄、性别、历史点击 item 序列等;目标 item 特征包括类目、品牌、item ID 等。此外每条样本还包含目标 item 与行为序列中每个 item 的多模态内容(图像、标题),作为多模态编码器的输入。
模型。CTR 预估模型采用淘宝展示广告系统在用的 MUSE。多模态编码器方面,为了可靠地衡量 E2EM 的价值,采用的是已在淘宝展示广告系统中被证明有效的强预训练编码器:基于 Chinese CLIP ViT-B/16,用 SCL(Semantic-aware Contrastive Learning) 预训练——即在语义相似对上做 MoCo 式对比学习,以捕获细粒度电商语义。
训练设置。CTR 模型稀疏 embedding 部分用 Adam,学习率 2e-3;dense 部分用 AdamW,学习率 2e-4;多模态编码器同样用 AdamW,学习率 2e-4,配 cosine 学习率调度。
Baseline。淘宝展示广告线上部署的 SCL 编码器。
多模态表征使用方式。两条互补路径:(1) Similarity-based——用多模态表征计算目标 item 与用户历史点击序列中每个 item 的相似度,再通过 SA-TA、SimTier 等方式接入 CTR 模型;(2) Direct Fusion——把每个 item 的多模态表征与其 ID 特征经线性层融合后直接送入预估模型。
评估指标:GAUC。
主结果¶
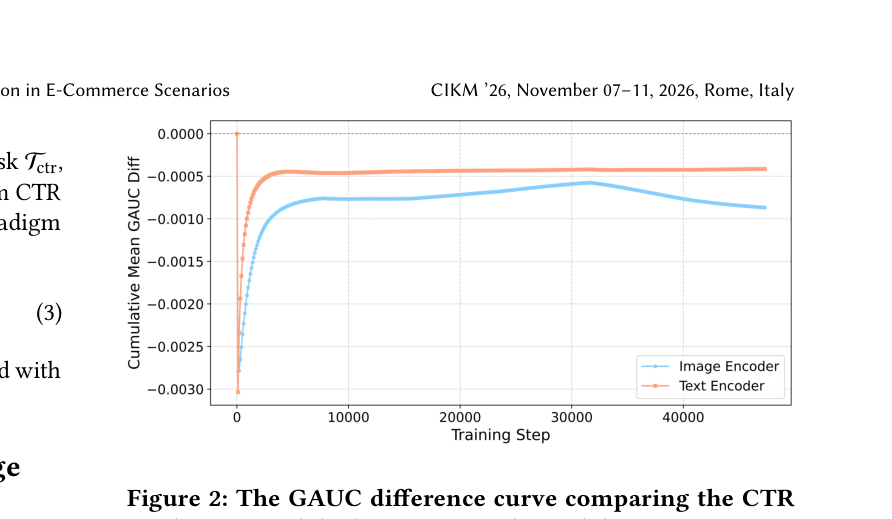
Figure 2 画的是"用 E2EM 编码器的表征"相对"用 SCL 编码器的表征"的累积平均 GAUC 差值曲线。图像编码器与文本编码器两条曲线在整个约 48k 训练步里全程为负:初始骤降到约 −0.003,随后回升并稳定——文本编码器收敛在约 −0.0004,图像编码器收敛在约 −0.0009,且图像侧在 30k 步后还有二次下滑趋势。结论明确:E2EM 相对 SCL 编码器没有任何提升,反而带来 GAUC 下降。
更多消融¶
由于 E2EM 在淘宝真实环境下训练成本极高(见 §4.3),做多组探索性实验不现实。因此作者转到 Taobao-MM 这个更轻量的 benchmark(同样采自淘宝真实场景,含长用户行为序列与多模态表征,与真实工业设置高度贴近)上做消融。
RQ1:E2EM 的作用范围。评估三种范围:仅目标侧(Tar E2EM)、目标侧 + LEMUR 的 memory bank(Tar E2EM + Memory Bank)、目标侧与序列侧都做(Tar & Seq E2EM)。
Table 1: RQ1 实验结果。MUSE 表示目标侧和序列侧都用 SCL 表征。
| E2EM Method | GAUC |
|---|---|
| MUSE | 0.6154 |
| Tar E2EM | 0.6139 |
| Tar E2EM + Memory Bank | 0.6128 |
| Tar & Seq E2EM | 0.6124 |
结论分析:所有 E2EM 变体都跑不过冻结编码器的 MUSE 基线,而且随着 E2EM 应用范围扩大性能单调下滑(0.6139 → 0.6128 → 0.6124)。作者的解释很直接:既然 E2EM 产出的表征本身就不如 SCL 表征,那么扩大它的使用范围只会放大这个劣势。值得注意的是引入 LEMUR 的 memory bank(一种为端到端多模态推荐设计的加速/扩容组件)也没能救回来,说明问题不在工程实现而在优化本身。
RQ2:学习率与优化器选择。把多模态编码器的优化器分别换成 SGD、Adam、AdamW,学习率分别取 2e-3、2e-4、2e-5,以排除训练超参对结论的干扰。
Table 2: RQ2 实验结果(GAUC)。
| GAUC | lr 2e-3 | lr 2e-4 | lr 2e-5 |
|---|---|---|---|
| SGD | 0.6139 | 0.6148 | 0.6146 |
| Adam | 0.6135 | 0.6133 | 0.6140 |
| AdamW | 0.6134 | 0.6139 | 0.6151 |
结论分析:9 组配置无一例外低于 MUSE 基线的 0.6154。最接近的是 AdamW + lr 2e-5(0.6151),但这本质上是"学习率小到几乎不更新编码器"的退化情形——越接近冻结越接近基线,恰恰反证了 CTR 梯度对编码器是净有害的。这一表把"E2EM 失效"从超参调优问题中彻底摘了出来。
第二问:为什么 E2EM 在强编码器上失效?¶
4.1 电商 CTR 数据只有部分可归因于多模态语义¶
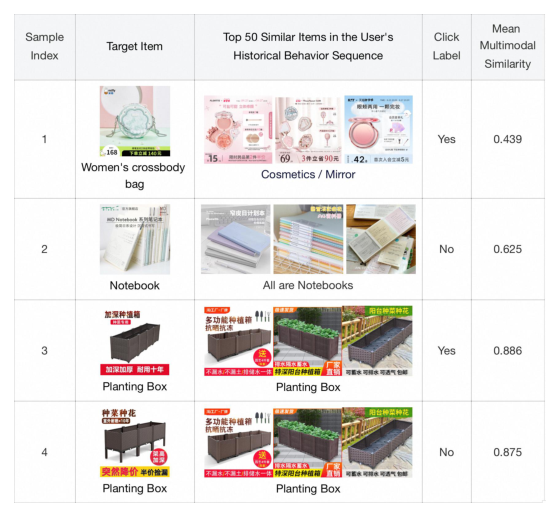
沿用 MUSE 的做法,用 SCL 表征从每个用户的行为序列中检索 Top-K 语义最相似的 item,与目标 item 一起可视化。Figure 3 揭示了两类语义与点击的错配:
- 比价点击、误触点击、位置偏差等非语义因素,会让用户点了低相似度的 item 而跳过高相似度的 item(样本 1、2);
- 兴趣疲劳会让用户跳过与此前已点击 item 相似的内容(样本 3、4)。
作者进一步用两个指标量化这种错配。如 Figure 4 所示,用 SCL 表征计算目标 item 与用户历史点击 item 的相似度,取其均值和最大值作为预测分,得到 MultiModal-Mean GAUC 与 MultiModal-Max GAUC——它们衡量的是"仅凭多模态语义相似度"能在多大程度上对齐电商场景中的点击偏好。
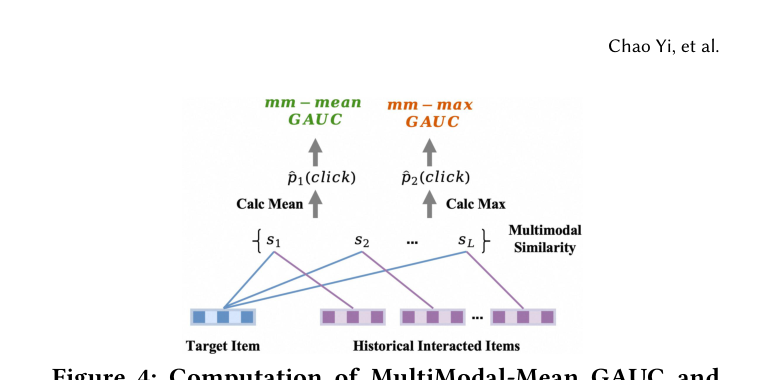
Table 3: MultiModal-Mean GAUC 与 MultiModal-Max GAUC 对比。
| MM Mean GAUC (↑) | MM Max GAUC (↑) |
|---|---|
| 0.541 | 0.536 |
结论分析:两个指标都只略高于随机预测(0.5)。这不意味着 CTR 数据里没有有用的多模态信号,而是说明 CTR 标签混合了多模态因素与非多模态因素,原始 CTR 数据并不是一个纯净的多模态监督信号。因此直接用它去优化一个共享的多模态编码器,拿到的是含糊监督。这是全文最关键的一张表——0.54 这个数字直接定量了"点击能被多模态解释的比例有多低"。
4.2 联合训练不会自动解耦 CTR 信号¶
上面的观察似乎暗示了一个解法:把编码器与 ID-based CTR 模型联合训练,指望 ID 分支吸收非多模态因素、编码器只学可归因于多模态语义的信号。但 §3 表明这种"自动分工"并没有出现。ID 分支只是提供了额外的建模容量,并不会显式地把每个监督信号分配给负责它的分支。
作者用梯度做了进一步分析:在冻结编码器参数以控制变量的前提下,测量端到端联训时不同输入 batch 下多模态编码器最后一层 Transformer 的梯度,并与 SCL 的梯度做对比。定义两个统计量:Avg Sim 1 是 batch 内样本梯度之间的平均余弦相似度;Avg Sim 2 是相邻 batch 的平均梯度之间的余弦相似度。值越低说明优化方向越不一致。
Table 4: 不同任务的梯度对齐结果。
| Task | Avg Sim 1 (↑) | Avg Sim 2 (↑) |
|---|---|---|
| SCL | 0.144 | 0.849 |
| E2EM (Co-train CTR) | 0.016 | 0.006 |
结论分析:即便有 ID 分支在场,E2EM 的梯度相似度仍显著低于 SCL——batch 内相似度 0.144 → 0.016(低一个数量级),相邻 batch 间相似度更是从 0.849 崩到 0.006(几乎正交,即前后两批数据把编码器往完全无关的方向推)。这说明 CTR 监督并没有在两条分支之间被有效路由。共享的 CTR loss 解释了这一点:它把每条 CTR 样本的梯度同时回传给两条分支,而不判断当前这条 CTR 数据是否能被多模态内容解释。因此 ID-based CTR 模型虽然可能拟合这类行为,但它本身阻止不了非多模态因素引发的监督信号去更新多模态编码器。
作者还尝试加入 SCL Loss 把编码器锚定在多模态语义上——如果干扰的根因是语义约束不足,SCL 应该能稳住训练。结果是:引入 SCL Loss 后 CTR GAUC 相对不加 SCL loss 又掉了 0.17 个百分点,同时 SCL Top-1 Accuracy 相对原始 SCL 编码器下降 5 个点。也就是说 CTR 侧和语义侧双输。虽然 SCL 提供了语义监督,但它依然无法识别"哪些 CTR 行为应该用来更新编码器"。这一结果直接排掉了"加正则"这条路,逼出了 Mine-Then-Train 的思路:在数据层面隔离监督,只让可靠的、多模态可解释的信号去更新编码器。
4.3 高昂的训练成本¶
抛开优化问题不谈,E2EM 还有一个独立的瓶颈:海量多模态输入的前向与反向传播开销。batch size 为 $B$、序列长度为 $N$ 时,对目标侧和历史 item 都做 E2EM,每步要处理 $B \times (N+1)$ 张图/条文本。作者用 CLIP ViT-B/16 与 MUSE($B=32$, $N=50$)实测峰值显存与平均步耗时。
Table 5: E2EM 的计算成本。
| Metric | Peak GPU Mem (GB) | Avg Step Time (s) |
|---|---|---|
| Without E2EM | 3.37 | 1.02 |
| With E2EM (tar) | 5.71 (1.69×) | 1.94 (1.90×) |
| With E2EM (tar & seq) | 84.56 (25.09×) | 7.32 (7.18×) |
结论分析:只做目标侧就已经是 1.69× 显存 / 1.90× 步耗时;一旦扩到序列侧,显存直接爆到 25.09×(84.56 GB,单卡已放不下)、步耗时 7.18×。而这还只是 ViT-B/16 这种小编码器;随着业界采用参数量越来越大的表征模型(MOON、NoteLLM-2 等),这个成本会越来越不可接受。这条成本论证很重要:它说明即使 E2EM 在优化上可行,工程上也难以规模化——两个理由叠加才构成对 E2EM 路线的完整否定。
Mine-Then-Train:面向 CTR 的原生多模态表征学习¶
5.1 为什么噪声样本对多模态表征影响巨大¶
要理解多模态表征为何比 ID 特征更怕噪声,关键差异在于抽取 item 表征时参数是否共享:
- ID 特征给每个 item 分配一组专属的可学习参数,学习过程高度解耦,item 之间基本互不影响;
- 多模态编码器用一个完全共享的编码器为所有 item 抽表征,item 之间存在强参数耦合。
参数共享固然提升泛化,但也引入一个致命问题:噪声样本(即无法归因于多模态语义的样本)的梯度会污染共享的编码器参数,从而降低所有 item 的表征质量。这使得多模态编码器对 CTR 数据的噪声高度脆弱,而 ID 特征因参数解耦天然鲁棒。
这一节是全文的机制性解释,也是方法设计的直接依据:与其靠额外的联合正则去压制噪声,不如先从 CTR 数据里把多模态可解释的监督抽出来,只用这批数据训练编码器。
5.2 用标注模型从 CTR 数据中自动挖掘训练样本¶
一个被否掉的朴素方案:直接在高协同相似度的 item 对(如 Swing 分数高、共点击次数多)上微调多模态编码器。作者的实验显示这相对 SCL 编码器没有可见增益,归因于两点:
- 信息冗余(Information Redundancy):这些对里的协同信号已经被 CTR 模型的 ID 特征充分捕获,学到的表征与既有 ID 特征高度冗余,信息增量有限;
- 语义不一致(Semantic Inconsistency):部分 item 对缺乏清晰的多模态语义关系(如视觉相似性),反而会损伤预训练 SCL 编码器的细粒度多模态语义理解能力。
因此作者提出选择性数据挖掘策略,要求挖出的训练样本同时满足三条准则:(1) 与用户点击偏好对齐;(2) 可从多模态语义角度解释;(3) 相对既有多模态表征与 ID 特征提供信息增益。
挖掘分两步:先训一个多模态标注模型(annotation model)捕获可被多模态语义解释的用户点击偏好;再用它的输出从 CTR 数据里挖高质量多模态训练样本。
第一步:标注模型。给定目标 item 与一个由 GSU(用 SCL 表征)从用户行为中检索出的行为 item,标注模型用两者的原始多模态内容(主图、标题)预测一个点击相关性分数(click-relevance score)。这个分数通过 SA-TA、SimTier 等方式接入下游 CTR 预估模型,从而让 CTR loss 端到端地训练标注模型。
为了保住 SCL 编码器对电商语义的细粒度理解,标注模型采用 TaskRes 的残差学习设计:
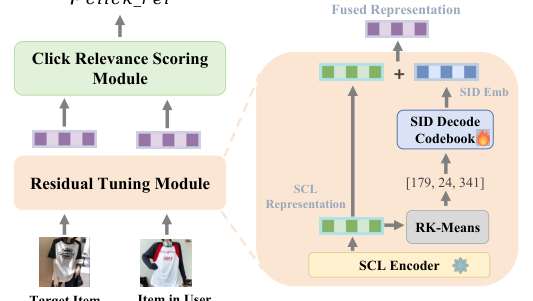
在 Residual Tuning Module 中,冻结的 SCL 编码器先从每个 item 的原始多模态内容抽表征;随后 RK-Means 对这些表征聚类,为每个 item 分配一个 SID(图中示例为 [179, 24, 341]);对应的 SID Embedding 从一个可学习的 3×8192 SID Decode Codebook 中取出,作为 SCL 表征之上的 CTR 专属残差。这个 decode codebook 零初始化,使训练开始时完全不扰动原始 SCL 表征。两个 item 的结果表征送入 Click Relevance Scoring Module,用 MLP 或归一化内积算出点击相关性分数。
两条关键设计考量:
- 为什么用 Residual Tuning:用户偏好完全由 SID Decode Codebook 承载,不改动 SCL Encoder 本身,从而防止 CTR 数据中的非多模态因素破坏编码器的细粒度电商语义理解能力。同时这个设计让 codebook 显式地去学"在 SCL 表征之上、面向 CTR 任务的增量信息"。
- 为什么用 SID Embedding:item SID 与 item 语义紧密绑定,保证学到的信息是多模态可解释的;SID 可以离线预计算并存储,因此端到端训练阶段只需一次 embedding 查表,比调多模态编码器高效得多;最后,SID Embedding 的参数解耦特性(呼应 §5.1)让它能更有效地从 CTR 数据中学习。
把标注模型的分数作为特征接进 CTR 预估模型,带来 +0.13% GAUC,证明标注模型确实学到了有效的信息增量。
为了搞清标注模型到底学到了什么,作者对比了 SCL 表征算出的 item 对余弦相似度与标注模型预测的点击相关性分数(原文 Figure 6)。结论是:标注模型学会了聚焦于更强驱动用户点击偏好的商品属性。
- 案例 (a):尽管目标 item 与 item 2 有更相似的廓形设计(同为无帽、同款领口),标注模型识别出条纹图案的匹配才是驱动点击的更重要因素——SCL Sim 0.462 / 0.469(item 2 更高),而 Anno Score 0.597 / 0.428(item 1 更高,排序反转);
- 案例 (b):尽管目标 item 与 item 2 的材质纹理更接近(竖向凹槽),模型识别出行李箱尺寸才是更决定性的因素——SCL Sim 0.443 / 0.415,Anno Score 0.521 / 0.366。
第二步:过滤出干净标签。标注模型仍有两个局限:(1) 它直接在 CTR 数据上训练,非多模态因素会让某些 item 对的点击相关性分数不准;(2) 用户偏好只通过 SID embedding 学习,其学习过程本质上类似 ID embedding 的记忆机制,缺乏对 item 原始多模态内容的直接访问,限制了知识的泛化性。因此作者把标注模型产出的高质量干净标签筛出来,构造多模态微调数据。
具体流程:对每条 CTR 样本,用 SCL 表征从用户点击历史中检索与目标 item 最相似的 Top-K 个 item,把每个与目标 item 配对,过滤掉多模态相似度低于 $\tau_m$ 的对以保证对内语义强相关;然后把共享同一目标 item 的对合并成三元组,保留满足如下条件的三元组:
$$Sim^{SCL}_{tar,1} - Sim^{SCL}_{tar,2} < \tau_s,\qquad Score^{Anno}_{tar,1} - Score^{Anno}_{tar,2} > \tau_a \tag{4}$$
其中 $Sim^{SCL}_{tar,1}$ 与 $Sim^{SCL}_{tar,2}$ 是目标 item 与三元组中另外两个 item 的 SCL 相似度,$Score^{Anno}_{tar,1}$ 与 $Score^{Anno}_{tar,2}$ 是它们对应的标注模型相关性分数。$\tau_m$、$\tau_s$、$\tau_a$ 分别是对相似度阈值、SCL 相似度差阈值、标注分差阈值。
这两个约束合在一起,保留的是语义相关但存在 SCL 没能捕捉到的清晰偏好差异的三元组。特别地,标注分差衡量的是标注模型对所预测偏好排序的置信度。
人工评测验证阈值有效性。在 $Sim^{SCL}_{tar,1} - Sim^{SCL}_{tar,2} < 0.05$ 的前提下,采样 1000 条标注分差 > 0.15 的高置信三元组与 1000 条标注分差 < 0.05 的低置信三元组,由多位人工标注员通过多轮投票判断"用户点了目标 item 后更可能点 Item 1 还是 Item 2",以多数票为 ground truth。结果:高置信组 Item 1 胜率 85%,低置信组仅 42%。这一巨大差距证实标注分差是伪标签质量的可靠指示器,能有效过滤噪声三元组。
保留下来的数据包含两类三元组:
- Rank-reversed(排序反转)三元组:在 SCL 表征下 Item 2 比 Item 1 更像目标 item,但在标注模型分数下排序被明确反转;
- Gap-widened(差距拉大)三元组:Item 1 在 SCL 下依然比 Item 2 更像目标 item,但标注模型给出的分差显著更大。
两类都提供细粒度监督,引导编码器聚焦于最影响用户点击偏好的 item 属性。最终得到 3000 万条高质量三元组。
5.3 基于挖掘数据训练原生多模态编码器¶
基于 §5.2 挖出的三元组,用 triplet margin loss 微调 SCL 编码器以学习相似度排序关系:
$$L_{margin} = \max\left(0,\ m - (Sim_{tar,1} - Sim_{tar,2})\right), \tag{5}$$
其中 $Sim_{tar,1}$ 与 $Sim_{tar,2}$ 是当前正在微调的多模态编码器抽出的表征算得的余弦相似度,$m$ 是 margin 阈值,设为 0.1。
为防止 SCL 编码器遗忘预训练阶段学到的细粒度电商语义理解能力,把 SCL Loss 作为正则项加入训练:
$$L_{SCL} = -\log \frac{\exp\left((q \cdot k^+)/\tau\right)}{\sum_{i=0}^{K}\exp\left((q \cdot k_i)/\tau\right)}. \tag{6}$$
其中 $q$ 与 $k^+$ 分别是用户查询的图像/文本及其对应的已购买 item,$k_0, k_1, \ldots, k_K$ 是 memory queue 中的其它负样本 item,$K$ 是 MoCo 中的 memory queue 大小,$\tau$ 是可学习温度参数。式 (6) 中所有 item 表征均做 L2 归一化。总损失为:
$$L_{total} = L_{margin} + L_{SCL}. \tag{7}$$
设计解读:注意这里的 SCL Loss 与 §4.2 里失败的那次"加 SCL Loss"是完全不同的角色。§4.2 中 SCL Loss 试图在含噪的 CTR 梯度面前充当语义锚点,结果两头落空;而这里 $L_{margin}$ 的监督已经在数据层被清洗过,SCL Loss 只需承担"防遗忘"这一件事。同一个损失项,在监督被隔离前后效果完全相反——这恰恰印证了作者"问题出在数据而非正则"的判断。
5.4 在线部署管线¶
由于本工作只优化多模态编码器、不修改任何其它模块,可以直接复用 SCL 编码器已有的在线部署管线。这是 Mine-Then-Train 相对 E2EM 的一个巨大工程优势:不需要在线逐请求编码,不需要改造 CTR 模型,离线抽表征 + 在线查表的老链路原样可用。
实验¶
实现细节¶
- 数据集:来自淘宝展示广告系统的 CTR 预估数据集,覆盖一个月。
- 模型:采用淘宝展示广告系统的 CTR 预估模型(EST),它已经接入了强 SCL 多模态表征,因此是一个很强的基线。
- 挖掘阈值:对相似度阈值 $\tau_m = 0.3$,SCL 相似度差阈值 $\tau_s = 0.05$,标注分差阈值 $\tau_a = 0.15$。
- 多模态表征使用方式:把 Native Multimodal Representation(NMR)接入 CTR 模型的序列建模模块,两种方式:(1) 用 NMR 计算目标 item 与用户历史点击序列的相似度,传给后续建模模块(SimTier、SA-TA);(2) 把 NMR 与 item 的其它 ID embedding 经线性层直接融合,送入后续模块。
- 评估指标:AUC 与 GAUC。
主要实验结果¶
Table 6: CTR 预估数据集上的整体性能(相对基线的相对提升)。
| Method | GAUC | AUC |
|---|---|---|
| Baseline (include SCL) | - | - |
| Add Annotation Score | +0.13% | +0.08% |
| NMRL | +0.22% | +0.11% |
结论分析:两点结论。(1) 标注模型确实捕获了基线模型之外的增量信息——单是把它的分数当特征接进去就有 +0.13% GAUC;(2) 基于标注模型的结果做过滤与挖掘,再去训练 SCL Encoder,比直接使用标注模型分数效果更好(+0.22% vs +0.13% GAUC,相对增益接近翻倍)。这印证了 §5.2 末尾的判断:标注模型的知识困在 SID embedding 的"记忆"里,只有把它蒸馏成三元组标签、回灌进能直接看原始多模态内容的共享编码器,才能拿到泛化性带来的额外收益。回到本文开头的参照系——在这个量级的系统里 0.1% GAUC 提升已被认为是有说服力的结果,+0.22% 是一个相当可观的数字。
线上 A/B 实验¶
2026 年初把 Native Multimodal Representation(NMR)接入淘宝展示广告系统,通过长期 A/B 实验评估在线表现。结果:CTR +1.5%,RPM(Revenue Per Mille)+0.5%。
解读:CTR 提升幅度显著大于 RPM,说明收益主要来自点击侧的用户体验改善,而在变现效率上转化得较为保守——这与方法本身只对齐"点击偏好"($L_{margin}$ 的监督来自点击相关性标注模型)而不涉及出价/成交信号是一致的。
核心贡献总结¶
- 一个高价值的负结果:在真实工业系统(淘宝展示广告)上系统性地验证了"在已充分预训练的强多模态编码器之上做 E2EM 不涨反跌",并用作用范围消融(Table 1)与 9 组优化器/学习率网格(Table 2)排除了实现与超参因素。
- 机制级归因:从数据侧(MM-Mean/Max GAUC 仅 0.541/0.536,点击只有小部分可由多模态语义解释)与优化侧(梯度相似度 0.144/0.849 → 0.016/0.006,且 ID 分支不自动路由监督)双重定量了 E2EM 失效的原因,并额外证伪了"加 SCL Loss 正则"这条补救路线。
- 参数共享视角的解释:指出 ID 特征参数解耦所以对噪声鲁棒、多模态编码器参数全共享所以噪声会跨 item 传染,这是全文最可迁移的 insight。
- Mine-Then-Train 配方:TaskRes 式残差标注模型(冻结 SCL + RK-Means SID + 零初始化 3×8192 decode codebook)→ 双阈值三元组挖掘(式 4)→ triplet margin + SCL 正则微调(式 5-7),并用人工评测(85% vs 42%)验证了置信度阈值的有效性。
- 可落地:只改编码器不动其它模块,复用既有部署管线;线上长期 A/B 拿到 CTR +1.5% / RPM +0.5%。
与已归档相关工作的对比¶
GALA GALA: Generative Aligned Learning for Adaptive Multimodal Representation (Rajax Network Technology / Taobao Shangou of Alibaba, 2026-07-31)¶
关系:独立并发(本文未引用 GALA,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇都把"离线预训练的多模态表征与下游 CTR/CVR 行为目标割裂"当作头号结构性瓶颈,也都认定"彻底端到端联训"在工业上不可行——GALA 的理由偏工程(在线逐请求编码或频繁刷缓存扛不住毫秒级延迟、长尾库存覆盖有缺口),本文的理由偏优化(含糊监督 + 25× 显存)。两者的问题陈述可以互换。
- 相近的技术骨架:都不走彻底端到端,而是在"预训练编码器"与"冻结注入 ranker"之间插入一个行为对齐中间阶段,用日志里的真实行为重塑多模态表征,然后冻结、复用既有的离线 embedding 部署管线(本文 §5.4 明说复用 SCL 管线,GALA 明说不替换级联链路)。四步骨架(预训练 → 行为对齐 → 冻结 → 注入排序)逐一对应。
- 本文的差异与推进:GALA 的对齐信号是"整条 next-shop 生成任务 + 购买是否命中的二值 GRPO 奖励",即把行为监督整体灌进一个 Qwen2.5-7B 骨干的生成目标;本文则先诊断出行为监督本身是含糊的(点击只有部分可归因于多模态),因而不敢把原始行为信号直接接到编码器上,而是先训标注模型、再用双阈值把"可被多模态解释的偏好对"筛出来,只让这部分数据更新编码器。有趣的是两者其实用不同手段回避了同一个风险:GALA 的终局稀疏标量奖励天然不做逐样本梯度归因(且作者刻意不混入客单价/评分等更嘈杂的效用),本文则在数据层面直接隔离——目的一致(阻止非多模态因素改写共享编码器),手段互补。
- 可比的方法/实验差异:GALA 报告闪购检索 Overall Recall@K 0.648→0.877,并在融合侧额外处理"强 ID 信号压制新接入多模态分支"的问题(ID-dependent adaptive gate + 辅助损失);本文完全不碰融合侧,沿用既有的 SimTier / SA-TA / 线性融合,只报相对 GAUC +0.22% / AUC +0.11% 与线上 CTR +1.5% / RPM +0.5%。两篇拼起来才是完整的"对齐 + 融合"闭环。
MMRM MMRM: A Multiplex Multimodal Representation Model for Product Ranking (JD.com, 2026-07-13)¶
关系:独立并发(本文未引用 MMRM,且两者结论存在直接实证分歧)· 已加载对方精读
- 共同关注的问题:都在问同一个问题——"该用什么行为信号去微调多模态编码器,才能让它对下游排序真正有增量?"两篇都认定单纯靠内容语义预训练的表征在排序侧次优。
- 相近的技术骨架:从行为日志构造 item 对/三元组 → 用对比式目标(MMRM 用 InfoNCE,本文用 triplet margin)微调多模态编码器 → 冻结产出 embedding → 注入排序模型的序列建模模块。四步一一对应,连"用 hard negative / 阈值控制样本质量"的位置都相同。
- 本文的差异与推进(实证冲突):MMRM 的正样本正是"同会话共点击 / 共加购 / 共下单"的图采样对,即协同信号驱动的微调;而本文 §5.2 明确报告:直接用高协同相似度对(Swing 分数高、共点击多)微调 SCL 编码器相对基线没有可见增益,原因是 (1) 信息冗余——协同信号已被 CTR 模型的 ID 特征充分吸收;(2) 语义不一致——部分共现对没有清晰的视觉/文本关系,反而损伤预训练的细粒度语义。这是两篇工业论文在同一问题上的直接实证分歧。可能的调和点:MMRM 的下游是搜索排序(有 q2i query 侧信号,且做了子类目内 hard negative 与热门下采样来对抗冗余),本文的下游是展示广告推荐(ID 特征更强、协同信号更饱和)。本文的选择是彻底绕开协同信号,改用"标注模型分差"这一与 ID 特征正交的新监督源。
- 可比的方法/实验差异:MMRM 线上 UCTR/UACR/UCVR +0.42%/+0.37%/+0.35%,强调"一次前向出四路表征"以服务多任务;本文只产一路表征,但把"哪些样本有资格当监督"这件事做深(双阈值 + 1000×2 人工评测验证)。一个在信号广度上扩张,一个在信号纯度上收缩,正好是同一坐标轴的两端。
DIG DIG: Discrimination Is Generation — Unifying Ranking and Retrieval from a Tokenizer Perspective (Meituan, 2026-05-14)¶
关系:独立并发,且对同一设计轴给出相反结论(本文未引用 DIG)· 已加载对方精读
- 共同关注的问题:root cause 完全同构。DIG 的诊断是"tokenizer 与下游两阶段串行训练,判别梯度从未流回 codebook,导致 codebook 边界反映的是内容相似度等高线而非推荐决策边界";本文式 (1)-(3) 的两条 misalignment(预训练任务 ≠ CTR 任务、预训练数据分布 ≠ CTR 数据分布)说的是同一件事,只是对象从离散 codebook 换成了连续编码器。两篇都在追问:判别式排序损失该不该、能不能直接驱动 item 内容表征?
- 相近的技术骨架 / 同一设计轴上的相反答案:DIG 的答案是"能"——把 VQ tokenizer 嵌进 DIN+DCNv2+MoE ranker 内部,让 ranking BCE 直接塑形 codebook,一次训练同时得到排序器与检索器。本文的答案是"不能"——在已充分预训练的 CLIP 编码器上做同样的事(即 E2EM),GAUC 不涨反跌,梯度一致性从 SCL 的 0.144/0.849 崩到 0.016/0.006。
- 本文的差异与推进:本文 §5.1 给出的解释恰好能调和这场冲突——参数是否共享决定了对噪声的敏感度。codebook 查表是解耦参数,噪声样本只污染自己那一格;共享 ViT 编码器则是全耦合,任何噪声梯度都会跨 item 传染。DIG 驱动的是离散 codebook(接近 ID 的鲁棒性),本文的 E2EM 驱动的是共享 ViT,所以同一条路线在两种参数结构下结局相反。更有意思的是,本文的标注模型本身就是一个 DIG 式方案:冻结 SCL 编码器 + RK-Means SID + 3×8192 零初始化 SID Decode Codebook,端到端接 CTR loss——它确实有效(单独接入即 +0.13% GAUC),正因为可学参数是解耦的 codebook。本文比 DIG 多走一步:把 codebook 学到的偏好知识再蒸馏成三元组标签去更新共享编码器,从而拿到 codebook 拿不到的泛化性(本文明说 SID embedding 的学习本质是记忆机制、缺乏对原始多模态内容的直接访问),最终 +0.22% > +0.13%。
- 可比的方法/实验差异:DIG 在三个公开数据集与两个美团工业数据集上报 R@10 相对五个 SID baseline 提升 52%~220%,同时排序 AUC 也提升;本文只报工业相对指标,没有公开数据集上的正面结果。两篇合起来给出了一条相当清晰的经验法则:让下游判别损失去驱动"解耦参数"(codebook / SID embedding)是安全的;去驱动"共享编码器"则需要先在数据层做监督隔离。
讨论与局限性¶
核心贡献与值得借鉴之处。这篇论文最大的价值不在于 Mine-Then-Train 这个配方本身,而在于它把一个业界普遍怀有的直觉("端到端总该更好")在真实工业系统上证伪,并给出了机制级归因。三个可迁移的 insight:(1) 原始行为标签不是纯净的模态监督——0.541 的 MM-Mean GAUC 是一个可以直接复用的诊断指标,任何想做 native representation learning 的团队都应该先算一下这个数;(2) 梯度一致性(batch 内 / 相邻 batch 间余弦相似度)可以作为"监督是否含糊"的廉价探针,比反复跑端到端实验便宜得多;(3) 参数共享程度决定噪声容忍度——这条把"为什么 ID 特征扛噪声而多模态表征不扛"讲清楚了,也解释了为什么"先用解耦参数(SID codebook)吸收 CTR 知识、再蒸馏给共享编码器"这条迂回路线是有道理的。
局限与争议。
- 主结果证据偏薄。Table 6 只有两行方法、两个指标,且全是相对提升——没有绝对 AUC/GAUC,没有置信区间,没有多次运行的方差,数据集是内部的。相比之下 §3-§4 的证伪部分反而扎实得多(有 Taobao-MM 上的绝对值、9 组超参网格、梯度统计、人工评测)。全文的实验重心明显偏在"破"而不在"立"。
- 挖掘阶段几乎没有消融。$\tau_m = 0.3$、$\tau_s = 0.05$、$\tau_a = 0.15$ 三个阈值只给了取值,没有敏感性分析;Top-K 的 K 值未披露;30M 三元组的规模是怎么定的、Rank-reversed 与 Gap-widened 两类三元组各占多少、各自贡献多少收益,全部缺失。既然论文的核心主张是"数据质量决定一切",这些恰恰是最该做的消融。
- 缺少与同类 native alignment 方法的横向对比。QARM、LEMUR、MOON、NoteLLM-2 都在引言/相关工作里被提到,但实验里一个都没作为 baseline 出现(LEMUR 只贡献了一个 memory bank 组件参与 E2EM 消融)。因此"Mine-Then-Train 是不是最优的对齐方式"这个问题并没有被回答,只回答了"它比不做和比 E2EM 好"。
- 只对齐点击、不对齐成交。$L_{margin}$ 的监督完全来自点击相关性标注模型,线上 RPM 只涨 0.5% 而 CTR 涨 1.5% 也印证了这一点。电商场景里成交/客单价才是终极目标,把 order/GMV 信号纳入挖掘准则是明显的下一步(GALA 恰好选择了购买命中作为奖励,可作对照)。
- 方法论可扩展性存疑。这是一条显式多阶段解耦的路线:SCL 预训练 → 标注模型(冻结编码器 + 固化 SID)→ 离线挖掘 → 编码器微调 → 冻结抽表征 → 注入 ranker。链条上每一环都是断开的,无法端到端联合优化;标注模型依赖的 RK-Means SID 一旦固化就限定了它能表达的偏好空间;而当编码器参数量继续放大(业界正在往 MOON、NoteLLM-2 这种大模型走)时,"表征能力"与"序列建模能力"没有一条共同的 scaling 通道——恰恰因为本文亲手证明了那条通道(E2EM)在成本与优化上都走不通。作者对此是自知的(§4.3 明说"随着业界采用参数量越来越大的表征模型,这个成本会越来越不可接受"),但论文没有给出这条路线的长期出路。换句话说,Mine-Then-Train 是一个在当前算力与当前编码器规模下最优的工程折中,而不是一个可以随规模一起成长的范式。
- 标注模型的循环依赖。标注模型是在 CTR 数据上端到端训练的,也就是说它本身也暴露在含糊监督之下——论文自己承认"非多模态因素会让某些 item 对的相关性分数不准"。整套方案靠"残差设计 + 解耦参数 + 置信度阈值 + 人工抽检"四道防线把这个风险压到可接受,但本质上仍是用一个受污染的模型去清洗污染数据。人工评测 85% 的胜率是很好的支撑,但那只覆盖了 $Sim^{SCL}$ 差 < 0.05 这一个切片。