GALA:用生成式行为对齐把多模态表征真正接入淘宝闪购排序系统
研究动机与背景
淘宝闪购的推荐链路面对数亿用户、数百万商家和数十亿商品。一次请求先经过召回、预排序、排序和重排,最终展示可履约商家。食物推荐尤其依赖图片和文本:同为汉堡店,菜品视觉、菜单描述、店铺风格都可能决定用户是否点击和下单;但传统 ID-based ranker 主要从交互历史学习 user/item/shop ID embedding,对新品、长尾商家和内容更新响应迟缓。
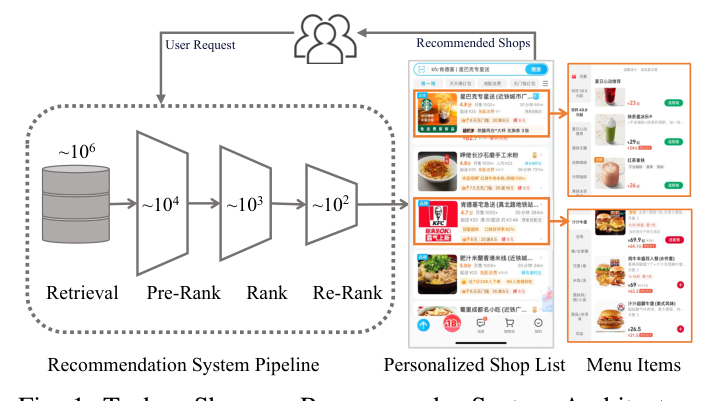
工业多模态排序主要有两条路线。第一条是端到端联合训练内容编码器与 ranker,目标一致但代价高:在线逐请求编码或频繁刷新缓存都难满足毫秒级延迟,并且快速变化的长尾库存会造成表示覆盖缺口。第二条是更常见的“两阶段”路线:离线预训练 image-text encoder、离线生成冻结 embedding、在线 KV lookup 后送入轻量 ranker。它易部署,却把“内容语义学习”和“CTR/CVR 行为目标”割裂开来,静态 embedding 难以跟随动态意图。
论文把问题归纳为三个结构性瓶颈:
- 目标与分布错配:预训练看静态内容,排序看动态行为;冻结表示无法吸收近期点击/转化。
- 领域表示缺口:通用视觉语言模型不理解餐饮语境中的细粒度差异,例如菜名、口味、时段和场景偏好。
- ID 主导下的融合失效:积累多年的强 ID 信号会压制新接入的多模态分支,简单拼接往往收益有限。
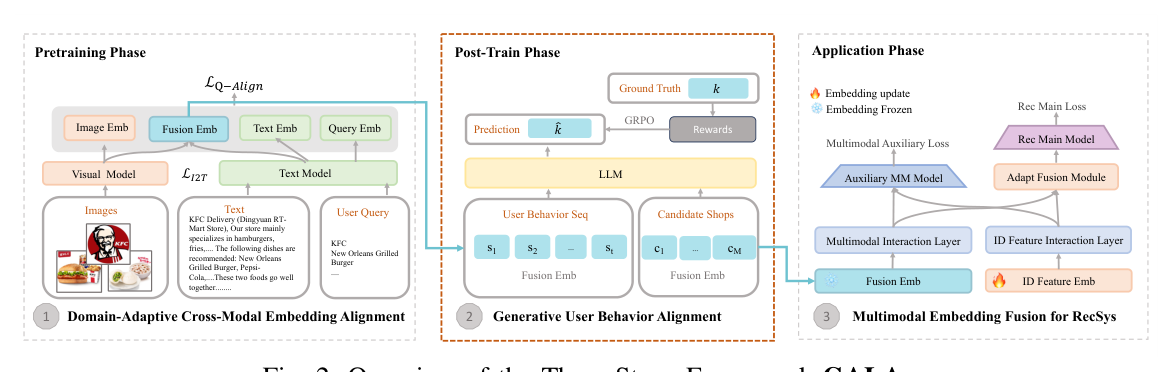
GALA 的核心回答是一个三阶段闭环:先用搜索到购买的真实行为构造 query-image-text 三元组进行领域对齐;再把用户历史、时空上下文和候选商家组成 next-shop 生成任务,以购买是否命中为奖励,用 SFT+GRPO 更新多模态商家 embedding;最后冻结该 embedding,以 ID-dependent gate 和辅助损失接入现有排序器。它不是彻底端到端,而是在工业可部署的离线 embedding 范式中增加一个“生成式 RL 行为对齐”桥梁。
预备:工业排序系统与特征构成
标准排序器输入三类信号:用户、商家、上下文等 ID 特征;用户历史行为序列;图片和文本形成的多模态表示。ID 特征先查 embedding,历史序列模块计算目标商家与历史行为的相关性,再与其他 embedding 拼接送入 MLP,输出 CTR/CVR。GALA 不替换这条成熟链路,而是增强多模态表示并控制其在 ID 主干中的占比。
核心方法与模型架构
Stage 1:领域自适应跨模态对齐
领域 Image-Text 对齐
餐饮内容存在强领域性和噪声:同一商家可能有多张冗余或低质量图片,菜名还可能含通用模型难以理解的地域表达。GALA 从结构化商家数据抽取可靠 image-text 正样本,并用 Momentum Contrast 风格的 batch 内负样本降低伪负例噪声。文本 embedding 为 $t$,正图片为 $i^+$,当前集合中的图片为 $i_j$,温度为 $\tau$:
$$ \mathcal{L}_{I2T}=-\log\frac{\exp(t\cdot i^+/\tau)}{\sum_{j=0}^{K}\exp(t\cdot i_j/\tau)}. \tag{1} $$
该目标提高匹配图文的相似度并压低错配内容,先建立餐饮领域内部一致的视觉—文本空间。
Query-Shop 三元组与多损失优化
单纯 image-text 对齐仍不知道用户“为何搜索”。作者从 search-to-purchase 日志中,为每个商家取 top-10 query 和 top-5 已购买主品类商品,形成高置信的 $(query,image,text)$ 三元组;购买商家为正例,同 batch 未购买商家为负例,并按品类、菜系等领域知识定制采样。
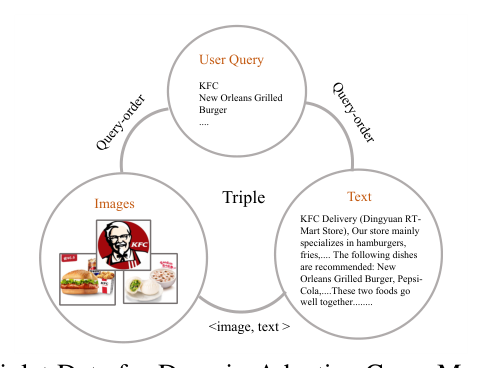
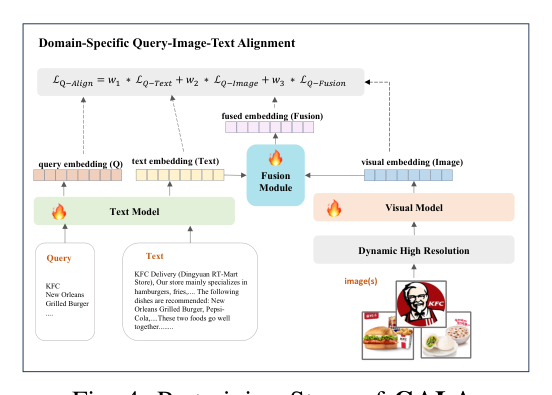
模型用层级视觉编码器提取菜品色彩、Logo 等细节,用文本编码器处理菜单、促销和店铺描述。三条对比学习支路分别对齐 query-text、query-image 和 query-fusion:
$$ \mathcal{L}_{Q\text{-Align}}=w_1\mathcal{L}_{Q\text{-Text}}+w_2\mathcal{L}_{Q\text{-Image}}+w_3\mathcal{L}_{Q\text{-Fusion}}. \tag{2} $$
三项均沿用式 (1) 的对比形式。论文采用 late fusion,理由是它比中间层交互更能保留识别香菜等细粒度视觉特征;同时比较 MLP 与 T5-style cross-attention 两种融合器。
Stage 2:生成式用户行为对齐
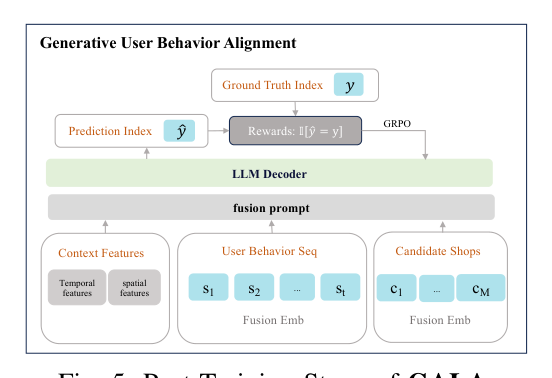
Stage 2 是论文最关键的增量。给定时空上下文 $c$、历史商家序列 $S_{1:t}=[s_1,\ldots,s_t]$、召回模块返回的可履约候选集 $C=[c_1,\ldots,c_M]$,以及实际购买商家在候选集中的位置 $y\in\{1,\ldots,M\}$,训练目标为:
$$ \max_{\theta}\log p_{\theta}(y\mid c,S_{1:t},C). \tag{3} $$
上下文被编码为文字 token;历史和候选商家各用占位 token,其输入 embedding 替换为 Stage 1 的融合多模态表示 $e(\cdot)$:
$$ X=[c;e(s_1);\ldots;e(s_t);e(c_1);\ldots;e(c_M)]. \tag{4} $$
LLM 先生成一小段 reasoning token,最终输出候选索引 token:
$$ o=[\langle\mathrm{think}\rangle,r_{1:L},\langle/\mathrm{think}\rangle,\langle\mathrm{index}_k\rangle]. \tag{5} $$
直接预测海量且动态变化的 shop ID 不现实,因此用大小固定的索引词表 $\{\langle\mathrm{index}_1\rangle,\ldots,\langle\mathrm{index}_{M_{\max}}\rangle\}$。令 $h$ 为最终索引预测隐状态,$E_{\mathrm{idx}}\in\mathbb{R}^{M_{\max}\times d}$ 为可学习索引矩阵:
$$ p(y=k\mid X)=\operatorname{Softmax}(E_{\mathrm{idx}}h)_k,\qquad k=1,\ldots,M. \tag{6} $$
这一设计让输出空间与库存规模解耦;只要新商家已生成 $e(\cdot)$ 并进入候选集,就能被模型选择。
SFT warm-up
骨干采用 Qwen2.5-7B-Instruct。作者用更大的 teacher(示例为 Qwen-72B)根据上下文和真实购买决策生成短理由,共得到 100 万条 $(c,S_{1:t},C,r_{1:L},y)$ 合成样本,用 SFT 学会稳定的推理格式和正确索引,再进入 RL。Stage 2 联合更新完整 decoder、$E_{\mathrm{idx}}$ 和多模态商家 embedding $e(\cdot)$。
GRPO 行为奖励对齐
RL 状态就是融合 prompt:
$$ s\triangleq X=[c;e(s_1);\ldots;e(s_t);e(c_1);\ldots;e(c_M)]. \tag{7} $$
动作空间是最终候选索引 token:
$$ \mathcal{A}=\{\langle\mathrm{index}_1\rangle,\ldots,\langle\mathrm{index}_M\rangle\},\qquad \operatorname{last}(o)\in\mathcal{A}. \tag{8} $$
奖励只看是否命中日志中的购买商家:
$$ r(s,o)=\mathbb{I}[\operatorname{last}(o)=\langle\mathrm{index}_y\rangle]. \tag{9} $$
作者刻意不混入客单价或评分等效用:它们更稀疏、噪声更大且需要敏感的权重调节。终局标量奖励广播给 reasoning 和 index 的所有 token。对同一状态,从旧策略采样 $G$ 个输出,GRPO 目标为:
$$ \begin{aligned} J_{\mathrm{GRPO}}(\theta)=\mathbb{E}_{s\sim P(S),\{o_i\}_{i=1}^{G}\sim\pi_{\theta_{\mathrm{old}}}(O\mid s)}\Bigg[\frac{1}{G}\sum_{i=1}^{G}\frac{1}{|o_i|}\sum_{t=1}^{|o_i|}\Bigg\{&\min\Bigg[\frac{\pi_\theta(o_{i,t}\mid s,o_{i,<t})}{\pi_{\theta_{\mathrm{old}}}(o_{i,t}\mid s,o_{i,<t})}\hat A_{i,t},\\ &\operatorname{clip}\!\left(\frac{\pi_\theta(o_{i,t}\mid s,o_{i,<t})}{\pi_{\theta_{\mathrm{old}}}(o_{i,t}\mid s,o_{i,<t})},1-\epsilon,1+\epsilon\right)\hat A_{i,t}\Bigg]\\ &-\beta D_{\mathrm{KL}}[\pi_\theta\Vert\pi_{\mathrm{ref}}]\Bigg\}\Bigg]. \end{aligned} \tag{10} $$
$\pi_{\mathrm{ref}}$ 固定为 SFT checkpoint,PPO-style clipping 防止单次更新过大。组内优势做标准化并广播到序列全部位置:
$$ \hat A_{i,t}=\tilde r_i=\frac{r_i-\operatorname{mean}(\mathbf r)}{\operatorname{std}(\mathbf r)},\qquad \mathbf r=\{r_1,\ldots,r_G\}. \tag{11} $$
若 $\operatorname{std}(\mathbf r)=0$,则置 $\tilde r_i=0$。KL 使用论文给出的非负无偏估计:
$$ D_{\mathrm{KL}}[\pi_\theta\Vert\pi_{\mathrm{ref}}]=\frac{\pi_{\mathrm{ref}}(o_{i,t}\mid s,o_{i,<t})}{\pi_\theta(o_{i,t}\mid s,o_{i,<t})}-\log\frac{\pi_{\mathrm{ref}}(o_{i,t}\mid s,o_{i,<t})}{\pi_\theta(o_{i,t}\mid s,o_{i,<t})}-1. \tag{12} $$
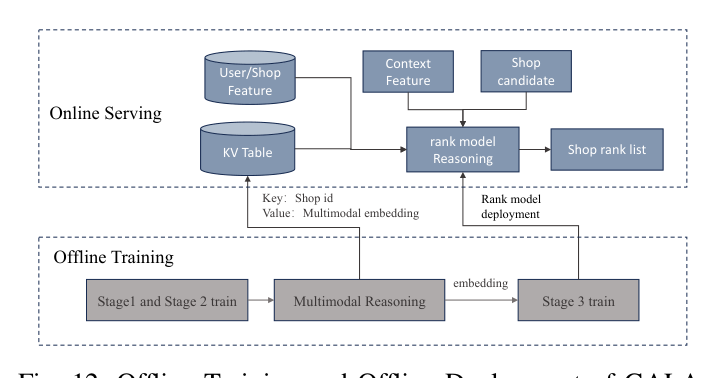
训练后导出优化过的 $e(\cdot)$,在 Stage 3 冻结。因而 LLM 推理只存在于离线后训练,不进入在线排序链路。
Stage 3:面向排序的自适应多模态融合
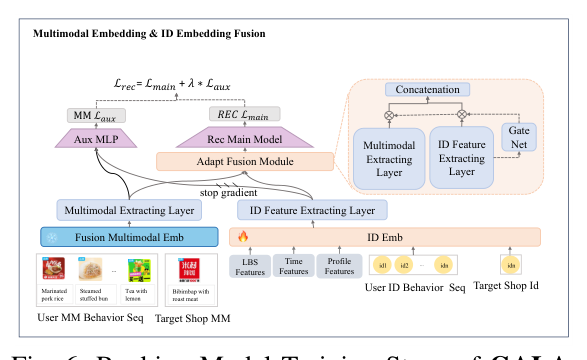
令用户历史和目标商家分别为 $S_u,I_t$,对应多模态输入为 $S_u^m,I_t^m$。ID 与多模态交互层输出 $h^{id}$ 和 $h^m$,gate 只由 ID 表示控制:
$$ h^{id}=f_{id}(S_u,I_t),\quad h^m=f_m(S_u^m,I_t^m),\quad g=\sigma(W_g h^{id}+b_g),\quad h^f=g\cdot h^{id}+(1-g)\cdot h^m. \tag{13} $$
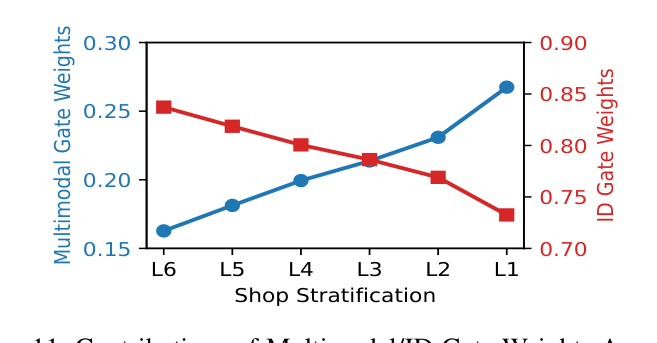
头部商家 ID 训练充分,模型可给 ID 更高权重;长尾和冷启动商家行为稀疏,则提高多模态占比。融合表示进入主 MLP,其交叉熵为:
$$ \mathcal{L}_{\mathrm{main}}=-\frac{1}{N}\sum_{i=1}^{N}\left[y_i\log p_i^{\mathrm{main}}+(1-y_i)\log(1-p_i^{\mathrm{main}})\right],\quad p_i^{\mathrm{main}}=\operatorname{MLP}(h_i^f). \tag{14} $$
仅靠主损失会发生 gate collapse:强 ID 分支抢走梯度,使多模态通路逐渐失效。GALA 增加辅助 MLP,把 $h_i^m$ 与 stop-gradient 的 $h_i^{id}$ 拼接:
$$ \mathcal{L}_{\mathrm{aux}}=-\frac{1}{N}\sum_{i=1}^{N}\left[y_i\log p_i^{\mathrm{aux}}+(1-y_i)\log(1-p_i^{\mathrm{aux}})\right], \tag{15} $$
其中
$$ p_i^{\mathrm{aux}}=\operatorname{MLP}([h_i^m;\operatorname{sg}(h_i^{id})]). \tag{16} $$
总目标为:
$$ \mathcal{L}_{\mathrm{rec}}=\mathcal{L}_{\mathrm{main}}+\lambda\mathcal{L}_{\mathrm{aux}}. \tag{17} $$
stop-gradient 阻止辅助任务借道改变 ID 主干,把监督真正压回多模态分支。
数据集、实验设置与指标
所有实验均基于淘宝闪购私有日志,无法公开。三阶段数据构成如下。
| 阶段 | 输入/特征 | 正负标签 | 划分与过滤 |
|---|---|---|---|
| Stage 1 | 每店 top-10 query、top-5 已购买商品、Logo/商品图片、标题/类目/描述 | 搜索后购买的 $(q,img,txt)$ 为正,batch 内其他商家为负 | 随机 8:2;排除主食配件、餐具等非主品类 |
| Stage 2 | 用户历史、时空上下文、可履约候选集 | 候选中的购买商家为正,其他未购买候选为负 | 过去 3 个月曝光/点击/订单训练,次日测试 |
| Stage 3 | ID、上下文、行为序列和冻结多模态 embedding | 曝光后点击/下单为正,未点击/未下单为负 | 过去 2 个月排序日志训练,次日测试 |
数据规模包括 800 万 verified image-text pair、1400 万 query-image-text triplet、3 个月共 9 亿条用户行为序列(每周约 700 万条高质量 GRPO 序列),以及 420 亿条排序样本。
Stage 1 以 GME unified joint encoder 为骨干,取最后 token 输出作为表示。全局 batch size 为 24,576(24 次梯度累积、每设备 batch 8),学习率 $2\times10^{-5}$,weight decay 0.1,5% linear warmup 后 cosine decay,$\tau=2.0$,$w_1=w_2=0.3,w_3=0.4$。Stage 2 学习率 $5\times10^{-5}$,$\epsilon=0.2$,$\beta=0.001$,最大生成长度 2048。Stage 3 取 $\lambda=0.01$。
表示质量用 Item Intention、Shop Intention、Composite Intention 三类检索任务。对 $K\in\{1,5,10,20\}$ 计算 Recall@K 并取平均:
$$ \operatorname{Recall@K}=\frac{|\operatorname{Top-K}\cap R|}{|R|}. \tag{18} $$
排序用 AUC 和 PCOC;AUC 衡量正例排在负例前的概率,PCOC 衡量概率校准:
$$ \operatorname{PCOC}=\frac{\mathbb{E}[\hat p]}{\mathbb{E}[y]}, \tag{19} $$
PCOC 越接近 1 越好。表示 baseline 为 ALBEF、CNCLIP、GME;排序 baseline 为直接注入的 MMREC、相似度特征 SimTier、内容/ID 对齐的 AlignRec、生成式用户建模 LUM。另以相同 gate 替换为 GME、image-only、text-only embedding,隔离表示质量与融合机制。
主要实验结果
表示检索
| 模型 | 维度 | Item | Shop | Comp | Overall |
|---|---|---|---|---|---|
| ALBEF | 128 | 0.724 | 0.107 | 0.791 | 0.541 |
| CNCLIP | 768 | 0.691 | 0.471 | 0.782 | 0.648 |
| GME | 1536 | 0.788 | 0.869 | 0.841 | 0.843 |
| GALA (MLP) | 128 | 0.841 | 0.877 | 0.851 | 0.856 |
| GALA (T5) | 128 | 0.844 | 0.887 | 0.848 | 0.860 |
| GALA (T5+GRPO) | 128 | 0.866 | 0.896 | 0.868 | 0.877 |
完整模型以 128 维达到 0.877 overall recall,比 1536 维 GME 高 0.034 绝对值;GRPO 相对 T5 再增 0.017,相对 MLP 增 0.021。这既说明领域 query 对齐有效,也说明行为奖励确实把 embedding 往推荐意图方向推进,而收益不是简单增加维度所得。ALBEF 在 Shop task 仅 0.107,突出通用跨模态对齐在品牌/商家意图上的失衡。
端到端 memory-bank 路线的部署反例也得到数据支持:用过去 1–60 天训练数据覆盖次日候选,即便按“至少一次转化”的宽松标准,覆盖率仍约止于 80%;GALA 每日离线增量推理达到 99.975% 覆盖。
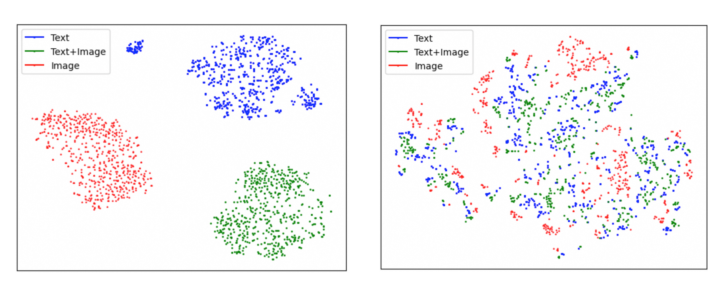
训练前文本、图像和融合表示分处不同区域;Stage 1 后明显重叠。查询词驱动的注意力可聚焦 Pancake、Clay Pot、Pear Soup、Cup 等不同图像区域,Stage 2 后 GALA(T5+GRPO) 比 GME 和仅 T5 更集中于与查询相关的内容,支持“先语义对齐、再行为对齐”的递进解释。
排序效果
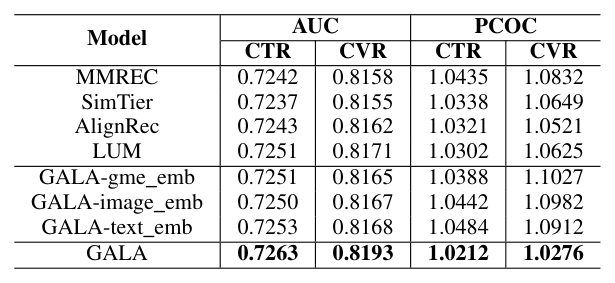
| 模型 | CTR AUC | CVR AUC | CTR PCOC | CVR PCOC |
|---|---|---|---|---|
| MMREC | 0.7242 | 0.8158 | 1.0435 | 1.0832 |
| SimTier | 0.7237 | 0.8155 | 1.0338 | 1.0649 |
| AlignRec | 0.7243 | 0.8162 | 1.0321 | 1.0521 |
| LUM | 0.7251 | 0.8171 | 1.0302 | 1.0625 |
| GALA-gme emb | 0.7251 | 0.8165 | 1.0388 | 1.1027 |
| GALA-image emb | 0.7250 | 0.8167 | 1.0442 | 1.0982 |
| GALA-text emb | 0.7253 | 0.8168 | 1.0484 | 1.0912 |
| GALA | 0.7263 | 0.8193 | 1.0212 | 1.0276 |
GALA 四项均最佳。尤其 CVR AUC 相比 LUM 提升 0.0022,CVR PCOC 从 1.0625 拉近到 1.0276。只换成 GME 或单模态 embedding 都明显退化,说明 Stage 1–2 产出的融合表示与 Stage 3 gate 是配套设计;现成强 embedding 加 gate 并不能复制结果。
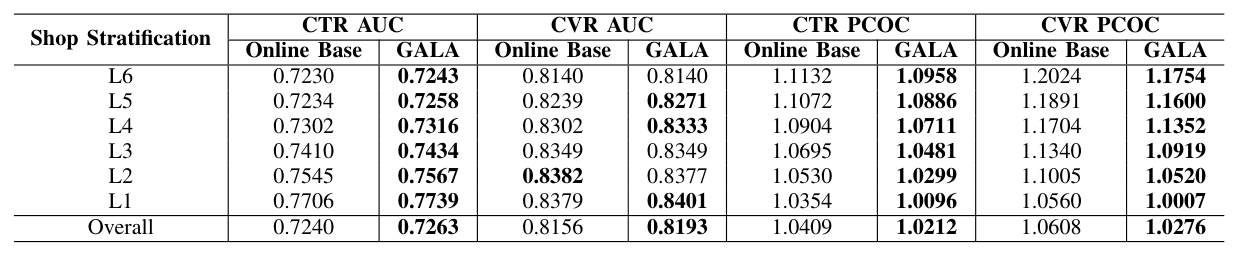
分层效果
| 商家层级 | CTR AUC Base | CTR AUC GALA | CVR AUC Base | CVR AUC GALA | CTR PCOC Base | CTR PCOC GALA | CVR PCOC Base | CVR PCOC GALA |
|---|---|---|---|---|---|---|---|---|
| L6 | 0.7230 | 0.7243 | 0.8140 | 0.8140 | 1.1132 | 1.0958 | 1.2024 | 1.1754 |
| L5 | 0.7234 | 0.7258 | 0.8239 | 0.8271 | 1.1072 | 1.0886 | 1.1891 | 1.1600 |
| L4 | 0.7302 | 0.7316 | 0.8302 | 0.8333 | 1.0904 | 1.0711 | 1.1704 | 1.1352 |
| L3 | 0.7410 | 0.7434 | 0.8349 | 0.8349 | 1.0695 | 1.0481 | 1.1340 | 1.0919 |
| L2 | 0.7545 | 0.7567 | 0.8382 | 0.8377 | 1.0530 | 1.0299 | 1.1005 | 1.0520 |
| L1 | 0.7706 | 0.7739 | 0.8379 | 0.8401 | 1.0354 | 1.0096 | 1.0560 | 1.0007 |
| Overall | 0.7240 | 0.7263 | 0.8156 | 0.8193 | 1.0409 | 1.0212 | 1.0608 | 1.0276 |
论文说明 L1 通常为尾部、L6 为头部。整体 CTR/CVR AUC 分别增加 0.0023/0.0037,校准同步改善;个别分层(L6、L3 的 CVR AUC,L2 的 CVR AUC)持平或略降,但 PCOC 普遍更接近 1。门控权重从 L6 到 L1 逐渐提高多模态占比,与“行为越稀疏,内容越有价值”的设计预期一致。
辅助损失消融
| $\lambda$ | CTR AUC | CVR AUC | CTR PCOC | CVR PCOC |
|---|---|---|---|---|
| 0.01 | 0.7263 | 0.8193 | 1.0212 | 1.0276 |
| 0.1 | 0.7261 | 0.8187 | 1.0245 | 1.0400 |
| 1 | 0.7150 | 0.8102 | 1.0196 | 1.0484 |
$\lambda=0.01$ 最均衡;辅助损失增大到 1 时 CTR/CVR AUC 显著下跌。辅助支路的作用是防止多模态失声,不是取代主排序目标;权重过大就会产生目标冲突。论文缺少 $\lambda=0$ 以及“无 gate / 无辅助支路”的完整组件消融,这是实验论证上的明显空白。
工程部署与在线收益
GALA 把重计算全部留在离线:Stage 1 每周用约 500 万三元组训练 18 小时;Stage 2 每周用约 700 万行为序列训练 24 小时;Stage 3 每天以约 7 亿排序样本训练 3 小时,相对 baseline ranker 增加约 10% 训练开销。每天为约 15 万张新增/更新图片和 7.6 万段文本做增量 embedding 推理,耗时约 30 分钟。
在线只查 KV 并做轻量融合。在 96 CPU core + PPU610 的生产近似机器上、加速器安全利用率上限 55% 时,P99 排序延迟从 15.9 ms 增至 17.6 ms,即增加 1.7 ms,吞吐和内存影响可忽略。
系统自 2024 年 11 月起上线淘宝闪购。随机流量 A/B 按“日级 uplift”计算显著性,订单量提升 0.55%,95% CI 为 [0.342%, 0.756%],$p<0.01$;商家曝光宽度整体增加 0.5%,早餐和晚餐高峰分别增加 1.78% 和 1.05%。这证明它不仅提高点击/转化估计,也实质改善长尾曝光和交易量。
核心贡献总结
- 把真实搜索—购买行为提前注入多模态预训练,以 query-image-text 三元组学习餐饮领域与用户意图,而不是只做通用图文一致性。
- 在离线 embedding 与在线 ranker 之间增加生成式 SFT+GRPO 对齐层,以真实购买命中奖励联合更新 decoder 和商家 embedding,把动态行为目标写回静态内容表示。
- 用 ID-dependent gate 与 stop-gradient 辅助损失解决强 ID 主干压制多模态信号的问题,并展示权重确实随头尾商家自适应。
- 给出覆盖率、训练频率、增量推理、P99 延迟和大规模 A/B,形成从表征学习到工业服务的完整证据链。
讨论与局限性
GALA 最值得借鉴的不是单个新模块,而是接口设计:它承认成熟工业 ranker 与离线 KV 服务不可轻易推倒,于是用一个离线生成式任务把行为监督“蒸馏”进可缓存 embedding,再用门控把内容信号接回 ID 系统。候选内 index token 也比直接生成 shop ID 更适配动态库存。这是一种效果、覆盖率和延迟之间非常务实的折中。
但方法仍有五点限制。第一,全部数据为淘宝闪购私有日志,没有公开数据集、公开代码或跨域验证,外部可复现性很弱。第二,Stage 2 的 binary purchase reward 极稀疏;组内奖励方差为零时整组优势为零,论文没有报告有效更新比例、group size、SFT 与 RL 训练轮数等关键配置。第三,teacher rationale 的质量、是否产生行为泄漏以及 reasoning token 是否真的必要,均缺少消融。第四,虽然作者强调 gate 与辅助损失,实验没有报告 $\lambda=0$、固定权重、无 gate 等最关键结构对照,不能完全分离行为对齐和融合机制的贡献。第五,这仍是显式三阶段解耦:表示每周更新、ranker 每日更新,端到端 ranking signal 不能持续回传到内容编码器;当模型 scaling 时,表征能力与下游序列建模并未共同增长,长期上限受冻结接口约束。
此外,论文称整体框架“tightly coupled/unified”,但工程上其实是异步耦合;“动态用户意图”也只是通过周期性离线行为对齐近似,而非请求级自适应。线上 0.55% 订单增益很有价值,却没有拆分 Stage 1、Stage 2、Stage 3 的独立在线贡献。
综合来看,这是一篇工业价值很高、方法组合合理但实验开放性和关键消融不足的工作。它把 GRPO 用在“优化可部署的内容表示”而非直接把大模型塞进在线链路,是很强的工程 insight;但三阶段固化和证据缺口使它更适合评为扎实的工业代表作,而非开创性范式。