MMRM:面向电商搜索排序的多路复用多模态表示模型¶
来自 JD.COM(京东)(Zhen-Lin Chen、Maosen Sheng、Peng Lin、Jianmin Chen、Zhuojian Xiao、Dongyue Wang、Xiwei Zhao,均为京东北京团队),SIGIR '26 短文(6 页),2026-07-13 挂 arXiv(2607.11030v1,cs.IR)。核心主张:现有把多模态大语言模型(MLLM)用于电商排序的做法有两个硬伤——(1) 只用单一协同信号(如 search-based q2i,或 behavior-based i2i click)去微调 MLLM,抓不住多任务排序真正需要的异质协同信号;(2) 把 MLLM 产出的多模态表示当普通 item 特征塞进排序模型,没挖掘它做用户行为建模的潜力。MMRM 用一个共享骨干 + 任务专用 token + 任务专用投影层的统一框架,让一个 MLLM 同时对齐四路协同信号(q2i_click、i2i_click、i2i_cart、i2i_order),一次前向就生成多路 item 表示(multiplex item representations);再用这些多路表示,通过「按任务做行为序列软检索」派生出任务专用的用户表示,喂给多任务排序塔。MMRM 已在京东电商搜索引擎全量部署,服务千万级日活,线上 A/B 在 UCTR / UACR / UCVR 三项分别 +0.42% / +0.37% / +0.35%。
研究动机与背景¶
电商搜索引擎的排序模型要在多个目标上刻画细粒度用户偏好:点击率(CTR)、加购率(Add-to-Cart Rate, ACR)、转化率(Conversion Rate, CVR)。传统纯 ID 的排序模型天然受两点掣肘:数据稀疏(长尾 item 的 ID embedding 训练不充分)与无法感知商品语义(看不懂标题、图片)。为解决这个问题,近期工作开始用多模态大语言模型(MLLM),借助协同信号(collaborative signals)去微调 MLLM,再把得到的表示作为辅助特征集成进排序模型。
但作者指出,这类方法有两个持续存在的局限:
第一,依赖单一协同信号。 现有方法要么只用基于搜索的 query-to-item(q2i)点击信号,要么只用基于行为的 item-to-item(i2i)点击信号去微调 MLLM。作者论证:电商信号本质上是异质的——q2i 点击捕捉的是宽泛的相关性(Fig. 1a-c),而序列化的 i2i 行为(尤其是加购 cart 与下单 order 信号,Fig. 1d-g)反映的是更强的细粒度相似性与互补关系。忽视这些多样信号,会让 MLLM 学不出多任务排序所必需的综合表示。
第二,多模态表示被下游排序模型低估。 多数排序模型用手工设计的特征交互表或简单的行为分组来消费多模态表示,抓不住多路复用的用户意图(multiplex user intents)。这会在多任务场景下造成信息损失与 embedding 纠缠(embedding entanglement)。
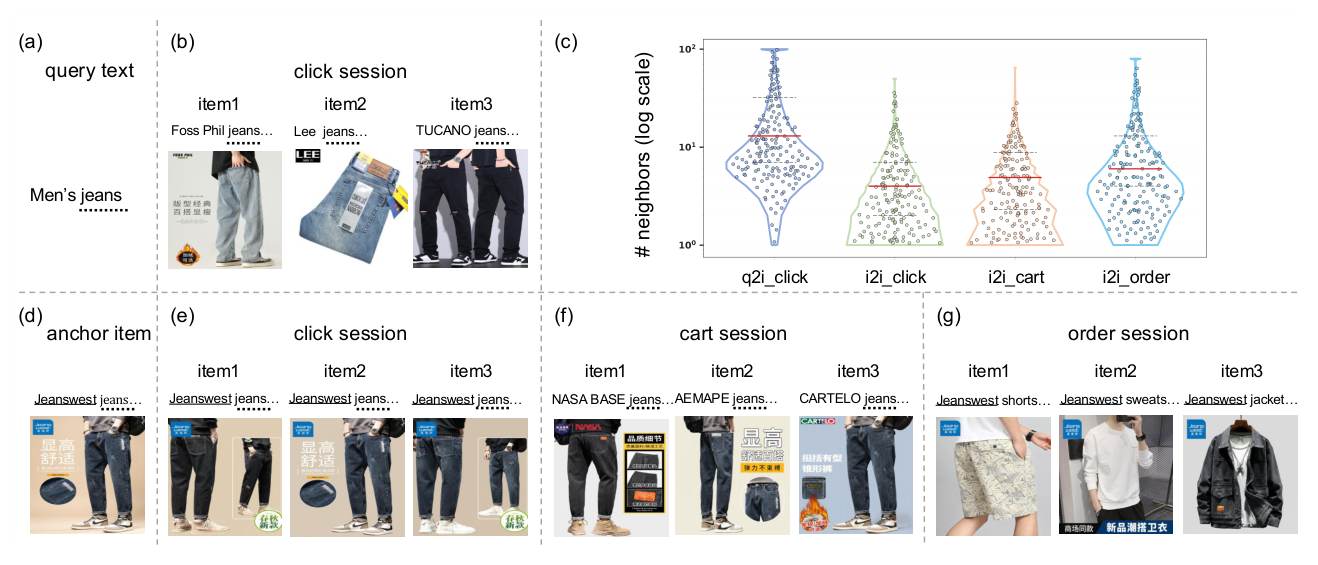
针对这两点,作者提出 MMRM(Multiplex Multimodal Representation Model),一个把 MLLM 与多样协同信号对齐的统一框架。通过共享骨干 + 任务专用 token + 投影层,MMRM 同时从四路信号学习,并在单次推理里高效生成综合的多路 item 表示。进一步,作者引入一种多路复用用户表示(multiplex user representation)策略,在排序模型里通过「利用多路 item 表示做基于搜索的行为序列建模」派生出任务专用的用户表示。
三点主要贡献:
- 提出 MMRM 统一框架,用一个共享骨干 + 任务专用 token 与投影层,把 MLLM 与多样协同信号有效对齐,一次前向即可高效生成多路 item 表示;
- 提出多路复用用户表示策略,从多路 item 表示派生任务专用用户表示,提升多任务排序性能;
- 通过大量离线与在线实验证明 MMRM 的优越性,并已线上部署。
核心方法:MMRM 架构¶
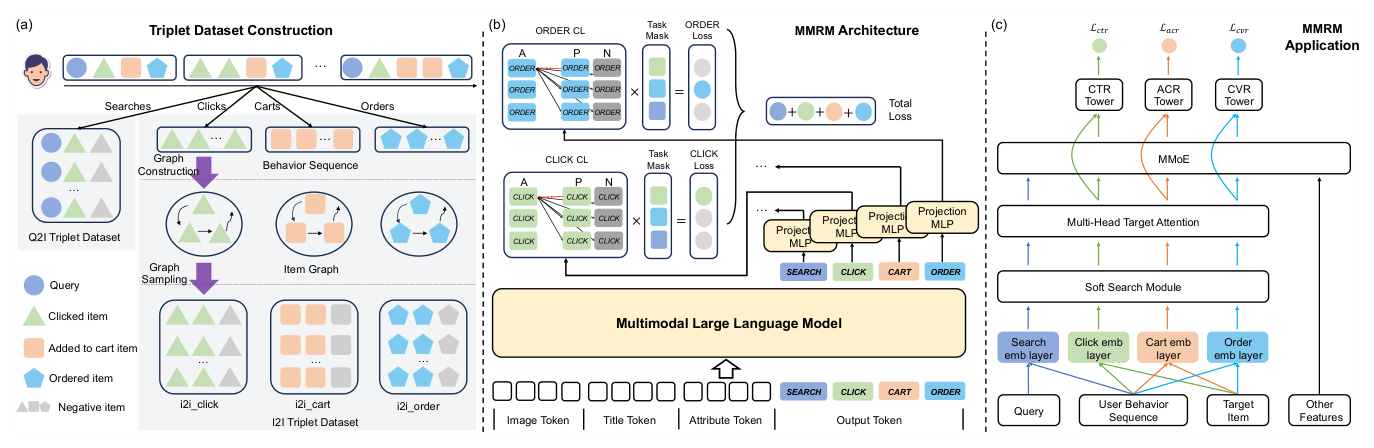
MMRM 分两大块:(2.1) 数据集构造(把用户行为拆成一路 q2i + 三路 i2i 的 triplet 数据集)与 (2.2) 多路复用多模态表示模型本身(共享 MLLM 骨干 + 任务 token + 对比学习目标);随后 (2.3) 讲这些表示怎么进入多任务排序模型。整体如 Fig. 2。
2.1 数据集构造¶
统一的数据格式是 triplet:<anchor, positive, negative>。
2.1.1 Q2I 数据集。 时序上,用户会话通常从搜索 query → item 点击 → 加购 → 下单逐级推进,构成完整行为链。为对齐文本 query 与多模态 item,作者用 query-item 点击(最普遍、最粗粒度的协同信号)构造 q2i_click 数据集。为增强对比学习,随机采一个来自正样本父类目但不同子类目的 item 作为 hard negative。最终的 q2i_click 数据集含 0.3 billion 条多样 triplet,跨 6 个月采集,每个 query 封顶在其 top 150 交互 item(见 Table 1)。
2.1.2 I2I 数据集。 为补足 q2i 宽泛信号所缺的细粒度 i2i 关系,作者用基于图的方法构造三个 i2i 数据集(click、cart、order)。以 i2i_click 为例:把 10 分钟窗口内连续点击的 item 连边,构造 item 图(捕捉强协同关系)。过滤掉噪声高频 item(促销、外卖、优惠券等)后,节点 $v_i$ 与边 $e_{ij}$ 分别按其出现频次 $f(v_i)$ 与转移频次 $g(e_{ij})$ 加权。
为缓解热门 item 主导,anchor item $v_a$ 按如下概率下采样(与 word2vec 一致):
$$P(v_a) = \sqrt{\frac{t}{f(v_a)}}, \tag{1}$$
其中 $t = 10^{-5}$。对每个 anchor,按转移概率从其一阶、二阶邻居中采样至多 30 个正样本 item $v_p$:
$$P(v_p \mid v_a) = \frac{g(e_{ap}) + \sum_{j \in B_a} g(e_{aj}) g(e_{jp})}{\sum_{j \in B_a} g(e_{aj}) + \sum_{j \in B_a} \sum_{k \in B_j} g(e_{aj}) g(e_{jk})}, \tag{2}$$
其中 $B_a$ 是 $v_a$ 的邻居集合。分子第一项是一阶直接转移 $g(e_{ap})$,第二项是经中间节点 $j$ 的二阶转移 $g(e_{aj})g(e_{jp})$;分母做归一化。
最后,从与 $v_p$ 同子类目的 item 里采样 hard negative $v_n$,概率(同 word2vec 负采样的 3/4 次幂分布)为:
$$P(v_n \mid < v_a, v_p >, n \notin \{a, p\}) = \frac{f(v_n)^{3/4}}{\sum_{j \in U_{s(v_p)}} f(v_j)^{3/4}}, \tag{3}$$
其中 $s(v_p)$ 是 $v_p$ 的子类目,$U_{s(v_p)}$ 是同子类目的 item 集合。i2i_cart 与 i2i_order 数据集遵循同样的生成流程,只是会话窗口配置不同(见 Table 1)。作者强调:与传统基于 CF 的方法不同,这里通过从序列化用户行为构造离散 item 图来捕捉细粒度 i2i 关系;hard negative 采样进一步强化了对比学习。
Table 1:MMRM 训练与测试数据集统计
| 数据类型 | 时间跨度 | 会话窗口 | 最大邻居数 | 训练样本 | 测试样本 |
|---|---|---|---|---|---|
| q2i_click | 6 mo | - | 150 | 0.3B | 0.5M |
| i2i_click | 6 mo | 10 min | 30 | 0.3B | 0.5M |
| i2i_cart | 1 yr | 30 min | 50 | 0.3B | 0.5M |
| i2i_order | 3 yr | 7 d | 100 | 0.3B | 0.5M |
表解读:四路信号的时间跨度与会话窗口递增(click 用 10 分钟、cart 用 30 分钟、order 直接放宽到 7 天窗口、3 年跨度),对应 Fig. 1c 中「点击相关性宽泛、下单相似性最强」的观察——越接近成交的信号越稀疏、越需要长窗口积累,但语义相似性越纯。每路都是 0.3B 训练 + 0.5M 测试,规模对称。
2.2 多路复用多模态表示模型¶
2.2.1 模型架构。 MMRM 以统一 triplet 格式同时吃一路 q2i 与三路 i2i 数据集。item 输入包含图像、标题、属性(如店铺名、价格);query 被当作没有图像和属性的特殊 item 处理。
为解耦四个任务,作者引入四个特殊 token——[SEARCH]、[CLICK]、[CART]、[ORDER]——追加到输入。利用 MLLM 的自回归特性,item $i$ 在任务 $t$ 下的任务专用 embedding,由特殊 token $t$ 的最后一层隐藏状态经一个任务专用 MLP 投影得到:
$$\mathbf{r}_i^t = \text{MLP}^t(\mathbf{h}_i^t), \quad t \in \{[SEARCH], [CLICK], [CART], [ORDER]\}. \tag{4}$$
也就是说,一次前向,同一个 item 就能拿到四路表示 $\mathbf{r}_i^{[SEARCH]}, \mathbf{r}_i^{[CLICK]}, \mathbf{r}_i^{[CART]}, \mathbf{r}_i^{[ORDER]}$——这正是「multiplex(多路复用)」的含义:共享 MLLM 骨干负责通用语义,任务 token + 任务 MLP 负责把通用语义投影到各信号专属的子空间,避免为每个信号跑一次单独的前向。
2.2.2 多任务学习目标。 训练时四个数据集均匀混合。对每个任务 $t$,只用它对应的正样本对算损失,其他任务的 item 充当 in-batch 负样本。任务 $t$ 的对比学习损失(InfoNCE 形式)为:
$$\mathcal{L}_t^{CL} = -\frac{1}{B}\sum_{i=1}^{B} \mathbb{1}_t(i) \log \frac{e^{\mathbf{r}_{ia}^t \cdot \mathbf{r}_{ip}^t / \tau^t}}{\sum_{j=1}^{B} e^{\mathbf{r}_{ia}^t \cdot \mathbf{r}_{jp}^t / \tau^t} + \sum_{j=1}^{B} e^{\mathbf{r}_{ia}^t \cdot \mathbf{r}_{jn}^t / \tau^t}}, \tag{5}$$
其中 $B$ 是 batch size;$\mathbb{1}_t(i)$ 是指示函数,当第 $i$ 个实例属于任务 $t$ 时返回 1;$\mathbf{r}_{ia}^t, \mathbf{r}_{ip}^t, \mathbf{r}_{in}^t$ 分别是任务 $t$ 中第 $i$ 个实例的 anchor、positive、negative embedding;$\tau^t$ 是任务 $t$ 的温度。分母里既有其他 positive($\mathbf{r}_{jp}^t$)也有 hard negative($\mathbf{r}_{jn}^t$)作为负样本。
总损失把各任务损失按权重 $\gamma^t$ 聚合:
$$\mathcal{L}_{total}^{CL} = \sum_t \gamma^t \mathcal{L}_t^{CL}, \quad t \in \{[SEARCH], [CLICK], [CART], [ORDER]\}. \tag{6}$$
设计动机:用一个 $\mathbb{1}_t(i)$ mask(即 Fig. 2b 中的 "Task Mask")把 batch 里属于不同任务的样本分开算各自的对比损失,是让「共享骨干 + 任务 token」能同时服务四路信号而互不干扰的关键——同一 batch 里 order 样本对 click 样本天然是负样本,这既提供了跨任务的丰富 in-batch 负样本,又通过 mask 保证每路损失只在本路正样本对上拉近。作者在 §3.2.1 把 MMRM 相对单任务模型的优势,归因于「多任务训练里更丰富的 in-batch 负样本」+「任务 token 让一次前向高效生成全部任务 embedding」。
2.3 多任务排序模型¶
如 Fig. 2c,给定一个 query $Q$、用户行为序列 $S$、目标 item $I$,以及其他特征 $O$:
第一步,任务专用软检索(Soft-Search)。 先用任务专用的多模态 embedding 表,从行为序列里抽出与任务 $t$ 相关的 top-K 行为子序列 $S_t'$:
$$S_t' = \text{Soft-Search}(S, I/Q, K, t). \tag{7}$$
即:不同任务用不同的 item 表示($\mathbf{r}^{[CLICK]}$ / $\mathbf{r}^{[CART]}$ / $\mathbf{r}^{[ORDER]}$ …)去度量「历史行为 item 与目标 item/query」的相关性,各自挑出各自最相关的 top-K 子序列。
第二步,派生任务专用用户表示。 用一个多头目标注意力(Multi-Head Target Attention, MHTA,即 multi-head DIN)模块,把软检索出的子序列聚合成任务专用用户表示 $U_t$:
$$U_t = \text{MHTA}^t(S_t', I/Q, t). \tag{8}$$
第三步,MMoE 融合。 把所有任务的用户表示与其他特征 $O$ 一起过 MMoE 模块,得到各任务的隐藏状态 $X_t$:
$$X_t = \text{MMoE}(U_{[SEARCH]}, U_{[CLICK]}, U_{[CART]}, U_{[ORDER]}, O, t). \tag{9}$$
第四步,任务塔预测。 对每个任务 $t$,把 $X_t$ 与任务专用用户表示 $U_t$ 一起喂给基于 MLP 的塔网络:
$$\hat{y}_t = \text{Tower}^t(X_t, U_t). \tag{10}$$
排序损失。 整体多任务排序损失是各任务交叉熵损失的加权和:
$$\mathcal{L}_t^{rank} = \text{Cross-entropy}(y_t, \hat{y}_t), \tag{11}$$
$$\mathcal{L}_{total}^{rank} = \sum_t \lambda^t \mathcal{L}_t^{rank}, \quad t \in \{ctr, acr, cvr\}, \tag{12}$$
其中 $\lambda^t$ 是任务 $t$ 的损失权重。
方法要点总结:MMRM 把「多路复用」贯穿两级——表示级(一个 MLLM 一次前向出四路 item 表示)和应用级(用四路表示分别做行为序列软检索 → 派生四路任务专用用户表示 → MMoE 分流三个排序塔)。相比把 MLLM 表示当静态 item 特征直接拼接的做法,MMRM 让每个排序任务都能用「与该任务信号对齐的 item 表示」去重新组织用户历史行为,这是它声称能缓解 embedding 纠缠、提升多任务排序的核心机制。
实验设置¶
3.1.1 数据集与指标。
- 表示模型评估:在四个 held-out 测试集上(各 0.5M 样本,Table 1)做 ANN 检索,用 F1@k 与 NDCG@k 度量检索与排序性能。
- 排序模型评估:收集8 天京东搜索日志,前 7 天训练(4B 样本),最后 1 天测试(2M 样本);排序性能用 GAUC(Grouped AUC)度量。
3.1.2 Baseline 模型。 比较三类表示模型:
- Single:任务专用的单任务模型(每路信号单独训一个);
- Vanilla-Multi:多任务,但用「任务专用 prompt + 共享 [EMB] token」实现;
- MMRM:多任务,用「任务专用 token」实现。
此外比较四类基于 SIM(Search-based Interest Model)的排序模型:
- $\text{SIM}_{hard}(\text{category})$:基于类目的行为过滤(category-based);
- $\text{SIM}_{soft}(item_{e2c})$:基于端到端 item embedding 过滤(在线基线);
- $\text{SIM}_{soft}(item_{MMRM[t]})$:用 MMRM 单个任务 $t$ 的 embedding 过滤;
- $\text{SIM}_{soft}(item_{MMRM[ALL]})$:用 MMRM 全部 embedding 做多路复用过滤。
3.1.3 实现细节。 MMRM 用 Qwen3-VL-4B-Instruct 初始化,训练除 vision encoder 外的所有参数。表示模型训练用 Adam(学习率 2e-5,batch size 2048,经 GradCache 扩大 batch),FlashAttention-2,$\tau^t = 0.05$,$\gamma^t = 0.25$。排序模型用 AdamW(学习率 3e-5,batch size 4096),$\lambda^t = 0.33$。所有模型在 8 张 NVIDIA H800 GPU 上训练。4B 参数的 MMRM 用 batch size 4096 在单台 H800 机器上训练。
主要实验结果¶
3.2 表示模型评估¶
Table 2:表示模型评估结果(加粗=最佳,下划线=次佳)
| 模型(训练任务) | F1@5 q2i_click | F1@5 i2i_click | F1@5 i2i_cart | F1@5 i2i_order | NDCG@5 q2i_click | NDCG@5 i2i_click | NDCG@5 i2i_cart | NDCG@5 i2i_order |
|---|---|---|---|---|---|---|---|---|
| Single (q2i_click) | 0.1985 | 0.2943 | 0.2679 | 0.0675 | 0.6356 | 0.7289 | 0.6655 | 0.4752 |
| Single (i2i_click) | 0.0818 | 0.3254 | 0.2981 | 0.0831 | 0.6129 | 0.7367 | 0.6752 | 0.4976 |
| Single (i2i_cart) | 0.0238 | 0.3237 | 0.3013 | 0.0908 | 0.5948 | 0.7351 | 0.6763 | 0.5070 |
| Single (i2i_order) | 0.0087 | 0.2989 | 0.2809 | 0.0904 | 0.5579 | 0.7293 | 0.6710 | 0.5224 |
| Vanilla-Multi | 0.1593 | 0.2987 | 0.2748 | 0.0676 | 0.6127 | 0.7295 | 0.6702 | 0.4875 |
| MMRM | 0.2055 | 0.3276 | 0.3037 | 0.0934 | 0.6392 | 0.7371 | 0.6779 | 0.5249 |
三点洞察: 1. 单任务模型只在自己训练的任务上强(对角线上多为次佳),凸显了任务的异质性——不存在能同时对齐所有协同信号的通用 embedding。例如 Single(q2i_click) 在 q2i_click 上 F1@5=0.1985(次佳),但在 i2i_order 上只有 0.0675(垫底)。 2. Vanilla-Multi 在所有单任务 baseline 上全面落败(F1@5 各列均不如对应的 Single 最优),说明「任务专用 prompt + 共享 [EMB] token」无法解耦任务——共享的单个 [EMB] token 成了信息瓶颈,四路信号在同一个 token 上互相干扰。 3. MMRM 全面超越所有 baseline(8 列全部加粗),验证其架构设计。作者把 MMRM 相对单任务模型的优势归因于多任务训练里更丰富的 in-batch 负样本;此外,不同的任务 token 让 MMRM 能一次前向高效生成所有任务 embedding,避免了 baseline 需要的多次独立前向。
关键对比:Vanilla-Multi vs MMRM 是最有信息量的 A/B——两者都是「共享骨干的多任务」,唯一区别是任务解耦机制(共享 [EMB] token vs 独立任务 token)。MMRM 全胜说明:多任务的收益不是「共享骨干」本身,而是任务专用 token 提供的解耦子空间。这一点直接回应了动机里的「embedding 纠缠」痛点。
3.2.2 消融实验:batch size¶
对比学习通常受益于大 batch,但大 batch 常被 GPU 显存卡住。为扩 batch,作者用 GradCache——把对比损失的反向传播拆成两阶段,将模型更新拆成显存高效的子更新。这让 4B 参数的 MMRM 能在单台 H800 上用 batch size 4096 训练。
Table 3:batch size 消融(batch > 1024 时用 GradCache,为加速省略了图像)
| Batch size | F1@5 q2i_click | F1@5 i2i_click | F1@5 i2i_cart | F1@5 i2i_order |
|---|---|---|---|---|
| 256 | 0.1874 | 0.3216 | 0.2991 | 0.0882 |
| 512 | 0.1937 | 0.3223 | 0.2984 | 0.0895 |
| 1024 | 0.1980 | 0.3239 | 0.2991 | 0.0907 |
| 2048 | 0.2007 | 0.3255 | 0.3004 | 0.0916 |
| 4096 | 0.1997 | 0.3251 | 0.3021 | 0.0919 |
结论:整体上更大的 batch 一致地提升 MMRM 性能。q2i_click / i2i_click 在 2048 达到峰值,i2i_cart / i2i_order 在 4096 达到峰值——越稀疏的信号(cart/order)越吃大 batch 带来的负样本增益。这从实证上支撑了「用 GradCache 扩 batch」的工程选择。(注意此表因加速省略了图像,绝对值略低于 Table 2。)
3.3 排序模型评估¶
Table 4:排序模型评估结果(GAUC)
| 模型 | CTR | ACR | CVR |
|---|---|---|---|
| $\text{SIM}_{hard}(\text{category})$ | 0.6816 | 0.7051 | 0.6733 |
| $\text{SIM}_{soft}(item_{e2c})$(在线基线) | 0.6866 | 0.7101 | 0.6783 |
| $\text{SIM}_{soft}(item_{MMRM[SEARCH]})$ | 0.6947 | 0.7164 | 0.6807 |
| $\text{SIM}_{soft}(item_{MMRM[CLICK]})$ | 0.6928 | 0.7145 | 0.6839 |
| $\text{SIM}_{soft}(item_{MMRM[CART]})$ | 0.6941 | 0.7124 | 0.6830 |
| $\text{SIM}_{soft}(item_{MMRM[ORDER]})$ | 0.6934 | 0.7127 | 0.6814 |
| $\text{SIM}_{soft}(item_{MMRM[ALL]})$ | 0.7037 | 0.7190 | 0.6875 |
结论: 1. 软检索优于硬检索:在线基线 $\text{SIM}_{soft}(item_{e2c})$ 全面超过 $\text{SIM}_{hard}(\text{category})$(CTR 0.6866 vs 0.6816),验证软检索策略。 2. 但 $item_{e2c}$ 依赖单个端到端 embedding 表做行为过滤 + 用户建模,会造成 embedding 纠缠,限制多任务表现。 3. 换成 MMRM 的任一单任务表示 $\text{SIM}_{soft}(item_{MMRM[t]})$ 都能在三个任务上取得显著更好结果——引入一张额外的多模态 embedding 表就有效。 4. 用 MMRM 全部四路表示做任务专用用户建模 $\text{SIM}_{soft}(item_{MMRM[ALL]})$ 取得最佳(CTR 0.7037 / ACR 0.7190 / CVR 0.6875),证明多路复用多模态表示对多任务排序的价值。
表解读:从 $item_{e2c}$(0.6866)到 $MMRM[ALL]$(0.7037),CTR 上 GAUC 涨了约 0.017(+1.7pt),在工业 GAUC 尺度上是很大的提升。且四个单任务表示各有所长(SEARCH 对 CTR/ACR 最好、CLICK 对 CVR 最好),恰好说明「用多路表示分别服务不同任务」的合理性——把它们全用上(ALL)才拿到全局最优。
3.4 线上 A/B 测试¶
在京东电商搜索引擎上做了为期一周的在线 A/B。$\text{SIM}_{soft}(item_{MMRM[ALL]})$ 相对在线基线 $\text{SIM}_{soft}(item_{e2c})$,在以下指标上分别提升:
- UCTR(用户点击率):+0.42%
- UACR(用户加购率):+0.37%
- UCVR(用户转化率):+0.35%
作者强调:鉴于平台的巨大流量,即便 0.10% 的提升都意味着可观的营收增长,因此这些增益「高度显著」。结果是——MMRM 与所提排序模型均已全量部署上线。
核心贡献总结¶
- 一个 MLLM 骨干对齐四路异质协同信号:不再单信号微调,而是把 q2i_click / i2i_click / i2i_cart / i2i_order 统一进一个共享 MLLM 骨干,用任务专用 token + 任务专用投影 MLP 解耦,一次前向生成多路 item 表示(式 4)。
- 任务解耦优于 prompt 共享:Table 2 中 MMRM 全面碾压「共享 [EMB] token」的 Vanilla-Multi,证明独立任务 token 是打破 embedding 纠缠的关键,而不仅仅是「共享骨干 + 多任务训练」就够。
- 多路复用用户表示策略:不把 MLLM 表示当静态 item 特征,而是用每路任务表示分别做行为序列软检索 → MHTA → MMoE,派生任务专用用户表示(式 7-10),让每个排序任务用「与其信号对齐的表示」重组用户历史。
- 扎实的工业落地:京东搜索全量部署,服务千万级日活,线上 A/B 三指标齐涨(+0.42%/+0.37%/+0.35%),GradCache + FlashAttention-2 让 4B MLLM 单机可训。
与已归档相关工作的对比¶
DUET DUET: Dual User Embedding Transformers(Meta, 2026-06-08)¶
关系:独立并发(本文未引用 DUET,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇都直指同一个 root cause——用单一编码器/单一协同信号去学表示,会被某一路信号主导,从而在下游多任务排序里 underfit 其他任务、造成信号纠缠。DUET 讲的是「单个上游模型把稠密点击流与稀疏转化流当同质流,被点击主导,欠拟合站外转化」;MMRM 讲的是「单一协同信号微调 MLLM,抓不住 q2i 宽泛相关性与 i2i cart/order 细粒度相似性并存的异质性」。两者的诊断在结构上高度同构。
- 相近的技术骨架:都采用「按信号语义把训练拆成多条统计同质的流 → 分别学出互补表示 → 冻结后作为特征喂给下游多任务 ranker」这条主线。DUET 拆成 Click 流 / Conversion 流两条,MMRM 拆成 q2i_click + i2i_click/cart/order 四路;两边都强调下游 ranker「联合消费多个互补 embedding」(DUET 的 ClickAUE/ConvAUE、MMRM 的四路 item 表示 → MMoE)。
- 本文的差异与推进:(1) 产出对象不同——DUET 产出的是用户嵌入(每条流一个独立 Transformer 塔,架构各自匹配统计特性:稠密流深层自注意力、稀疏流交叉注意力);MMRM 产出的是item 表示,且用一个共享 MLLM 骨干 + 任务 token 一次前向同时出四路,而非四个独立塔。(2) 用户建模的位置不同——DUET 在上游预训练阶段就把用户序列编码进 embedding;MMRM 把用户建模放在下游排序模型里,用多路 item 表示对行为序列做任务专用软检索(式 7-10)来派生用户表示。(3) 模态——MMRM 显式吃图像/标题/属性(MLLM),DUET 走的是 DLRM + 事件型特征 + 语义 ID 路线。可比的实验差异:两者都靠「多流/多路 vs 单流/单信号」的对照证明收益(DUET 训练 NE −0.38%、线上 CVR +0.66%/+0.15%;MMRM 线上 UCTR/UACR/UCVR +0.42%/+0.37%/+0.35%)。
IDProxy IDProxy(Xiaohongshu, 2026-03-02)¶
关系:独立并发(本文未引用 IDProxy)· 已加载对方精读
- 共同关注的问题:都要解决「纯 ID 排序模型数据稀疏、看不懂商品语义」,路径都是用 MLLM 从多模态内容产出 item 表示,作为特征注入现有 CTR/排序模型,并用对比学习把 MLLM 表示对齐到排序模型能用的空间。
- 技术骨架差异:IDProxy 是单信号、冷启动导向——用两阶段粗到细把 MLLM 内容 embedding 对齐到在线 CTR 模型的 ID embedding 空间(式:InfoNCE 拉近 $\bar{\mathbf{h}}_i$ 与 $\mathbf{e}_i$),核心目标是给缺乏交互的新 item 造「代理 ID embedding」。MMRM 不针对冷启动,而是针对多任务排序的信号异质性:它对齐的不是 ID embedding 空间,而是四路真实协同信号(q2i/i2i click/cart/order),且强调「多路复用一次前向」与「下游任务专用用户建模」。所以两者虽都属「MLLM→item 表示→排序特征 + 对比对齐」这一大类,但 IDProxy 是单信号补冷启动,MMRM 是多信号解纠缠 + 多任务用户建模,解法骨架的重心不同。列在此处作为「同大类、不同重心」的对照,而非严格孪生。
讨论与局限性¶
核心贡献与值得借鉴的设计:
- 「任务 token 解耦 + 一次前向多路输出」是很干净的工程 insight。相比为每个协同信号训一个独立 MLLM(Single)或用共享 prompt token(Vanilla-Multi),MMRM 用「共享骨干 + N 个任务 token + N 个投影 MLP」在推理成本几乎不变的前提下拿到 N 路解耦表示,Table 2 的全面提升说明这套解耦确实有效。这个范式可迁移到任何「一个大模型要同时服务多路异质监督信号」的场景。
- 把多模态表示从「静态 item 特征」升级为「用户建模的检索键」是另一个值得借鉴的点——用任务专用表示对行为序列做软检索,让每个排序任务都能用「自己信号对齐的表示」去重组用户历史,直接对症「embedding 纠缠」。
局限与争议:
- 短文体量,方法细节偏薄:作为 SIGIR 6 页短文,很多关键设计只有一句话——如 Soft-Search(式 7)、MHTA(式 8)、MMoE(式 9)都直接引用已有工作(DIN/MMoE),没有展开 MMRM 特有的适配细节;四路信号的 $\gamma^t$、$\tau^t$ 是否按信号稀疏度分别调、hard negative 采样对 order 这种极稀疏信号是否够,都未讨论。
- 消融不够系统:只做了 batch size 一个消融。缺「任务 token 数量」「去掉某一路信号」「$item_{MMRM[ALL]}$ 里各路的边际贡献」等更能说明多路复用价值的消融——Table 4 虽有单任务表示对照,但没有「逐步加入信号」的增量曲线。
- 表示与排序两阶段解耦(扩展性隐患):MMRM 的 MLLM 表示是离线预训练后冻结再喂给排序模型(
item_{MMRM}作为 embedding 表),表示学习与排序目标没有端到端联合优化。这意味着:MLLM 学到的四路表示对「对比学习的检索目标」最优,但未必对「CTR/ACR/CVR 排序目标」最优——存在两阶段目标错配的经典隐患。参数量 scaling 时,扩大 MLLM 骨干能提升表示质量,但下游排序模型如何同步吃到这份提升、是否需要重新对齐,论文未涉及。这是「先离线学表示、再喂下游」范式共有的上限问题。 - 纯自报告工业指标:表示模型评估用的是京东内部数据集(q2i/i2i),排序评估也是京东日志,无公开数据集对照,外部无法复现;线上 A/B 只跑了一周。
工业落地价值:论文的落地信号很强——4B MLLM(Qwen3-VL-4B-Instruct)用 GradCache + FlashAttention-2 做到单机 H800 可训,表示离线预计算后冻结注入排序模型,推理侧新增一张多模态 embedding 表即可,工程侵入小;已在京东搜索全量部署服务千万级日活,线上 A/B 三指标齐涨。对「想把 MLLM 表示低成本接入已有多任务排序系统」的工业团队,这套「多路复用表示 + 任务专用软检索」是可直接参考的落地范式。