LLM4AIGQ: LLM-based AI Guidance Query Generation Framework for Multi Interest Mining 精读¶
阿里巴巴(Alibaba Group,作者邮箱 @alibaba-inc.com / @taobao.com,第一作者与通讯作者分别挂华中科技大学、南开大学联培),arXiv:2609.03674v1,2026-09-03,10 页,cs.IR。
一句话:把淘宝/天猫「AI 导购引导词(AI-Generated Query, AIGQ)」的生产链路,从「多路召回主搜 query → 规则泛化」的判别式级联,换成「一个 LLM 直接从用户画像 + 多行为序列里切分多兴趣、推断消费意图、生成引导词」的生成式管线;训练用 SFT → GRPO(四级奖励)→ DPO(think 蒸馏进 non-think)三段式后训练;部署用近线生成 + 在线读表架构,把 LLM 彻底挡在实时请求路径之外。天猫多场景线上 A/B:10% 流量 uCTR +4.46%,放量到 40% 后六天 uCTR +2.53%。
1. 研究动机与背景¶
1.1 任务定义:什么是 AIGQ¶
购物 agent 通过自然语言交互给出商品推荐与决策支持,但用户在会话起点往往说不清自己要什么。为降低这个交互门槛,电商平台在首页推荐、AI 搜索等场景主动展示 AI 生成的引导词(AIGQ):用户点一下,这条引导词就作为初始 request 送给购物 agent。因此一条合格的 AIGQ 必须同时满足三件事——反映用户偏好、传达可执行的购物意图、简洁合规。论文把这条链路的目标概括为「stimulate user consumption by extracting preferences to provide search queries with guidance value」。
1.2 传统 Q2AIGQ 管线的两个结构性缺陷¶
既有方法普遍走两阶段的 Q2AIGQ(Query-to-AI-Generated-Query) 关联范式:
- 先从用户画像、历史行为序列、item 侧信息与当前 query 出发,通过多路检索(图中的 q2q / u2q / i2q 三路)召回用户的主搜 query(primary/anchor search query),再经 RankModel 取 Top-K;
- 再用规则化泛化(Cases / Rules / Role / WorkFlow)把主搜 query 改写成 AIGQ。
论文指出两个根因:
- 信息级联损失导致语义漂移(semantic drift)。中间那个「主搜 query」是一个信息瓶颈:用户的原始上下文(画像 + 多行为序列 + item 属性)被压缩成一个短 query,后续规则只能在这个已经失真的锚点上做泛化,最终产物与原始意图之间已经隔了两层有损变换。
- 共现关系撑不起多兴趣建模。锚点 query 的推断被孤立的搜索行为与 user–item 共现信号主导,本质上只表达「和你相似的人搜过什么」,无法刻画用户的多样兴趣与个性化意图。结果是引导词导购价值低、和真实购买意图错位。
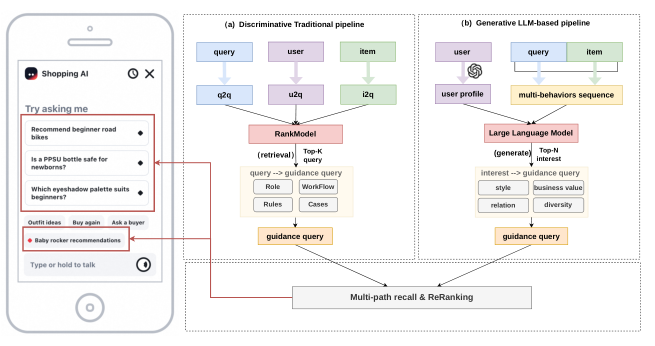
Fig. 1 里最值得注意的一处对照是:判别式管线的中间产物是 query,生成式管线的中间产物是 interest。论文把「先召回一个 query 再泛化」换成「先切分兴趣再生成」,这个中间表示的替换才是全文方法论的支点。
1.3 三个待解挑战¶
论文自陈需要解决三个挑战:
- 噪声交互下的多兴趣建模。用户兴趣天然多样,而历史交互序列不可避免混入误触、曝光偏差等噪声,必须在去噪的同时准确识别主兴趣。
- 无显式 ground truth 的有效监督。AIGQ 没有严格定义的标准答案,质量难以可靠评估,监督信号难以构造。
- 在线服务的推理效率。线上动态推理要求高响应、低时延,必须在保住生成质量的前提下大幅压掉 LLM 推理延迟。
对应的三招分别是:教师模型做兴趣切分构造单兴趣监督数据(挑战 1)、多层级奖励函数 + GRPO(挑战 2)、近线生成 + 在线读取 + DPO 把 think 蒸进 non-think(挑战 3)。
1.4 与已有 LLM-for-Rec 工作的关系¶
Related Work 分两块。查询推荐一侧从 QEM / DREM 的 query–item 语义相似度,到 HEM(评论学 user embedding 建模长期偏好)、AEM(注意力聚合历史交互)、ZAM(零注意力向量自适应控制个性化强度)、TEM(Transformer encoder 捕捉搜索历史的序列依赖);多兴趣方向有 CAMI(知识图谱嵌入解耦多兴趣)、GraphSRRL(user–query–item 图的结构模式);搜推联合建模有 USER、UniSAR、MIJSR。论文强调自己的任务与常规查询推荐不同——不只要找到匹配兴趣的商品作为检索实体,还要提升导购价值以刺激消费,因此引入多行为数据并同时建模长短期兴趣。
LLM-for-Rec 一侧列了 LLMRec(LLM 增广 user–item 交互与文本做图推荐)、TALLRec(指令微调对齐下游推荐)、XRec(协同特征映射进 LLM 语义空间做可解释推荐)、ReFICR(指令微调让检索增强 LLM 做对话式推荐)、Rec-R1 / Reason4Rec / OneReason(PPO/GRPO + 定制奖励模型增强偏好理解与事实推理)。本文的定位是:用 SFT–RL–DPO 后训练管线改进引导词生成,并用多维奖励同时承载多目标优化与长链推理。
2. 核心方法:LLM4AIGQ 整体架构¶
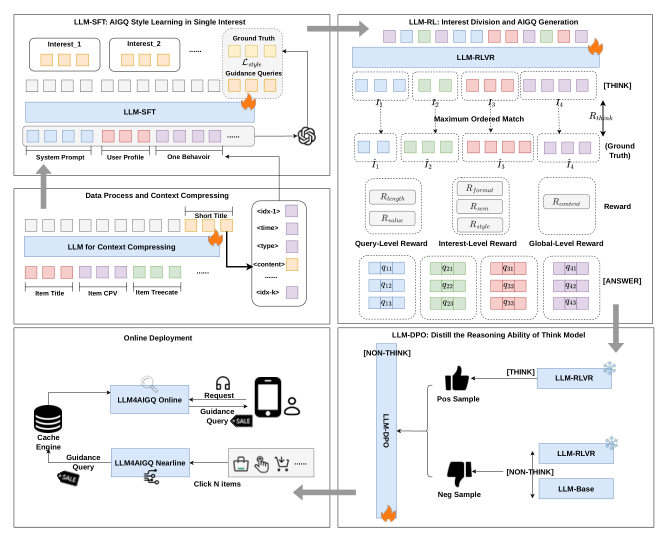
框架是严格的三段式训练范式 SFT → RL → DPO,外加一个前置的数据压缩阶段和一个后置的部署架构:
- 数据处理与上下文压缩:LLM 把冗长的商品原标题压成短标题,缩短行为序列的 token 长度;
- SFT:只喂单兴趣子序列,让模型专心学 AIGQ 的表达风格;
- RL(GRPO):喂多兴趣混合序列,要求模型自主推断兴趣划分,用 think / query / interest / global 四级奖励监督;
- DPO:把 think 模式下的推理成果蒸馏进 non-think 模式,线上直接出答案;
- 部署:近线按行为累积触发生成,写进 user_id → guidance queries 映射表,在线只做向量检索读取。
2.1 预备:数据构成与任务目标¶
LLM 生成 AIGQ 的输入由两部分组成:任务指令 $R$ 与用户上下文 $C_u$。用户上下文进一步拆成用户画像 $P_u$ 与用户历史序列 $S_u$。$P_u$ 由 Qwen 模型基于用户消费模式与基础个人信息总结抽取而得(反映相对稳定的长期兴趣);$S_u$ 主要包含用户近期行为,每条行为 $B_u$ 由时间戳 $t$、行为类型 $a$ 和行为内容 $c$ 三元组构成(反映动态异质的短期兴趣)。行为类型 $a$ 覆盖 like / favorite / add-to-cart / purchase / search 五类;对 search 行为,$c$ 是用户的 query 词,其余行为的 $c$ 是关联的商品标题。
任务目标:LLM 需要基于 $C_u$ 识别出用户兴趣 $I_u$,并为每个子兴趣生成对应的 AIGQ。总结出的兴趣要贴合用户消费模式,生成的引导词要击中购买痛点、有导购价值、且简洁合规。
2.2 数据处理与上下文压缩(§4.1)¶
考虑到用户历史消费数据体量巨大,先做截断:只保留最近 50 条交互行为以捕捉短期兴趣。每条行为格式化为 <序号 idx><时间 t><行为类型 a>行为内容 c,行为之间用 | 分隔,时间 $t$ 表示相对当前时刻的间隔。
商品原标题的问题是:命名不规范、可读性差,且为了追求搜索曝光塞满冗余营销词。论文用 Qwen3-30B-A3B 从原标题 $i_d$、CPV 信息 $i_c$ 与品牌类目信息 $i_b$ 中总结短标题,剔除营销关键词与旗舰店等冗余信息。为了让短标题简洁有效,用更大容量的 DeepSeek-V4-Pro 的推理结果作为标准答案,对短标题任务做微调:
$$\mathcal{L}_{short} = -E_{(x,z)\sim \mathcal{D}}\left[\sum_{t=1}^{T}\log P(z_t \mid z_{<t}, x; \theta)\right] \tag{1}$$
其中 $x = [i_d, i_c, i_b]$ 是模型输入(商品相关信息),$\theta$ 是模型参数,$T$ 是生成短标题的长度。
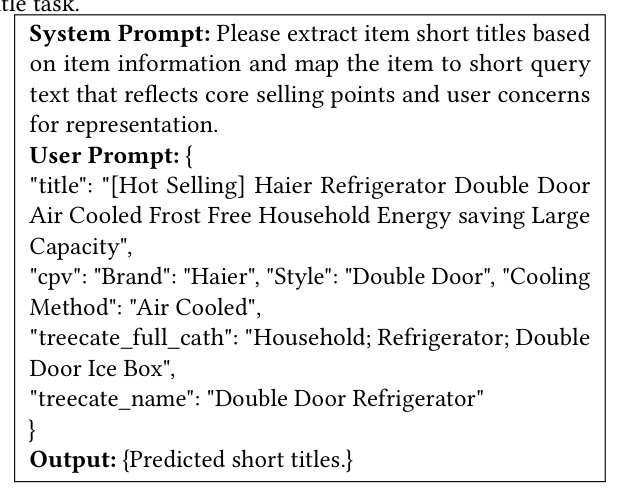
这一步的物理含义:用一次离线的语义归一化,把行为序列从「电商标题体」翻译成「query 体」。这不只是省 token——§5.3.1 的消融显示模型会模仿商品标题的长度与文风来写引导词,所以缩短标题同时也让输出更简洁。
2.3 SFT 阶段:在单兴趣下学习 AIGQ 风格(§4.2)¶
SFT 的目标是让 LLM 理解「什么是 AIGQ、什么是好的 AIGQ」。任务指令里显式列出 AIGQ 的可能应用场景(单品咨询、比较决策、品类选择等),并要求模型输出有导购价值、内容合规、表达简洁的引导词。
人工测试发现两件事:
- 直接用 Qwen3-30B-A3B 生成的 AIGQ 存在导购价值低、表达多样性差的问题;相比之下 DeepSeek-V4-Pro 生成的 AIGQ 在表达与实用场景契合度上更好、导购价值更高。因此用大模型的推理结果作为标准答案做指令微调。
- 直接用复合兴趣的历史行为数据微调会出问题:模型在推理时容易「自主外推」,对低频触发词不友好,且生成的多条候选 AIGQ 往往集中在单一主兴趣上。
为此,先用 SOTA LLM 对用户历史序列 $S_u$ 做兴趣切分,为每个子兴趣 $I_k$ 按时序抽出对应子序列 $S_k$ 并推断相应引导词。这样设计鼓励模型专注学习引导词的生成风格,而不是在多个兴趣之间做选择。目标函数为:
$$\mathcal{L}_{style} = -E_{(P_u, S_u, z)\sim \mathcal{D}}\left[\sum_{k=1}^{K}\sum_{t=1}^{T}\log P(y_t \mid y_{<t}, P_u, S_k; \theta)\right] \tag{2}$$
其中 $P_u$ 是用户画像,$\theta$ 是模型参数(实现中为 Qwen3-30B-A3B),$T$ 是生成 AIGQ 的长度。
设计动机解读:SFT 与 RL 在这里被刻意做了任务难度的分工——SFT 只学「怎么写」,RL 才学「写给谁、分几组」。这是全文最干净的一个方法论决策,后面 Table 1 的 ONESFT vs MULTISFT 对照就是为了验证它。
2.4 RL 阶段:兴趣划分与 AIGQ 生成(§4.3)¶
RL 阶段要求模型自主完成兴趣切分并为每个子兴趣生成 AIGQ。指令强制模型先按预定义的三步流程推理再给最终答案:
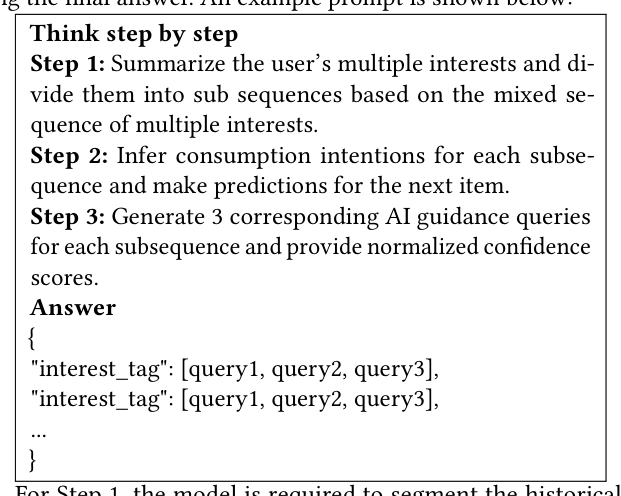
三步的具体约束:
- Step 1:基于行为的时间邻近性、语义相关性和画像偏好,把历史序列切成至多三个兴趣子序列。对每个子序列 $S_k$ 识别对应的交互行为 $B_k = [B_{k1}, ..., B_{km}]$,并总结出兴趣标签 $I_k$。
- Step 2:基于兴趣标签 $I_k$、$B_k$ 反映的商品特征以及用户画像 $P_u$,推断用户当前的消费意图 $M_k$,并预测下一个可能偏好的商品 $i_k$。
- Step 3:根据推断出的兴趣 $I_k$ 与预测商品 $i_k$ 生成三条引导词,并为每条赋一个置信度 $c$。
最后以 JSON 输出兴趣标签与对应引导词。
论文明确指出多目标优化会带来目标冲突与训练信号稀释,因此采用分层奖励设计,在 think / query / interest / global 四个粒度上定义奖励。
2.4.1 Think-Level Reward:监督兴趣切分的合理性¶
先用高参数量模型(DeepSeek-V4-Pro)在相同 prompt 下生成参考推理过程与标准输出。设参考兴趣子序列为 $\hat{S}_u = [\hat{S}_1, ..., \hat{S}_m]$,对应兴趣标签 $\hat{I}_u = [\hat{I}_1, ..., \hat{I}_m]$;模型生成的子序列为 $S_u = [S_1, ..., S_n]$,标签 $I_u = [I_1, ..., I_n]$。
难点在于:参考输出与模型输出推断出的兴趣数量可能不同($m \ne n$),且 LLM 通常把主兴趣放在前面、次兴趣放在后面。因此采用最优有序匹配算法求最合理的对齐策略 $M$。匹配得分主要由两个子序列的重叠度决定,并引入序列长度作为惩罚因子(因为对齐主兴趣更重要):
$$score(\hat{I}_i, I_j) = 2 * \frac{|\hat{S}_i| \cap |S_j|}{|\hat{S}_i| + |S_j|} * \log(|\hat{S}_i| + |S_j|) \tag{3}$$
前半部分是 Dice 系数(行为重叠率),后半部分 $\log$ 项让长子序列的匹配得分更高,从而在动态规划里优先对齐主兴趣。
Algorithm 1(最优有序匹配) 是一个标准的序列对齐 DP,保序(不允许交叉匹配),允许跳过任一侧:
输入:参考序列 Ŝ_u(长度 m)、模型序列 S_u(长度 n)、打分函数 score(a,b)
输出:最大得分、DP 表、回溯指针
1  m ← len(Ŝ_u);  n ← len(S_u)
2  DP[0..m][0..n] ← 0;  Parent[0..m][0..n] ← null
3  for i ← 1 to m:
4      for j ← 1 to n:
5          best ← DP[i-1][j];               Parent[i][j] ← (i-1, j, 'skip Ŝ_u')
6          if DP[i][j-1] > best:
7              best ← DP[i][j-1];           Parent[i][j] ← (i, j-1, 'skip S_u')
8          matchVal ← DP[i-1][j-1] + score(Ŝ_u[i-1], S_u[j-1])
9          if matchVal > best:
10             best ← matchVal;             Parent[i][j] ← (i-1, j-1, 'match')
11         DP[i][j] ← best
12 return (DP[m][n], DP, Parent)
拿到匹配集合 $M$ 后,用行为-逻辑双通道匹配计算兴趣准确度奖励 $R_{match}$:对每对 $(a,b) \in M$,行为奖励 $R_{action}$ 由两个子序列的行为重叠数决定,逻辑奖励 $R_{logic}$ 由两个兴趣标签的语义相似度决定,二者相乘:
$$R_{match} = \frac{1}{|M|}\sum_{(a,b)\in M} R_{a,b} = \frac{1}{|M|}\sum_{(a,b)\in M} R^{(a,b)}_{action} * R^{(a,b)}_{logic}$$ $$R^{(a,b)}_{action} = 2 * \frac{|\hat{S}_a| \cap |S_b|}{|\hat{S}_a| + |S_b|}, \quad R^{(a,b)}_{logic} = g(f(\hat{I}_a), f(I_b)) \tag{4}$$
其中 $f(\cdot)$ 是语义编码器(实现用 mge-small),$g(\cdot)$ 是余弦相似度。相乘而非相加的含义是:分对了行为但兴趣标签命名离谱,或者标签对了但圈错了行为,都不给分——这是一个 AND 语义的门控。
此外还有 think 的格式奖励:检测 Step1 / Step2 / Step3 三个关键 token 是否存在,并以 JSON 解析每一步验证属性键是否完整。满足则 $R_{think\_format} = 1$,否则为 0。
2.4.2 Query-Level Reward:监督单条引导词的商业价值与合规¶
作用在每个子兴趣 $I_k$ 下的每条引导词 $q^k_j$ 上,含两项:
- 长度奖励 $R_{length}$:要求引导词不超过 15 个汉字,满足为 1,否则为 0。
- 导购价值奖励 $R_{value}$:先在人工标注数据上训练一个 judge model 评估每条引导词的商业导购价值,输出评级 $r_t \in \{S, A, B\}$:
$$R_{value} = \begin{cases} 1, & r_t = S \\ 0.5, & r_t = A \\ 0, & r_t = B \end{cases} \tag{5}$$
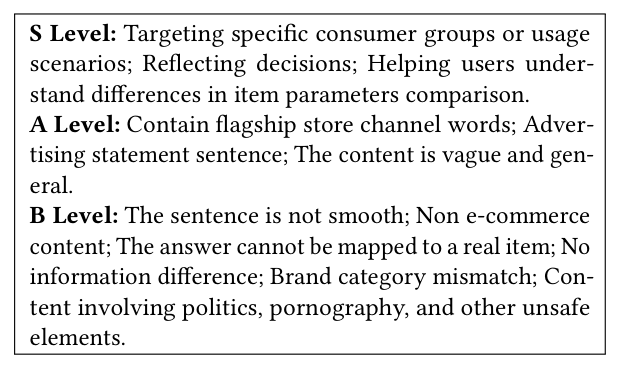
这套 rubric 值得注意:它把「无信息差(no information difference)」直接判为 B 级——即一条只是复述用户已知信息的引导词被视为无价值,而不是中性。这实际上是在奖励函数层面编码了「引导词必须提供增量信息」的产品准则。
2.4.3 Interest-Level Reward:监督同一兴趣簇内多条候选的准确性与多样性¶
三项奖励:
(1)语义准确度奖励 $R_{sem}$。设高参数量模型在子兴趣 $I_k$ 下生成的参考引导词为 $\hat{q}_k$,模型生成 $T$ 条候选 $q_k = [q_{k1}, ..., q_{kT}]$,Step 3 同时给出置信度 $\{c_k\}^T_{i=1}$。先把置信度归一化为重要性权重,再对每条候选与参考的语义相似度做加权聚合:
$$R_{sem} = \sum_{i=1}^{T} w_{ki} \cdot g(f(q_{ki}), f(\hat{q}_k)), \quad \omega_{ki} = \frac{c_{ki}}{\sum_{j=1}^{T} c_{kj}} \tag{6}$$
用模型自报的置信度做权重,等于把「让模型给自己的输出排序」也纳入被优化的对象——置信度给错了,同样会拉低 $R_{sem}$。
(2)风格多样性奖励 $R_{style}$。用 Type-Token Ratio(TTR)度量同一兴趣簇内的表达多样性,即去重 token 数与总 token 数之比:
$$R_{style} = \frac{|\cup_{i=1}^{T}\{Token(q_{ki})\}|}{\sum_{i=1}^{T}|Token(q_{ki})|} \tag{7}$$
(3)格式约束奖励 $R_{format}$。要求每个兴趣簇生成的候选数 $N_q$ 严格等于指令要求的数量 $T$:
$$R_{format} = \begin{cases} 1, & N_q = T \\ 0, & \text{otherwise} \end{cases} \tag{8}$$
2.4.4 Global-Level Reward:监督不同兴趣之间的内容多样性¶
目标是鼓励兴趣多样化、避免不同兴趣簇之间表达同质。设模型输出 $N$ 个兴趣组 $I_u = [I_1, ..., I_N]$,每个子兴趣含 $T$ 条引导词 $Q_j = [q_1, ..., q_T]$。先对组内引导词的语义表示做 mean pooling 得到兴趣簇表示 $E(\bar{Q}_j) = MeanPool(E(q_1), ..., E(q_T))$,再计算簇间相似度矩阵 $E_Q \in R^{N\times N}$:
$$R_{content} = 1 - \frac{1}{N(N-1)}\sum_{i=1}^{N}\sum_{j=1, j\ne i}^{N} E_{ij} \tag{9}$$
即「1 减去簇间平均相似度」——兴趣切得越正交,奖励越高。
2.4.5 多奖励 GRPO 优化¶
四级奖励加权聚合成 response-level 奖励:
$$R_{response} = R_{think} + R_{query} + R_{interest} + R_{global}$$ $$R_{think} = \omega_{think\_format} R_{think\_format} + \omega_{match} R_{match}$$ $$R_{query} = \frac{1}{N*T}\sum_{i=1}^{N*T}(\omega_{length}R^i_{length} + \omega_{value}R^i_{value})$$ $$R_{interest} = \frac{1}{N}\sum_{i=1}^{N}(\omega_{sem}R^i_{sem} + \omega_{style}R^i_{style} + \omega_{format}R^i_{format})$$ $$R_{global} = \omega_{content}R_{content} \tag{10}$$
注意归一化的粒度是层级化的:query 级奖励对 $N \times T$ 条引导词求平均,interest 级奖励对 $N$ 个兴趣簇求平均,global 级只有一项。这样兴趣数 $N$ 变化时不会让某一级奖励的量纲跟着漂移——这是「分层」相对「一把加和」的实质收益。
GRPO 目标函数:
$$\mathcal{J}_{grpo} = E\left[\frac{1}{G}\sum_{i=1}^{G}\min\left(r_i(\theta)A_i, clip(r_i(\theta), 1-\epsilon, 1+\epsilon)A_i\right) - \beta D_{KL}\right]$$ $$r_i(\theta) = \frac{\pi_\theta(o_i|q)}{\pi_{old}(o_i|q)}, \quad A_i = \frac{R_i - mean(\{R_1, ..., R_G\})}{std(\{R_1, ..., R_G\}) + \epsilon} \tag{11}$$
其中 $o_i$ 是第 $i$ 个采样输出序列,$q$ 是模型输入,$\pi_\theta$ 是当前策略,$\pi_{old}$ 是旧策略。
2.5 DPO 阶段:把 think 模式的推理能力蒸馏进 non-think(§4.4)¶
RL 之后模型在兴趣切分准确度与引导词质量上都有实质提升,但线上环境要求高响应,多步推理会显著增加延迟,实际部署希望模型不出显式推理步骤直接给最终答案。
论文报告的关键实验现象:去掉深度推理后生成质量明显退化。归因是训练与推理输出格式不一致造成的条件分布偏移(conditional distribution shift),导致推理性能下降。
DPO 的构造方式:
- 正样本 $y_w$:用 RL 阶段的模型 checkpoint 在 think 模式下生成回答,只保留最终答案、丢弃显式推理轨迹;
- 负样本 $y_l$:直接在 non-think 模式下生成的回答。为增强可区分性,70% 负样本来自 RL 阶段的 checkpoint,30% 来自 base model。
优化目标:
$$\mathcal{J}_{DPO}(\pi_\theta; \pi_{ref}) = -E\left[\log\sigma\left(\beta\log\frac{\pi_\theta(y_w|x)}{\pi_{ref}(y_w|x)} - \beta\log\frac{\pi_\theta(y_l|x)}{\pi_{ref}(y_l|x)}\right)\right] \tag{12}$$
其中 $\pi_\theta$ 是策略模型,$\pi_{ref}$ 是参考模型,$\beta$ 是控制偏离参考模型程度的温度系数。
训练中还观察到正负样本的偏好间隔不够显著,于是加了一个简单的偏好对过滤策略:计算每个正负样本对的语义相似度,剔除最相似的前 30%,以缓解「无效训练(ineffective training)」。离线实验证明该过滤能提升 DPO 效果。
这一段的本质是:用一次偏好对齐把 CoT 的收益「烘焙」进直接解码的行为里,从而在推理时省掉整段 think token。它不是通用意义上的推理能力提升,而是一次针对特定输出格式的行为迁移。
2.6 在线部署:近线生成 + 在线读取(§4.5)¶
为满足线上高吞吐低时延,设计在线与近线两条服务链路:
近线召回(Nearline Recall):近线链路不负责实时生成。模型在用户累积 $N$ 次交互(如点击、收藏)后被调用一次,生成引导词并直接回写进映射表。模型运行在 non-think 模式,直接输出多个兴趣标签及对应引导词。用户历史行为序列随新交互持续更新。
在线召回(Online Recall):构建 user_id → guidance queries 的离线映射表,动态接收近线链路的生成结果。用户进入导购界面时,在线链路用高效向量检索算法定位表中对应索引,取出个性化候选引导词做实时召回。
论文在贡献列表里补充:用户引导词池每日离线更新一次,近线 LLM 推理则根据近期交互动态生成。
这是全文最重要的工程决策:LLM 被完全挡在实时请求路径之外,在线只剩一次向量检索的读表操作。代价是引导词的新鲜度受制于「每 $N$ 次交互触发一次 + 每日全量刷新」的粒度,且近线生成的内容无法条件化于当前请求上下文(比如用户此刻正在看的那个商品)——这条链路生产的是「用户级」制品而非「请求级」制品。
3. 实验设置¶
3.1 数据集¶
数据采样自淘宝与天猫电商平台的多行为用户交互日志,覆盖 2026 年 6 月至 7 月:
| 用途 | 规模 | 说明 |
|---|---|---|
| 短标题微调 | 8,000 | 采自淘宝 item CPV 表 |
| SFT | 5,000 → 11,259 | 高活用户的单日交互记录,经 DeepSeek-V4-Pro 教师拆成多条单兴趣样本 |
| RL | 3,000 | 多兴趣混合序列 |
| DPO | 5,000 → 3,500 | 偏好对过滤后剩余有效样本 |
| 离线测试 | 1,000 | — |
为保证数据隔离,不同阶段的交互数据采自不同时间分区。
3.2 评估指标¶
由于 AIGQ 缺乏通用评估指标,论文从相关性(relevance)与导购价值(shopping guidance value)两个方面评估。
导购价值:直接报告测试集上生成引导词的 S / A / B 评级占比。
相关性:期望生成的 query 能准确匹配用户未来可能交互的商品。对每个测试样本,mask 掉最近交互的 10 个商品作为正样本 $P_i$,从全量商品池随机抽 500 个作为负样本 $N_i$;对每条生成 query $q_i$ 计算与所有样本的语义相似度,检查正样本是否落在 top-k 内,用 Recall@k / NDCG@k 度量。
考虑到用户兴趣复杂多样,抽到的正样本可能与历史行为存在较大兴趣差异,为提升评估可靠性,计算历史 $H_i$ 与正样本 $P_i$ 的语义相似度矩阵 $S_{hp}$,用其平均池化结果作为置信度 $c_i$ 对样本加权:
$$c_i = \frac{1}{L_i M}\sum_{a=1}^{L_i}\sum_{b=1}^{M} S^{(i)}_{hp}(a,b) \tag{13}$$
$$Recall@k = \frac{\sum_{i=1}^{R} c_i \sum_{t=1}^{T}\sum_{j=1}^{M} 1(rank^t_i(j) \le k)}{\sum_{i=1}^{R} c_i \cdot T \cdot M} \tag{14}$$
$$NDCG@k = \frac{\sum_{i=1}^{R} c_i \sum_{t=1}^{T}\frac{DCG^t_i@k}{IDCG@k}}{\sum_{i=1}^{R} c_i \cdot T}$$ $$DCG^t_i@k = \sum_{j=1}^{M}\frac{1(rank^t_i(j)\le k)}{\log_2(rank^t_i(j)+1)}, \quad IDCG@k = \sum_{j=1}^{\min(M,k)}\frac{1}{\log_2(j+1)} \tag{15}$$
其中 $R$ 为测试样本数,$T$ 为每样本生成的 query 数,$L$ 为历史行为数,$M$ 为正样本数,$N$ 为负样本数。
一个必须标注的方法论问题:这套「相关性」指标是在语义编码器空间里用余弦相似度定义的,而 RL 阶段的 $R_{logic}$、$R_{sem}$、$R_{content}$ 三项奖励用的是同一族语义编码器(mge-small)和同一个余弦相似度函数。也就是说,模型被训练去最大化编码器空间里的相似度,然后又被这个编码器空间里的相似度评估。同理,「价值」指标的 S/A/B 占比,用的正是 $R_{value}$ 里那个 judge model。两个离线指标都是训练奖励本身,Table 1/3 的离线提升有相当一部分是构造上保证的,不能作为「模型真的更懂用户」的独立证据。详见 §6.2。
3.3 Baseline¶
两类:(1)zero-shot LLM,包括若干先进模型与同族更大变体,均不做领域适配;(2)LLM4AIGQ 的变体,报告不同训练阶段的 checkpoint,分单兴趣 SFT 分支(ONE)与多兴趣 SFT 分支(MULTI)两条线。
注意:Table 1 里没有传统 Q2AIGQ 判别式管线的任何数据点——论文声称要替代的那套线上系统,从未在离线实验中被测量。
3.4 实现细节¶
- 骨干:Qwen3-30B-A3B,训练于 NVIDIA H20 GPU
- 最大输入/输出长度:8192 / 2048
- SFT:4×H20,500 steps,per-device batch size 2,梯度累积 8,LoRA rank 16,lr 1e-5
- RL:ROLL 框架,16×H20,100 steps,group size 8,lr 1e-6,推理引擎 vLLM
- DPO:LoRA 微调,4×H20,500 steps,梯度累积 4
- 奖励权重:$\omega_{think\_format}=0.5$,$\omega_{match}=2.0$,$\omega_{length}=0.2$,$\omega_{value}=0.8$,$\omega_{sem}=0.5$,$\omega_{style}=0.3$,$\omega_{format}=0.2$,$\omega_{content}=0.5$
- 所有离线实验都在 non-think 模式下、用相同指令设置与相同测试集进行
奖励权重的分配透露了优先级:$\omega_{match}=2.0$ 一枝独秀,是第二高($\omega_{value}=0.8$)的 2.5 倍——兴趣切得对不对,被认为比引导词写得好不好重要得多。
4. 主要实验结果¶
4.1 Table 1:主结果¶
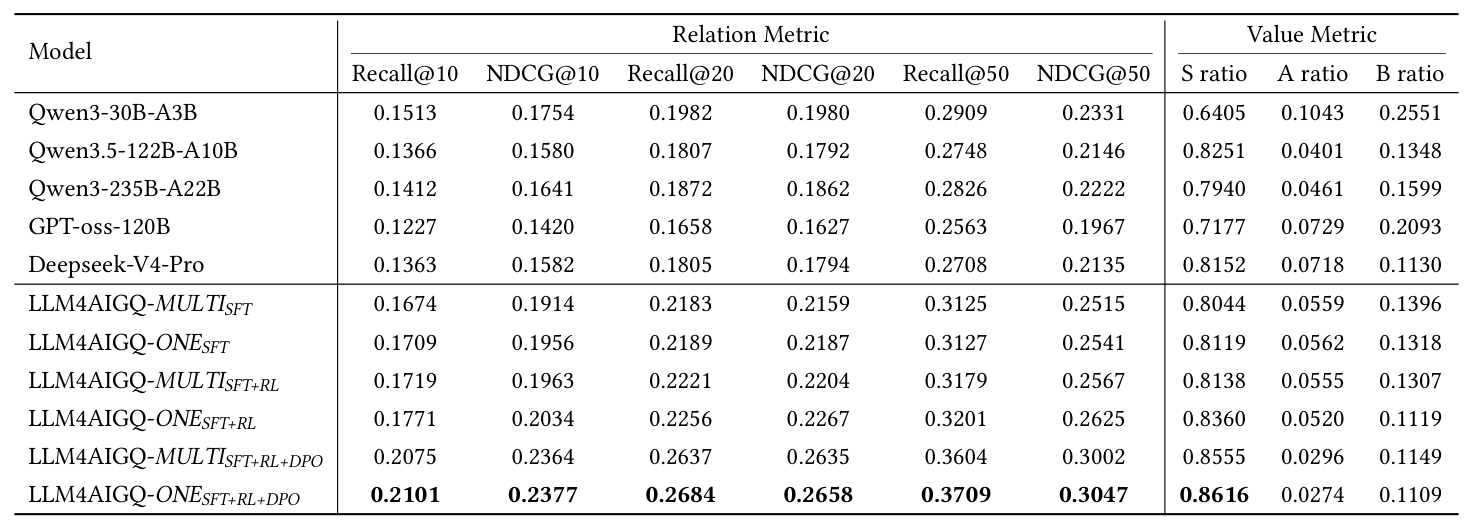
| Model | Recall@10 | NDCG@10 | Recall@20 | NDCG@20 | Recall@50 | NDCG@50 | S ratio | A ratio | B ratio |
|---|---|---|---|---|---|---|---|---|---|
| Qwen3-30B-A3B | 0.1513 | 0.1754 | 0.1982 | 0.1980 | 0.2909 | 0.2331 | 0.6405 | 0.1043 | 0.2551 |
| Qwen3.5-122B-A10B | 0.1366 | 0.1580 | 0.1807 | 0.1792 | 0.2748 | 0.2146 | 0.8251 | 0.0401 | 0.1348 |
| Qwen3-235B-A22B | 0.1412 | 0.1641 | 0.1872 | 0.1862 | 0.2826 | 0.2222 | 0.7940 | 0.0461 | 0.1599 |
| GPT-oss-120B | 0.1227 | 0.1420 | 0.1658 | 0.1627 | 0.2563 | 0.1967 | 0.7177 | 0.0729 | 0.2093 |
| Deepseek-V4-Pro(教师) | 0.1363 | 0.1582 | 0.1805 | 0.1794 | 0.2708 | 0.2135 | 0.8152 | 0.0718 | 0.1130 |
| LLM4AIGQ-MULTISFT | 0.1674 | 0.1914 | 0.2183 | 0.2159 | 0.3125 | 0.2515 | 0.8044 | 0.0559 | 0.1396 |
| LLM4AIGQ-ONESFT | 0.1709 | 0.1956 | 0.2189 | 0.2187 | 0.3127 | 0.2541 | 0.8119 | 0.0562 | 0.1318 |
| LLM4AIGQ-MULTISFT+RL | 0.1719 | 0.1963 | 0.2221 | 0.2204 | 0.3179 | 0.2567 | 0.8138 | 0.0555 | 0.1307 |
| LLM4AIGQ-ONESFT+RL | 0.1771 | 0.2034 | 0.2256 | 0.2267 | 0.3201 | 0.2625 | 0.8360 | 0.0520 | 0.1119 |
| LLM4AIGQ-MULTISFT+RL+DPO | 0.2075 | 0.2364 | 0.2637 | 0.2635 | 0.3604 | 0.3002 | 0.8555 | 0.0296 | 0.1149 |
| LLM4AIGQ-ONESFT+RL+DPO | 0.2101 | 0.2377 | 0.2684 | 0.2658 | 0.3709 | 0.3047 | 0.8616 | 0.0274 | 0.1109 |
论文的三条结论与我的核对:
(1)本方法在相关性与导购价值上都超过 zero-shot SOTA,也超过同族更大模型。 相对 30B 骨干 zero-shot,Recall@10 从 0.1513 → 0.2101(+38.9%),S 占比从 0.6405 → 0.8616(+34.5%)。相对教师 DeepSeek-V4-Pro,Recall@10 +54.1%,S 占比 +5.7%。
一个反直觉现象论文自己指出了:更大的 SOTA 模型在相关性上反而不如 30B 骨干(Qwen3-235B-A22B 的 Recall@10 = 0.1412 < Qwen3-30B-A3B 的 0.1513)。论文解释是大模型倾向生成更新颖(novel)的 query,小模型更依赖高频上下文词;在电商场景这种新颖性更容易滑向幻觉,对导购任务有害。但注意:这个解释同时也暴露了指标的方向——「更贴近历史高频词」在这套编码器相似度指标下天然得分更高,所以「大模型相关性差」有可能只是「大模型输出的词面离历史更远」。价值维度上大模型确实更好(Qwen3.5-122B 的 S 占比 0.8251 vs 30B 的 0.6405),两个指标给出相反排序,这一点论文没有正面处理。
(2)ONE 分支一致优于 MULTI 分支,且优势贯穿后续所有阶段。 ONESFT 0.1709 vs MULTISFT 0.1674;+RL 后 0.1771 vs 0.1719;+DPO 后 0.2101 vs 0.2075。论文归因于混合兴趣场景噪声更高、信息被稀释,模型把精力花在识别主导兴趣而非学习高质量引导词模式上。这个对照设计得干净,是全文最扎实的一组实验。不过差距很小(Recall@10 相对差异 1.3%~3.0%),且没有报告方差或多次实验,结论方向可信但幅度存疑。
(3)每个训练阶段都带来显著提升。 但增益分布很不均:SFT 阶段 Recall@10 +13.0%(0.1513→0.1709),RL 阶段 +3.6%(0.1709→0.1771),DPO 阶段 +18.6%(0.1771→0.2101)。DPO 是三段里贡献最大的一段——这非常反常,因为 DPO 的设计目标只是「把 think 的成果搬到 non-think 格式下」,不应带来最大的能力增益。§6.2 会展开这个疑点。
4.2 Table 2:上下文压缩的效果(§5.3.1)¶
从测试集取 100 个样本,分别用商品短标题与原标题构造用户上下文,线上做压测收集模型响应:
| Ablation | Input Tokens | Output Tokens | TTFT | RT |
|---|---|---|---|---|
| short_title | 2.35k | 146 | 110ms | 2.84s |
| long_title | 3.21k | 153 | 114ms | 3.18s |
短标题让输入 token 平均降 26.8%、响应延迟(RT)降 10.7%,输出 token 也略降。案例分析发现:模型推理引导词的长度与风格会模仿商品标题——标题变短,输出也更简洁。这是一条有实用价值的观察:上下文的文风会直接迁移到输出文风,压缩上下文是一种隐式的输出风格控制手段。
注意 TTFT 只降了 4ms(3.5%)而 RT 降了 340ms(10.7%),说明省下的时间主要来自 prefill 之外的 decode 阶段——与输出 token 数从 153 降到 146 相符。
4.3 Table 3:GRPO 多级奖励与 DPO 数据过滤的消融(§5.3.2–5.3.3)¶
| Model | Recall@10 | NDCG@10 | S ratio |
|---|---|---|---|
| LLM4AIGQ-ONESFT+RL | 0.1771 | 0.2034 | 0.8360 |
| ├ w/o think reward | 0.1696 (−4.2%) | 0.1942 | 0.8332 (−0.3%) |
| ├ w/o query reward | 0.1727 (−2.5%) | 0.1980 | 0.8168 (−2.3%) |
| ├ w/o interest reward | 0.1713 (−3.3%) | 0.1972 | 0.8207 (−1.8%) |
| └ w/o global reward | 0.1744 (−1.5%) | 0.2001 | 0.8195 (−2.0%) |
| LLM4AIGQ-ONESFT+RL+DPO | 0.2101 | 0.2377 | 0.8616 |
| └ w/o pair filter | 0.1959 (−6.8%) | 0.2182 | 0.8426 (−2.2%) |
| LLM4AIGQ-MULTISFT+RL+DPO | 0.2075 | 0.2364 | 0.8555 |
| └ w/o pair filter | 0.1922 (−7.4%) | 0.2127 | 0.8297 (−3.0%) |
逐项分析:
- 去掉 think-level reward:相关性掉幅最大(−4.2%),价值几乎不动(−0.3%)。说明监督推理过程中的兴趣解耦确实帮模型更准确地捕捉多兴趣、生成更贴合意图的 query,而且它只影响「切得对不对」,不影响「写得好不好」——分层设计的目标隔离性得到了验证。
- 去掉 query-level reward:价值掉幅最大(−2.3%),相关性掉幅较小。说明长度约束 + judge 质量评估确实定向作用在合规与导购质量上。
- 去掉 interest-level reward:两个维度都掉。论文解释:缺了语义正确性约束会削弱相关性判断,缺了多样性引导会让同一兴趣簇内的 query 形式同质化,从而降低价值。
- 去掉 global-level reward:不同兴趣的 query 彼此语义相似,进一步伤害整体导购价值(价值 −2.0% > 相关性 −1.5%)。
这组消融的结构是干净的:四项奖励的掉分方向与各自的设计目标一一对应(think→相关性、query→价值、interest→两者、global→价值),不是简单的「都掉一点」。这在多目标奖励设计的论文里不常见,值得肯定。
- 去掉 DPO 偏好对过滤:两条分支上相关性都掉 6.8%~7.4%,是所有消融里掉幅最大的。论文解释:未过滤的正负样本对包含大量语义相似的难分样本,在这种数据上训练让优化过程更不稳定,模型输出更模板化、风格更同质,造成「无效学习」,最终削弱蒸馏效果。
4.4 Table 4:A/B Pairwise 评估(§5.4)¶
为了跳出检索式自动指标,用 Gemini-3.5-Flash 做 LLM-as-Judge 的 pairwise 评估:给定相同用户上下文,让裁判把每个 LLM4AIGQ 变体的 AIGQ 与教师模型 DeepSeek-V4-Pro 的输出对比,考量与用户消费意图/偏好的一致性、导购价值、内容合理性、语言质量。实验采用 A/B 随机化以防位置偏差。
| model | Win Rate | Lose Rate |
|---|---|---|
| base model | 34.63% | 65.37% |
| LLM4AIGQ$_{SFT}$ | 50.25% | 49.75% |
| LLM4AIGQ$_{SFT+RL}$ | 57.53% | 42.47% |
| LLM4AIGQ$_{SFT+RL+DPO}$ | 54.95% | 45.05% |
论文的解读:base 只有 34.63% 胜率,说明领域专用 AIGQ 生成能力差距大;SFT 后升到 50.25%,说明监督学习有效迁移了教师的领域知识与生成模式;RL 后升到 57.53%,学生超过教师,说明收益不只来自模仿教师,还来自兴趣理解、query 质量与内容多样性的优化;DPO 后小幅回落到 54.95% 但仍高于教师,符合 DPO「把推理能力迁移到高效 non-think 推理」而非「进一步提升生成质量」的目标,这个小幅下降反映了推理质量与推理效率的权衡,大部分 RL 习得的能力被保留。
这是全文唯一一个不在奖励回路里的评估指标,也因此最值得信任——而它给出的排序与 Table 1 冲突:Table 4 说 DPO 让质量降低(57.53%→54.95%,相对 −4.5%),Table 1 说 DPO 让 Recall@10 暴涨 18.6%、S 占比涨 3.1%。同一次训练,独立裁判说变差,训练奖励说大幅变好。§6.2 展开。
4.5 线上 A/B(§5.5)¶
在天猫的多个业务场景(导购、搜索、商品详情页)做线上 A/B。论文原文(全节仅三句):
"Experimental results show that introducing AIGQ consistently improves user click performance in the query recommendation pipeline. In the initial 10% traffic experiment, the experimental group achieved a 4.46% improvement in uCTR compared with the baseline bucket. After scaling the traffic to 40%, the overall uCTR still maintained a positive gain of 2.53% over six days of online validation, demonstrating strong generalization capability and online stability under larger-scale deployment."
结论章补充:「本方法已上线部署,在数亿用户规模上取得显著效果」。
5. 核心贡献总结¶
- 中间表示的替换:把导购词生产链路的中间产物从「主搜 query」换成「用户兴趣」,从根上绕开 Q2AIGQ 的信息级联瓶颈。
- SFT–RL–DPO 三段式后训练,三段各有明确分工:SFT 在单兴趣下只学风格、RL 在多兴趣下学切分与生成、DPO 只做 think→non-think 的格式迁移。ONE vs MULTI 的对照实验为「SFT 阶段应当降低任务难度」提供了工业规模的证据。
- 四级分层奖励 + 最优有序匹配算法:在没有 ground truth 的生成任务上,用「教师参考 + 有序匹配 DP + 行为/逻辑双通道相乘」把「兴趣切分对不对」变成一个可计算的稠密奖励。消融显示四级奖励的作用方向可分离。
- 近线生成 + 在线读表的部署形态:LLM 完全退出实时请求路径,在线只剩一次向量检索。
- 上下文压缩的副作用观察:商品短标题不仅省 26.8% 输入 token,还因为「模型模仿上下文文风」而让输出更简洁——一条可复用的工程经验。
6. 与已归档相关工作的对比¶
OneSug OneSug: The Unified End-to-End Generative Framework for E-commerce Query Suggestion(Kuaishou, 2025-06-07)¶
关系:本文未引用(时间上早于本文一年多,属未引用的先行同题工作)· 已加载对方精读
- 共同关注的问题:两者的 root cause 陈述几乎逐字同构——电商 query 生成被多阶段级联架构(MCA)束缚。OneSug 列的三条罪状是「前一阶段的性能决定下一阶段上限 / 各阶段优化目标不一致导致整体次优 / 未见前缀的长尾场景表现差」;本文列的是「信息级联损失导致语义漂移 / 共现关系撑不起多兴趣 / 引导价值低」。两者都把矛头指向级联中间产物的信息瓶颈,并都选择用一个端到端生成模型直接吃原始上下文、直接吐 query 文本。
- 相近的技术骨架:都是「统一生成模型 + 用户行为偏好对齐」两段式。OneSug 是 encoder-decoder 直接 beam search 生成 query,再用 Reward-Weighted Ranking(RWR)——把线上六档行为(Order / Item Click / Click / Show / Not Show / Rand)折成奖励权重 $r = \lambda e^{pi}$,构造九种正负对,用 pair-wise DPO 与 list-wise(S-DPO / Plackett-Luce 风格)混合损失对齐;本文是 decoder LLM 生成,用 GRPO 多级奖励 + DPO 对齐。两者的对齐信号都落在 DPO 家族上。
- 本文的差异与推进:① 输入端的起点不同——OneSug 有用户输入的 prefix 作为锚(prefix2query),本文没有任何 query 输入,纯从 profile + 行为序列冷启,因此本文必须多做一步「多兴趣切分」,OneSug 则把力气花在 PRE 模块(对齐 BGE + 共现 query 增强 + RQ-VAE 语义 ID 由粗到细聚类检索)去消解 prefix 的歧义。② 奖励来源根本不同——OneSug 的奖励来自真实线上行为(订单/点击/曝光六档),本文的奖励来自教师模型参考 + judge model + 语义编码器相似度,全是代理信号,没有一条来自真实点击。这是本文相对 OneSug 的实质退步:OneSug 的偏好数据天然携带业务价值,本文的偏好数据只携带「像不像 DeepSeek 写的」。③ 部署形态不同——OneSug 是在线生成(prefix 必须实时响应),本文是近线生成 + 在线读表。
- 可比的方法/实验差异:OneSug 在快手电商搜索有完整的离线 + 线上对比,且与被替换的多阶段级联系统直接对照;本文的离线表里完全没有传统 Q2AIGQ 管线的数据点,只对比了 zero-shot LLM 与自己的变体。在「证明生成式确实优于判别式级联」这件核心主张上,OneSug 的证据链比本文完整。
RecGPT RecGPT Technical Report(Alibaba 淘天集团, 2025-07-30)¶
关系:本文未引用(同公司同平台的先行系统,时间早于本文 13 个月)· 已加载对方精读
- 共同关注的问题:RecGPT 的核心命题是传统推荐「learn clicks from clicks」——只在拟合历史日志里的共现模式,缺乏对用户意图的显式理解;本文的第二条罪状是「锚点 query 推断被 user–item 共现信号主导,无法建模多样兴趣」。两者指认的 root cause 是同一个:共现拟合无法表达意图。两者也都把解法定位为「让 LLM 显式推理用户想要什么」。
- 相近的技术骨架:骨架抽象重合度极高——(i)长行为序列压缩 →(ii)LLM 离线/近线挖掘多个用户兴趣 →(iii)把兴趣物化成自然语言制品 →(iv)在线用轻量检索消费该制品。RecGPT 的 $\mathcal{LLM}_{UI}$ 做 Generative User Profiling,离线预测人均 16.1 个兴趣、每两周刷新;本文近线每 $N$ 次交互触发一次、至多切三个兴趣、每日刷新引导词池。RecGPT 的行为压缩是「可靠行为抽取(剔除普通点击)+ 层次化压缩(item 级 LLM 压属性 + 序列级时序聚合)」,本文的压缩是「截断最近 50 条 + LLM 压商品短标题」——同一招的轻量版。两者甚至都用了 S/A/B 三级的质量评级(RecGPT-V2 的 Agent-as-a-Judge 是三层 S-A-B,本文的 $R_{value}$ 也是 S/A/B)。
- 本文的差异与推进:① 制品的消费方不同,这是最本质的分歧。RecGPT 的兴趣 tag 是中间制品,用户看不见,靠下游 user-item-tag 三塔检索转化成商品——tag 写歪了还有排序模型兜底;本文的引导词本身就是用户看到并点击的界面元素,没有任何下游模型能修正它。这解释了为什么本文必须在奖励里塞进长度约束、合规约束(涉政涉黄判 B)、文风多样性——制品直接面向用户,质量责任无处转移。② 多奖励冲突的处理方式不同。RecGPT-V2 明确诊断出「四个奖励朴素加和会造成梯度混叠,优化轨迹被简单目标(diversity)主导、牺牲 accuracy」,其解法 Constrained Reward Shaping 把次要奖励做成硬约束门控($R_{total}=R_{acc}\cdot\mathbb{1}[R_{align}\ge\tau]\cdots$,HR@30 从 SUM 的 27.38% 提到 CRS 的 32.60%);本文同样意识到「目标冲突与训练信号稀释」,但解法仍是分层加权求和(式 10),只是把归一化粒度分了层。同集团的前作已经用实验证明加权和这条路会被简单目标主导,本文既没引用也没回应。③ 本文额外做了 think→non-think 的 DPO 蒸馏,RecGPT V1 没有这一层。
- 可比的方法/实验差异:RecGPT V1 在淘宝首页「猜你喜欢」全量部署,报告 CTR +6.33% / IPV +9.47% / DCAU +3.72% / CICD +6.96% / DT +4.82% 五个指标,并给出按商品热度分组的马太效应缓解曲线;本文只报一个 uCTR,无转化、无长尾分布、无多轮时长。同公司同平台,报告完整度差了一个数量级。
OneReason OneReason Technical Report(Kuaishou, 2026-06-04)¶
关系:显式引用但原文未展开对比(仅在 Related Work 与 Rec-R1 / Reason4Rec 并列一句带过「employ RL algorithms such as PPO and GRPO with tailored reward models」)· 已加载对方精读
- 共同关注的问题:两者都在处理推荐/导购场景下 think 模式与 non-think 模式的收益差。OneReason 的出发点是一个反常现象——「thinking 模式在推荐 benchmark 上并未显著优于 non-thinking」;本文的出发点正好是它的镜像——「去掉深度推理后生成质量明显退化」,并把根因归为训练与推理输出格式不一致造成的条件分布偏移。
- 相近的技术骨架:两者都是「GRPO 多奖励后训练 + 把推理收益迁移到 non-think」。OneReason 的 MOPD(on-policy 多教师蒸馏)被明确报告为「think/nonthink 高度同步,大幅增强 non-thinking 的『直觉』」,且 §8.2 的 token-aligned 实验显示在相同 token 预算下用 CoT 数据替换部分 unCoT 数据能提升 non-thinking 性能——这正是本文 DPO 阶段想要的效果。OneReason 的部署侧也是 Fast-Slow 架构:近线跑慢的 OneReason,在线跑快的 OneRec,与本文的「近线生成 + 在线读表」是同一个退守策略。
- 本文的差异与推进:① 立场相反。OneReason 的目标是改造训练让 thinking 永远赢(perception 对齐 + 三层认知 CoT + specialize-then-unify RL),把成本问题完全甩给部署侧;本文接受「线上不可能跑 think」这个前提,用 DPO 做一次性的行为迁移,Table 4 显示这次迁移的代价是相对教师胜率从 57.53% 降到 54.95%。② 正负样本构造更简单也更粗。OneReason 的 RFT 做 off-policy 拒绝采样,只蒸馏「与正确推荐逻辑对齐的 golden 路径」;本文的正样本是「think 模式输出砍掉推理轨迹」,没有任何正确性过滤——如果 think 的答案本身就错,它照样成为正样本。本文唯一的过滤是「剔除语义最相似的前 30% 正负对」,过滤的是可分性而非正确性。OneReason 明确警告 MOPD「缺严格 off-policy 过滤会吸入噪声/无根 CoT」,本文正落在这个警告里。③ OneReason 用 $\Delta$LL 等四维诊断指标验证 CoT 是否真的贡献到最终预测;本文没有任何 CoT 质量诊断,think 是否真在起作用只有 Table 4 一个间接证据。
7. 讨论与局限性¶
7.1 归档谱系:LLM 进不了实时推理路径,各家退守在哪一层¶
把本文放进已归档的同类工作里,会看到一条清晰的谱系:没有一家能让 LLM 待在实时请求路径上,区别只在退守到哪一层、产出什么形态的制品。
| 系统 | 退守层次 | 离线/近线产出的制品 | 在线消费方式 | 制品是否面向用户 |
|---|---|---|---|---|
| CORAL(Meta, 2609.02730) | 控制面 | 每 3 天一版的控制单元配置参数 | 直接作为系统配置生效 | 否(用户完全不可见) |
| AMBER(Meta, 2608.25546) | 特征物化层 | 每个 event 压成 1–2 个连续 Event Token | 作为特征喂进推荐模型 | 否 |
| AIR(港理工/快手, 2606.10357) | 语义制品层 | 原子化的 behavior–intent 对(缓存) | intent-tree 检索 + MHA 融合进排序模型 | 否 |
| RecGPT(阿里, 2507.22879) | 语义制品层 | 自然语言兴趣 tag(人均 16.1 个,双周刷新) | user-item-tag 三塔检索 | 否(tag 不展示,商品才展示) |
| LLM4AIGQ(本文) | 语义制品层,且是最外一层 | 自然语言引导词(每 $N$ 次交互触发,每日刷新池) | user_id → queries 映射表的向量检索 | 是——引导词本身就是被点击的界面元素 |
本文的位置是这条谱系里最靠外的一格:CORAL 退到控制面调参、AMBER 退到特征物化、AIR 和 RecGPT 退到「给下游模型用的语义制品」,而本文的制品跳过了所有下游模型,直接就是用户界面上的一行字。
这个位置带来一个别人没有的性质:没有下游模型可以兜底。AIR 的 intent 向量喂进 CTR 模型后,模型可以学着忽略不靠谱的维度;RecGPT 的 tag 送进三塔后,协同信号还能把语义信号往回拉($\hat{y}_{final}=\beta \hat{y}_{col}+(1-\beta)\hat{y}_{sem}$)。本文没有这层缓冲——LLM 写歪一个字,用户就看到那个字。这解释了本文奖励设计里那些看起来很「产品经理」的项(15 字上限、旗舰店渠道词判 A、涉政涉黄判 B、无信息差判 B):当制品直接暴露给用户,合规与文案质量必须写进奖励函数,因为没有别的地方能管它。这是本文相对该谱系其他工作最值得记住的一条实践差异。
但同一个位置也带来一个别人没有的弱点:制品是用户级的,不是请求级的。AIR / AMBER / RecGPT 的制品在线上还要与当前请求上下文(当前 query、当前浏览商品、当前场景)做一次融合;本文的映射表按 user_id 索引,同一个用户在导购页、搜索页、商品详情页三个场景看到的候选引导词来自同一个池子。而 §5.5 恰恰说 A/B 是在这三个场景同时跑的。请求级个性化的缺失,可能正是下一节要讨论的放量衰减的一个候选解释。
7.2 三个需要独立核实的问题¶
(A)放量后收益衰减近半(+4.46% → +2.53%),论文未作任何解释¶
核实结论:论文完全没有讨论这个衰减。 §5.5 全节只有三句话,把 40% 流量下的 +2.53% 描述为「demonstrating strong generalization capability and online stability under larger-scale deployment」——即把相对衰减 43.3% 的事实包装成了「稳定性」的证据,连衰减本身都没有承认。
这属于该写而未写。常见的三种解释论文一个都没排除:
- 小流量实验的新奇效应(novelty effect)。10% 流量下用户第一次见到 AIGQ,点击里含有大量探索性点击;放量后新鲜感消退。这一条本可以用「10% 桶的逐日 uCTR 曲线」直接证伪或证实,论文没给。
- 竞争性挤出 / 生态位饱和。放量后更多用户被引导进同一批热门 query 与商品,搜索结果页的竞争加剧,边际点击价值下降。本文的 $R_{content}$ 只保证单个用户内部不同兴趣簇的多样性,完全没有跨用户的多样性约束——放大流量后引导词池在全局层面塌缩到少数高频表达,是这个奖励设计的自然后果。
- 大盘稀释 / 桶间干扰。10% 实验组与 90% 对照组共享同一个大盘;放量到 40% 后实验组自身开始改变大盘分布,对照组的基线也在移动,两次实验的分母不可比。
- 时长混淆:论文只说 40% 实验跑了「six days」,没说 10% 实验跑了多久。如果 10% 是短窗口而 40% 是六天窗口,那么两个数字的差异里混着「时间长度」和「流量比例」两个变量,无法归因。
判定:作为存疑点写入局限。 论文既没有解释也没有提供可用于解释的数据(逐日曲线、实验时长、桶大小、置信区间一概没有)。
(B)收益是否来自曝光位增加而非内容质量——坑位/曝光控制完全缺失¶
核实结论:论文没有提供任何坑位或曝光量的控制信息,且对照组的定义在原文里自相矛盾。
- 对照组是什么,原文说不清。§5.5 写的是「introducing AIGQ consistently improves user click performance」——字面读是「引入 AIGQ」,即对照组不展示 AIGQ;但 Fig. 1(a) 和 Introduction 反复说明线上已经存在一套 Q2AIGQ 判别式管线在产出 AIGQ,那么对照组应该是旧管线的 AIGQ。原文只说了 "compared with the baseline bucket",没有一个字定义 baseline bucket 的内容。这两种读法对应的结论截然不同:如果对照组是「什么都不展示」,那 uCTR 的提升里有相当一部分只是「多了一个可点击元素」,与本文方法的质量无关;如果对照组是旧管线,才是干净的方法对比。
- 没有任何曝光/坑位口径的说明:没有 PV / 曝光量、没有引导词展示条数、没有坑位数是否对齐、没有单坑位 CTR。uCTR(人均点击率)恰恰是对曝光量最不敏感的指标之一——多给一个坑位,uCTR 天然会涨。
- 没有任何转化指标。这一点最致命:全文的立论是「引导词要 stimulate user consumption / convey actionable shopping intent / 击中购买痛点」,S 级评级标准也写着「体现决策」,但线上只报 uCTR,没有 CVR、没有订单、没有 GMV、没有 AI 搜索会话的后续深度。对比同组的 RecGPT 报了 CTR / IPV / DCAU / CICD / DT 五个指标,同期的 OneSug 报了完整的线上行为分层——本文这个口径明显偏窄。在「导购价值」这个自我宣称的核心主张上,线上没有一个指标能证实它。
判定:无法排除「收益部分来自曝光位增加」。 论文既没有报告对照组构成,也没有报告曝光/坑位口径,也没有任何转化指标做交叉验证。这是本文最大的实验缺陷。
(C)按「引入新信号 ≠ 收益来源」核验消融¶
消融本身的结构是合格的(见 §4.3):四级奖励逐项 leave-one-out,掉分方向与各自设计目标一一对应,不是无差别下降,说明四个信号确实各自在起作用、没有冗余。DPO 的偏好对过滤也有对照。在「每个引入的组件都非零贡献」这一层,论文过关。
但在「新信号是否就是收益来源」这一层,论文不过关,理由有三:
- 奖励与评估指标循环(最严重)。离线「相关性」用语义编码器余弦相似度定义,而 $R_{logic}$、$R_{sem}$、$R_{content}$ 用的是同一族编码器(mge-small)+ 同一个余弦函数;离线「价值」的 S/A/B 占比,用的就是 $R_{value}$ 里那个 judge model。这意味着 Table 1 与 Table 3 里的两个维度都是训练奖励本身。一个被优化去最大化某个标量的模型,在那个标量上变好是构造保证的,不是发现。想要打破循环,最低要求是换一个未参与训练的编码器复算相关性、换一个独立标注集复算价值——论文都没做。
- 唯一的独立指标给出了相反信号。Table 4 的 Gemini-3.5-Flash pairwise 是全文唯一不在奖励回路里的评估,而它显示 DPO 让质量下降 4.5%(57.53%→54.95%)。同一次 DPO,在奖励回路内的 Recall@10 上涨 18.6%、S 占比上涨 3.1%。一个只负责「把 think 的答案搬进 non-think 格式」的对齐步骤,不应该带来全流程最大的一次能力跃升——+18.6% 这个幅度更像是输出文风向「高频上下文词」偏移带来的编码器相似度红利,而这恰好就是论文自己在解释「大模型相关性反而更差」时给出的机制(大模型爱写新颖词、小模型爱写高频词,后者在这套指标下得分更高)。论文用同一个机制解释了 baseline 的劣势,却没有用它检查自己的增益。
- 没有线上消融,也没有旧管线的离线数据点。线上只有一个 uCTR 数字,无法拆解 SFT / RL / DPO / 上下文压缩各自贡献多少;离线表里完全没有被替代的 Q2AIGQ 判别式管线,所以「生成式优于判别式级联」这个全文最顶层的主张在任何一张表里都没有被直接测量过。
判定:消融证明了「四级奖励各有贡献」,但没有证明「离线增益等于真实质量提升」,更没有证明「线上收益来自本文方法」。
7.3 其他局限¶
- 奖励全部是代理信号,没有一条来自真实用户反馈。$R_{match}$ / $R_{sem}$ 对齐的是 DeepSeek-V4-Pro 的输出,$R_{value}$ 对齐的是人工标注 judge,$R_{content}$ / $R_{style}$ 是纯形式约束。整条链路上没有一个奖励来自线上点击或成交。对照 OneSug 用六档真实线上行为构造奖励权重,本文的偏好数据只携带「像不像教师写的」这一种信息。这也意味着:教师模型的品味构成了本文的性能天花板,而 Table 1 显示 RL 后学生已经在这些指标上超过教师——超过教师之后,奖励还能提供什么方向性信息,论文没有回答。
- 多兴趣数量硬上限为 3,且切分的监督完全来自教师。教师切错了,$R_{match}$ 会把学生也拉过去。论文没有报告教师切分本身的准确率。
- 近线制品是用户级而非请求级(见 §7.1),三个业务场景共用一个候选池,无法条件化于当前上下文。
- 上下文只保留最近 50 条行为,长期兴趣完全依赖 $P_u$ 这一段由 Qwen 总结的文本画像;画像的生成质量、更新频率、以及它与短期序列的冲突处理,全文没有任何说明。
- 方法论可扩展性存疑:这是一个显式多阶段解耦的架构——「离线压缩上下文 → 近线生成制品 → 在线读表」,LLM 与线上点击信号之间隔着两层不可微的边界,无法端到端联合优化。参数量 scaling 时能改善的只是「制品写得更好」,不能改善「制品如何被消费」;而 Table 1 里更大的模型在相关性指标上反而更差,也说明这条路线上单纯堆参数的回报并不明确。
- 写作质量问题:ACM 模板未替换(会议名仍是 "Woodstock, NY"、版权年 2018、DOI 为 XXXXXXX),语义编码器写作 "mge-small"(大概率是 bge-small 的笔误),"LLM4ALGQ" / "LLm" 等拼写错误多处。属 v1 预印本的常见状态,但也侧面反映实验章节(尤其 §5.5)的仓促。
7.4 值得借鉴的设计¶
抛开实验缺陷,有三处工程设计是可迁移的:
- 最优有序匹配 + 行为/逻辑相乘的 $R_{match}$(式 3、4)。在「模型输出的分组数与参考分组数不等」这种常见的结构化生成场景里,用保序 DP 求最优对齐、用 $\log$ 长度项偏向主分组、用乘法门控要求「圈对行为 AND 命名对兴趣」,是一套完整可复用的奖励构造模式。
- 分层归一化的多目标奖励聚合(式 10)。query 级对 $N\times T$ 条平均、interest 级对 $N$ 个簇平均,使得兴趣数变化时各级奖励量纲稳定。虽然它没解决 RecGPT-V2 指出的梯度混叠问题,但至少解决了量纲漂移。
- 上下文文风会迁移到输出文风(§4.2 的案例分析)。把商品标题压短,输出的引导词也跟着变简洁——这意味着输入侧的文本归一化是一种低成本的输出风格控制手段,比在奖励里加长度惩罚更根本。