LLM-Based Re-Ranking for Real Estate Search 精读¶
QuintoAndar(拉美最大住房交易平台,业务覆盖巴西/墨西哥等地的租房与买卖)把 LLM 用作对话式房产搜索的重排器(re-ranker)。核心命题:房产是「高风险、低频、偏好多维且高度定性」的决策场景,用户在对话助手 Concierge 里用自然语言表达的需求(通勤便利、采光、社区调性、"愿意为某个卖点超预算")根本无法被结构化过滤器(Text2Filter)表达;一阶段召回只能保证"名义上满足硬约束",却系统性地错过用户的深层目标。本文不做端到端生成式召回、不重写服务栈,只在重排环节引入一个 point-wise LLM 打分器:对召回出的小候选集(top-20)逐个独立打一个 [0,1] 的 affinity score,喂给 LLM 的输入包括自然语言用户画像、结构化过滤器、房源元数据 + 描述,以及候选集聚合统计量,最后按分数排序取 top-5 呈现。配套构建了一个 96 万 query-item 对的离线评测集(合成 query + 真实生产 query,用 LLM-as-a-Judge 打相关性标签 + 人工校验)。线上 A/B(20 万+ 生产 trace,50/50 分流)取得统计显著的 +5.3% CTR 与 +4.8% 预约看房(scheduled visits),端到端延迟仅增 4.2s、推理成本增 ~7%,证明"异步 point-wise 打分"是工业对话推荐里可落地的一条路。
这是一篇工业实践 / 系统落地报告(RecSys '26),不提出新模型结构,重点在工程做法、prompt 设计、数据构造与线上收益,因此下文按"工程叙事"而非学术公式结构组织。
1. 研究动机与背景¶
1.1 从"过滤菜单"到"多轮对话"的范式迁移¶
LLM 驱动的对话助手正在重塑用户与在线服务的交互方式:人们越来越倾向用开放、增量式的对话表达需求,而非填结构化表单 / faceted search。这对推荐系统影响深远,尤其在用户意图稠密、定性、随时间演化的领域。
房产就是典型:找房是一个高风险、低频的重大决策,偏好横跨生活方式(通勤到公司近、采光好、社区调性)、条件式权衡(愿意为某个特定卖点超预算)、以及在结构化目录里根本没有干净表示的定性属性。这些信号对传统 faceted search 基本不可见——导致系统能列出"满足查询显式约束"却"错过用户底层目标"的房源。
1.2 QuintoAndar 的对话化落地:Concierge¶
在 QuintoAndar,这一对话化转向已经落地为 Concierge——一个多智能体助手,通过自然语言对话处理房源发现、房源问询、预约看房。但作者明确指出:只有当排序阶段能利用对话提供的额外上下文时,自然语言界面才能带来更好的推荐。基于结构化过滤器的召回能产生一个合理的候选集,但它无法区分"名义上匹配同一批约束、却在'与用户更宏观目标的契合度'上差异巨大"的房源。
1.3 为什么选"重排"这一环节¶
对话理解可以注入推荐流水线的多个阶段,但本文聚焦重排(re-ranking),理由是它在生产部署上提供了一个务实的平衡点:
- 只作用于一个小的、低延迟容忍度的候选集(top-20);
- 无缝集成进现有的高吞吐召回基础设施,不需要重写服务栈;
- 能对硬约束、软偏好、相对价值做整体性(holistically)推理。
这个"只改重排、不动召回"的克制选择,是全文的工程主线。
1.4 两条主要贡献¶
- 一个 LLM-based point-wise 重排器:用 LLM 生成的用户画像 + 候选集聚合统计量对候选打分,在严格的生产延迟预算下实现候选间的相对比较。
- 一份综合实证研究:结合"专有离线数据集"上的评测(合成 + 生产 query,用 LLM-as-a-Judge 标注)与"生产 A/B 实验",两者都显示排序质量一致提升。
2. 相关工作¶
2.1 从对话式 RS 到 Agentic RS¶
传统对话推荐系统(Conversational RS)依赖多轮对话显式询问用户偏好、给出解释或处理反馈。早期方法集中在 critique-based(用户给出"更便宜""更靠中心"等 critique)与 slot-filling(用预定义对话路径获取特定属性,常受限于僵化的分类体系)。近来神经架构转向在大语料上、用 RL 训练的模型。尽管如此,传统任务导向 chatbot 与"真正对话式推荐"之间仍有鸿沟,催生了 Agentic RS——LLM 作为自主推理实体,隐式管理对话状态并编排各种工具调用来辅助用户。
作者把 LLM 与推荐流水线的集成归为四类:
- Query Understanding & Expansion:入口处,LLM 弥合用户自然语言与 item 元数据的词表错配,把模糊 query 转成结构化过滤器或扩展语义 query,提升初始召回精度。
- User Profiling & Representation:LLM 作为复杂特征抽取器,把用户历史与多模态行为蒸馏成压缩的隐表示——可以是自然语言的显式用户画像,也可以是从对话轨迹生成的稠密 embedding。
- LLM Re-ranking:两阶段——传统召回器出候选,LLM 作为 ranker 精修 top-k。这使系统能整合复杂用户意图与跨属性推理,超出标准召回函数的能力。
- Agentic Frameworks & Orchestration:更广义的集成,LLM 编排整个流程——决定何时搜索、何时澄清、如何呈现最终推荐。
本文归属 LLM Re-ranking 类,聚焦对话式房产助手中的重排环节。
2.2 LLM-Based 重排¶
用 LLM 做重排能利用其深层语义理解精修一阶段召回出的候选集。不同于强调效率的一阶段召回,LLM 重排聚焦复杂推理与跨属性评估。
- 零样本能力:早期工作评估无需推荐数据训练的 LLM 零样本能力,把任务形式化为"LLM 评估外部模型召回的候选列表"的条件排序问题,识别出三种范式:point-wise / pair-wise / list-wise。虽然 LLM 与传统 IR 排序对齐良好,却对 prompt 中 item 顺序、以及 item 在训练数据里的频率敏感(即位置偏置 / 流行度偏置)。
- 指令微调:为克服零样本局限,近期工作用推荐目标做指令微调对齐 LLM。TALLRec 证明高效微调能弥合通用语言任务与推荐域之间的鸿沟;更专门的方法(如 RecRanker)针对 top-k list-wise 重排引入指令微调,用重要性感知采样与位置平移策略消偏。LLM4Rerank 把不同重排目标(准确性、多样性、公平性)抽象进一个图结构,用 Chain-of-Thought 推理自动平衡这些竞争因子。
本文与这些工作的差异:只用 prompt、零训练,聚焦对话式房产助手,利用对话上下文 + 结构化过滤器 + 房源元数据 + 候选集统计量在生产约束下提升排序质量。
3. 方法:Concierge + LLM 重排器¶
流水线是两阶段架构:召回阶段产出候选房源集合,重排阶段用一个 point-wise LLM 打分函数作用于 query-property 对,对候选集重新排序。
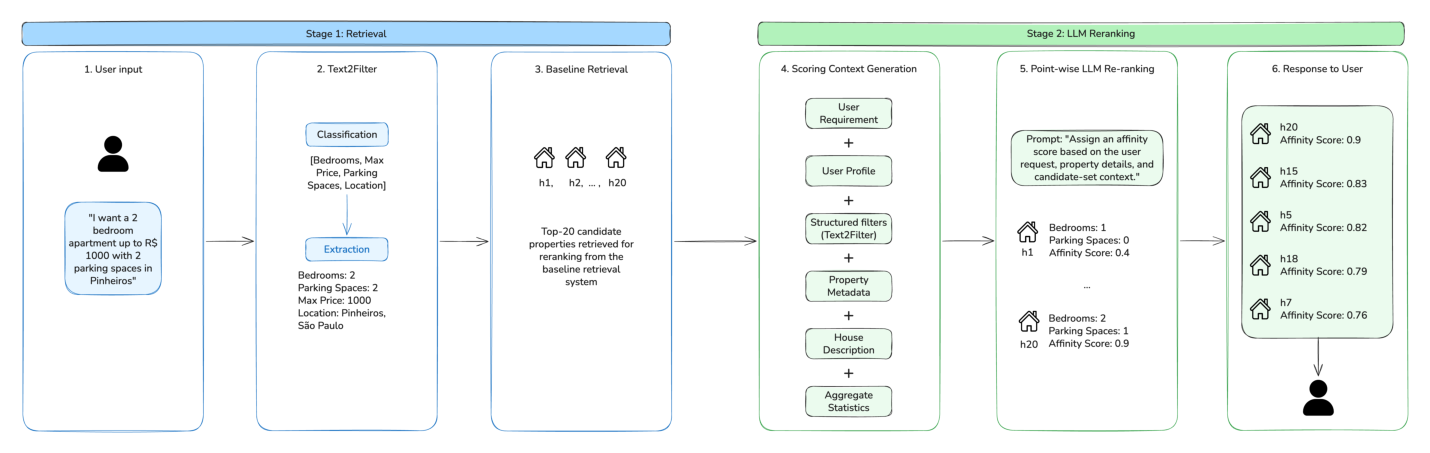
如 Figure 2,整条链路分两大阶段:
- Stage 1 召回:用户输入 → Text2Filter 分类 + 抽取 → 基线召回出 Top-20 候选;
- Stage 2 重排:Scoring Context Generation(拼装用户需求 + 用户画像 + 结构化过滤器 + 房源元数据 + 房源描述 + 聚合统计)→ point-wise LLM 逐个打 affinity score → 按分排序,返回 top-5 给用户。
3.1 对话推荐系统(Concierge)¶
Concierge 是一个对话式、多智能体框架,返回个性化房源推荐,由多个领域专用 agent 构成:
- recommendation agent(房源发现)
- property details agent(拉取具体房源信息)
- visits agent(处理预约看房工作流)
一个 LLM-based planner 作为每次用户交互的入口:它分类用户意图,把请求分派给最合适的领域 agent。
当 planner 把 query 路由到 recommendation agent,请求进入召回流水线。其核心组件是 Text2Filter——把自由文本 query 转成结构化搜索过滤器(支持 location、price range、number of bedrooms 等多种过滤类型)。Text2Filter 实现为一个两阶段 LLM 流水线,基于 GPT-4o (2024-11-20):
- 第一阶段:LLM 识别 query 里存在哪些过滤属性;
- 第二阶段:为每个识别出的属性生成过滤值。 两个阶段都跑在一个预定义 schema 上,确保抽取过滤器的一致性与有效性。
得到的过滤器用于在现有搜索系统里召回并排序候选房源——这个现有系统充当基线召回阶段。为了让对话界面回复简洁易读,只返回 top-5 房源。
3.2 LLM-based 用户搜索画像(User Search Profile)¶
用户搜索画像是用户搜索意图的自然语言表示,由 LLM 从三个互补来源构造:
- 此前生成的画像(若有)——提供跨会话的连续性;
- 与 Concierge 最近的对话——捕获显式表达的需求;
- 从历史 listing 交互衍生的结构化行为文本画像。
行为画像按 location、price、property type、amenities 等关键属性聚合隐式偏好信号,并按重要性给不同交互事件赋不同相关性权重:例如点击视作弱参与信号,而收藏(favorites)与预约看房(scheduled visits)视作更强的用户偏好指标。
冲突消解原则:当各来源信号冲突时,模型优先采信最近的、最显式表达的对话信息。一条核心设计原则是——把行为信号当作软偏好而非硬约束。不是直接把结构化值转成搜索过滤器,而是把它们表达为带不同置信度 / 强度的自然语言偏好。这让画像能有意义地区分"弱行为倾向"与"强而一致的硬性要求"。
文本组件捕获了房产目录里缺失的信息:如生活方式 / 社区调性等定性维度,以及"愿意为某个特定 amenity 超预算"等条件式权衡。这类细腻信号在房产搜索里尤其重要,因为意图往往多维且上下文相关。
最终输出是"用户搜索意图的简洁自然语言摘要 + 一个显式提及的 points of interest 列表"(Figure 1)。通过把隐式行为信号与显式对话线索整合进一个统一的文本表示,画像给重排器提供了富上下文的 grounding,使其能命中"即便当前 query 里没直接体现的、持久或条件式的偏好"。
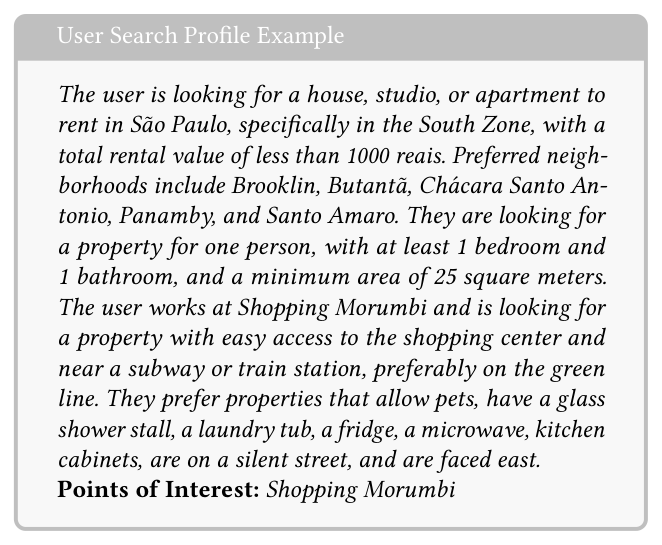
Figure 1 给出一个真实画像样例(圣保罗南区、月租 <1000 reais、1 室 1 卫、≥25㎡、在 Shopping Morumbi 工作、要靠近地铁/绿线火车站、允许养宠、玻璃淋浴隔断、洗衣槽、冰箱、微波炉、橱柜、安静街道、朝东……),并附 Points of Interest: Shopping Morumbi。可见画像把硬约束与大量软偏好用自然语言混排,正是结构化过滤器无法表达的部分。
3.3 LLM-based 重排器¶
重排器精修从召回模型拿到的排序,使之更贴合用户意图。做法是用文本 + 结构化输入 + 跨候选集聚合统计量做 context-aware 打分,LLM 再用 point-wise 策略产出精修后的 top-k 排序。
3.3.1 Point-wise 排序策略(及为何不选 pair/list-wise)¶
在 point-wise 策略下,每个候选房源被独立打一个 affinity score——一个标量,估计该房源与用户意图 / 偏好的契合度。独立打分允许候选并行评估,这对压低重排延迟至关重要。
作者明确讨论了三种范式的取舍:
- list-wise:联合评估整个候选集,能捕获更丰富的候选间依赖,但与生产延迟要求不兼容;
- pair-wise:比较成本随候选数平方增长——例如排 20 个房源需要 190 次成对比较($\binom{20}{2}$);
- point-wise:因此本文采用 point-wise,作为排序质量、可扩展性与延迟之间的务实折中。
(注意:point-wise 的固有弱点是"缺乏候选间信息",本文用 §3.3.2 的候选集聚合统计量来部分弥补——把"这个候选相对整个集合是贵还是便宜、是否异常齐全"喂给 LLM。)
3.3.2 打分上下文构造(Scoring Context Construction)¶
对每个请求,构造一个打分上下文,由以下输入拼装:
- User requirement(用户需求):自由文本请求,捕获主要意图、偏好、以及结构化字段无法表示的定性需求。
- Textual user profile(文本用户画像):§3.2 的 LLM 生成历史交互摘要,提供额外个性化上下文(重复行为模式、生活方式偏好、当前 query 未显式表达的隐式兴趣)。
- Structured filters(结构化过滤器):来自 Text2Filter 的归一化约束(location、price range、room requirements),帮模型区分硬性合格标准与软偏好。
- Property metadata(房源元数据):候选级信息——amenities、installations、房产属性、以及房源描述(house descriptions),作为"该房源是否满足用户显式与隐式偏好"的判据。
- Candidate-set statistics(候选集统计量):在整个候选集上计算的聚合摘要——price range、中位数、房间数分布、房型分布、amenity 普及率——为 point-wise 打分提供上下文基线。因为每个房源被独立评估,这些统计量让模型能判断某候选是否相对偏贵、异常齐全、或在检索集中很突出,从而改善候选间的打分一致性。
3.3.3 Affinity 打分与排序¶
每个候选由 LLM 打一个 [0,1] 的 affinity score,反映其与用户意图的对齐度。打分 prompt 考虑三个互补维度:硬约束满足度、显式+隐式用户偏好对齐度、在候选集内的相对价值。这个形式把"结构化约束检查"与"对权衡和隐式偏好的语义推理"结合起来。
形式化:给定用户 query $q$ 与候选房源 $p_i$,LLM 打分为
$$s_i = f_{\mathrm{LLM}}(q, p_i, u, c) \tag{1}$$
其中 $u$ 表示文本用户画像,$c$ 表示上下文候选集聚合统计量。结果分数 $s_i \in [0,1]$ 估计房源与用户意图 / 偏好的契合度。
最终排序由按 affinity 分数降序排序候选得到:
$$R = \mathrm{sort}(P, s) \tag{2}$$
其中 $P$ 是召回候选集,$R$ 是最终重排结果。
关键工程细节:affinity 分数在所有候选上异步(asynchronously)计算;房源按分数降序排序,平分时用一阶段召回原始分数打破平局;生产系统里只把 top-k(k=5) 呈现给用户。异步计算是延迟可控的关键——point-wise 天然并行,这也是选它的重要工程理由。
3.3.4 打分 prompt 设计¶
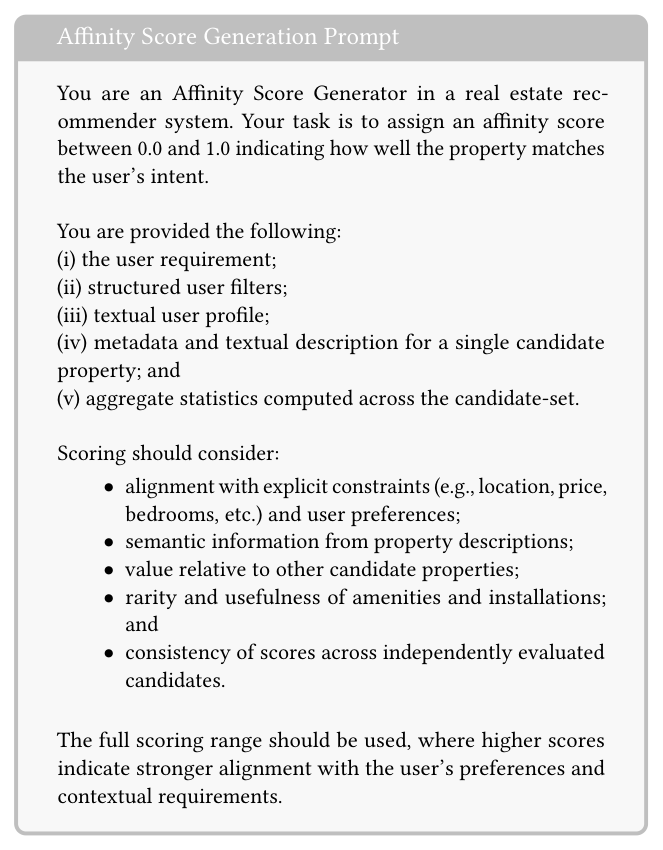
Figure 3 给出简化版的 affinity 打分 prompt。它把 LLM 设定为"房产推荐系统里的 Affinity Score Generator",任务是给出 0.0-1.0 的 affinity 分数。提供给它的输入有五项:(i) 用户需求;(ii) 结构化过滤器;(iii) 文本用户画像;(iv) 单个候选房源的元数据与文本描述;(v) 跨候选集计算的聚合统计量。打分需综合考虑:
- 与显式约束(location、price、bedrooms 等)及用户偏好的对齐;
- 房源描述里的语义信息;
- 相对其它候选的价值(value for money);
- amenities / installations 的稀有度与有用性;
- 跨独立评估候选的分数一致性(consistency of scores)。
prompt 明确要求"用满整个打分区间,分数越高代表与用户偏好和上下文要求越吻合"——即鼓励 LLM 拉开分差,避免 point-wise 打分挤在一起。
4. 评测¶
沿两条互补轴评测:(1) 离线——在带标签的搜索数据集上做受控对比与消融;(2) 在线——生产 A/B 测量对真实用户交互的影响。离线设置里,clicks 和下游参与度作为用户满意度的代理。
4.1 离线搜索数据集构造¶
为支持稳健、可扩展的评测,构造了一个大规模、领域专用的离线数据集,把合成 query 生成与真实生产 query结合,用 LLM-as-a-Judge 框架做可扩展相关性标注 + 人工校验。整个数据构造流水线四个阶段(Figure 4):
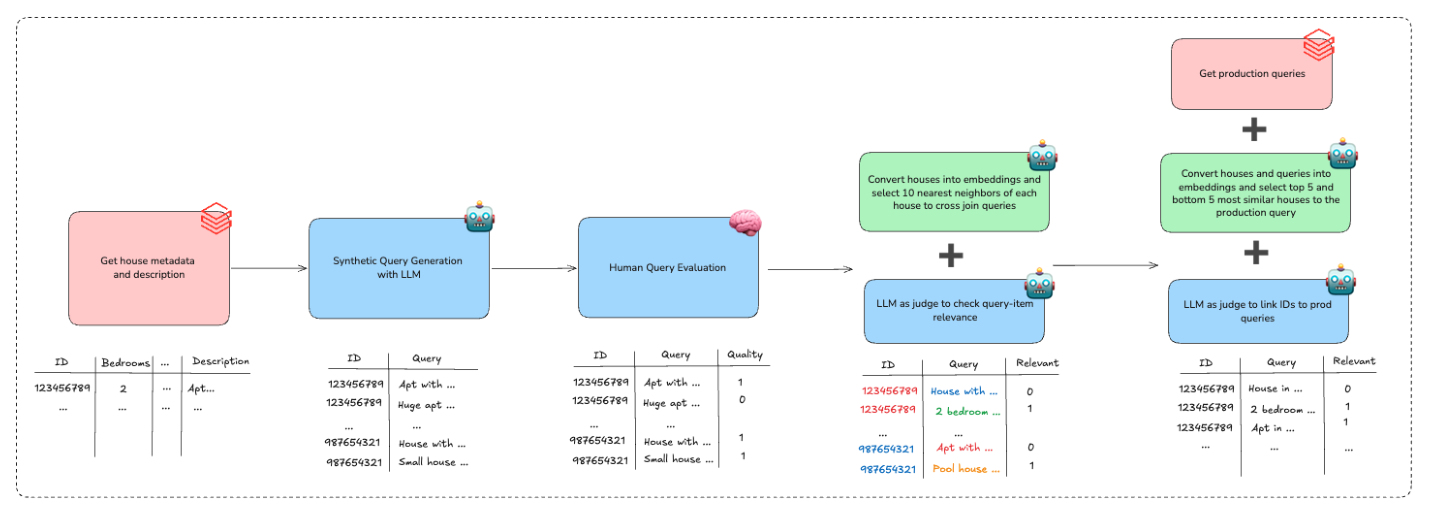
4.1.1 数据选取与合成 query 生成 从 QuintoAndar 库存里随机采样 10,000 条 active 房源。结构化字段提供核心属性信号,描述文本补充"离 point-of-interest 的距离、定性社区特征"等互补信息。合成 query 用 Gemini 3.1 Flash Lite 生成,把每条 listing 当锚 item。定义了六种 query 类型的分类体系,以覆盖多样搜索行为: (i) explicit attribute queries;(ii) trade-off formulations(权衡表述);(iii) high-complexity constraint queries;(iv) conversational queries;(v) lifestyle and amenity driven queries;(vi) persona-based scenarios。 每类每房源生成一条 query,共 60,000 条合成 query。这个分类体系系统性覆盖了"多约束、persona 驱动"等在生产日志里稀疏、但对评测高级召回系统至关重要的模式。
query 质量校验:在 1,000 个 query-property 对的随机样本上做人工评估,标注员给二值相关性标签,结果与 LLM 生成标签有 94% 一致性,表明合成质量高。
4.1.2 候选召回与硬负样本生成 对每个锚房源,召回语义相似候选,以引入硬负样本(而非平凡随机负样本)。鉴于场景跨语言(英文结构化元数据 + 葡萄牙语描述),把两种字段类型拼接后用 intfloat/multilingual-e5-base 算稠密 embedding(在召回性能与算力间取平衡)。embedding 用 FAISS 在内积相似度度量下索引。对每个锚召回 top-k 最近邻(k=10),把数据集从 60,000 扩展到 600,000 query-property 对,同时保持 LLM 标注可行。
4.1.3 LLM-as-a-Judge 相关性标注 二值相关性标签用 Claude Sonnet 4 配一个结构化 prompt 策略打:模型被指示 (i) 识别 query 里表达的所有约束;(ii) 核验它们在候选 listing 里是否存在;(iii) 对 location、price 等关键属性的 mismatch 应用拒绝准则。在 1,000 对样本上做的另一次人工评估,与 LLM 判断有 96% 一致性,支撑用 LLM-as-a-Judge 作为可扩展标注方案。
4.1.4 生产 query 集成 为用真实用户行为补充合成数据,从生产日志采样 30,000 条唯一 query 纳入数据集。对每条 query,用 Stage 2 相同的 embedding 模型与 FAISS 配置召回候选。为保证难度多样,候选池由"top-5 最相似(likely 正例与硬负)"+"bottom-5 最不相似(易负)"组合而成,覆盖广谱难度。相关性标注同样用 LLM-as-a-Judge。
4.1.5 数据集摘要 最终数据集含 960,000 query-item 对。每对由一个用户 query 和一个候选房源(其 identifier、结构化元数据、非结构化描述、二值相关性标签)组成。相关性分布为 33% 正例 / 67% 负例,构成一个中度不平衡设置,增加准确排序的难度。
4.2 实验变体¶
所有变体都从 §3.3.3 的 affinity 打分 prompt 派生。先评"无 LLM 重排的基线召回",再增量式引入各组件测其单独贡献:
- Baseline (B):现有召回系统。
- Base Re-ranker (BR):引入 point-wise LLM 重排阶段,用结构化房源元数据 + 用户 query 信息。
- Aggregated Statistics (AS):加入候选集统计量(price ranges、房间分布、amenity 普及率),为 point-wise 打分提供上下文 grounding。
- Scoring Rules (SR):加入显式打分校准指令,鼓励全局一致的 affinity 分数。
- House Description (HD):加入非结构化房源描述文本,评估更丰富语义属性上下文的贡献。
- Textual User Profile (TUP):加入 LLM 生成的历史偏好文本表示,评估个性化信号的效果。
4.3 离线评测结果¶
表 1:不同 prompt 形式与输入配置下的离线排序性能
| Configuration | Recall@5 | nDCG@5 |
|---|---|---|
| B + BR + AS + HD + TUP | 0.814* | 0.889* |
| B + BR + AS + HD | 0.797 | 0.865* |
| B + BR + AS + SR | 0.784 | 0.848* |
| B + BR + AS | 0.790 | 0.857* |
| B + BR | 0.784 | 0.850* |
| B | 0.766 | 0.770 |
* 表示相对基线配置统计显著($p < 0.05$)。粗体为最佳,下划线为次佳。
结果分析(逐条 why,而非仅 what):
- LLM 重排大幅提升排序质量,且所有指标一致。最强提升在 nDCG,说明重排器尤其擅长把相关房源的排序推到列表顶部。仅 Base Re-ranker(B+BR)相对基线召回就把 nDCG@5 提升 10.4% 相对值(0.770→0.850)。且所有重排配置在 nDCG@5 上都相对基线统计显著。
- 候选集聚合统计量(AS)带来一致增益:nDCG@5 相对无统计量的匹配配置 +0.8%(0.850→0.857)。说明候选级上下文帮模型在 point-wise 打分里比较相对价值、稀有度与权衡——正好补齐 point-wise "看不到别的候选"的短板。
- 显式打分规则(SR)反而轻微掉点:nDCG@5 相对无 SR 的对应配置 降 1.1%(AS 的 0.857 vs AS+SR 的 0.848)。说明僵化的分数校准指令可能削弱模型在 point-wise 设置里做细腻语义排序决策的能力——过度约束反噬。这是一个反直觉但重要的踩坑发现。
- 房源描述(HD)正向贡献:nDCG@5 相对无描述的对应配置 +0.9%(0.857→0.865)。说明自由文本描述提供了结构化元数据之外的重要语义信号,尤其对生活方式导向、定性 query。
- 文本用户画像(TUP)贡献最大的整体提升:最佳配置(AS+HD+TUP)相对无 TUP 的最强配置,nDCG@5 +2.8%、Recall@5 +2.1%(0.865→0.889,0.797→0.814)。说明把富语义房产上下文与历史偏好表示结合,能为"语义相似房源的排序"提供更强的个性化信号。
HD 贡献的定性示例(Figure 5):
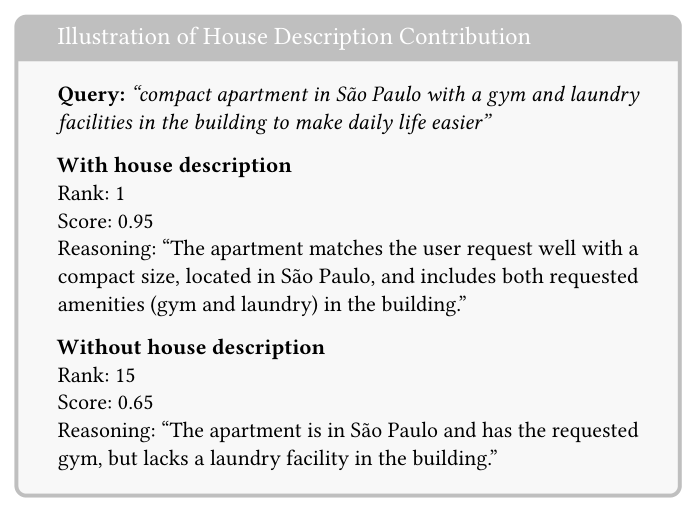
Query:"compact apartment in São Paulo with a gym and laundry facilities in the building to make daily life easier"。有房源描述时:Rank 1,Score 0.95,理由"公寓很好地匹配了用户请求——紧凑、位于圣保罗、且楼内同时有健身房和洗衣设施"。无房源描述时:Rank 15,Score 0.65,理由"公寓在圣保罗、有健身房,但缺洗衣设施"。可见描述文本让 LLM 捕获到"楼内洗衣"这一只在描述里出现、结构化字段缺失的关键卖点,直接把排名从 15 拉到 1。
部署版本说明:次佳配置(排除 TUP)对应 §4.4 在线 A/B 中部署的版本——因为部署时文本用户画像已用于离线评测、但尚未接入生产服务流水线。也就是说线上收益是在"没上 TUP、上了 AS+HD"的配置下取得的,离线还显示 TUP 有额外 headroom。
4.4 在线 A/B 测试¶
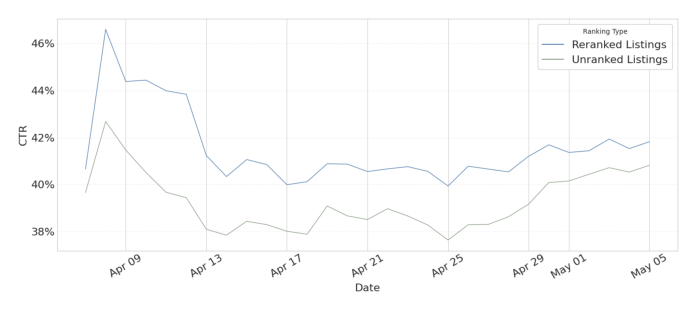
重排器在一个随机 A/B 实验里部署,时间 2026-04-07 至 2026-05-08。用户随机 50/50 分到 treatment / control 组。实验含 200,000+ 生产推荐 trace(真实用户与 Concierge 的交互)。treatment 组收到 LLM 重排结果,control 组收到基线召回排序。关键指标:Click-Through-Rate (CTR) 与通过对话系统产生的 scheduled visits(预约看房)。
在线结果:
- LLM 重排在整个评测期一致优于召回基线,取得统计显著的 +5.3% 相对 CTR 提升(Figure 6,Reranked 曲线整体在 Unranked 之上)。
- 影响不止于点击:treatment 组在"通过对话系统产生的预约看房"上取得统计显著 +4.8% 提升。这说明更好的排序质量转化成了更有意义的用户行动(真去看房),而不只是更高的表层参与度。
延迟与成本(工程可行性关键):从系统视角,线上部署验证了 point-wise 架构的实用性。尽管多了一个 LLM 推理阶段,系统在整个实验期维持稳定的生产延迟,仍在对话平台的操作响应时间约束内。相对召回基线,端到端响应延迟平均增加 4.2s,推理成本增加约 +7%。作者判断这些开销"在可接受生产限度内,被观察到的用户参与度与预约看房改善所抵消"。
4.5 LLM-as-a-Judge 评估¶
除 A/B 外,还用 LLM-as-a-Judge 在采样生产 trace 上评估排序质量。对每条 trace,把召回模型与重排列表各自的 top-5 房源以匿名、去可识别信息的形式呈现给 judge,让它选哪个排序更满足用户意图。
评测被形式化为成对偏好任务(pairwise preference)而非绝对打分——这个设计规避了分数校准问题,让 judge 专注于比较性排序质量。judge 被指示优先考虑 location、budget、number of bedrooms 等硬约束,同时兼顾软偏好、语义相关性、value-for-money 权衡。为更贴近真实推荐行为,允许"轻微违反约束但整体性价比显著更好"的房源仍被偏好。
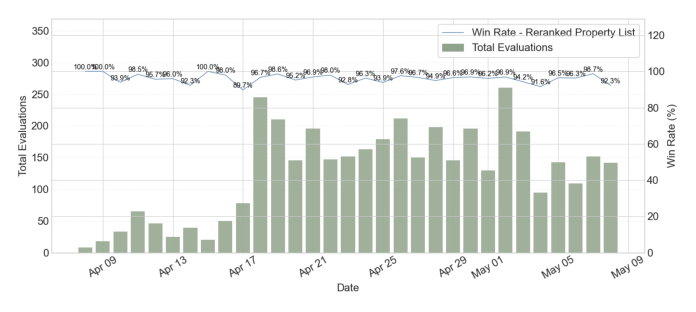
结果:在 3,944 条采样 trace上,judge 在 95% 的评测案例里偏好重排后的房源列表(相对基线召回排序)。Figure 7 显示评测期内的每日 win rate 与评测量。对 judge rationale 的定性检查显示,重排器更有效地优先了:
- 满足显式用户约束的房源;
- 更强 value-for-money 权衡的房源;
- 语义相关的生活方式与 amenity 偏好;
- 排序列表里更高质量的房源。
judge 解释还揭示:重排器频繁改善了语义模糊 / 边界候选的排序,同时保留了召回系统识别出的最强匹配。这与离线指标观察到的排序质量提升一致。
5. 核心贡献总结¶
- 在真实对话式房产平台落地了一个 zero-training、prompt-only 的 point-wise LLM 重排器,只改重排、不动召回栈,就在线上拿到 +5.3% CTR / +4.8% 预约看房,且延迟与成本增量可控(+4.2s / +7%)。证明"异步 point-wise 打分"是工业对话推荐里可落地的路径。
- 把 point-wise 的固有短板(看不到其它候选)用候选集聚合统计量补齐——这是本文最值得借鉴的工程巧思:既保住并行/低延迟,又给 LLM 提供"相对贵/相对齐全"的横向上下文。
- 一份可复用的数据构造方法论:合成 query(六类分类体系 + Gemini 3.1 Flash Lite)+ 硬负样本(multilingual-e5 + FAISS)+ LLM-as-a-Judge 标注(Claude Sonnet 4,人工一致性 94%/96%)+ 生产 query 混入,产出 96 万对离线评测集。
- 一批反直觉的踩坑发现:僵化的显式打分规则(SR)反而掉点;文本用户画像(TUP)离线增益最大但线上还没接。
6. 与已归档相关工作的对比¶
GR2 GR2: Generative Reasoning Re-Ranker (Meta AI, 2026-06-30)¶
关系:独立并发(本文未引用 GR2,两者殊途同归地攻击"工业重排环节没吃到 LLM 红利"这同一 root cause)· 已加载对方精读
- 共同关注的问题:两篇都把矛头精确指向工业推荐漏斗里离用户最近、对参与度影响最大的 re-ranking 环节,指出它至今仍在用 point-wise CTR 打分、对用户意图与 item 语义不做任何显式推理。GR2 明确称之为"被 LLM 忽视的最后一公里",QuintoAndar 则表述为"结构化过滤器无法表达对话里的多维定性意图"。root cause 同构。
- 相近的技术骨架:都是"传统召回出候选 → LLM 在小候选集上做语义重排"的两阶段范式,都用语义信息 + item 元数据让 LLM 对候选做整体推理,都在工业真实流量上跑 A/B 拿到 CTR/参与度提升。
- 本文的差异与推进:方法复杂度是两个极端。GR2 是重装路线——SID mid-training(≥99% uniqueness 解决词表错配)+ teacher 推理链蒸馏 + 可验证奖励 RL(DAPO)+ On-Policy Distillation + 推理内化,一整套训练机器,拿到 +18.7% R@1、~15× serving ROI。QuintoAndar 是轻装路线——完全 zero-training、纯 prompt,靠"自然语言用户画像 + 候选集聚合统计量"喂 point-wise LLM,拿到 +5.3% CTR。QuintoAndar 用候选集统计量在 prompt 侧廉价补齐 point-wise 的横向盲区,而 GR2 用 list-wise 风格的 CoT 推理直接建模候选间依赖。
- 可比的方法 / 实验差异:一个共同踩坑值得对照——GR2 花大力气对付 reward hacking(模型靠"保持输入顺序"或"利用位置偏置"刷奖励),QuintoAndar 则发现"僵化的显式打分规则(SR)反而掉 1.1% nDCG"。两者都指向同一底层现象:过度约束 / 错误校准 LLM 的排序打分行为会反噬排序质量,只是 GR2 在 RL 奖励侧、QuintoAndar 在 prompt 指令侧各自撞到。GR2 是"如何把 LLM 推理能力最大化榨进重排"的天花板参考,QuintoAndar 是"用最小工程代价把 LLM 塞进重排并证明 ROI"的地板参考——两篇合读能框定这条赛道的上下界。
被剔除的近似候选(防止门槛放水):
- RAR_GPT RAR (UIUC):同样是"对话推荐 + 检索-生成不对齐",问题层有交集;但它是学术电影 CRS,解法是用 RL(Plackett-Luce / DPO)训练 retriever 对齐检索与生成,而非工业房产的 zero-training point-wise 重排。解法骨架实质偏离(training-based RL 对齐 vs prompt-only 打分),剔除。
- DebiasFirst DebiasFirst (Amsterdam):聚焦 list-wise LLM 重排的位置偏置,用 IPS 校准 + 位置感知数据增强在微调阶段消偏。虽同属"LLM 重排"大类,但它是 list-wise + 训练侧消偏的方法论,与本文 point-wise + 零训练的工业落地叙事不同构,剔除。
- ReRec ReRec (PolyU):reasoning-augmented LLM 推荐助手,用 RFT(dual-graph reward shaping + reasoning-aware advantage) 做复杂 query 推理排序。问题层(自然语言复杂 query → 个性化排序)有相似性,但解法是 RL 训练 + 奖励塑形,与本文纯 prompt 工程落地路径差异大,剔除。
7. 讨论与局限性¶
核心贡献与借鉴价值:
- 本文的最大价值不在方法新颖性(LLM-as-reranker + LLM-as-Judge 都是已有范式),而在工程克制与落地证据:用最小侵入的方式(只改重排、零训练、纯 prompt)在真实拉美房产平台拿到统计显著的线上收益,并诚实报告延迟/成本代价。对任何想把 LLM 塞进现有推荐栈的团队,这是一份"低风险起步"的实操模板。
- 候选集聚合统计量补齐 point-wise 盲区是最可迁移的设计点——它让团队在不牺牲并行/延迟的前提下,给 LLM 注入横向候选上下文。
- 成对偏好式 LLM-as-a-Judge(而非绝对打分)规避分数校准问题,是一个干净的离线评测设计,可直接复用。
局限与争议:
- 方法新颖性有限:架构本身较标准,本质是"prompt 工程 + 数据工程",DAG 层面不注册新模型节点(论文不提出可检索命名的新模型/系统)。
- 延迟代价不小:+4.2s 的端到端延迟对某些交互场景可能偏高,本文靠"对话式界面对延迟容忍度高"来消化;换到低延迟 feed 场景未必成立。
- TUP 尚未上线:离线增益最大的文本用户画像组件在 A/B 时还没接进生产,线上收益因此低估了个性化的潜力;反过来说线上稳定性也未在 TUP 下验证。
- 评测依赖 LLM-as-a-Judge:虽有 94%/96% 人工一致性背书,但 judge 与打分器可能共享同源偏置(都是 LLM),offline nDCG 与 judge win rate 之间存在潜在循环论证风险。
- 合成 query 主导离线集:96 万对里 60 万来自合成扩展(每锚 top-10 近邻),真实生产 query 仅 3 万条唯一 query,分布可能偏离真实用户 query 的长尾。
未来工作:作者提出探索更深的 agentic 集成——召回、排序、后续交互基于更宏观的对话状态联合优化;A/B 测试把 LLM-based 用户画像(TUP)作为个性化信号加入;让助手在意图模糊时主动提澄清问题、随对话轮次动态调整候选集、纳入 clicks/saved/visits 等下游反馈;以及在候选集较小或 query 需更细腻权衡分析时,研究混合 point-wise + list-wise 策略——既保住独立打分的延迟优势,又在小候选集上补充候选间推理。
AI Usage Disclosure(原文 §7):作者使用 AI 辅助工具做语法纠错与轻微文字润色,所有科学内容、结论与主张由作者负责。