ESP:面向动态多目标召回的 Embedding 子空间切分¶
LinkedIn(Mountain View),RecSys '26(Minneapolis),arXiv 2609.30601v1,2026-09-24。作者 16 人,一作 Shaobo Zhang,末位 Wenjing Zhang;Yuchin Juan、Jianqiang Shen、Luke Simon 等同时是 LinkedIn GPU 穷举 KNN 召回系统论文 [12] 的作者。
研究动机与背景¶
工业召回器从来不只服务一种"相关性"¶
论文以 LinkedIn 职位匹配平台开篇:第一阶段召回要产出一个候选集,同时覆盖会员与职位的语义契合度(semantic fit)、会员的 engagement 预测、以及市场侧的 revenue 目标。电商搜索(语义相关 vs 品牌/属性匹配)、信息流(主题相关 vs 新鲜度/多样性)也有同类 trade-off。
主流的大规模召回是 bi-encoder:每个 item 投影到一个整体的 $d$ 维 embedding,相关性用一个标量点积度量,这正是 ANN 索引与低延迟服务可行的前提。但在多目标场景下,它带来一个硬限制:所有信号都必须塞进同一套几何结构。工业界的两种常见应对:
- (a) 用加权多目标损失训一个 embedding(Uni-Retriever、淘宝 EBR 等),trade-off 被固化在训练里,业务优先级一变就要重训;
- (b) 每个目标一套独立召回栈、下游合并,基础设施随目标数线性碎片化。
作者把这称作 no-knob problem:单 embedding bi-encoder 没有给运营留一个"在语义契合与 revenue 之间拧动"的旋钮。
作者的核心论点:瓶颈是架构性的,不是优化器侧的¶
论文主张这是表征容量问题而非优化问题:借用 Weller et al. 对 bi-encoder 的容量界(本库已归档的 LIMIT,LIMIT),作者在第 3 节论证在目标冲突时共享 embedding 的每目标容量会随冲突个数与冲突强度退化;PCGrad 这类梯度手术能缓解但不能消除,因为瓶颈在表征层面。
为什么"多头"在召回里比在排序里难¶
排序模型里多头(multi-head)很常见,但搬到第一阶段召回就不同:IVFPQ 等标准 ANN 索引对文档做聚类并用残差量化近似距离,预设 embedding 是一个几何上自洽的对象;而 $k$ 个子空间向量的拼接只是"独立 embedding 粘在一起",没有单一的邻域结构可供聚类。退而求其次建 $k$ 个独立 ANN 索引,又回到基础设施线性膨胀。ESP 的解法是 GPU 加速的穷举 KNN(LinkedIn 自家 [12]):一个模型–硬件协同设计,在一个拼接索引上做暴力扫描打分,权重从请求侧注入成为服务期旋钮。
论文称该方法已在 LinkedIn 职位匹配上线两年,服务 7000 万+ 周活用户;7 天 A/B 中"只重调服务期权重、同一个训练好的模型"带来 +4.0% revenue、+3.95% 职位申请、−8.95% no-fit rate。注意这句话的措辞——对照组的性质在后文是关键问题。
几何分析:多目标 embedding 的容量界¶
问题形式化¶
定义 1(多目标 bi-encoder 召回):给定 query 集合 $\mathcal{Q}$、文档集合 $\mathcal{D}$、以及 $k$ 个相关性矩阵 $R_1, \ldots, R_k \in \mathbb{R}^{|\mathcal{Q}| \times |\mathcal{D}|}$,求编码器 $f: \mathcal{Q} \to \mathbb{R}^d$ 与 $g: \mathcal{D} \to \mathbb{R}^d$,使得 $S = f(\mathcal{Q})\, g(\mathcal{D})^\top$ 在相对 Frobenius 误差 $\delta$ 内逼近每个 $R_i$:
$$\|S - R_i\|_F \le \delta \|R_i\|_F, \quad \forall i \in [k] \tag{1}$$
由于 $\text{rank}(S) \le d$,根本约束变成:最小的 $d$ 是多少,才能让一个秩 $d$ 矩阵同时 $\delta$-逼近所有 $k$ 个目标的主导子空间。
子空间冲突¶
对每个 $R_i = U_i \Sigma_i V_i^\top$,定义 $\delta$-有效右子空间 $V_i^\delta \subseteq \mathbb{R}^{|\mathcal{D}|}$ 为捕获 $1-\delta^2$ 平方 Frobenius 范数所需的最少右奇异向量张成的空间,$r_i = \dim V_i^\delta$ 为目标 $i$ 的 $\delta$-有效秩。
定义 2(子空间冲突):
$$\varepsilon_{ij} := 1 - \frac{\|P_{V_i^\delta} P_{V_j^\delta}\|_F^2}{\min(r_i, r_j)} \tag{2}$$
其中 $P_V$ 为到 $V$ 的正交投影,$\|P_{V_i^\delta} P_{V_j^\delta}\|_F^2 = \sum_l \cos^2\theta_l$ 是两子空间主角(principal angles)余弦平方和。于是 $\varepsilon_{ij} \in [0,1]$:一个子空间包含于另一个时为 0(完全对齐),正交时为 1。作者强调这是数据几何的内禀属性,与优化器和损失无关。
定理 3:共享 embedding 的容量下界¶
任何满足式 (1) 的秩 $d$ 得分矩阵 $S$ 必须满足
$$d \ge \dim\Big(\sum_{i=1}^{k} V_i^\delta\Big) \tag{3}$$
在对称模型 $r_i = r$、$\varepsilon_{ij} = \varepsilon$ 下化简为
$$d \ge r \cdot \big(1 + (k-1)\varepsilon\big) \cdot \big(1 - O(\delta)\big) \tag{4}$$
等价地,固定预算 $d$ 时能被联合保留的每目标有效秩上界为
$$r_{\text{eff}}(d, k, \varepsilon) \le \frac{d}{1 + (k-1)\varepsilon} \tag{5}$$
证明梗概:令 $P$ 为到 $\text{row}(S)^\perp$ 的正交投影,由 $SP = 0$,
$$\|R_i P\|_F = \|(R_i - S)P\|_F \le \|R_i - S\|_F \le \delta \|R_i\|_F \tag{6}$$
即 $R_i$ 落在 $\text{row}(S)$ 之外的部分至多占 $\delta^2\|R_i\|_F^2$;结合 $\delta$-有效子空间定义与 Wedin 扰动定理,$V_i^\delta$ 在 $O(\delta)$ 角度内被包含于 $\text{row}(S)$,故 $d = \text{rank}(S) \ge \dim(\sum_i V_i^\delta)$。对称化简时把每个 $V_i^\delta$ 拆成一个维度 $r(1-\varepsilon)$ 的跨目标共享核心 + 一个维度 $r\varepsilon$ 的跨目标正交私有补,得 $\dim(\sum_i V_i^\delta) = r(1-\varepsilon) + k \cdot r\varepsilon = r(1 + (k-1)\varepsilon)$。
直观含义:要表示 $k$ 个可能冲突的目标,embedding 必须张成它们有效子空间的并,所需维度在 $k$ 与冲突 $\varepsilon$ 上都线性增长。
定理 4:切分在最坏情形下饱和该界¶
把 embedding 切成 $k$ 个正交块,大小 $\{d_i\}$ 满足 $d_i \ge r_i$、$\sum_i d_i = d$,第 $i$ 块专供 $R_i$,则在总维度 $d = \sum_i r_i$ 时对所有 $i$ 满足式 (1),且与冲突模式 $\{\varepsilon_{ij}\}$ 无关。证明:每块是 $R_i$ 单独的秩 $d_i$ 逼近,由 Eckart–Young,$d_i \ge r_i$ 保证 $\delta$-精度;块间正交保证目标互不干扰。
对 ESP 的含义:共享 embedding 的需求 $r(1+(k-1)\varepsilon)$ 随冲突增长,切分的需求 $\sum_i r_i$ 恒定。两个界只在最坏情形($\varepsilon \to 1$)重合;中等冲突时共享 embedding 原则上能达到更小的界,前提是训练真的能发现并对齐数据的共享/私有成分。切分用这种潜在的维度效率换一个架构性保证:分解是内置的,不是学出来的。
读者注:这一段作者自己承认了切分在 $\varepsilon < 1$ 时维度上更浪费($\sum_i r_i = kr$ vs $r(1+(k-1)\varepsilon)$)。所以"partitioning 更好"并不能从定理推出,只能推出"partitioning 不依赖训练去发现结构"。实际优劣完全由实验决定。
冲突的实用估计¶
直接算 $\varepsilon_{ij}$ 要对每个 $R_i$ 做 SVD,工业规模不可行。作者用 held-out query 上两目标诱导排序的 Kendall's $\tau$ 作代理:
$$\hat{\varepsilon}_{ij} = 1 - \tau(\text{rank}_i, \text{rank}_j) \tag{7}$$
$\tau$ 取 eval 集 1,359 个 query 在约 39K passage 语料上的逐 query Kendall 相关均值。作者明确说这只是方向性一致的代理(奇异值差异在 $\varepsilon = 0$ 时也能造成排序分歧),只当作量级指示。
定理 5:按有效秩分配维度¶
当 $d < \sum_i r_i$ 时必须分配维度。在 $\sum_i d_i = d$、$d_i \ge 1$ 约束下,最大化最坏情形 Frobenius 覆盖率 $\min_i \|P_{d_i}(R_i)\|_F^2 / \|R_i\|_F^2$(均匀谱衰减假设下)的分配为
$$d_i^* = d \cdot \frac{r_i}{\sum_{j=1}^{k} r_j} \tag{8}$$
证明:在秩 $d_i$ 截断 $R_i$ 留下残差 $\sum_{l > d_i} \sigma_l^2$;在均匀衰减 $\sigma_l^2/\|R_i\|_F^2 \approx \frac{1}{r_i}\mathbb{1}[l \le r_i]$ 下残差为 $1 - d_i/r_i$,令各目标截断水平 $d_i/r_i$ 相等即得比例分配。
分辨率差距(resolution gap):类别型实体匹配这种低分辨率目标的 $r_i$ 很小——约 780 个唯一实体,按 sphere-packing $r_i = O(\log 780) \approx 10$ 维即可;高分辨率的语义排序目标 $r_i$ 随语料复杂度增长。实验中实体匹配在 $d_{\text{ent}} = 32$($H = 1024$ 的 3%)就饱和,而语义质量需要 $d_{\text{sem}} \gtrsim 750$,约 1:20。系统含义:辅助业务目标常常只需紧凑子空间,大部分维度可留给高保真语义召回;但像近重复 SKU 这种高度易混属性就要更大子空间。
核心方法:Embedding Subspace Partitioning¶
ESP 与架构无关,给出两种实现:(1) Transformer-ESP,靠特化的注意力掩码利用自回归模型的内部表征能力;(2) DNN-ESP,共享 trunk + 每目标投影头。两者在不同的目标对上评估:Transformer-ESP 在开源 MS MARCO 基准上做"语义 vs 实体属性匹配"(第 5 节),DNN-ESP 在生产上做"engagement vs revenue(+fitness)"(第 6 节)。作者解释为"各场景天然可得的标签不同"。
读者注:这意味着线上部署的 DNN-ESP 与开源实验的 Transformer-ESP 不是同一个方法实例,论文里 EOS 分段、segment-aware mask、position-ID reset 这些 Transformer 特有机制都没有任何线上证据;线上 ESP 在结构上就是"共享 trunk + $k$ 个投影头",即 MTMH 的结构,差异只在服务端怎么合分。
4.1 ESP 架构¶
ESP 把 embedding 切成 $k$ 个正交子空间,第 $i$ 个子空间产出专供目标 $i$ 的子 embedding $\mathbf{e}_i \in \mathbb{R}^{d_i}$;完整 embedding 为拼接 $\mathbf{e} = [\mathbf{e}_1; \ldots; \mathbf{e}_k] \in \mathbb{R}^d$,$d = \sum_i d_i$。每个 $\mathbf{e}_i$ 各自 L2 归一化,使 $\langle \mathbf{e}_i, \mathbf{e}'_i \rangle \in [-1, 1]$;各目标维度按定理 5 比例分配。
带服务期旋钮的打分:query $\mathbf{q}$ 与文档 $\mathbf{d}$ 的召回得分是各子空间点积的加权和
$$S(\mathbf{q}, \mathbf{d}) = \sum_{i=1}^{k} w_i \cdot \langle \mathbf{e}_i, \mathbf{e}'_i \rangle \tag{9}$$
权重 $\{w_i\}$ 在请求侧、服务时施加,不固化进模型:同一个训练好的 ESP 模型改变 $\{w_i\}$ 就能扫出目标间的 Pareto 前沿,无需重训。实现上只需把 query 侧第 $i$ 个子向量乘以 $w_i$ 再与拼接后的文档向量做一次点积;$w_i = 1$ 时退化为拼接 embedding 上的标准点积,与现有穷举 KNN 基础设施完全兼容。
逐子空间训练:每个子空间用自己的目标损失训练,损失族不受架构约束——对比损失(排序目标用 InfoNCE)、回归损失(revenue 预测用 MSE)、分类损失(二值 fitness 用 BCE)可自由组合,LinkedIn 生产系统三者都用。排序任务的 InfoNCE:
$$\mathcal{L}_i = -\frac{1}{N}\sum_{n=1}^{N} \log \frac{\exp\big(\langle \mathbf{e}_i^{(n)}, \mathbf{e}_i'^{+(n)} \rangle / \tau\big)}{\sum_{j=1}^{B} \exp\big(\langle \mathbf{e}_i^{(n)}, \mathbf{e}_i'^{(j)} \rangle / \tau\big)} \tag{10}$$
$\tau$ 为温度,$B$ 为 batch size(in-batch 负样本)。总训练损失:
$$\mathcal{L} = \sum_{i=1}^{k} \alpha_i \cdot \mathcal{L}_i \tag{11}$$
因为 $\mathcal{L}_i$ 只依赖 $\mathbf{e}_i$,有 $\partial \mathcal{L}_i / \partial \mathbf{e}_j = 0$($j \ne i$):每个损失只更新自己子空间的表征方向,输出端不会出现目标间的"折中方向"。作者也承认共享 encoder 参数仍接收所有 $\mathcal{L}_i$ 的混合梯度,但声称定理 4 的容量保证只依赖输出切分、不依赖 trunk,所以训练期权重 $\{\alpha_i\}$ 只影响收敛速度而不影响几何容量。
读者注:这个"$\alpha_i$ 只影响收敛速度"的说法与第 6.3 节"部署的是 $\alpha = 0.99$ 训练的 ESP 模型"相互矛盾——如果 $\alpha$ 无关紧要,就没必要专门挑 0.99;而且共享 trunk 上的梯度竞争正是 MTSH 干扰的来源之一,只是被移到了 trunk 而非输出层。
4.2.1 Transformer bi-encoder:EOS 分隔的段¶
输入格式:复用模型原生的 end-of-sequence token(EOS)作段分隔符,而不是新增词表 token——作者强调这是关键,因为预训练 encoder 已经会在 EOS 位置产出摘要表征,ESP 因此无需微调即可工作。属性段放在正文之前:
⟨attribute value⟩<EOS>
Instruct: ... query: ⟨text⟩<EOS>
文档侧格式类似。属性前置(attribute-first) 的两个理由:(i) 仅用 causal attention(预训练模型评估不改 encoder 的情形)时,属性 EOS 天然只看到属性 token,因为前面没有正文,这就免费获得属性子空间的隔离;(ii) 与下面的段感知掩码配合后隔离变成对称的:两个 EOS embedding 都只依赖各自的段,定理 4 的正交假设严格成立。
query 与文档两侧的属性值必须指向同一个类型字段(都含人名,或都含职位名)。这假设上游有一个实体 tagger,作者称这在生产召回系统里是标配;没有被打标属性的 query 就省略属性段,ESP 退化为标准单 embedding 召回。
段感知注意力掩码(segment-aware attention masking):位置 $p_i$ 处的每个 EOS token 只 attend 自己段内的 token,即位置 $[p_{i-1}+1, \ldots, p_i]$。于是属性 EOS 只看属性 token,语义 EOS 只看正文 token,实现对称隔离。作者还指出在该掩码下 layer normalization 也只在段内聚合,因此不存在任何跨段泄漏路径。实现上用 SDPA(而非 flash attention)以支持自定义 4D 掩码。
Position-ID 重置(RoPE 校正):RoPE 让隐状态依赖绝对位置;不校正时,同一段属性文本因前面正文长度不同而落在不同位置,就会得到不同 embedding。做法是在每个段边界重置 position ID,让每段都从 0 开始,保证 query 与文档两侧相同的属性文本获得相同的位置编码,余弦相似度 $\approx 1$。
Embedding 抽取:取每段 EOS 位置的隐状态 $\mathbf{h}_i \in \mathbb{R}^H$ 作为归一化前的子 embedding;若做维度分配,把 $\mathbf{h}_i$ 截断到前 $d_i$ 维($\sum_i d_i \le H$)再 L2 归一化得 $\mathbf{e}_i$。Transformer 实现不引入任何额外参数。
机制消融小结(原文 4.2.1 末段,只有文字,没有表格):
| 机制 | 度量 | 结果 |
|---|---|---|
| 仅属性前置(causal) | 相同实体文本的余弦 | $\approx 0.97$,与正文内容无关 |
| + 段感知掩码 | 实体可辨别度 | 92.8% → 100%(+7.2pp) |
| + position-ID 重置 | 相同属性余弦 | $\approx 0.50$ → $\approx 0.73$–$1.0$ |
作者建议:预训练模型评估用 causal-only ESP;微调时加掩码 + 位置重置。
读者注:这三项消融都是在"实体可辨别度 / 余弦"这种中间量上做的,不是在 Sem NDCG@10 / Ent Recall@10 这些主指标上做的。因此无法判断去掉掩码或位置重置后,召回主指标会掉多少、是否会掉到 MTSH 之下。
4.2.2 DNN bi-encoder:投影头¶
没有 causal attention 的 DNN bi-encoder 用不了 EOS 分段,改用共享 encoder trunk 上的 $k$ 个可训练投影头:$\mathbf{e}_i^q = h_i(f(q))$、$\mathbf{e}_i^d = h_i(g(d))$,独立的头在结构上强制输出切分。LinkedIn 生产召回系统 [12] 用此设计,$k = 3$(engagement、revenue、fitness)。
服务:GPU 穷举 KNN¶
ESP 的加权点积与 IVFPQ 这类基于分区的 ANN 索引不兼容(聚类与残差量化预设单一自洽几何)。借助 GPU 加速穷举召回 [12, 21],可在统一索引上做精确的服务期重加权。作者因此把 ESP 定位为"由现代计算硬件使能的模型–系统联合设计"。存储上每个文档 $k = 2$–$3$ 个子向量拼成一个向量,与标准 bi-encoder 相当;对比 ColBERT 的 $O(L)$ 个 token 向量。
实验设置¶
开源基准构建(MS MARCO + 实体硬负例)¶
作者认为标准召回基准混淆了语义相关与关键词匹配,于是从 MS MARCO 构造一个专门的多目标基准:
- 实体抽取:对每个 query 抽取在相关 passage 中逐字出现的多词命名实体(如 "Martin Luther King"、"New York City"、"machine learning"),过滤泛化短语。
- 硬负例:对每个 (query, 实体) 对,从其他 query 的 passage 中采样同样包含该实体字符串、但回答不同问题的段落。例:"Martin Luther King speeches" 的硬负例是关于 "Martin Luther King birthday" 的 passage——同实体、不同信息需求。纯实体匹配会把两者排成一样,语义信号必须区分它们。
- 统计:1,993 个唯一 query;13,951 条训练、2,093 条评估的 (query, positive, hard-negative) 三元组;评估三元组覆盖 1,359 个唯一 eval query。eval 对中 72% 是硬负例(正负都含实体),28% 是易负例(负例不含实体)。
- 检索语料:约 39K passage(eval 集 + 35K 随机采样的 MS MARCO 干扰段落),每个 query 对全语料排序。
- 指标:Semantic NDCG@10(MS MARCO 相关性);Entity Recall@10(top-10 中实体匹配 passage 的比例)。
- 模型:开源 0.6B embedding 模型($H = 1024$,即 Qwen3-Embedding-0.6B [37]);训练 1 epoch。所有方法都用 entity-first 输入格式。
- 学习率、batch size、温度等开源实验超参原文未报告。
实测冲突¶
在预训练 0.6B 模型上,语义排序与实体排序的 Kendall $\tau = 0.34$,$\hat{\varepsilon} = 1 - \tau = 0.66$。代入定理 3($k = 2$)预测最大有效秩 $r_{\text{eff}} \le 1024 / 1.66 \approx 616$,即任何共享 embedding 模型可用表征容量减少 40%。作者说这是最坏理论极限,训练实际上实现的是"更小但单调"的容量损失。
Baseline¶
- Baseline (no entity):不含实体信息的单 embedding。
- Entity in prompt:把实体文本前置进 query 与 passage(instruction-based 路由 [36])。
- MTMH [34]:多任务多头,$k$ 个投影头各自建 ANN 索引 + 下游合并。预训练设定下用"每目标一个 prompt、同一 encoder"模拟,各取 top-$n/2$ 合并。
- ColBERT [14]:token 级 late interaction,$O(L)$ 向量/文档,MaxSim。
- MTSH:多任务单头,实体损失权重 $\alpha_e \in \{1, 5, 10\}$。
- MTSH + PCGrad [33]:梯度手术。
- JRC [25](仅生产离线):学习双 member embedding 做召回 + 校准联合优化。
主要实验结果¶
Table 1:预训练召回(0.6B,39K 语料,1,359 query)¶
| Method | Sem (NDCG@10) | Ent (Recall@10) | Vectors / Doc | Scoring |
|---|---|---|---|---|
| Baseline (no entity) | .668 | .496 | 1 | dot |
| Entity in prompt | .762 | .594 | 1 | dot |
| MTMH† [34] | .677 | .833 | 2 | 2× dot, merge |
| ColBERT [14] | .849 | .935 | $L$ token vectors | MaxSim |
| ESP (ours) | .843 | .932 | 1 | dot |
†预训练 MTMH 用每目标 prompt 模拟。
分析:不加实体时 baseline 语义 NDCG .668;把实体写进输入提到 .762(+14pp),但作者指出这是 task switching 而非多目标优化——单 embedding 把实体与语义信号缠在一起,无 trade-off 机制。MTMH 的 $n/2$ 合并把召回预算劈成两半,两项指标都受损。ColBERT 质量最好但存储与计算昂贵;ESP 用标准 bi-encoder 成本拿到与 ColBERT 相当的实体召回(.932 vs .935),语义 .843 仅低 0.6pp。作者把 ESP 高于 entity-in-prompt(.843 vs .762)归因于子空间隔离阻止实体信号干扰语义排序。
几个值得注意的细节:(1) ESP 在 Table 1 使用的服务权重没有给出;(2) MTMH 是"prompt 模拟"而非真正训练的多头,而 MTMH 的 $n/2$ 硬合并本身就是一个较弱的合并策略——ESP 相对 MTMH 的差距混合了"加权融合 vs 配额合并"的差异,而不纯粹是"切分 vs 不切分";(3) Table 1 中 ESP 的"1 vector/doc"实际上是 $k$ 个子向量的拼接,维度可能是单向量 baseline 的两倍(见下文容量讨论)。
Table 2:训练后模型(0.6B,1 epoch,39K 语料,1,359 query)¶
| Method | Sem NDCG@10 | Ent Recall@10 |
|---|---|---|
| Baseline (no entity) | .870 ± .220 | .679 |
| MTSH ($\alpha_e$=1) | .924 ± .164 | .887 |
| MTSH ($\alpha_e$=5) | .875 ± .208 | 1.000 |
| MTSH ($\alpha_e$=10) | .823 ± .240 | 1.000 |
| MTSH + PCGrad [33] | .879 ± .205 | 1.000 |
| ESP ($w_e$=0.3) | .899 ± .188 | .908 |
| ESP ($w_e$=0.5) | .900 ± .183 | .986 |
| ESP ($w_e$=0.8) | .900 ± .183 | .999 |
± 为跨 query 标准差。trained ColBERT 被略去,理由是 $\sim L$ 向量/文档的存储(约 350TB)在目标场景不可部署。
作者的解读:MTSH 增大实体权重时语义质量逐步下降而实体召回饱和;PCGrad 缓解干扰(原文"−4.6pp semantic vs. −4.9pp for MTSH $\alpha_e$=5",即 .879 与 .875 相对 MTSH $\alpha_e$=1 的 .924 的落差)但不能消除,"证实瓶颈是几何的而非梯度冲突"。ESP $w_e = 0.8$ 达到 .900 语义 + .999 实体,在匹配实体召回下比最好的 MTSH 高 +2.5pp 语义 NDCG($p < 0.001$,1,359 query bootstrap 95% CI [+1.6, +3.5]),且无需重训。
我的解读:
- "匹配实体召回下 +2.5pp"的比较对象是 MTSH $\alpha_e = 5$(.875/1.000),这个比较成立且有 CI 支撑,是全文开源部分唯一有统计检验的主结论。
- 但 MTSH $\alpha_e = 1$(.924/.887)没有被 ESP 支配:ESP 在任何权重下语义都没超过 .900;在最近的操作点 ESP $w_e = 0.3$(.899/.908)上,ESP 实体高 2.1pp、语义低 2.5pp。所以摘要与贡献列表里"outperforms ... at every matched operating point""consistently matches or exceeds"的说法在低实体强调区域不成立,MTSH $\alpha_e=1$ 是一个非支配点。
- 语义 NDCG 的 ±.18–.24 跨 query 标准差很大,但因为有配对 bootstrap,这不直接否定 +2.5pp。
- 训练只有 1 epoch、13,951 条样本,是很小的微调规模。
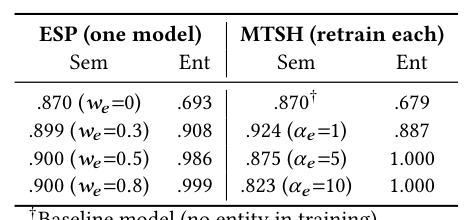
Table 3:Pareto 对比——ESP 单模型扫权重 vs MTSH 每点重训¶
| ESP Sem | ESP Ent | MTSH Sem | MTSH Ent |
|---|---|---|---|
| .870 ($w_e$=0) | .693 | .870† | .679 |
| .899 ($w_e$=0.3) | .908 | .924 ($\alpha_e$=1) | .887 |
| .900 ($w_e$=0.5) | .986 | .875 ($\alpha_e$=5) | 1.000 |
| .900 ($w_e$=0.8) | .999 | .823 ($\alpha_e$=10) | 1.000 |
†Baseline 模型(训练不含实体)。
作者认为 ESP 用一个模型画出平滑的 Pareto 前沿,在可比实体召回下"一致地持平或超过"MTSH,且 ESP 的价值不在任何单一操作点,而在于能从单模型扫出整条前沿——这一句比摘要的表述要诚实得多,也是本文最站得住的主张。
语义 NDCG 平台与信号互补:ESP 语义 NDCG 在 $w_e \in [0.3, 0.8]$ 几乎不变(.899–.900)。$w_e = 0$(纯语义)时 .870——与未见实体的 baseline 完全相同;加实体权重到 0.3 反而让语义 NDCG +2.9pp,因为在这个基准里实体匹配的 passage 与语义相关性相关。在 $[0.3, 0.8]$ 区间,被 $w_e$ 抬升的 passage 既实体匹配又语义相关,所以语义质量不掉。极端 $w_e = 1.0$ 时语义 NDCG 崩到 .583,说明 trade-off 存在,只是在实体信号完全压倒语义时才显现。作者据此说子空间隔离让"实体强调不能破坏语义排序,只能重加权合分";而 MTSH 中实体强调单调损害语义(.924 → .823)。
读者注(引入新信号 ≠ 收益来源):ESP $w_e=0$ 与 baseline 同为 .870,说明 ESP 的语义子空间本身没有任何提升;ESP 语义 NDCG 从 .870 到 .900 的 +3pp 全部来自把实体信号(一个在本基准里与相关性正相关的新输入)加回合分。MTSH $\alpha_e = 1$ 用同样的实体信号拿到 .924。因此"子空间隔离带来语义增益"并不成立;成立的是"隔离后,加大实体权重不会像 MTSH 那样拖垮语义"。另外,这个基准里的实体目标本质是逐字字符串匹配(实体按"在相关 passage 中逐字出现"抽取,32 维即 100% 准确),一个布尔过滤或特征也能做到,用它来验证"多目标表征容量"的理论偏弱——作者在未来工作里也承认需要"两个目标都要求高分辨率"的基准。
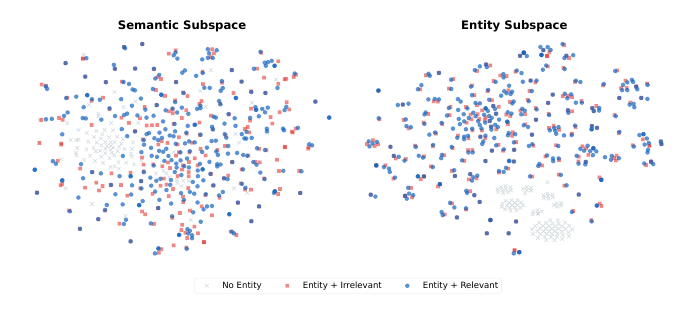
Figure 1 的 t-SNE:语义子空间中实体身份与内容缠在一起(左);实体子空间中同实体 passage 不论相关与否都紧密聚类(右),无实体样本单独成簇。作者据此说实体匹配是一个低维、易于隔离的信号。
维度分配(5.5)¶
把每个 EOS 的隐状态截断,扫 $d_{\text{ent}}$ 从 0 到 $H$,令 $d_{\text{sem}} = H - d_{\text{ent}}$。在 entity-first 格式提供完美隔离(相同实体余弦 $\approx 1.0$)时,预训练与训练后模型都在 $d_{\text{ent}} = 32$(3%)达到 100% 实体准确率,与 3.5 节"约 780 个实体只需 $O(\log 780) \approx 10$ bit"的分辨率差距论证一致。原文只给文字,没有给出语义 NDCG 随 $d_{\text{sem}}$ 变化的曲线,因此"语义需要 $d_{\text{sem}} \gtrsim 750$"的数据支撑在正文中不可见。
单目标通用性(5.6)¶
在三个 BEIR 基准(NFCorpus、SciFact、FiQA)上,用 "none" 实体前缀评估预训练模型(加掩码 + 位置重置),ESP 退化为标准 bi-encoder;与 baseline 相比变化 $\le 0.3$pp,说明无显著退化——实体子空间 embedding 对所有文档恒定,不影响排序。原文未给逐数据集表格。
Table 4:$k = 3$ ESP(语义 + 实体 + 长度偏好,预训练 0.6B,1,359 query)¶
第三个目标为 passage 长度偏好:按词数分为短(<30)、中(30–80)、长(>80),query 偏好设为"中"。输入格式 <length><EOS><entity><EOS><passage><EOS>,得分 $S = w_s \cdot s_{\text{sem}} + w_e \cdot s_{\text{ent}} + w_l \cdot s_{\text{len}}$。
| Weights $(w_s, w_e, w_l)$ | Sem | Ent | Len (Length Match@10) |
|---|---|---|---|
| (1.0, 0.0, 0.0) sem only | .867 | .687 | .812 |
| (0.5, 0.5, 0.0) $k$=2 | .861 | .985 | .858 |
| (0.5, 0.3, 0.2) $k$=3 balanced | .843 | .957 | .912 |
| (0.4, 0.4, 0.2) $k$=3 ent+len | .824 | .969 | .912 |
| (0.5, 0.2, 0.3) $k$=3 heavy len | .830 | .918 | .931 |
分析:$(0.5, 0.3, 0.2)$ 下同时得到 .843/.957/.912,全部来自一个未额外训练的预训练模型。相对 $k=2$ 的 $(0.5, 0.5, 0)$,加长度目标损失 −1.8pp 语义与 −2.8pp 实体,换来 +5.4pp 长度匹配,作者称之为"平滑可预测的 trade-off 而非灾难性干扰"。作者也明说长度偏好是玩具目标。这张表的价值是展示了多维权重空间里的可控性;局限是没有任何 $k=3$ 的单 embedding 对照。
生产验证(LinkedIn 职位匹配)¶
目标与标签¶
部署在服务 7000 万+ 周活的职位匹配平台,使用 DNN-ESP,$k = 3$ 个投影头从共享 encoder trunk 分叉:
- Engagement:30 天内 1.35 亿次点击、1200 万次申请、300 万次收藏;in-batch 负采样 + 随机易负例(mixed negative sampling),InfoNCE,温度 $T = 0.01$。
- Revenue:CPC 计价下 revenue 估计为 $P(\text{click} \mid \text{impression}) \times \text{bid}$;从高精度 L2 ranker 做知识蒸馏,借助反事实数据生成 soft pClick 标签;对伪标签用 MSE 训练。
- Fitness:由在 2.5 万条人工标注上微调的 LLM 生成 soft 标签,衡量职位与求职者资质的匹配度;阈值化为二值标签,用 BCE 训练。
Table 5:生产多目标联合训练(离线)¶
MSE diff 相对 revenue-only baseline(MTSH $\alpha$=0.99);recall diff 相对 engagement-only baseline(MTSH $\alpha$=0.01)。ESP 权重为 $(w_{\text{rev}}, w_{\text{eng}})$。
| Model | MSE diff (%) | in-batch-2048 @10 diff (%) | offline-KNN @6400 diff (%) |
|---|---|---|---|
| MTSH ($\alpha$=0.01) | +6905.80 | 0.00 | 0.00 |
| MTSH ($\alpha$=0.99) | 0.00 | −28.24 | −21.19 |
| JRC [25] | +5307.25 | −0.03 | −0.45 |
| ESP (0.5, 0.5) | +52.17 | −1.10 | −1.29 |
| ESP (0.8, 0.2) | +42.03 | −0.67 | −1.21 |
| ESP (0.9, 0.1) | +23.19 | −0.84 | −0.76 |
| ESP (0.99, 0.01) | +4.35 | −0.54 | −0.17 |
作者的解读:MTSH 在规模上干扰严重——强调 revenue($\alpha$=0.99)损失 28.24% in-batch recall 与 21.19% 离线 KNN recall。在"匹配的 revenue 强调"下(MTSH $\alpha$=0.99 vs ESP $w_{\text{rev}}$=0.99),MTSH 损失 28.24% 而 ESP 只损失 0.54%,"约 50× 改善"。JRC 缓解了 recall 损失(−0.03%),但 MSE 惩罚巨大(+5307.25%),且同样不能服务期重调。
我的解读:
- "匹配 revenue 强调"并不匹配:MTSH $\alpha$=0.99 是训练时几乎只学 revenue 的模型;ESP $w_{\text{rev}}$=0.99 是两个目标都完整训练过、只在合分时给 engagement 0.01 权重的模型。两者比较的是"训练时丢掉 engagement"与"服务时降权 engagement",50× 的数字主要反映的是 MTSH 在 $\alpha=0.99$ 下 engagement 损失权重只剩 0.01。
- MTSH 只有两个极端点(0.01 与 0.99),没有中间 $\alpha$(比如 0.5)作为匹配操作点的对照,因此生产离线表无法回答"在同一个 trade-off 点上 ESP 是否优于单 embedding 联合训练"。
- ESP $w_{\text{rev}}$=0.99 时 recall 只掉 0.54%、MSE 只差 +4.35%——如果合分真的 99% 来自 revenue 子空间,engagement recall 应当接近 MTSH $\alpha$=0.99 的水平;这个结果暗示两个子空间得分量级/校准差异很大(作者在未来工作里提到要做 per-subspace 校准),或 MSE/recall 分别是在各自子空间而不是加权合分上评估的。原文没有说明 ESP 各行的 MSE 与 recall 是怎么随服务权重计算的,权重扫描在该表里的含义不清。
- 容量未匹配:ESP 的 $k$ 个投影头拼接后的维度、MTSH 单 embedding 的维度、trunk 大小均未报告。在开源实验里,每个 EOS 的隐状态都是 $H = 1024$ 维,维度分配"若施加则截断",Table 2 的 ESP 是否使用 $2 \times 1024$ 维也未说明。matched-capacity 比较没有被显式控制。
- 缺少训练后的 MTMH 对照:DNN-ESP 在结构上就是 MTMH(共享 trunk + 每目标头),真正需要回答的是"同样的多头模型,加权合分进一个穷举索引 vs 每头 ANN + 配额合并"谁更好——这个对照在开源(只有 prompt 模拟版)与生产里都没有。
扩展到 $k=3$:加 fitness 子空间后,fitness 子空间在 held-out fitness 标注上 AUC 0.938,engagement 与 revenue 指标"与 $k=2$ 配置持平"。原文未给数值表。
Table 6:线上 A/B($d_1$:revenue,$d_2$:engagement)¶
部署的是以 $\alpha = 0.99$ 训练的 ESP 模型,改变 revenue 的服务期权重 $w_{d_1}$,engagement 权重 $w_{d_2} = 1 - w_{d_1}$。7 天 A/B,结果均统计显著($p < 0.05$):
| Weight $w_{d_1}$ | Revenue | Job Application | Click Rate |
|---|---|---|---|
| 0.1 | +0.91% | +3.30% | +0.04% |
| 0.2 | +2.31% | +3.20% | +0.37% |
| 0.3(生产选定) | +4.01% | +3.95% | +0.92% |
| 0.5 | +7.36% | +1.88% | +0.61% |
$w_{d_1} = 0.3$ 为选定的生产操作点,所有指标同时正向;上量后(post-ramp)分析显示该配置下 no-fit rate 下降 8.95%(被下游过滤器与人工审核标记为与求职者资质不匹配的推荐职位比例)。同一个训练好的 ESP 模型覆盖四个生产操作点而无需重训,revenue 增益从 +0.91% 到 +7.36%。
关键审视(工业署名 ≠ 工业证据):
- 对照组未说明。论文从未写出 A/B 的 control 是什么。引言的措辞是"retuning the serving-time weights alone on a single trained model yielded ...",结合"已上线两年",最可能的解读是:control 是同一个或上一版 ESP 在旧权重下,treatment 是新权重。若如此,这组线上数字衡量的是"拧旋钮的收益",而不是"ESP vs 单 embedding / MTMH"的架构收益——论文没有任何 ESP 对非 ESP 的线上对照。
- 即便如此,Table 6 仍是一个真实的、跨四个权重的线上扫描,这正是"服务期重加权确实能在线上作为业务杠杆"的直接证据:revenue 随 $w_{d_1}$ 单调上升(+0.91% → +7.36%),申请数在 0.3 附近达峰后回落(3.95% → 1.88%),trade-off 形状符合预期。这比只报一个操作点强得多。
- 训练期 $\alpha = 0.99$ 与 4.1 节"$\alpha_i$ 只影响收敛速度"的说法冲突,但未被解释;这里 $\alpha$ 的记号还沿用了 MTSH 的 revenue 损失权重定义。
- −8.95% no-fit 来自上量后的观察性分析,不是 A/B 的随机对照结果。
- 每个 treatment 相对哪个 control、流量比例、是否同一时间窗并行,均未给出。
服务延迟与其他讨论¶
Transformer-ESP 延迟(开源基准,0.6B encoder,H200):作者称 ESP 零延迟开销——causal-only 版本(flash attention)相对标准编码多 <0.1%;masked 版本(SDPA)在短序列上比 flash attention 快 12%(原文写作"22.4ms vs. 19.6ms per document",数字顺序与"更快"的表述需读者自行对应)。自定义 4D 掩码本身开销可忽略。生产 DNN-ESP 规模小得多、推理栈不同,系统级延迟请参阅 [12],本文未报告生产延迟与 GPU 成本。
属性打标是独立问题:ESP 把多目标召回拆成 (1) 上游实体/属性打标、(2) 切分 embedding 匹配。作者认为这是自然的流水线分解而非局限;未打标的 query 平滑退化为单 embedding 召回。
基础设施前提:加权点积与 IVFPQ 不兼容,必须依赖 GPU 穷举 KNN——对没有这类基础设施的团队,ESP 的"单索引"优势不成立,只能退回 $k$ 个索引或近似方案。
作者列出的未来工作:多个目标同时需要高分辨率 embedding 的场景(如语义精度 vs 主题多样性)及相应基准;per-subspace 得分校准(post-hoc scaling、isotonic regression),以便随 $k$ 增长更容易控制 Pareto 操作点;更多异质目标;收紧定理 5 的分配界;改进共享 trunk 中的跨目标梯度流;与 FlashAttention 兼容的段感知掩码 kernel。
核心贡献总结¶
- 把"服务期可调的多目标召回"具体落地:$k$ 个 L2 归一化子空间 + 请求侧权重的加权点积(式 9),配合 GPU 穷举 KNN 在一个拼接索引上精确合分,绕开"多头召回需要 $k$ 个 ANN 索引"的工程障碍。
- Transformer 上的零参数切分:复用 EOS 作段分隔、属性前置、段感知 4D 掩码、段内 position-ID 重置,一次前向得到隔离的多个子 embedding,预训练模型不微调也能用。
- 一个容量论证:定理 3/4/5 给出共享 embedding 在目标冲突下的维度下界、切分的构造性上界、以及按有效秩的维度分配。论证本身较浅(下界是子空间并的维数,切分在 $\varepsilon<1$ 时维度上反而更贵),作用更多是动机而非预测。
- 开源多目标基准:MS MARCO + 同实体硬负例,1,993 query。
- 线上权重扫描:一个训练好的模型在四个服务权重上的 7 天 A/B,revenue +0.91%~+7.36%,选定点 +4.01% revenue / +3.95% 申请 / +0.92% 点击率。
与已归档相关工作的对比¶
Multi-Decoder OneRec Multi-Decoder OneRec: Controllable Generative Retrieval for Multi-Objective Recommendation(Kuaishou,2026-07-29)¶
关系:独立并发(本文未引用 Multi-Decoder OneRec,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇都在问同一个工业召回问题——一个统一召回模型服务多个业务目标时,共享参数会把各目标耦合在一起(ESP 称之为 no-knob problem + 几何干扰;Multi-Decoder OneRec 称之为目标策略耦合 + 负迁移),而传统解法"每个目标一路召回"又让建模、训练、服务碎片化。两篇都把"在不重训的前提下改变候选池的目标构成"当成运营侧的核心需求。
- 相近的技术骨架:都是"共享 trunk + 每目标隔离的输出参数 + 服务期可调的组合规则"。ESP 是共享 encoder + 每目标投影头 / EOS 段,输出端 $\partial \mathcal{L}_i / \partial \mathbf{e}_j = 0$;Multi-Decoder OneRec 是共享 user-context module 与 General Decoder + 每目标 LoRA 专家 / BOS / SID embedding 残差。服务期旋钮在 ESP 是加权点积的权重 $w_i$,在 Multi-Decoder OneRec 是各路线的配额 $q_r$。
- 本文的差异与推进:(1) 隔离力度不同——Multi-Decoder OneRec 用 stop-gradient 把目标损失的梯度挡在共享基座之外,共享参数只由曝光 NTP 更新;ESP 的共享 trunk 仍收到所有目标损失的混合梯度,作者只宣称输出端隔离。就"消除 trunk 上的干扰"而言,Multi-Decoder OneRec 更彻底。(2) 组合方式不同——ESP 是连续的加权和(一个候选同时由多个目标打分),Multi-Decoder OneRec 是离散的配额 + 前缀屏蔽去重(一个候选归属一条路线);前者天然没有重复问题,后者需要 MD-CBS 专门处理重复。(3) 范式不同——ESP 是 embedding 检索、依赖 GPU 穷举 KNN;Multi-Decoder OneRec 是 SID 生成式召回、依赖 beam search。
- 可比的方法 / 实验差异:Multi-Decoder OneRec 有同预算下对单 decoder OneRec 的离线对照(Recall@512 +1.69%~5.62%)和对 A/B 控制组明确的线上实验;ESP 有跨四个权重的线上扫描,但没有对非 ESP 召回的线上对照,生产离线也只有 MTSH 的两个极端点。两篇都缺少"完全复制的每目标独立模型"这一上界对照。
讨论与局限性¶
值得借鉴的设计¶
- 把 trade-off 从训练期挪到服务期是最有实际价值的点。对于运营需要按季度/按活动调整 revenue 与 engagement 配比的场景,一个模型 + 请求侧权重,比每次重训 MTSH 或维护多套召回栈便宜得多。Table 6 的四点线上扫描证明这个旋钮在真实流量上确实可用且响应形状合理。
- EOS 分段 + 段感知掩码 + 位置重置是一个干净的工程技巧:不加参数、不加词表,就让一个 decoder-only embedding 模型一次前向吐出多个彼此隔离的向量。适合"属性匹配 + 语义匹配"这种可以由上游 tagger 提供结构化字段的场景。
- 分辨率差距的观察有实用意义:实体/类目这类辅助目标只需要很小的子空间(32/1024),大部分维度留给语义。
主要局限与争议¶
- 线上证据衡量的是旋钮,不是架构。A/B 的 control 从未说明,引言措辞指向"同一模型、只改权重"。论文没有 ESP vs MTSH、ESP vs MTMH、ESP vs 上线前系统的线上对照。已上线两年的系统,其原始上线收益没有报告。
- 生产离线对照不匹配。MTSH 只有 $\alpha = 0.01$ 与 $0.99$ 两个极端点;"50× 改善"是把训练时几乎不学 engagement 的模型与两个目标都学过的模型相比。没有中间 $\alpha$ 的 MTSH,也没有训练过的 MTMH(真正的多头召回 + 各自 ANN + 合并),而 DNN-ESP 的结构恰恰就是 MTMH。
- 容量没有匹配。子向量拼接后的总维度、各头维度、MTSH 的维度都没报告;开源部分每个 EOS 可取满 $H=1024$ 维,ESP 很可能比单向量 baseline 多一倍维度。定理本身也表明切分在 $\varepsilon<1$ 时需要更多维度,因此"同容量下切分更好"这个关键问题恰恰没有被检验。
- "每个操作点都更好"不成立。MTSH $\alpha_e = 1$(.924/.887)在低实体强调区域未被 ESP 支配;ESP 语义最高只有 .900。ESP 的语义子空间单独用($w_e=0$)与 baseline 同为 .870,语义提升全部来自把实体信号加回合分,而这个基准的实体信号与相关性正相关。
- 消融强度无法与收益比较。机制消融只在实体可辨别度与余弦这类中间量上做(+7.2pp、0.50→0.73–1.0),没有在 Sem NDCG / Ent Recall 主指标上报告"去掉掩码 / 去掉位置重置"的数值,因此无法判断消融降幅是否超过 ESP 相对最强 baseline 的 +2.5pp 裕度——而且线上用的 DNN-ESP 根本不含这些机制。
- 开源基准偏玩具。实体按"在相关 passage 中逐字出现"构造,32 维即 100% 准确,本质接近字符串匹配;第三个目标(passage 长度)作者自己称为玩具。用这种低分辨率目标验证"表征容量冲突"的理论说服力有限。训练 1 epoch、约 1.4 万条样本,超参未报告。
- 理论贡献偏薄。下界是"目标有效子空间的并的维数",切分上界是 Eckart–Young 的直接应用;$\hat{\varepsilon} = 1 - \tau$ 只是方向性代理,"容量减少 40%"的预测也未被训练实验定量验证(作者自己说实际损失"更小")。
- 强依赖 GPU 穷举 KNN。加权点积与 IVFPQ 不兼容,对没有穷举召回基础设施、或语料规模超出穷举能力的团队,ESP 的"单索引"卖点不成立。生产延迟与 GPU 成本均未报告。
- 细节不一致:部署模型"以 $\alpha = 0.99$ 训练"与"$\alpha$ 只影响收敛"的说法冲突;Table 5 中 ESP 各权重的 MSE/recall 如何随服务权重计算没有说明;SDPA 延迟数字与"快 12%"的表述对应关系含糊。
方法论可扩展性¶
ESP 的切分是输出层的结构约束,参数量 scaling 时 trunk 可以照常放大,没有"先压缩再建模"式的两阶段解耦,也没有固化的离散码本;扩展瓶颈主要在服务侧——$k$ 增长时拼接向量维度与穷举扫描成本线性增长,且多目标同时需要高分辨率时(作者自己列为未来工作)切分的维度代价会很快显现。
工业落地价值¶
对 LinkedIn 自身而言,价值是真实的:一个召回模型覆盖 engagement / revenue / fitness 三个目标、上线两年、可以在不重训的情况下按业务优先级调权,选定点带来 +4.01% revenue、+3.95% 申请、+0.92% 点击率(相对未说明的对照),以及上量后 −8.95% no-fit。对其他团队,可直接借鉴的是"子空间 + 请求侧权重 + 穷举合分"的服务设计与 EOS 分段技巧;但如果想据此论证"切分比单 embedding 联合训练更好",本文的证据还不够——需要匹配容量、匹配操作点的离线对照,以及 ESP 对非 ESP 召回的线上 A/B。