Efficient Retrieval Scaling with Hierarchical Indexing for Large Scale Recommendation
Dongqi Fu, Kaushik Rangadurai, Haiyu Lu, Yunchen Pu, Siyang Yuan, Minhui Huang, Yiqun Liu, Golnaz Ghasemiesfeh, Xingfeng He, Fangzhou Xu, Andrew Cui, Vidhoon Viswanathan, Lin Yang, Liang Wang, Jiyan Yang, Chonglin Sun · Meta (USA) · EDBT '26 (Tampere, Finland) · arXiv:2604.12965v1 · 2026-04-14
一句话总结
这是 Meta 广告检索团队的一篇「大模型怎么真上线」的经验论文:他们指出把基础检索模型(foundation retrieval model)做大之后,真正卡住落地的不是训练而是推理阶段要在 $O(10^7)$ 量级的物品库上对每个用户做一遍复杂交互打分,而业界常见的两条 quick-win——离线预算用户候选集缓存、把大模型蒸馏成小模型——都等于放弃了大模型的表征与推理能力;因此他们提出 HILL(Hierarchical Index Learning),用 cross-attention 软分配 + 残差量化,把一棵分层索引和基础检索模型联合训练出来,在线只沿这棵树做 beam search 就能在保持 exactness 的前提下剪掉绝大部分搜索空间;同时他们第一次系统性地公开了 Meta 线上的检索基础模型 MoNN(Modular Neural Network) 的架构、训练流程与损失函数,并把 MoNN 按索引层级堆成多层(L1 用大模型跑粗粒度索引节点、L3 用小模型跑物品粒度),在 Meta 广告生产环境拿到 +2.57% 线上广告指标;最后他们发现一个「意外收获」:索引树的中间层节点回溯出来的
1. 研究动机与背景
1.1 推荐领域的 scaling 浪潮把成本问题推到了推理侧
随着基础模型 scaling law 的成功(Kaplan et al. 2020;Hoffmann et al. 2022 的 Chinchilla),推荐领域也把数据量、算力、参数量三条轴上的 scaling 结论搬了过来(Ardalani et al. 2022;Fang et al. 2024;Guo et al. 2024;Shin et al. 2023;Zhang et al. 2024),催生了 Wukong、HSTU、InterFormer、ExFM 一批大规模工业推荐系统。
但论文指出一个被普遍回避的问题:这些巨大的排序 / 检索基础模型该怎么服务真实的高频重载场景,讨论得远远不够。最扎眼的开销就是推理与检索成本——要用基础检索模型的推理能力,就得把 user 和 item 特征都灌进这个庞大的复杂网络去拿偏好分,面对海量 user-item 对时既慢又贵。
业界的两条 quick-win 解法:
- 离线预计算:提前给用户算好检索集合,在一个时间窗内静态地服务这份结果;
- 蒸馏:把大模型蒸成小模型再上线。
论文的判断很直接:两条路都没有完全释放大模型的表征与推理能力(前者牺牲了实时性与个性化时效,后者牺牲了容量)。
1.2 已有索引方法为什么不够用
用索引结构组织物品、在索引上做近似搜索(例如 beam search)来压缩搜索空间、快速吐出相似对,是一条成熟路线(Feng et al. 2022 Recommender Forest;Gao et al. 2020 Deep Retrieval;Li et al. 2023 Tree-based Index for Dense Retrieval;Li et al. 2025 Differentiable Indexers;Liu et al. 2024 Deep Tree-based Retriever;Zhu et al. 2018 TDM)。
但论文认为这些方法不适配今天工业界的基础模型场景:现代工业模型普遍采用深、稠密连接的神经网络去学 user–item 之间的复杂交互,并且喂进去的是带丰富结构化描述的特征;而传统树构建高度依赖单纯的 item embedding,构树过程本身就在丢信息(论文原话是 "avoid the tree construction process relying solely on item embeddings to lose information")。因此作者要做的是一个学习式(learning-based)的树构建方法,而且既然 MoNN 已经能吃下大量
1.3 三条贡献
- 分享 Meta 广告平台部署大规模基础检索模型的经验:为基础检索模型学一棵分层索引,能让它进入一个「效果—效率」平衡的可上线状态;
- 为强调可复现性,首次系统性地拆解 Meta 在线服务的检索基础模型 MoNN(神经架构、训练流程、损失函数);
- 发现索引树的中间层节点构成一个体量小但质量高的新数据源,用它微调预训练检索模型可以得到一次「test-time training」式的推理侧提升。TTT 指的是在推理阶段更新模型参数、通常不需要 ground-truth 标签的一类方法(Sun et al. 2020;Hardt & Sun 2024;Yuksekgonul et al. 2026),其目的是适配而非单纯依赖预训练。
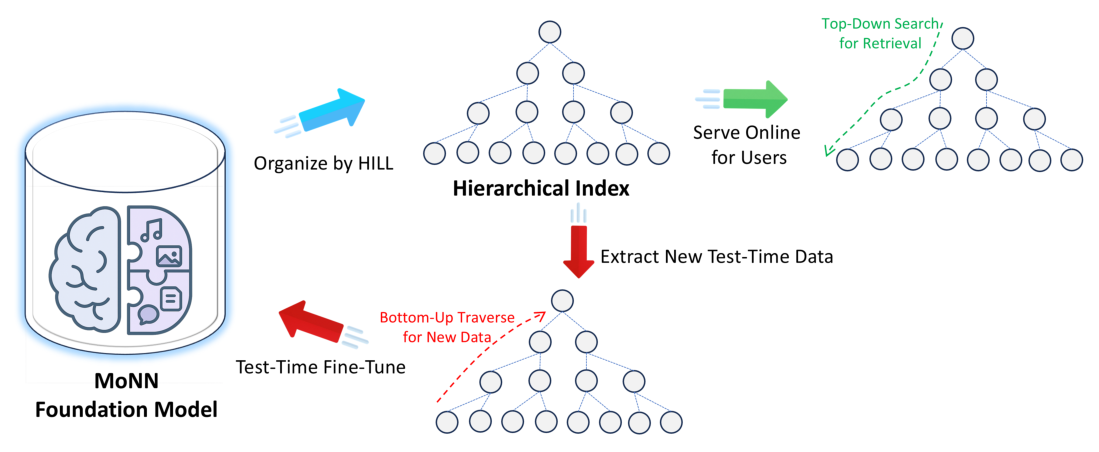
整条流水线如下图:MoNN 基础模型的「记忆」被 HILL 组织成分层索引 → 在线自顶向下 beam search 出检索结果 → 同时自底向上回溯抽出新的 test-time 数据 → 反过来微调 MoNN。
2. MoNN:Meta 线上的基础检索模型
MoNN(Modular Neural Network)的设计目标是:在超越单纯点积的前提下学到复杂的 user-item 交互,同时保持高效率,并且能在不同基础设施约束下灵活伸缩。它是模块化的,由三座塔加一个顶层架构组成。
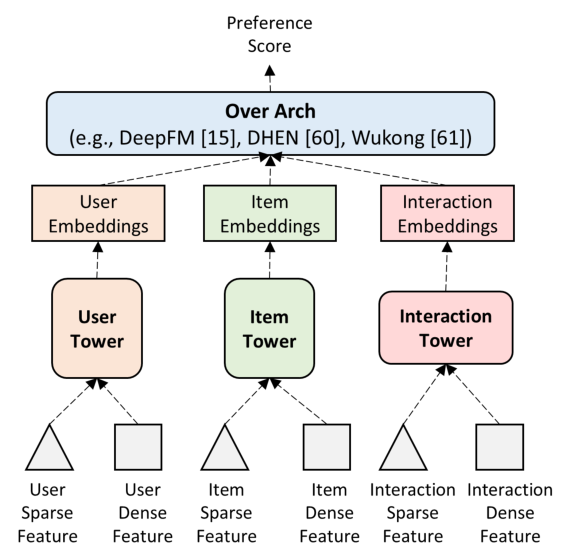
User Tower。吃用户特征产出定长用户 embedding。特征既有稠密的(如用户点击次数)也有稀疏的(如用户看过的视频);稀疏特征过 embedding lookup table,然后所有特征 embedding 拼接后送进塔。关键性质:用户塔只需要算一次,就能被海量 item 共享,因此它可以放心地堆到很高的复杂度——这正是后文让大模型去跑粗粒度索引层的算力依据。
Item Tower。与用户塔镜像,处理 item 的稠密特征(如物品历史 CTR)与稀疏特征(如物品内容),走另一张 embedding table,拼接后进塔。
Interaction Tower。吃
Over Architecture(OverArch)。骑在三座塔之上,负责综合聚合所有信息、产出 user-item 偏好分。OverArch 可以直接复用 DHEN、DeepFM 或 Wukong 来生成数值 logits——也就是说 MoNN 不是要替代这些特征交叉架构,而是把它们当作可插拔的顶层。
训练设置。MoNN 在大规模训练集上训练,以点击和转化为正标签、以曝光但未点击/未转化为负样本,另外引入无标注数据做半监督学习来给模型去偏。输入特征规模在 $O(1000)$ 量级,模型针对多任务(点击任务、转化任务等)优化,总损失是多任务交叉熵:
$$\mathcal{L} = \mathcal{L}_{sup} + \mathcal{L}_{unsup} \tag{1}$$
监督项为:
$$\mathcal{L}_{sup} = -\frac{1}{S}\sum_{i=1}^{S}\sum_{t=1}^{T} w_t\Big(y_{ti}\log(\hat{y}_{ti}) + (1-y_{ti})\big(\log(1-\hat{y}_{ti})\big)\Big) \tag{2}$$
其中 $w_t$ 是任务 $t \in \{1,2,\dots,T\}$ 的权重(代表其重要性),$y_{ti}\in\{0,1\}$ 是样本 $i$ 在任务 $t$ 上的真实标签,$\hat{y}_{ti}$ 是模型预测值,$S$ 是样本数。无监督项为:
$$\mathcal{L}_{unsup} = -\frac{1}{S}\sum_{i=1}^{S}\sum_{t=1}^{T} distill\big(\hat{y}_{ti},\, y_{ti}^{model}\big) \tag{3}$$
其中 $y_{ti}^{model}$ 是由 MoNN 自身或另一个训练好的 teacher 模型给出的软标签,$distill$ 函数同样可以实例化为交叉熵。
点评:这一节的价值主要是「首次公开」,架构本身没有惊喜——它就是一个把 interaction tower 显式化、顶上挂 DHEN/Wukong 的加强版双塔。真正的信息量在两处:(a) 用户塔可复用因而可以单独放大,这为后面「大模型跑粗层」提供了合法性;(b) 半监督软标签自蒸馏是 Meta 线上去偏的常规手段。但论文对 I2IF 只给了一句话,没有任何实现细节或消融,这是可复现性上的明显缺口。
3. HILL:分层索引学习
3.1 总览
HILL 要建一棵组织物品的层次结构,帮助基础检索模型(如 MoNN)为用户检索最相关的物品,同时顺带产出一小批高质量新数据来做 test-time 微调。
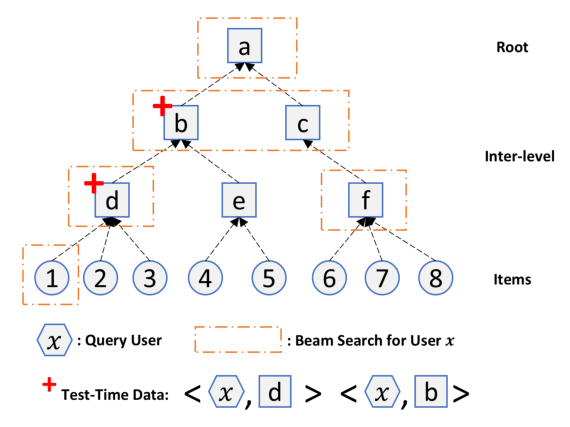
以图 3 为例:8 个物品编号 1–8,学出来的是一棵三层树,根节点为 $a$,中间层为 $b,c,d,e,f$。给定用户 query $x$,从根 $a$ 出发用 beam search(宽度为 2)向下走,最终定位到物品 1 作为最相关物品,进入用户 $x$ 的推荐集合,从而避免了逐个计算每个物品到用户 $x$ 的相似度。
更重要的是,从叶子 1 回溯到根 $a$,HILL 还识别出一条「有价值但隐藏」的路径 $1 \to d \to b \to a$,它记录了用户 $x$ 可能同样感兴趣的中间层节点。由于这棵树是学出来的,$d, b, a$ 都是虚拟节点、不出现在训练数据里,因此 <$x, d$> 和 <$x, b$> 具备微调模型的潜力。为什么选 $d$ 和 $b$ 而排除 $a$,见 3.6 节。
3.2 单层注意力学习
建树的第一步是建一层:把物品当叶子,映射到上一层。
算法 1 以 MoNN 提供的 embedding 向量为输入,通过最小化 item embedding 与索引节点 embedding 的 L2 距离来学粗粒度索引节点 embedding。它是 attention 式的:以 item embedding 为 query,以索引节点的可学习 embedding 为 key 和 value,用注意力分数算出索引 embedding。注意力带来的关键性质是软映射(soft mapping)——训练过程中一个 item 可以以不同权重同时属于多个索引节点。
Algorithm 1: One-Layer Attention Learning
Require: MoNN 模型, 超参 K
Ensure:  item→index 映射函数 M, 索引节点 embedding 矩阵 R
 1: 随机初始化索引节点 embedding {c_k}_{k=1..K}
 2: while 未收敛 do
       /* Mini-Batch 训练 */
 3:    for batch 中每个 item j do
 4:        采样一个 <i, j> user-item 对及标签 y,
           用 MoNN 算出用户 embedding u_i 与物品 embedding v_j
 5:        计算 item j 与索引 k 的距离   d(j,k)
 7:        计算 item j 与索引 k 的亲和度 a_k
 9:        计算伪 item embedding        c̄ = Σ_k a_k · c_k
10:        用新对 (y, <u_i, c̄>) 更新 MoNN 的优化
11:    end for
       /* 固化索引 embedding 与映射 */
12:    for 每个索引节点 k do
13:        for 语料中每个 item j do
14:            用 d(j,k) 更新 M(j,k)
15:            若 j = argmin_j d(j,k),则令 c_k = v_j
16:        end for
17:    end for
18: end while
19: 返回函数 M 与矩阵 R(k,:) = c_k
其中距离与亲和度分别为:
$$d(j,k) = \lVert \boldsymbol{v}_j - \boldsymbol{c}_k \rVert_2 \tag{4}$$
$$a_k = \frac{e^{-\alpha \cdot d(j,k)}}{\sum_{k'} e^{-\alpha \cdot d(j,k')}} \tag{5}$$
$$\bar{\boldsymbol{c}} = \sum_k a_k \boldsymbol{c}_k \tag{6}$$
第 10 行是整个设计的枢纽:它把 (user, 伪 item embedding) 这一对连同真实标签 $y$ 塞回 MoNN 的优化目标,于是索引节点 embedding 的梯度是从下游推荐损失里回传来的,而不是靠一个孤立的聚类目标——这就是所谓「联合学习」的具体含义。第 15 行则是收尾时把每个索引节点锚定到离它最近的那个真实 item 的 embedding 上,让索引节点成为一个「代表性物品」,这也解释了后文「index node 在特征计算时被一个代表性 item 替换」的做法。
3.3 跨层残差学习
有了单层就要往上叠。为了让索引真正「分层」(上层语义应当依赖下层,同时存住下层存不下的信息),HILL 借鉴残差量化(Lee et al. 2022 的 RQ 图像生成;Zeghidour et al. 2021 的 SoundStream),把「输入 item embedding 与其下层索引节点 embedding 之间的残差」传给上一层索引。
回看算法 1 的第 8–9 行,索引节点表示是以伪 item embedding(软分配 / 注意力聚合)的形式存下来的,这就保证了树的各层维度对齐:每一层都有一个真实 item embedding 和一个与索引 embedding 紧密关联的伪 item embedding。
数学上,设每层有 $K$ 个索引节点(记号上简化为各层节点数相同,实现时是超参),共建 $N$ 层。先由 MoNN 给出所有 item 的初始 embedding,item $j$ 记为 $\boldsymbol{v}_j$,则第 1 层的初始残差向量为:
$$\boldsymbol{r}^1_j = \boldsymbol{v}_j \tag{7}$$
HILL 在把第 1 层映射到第 2 层时会产出伪 item embedding $\bar{\boldsymbol{c}}^1_j$,于是在每一层 $n \in \{2,\dots,N\}$ 上,残差向量的递归量化为:
$$\boldsymbol{r}^n_j = \boldsymbol{r}^{n-1}_j - \bar{\boldsymbol{c}}^{n-1}_j \tag{8}$$
这个 $\boldsymbol{r}^n_j$ 会替换算法 1 第 4 行里「问 MoNN 要 item embedding」的那一步,作为构建下一层时的 item 表示。相应地,第 $n$ 层的量化 embedding 为:
$$\boldsymbol{q}^n_j = \sum_{l=1}^{n-1} \bar{\boldsymbol{c}}^l_j \tag{9}$$
重构损失为:
$$\mathcal{L}_{recon} = \sum_j \lVert \boldsymbol{q}^N_j - \boldsymbol{v} \rVert_2 \tag{10}$$
论文指出:沿层次往下走时残差幅度递减,因此粗层索引标识表达的是更泛化的概念,细粒度索引层捕捉更具体的语义。这与 RQ-VAE 家族的直觉完全一致,区别在于这里的「码本」是被下游推荐损失和 L2 重构损失共同拉扯的。
3.4 优化技巧
为了让索引训练稳定,HILL 额外引入三个技巧:
(a)Softmax 温度调度器(Softmax Temperature Scheduler)。服务阶段索引节点 embedding 要作为虚拟 item 帮用户 query 检索相关物品;但训练时用的是软分配,每个索引节点是一堆不同兴趣物品的混合,可能混进不相关的物品。为弥合这种训练—服务差异,调度器逐渐升高温度 $\alpha$,从初期的软分配过渡到后期的硬分配。$\alpha$ 小 → item-to-index 分配分布均衡;$\alpha$ 大 → 分布尖锐。调度函数为:
$$alpha = max\_alpha \cdot \frac{current\_iter^{exp}}{max\_iters^{exp}} \tag{11}$$
(b)均衡索引分布(Balanced Index Distribution)。索引学习常见簇塌缩(cluster collapse)——模型只用上一小撮索引节点。均衡分布对于让高复杂度神经网络发挥作用是关键的,因此 HILL 采用 FLOPs 正则(动机来自 Paria et al. 2020 的 Minimizing FLOPs to Learn Efficient Sparse Representations),惩罚「所有 item 被分到同一个索引节点」或「
(c)Warmup 策略。对索引损失权重做线性 warmup 逐步提升学习率,稳定模型参数,缓解训练初期 item 在不同索引节点之间来回震荡的问题。
3.5 用 FAISS 做 EM 近似
学分层索引的本质是把基础模型的记忆结构化组织起来,让相关性检索能走最优路径、剪掉不必要的分支。但上面的联合训练不可避免地要连带训练基础模型,这在短时间窗(如小时级)+ 重负载(十亿级用户、百万级物品)的条件下可能不可行。因此论文给了一个算力不足时的替代方案。
如果把分层索引视作「已训练好的基础模型」的内部组成部分,那么学索引这件事可以用 EM 算法求解:把索引节点看成 item 的(软或硬)簇,则 item–index 映射是隐变量,user / item embedding 是观测变量,问题被近似成一个高斯混合模型。于是:
- E 步:把每个 item 分配到最近的簇,可以直接用 GPU 版 FAISS 的并行聚类库(如 K-Means)实现(Johnson et al. 2021;Douze et al. 2024);
- M 步:按当前索引 embedding 训练基础模型。
这套 EM 近似在算力不够或两个时间窗之间只需小幅更新时能快速收敛,实验表明其效果损失可接受。
论文同时强调:算力允许时仍推荐 full 版 HILL,理由有二:(1) 用神经网络持续训练索引,能在在线流式场景里动态适配最新数据;(2) 避免维护两套不同的计算框架——对工业级生产系统来说这两点都很重要。
3.6 从 HILL 抽新数据做 test-time training
建好索引之后,怎么发现能微调基础模型的新数据?
回到图 3:自顶向下的 beam search 为用户 $x$ 找到物品 1;回溯这条路径 $1 \to d \to b \to a$,就意味着用户 $x$ 也对索引节点 $d, b, a$ 感兴趣。论文的直觉解释是:中间层索引节点可以被理解为(预)训练之后 item 的「机器可读的类目节点」,把它们和原用户配对,就生成了此前训练迭代中从未见过的新训练数据
但并非路径上所有中间节点都够格:
第一条筛选:回溯深度 $\phi_{DEP}$。层级越高的索引节点含义越泛化——极端情况是根节点被所有用户共享,
第二条筛选:兴趣集中率 $\phi_{IR}$。即便是 $d$ 或 $b$ 也可能不够格,因为用户 $u$ 的兴趣可能同时散落在 $d$ 的物品和其他索引的物品上。论文建模为:只有当用户 $u$ 的兴趣集中在 $d$ 的物品上时,
$$\phi_{IR}(u, i_n) = \frac{\big|Int(u, n-1) \cap Child(i_n)\big|}{Child(i_n)} \tag{12}$$
其中 $Int(u, n-1)$ 返回索引树第 $n-1$ 层上用户感兴趣的物品(或索引节点),$Child(i_n)$ 返回 $i_n$ 在第 $n-1$ 层的直接孩子集合。
论文给了一个直观解释:只有当用户在
结论是:只要 $\phi_{DEP}$ 取小、$\phi_{IR}$ 阈值取大,就能选出一小部分新数据,用它微调即可拿到显著提升。论文明确指出目前只考虑了正向强信号、微调时沿用原损失;给新数据对加权、引入弱信号乃至负信号、在微调时加对比学习损失,都被留作未来方向。
4. 实验设置
4.1 数据集
同时用公开基准和内部数据。公开数据集选 Gowalla、Yelp 2018、Amazon-Book(统计见下表),内部数据集是 Meta 平台的日常广告推荐任务。
Table 2: 公开基准数据集统计
| Dataset | # Users | # Items | # Interactions | Density |
|---|---|---|---|---|
| Gowalla | 29,858 | 40,981 | 1,027,370 | 0.084% |
| Yelp2018 | 31,688 | 38,048 | 1,561,406 | 0.130% |
| Amazon-Book | 55,188 | 9,912 | 1,445,622 | 0.062% |
数据核对:Gowalla 与 Yelp2018 两行自洽($1{,}027{,}370 / (29{,}858 \times 40{,}981) = 0.084\%$,$1{,}561{,}406/(31{,}688\times 38{,}048)=0.130\%$);但 Amazon-Book 行不自洽——$1{,}445{,}622/(55{,}188\times 9{,}912)=0.264\%$,与表中 0.062% 相差 4 倍以上,且 9,912 的 item 数远小于 LightGCN 系工作常用的 Amazon-Book 划分。这一行的物品数或交互数很可能誊写有误。
4.2 Baseline
论文选了六个类别的 baseline:(1) 经典协同过滤;(2) 神经协同过滤;(3) 生成式协同过滤;(4) 工业检索模型;(5) 通用图神经网络;(6) 图神经网络启发的检索模型。因篇幅限制,每个 baseline 的引用直接标在 Table 3 里。
内部实验的 baseline 有两个:TTSN(Siamese Time Delay Neural Network 谱系的双塔模型,Bromley et al. 1993)与 EBR(Embedding-based Retrieval in Facebook Search,Huang et al. 2020)。
4.3 指标
Recall@K 衡量模型在 top-$K$ 推荐列表中召回相关物品的能力:
$$\text{Recall@}K = \frac{|\text{Rel}_u \cap \text{Rec}^K_u|}{|\text{Rel}_u|} \tag{13}$$
其中 $\text{Rel}_u$ 是用户 $u$ 的相关(ground-truth)物品集合,$\text{Rec}^K_u$ 是 top-$K$ 推荐集合。公开数据集上取 Recall@20。
NDCG@K 不仅看相关物品是否出现,还看它们的位置:
$$\text{NDCG@}K = \frac{1}{|\mathcal{U}|}\sum_{u \in \mathcal{U}} \frac{\text{DCG}_u@K}{\text{IDCG}_u@K} \tag{14}$$
其中 $\text{DCG}_u@K = \sum_{i=1}^{K}\frac{\mathbb{I}(r_{u,i}=1)}{\log_2(i+1)}$,$\mathbb{I}(y_{u,i}=1)$ 指示用户 $u$ 推荐列表中第 $i$ 个物品是否相关,$\text{IDCG}_u@K = \sum_{i=1}^{\min(K,|\text{Rel}_u|)}\frac{1}{\log_2(i+1)}$。
NE(Normalized Entropy) 沿用 Facebook 的广告点击预测经验(He et al. 2014)。设训练集有 $N$ 个样本,标签 $y_i \in \{-1,+1\}$,预测点击概率为 $p_i$,平均经验 CTR 为 $p$,则:
$$NE = \frac{-\frac{1}{N}\sum_{i=1}^{n}\Big(\frac{1+y_i}{2}\log(p_i) + \frac{1-y_i}{2}\log(1-p_i)\Big)}{-\big(p \cdot \log(p) + (1-p)\cdot\log(1-p)\big)} \tag{15}$$
之所以要这样归一化:背景 CTR 越接近 0 或 1,越容易拿到好的 log loss;除以背景 CTR 的熵之后,NE 就对背景 CTR 不敏感了。值越低越好。论文另外还写了一个 top-K 形式:
$$\text{Normalized Entropy@}K = \frac{-\sum_{i \in \mathcal{I}} p_i \log p_i}{\log |\mathcal{I}_K|} \tag{16}$$
注:式 (15) 与式 (16) 是两个语义不同的量——前者是归一化 log loss,后者是检索分布的归一化熵。论文并列给出但没有说明各自用在哪张表上,从表 1/4/5 的「NE Gain」相对值来看,实际用的应该是式 (15)。这是本文写作上的一处瑕疵。
5. 主要实验结果
5.1 内部数据:模型规模、效果与基建成本的三方权衡
Table 1: HILL-Enabled MoNN 在内部数据上的表现($I_1, I_2, V$ 分别为 $O(1{,}000)$、$O(100{,}000)$、$O(10{,}000{,}000)$ 量级;$M_{XS}$ 是服务双塔模型的成本,$M_S / M_M / M_L$ 分别是服务 MoNN Small / Medium / Large 的成本;$I_1$ 是 L1 层节点数,$I_2$ 是 L2 层节点数,$V$ 是语料中的物品数)
| Model Architecture | Eval NE (↓) | Recall (↑) | Infra Cost (↓) | Theoretical Cost |
|---|---|---|---|---|
| TTSN | baseline | 0% | 1x | $M_{XS} \times V$ |
| EBR | +0.03% | −0.1% | 0.5x | $M_{XS} \times I_1$ |
| MoNN Small | −0.29% | +2.4% | 2.5x | $M_S \times V$ |
| MoNN Medium | −0.70% | +4.2% | 17.3x | $M_M \times V$ |
| MoNN Large | −1.70% | +9.4% | 24.6x | $M_L \times V$ |
| 2-layer MoNN (L1: MoNN Small, L2: TTSN) | −0.23% | +2.2% | 1.7x | $M_S \times I_1 + M_{XS} \times V$ |
| 2-layer MoNN (L1: MoNN Medium, L2: MoNN Small) | −0.47% | +3.6% | 3.3x | $M_M \times I_1 + M_S \times V$ |
| 2-layer MoNN (L1: MoNN Large, L2: MoNN Small) | −0.97% | +6.0% | 3.9x | $M_L \times I_1 + M_S \times V$ |
结论分析(why 而不只是 what):
- 表里所有 MoNN 模型都联合优化了 HILL。按 He et al. 2014 的经验,NE 增益 > 0.05% 即为显著,因此表中所有 MoNN 行都是显著的。
- 单层 scaling 有效但代价失控:MoNN Large 效果最好(NE −1.70%、Recall +9.4%),但基建成本是 TTSN 的 24.6 倍。理论成本一栏解释了原因——单层 MoNN 的开销是「单模型服务成本 × 全语料物品数 $V$」,而 $V$ 是 $O(10^7)$。
- 分层的收益来自把 $V$ 换成 $I_1$:2-layer MoNN (L1: MoNN Large, L2: MoNN Small) 的理论成本是 $M_L \times I_1 + M_S \times V$,即大模型只在 $O(10^3)$ 个索引节点上跑,小模型才在 $O(10^7)$ 个物品上跑。结果是成本从 24.6x 降到 3.9x(降 84%),而 Recall 从 +9.4% 只掉到 +6.0%(保住 64%)、NE 从 −1.70% 掉到 −0.97%(保住 57%)。这就是论文所谓「effective-efficiency-balanced stage」的量化含义。
- EBR 是一个反面参照:它成本最低(0.5x,因为只在 $I_1$ 上跑双塔),但效果反而劣于 TTSN(NE +0.03%、Recall −0.1%)。这说明光有索引剪枝、没有足够强的打分模型,剪枝只会损失效果——HILL 的价值恰恰在于让强模型能被放到粗层去用。
- 论文对训练策略的表述是「stack MoNN blocks and make the lower level take the majority (but not all) of the data during the training」,即下层承担大部分数据。
5.2 公开基准:HILL + NESCL
公开实验的做法是:选 NESCL(Sun et al. 2024,Neighborhood-Enhanced Supervised Contrastive Learning)作为检索模型,先用 EM 版 HILL 学出分层索引,然后抽取
Table 3: 三个公开数据集上的 baseline 对比(粗体 = 各列最优,下划线 = 次优)
| Baseline | Gowalla Recall@20 | Gowalla NDCG@20 | Yelp2018 Recall@20 | Yelp2018 NDCG@20 | Amazon-Book Recall@20 | Amazon-Book NDCG@20 |
|---|---|---|---|---|---|---|
| BPR | 0.1627 | 0.1378 | 0.0576 | 0.0468 | 0.0338 | 0.0261 |
| GRMF | 0.1477 | 0.1205 | 0.0571 | 0.0462 | 0.0354 | 0.0270 |
| GRMF-norm | 0.1557 | 0.1261 | 0.0561 | 0.0454 | 0.0352 | 0.0269 |
| HOP-Rec | 0.1399 | 0.1214 | 0.0517 | 0.0428 | 0.0309 | 0.0232 |
| ENMF | 0.1523 | 0.1315 | 0.0624 | 0.0515 | 0.0359 | 0.0281 |
| MF-CCL | 0.1837 | 0.1493 | 0.0698 | 0.0572 | 0.0559 | 0.0447 |
| SimpleX | 0.1872 | 0.1557 | 0.0701 | 0.0575 | 0.0583 | 0.0468 |
| NeuMF | 0.1399 | 0.1212 | 0.0451 | 0.0363 | 0.0258 | 0.0200 |
| Mult-VAE | 0.1641 | 0.1335 | 0.0584 | 0.0450 | 0.0407 | 0.0315 |
| Macrid-VAE | 0.1618 | 0.1202 | 0.0612 | 0.0495 | 0.0383 | 0.0295 |
| YouTubeNet | 0.1754 | 0.1473 | 0.0686 | 0.0567 | 0.0502 | 0.0388 |
| CMN | 0.1405 | 0.1221 | 0.0475 | 0.0369 | 0.0267 | 0.0218 |
| CML | 0.1670 | 0.1292 | 0.0622 | 0.0536 | 0.0522 | 0.0428 |
| DeepWalk | 0.1034 | 0.0740 | 0.0476 | 0.0378 | 0.0346 | 0.0264 |
| LINE | 0.1335 | 0.1056 | 0.0549 | 0.0446 | 0.0410 | 0.0318 |
| Node2Vec | 0.1019 | 0.0709 | 0.0452 | 0.0350 | 0.0402 | 0.0309 |
| Item2Vec | 0.1325 | 0.1057 | 0.0503 | 0.0411 | 0.0326 | 0.0251 |
| GAT | 0.1401 | 0.1401 | 0.0543 | 0.0431 | 0.0326 | 0.0235 |
| JKNet | 0.1622 | 0.1391 | 0.0608 | 0.0502 | 0.0268 | 0.0343 |
| DropEdge | 0.1627 | 0.1394 | 0.0614 | 0.0506 | 0.0342 | 0.0270 |
| APPNP | 0.1708 | 0.1462 | 0.0635 | 0.0521 | 0.0384 | 0.0299 |
| DisenGCN | 0.1356 | 0.1174 | 0.0558 | 0.0454 | 0.0329 | 0.0254 |
| LightGCN | 0.1830 | 0.1554 | 0.0649 | 0.0530 | 0.0411 | 0.0315 |
| GC-MC | 0.1395 | 0.1204 | 0.0462 | 0.0379 | 0.0288 | 0.0224 |
| PinSage | 0.1380 | 0.1196 | 0.0471 | 0.0393 | 0.0282 | 0.0219 |
| NIA-GCN | 0.1359 | 0.1106 | 0.0599 | 0.0491 | 0.0369 | 0.0287 |
| SGL-ED | 0.1835 | 0.1539 | 0.0675 | 0.0555 | 0.0478 | 0.0379 |
| DeosGCF | 0.1784 | 0.1477 | 0.0626 | 0.0504 | 0.0410 | 0.0316 |
| IMP-GCN | 0.1845 | 0.1567 | 0.0653 | 0.0531 | 0.0460 | 0.0357 |
| BUIR | 0.1575 | 0.1301 | 0.0647 | 0.0526 | 0.0439 | 0.0346 |
| DGCF | 0.1842 | 0.1561 | 0.0654 | 0.0534 | 0.0422 | 0.0324 |
| IA-GCN | 0.1839 | 0.1562 | 0.0659 | 0.0537 | 0.0472 | 0.0373 |
| LT-OCF | 0.1875 | 0.1574 | 0.0671 | 0.0549 | 0.0442 | 0.0341 |
| HMLET | 0.1874 | 0.1589 | 0.0675 | 0.0557 | 0.0482 | 0.0371 |
| GTN | 0.1870 | 0.1588 | 0.0679 | 0.0554 | 0.0450 | 0.0346 |
| MGDCF | 0.1864 | 0.1589 | 0.0696 | 0.0572 | 0.0490 | 0.0378 |
| BSPM-LM | 0.1901 | 0.1570 | 0.0713 | 0.0584 | 0.0733 | 0.0610 |
| NESCL | 0.1908 | 0.1614 | 0.0740 | 0.0609 | 0.0623 | 0.0509 |
| HILL (Ours) | 0.1924 | 0.1628 | 0.0745 | 0.0612 | 0.0625 | 0.0513 |
结论分析:
- HILL 在 Gowalla 与 Yelp2018 上取得全表最优,但提升幅度很小:相对 NESCL,Gowalla Recall@20 +0.84%(0.1908→0.1924)、NDCG@20 +0.87%;Yelp2018 Recall@20 +0.68%、NDCG@20 +0.49%。
- Amazon-Book 上 HILL 并非最优:BSPM-LM 以 0.0733 / 0.0610 大幅领先(Recall 高出 17.3%),HILL 只是次优(0.0625 / 0.0513),相对其 backbone NESCL 提升 +0.32% / +0.79%。论文正文对这个失利没有任何讨论。
- 更关键的是:HILL 在这张表里的角色是「NESCL + test-time 微调」,而不是「HILL 作为一个独立检索模型」。也就是说,公开实验验证的只是 3.6 节的 TTT 数据抽取有效,并没有验证 3.2–3.4 节的联合训练索引本身能不能提升公开数据集上的效果(因为这里用的是 EM 近似版)。表格给人的直觉印象(HILL 是一个 SOTA 检索模型)与实际做法(HILL 是一个加在 NESCL 上的微调数据来源)之间存在落差。
- 表中还有两处印刷异常应予标注:GAT 在 Gowalla 上 Recall@20 与 NDCG@20 完全相同(均为 0.1401);JKNet 在 Amazon-Book 上 NDCG@20 (0.0343) 反而高于 Recall@20 (0.0268)——这两者在正常评测下都不应出现,很可能是转录自原始 baseline 表时的错位。
6. 消融与参数分析
6.1 训练技巧消融
Table 4: HILL 训练技巧消融(backbone: MoNN Small,Gowalla)
| Training Variant | NE (↓) |
|---|---|
| w/o Softmax Temperature Scheduler | +0.10% |
| w/o Balanced Index Distribution | +0.05% |
| w/o Warmup Strategy | +0.03% |
分析:(1) 含全部技巧的完整版表现最好;(2) 移除任何一个都会掉点,说明三者不冲突、可叠加;(3) Softmax 温度调度器移除后损失最大(+0.10%)——这与 3.4 节的动机一致:训练用软分配、服务用硬分配之间的 gap 是这套方案最大的结构性风险,温度调度正是唯一直面这个 gap 的组件。均衡索引分布次之(+0.05%,恰好压在「显著」阈值上),warmup 影响最小(+0.03%,未达显著阈值)。
6.2 EM 近似消融
Table 5: HILL 近似版消融(backbone: 2-Layer MoNN,Gowalla)
| Model Architecture | NE (↓) |
|---|---|
| HILL | −0.15% |
| HILL (EM) | −0.11% |
分析:EM 版损失 0.04% NE,低于 0.05% 的显著性阈值,因此论文称其「competitive」。反过来讲,full 版相对 EM 版的优势也不显著——这在论证上是把双刃剑:它既支持了「算力不够时可以用 EM 版」,也削弱了「联合训练比离线 K-Means 聚类更好」这一核心主张的实验支撑。论文选择的表述是「这也说明算力允许时 full 版 HILL 有理由被考虑」,属于比较委婉的说法。
6.3 回溯深度 $\phi_{DEP}$ 的参数分析
Table 6: 不同 $\phi_{DEP}$ 的表现(Gowalla)
| $\phi_{DEP}$ | # Nodes per Inter-layer | $\phi_{IR}$ | Recall@20 | NDCG@20 |
|---|---|---|---|---|
| 1 | 8000 | 0.8 | 0.1922 | 0.1624 |
| 2 | 8000, 800 | 0.8, 0.4 | 0.1924 | 0.1628 |
| 3 | 8000, 800, 80 | 0.8, 0.4, 0.2 | 0.1922 | 0.1624 |
| 4 | 8000, 8000, 80, 8 | 0.8, 0.4, 0.2, 0.1 | 0.1916 | 0.1623 |
6.4 兴趣集中率 $\phi_{IR}$ 的参数分析
Table 7: 不同 $\phi_{IR}$ 的表现(Gowalla;下划线为论文最终采用的配置)
| $\phi_{DEP}$ | # Nodes per Inter-layer | $\phi_{IR}$ | Recall@20 | NDCG@20 |
|---|---|---|---|---|
| 1 | 8000, 800 | 0.8, 0.1 | 0.1916 | 0.1624 |
| 1 | 8000, 800 | 0.8, 0.2 | 0.1923 | 0.1629 |
| 1 | 8000, 800 | 0.8, 0.3 | 0.1914 | 0.1624 |
| 1 | 8000, 800 | 0.8, 0.4 | 0.1924 | 0.1628 |
| 1 | 8000, 800 | 0.8, 0.5 | 0.1914 | 0.1623 |
| 1 | 8000, 800 | 0.8, 0.6 | 0.1924 | 0.1620 |
| 1 | 8000, 800 | 0.8, 0.7 | 0.1925 | 0.1623 |
分析:论文给出的结论是「少量但精确的 test-time 数据就足以拿到领先表现」——加更多新数据对并不会持续提升。但把两张表放在一起看,问题相当明显:
- 波动幅度小于噪声量级。Table 6 中最好(0.1924)与最差(0.1916)的 Recall@20 只差 0.42%;Table 7 里 7 组配置的 Recall@20 在 0.1914–0.1925 之间无规律跳动(0.1→0.1916、0.2→0.1923、0.3→0.1914、0.4→0.1924、0.5→0.1914、0.6→0.1924、0.7→0.1925),看不出任何单调或单峰趋势。论文没有报告任何方差 / 多次运行结果,因此「$\phi_{IR}$ 该取多大」这个问题实际上没有被实验回答。
- 两张表的最优点互相矛盾。Table 7 的 Recall@20 最优是 $\phi_{IR}=0.8,0.7$(0.1925),NDCG@20 最优是 $0.8,0.2$(0.1629),而论文正文和 Table 3 采用的却是 $0.8,0.4$(0.1924 / 0.1628)——即两个指标都不是最优的那一组。论文没有解释选择依据。
- 两处明显的排版错误:Table 6 第 4 行「# Nodes per Inter-layer」写作
8000, 8000, 80, 8,按等比递减规律应为8000, 800, 80, 8;Table 7 整列 $\phi_{DEP}$ 全部标为 1,但每行都配了两层节点数与两个 $\phi_{IR}$ 值,且正文明确说 Gowalla 用的是 $\phi_{DEP}=2$,故该列应为 2。
7. 线上部署与多层 MoNN 细节
7.1 线上 A/B 结果
MoNN 基础检索模型已在 Meta 成功部署于广告检索。在部署 MoNN Large 之前,团队先把基建成本相对较低的 MoNN Small 架构推上了生产——这是一条很实在的工程路径信息。
Table 8: Meta 广告生产环境线上表现
| Model Architecture | Online Metric (↑) |
|---|---|
| TTSN | −0.21% |
| MoNN Small | baseline |
| 2-Layer MoNN (L1: MoNN Medium, L2: MoNN Small) | +1.22% |
| 2-Layer MoNN (L1: MoNN Large, L2: MoNN Small) | +2.57% |
分析:线上以 MoNN Small 为基线,2-Layer MoNN (Large + Small) 拿到 +2.57% 的在线广告指标,且 L1 用 Medium 换成 Large 能从 +1.22% 再翻一倍到 +2.57%——这条趋势线(粗层模型越大、线上收益越大,而成本因为只作用在 $O(10^3)$ 个索引节点上而受控)是全文最有说服力的证据。TTSN 相对 MoNN Small 是 −0.21%,与 Table 1 的离线趋势一致。需要注意论文没有披露「Online Metric」具体是什么指标(收入 / 转化 / 广告质量分),也没有给出实验流量与时长。
7.2 多层 MoNN 的部署细节
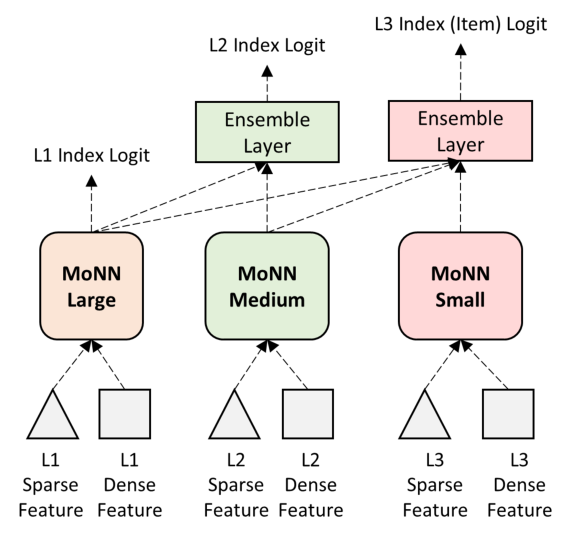
图 4 展示了三层 MoNN:L1 层运行在最粗的索引粒度上,因此可以(通过计算共享)用上复杂度最高的 MoNN 架构以及一整套
特征分配。MoNN Small 在单个 item 粒度上处理特征,用的是 user 特征、item 特征与
损失函数。多层 MoNN 的每一层都有自己的损失函数,即一个
8. 核心贡献总结
- 把「索引结构」从离线预处理升格为与基础模型联合训练的一部分。传统树索引(TDM 谱系)先拿 item embedding 聚类建树、再训打分模型,构树这一步就把信息丢了;HILL 把索引节点 embedding 直接放进 MoNN 的优化目标(算法 1 第 10 行),让索引由下游推荐损失来塑形。
- 用残差量化让层次真正「分层」。逐层传递残差(式 7–10)保证上层存的是下层存不下的信息,残差幅度随深度递减,天然形成「粗层泛化概念 / 细层具体概念」的语义层次。
- 把算力按索引层级分配,这是全文最有工程价值的一招。理论成本从 $M_L \times V$($V\sim10^7$)变成 $M_L \times I_1 + M_S \times V$($I_1\sim10^3$),于是「大模型」这三个字的成本被摊到了粗层,基建成本从 24.6x 降到 3.9x 而效果保住六成以上。
- 首次系统披露 Meta 检索基础模型 MoNN 的架构、训练流程与损失,包括 I2IF 倒排索引式交互特征、多任务交叉熵 + 半监督软标签去偏这些工业细节。
- 一个漂亮的副产品:索引中间节点 = 免费的高质量新监督数据。
- 给出了算力不足时的 EM/FAISS 退化方案,并诚实报告了它与 full 版的差距(0.04% NE)。
9. 与已归档相关工作的对比
GRACE GRACE: Generative Recommender Acceleration Engine for Real-Time Ads Retrieval (Meta Platforms, 2026-08-02)
关系:同公司同业务的后继工作(本文 2026-04-14 早于 GRACE 约 3.5 个月,本文不可能引用它;GRACE 亦未引用本文,两者是 Meta 广告检索上并行推进的两条服务化路线)· 已加载对方精读
- 共同关注的问题:两篇都在回答同一个问题——Meta 广告检索里,怎么让一个昂贵的大模型真正跑进实时链路。本文的瓶颈定义是「复杂交互打分 × $O(10^7)$ 物品全库」,GRACE 的瓶颈定义是「生成式解码的候选合格性(eligibility)+ 宽 beam 短序列形状下的注意力算力」。root cause 同构:平坦的全库/全前缀搜索空间必须被结构化剪枝,否则模型容量再大也上不了线。
- 相近的技术骨架:两者都把物品组织成一棵层次结构,并在这棵树上做自顶向下的 beam search,逐步把不可能命中的分支整枝掉。本文的树是 HILL 用 cross-attention + 残差量化学出来的;GRACE 的树是 SID 前缀 trie(沿用 STATIC 的 catalog-valid 受限解码索引)——结构是给定的,剪枝器是挂上去的:每个 trie 节点挂 subtree-union 的 bitmask / Bloom matcher,解码每步把不含合格广告的前缀掩成 $-\infty$。抽象成方法流程图,两者都是「层次索引 + 逐层剪枝 + beam 保留 top-k」。
- 本文的差异与推进:本文剪枝的目的是省算力(把大模型限制在 $O(10^3)$ 个粗层节点上跑),剪枝准则是学出来的相关性;GRACE 剪枝的目的是保合格性(广告主定向规则是请求级、个性化的),剪枝准则是外挂的位图/Bloom 谓词,且明确承认自己的 SID 级过滤是保守的(子树 OR 会引入假阳性),仍需 CPU 侧精确的广告级复核。换句话说,本文解决的是「大模型怎么摊算力」,GRACE 解决的是「生成式范式怎么满足广告的硬约束 + kernel 怎么适配宽 beam 形状」。
- 可比的方法 / 实验差异:本文的成本叙事停留在相对基建成本倍数(24.6x → 3.9x)与线上 +2.57%,没有任何绝对延迟数字;GRACE 给到了毫秒级的 P99 拆解(解码器 P99 197.7ms → 17.8ms,端到端 P99 53.6ms 卡在 70ms 算力窗内)。另一处值得注意的分叉:GRACE 在相关工作里提到 Meta 自家的 Andromeda(「深度召回模型 + 分层索引,在数千万广告候选上搜索」),这与本文 MoNN + HILL 是同一条技术脉络,但两篇论文都没有把对方的方案作为 baseline 对比过,Meta 内部这条分层索引检索线的完整演进关系目前在两篇论文里都是缺失的。
AIR-MoE AIR-MoE: Adaptive Inverted-index Routing for Granular Mixtures of Experts (Max Planck Institute for Intelligent Systems, 2026-05-06)
关系:独立并发、跨领域殊途同归(AIR-MoE 晚于本文 3 周,双方互不引用;两者把同一套 IVF 配方分别用在 item 检索和 MoE 路由上)· 已加载对方精读
- 共同关注的问题:两篇的 root cause 完全一致——当候选集合大到 $10^5$–$10^7$ 量级时,「对每个候选精确打一遍分」的平坦 top-K 成为主导开销,使得更强的模型/更细的粒度在实践中不可用。本文的候选是物品库($V \sim O(10^7)$),AIR-MoE 的候选是专家集合($E$ 达 65k 乃至百万级),后者把这一开销直呼为「granular MoE 实际不可训」的根因。
- 相近的技术骨架:两者都用「学一个远小于候选集的粗粒度码本 → 用它把候选收窄成 shortlist → 只在 shortlist 内做精确打分」这套倒排索引(IVF)配方,且都强调保留 exactness(本文称 exactness-aware hierarchical index,AIR-MoE 称 "exact top-K is scored only inside the cached shortlist")。更巧的是码本的学法:本文 3.5 节的 EM 近似正是「E 步用 GPU FAISS 做 K-Means 聚类、M 步训基础模型」,而 AIR-MoE 的 codebook 训练是 gradient-free 的 adaptive spherical K-Means(EMA 计数 + 球面归一化 + dead-code 重初始化)——两者独立地收敛到了「码本不走梯度、由聚类维护;打分部分走梯度」这一相同分工。
- 本文的差异与推进:本文的 full 版走得更远,把索引节点 embedding 直接放进下游推荐损失做联合训练(算法 1 第 10 行的伪 item embedding $\bar{c}$ 参与 MoNN 优化),并用残差量化把码本堆成多层(式 7–10),得到的是一棵可做多层 beam search 的树;AIR-MoE 只有单层 codebook + shortlist,明确选择不给专家中心 $\mathbf{W}$ 施加任何结构约束(这是它相对 PEER 的卖点),也不做 STE。反过来,AIR-MoE 有本文完全没有的东西:一个路由质量下界(Prop. 1),把 shortlist 近似与 exact top-K 的差距做了理论刻画;本文对「HILL 的分层 beam search 相对全量打分损失多少」既无理论界也无实测(Table 1 的 Recall 是端到端的,无法分离剪枝损失)。
- 可比的方法 / 实验差异:本文的均衡性手段是 FLOPs 正则 + 池化多个 batch,AIR-MoE 用的是 Switch 式 load-balancing loss + dead-code 重初始化——两者面对的是同一个病(cluster collapse / dying expert),开的是不同的药。本文用软→硬的温度调度处理「训练软分配、服务硬分配」的 gap,AIR-MoE 则用双重 Gaussian jitter(shortlist 构造与专家选择各加一次)来保持探索性,思路相通但机制不同。
IID-Nav IID-Nav: From Extraction to Navigation, Progressive Retrieval with Indirectly Infinite Depth (Kuaishou Technology, 2026-06-29)
关系:独立并发(IID-Nav 晚于本文 2.5 个月,双方互不引用;两者对「静态树索引不够用」这一诊断一致但给出相反的解法)· 已加载对方精读
- 共同关注的问题:两篇都从同一个诊断出发——工业检索要在十亿级语料、<100ms 延迟下,用一个比双塔强得多的交互模型来打分,因此必须有结构化索引来剪枝;但现成的索引结构会拖累效果。本文的说法是「传统树构建只依赖 item embedding 会丢信息,不适配深、稠密连接的现代基础模型」;IID-Nav 的说法是 TDM 这类树方法「拓扑受限(topologically constrained)」,一旦层次建好,任意意图的导航路径就基本被索引结构预定义了,无法适应实时异质的兴趣漂移,并把由此产生的两个病症命名为兴趣隧道与搜索漂移。两者都明确反对 EBR 式「固定 embedding 空间里做被动内积匹配」的路线——这一点在本文 Table 1 里有直接证据:EBR 成本最低(0.5x)但效果反而劣于 TTSN 双塔基线。
- 相近的技术骨架:都是「用一个不受双塔结构限制的复杂判别模型,引导在一个结构化的物品组织上做逐步剪枝式搜索」。本文的结构是学出来的多层树、引导者是 MoNN、搜索是自顶向下 beam search;IID-Nav 的结构是协同图 + 语义图组成的异质图、引导者是 target-aware attention 排序模型、搜索是逐跳图导航。
- 本文的差异与推进:面对同一个「静态拓扑」诊断,两者的解法方向恰好相反。本文选择继续用树,但让树本身可学、并与基础模型联合训练——即通过「让结构适配模型」来消解拓扑刚性;IID-Nav 选择放弃树、改用图,并通过跨请求的 Redis 状态接力(Indirectly Infinite Depth)把被单次请求延迟预算锁死的探索深度沿时间轴累积起来——即通过「让搜索跨越时间」来突破深度上限。本文的算力叙事是空间维度的分层摊薄(大模型只跑 $O(10^3)$ 个粗节点),IID-Nav 的算力叙事是时间维度的深度累积(单请求少数几跳,跨请求逻辑上无限深)。这两条路径在原理上并不互斥,理论上可以叠加。
- 可比的方法 / 实验差异:IID-Nav 报告工业数据 Recall@500 相对最强基线 +36.35%,本文报告内部 Recall 相对 TTSN +6.0%(2-layer Large+Small 配置)——数字量级差异巨大但完全不可比:基线不同(IID-Nav 对的是图索引/i2i 检索基线,本文对的是双塔 TTSN)、K 不同(500 vs 未披露)、语料与业务不同(快手短视频 vs Meta 广告)。真正可比的一点是训练信号的处理:IID-Nav 专门设计了图硬负采样 + 轨迹感知学习来抑制多跳搜索的累积误差,而本文对「beam search 沿树往下走时误差如何累积」没有任何对应机制,也没有相关分析——这是本文方法论上一个未被覆盖的风险面。
10. 讨论与局限性
10.1 值得借鉴的设计
- 「算力按索引层级分配」是可以直接迁移的架构范式。它的普适形式是:把候选集合组织成金字塔,越往上候选越少、就越用得起复杂模型;越往下候选越多、就必须用便宜模型。Table 1 的理论成本一栏($M_L \times I_1 + M_S \times V$)把这件事写得非常清楚,比任何蒸馏/量化方案都更直白地回答了「大模型的钱该花在哪」。
- 索引节点锚定到代表性真实 item(算法 1 第 15 行)是个务实的小设计:它让虚拟索引节点可以直接复用现有的 item 特征管线去算
- 中间层节点即新监督数据这个观察本身有启发性。它的深层含义是:一个学出来的层次结构不只是检索加速器,它同时是一个「自动发现的类目体系」,而类目体系是可以生成训练信号的。这个视角比论文自己贴的「test-time training」标签更有价值。
10.2 局限与争议
- 「test-time training」这个名号名不副实。论文自己给的 TTT 定义是「在推理阶段更新模型参数、通常不需要 ground-truth 标签」。但 HILL 的实际做法是:先用训练时学好的索引,回溯出
- 核心主张的实验支撑是断开的。方法部分(3.2–3.4)的卖点是「联合训练的索引比离线聚类的索引好」,但:内部实验(Table 1)用的是 full 版但没有与「MoNN + 离线 K-Means 树」做对照,无法分离「分层」与「联合学习」各自的贡献;公开实验(Table 3)用的是 EM 近似版,本质上就是离线 K-Means;唯一的对照是 Table 5 的 full vs EM,差距 0.04% NE,低于论文自己定义的 0.05% 显著性阈值。也就是说,论文最有理论野心的部分恰恰缺少显著的实验证据。
- 公开实验的角色被表格形式误导了。Table 3 把 HILL 与 38 个 CF/GNN baseline 并列,读者会自然地把 HILL 理解为一个检索模型;实际上它是「NESCL + HILL 抽的数据做微调」。真正诚实的写法应该是 NESCL 与 NESCL+HILL 的成对对比。在这个视角下,提升幅度只有 0.3%–0.9%,且在 Amazon-Book 上被 BSPM-LM 大幅拉开(0.0625 vs 0.0733),论文对此完全未做讨论。
- 参数分析没有结论。6.3/6.4 节两张表的数值波动(0.1914–0.1925)小于典型的随机种子噪声,无方差报告、无多次运行,$\phi_{DEP}$ 和 $\phi_{IR}$ 的最优值在 Recall 与 NDCG 之间还互相矛盾,最终采用的配置(0.8, 0.4)两项都不是最优。这一节实质上没有回答「这两个超参怎么调」。
- beam search 的精度损失完全未被量化。论文反复强调 exactness-aware,但从未报告「分层 beam search 相对全量精确打分损失了多少 Recall」,也没有像 AIR-MoE 那样给出近似的理论界。Table 1 的 Recall 是端到端数字,混合了模型容量增益与剪枝损失,两者无法分离。此外,beam width 这一关键超参在全文没有出现过(只在图 3 的示意里提到「宽度为 2」)。
- 工程细节大量缺失,可复现性存疑。论文声称「为强调可复现性首次系统拆解 MoNN」,但 I2IF 只有一句话、OverArch 只说「可用 DHEN/DeepFM/Wukong」、模型尺寸只有 Small/Medium/Large 三个标签而无参数量、索引层数与每层节点数在内部实验中未披露、线上 A/B 的指标定义与实验规模未披露、公开实验的学习率/batch size/训练步数全部缺失。EDBT 的篇幅限制可以解释一部分,但与「可复现性」这个自我定位仍有相当距离。
- 多处数据与排版错误。Table 2 的 Amazon-Book 行密度与用户/物品数不自洽;Table 3 中 GAT (Gowalla) 的 Recall 与 NDCG 完全相同、JKNet (Amazon-Book) 的 NDCG 高于 Recall;Table 6 第 4 行节点数写成
8000, 8000, 80, 8;Table 7 的 $\phi_{DEP}$ 整列应为 2 却全写成 1;式 (15) 与式 (16) 并列给出两个不同的 NE 定义却未说明各自用处。这些都会削弱读者对数值的信任度。 - 方法论可扩展性上的隐忧。HILL 虽然是联合训练,但索引结构(层数、每层节点数 $K$)依然是预先固定的超参,一旦确定,物品的组织粒度就被锁死;当基础模型继续 scaling、表征能力增强时,索引的容量并不会自动跟着长。3.2 节末尾「$c_k = v_j$ if $\arg\min_j d(j,k)$」这一硬锚定操作也让索引节点的表达上限被真实 item 的 embedding 空间限住。论文自己列出的未来方向(给新数据对加权、引入负信号、加对比损失)都集中在 3.6 节的数据侧,对索引结构本身如何随模型一起 scaling 没有讨论。
10.3 工业落地价值
抛开学术上的种种不严谨,这篇论文的工业价值是实打实的:它是少数几篇正面回答「基础检索模型 scaling 之后怎么上线」的论文,而且给出了完整的成本账本和真实的线上收益。三条最可复用的经验是:(1) 先把小模型(MoNN Small)推上生产验证链路,再逐步把大模型往粗层放;(2) 成本模型要写成「单模型成本 × 该层候选数」的形式,这样每一层用多大的模型就变成一个可算的决策;(3) 学出来的索引层次可以反哺训练数据。对任何正在做召回侧模型放大的团队,Table 1 和 Table 8 这两张表本身就值回票价。