Effective Learning Rate Governs Loss Dynamics in Language Model Pretraining¶
arXiv:2608.24814v1 · 2026-08-25 · cs.LG
作者:Zihan Liu^{1,2,*}、Ruiheng Zheng^{1,*}、Shaobo Zhang^1、Changxin Tian^2、Kunlong Chen^2、Zhiqiang Zhang^2、Lei Wu^{1,†}
机构:^1 北京大学(Peking University),^2 蚂蚁集团(Ant Group)。* 表示共同一作(顺序由抛硬币决定),† 通讯作者 Lei Wu([email protected])。致谢中注明 Zihan Liu 受 Ant Group Research Intern Program 资助,Lei Wu 受 NSFC 12522120 / 92470122 / 12288101 资助。
一句话:论文提出并系统验证了 ELR collapse(有效学习率坍缩)——语言模型预训练中,学习率 $\eta$ 与参数范数 $\|W\|_F$ 并不是两个独立的动力学自由度,它们主要通过比值 $\eta/\|W\|_F$(即 ELR)来支配 loss 轨迹;只要 ELR 逐步对齐,即便 LR 与范数轨迹差异巨大,整条 loss 曲线也会以几个 $\times 10^{-3}$ 的平均绝对误差重合,这个误差比换随机种子带来的抖动还小 4–9 倍。
一、研究动机与背景¶
1.1 norm control 是不是一条独立的动力学坐标?¶
大模型预训练的动力学历来被认为由学习率(LR)与 batch size 这类超参主导。近几年 norm control(范数控制) 又加进来一条新轴:它既可以是隐式的——weight decay(Krogh and Hertz, 1991;Loshchilov and Hutter, 2019)通过收缩因子间接约束参数范数;也可以是显式的——Hyperball(Wen et al., 2026)把每个矩阵参数约束到给定 Frobenius 范数的球面上,SSO(Xie et al., 2026)施加谱范数约束,Loshchilov (2023) 的 weight norm control 把参数范数导向指定目标。这类机制被观察到能改善训练稳定性(D'Angelo et al., 2024)、改善超参跨规模迁移(Kosson et al., 2026),并且往往加速收敛。
于是论文提出了那个最朴素但从未被定量回答的问题:
norm control 是否引入了一个支配 loss 动力学的独立自由度?
本文在所研究的区间内给出否定的答案。作者构造出一批 LR 轨迹与参数范数轨迹差异巨大、但逐步匹配同一条 ELR 日程的训练:
$$\eta^{\mathrm{eff}}_k := \frac{\eta_k}{\|W_k\|_F} \tag{1}$$
结论是:当 ELR 日程匹配时,整条 loss 轨迹以仅几个 $\times 10^{-3}$ 的平均绝对差重合。作为对照,在同一配置下仅更换初始化种子或数据顺序种子,成对 loss 平均差是 $10^{-2}$ 量级。作者把这个现象命名为 ELR collapse。它给出一幅简洁的宏观图景:LR 调度与 norm control 不是两个独立的控制器,而是共同实现某一条 ELR 日程的两种不同机制。
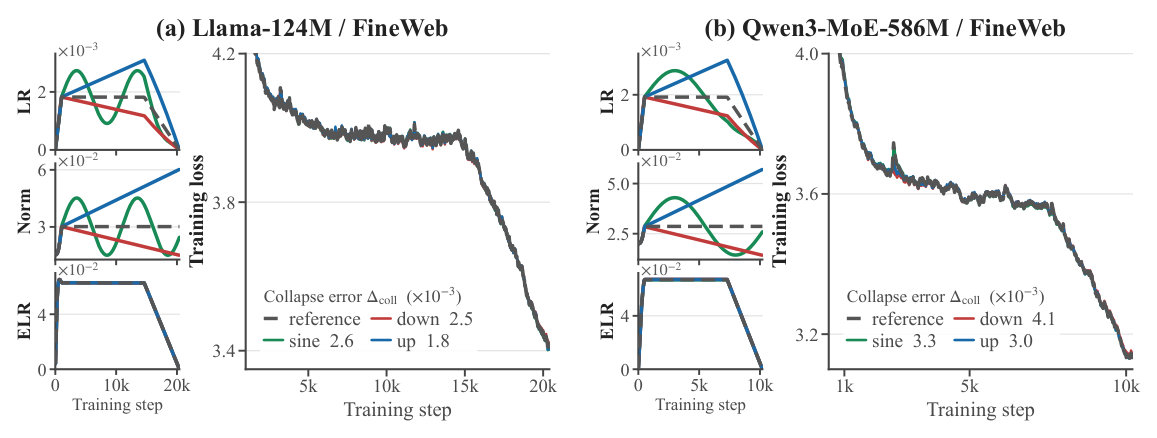
论文在结论章用了一个很好的类比:这种约化类似于密度之于宏观物理系统——质量与体积可以各自变化很大,但决定体相行为的主要是它们的比值密度,而非任一单独量。LR 与范数之于 loss 动力学正是如此。
1.2 为什么这件事不平凡:Transformer 并不尺度不变¶
一个自然的反驳是:ELR 早就是尺度不变(scale-invariant)模型里的经典量,坍缩不过是重参数化对称性的必然推论。作者花了整节(正文 §1 + 附录 A.1)反驳这一点。
在尺度不变目标 $\mathcal{L}(cW) = \mathcal{L}(W)$ 下,loss 只依赖方向 $\widehat{W} = W/\|W\|$。对 GD,支配 $\widehat{W}_k$ 动力学的 ELR 是 $\eta_k/\|W_k\|^2$(Hoffer et al., 2018);对 signSGD、Adam 这类尺度不敏感优化器,对应的 ELR 是 $\eta_k/\|W_k\|$(van Laarhoven, 2017)。这条线(Li and Arora, 2020;Li et al., 2020;Heo et al., 2021;Wan et al., 2021;Kodryan et al., 2022)都是从精确尺度不变性推导 ELR。
但 Transformer 并不满足这个对称性。即便只考虑最强的"仅矩阵参数尺度不变"假设
$$\mathcal{L}(cW, \phi) = \mathcal{L}(W, \phi), \quad \forall c > 0 \tag{2}$$
($W$ 为矩阵参数,$\phi$ 为向量参数如 FFN bias、归一化层 gain),它也同时在两个层面失效:
- 即使 Eq. (2) 精确成立,匹配 ELR 也推不出 loss 轨迹匹配,因为 loss 对 $\phi$ 的尺度仍然敏感;
- Eq. (2) 本身就不成立,原因有四条结构性的:
- Pre-norm 残差块。$h_{\ell+1} = h_\ell + F_\ell\big(\mathrm{RMSNorm}_{\gamma_\ell}(h_\ell); W_\ell\big)$ 中,恒等支路保留 $h_\ell$ 的尺度,而 RMSNorm 把尺度抹掉;因此对上游矩阵做缩放会不对称地影响两条支路。
- Value–Output 投影路径。注意力的 $(HW_V)W_O$ 在 $W_V, W_O$ 同乘 $c$ 时按 $c^2$ 缩放,相对残差流的量级随之改变。
- SwiGLU FFN:$\mathrm{MLP}(H) = \big[\mathrm{SiLU}(HW_G) \odot (HW_U)\big] W_D$,乘性门耦合了多个投影的尺度,而 SiLU 非齐次,因此对 $W_G, W_U, W_D$ 的共同缩放无法被单一全局因子抵消。
- Embedding 与输出 logits:缩放 token embedding 改变初始残差流尺度,且不会被后续残差块消掉;缩放 head 层改变 logit 尺度、进而改变有效 softmax 温度,交叉熵对此不不变。绑定 embedding 时,同一参数同时在网络两端引入尺度依赖。
所以 ELR collapse 不是静态架构对称性的推论。它是一条经验性的宏观律,作者也据此把微观机制显式列为 open problem。
1.3 高精度坍缩也不是自动的¶
论文进一步指出坍缩精度是有条件的,并识别出三个强影响因子:QK-Norm(Henry et al., 2020)、可学习的 RMSNorm gain、以及LR–范数实现的变化时间尺度。其中最反直觉的一条是:固定 RMSNorm gain 会让参数化"更"尺度不变,却把坍缩误差抬高约 3.5 倍。这直接排除了"静态尺度对称性"作为完整解释。
1.4 本文的四层论证¶
作者把主张分成层层加强的四步来测试:
- 规定范数(prescribed-ELR)实验:直接控制范数轨迹,证明现象本身;
- 实际 norm control 中介实验:保留 weight decay / Hyperball 不动,只调 LR 去匹配目标 ELR,看能否复现目标 loss;
- scaling law 迁移:把 Li et al. (2025a) 的 functional scaling law(FSL)中的 LR 换成 ELR,检验在未参与拟合的 norm-control 方案上能否零重拟合外推;
- 解释 delayed acceleration:用 ELR 图景解释"norm control 前期 loss 更高、后期反超"这一反复出现的效应,并把解释转化为控制手段。
二、核心概念与度量¶
2.1 ELR 与两类 norm control¶
设 $W_k$ 是 Transformer 中某个矩阵参数,第 $k$ 步的 LR 为 $\eta_k$,则其 ELR 与 ELR 日程 $\{\eta^{\mathrm{eff}}_k\}_k$ 由 Eq. (1) 定义。
解耦式 weight decay 的更新为
$$W_{k+1} = (1 - \eta_k \lambda) W_k - \eta_k U_k \tag{3}$$
其中 $U_k$ 是优化器的未缩放更新量。它不规定 $\|W_k\|_F$,而是通过收缩因子 $1 - \eta_k\lambda$ 调节范数演化,从而隐式塑造 ELR。
Hyperball(Wen et al., 2026)则把每个矩阵参数约束到半径 $R$ 的球面:
$$W_{k+1} = \mathrm{Norm}_R\big(W_k - \eta_k\,\mathrm{Norm}_R(U_k)\big), \qquad \mathrm{Norm}_R(Q) := R\frac{Q}{\|Q\|_F} \tag{4}$$
注意内层更新可以改写为 $W_k - \dfrac{\eta_k R}{\|U_k\|_F} U_k$,即 $U_k$ 前的实际系数是 $\tilde\eta_k = \eta_k R/\|U_k\|_F$。由于 Hyperball 维持 $\|W_k\|_F = R$,其 ELR 为
$$\eta^{\mathrm{eff}}_k = \frac{\tilde\eta_k}{\|W_k\|_F} = \frac{\eta_k}{\|U_k\|_F} \tag{5}$$
这个优化器相关的 ELR 定义是全文匹配协议的关键:Hyperball 的分母不是参数范数而是更新范数。
2.2 坍缩误差的定义¶
每个坍缩实验都是一次配对受控比较:目标 run 与比较 run 使用相同的参数初始化与数据顺序,其他随机源全部固定,只在被研究的 LR / norm-control 干预上不同。记 $\{L_k\}$ 与 $\{L^{\mathrm{ref}}_k\}$ 为匹配 run 与参考 run 的 loss 轨迹,定义 loss 残差与平均坍缩误差:
$$r_k := L_k - L^{\mathrm{ref}}_k, \qquad \Delta_{\mathrm{coll}} := \frac{1}{|\mathcal{T}|}\sum_{k \in \mathcal{T}} |r_k| \tag{6}$$
$\mathcal{T}$ 是评估坍缩的训练步集合(默认为全部 post-warmup 步)。所有 loss 在计算 $r_k$ 与 $\Delta_{\mathrm{coll}}$ 前先做 $\alpha_{\mathrm{EMA}} = 0.99$ 的指数滑动平均,且逐 run 独立平滑。
2.3 校准:$10^{-3}$ 到底算不算小?¶
论文很坦诚:两条预训练 loss 曲线差多少才算"有意义地不同",并不存在与配置无关的阈值。作者给出两把尺子:
外部惯例:近年 LLM 优化器研究普遍用 $10^{-2}$ 量级的 loss 差来区分优化器与超参选择(Liu et al., 2024, 2025;Wang et al., 2025a,b;Chen et al., 2026)。作者明说这只是实践惯例而非普适阈值。
内部标定(附录 A.2):固定随机性来源 $c$,记 run $i$ 在第 $k$ 步的平滑 loss 为 $L_{i,k}$,定义成对平均绝对差与随机变异:
$$d_{ij} := \frac{1}{|\mathcal{T}|}\sum_{k \in \mathcal{T}}\big|L_{i,k} - L_{j,k}\big|, \quad 1 \leqslant i < j \leqslant n \tag{7}$$
$$\Delta_{\mathrm{stoch}}(c) := \frac{2}{n(n-1)}\sum_{1 \leqslant i < j \leqslant n} d_{ij} \tag{8}$$
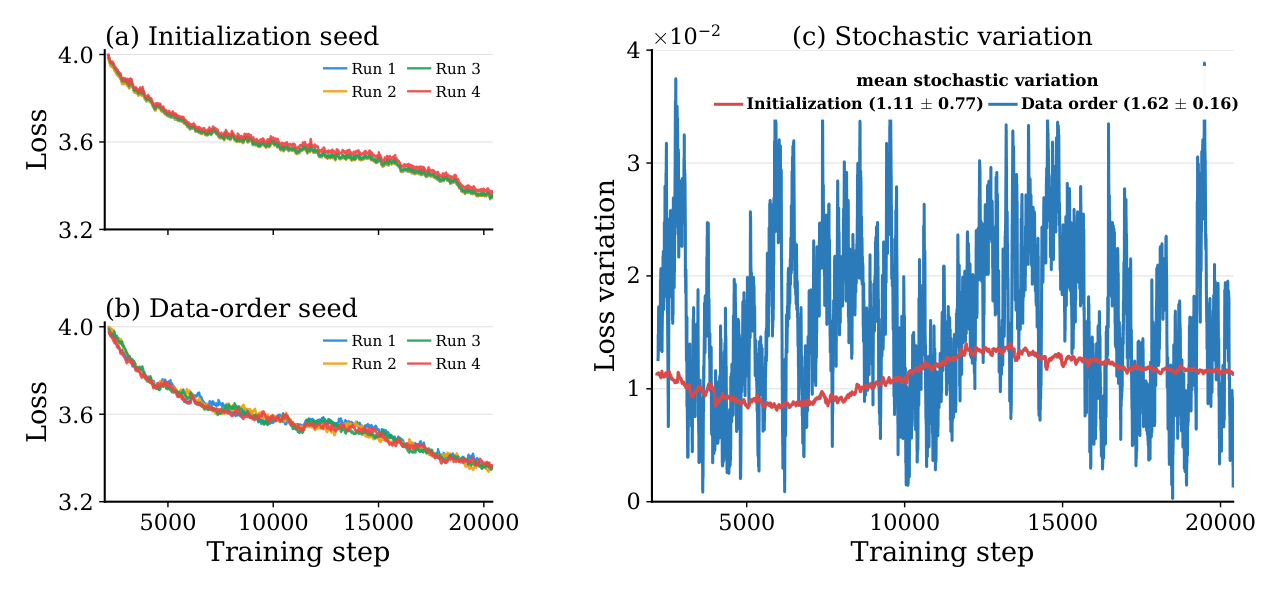
这个定义与 $\Delta_{\mathrm{coll}}$ 同度量,因而可直接比较。在最常用的 Llama-124M / FineWeb / AdamW 配置上重复训练、仅换种子:
$$\Delta_{\mathrm{stoch}}(\text{init}) = 1.11 \times 10^{-2}, \qquad \Delta_{\mathrm{stoch}}(\text{data-order}) = 1.62 \times 10^{-2}$$
而同配置下三条 ELR-matched run(两种种子都固定)的坍缩误差为 $1.8$、$2.5$、$2.6 \times 10^{-3}$。即便是最大的坍缩误差也比更低的那条随机变异基线小 4 倍以上;跨全部报告值,比值在 4.3–9.0 之间。
三、ELR 坍缩:中心实验与跨配置验证¶
3.1 匹配协议(附录 B.2)¶
论文用了两套匹配协议,理解它们是理解全文实验的前提。
协议一:匹配规定的 ELR 日程(prescribed-ELR)。
设参考 run A 的 LR 日程为 $\{\eta^A_k\}$、范数演化为 $R^A_k := \|W^A_k\|_F$,诱导出 ELR 日程
$$\gamma_k := \frac{\eta^A_k}{R^A_k}, \qquad \text{对另一条 LR 日程 } \{\eta^B_k\} \text{,目标范数为 } R^B_k := \frac{\eta^B_k}{\gamma_k} \tag{9}$$
一般地,给定目标 ELR 日程 $\{\eta^{\mathrm{eff}}_k\}_{k \geqslant k_0}$,选定任一 LR 日程 $\{\eta_k\}$,定义范数日程
$$\rho_k := \frac{\eta_k}{\eta^{\mathrm{eff}}_k} \tag{10}$$
并把 LR 日程整体缩放使 $\rho_{k_0} = \|W_{k_0}\|_F$,保证受控阶段起点的连续性。每一步先用 LR $\eta_k$ 施加底层优化器更新得到暂定参数 $\widetilde W_{k+1}$,再投影到下一步的目标范数:
$$W_{k+1} \leftarrow \rho_{k+1}\frac{\widetilde W_{k+1}}{\|\widetilde W_{k+1}\|_F} \tag{11}$$
于是全程 $\|W_k\|_F = \rho_k$,从而 $\eta_k/\|W_k\|_F = \eta_k/\rho_k = \eta^{\mathrm{eff}}_k$。对 Hyperball run,其规定半径本身就提供了范数控制,改为在算出 $U_k$ 后设
$$\eta_k = \eta^{\mathrm{eff}}_k \|U_k\|_F \tag{12}$$
协议二:参考 run 的 ELR 匹配(reference-run matching)。此协议不规定匹配 run 的范数轨迹——它的优化器与 norm-control 机制原封不动,只改 LR。先训练参考 run A 并记录其 ELR:
$$\eta^{\mathrm{eff},A}_k = \begin{cases} \eta^A_k / \|W^A_k\|_F, & \text{A 用直接更新型优化器}\\[2pt] \eta^A_k / \|U^A_k\|_F, & \text{A 用 Hyperball}\end{cases} \tag{13}$$
训练 run B 时设
$$\eta^B_k = \begin{cases} \eta^{\mathrm{eff},A}_k \|W^B_k\|_F, & \text{B 用直接更新型优化器}\\[2pt] \eta^{\mathrm{eff},A}_k \|U^B_k\|_F, & \text{B 用 Hyperball}\end{cases} \tag{14}$$
干预时机:记 $k_0$ 为 warmup 之后的第一个训练步。所有匹配控制与干预都在 $k_0$ 激活;$k_0$ 之前各 run 共享同一 warmup 配置,从同一参数状态进入受控阶段。
3.2 中心实验:两个代表性系统¶
作者取两个代表性系统——稠密 Llama-124M 与 Qwen3-MoE-586M,都用 AdamW 训练。每个设定规定一条共同的 WSD(warmup–stable–decay)ELR 日程,并用四种不同的 LR + 目标范数组合去实现它:参考 run 用 WSD LR 日程,另外三条分别用 linear-up、linear-down、sinusoidal LR,目标范数相应调整以保持规定 ELR。
Figure 1 是全文的中心结果:尽管 LR 与参数范数轨迹差异巨大(例如 Llama panel 中范数在 $3\text{–}6 \times 10^{-2}$ 区间被主动塑形),loss 曲线几乎完全重合。按 linear-up / linear-down / sinusoidal 的顺序:
$$\text{Llama-124M}: \Delta_{\mathrm{coll}} = (1.8,\ 2.5,\ 2.6) \times 10^{-3}$$ $$\text{Qwen3-MoE-586M}: \Delta_{\mathrm{coll}} = (3.0,\ 4.1,\ 3.3) \times 10^{-3}$$
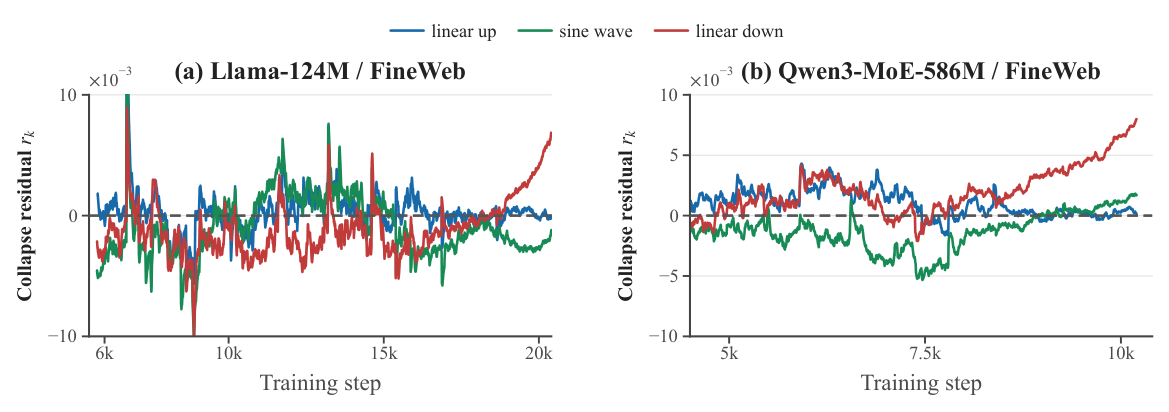
Figure 2 进一步给出全程残差 $r_k$:它们总体围绕零波动、无系统性漂移,虽然存在瞬态偏离。作者据此把 ELR collapse 精确定性为轨迹级的定量一致(平均差几个 $\times 10^{-3}$),而不是 loss 曲线的逐点相等。
3.3 跨配置的广泛验证¶
论文把同一协议推广到:
- 模型:稠密(Llama、Qwen3)、MoE(Qwen3-MoE)、线性注意力(Kimi Delta Attention, KDA;Zhang et al., 2025),规模 100M–1B;
- 数据集:FineWeb、C4、OpenWebText;
- 优化器:AdamW、Muon、Signum。
Table B.1:稠密模型配置与峰值学习率
| 模型 | size | $d_{\mathrm{model}}$ | $d_{\mathrm{FF}}$ | Q/KV heads | depth | peak lr | final lr |
|---|---|---|---|---|---|---|---|
| Llama-124M | 124M | 768 | 3072 | 6 | 12 | $1.8\times10^{-3}$ | 0 |
| Llama-135M | 135M | 576 | 1536 | 9/3 | 30 | $6\times10^{-4}$ | $6\times10^{-5}$ |
| Llama-1B | 1.07B | 2560 | 10240 | 20 | 12 | $3\times10^{-4}$ | 0 |
| Qwen3-145M | 145M | 768 | 2304 | 12/6 | 12 | $1.8\times10^{-3}$ | 0 |
| KDA-127M | 127M | 768 | 3072 | 6 | 12 | $1.8\times10^{-3}$ | 0 |
Table B.2:Qwen3-MoE 配置
| 模型 | size | $d_{\mathrm{model}}$ | $d_{\mathrm{FF}}$ | Q/KV | depth | $n_{\mathrm{experts}}$ | top-k | peak lr | final lr |
|---|---|---|---|---|---|---|---|---|---|
| Qwen3-MoE | 586M | 768 | 576 | 12/4 | 12 | 32 | 4 | $1.8\times10^{-3}$ | 0 |
训练配方:AdamW $\beta_1 = 0.9, \beta_2 = 0.95$;Muon 用 MoonShot 变体(Liu et al., 2025),动量 $\beta = 0.95$;Signum(Bernstein et al., 2018)动量 $\beta = 0.95$。除非显式指定,weight decay 为 0。默认 LR 日程为 WSD(Hu et al., 2024)。所有语言模型实验 batch size $B = 128$、序列长度 1024。Llama 的 124M/1B 实现改自 Modded-NanoGPT,使用 tied embedding、QK-Norm 与 padded 到 50,304 的 GPT-2 词表;Qwen3-MoE 把稠密 MLP 换成 32 专家 top-4 的稀疏 MoE 层;KDA 把每 4 层中的 3 层换成门控线性注意力(3:1 比例)。
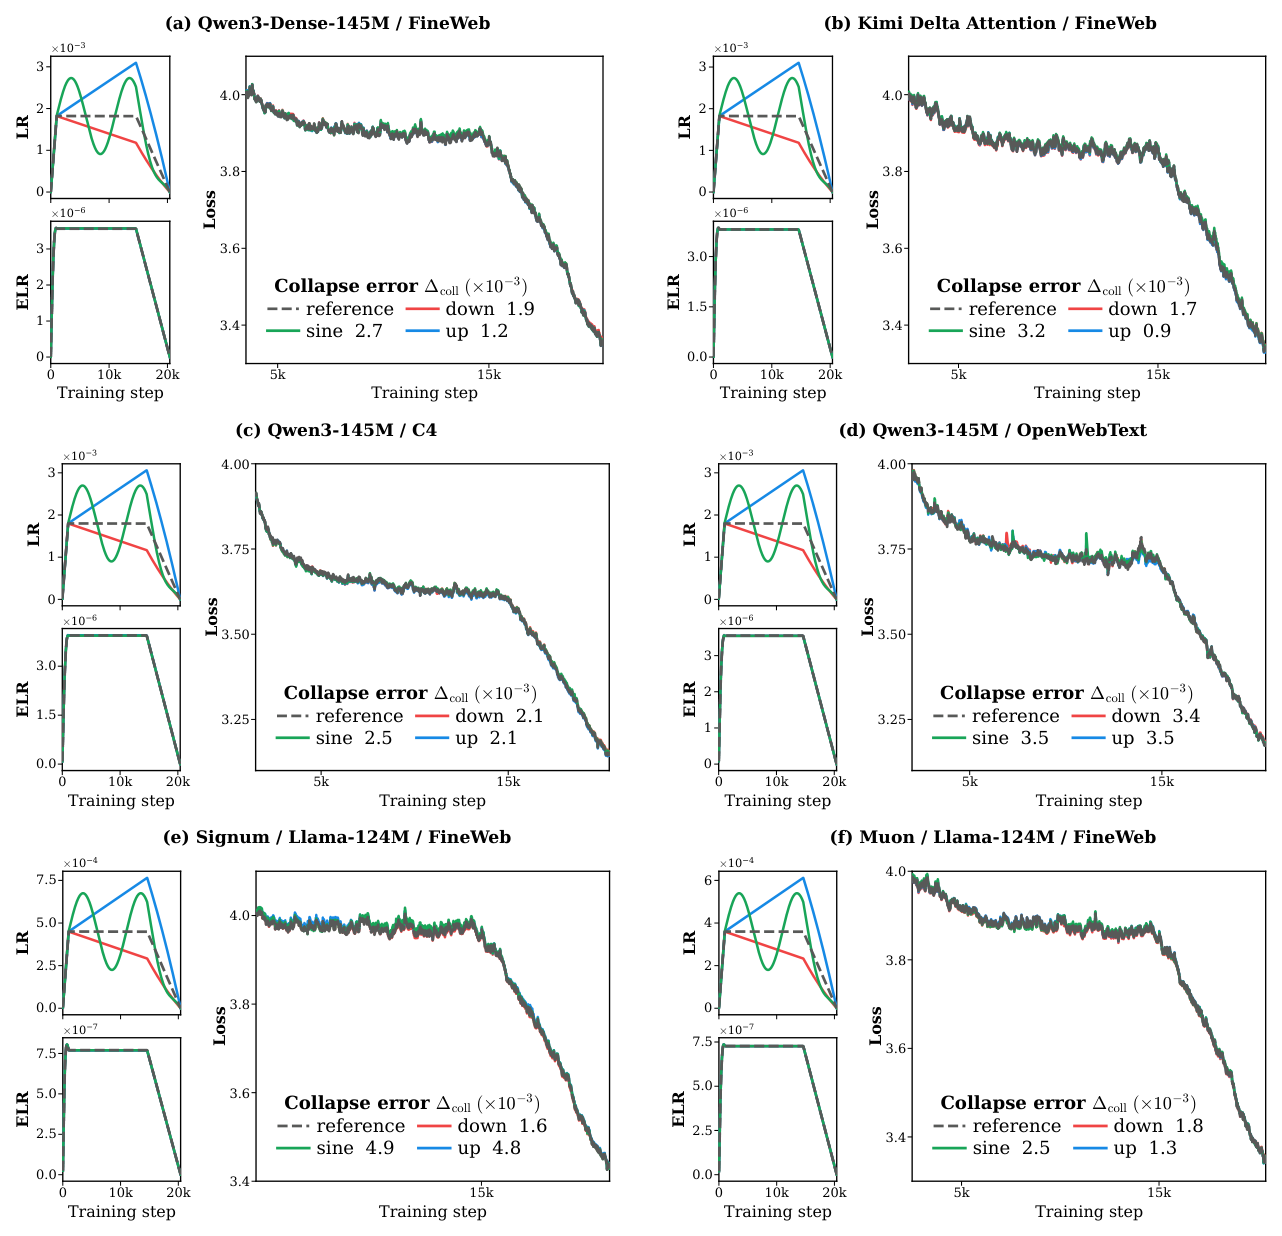
Table C.1:跨规定-ELR 验证设定的坍缩误差(单位 $10^{-3}$)
| No. | 验证设定 | 模型 | 数据集 | Up | Down | Sine | 图 |
|---|---|---|---|---|---|---|---|
| 1 | Dense Llama | Llama-124M | FineWeb | 1.8 | 2.5 | 2.6 | Fig. 1 |
| 2 | MoE | Qwen3-MoE 586M | FineWeb | 3.0 | 4.1 | 3.3 | Fig. 1 |
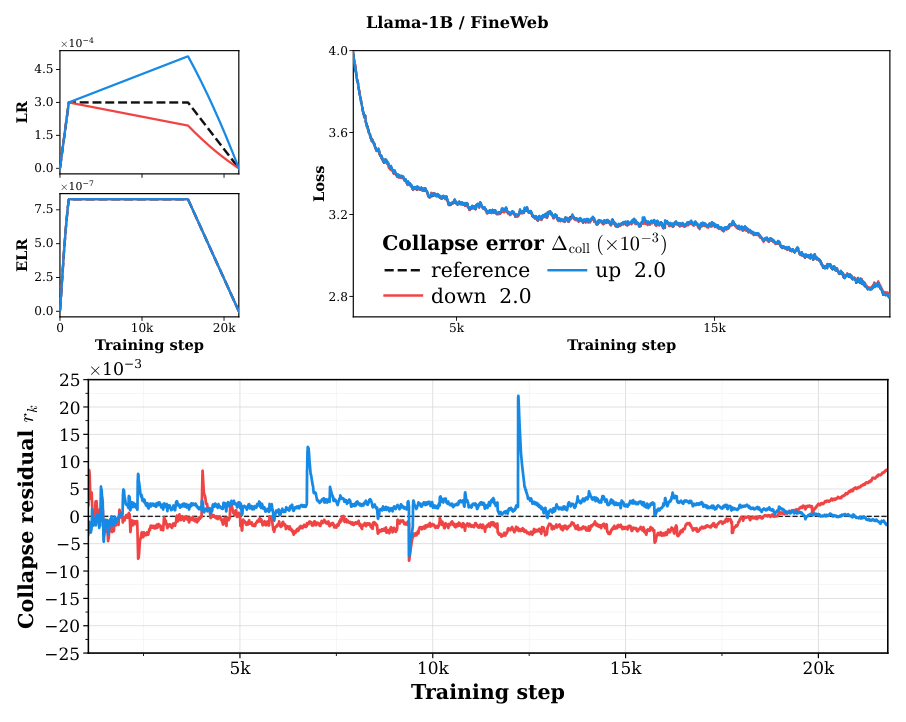
| 3 | 1B scale | Llama-1B | FineWeb | 2.0 | 2.0 | — | Fig. C.1 |
| 4 | Qwen3 Dense | Qwen3-145M | FineWeb | 1.2 | 1.9 | 2.7 | Fig. C.2(a) |
| 5 | Linear attention | KDA-127M | FineWeb | 0.9 | 1.7 | 3.2 | Fig. C.2(b) |
| 6 | C4 | Qwen3-145M | C4 | 2.1 | 2.1 | 2.5 | Fig. C.2(c) |
| 7 | OpenWebText | Qwen3-145M | OpenWebText | 3.5 | 3.4 | 3.5 | Fig. C.2(d) |
| 8 | Signum | Llama-124M | FineWeb | 4.8 | 1.6 | 4.9 | Fig. C.2(e) |
| 9 | Muon | Llama-124M | FineWeb | 1.3 | 1.8 | 2.5 | Fig. C.2(f) |
结论分析:26 组 ELR-matched 比较的中位坍缩误差为 $2.5\times10^{-3}$,且全部低于 $5\times10^{-3}$。值得注意的几点:(i) 现象在 1B 规模上依然成立(Llama-1B 两条实现各 $2.0\times10^{-3}$),说明它不是小模型的特例;(ii) 换到线性注意力(KDA)后坍缩甚至更精确(最好一档 $0.9\times10^{-3}$),说明它不依赖 softmax 注意力的特定结构;(iii) 误差最大的一档出现在 Signum(4.8/1.6/4.9),暗示纯符号型优化器的更新与范数耦合方式可能略偏离 $\eta/\|W\|$ 这一具体形式,但仍在 $5\times10^{-3}$ 以内;(iv) 换数据集(C4、OpenWebText)几乎不改变结论,OpenWebText 上三档统一在 $3.4\text{–}3.5\times10^{-3}$。
四、坍缩何时精确:两条敏感性¶
正文 §4.2 是全文最有价值的诊断部分。既然 Transformer 并不精确尺度不变,高精度坍缩就不来自架构对称性,那它到底依赖什么?作者遍历了一系列参数化与训练配置,一致地浮现出两条敏感性。
4.1 QK-Norm 与可学习 RMSNorm gain 反直觉地锐化坍缩¶
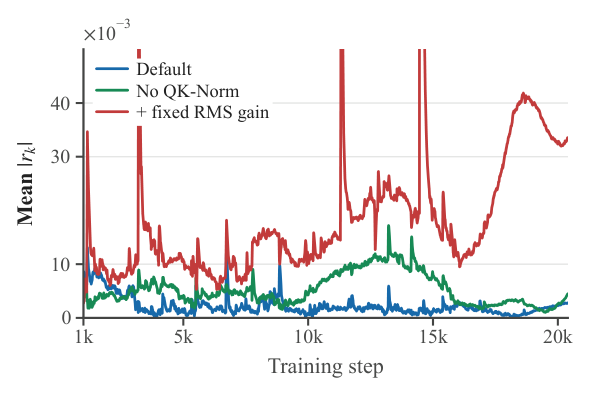
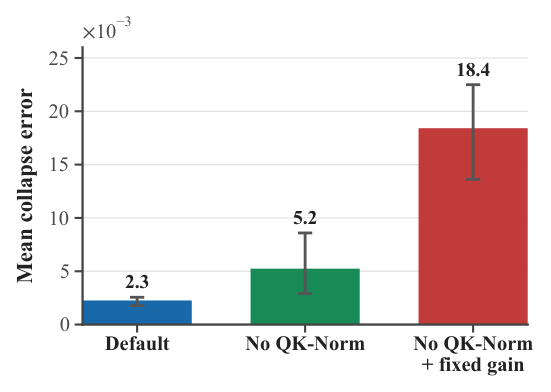
作者的默认模型在 query/key 投影之后施加 QK-Norm(Henry et al., 2020),并在注意力与 FFN 块之前施加带可学习 gain 的 RMSNorm(Zhang and Sennrich, 2019)。虽然在本文的设定下 QK-Norm 并不是训练稳定所必需的,但广泛探索发现它显著改善坍缩精度。作者据此做了三层嵌套消融:默认模型 → 去掉 QK-Norm → 去掉 QK-Norm 且固定 RMSNorm gain,每层都重跑 Figure 1/2 的四日程规定-ELR 协议。
| 配置 | 平均坍缩误差 $\Delta_{\mathrm{coll}}$ |
|---|---|
| Default(QK-Norm + 可学习 RMSNorm gain) | $2.3\times10^{-3}$ |
| No QK-Norm | $5.2\times10^{-3}$ |
| No QK-Norm + fixed RMSNorm gain | $1.84\times10^{-2}$ |
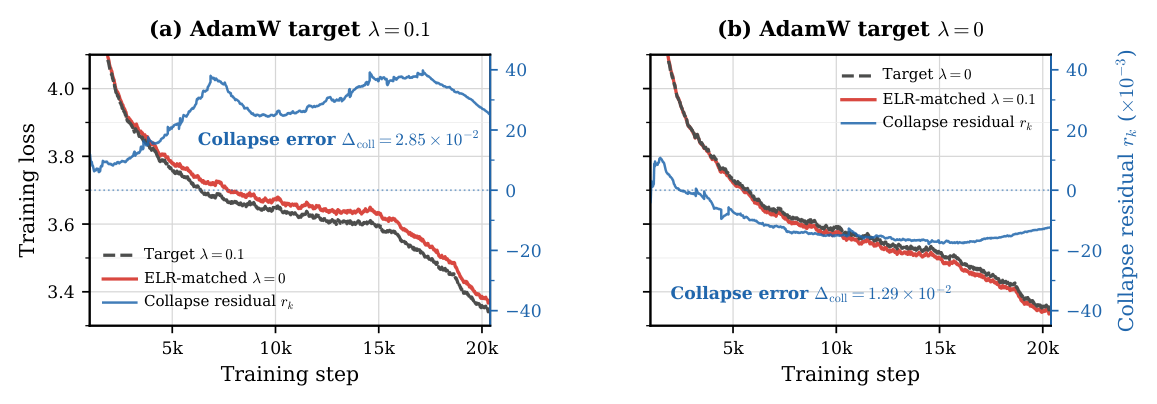
结论分析:组合消融把坍缩误差抬高了近一个数量级。其中 gain 消融极其反直觉——固定 gain 让参数化更加尺度不变,却把误差相对可学习 gain 的对照抬高约 3.5 倍。这条结果单枪匹马就否掉了"静态架构尺度不变性"作为完整解释的可能,并提示归一化与 gain 自适应扮演了某种动力学角色(而非静态对称性角色),其机制作者明确留作 open problem。附录 D.3 还验证了这条依赖不特定于规定范数日程:在只调 LR、范数自由演化的干预下,固定 gain 同样把误差抬到 $10^{-2}$ 量级($2.85\times10^{-2}$ 与 $1.29\times10^{-2}$)。
4.2 LR–范数变化越快,坍缩越差¶
从 WSD LR 日程 $\eta^{\mathrm{WSD}}_k$ 出发,引入正弦调制
$$\eta^{(m)}_k = s_m(k)\,\eta^{\mathrm{WSD}}_k, \qquad s_m(k) = 1 + 0.5\sin\left(\frac{2\pi m k}{N}\right) \tag{15}$$
其中 $N$ 是训练总步数,$m$ 控制振荡周期数。对每个 $m$,把目标范数日程乘以同一个 $s_m(k)$,从而规定的 ELR 日程保持不变。改变 $m$ 就是在保持 ELR 不变的前提下改变 LR–范数实现的时间尺度。
| 调制周期数 $m$ | 2 | 4 | 8 | 16 | 32 |
|---|---|---|---|---|---|
| $\Delta_{\mathrm{coll}}$ ($\times10^{-3}$) | 2.8 | 4.1 | 4.9 | 6.5 | 7.5 |
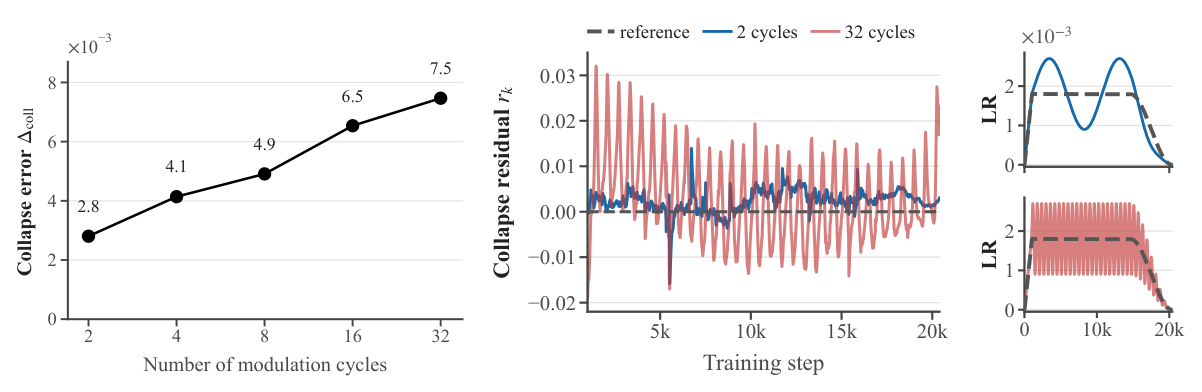
结论分析:坍缩误差随周期数单调上升,从 2 周期的 $2.8\times10^{-3}$ 到 32 周期的 $7.5\times10^{-3}$。右图揭示残差以被施加的频率振荡,快调制下振幅显著更大。因此这种劣化主要是短时间尺度的响应滞后,而非 loss 轨迹的系统性发散。作者由此归纳:ELR 是一个精确但不严格的坐标,坍缩精度依赖归一化设计与 LR–范数联合变化的时间尺度;其起源必然涉及静态尺度不变性之外的训练动力学,作者推测存在某种"具有有限响应时间尺度的动力学补偿机制"。
五、weight decay 与 Hyperball 确实通过 ELR 起作用¶
前面的实验都靠规定范数轨迹建立现象。§5 要回答的是更强的问题:实际使用的 norm-control 方法(不人为规定范数)是否也通过它诱导的 ELR 来影响 loss?
方法论是干净的中介检验:训练一个 norm-controlled 目标 run,记录它诱导的 ELR 轨迹;再训练一个在不同 norm-control 设定下的比较 run,其范数轨迹不加规定、norm-control 机制原封不动,只调 LR 去匹配目标 ELR(即协议二)。若这个 LR-only 干预能在范数轨迹与 norm-control 机制都不同的情况下复现目标 loss 动力学,就说明该方法对 loss 的影响是由 ELR 中介的。
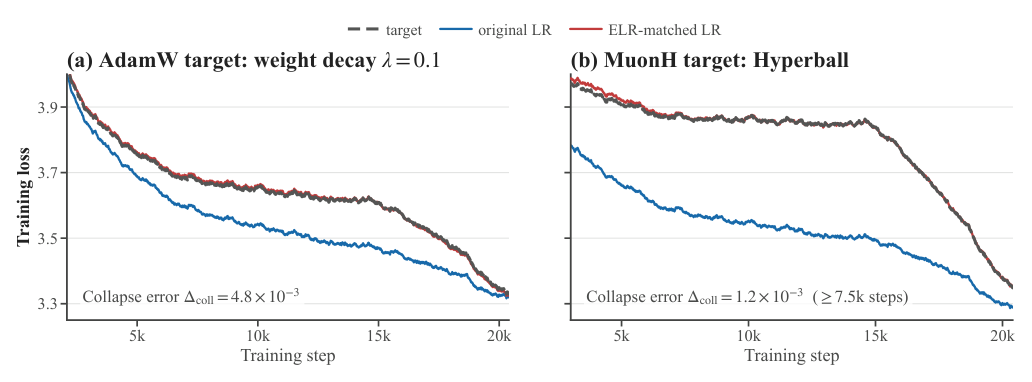
Weight decay(AdamW)。取 $\lambda = 0.1$ 的 AdamW run 作目标,与 $\lambda = 0$ 的 run 比较。在原 LR 日程下,去掉 weight decay 改变了范数演化,loss 轨迹与目标显著偏离。而只把 $\lambda = 0$ run 的 LR 调整为匹配目标 ELR 后,整条 loss 轨迹全程紧贴目标,$\Delta_{\mathrm{coll}} = 4.8\times10^{-3}$(精确值 $4.78\times10^{-3}$)。
Hyperball(Muon)。取 MuonH(Muon + Hyperball)作目标,只调 MuonW(Muon + weight decay)的 LR 去匹配。MuonW 用原 LR 时与 MuonH 显著偏离;ELR 匹配后在一段短暂初始瞬态之后紧密对齐。这个瞬态发生在匹配起始、适配 LR 最大的时刻,因此作者从第 7.5k 步起评估,得到 $\Delta_{\mathrm{coll}} = 1.2\times10^{-3}$(精确值 $1.15\times10^{-3}$)。
反向干预(附录 D)。两个实验都做了方向反转版本,让每种 norm-control 设定轮流充当目标:
| 干预 | 目标 | 被调 LR 的 run | $\Delta_{\mathrm{coll}}$ |
|---|---|---|---|
| AdamW weight decay | $\lambda = 0.1$ | $\lambda = 0$ | $4.78\times10^{-3}$ |
| AdamW weight decay(反向) | $\lambda = 0$ | $\lambda = 0.1$ | $1.77\times10^{-3}$ |
| Muon Hyperball | MuonH | MuonW | $1.15\times10^{-3}$($\geqslant$ 7.5k 步) |
| Muon Hyperball(反向) | MuonW | MuonH | $2.48\times10^{-3}$ |
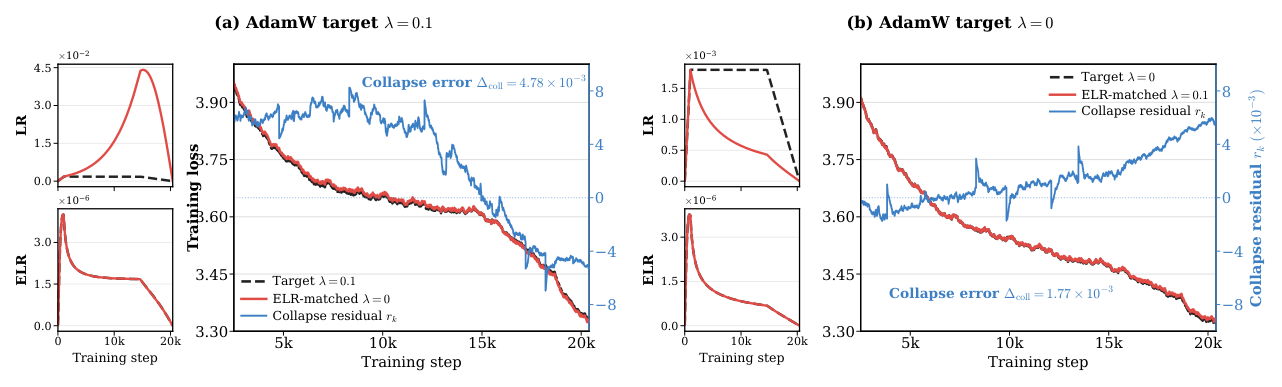
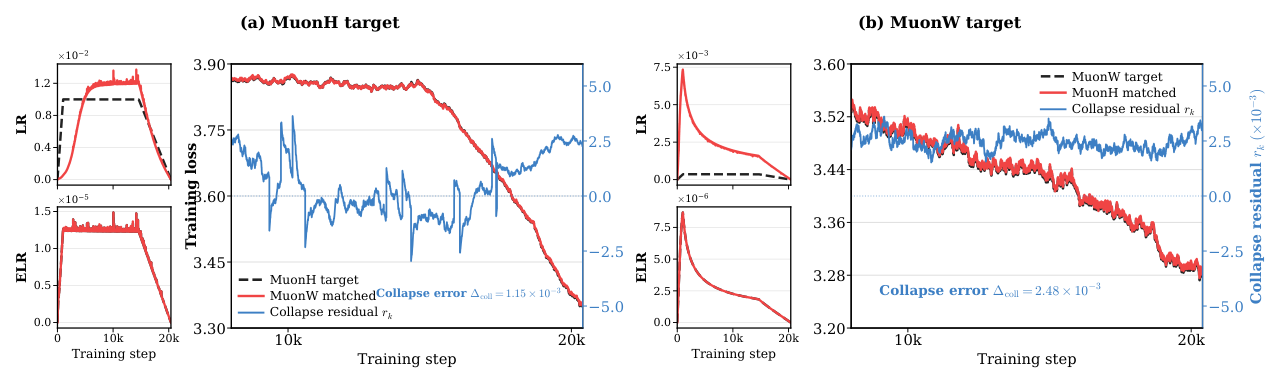
结论分析:由于 $\lambda = 0$ 的 run 范数增长更快,为匹配目标 ELR,它的适配 LR 在训练中大部分时间都在上升,在终末衰减前达到约 $4\times10^{-2}$——这是一个比常规 LR 大两个数量级的值,却依然复现出目标 loss 轨迹,非常有说服力地说明"名义 LR 数值本身并不携带动力学信息"。反向方向同样成立,说明这不是某个特定方向上的巧合。作者也谨慎地补了一句边界:这并不意味着 norm control 一定能改善收敛——它的效果取决于它诱导出怎样的 ELR 轨迹。
六、ELR 让 scaling law 跨 norm-control 方案迁移¶
逐对 ELR 匹配只说明个别轨迹能对齐,不足以说明这些方法服从同一条预测律。§6 提出更强的问题:一条在没有 Hyperball 的数据上拟合的 scaling law,用 ELR 坐标表达后能否迁移到 Hyperball?
6.1 Functional Scaling Law(FSL)¶
Li et al. (2025a) 的 FSL 刻画一般 LR 日程下的 loss 动力学。给定 LR 日程 $\eta = (\eta_0, \ldots, \eta_N)$,定义内蕴训练时间 $t_k := \sum_{j=0}^{k}\eta_j$,FSL 把第 $k$ 步的 loss 建模为
$$L_k = L_\infty + S(t_k) + N_k, \qquad N_k = \sum_{j=0}^{k} K(t_k - t_j)\,\eta_j^2 \tag{16}$$
其中 $L_\infty$ 是不可约 loss;大 $t$ 时信号项与记忆核满足 $S(t) \asymp t^{-s}$、$K(t) \asymp t^{-\gamma}$($s, \gamma > 0$)。信号项随累积训练时间下降,$N_k$ 捕捉沿轨迹累积的优化噪声。于是提高 LR 一方面通过推进内蕴时间加速信号学习,另一方面通过因子 $\eta_j^2$ 加大噪声注入——这个"信号 vs 噪声"的张力是后面解释 delayed acceleration 的全部关键。作者把原始 LR 版本称为 lr-FSL。
elr-FSL 的定义极简:把 Eq. (16) 中所有 $\eta_j$ 换成 $\eta^{\mathrm{eff}}_j$(内蕴时间与噪声项都换),函数形式一字不改。两个模型只差在 loss 动力学是用 LR 还是 ELR 参数化。
具体拟合形式(附录 E)为:给定速率日程 $\{r_j\}$,$t_k = \sum_{j=0}^{k} r_j$,
$$\widehat{L}_k = L_\infty + C_1(B_1 + t_k)^{-a_1} + C_2\sum_{j=0}^{k}(B_2 + t_k - t_j)^{-a_2} r_j^2 \tag{17}$$
两个变体共享这套参数化,只在输入速率日程上不同:
$$r^{\mathrm{lr}}_k = \eta_k, \qquad r^{\mathrm{elr}}_k = \frac{\eta_k}{n_k} \tag{18}$$
其中 $n_k$ 是第 $k$ 步测得的范数尺度:标准训练轨迹取参数的 Frobenius 范数,Hyperball 轨迹取平均更新范数尺度(与 Eq. (5) 的优化器相关定义一致)。
6.2 实验设置¶
在 FineWeb 上训练 Llama-124M 42,000 步(含 1,000 warmup),共十条轨迹:四条不带 weight decay、四条 $\lambda = 0.1$、两条 Hyperball。标准训练峰值 LR $6\times10^{-4}$;Hyperball 直接控制更新范数、峰值 LR $2\times10^{-3}$。四种 LR 日程:WSD-10%、WSD-30%(分别在最后 10% / 30% 步衰减)、cosine、7111(把 post-warmup 步分成 70%/10%/10%/10% 四段,每个段界把 LR 除以 $10^{1/3}$)。
两个 FSL 变体在同样的四条 non-Hyperball 轨迹上拟合;另四条 non-Hyperball 轨迹作为 ID(in-distribution) 留出集,检验对未见 LR 日程的泛化;两条 Hyperball 轨迹作为 OOD,检验对拟合集中完全没有出现过的 norm-control 方法的迁移。拟合细节:联合拟合 7 个参数 $\Theta = (L_\infty, C_1, B_1, a_1, C_2, B_2, a_2)$,loss 先做 0.99 EMA、排除前 2,000 步,800 步 Adam 后接 10 步 L-BFGS 精修,两变体用同一初始化。
6.3 结果¶
(a) 各数据划分上的预测误差(RMSE 均值)
| 评估 | # Runs | lr-FSL RMSE ↓ | elr-FSL RMSE ↓ | $\mathrm{RMSE}_{\mathrm{lr}}/\mathrm{RMSE}_{\mathrm{elr}}$ ↑ |
|---|---|---|---|---|
| Fit | 4 | 0.0183 | 0.0131 | 1.40× |
| ID: held-out | 4 | 0.0239 | 0.0133 | 1.80× |
| OOD: Hyperball | 2 | 0.2508 | 0.0212 | 11.83× |
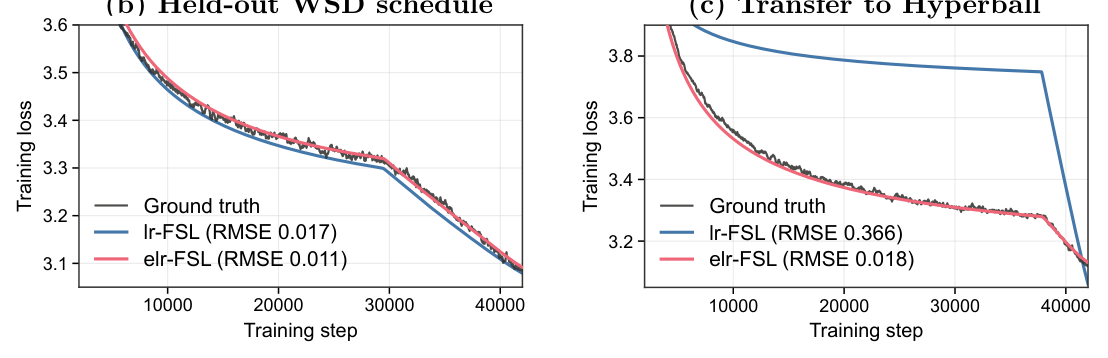
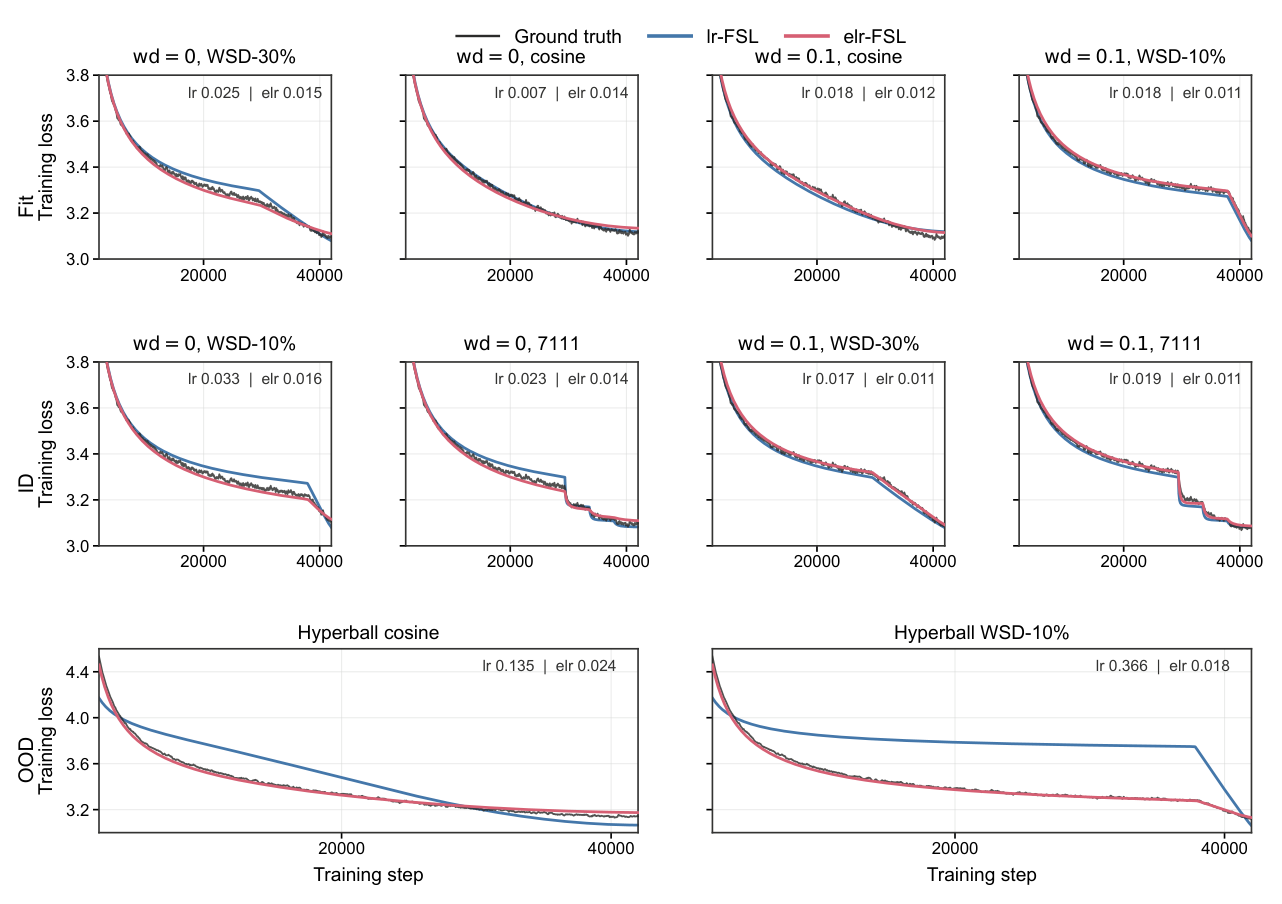
Table E.1:逐轨迹预测误差(Improvement $= \mathrm{RMSE}_{\mathrm{lr}}/\mathrm{RMSE}_{\mathrm{elr}}$,大于 1 favor elr-FSL)
| Split | Trajectory | lr-FSL ↓ | elr-FSL ↓ | Improvement ↑ |
|---|---|---|---|---|
| Fit | wd = 0, WSD-30% | 0.0251 | 0.0150 | 1.68× |
| Fit | wd = 0, cosine | 0.0069 | 0.0138 | 0.50× |
| Fit | wd = 0.1, cosine | 0.0180 | 0.0122 | 1.48× |
| Fit | wd = 0.1, WSD-10% | 0.0184 | 0.0112 | 1.65× |
| ID | wd = 0, WSD-10% | 0.0327 | 0.0160 | 2.05× |
| ID | wd = 0, 7111 | 0.0233 | 0.0143 | 1.63× |
| ID | wd = 0.1, WSD-30% | 0.0172 | 0.0110 | 1.56× |
| ID | wd = 0.1, 7111 | 0.0193 | 0.0113 | 1.70× |
| OOD | Hyperball, cosine | 0.1353 | 0.0241 | 5.61× |
| OOD | Hyperball, WSD-10% | 0.3662 | 0.0183 | 19.96× |
结论分析:
- OOD 迁移是量级差。在两条未见的 Hyperball run 上,elr-FSL 无需重拟合仍保持准确(平均 RMSE 0.0212),而 lr-FSL 出现巨大的系统性偏差(0.2508)。论文正文报的 11.83× 是平均 RMSE 之比;Figure 6 caption 与引言报的 12.9× 是逐 run 改善倍数的平均($(5.61+19.96)/2 \approx 12.8$)。两个数字口径不同,都成立。
- ID 上也有实质提升:0.0239 → 0.0133(1.80×),说明 ELR 的好处不止在 OOD。
- elr-FSL 在 10 条里 9 条更优,唯一的例外是拟合集里的
wd = 0, cosine(0.50×)。这是一个值得注意的诚实细节:在没有 weight decay 且 LR 平滑衰减时,参数范数演化本身平缓,ELR 与 LR 近乎共线,此时 ELR 的重参数化不带来信息增量,反而可能因分母噪声略微劣化拟合。 - 失败模式很有指示性:lr-FSL 在
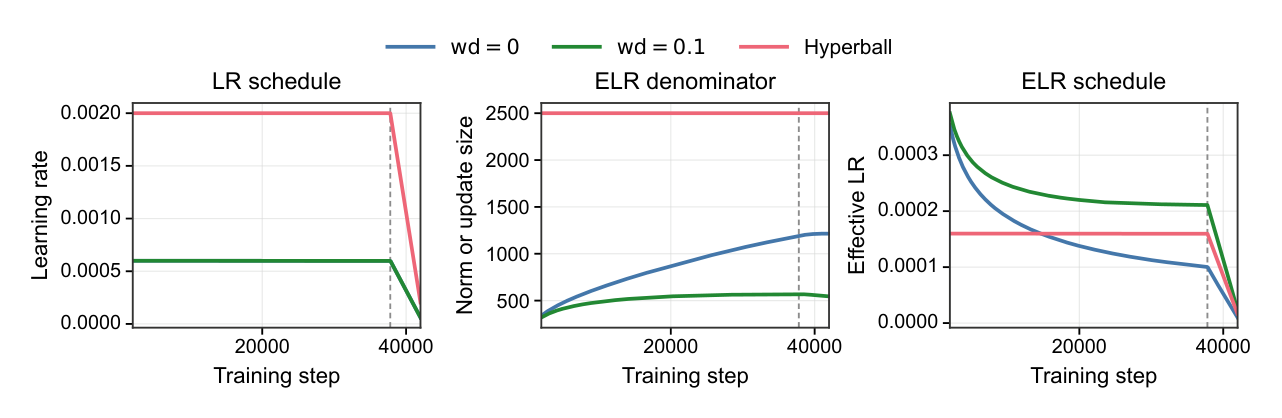
Hyperball, WSD-10%上 RMSE 高达 0.3662——这不是"稍差",而是律本身在该 regime 崩溃。原因见 Figure E.1:Hyperball 的 LR 峰值是标准训练的 3 倍多($2\times10^{-3}$ vs $6\times10^{-4}$),但它的 ELR 分母是更新范数而非参数范数,两者数量级完全不同;用 LR 作坐标时 Hyperball 直接落在拟合域之外,而换成 ELR 后三种 norm-control regime 被放到可比的尺度上。
七、Delayed Acceleration:解释与控制¶
7.1 现象¶
weight decay 对维持大规模训练下的优化器效率往往至关重要(Liu et al., 2025, Fig. 2;Hoffmann et al., 2022, Fig. A7),但它的收益常常很晚才显现:带 weight decay 的 run 前期 loss 更高,后期却反超未正则化基线并取得更低的最终 loss。Hyperball 也表现出同样的定性行为。作者把这个晚显收益命名为 delayed acceleration(延迟加速)。
7.2 机制一:范数增长过早压低 ELR¶
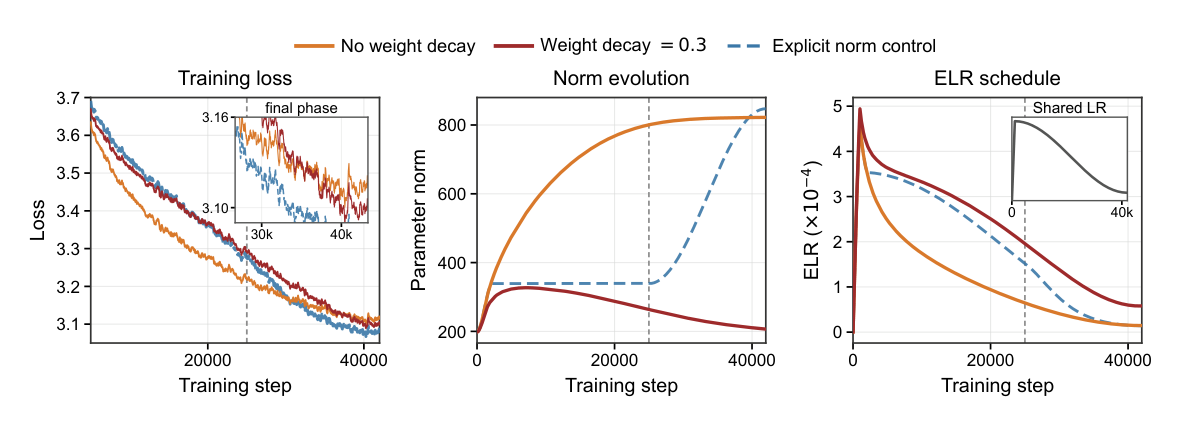
Figure 7 中、右两栏揭示了反转的来源:不带 weight decay 时参数范数稳步增长,使得 $\eta^{\mathrm{eff}}_k = \eta_k/\|W_k\|_F$ 的衰减显著快于名义 LR。weight decay 抑制了这种范数增长,从而把较大的 ELR 维持得更久。于是两条 run 尽管共享同一条 LR 日程,却走在截然不同的有效优化轨迹上。从 ELR 视角看,weight decay 在 loss 动力学中的角色就是防止 ELR 过早衰减。
7.3 机制二:收益早获得、晚显现(FSL 的信号–噪声分解)¶
为什么更大的 ELR 带来的好处是延迟的?FSL 的信号–噪声分解给出解释。令有效训练时间
$$t^{\mathrm{eff}}_k = \sum_{j=0}^{k}\eta^{\mathrm{eff}}_j \tag{19}$$
维持更大的 ELR 让 $t^{\mathrm{eff}}_k$ 累积得更快,从而压低信号学习项 $S(t^{\mathrm{eff}}_k)$。但同一个更大的 ELR 也带来更大的噪声累积(Eq. (16) 中的 $\eta_j^2$ 项),这个噪声会在早期掩盖信号学习优势。随着 ELR 在训练后期衰减,新的噪声注入减少,而此前累积的噪声继续被"遗忘",于是早先获得的优势才作为更低的训练 loss 显现出来。作者的总结很精炼:delayed acceleration 反映的是一种时间上的分离——收益在早期获得,在晚期显现(the gain is acquired early but revealed late)。
7.4 决定性检验:WSD 衰减比例(附录 F.1)¶
cosine 日程下 LR 连续下降,难以独立改变"后期低 ELR 阶段"的时长。作者因此用 WSD 做了一个针对性实验:在 Llama-135M / FineWeb 上固定峰值 LR 与训练预算,只把 WSD 衰减比例从 0.1 改到 0.3。
FSL 的决定性预测是:短衰减期可能在优势显现之前就结束,而更长的衰减期应当让它显现、使带 weight decay 的 run 更早反超。
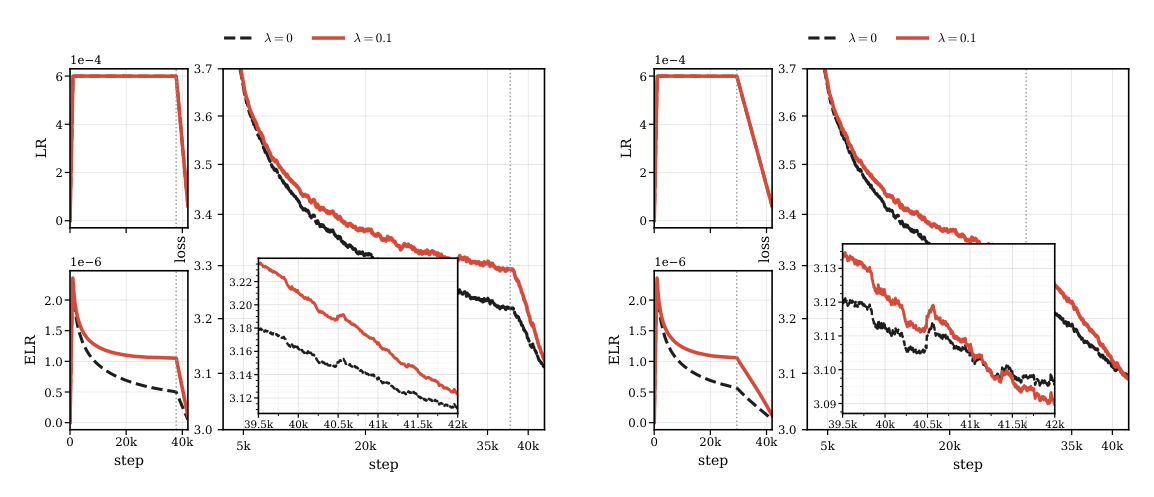
结果:衰减比例 0.1 时,$\lambda = 0.1$ 全程维持比 $\lambda = 0$ 更大的 ELR,但终末衰减太短,训练结束时仍高于未正则化基线;把衰减比例提到 0.3 后,更长的低 ELR 阶段改变了结局,$\lambda = 0.1$ 在衰减期内反超 $\lambda = 0$ 并取得更低最终 loss。这条实验把"早获得、晚显现"从一个事后叙事变成了可证伪的前瞻预测并通过检验,是全文实验设计上最漂亮的一处。
7.5 从解释到控制:ELR 重塑¶
既然解释成立,就可以拿它当设计原则。作者据此改造 $\lambda = 0.3$ 诱导的 ELR 日程:保留其早期相对较大的 ELR,但在后期更激进地压低 ELR。实现方式是一条规定的范数日程——早期近似跟随 $\lambda = 0.3$ run,后期更快地增长范数(Figure 7 中栏虚线之后)。在共享的 LR 日程下,这产生了相近的早期 ELR 与更小的后期 ELR(Figure 7 右栏)。
结果:改造后的 run 既保留了 delayed acceleration,又取得了比 weight decay 基线更低的最终 loss。
这里有一个至关重要的细节:这个改善是通过在后期更快地增大参数范数得到的——也就是说,收益不来自"始终保持较小范数"这一直觉。这直接排除了"范数小本身是好的"这类解释,坐实了norm control 是通过它实现的 ELR 日程来影响 loss 动力学的。作者也如实说明这条规定日程是启发式而非优化得到的。
7.6 Hyperball 下的同一机制(附录 F.2)¶
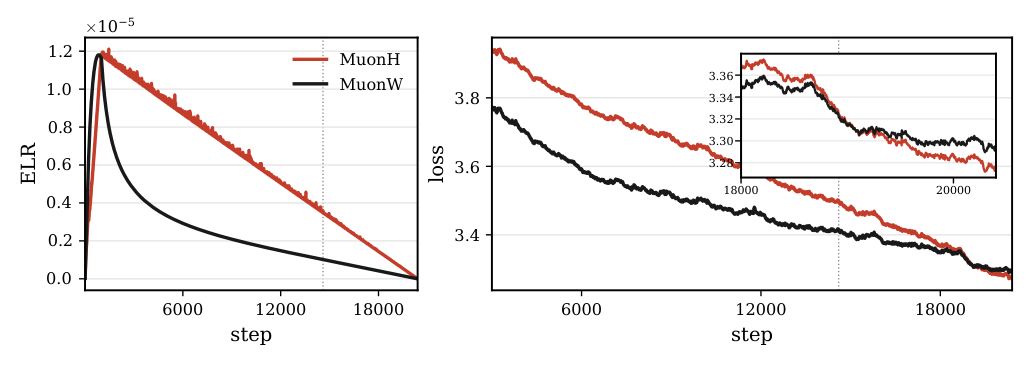
在 Llama-124M / FineWeb 上用线性日程比较 MuonH 与 MuonW:MuonH 早期 loss 更高,随后追上并反超,在训练接近尾声时取得更低 loss。同样的 ELR 机制解释了这一反转:Hyperball 的范数控制相对 MuonW 减缓了 ELR 衰减,在终末衰减前维持更大的 ELR,加速信号学习同时加大噪声累积;终末衰减期 ELR 下降、累积噪声被逐渐遗忘,早先的优势显现。作者还指出 Wen et al. (2026, Fig. 3 右) 报告的 MuonH 轨迹中已经隐约可见这一延迟收益。这与 Figure 5(b) 一致:匹配 MuonH 的归一化更新系数即可以 $1.2\times10^{-3}$ 的误差复现其 loss 轨迹。
八、超出语言模型:ViT / ImageNet 上的验证(附录 G)¶
为检验 ELR collapse 是否超出语言建模,作者在 9.8M 参数的 pre-norm ViT(Dosovitskiy et al., 2021)上重复了范数控制匹配实验,数据集为 ImageNet-1K($64\times64$ 输入)。模型 12 层、隐藏维 256、4 个注意力头、MLP 扩张比 4、$8\times8$ patch,使用 RMSNorm、QK-Norm 与 ReLU 激活。FP32 训练 50,000 步,AdamW $(\beta_1,\beta_2)=(0.9,0.95)$、无 weight decay、全局 batch 512、WSD 日程(1,250 步 warmup 到 $6\times10^{-4}$,保持到 45,000 步后衰减到 $6\times10^{-5}$)。
受控的参数集合包括 patch-projection 仿射参数、class token 与位置编码、以及所有注意力与 MLP 块的仿射参数;RMSNorm gain 与分类头保留基础学习率、排除在规定范数投影之外。
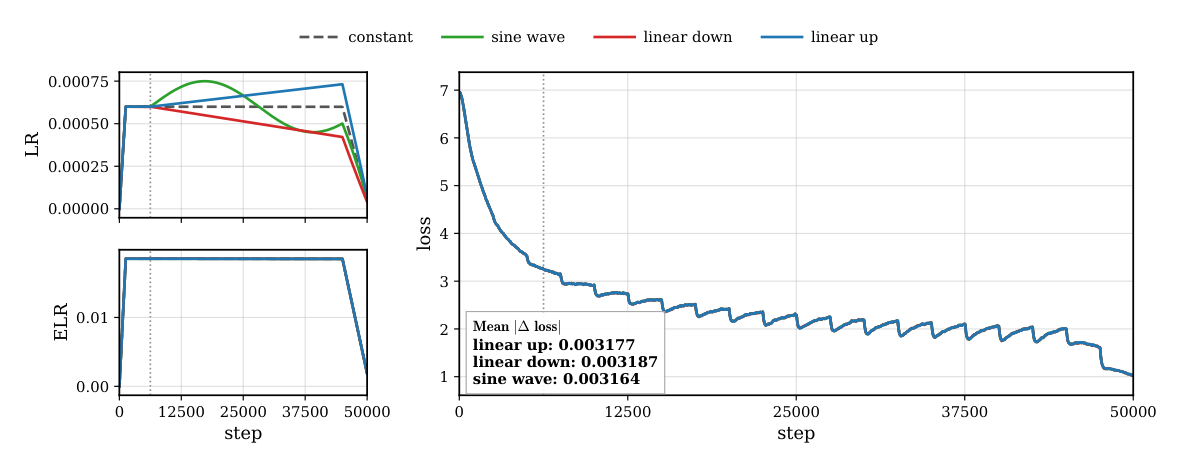
结果:在第 6,250 步分叉出四条 LR / 范数日程不同但 ELR 匹配的 run,三条非常数分支与常数分支保持坍缩,$\Delta_{\mathrm{coll}} \in [3.16, 3.19]\times10^{-3}$(linear up 0.003177、linear down 0.003187、sine wave 0.003164)。
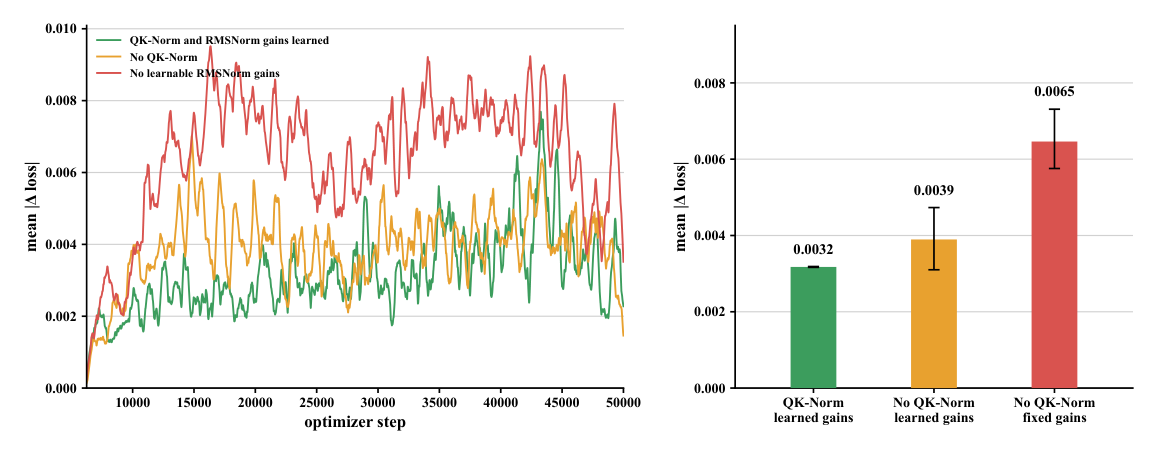
归一化依赖同样复现:三层嵌套变体(QK-Norm + 可学习 gain → 无 QK-Norm + 可学习 gain → 无 QK-Norm + 固定 gain)上,平均坍缩误差从 $3.18\times10^{-3}$ 升到 $3.90\times10^{-3}$,再升到 $6.46\times10^{-3}$——与语言模型上的定性次序完全一致。这条跨模态验证相当有力:它说明 §4.1 那个反直觉的 gain 效应不是语言模型或某个 codebase 的偶然产物。
九、核心贡献总结¶
- 提出并定量确立 ELR collapse:在 LLM 预训练中,LR 与参数范数主要通过比值 $\eta/\|W\|_F$ 支配 loss 动力学。跨 4 类架构(稠密 Llama/Qwen3、MoE、线性注意力 KDA)、3 个数据集、3 种优化器、100M–1B 规模的 26 组对照,中位坍缩误差 $2.5\times10^{-3}$,全部 $< 5\times10^{-3}$,且比同配置的换种子变异小 4.3–9.0 倍。
- 明确划出现象的非平凡性与边界:证明 Transformer 不满足矩阵尺度不变性(pre-norm 残差、$W_VW_O$ 路径、SwiGLU 门控、embedding/head 四条),因此高精度坍缩不是对称性推论;并识别出两条决定精度的因子——归一化设计(QK-Norm、可学习 RMSNorm gain,其中固定 gain 让参数化更尺度不变却使误差涨 3.5 倍)与 LR–范数变化的时间尺度(调制周期 2→32 使误差 2.8→7.5 $\times10^{-3}$)。
- 建立中介关系:保留 norm-control 机制不动、只调 LR 匹配 ELR,即可复现 weight decay($4.8\times10^{-3}$)与 Hyperball($1.2\times10^{-3}$)的目标 loss 动力学,双向验证。
- 实现 scaling law 跨 norm-control 迁移:把 FSL 的 LR 换成 ELR 后,仅用 non-Hyperball 数据拟合的律可零重拟合外推到 Hyperball,RMSE 从 0.2508 降到 0.0212(11.83×,逐 run 均值 12.9×)。
- 解释并主动控制 delayed acceleration:用 ELR + FSL 信号–噪声分解解释"早获得、晚显现",用 WSD 衰减比例实验做前瞻性验证,并通过重塑 ELR 日程(后期加快范数增长)取得比 weight decay 基线更低的最终 loss。
- 提出 ELR-first 的预训练抽象:ELR 日程是设计对象,LR 调度与 norm control 是实现它的机制;跨规模超参迁移可拆成"先定目标 ELR 日程、再选稳定的 LR–范数实现"的两阶段问题。
十、与已归档相关工作的对比¶
Small-Scale Experiments: Are We There Yet? Small-Scale Experiments: Are We There Yet? (FAIR at MSL Meta + NYU, 2026-08-12)¶
关系:独立并发(本文未引用,该文比本文早 13 天)· 已加载对方精读
- 共同关注的问题:两篇论文指向同一个 root cause——预训练 loss 对超参的依赖,其有效维度远低于名义维度。本文的靶子是"LR 与参数范数是两个独立的动力学自由度"这一默认假设,答案是它们塌缩成 1 维的 $\eta/\|W\|_F$;Small-Scale Experiments 的靶子是"小规模 scaling law 不可靠"这一常识,答案是混淆因子在超参,而超参损失面的内蕴维度(有效超参数个数 $\gamma$)随规模下降、最终掉到 1——268M 模型在名义搜索 7–9 个超参时实际只沿一个方向敏感。
- 相近的技术骨架:都不是提出新架构,而是用大批严格受控的训练 run + 一个标量统计量来量化"塌缩"。本文用配对受控比较(同初始化、同数据顺序)与平均绝对轨迹差 $\Delta_{\mathrm{coll}}$;对方用约 4000 次随机搜索与 noisy quadratic 分布 $Q_{\min}(\alpha,\beta,\gamma,\sigma)$ 的尾部拟合。两者也都专门校准了噪声地板——本文测种子变异 $\Delta_{\mathrm{stoch}} = 1.11\text{–}1.62\times10^{-2}$ 作为可信度门槛,对方把 $\sigma$ 作为分布的一个显式参数。
- 本文的差异与推进:塌缩发生的层次不同。对方的塌缩是终点层面的(最终 loss 的边际分布),$\gamma$ 是拟合出来的一个维数,不给出坐标是什么;本文的塌缩是轨迹层面的(全程逐步 loss 重合),而且直接把那条坐标写成解析式 $\eta/\|W_k\|_F$,因而可以被主动构造(规定范数日程)与外插(elr-FSL)。反过来对方覆盖了本文没有的维度:它把 $\gamma$ 的下降归因于参数量而非数据,并给出"小规模高维不宽容、大规模温和低维"的方法论处方。
- 可比的方法/实验差异:本文最大 1B 参数、26 组配对比较、误差单位 $10^{-3}$;对方 4M–268M 有效参数、约 4000 次随机搜索、误差单位是 scaling law 的 test MSE($1.30\times10^{-2} \to 3.70\times10^{-6}$)。有意思的是对方在 §4.2 主动提出了一个未解的张力:$\gamma$ 依赖规模却不依赖架构,且在 μP 这类替代参数化下规模的影响可能改变。本文的 ELR 恰好就是一种"替代参数化",因而两篇合起来给出一个自然的后续问题:在 ELR 坐标下重做那套随机搜索,$\gamma$ 是否会再降一维?
Let's Scale Step by Step: Compute-Efficient Hyperparameter Transfer for Large-Scale Mixture-of-Experts Let's Scale Step by Step: Compute-Efficient Hyperparameter Transfer for Large-Scale MoE (Kakao Corp., 2026-08-20)¶
关系:独立并发(本文未引用 Kakao 这篇,该文比本文早 5 天;本文只引用了 μP 原论文 Yang et al., 2021)· 已加载对方精读
- 共同关注的问题:名义学习率不是一个可迁移的坐标。Kakao 的具体形态是"最优 LR 同时对模型规模与 token 预算敏感,规模一变就要重搜",本文的具体形态是"最优 LR 依赖 norm-control 方案,换 weight decay / Hyperball 就要重调、scaling law 也要重拟合"。两者的解法都是换坐标:找到一个使规律不随该维度改变的重参数化。
- 相近的技术骨架:都把一个多维超参搜索问题降维。Kakao 把 (模型规模 M, token 规模 D) 的二维扫描拆成"μP 消 M 维 + log-log 线性外推消 D 维";本文把 (LR, norm control) 的二维设计空间压成一维 ELR 日程,并在正文 §8 明确提出对应的两阶段抽象——先确定目标规模该用的 ELR 日程,再选一个稳定的 LR–范数实现,这与 Kakao 的两步框架在结构上是同一形状。
- 本文的差异与推进:坐标的性质根本不同。μP 的缩放因子是静态、解析、由 fan-in 决定的($\mathrm{fan\_in}_{base}/\mathrm{fan\_in}$,训练前就能算出),消掉的是模型规模维;ELR 的分母是训练中实测、逐步变化的量($\|W_k\|_F$ 或 $\|U_k\|_F$),消掉的是 norm-control 机制维。因此两者是正交且可叠加的:μP 管跨规模,ELR 管跨 norm-control。本文引用的 Kosson et al. (2026)《Weight decay may matter more than μP for learning rate transfer in practice》正好是连接两条线的桥——如果 weight decay 的作用确实是通过 ELR 中介的(本文 §5 已证),那么该结论就可以被重述为"跨规模迁移中真正需要对齐的是 ELR 日程而非 LR"。
- 可比的方法/实验差异:验证规模差距极大。Kakao 用该配方从零预训练了 155B 总参 / 17B 激活的 MoE,10T token,LR 选择成本约全量的 1%(98× 算力比),并落在 compute-vs-MMLU-Pro 的 Pareto 前沿;本文最大只到 Llama-1B / FineWeb,且明确声明"匹配的 loss 轨迹不蕴含匹配的参数、表征或下游性能"——即完全没有下游评测。所以就工程可信度而言 Kakao 更硬,而本文的贡献在于揭示了一条 Kakao 框架尚未利用的自由度。
Arch-Warmup Taming Curvature: Architecture Warm-Up for Stable Transformer Training (Pluralis Research, 2026-06-15)¶
关系:独立并发(本文未引用,该文比本文早 2 个多月;本文全文未出现 Hessian / eigenvalue / Edge-of-Stability 等词)· 已加载对方精读
- 共同关注的问题:$\eta$ 本身不是动力学量,$\eta$ 与某个沿训练演化的标量的组合才是。Taming Curvature 认为那个组合是 $\eta\,\lambda_{\max}(H)$(Edge of Stability;Adam 下是预条件曲率 $\lambda_{\max}(P_t^{-1/2}HP_t^{-1/2})$),本文认为是 $\eta/\|W_k\|_F$。两篇都把一批看似互不相干的经验技巧(LR warmup、weight decay、QK-Norm、norm 约束)重新解释为同一个有效量的不同实现手段。
- 相近的技术骨架:都是"定义一个 time-varying 有效步长 → 在线测量它 → 用它解释既有技巧 → 反过来用它主动设计训练日程"。Taming Curvature 的测量是热启动 HVP 幂迭代(每步 $<5$ 次 HVP,把 EoS 验证从 $\lesssim25$M 参数推到十亿级),控制手段是 architecture warm-up(早期保持浅层压曲率、LR 衰减后逐层解锁);本文的测量是逐步记录 $\|W_k\|_F$ 或 $\|U_k\|_F$,控制手段是规定范数投影 Eq. (11) 与 LR-only 适配 Eq. (14)。
- 本文的差异与推进:代价与目标都不同。曲率是二阶信息,即便用热启动幂迭代也要每步额外若干次反向传播;ELR 的分母是零阶、几乎免费。目标上,Taming Curvature 管的是稳定性(loss spike、可用 LR 范围),本文管的是 loss 轨迹的定量精度($10^{-3}$ 级重合)——本文甚至明确说 QK-Norm 在其设定下并非训练稳定所必需,却仍显著改善坍缩精度。
- 最有意思的交叉点:两篇对同一个模块给出了互补解释。Taming Curvature 把 QK-Norm / QK-clip 归为"压住预条件曲率、把 $\eta\lambda_{\max}$ 拉回稳定包络"的经验补丁;本文则发现 QK-Norm 会把坍缩误差从 $5.2\times10^{-3}$ 降到 $2.3\times10^{-3}$,且可学习的 RMSNorm gain 也起同向作用,尽管固定 gain 才让参数化更尺度不变。本文把这条反常留作 open problem 并推测存在"有限响应时间尺度的动力学补偿机制"——而 Taming Curvature 提供了一个现成的候选语言:如果归一化 gain 的自适应实质上是在跟踪并抵消曲率的漂移,那么"ELR 坍缩为何依赖可学习 gain"与"曲率为何随深度增长"就可能是同一件事的两个投影。这是两篇论文合起来才浮现出的问题,任一篇单独都提不出来。
十一、讨论与局限性¶
11.1 核心贡献的分量¶
这篇论文最值得称道的地方在于论证的层次感。它没有停在"我们发现 ELR 匹配时 loss 重合"这一条观察上,而是把主张一路推到:(a) 现象在 26 组配置上稳健且误差低于噪声地板;(b) 现象不是平凡对称性的推论,并把不平凡性用四条架构理由写死;(c) 精度是有条件的,条件被定量刻画;(d) 现象能中介实际的 norm-control 方法;(e) 现象能被转化为预测律的迁移;(f) 现象能被转化为控制手段并真的降低最终 loss。这条从"现象 → 边界 → 中介 → 预测 → 控制"的链条,是经验科学式论文里少见的完整度。
方法论上最值得借鉴的三点:
- 给"小差异"建立内部噪声地板。$\Delta_{\mathrm{stoch}}$ 与 $\Delta_{\mathrm{coll}}$ 用同一个度量定义,使得"$2.5\times10^{-3}$ 算不算小"这个问题有了自洽答案,而不是靠"看图很接近"。任何声称"两条 loss 曲线一致"的工作都应该照抄这一步。
- 反向干预。§5 的每个中介实验都做了方向反转($\lambda=0.1$ 为目标 / $\lambda=0$ 为目标;MuonH 为目标 / MuonW 为目标),排除了"某一方向恰好容易匹配"的解释。
- 把解释变成可证伪预测再检验。§7.4 的 WSD 衰减比例实验是全文最强的一处:FSL 的信号–噪声分解预先预言"短衰减期看不到反超、长衰减期能看到",实验随后确认。这比在既有曲线上讲一个自洽故事有力得多。
11.2 局限与争议¶
(1) 作者自陈的最重要限制:结论只限于 loss 动力学。原文明确写道"matched loss trajectories need not imply matched parameters, representations, or downstream performance"。这条限制的分量比它的篇幅大得多——全文没有任何下游评测(无 MMLU、无 few-shot、无任何能力基准)。考虑到 §7.5 提出的 ELR 重塑是要当作训练配方来用的,"最终训练 loss 更低"与"模型更好"之间的缺口在这里是实打实的。对照 Small-Scale Experiments: Are We There Yet? 讨论的 perplexity–capability correspondence——只有在预训练数据保持不变时 loss 才与能力对应——本文的实验确实都固定了数据,所以这条缺口大概率不致命,但依然是未验证的。
(2) 微观机制完全 open。作者非常坦率:为什么 Transformer 训练中大量耦合的自由度能在 loss 层面容纳如此精确的低维描述?为什么精度依赖归一化设计与 LR–范数变化的时间尺度?固定 RMSNorm gain 让参数化更尺度不变却使误差涨 3.5 倍——这条结果本身就是对任何现成理论的证伪。作者只能给出"存在具有有限响应时间尺度的动力学补偿机制"这样一个推测。这意味着 ELR collapse 目前是一条经验律,其适用边界只能由实验划定,无法先验判断。
(3) 规模上限。最大只到 Llama-1B、20k–42k 步、batch 128 × seq 1024。虽然 1B 的坍缩误差($2.0\times10^{-3}$)并不比 124M 差,趋势上没有恶化迹象,但"ELR 日程应当如何随模型规模、batch size、数据预算、训练 horizon 变化"这个真正实用的问题(作者在 §8 自己提出)完全没有回答。相比之下 Let's Scale Step by Step: Compute-Efficient Hyperparameter Transfer for Large-Scale Mixture-of-Experts 那种 155B / 10T token 的端到端验证是本文缺失的一环。
(4) ELR 定义的粗糙之处。Eq. (1) 用的是整体的 Frobenius 范数,而实际实现中每个矩阵参数各自被投影到目标范数(Eq. (11)),论文没有讨论逐层 ELR 是否需要不同日程,也没有讨论向量参数(bias、gain)——它们被排除在受控集合之外(ViT 实验中显式说明 RMSNorm gain 与分类头保留基础 LR),而附录 A.1 又指出 loss 对 $\phi$ 的尺度是敏感的。这在逻辑上留了一个小口子:坍缩之所以成立,是否部分依赖于"向量参数被固定在同一条 LR 日程上"?论文未做这一项消融。
(5) elr-FSL 的一个反例被诚实报告但未被解释。Table E.1 中 wd = 0, cosine 是唯一 elr-FSL 更差的轨迹(0.50×)。作者只列数据不作分析。合理猜测是无 weight decay + 平滑衰减时 ELR 与 LR 近乎共线、重参数化无信息增益,但这只是读者的推断。
(6) Signum 的偏差。Table C.1 中 Signum 是唯一一行有两档超过 $4.8\times10^{-3}$ 的(4.8 / 1.6 / 4.9)。考虑到 signSGD 家族正是 van Laarhoven (2017) 那条 $\eta/\|W\|$ ELR 推导的原始适用对象,这个相对更差的表现有点意外,论文未加评论。
(7) 与并发工作的界定。论文自己点名了两项并发研究:Yang et al. (2026)《On the nonlinearity of learning rate scaling for LLM training》用 ELR 表达最优 LR 以改善跨规模外推;Xiao et al. (2026)《Hyperball may not be a free lunch》推导角度 ELR 并在 weight-decay 与 Hyperball 的 Muon run 之间匹配。作者的差异化论述是清楚的(本文测的是全轨迹级假设、跨配置系统检验、并识别精度条件),但这意味着"ELR 是正确坐标"这个 insight 在 2026 年年中已经被多个团队独立触及,本文的原创性主要在系统性与定量化,而非 insight 本身。
11.3 工业落地价值¶
本文没有工业落地。作者机构含蚂蚁集团(一作为蚂蚁研究实习生,另三位作者为蚂蚁员工),但全部实验为 100M–1B 规模、公开数据集(FineWeb / C4 / OpenWebText / ImageNet-1K)、无任何自研基座模型、无生产系统、无线上 A/B、无 serving 或资源开销讨论。有公司署名不等于工业验证,本文归为 academic。
不过其潜在工程价值是明确的,且成本极低:
- ELR 是零成本可观测量。$\|W_k\|_F$ 在训练中几乎免费,把它连同 LR 一起记进日志,就能得到一条比 LR 更有解释力的曲线。对"换了 weight decay 后 loss 曲线不可比"这类日常困扰,ELR 提供了直接的对齐坐标。
- scaling law 拟合的输入应换成 ELR。§6 的结果(OOD RMSE 0.2508 → 0.0212)说明:只要预训练配方里存在任何形式的 norm control,用 LR 作输入拟合的律在换 norm-control 方案后会崩溃而非仅仅劣化。对需要跨多轮配方迭代复用 scaling law 的团队,这是一条低成本高回报的改动。
- 终末衰减期的长度是可调的杠杆。§7.4 表明 weight decay 的收益能否显现取决于低 ELR 阶段是否足够长。这给"WSD 衰减比例该设多少"提供了机制层面的判据,而非纯经验试错。
- 一条实操原则:先设计 ELR 日程,再选能稳健实现它的 LR 与 norm-control 机制。作者也补了边界——稳定性、数值精度、可迁移性仍是对"如何实现"的额外约束,ELR 不覆盖训练的每一个方面。