DSAIN:面向 CTR 预估的深度情境感知交互网络¶
作者:Yimin Lv, Shuli Wang, Beihong Jin(通讯), Yisong Yu, Yapeng Zhang, Jian Dong, Yongkang Wang, Xingxing Wang, Dong Wang 机构:中国科学院软件研究所 / 中国科学院大学 + 美团(Meituan) 发表:RecSys '23(Singapore, 2023-09-18~22),arXiv 版本 2604.12298v1 于 2026-04-14 提交 代码:https://github.com/W-void/DSAIN
阅读须知(时间线):本文正文是 2023 年 RecSys 的论文,参考文献截止于 2023 年(正文中最新引文为 2023 年的 SIGIR/AAAI 工作),线上 A/B 实验时间为 2022 年 12 月。它在 2026-04-14 才被挂上 arXiv。因此下文所有与 2024 年之后工作的对比,都必须理解为「本文在时间上先行、不可能引用对方」,而不是「本文遗漏了对方」。
一、研究动机与背景¶
CTR 预估是推荐系统与在线广告的核心任务。近年的主线是用户行为序列建模:把用户在 App 上留下的动作轨迹送进模型,推断用户对候选物品的兴趣。
一条行为序列最少只包含用户交互过的 item。但对具体业务场景而言,序列可以被扩充进大量交互的副信息(side information)。本文把副信息分为三类:
- item 相关副信息(品类、品牌等);
- user 相关副信息(年龄、性别等);
- behavior 相关副信息 —— 即行为类型,以及行为发生的时间与(物理或虚拟)位置。
作者的核心判断是:第 3 类(behavior 相关)副信息至今没有被充分利用。回顾已有工作:
- 早期工作(GRU4Rec、Caser)用 RNN/CNN 捕捉序列依赖,但只有 item ID 可用,无法获得行为的语义;
- 一部分工作(ST-PIL、Spatiotemporal-enhanced network 等)利用行为的时空信息建模兴趣;
- 另一部分工作(NMTR、DMT、FeedRec)从多行为序列里抽取行为模式、刻画不同行为类型之间的相关性;
- 还有一部分(Trans2D、NOVA、DIF-SR、CARCA、FDSA、S3-Rec、MISS)把异构副信息接入自注意力。
存在的结构性缺口:现有模型都只聚焦副信息的某一个侧面(要么行为类型,要么时间信息)。没有任何工作能同时把行为类型与行为时空信息一起纳入序列建模,这既浪费了有价值的副信息,也忽略了不同副信息之间复杂的相互依赖。
于是本文提出 situation(情境) 与 situational features(情境特征) 的概念:对一次「用户 × item」的交互而言,行为类型 + 时间特征 + 空间特征共同构成该次交互的一个 situation。以外卖场景为例:
- 时间特征:一天中的小时、一天中的用餐时段(早餐/午餐/晚餐等)、一周中的时段(工作日/周末);
- 空间特征:在用户地理位置不可得时,可把 App 本身视为一个虚拟空间——记录动作触发位置(搜索结果页 / 推荐列表页)的特征,以及标识动作发生处是否为广告位的特征。
每一个 situation 都自带语义。由此引出本文要解决的核心挑战:
给定一次用户行为及其对应的情境特征,在考虑多重内部相关性(包括但不限于同一行为不同情境特征之间的相关性)的前提下,如何为这些情境特征与该行为生成高质量的 embedding?
主要贡献:
- 识别出用户行为序列中的噪声,用重参数化技巧(reparameterization trick)降低噪声干扰;
- 把同类型情境特征的共性与差异合并进其 embedding,并把情境特征 embedding 参数化,用于逼近 item ID 与每个情境特征之间的交互,得到 refined 情境特征表示;
- 设计轻量的三向(tri-directional)相关性建模方案,一致地捕捉跨行为、跨情境特征、跨通道三类相关性;
- 在三个真实数据集(两个公开 + 一个工业)与线上 A/B 上验证:线上 CTR +2.70%、CPM +2.62%、GMV +2.16%。
二、核心方法:DSAIN 架构¶
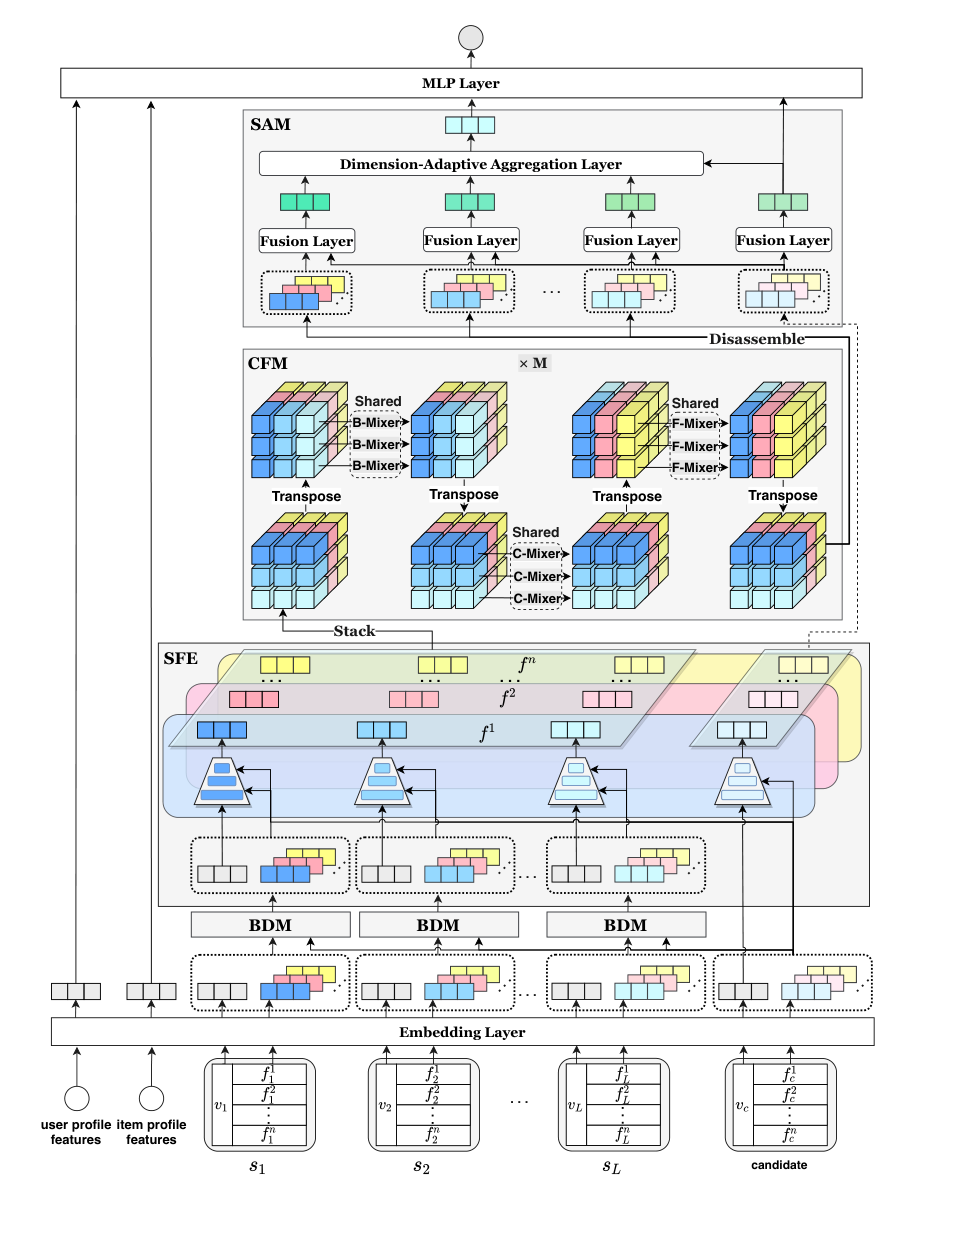
除 embedding 层外,DSAIN 由四个模块构成:
| 模块 | 全称 | 职责 |
|---|---|---|
| BDM | Behavior Denoising Module | 用 Gumbel-Softmax 对历史序列做可微软采样去噪 |
| SFE | Situational Feature Encoder | 融合通用/特化向量,并把情境特征 embedding 参数化为 micro-MLP |
| CFM | Correlation Fusion Module | 三个 MLP mixer 捕捉跨行为 / 跨通道 / 跨情境特征相关性 |
| SAM | Situation Aggregation Module | 维度自适应地把行为表示聚合成序列 embedding |
2.1 问题形式化¶
设 $U, V$ 分别为用户集与 item 集。对用户 $u \in U$,其历史行为序列记为 $S = \{s_i\}_{i=1}^{L}$,$L$ 为序列长度,$s_i = (v_i, B_i)$ 是第 $i$ 个行为,$v_i \in V$ 是交互的 item,$B_i$ 是该行为对应的 situation。设共有 $n$ 类情境特征,则 $B_i = \{f_i^k\}_{k=1}^{n}$,$f_i^k$ 表示行为 $s_i$ 的第 $k$ 个情境特征。此外用当前请求的上下文表示点击候选 $v_c$ 时的当前情境 $C = \{f_c^k\}_{k=1}^{n}$。
以 $\mathcal{X} = \{(u, S)\} \cup \{v_c, C\}$ 为输入、$y \in \{0,1\}$ 为点击标签,CTR 任务形式化为:
$$P(y = 1 \mid \mathcal{X}) = F(\mathcal{X}; \theta) \tag{1}$$
2.2 Embedding 层¶
输入分四组特征:用户画像(user ID、年龄、性别等)、item 画像(item ID、category ID 等)、行为序列、当前请求上下文。关键设计:用两张不同的 embedding table 分别为情境特征与普通特征生成 embedding。查表后得到用户 embedding $\mathbf{u}$、历史 item embedding $\mathbf{v}_i$、行为情境 embedding $\mathbf{B}_i = \{\mathbf{f}_i^k\}_{k=1}^n$、候选 item embedding $\mathbf{v}_c$、当前情境 embedding $\mathbf{C} = \{\mathbf{f}_c^k\}_{k=1}^n$。情境特征 embedding 维度为 $d_1$,其余为 $d_2$(实验中 $d_1 = 144 \gg d_2 = 8$,这个悬殊的比例正是为了给 §2.4 的 micro-MLP 参数化提供足够的参数预算)。
2.3 BDM:行为去噪模块¶
本文考虑的历史行为序列大量混入了曝光(exposed)item —— 它们是在线服务强加给用户的,而非用户主动选择。曝光 item 一定程度上能反映兴趣,但噪声很多,会损害 CTR 模型。
朴素做法是按类目/品牌硬筛 top-$k$ 最相关 item。本文改为软模式:先算 item 与候选的相关性分数,再按概率采样。
$$p_i = \mathrm{sigmoid}\Big( \mathbf{W}_2 \big( \mathbf{v}_i + \mathbf{W}_1 \big( (\mathbf{f}_c^k)\|_{k=1}^n \otimes (\mathbf{f}_i^k)\|_{k=1}^n \big) + \mathbf{v}_c \big) \Big) \tag{2}$$
其中 $\mathbf{W}_1 \in \mathbb{R}^{d_2 \times (n \times d_1)}$、$\mathbf{W}_2 \in \mathbb{R}^{1 \times d_2}$ 可学习,$\otimes$ 为逐元素积,$(\cdot)\|_{k=1}^n$ 表示把 $n$ 个情境特征拼接。$p_i$ 是 $v_i$ 相对候选 $v_c$ 的相关性分数,直接用作 $v_i$ 的保留概率,丢弃概率为 $1 - p_i$。定义二元选择因子 $d_i \in \{0,1\}$。
从 $[p_i, 1-p_i]$ 直接采样是离散、不可微的,会阻断梯度回传。本文借鉴 Gumbel-Softmax,把不可微采样转成从 Gumbel 分布的连续可微采样:
$$\hat{d}_i = \frac{\exp\big((g_0 + \log p_i)/\tau\big)}{\exp\big((g_0 + \log p_i)/\tau\big) + \exp\big((g_1 + \log(1 - p_i))/\tau\big)} \tag{3}$$
$\tau$ 为 softmax 温度;$g_0, g_1$ 是从标准 Gumbel 分布 $G(0,1)$ 独立同分布采样的样本(即先从 $U(0,1)$ 采 $\gamma$,再取 $-\log(-\log \gamma)$)。随后用选择因子更新 item embedding:
$$\hat{\mathbf{v}}_i = \hat{d}_i \mathbf{v}_i \tag{4}$$
设计动机:这是一种「软丢弃」——被判定为噪声的曝光行为其 embedding 被连续地衰减而非硬性剔除,既保留了梯度通路,也避免了硬 top-$k$ 一刀切丢掉边缘有用信息。
2.4 SFE:情境特征编码器¶
SFE 做两件事:(a)合并同类情境特征的共性与差异;(b)把情境特征 embedding 参数化成一个 micro-MLP,用以逼近 item ID 与该情境特征之间的交互。
对第 $k$ 类情境特征 $f^k$($1 \le k \le n$),生成一个通用向量(general vector) $\mathbf{f}^k$(描述该类特征的共性,例如「一周中的时段」这个概念本身),以及特化向量列表(specific vector list) $\{\mathbf{f}^{k,t}\}_{t=1}^{m_k}$,对应该类特征所有取值(如工作日/周末,此时 $m_k = 2$),刻画同类特征内部的差异。
对具体的 $f_i^k$,取其 embedding $\mathbf{f}_i^k$ 作为特化向量,再结合候选信息做门控融合:
$$\mathrm{gate}_{i,k} = \mathrm{sigmoid}\Big( \mathrm{MLP}\big( (\mathbf{v}_c \| \mathbf{f}_c^k) \otimes (\hat{\mathbf{v}}_i \| \mathbf{f}_i^k) \big) \Big) \tag{5}$$
$$\hat{\mathbf{f}}_i^k = \mathrm{gate}_{i,k}\, \mathbf{f}_i^k + (1 - \mathrm{gate}_{i,k})\, \mathbf{f}^k \tag{6}$$
$\|$ 为拼接操作;$\hat{\mathbf{f}}_i^k$ 与 $\mathbf{f}_i^k$ 维度相同($d_1$)。
接着是本文最有辨识度的一步:把 $\hat{\mathbf{f}}_i^k$ reshape 并切分为权重矩阵与偏置向量,作为一个名为 $\mathrm{MLP}_i^k$ 的 micro-MLP 的参数:
$$\big( w_{i,j}^k \,\|\, b_{i,j}^k \big) \Big\|_{j=0}^{D-1} = \hat{\mathbf{f}}_i^k \tag{7}$$
$$\sum_{j=0}^{D-1} \Big( \big| w_{i,j}^k \big| + \big| b_{i,j}^k \big| \Big) = \big| \hat{\mathbf{f}}_i^k \big| = d_1 \tag{8}$$
$w_{i,j}^k, b_{i,j}^k$ 是 $\mathrm{MLP}_i^k$ 第 $j$ 层的权重与偏置,$D$ 决定 micro-MLP 的深度,$|\cdot|$ 取变量规模。最后把去噪后的 item embedding 喂进这个 micro-MLP,得到 refined 的情境特征表示:
$$\mathbf{v}_{i,k} = \mathrm{MLP}_i^k(\hat{\mathbf{v}}_i) \tag{9}$$
这一步的物理含义:情境特征不再是被「加」或「拼」到 item embedding 上的一段向量(那会污染 item ID 的原始表征,正是 NOVA / DIF-SR 一脉批评的问题),而是变成一个作用在 item embedding 上的函数。$\mathrm{MLP}_i^k(\hat{\mathbf{v}}_i)$ 天然逼近了 item ID 与第 $k$ 个情境特征之间的高阶交互,而不是简单的一阶相加。这也解释了为什么 $d_1 = 144$ 要远大于 $d_2 = 8$——$d_1$ 是 micro-MLP 的参数预算,$d_2$ 才是激活维度。
同理可得历史行为 $s_i$ 的 $\{\mathbf{v}_{i,k}\}_{k=1}^n$,以及目标行为(点击候选 $v_c$)的 $\{\mathbf{v}_{c,k}\}_{k=1}^n$。
2.5 CFM:相关性融合模块¶
CFM 一致地学习三个方向的相关性:
- 第一方向:沿行为序列(跨行为);
- 第二方向:同一行为内不同情境特征之间的关系(跨情境特征);
- 第三方向:情境特征 embedding 不同维度(通道)之间的相关性——不同通道包含不同的潜在语义。
CFM 由 $M$ 层同构 block 堆叠,每个 block 含三个基于 MLP 的 mixer:behavior-mixer、channel-mixer、feature-mixer。block 内的顺序是:先对行为序列做 behavior-mixer,再用 channel-mixer 学每个情境特征 embedding 的潜在语义,最后用 feature-mixer 学同一行为内所有情境特征的内在相关性。
两个值得注意的设计取舍:
- CFM 是 MLP-based 的,而 MLP 天然对位置敏感,因此无需引入位置编码——这与基于 Transformer 的一系列方法不同;
- $M$ 层之间参数共享,以减轻训练与线上推理的负担。
预处理:基于 SFE 得到的 $\mathbf{v}_{i,k} \in \mathbb{R}^{d_2}$,先把 $\{\mathbf{v}_{i,k}\}_{i=1}^{L}$ 堆叠成二维矩阵 $\mathbf{V}^k \in \mathbb{R}^{L \times d_2}$,再把 $\{\mathbf{V}^k\}_{k=1}^n$ 堆叠成三维张量 $\mathbf{V} \in \mathbb{R}^{n \times L \times d_2}$。
2.5.1 Behavior-Mixer¶
最简单的实现是把 $\mathbf{V}^k$ 的列向量送进含两层全连接 + 非线性激活的 MLP block,输出同维 embedding(等价于转置后对 $\mathbf{V}^{k\top}$ 的行做变换)。该 mixer 从 $\mathbb{R}^L$ 映射到 $\mathbb{R}^L$,并在 $\mathbf{V}^k$ 所有列间共享:
$$\mathbf{V}^{k,\mathrm{Beh}}_{*,\alpha} = \mathbf{V}^k_{*,\alpha} + \mathbf{W}_2\, \sigma\big( \mathbf{W}_1 \mathrm{LayerNorm}(\mathbf{V}^k_{*,\alpha}) \big), \quad \alpha = 1, \dots, d_2 \tag{10}$$
$\sigma$ 为 GELU,$\mathbf{W}_1 \in \mathbb{R}^{D_L \times L}$、$\mathbf{W}_2 \in \mathbb{R}^{L \times D_L}$,$D_L$ 是 behavior-mixer 的隐藏维度;另配 LayerNorm 与残差连接。
但这个朴素版本有三个问题:(i)把整条长度 $L$ 的序列不加区分地送进同一个 MLP block,会引入噪声干扰;(ii)忽略了由相邻行为构成的行为子序列内部复杂的关系;(iii)子序列之间并非严格独立,其潜在相关性也应被建模。
因此本文用 partition-and-fusion 模式改造 behavior-mixer:按三种不同的划分策略把长度 $L$ 的序列切成三类子序列,各配一个 behavior-mixer。
Adjacent Behavior-Mixer(相邻):设窗口大小 $L_w$($L$ 能被 $L_w$ 整除),从头把序列切成 $\frac{L}{L_w}$ 个段,每段 $L_w$ 个连续行为。第 $\varphi$ 段($\varphi \in \{1, \dots, \frac{L}{L_w}\}$)经过 MLP block($\mathbf{W}_1^\varphi \in \mathbb{R}^{D_{L_w} \times L_w}$、$\mathbf{W}_2^\varphi \in \mathbb{R}^{L_w \times D_{L_w}}$,不同段之间共享):
$$\mathbf{V}^{k,\mathrm{Adj}}_{*,\alpha}\langle \varphi \rangle = \mathbf{V}^{k,\mathrm{Div}}_{*,\alpha}\langle \varphi \rangle + \mathbf{W}_2^\varphi \sigma\big( \mathbf{W}_1^\varphi \mathrm{LayerNorm}\big( \mathbf{V}^{k,\mathrm{Div}}\langle \varphi \rangle \big)_{*,\alpha} \big), \quad \alpha = 1, \dots, d_2 \tag{11}$$
$$\mathbf{V}^{k,\mathrm{Adj}}_{*,\alpha} = \Big( \mathbf{V}^{k,\mathrm{Adj}}_{*,\alpha}\langle \varphi \rangle \Big) \Big\|_{\varphi=1}^{\frac{L}{L_w}}, \quad \alpha = 1, \dots, d_2 \tag{12}$$
Dilated Behavior-Mixer(空洞):受空洞卷积启发,以 $\frac{L}{L_w}$ 为间隔从整条序列上跳采行为,生成 $\frac{L}{L_w}$ 个段,每段由 $L_w$ 个不连续行为组成。它专注长程依赖、忽略相邻行为的局部模式,与 adjacent 互补:
$$\mathbf{V}^{k,\mathrm{Dil}}_{*,\alpha}\langle \varphi' \rangle = \mathbf{V}^{k,\mathrm{Gat}}_{*,\alpha}\langle \varphi' \rangle + \mathbf{W}_2^{\varphi'} \sigma\big( \mathbf{W}_1^{\varphi'} \mathrm{LayerNorm}\big( \mathbf{V}^{k,\mathrm{Gat}}\langle \varphi' \rangle \big)_{*,\alpha} \big), \quad \alpha = 1, \dots, d_2 \tag{13}$$
$$\mathbf{V}^{k,\mathrm{Dil}}_{*,\alpha} = \Big( \mathbf{V}^{k,\mathrm{Dil}}_{*,\alpha}\langle \varphi' \rangle \Big) \Big\|_{\varphi'=1}^{\frac{L}{L_w}}, \quad \alpha = 1, \dots, d_2 \tag{14}$$
Shifted Behavior-Mixer(移位):学习相邻两段之间的相关性,是 adjacent 的另一个补充。把 adjacent 的分段整体偏移 $\lfloor \frac{L_w}{2} \rfloor$;序列头尾未被移位窗口覆盖的若干行为拼成 $\mathbf{V}^{k,\mathrm{Remain}} \in \mathbb{R}^{L_w \times d_2}$,在做 MLP 映射时跳过。移位窗口共生成 $\frac{L}{L_w} - 1$ 个段:
$$\mathbf{V}^{k,\mathrm{Shi}'}_{*,\alpha}\langle \varphi'' \rangle = \mathbf{V}^{k,\mathrm{Sft}}_{*,\alpha}\langle \varphi'' \rangle + \mathbf{W}_2^{\varphi''} \sigma\big( \mathbf{W}_1^{\varphi''} \mathrm{LayerNorm}\big( \mathbf{V}^{k,\mathrm{Sft}}\langle \varphi'' \rangle \big)_{*,\alpha} \big), \quad \alpha = 1, \dots, d_2 \tag{15}$$
$$\mathbf{V}^{k,\mathrm{Shi}}_{*,\alpha} = \mathbf{V}^{k,\mathrm{Remain}}_{*,\alpha} \, \Big\| \, \Big( \mathbf{V}^{k,\mathrm{Shi}'}_{*,\alpha}\langle \varphi'' \rangle \Big) \Big\|_{\varphi''=1}^{\frac{L}{L_w}-1}, \quad \alpha = 1, \dots, d_2 \tag{16}$$
三类互补相关性以可学习权重自适应融合:
$$\mathbf{V}^{k,\mathrm{Beh}} = w_1 \mathbf{V}^{k,\mathrm{Adj}} + w_2 \mathbf{V}^{k,\mathrm{Dil}} + w_3 \mathbf{V}^{k,\mathrm{Shi}} \tag{17}$$
2.5.2 Channel-Mixer¶
channel-mixer 取 $\mathbf{V}^{k,\mathrm{Beh}} \in \mathbb{R}^{L \times d_2}$ 的行向量为输入,从 $\mathbb{R}^{d_2}$ 映射到 $\mathbb{R}^{d_2}$,所有行共享:
$$\mathbf{V}^{k,\mathrm{Cha}}_{\beta,*} = \mathbf{V}^{k,\mathrm{Beh}}_{\beta,*} + \Big( \mathbf{W}_4\, \sigma\big( \mathbf{W}_3 \mathrm{LayerNorm}\big(\mathbf{V}^{k,\mathrm{Beh}}_{\beta,*}\big)^{\top} \big) \Big)^{\top}, \quad \beta = 1, \dots, L \tag{18}$$
$\mathbf{W}_3 \in \mathbb{R}^{D_{d_2} \times d_2}$、$\mathbf{W}_4 \in \mathbb{R}^{d_2 \times D_{d_2}}$,$D_{d_2}$ 为 channel-mixer 隐藏维度。
2.5.3 Feature-Mixer¶
前两步已把跨行为与跨通道相关性注入每个情境特征的 embedding,但所有情境特征之间(它们共同刻画该行为的 situation)的内在关系尚未被捕捉。把 $\mathbf{V}^{k,\mathrm{Cha}}$ 重记为 $\widetilde{\mathbf{V}}^k$,拼接 $n$ 个得到 $\widetilde{\mathbf{V}} \in \mathbb{R}^{n \times L \times d_2}$,转置为 $\mathbb{R}^{L \times d_2 \times n}$,对每个行为 $s_i$ 单独把 $\widetilde{\mathbf{V}}^i \in \mathbb{R}^{d_2 \times n}$ 送进 feature-mixer(从 $\mathbb{R}^n$ 映射到 $\mathbb{R}^n$,各行共享):
$$\widetilde{\mathbf{V}}^{i,\mathrm{Fea}}_{\alpha,*} = \widetilde{\mathbf{V}}^{i}_{\alpha,*} + \Big( \mathbf{W}_6\, \sigma\big( \mathbf{W}_5\, \mathrm{LayerNorm}(\widetilde{\mathbf{V}}^{i})_{\alpha,*}^{\top} \big) \Big)^{\top}, \quad \alpha = 1, \dots, d_2 \tag{19}$$
$\mathbf{W}_5 \in \mathbb{R}^{D_n \times n}$、$\mathbf{W}_6 \in \mathbb{R}^{n \times D_n}$。由于 feature-mixer 排在 behavior-mixer 与 channel-mixer 之后,它不仅建模跨情境特征相关性,还为跨行为与跨通道相关性在所有情境特征之间架起了信息沟通的桥梁——feature-mixer 正是把三个方向一致地连接起来的那一环。
2.6 SAM:情境聚合模块¶
沿 $n$ 轴切分 $\widetilde{\mathbf{V}}^{i,\mathrm{Fea}} \in \mathbb{R}^{d_2 \times n}$,得到历史行为 $s_i$ 的 $\{\tilde{\mathbf{v}}_{i,k}\}_{k=1}^n$。注意:CFM 不作用于目标行为的情境特征,因此 $\{\mathbf{v}_{c,k}\}_{k=1}^n$ 保持 SFE 的输出。SAM 用两种不同方式分别聚合两者。
对目标行为,考虑不同情境特征的重要性差异,按可学习权重 $w_{c,k}$ 聚合:
$$\mathbf{b}_c = \mathrm{MLP}\Big( \mathbf{v}_c + \sum_{k=1}^{n} w_{c,k} \mathbf{v}_{c,k} \Big) \tag{20}$$
对每个历史行为 $s_i$,以目标行为的情境特征为参照动态重加权:
$$w_{i,k} = \mathrm{MLP}\big( \tilde{\mathbf{v}}_{i,k} + \mathbf{v}_{c,k} \otimes \tilde{\mathbf{v}}_{i,k} \big) \tag{21}$$
$$w'_{i,k} = \frac{\exp(w_{i,k})}{\sum_{k=1}^{n} \exp(w_{i,k})} \tag{22}$$
$$\mathbf{b}_i = \mathrm{MLP}\Big( \mathbf{v}_i + \sum_{k=1}^{n} w'_{i,k} \tilde{\mathbf{v}}_{i,k} \Big) \tag{23}$$
随后是通道自适应单元(channel-adaptive unit)。本文明确放弃了 DIN 的做法——DIN 只在 item 粒度算一个标量相似度分数;DSAIN 改为算一个与 $\mathbf{b}_i$ 同维的向量门控因子 $\mathbf{g}_i$:
$$\mathbf{g}_i = \mathrm{sigmoid}\big( \mathbf{W}_g (\mathbf{b}_i \,\|\, (\mathbf{b}_i \otimes \mathbf{b}_c) \,\|\, \mathbf{b}_c) \big) \tag{24}$$
$\mathbf{W}_g \in \mathbb{R}^{d_2 \times 3 d_2}$。最终序列 embedding:
$$\mathbf{e}_s = \frac{1}{L} \sum_{i=1}^{L} \mathbf{g}_i \otimes \mathbf{b}_i \tag{25}$$
2.7 优化目标¶
用户 embedding $\mathbf{u}$、序列 embedding $\mathbf{e}_s$、目标行为 embedding $\mathbf{b}_c$ 以及其余特征 embedding $\mathbf{e}_o$ 拼接后送入 MLP:
$$\hat{y} = \mathrm{sigmoid}\big( \mathrm{MLP}(\mathbf{u} \,\|\, \mathbf{e}_s \,\|\, \mathbf{b}_c \,\|\, \mathbf{e}_o) \big) \tag{26}$$
以负对数似然优化:
$$\mathcal{L} = -\frac{1}{N} \sum_{i=1}^{N} \big( y_i \log \hat{y}_i + (1 - y_i) \log(1 - \hat{y}_i) \big) \tag{27}$$
2.8 复杂度分析¶
空间复杂度:可学习参数来自 item embedding($O(|V| d_2)$)、情境特征 embedding($O(n d_1)$),以及 BDM($O(n d_1 d_2)$)、CFM($O(n L_w D_{L_w} + n d_2 D_{d_2} + n D_n)$)、SAM($O(d_2^2)$);SFE 没有额外参数(其「参数」来自情境特征 embedding 的重解释)。记 $d_1 = \delta d_2$($\delta$ 为常数),$L_w, D_{L_w}, D_{d_2}, D_n$ 都是较小的超参,故总参数量为 $O(|V| d_2 + n d_2^2)$,由于 $n$ 很有限,这相对经典有效方法(如 FeedRec 的 $O(|V| d + d^2)$)仍属适中。
时间复杂度:BDM $O(L n d_1 d_2)$、SFE $O(L n (d_1 + d_2 + d_2^2))$、CFM $O(M L n d_2)$、SAM $O(L d_2^2)$,总计 $O(L n d_2^2 + M L n d_2)$。由于 $n$ 与 $M$ 都较小,计算成本相对其他 CTR 模型(如 FeedRec 的 $O(n d^2 + n^2 d)$)没有增加。一个便利性质是:序列中所有 item 的计算完全可并行,适合 GPU 加速。
三、实验设置¶
围绕四个研究问题展开:RQ1 DSAIN 是否优于已有 CTR 模型;RQ2 四个模块各自贡献如何;RQ3 关键超参如何影响性能;RQ4 线上真实生产环境(美团外卖)的表现如何。
3.1 数据集¶
Table 1. 数据集统计
| 数据集 | #Users | #Items | #Categories | #Behaviors |
|---|---|---|---|---|
| Taobao | 1,141,729 | 99,815 | 6,769 | 26,557,961 |
| Eleme | 14,427,689 | 7,446,116 | 10 | 177,114,244 |
| Meituan | 130,648,310 | 14,054,691 | 184 | 1,331,247,488 |
- Taobao(公开,tianchi 数据集 56):淘宝展示广告系统日志,8 天内 114 万用户的 2600 万+ 交互。每条样本含 user ID、时间戳、行为类型、item 品牌 ID、品类 ID 五个特征。注意该数据集不含 item ID,用品牌 ID 代替。本文基于时间戳构造时间特征,与行为类型共同构成情境特征。
- Eleme(公开,tianchi 数据集 131047):饿了么服务日志,8 天内的交互。除行为类型外天然含丰富时间特征(一天中的小时、工作日/周末等)。
- Meituan(工业):美团外卖平台,30 天内 1.3 亿用户的 13 亿条交互。除行为类型与时间特征(早/午/晚餐时段、工作日/周末)外,还含行为相关的空间信息——行为发生的页面(搜索结果页 / 推荐列表页)。
三个数据集的情境特征覆盖度是递进的:Taobao 只有时间 + 行为类型,Eleme 时间更丰富,只有 Meituan 同时含时间与空间。
3.2 对比模型¶
八个 baseline,分三组:
- Group I(把行为副信息当作普通特征):DIN(局部激活单元按候选动态重加权历史行为)、DIEN(在 DIN 基础上加兴趣演化层)、CAN(用 co-action 单元解耦表征学习与特征交互建模,配多阶增强与多层独立性)。
- Group II(对行为类型建模):DMT(Deep Multifaceted Transformers 建模多样行为序列 + MMoE 多目标 + Bias DNN 降低隐式反馈选择偏差)、FeedRec(融合各类显式/隐式用户反馈推断兴趣)。
- Group III(对行为时间/空间信息建模):CARCA(多头自注意力捕捉上下文特征与 item 属性的动态)、Trans2D(attention2D 从多属性序列学 item-item、attribute-attribute、item-attribute 模式)、DIF-SR(解耦行为副信息与 item embedding,防止信息纠缠)。
3.3 评估指标与实现细节¶
离线用 AUC 与 Logloss(AUC 越大越好,Logloss 越小越好)。作者引用 DIN 的论断:AUC 的微小提升往往带来线上 CTR 的显著增长。线上用 CTR、CPM、GMV。
实现细节(TensorFlow):所有模型统一用 Adam,学习率固定 0.001;参数以均值 0、标准差 0.01 的正态分布初始化。DSAIN 专属超参:$L = 300$、$L_w = 30$、$n = 5$、$d_1 = 144$、$d_2 = 8$;BDM 温度 $\tau = 1$;CFM 层深 $M = 4$;三个 mixer 的隐藏维度 $D_{L_w} = 10$、$D_{d_2} = 16$、$D_n = 8$。
四、主要实验结果¶
4.1 整体性能(RQ1)¶
Table 2. 性能对比(每行最优加粗,次优下划线;所有实验重复三次,baseline 报最优、DSAIN 报均值±标准差)
| 数据集 | 指标 | DIN | DIEN | CAN | DMT | FeedRec | CARCA | Trans2D | DIF-SR | DSAIN |
|---|---|---|---|---|---|---|---|---|---|---|
| Taobao | AUC | 0.6223 | 0.6241 | 0.6276 | 0.6268 | 0.6312 | 0.6289 | 0.6303 | 0.6330 | 0.6452 ± 0.5‰ |
| Taobao | Logloss | 0.2622 | 0.2618 | 0.2607 | 0.2611 | 0.2592 | 0.2603 | 0.2599 | 0.2588 | 0.2571 ± 0.1‰ |
| Eleme | AUC | 0.6368 | 0.6420 | 0.6450 | 0.6435 | 0.6477 | 0.6455 | 0.6464 | 0.6502 | 0.6634 ± 0.4‰ |
| Eleme | Logloss | 0.1245 | 0.1198 | 0.1157 | 0.1173 | 0.1143 | 0.1152 | 0.1149 | 0.1135 | 0.1116 ± 0.1‰ |
| Meituan | AUC | 0.6577 | 0.6612 | 0.6645 | 0.6635 | 0.6715 | 0.6683 | 0.6709 | 0.6740 | 0.6823 ± 0.4‰ |
| Meituan | Logloss | 0.1922 | 0.1884 | 0.1855 | 0.1861 | 0.1819 | 0.1842 | 0.1825 | 0.1799 | 0.1763 ± 0.1‰ |
结论分析(原文给出三条观察):
- Group II 的 FeedRec 优于 Group I 全部模型,Group III 的 DIF-SR 优于 I、II、III 中所有其他模型 —— 说明充分利用行为副信息确有意义。
- Group II 的 DMT 优于 Group I 的 DIN 与 DIEN,却略逊于 Group I 的 CAN;Group III 的 CARCA 与 Trans2D 超过 Group I 全部与 Group II 的 DMT,却略逊于 Group II 的 FeedRec。这说明性能提升不仅取决于用了多丰富的交互信息,模型架构本身同样举足轻重——这是本文一个相当克制的自省式观察。
- DSAIN 在所有数据集上一致超过全部 baseline,取得 SOTA。作者归因:所有竞争者要么低估了行为副信息,要么没能捕捉行为序列中隐含的多方向相关性——尤其是不同情境特征之间的依赖。
从相对幅度看,DSAIN 相对次优的 DIF-SR,AUC 提升为 Taobao +1.93%、Eleme +2.03%、Meituan +1.23%;相对最弱的 DIN 则达到 +3.68% / +4.18% / +3.74%。工业数据集上的相对增幅小于公开数据集,符合工业场景 baseline 更强的直觉。
4.2 消融实验(RQ2)¶
消融全部在 Meituan 工业数据集上进行(DSAIN 全量 AUC 0.6823 / Logloss 0.1763)。
4.2.1 BDM 的作用¶
变体:DSAIN*₁ 直接去掉 BDM,原始历史序列不做任何处理;DSAIN*₂($x$) 在每个点击 item 前只保留指定数量 $x$ 个曝光 item、丢弃其余,$x \in \{2,4,8,12,16,20\}$。
Table 3. 不同 BDM 变体的性能
| DSAIN*₁ | DSAIN*₂(2) | DSAIN*₂(4) | DSAIN*₂(8) | DSAIN*₂(12) | DSAIN*₂(16) | DSAIN*₂(20) | DSAIN | |
|---|---|---|---|---|---|---|---|---|
| AUC | 0.6808 | 0.6778 | 0.6797 | 0.6808 | 0.6811 | 0.6804 | 0.6803 | 0.6823 |
| Logloss | 0.1765 | 0.1770 | 0.1767 | 0.1764 | 0.1764 | 0.1767 | 0.1765 | 0.1763 |
分析:(1)DSAIN 一致优于 DSAIN*₁ 与所有 DSAIN*₂(·),证实 BDM 有效。(2)只保留 2 个曝光时性能最差(0.6778)——本文的历史序列含大量曝光而点击相对稀疏,几乎丢光曝光会连带丢掉太多有价值信息;$x$ 从 2 增到 12 性能上升(0.6778 → 0.6811),但从 12 继续增大反而下降(0.6804 / 0.6803),因为过量曝光引入噪声干扰。这条曲线的倒 U 型正是 BDM 存在的实证依据:硬阈值需要人工调参且只能取一个折中点,而 Gumbel-Softmax 软采样能按候选逐样本自适应。
4.2.2 SFE 的作用¶
变体:DSAIN†₁ 用对所有 $\hat{\mathbf{f}}_i^k$ 的平均池化 + 与 item embedding $\hat{\mathbf{v}}_i$ 拼接来替代 SFE;DSAIN†₂ 先对所有 $\hat{\mathbf{f}}_i^k$ 平均池化得 $\bar{\mathbf{f}}_i^k$,再把它切成 micro-MLP 的权重与偏置、把 $\hat{\mathbf{v}}_i$ 喂进去;DSAIN†₃ 把 $\hat{\mathbf{v}}_i$ 与每个 $\hat{\mathbf{f}}_i^k$ 直接拼接生成 $\mathbf{v}_{i,k}$(即去掉 micro-MLP);DSAIN†₄ 只用特化向量 $\mathbf{f}_i^k$、丢掉通用向量 $\mathbf{f}^k$。
Table 4. 不同 SFE 变体的性能
| DSAIN†₁ | DSAIN†₂ | DSAIN†₃ | DSAIN†₄ | DSAIN | |
|---|---|---|---|---|---|
| AUC | 0.6790 | 0.6795 | 0.6801 | 0.6810 | 0.6823 |
| Logloss | 0.1766 | 0.1766 | 0.1765 | 0.1764 | 0.1763 |
分析:(1)原始 DSAIN 优于全部四个变体。(2)DSAIN†₁(0.6790)与 DSAIN†₂(0.6795)性能下降最剧烈,说明过早融合情境特征会导致信息分散、损害性能;即便像 DSAIN†₂ 那样用了 micro-MLP 这种更复杂的交互方案,相对 DSAIN†₁ 的提升也非常有限(+0.0005)——这凸显了分别对待每个情境特征的必要性。(3)DSAIN†₃ 丢掉 micro-MLP 后掉到 0.6801,说明 micro-MLP 确实帮助达成了 item embedding 与情境特征之间的充分交互。(4)DSAIN†₄(0.6810)低于 DSAIN,说明同类情境特征的共性被成功注入了 SFE 的通用向量。
4.2.3 CFM 的作用¶
七个变体:‡₁ 只做 behavior mixing;‡₂ 只做 channel mixing;‡₃ 只做 feature mixing;‡₄ 移除 feature-mixer(保留 behavior + channel);‡₅ 移除 channel-mixer;‡₆ 移除 behavior-mixer;‡₇ 移除三个 mixer 的 MLP block 中的 GELU 非线性激活。
Table 6. 不同 CFM 变体的性能
| ‡₁ | ‡₂ | ‡₃ | ‡₄ | ‡₅ | ‡₆ | ‡₇ | DSAIN | |
|---|---|---|---|---|---|---|---|---|
| behavior-mixer | ✓ | ✓ | ✓ | ✓ | ✓ | |||
| channel-mixer | ✓ | ✓ | ✓ | ✓ | ✓ | |||
| feature-mixer | ✓ | ✓ | ✓ | ✓ | ✓ | |||
| GELU | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | |
| AUC | 0.6805 | 0.6779 | 0.6793 | 0.6798 | 0.6812 | 0.6770 | 0.6806 | 0.6823 |
| Logloss | 0.1765 | 0.1767 | 0.1767 | 0.1766 | 0.1764 | 0.1769 | 0.1765 | 0.1763 |
分析:(1)七个变体的 AUC 全部下降、Logloss 全部上升。(2)单 mixer 变体(‡₁ 0.6805 / ‡₂ 0.6779 / ‡₃ 0.6793)显示 behavior-mixer 与 feature-mixer 比 channel-mixer 更重要,其中 behavior-mixer 最关键。(3)双 mixer 变体中 ‡₆(移除 behavior-mixer)跌得最狠(0.6770,-0.0053),再次印证 behavior-mixer 的重要性;而 ‡₄(移除 feature-mixer)相对完整版 AUC 下降超过 20 个万分点级别(0.6798 vs 0.6823),说明 feature-mixer 一致地连接了三向信息。(4)‡₇(去 GELU,0.6806)下降,说明在 CFM 中引入非线性是必要的。(5)一个反直觉观察:相对单独使用 behavior-mixer 或 feature-mixer,进一步引入 channel-mixer 会导致性能下降(‡₁ 0.6805 → ‡₄ 0.6798;‡₃ 0.6793 → ‡₆ 0.6770),作者归因于信息纠缠;但 ‡₅(去 channel-mixer,0.6812)与完整 DSAIN(0.6823)的对比又表明,三者同时使用时 channel-mixer 才能发挥捕捉多通道潜在语义的作用。这条「二元有害、三元有益」的现象是本文消融里最值得琢磨的一处。
4.2.4 SAM 的作用¶
变体:⋄₁ 对同一行为的所有 $\tilde{\mathbf{v}}_{i,k}$ 做平均池化;⋄₂ 以权重自适应方式聚合 $\tilde{\mathbf{v}}_{i,k}$;⋄₃ 计算目标行为与每个历史行为之间的相关性分数来动态调整历史行为贡献(即退化为 DIN 式的 item 粒度标量门控)。
Table 5. 不同 SAM 变体的性能
| DSAIN⋄₁ | DSAIN⋄₂ | DSAIN⋄₃ | DSAIN | |
|---|---|---|---|---|
| AUC | 0.6805 | 0.6800 | 0.6812 | 0.6823 |
| Logloss | 0.1765 | 0.1767 | 0.1764 | 0.1763 |
分析:(1)⋄₁ 与 ⋄₂ 的 AUC 都下降,说明充分利用目标行为来引导同一行为内情境特征 embedding 的聚合很重要。(2)⋄₃ 相对完整 DSAIN 的下降(0.6812 vs 0.6823)证明了 SAM 中通道自适应单元的有效性——在行为 embedding 的维度级别调制贡献,比 item 级别更细粒度。
4.3 超参数分析(RQ3)¶
(原文 Fig. 2 为三张矢量折线图,本次图片提取未能获得位图,以下按正文数值描述。)
- CFM 层深 $M$(1→8):$M$ 从 1 增到 4 性能持续变好,之后继续增大反而变差。作者解释:适度堆叠有助于充分挖掘三向相关性,层数过多会引入噪声干扰、模糊情境特征表示。故取 $M = 4$。
- 三个 mixer 的隐藏维度:先固定 $D_{d_2} = 16$、$D_n = 8$,在 $\{2,4,8,10,12,16,20\}$ 中调 behavior-mixer 的 $D_{L_w}$(针对总长 300 的序列),$D_{L_w} = 10$ 最佳(该图因篇幅省略)。再固定 $D_{L_w} = 10$,考察 $D_{d_2} \in \{8,16,32\}$ 与 $D_n \in \{8,16,32\}$ 的组合(图中记作 "c-f",如 "8-16" 表示 $D_{d_2}=8, D_n=16$),峰值出现在 $D_{d_2} = 16$、$D_n = 8$。
- BDM 温度 $\tau$($\{0.1, 0.3, 1.0, 3.0, 10.0\}$):适中的 $\tau = 1.0$ 最合适,过小或过大都次优。这符合 Gumbel-Softmax 的直觉——$\tau$ 过小逼近硬 one-hot(梯度方差大),过大则过度平滑(选择因子趋近 0.5,失去筛选能力)。
4.4 线上 A/B 实验(RQ4)¶
- 时间与流量:2022 年 12 月 6 日起,在美团外卖平台上以真实 40% 流量部署 DSAIN,持续 7 天;对照组为美团外卖当时线上服务的 CTR 模型。
- 收益:CTR +2.70%、CPM +2.62%、GMV +2.16%。
- 部署状态:DSAIN 已部署于美团外卖平台的列表广告推荐系统(list-advertisement recommender system),服务数亿用户,带来显著的业务收入增长。
三个指标同向提升是一个相对干净的结果:CTR 涨说明排序更准,CPM 同步涨说明没有靠牺牲广告变现效率换点击,GMV 涨说明点击确实转化成了交易而非无效流量。
五、核心贡献总结¶
- 概念层:提出 situation / situational features,把行为类型 + 时间 + 空间统一到同一个抽象下,首次让三类 behavior-related 副信息可以被一个模型同时消化。
- 表示层:SFE 的「通用向量 + 特化向量」门控融合,以及把情境特征 embedding 重解释为 micro-MLP 参数——这是一个极其经济的设计(SFE 本身零额外参数),把「副信息与 item 的交互」从加法/拼接升格为函数作用。
- 相关性建模层:CFM 用纯 MLP 的三向 mixer(behavior / channel / feature)取代 Transformer,无需位置编码、层间参数共享,在保持轻量的同时把跨行为、跨通道、跨情境特征三类相关性一致地打通;behavior-mixer 内部再用 adjacent / dilated / shifted 三种分段策略做 partition-and-fusion。
- 聚合层:SAM 的通道自适应单元把 DIN 的 item 级标量门控升级为维度级向量门控。
- 工业价值:美团外卖主流量 40% 七天 A/B,CTR/CPM/GMV 三指标同向提升并全量部署,开源代码可复现。
六、与已归档相关工作的对比¶
时序前提(务必先读):本文正文是 RecSys '23 论文,参考文献截止 2023 年,arXiv 版本迟至 2026-04-14 才提交。下列三篇归档论文全部诞生于 2026 年,本文在结构上不可能引用它们——这不是「遗漏引用」,而是纯粹的时序使然。真正值得注意的是反方向:其中 SIF 反过来引用了本文。
SIF SIF: Sample-Is-Feature(Meituan,arXiv 2026-04-17)¶
关系:后继工作反向引用本文(SIF 把本文作为 "sequence widening" 路线的代表作引用,缩写为 "DSAN [13]")· 已加载对方精读
- 共同关注的问题:两篇论文指向完全相同的 root cause——工业排序模型的历史行为 token 只是一个 bare item embedding,每次交互真实携带的丰富上下文(时间、页面位置、行为类型、请求上下文)被丢弃。SIF 用「凌晨优惠券激活时的点击 vs 正午吃饭高峰的点击,在 bare item ID 下完全一致」举例,与本文用「takeout 场景下同一家餐厅在早餐/午餐/晚餐时段被点击语义不同」的论证是同一个洞察。两者还都落在美团外卖这一同一业务场景。
- 相近的技术骨架:更惊人的是方法骨架的抽象重合。本文的 CFM 是一个 MLP-Mixer 风格的三段分解(behavior-mixer 沿行为维、channel-mixer 沿通道维、feature-mixer 沿情境特征维);SIF-Mixer 同样明确声明「受 MLP-Mixer 风格分解设计启发」,其 SIF Block 也是三段——Token-level Mixer(沿同一样本内的 sub-token 维,对应本文的 feature-mixer)、Sample-level Mixer(沿样本/行为维,对应本文的 behavior-mixer)、Token-level FFN(逐位置非线性,对应本文的 channel-mixer)。两者都通过「把 intra-behavior 的字段维交互与 inter-behavior 的时序维交互解耦成正交的 mixer」来同时获得表达力与可控复杂度。
- 本文的差异与推进:本文走的是在线端到端、结构化指定路线——人工定义 $n = 5$ 类情境特征(时间/时段/周期/页面/是否广告位),并用 micro-MLP 参数化保证 item 与每类情境特征的交互;SFE 零额外参数,全部计算在线完成。SIF 走的是离线压缩、全量覆盖路线——把整条 Raw Sample(数千字段,含预计算交叉特征)用 HGAQ 分组残差量化压成 648 bits 的 Token Sample 离线存 KV,在线只查表。本文靠先验挑选少量高价值副信息并精细建模;SIF 靠无差别压缩全部字段并把筛选交给 mixer。SIF 因此还多出了本文没有的两个组件:label-supervised 码本训练($\mathcal{L}_{\text{token}}$)与 target-token 对齐损失($\mathcal{L}_{\text{align}}$)——本文因为不做量化压缩,天然不存在这两个问题。
- 可比的方法 / 实验差异:两者均在美团数据 + 线上 A/B 上验证,但基线代际不同。本文的对手是 DIN/DIEN/CAN/DMT/FeedRec/CARCA/Trans2D/DIF-SR 这一代(2018-2022),离线 Meituan AUC 0.6823(相对次优 DIF-SR +1.23%),线上 CTR +2.70% / CPM +2.62% / GMV +2.16%(2022-12,40% 流量 7 天)。SIF 的对手已是 HyFormer 这类统一 Transformer 架构,报 GAUC +0.88%、线上 CTR +2.03% / CVR +1.21% / GMV per session +1.35%。两者线上量级接近,但注意本文的 A/B 早了三年多,此后美团的线上 baseline 已被大幅抬高,跨论文比较线上相对增幅没有意义。
AttnMVP AttnMVP: Attention-based Mixed-Value Pooling(LinkedIn,arXiv 2026-03-11)¶
关系:独立并发/殊途同归(双方互不引用;本文实际工作早约 2.5 年,AttnMVP 的 arXiv 日期早于本文 arXiv 日期约 1 个月)· 已加载对方精读
- 共同关注的问题:两篇都在回答同一个 root cause 问题——行为的 action/side 信息究竟该以什么方式进入 item 表征。AttnMVP 攻击的是 HSTU 式 interleaving($[i_0, a_0, i_1, a_1, \dots]$):item 与 action 是语义上不相交、关系非对称且因果的实体,把它们混进同一序列会造成「因果稀释」与「注意力噪声」——某个 cat token 会继承来自 "like on dog" 的正向信号,被错误编码成 "partially liked cat"。本文攻击的是同一枚硬币的另一面:把情境特征直接加/拼到 item embedding 会污染 item ID 的原始表征、造成信息分散——这正是本文 DSAIN†₁/†₂ 消融实测到的「过早融合导致信息分散」(AUC 0.6790/0.6795 vs 0.6823)。
- 相近的技术骨架:两者给出的解法在抽象层面同构——让 side/action 信息「调制」item 表征,而不是与之同质化混合。AttnMVP 的做法是把 action 严格排除出 Q/K、只作为 Value 的加性成分注入:$\mathbf{V}_t^{(\ell)} = \mathbf{H}_t^{(\ell-1)} + \lambda \mathbf{a}_t$,item 流独立演化,action 逐层渗透。本文的做法是把情境特征 embedding 重解释为一个 micro-MLP 的权重与偏置,让它乘性地作用在 item embedding 上:$\mathbf{v}_{i,k} = \mathrm{MLP}_i^k(\hat{\mathbf{v}}_i)$。一个是加性注入 Value,一个是参数化的函数作用,但共享同一条归纳偏置:item 表征保持主干地位,副信息只改变它被读取的方式。
- 本文的差异与推进:(i)范式不同:AttnMVP 在生成式推荐(HSTU ranker)语境下工作,用 NE/eval loss 评估;本文是纯判别式 CTR,用 AUC/Logloss。(ii)副信息覆盖面不同:AttnMVP 的 action 词表只有约 10 个量级(click/skip/dwell/like/share/comment 等),且只处理 action 这一类;本文的 situation 同时覆盖行为类型、时间(小时/餐段/周期)与空间(页面/广告位),并额外用 feature-mixer 显式建模不同副信息类型之间的相互依赖——AttnMVP 因为只有 action 一类,不存在这个问题。(iii)本文更早、且工业验证更硬:本文的机制早在 2023 年 RecSys 就已提出,并有 40% 主流量 A/B 与全量部署;AttnMVP 只报离线 NE 改善(-0.41% ~ -1.1%)与训练时间节省(-12.3%),未报线上收益。(iv)AttnMVP 的推进:它给出了 interleaving 为何有效的理论解释(self-attention 隐式充当基于 item 相似度的结构化 pooling 算子),并附带解决了序列长度翻倍带来的 4× 计算问题——这是本文完全没有涉及的角度。
IAT IAT: Instance-As-Token(ByteDance,arXiv 2026-04-10)¶
关系:独立并发(双方互不引用;IAT 的 arXiv 日期早于本文 arXiv 日期 4 天,但本文实际工作早 2.5 年)· 已加载对方精读
- 共同关注的问题:IAT 把问题命名为「手工序列特征的信息瓶颈」——排序模型的行为序列特征(item ID、类目、交互类型、时间戳)只是从数千维候选特征集中人工挑出的稀疏子集,细粒度特征(价格、频率)被存储与计算成本挡在门外。这与本文开篇的判断——「与用户行为相关的信息至今没有被充分利用」——是同一个 root cause 的两种措辞。
- 相近的技术骨架:两者都在做「把序列 token 的信息载荷从 bare item ID 往上抬」这件事,且都意识到 side information 需要与主表征分开对待:IAT 把 label 侧信息与时间戳等作为可选的 $E_{\text{side}}$ 与 InsEmb 拼接成 IAT 序列(Eq. 9),本文则把等价的信息(行为类型即 label 语义、时间即时间戳)提升为一等公民 situation 并做结构化交互。
- 本文的差异与推进:分歧比 SIF 那一组更大,属于「同问题、不同技术路线」。IAT 是两阶段离线压缩 + 参数服务器架构:source model(时序序 / 用户序两种,后者含 Source Instance Transformer)把每条历史训练样本压成 64 维 InsEmb 写进 PS,下游按 UID→InsID→InsEmb 检索装配;代价是数 TB 级 PS 存储与两阶段训练的工程复杂度,收益是完全绕开手工特征工程。本文是单阶段在线端到端:不引入任何离线存储,靠 $d_1 = 144$ 的情境特征 embedding 承担参数预算,靠 CFM 层间参数共享控制推理成本,代价是情境特征必须人工定义($n = 5$)。换言之:IAT 用存储换特征工程,本文用结构设计换存储。
- 可比的方法 / 实验差异:两者无共同数据集,无法直接比数值。本文在公开 Taobao/Eleme 上有完整对照表(DSAIN AUC 0.6452 / 0.6634),IAT 只报 ByteDance 内部多场景线上收益;本文的 A/B 在 2022-12 的美团外卖,IAT 在 2026 的字节多业务线。此外 IAT 明确把建模结果送进 RankMixer 这类上层特征交互模块效果最佳,而本文的 CFM 本身就是 mixer 家族的早期形态——从这个角度看,本文可以视为 mixer 用于情境副信息建模的一个更早的、更轻量的实例。
被剔除的近似候选及理由(本步骤门槛把关记录):
- RankMixer(2507.15551, ByteDance, 2025-07-21)/ UniMixer(2604.00590, Kuaishou, 2026-04-01)/ TokenMixer-Large(2602.06563, ByteDance, 2026-02-06):都是 MLP token-mixing 家族,与本文 CFM 形似,但问题不同构——它们解决的是硬件 MFU、参数量 scaling、深度扩展瓶颈,与「行为副信息如何融合」无关。「都用了 mixer」属于过宽共性,按 §2.5.3 反例规则剔除。
- TokenFormer(2604.13737, Tencent, 2026-04-15,比本文 arXiv 晚 1 天):同样在统一多字段特征与序列建模,但 root cause 是 Sequential Collapse Propagation(表征坍缩沿层传播),解法是 Bottom-Full-Top-Sliding 注意力布局,与本文的副信息融合问题不同构。
- FAT(2511.12081, Alibaba, 2025-11-15):Field-Decomposed Attention 的 per-field QKV 分解 + field-pair 调制,与本文 feature-mixer 建模「跨字段相关性」形似,但其问题是特征交互模型 scaling 时的参数复杂度 $O(F^2 d^2)$ 爆炸,作用对象是非序列的稀疏特征场,而非行为序列的副信息。剔除。
- Pro-GEO(2604.23156, BUPT, 2026-04-25):同样把空间信息注入表征(本文的空间特征是页面位置),但其载体是生成式推荐的第三层码本 + Geo-RoPE,属于生成式 SID 路线,与本文判别式 CTR 的 micro-MLP + mixer 路线毫无抽象重合。剔除。
- ChronoID(2606.14260, Rochester, 2026-06-12):系统研究时间信号注入 Semantic ID 的三条正交轴(绝对/相对编码、早/晚融合),其 early-vs-late fusion 之辩与本文 DSAIN†₁/†₂ 消融结论呼应,但基底是生成式 SID 而非判别式行为序列,且不涉及行为类型与空间信息。作为近似候选剔除。
- SIREN(2605.25726, Tencent, 2026-05-25):主张用 item-level early fusion 取代 late fusion,表面上与本文「过早融合有害」的结论对立而有趣,但其问题是多模态终身兴趣建模、解法靠 SID 前缀编码 + target-aware 相似度分桶,技术骨架与本文不重合。剔除。
七、讨论与局限性¶
7.1 值得借鉴的设计¶
- 把 embedding 重解释为参数(SFE):这是全文最优雅的一招。$d_1 = 144$ 的情境特征 embedding 不是拿来相加的表示,而是一个 micro-MLP 的权重矩阵与偏置向量。这让 SFE 做到「零额外参数」的同时获得了 item × 情境特征的高阶交互能力。这个思路(用一段 embedding 生成另一个网络的权重)与后来的 hypernetwork / FiLM 类调制在推荐系统中的应用是同源的,本文在 2023 年就把它用在了副信息融合上。
- MLP-Mixer 天然免位置编码:作者明确指出 MLP 对位置敏感,因此 CFM 无需位置编码。这在长序列($L = 300$)判别式 CTR 里是实打实的省事——省掉了位置编码的设计与外推问题。
- behavior-mixer 的三重分段(adjacent / dilated / shifted):这几乎是把 CNN 的感受野工程(普通卷积 / 空洞卷积 / 滑窗偏移)搬到了 MLP-Mixer 的序列维上,且用三个可学习标量 $w_1, w_2, w_3$ 自适应融合。对长行为序列而言,这是一个比「一个大 MLP 吃整条序列」更有结构先验的设计。
- 通道自适应门控替代 DIN 的标量门控:把注意力权重从标量升到向量,在几乎不增加成本的前提下($\mathbf{W}_g \in \mathbb{R}^{d_2 \times 3d_2}$,$d_2 = 8$)稳定拿到 +0.0011 AUC。
7.2 局限与争议¶
- 情境特征必须人工定义,且规模很小($n = 5$)。SFE 的零参数优势建立在「情境特征类别数很少」这个前提上——空间复杂度 $O(n d_2^2)$ 与时间复杂度 $O(L n d_2^2 + M L n d_2)$ 都线性依赖 $n$。当业务方想把上百个上下文字段都纳入 situation 时,这套设计的经济性会迅速恶化。这正是三年后 SIF 用离线量化压缩替代人工挑选的直接动因。
- 方法论可扩展性存疑。按「参数量 scaling 时,表征能力与序列建模能力能否一起增长」这条标准审视:DSAIN 的容量几乎全部锁在 $d_1$(micro-MLP 参数预算)与 $L, L_w, D_{L_w}, D_{d_2}, D_n$ 这几个小超参上,而 $d_2 = 8$ 这个激活维度小得惊人。CFM 层间参数共享进一步压死了深度方向的扩容空间,超参实验也显示 $M > 4$ 反而变差。换句话说,这是一个为固定小容量精心设计的模型,而不是一条能沿参数量继续走下去的路线——与 2024 年后 HSTU/RankMixer/MTGR 这一代「先把架构做得可 scaling」的思路方向相反。
- 公开数据集上的情境特征相当贫瘠。Taobao 数据集连 item ID 都没有(用品牌 ID 代替),情境特征只能由时间戳 + 行为类型构造;Eleme 只有时间类。只有工业 Meituan 数据集才真正具备本文主张的「时间 + 空间」完整 situation,而全部消融实验也都只在 Meituan 上做。这意味着本文最核心的主张——「同时纳入行为类型与时空信息」——在可复现的公开数据上其实没有被完整验证过。
- 消融的绝对增益很小。Meituan 上所有消融变体的 AUC 差异都在 0.0011~0.0053 区间(万分之十几到五十几)。虽然 CTR 领域公认「AUC 千分之一即显著」,但四个模块中 BDM(-0.0015)、SFE 单项(-0.0013~-0.0033)、SAM(-0.0011~-0.0023)的贡献都很微弱,真正扛事的只有 CFM 里的 behavior-mixer(-0.0053)。模型的复杂度与各模块的边际收益并不成比例。
- channel-mixer 的「二元有害、三元有益」缺乏机制解释。作者只用「信息纠缠」四个字带过 ‡₁→‡₄、‡₃→‡₆ 的下降,却又要用 ‡₅ vs DSAIN 论证 channel-mixer 有效。这个非单调性没有得到令人信服的机制说明,也没有做进一步的诊断实验。
- 线上 A/B 的对照组不透明。只说「baseline 是美团外卖当时线上服务的 CTR 模型」,未披露其架构、参数量或序列长度,也未报告推理延迟与资源开销的对比。对于一篇强调「计算成本没有增加」的论文,缺少线上延迟数据是个遗憾。
- 时间戳的错位。arXiv 版本延至 2026-04-14 才提交,正文却完全是 2023 年的状态(引文截止 2023、A/B 在 2022-12),既没有补充这三年间领域的巨大变化,也没有更新与 HSTU 之后一代工作的对比。读者若按 arXiv 日期理解其新颖性,会严重高估——这一点在引用与归档时必须显式标注。
7.3 工业落地价值¶
本文的工业价值是清晰且可验证的:美团外卖平台 40% 真实流量、7 天 A/B、CTR +2.70% / CPM +2.62% / GMV +2.16%,随后全量部署到列表广告推荐系统并服务数亿用户,且开源了代码(https://github.com/W-void/DSAIN)。三个指标同向提升排除了「用广告效率换点击」的常见嫌疑。对于本地生活/外卖这类时间与场景强相关的业务(早餐/午餐/晚餐、工作日/周末、搜索页/推荐页),把 situation 显式建模进行为序列是一个直觉正确且成本可控的方向——这也解释了为什么三年后美团内部的 SIF 仍把本文列为该路线的代表工作并继续向前推进。