CMRec:把多语 NLP 的 code-switching 语料搬进跨国生成式推荐¶
- 作者:Yuan Gao, Hao Deng, Haibo Xing, Yi Xu, Lingyu Mu, Jinxin Hu†, Yu Zhang, Xiaoyi Zeng(* 共同一作,† 通讯作者)
- 机构:Alibaba International Digital Commerce Group(阿里国际数字商业集团,北京 / 杭州)
- Arxiv:2609.28972(cs.IR,2026-09-24);CIKM '26 短文(6 页)
- 关键词:Generative Recommendation, Cross Country, Code Mixing
阅读提示:这是一篇 6 页的 CIKM 短文,正文只有 3 条公式(外加问题定义里的 1 条)、2 张表、3 张图。下面的精读把所有公式、表格和图注都完整转录,并单独拆解线上 A/B 与"收益到底来自 code-mixing 本身、还是来自多加了一批跨国训练数据"这一归因问题。
研究动机与背景¶
跨国推荐和跨域推荐(CDR)不是一回事¶
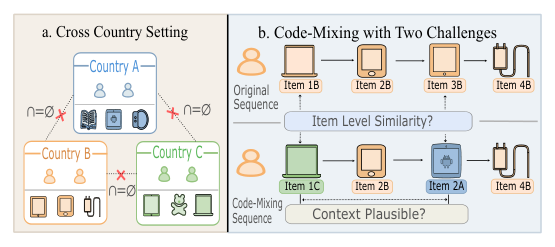
现代电商平台越来越多地同时在很多国家运营。实际部署里,每个国家都是一套独立的系统:用户交互只在单个国家内记录,user ID 和 item ID 空间各国分别维护。结果是 ID 与行为序列都被严格按国家切分,国家之间天然没有任何交集(Figure 1(a))。
这与已被充分研究的跨域推荐(cross-domain recommendation, CDR)设定不同。CDR 的知识迁移通常依赖某种跨域重叠——共享用户、共享物品,或人工锚定的实体,由它们携带协同信号。基于生成式推荐(GR)的近期 CDR 方法(GenCDR、GMC)放宽了这一 ID 级要求:把不同域的物品映射到一个共享的语义 token 空间,训练一个统一的生成模型,于是知识迁移发生在参数层(parameter level),由共享骨干和共享 token 空间承担。
但 GR 主要是从训练序列内部的物品共现里学东西。在跨国设定下,训练序列仍然严格按国家切分——A 国的物品永远不会出现在 B 国用户的上下文里,于是数据层(data level)的跨国强化完全缺席:大市场里丰富的交互信号帮不到小市场,跨国知识共享的潜力基本没被挖掘。
从 code-switching 语料得到的启发¶
多语 NLP 里,模型通过 code-switched 语料学到跨语言对齐——同一条训练序列里交替出现不同语言的 token(作者引用 Blevins & Zettlemoyer 2022 "Language Contamination"、Briakou et al. 2023 PaLM 中的 incidental bilingualism、PreAlign 2024)。受此启发,作者想问:能否为跨国 GR 构造类似的东西——把来自不同市场的物品交织在同一条序列里的"混国序列"?
问题在于这种语料在推荐里不会自然存在,只能靠替换合成。于是出现一个推荐特有的问题:什么才算合法的替换品? 已有基于替换的数据增强方法(SRA-CL、LLM4CDSR 类、MISSRec 等,多为 CDR 设定下开发)按内容(标题、描述、图片)匹配物品并在用户序列里替换。这种做法原则上能直接搬到跨国 GR,但作者认为它在两个互补维度上不够:
- (a) 物品层面的替换准则不完整:只看内容相似,忽略了两类关键信号——行为信号(co-purchase、co-click 模式)与市场信号(价格、受众、流行度)。两个长得像的物品在不同市场里可能扮演完全不同的角色,只靠内容准则会引入大量噪声。
- (b) 上下文层面的替换粒度太粗:即使一个候选单独看是合理的,也可能与用户当下的意图冲突。作者举的例子:一条由 Apple 设备主导的序列里,把某个物品换成一台内容和基础属性都相似的 Android 平板——"句法上"合理,"上下文上"错误;这种错误任何离线的 item-pair 过滤器都检测不出来。
本文方案与贡献¶
作者提出 CMRec:通过双约束、上下文感知的 code-mixing,在数据层注入跨国监督。三步:
- 从跨国的多模态内容与行为共现中学一个共享语义码本,它同时充当 GR 的 tokenizer 和跨国替换所用的公共语义空间;
- 在该码本上做 token 级、双约束的 code-mixing:替换作用在语义 token 序列上而不是国家特有的 item ID 上,候选必须同时满足静态(内容)约束与动态(价格、受众、流行度)约束;
- 引入上下文感知损失,让 GR 模型按"混入样本在当前上下文中的合理性"重新加权,压低噪声替换、保留有用的跨国信号。
在两个真实多国数据集与一次线上 A/B 上验证,报告广告收入 +1.77%、订单 +2.64%。
问题定义¶
考虑国家集合 $\mathcal{C}$ 上的跨国推荐,每个国家 $c\in\mathcal{C}$ 是一个独立的域,拥有互不相交的用户集和物品集 $\mathcal{U}^{(c)}$ 与 $\mathcal{I}^{(c)}$,即对 $c\neq c'$ 有 $\mathcal{U}^{(c)}\cap\mathcal{U}^{(c')}=\mathcal{I}^{(c)}\cap\mathcal{I}^{(c')}=\emptyset$。对用户 $u\in\mathcal{U}^{(c)}$,其交互序列记为 $x_c=(i_1,\dots,i_T)$,$i_t\in\mathcal{I}^{(c)}$,目标物品 $y_c\in\mathcal{I}^{(c)}$。
沿用 GR 范式(TIGER、REG4Rec),用码本把每个物品映射为一个离散 token 序列,把推荐表述为统一 token 空间里的条件序列生成。令 $\mathcal{D}^{(c)}=\{(x_c,y_c)\}$ 收集国家 $c$ 的训练对。多国联合训练时,把所有国家的样本汇成 $\mathcal{D}=\bigcup_{c\in\mathcal{C}}\mathcal{D}^{(c)}=\{(x,y)\}$,GR 模型最大化
$$\mathcal{L}_{\mathrm{GR}}(\theta)=\sum_{(x,y)\in\mathcal{D}}\log P_\theta(y\mid x) \tag{1}$$
其中 $\theta$ 为模型参数。注意:这个"汇池联合训练"就是参数层迁移的全部——每条样本内部仍是单一国家的物品。
核心方法:CMRec 的三个组件¶
3.1 行为与内容共同奠基的共享码本(Behavior- and Content-Grounded Shared Codebook)¶
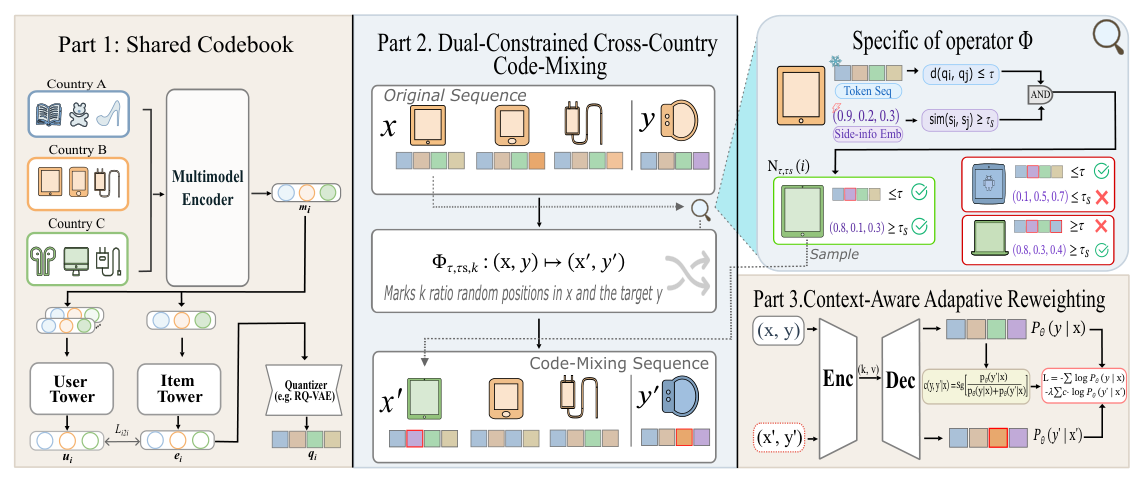
为了让一个统一的跨国 GR 骨干成为可能,作者先构建一个同时吸收多模态内容与行为信号的共享语义码本。它一身二用:给 GR 做物品 tokenizer;给跨国 token 替换提供公共语义空间。
第一步:内容 embedding。 用跨国共享的预训练模型(Qwen2.5-VL 系列)把每个物品的多模态 side information(标题、图片等)编码为内容 embedding $\mathbf{m}_i$。这给出一个统一语义空间,让所有国家的物品在内容层面可比。但内容本身不刻画物品在各国的真实"行为表现":视觉相似的物品可以有截然不同的流行度与共现模式,而这些行为信号隐含在用户交互序列中。
第二步:跨国联合的行为 i2i 对齐。 为注入行为信息,作者在 $\mathbf{m}_i$ 之上跨所有国家联合训练一个行为驱动的 item-to-item(i2i)对齐模型。采用带 sampled softmax 的双塔结构:user tower 把一条行为序列映射为用户 embedding $\mathbf{u}_i$,item tower 把 $\mathbf{m}_i$ 映射为物品 embedding $\mathbf{e}_i=T(\mathbf{m}_i)$。联合 i2i 训练目标为
$$\mathcal{L}_{\mathrm{i2i}}=-\sum_i\log\frac{\exp(\mathbf{u}_i^\top\mathbf{e}_{i^+})}{\exp(\mathbf{u}_i^\top\mathbf{e}_{i^+})+\sum_{j\in\mathcal{N}_i}\exp(\mathbf{u}_i^\top\mathbf{e}_j)} \tag{2}$$
其中 $i^+$ 为正样本物品,负样本池 $\mathcal{N}_i$ 在国家之间共享(沿用 Facebook EBR 的做法)。含义:由于 item tower 的输入是跨国可比的内容 embedding,且负样本跨国共享,模型被迫把"内容相似且在各自国家的交互模式里行为相似"的物品在 $\mathbf{e}_i$ 空间里拉近——这是让"A 国某物品"和"B 国某物品"能在同一空间里比较行为角色的关键。注意这里并不需要任何跨国用户或物品重叠:每条用户序列仍来自单一国家,跨国对齐完全靠共享的内容输入空间 + 共享负样本池传递。
第三步:残差量化。 对 $\{\mathbf{e}_i\}$ 施加残差量化器(如 RQ-VAE),得到共享 token 序列 $\mathbf{q}_i=(q_i^{(1)},\dots,q_i^{(M)})$。这些 token 组成统一码本,既作 GR tokenizer,也作跨国 code-mixing 的底座。
实现细节(§4.1):内容向量由 Qwen-VL-32B 编码为 64 维;RQ-VAE 产出长度 $L=4$ 的 token 序列。
3.2 双约束跨国 code-mixing(Dual-Constrained Cross-Country Code-Mixing)¶
有了共享码本,不同国家的物品就能在同一 token 空间里匹配。接下来在 token 层做跨国 code-mixing,让 GR 看到跨国混合的序列。
为什么不能只看码本? 朴素做法是只按码本表示做替换。但码本更新不频繁,捕捉不到快速变化的属性——价格折扣、流行度、受众标签——而这些恰恰决定两个物品在实践中是否可互换。
双约束过滤器。 每个物品 $i$ 配一个关于这些动态属性的 side-information embedding $\mathbf{s}_i$,其中每个元素都用按国家的分位数分桶(per-country quantile bucketization)离散化,使不同国家的数值落在可比尺度上(例如 A 国的"高价"与 B 国的"高价"都映射到本国分位数的高桶,规避汇率与消费水平差异)。跨国候选集定义为
$$\hat{\mathcal{N}}_{\tau,\tau_s}(i)=\Big\{\,j\in\bigcup_{c'\neq c}\mathcal{I}^{(c')}\ \Big|\ d(\mathbf{q}_i,\mathbf{q}_j)\le\tau\ \wedge\ \mathrm{sim}(\mathbf{s}_i,\mathbf{s}_j)\ge\tau_s\,\Big\} \tag{3}$$
其中 $d$ 是 token 序列间的 Hamming 距离,$\mathrm{sim}$ 是余弦相似度;前者保证静态一致性(内容 + 行为,经码本固化),后者保证动态一致性(市场属性)。候选只从其他国家($c'\neq c$)的物品中取——这是"跨国"code-mixing 的定义所在。实验默认 $\tau=1$(4 位 token 中最多 1 位不同)、$\tau_s=0.8$,作者称之为"相对严格"的阈值。
替换算子 $\Phi$。 给定训练对 $(x,y)$,算子 $\Phi_{\tau,\tau_s,k}:(x,y)\mapsto(x',y')$ 把 $x$ 与 $y$ 中比例为 $k$ 的随机位置上的物品替换为从 $\hat{\mathcal{N}}_{\tau,\tau_s}(\cdot)$ 抽取的邻居,其余位置保持不变,从而在 token 层注入跨国共现。然后对 $\mathcal{D}$ 的一个比例为 $p$ 的子样本施加 $\Phi$,形成孪生集 $\mathcal{D}'$;$p$ 控制跨国混合强度。
步骤化描述:
- 离线:对每个物品 $i$,用式 (3) 预计算跨国候选集 $\hat{\mathcal{N}}_{\tau,\tau_s}(i)$;
- 每轮训练数据构造:从 $\mathcal{D}$ 中按比例 $p$ 抽样训练对;
- 对每个被抽中的 $(x,y)$,在 $x$ 的位置与目标 $y$ 上按比例 $k$ 随机选择槽位(Figure 2 中目标 $y$ 也被替换了),对每个被选中的物品从其候选集中抽一个跨国邻居替换;
- 得到孪生样本 $(x',y')$,加入 $\mathcal{D}'$,与原样本一起进入 3.3 的损失。
默认 $p=0.1$、$k=0.1$:即只有 10% 的训练对生成孪生样本、每条孪生样本里约 10% 的位置被替换。这意味着额外引入的数据量很小(孪生样本占原数据约 10%,且再乘以 $\lambda=0.5$ 与逐样本权重 $w$),这一点对后文的"数据量归因"很重要。
3.3 上下文感知的自适应重加权(Context-Aware Adaptive Reweighting)¶
过滤器 $\hat{\mathcal{N}}_{\tau,\tau_s}$ 只保证物品层面的合理性,它对用户上下文、以及模型预测在训练过程中如何演化都是盲的。一些合成替换仍可能与周围序列不相容,在长而嘈杂的历史中尤其如此(即 Apple 序列中换进 Android 平板的问题)。作者于是让 GR 模型自己在训练中评估每个被替换的物品。对由原始对 $(x,y)$ 派生的替换样本 $(x',y')$,定义上下文条件可替换度:
$$w(y,y'\mid x)=\mathrm{sg}\left[\frac{P_\theta(y'\mid x)}{P_\theta(y\mid x)+P_\theta(y'\mid x)}\right]\in[0,1] \tag{4}$$
其中 $P_\theta(\cdot\mid x)$ 是原始上下文下的自回归物品似然,$\mathrm{sg}[\cdot]$ 为 stop-gradient,所以 $w$ 影响损失但不接收梯度。
两个设计细节:
- 为什么用原始上下文 $x$ 而不是混合后的 $x'$ 评估 $y'$? 作者认为 $P_\theta$ 在观测到的 $x$ 上更校准;用 $x$ 可以防止 $w$ 在训练早期被模型对分布外合成替换的不稳定响应所主导。物理含义上,$w$ 是一个二元 Bradley–Terry 式的相对概率:在同一个真实上下文里,"替换目标 $y'$"与"真实目标 $y$"相比有多可信。$w\to 0.5$ 表示两者对模型而言同样合理,$w\to 0$ 表示替换品在该上下文里明显不合理。
- 为什么 stop-gradient? 否则模型可以通过压低 $P_\theta(y'\mid x)$ 来降低 $w$、从而"逃避"替换样本的损失,形成退化解。
总训练目标把原始监督与替换监督合并:
$$\mathcal{L}(\theta)=-\sum_{(x,y)\in\mathcal{D}}\log P_\theta(y\mid x)-\lambda\sum_{(x',y')\in\mathcal{D}'}w(y,y'\mid x)\log P_\theta(y'\mid x') \tag{5}$$
其中 $\lambda$ 控制替换样本的总体贡献(默认 $\lambda=0.5$)。因为 $w$ 来自模型自身的预测,它充当一个上下文感知权重:训练早期大多数替换获得相近的权重,训练后期模型会压低那些物品级过滤器分辨不出的上下文无效替换。
注意:由于 $w\le 1$ 且理想情况下 $P_\theta(y\mid x)$ 是模型对真实目标的高置信预测,大部分 $w$ 实际会显著小于 0.5,这意味着替换样本的有效权重远小于 $\lambda$。另外,计算 $w$ 需要对每个孪生样本在原始上下文 $x$ 下额外做一次 $y'$ 的似然前向(decoder 以 $y'$ 的 4 位 token teacher-forcing),论文没有报告这部分训练开销。
实验设置¶
数据集¶
| 数据集 | 规模 | 国家/站点 | 特点 |
|---|---|---|---|
| Industrial(阿里国际站内广告数据) | 超 10 亿交互、1900 万用户、2500 万广告 | 6 国(A–F) | 最大国家训练交互量约为最小国家的 10 倍;各国 user / item ID 完全不相交 |
| Amazon M2(KDD Cup 2023 多语会话推荐基准) | — | 6 个 locale:高资源 UK/DE/JP,低资源 IT/FR/ES | 高资源 locale 占全部训练会话约 91%,长尾明显 |
Table 1 每个指标报告 6 国/站点平均(Avg6)以及三个代表国/站点,上标 $L/M/S$ 表示大/中/小体量(Amazon M2 没有 M 档):Industrial 展示 $A^L$、$B^M$、$C^S$;Amazon M2 展示 $UK^L$、$FR^S$、$ES^S$。
评估指标¶
Recall@10/100 与 NDCG@10/100。Recall@K 衡量真实下一物品是否出现在 top-K 列表中;NDCG@K 在此基础上按命中位置做对数折损,排得越靠前得分越高。论文未说明是否全量排序、候选集大小和数据切分协议(leave-one-out 还是时间切分)。
Baseline¶
五个代表方法 + 两个增强变体:
- SASRec:基于 ID 的自注意力序列推荐;
- HSTU:Meta 的 ID-based 生成式推荐架构;
- TIGER:Semantic ID + 生成式检索;
- REG4Rec:同一团队(阿里国际)的推理增强生成式推荐;
- GenCDR:基于生成式、自适应语义 tokenization 的跨域推荐(AAAI 2026),即"参数层迁移"的代表;
- GenCDR+Cont:仿照 SRA-CL,在 GenCDR 上构造的内容增强变体(按内容相似做替换);
- GenCDR+CF:仿照 CoSeRec 与 TiCoSeRec,在 GenCDR 上构造的协同增强变体(按用户行为信号做替换)。
关键控制:两个增强变体都使用与 CMRec 相同的替换比例和采样预算——这正是本文里"数据量匹配"的对照(见后文归因分析)。所有 baseline 按原始设计实现,在同一数据切分上训练。
实现细节与超参¶
| 项 | 取值 |
|---|---|
| 内容编码器 | Qwen-VL-32B,输出 64 维 |
| 量化器 | RQ-VAE,token 序列长度 $L=4$ |
| GR 骨干 | GenCDR |
| 孪生子样本比例 $p$ | 0.1 |
| 槽位替换比例 $k$ | 0.1 |
| 替换损失权重 $\lambda$ | 0.5 |
| Hamming 阈值 $\tau$ | 1 |
| side-info 余弦阈值 $\tau_s$ | 0.8 |
论文没有给出学习率、batch size、训练步数、模型层数/参数量、码本每层大小等信息。
主要实验结果¶
Table 1(a):Industrial 数据集(6 国)¶
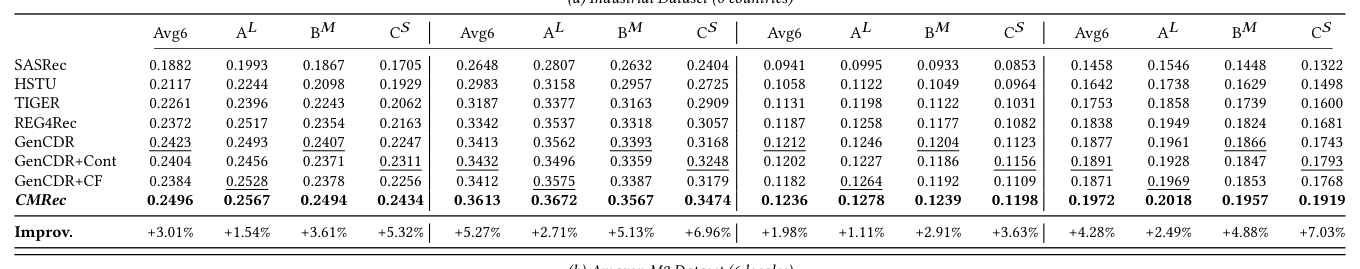
Recall@10 / Recall@100
| 方法 | R@10 Avg6 | R@10 $A^L$ | R@10 $B^M$ | R@10 $C^S$ | R@100 Avg6 | R@100 $A^L$ | R@100 $B^M$ | R@100 $C^S$ |
|---|---|---|---|---|---|---|---|---|
| SASRec | 0.1882 | 0.1993 | 0.1867 | 0.1705 | 0.2648 | 0.2807 | 0.2632 | 0.2404 |
| HSTU | 0.2117 | 0.2244 | 0.2098 | 0.1929 | 0.2983 | 0.3158 | 0.2957 | 0.2725 |
| TIGER | 0.2261 | 0.2396 | 0.2243 | 0.2062 | 0.3187 | 0.3377 | 0.3163 | 0.2909 |
| REG4Rec | 0.2372 | 0.2517 | 0.2354 | 0.2163 | 0.3342 | 0.3537 | 0.3318 | 0.3057 |
| GenCDR | 0.2423 | 0.2493 | 0.2407 | 0.2247 | 0.3413 | 0.3562 | 0.3393 | 0.3168 |
| GenCDR+Cont | 0.2404 | 0.2456 | 0.2371 | 0.2311 | 0.3432 | 0.3496 | 0.3359 | 0.3248 |
| GenCDR+CF | 0.2384 | 0.2528 | 0.2378 | 0.2256 | 0.3412 | 0.3575 | 0.3387 | 0.3179 |
| CMRec | 0.2496 | 0.2567 | 0.2494 | 0.2434 | 0.3613 | 0.3672 | 0.3567 | 0.3474 |
| Improv. | +3.01% | +1.54% | +3.61% | +5.32% | +5.27% | +2.71% | +5.13% | +6.96% |
NDCG@10 / NDCG@100
| 方法 | N@10 Avg6 | N@10 $A^L$ | N@10 $B^M$ | N@10 $C^S$ | N@100 Avg6 | N@100 $A^L$ | N@100 $B^M$ | N@100 $C^S$ |
|---|---|---|---|---|---|---|---|---|
| SASRec | 0.0941 | 0.0995 | 0.0933 | 0.0853 | 0.1458 | 0.1546 | 0.1448 | 0.1322 |
| HSTU | 0.1058 | 0.1122 | 0.1049 | 0.0964 | 0.1642 | 0.1738 | 0.1629 | 0.1498 |
| TIGER | 0.1131 | 0.1198 | 0.1122 | 0.1031 | 0.1753 | 0.1858 | 0.1739 | 0.1600 |
| REG4Rec | 0.1187 | 0.1258 | 0.1177 | 0.1082 | 0.1838 | 0.1949 | 0.1824 | 0.1681 |
| GenCDR | 0.1212 | 0.1246 | 0.1204 | 0.1123 | 0.1877 | 0.1961 | 0.1866 | 0.1743 |
| GenCDR+Cont | 0.1202 | 0.1227 | 0.1186 | 0.1156 | 0.1891 | 0.1928 | 0.1847 | 0.1793 |
| GenCDR+CF | 0.1182 | 0.1264 | 0.1192 | 0.1109 | 0.1871 | 0.1969 | 0.1853 | 0.1768 |
| CMRec | 0.1236 | 0.1278 | 0.1239 | 0.1198 | 0.1972 | 0.2018 | 0.1957 | 0.1919 |
| Improv. | +1.98% | +1.11% | +2.91% | +3.63% | +4.28% | +2.49% | +4.88% | +7.03% |
结论分析:
- 提升呈"小国大、大国小"的梯度:以 R@100 为例,相对最佳 baseline 的提升从大国 $A^L$ 的 +2.71%、中国 $B^M$ 的 +5.13% 到小国 $C^S$ 的 +6.96%;若直接对 GenCDR(CMRec 的骨干)算,$C^S$ 从 0.3168 到 0.3474 是 +9.7%,$A^L$ 从 0.3562 到 0.3672 是 +3.1%。这与"大市场信号经 code-mixing 流向小市场"的叙事吻合,且大国没有被拖累(作者所谓 "preserving performance in data-rich countries")。
- top 位置的提升明显小于 @100:R@10 Avg6 仅 +3.01%、N@10 Avg6 仅 +1.98%,而 R@100 +5.27%、N@100 +4.28%。说明跨国替换主要扩大了"召回面",对头部精排序的帮助有限——对一个生成式召回模型而言这是合理的,但也意味着线上若在头部位置消费,收益会被稀释。
- 单信号增强是"拆东墙补西墙":GenCDR+Cont 在小国 $C^S$ 上 R@10 从 0.2247 升到 0.2311,但大国 $A^L$ 从 0.2493 掉到 0.2456;GenCDR+CF 恰好相反,大国小升、中小国持平或降。两者的 Avg6 R@10 都低于不增强的 GenCDR(0.2404 / 0.2384 vs 0.2423)。这正是作者主张的"只看内容或只看行为的替换会引入噪声"。
- Token 化 GR 优于 ID-based GR:REG4Rec、GenCDR > TIGER > HSTU > SASRec,作者归因于 tokenization 与跨国参数共享对小国更友好(小国 $C^S$ 上 SASRec 0.1705 → GenCDR 0.2247 的 R@10 差距比大国更大)。
Table 1(b):Amazon M2 数据集(6 locale)¶
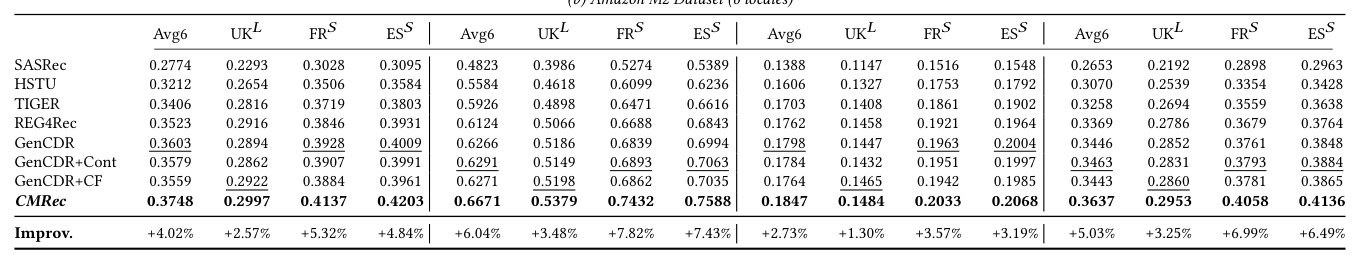
Recall@10 / Recall@100
| 方法 | R@10 Avg6 | R@10 $UK^L$ | R@10 $FR^S$ | R@10 $ES^S$ | R@100 Avg6 | R@100 $UK^L$ | R@100 $FR^S$ | R@100 $ES^S$ |
|---|---|---|---|---|---|---|---|---|
| SASRec | 0.2774 | 0.2293 | 0.3028 | 0.3095 | 0.4823 | 0.3986 | 0.5274 | 0.5389 |
| HSTU | 0.3212 | 0.2654 | 0.3506 | 0.3584 | 0.5584 | 0.4618 | 0.6099 | 0.6236 |
| TIGER | 0.3406 | 0.2816 | 0.3719 | 0.3803 | 0.5926 | 0.4898 | 0.6471 | 0.6616 |
| REG4Rec | 0.3523 | 0.2916 | 0.3846 | 0.3931 | 0.6124 | 0.5066 | 0.6688 | 0.6843 |
| GenCDR | 0.3603 | 0.2894 | 0.3928 | 0.4009 | 0.6266 | 0.5186 | 0.6839 | 0.6994 |
| GenCDR+Cont | 0.3579 | 0.2862 | 0.3907 | 0.3991 | 0.6291 | 0.5149 | 0.6893 | 0.7063 |
| GenCDR+CF | 0.3559 | 0.2922 | 0.3884 | 0.3961 | 0.6271 | 0.5198 | 0.6862 | 0.7035 |
| CMRec | 0.3748 | 0.2997 | 0.4137 | 0.4203 | 0.6671 | 0.5379 | 0.7432 | 0.7588 |
| Improv. | +4.02% | +2.57% | +5.32% | +4.84% | +6.04% | +3.48% | +7.82% | +7.43% |
NDCG@10 / NDCG@100
| 方法 | N@10 Avg6 | N@10 $UK^L$ | N@10 $FR^S$ | N@10 $ES^S$ | N@100 Avg6 | N@100 $UK^L$ | N@100 $FR^S$ | N@100 $ES^S$ |
|---|---|---|---|---|---|---|---|---|
| SASRec | 0.1388 | 0.1147 | 0.1516 | 0.1548 | 0.2653 | 0.2192 | 0.2898 | 0.2963 |
| HSTU | 0.1606 | 0.1327 | 0.1753 | 0.1792 | 0.3070 | 0.2539 | 0.3354 | 0.3428 |
| TIGER | 0.1703 | 0.1408 | 0.1861 | 0.1902 | 0.3258 | 0.2694 | 0.3559 | 0.3638 |
| REG4Rec | 0.1762 | 0.1458 | 0.1921 | 0.1964 | 0.3369 | 0.2786 | 0.3679 | 0.3764 |
| GenCDR | 0.1798 | 0.1447 | 0.1963 | 0.2004 | 0.3446 | 0.2852 | 0.3761 | 0.3848 |
| GenCDR+Cont | 0.1784 | 0.1432 | 0.1951 | 0.1997 | 0.3463 | 0.2831 | 0.3793 | 0.3884 |
| GenCDR+CF | 0.1764 | 0.1465 | 0.1942 | 0.1985 | 0.3443 | 0.2860 | 0.3781 | 0.3865 |
| CMRec | 0.1847 | 0.1484 | 0.2033 | 0.2068 | 0.3637 | 0.2953 | 0.4058 | 0.4136 |
| Improv. | +2.73% | +1.30% | +3.57% | +3.19% | +5.03% | +3.25% | +6.99% | +6.49% |
结论分析:Amazon M2 上的模式与 Industrial 一致——低资源 locale(FR、ES)上的 R@100 提升(+7.82% / +7.43%)约为高资源 UK(+3.48%)的两倍,@10 的提升同样显著小于 @100。一个值得注意的反常:M2 上小 locale 的绝对指标反而高于大 locale(ES R@10 0.4203 > UK 0.2997),这大概率是 M2 各 locale 会话长度与候选规模差异造成的,所以跨 locale 比较只能看相对提升而不能看绝对值。另一个需要读者自行留意的点:Amazon M2 原始数据里各 locale 之间存在一定的商品重叠(同一产品在多个站点上架),这与论文 §2 "物品集合完全不相交"的形式化设定不完全一致,论文没有说明是否对 M2 做了去重叠处理;如果没有,M2 上的"跨国替换"一部分可能是在替换本就共享的商品,结论向 Industrial 数据的外推需打折扣。
消融与分析¶
Table 2:Industrial 数据集消融(6 国平均)¶
| 变体 | Recall@100 | NDCG@100 |
|---|---|---|
| CMRec (Full) | 0.3613 | 0.1972 |
| w/o Token-level distance constraint | 0.3447 (−4.59%) | 0.1894 (−3.96%) |
| w/o Side-info Similarity constraint | 0.3573 (−1.11%) | 0.1947 (−1.27%) |
| w/o Context-aware Adaptive Reweighting | 0.3531 (−2.27%) | 0.1928 (−2.23%) |
(括号内为相对 Full 的差距。)
逐项分析:
- Token 级距离约束贡献最大(−4.59%):作者据此认为"码本邻近度是迁移跨国行为结构的关键"。去掉它之后,候选只剩 side-info(价格/受众/流行度分桶)相似这一条约束——换言之是"同价位、同流行度档的任意跨国物品",接近随机替换。此时 R@100 仍有 0.3447,比 GenCDR 骨干(0.3413)高 1.0%,比最强 baseline GenCDR+Cont(0.3432)高 0.4%。
- Side-info 相似约束(−1.11%):进一步用动态市场属性精修替换,贡献最小。
- 上下文感知重加权(−2.27%):去掉后仍为 0.3531,高于所有 baseline(比 GenCDR+Cont 高 2.9%)。
消融降幅与"对最强 baseline 的领先幅度"的关系:CMRec 在 R@100 Avg6 上领先最强 baseline(GenCDR+Cont,0.3432)+5.27%。三项消融的单项降幅(4.59% / 1.11% / 2.27%)都没有超过这个领先幅度,所以不存在"去掉一个组件后比 baseline 还差很多"那种不自洽的消融;但降幅相加(约 8%)大于总领先(5.27%),说明组件之间存在交互——特别是 token 约束与重加权:token 约束决定候选是否"大体对",重加权在其上做上下文精筛,候选本身太差时重加权也救不回来。最关键的一点:去掉 token 约束后几乎吃掉全部领先(只剩 +0.4%),所以本方法的收益主体来自"用行为+内容码本选替换品"这一步,而不是市场侧 side-info——后者作为论文强调的"market-aware"新信号,只贡献约 1%。按档案"引入新信号 ≠ 收益来源"的口径,论文把 dynamic side-info 包装成与 static 并列的一半贡献,实际它是边角料;真正起作用的是共享码本上的邻近替换 + 模型自评权重。
消融缺失项:没有"行为 i2i 对齐(式 2)去掉、只用纯内容码本"的消融——而这恰恰是区分"CMRec 的 token 约束"与"GenCDR+Cont 的内容替换"的关键变量;也没有 $\lambda$、$\tau$、$\tau_s$ 的敏感性分析。
Figure 3:$p$ 与 $k$ 的敏感性¶
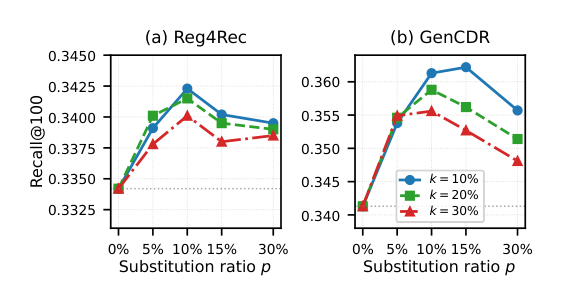
在两个骨干上扫 $(p,k)$:所有组合都一致优于未增强的 baseline,默认 $(p=10\%,k=10\%)$ 在两种情况下都接近最优,作者据此称增强对超参与骨干选择都稳健。
几个读图补充:
- 骨干差异很大:REG4Rec 骨干上最佳提升只有约 +2.4%(0.3342 → 0.3423),GenCDR 骨干上约 +5.9%(0.3413 → 0.3612)。code-mixing 在"本身就是跨域设计"的 GenCDR 上收益更大;在 REG4Rec 上 +2.4% 的提升,也低于它和 GenCDR 之间本来的差距(0.3342 vs 0.3413 已是 +2.1%)。
- 倒 U 形而非单调:$p$ 超过 10–15% 后开始回落,$k$ 越大越差($k=30\%$ 峰值最低)——替换越多、合成序列越偏离真实分布,负面作用越大。这与 SCALR 等合成数据工作里"合成/真实比例存在最优点"的结论一致。
- $p=0$ 点与 baseline 重合:说明(至少在作者的实现里)不做 code-mixing 时 CMRec 与骨干等价,收益全部来自 code-mixing 这一步,而不是来自 CMRec 自己换了一个更好的行为+内容码本做 tokenizer。这排除了"tokenizer 换了"这一个混杂因素,是本文比较干净的一处证据。
归因分析:收益来自 code-mixing,还是只是"多加了跨国数据"?¶
这是评价本文的核心问题,单独拆开讨论。
(1) 数据量匹配的对照存在,而且结论清楚。 GenCDR+Cont 与 GenCDR+CF 被明确设定为"与 CMRec 相同的替换比例和采样预算"——即同样多的孪生样本、同样多的被替换槽位,只是替换准则不同(纯内容 / 纯协同)且无上下文重加权。结果:
| 对比(Industrial,Avg6) | R@10 | R@100 | 相对 GenCDR 的 R@100 变化 |
|---|---|---|---|
| GenCDR(无增强) | 0.2423 | 0.3413 | — |
| GenCDR+Cont(同预算,内容替换) | 0.2404 | 0.3432 | +0.56% |
| GenCDR+CF(同预算,协同替换) | 0.2384 | 0.3412 | −0.03% |
| CMRec w/o token 约束(同预算,近随机替换 + 重加权) | — | 0.3447 | +1.00% |
| CMRec w/o 重加权(同预算,双约束替换,无重加权) | — | 0.3531 | +3.46% |
| CMRec Full | 0.2496 | 0.3613 | +5.86% |
同等数据量下,"多灌一些跨国样本"本身几乎没有收益(+0.56% / −0.03% / 近随机替换 +1.0%),收益随替换准则质量单调上升。这基本回答了"是不是只是加了数据":不是——离线层面,增益可以归因到"替换准则 + 重加权"的质量,而不是数据量。
(2) 但缺一个同样关键的对照:同国替换。 所有同预算对照都是"跨国"替换。论文没有一个"用同样的双约束 + 重加权、但只从本国物品池里挑替换品"的变体。没有它,就无法区分收益到底来自跨国信号(论文的核心叙事:大市场知识流向小市场)还是来自一种通用的、高质量的序列替换增强(CoSeRec 一类方法在单域里也能带来收益)。小国提升更大这一梯度是支持跨国叙事的间接证据,但小国本身数据少、任何正则化增强都更容易在小国见效,所以这个梯度并不能单独定论。
(3) 线上 A/B 的对照组没有说明。 §4.2 只写"在工业平台上 10% 流量、2026-05-10 至 05-20、覆盖全部六国做了 A/B,CMRec 在六国汇总上广告收入 +1.77%、订单 +2.64%"。对照组是什么没有写——是同一个 GenCDR 骨干不做 code-mixing(这才是干净的归因),还是线上原有的生产系统(那样 +1.77% 就混入了"换成 GR 骨干 + 新码本"本身的收益)?同样没有置信区间 / 显著性、没有分国家结果(本文核心卖点就是小国受益,线上却只给六国汇总),也没说明 GR 服务在广告链路的哪一级。按档案"工业署名 ≠ 工业证据"的口径,这个 A/B 只能证明"某个包含 CMRec 的版本在线上赢了某个未说明的对照",不能证明 code-mixing 本身的线上价值。
核心贡献总结¶
- 问题刻画:把"跨国推荐"与依赖重叠锚点的 CDR 区分开,并指出基于 GR 的跨域方法只有参数层迁移、没有数据层跨国共现——这是一个清晰、工业上真实存在(阿里国际多站点)的问题陈述。
- 类比迁移:把多语 NLP 的 code-switching 语料思想移植到推荐序列,用共享语义码本作为"跨国词典",在 token 层做替换。
- 两级噪声控制:物品级的双约束过滤(码本 Hamming 距离 + 按国分位数分桶的市场属性相似)+ 上下文级的模型自评权重 $w=\mathrm{sg}[P(y'|x)/(P(y|x)+P(y'|x))]$。后者是一个简单但巧妙的设计:用原始上下文评估替换目标,用 stop-gradient 防止退化。
- 同预算对照:离线实验提供了替换比例与采样预算匹配的单信号增强对照,使"收益不来自数据量"这一点可以被检验。
与已归档相关工作的对比¶
SCALR SCALR: Synthetic Data from Cross-Domain Events (Meta, 2026-05-29)¶
关系:独立并发(本文未引用 SCALR,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇都认为现有跨域推荐把迁移放在模型层(共享参数 / embedding),而稀疏域真正缺的是训练数据里的跨域信号;两者都把答案放到数据层——在训练之前把富域的行为"翻译"成稀疏域能直接消费的合成训练样本,并都借用 LLM / NLP 里合成数据的类比(SCALR 类比 teacher 输出作合成语料,CMRec 类比 code-switching 语料)。
- 相近的技术骨架:流程图几乎可以对齐——① 估计一个"源物品 → 目标物品"的替换/翻译关系(SCALR 的 $\hat P(i_\mathcal{T}\mid j_\mathcal{S})$,CMRec 的 $\hat{\mathcal{N}}_{\tau,\tau_s}(i)$);② 按它生成合成样本(SCALR 从翻译分布采样 $K$ 个目标物品,CMRec 对序列中比例 $k$ 的槽位抽邻居替换);③ 原始损失 + $\lambda$ 加权的合成损失联合训练(SCALR 式 6 与 CMRec 式 5 结构相同),且都发现合成比例存在倒 U 形最优点。
- 本文的差异与推进:SCALR 的翻译分布靠重叠用户的共现统计估计,CMRec 的设定是用户和物品都零重叠,只能改靠共享的内容+行为码本做"语义翻译"——这是 CMRec 最实质的推进。CMRec 还多了 SCALR 明确留作未来工作的逐样本置信权重:SCALR 当前实现 $w_k\equiv1$、靠采样频率隐式编码置信度,CMRec 用模型自身的相对似然 $w(y,y'|x)$ 做上下文相关的逐样本加权,消融显示去掉它 R@100 掉 2.27%。另外 CMRec 是序列级(替换序列中的若干位置,保留上下文),SCALR 是事件级(单个 (u,i) 对,面向转化预测的判别式模型)。
- 可比的方法 / 实验差异:SCALR 最有价值的实验是体量受控的 top-1 vs 采样对比(采样覆盖约 30% 的目标 catalog,top-1 仅约 4%),CMRec 对应的是同预算下的替换准则对比(内容 / 协同 / 双约束);两者都用"同体量"对照把收益从"数据量"里剥离出来。SCALR 的线上结果是多周一致的 CVR +0.14%–0.24%,对照明确为"同架构、只训原始数据";CMRec 的线上 +1.77% 收入更大,但对照组未说明,归因干净度反而不如 SCALR。
讨论与局限性¶
值得借鉴的设计¶
- $w$ 的"用原始上下文评替换目标"技巧:这是全文最值得拿走的一点。任何合成/替换式序列增强都会遇到"合成样本在上下文里是否合理"的问题;用模型在真实上下文 $x$ 下对 $y'$ 与 $y$ 的相对似然做 stop-gradient 权重,零额外参数、实现简单,并且规避了在 OOD 的 $x'$ 上打分不稳定的问题。它可以直接移植到 SCALR 式的事件级合成、或者 CoSeRec 式的单域增强。
- 按国分位数分桶:把价格/流行度这类跨市场不可比的数值统一成"本国分位数"再比较,是跨市场特征对齐的实用做法。
- 同预算对照的实验设计:给增强类 baseline 与本方法相同的替换比例和采样预算,是评估数据增强方法时应有的标配。
局限与争议¶
- 线上证据薄:A/B 对照组未说明,没有置信区间、没有分国家结果、只有 10 天、10% 流量。本文最核心的主张是"小国受益、大国不受损",线上却只报六国汇总。线上 +1.77% 收入无法归因到 code-mixing 本身。
- 缺少同国替换对照:无法区分"跨国知识迁移"与"高质量序列替换增强的一般正则化效果"。小国提升更大是支持性但非决定性证据。
- 市场侧新信号贡献有限:论文把 static + dynamic 双约束作为核心卖点,但 dynamic side-info 约束只贡献约 1.1%;主体收益来自码本邻近替换(去掉后几乎回到 baseline)与重加权。
- 细节缺失:没有训练超参、模型规模、码本大小;没有说明计算 $w$ 带来的额外前向开销;没有 $\lambda/\tau/\tau_s$ 敏感性;Industrial 只展示 6 国中的 3 国;Amazon M2 是否处理了 locale 间的商品重叠未说明;没有"去掉 i2i 行为对齐、只用内容码本"的消融。
- 收益体量:离线 R@10 / N@10 的提升只有 1–3%,主要提升集中在 @100;绝对提升主要来自单一骨干(GenCDR),在 REG4Rec 骨干上只有约 +2.4%。
- 方法扩展性:码本作为替换底座是离线固化的(论文自己说"更新不频繁"),替换质量受限于码本质量,且码本与 GR 模型不能端到端联合优化——属于档案关注的"核心组件固化"类扩展性隐患,但对于一个训练侧数据增强方法,这一限制影响有限。本文的增强只在训练侧,推理时模型照常生成,不存在"训练侧亮点、推理退回旧范式"的不一致问题("设计不彻底"规则不适用)。
与已有工作的差异¶
与 GenCDR / GMC(参数层迁移)相比,CMRec 在数据层补上跨国共现;与 SRA-CL / CoSeRec 类替换增强相比,CMRec 的准则融合了内容、行为与市场三类信号并加了上下文重加权;与 SCALR 相比,CMRec 不依赖重叠用户。
工业落地价值¶
对多站点跨境电商(阿里国际、Shopee、Amazon 多 locale 等)而言,"各国 ID 与日志完全隔离、小国冷启动"是真实痛点,CMRec 给出了一个不改模型结构、只改训练数据与损失的方案,工程接入成本低:需要一个跨国共享的多模态编码器 + 一个跨国联合训练的 i2i 双塔 + RQ-VAE 码本(很多 GR 系统本来就有)、一张离线预计算的跨国候选表,以及训练时对 10% 样本多一次前向。部署侧报告了广告收入 +1.77%、订单 +2.64%(10% 流量、10 天、六国汇总),但如上所述对照组与显著性均未披露。