Beyond Raw Engagement:Netflix 的反事实可观测性框架¶
Beyond Raw Engagement: A Counterfactual Observability Framework for Recommender Systems at Netflix Chaoran Guo*, Ding Tong*, Ting-Po Lee*†, Scarlet Chen — Netflix(Los Gatos, CA),arXiv 2609.22747v1,2026-09-19 发表于 RecSys 2026 CONSEQUENCES workshop(2026-10-02, Minneapolis),正文 5 页 + 附录 1 页,共 6 页。 类目 cs.IR;关键词:observability, counterfactual, evaluation framework, content creators, incrementality, bias reduction, feedback loop (*三位共同一作;†该工作在 Netflix 期间完成)
这不是一篇模型论文:全文不提出任何网络结构、不跑任何公开 benchmark、不报告任何线上业务指标。它是一份测量方法论 + 少量生产验证的 position/experience paper,主张把「推荐系统对内容创作者与模型开发者的可观测性」形式化成一个反事实测量问题:估计在没有某个内容项或某次模型决策的情况下,推荐器会怎么出、随之而来的互动会是什么样。
研究动机与背景¶
推荐系统的研究绝大多数在优化用户侧的 engagement,而把两类同样依赖这套系统的利益相关方晾在外面:
- 内容创作者(content creators):在 Netflix 的语境里包括 row curator(首页上「某某主题」横排片单的策展人)等角色,他们需要知道「我做的这条内容/这个策展好不好」;
- 模型开发者(model developers):需要知道「我的模型是不是真的在贡献价值、某个上游阶段是不是在白占算力」。
这两类人手上能拿到的只有 views / clicks / likes 这类原始统计量,而这些量被推荐与呈现过程严重污染。论文用一个贯穿全文的例子说明后果:
一条高质量内容可能仅仅因为新上线的模型没把它摆好位置,就在 CTR 上看起来很差,从而导致好内容被低估、或把优化方向带偏。
论文把工业界在这件事上的常见坑归纳为三类(§2):
- ML「黑箱」的透明度不足:大量生产推荐器只暴露高层日志或聚合计数器,缺少诊断数据;性能一跌,创作者和开发者都只能靠猜。
- 评估信号有偏,又细分为两条:
- 呈现偏置(presentation bias):排得越靠前的内容天然拿到越多注意力,与质量无关,直接把点击/播放数吹高;
- 内容表现与模型表现混淆:CTR 同时反映内容质量和模型的推荐有效性,创作者只看 CTR 会得出错误结论。
- 短视野目标:多数评估框架只优化即时互动,会抑制探索,损害留存、内容多样性这类长期结果。
对应地,论文给出三条以利益相关方为中心的可观测性原则:
- 把内容质量与模型行为分开(Separate content quality from model behavior);
- 纠正推荐系统中出现的各类偏置(Correct for different types of bias);
- 让测量与长期业务价值对齐(Align measurements with long-term business value)。
论文自述的三项贡献:(i) 上述三条原则;(ii) 一套从「带 logged selection probability 的 Exploration & Exploitation 模块」出发的统一测量工具箱,覆盖 bias reduction / relativity / incrementality,并首次把 incrementality 测量统一到单阶段与级联两种推荐系统;(iii) 生产验证——仿真对照 ground truth、与 Netflix 历史 A/B 的一致性、以及一个借 incrementality 指标发现 label 误归因 bug 的监控案例。
系统设计:把 E&E 模块放进反馈回路¶
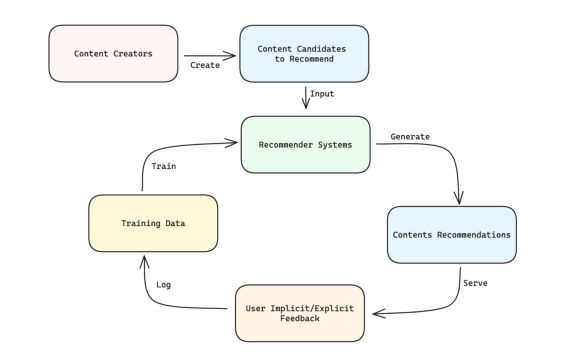
理解全文的前提是附录 6.1 的系统图。传统做法(Figure 4a)里,创作者→内容候选→推荐器→推荐结果→用户反馈→训练数据→推荐器 是一个闭环,而创作者与模型开发者的可观测性完全在这个训练回路之外:
论文的增强设计(Figure 4b)做了两处改动:推荐器内部显式带上 Explore / Exploit 两个分支,训练数据也相应区分 Explore / Exploit;在回路上新挂一个 Evaluation 节点(同时评估 Contents 与 Models),它从用户反馈里 uncover 信号,向创作者与推荐器两个方向 improve:
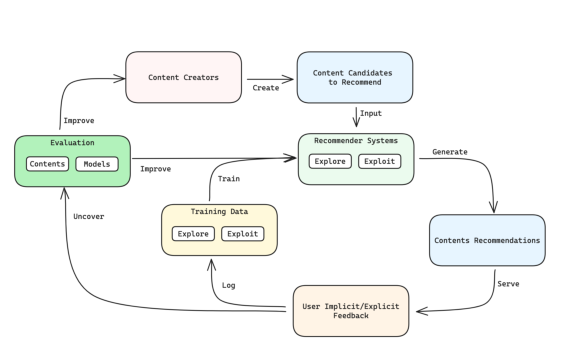
这个设计的关键不是图本身,而是它带来的工程前提:整套测量方法依赖 Exploration & Exploitation 模块记录每个候选被选中的概率 $\pi_0(a_j \mid x_j)$。没有这份 propensity 日志,后面所有 IPS 系估计器都无从谈起。论文明确说 E&E 模块「不仅提供了去偏和解耦内容/模型表现的基础,还让我们能优化平台的长期用户价值」。
核心方法:测量工具箱¶
设定¶
论文在 contextual bandit / RL 框架下建模 E&E 模块:给定上下文 $x_j$,臂 $a_j$ 按策略 $\pi$ 以概率 $\pi(a_j\mid x_j)$ 被选中;若被选中则观测到 reward $r_j$,$r_j$ 可以是 CTR 这类短期 reward,也可以是用户留存这类长期 reward。
1) Bias reduction:SNIPS¶
用 inverse propensity score(IPS)及其 clipped 变体做去偏。对 logged policy $\pi_0$ 下的 target policy $\pi_e$,$N$ 条日志上的 self-normalized IPS(SNIPS) 为
$$\mathrm{SNIPS}=\frac{\sum_{j=1}^{N} r_j\,\dfrac{m(a_{j,\pi_e},a_{j,\pi_0})}{\pi_0(a_j\mid x_j)}}{\sum_{j=1}^{N} \dfrac{m(a_{j,\pi_e},a_{j,\pi_0})}{\pi_0(a_j\mid x_j)}} \tag{1}$$
其中 $m$ 是 match function,衡量 target policy 与 logged policy 的对齐程度。论文在脚注里挑明了一个关键取舍:精确匹配(exact matching)是 $m$ 的一个特例,它给出无偏估计;其他匹配函数则是在 bias-variance 之间做不同权衡——后文级联场景用 Jaccard 相似度做 $m$,就是主动牺牲无偏性换取估计量不恒为零。
2) Relativity:策略级与物品级¶
「相对性」问的是「A 相对 B 怎么样」,分两层:
- 策略级相对性(policy-level):分别以两个策略为 target policy 计算 SNIPS,取差值 → 得到算法 A vs 算法 B。
- 物品级相对性(item-level):问「这条内容相对于同一位置上展示的其他内容表现如何」。设可用内容集合 $\bar c$(含 $|\bar c|$ 条内容)在 $K$ 个位置上被用户浏览,先计算内容 $c_i$ 在位置 $k$ 与「同位置上从 $\bar c$ 随机取一条内容」之间的差值以缓解呈现偏置;由于同一内容会出现在不同位置,再按位置调整权重 $w_k$ across $K$ 个位置聚合:
$$\text{ItemRelativity}(c_i)=\sum_{k=1}^{K} w_k\bigl(\mathrm{SNIPS}_{c_i,k}-\mathrm{SNIPS}_{\bar c,k}\bigr) \tag{2}$$
论文强调:策略级 + 物品级两个分量合在一起,才把算法表现和内容表现分开。
3) Incrementality:反事实的核心¶
这是论文自称「最重要」的一块。对内容问的是:
如果把这一条内容拿掉,等推荐器换上它的次优替代品之后,我们会损失多少价值?
这个反事实视角揭示一条内容的真实贡献,是把内在质量与模型行为分离的关键。
单阶段系统的 Incrementality:Leave-One-Out¶
单阶段(非级联)推荐器在一层内决策,不经过上游候选筛选。论文提出 Leave-One-Out(LOO)测量:在 Exploration policy 之上构造一个模拟策略,对应「某条内容被从内容集合中移除」的反事实。用 Exploration policy 与 Leave-One-Out policy 各自的 SNIPS,incrementality 就是跨位置聚合的 lift:
$$\text{Incrementality}_{\text{single}}=\sum_{k=1}^{K} w_k\bigl(\mathrm{SNIPS}_{\text{Exploration},k}-\mathrm{SNIPS}_{\text{Leave-One-Out},k}\bigr) \tag{3}$$
match function 的具体规则(这是整个 LOO 能落地的关键,论文只用散文描述):$m=1$ 当且仅当
- (i) 被探索到的臂是 Exploration policy 的 top pick,且不是被移除的那条内容;或
- (ii) 它是 second-best pick,且 top pick 正是被移除的那条内容;
否则 $m=0$。直觉很清楚:情形 (i) 是「移除该内容不影响这次决策」,情形 (ii) 是「移除后推荐器会顺位补上谁」——正好覆盖 LOO 反事实下两种可能的实际出牌。
方差控制:把 logged probability 在第 10 百分位处做下截断(cap as a lower bound),避免极小 propensity 把权重放大到爆。
级联系统的 Incrementality:两个受众、两种反事实¶
级联推荐器(retrieval → ranking → reranking)中每一级的候选池来自上游,因此一条内容的观测表现依赖每一级;低互动信号可能反映的是上游过滤,而非内在质量。论文的判断是:该用哪种测量,取决于受众是谁。
A) 面向上游模型开发者:set-similarity Leave-One-Out¶
上游开发者问的是「把物品 $i$ 放进候选池这个决策好不好」。仍沿用 LOO 构造,但因为丢掉 $i$ 会改变整个下游候选池,target action 从「单个 top pick」变成「一个集合」,精确匹配几乎永远命中不了(任何一个物品缺失或重排都会让 $m=0$)。因此论文把 $m$ 重定义为 target policy 候选池与被探索候选池之间的集合相似度(如 Jaccard),per-item lift 仍用与单阶段相同的公式(3)聚合。
读法:跨大量物品的高 lift 说明上游模型确实贡献了真价值;持续偏低的 lift 说明它产出的候选池在下游是可互换的(即这个上游阶段可以砍)。
B) 面向创作者与平台:Irreplaceability × Universality¶
创作者与平台可观测性需要的是一条内容在整条级联上的总体贡献,既要算它多经常有资格进入候选,也要算它一旦被展示能加多少价值。由于在完整流水线上忠实复现一个 LOO policy 代价高昂,论文把总价值分解为两个可解释量:
$$\text{Incrementality}(i)=\text{Irreplaceability}(i)\cdot \text{Universality}(i) \tag{4}$$
- Irreplaceability(i):在 $i$ 有资格进入其候选池的条件下的因果增量 lift;
- Universality(i):$i$ 有资格(eligible)的概率。
论文称这个分解「把条件内容质量与系统触达分离开,这对于拿小众内容与大众内容做比较是必需的」。
估计器细节(附录 6.2)¶
从用户曝光与互动日志出发,为内容 $i$ 构造合成处理样本(synthetic treatment samples):处理指示 $T_j$ 表示 $i$ 是否出现在样本(如一次 session)$j$ 中,$r_j$ 是观测 reward,$\pi_j$ 是 $i$ 在曝光 $j$ 中被选中的 logged probability。
Horvitz–Thompson 形式:
$$\text{Irreplaceability}(i)=\frac{1}{N}\sum_{j=1}^{N}\left(\frac{T_j r_j}{\pi_j}-\frac{(1-T_j)r_j}{1-\pi_j}\right) \tag{5}$$
Hájek(自归一化)形式:
$$\text{Irreplaceability}_{\text{Hájek}}(i)=\frac{\sum_{j\in\mathcal{E}_i} T_j r_j/\pi_j}{\sum_{j\in\mathcal{E}_i} T_j/\pi_j}-\frac{\sum_{j\in\mathcal{E}_i}(1-T_j)r_j/(1-\pi_j)}{\sum_{j\in\mathcal{E}_i}(1-T_j)/(1-\pi_j)} \tag{6}$$
其中 $\mathcal{E}_i$ 是 $i$ 有资格出现的样本集合。论文对两者的取舍说得很清楚:HT 在常规假设下保持无偏,但 propensity 不均时方差很大;Hájek 因为在处理组与对照组内部各自归一化 IPS 权重,有限样本更稳、方差更小,代价是引入一些偏差。具体用哪个「按可观测性场景逐个选」。
无放回的序列生成:很多推荐器要从候选池里生成一个序列(slate / playlist / feed),且是无放回选取——一旦某物品在早前位置被选中,就从池中移除。此时不能用单次 propensity,而要换成累计选中概率。设 $\pi_{ik}$ 是「$i$ 在位置 $k$ 被选中、条件于它在位置 $1..k-1$ 未被选中」的 logged probability,则长度 $K$ 的序列上
$$p_{iK}=1-\prod_{k=1}^{K}(1-\pi_{ik}) \tag{7}$$
用 $p_{iK}$ 替换式(5)中的 $\pi_j$。
Universality:
$$\text{Universality}(i)=\frac{\#\{\text{samples where content } i \text{ is a candidate}\}}{\#\{\text{all samples}\}} \tag{8}$$
即「$i$ 是合格候选的样本占比」。
实验设置¶
论文只有仿真部分给出了完整设置(附录 6.3),线上部分几乎没有可复现细节。
仿真设置:
| 组件 | 设置 |
|---|---|
| 臂空间 | 1,000 条内容 |
| 内在 CTR 分布 | $\mathrm{Beta}(1,8)/4$(刻意选成偏斜分布:多数内容低互动,少数高亲和) |
| Content set | 结构化列表,viewing depth 约束 = 10 |
| Target policy | 拿到「用户-内容亲和度 + $\mathcal{N}(0,\text{noise})$」的噪声版本并据此排序;noise level 就是推荐模型质量的代理 |
| Explore / logging policy | Boltzmann 分布,温度 0.1;记录每个候选的选择概率 |
| 用户亲和度 | 内在 CTR 的噪声实现,噪声为标准差 = CTR 的正态分布,再线性缩放回 $[\min(\text{CTR}),\max(\text{CTR})]$ |
| 用户点击过程 | viewing depth $\sim \mathrm{Poisson}(10)$;顺序浏览至 depth 或列表末尾;每条内容 $\mathrm{Bernoulli}(\text{affinity}_i)$;depth 内任一正实现则该 content set 记为「clicked」,否则「abandoned」 |
| 噪声扫描范围 | 约 0.010 → 0.050(11 个点,见 Figure 1a 横轴) |
真值构造:随机挑两条内容 R1、R2,分别仿真「移除 R1」「移除 R2」得到 $CTR_{R1Removed}$、$CTR_{R2Removed}$,真实 incrementality 即 $CTR_{FullContentSet}-CTR_{R\cdot Removed}$,再与 LOO 测量对比。
线上部分(§4.2)披露的设置:
- 场景:Netflix 首页的 row(由内容策展人 curate 的片单横排);
- 估计器:试过多种,最终选 self-normalized Hájek 估计器以应对异质 propensity;
- propensity 截断到 $[0.0001, 0.9999]$ 进一步降方差;
- 每个 row 至少要求 100 条观测;
- 跨不同长度的首页做聚合;
- 真值:11 次 A/B 测试,做法是把一系列 row 从推荐系统中移除,测量由此产生的用户 engagement 损失。
主要实验结果¶
1) 仿真:Leave-One-Out 对照仿真真值(§4.1)¶
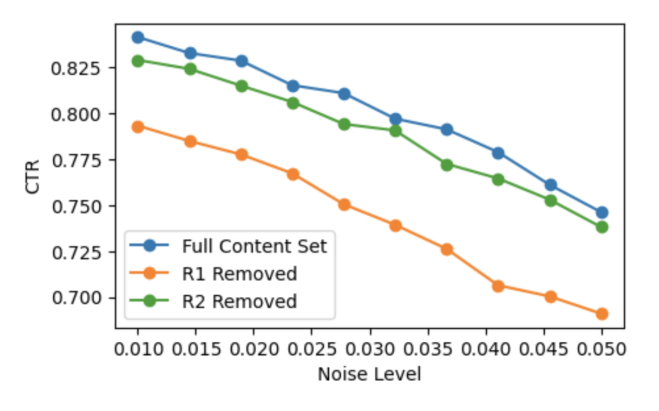
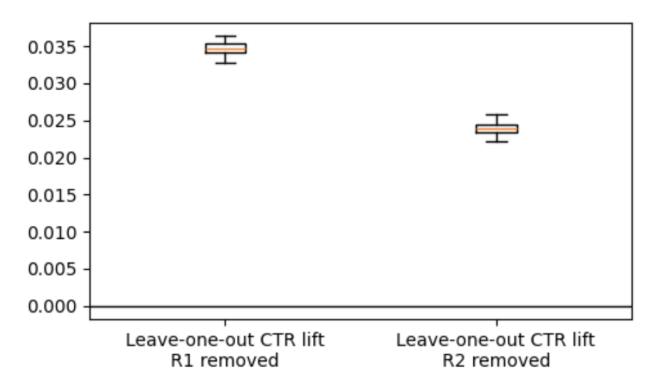
把两张图并排读(数值为读图估算):
| 量 | noise = 0.010 | noise = 0.050 |
|---|---|---|
| $CTR_{FullContentSet}$(蓝) | ≈ 0.841 | ≈ 0.747 |
| $CTR_{R1Removed}$(橙) | ≈ 0.793 | ≈ 0.692 |
| $CTR_{R2Removed}$(绿) | ≈ 0.829 | ≈ 0.739 |
| R1 真实 incrementality | ≈ 0.048 | ≈ 0.055 |
| R2 真实 incrementality | ≈ 0.012 | ≈ 0.008 |
| R1 的 LOO 估计 | ≈ 0.0347(箱体 0.0335–0.0355) | 同左(箱体几乎不随噪声变化) |
| R2 的 LOO 估计 | ≈ 0.0240(箱体 0.0228–0.0250) | 同左 |
论文的结论是:「R1 与 R2 的增量价值在两种方法之间高度吻合;量级差异在低噪声下非常小,随噪声上升而变大,但仍在可容忍范围」,并据此宣称「验证了我们的指标可用于评估单条内容的增量价值」。
我的读图结论与论文自述有落差,这一点必须记下来:
- 序关系确实保住了:R1 > R2 在真值和估计上都成立,作为「排序谁更不可替代」的工具是可用的;
- 但量级并不吻合。R1 被低估约 28%–37%(0.048–0.055 → 0.0347);R2 被高估 2–3 倍(0.008–0.012 → 0.0240)。即使在最低噪声处,R2 的估计也已经是真值的 2 倍——论文「低噪声下差异非常小」的说法对 R2 不成立。
- 估计量几乎不随噪声变化,而真值随噪声单调变化(R1 变大、R2 变小),两者的趋势方向都对不上。若把 LOO 解读为「模型无关的内在增量」,这种不变性可以辩护;但论文明确是拿它去逼近「给定模型下移除该内容的 CTR 损失」这个会随模型质量变化的量,则这里是系统性失配。
- 样本量是两条内容,没有报告任何跨内容的 MSE / 相关系数 / 覆盖率,也没有对照任何更朴素的估计器(如按位置归一化的原始 CTR)。
2) 与线上 A/B 的一致性(§4.2)¶
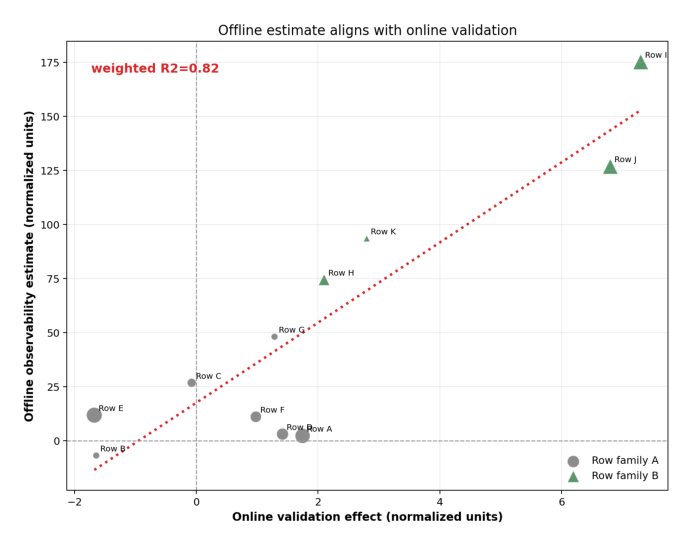
核心结果:跨 11 次 A/B 测试,所提 row incrementality 测量与 A/B 真值之间的加权 $R^2 = 0.8212$。 论文称这是对方法的强验证,并给出业务含义:row curator 可以离线学习哪些策展想法/策略更好、迭代出更强的策展策略,而不必每次都跑 A/B。
图上可读出的细节(论文正文未讨论):
- 共 11 个点(Row A–K),分属两个 row family(灰圆 family A / 绿三角 family B);
- 拟合被右上角两个点(Row I ≈ (7.3, 175)、Row J ≈ (6.8, 126))强烈杠杆化,而这两点的 marker 很小,即观测样本量少;
- 样本量最大的 Row E 出现符号不一致:线上效应约 $-1.6$(负),离线估计约 $+12$(正)。对策展人而言「这条 row 到底是加分还是减分」正是符号问题,而权重最高的那一点符号判错了;
- 两轴都是「normalized units」,没有绝对刻度,因此无法判断校准(斜率是否接近 1、有无系统性缩放),这份验证实际只能支持相对排序而非数值可用;
- 没有置信区间、没有留一交叉验证、没有任何 baseline 对照——论文从未展示「如果直接用原始 row engagement 或简单位置归一化 CTR 去拟合同样 11 个 A/B,$R^2$ 会是多少」。
3) 模型开发者可观测性案例(§4.3)¶
论文搭了一套监控机制,跟踪内容表现指标随时间的变化并检测异常。Figure 3(本次图表提取未能抓出该图,为正文左下角的一张小图)展示了一条「内容 A」的指标(红线)出现突然下跌,而相似内容(绿线)保持相对稳定;这个异常最终导向发现了模型中影响内容 A 正样本标签的 label misattribution(标签误归因)问题。
这张图在原文里横纵轴均无可读标签、无刻度、无日期、无量级,文字也没有给出下跌幅度、检测延迟、误报率或对照基线。它是一个逸事(anecdote),不构成可验证证据。
4) 关于部署收益:论文报告了什么¶
必须明确指出:论文没有报告任何可归因于该框架的部署收益。全文出现的部署表述是「已在 Netflix 多个推荐系统上广泛采用」「历时数年设计与部署」「several production deployments」,但没有任何业务指标(留存 / 观看时长 / 创作者数量 / 内容多样性)、没有任何规模数字(覆盖多少 row、多少内容、多少流量)、没有任何工程成本数字(算力、延迟、存储、propensity 日志规模)。§5 结论里最实在的一句运营收益是「许多测量问题现在可以离线回答,让迭代快得多」——这仍是定性陈述。
换言之,题设里「是否有可归因于框架本身的部署收益」这个问题的答案是:没有任何被报告的部署收益,因此也无从谈归因。唯一量化的生产侧证据就是 §4.2 的 $R^2=0.8212$。
核心贡献总结¶
- 把可观测性重述为全流水线上的反事实测量问题——「若没有这条内容 / 这次模型决策,推荐器会怎么出、互动会如何」。这个 reframe 简洁、可操作,是全文最有价值的部分。
- Incrementality = Irreplaceability × Universality 的分解:把「有资格时的条件质量」与「系统触达」拆开。这是真正可复用的概念产物——它让小众内容与大众内容第一次可比(小众内容可以 Irreplaceability 很高但 Universality 很低),也让「内容差」与「分发不到」两种失败模式在指标上可区分。
- 同一套测量基座服务两类受众:创作者要的是可解释的 per-item 信号,模型开发者要的是 per-stage 的诊断信号;论文指出在级联系统里两者需要的是同一条流水线上的不同反事实(上游 set-similarity LOO vs 全链路分解),这个不对称性讲得很清楚。
- 级联场景下把 match function 放宽为集合相似度:直面「精确匹配在级联里几乎永远不命中」的工程现实,是务实的 hack。
- 11 次真实移除式 A/B 作为离线指标的真值:多数测量类论文根本不做这种验证,这份对照本身是稀缺的。
与已归档相关工作的对比¶
本文的语义指纹是:问题 = 面向内容/创作者的原始互动信号被推荐器自身的曝光决策混淆,导致内容价值不可观测;解法 = 在生产系统里建一层测量基座,用带 propensity 的探索日志做反事实/去偏估计,把「内容内在价值」从「模型分发行为」里剥出来。按此指纹在库内 340 篇 deeply_read 论文中筛选,两篇同时满足问题与解法双同构。
被剔除的近似候选(记录以防门槛放水):
- DADF DADF(Kuaishou):同样处理「原始互动信号有偏」,但它是在训练侧对 watch-time 预测做 Box-Cox 残差校正以提升模型精度,不是建可观测性测量层,解法骨架不重合;
- PEARL PEARL(TikTok):同样用无偏估计(对比指示的无偏 CDF 估计),但目标是做出更好的预测模型而非度量内容价值,受众是模型而非创作者;
- DebiasFirst DebiasFirst(UvA):同样处理 position bias 且同样用 IPS,但对象是 LLM listwise reranking 的模型内部位置偏好,是学术单点方法而非生产可观测性框架。
PinEqualizer PinEqualizer: Full Funnel Content Exploration and Debiasing System at Pinterest(Pinterest, 2026-07-24)¶
关系:独立并发(本文参考文献仅 10 条,未引用 PinEqualizer;两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇都认定「内容的原始互动量不是内容质量的读数,而是推荐器曝光决策的读数」,并都把这件事上升为平台生态健康问题——Netflix 说创作者会被误导、好内容被低估;Pinterest 说这会形成 rich-get-richer 回路,既有内容提供者相对新入场者优势越滚越大。两篇也都明确把级联漏斗的多阶段性当成根因的一部分:低互动信号可能只是上游过滤的结果。
- 相近的技术骨架:都在生产推荐器上新增一层内容级测量基座,都区分「短期可快测的实验指标」与「长期真值」,都要求为此改造系统本体(Netflix 是把 E&E 模块塞进回路以拿到 logged propensity;Pinterest 是在 corpus selection / retrieval / ranking / utility 四段逐段改造并加全漏斗瓶颈分析日志)。两篇都独立得出「per-stage 输入可得性 vs 输出存活率」类型的诊断视角——Netflix 的上游 set-similarity LOO 与 Pinterest 的 output survival rate 回答的是同一个问题:这个上游阶段是不是在扼流。
- 本文的差异与推进:路线在真值来源上完全分岔。PinEqualizer 的真值是实验:长期 fresh-content holdout(treatment 移除新鲜内容,control 随机移除等量内容以消除候选池规模优势),再用 content graduation 做中间代理、用 under-explored content engagement volume 做可快跑的 user-segmented A/B 指标;Netflix 的真值是估计:从 exploration 日志用 SNIPS / HT / Hájek 做 off-policy 反事实估计,A/B 只用来事后校验估计器(11 次,$R^2=0.82$)。两条路各有代价:Pinterest 要长期持有 holdout 桶、要承受实验期的 engagement 成本;Netflix 要先有一个记录 propensity 的探索模块,且估计质量受 propensity 异质性直接支配。另一处推进是粒度:Netflix 给出 per-item 的 Irreplaceability × Universality 分解,可以直接回答「这一条内容值多少」;PinEqualizer 的三层度量都是语料级/群体级的(毕业内容条数、欠探索互动总量),拿不到单条内容的因果增量。
- 可比的方法 / 实验差异:PinEqualizer 有明确的累计业务收益(新鲜内容曝光 +350%、成功内容提供者 +99%,两年迭代部署、覆盖承载 92% 曝光的三大产品面);本文一个业务数字都没有。反过来,PinEqualizer 的 §2.3 明确论证了「user-segmented A/B 因两臂共享内容语料而无法评估内容级指标(content-level leakage)」,并解释了为何放弃 Su et al. 的 user-corpus co-diverted 设计——这恰恰指向本文 §4.2 未处理的隐患:本文拿来当 ground truth 的「把一批 row 从推荐系统中移除」的 A/B,同样是用户分桶实验,两臂共享同一片内容语料,被移除 row 里的 title 完全可能在对照组/实验组通过其他 row 触达用户。Netflix 全文没有讨论这层泄漏,因此 $R^2=0.8212$ 所对齐的「真值」本身的无偏性是未经审视的。
Content Exploration Beyond the Feed: Creator Supply and the Shared Corpus Content Exploration Beyond the Feed: Creator Supply and the Shared Corpus(Snap, 2026-08-29)¶
关系:独立并发(本文未引用;Snap 论文亦未引用本文)· 已加载对方精读
- 共同关注的问题:两篇都在问「一条内容/一次投放的真实增量价值是多少」,都认定标准的用户侧互动读数会系统性地错答这个问题,也都把创作者当作一等受众(Netflix 的 row curator ↔ Snap 的视频创作者)。两篇都用「移除/消融」作为定义增量的方式:Netflix 的 Leave-One-Out 是模拟移除,Snap 的 creator/viewer ablation 是真实移除(一个跑了 8 个月,一个跑了一年多)。
- 相近的技术骨架:都建立在「探索模块产生的随机化」之上——Netflix 用 Boltzmann 探索的 logged selection probability 做 IPS 权重,Snap 用生产探索机制的随机化做 ablation cell。都把总价值做通道分解:Netflix 分成 Irreplaceability(条件质量)× Universality(触达),Snap 分成 direct 观看 / organic take-up / 诱发的创作者供给三通道,并把每个通道映射到能识别它的随机化设计。
- 本文的差异与推进:Snap 走的是识别理论 + 长周期真实消融,Netflix 走的是估计器 + 短周期离线复用日志。Netflix 的优势是便宜且高频——不必持有 8 个月的消融桶就能每天出每条内容的增量读数,这正是 §5 强调的「许多测量问题现在可以离线回答」。但 Snap 的 Theorem 1 直接给本文的方法论划了一条本文从未提及的边界:单侧(用户分桶)实验里两臂共享同一语料,语料通道在任何视野、任何样本量下都恒被抵消;而在换手率 $\omega$ 下,$t$ 周期实验最多表达渐近效应的 $\omega t$。Netflix 的 LOO 与 Irreplaceability 全部建立在用户侧曝光日志上,因此它们在构造上能测的只有 Snap 所说的 direct 通道(可能带一点 take-up),创作者供给响应与语料存量通道对它是结构性盲区。Snap 的数值给出了这个盲区的大小:在回路增益 $\mathcal{R}=0$ 时创作者通道已占一次曝光边际价值的 46%,$\mathcal{R}=0.7$ 时 70%,$\mathcal{R}=0.95$ 时 87%。这对 Netflix 的定位不是致命伤(Netflix 是自制 + 授权内容库,创作者供给回路的增益 $\mathcal{R}$ 远低于 UGC 短视频平台),但论文的第三条原则明写「让测量与长期业务价值对齐」,而它给出的所有估计器测的都是短期用户侧 reward 的反事实差,这条原则在方法层面实际是空的。
- 可比的方法 / 实验差异:Snap 有有符号的生产结论(相对最小保底,人均发布 +8.55%、至少发布一次的创作者 +7.10%),并诚实报告「三周 co-diverted 探针如理论预测那样无法给语料渐近效应定号」——即明说自己测不出什么。Netflix 的对应位置是「广泛采用、几个生产部署」,没有数字,也没有任何「本框架测不了什么」的声明。两篇在实验证据密度上不在一个量级。
讨论与局限性¶
值得借鉴的设计¶
- Irreplaceability × Universality 是可以直接拿走用的抽象。任何有冷启/长尾内容的平台,都会遇到「这条内容互动低,是它不行还是它根本没机会」的争论;把总增量拆成「有机会时的条件增量」与「有机会的概率」,把这场争论变成两个可分别测量、可分别归因到不同团队(内容侧 vs 分发侧)的数字。
- 把 E&E 模块当成可观测性的基础设施,而不只是 exploration 的执行器。论文最实在的工程主张是:只要在生产里老老实实记 selection probability,你就同时买到了去偏、策略对比、内容增量三件事的估计基座。这个 ROI 论证对说服工程团队加 propensity 日志是有用的。
- 级联里放宽 match function 为集合相似度。承认「无偏但永远不触发」的估计器在工业上等于没有,主动换成有偏但有信号的版本,并把这个取舍写在脚注里,是诚实且可复用的工程判断。
局限与争议¶
- 框架只在「原则 + 一个窄切面」层面被验证,而声称覆盖四类测量构件。全文提出的测量构件有四组:单阶段 LOO、物品级 position-adjusted relativity、级联上游 set-similarity LOO、级联全链路 Irreplaceability × Universality。而验证只有:单阶段 LOO 的两条内容合成仿真(且量级明显失配)、级联分解在首页 row 一个物料形态上的 11 次 A/B 对齐。上游 set-similarity LOO 零验证,策略级/物品级 relativity 零验证,Universality 这一半从未被单独验证($R^2$ 验证的是乘积,无法判断分解是否各自正确,也可能是两个错误相消)。式(4)的乘积形式本身是断言而非推导:它隐含「资格获得与条件增量在某种意义上可分」的假设,论文既未写出这个假设,也未讨论它何时失效(例如一条内容恰恰因为在某类 session 里更容易被判为 eligible,这类 session 又恰恰是它 Irreplaceability 更高的场合——此时乘积会系统性低估)。
- $R^2=0.82$ 没有 baseline 对照,因此不能归因给反事实机制本身。这是本条最该扣分的地方:论文引入了一整套新信号(logged propensity、模拟 LOO policy、Hájek 估计器、位置权重聚合),却从未展示去掉这些机制后的朴素替代物(原始 row engagement、按位置归一化的 row CTR、甚至 row 的曝光量)在同样 11 次 A/B 上能拿到多少 $R^2$。引入新信号 ≠ 收益来源:在只有 11 个点、且被右上角两个小样本高杠杆点主导的散点上,一个简单得多的指标很可能也能拿到接近的 $R^2$。没有这条对照,全文最硬的那个数字撑不起「验证了反事实框架」的结论,只能撑起「我们做了一个与 A/B 相关的离线指标」。
- 截断策略在最需要它的地方最不可信。方法在两处做了重截断:LOO 把 logged probability 在第 10 百分位处做下截断,线上把 propensity 截到 $[0.0001,0.9999]$,并要求每个 row 至少 100 条观测。IPS 系估计器的偏差恰恰集中在小 propensity 区域,而小 propensity 正是长尾/冷启内容所在的区域——也就是创作者可观测性最有价值的那一段。换句话说,这套面向创作者的测量在头部内容上最准、在长尾内容上最不准,而头部内容本来就不需要它。论文没有讨论截断引入的偏差方向与量级。
- 「模型无关」的宣称与实现之间有内在张力。§3.1 说这套指标「agnostic to model exposure」,但式(2)(3) 都要跨位置按 $w_k$ 聚合,而一条内容实际出现在哪些位置,正是当前模型决定的;$w_k$ 本身在全文中从未被定义(既没说怎么选、也没说是否随场景调整)。realized position 分布是模型行为的直接函数,因此模型行为通过聚合权重重新渗回了一个声称与模型无关的指标里。
- 可复现性接近于零。match function 只用散文描述、无算法框;$w_k$ 无定义;$K$ 未给;内容集合规模、propensity 实际分布、每次 A/B 的流量与时长、11 个 row 的类型分布、$R^2$ 的加权方式全部缺失;Figure 3 无坐标轴。这在 6 页 workshop 论文里可以理解,但也意味着框架无法被独立复现或检验,「generic / 可迁移到其他平台」的宣称只能按意图理解,不能按证据理解。
- 工业署名 ≠ 工业证据。Netflix + 「历时数年部署」是署名与叙事,而可核查的生产证据只有 11 次 A/B 的一个相关系数。没有规模、没有业务收益、没有成本、没有失败案例、没有 rollout 过程。§5 的「飞轮」段落(更好的测量 → 更好的内容与更好的决策 → 更多用户 → 更丰富信号 → 更好的测量)是纯修辞,论文没有测量这个飞轮的任何一环。
- 方法论可扩展性:硬前提 + 短视野。整套框架的前提是「生产系统里存在一个记录 selection probability 的 E&E 模块」,这对大多数团队是一次不小的改造;一旦没有随机化,全部估计器失效(这也是论文自己在 §1 结尾承认的适用边界:「适用于带 exploration-based logging 的推荐系统」)。更根本的是,reward $r_j$ 在所有实现里都是单次曝光尺度上的短期互动,而论文的第三条原则要的是长期价值——如 Snap 那篇所证,长期通道(创作者供给、语料存量)在用户侧随机化对比里结构性地测不出来,不是加样本能解决的。因此这套框架能 scale 的是广度(更多内容、更多阶段、更多产品面),而不是视野。
- 文本层面的粗糙:参考文献 [9] 与 [10] 是同一篇(Swaminathan & Joachims 2015)重复录入;§4.1 写「as described in Section 3.3」但单阶段 LOO 在 §3.2;Figure 3 无坐标标签。这些不改变技术判断,但与「历时数年、广泛部署」的叙事形成反差,符合一篇赶 workshop deadline 的稿件形态。
一句话判断¶
框架被真正验证的只有一个切面(首页 row 的级联增量分解,11 次 A/B,$R^2=0.82$ 且无 baseline 对照),其余构件停留在原则与公式层;论文报告的部署事实全部是定性的,不存在任何可归因于本框架的业务收益数字。 值得带走的是 Irreplaceability × Universality 这个分解和「把 E&E 当可观测性基建」的工程主张;不值得带走的是它对自身验证强度的描述。