OneLA: Scaling Linear-Attention Decoding to Large Beams in Generative Recommendation¶
一句话总结¶
OneLA 指出线性注意力(GDN)在生成式推荐中把"序列长度"瓶颈换成了新的"beam 宽度"瓶颈——每条 beam 各自物化一份 $d_v \times d_k$ 循环状态使显存与访存随 beam 数线性膨胀,且全局 beam 选择每步都要搬运状态——并用"一份共享 prefill 状态 + 只追加的紧凑转移记录(GTR)+ 轻量祖先索引 + 融合共享上下文 kernel"取代逐 beam 状态物化,把状态从来不重建、只把两个向量投影沿祖先链重放,在离线实验上取得 1.54–2.46× 端到端解码提速与 20–56× 持久状态容量下降。
1. 研究动机与背景¶
1.1 GR 的解码形状:长共享 prompt + 短 SID 后缀 + 大 beam¶
生成式推荐(Generative Recommendation, GR)把候选生成重写成自回归序列生成:每个物品 $i$ 被表示成一小段离散语义 ID(Semantic ID, SID)序列 $\mathbf{s}_i = (s_i^1, \dots, s_i^T)$,模型在用户 prompt $\mathbf x$ 条件下逐级生成
$$\prod_{t=1}^{T} P\!\left(s_i^t \mid \mathbf x, s_i^{<t}\right) \tag{1}$$
生成结束后完整 SID 序列再映射回物品。OneRec、OneReason、PLUM、S-GRec 等工业系统已经把 SID 生成确立为 GR 的通用形式。
但和常规文本生成最关键的差别在于:GR 一次请求要吐出几百个候选物品,而不是一条最优序列。因此它依赖 large-beam decoding——每个解码步所有活跃 beam 在 SID 码本上展开,再全局取 top-$k$ 保留。多个存活的孩子可能来自同一个父亲,另一些父亲则整个消失,于是父映射 $\pi_t(b)$ 每步都在变,形成一棵动态 beam 树。
论文把这个负载的形状概括为一句关键不等式:
$$L_{\text{prompt}} \gg T, \qquad W_t \gg T \tag{2}$$
即 prompt 长度和 beam 宽度都远大于 SID 序列长度。这与 LLM 服务的典型形状(长 prompt、长生成、beam=1)完全相反,是后文所有设计的出发点。
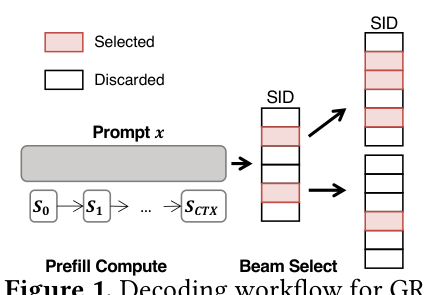
图 1 概括了这个流程:prefill 把共享 prompt 压成状态,随后 beam 选择反复展开并保留候选 SID 序列。
1.2 线性注意力解决了长度,却把 beam 宽度变成新瓶颈¶
用户历史很长,常规注意力在序列长度上是二次计算、KV cache 线性增长,因此 GR 里越来越多地采用线性注意力。本文以 Gated DeltaNet (GDN) 作为代表实例——它被 Qwen3-Next 等前沿 LLM 广泛采用。GDN 每个 head 把之前的历史压进一个固定大小的循环状态 $S_t \in \mathbb{R}^{d_v \times d_k}$,每个 token 更新一次:
$$S_t = \alpha_t S_{t-1} + \beta_t\left(v_t - \alpha_t S_{t-1} k_t\right) k_t^{\top}, \qquad o_t = S_t q_t \tag{3}$$
其中 $\alpha_t$ 控制状态衰减、$\beta_t$ 控制修正强度,$q_t$、$k_t$ 为 query 与 key。论文把一次 $S_{t-1} \to S_t$ 的更新称为一个 GDN transition step:状态 $S_t$ 概括了到 token $t$ 为止的全部历史,输出 $o_t$ 沿 query $q_t$ 把它读出来。
问题恰恰出在"固定大小"这个优点上:固定大小是相对序列长度而言的,对 beam 宽度并不固定。维持 $w$ 条活跃 beam 各自独立的状态需要 $\Theta(w\, d_v d_k)$ 的持久容量,而且每个解码步都要按 beam 维度读出、写回这些状态。线性注意力把长度维的开销压掉了,却让 beam 维的开销原样暴露出来——beam 宽度成了循环线性注意力一个全新的 scaling 维度,这是本文的第一条贡献。
1.3 现有服务框架为什么不适配¶
通用 LLM 服务系统的 KV-cache 管理与注意力执行都是围绕"每条序列拥有独立状态"这个前提设计的,它们的 GDN 执行路径继承了同样的假设:一条 beam 要么持有自己完整的循环状态,要么从自己的历史重建一份,两种情况下状态都被绑定在持有它的逻辑 beam 上。而 GR 的全局 beam 选择每步都在重排和复制 beam,这种绑定就逼着状态被拷贝、重建或重算。
具体到框架层面,论文的调研结论是:
| 框架 | GDN + beam search 端到端支持 | 状态管理方式 | 主要问题 |
|---|---|---|---|
| vLLM FullState | ✅ 原生支持 | 每条活跃 beam 一份完整循环状态 | 大量巨大的 full-state 矩阵;beam 重排要搬状态 |
| vLLM ReplaySSM | ✅ 原生支持 | prompt block 边界上打状态 checkpoint,之后前缀重放 | 不区分长共享 prompt 与短 decode,可能留下很长的 prompt 尾巴要重放;每条 beam 被当成独立请求,各自加载 checkpoint 并重放 |
| SGLang / FlashInfer / TensorRT-LLM | ❌ 仅算子级 | — | 没有端到端 GDN + beam search 服务路径 |
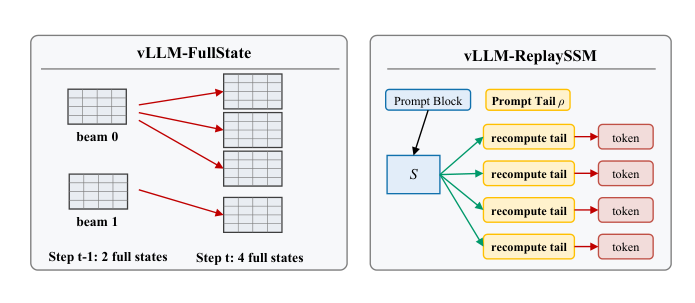
图 2 画出了这两条路径的病灶:FullState 在步 $t-1$ 有 2 份完整状态、到步 $t$ 变成 4 份;ReplaySSM 则每条 beam 都要从 prompt block 边界重算一段"recompute tail"。
归纳起来两点失效原因:
- beam 维带来新的容量与访存放大:$\Theta(w\, d_v d_k)$ 的持久状态,以及每步按 beam 数放大的状态读与写回;
- 动态 beam 演化与"状态绑定逻辑 beam"冲突:全局 beam 选择会重排、复制 beam 并改变 beam 宽度,父子重新指派就变成状态拷贝、重建或重算。
结论是:高效的大 beam GDN 解码必须既避免为每条 beam 物化完整循环状态,又把逻辑 beam 演化与物化状态的放置解耦。
1.4 两条关键洞察¶
洞察一:状态可以不被重建。 同一请求内所有候选 beam 源自同一份 prompt 派生的循环状态,只通过一小段 GDN transition step 发散开;每个 transition step 可以用一个远小于完整状态的紧凑元组表示;更关键的是——每个 transition step 只通过两次投影消费循环状态,状态本身根本不需要被重建。
洞察二:记录可以不被搬动。 beam 选择只改变"哪条存活 beam 引用哪些历史记录",并不修改已经产生的循环更新本身。因此这些记录可以保持不可变、只追加,用轻量的祖先元数据指明每条 beam 由哪些记录构成,从而在 beam 选择推进时完全不需要搬动状态或记录。
2. 核心方法:OneLA¶
2.1 设计总览与符号¶
记 $t$ 为当前解码步,$W_t$ 为步 $t$ 的活跃 beam 数,$b \in \{0, \dots, W_t - 1\}$ 为一条 beam;$t > 0$ 时 $\pi_t(b)$ 表示 $b$ 在上一步被选中的父亲。记 $S_{\text{ctx}}$ 为 prompt prefill 之后产生的循环状态,同一请求内所有 beam 共享这一份。$S_{t,b}$ 表示 beam $b$ 在解码步 $t$ 之后的概念上的循环状态——它在 OneLA 中从不被物化。以下描述均针对单请求、单 GDN head,省略请求与 head 下标。
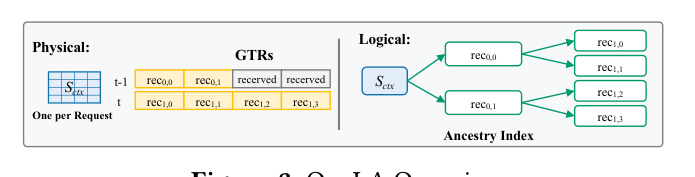
如图 3,OneLA 把状态管理拆成三层:
- 逻辑层:每请求一份 $S_{\text{ctx}}$;
- 物理层:只追加的 GTRs(GDN Transition Records),写进固定物理槽后永不迁移;
- 索引层:Ancestry Index,记录每条 beam 由哪些物理槽的记录构成。
图中 $t-1$ 到 $t$ 的变化里,被淘汰的记录标为 recerved(保留在原槽不动),存活 beam 只是改变了自己引用的槽序列。
2.2 GTR:紧凑的状态转移记录¶
先把 GDN 更新式改写成显式的秩一更新形式:
$$S_t = \alpha_t S_{t-1} + \beta_t\left(v_t - \alpha_t S_{t-1} k_t\right)k_t^{\top} = \alpha_t S_{t-1} + \delta_t k_t^{\top} \tag{4}$$
其中 $\delta_t = \beta_t\left(v_t - \alpha_t S_{t-1} k_t\right)$,$S_{t-1}$ 是被选中父 beam 的状态,初始状态就是共享的 $S_{\text{ctx}}$。论文把三元组
$$r_t = (\alpha_t,\ \delta_t,\ k_t) \tag{5}$$
称为一个 GDN Transition Record (GTR)。给定父状态,一个 GTR 完整决定了到子状态的转移。
存储代价对比:传统 FullState 要为每条活跃 beam 持久化一个 $d_v \times d_k$ 的矩阵,即 $O(d_v d_k)$;而一个 GTR 只含一个标量衰减因子、一个 $d_v$ 维更新向量和一个 $d_k$ 维 key 向量,只要 $O(d_v + d_k)$。以 $d_v = d_k = 128$ 为例,前者 16384 个元素,后者 257 个——单条转移记录约省 64×。
为什么存 $\delta_t$ 而不是 $(\beta_t, v_t)$? 这是整个设计里最关键、也最容易被略过的一个细节,论文专门论证了它。重放过程从来不需要状态矩阵本身,只需要它在当前 query 与 key 上的投影,而一条记录对这两个投影的贡献恰好是 $\delta_t$ 乘上一个标量点积。如果改存 $(\beta_t, v_t)$,那么这条记录的贡献仍然依赖父状态 $S_{t-1}$(因为 $\delta_t$ 的定义里含 $S_{t-1}k_t$),就必须先把父状态重建出来才能使用这条记录——记录本身的意义就被抵消了。换句话说,$\delta_t$ 是把"对状态的依赖"提前求值并固化下来的那一步。
2.3 投影重放(Projection Replay)¶
把 beam 表示成 GTR 序列消除了持久矩阵存储,但计算下一个解码步仍然需要历史状态的信息。关键观察是:一个 GDN 层只通过两次向量收缩与前一状态 $S_{t-1}$ 交互——key 投影 $S_{t-1}k_t$(用于产生更新量 $\delta_t$)和 query 投影 $S_{t-1}q_t$(用于产生输出 $o_t$)。
因此 OneLA 不去即时重建那个 $d_v \times d_k$ 的中间矩阵,而是直接沿当前 beam 的祖先 GTR 链求这两个投影。定义 query 投影累加器 $u_q^{(j)} \equiv S_j q_t$ 与 key 投影累加器 $u_k^{(j)} \equiv S_j k_t$,其中 $j$ 是沿 beam 祖先的重放深度。把式 (4) 的状态转移右乘 $q_t$ 或 $k_t$,即得如下递推(从共享上下文起步):
$$u_q^{(-1)} = S_{\text{ctx}} q_t, \qquad u_q^{(j)} = \alpha_j u_q^{(j-1)} + \delta_j\left(k_j^{\top} q_t\right) \tag{6}$$
$$u_k^{(-1)} = S_{\text{ctx}} k_t, \qquad u_k^{(j)} = \alpha_j u_k^{(j-1)} + \delta_j\left(k_j^{\top} k_t\right), \qquad 0 \le j < t \tag{7}$$
重放到 $j = t-1$ 之后,两个累加器直接给出当前 GDN 计算所需的两个投影,于是当前步的更新量与输出为:
$$\delta_t = \beta_t\left(v_t - \alpha_t u_k^{(t-1)}\right), \qquad o_t = \alpha_t u_q^{(t-1)} + \delta_t\left(k_t^{\top} q_t\right) \tag{8}$$
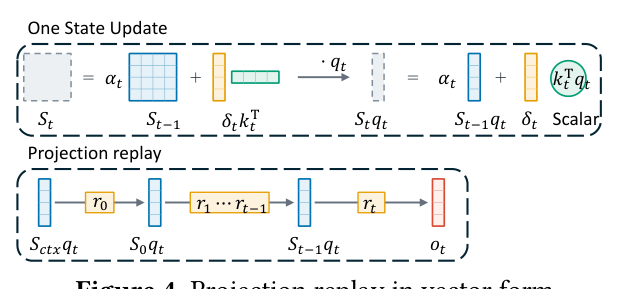
图 4 直观展示了这次"降维":左边是矩阵形式的一次状态更新 $S_t = \alpha_t S_{t-1} + \delta_t k_t^{\top}$,右边是右乘 $q_t$ 之后的向量形式——矩阵外积 $\delta_t k_t^{\top}$ 退化成 标量 $k_t^{\top}q_t$ 乘以向量 $\delta_t$。
这就是全文的技术核心:因为层只从右边乘状态,就可以把右乘一路推穿整条祖先链,全程只维护两个 $d_v$ 维累加器,从头到尾不出现 $d_v \times d_k$ 的中间矩阵。重放深度被固定长度的 SID 序列严格界住($j < t \le T$),所以这是一次用受控的计算换掉内存的交易,而不是无界的重算。
复杂度对照(单 head、单请求、$W$ 条 beam、SID 长度 $T$):
| 持久状态容量 | 每步每 beam 的状态读写 | 每步每 beam 的计算 | |
|---|---|---|---|
| FullState | $\Theta(W d_v d_k)$ | 读 + 写回一个 $d_v \times d_k$ 矩阵 | $O(d_v d_k)$ 矩阵运算 |
| OneLA | $\Theta(d_v d_k) + \Theta(W T (d_v + d_k))$ | 读 $t$ 个 GTR + 共享 $S_{\text{ctx}}$,写 1 个 GTR | $O(t(d_v + d_k))$ 向量运算 |
注意 $\Theta(d_v d_k)$ 那一项与 $W$ 无关——这正是收益的主要来源:$S_{\text{ctx}}$ 每请求只有一份,而不是每 beam 一份。
2.4 动态 Beam 祖先索引¶
真实的动态 beam search 会剪枝、重排、扇出 beam,一条逻辑 beam 很难被绑定到一组固定的物理记录上。但正如洞察二所说,这些操作并不修改已生成的转移记录,只是更新"每条存活 beam 引用哪些记录"。
OneLA 因此让 GTR 只追加地留在它们原来的物理槽里,用一个轻量祖先索引单独追踪 beam 演化。对步 $t$ 的 beam $b$,定义 $h_t(b, j)$ 为沿 $b$ 的祖先链上、解码步 $j$($j < t$)那个 GTR 的物理槽号。设 $\pi_t(b)$ 为 $b$ 的父 beam,索引更新规则为:
$$h_t(b, j) = \begin{cases} h_{t-1}\!\left(\pi_t(b),\, j\right), & 0 \le j < t-1 \\[4pt] \pi_t(b), & j = t-1 \end{cases} \tag{9}$$
即每个孩子直接复用父亲的祖先索引,并把父亲的物理槽号记为紧邻的前一步。新产生的 GTR 只写一次到当前解码步的物理槽,此后永不迁移。逻辑 beam 树完全由祖先索引表示,底层 GTR 保持不可变。
这层间接寻址带来的效果非常干净:
- 剪枝 = 丢弃引用;
- 重排 = 改变引用顺序;
- 扇出 = 复制祖先索引(几个整数),而不是复制对应的 GTR 链。
因此动态 beam 选择不需要搬动或复制任何历史 GTR。重放时按 $r_{j,\,h_t(b,j)}$ 直接取深度 $j$ 的记录,就得到当前 beam 精确对应的 GTR 序列。
2.5 融合的共享上下文注意力 Kernel¶
紧凑表示消掉了逐 beam 的全状态持久化,但这些内存收益必须在 GPU 执行时也保住:$S_{\text{ctx}}$ 是跨 beam 共享的,不应该被反复从 HBM 取;重放过程中的瞬时投影也不应该在内存里物化。
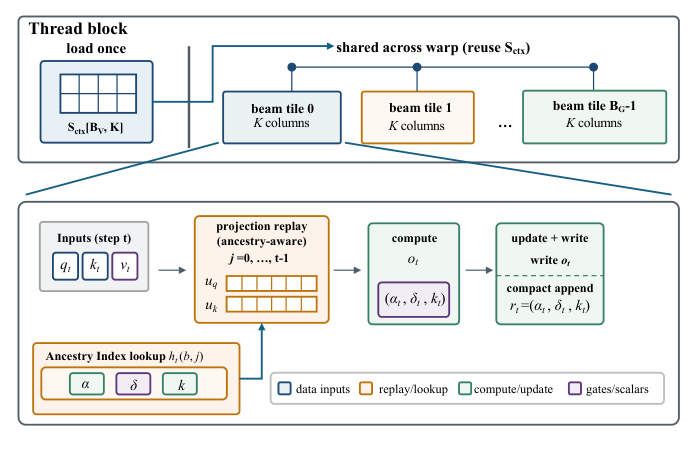
OneLA 为此设计了融合 kernel(图 5):
- 跨 beam 复用:每个 GPU thread block 被分配 value 维上的一个 $B_V$ 行 tile,外加一组 beam。block 把对应的 $S_{\text{ctx}}[B_V, d_k]$ tile 一次性载入片上存储,在该 block 处理的所有 beam tile 之间复用。这把读 $S_{\text{ctx}}$ 的 HBM 代价摊薄到多条 beam 上,而不是每条 beam 各自承担一次。
- 单流融合:block 内先载入当前的 query / key / value / gate 输入,用 $S_{\text{ctx}}$ tile 初始化两个投影累加器 $u_q = S_{\text{ctx}}q_t$、$u_k = S_{\text{ctx}}k_t$;随后按祖先索引重放——(a) 在重放深度 $j$ 用 $h_t(b,j)$ 把逻辑祖先位置映射到物理 GTR 槽并 gather $r_j = (\alpha_j, \delta_j, k_j)$;(b) 把重放直接作用在两个累加器上,全程不重建中间循环状态矩阵 $S_j$;(c) 累加器持有的正是 $S_{t-1}q_t$ 与 $S_{t-1}k_t$,立刻用来算当前的 $r_t$ 与 $o_t$。
- 只写紧凑记录:kernel 最后只为每条新生成的 beam 追加紧凑 GTR $r_t = (\alpha_t, \delta_t, k_t)$,而不是写回一个完整的 $S_t \in \mathbb{R}^{d_v \times d_k}$——消除了巨大的逐 beam 状态写回开销,并让紧凑表示在整个解码过程中一直成立。
由于以上步骤融合进一个 kernel 且不重建任何中间状态矩阵,中间值全部留在片上,不落 HBM。
3. 实验设置¶
评测要回答三个问题:(Q1) OneLA 对端到端整模型解码性能的改善有多大?(Q2) GR GDN 注意力 kernel 的延迟与状态容量优势能否跨负载与模型配置保持?(Q3) OneLA 的重放执行效率如何,能减少多少访存与内存占用?
符号:$R$ 为请求数,$W$ 为固定逻辑 beam 宽度,$O$ 为输出 token 总数。prefill 选出第一个输出 token,因此剩下 $T = O - 1$ 次 decode 调用。
整模型实验:0.8B 的 Qwen3.5 模型,6 层 full attention + 18 层 GDN;$R = 4$,$W = 256$,prompt 长度 1K / 5K,$O = 3\text{–}7$。
算子实验:405 种 shape,覆盖 $R = 4/8/16$,$W = 128/256/512$,$T = 2\text{–}6$,以及 9 种循环几何($H_K = 4\text{–}32$,$H_V = 4\text{–}64$,$K = 128\text{–}256$,$V = 128\text{–}512$)。
对比对象:在相同输入与相同的重排-复制 lineage 下,把 OneLA 与未经修改的 vLLM / SGLang 的 FullState 与 ReplaySSM kernel、FlashInfer、TensorRT-LLM FullState 在各自原生支持的 shape 上配对比较。
四条端到端执行路径:vLLM FullState、vLLM ReplaySSM(框架原生参照)、Controlled FullState(与 OneLA 用同一条 decode 流水线,但保留传统的逐 beam FullState 执行)、OneLA(完整系统)。
4. 主要实验结果¶
4.1 端到端 decode-forward 性能(Q1)¶
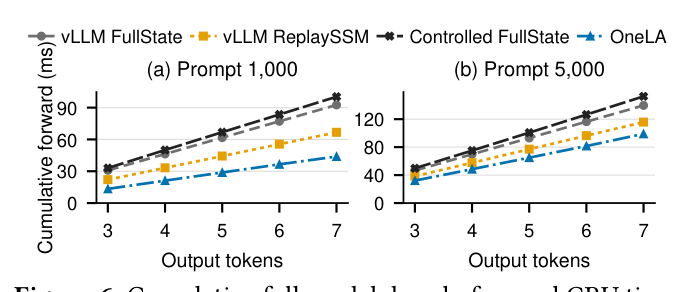
图 6 报告了两种 prompt 长度下整模型的 decode-forward GPU 时间(累计,随输出 token 数 3→7 增长)。关键结论:
| 对比 | 结果 |
|---|---|
| Controlled FullState vs 原生 vLLM FullState | 相差 6.9–9.3% 以内 |
| OneLA vs Controlled FullState | 累计 decode-forward 时间降低 1.54–2.46× |
| OneLA vs 两条 vLLM 路径 | 论文称"consistently outperforms",但未给出具体倍数 |
分析:第一行是一个设计得不错的对照——它证明作者自己的流水线实现确实忠实复现了框架基线,因而第二行的收益可以归因到循环状态计算这一处替换,而不是流水线工程。但第二行也正是全文最重要的那个数字被测在哪条基线上的答案:Controlled FullState,也就是 FullState 路径。而 FullState 恰恰是两条可用路径里较弱的那条——从 §4.3 的算子中位数看,ReplaySSM 比 FullState 快约 $40.5/17.5 \approx 2.3\times$。论文对更强的 ReplaySSM 基线只给了图上的曲线和一句定性描述,没有报出端到端倍数。这一点后文"讨论与局限性"会详细展开。
4.2 GR GDN 注意力的泛化性(Q2)¶
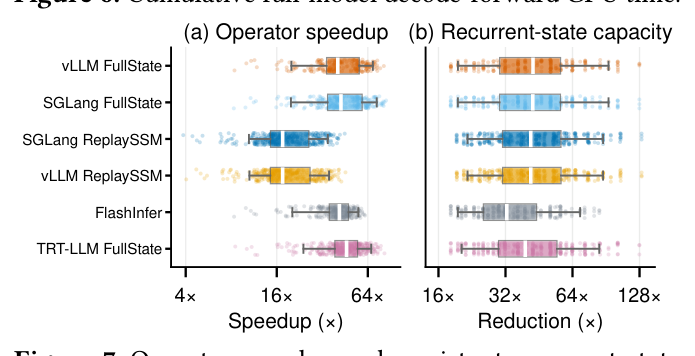
图 7 把 GDN 注意力算子单独隔离出来,在每对配对负载上报告 baseline/OneLA 的比值(箱体为中位数与四分位距,须为 5–95 分位)。
(a) 算子延迟加速比(中位数):
| 基线 | 中位加速比 |
|---|---|
| vLLM FullState | 40.5× |
| SGLang FullState | 42.5× |
| vLLM ReplaySSM | 17.5× |
| SGLang ReplaySSM | 17.5× |
| FlashInfer | 41.5× |
| TensorRT-LLM FullState | 46.3× |
在最大的 Qwen 几何($R=16$、$W=512$、$H_K=H_V=16$、$K=V=128$)上,OneLA 在 $O=3$ 用 0.212 ms、$O=7$ 用 0.990 ms,对该 shape 上支持的四条基线取得 16.0–56.5× 加速。
数值正确性:在全部 405 个 OneLA 用例上,相对 FP32 FullState 的最大绝对输出误差为 $4.88 \times 10^{-4}$。这一条很重要——它说明投影重放是数学等价的重排,而不是有损近似,因此推荐质量天然不受影响,也解释了论文为什么没有(也不需要)报告任何推荐指标。
(b) 持久循环状态容量:跨配对负载,OneLA 把中位所需容量相对基线最多降低 42.5×。
分析:这里出现了全文最需要警惕的一处落差——算子级 17.5–46.3× 的中位加速,到端到端只剩 1.54–2.46×。这是标准的 Amdahl 效应:0.8B 模型里只有 18 层 GDN,而每层 GDN 里 OneLA 触及的只是循环状态那一段,QKV/输出投影与 FFN 原封不动,另有 6 层 full attention 完全不受影响。论文在摘要里以 1.54–2.46× 这个诚实的数字打头,这一点值得肯定;但正文里体量最大、视觉最醒目的仍是那些几十倍的算子数字。读者若只记住 40×,会严重高估这项工作的实际收益。
4.3 性能来源拆解(Q3)¶
在 Qwen 几何、$R=4$、$W=512$ 下,论文隔离出完整的循环状态路径,用三组互补测量做拆解:状态路径延迟、持久容量与逻辑写入、物理 DRAM 流量。
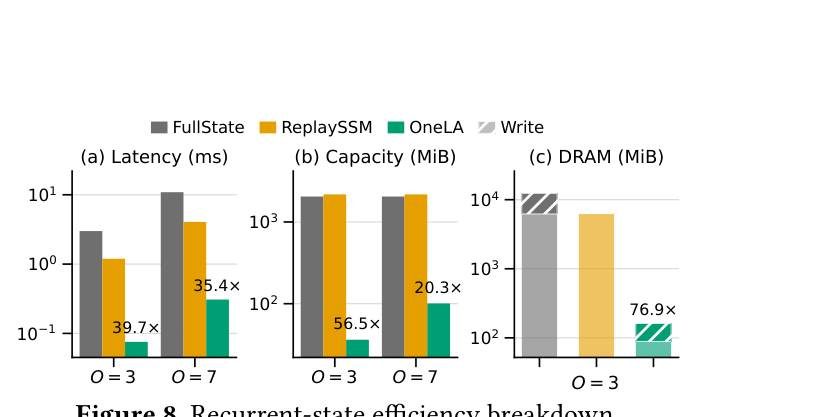
(a) 循环状态路径延迟(含各路径显式的 beam 状态维护):
| 路径 | $O=3$ | $O=7$ |
|---|---|---|
| vLLM FullState | 3.00 ms | 10.9 ms |
| vLLM ReplaySSM | 1.20 ms | 4.06 ms |
| OneLA | 0.0755 ms | 0.308 ms |
| OneLA vs FullState | 39.7× | 35.4× |
| OneLA vs ReplaySSM(由上表推算) | 15.9× | 13.2× |
(b) 持久状态容量与状态写入:
| 指标 | $O=3$ | $O=7$ |
|---|---|---|
| OneLA 持久容量 | 36.3 MiB | 101 MiB |
| 相对 FullState 的容量下降 | 56.5× | 20.3× |
| OneLA 状态写入量 | 32.3 MiB | 96.8 MiB |
| 相对 FullState 的写入下降 | 127× | 127× |
(c) 物理 DRAM 流量($O=3$):OneLA 只搬运 161 MiB,相对 FullState 与 ReplaySSM 分别下降 76.9× 与 39.9×。由此 OneLA 的算术强度达到 40.0 FLOP/byte,比 FullState 与 ReplaySSM 分别高 45.6× 与 20.6×,直接解释了状态路径的延迟改善。
分析与数字自洽性核对:这组数字内部是自洽的,而且可以部分地被解析验证。以 $d_v = d_k = 128$ 算,单条转移记录相对全状态矩阵的比值是 $16384 / 257 \approx 63.8\times$,而实测写入下降是 127×——正好约两倍。同理,$O=3$($T=2$)时按 $W \cdot d_v d_k$ 对 $d_v d_k + W T (d_v + d_k + 1)$ 粗算持久容量比约 30×,实测 56.5×,也是约两倍。这个一致的 2× 差额与论文自己的论证吻合:FullState 在 beam 重排时必须同时持有父代状态与新写入的子代状态(copy-on-reorder 的双份开销),这恰恰是 OneLA 用祖先索引消掉的那一部分。换句话说,容量与写入这两项收益不是纯经验数字,而是可以从表示方式本身推导出来的,可信度明显高于延迟数字。
还有一个趋势值得记录:OneLA 的相对优势随 $O$ 增长而收缩(容量 56.5× → 20.3×,延迟 39.7× → 35.4×)。原因很直接——GTR 总量随 $T$ 线性增长,而 FullState 的持久容量与 $T$ 无关;重放的计算量也随 $t$ 线性增长。GR 的 SID 长度只有 3–7,所以在本文的适用范围内完全不是问题,但这说明该方法有一个理论上的交叉点,论文没有测出它在哪里。
5. 核心贡献总结¶
- 识别出 beam 宽度是循环线性注意力的一个新 scaling 维度,揭示逐 beam 状态管理的低效。这个 framing 本身是干净且正确的:线性注意力被发明出来是为了解决序列长度维的开销,而 GR 的大 beam 负载把开销换到了另一个维度上,既有服务系统对此毫无准备。
- 设计 OneLA:共享上下文状态 + 紧凑只追加 GTR + 轻量 beam 祖先索引,并实现一个融合 kernel 做片上投影重放与跨 beam 状态复用。其中"因为层只右乘状态,所以把右乘推穿祖先链、只维护两个 $d_v$ 维累加器"这一步是真正原创且数学上严格等价的洞察,不是已有手段的组合。
- 实现并评测 OneLA:相对既有 GDN 执行路径取得 1.54–2.46× 端到端解码加速,以及 20–56× 的持久状态容量下降与 127× 的状态写入下降。
6. 与已归档相关工作的对比¶
GRACE GRACE: Generative Recommender Acceleration Engine for Real-Time Ads Retrieval (Meta, 2026-08-02)¶
关系:独立并发(本文未引用 GRACE,两者殊途同归)· 已加载对方精读
-
共同关注的问题:两篇论文各自独立地把同一个 root cause 说了出来——GR 解码的负载形状(宽 beam、短生成序列、请求级共享上下文)与通用 LLM 服务 kernel 所假设的形状(窄 beam、长序列、每序列独立状态)根本错配,于是 FlashAttention / FlashInfer / vLLM 这类通用实现在 GR 解码上严重欠利用。GRACE 的表述是 "$B\cdot M = 16\times1024 = 16384$ 行的极宽有效 batch、$L_{\text{SID}}=4$ 的极短自注意力序列、encoder 输出在所有 beam 间共享";OneLA 的表述是 $L_{\text{prompt}} \gg T$、$W_t \gg T$。两者说的是同一件事。
-
相近的技术骨架:三处机制几乎一一对应。(1) 共享上下文只加载一次:GRACE 把 cross-attention 的 $K,V$ 保持在请求级布局 $\mathbb{R}^{B\times H\times T_{\text{ctx}}\times d_h}$、只置换 $Q$,让同一请求的 $M$ 条 beam 变成 query 序列维去打同一份 user-context KV;OneLA 让每个 thread block 把 $S_{\text{ctx}}[B_V, d_k]$ 一次载入片上、在其负责的所有 beam tile 之间复用。两者都是"beam 是 query 维、context 是共享维"这同一个 relayout 思想,只是一个作用在 softmax 注意力的 KV 上,一个作用在线性注意力的循环状态上。(2) beam 重排只搬索引不搬数据:GRACE 沿用 PagedAttention,beam 选中父行后只复制父行已有前缀的 block id $P^{\text{new}}_{i,j} = P_{p_i,j}$,把大块 KV 拷贝换成小的整数表拷贝;OneLA 的祖先索引 $h_t(b,j) = h_{t-1}(\pi_t(b), j)$ 做的是完全相同的事——扇出只复制祖先索引,不复制 GTR 链。(3) 证明是纯等价变换:GRACE 在 Appendix B 论证 beam-as-query reshape 不混合请求、不重排输出,是纯 layout 变换;OneLA 用 405 个 shape 上相对 FP32 FullState 最大 $4.88\times10^{-4}$ 的绝对误差给出数值证据。两篇都把"不损失质量"当作必须明示的前提。
-
本文的差异与推进:OneLA 面对的是一个 GRACE 不会遇到的难题。GRACE 的 self-attention KV 是 beam-specific 的,它明确承认"cross-attention 的 KV 广播技巧在这里不适用",只能退而用块对角 mask 把多条 beam 行合并进一个 tile(有用算力只有 $1/G$)。OneLA 的 GDN 循环状态同样是 beam-specific 的,但它找到了 GRACE 没有的那条出路:因为 GDN 层只通过右乘消费状态,beam-specific 的那部分可以被压缩成 $O(d_v+d_k)$ 的转移记录,并沿祖先链以向量方式重放,从而连"beam-specific 的状态"本身都不必存在。GRACE 只能让 beam-specific 的数据更规整,OneLA 则把它整个消掉了。这是线性注意力相对 softmax 注意力独有的代数结构红利。
-
可比的方法 / 实验差异:证据强度上 GRACE 明显更硬。GRACE 报出 GH200 上 cross-attention 延迟降 68.0×、self-attention 降 23.4–25.8×,并且一路走到 decoder P99 从 197.7ms 降到 17.8ms(11.1×)、端到端 P99 53.6ms 落在 70ms 计算窗口内的生产结论;OneLA 只有算子级几十倍与端到端 1.54–2.46×,没有 P99、没有线上部署、连 GPU 型号都未言明,且用的是 0.8B Qwen3.5 代理模型而非其生产 GR 模型。另一处差异是范围:GRACE 还要同时解广告 eligibility(GTM bitmask + Bloom 的解码期个性化合格性检查),OneLA 是纯粹的状态管理与 kernel 工作。两篇合起来其实拼出了一张完整的图:GRACE 覆盖 softmax 注意力路径(cross-attention 共享 + paged self-attention),OneLA 覆盖线性注意力路径(共享循环状态 + GTR 重放),而 OneLA 未引用 GRACE 这一点,说明这条"宽 beam GR 解码需要专用服务层"的认识正在多家工业界独立浮现。
7. 讨论与局限性¶
7.1 值得借鉴的设计¶
最值得带走的是那个代数动作,而不是那个系统。 "算子只从某一侧消费一个大状态 ⇒ 把这一侧的乘法推穿整条历史链 ⇒ 大状态永不必被物化"是一个可迁移的模式,任何形如 $S_t = \alpha_t S_{t-1} + \delta_t k_t^{\top}$ 且只通过右乘被读出的递推都适用——Mamba2、DeltaNet 家族、各类门控线性注意力都在此列。凡是"共享前缀 + 多分支短后缀"的负载(beam search、树形推测解码、多候选并行评估)都可以复用。
第二个是"数据不动、只动索引"这条老经验在新场景下的正确落点。 OneLA 的祖先索引与 GRACE 的 paged block table、乃至 vLLM 的 PagedAttention 是同一个思想谱系。它之所以在这里特别有效,是因为 GR 的 beam 选择只改变引用、不改变内容——识别出这条不变量,比实现索引本身更重要。
第三个是 Controlled FullState 这个对照的设置方式。 先证明"我自己的流水线与框架基线相差 6.9–9.3%",再在同一条流水线上只替换被研究的那一个组件——这套做法有效隔离了"系统工程红利"与"方法红利",值得在做系统类工作时照搬。可惜论文只把它用在了基线一侧(见下)。
7.2 局限与争议¶
(1) 头条加速比测在较弱的那条基线上。 1.54–2.46× 是相对 Controlled FullState(即 FullState 路径)得到的,而同一框架里可用的 ReplaySSM 路径在算子级就比 FullState 快约 2.3×(中位 17.5× vs 40.5×),在状态路径延迟上快 2.5–2.7×(1.20/4.06 ms vs 3.00/10.9 ms)。论文对 ReplaySSM 只说"consistently outperforms"并画在图 6 里,始终没有报出端到端倍数。用 §4.3 的数字反推可以估个量级:若整模型 $O=7$ 时 OneLA 相对 FullState 为 2.46×,把非循环状态部分当作常数解出来,OneLA 相对 ReplaySSM 的端到端加速大致落在 1.2–1.5× 区间(此为本文读者的粗算,非论文数据,仅供判断量级)。也就是说,面对真正最强的公开基线,实际收益可能只有头条数字的一半左右。一篇以效率为唯一卖点的论文,把头条数字挂在次优基线上,是需要扣分的表述选择。
(2) 最贴近的同问题工作被引而不比。 xGR(Efficient Generative Recommendation Serving at Scale, arXiv 2512.11529)在全文被引用 8 次,且正是"GR 大 beam 解码负载刻画"的全部出处($L_{\text{prompt}} \gg T$、$W_t \gg T$、动态 beam 树这些论断都标注引自它),但它从未作为基线出现在任何一张图里。一篇专做 GR 服务效率的论文,把同名同题的前作只当作问题陈述的引文来源而不做对比,是基线完整性上的明显缺口。加上完全未引用的 GRACE(早 5 周、同一负载形状、同一类 relayout 思想),本文的"对比面"实际上只覆盖了通用 LLM 服务框架,没有覆盖任何一篇专为 GR 服务设计的工作。
(3) 零组件消融——收益归因无法验证。 这是最要命的一条。OneLA 有三个可分离的组件:GTR 紧凑表示 + 投影重放、祖先索引、融合共享上下文 kernel。论文没有做任何一项消融:§4.4 "Sources of Performance Improvement" 不是消融,而是 OneLA 与基线之间在延迟/容量/DRAM 三个量上的测量拆解。缺少的关键对照是"OneLA 的 kernel 工程 + FullState 的表示"或"GTR 表示 + 未融合 kernel"——没有这一臂,就无法回答那个最该被回答的问题:几十倍的算子加速里,有多少来自 GTR 表示这个新机制,有多少只是因为给一个 tile 极小、通用 kernel 本来就严重欠利用的负载手写了一个专用融合 kernel? GRACE 的数据恰好提示后者可能占大头:它没有用任何新的状态表示,仅靠 relayout + 合并访存 + 定制 Triton/CUDA kernel,就在同类小 shape 上相对 FlashAttention-2/3 拿到了 23.4–68.0×。也就是说,本文几十倍的算子数字,有相当一部分可能是"专用 kernel vs 通用 kernel"的常见红利,而非其宣称机制的功劳。需要说明的是,容量与写入这两项收益不受此质疑影响——它们可由表示方式解析推导(§4.3 已核对,实测与解析估计在 2× 之内且差额可由 copy-on-reorder 解释),确实来自 GTR。但延迟、尤其是端到端延迟这条因果链,论文没有提供切断它所需的实验。
(4) 规模小,且不是它自己的生产模型。 整模型实验只有 $R=4$、$W=256$、prompt 1K/5K、$O=3\text{–}7$,模型是 0.8B 的 Qwen3.5 而非快手自家的 OneRec 系模型。论文称"evaluate it on an industrial GR workload",但严格说只是负载形状是工业式的,模型是开源 LLM 代理。GPU 型号全文未提,批量/并发规模、多请求排队、与 prefill 的流水线交互等真实服务变量一概没有涉及。
(5) 无线上部署、无 A/B。 作者主体是快手,却没有任何上线证据。对系统类工作,这削弱了"工业价值"这一维。不过要公平地说:因为方法是数学等价的($4.88\times10^{-4}$ 的误差上界),它天然不需要推荐质量指标,上线风险也确实低于任何有损方法——这是它相对量化、蒸馏、推测解码类加速方案的一个结构性优势。
(6) 优势随生成长度收缩,交叉点未知。 GTR 总量与重放计算量都随 $T$ 线性增长,而 FullState 的持久容量与 $T$ 无关。实测已经能看到这个趋势(容量优势 56.5× → 20.3×)。GR 的 SID 长度只有 3–7 所以无妨,但论文既没给出交叉点,也没讨论 SID 层数增加(例如更细的多级码本)时该方法的退化边界。
(7) 体量与定位。 8 页短文,无 related work 专章,无开源承诺。定位更接近一份扎实的 workshop / 短论文而非完整系统论文。
7.3 与已有工作的定位¶
把它放回已归档的谱系里:GR 推理加速这条线上,RecoGEM(快手,FP8 量化)走数值精度,PAD-Rec / DaV-Gen / SOLARIS 走推测解码与草稿-验证,KSA / SequenceO1 / TM20K 走序列压缩(改模型、需重训、有损),HLEM 走显存分区调度,TurboGR 做的是训练侧。OneLA 与 GRACE 占据的是一个此前在归档库里几乎空白的位置:不改模型、数学等价、纯粹重排状态表示与访存布局的服务层优化。这一类方法的上线风险最低、与上述所有方案正交(可与量化、推测解码叠加),因此即便本文自身的证据链有明显缺口,它指出的方向仍然有价值。
评分说明¶
reading_score: 6
机制本身是原创且数学上严格的——"GDN 只右乘状态 ⇒ 把右乘推穿祖先链 ⇒ 状态永不物化"这一步是真洞察,把逐 beam 状态从 $O(d_v d_k)$ 压到 $O(d_v+d_k)$ 的结论可解析验证,祖先索引与 GRACE 的 paged block table 殊途同归也佐证了这条路线的正确性,单看方法足以支撑 7 分。扣到 6 分的是证据链上三个彼此独立的洞:头条 1.54–2.46× 测在较弱的 FullState 基线上(对更强的 ReplaySSM 只有定性描述,粗算实际可能仅 1.2–1.5×);最贴近的同问题前作 xGR 被引用 8 次却从不作为基线,同期 GRACE 未引;以及完全没有组件消融——缺"OneLA kernel + FullState 表示"这一臂,就无法把几十倍的算子加速在"新表示"与"手写专用 kernel"之间分开,而 GRACE 仅靠后者就拿到过 23–68×。再叠加 0.8B Qwen3.5 代理模型、GPU 型号未言明、无线上部署。容量与写入的收益可解析推导、不受此质疑,且方法数学等价、上线风险低,这些托住了下限。