MoME 精读:把 token-indexed 记忆表从「一 token 一行」改成「一 token 一个混合」¶
MoME: Mixture-of-Memory Embeddings for Context-Aware Sparse Lookup(arXiv 2609.15126,2026-09-14) Muchen Li、Leonid Sigal、Renjie Liao(University of British Columbia / Vector Institute for AI / Canada CIFAR AI Chair / NSERC CRC Chair),联系人 [email protected],代码与预训练模型开源。
1 研究动机与背景¶
1.1 稀疏扩容的第二条轴:conditional memory¶
LLM 的高效扩容长期沿两条线走。第一条是 Mixture-of-Experts(MoE):每个 token 只路由到一小撮专家,把容量增长与「广泛激活的计算」解耦,如今已是前沿模型标配。第二条是最近才成形的 conditional memory(条件记忆)——一条与 MoE 互补的稀疏扩容路径。
它的动机来自对语言建模任务本身的拆解:语言建模其实交织了两个子任务——组合式推理(需要动态计算)与局部静态模式的检索(命名实体、固定搭配这类"查表就够"的知识)。Transformer 本身没有原生的 lookup primitive,只能用计算去模拟检索,把早期层的容量花在"重建一张静态表"上。Conditional memory 的做法是直接给它一张表:每个 token 只取回若干条记忆项,把有用的先验注入骨干。
这条线上的代表工作包括 Gemma 3n 的 Per-Layer Embedding、Value Embedding(value-stream 记忆变体)、STEM(Scaling Transformers with Embedding Modules)、Engram(条件记忆的可扩展查表)和 Bigram(modded-nanogpt 的 2-gram 哈希实现)。它们的共同吸引力是"便宜":任一 token 只激活表的极小一部分,查表本身很轻,所以表可以在很低的算力增量下扩大。
1.2 共同的结构性限制:索引是 surface form 的确定性函数¶
论文用 Table 1 把这一族方法按四个维度排成一张对照表,指出它们在「记忆怎么被寻址」这一点上共享同一个限制。
Table 1:已有工作如何检索与注入记忆嵌入(Context aggregation 描述的是记忆寻址方式;canonical Engram 额外用 hidden state 条件化 fusion)
| Method | Memory index | Index function | Injection position | Context aggregation |
|---|---|---|---|---|
| Per-Layer Embedding [Gemma 3n] | $V \times d_{model}$ | $x_t$ | Input embedding | None |
| Value Embedding [ResFormer] | $V \times H \times d_{value}$ | $x_t$ | Attention value | None |
| STEM | $V \times d_{ffn}$ | $x_t$ | SwiGLU hidden | None |
| Engram (canonical) | $N_{hash} \times d_{model}$ | $h(x_t,\dots,x_{t-n})$ | Block input | n-gram |
| Ours (MoME) | $N \times M \times d_{value}$ | $f(x_t),\ A_{t,i}$ | Attention value | Hidden embedding |
Per-Layer Embedding 用 token identity、Value Embedding 用 token identity、STEM 用 token-indexed embedding module、Engram 用固定 n-gram 哈希——检索永远是 surface form 的确定性函数,而不是 hidden state 的函数,即使 fusion 那一步是上下文相关的。
作者把这个 mismatch 的根因概括为一句话:容量是按 token 分配的,而不是按语义内容分配的。它有两个互相叠加的后果:
(i) 容量错配(Misallocated capacity)。 一 token 一槽位等于默认所有 token 携带同等语义负载,但实际并非如此。有些 token 近乎冗余——cats/cat 语义高度重叠,却各占一行,表里重复存了同一份内容;另一些 token 恰好相反——单独一行被要求装下好几个不同含义,比如 bank(金融机构 vs. 河岸),没有空间把它们分开。
(ii) 上下文盲检索(Context-blind retrieval)。 确定性查表让记忆检索对完整上下文失明。token 语义随上下文剧烈变化(python 是编程语言还是蟒蛇,spring 是季节、弹簧还是动词),所以一个 token 的记忆本应在上下文维度上是多峰的,而确定性表只给它一个槽位。(脚注:canonical Engram 用 2-gram 和 3-gram 查表,本文的 Bigram 基线只用 2-gram——n-gram 窗口太短,依然无法消歧。)
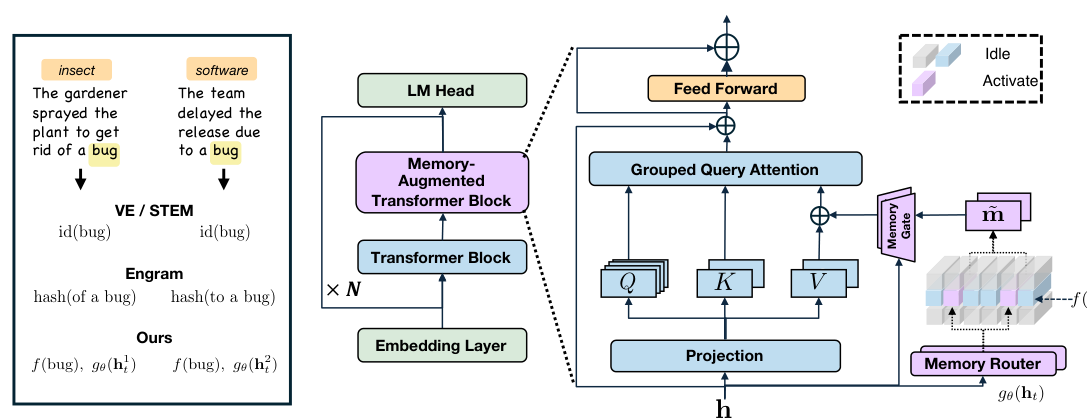
MoME 的定位由此确定:在保留 token-indexed lookup 访问模式(因而保留其效率)的前提下,让检索本身变得上下文相关。不是给每行一个固定向量,而是存一个记忆槽位的混合(mixture of memory slots),并用当前的 hidden context 决定读取混合中的哪些分量。
1.3 贡献¶
- 设计 MoME,一个 mixture-of-memory 模块,把上下文感知带进 token-indexed 记忆嵌入的表查找里;
- 证明 MoME 在 nanochat、Llama 3/MobileLLM、Qwen3 三个骨干家族上,相对 Base、Value Embedding、STEM、Bigram 都有竞争力且可迁移;
- 证明 MoME 的记忆规模 scaling 趋势优于既有基线,且可与 Bigram 复合扩容;
- 路由分析显示模块学会了按上下文动态索引不同槽位,且被选中的槽位反映输入语义。
2 核心方法 / 模型架构¶
2.1 前置:token-indexed 表作为可学习记忆¶
已有 memory-augmented transformer 都可以统一写成学习一张嵌入表 $E \in \mathbb{R}^{N \times D_{inj}}$,$N$ 是可寻址记忆项数,$D_{inj}$ 是注入点要求的维度。对每个输入 token $x_t$,表被确定性索引——或者直接按 token id($N = V$),或者按 n-gram 窗口上的哈希($N = N_{hash}$)。差异只在注入位置:Per-Layer Embedding 注入 input embedding,Engram 通过上下文相关门把记忆融进 block-input hidden state,Value Embedding 注入 attention value 流,STEM 融进 SwiGLU hidden state。
2.2 记忆张量的设计¶
MoME 引入两个设计:(i) $M$ 个记忆槽位的混合 + 一个学到的上下文感知门(动机直接来自 MoE),(ii) 分组 token 索引 $f$(可选,用于降低表中的冗余,作者发现它提升训练效率)。
记忆是一个可学习参数张量
$$E_{mem} \in \mathbb{R}^{N \times M \times d_{value}}, \qquad m_{n,a} = E_{mem}[n,a,:] \in \mathbb{R}^{d_{value}} \tag{1}$$
其中 $N$ 是第一级索引器 $f$ 选出的行数(identity 索引时 $N = V$,分组后 $N \le V$),$M$ 是每行的槽位数,$d_{value}$ 是记忆注入点的每头 value 维度。
结构上(Figure 1 右),普通 transformer block 与 memory-augmented block 交替。每个 memory-augmented block 保留标准 transformer 计算,额外挂一个旁路记忆模块:模块读取 block 输入,取回一个上下文相关的记忆向量,再把它注入每个 value head 的 attention value 流。两个索引器被显式分开:$f(x_t) \to n_t$ 选记忆行,$g_\theta(h_t) \to (A_{t,i}, \alpha)$ 在该行内选择并加权槽位。
2.3 上下文感知路由与聚合¶
MoME 可以看成两个记忆索引器的复合:token 索引器 $f(x_t)$ 选行 $n_t$,上下文索引器 $g_\theta(h_t)$ 在行内选并加权槽位。对每个 value head $i \in [H]$,门先把 hidden state 映成槽位 logits:
$$\ell_{t,i} = W_g^{(i)} h_t + b_g^{(i)} \in \mathbb{R}^{M} \tag{2}$$
上下文正是在这里进入查表的——$h_t$ 已经通过上游 transformer 层整合了上下文,所以把槽位门条件化在 $h_t$ 上就使路由上下文感知。然后取 top-K:
$$A_{t,i} = \mathrm{TopK}(\ell_{t,i}, K), \qquad A_{t,i} \subseteq [M], \qquad |A_{t,i}| = K \tag{3}$$
聚合时,$K > 1$ 用 sigmoid-norm 门——先过 sigmoid 得分,再只在被选中的槽位上归一化:
$$s_{t,i} = \sigma(\ell_{t,i}), \qquad \alpha^{(i)}_{t,a} = \frac{s_{t,i,a}}{\sum_{b \in A_{t,i}} s_{t,i,b}}, \quad a \in A_{t,i} \tag{4}$$
$K = 1$ 时改用 softmax 变体 $\alpha^{(i)}_{t,a} = [\mathrm{softmax}(\ell_{t,i})]_a$。给定 $n_t = f(x_t)$ 与混合权重,head $i$ 的聚合记忆是激活槽位的加权和:
$$\tilde{m}_{t,i} = \sum_{a \in A_{t,i}} \alpha^{(i)}_{t,a} m_{n_t,a} \in \mathbb{R}^{d_{value}} \tag{5}$$
设计含义:sigmoid-norm 而非全局 softmax,意味着未被选中的槽位不参与归一化分母,门的绝对强度信息($\sigma$ 的取值)不会被 top-K 之外的 logits 稀释。
2.4 Token-Index 分组函数¶
可选地,还能优化 token 索引器本身:把语义相近的 token 合并到共享行,在保留行内上下文感知槽位的同时减少冗余的 token-indexed 容量。设计为
$$f: V \to [N], \quad N \le V, \qquad f(x) = \mathrm{kNN}\!\left(U^{ref}_x;\ U^{ref},\ c_{grp}\right) \tag{6}$$
作者试了多种相似度启发式,发现基于嵌入的匹配效果最好:用一个轻度预训练过的 token embedding 矩阵 $U^{ref} \in \mathbb{R}^{V \times d_{value}}$(来自 $f = \mathrm{id}$ 的基线 run,nanochat-d12 上约 1B token、约 $10^{18}$ FLOPs)在预训练嵌入空间做离线 kNN 匹配,得到一张分组因子为 $c_{grp}$ 的固定槽位映射表,训练全程冻结。注意 $\mathrm{kNN}(\cdot)$ 指离线构行映射,不是运行时检索。分组把 token-indexed 行维度压缩 $c_{grp}$ 倍,省下的容量通过把每行槽位数 $M$ 乘以 $c_{grp}$ 转回给上下文感知记忆——总参数量守恒,只是把容量从"token 轴"搬到"上下文轴"。
2.5 记忆注入¶
门控注入。 聚合后的 $\tilde{m}_{t,i}$ 通过一个独立的 per-head value-residual 门融进 value 流:
$$\gamma_\theta(h_t) = 2\sigma(W_\gamma h_t + b_\gamma) \in \mathbb{R}^{H}, \qquad \tilde{v}_{t,i} = v_{t,i} + \gamma_{\theta,t,i}\,\tilde{m}_{t,i} \tag{7}$$
于是 $g_\theta$ 控制读哪些槽位,$\gamma_\theta$ 控制加多强,职责分离。系数 2 的作用是:门 logit 初始化为 0 时 $\gamma_{\theta,t,i} = 1$,给出一个中性的初始 value-residual 尺度(对照 PrefixMem 把 $W_{out}$ 初始化到近零,两者都在解决"新模块不要在早期干扰骨干"的问题,但 MoME 选的是中性而非零起点)。
延迟友好的设计。 记忆分支引入额外的 per-head 计算:router 把 hidden state 投到槽位得分、做 top-K、聚合选中的记忆向量。这一分支 FLOPs 很轻,但额外 kernel 位于关键路径上仍可能加延迟。条件化在 $h_t$ 上并注入 value 流的一个副产品是:记忆分支的大部分计算可以与产生 $v_{t,i}$ 的标准 value 投影并行调度,两条分支都完成后只需要一次门控残差加法做 join。在 qwen3_4b 两层记忆的 benchmark 上,该设计增加 0.509 ms,而 MoME 的 hidden-state-injection 变体增加 0.996 ms——几乎翻倍的延迟开销。
多头记忆。 作为参数效率上的选择,memory-augmented 层内所有 value head 共享同一张记忆表 $E_{mem}$,把每层记忆参数量封顶在 $NMd_{value}$ 而非 $NMHd_{value}$。为了在共享表下保留 head-specific 的聚合灵活性,router/门的输出是 per-head 的:每个 value head 独立选自己的激活槽位子集和混合权重,所以不同 head 可以对"读哪些槽位"意见不一,却共用同一个存储 bank。
3 实验设置¶
3.1 评估协议¶
遵循 nanochat 的评测脚本(参考 commit 348fbb3),报告最终 train bpb、validation bpb、原始 benchmark 准确率与 CORE 指标:
$$\mathrm{bpb} = \frac{\sum_i -\log p_\theta(y_i \mid x_{<i})}{\log(2) \sum_i \mathrm{bytes}(y_i)} \tag{8}$$
$$\mathrm{CORE} = \frac{1}{J}\sum_{j=1}^{J} \frac{a_j - r_j}{1 - r_j} \tag{9}$$
$a_j$ 是任务准确率、$r_j$ 是该任务的随机基线。bpb 越低越好、CORE 越高越好。评测器对每个任务用固定种子打乱、评原始准确率、从元数据读随机基线,报告中心化准确率的未加权均值。bpb 部分对计数 token 求目标 NLL,屏蔽 ignored 与 special token 目标,nat 转 bit 后按同批目标的 UTF-8 字节数归一。
CORE 的 22 个任务(Table 8):HellaSwag-0(0-shot 多选)、Jeopardy(10-shot LM)、BB-QA Wikidata(10-shot LM)、ARC-Easy(10)、ARC-Challenge(10)、COPA(0)、CommonsenseQA(10)、PIQA(10)、OpenBookQA(0)、LAMBADA OpenAI(0)、HellaSwag(10)、Winograd(0,schema)、WinoGrande(0,schema)、BB-Dyck Languages(10)、AGI Eval LSAT-AR(3)、BB-CS Algorithms(10)、BB-Operators(10)、BB-Repeat Copy Logic(10)、SQuAD(10)、CoQA(0)、BoolQ(10)、BB-Language Identification(10)。
3.2 训练设置(Table 9)¶
| 项目 | 设置 |
|---|---|
| 数据 | Table 2–4 用 FineWeb-Edu;100B-token 的 Table 6 与 d24 附录对照用 ClimbMix |
| Tokenizer | 共享 byte-level BPE,词表 32,768,在 FineWeb-Edu 流上用 20B token 训得;special token 的 byte count 为 0 |
| 上下文长度 | 2048 |
| 总 batch | Table 2–4 用 524,288 token;Table 6 与 d24 对照用 1,048,576 token(梯度累积保证总 batch 不随 device batch/world size 变化) |
| 优化器分组 | Muon 用于矩阵形状的 transformer 参数;AdamW 分组用于 embedding、unembedding、标量参数、value-memory 表及其他非矩阵参数(记忆表可用独立的 AdamW lr 与 wd) |
| LR schedule | warmup + cosine decay 或 warmdown;nanochat scaling run 用 target-FLOP 停止,token-matched run 用固定 token 预算 |
| 评测 token | nanochat/scaling 报告每 split 20,971,520 token;token-matched 报告每 split 2,097,152 token |
| 种子策略 | nanochat scaling 表为 seed 42/43/44 三种子均值;token-matched 家族表用各配置已完成的 run |
| 分布式 | DDP;nanochat 与 Llama/MobileLLM 多数 run world size 4,Qwen3-style 与更大的 nanochat d24 用 8 |
| 硬件 | NVIDIA RTX PRO 6000 Blackwell (96GB) 与 H100 (80GB);d24 对照重跑用 4×H100,Table 13 的 sparse-MoE 吞吐对比用 8×H100 |
3.3 骨干与记忆配置(Table 10 / Table 11)¶
骨干配置:
| Family | Scale | Model type | Depth | $d_{model}$ | Head dim | Attn heads | KV heads | Tie emb. | Ctx | 训练预算 |
|---|---|---|---|---|---|---|---|---|---|---|
| nanochat | d12 | gpt | 12 | 768* | 128 | 6* | 6* | No | 2048 | $3\times10^{18}$ FLOPs;3.3B tokens |
| nanochat | d24 | gpt | 24 | 1536* | 128 | 12* | 12* | No | 2048 | $6\times10^{19}$ FLOPs;12B tokens |
| Llama/MobileLLM | 125M | stemgpt_350m | 30 | 576 | 64 | 9* | 3 | Yes | 2048 | 5B tokens |
| Llama/MobileLLM | 350M | stemgpt_350m | 32 | 960 | 64 | 15* | 5 | No | 2048 | 20B tokens |
| Qwen3-style | 0.6B | qwen3_0p5b | 28 | 1024 | 128 | 16 | 8 | Yes | 2048 | 20B tokens |
(* 标记的维度由配置的 aspect ratio 与 head dim 推出。)
记忆配置:
- nanochat d12:memory block span 1;MoME 主行用 A2/6、A2/12、A2/24,scaling 研究里扫 $M$;行索引器 $f$ 为 identity 或冻结 kNN 表;router 输入 hidden;门 sigmoid-norm;记忆表 AdamW lr 0.2 / wd 0.001。
- nanochat d24:记忆层为奇数层 1,3,…,23;MoME A2/12;$f$ identity;router 输入 hidden;sigmoid-norm;lr 0.2 / wd 0.001。
- Llama/MobileLLM 125M:奇数层 1,3,…,29;MoME A1/3 与 A2/6;$f$ identity;router 输入 value;A1/3 用 softmax、A2/6 用 sigmoid-norm;lr 0.1 / wd 0.001。
- Llama/MobileLLM 350M:奇数层 1,3,…,31;MoME A2/5 与 A2/10;$f$ identity;router 输入 value;sigmoid-norm;lr 0.1 / launcher 默认 wd。
- Qwen3-style 0.6B:奇数层 1,3,…,27;MoME A2/8;$f$ identity;router 输入 hidden;sigmoid-norm;lr 0.2 / wd 0.001。
记号约定 MoME-A$K$/$M$:前缀 A 表示 Activated,即每行 $M$ 个槽位中激活 $K$ 个(如 A2/5 = 5 选 2)。默认 $K=2$,默认 $M = H$(与 value embedding 做等参对照)。除 §4.3 的 nanochat 消融外,默认不使用 kNN 分组($f = \mathrm{id}$,$c_{grp}=1$),以隔离"记忆混合本身"的效果。
3.4 基线实现¶
- Bigram:按 modded-nanogpt PR #201 的 2-gram 哈希嵌入实现,而非 Cheng et al. 的 canonical Engram 架构。记忆是一张 $N$ 行、行维 $d_{model}$ 的表,每个位置按"前一个 token + 当前 token"的确定性哈希索引(bigram key)。同一张表被所有 memory-augmented 层共享(nanochat 默认配置的奇数 block),每层通过 hidden-state 条件化的 per-head 门与一个可学习的 per-layer 标量加进残差流。字典大小写成词表 $V$ 的倍数。作者明确指出:在 d24 ClimbMix、约 $6\times10^{19}$ FLOPs、参数近似匹配的对照中,Bigram 的 val bpb 与 CORE-22 都好过他们自己适配的 canonical Engram(Table 16),所以主对比里用 Bigram 而非 Engram。
- Value Embedding (VE):遵循 modded-nanogpt/nanochat 实践与 Zhou et al. 的 value residual 公式。一张 $V \times H \times d_{value}$ 的 token-indexed 表,为每个 attention head 供一片嵌入加进 value 流,默认注入奇数层。
- STEM:按原论文与开源实现,采用其报告的 1/2 STEM 设置(记忆模块插在一半的 transformer 层里),迁移到相同训练框架、tokenizer、上下文长度与 batch size。
4 主要实验结果¶
4.1 nanochat iso-FLOP 对照(Table 2)¶
12 层 135M nanochat 骨干,固定 $3\times10^{18}$ 训练 FLOPs(约 3.3B token),每隔一层插一个 memory block,所有增强变体通过 Bigram 的 $N_{hash} = 6V$ 对齐到 151M 记忆参数预算。
Table 2:nanochat 骨干预训练结果(Param (M/T) = 记忆参数 / 总参数)
| Run | Memory | Train bpb ↓ | Val bpb ↓ | CORE ↑ | Param (M/T) | Train Throughput |
|---|---|---|---|---|---|---|
| Base | – | 0.8783±0.0009 | 0.8785±0.0010 | 0.1447±0.0064 | 0M / 135M | 1.15M tok/s |
| Bigram | $N_{hash}\times d_{model}$ | 0.8632±0.0009 | 0.8636±0.0009 | 0.1533±0.0116 | 151M / 286M | 1.09M tok/s |
| VEmbedding | $V\times 6\times d_{value}$ | 0.8631±0.0006 | 0.8633±0.0006 | 0.1522±0.0045 | 151M / 286M | 1.10M tok/s |
| 151M memory | ||||||
| MoME ($c_{grp}$=1) | $V\times 6\times d_{value}$ | 0.8618±0.0002 | 0.8621±0.0003 | 0.1571±0.0030 | 151M / 286M | 1.07M tok/s |
| MoME ($c_{grp}$=2) | $\frac{V}{2}\times 12\times d_{value}$ | 0.8609±0.0003 | 0.8611±0.0003 | 0.1583±0.0020 | 151M / 287M | 1.07M tok/s |
| MoME ($c_{grp}$=4) | $\frac{V}{4}\times 24\times d_{value}$ | 0.8608±0.0004 | 0.8610±0.0004 | 0.1554±0.0029 | 151M / 287M | 1.07M tok/s |
| 302M memory | ||||||
| MoME ($c_{grp}$=1) | $V\times 12\times d_{value}$ | 0.8567±0.0002 | 0.8569±0.0002 | 0.1635±0.0067 | 302M / 438M | 1.03M tok/s |
| MoME ($c_{grp}$=2) | $\frac{V}{2}\times 24\times d_{value}$ | 0.8558±0.0003 | 0.8561±0.0003 | 0.1664±0.0059 | 302M / 438M | 1.03M tok/s |
| MoME ($c_{grp}$=4) | $\frac{V}{4}\times 48\times d_{value}$ | 0.8563±0.0005 | 0.8565±0.0006 | 0.1515±0.0110 | 302M / 439M | 1.02M tok/s |
结论分析:
- 等参预算下 MoME 同时赢 bpb 与 CORE:151M 预算上 MoME($c_{grp}$=1) 的 val bpb 0.8621 优于 Bigram 0.8636 与 VE 0.8633,CORE 0.1571 优于 0.1533 / 0.1522。要注意 CORE 的 std 不小(Bigram ±0.0116),所以真正稳的信号是 bpb,CORE 的优势要结合"MoME 的 std 明显更小(±0.0030 vs ±0.0116)"一起看。
- 加倍记忆到 302M 让三种分组的 val bpb 全部继续下降,但 CORE 只在 $c_{grp}$=1 和 2 上继续改善;$c_{grp}$=4 在 302M 时 CORE 塌到 0.1515±0.0110——比 151M 的自己还差,也差于同预算的 VE。这说明"把容量从 token 轴搬到上下文轴"不是越多越好,压缩掉 3/4 的 token 行会开始损伤 token 身份的分辨力。
- 分组因子的甜点是 $c_{grp}$=2:两个预算下 CORE 都最高,302M 下 train/val bpb 也最低;151M 时 $c_{grp}$=4 的 bpb 略低一点。
- 路由开销可忽略:MoME 的吞吐(1.02–1.07M tok/s)保持在等参 Bigram(1.09M)的 2% 以内。
4.2 Llama/MobileLLM 与 Qwen3 的 iso-token 对照(Table 3)¶
每个骨干规模内固定 token 预算:MobileLLM 125M 用 5B token,MobileLLM 350M 与 Qwen3 0.6B 用 20B token。记忆参数预算按方法与配置各异。按原 STEM 的 1/2 设置,记忆模块插进一半的 transformer 层。
Table 3:iso-training-token 结果(Mem = 记忆表大小,per-benchmark 列为原始准确率 %,BB-avg 是 suite 内 BigBench 任务的未加权均值,Wall 是同 block 内相对 dense 基线的训练时间)
| Method | Mem | Val bpb ↓ | CORE ↑ | ARC-E | ARC-C | BoolQ | PIQA | HSwag | OBQA | WinoG | BB-avg | Wall |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Llama/MobileLLM 125M | ||||||||||||
| Base | 0M | 0.8852 | 0.1382 | 52.82 | 27.56 | 55.14 | 63.82 | 33.27 | 33.40 | 53.04 | 20.13 | 1× |
| STEM | 755M | 0.8633 | 0.1483 | 55.72 | 29.35 | 54.01 | 65.13 | 35.47 | 34.20 | 52.88 | 20.13 | 1× |
| VEmbedding | 95M | 0.8620 | 0.1530 | 56.82 | 28.50 | 53.67 | 66.43 | 36.23 | 31.20 | 52.09 | 22.21 | 1.03× |
| MoME-A1/3 | 95M | 0.8623 | 0.1587 | 56.44 | 27.30 | 50.49 | 66.00 | 35.59 | 34.00 | 52.49 | 23.31 | 1.07× |
| MoME-A2/6 | 189M | 0.8560 | 0.1686 | 57.24 | 27.65 | 57.86 | 65.18 | 36.19 | 32.00 | 51.93 | 21.98 | 1.07× |
| Llama/MobileLLM 350M | ||||||||||||
| Base | 0M | 0.7750 | 0.1988 | 64.23 | 34.04 | 55.66 | 70.13 | 47.87 | 37.20 | 54.14 | 16.68 | 1× |
| STEM | 1342M | 0.7697 | 0.2179 | 64.52 | 35.41 | 50.52 | 69.37 | 47.64 | 36.80 | 54.54 | 25.94 | 1.09× |
| VEmbedding | 168M | 0.7651 | 0.2214 | 66.29 | 36.26 | 47.06 | 70.62 | 49.60 | 37.00 | 56.35 | 23.87 | 1.04× |
| MoME-A2/5 | 168M | 0.7647 | 0.2202 | 65.03 | 36.60 | 44.65 | 70.73 | 49.20 | 35.80 | 56.04 | 24.70 | 1.04× |
| MoME-A2/10 | 336M | 0.7610 | 0.2286 | 65.28 | 36.77 | 55.44 | 71.60 | 49.50 | 36.00 | 56.75 | 21.15 | 1.08× |
| Qwen3 0.6B | ||||||||||||
| Base | 0M | 0.7594 | 0.2491 | 65.99 | 35.32 | 59.88 | 70.78 | 50.58 | 37.60 | 55.96 | 25.72 | 1× |
| STEM | 1409M | 0.7564 | 0.2556 | 67.97 | 36.52 | 56.39 | 71.98 | 51.01 | 39.00 | 56.59 | 26.01 | 1.07× |
| VEmbedding | 470M | 0.7427 | 0.2530 | 66.50 | 38.05 | 47.55 | 71.00 | 53.07 | 39.00 | 57.14 | 26.82 | 1.06× |
| MoME-A2/8 | 470M | 0.7461 | 0.2737 | 67.09 | 38.31 | 63.39 | 71.76 | 53.39 | 39.60 | 56.04 | 26.19 | 1.06× |
结论分析:
- 相对 no-memory base 的增益稳定且可迁移:三个规模、两个家族全部成立。
- MoME 在三个规模上同时用更少记忆参数打赢 STEM 的 val bpb 与 CORE——这是本文最干净的一条对比:Qwen3 0.6B 上 MoME 用 470M 记忆(STEM 用 1409M,3 倍)拿到 0.7461 / 0.2737 vs 0.7564 / 0.2556。
- 训练墙钟只需 base 的 1.04–1.08×。
- 但等参 vs VE 的结论并不是一边倒:MobileLLM 350M 上 MoME-A2/5 与 VE 基本打平(bpb 0.7647 vs 0.7651 略好,CORE 0.2202 vs 0.2214 略差);Qwen3 0.6B 上 MoME-A2/8 的 val bpb 反而更差(0.7461 vs 0.7427),只靠 CORE 大幅领先(+0.0207)翻盘。CORE 的领先主要来自 BoolQ 的 63.39 vs 47.55(+15.8 个点)这一个任务——BoolQ 在 base 上 59.88、加了 VE 掉到 47.55,本身波动极大,把它当作关键证据需要谨慎。摘要里"improves over Value Embedding … in iso-parameter and iso-training-FLOP settings"这句话略有夸大。真正说服力强的是同预算加倍记忆(A2/6 对 A1/3、A2/10 对 A2/5)那几行。
Table 15(附录) 给出这 14 个 run 的完整 22 任务原始准确率,比 Table 3 多了 train bpb 与逐个 BigBench 子任务(MobileLLM 125M 各列为 2026 年 9 月复现的 seed 42):
| Metric | 125M Base | 125M STEM | 125M VE | 125M A1/3 | 125M A2/6 | 350M Base | 350M STEM | 350M VE | 350M A2/5 | 350M A2/10 | Qwen Base | Qwen STEM | Qwen VE | Qwen A2/8 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Mem | 0M | 755M | 94.4M | 94.4M | 188.7M | 0M | 1342.2M | 167.8M | 167.8M | 335.5M | 0M | 1409.3M | 469.8M | 469.8M |
| Wall | 1× | 1× | 1.03× | 1.07× | 1.07× | 1× | 1.09× | 1.04× | 1.04× | 1.08× | 1× | 1.07× | 1.06× | 1.06× |
| Train bpb | 0.8904 | 0.8683 | 0.8671 | 0.8673 | 0.8613 | 0.7807 | 0.7645 | 0.7710 | 0.7704 | 0.7675 | 0.7577 | 0.7484 | 0.7374 | 0.7381 |
| Val bpb | 0.8852 | 0.8633 | 0.8620 | 0.8623 | 0.8560 | 0.7750 | 0.7697 | 0.7651 | 0.7647 | 0.7610 | 0.7594 | 0.7564 | 0.7427 | 0.7461 |
| CORE | 0.1382 | 0.1483 | 0.1530 | 0.1587 | 0.1686 | 0.1988 | 0.2179 | 0.2214 | 0.2202 | 0.2286 | 0.2491 | 0.2556 | 0.2530 | 0.2737 |
| HSwag-0 | 34.11 | 35.81 | 36.28 | 36.15 | 36.59 | 48.00 | 47.65 | 49.35 | 49.11 | 49.79 | 50.12 | 50.81 | 52.66 | 52.66 |
| Jeopardy | 0.76 | 2.36 | 0.90 | 0.85 | 3.83 | 13.79 | 15.45 | 17.48 | 16.34 | 16.67 | 18.19 | 22.34 | 23.29 | 22.82 |
| ARC-E | 52.82 | 55.72 | 56.82 | 56.44 | 57.24 | 64.23 | 64.52 | 66.29 | 65.03 | 65.28 | 65.99 | 67.97 | 66.50 | 67.09 |
| ARC-C | 27.56 | 29.35 | 28.50 | 27.30 | 27.65 | 34.04 | 35.41 | 36.26 | 36.60 | 36.77 | 35.32 | 36.52 | 38.05 | 38.31 |
| COPA | 58.00 | 65.00 | 64.00 | 63.00 | 66.00 | 65.00 | 66.00 | 67.00 | 68.00 | 70.00 | 72.00 | 69.00 | 71.00 | 68.00 |
| CSQA | 31.61 | 27.19 | 22.11 | 29.48 | 30.71 | 19.74 | 22.44 | 20.72 | 21.95 | 20.31 | 22.36 | 23.10 | 22.28 | 28.99 |
| PIQA | 63.82 | 65.13 | 66.43 | 66.00 | 65.18 | 70.13 | 69.37 | 70.62 | 70.73 | 71.60 | 70.78 | 71.98 | 71.00 | 71.76 |
| OBQA | 33.40 | 34.20 | 31.20 | 34.00 | 32.00 | 37.20 | 36.80 | 37.00 | 35.80 | 36.00 | 37.60 | 39.00 | 39.00 | 39.60 |
| LAMBADA | 27.58 | 28.68 | 29.54 | 29.38 | 30.72 | 39.41 | 38.19 | 39.94 | 41.51 | 42.05 | 43.16 | 42.03 | 42.98 | 43.45 |
| HSwag | 33.27 | 35.47 | 36.23 | 35.59 | 36.19 | 47.87 | 47.64 | 49.60 | 49.20 | 49.50 | 50.58 | 51.01 | 53.07 | 53.39 |
| Winograd | 60.81 | 58.61 | 57.51 | 62.64 | 60.44 | 65.20 | 62.64 | 67.40 | 66.67 | 68.50 | 67.03 | 71.43 | 69.23 | 69.96 |
| WinoGrande | 53.04 | 52.88 | 52.09 | 52.49 | 51.93 | 54.14 | 54.54 | 56.35 | 56.04 | 56.75 | 55.96 | 56.59 | 57.14 | 56.04 |
| LSAT-AR | 23.91 | 23.91 | 25.65 | 26.09 | 25.65 | 27.83 | 23.91 | 21.30 | 23.04 | 23.04 | 24.35 | 24.78 | 24.35 | 26.09 |
| SQuAD | 4.81 | 6.14 | 13.61 | 8.96 | 14.31 | 26.35 | 28.98 | 31.43 | 30.57 | 30.61 | 28.05 | 29.78 | 35.87 | 35.62 |
| CoQA | 10.12 | 12.31 | 13.52 | 14.17 | 14.73 | 21.48 | 23.19 | 25.23 | 24.14 | 23.60 | 24.60 | 25.96 | 28.18 | 28.50 |
| BoolQ | 55.14 | 54.01 | 53.67 | 50.49 | 57.86 | 55.66 | 50.52 | 47.06 | 44.65 | 55.44 | 59.88 | 56.39 | 47.55 | 63.39 |
| BB-QAW | 31.48 | 37.23 | 40.29 | 41.36 | 39.13 | 53.54 | 54.24 | 51.66 | 53.64 | 54.54 | 54.93 | 56.58 | 54.43 | 53.89 |
| BB-Dyck | 6.20 | 8.40 | 12.60 | 10.60 | 8.40 | 0.00 | 8.20 | 9.70 | 8.40 | 8.50 | 16.70 | 14.10 | 13.20 | 9.90 |
| BB-CS | 43.11 | 38.33 | 43.03 | 39.92 | 39.77 | 0.00 | 43.03 | 34.24 | 41.97 | 18.26 | 40.98 | 36.89 | 45.45 | 44.17 |
| BB-Op | 11.90 | 10.95 | 12.38 | 16.19 | 15.71 | 17.14 | 15.71 | 21.90 | 18.57 | 20.00 | 16.19 | 19.52 | 22.38 | 23.81 |
| BB-RCL | 3.12 | 0.00 | 0.00 | 6.25 | 3.12 | 3.12 | 9.38 | 0.00 | 0.00 | 0.00 | 0.00 | 3.12 | 0.00 | 0.00 |
| BB-LI | 24.96 | 25.88 | 24.97 | 25.52 | 25.72 | 26.30 | 25.07 | 25.70 | 25.64 | 25.62 | 25.50 | 25.87 | 25.48 | 25.35 |
这张表暴露了一个容易被 CORE 聚合掩盖的事实:BigBench 系列(Dyck、CS Algorithms、Repeat Copy Logic)在这个规模上几乎全是噪声——350M Base 的 BB-Dyck 与 BB-CS 都是 0.00,350M MoME-A2/10 的 BB-CS 是 18.26 而同家族 VE 是 34.24、A2/5 是 41.97,BB-RCL 大面积为 0 或 3.12。这些列不应当被读作能力差异。
4.3 记忆规模 scaling(Figure 2 / Table 17)¶
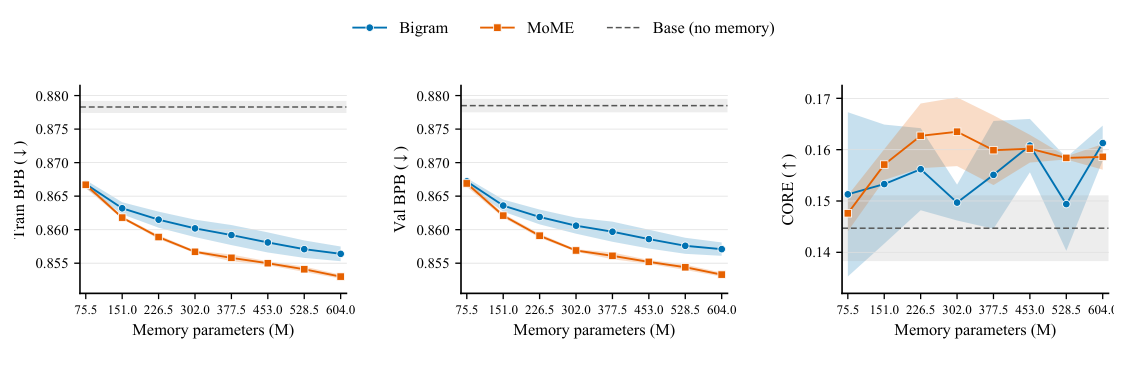
固定 nanochat d12 骨干,iso-FLOP 下扩记忆参数,block 数取 $\{3,6,9,12,15,18,21,24\}$,每个 block 给记忆表加约 25.2M 参数,三种子均值±std。
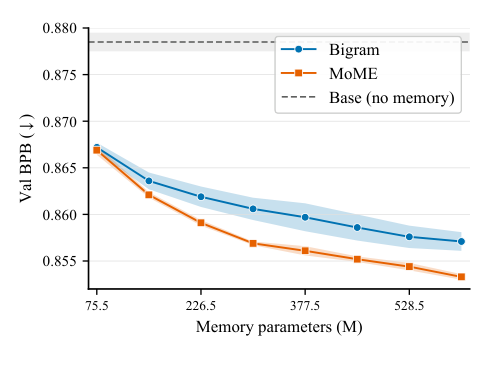
Table 17:nanochat d12 记忆规模扫描(3e18 FLOPs,约 3.3B token)
| Method | Blocks | Mem (M) | Train BPB ↓ | Val BPB ↓ | CORE ↑ | Wall (min) |
|---|---|---|---|---|---|---|
| Base | – | 0 | 0.8783±0.0009 | 0.8785±0.0010 | 0.1447±0.0064 | – |
| Bigram | 3 | 75.5 | 0.8668±0.0006 | 0.8672±0.0005 | 0.1513±0.0160 | 106.72±0.70 |
| Bigram | 6 | 151.0 | 0.8632±0.0009 | 0.8636±0.0009 | 0.1533±0.0116 | 108.80±0.47 |
| Bigram | 9 | 226.5 | 0.8615±0.0012 | 0.8619±0.0011 | 0.1562±0.0080 | 110.55±0.50 |
| Bigram | 12 | 302.0 | 0.8602±0.0013 | 0.8606±0.0012 | 0.1497±0.0035 | 112.49±0.38 |
| Bigram | 15 | 377.5 | 0.8592±0.0015 | 0.8597±0.0015 | 0.1551±0.0105 | 114.35±0.43 |
| Bigram | 18 | 453.0 | 0.8581±0.0015 | 0.8586±0.0014 | 0.1608±0.0052 | 116.34±0.60 |
| Bigram | 21 | 528.5 | 0.8571±0.0013 | 0.8576±0.0012 | 0.1494±0.0091 | 118.28±0.40 |
| Bigram | 24 | 604.0 | 0.8564±0.0011 | 0.8571±0.0010 | 0.1613±0.0034 | 120.17±0.45 |
| MoME | 3 | 75.5 | 0.8667±0.0005 | 0.8669±0.0005 | 0.1476±0.0035 | 109.77±0.82 |
| MoME | 6 | 151.0 | 0.8618±0.0002 | 0.8621±0.0003 | 0.1571±0.0030 | 111.89±0.59 |
| MoME | 9 | 226.5 | 0.8589±0.0003 | 0.8591±0.0003 | 0.1627±0.0063 | 113.48±0.59 |
| MoME | 12 | 302.0 | 0.8567±0.0002 | 0.8569±0.0002 | 0.1635±0.0067 | 115.68±0.54 |
| MoME | 15 | 377.5 | 0.8558±0.0005 | 0.8561±0.0005 | 0.1599±0.0068 | 117.59±0.57 |
| MoME | 18 | 453.0 | 0.8550±0.0003 | 0.8552±0.0003 | 0.1602±0.0027 | 119.76±0.51 |
| MoME | 21 | 528.5 | 0.8541±0.0004 | 0.8544±0.0004 | 0.1584±0.0003 | 121.85±0.60 |
| MoME | 24 | 604.0 | 0.8530±0.0003 | 0.8533±0.0003 | 0.1586±0.0025 | 123.70±0.51 |
结论分析:
- 小记忆规模下两者起点接近(75.5M:0.8669 vs 0.8672),但 MoME 在每一个测试过的记忆规模上 val bpb 都更低,且差距随规模拉大(604M:0.8533 vs 0.8571,差 0.0038)。在测试范围内,扩 MoME 的 bpb 轨迹一致优于扩 Bigram。
- MoME 的 run-to-run 方差显著更小(Figure 2 的误差带明显更窄,Table 17 里 MoME 的 bpb std 普遍 ±0.0003–0.0005,Bigram 是 ±0.0005–0.0015),说明在该设定下 MoME 更好训。这一点其实比 bpb 的绝对优势更有信息量:确定性哈希查表天然对哈希碰撞与初始化敏感,而 hidden-state 路由是连续可微的软选择。
- CORE 上没有同样干净的单调趋势:MoME 的 CORE 在 302M(0.1635)之后反而略降到 0.1584–0.1602,Bigram 更是在 0.1494–0.1613 之间上下跳。作者在正文里没有把 CORE 纳入 scaling 的结论——这是诚实的,但也意味着"scaling 更优"这一主张目前只有 bpb 支撑。
4.4 与 Bigram 的复合扩容(Table 4 / Table 12)¶
因为 MoME 不对第一级 token 索引器 $f(x_t)$ 作任何假设,它天然与 Bigram 这类方法互补。作者把 Bigram 的 bigram 索引器当作第一级索引器,保留 MoME 的整体记忆设计,并微调配置使所有 memory-augmented 层共享同一张记忆表,从而与 Bigram 基线做等参对照。
Table 12(Table 4 的完整版):Bigram 表大小 $N$ 与 MoME 槽位数 $M$ 的复合扩容(12 层 nanochat,三种子均值;粗体/下划线为每个固定预算组内最优/次优)
| Bigram $N$ | MoME setting | Mem (M) | Total params (M) | Train bpb ↓ | Val bpb ↓ | CORE ↑ |
|---|---|---|---|---|---|---|
| 6V | A2/6 | 151 | 286.4 | 0.8618±0.0010 | 0.8624±0.0010 | 0.1647±0.0023 |
| 12V | A2/6 | 302 | 437.4 | 0.8576±0.0008 | 0.8582±0.0007 | 0.1549±0.0084 |
| 8V | A2/9 | 302 | 437.5 | 0.8579±0.0010 | 0.8585±0.0010 | 0.1551±0.0088 |
| 6V | A2/12 | 302 | 437.6 | 0.8582±0.0008 | 0.8588±0.0008 | 0.1544±0.0095 |
| 12V | A2/12 | 604 | 739.6 | 0.8540±0.0002 | 0.8546±0.0001 | 0.1604±0.0050 |
| 24V | A2/6 | 604 | 739.4 | 0.8541±0.0011 | 0.8547±0.0012 | 0.1590±0.0096 |
| 6V | A2/24 | 604 | 739.9 | 0.8544±0.0012 | 0.8550±0.0012 | 0.1614±0.0108 |
结论分析: 同预算下 MoME+Bigram 优于纯 Bigram(151M:0.8624 vs Bigram 的 0.8636);更重要的是,在 604M 这个更大预算上,最优配置来自"两个轴同时扩"(12V × A2/12 的 0.8546,优于只扩 Bigram 表的 24V × A2/6 = 0.8547 与只扩槽位的 6V × A2/24 = 0.8550——不过三者差距只有 0.0004,在 std ±0.0001–0.0012 的量级边缘,"同时扩最好"的说法证据偏弱)。真正稳的结论是:两条机制兼容,可以叠加,且叠加后的 604M 组(0.8546)比纯 MoME 的 604M(0.8533,Table 17)……反而更差——这一点作者没有点破,说明复合扩容在这个预算上并没有跑赢单纯扩 MoME 槽位。
4.5 推理延迟(Table 5 / Table 21)¶
Table 5:相对 Base 模型的推理时间增幅
| Size | Value Inject | Hidden State Inject | |
|---|---|---|---|
| Llama/MobileLLM | 350M | 7.82% | 8.05% |
| Llama/MobileLLM | 1B | 5.47% | 5.37% |
| Qwen3 | 0.6B | 7.90% | 6.44% |
| Qwen3 | 4B | 2.35% | 4.60% |
| Qwen3 | 8B | 1.56% | 2.23% |
Table 21:完整延迟扫描(Baseline 为绝对延迟 ms,记忆列为相对基线的绝对增量,括号内为百分比;$L_{mem}$ 是本 benchmark 中被注入记忆的层数)
| Arch | $L_{mem}$ | Baseline ms | VE | Bigram | MoME | MoME (hidden-state inject) |
|---|---|---|---|---|---|---|
| mobilellm350 | 2 | 3.069 | +0.017 (+0.55%) | −0.036 (−1.18%) | +0.240 (+7.82%) | +0.247 (+8.05%) |
| mobilellm350 | 3 | 4.526 | +0.025 (+0.55%) | +0.073 (+1.61%) | +0.249 (+5.50%) | +0.299 (+6.61%) |
| mobilellm1b | 2 | 5.065 | +0.024 (+0.47%) | −0.016 (−0.31%) | +0.277 (+5.47%) | +0.272 (+5.37%) |
| mobilellm1b | 3 | 7.481 | +0.035 (+0.47%) | +0.151 (+2.02%) | +0.295 (+3.95%) | +0.317 (+4.24%) |
| qwen3_0p6b | 2 | 4.768 | +0.053 (+1.11%) | −0.038 (−0.80%) | +0.377 (+7.90%) | +0.307 (+6.44%) |
| qwen3_0p6b | 3 | 7.065 | +0.050 (+0.71%) | +0.089 (+1.26%) | +0.378 (+5.35%) | +0.361 (+5.11%) |
| qwen3_4b | 2 | 21.665 | +0.099 (+0.46%) | +0.088 (+0.41%) | +0.509 (+2.35%) | +0.996 (+4.60%) |
| qwen3_4b | 3 | 32.532 | +0.129 (+0.40%) | +0.236 (+0.73%) | +0.503 (+1.55%) | +1.125 (+3.46%) |
| qwen3_8b | 2 | 37.906 | +0.079 (+0.21%) | +0.025 (+0.07%) | +0.590 (+1.56%) | +0.846 (+2.23%) |
| qwen3_8b | 3 | 56.724 | +0.085 (+0.15%) | +0.267 (+0.47%) | +0.592 (+1.04%) | +0.948 (+1.67%) |
结论分析: 路由与记忆检索的绝对开销几乎是常数(0.24–0.59 ms),所以骨干越大相对开销越小——8B 上只剩 1.04–1.56%。value-stream 注入相对 hidden-state 注入的优势只在大模型上显现(qwen3_4b:0.509 vs 0.996 ms,几乎减半;qwen3_8b:0.590 vs 0.846),小模型上两者持平甚至反向(mobilellm1b L=2、qwen3_0p6b 两行 hidden-state 更快)。也就是说"value 注入延迟更优"是一个随规模才生效的论断。另外要注意 MoME 的绝对开销比 VE(+0.02–0.13 ms)和 Bigram(−0.04~+0.27 ms)大一个量级——MoME 不是免费的,它只是在大骨干上被稀释。
4.6 ClimbMix 上的放大训练(Table 6 / Table 14)¶
在 104.858B ClimbMix token 上对比 MoME、Dense、VEmbedding,nanochat d24 架构,并把 Qwen3-0.6B 与 Llama 3.2-1B 作为在远大得多语料上训练的外部参考。报告四个语料的 bpb:held-out ClimbMix 验证集是 in-domain,FineWeb-Edu / enwik9 / Shakespeare 是 out-of-domain。
Table 6:100B-token 训练结果(Network 参数不含记忆参数)
| Model | Train tokens | Network (B) | Memory (B) | Score tok/s | ClimbMix ↓ | FineWeb-Edu ↓ | enwik9 ↓ | Shakespeare ↓ | CORE-22 ↑ |
|---|---|---|---|---|---|---|---|---|---|
| Qwen3-0.6B | 36T | 0.60 | 0.00 | 43.8k | 0.7629 | 0.8125 | 0.8649 | 1.3855 | 0.3753 |
| Llama-3.2-1B | ≤9T | 1.24 | 0.00 | 51.7k | 0.7186 | 0.7378 | 0.7451 | 1.2169 | 0.3629 |
| Dense | 100B | 0.78 | 0.00 | – | 0.6639 | 0.7677 | 0.9037 | 1.4993 | 0.3441 |
| VEmbedding | 100B | 0.78 | 0.60 | 64.0k | 0.6463 | 0.7549 | 0.8860 | 1.4823 | 0.3484 |
| MoME-A2/12 | 100B | 0.78 | 0.61 | 58.4k | 0.6504 | 0.7548 | 0.8850 | 1.4789 | 0.3687 |
结论分析: 在 100B 的受控 block 内,MoME 在三个 out-of-domain 评测上 bpb 全部最低、CORE-22 最高(0.3687,比 VE 高 0.0203),但 in-domain ClimbMix bpb 反而略高于 VE(0.6504 vs 0.6463)。这个组合本身很有意思:上下文路由让模型少记一点 in-domain 的表面统计、多学一点可迁移的结构。MoME 的 CORE-22 逼近 Qwen3-0.6B(0.3687 vs 0.3753)而预训练 token 少两个数量级,吞吐(58.4k)与两个外部参考同量级。但这一格 block 只跑了单种子(作者在 Limitations 里自认),所以 0.6504 vs 0.6463 这类 0.004 量级的差异不可过度解读。
Table 14:100B 检查点与外部参考的 22 任务原始准确率(%)
| CORE task | Dense VE | MoME | Qwen3-0.6B | Qwen3-1.7B | Llama-3.2-1B | Llama-3.2-3B |
|---|---|---|---|---|---|---|
| HellaSwag, zero-shot | 66.36 | 66.75 | 52.13 | 64.86 | 63.59 | 73.43 |
| Jeopardy | 26.12 | 28.34 | 25.22 | 40.58 | 34.91 | 48.18 |
| BigBench QA Wikidata | 56.44 | 57.27 | 59.93 | 68.81 | 69.34 | 72.15 |
| ARC-Easy | 74.96 | 74.24 | 73.19 | 78.87 | 68.69 | 75.34 |
| ARC-Challenge | 47.27 | 46.50 | 43.69 | 54.44 | 38.14 | 48.04 |
| COPA | 69.00 | 70.00 | 71.00 | 75.00 | 74.00 | 80.00 |
| CommonsenseQA | 50.12 | 59.38 | 66.01 | 80.10 | 36.77 | 71.42 |
| PIQA | 78.07 | 78.18 | 71.16 | 76.12 | 75.52 | 79.11 |
| OpenBookQA | 45.20 | 43.20 | 34.80 | 41.80 | 38.80 | 43.80 |
| LAMBADA | 52.78 | 52.49 | 54.59 | 62.51 | 62.16 | 69.57 |
| HellaSwag | 67.38 | 67.97 | 52.45 | 65.55 | 65.16 | 75.49 |
| Winograd | 80.95 | 80.22 | 75.46 | 80.59 | 82.42 | 85.71 |
| WinoGrande | 61.80 | 60.46 | 58.25 | 63.77 | 60.22 | 69.53 |
| BigBench Dyck Languages | 4.40 | 7.80 | 12.20 | 31.50 | 13.70 | 22.40 |
| AGI Eval LSAT-AR | 24.78 | 25.22 | 24.35 | 26.09 | 23.91 | 24.35 |
| BigBench CS Algorithms | 37.35 | 43.64 | 47.73 | 73.79 | 46.21 | 62.20 |
| BigBench Operators | 18.57 | 23.33 | 60.95 | 73.33 | 40.00 | 58.10 |
| BigBench Repeat Copy Logic | 3.12 | 3.12 | 15.62 | 18.75 | 9.38 | 21.88 |
| SQuAD | 52.12 | 52.53 | 57.75 | 65.51 | 51.97 | 61.00 |
| CoQA | 38.13 | 39.30 | 39.45 | 44.91 | 36.34 | 43.76 |
| BoolQ | 62.51 | 69.36 | 74.25 | 81.28 | 64.98 | 74.28 |
| BigBench Language Identification | 25.42 | 26.31 | 36.58 | 42.71 | 24.77 | 49.00 |
MoME 在 22 个任务里赢下 15 个,最大增幅来自 CommonsenseQA(+9.26)、BoolQ(+6.85)、BB-CS Algorithms(+6.29)、BB-Operators(+4.76);输的 7 个都是小幅(最大 −2.00 的 OpenBookQA)。
5 消融与分析¶
5.1 上下文条件化路由是否真的必要(Table 18)——本文最关键的对照¶
这是直接检验核心主张的实验:在保留多个可训练槽位、参数与算力近似匹配的前提下,只改路由规则。
Table 18:路由对照(d24/w1536/h12,ClimbMix,seed 42,约 $6\times10^{19}$ 训练 FLOPs;两个 delta 列都是"对照值减 MoME 值")
| Variant | Context-conditioned | Parameters (M) | Validation bpb ↓ | ∆bpb | CORE-22 ↑ | ∆CORE |
|---|---|---|---|---|---|---|
| MoME, hidden-state routing | Yes | 1,386.8 | 0.6990 | — | 0.2941 | — |
| MoME, learned token-only routing | No | 1,388.8 | 0.7044 | +0.0054 | 0.2853 | −0.0088 |
| MoME, fixed-random routing | No | 1,384.1 | 0.7018 | +0.0028 | 0.2768 | −0.0173 |
结论分析: 这张表干净地把增益归因到"上下文"而不是"更多槽位"——两个非上下文对照都保留了 $M$ 个槽位与相同参数量,bpb 各退 0.0028/0.0054、CORE-22 各退 0.0088/0.0173。有趣的是 learned token-only routing 的 bpb 比 fixed-random 还差(0.7044 vs 0.7018),说明"学一个只看 token id 的路由"是最糟的配置——它把容量花在学一个退化的确定性映射上,还不如随机固定分配来得干净。这反过来强化了论文的论点:槽位的价值必须由上下文兑现。
5.2 与稠密扩容的对照(Table 19)¶
Table 19:Dense-scaling 对照(ClimbMix,seed 42,约 $6\times10^{19}$ 训练 FLOPs。latency-matched 宽度是训练前用实测推理延迟选的;matched-total 稠密模型是 compute-matched 而非 token-matched,因为更大的稠密骨干在固定 FLOPs 下处理更少 token)
| Model | Params (M) | Validation bpb ↓ | FineWeb-Edu bpb ↓ | enwik9 bpb ↓ | Shakespeare bpb ↓ | CORE-22 ↑ |
|---|---|---|---|---|---|---|
| Pure dense d24/w1536 | 780 | 0.7042 | 0.8105 | 0.9775 | 1.5610 | 0.2843 |
| Latency-matched dense d24/w1728 | 973 | 0.6998 | 0.8097 | 0.9757 | 1.5632 | 0.2773 |
| Matched-total dense d25/w2048 | 1,393 | 0.7033 | 0.8092 | 0.9780 | 1.5584 | 0.2871 |
| MoME d24/w1536 | 1,387 | 0.6990 | 0.8045 | 0.9712 | 1.5531 | 0.2941 |
结论分析: 这是本文最有说服力的一张表——同训练 FLOPs 下,MoME 在原生验证集与三个 shifted-domain 评测上 bpb 全部最低、CORE-22 最高,而对照组不只有"同宽度稠密",还包括按实测延迟匹配的更宽稠密与按总参匹配的更大稠密。两个更大的稠密模型都没能超过 MoME,说明 151M→604M 这条稀疏容量确实比等量稠密容量更划算。
5.3 与其它 token-indexed 记忆基线的对照(Table 16)¶
Table 16:token-indexed 记忆对比(d24/w1536/h12,ClimbMix,seed 42,约 $6\times10^{19}$ 训练 FLOPs。Bigram 是主对比用的 2-gram 基线;canonical Engram、JTok、JTok-M、MoVE-Input 都是按近似匹配参数量适配到本文骨干的版本,架构与训练设置与原论文不同)
| Method | Parameters (M) | Validation bpb ↓ | CORE-22 ↑ |
|---|---|---|---|
| Bigram | 1,384.1 | 0.6943 | 0.2871 |
| Canonical Engram adaptation | 1,389.6 | 0.7029 | 0.2698 |
| JTok adaptation | 1,384.1 | 0.6974 | 0.2764 |
| JTok-M adaptation | 1,384.1 | 0.7003 | 0.2756 |
| MoVE-Input adaptation | 1,386.7 | 0.7016 | 0.2744 |
| MoME | 1,386.8 | 0.6990 | 0.2941 |
结论分析: 这是作者最诚实的一张表——在 d24 这个更大规模上,Bigram 的 val bpb(0.6943)明显好于 MoME(0.6990),MoME 只在 CORE-22 上领先(0.2941 vs 0.2871)。这与 §4.3 在 d12 上"MoME 每个规模 bpb 都更低"的结论相冲突;两者的差异是骨干规模(d12→d24)与数据(FineWeb-Edu→ClimbMix)都变了,作者没有解释这个反转。它也解释了为什么复合扩容(§4.4)是作者专门留的一条出路:MoME 与 Bigram 各有所长,合用才是完整答案。同时,canonical Engram 的适配版在这里是最差的一档(0.7029 / 0.2698),这正是作者选 Bigram 而非 Engram 做主基线的依据。
5.4 与稀疏 FFN MoE 的交互(Table 13)¶
Table 13:Sparse-MoE 交互(d24/w1536/h12,ClimbMix,seed 42,约 $6\times10^{19}$ 训练 FLOPs。E6/K2 在每个 Transformer 层的 6 个路由专家里激活 2 个并保留 1 个常开共享专家;"+ MoME" 额外在每个奇数层放 MoME。吞吐在 8×H100 上以相同 global batch 与原生 Flash Attention 3 测得。Active 计数包括完整的输入/输出嵌入矩阵、router、其他 dense/shared 参数、被选中的 FFN 专家与被检索到的不同记忆项;未选中的专家与未访问的记忆项被排除)
| Model | Stored params (M) | Active params/token (M) | Training tokens/s | Validation bpb ↓ | CORE-22 ↑ |
|---|---|---|---|---|---|
| MoME | 1,386.8 | 782.8 | 796,258 | 0.6990 | 0.2941 |
| MoE-FFN, E6/K2/24 | 1,384.3 | 780.4 | 653,033 | 0.6903 | 0.2886 |
| MoE-FFN, E6/K2/24 + MoME | 1,991.0 | 783.0 | 611,249 | 0.6913 | 0.2986 |
结论分析: 匹配总参的 MoE-FFN 拿到最低 val bpb(0.6903),而 MoME 拿到更高的 CORE-22 与明显更高的训练吞吐(796k vs 653k tok/s,+22%)——因为 MoME 不引入 all-to-all 专家通信。两者叠加给出最高 CORE-22(0.2986),但存储参数从 1.38B 涨到 1.99B、吞吐再降到 611k。这张表的实际读法是:MoME 与 MoE-FFN 是两条正交的稀疏轴,前者更省通信、后者更会压 loss。
5.5 各层的记忆使用(Figure 4)¶
用 Table 6 的模型,在每个记忆层 $\ell$ 上对 token 位置与 value head 做任务均衡平均:
$$M_\ell = \mathbb{E}_{\substack{(x,t)\sim \mathrm{CORE} \\ i\in[H]}}\big[\|\gamma_{\ell,t,i}\tilde{m}_{\ell,t,i}\|_2\big], \qquad \tilde{\gamma}_\ell = \mathbb{E}_{\substack{(x,t)\sim \mathrm{CORE} \\ i\in[H]}}\big[\gamma_{\ell,t,i}\big] \tag{10}$$
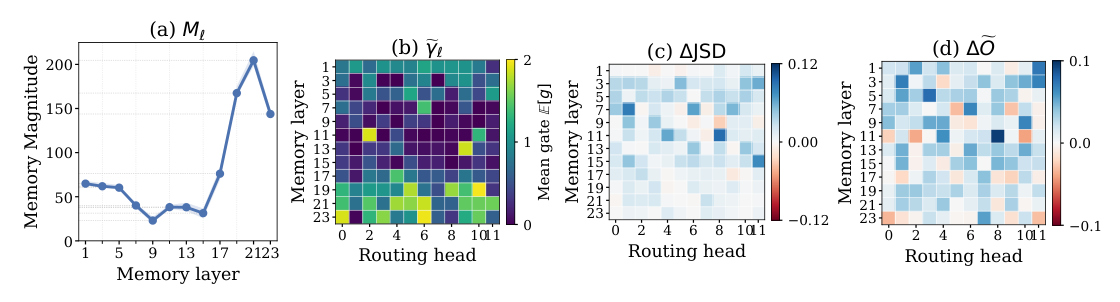
两个量给出相同的深度剖面:记忆使用在模型开头、尤其是末尾最强,中间层显著更低(Figure 4a 中第 19–23 层的记忆范数冲到 170–205,中段只有 25–40)。作者的解释是记忆先参与早期上下文化,中段让位给被变换过的骨干表征,末段再被重新召回做任务特定的精修。
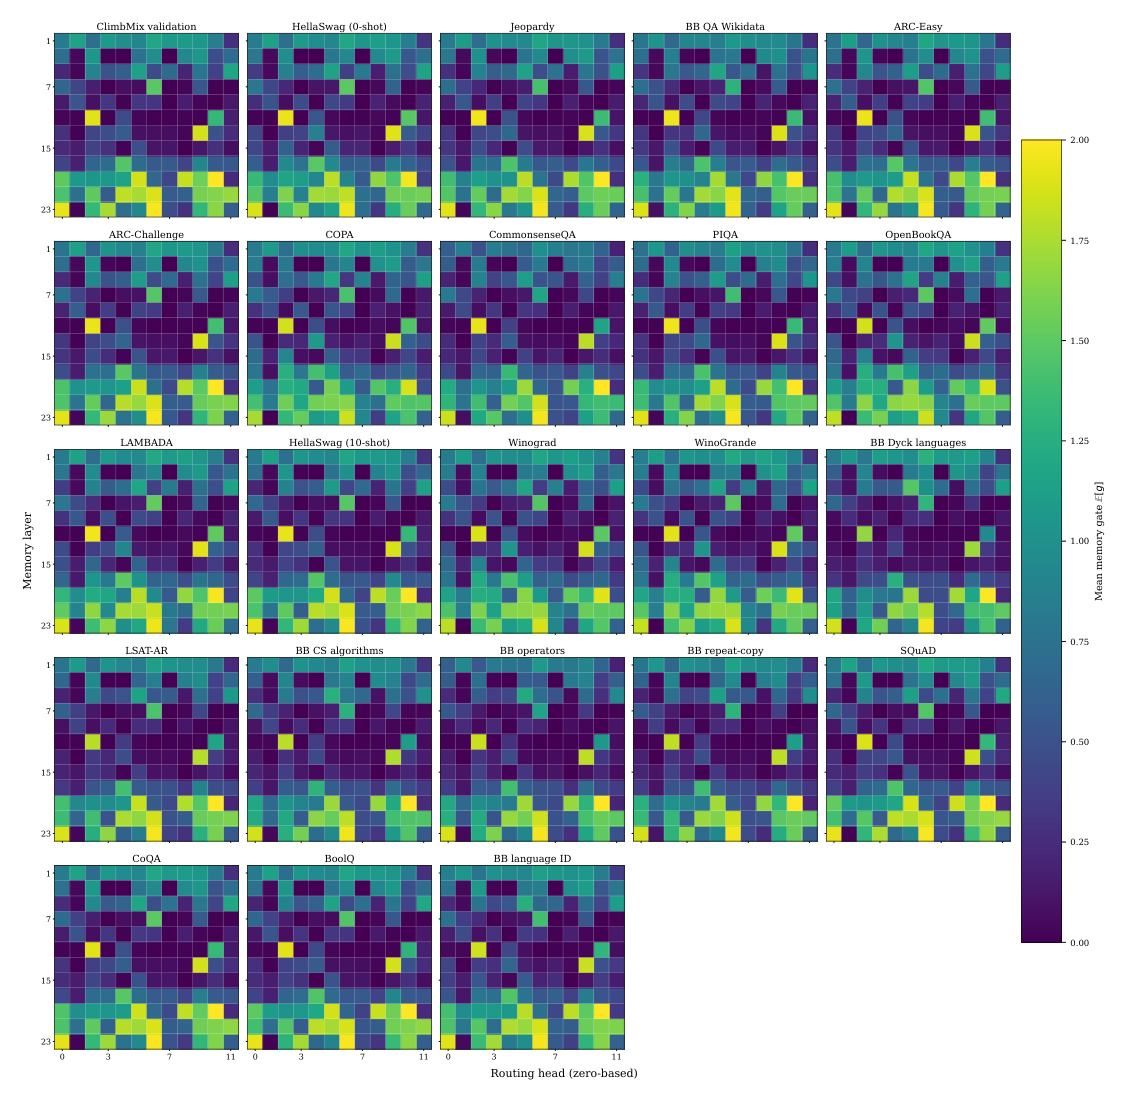
Figure 6 显示跨 CORE 任务的门模式相似,但同一层内不同 head 差异巨大——有些 head 的注入门几乎关闭,另一些接近上界 2,层均值会掩盖这些差异。Figure 7 的实际注入幅度 $\mathbb{E}[\|\gamma m\|_2]$ 在晚期层最大;作者明确声明:这些范数只度量注入幅度,不能确立记忆对预测贡献了多少。
5.6 语义可解释性:定性(Figure 3)¶
在一组多义词 token 上探查学到的 router,发现同义 prompt 倾向路由到同一个记忆槽位。论文在 Qwen-0.6B 的 Layer 7 / Head 7 上给出 bank、bug、drive 三个例子(正文 Figure 3,附录 A.11 还有 apple、cell、python 在 nanochat d24 与 Qwen 0.6B 上的结果):
- bank:
She deposited the check at the bank before noon.→ e7 权重 .98;He opened a savings account at the bank downtown.→ e7 权重 .97;而The canoe scraped the muddy bank as it landed.→ 跳到 e6,权重 .97。 - bug:两个软件语境都是 e3 权重 .99;昆虫语境跳到 e6 权重 .94。
- drive:两个存储语境都是 e3(.99 / 1.00);车辆语境变成 e6 .51 / e7 .49 的均分——这是三例里唯一没有干净分离的,作者把它原样呈现。
- nanochat d24 上同样成立:
python在 Layer 5/Head 4 上,编程语境两次都是 e3 权重 1.00,蟒蛇语境跳到 e9 权重 .92。
作者强调:这三个例子里 n-gram 路由的窗口都太短,无法消歧,而 MoME 可以条件化在完整前缀上——注意目标词之后的文本被灰掉了,因为路由只看得到前缀。
5.7 语义可解释性:定量(WiC,Figure 8 / Figure 9)¶
用 Word-in-Context (WiC) 数据集做量化:每条样本含两句自然句、同一个标记目标词,并标注两处词义是否相同。
过滤协议:从全部 6,828 对(5,428 train + 1,400 test)出发,只保留"strict-natural"对——两句中被标记的表面形式与规范目标词大小写不敏感地一致、每处恰好是一个 tokenizer token、两处 token ID 相同,剩 3,206 对。由于记忆 router 是因果的、只能用目标词之前的前缀,再要求两处出现都严格位于其分词后句子的中点之后:
$$r(x) = \frac{p(x) - \frac{1}{2}}{L(x) - 1} > \frac{1}{2} \tag{11}$$
$p(x)$ 是含 BOS 的序列里目标词位置、$L(x)$ 是序列长度,两处都通过才保留。最终 670 对(549 train + 121 test;354 同义 T + 316 异义 F),362 个不同目标 token ID,1,340 处出现。最短前文长度中位数 5 token、四分位距 4–6;547 对至少有 4 个前置 token。保留集严重偏名词(634 名词对 vs 36 动词对)。
两个互补指标,在 d24 检查点的全部 144 个 layer–head 站点上评估。对第 $i$ 对,设两处出现的完整路由分布为 $q_{i1,s}, q_{i2,s}$,$m_{i,s} = (q_{i1,s}+q_{i2,s})/2$,用 base-2 的 Jensen–Shannon 散度:
$$d_{i,s} = \tfrac{1}{2}\mathrm{KL}_2(q_{i1,s}\|m_{i,s}) + \tfrac{1}{2}\mathrm{KL}_2(q_{i2,s}\|m_{i,s}), \qquad \Delta\mathrm{JSD}_s = \mathbb{E}[d_{i,s}\mid F] - \mathbb{E}[d_{i,s}\mid T] \tag{12}$$
再用 Olson et al. 的机会校正 top-K 决策重叠:设 $A_{i1,s}, A_{i2,s}$ 为实际执行的 top-K 槽位集合,$o_{i,s} = |A_{i1,s}\cap A_{i2,s}|$,$M$ 为槽位数:
$$\tilde{O}_{i,s} = \frac{o_{i,s} - K^2/M}{K - K^2/M}, \qquad \Delta\tilde{O}_s = \mathbb{E}[\tilde{O}_{i,s}\mid T] - \mathbb{E}[\tilde{O}_{i,s}\mid F] \tag{13}$$
JSD 比较完整路由分布(即使选中的槽位相同也能捕捉权重差异),$\tilde{O}$ 度量两处出现选中相同槽位的程度(离散决策)。两个都用是为了检查结论对权重和离散选择是否都成立。
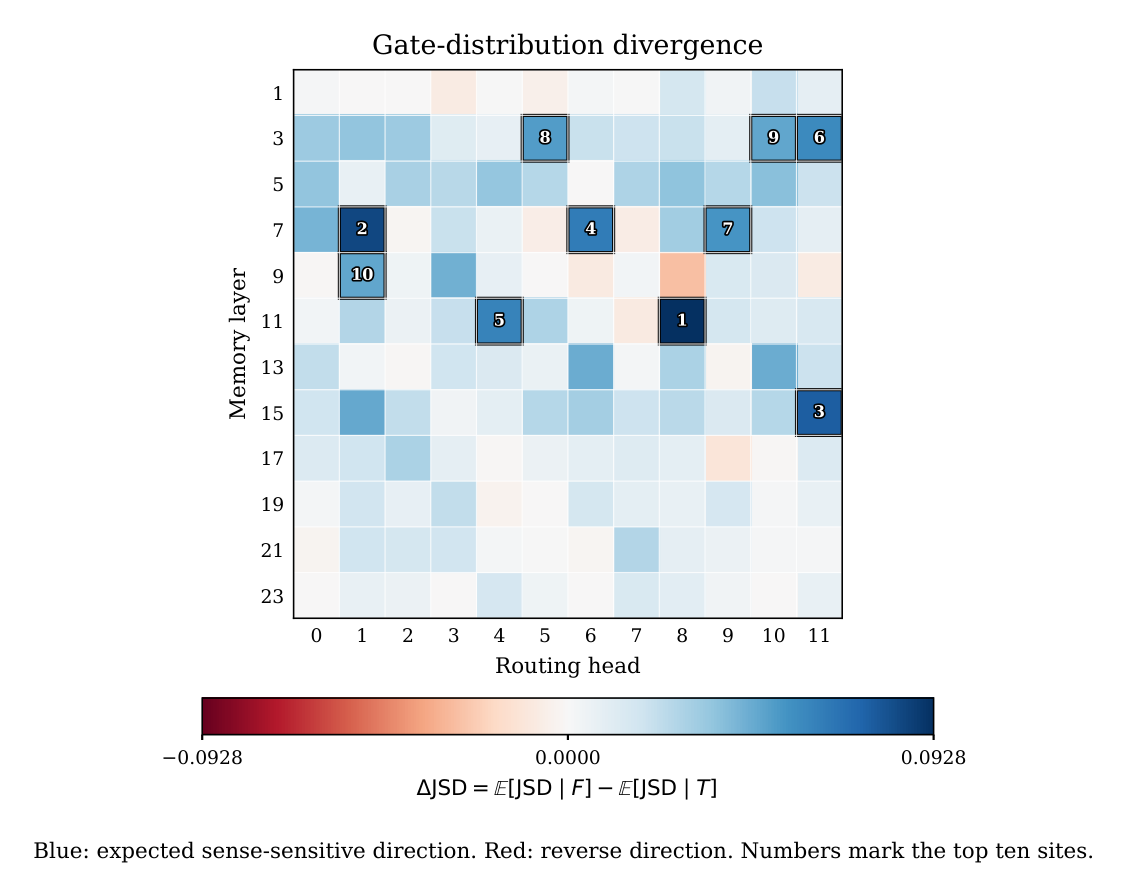
结果:144 个站点中 117 个的 ∆JSD 为正、110 个的 ∆Õ 为正。 最大效应在 layer 11 / head 8:$\Delta\mathrm{JSD}=0.0928$,pair-stratified bootstrap 95% 区间 $[0.0489, 0.1357]$;同一站点 $\Delta\tilde{O}=0.0939$,区间 $[0.0360, 0.1520]$。十个最大效应的逐点 bootstrap 区间都在零以上。最大的差异多出现在中间层。
注入门加权的敏感性分析:为了考虑注入强度,用 $w_{i,s} = \sqrt{\gamma_{i1,s}\gamma_{i2,s}}/2 \in [0,1]$(任一处门小则权重下降)加权:
$$\Delta\mathrm{JSD}^{gate}_s = \mathbb{E}[w_{i,s}d_{i,s}\mid F] - \mathbb{E}[w_{i,s}d_{i,s}\mid T] \tag{14}$$
并按 $\min(\gamma_{i1,s},\gamma_{i2,s}) \ge \tau$($\tau \in \{0.1,0.2,0.25\}$)重算两个指标。加权后最大效应的站点换人了:layer 11/head 8 虽有最大的未加权路由差异,但它的注入门几乎关闭;换成门几乎全开的 layer 7/head 6 成为最大加权效应($\Delta\mathrm{JSD}^{gate}=0.0589$,区间 $[0.0167,0.1016]$),15 个站点的加权区间在零以上。$\tau=0.1$ 时 122/144 站点为正,$\tau=0.2$ 时 116/144;最严格的 $\tau=0.25$ 下多数保留站点仍显示异义对路由散度更大、同义对槽位重叠更多。
作者自陈的局限(Scope and limitations):路由差异与词义相关,但该分析不度量它们对预测的影响;只有 81 个目标 token 组同时含两种词义标签,所以池化比较可能反映词汇组成差异;分析把 WiC 的 train 与 test 合并,不估计 held-out 泛化;bootstrap 区间是逐点的,最大效应在同一批样本上被选出且未跨 144 个站点做多重比较校正。确认性检验需要另一批含重复目标类型的数据以及带 max-T 或 FDR 校正的站点级标签置换检验。——这段自陈非常克制,是本文加分项。
5.8 Router 槽位利用率审计(Table 20)¶
在 100B-token 检查点上,对 ClimbMix 验证、FineWeb-Edu 验证、enwik9、Shakespeare 各取 1,048,576 个源 token 位置(排除 BOS 与 padding),在 12 记忆层 × 12 路由头共 144 个站点上统计,有效槽位数定义为 $M_{eff} = \exp(H(p))$。
Table 20:100B-token MoME 检查点的 router 槽位利用率审计(Per-token 计数只保留出现至少 32 次的 token ID;Inactive cells 统计在该语料上从未被选中的 layer–head–slot 组合;JSD 比较各站点路由权重分布与 ClimbMix 的差异)
| Domain | Marginal effective slots | Weight-effective slots | Largest-slot mass | Per-token effective slots | Inactive site–slot cells | Mean/max JSD |
|---|---|---|---|---|---|---|
| ClimbMix validation | 4.614 | 3.265 | 61.66% | 3.550 | 4 / 1,728 | 0 / 0 |
| FineWeb-Edu validation | 4.576 | 3.222 | 61.85% | 3.491 | 9 / 1,728 | 0.0026 / 0.0282 |
| enwik9 | 4.528 | 3.209 | 60.95% | 3.353 | 12 / 1,728 | 0.0235 / 0.1412 |
| Shakespeare | 4.230 | 2.959 | 64.01% | 3.082 | 42 / 1,728 | 0.0305 / 0.2975 |
结论分析: 路由质量确实集中在一部分槽位上(最大槽位占 61–64% 质量,12 个槽位的有效数只有 4.2–4.6),但同一 token 的重复出现确实会用到不同的槽位对——每个域的 token-conditional 有效槽位数(3.08–3.55)都超过每次出现选中的槽位数($K=2$)。这是对"同一 token 在不同上下文走不同路由"最直接的统计证据,比 §5.6 的挑选例子更有说服力。域偏移越大,路由分布与 ClimbMix 的差距越大(Shakespeare mean JSD 0.0305、max 0.2975,未激活单元也从 4 涨到 42)。作者提醒:这些统计度量的是 router 的集中度,而非学到的记忆表覆盖率。
6 核心贡献总结¶
- 把 conditional memory 的瓶颈从"注入位置"重新定位到"寻址方式"。Table 1 的整理显示整个 memory-embedding 家族在注入点上百花齐放,却共享同一个确定性 surface-form 索引;MoME 是第一个把第二级索引器条件化在 hidden state 上的工作,并且把"两级索引器复合"($f$ 选行、$g_\theta$ 选槽)写成了一个清晰的抽象。
- 一个把容量从 token 轴搬到上下文轴的旋钮:$c_{grp}$ 让 token 行数压缩 $c_{grp}$ 倍、槽位数扩大 $c_{grp}$ 倍,总参数守恒。这把"一 token 一行是不是最优的容量分配"变成了可实验的问题,答案是 $c_{grp}=2$ 附近最好、$c_{grp}=4$ 开始伤 CORE。
- 注入点选择带来的延迟红利:条件化在 $h_t$ 上并注入 value 流,让记忆分支能与标准 value 投影并行调度,只在门控残差加法处 join;在 4B/8B 骨干上比 hidden-state 注入的开销少一半。
- 一个真正隔离了核心主张的对照实验(Table 18):在等参且同样保留 $M$ 个槽位的前提下,hidden-state 路由 > fixed-random > learned-token-only。这比"我的方法赢了 baseline"有价值得多。
- 上下文路由与词义相关的定量证据(117/144 与 110/144 站点方向一致,带 bootstrap 区间与门加权敏感性),且局限性自陈克制。
7 与已归档相关工作的对比¶
PrefixMem PrefixMem: LLMs Need Encoders for Semantic IDs Too(Pinterest,2026-05-29)¶
关系:独立并发(本文未引用 PrefixMem,PrefixMem 也未引用 MoME,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇论文的问题陈述几乎可以互换。PrefixMem 的核心事实是"一个码的含义取决于它的前缀"——前缀 1273 之后的码 505 索引 sneakers,前缀 974 之后的同一个 505 索引 vintage art;如果把 SID 当扁平词表 token,同一个 505 无论前缀如何都拿到同一个 embedding。MoME 的核心事实是"同一个 token 在不同上下文携带不同语义"——
python是语言还是蟒蛇、bank是银行还是河岸,而确定性表只给它一个槽位。两者指向同一个 root cause:token-indexed 嵌入表把容量按 surface form 分配,因此对上下文失明,而且都把它称为"同一个 id 拿到同一个向量"的结构性缺陷。 - 相近的技术骨架:两者都是"在 token embedding 之上挂一张可扩容的稀疏记忆表,把上下文条件化的向量以残差形式加回主干",且都特意处理了新模块的冷启动——PrefixMem 把 $W_{out}$ 初始化到近零让哈希表慢慢预热,MoME 用系数 2 让 $\gamma$ 门在 logit=0 时取 1 给出中性初始尺度。PrefixMem 的物理解释("哈希表为每一个前缀模式提供专属容量,一次 $O(1)$ 查找取回前缀条件表征,而 LLM 要达到同样效果必须通过多层 attention 在前缀 token 上组合出这份知识")和 MoME 的动机("Transformer 没有原生 lookup primitive,只能花早期层容量去重建一张静态表")是同一句话的两种说法。
- 本文的差异与推进:分野在上下文键是什么。PrefixMem 的上下文键仍是 surface form 的确定性函数——把递增长度的前缀 n-gram 用固定质数 XOR 哈希进多头表($\mathrm{idx}_{n,h}=(\bigoplus_i c_i\times p_{i,h})\bmod T$),这正是 MoME 明确要超越的 Engram/Bigram 一档(Table 1 的 "Context aggregation: n-gram")。MoME 把第二级索引器换成 $g_\theta(h_t)$ 上的可学习 top-K 门,从而能条件化在任意长的完整前缀上,而不是固定窗口的 n-gram。MoME 的 Table 18 恰好可以被读作对 PrefixMem 路线的间接反驳:learned token-only routing 的 val bpb 0.7044 是三个变体里最差的。反过来,PrefixMem 在 SID 场景下有 MoME 没有的优势——SID 的前缀本身就是层级化、语义有序的,n-gram 哈希在那里不是近似而是精确寻址;而自然语言 token 的 2-gram 窗口确实太短。
- 可比的方法/实验差异:PrefixMem 在 Pinterest 十亿级物品语料上验证,收益集中在"贪心解码失败的硬样本"(相对 +77%)与稀有物品(+115%),且编码器可独立预训练、跨 LLM 家族迁移;MoME 是 sub-1B 的受控预训练,指标是 bpb/CORE,没有部署。两者对"新模块要不要预训练"给出相反的工程选择:PrefixMem 把编码器当视觉编码器一样先在物品数据上预训练再挂进目标 LLM;MoME 的 kNN 分组表来自一个轻度预训练(约 1B token)的基线 run 但全程冻结,且默认配置里干脆关掉分组以隔离混合本身的效果。
ComeIR ComeIR: Conditional Memory Enhanced Item Representation(香港城市大学 / 清华,2026-05-12)¶
关系:独立并发(本文未引用 ComeIR)· 已加载对方精读
- 共同关注的问题:ComeIR 与 MoME 都建立在 Engram 这条 conditional-memory 线上,且都认为"单个 token/code 的 embedding 装不下它在不同上下文里需要携带的证据"。ComeIR 把这个缺陷落在生成式推荐的 representation stage:把 $L$ 个 SID code 线性 merge 成一个 item 向量会"放大量化损失、掩盖码间结构",而 external-input 方法注入的信号"不是按 SID 结构组织的"。MoME 落在 LLM 的 token 表:一行被要求装下
bank的两个意思。两者的解法起点因此一致:给主干挂一张按离散模式寻址的稀疏记忆表,把检索到的证据以门控残差加回表征。 - 相近的技术骨架:ComeIR 的 General Engram 读出 $\mathcal{R}_\ell(q,p)$ 与 MoME 的记忆读出结构惊人地平行——(a) 用离散模式做多头哈希查表拿到候选记忆,(b) 用一个 query 算 sigmoid 标量门 $\lambda_{\ell,o}=\sigma((W_Q q)^\top(W_K a)/\sqrt{d})$ 过滤每个 order 的贡献,(c) 门控加权求和后投影。对照 MoME 的 (2)(4)(5)(7):同样是 hidden/summary 作 query、同样是 sigmoid 门、同样是加权和后以残差注入。ComeIR 的 Memory-conditioned Token Merge 更是逐层 gated residual $s^\ell_n = s^{\ell-1}_n + \omega_{n,\ell}W^M_{V,\ell}u_{n,\ell}$,与 MoME 的 $\tilde v_{t,i}=v_{t,i}+\gamma_{\theta,t,i}\tilde m_{t,i}$ 同构。
- 本文的差异与推进:分野同样在寻址 vs. 融合。ComeIR 的上下文只进入融合门 $\lambda$,寻址依旧是 SID 的确定性 n-gram 模式(intra-item 的 $(c^{<\ell}_n,c^\ell_n)$、inter-item 的前缀转移后缀窗口)——这正是 MoME 在 Table 1 里给 canonical Engram 打的标签:"Context aggregation: n-gram;canonical Engram additionally conditions fusion on the hidden state"。MoME 把上下文往前挪了一步,让它决定读哪一行的哪些槽位,而不只是信多少。反过来 ComeIR 有 MoME 没有的一招:Memory-restoring Prediction Head——因为哈希是确定性的,输入端用过的 entry 在解码端可以按候选 code 重新拼出模式再取回,从而打通输入-输出粒度错配。MoME 的 hidden-state 路由恰恰牺牲了这个可复用性:路由依赖当前 hidden state,无法在解码端凭候选 token 重建,这是"确定性寻址"被放弃后付出的代价。
- 可比的方法/实验差异:两者都做了记忆容量的 scaling 研究但结论不同。ComeIR 拟合出对数线性律 $R_e = 6.5^{-4}\log_2(P_S)+0.0117$(intra)与 $5.9^{-4}\log_2(P_T)+0.0140$(inter),并观察到 intra 在 $C^L=128^3\approx 2.1$M 的模式空间上限处饱和、inter 扩到 4.43B 稀疏参数仍在拿增益,但 $s_T\ge 5.0$ 时出现 U 型反伤(bucket 太多导致槽位样本不足)。MoME 在 75.5M→604M 区间内没有观察到饱和或反伤,但它的容量轴是"槽位数 $M$"而非"哈希桶数"——槽位是稠密训练的(每行的每个槽位都被该 token 的所有出现共享),天然不会遇到 ComeIR 那种 sparse over-allocation。这实际上是 MoME 相对哈希类方法一个未被作者点明的结构优势,也部分解释了 §4.3 里 MoME 的 run-to-run 方差为何明显更小。另一边,ComeIR 在 Yelp/Amazon 上拿到 H@5 +8% 的同时 2.5× 推理加速(靠把序列从 $L\times N$ 压到 $N$),MoME 则是纯增开销(+1.0%~+7.9% 延迟)——因为 MoME 不改变序列长度,只加一条旁路。
8 讨论与局限性¶
8.1 核心贡献与值得借鉴的设计¶
最值得抄的是 Table 18 那种"保留全部结构、只抽掉被声称的那一个因素"的对照。很多论文的消融是"去掉模块 X 掉多少分",而这里三个变体参数量都在 1,384–1,389M、都保留 $M$ 个可训练槽位,唯一变的是"门看不看 hidden state"。这样得到的 +0.0054 bpb / −0.0088 CORE 才真正归因到"上下文"。更妙的是 learned token-only routing 比 fixed-random 还差这个反直觉结果——它说明可学习的确定性路由会主动浪费容量。
第二个可借鉴点是注入点与调度的协同设计。作者不是随便选了 value stream,而是明确论证:条件化在 $h_t$ 上使 router 的输入与 value 投影的输入相同,因此两条分支可以并行调度,只在门控残差加法处 join。这类"把架构选择的理由落到 kernel 调度上"的推理在学术论文里不多见,Table 21 的实测也支持它(但只在 4B/8B 上生效)。
第三个是 $c_{grp}$ 这个旋钮本身:把"token 轴容量 vs 上下文轴容量"参数化成一个守恒的可扫变量,是一个干净的实验设计。放到推荐系统的语境里,这对应"一个 item ID 一行 embedding" vs "一个语义簇一行、簇内按上下文分槽"——MoME 的答案是压缩 2 倍最好、4 倍开始伤。当然这只是 LLM token 表上的结论,item ID 表的稀疏度、长尾分布与冷启动都不同,不能直接搬。
8.2 局限性与争议¶
- 规模:作者自陈的首要限制。100B-token 实验总参约 1.4B,但底下的稠密骨干只有约 0.8B,且这个规模检查只跑了一个种子。所有"三种子均值"的严谨结论都在 135M 的 nanochat d12 上。
- 主张与证据不完全对齐。摘要说"MoME 在 iso-parameter 与 iso-training-FLOP 设定下优于 Value Embedding、Bigram、STEM 基线",但:Qwen3 0.6B 等参下 MoME 的 val bpb 比 VE 差(0.7461 vs 0.7427),靠 CORE 翻盘而 CORE 的增量高度集中在 BoolQ 这个单任务上(+15.8 点,而 base→VE 本身就掉了 12 点,说明该任务在此规模上极不稳定);d24 规模上 Bigram 的 val bpb 明显好于 MoME(0.6943 vs 0.6990,Table 16),与 d12 上"每个规模 MoME 都更低"(Table 17)相反,作者未解释这个反转。更准确的表述应该是"MoME 一致改善 CORE,bpb 上的优势依骨干与数据而定"。
- CORE 的噪声水平与效应量同量级。Table 2 中方法间 CORE 差异约 0.005–0.014,而单个配置的 std 可达 ±0.011(Bigram ±0.0116、$c_{grp}$=4 ±0.0110)。Table 15 更暴露出 BigBench 子任务在这个规模上大面积为 0 或接近随机。以 CORE 为主要证据链条时应当更谨慎。
- $c_{grp}$ 的故事不稳。$c_{grp}=4$ 在 151M 时 bpb 最好,到 302M 时 CORE 塌到 0.1515(比不分组差 0.012,比 VE 还差)。而复合扩容表(Table 12)在 604M 的最好配置 0.8546 反而不如纯 MoME 扩槽位的 0.8533(Table 17)——"复合扩容更好"的叙事在数据上并不成立,作者没有把这两张表放在一起看。
- 可解释性分析是描述性的。作者自己说得很清楚:CORE 激活与 WiC 分析提供的是"选择性记忆使用与词义敏感路由的描述性证据",需要因果干预才能确立这些行为是否改善下游准确率或域偏移下的鲁棒性。WiC 分析还合并了 train/test、最大效应在同一批样本上被选出、144 个站点未做多重比较校正、保留集严重偏名词(634:36)。Figure 4a 的记忆范数也只是幅度而非贡献。
- MoME 不是免费的。绝对延迟开销(0.24–0.59 ms)比 VE 和 Bigram 大一个量级,只是在 4B/8B 骨干上被摊薄到 1–2%。在小模型/端侧场景,7.8% 的延迟增幅换来的收益是否划算需要单独论证。训练吞吐也降 2–7%。
- 与推荐系统的关系是"同构可迁移",不是本文的证据。token-indexed 记忆表与推荐里的 item ID 嵌入表结构同构("一个 id 一行" → "M 个槽位 + 隐状态门控选择"正好对应"同一物品在不同上下文下的多义表示"),这也是这篇纯 LLM 论文对本档案有价值的原因。但本文的实验全部在受控语言模型预训练上,没有任何推荐任务的证据,迁移性只是结构上的类比。真要落到推荐,至少还有三个开放问题:item ID 的长尾分布远比 token 极端(大量 item 出现次数不足以训熟 $M$ 个槽位)、$c_{grp}$ 的 kNN 分组在 item 语义空间上未必成立、以及 MoME 放弃确定性寻址后无法像 ComeIR 那样在解码端复用记忆。
8.3 未来方向(作者观点)¶
作者提出两条:(1) 研究更好的复合扩容策略,把高效 token 路由与 mixture-of-memory 机制结合;(2) 从学到的路由中观察到的语义结构出发,探索控制记忆路由能否成为引导模型行为的实用抓手——这一条如果做通,等于把 MoE 可解释性研究里的"专家即语义"叙事落到一个更可控的对象(记忆槽位)上。