KuaFu:把十亿用户的长行为压缩成"理解"——以单个行为 item 为压缩单元的 LLM 用户理解层¶
论文:KuaFu: Compressing Long User Behavior into Understanding at Billion Scale(arXiv 2609.31045,2026-09-25) 机构:Tencent Inc.(深圳),Jiahao Hui、Lin Zhu 等 11 人
一、研究动机与背景¶
1.1 背景:用户理解是对话 agent、生成式推荐、个性化广告的共同底座¶
论文开篇把问题放在一个很宽的框架里:对话式 agent、生成式推荐和个性化广告都依赖同一项能力——从原始行为日志里理解每个用户。工业界现行做法是 task-wise 的:每个画像任务(兴趣总结、职业/行业、人生阶段……)先从全量历史里筛出与该任务相关的子序列,再为它单独训练一个理解模型。分工清楚、各任务能独立迭代上线,是当下最务实的选择,但它撞上两个生产事实:筛完之后序列依然极长;画像必须定期刷新。
LLM 改变了这件事:它不再只是外推统计共现,而是能读出行为序列背后的意图。论文引用 "Language Modeling Is Compression"(Delétang et al.)作为桥梁:模型压缩一个数据集所需的比特数直接反映它对数据的理解与预测能力——压缩和理解是同一目标的两个视角。因此,先把长行为序列压成紧凑、语义丰富的表示再交给 LLM,是兼顾精度与效率的自然路线;而一个紧凑、忠实、可复用的行为表示,也是"一个基础模型读完整段历史、按需回答任何画像问题"这一终局得以成立的前提。
1.2 三个耦合的问题¶
落地时论文识别出三个相互耦合的问题:成本墙逼着必须压缩(P1)→ 压缩本身诱发幻觉(P2)→ 缺少中间评测使这些幻觉无法度量与定位(P3)。
- P1:长序列 × 定期刷新的成本墙。 把历史序列化成 prompt 文本会随序列增长溢出 context window;即便是按任务筛过的子序列,长尾也超过一千个 item(见 Table 2),完整历史更是遥不可及。更硬的约束来自规模:十亿用户每周重算一次画像,总量约 100K QPM,在固定 GPU 预算下这变成单卡吞吐的硬下界,直接在数万原始 token 上推理远达不到。要摊薄成本,压缩表示必须离线缓存、在线复用,于是单个表示的字节数变得关键:每个 item 存两个 2560 维向量(fp16 约 10 KB)在全量规模下不可行,而 $2\times128$(约 0.5 KB)才让缓存可行。
- P2:压缩诱发的幻觉。 当 LLM 被迫在压缩或截断的行为描述上推理时,用户理解特有的四类幻觉会反复出现:fabrication(编造从未发生的兴趣)、omission(压缩中丢失的偏好信号被漏掉)、date misattribution(事件被归到错误时间桶)、broken logic(在残余证据上推理失败)。已有研究(An Empirical Study on Prompt Compression, 2505.00019)报告 prompt compression 几乎总会抬高幻觉率、信息损失是主因,与作者的生产观察一致。这些模式集中在开放式生成中,而没有 ground-truth 画像时很难检测。
- P3:未被度量的中间阶段。 行为压缩与理解作为中间环节,缺少标准数据集和指标。推荐中的行为序列压缩按端到端(CTR、GMV)评判,通用压缩又不关心画像语义;没人直接问"压缩表示是否忠实保留了用户偏好"。压缩引入的误差只以下游的间接退化出现:一次线上 A/B 要一周,而根因是压缩伪影、幻觉还是 decoder 容量,看月底业务指标根本分不出来。
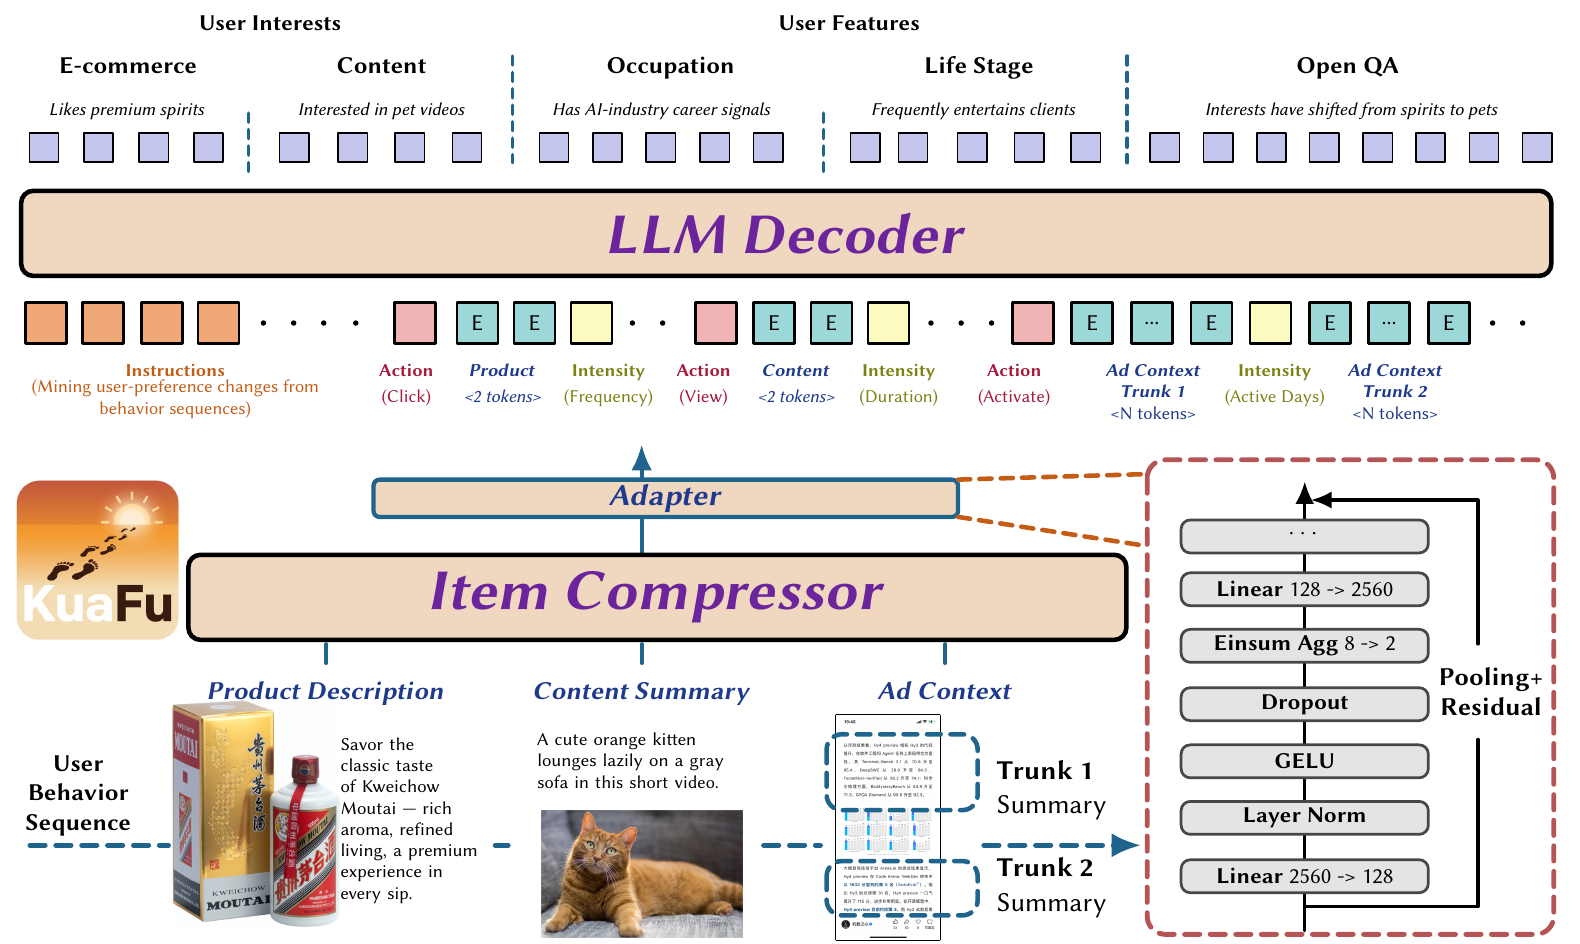
Figure 1 给出了生产形态:输入端是 "Action(Click/View/Activate)+ item 压缩 token(商品 <2 tokens>、内容 <2 tokens>、广告上下文按 trunk 各
1.3 贡献¶
- 架构:item 级、可缓存、两轴压缩。 每个行为事件独立编码,因此 embedding 可缓存、可跨用户与任务复用、可随新行为追加;缓存规模随 item 库存而非 #users × #tasks 增长。作者称这是首次在十亿用户广告推荐生产环境里以 item 粒度编码行为文本。两轴投影器再沿 token 轴与宽度轴继续压缩。
- 训练:面向保真的四阶段配方。 覆盖 42 类任务的分层难度数据;重建 → 理解 → 压缩与生成联合训练 → 幻觉感知 RL 四阶段由易到难逐级继承;重建阶段用序列长度课程保证收敛;RL 目标对每类幻觉设一个惩罚项并加完整性奖励,抑制幻觉的同时不让模型退化为拒答。
- 评测与部署:分层中间评测协议 + 大规模生产验证。 从简单分类、复杂多标签归因到开放域 QA 与多任务迁移,直接给压缩表示打分,把"压缩误差 → 下游退化"的反馈回路从数月缩短到数天。
二、相关工作定位¶
- 通用上下文压缩。 Hard compression(Selective Context、LLMLingua 及后继)按信息量删 token,仍输出自然语言。Soft compression 把上下文写进少量 memory slot:GIST 压短指令;AutoCompressor 递归产生 summary vector;ICAE 用 LoRA encoder 写 memory、冻结 decoder 从中生成;500xCompressor 把压缩比推得更高;REFRAG 用 RL 决定 RAG 中哪些 chunk 展开成完整 token;近期 SAC 与 EPL 在压缩比和保真度上继续推进,是本文的主要对比对象。这些方法证明 QA 在压缩后能存活,但处理对象是连续文档或检索段落,没有显式建模带时间戳、跨模态的行为事件;目标是重建或下游 QA,不直接约束编造、漏检或日期错位。
- 推荐中的 item/行为 tokenization。 TIGER(RQ-VAE 层次 semantic ID)、LAMIA(并行多面 embedding)、Token Factory(融合异构交互特征)、PatchRec(把远端历史按 session 打 patch)、Q-Former 家族(含 U2QT/FOUNDv2,用固定数量 query 做信息瓶颈)。这些表示服务于 next-item 预测,评测几乎只有 HR/NDCG/CTR:偏好与时序是否在压缩中存活,无法从端到端分数中分离;同一表示也很难迁移到需要解释行为证据的画像或对话推荐。GISTBench、UserSumBench 开始评估兴趣是否可验证,但针对的是未压缩文本,没有把压缩比、保真度和画像质量放到同一个权衡平面上。
- 工业界长序列与 LLM 效率。 三个方向:(1) 长行为序列高效建模——字节在抖音端到端建模 10K 级 ID 序列、中科院软件所与美团把稀疏注意力用于长期行为 CTR;它们在排序模型内部解决长度问题、以预测精度为目标,而 KuaFu 在 LLM 输入侧做语义压缩、目标是可解释可复用的画像表示。(2) LLM 部署效率——美团把推理 LLM 两阶段蒸馏进 BERT、阿里国际把多视角 CoT 蒸馏为 latent reasoning、百度在线剪 KV cache、阿里与港城大加速生成式推荐解码(NEZHA);它们都是"用小模型换大模型",KuaFu 保留 LLM 的理解能力、压缩其输入,产出离线缓存、跨请求跨任务复用的资产。(3) PLM/LLM 驱动的生产级生成式推荐——Google DeepMind/YouTube 的 PLUM、浙大与淘天的长 semantic ID(LSIG);它们理解 item 侧语义,KuaFu 理解用户侧长行为序列,二者互补。
三、核心方法¶
3.1 问题设定与 item 级范式¶
记 $x_i$ 为某用户的第 $i$ 个行为 item(一次点击、一次观看……),同一用户的 $n$ 个 item 按时间顺序构成序列 $X=(x_1,\dots,x_n)$。给定任务 prompt $q$,模型输出答案 $y$。论文以单个 item 作为最小压缩单元,构建"多 item 压缩范式":每个 $x_i$ 被独立编码为 item embedding $z_i$,各 $z_i$ 按 $X$ 的时间顺序拼接,与 $q$ 一起送入 decoder。与"把整段历史编码进一个共享向量"不同,这一范式满足 $z_i=f(x_i)$——压缩结果只依赖该 item 本身。由此推出三条性质:
- 同一 item 的 $z_i$ 可在不同用户的序列中复用;
- 新行为 $x_{n+1}$ 只需计算 $z_{n+1}$ 并追加,无需重压 $X$;
- 离线缓存随 item 库存而非用户数增长。
作者明确说:这三点就是 §4.9 所报告的全部系统经济性的来源。
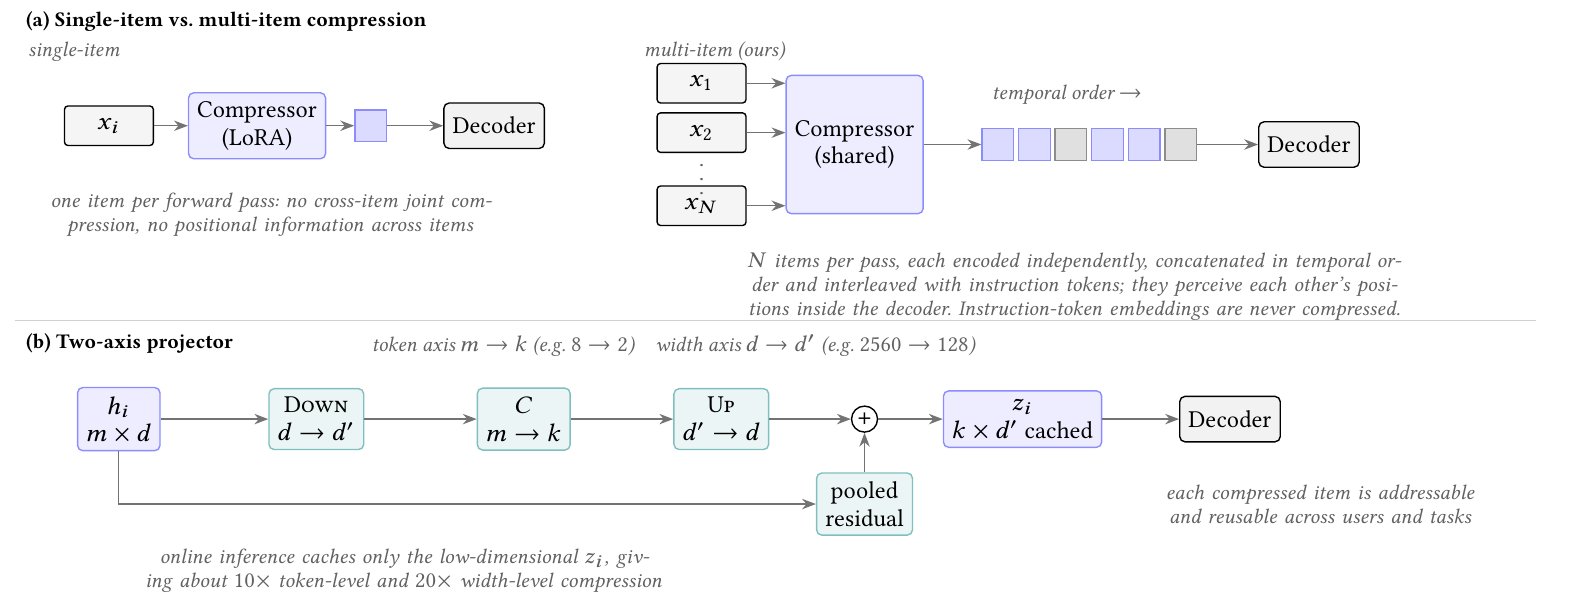
Figure 2(a) 解释了为什么是"多 item":早期的 single-item 训练每次前向只压一个 item 再交给 decoder,既没有跨 item 的联合压缩,也没有跨 item 的位置信息;现在的 multi-item 训练每次前向放入 $N$ 个 item,每个仍独立编码(保证可缓存),但拼接后在 decoder 内部彼此可见位置。注意:instruction token 的 embedding 永远不被压缩。
3.2 Compressor、Projector 与 Decoder¶
Compressor。 压缩器 $E$ 是一个带 LoRA、隐藏宽度为 $d$ 的因果语言模型。在 $x_i$ 之后追加 $m$ 个 memory token——它们不属于普通词表,embedding 来自一张单独的表;$x_i$ 的词仍使用 $E$ 的词嵌入。对拼接序列做一次前向,取 $m$ 个 memory 位置的最后一层隐状态:
$$h_i=\mathrm{Enc}_E\big(x_i\oplus[\mathrm{mem}]_{1:m}\big)\in\mathbb{R}^{m\times d} \tag{1}$$
$h_i$ 只依赖 $x_i$。每个 item 单独编码,因此一个 embedding 对应一个可缓存、可追加的 item。这本质上是 ICAE 式的"LoRA encoder + memory slot"结构,差别在于压缩单元从"一段连续文档"换成了"一个行为 item"。
Projector(两轴投影器)。 $h_i$ 仍是 $m$ 个宽度为 $d$ 的向量。投影器沿两个轴压缩:token 轴把数量从 $m$ 降到 $k$(如 $8\to2$),宽度轴把维度从 $d$ 降到 $d'$(如 $2560\to128$)。具体是:一个 Down 网络把每个向量降到 $d'$ 维,一个组合矩阵 $C\in\mathbb{R}^{k\times m}$ 在低维空间里把 $m$ 个向量融合成 $k$ 个,再由 Up 网络映射回宽度 $d$,并加上池化残差:
$$z_i=\mathrm{Up}\big(C\cdot\mathrm{Down}(h_i)\big)+\mathrm{Pool}(h_i) \tag{2}$$
设计动机有两层:先做 token 轴的逐步合并,避免一步把原始文本坍缩成过短的表示;宽度轴降维则直接压存储量。记 $L_i$ 为 $x_i$ 的原始 token 数,则 token 轴压缩比为 $L_i/k$;线上推理缓存的是 $d'$ 维而非 $d$ 维表示,宽度轴压缩比为 $d/d'$。以 $(k,d')=(2,128)$ 为例,每个 item 存 $2\times128$ 个 fp16 数 = 512 B,相对 $(2,2560)$ 的 10 KB 为 20×。Figure 1 右侧给出了 adapter 的具体层序:Linear 2560→128、LayerNorm、GELU、Dropout、Einsum Agg 8→2、Linear 128→2560,旁路为 Pooling + Residual。
读者需要注意的一处细节:公式 (2) 中的 $\mathrm{Pool}(h_i)$ 是 $d$ 维(2560)的,而论文声称线上"只缓存 $d'$ 维的 $z_i$"。如果推理时残差仍在,只存低维部分是无法还原 $z_i$ 的;论文在 co-training 一节提到"降维用残差上的 cosine 调度做退火",最合理的解读是残差在训练后期被退火掉、推理时仅剩低维通路,但原文没有明确写出推理时残差是否为零。消融里宽度轴的"+progressive residual / +differentiated LR annealing"两步也与此一致。
Decoder 与位置编码。 Decoder $D$ 不扩展词表。prompt 中每个被压缩的 item 被替换为其 item embedding,其余文本保持 $D$ 的词嵌入,在拼接序列上做生成。单个 item 内部(含其 memory token)和整条输入都使用一维 RoPE;item 之间的顺序完全由拼接顺序承载——没有显式的时间戳编码,行为时间信息只能来自 item 文本本身或交错的 action/intensity token。
3.3 四阶段训练¶
四个阶段服务于同一目标——压缩表示的事实保真度——并由易到难逐级继承。三个监督阶段共享同样的前向过程(逐 item 独立编码 → 按时间拼接 → 送入 decoder),只在目标函数与可训练集合上不同;三者都在"每个样本的 item 数"上做由短到长的课程。
Table 1:各阶段可训练集合(C/P/D = compressor/projector/decoder)
| Stage | Objective | C | P | D |
|---|---|---|---|---|
| Pre-training | reconstruct | update | — | freeze |
| Post-training | compressed QA | update | update | freeze |
| Co-training | fit both ends | update | update | update |
| Hallu.-aware RL | de-hallucinate | freeze | freeze | update |
- Compressor pre-training(重建)。 $x_i$ 压成 $z_i$ 后由 $D$ 还原。只更新 $E$ 上的 LoRA 与 memory embedding;投影器不启用,$D$ 冻结、只用于计算还原 loss。还原在整条拼接后的压缩序列上进行,decoder 必须从并存的多个 $z_i$ 中逐 item 还原原文。直接在长序列上做还原不收敛,因此在 item 数上用五桶课程:1、1–3、1–200、1–500、1–1200。
- Compressor post-training(压缩 QA)。 接上投影器,与 LoRA、memory embedding 一起训练,$D$ 仍冻结。decoder 需要从每个并存的 $z_i$ 读出所需信息并合并为对整段历史的理解。分 simple(8 类行为理解 + 7 类通用 NLP)与 complex(22 类复杂长序列 + 4 类画像任务)两个子集。
- Co-training(压缩与生成联合训练)。 解冻 $D$,联合更新 $E$ 的 LoRA、memory embedding、投影器与 $D$。动机:post-training 中 $D$ 冻结,$E$ 只能为一个永不改变的 decoder"写作";两端同训让 $D$ 学会读压缩 embedding,同时 $E$ 与投影器把 $z_i$ 调整为 QA 真正需要的形态。降维在残差上用 cosine 调度退火,防止压缩瓶颈在生成 loss 的压力下坍塌。
- Hallucination-aware RL(见 §3.4)。
Table 5:完整四阶段配方与数据统计
| Stage | Objective | C | P | D | 任务构成 | Samples | Tokens |
|---|---|---|---|---|---|---|---|
| Pre-training | restore text | upd. | — | frz. | 行为序列 + 长文本,按 item 数分桶 | 2.13M | 8.06B |
| Post-tr. (simple) | compressed QA | upd. | upd. | frz. | 8 行为理解 + 7 通用 NLP | 150K | 0.80B |
| Post-tr. (complex) | compressed QA | upd. | upd. | frz. | 22 复杂长序列 + 4 画像任务 | 350K | 2.30B |
| Co-training | fit both ends | upd. | upd. | upd. | 与 post-training 同构成 | 350K | 2.30B |
| Hallu.-aware RL | suppress 4 errors | frz. | frz. | upd. | 长序列开放式 QA | 5K | 41M |
3.4 幻觉感知强化学习¶
这一阶段直接在压缩表示之上抑制幻觉:$E$ 与投影器冻结,item embedding 从离线缓存注入,只更新 $D$。对每个 prompt 采样一组答案,由一个生成式奖励模型逐项对照原文评判。奖励由两部分组成:四类错误——fabrication、missed detection、date misattribution、broken logic——各自判定"出现/未出现",按对用户的伤害程度赋予递增权重 $w_c$(编造最重、漏检最轻);完整性从 {complete, partial, missing} 映射为奖励 $b(\cdot)$,防止模型靠少答来躲避惩罚:
$$r(y)=b\big(\mathrm{comp}(y)\big)-\sum_{c=1}^{4}w_c\cdot\mathbb{1}\big[y\ \text{hits error}\ c\big] \tag{3}$$
附录 E 给出权重:fabrication 0.45、date misattribution 0.24、logic/task error 0.24、missed detection 0.07。同组 $G$ 个答案共享一个 prompt,advantage 以组均值归一化。策略用 DAPO 更新:token 级重要性比、非对称 clipping、无 KL 项、截断答案不计入 loss——以缓解 GRPO 的长度坍塌。
评判协议(附录 E):每个答案对照未压缩原文在五个独立维度上评判,前四项二值、第五项三档;judge 被要求对轻微措辞和温和推断宽容,只对实质性错误判"出现"。
- Fabrication:引入原文中不存在的实体、品牌、人物、地点、标题、组织、数字、事件或直接引语,或编造原文未给出的平台/地区标签;
- Missed detection:原文至少有一条相关条目(含同义/近义表述)时却断言"没有/未找到";
- Date misattribution:把事件归到错误日期、误引年/月/日,或编造原文未给出的时段标签;
- Broken logic:日期以外的事实扭曲——数值方向反转、属性张冠李戴、对应关系断裂、自相矛盾、与明确事实冲突,或因果倒置与明显无效推理;
- Completeness:complete / partial / missing,相对于答案实际回应的那部分指令。
3.5 训练数据与课程任务¶
数据两源:(1) 广告行为序列——原始用户广告行为及由这些长序列派生的兴趣总结序列;(2) 通用数据——中文长文本语料 MNBVC(新闻、小说、教材、法律与医学文档)用于巩固通用重建能力,外加实体识别、意图识别、续写、QA 等通用 NLP 与 RAG 数据。经专门 judge 去重去低质后,统一为"压缩–还原"和"压缩–理解"两种格式,按难度混合、分阶段注入。重建样本把样本中每个 item(或 chunk)都压缩,再按时间顺序逐个还原,按 item 数分桶(1、1–3、1–200、1–500、1–1200)。
最终训练集覆盖 42 类任务:1 类序列 item/段落重建、8 类简单行为序列理解、7 类通用 NLP 理解、22 类复杂长序列行为理解、4 类下游用户理解任务。
理解样本的构造(附录 A):先由大指令模型检索相似 item 辅助写 prompt;正式样本两步生成——统计词频、抽取名词主语以锁定必须保留的关键信息,再据此生成规范化的问答对。简单理解包括实体识别、按下标/奇偶/连续区间复述 item、计数、最长兴趣连续段抽取;复杂理解包括用户画像与兴趣挖掘、item 相似度、主题覆盖与兴趣分组、行为原因解释、跨来源协同、时序行为分析。附录 F 列出课程任务族,例如 Needle in a haystack(给定某 item 找出所有相关 item;给定类型找出该类型所有 item;对全部 item 做实体识别;总结全部 item;取奇数/偶数位 item;取第 $j$ 到 $k$ 位;取若干随机指定位置)与 Interest distribution and diversity(序列中下标越小越近期,挖掘每个主兴趣类目下的子类兴趣,输出 JSON:以主类目为键的 subcategory_interests 字典,值为带 keyword、count 与支撑证据的子类列表,外加简短 reasoning 字段)。
四、实验设置¶
- 模型:LLM encoder + LLM decoder 架构;compressor 与下游 decoder 都基于 Qwen3-4B;与外部压缩基线对比时换成 Llama-3.2-1B 以匹配对照组;设计已扩展到多模态骨干 Qwen3-VL-4B-Instruct(ViT encoder 冻结)。
- Baseline 三组:(1) 线上基线:对每个下游任务分别用 SFT + DPO 训练的未压缩 LLM;(2) 通用行为压缩器:ICAE、LLMLingua-2、500xCompressor、EPL、SAC;(3) 推荐组:RecBench 中以 GLM、Qwen、Llama、Mistral 等为骨干的 LLM 推荐器。
- 评测:离线报告下游任务的 precision/recall/F1 或 accuracy,以及 loss 与 QPM;线上报告 GMV 与 QPM 增益。内部验证集从自有数据切分,聚焦四个下游任务。公开数据:MRQA 六个 in-domain 子集(SQuAD、NewsQA、TriviaQA、SearchQA、HotpotQA、NaturalQuestions)与六个 out-of-domain 子集(BioASQ、DROP、DuoRC、RACE、Relation Extraction、TextbookQA);推荐侧用 RecBench 的 MIND、MicroLens、Goodreads、CDs、H&M。
- 优化与服务:学习率约 1e−5 至 1e−4,3–5 个 epoch;RL 用 DAPO;服务在 vLLM 上,embedding server 用信号量限并发以保持显存稳定。LoRA rank 128、scaling factor 2(§4.3 对齐协议中给出)。
五、主要实验结果¶
5.1 生产画像任务(Table 2)¶
KuaFu 部署在腾讯广告与推荐平台的画像生产流水线上,每周挖掘十亿用户的原始行为序列,输出直接写入推荐特征的结构化标签。标签分两个业务族:兴趣总结(内容兴趣、电商兴趣,从数百到数千个跨模态行为归纳可验证兴趣点;序列更长,压缩比设为 10×)和用户画像(职业/行业、人生阶段,从相对较短的行为判定稳定属性;压缩比 15×)。两族共享同一套 item 级压缩表示,仅下游 head 与指标不同。
Table 2:生产中的下游用户理解任务(Δ 为 KuaFu 相对单任务线上模型的百分点变化)
| Task | Family | items(均值/尾部) | ratio | online | KuaFu | Δ |
|---|---|---|---|---|---|---|
| Content interest | summary | 400/1200 | 10× | 85.9 | 86.5 | +0.6 |
| E-com. interest | summary | 150/200 | 10× | 95.7 | 96.1 | +0.4 |
| Industry | profile | 30/100 | 15× | 81.0 | 82.1 | +1.1 |
| Occupation | profile | 30/100 | 15× | 86.7 | 87.6 | +0.9 |
| Life stage | profile | 16/100 | 15× | 76.0 | 78.0 | +2.0 |
兴趣总结报 F1,职业/行业报行业/职业准确率,人生阶段报 exact-match 准确率。五个头部指标上压缩版 KuaFu 均不差于线上模型,人生阶段增益最大(+2.0)。作者的解释是:除了把十亿用户的周全量刷新塞进 QPM 预算,压缩在一定程度上也"提纯"了长序列——弱相关、重复、噪声行为被压掉,稳定的兴趣与属性信号更突出。
分析:这张表的对照是"单任务、未压缩、SFT+DPO 的线上模型" vs "多任务、压缩的 KuaFu"。两者同时差了多任务训练与压缩两个变量(KuaFu 还吃了 42 类任务、数十亿 token 的额外训练),所以 +0.4~+2.0 的小幅正向更准确的读法是"压缩没有造成损失",而非"压缩带来了提升"。论文没有给出"多任务 + 未压缩"的对照,"压缩提纯了序列"这一解释缺乏直接证据;表中也没有置信区间或样本量。
5.2 内部基准 vs 外部压缩器(Table 3)¶
在 KuaFu 训练数据覆盖的四个下游任务验证集上测试通用压缩器在工业数据上的表现。四个 soft 压缩基线不是现成权重或零样本调用,而是在与 KuaFu 对齐的条件下重训:相同用户行为序列、相同 train/val 切分(验证集不进入任何基线的训练或模型选择)、相同四任务监督、相同输入重组、共同的 Llama-3.2-1B 骨干、共同的 15× 压缩比;每个基线按其原论文的目标与流程训练至收敛,其 compressor 共享 KuaFu 的 LoRA 参数化(rank 128、scaling 2),目标 LM 保持冻结。LLMLingua-2 是免训练的 hard compression,以官方权重零样本、5× 调用,与 soft 设定不对齐,仅作外部参考。所有分数由 LLM judge 给出。
Table 3:内部基准(百分制)
| Method | E-com. | Occup. | Content | Life | Overall | Δ |
|---|---|---|---|---|---|---|
| LLMLingua-2† | 49.7 | 31.1 | 22.9 | 22.7 | 31.6 | −31.4 |
| ICAE | 50.5 | 43.1 | 30.9 | 21.7 | 36.6 | −26.4 |
| SAC | 48.3 | 50.7 | 34.3 | 23.7 | 39.2 | −23.8 |
| 500xCompressor | 55.7 | 46.1 | 32.0 | 23.9 | 39.4 | −23.6 |
| EPL | 53.9 | 56.3 | 34.7 | 24.5 | 42.4 | −20.6 |
| KuaFu | 71.7 | 64.5 | 64.7 | 51.1 | 63.0 | — |
KuaFu 以 63.0 明显领先,相对各任务最强基线的领先分别为 16.0、8.2、30.0、26.6 分;没有任何基线在任一任务上超过 60,而 KuaFu 最弱的任务(人生阶段 51.1)仍高于最佳基线的总体均值(42.4)。作者认为在训练数据、切分、监督、输入重组、骨干、可训练范围、参数化与压缩比全部对齐后,领先可归因于压缩结构本身——以行为 item 为压缩单元、把每个 item 映射为一组 embedding,而不是把整段序列挤成少数 token 或在 token 粒度上筛选。四个任务的难度顺序一致:人生阶段对所有方法都最低。
分析:领先幅度(平均 20.6 分)远大于任何合理噪声,结构性优势可信。但有两点需保留:(1) 协议写明基线的"目标 LM 保持冻结",而 KuaFu 的配方包含解冻 decoder 的 co-training——若 Table 3 中 KuaFu 用的是完整配方,那么"可训练范围对齐"的说法并不成立,领先中有一部分来自 decoder 被训练来读压缩 embedding;原文没有澄清。(2) 同一批任务在 Table 2(人生阶段 78.0)、Table 3(51.1)和 Table 4(decoder 消融里 0.81)上的数值口径差异很大(骨干不同、打分方式不同:准确率 vs LLM judge),论文没有把三者对齐说明。
5.3 通用压缩:MRQA in-domain 与 out-of-domain(Figure 3 / Table 6)¶
为测试通用压缩能力,按 SAC 原配方在 SAC 训练数据上重训 KuaFu;所有基线数值直接取自 SAC 论文。In-domain 用六个 MRQA 子集的官方测试集;out-of-domain 测零样本迁移,使用完全相同的 checkpoint、无领域适配。
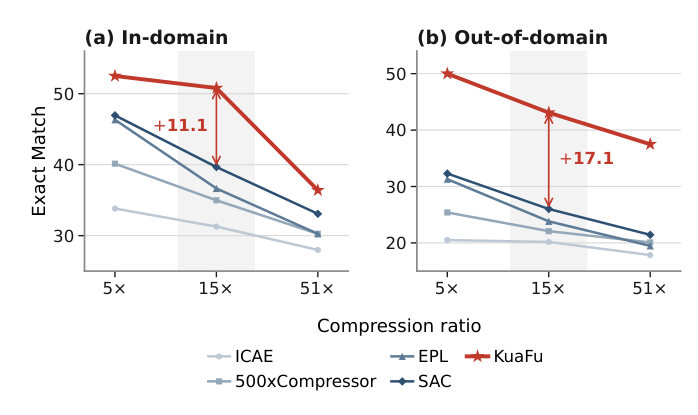
Table 6:MRQA 完整结果,EM / ROUGE-1 F1(Llama-3.2-1B)
| Method | ID Full | ID 5× | ID 15× | ID 51× | OOD Full | OOD 5× | OOD 15× | OOD 51× |
|---|---|---|---|---|---|---|---|---|
| ICAE | – | 33.82 / 47.53 | 31.28 / 44.5 | 27.99 / 40.39 | – | 20.51 / 31.22 | 20.18 / 30.81 | 17.85 / 27.98 |
| 500xCompressor | – | 40.14 / 55.26 | 34.98 / 49.35 | 30.26 / 43.19 | – | 25.4 / 38.46 | 22.09 / 34.04 | 20.09 / 30.43 |
| EPL | – | 46.33 / 62.9 | 36.65 / 51.52 | 30.26 / 43.22 | – | 31.3 / 46.95 | 23.83 / 36.74 | 19.48 / 30.22 |
| SAC | – | 46.95 / 63.63 | 39.67 / 54.95 | 33.08 / 46.37 | – | 32.3 / 47.72 | 26.02 / 39.26 | 21.44 / 32.24 |
| KuaFu | 70.8 / 79.3 | 52.5 / 66.1 | 50.8 / 61.7 | 36.4 / 45.9 | 64.4 / 73.7 | 50.0 / 60.1 | 43.1 / 54.2 | 37.5 / 48.2 |
KuaFu 在两种设定的每个压缩比上都领先 EM;未压缩时 in-domain 70.8、out-of-domain 64.4。两点解读:15× 下 50.8 的 in-domain EM 已与同骨干 SAC 在 5× 下的水平(46.95)相当甚至更高,即三倍压缩强度下同等可用;out-of-domain 的领先随压缩比增大只轻微收窄,51× 下 KuaFu 仍高于所有基线的 5× 成绩。唯一例外是 51× in-domain 的 ROUGE-1 F1:KuaFu 45.9 略低于 SAC 46.37。摘要中"最高 +17.7 EM"对应 OOD 5×(50.0 vs 32.3)。
分析:(1) 基线数值来自 SAC 论文而非同一次重跑,训练算力、decoder 是否可训练都无法保证对齐;KuaFu 的配方允许解冻 decoder,而 ICAE 等方法的定义就是冻结 decoder。(2) KuaFu 自身从 Full 70.8 掉到 5× 52.5(−18.3 EM),说明即便在它最强的设定下,压缩的信息损失依然可观;但 5× 与 15× 几乎持平(52.5 vs 50.8),表明主要损失发生在"是否压缩"而非"压多少",这与 item 级 memory token 的表达上限相符。
5.4 推荐基准:RecBench 零样本 pairwise CTR(Figure 6)¶
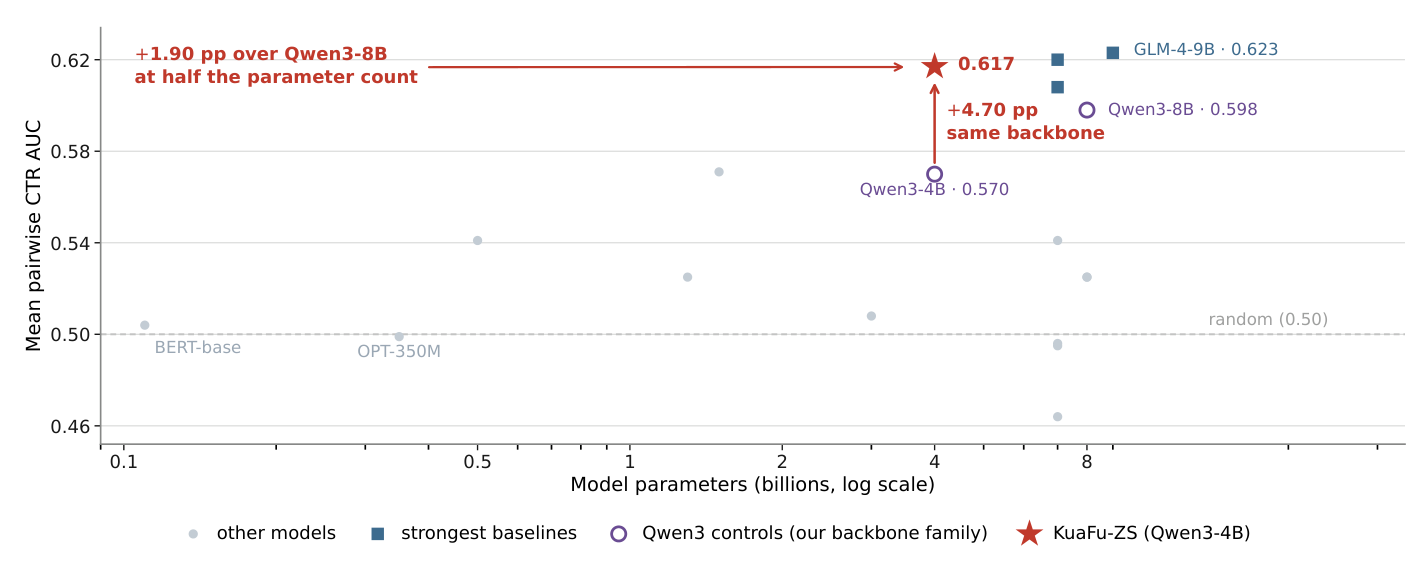
在推荐侧检验记忆压缩是否保留偏好信号:按 RecBench 的零样本 pairwise CTR 设定、在其五个数据集上评测,并只与该基准的零样本区块比较。在没有任何推荐专用训练、且用户行为输入已被压缩为定长记忆表示的情况下,KuaFu-ZS 的五数据集均值为 0.617(未取整 0.6166),仅次于 Mistral-7B(0.6199)和 GLM-4-9B(0.6231),领先其余所有零样本模型。关键的同骨干对照:KuaFu-ZS 比其骨干 Qwen3-4B(0.570,相同权重与协议)高 4.70 pp;由此一个 4B 模型超过其 8B 兄弟 Qwen3-8B(0.598)1.90 pp。
| Model | 参数量 | RecBench 5 数据集均值 AUC |
|---|---|---|
| GLM-4-9B | 9B | 0.6231 |
| Mistral-7B | 7B | 0.6199 |
| KuaFu-ZS (Qwen3-4B) | 4B | 0.6166 |
| Qwen3-8B | 8B | 0.598 |
| Qwen3-4B | 4B | 0.570 |
| GPT-3.5 | API | 0.523 |
| P5-Beauty | — | 0.505 |
另:CDs 子集 KuaFu-ZS 0.489 vs Qwen3-4B 0.510。
分析:作者把 +4.70 pp 归因于"输入侧的压缩记忆表示,而非参数量"。但 KuaFu-ZS 与 Qwen3-4B 之间的差别并不只是"输入被压缩":KuaFu 的 decoder 经历了 42 类行为理解任务、数十亿 token 的 SFT、co-training 与 RL,这些训练本身就是在教模型读用户行为——引入新信号 ≠ 收益来源,增益更可能来自"大量用户行为理解训练",而压缩只是没有把它抹掉。要把功劳归给压缩,需要一个"同样训练但不压缩"的 Qwen3-4B 对照,论文没有给。此外 AUC 0.617 在 pairwise 零样本设定下绝对水平偏低,CDs 上低于随机(0.489)。
六、幻觉感知 RL 的效果(Figure 4)¶
从 co-training checkpoint 出发跑幻觉感知 DAPO,压缩侧冻结、只更新 decoder;训练用的生成式奖励模型对照未压缩原文判定四类错误与完整性。离线评测集为 1000 个长序列开放式 QA 样本,覆盖五个指令族;每个答案由另一个更强的 LLM judge 评判,使训练 judge 与测试 judge 不是同一个模型。
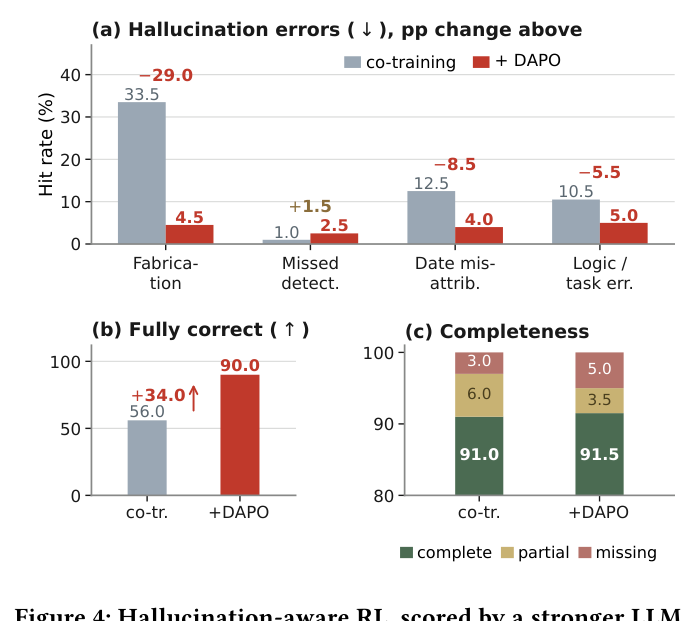
| 指标 | co-training | + DAPO | 变化 |
|---|---|---|---|
| Fabrication 命中率 | 33.5 | 4.5 | −29.0 |
| Missed detection | 1.0 | 2.5 | +1.5 |
| Date misattribution | 12.5 | 4.0 | −8.5 |
| Logic / task error | 10.5 | 5.0 | −5.5 |
| Fully correct | 56.0 | 90.0 | +34.0 |
| Completeness: complete / partial / missing | 91.0 / 6.0 / 3.0 | 91.5 / 3.5 / 5.0 | — |
危害最大的编造下降 29.0 pp,日期与逻辑错误同步下降,完全正确率上升 34.0 pp。漏检与 missing 答案略升(+1.5 / +2.0)——这正是"重罚编造、轻罚遗漏"的加权所要求的;完整性保持住了,模型给出完整回答而不是拒答。
分析:co-training 阶段 33.5% 的编造率本身是一个值得注意的数字——它说明未经 RL 时,压缩表示 + 生成式 decoder 在开放 QA 上相当不可靠,P2 的风险是真实的。RL 的收益显著,且用独立更强的 judge 评估一定程度缓解了 reward hacking 的担忧;但训练与评测 judge 同属 LLM-as-judge 范式,且评测集只有 1000 条,没有置信区间与人工校验。另外 Table 4 显示 DAPO 在封闭式任务上几乎无增益(人生阶段 0.81 → 0.81),RL 的价值集中在开放式生成。
七、消融与分析(Table 4 / Table 7)¶
Table 4:消融汇总
| Group | 对比设置 | 指标 |
|---|---|---|
| Curriculum(compressor) | 混合 1–1200(980K) vs 五个递增桶 | train loss 2.27 vs 0.2, 0.28, 0.16, 0.02, 0.034 |
| Inheritance(compressor SFT) | 不继承 vs 继承预训练 | init/train/val loss 3.2/0.7/4.1 vs 1.2/0.6/0.8 |
| Token axis(projector) | pooling / adapter / adapter + pooled residual | train loss 1.9967 / 1.8026 / 1.4148 |
| Width axis(projector) | naive / +residual / +LR annealing / +continued training | train reward 0.1 / 0.25 / 0.6 / 0.8 |
| Decoder backbone | Base / SFT / DAPO | life stage 0.74 / 0.81 / 0.81;e-commerce 0.806 / 0.823 / 0.826 |
Table 7(a):Compressor 课程细节
| Setting | Items | Samples | Avg. tok. | Total tok. | Loss |
|---|---|---|---|---|---|
| curriculum | 1 | 550K | 133 | 73.15M | 0.2 |
| curriculum | 1–3 | 400K | 267 | 106.8M | 0.28 |
| curriculum | 1–200 | 500K | 5330 | 2.6B | 0.16 |
| curriculum | 1–500 | 600K | 7656 | 4.6B | 0.02 |
| curriculum | 1–1200 | 83K | 8202 | 680M | 0.034 |
| no curriculum | 1–1200 | 980K | 8245 | 8.1B | 2.27 |
逐项分析:
- 课程(最重要的一组)。 不分难度、直接在 1–1200 混合长度上训练,loss 卡在 2.27,即使用最大数据量(980K 样本)也降不下去;五个递增桶则分阶段收敛到 0.2/0.28/0.16/0.02/0.034。两者总 token 相当(8.06B vs 8.1B),差别只在难度组织——难度切分而非数据量是 compressor 收敛的必要条件。这是全文证据最干净的一组消融。
- 继承。 只看训练 loss 会被误导:不继承预训练权重时训练 loss 仍降到 0.7,但验证 loss 异常攀升到 4.1;继承时两者同步下降(0.6 与 0.8)。即重建预训练是 SFT 泛化的前提。
- Token 轴。 纯 pooling 1.9967 → adapter 1.8026 → adapter + pooled residual 1.4148,二者组合最优。
- 宽度轴。 朴素降维 reward 仅 0.1;逐步加入 progressive residual(0.25)、差异化学习率退火(0.6)、继续训练(0.8)后逐级提升——说明 $2560\to128$ 的激进降维必须配合残差退火才能不坍塌。
- Decoder 骨干。 Base → SFT 在人生阶段上 0.74 → 0.81、电商兴趣 0.806 → 0.823;DAPO 再加 0 / +0.003。
分析:投影器两组消融只报训练 loss / 训练 reward,没有下游任务指标,因此无法判断"去掉某组件"的下游代价是否超过 KuaFu 对最强基线的领先(Table 3 中平均 +20.6)。论文也缺少最关键的一组消融:同一多任务 decoder、同样的训练,输入不压缩(或只做 token 轴、不做宽度轴)时的下游指标与吞吐——这正是回答"20× 宽度压缩到底损失了多少"的对照。
Table 7(d):生产存储(2 百亿去重 item 库存,跨用户共享)
| Compression | 20× | 10× | 2.5× | 1× |
|---|---|---|---|---|
| (token, width) | (2, 128) | (2, 256) | (2, 1024) | (2, 2560) |
| per item | 512 B | 1 KB | 4 KB | 10 KB |
| total (TiB) | 9.3 | 18.6 | 74.5 | 186.2 |
宽度 128 让 200 亿 item 的缓存从 186 TiB 降到 9.3 TiB,这是"离线缓存可行"的定量依据。
八、工业落地:线上 A/B 与生产部署¶
8.1 线上 A/B¶
按 unique visitor 随机分流。两组用于画像挖掘的资源保持一致;对照组保留旧的画像特征(一年行为、按月刷新),实验组换成 KuaFu 画像特征(两年行为、按周刷新);推荐模型、训练样本和其他所有特征完全相同,因此两组差异"只反映画像本身"。四周观察窗内流量按 1% → 5% → 20% → 80% → 100% 放量;全量后保留 5% holdout,再观察十个月,整体 GMV 相对 holdout 提升 1.37%(95% CI [0.71%, 2.03%])。
作者的归因:由于两组消耗相同的端到端资源(主要是 GPU 与存储),收益来自压缩释放出的两种余量——可负担的行为时间窗从一年延长到两年,让更长程的兴趣信号进入推荐模型;刷新节奏从月度变为周度,让兴趣漂移更快反映到线上特征。
分析(本文的关键核查点):
- A/B 对照是什么:是"旧画像系统(一年历史、月更)",不是"同样历史长度与刷新频率下的未压缩 KuaFu"。实验组同时改变了历史长度(1 年 → 2 年)、刷新频率(月 → 周)、画像模型本身(旧单任务模型 → 多任务 KuaFu)三个变量。
- GMV 增益能否归因于压缩:不能直接归因。论文自己的归因也是"压缩释放的余量被用来喂更长历史、更勤刷新"——收益的直接来源是更长的历史与更新鲜的特征,这是"引入新信号";压缩是让这件事在固定资源下可负担的使能条件。论文没有拆分"只延长历史""只提高刷新频率"的贡献,也没有"资源放开时的未压缩版本"作上界。换句话说,1.37% 是"KuaFu 画像系统整体替换"的收益,其中多少来自压缩表示本身的质量,A/B 无法回答。
- 证据强度:随机分流、十个月 5% holdout、给出 95% CI,这是比常见"两周 A/B"更扎实的系统级证据;但 GMV 是画像特征经推荐模型间接作用后的结果,KuaFu 并不直接做排序。
8.2 生产部署与吞吐¶
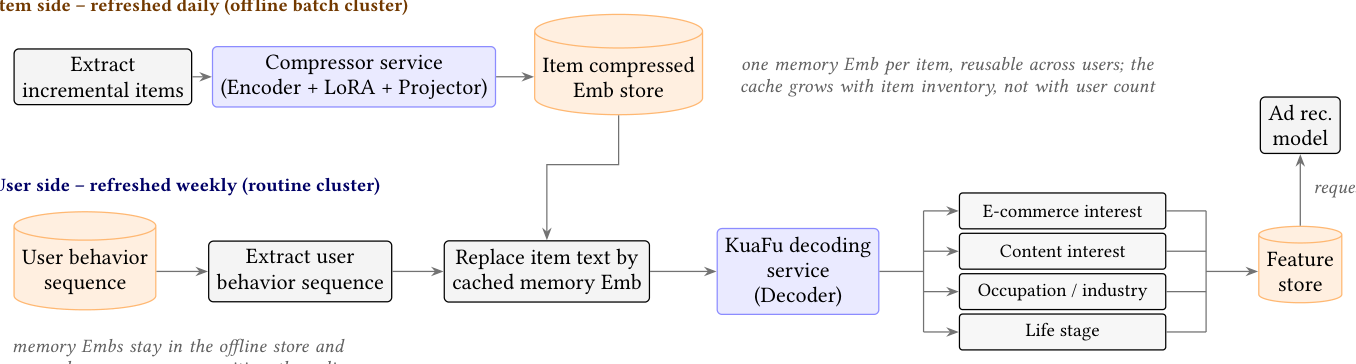
在腾讯广告与推荐平台为十亿用户构建两年行为序列,流水线分两条例行流:
- Item 侧,日更(离线批处理集群):每天抽取增量 item,由 compressor 服务(Encoder + LoRA + Projector)压成 memory embedding,写入 item 表示库;一份 memory embedding 是长期、跨用户复用的缓存,无需按用户重算。
- User 侧,周更(例行集群):把十亿用户序列中的 item 文本替换为缓存的 memory embedding,重组后的序列进入 KuaFu decoding 服务,挖掘内容兴趣、电商兴趣、职业/行业与人生阶段,写入在线特征库供广告推荐模型请求。memory embedding 只留在离线库、只用于序列重组;在线特征库只承载画像结果。
compressor 与 decoder 部署在不同集群:前者是离线批处理、逐 item 可缓存;后者是例行、逐用户的序列理解。负载形态、batch 结构与扩缩节奏都不同,分开部署让二者各自扩缩,也避免 decoder 侧的序列计算挤占 item 压缩吞吐。
吞吐与 GPU 节省:
| 任务 | 单卡 QPM(前 → 后) | 增幅 | GPU 数(前 → 后) | 节省 |
|---|---|---|---|---|
| Life stage profiling | 592 → 810 | +37% | 41 → 30 | 11 |
| E-commerce interest | 250 → 800 | +220% | 90 → 28 | 62 |
| Content interest | 40 → 180 | +350% | 150 → 33 | 117 |
| 合计 | 190 |
分析:(1) "前"指的应是未压缩的单任务线上模型(与 Table 2 同一对照),相对可比;增幅与序列长度正相关(内容兴趣序列最长、增幅最大),符合压缩的预期。(2) 但 190 张卡只统计了 decoder 侧三个任务;每日为 200 亿级 item 库存增量跑 LLM compressor 的集群成本没有从中扣除,职业/行业任务也未列出。(3) 吞吐对比时两侧处理的历史长度是否相同(一年 vs 两年)原文没有说明——若 KuaFu 在处理更长历史的同时仍省卡,结论更强;若对比是在不同历史长度下做的,则单卡 QPM 不完全同口径。
九、经验总结(论文 §5 Lessons Learned)¶
- 课程是收敛的必要条件,不是加速技巧:长序列压缩的收敛瓶颈在长度分布的难度结构,而非数据量。
- 四类幻觉在生产中只表现为下游指标的弥散下滑:线上 A/B 一周、根因定位一个月;分层中间评测把回路缩到一天,这也是能迭代幻觉感知 RL 的前提。
- RL 奖励应按对用户的伤害排序,并显式对抗拒答:编造权重最高(0.45)、漏检最低(0.07),完整性单列奖励;代价是漏检与 missing 答案多 1.5–2.0 点,属预期权衡。
- 表示的可缓存性决定系统经济性:item 级独立编码让缓存按 item 键控,随 item 库存而非 #users × #tasks 增长;十亿用户周全量刷新取决于表示设计而非堆算力。
十、核心贡献总结¶
- 把"用户理解"的压缩单元定为单个行为 item,使压缩结果 $z_i=f(x_i)$ 与用户、任务、历史无关,从而可离线缓存、跨用户复用、增量追加——这是工程上最有价值的设计,所有系统经济性都挂在这条性质上。
- 两轴投影器(token 轴 $m\to k$、宽度轴 $d\to d'$ + 池化残差 + 退火)把单 item 缓存从 10 KB 压到 0.5 KB,让 200 亿 item 的缓存从 186 TiB 降到 9.3 TiB。
- 面向保真的四阶段训练:重建(带五桶长度课程)→ 冻结 decoder 的压缩 QA → 两端联合 → 按危害加权、带完整性奖励的幻觉感知 DAPO;课程与继承两组消融证据干净。
- 分层中间评测:直接对压缩表示在分类、多标签、开放 QA 与迁移上打分,而非只看端到端业务指标。
- 长期生产验证:十亿用户周更、十个月 5% holdout、GMV +1.37%(95% CI [0.71%, 2.03%]),decoder 侧节省 190 张卡。
与已归档相关工作的对比¶
AMBER AMBER: An Event is Worth One Token (Meta, 2026-08-26)¶
关系:独立并发(本文未引用 AMBER,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇都认定工业 LLM 用户建模的瓶颈不在 LLM 容量,而在"逐事件的丰富信息 × 很长的历史"在服务侧不可负担:AMBER 称之为 serving 侧特征物化成本迫使历史退化为 Semantic ID 或手挑特征子集(snapshot resolution 被压低);KuaFu 则是十亿用户周刷新下,把 item 文本序列化进 prompt 的 token 成本撞上单卡吞吐下界。
- 相近的技术骨架:几乎可以画成同一张图——一个逐事件、与历史无关的编码器(AMBER:双向 Transformer + [CLS] 的 Event Tokenizer;KuaFu:LoRA 因果 LM + memory token + 两轴投影器)把每个事件压成 1–2 个连续 token,事件发生时算一次、缓存、追加;下游一个 LLM(AMBER:1B Llama User LLM;KuaFu:Qwen3-4B decoder)读缓存 token 序列。训练也都先冻结 LLM 做对齐、再端到端联合(AMBER:pre-alignment → joint → recurrent;KuaFu:重建/压缩 QA 冻结 D → co-training 解冻 D)。两者都把"history-independent"视为承重性质,而非顺手设计。
- 本文的差异与推进:(1) 输入模态不同:AMBER 压的是数百个结构化异构特征(user/item/context/outcome),KuaFu 压的是 item 文本(商品描述、内容摘要、广告上下文 trunk)。(2) 输出不同:AMBER 以推荐目标(NE)端到端训练,token 直接作为排序/检索的序列特征;KuaFu 以重建与 QA 为目标,输出的是自然语言画像标签,再作为特征进入推荐模型——多了一层"理解"的中间产物,因而必须处理 AMBER 不需要面对的生成幻觉问题(四类幻觉 + 幻觉感知 RL)。(3) KuaFu 的缓存键是 item(跨用户共享,随库存增长),AMBER 的 Event Token 按用户事件缓存(含用户与上下文特征,不能跨用户共享)——KuaFu 的共享度更高,代价是 item 表示中不含该用户的行为上下文,只能靠交错的 action/intensity token 补回。
- 可比的方法 / 实验差异:AMBER 用事件时间戳做 RoPE,KuaFu 只用拼接顺序承载 item 间顺序;AMBER 做了 Tokenizer vs User LLM 的 scaling 与 FLOPs 核算,KuaFu 明确承认 scaling 未系统验证。AMBER 的部署收益是 NE −0.06%(作为历史特征喂给现网模型),KuaFu 是 GMV +1.37%(但对照同时改变了历史长度与刷新频率);两者都属于"新表示层作为上游特征"的间接收益。
RecGPT-V2 RecGPT-V2 Technical Report (Alibaba, 2025-12-16)¶
关系:独立并发(本文未引用 RecGPT-V2)· 已加载对方精读
- 共同关注的问题:两者都面对"LLM 需要读用户完整行为历史做意图/兴趣推理,但把历史当全文自然语言喂进去时 context 过长、prefill 成本爆炸"的问题。RecGPT-V2 的出发点是 V1 用全文编码用户行为导致 GPU 成本过高;KuaFu 的出发点是十亿用户周更的 QPM 预算。
- 相近的技术骨架:RecGPT-V2 的 Atomized Entity Compression 用一个冻结 LLM + 可训练 adaptor 把 item 标题等实体压成紧凑表示,再喂给推理 LLM,上下文从约 32K token 压到 11K(≈7×),MFU 11.56% → 17.04%、GPU −60%。KuaFu 同样是"以 item 为单元的 LLM 编码 + adaptor 投影 → 推理 LLM 读压缩 token"。
- 本文的差异与推进:(1) KuaFu 显式加入宽度轴压缩(2560 → 128)并以离线缓存体积为核心设计目标,RecGPT-V2 的精读中未见宽度轴压缩与缓存存储核算;(2) KuaFu 对 compressor 做 LoRA 训练、并有完整的重建课程与 co-training,RecGPT-V2 冻结编码 LLM 只训 adaptor;(3) KuaFu 把"压缩诱发幻觉"作为一等问题,给出四类错误分类、按危害加权的 RL 奖励与独立 judge 评测,这是 RecGPT-V2 的实体压缩所没有专门处理的;(4) RecGPT-V2 的压缩服务于在线意图推理与推荐生成,KuaFu 服务于离线周更的画像挖掘。
- 可比的方法 / 实验差异:压缩比口径不同——RecGPT-V2 报整体上下文 ≈7×(中文标题上可达 12:1),KuaFu 报 token 轴 10×/15×(按任务族)与宽度轴 20×;两者都报告了显著的 GPU 节省(RecGPT-V2 −60%,KuaFu decoder 侧 190 卡、单卡吞吐 +37%~+350%),但都没有把压缩器自身的算力成本从节省中扣除的完整核算。
十一、讨论与局限性¶
11.1 值得借鉴的设计¶
- "压缩单元 = item"这一决定的系统经济学推理是全文最有迁移价值的部分:只要 $z_i=f(x_i)$,缓存就按 item 键控、跨用户共享、随库存增长,新行为只需追加。这把 LLM 用户理解从"每个用户每次重读全文"变成"item 侧日更批处理 + 用户侧周更解码"两条独立扩缩的流水线。
- 宽度轴压缩服务于存储而非计算:token 轴压缩降低 decoder 的序列长度(计算),宽度轴压缩降低缓存体积(存储),两者对应不同的系统瓶颈,这个区分很清楚。
- 长度课程是收敛的必要条件:同等 token 预算下 loss 2.27 vs 0.02~0.28,对任何"多 item 联合重建"类训练都是可复用的经验。
- 按危害加权的幻觉奖励 + 完整性奖励防拒答,以及训练 judge 与评测 judge 分离,是生成式画像场景下可直接借用的 RL 设计。
11.2 局限与争议¶
- 线上收益与压缩本身的归因不清。A/B 对照是旧画像(1 年、月更),实验组是 KuaFu(2 年、周更)+ 新模型。GMV +1.37% 是整个画像系统替换的收益;按"引入新信号 ≠ 收益来源",直接收益来源是更长的历史和更新鲜的特征,压缩是让其在同等资源下可负担的使能条件,论文没有拆分各变量贡献。
- "压缩 ≥ 未压缩"的离线证据混入了多任务训练。Table 2 的 +0.4~+2.0 对比的是单任务未压缩 vs 多任务压缩,缺少"多任务未压缩"对照;RecBench 的 +4.70 pp 同骨干增益同样混入了大量行为理解训练,不能归因于"压缩表示"。
- 与外部压缩器的对齐不完全。Table 3 协议写明基线的目标 LM 冻结,而 KuaFu 配方包含解冻 decoder 的 co-training;MRQA 的基线数值直接取自 SAC 论文。领先幅度(Table 3 平均 +20.6、MRQA 15× OOD +17)很大,结构性优势大概率成立,但"全部对齐"的表述偏强。
- 消融多停在训练 loss / reward。投影器 token 轴与宽度轴的消融没有下游指标,无法与对最强基线的领先幅度直接比较;也没有"只做 token 轴不做宽度轴"的下游对照来量化 20× 宽度压缩的代价。
- GPU 节省的口径。190 卡只算 decoder 侧三个任务,未扣除日更 compressor 集群(LLM 编码 200 亿级库存增量)的成本;前后是否在相同历史长度下比较也未说明。
- 评测高度依赖 LLM judge。Table 3、幻觉评测均由 LLM judge 打分;同一任务在 Table 2/3/4 中的数值口径差异大且未对齐说明。
- 方法论可扩展性。这是典型的"先离线压缩、再在线理解"两阶段范式:compressor 在 RL 阶段被冻结、缓存一旦写入即固化,下游 decoder 能看到的信息上限由 2 个 128 维 token 决定;论文自己承认 scaling 未验证、过长 item 在低宽度下会丢细节、压缩比按任务族固定。公式 (2) 中 $d$ 维池化残差与"只缓存 $d'$ 维"之间的关系也没有交代清楚。
- 作用层级。KuaFu 作用在 LLM 用户画像层,产出的是写入特征库的结构化标签,推荐排序模型本身未变;它对推荐效果的影响是间接的。同时,腾讯署名与十个月部署证明的是"这套画像系统在生产中跑通且整体正向"——工业署名 ≠ 工业证据,对"item 级压缩表示优于未压缩表示"这一具体方法主张,生产数据并没有提供干净的对照。
11.3 与已有工作的差异¶
相对 ICAE/500xCompressor/SAC/EPL 等通用 soft compression,KuaFu 的新意不在压缩算子本身(仍是 memory token + LoRA encoder 的 ICAE 谱系),而在于把压缩单元从连续文档改为带时间顺序的行为 item,并围绕可缓存性、存储体积、长度课程和幻觉控制构建了完整的工业系统。相对排序模型内的长序列方案(SIM/TWIN/LONGER/VISTA 类),它处在 LLM 输入侧、以可解释画像为产物;相对 Meta AMBER,它压文本而非结构化特征、输出画像而非直接作为排序序列特征,并以 item 为键实现跨用户共享。