IntBMoE: Integrating Block-Level Conditioning into Expert Composition for Full-Participation Mixture-of-Experts¶
DreamX, Alibaba Group。arXiv:2609.21346v1 [cs.LG],2026-09-18。作者 Ran Cheng*、Longfei Xu*†、Zheng Liu*、Kaikui Liu、Xiangxiang Chu(* 共同一作,† 项目负责人)。代码:https://github.com/AMAP-ML/DreamX-Rec/ (链接可访问)。与同组的 IntTravel(arXiv 2602.11664)、IntHQ(arXiv 2608.09634)同属高德 DreamX 的 "Int" 系列。
研究动机与背景¶
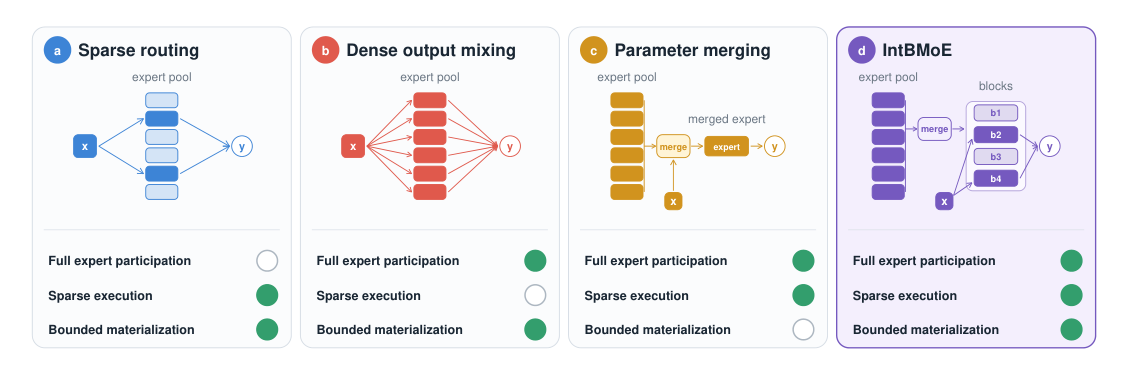
论文开篇没有从"MoE 怎么更强"切入,而是先做了一次概念拆解:对单个 token 而言,MoE 里有三个此前被混为一谈的量。
- 参与度(participation):有多少个专家的知识真正进入了这个 token 的输出;
- 执行量(execution):其中有多少个专家被实际计算了,对应算力成本;
- 物化量(materialization):运行时必须构造并存放多少份"专家大小"的参数集合(每个不同的路由决策一份),对应显存成本。
作者主张这三者原则上互相独立,但现有三类 MoE 设计都把它们耦合在了一起,于是各自付出一种代价:
- 稀疏路由限制参与度。Switch Transformer / GShard / DeepSeekMoE 这类方法为每个 token 只激活 $k$ 个专家,执行量被压住了,但没被选中的专家既不影响该 token 的输出,也拿不到来自它的学习信号——参与度被路由决策直接砍掉。
- 全参与要求稠密执行。MMoE / PLE 这类 dense output-mixing 把所有专家输出加权求和,参与度满了,但每个专家都要跑一遍,执行量随专家数线性增长。
- 单专家执行抬高物化量。SMEAR / Lory 这类 parameter-merging 先把整池专家参数融合成一个复合专家再执行一次,执行量是 1,但每个不同的路由单元都要有自己的一份融合权重,运行时构造的"专家大小参数集"数量随路由单元数增长。
由此逼出全文的中心问题:
能否让每个 token 都受益于完整的专家池,同时既不做稠密执行,也不让参数物化量无界增长?
论文的诊断是:现有 MoE 公式化方式把"专家变换的构造"与"它在 token 上的执行"捆死了。IntBMoE 的解法就是把这两个阶段拆开——先由完整专家池构造出一小撮可复用的变换(block),再让每个 token 独立地挑其中几个来执行。构造阶段吃满整池(参与度满),执行阶段只跑 Top-$k$ 个 block(执行稀疏),而 block 的数量由一个学习到的码本而非输入决定(物化有界)。
论文自述的三点贡献:
- 解耦参与度 / 执行量 / 物化量:一个 $K$ 条目的学习码本定义了模块可用的 block,一个共享超网络逐层把该层的专家基融合成一个复合专家;路由器只把 token 送到少数几个 block。
- 更有表达力的专家组合:Dual-Path Residual Gating(DPRG)把每个 block 的专家基融合两次,得到 value 路径与 gate 路径,两者相乘使结果对专家基是非线性的——在不扩大专家池的前提下增加表达力。
- 视觉主实验 + 跨域泛化 + 工业落地:ImageNet-1K 上对比稀疏与稠密 MoE baseline;MiniPile(语言建模)与 IntTravel(序列推荐)验证跨模态;并在高德生成式推荐系统全量部署,60 ms 时延预算下线上 A/B 相对 UVCTR +2.4%。
预备知识:三类 MoE 的形式化¶
设 $x_t \in \mathbb{R}^d$ 为输入元素 $t$ 的表示,$f_e(\cdot;\theta_e)$ 为参数 $\theta_e$ 的专家 $e$。
稀疏 MoE维护 $E$ 个专家,用路由器选其中 $k$ 个:
$$r_t = g_{\text{router}}(x_t),\quad p_t = \mathrm{softmax}(r_t),\quad y^{\text{sparse}}_t = \sum_{e \in \mathrm{TopK}(r_t,k)} p_{t,e} f_e(x_t;\theta_e). \tag{1}$$
其中 $g_{\text{router}}:\mathbb{R}^d \to \mathbb{R}^E$,$\mathrm{TopK}(r_t,k)$ 返回得分最高的 $k$ 个专家下标。每个 token 只评估 $k$ 个专家网络。
稠密输出混合则聚合全部专家输出:
$$y^{\text{dense}}_t = \sum_{e=1}^{E} p_{t,e} f_e(x_t;\theta_e). \tag{2}$$
全部 $E$ 个专家都能影响该 token,但每个专家都必须执行。基于 slot 的变体(Soft MoE)只是把专家计算的单位从单个 token 换成了学习到的 token 混合,仍然要处理全部与专家绑定的 slot。
参数融合则用另一条路拿到全参与。设 $u$ 为路由单元(可以是 token、segment 或整条序列),$a_{u,e}$ 为分配给专家 $e$ 的系数:
$$\bar{\theta}_u = \sum_{e=1}^{E} a_{u,e}\theta_e,\quad y^{\text{merge}}_t = f(x_t;\bar{\theta}_u). \tag{3}$$
token 只被一个复合专家处理,但每个路由单元都要有自己的一份专家大小参数集。若某层有 $G$ 个不同的路由单元,参数合成开销为 $O(GE|\theta|)$,$|\theta|$ 为单个专家的规模。论文把"运行时构造这些派生参数集"这件事称为 materialization。
核心方法 / 模型架构¶
架构总览¶
IntBMoE 通过替换 Transformer 的 FFN 子层接入骨干。每个 IntBMoE 模块从共享专家池中合成出可复用的多层 block,再把每个 token 稀疏地路由到其中几个 block。
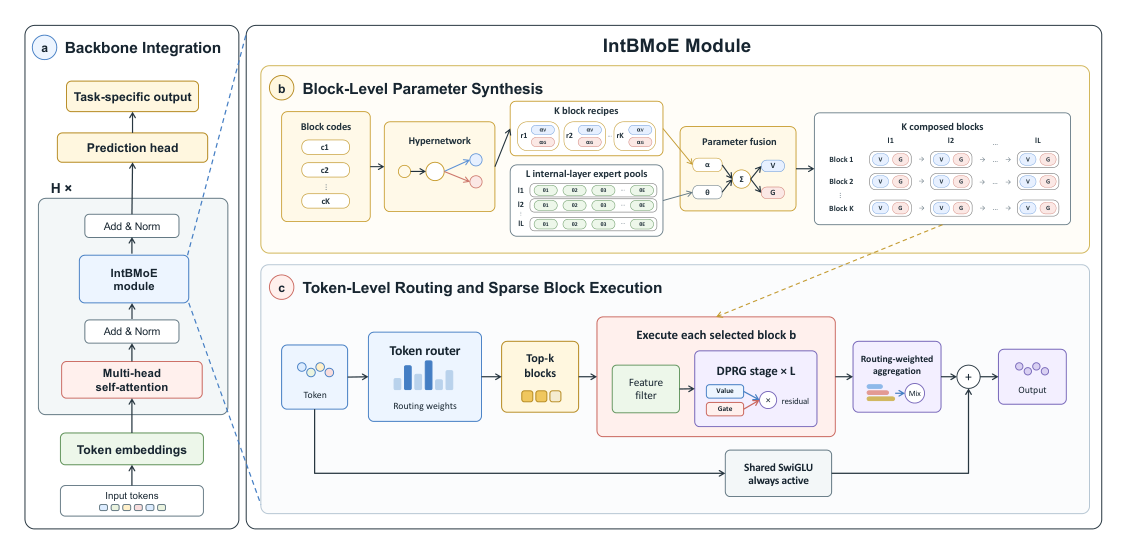
- Block 层面:$K$ 个学习到的码本嵌入产生组合系数,这些系数把逐层的专家池融合成 $K$ 个与 token 无关的 $L$ 层 block。
- Token 层面:路由器为每个 token 独立选 Top-$k$ 个 block。每个被选中的 block 先做 block-conditioned 特征过滤,再让 token 顺序穿过它的 $L$ 个复合专家。
- 输出:被选中 block 的输出按路由概率加权,再加上一个始终激活的共享 SwiGLU 专家的输出。
Block 级参数合成¶
每个 IntBMoE 模块维护一个 $K$ 条学习嵌入的码本:
$$\mathcal{C} = \{c_b \in \mathbb{R}^{d_c}\}_{b=1}^{K}. \tag{4}$$
每个 $c_b$ 标识一个 $L$ 层 block,并用于合成它的参数。码本因此定义了路由器可选的 $K$ 个 block。
论文全程使用列向量,线性映射为左乘。令 $d_0 = d_L = d$,$d_\ell$ 为内部层 $\ell$ 的输出维度。对每个 $\ell \in \{1,\dots,L\}$,模块维护一个被 $K$ 个 block 共享的层内专家基池:
$$\mathcal{P}^{(\ell)} = \{(W^{(\ell)}_e, b^{(\ell)}_e)\}_{e=1}^{E},\quad W^{(\ell)}_e \in \mathbb{R}^{d_\ell \times d_{\ell-1}},\ b^{(\ell)}_e \in \mathbb{R}^{d_\ell}. \tag{5}$$
这些"路由专家基"与后文的常驻共享专家是两回事;各内部层之间、各骨干层之间的池互相独立。
block 超网络 $h_\phi$ 在同一个 IntBMoE 模块内被 $K$ 个码本条目共享。它只吃学习到的 block 嵌入 $c_b$,结构是 linear–LayerNorm–ReLU 主干加两个线性输出头:
$$q_b = \mathrm{ReLU}\left(\mathrm{LN}(A c_b + a)\right), \tag{6}$$
其中 $A \in \mathbb{R}^{d_h \times d_c}$、$a \in \mathbb{R}^{d_h}$ 为可训练的输入投影权重与偏置,$q_b \in \mathbb{R}^{d_h}$。两个输出头分别给出 value 与 gate 的组合系数:
$$\alpha^v_b = A^v q_b + a^v,\quad \alpha^g_b = A^g q_b + a^g,\quad \alpha^v_b, \alpha^g_b \in \mathbb{R}^{E}, \tag{7}$$
$A^v, A^g \in \mathbb{R}^{E \times d_h}$,$a^v, a^g \in \mathbb{R}^{E}$。
关键设计:这些系数不做 softmax 也不做 sigmoid 归一化。它们可以为负、也不必和为 1,从而允许在专家基的线性张成空间上组合,而不是被限制在它们的凸包里。为了让复合参数的尺度在专家池变大时保持近似稳定,论文改用一个保方差因子 $1/\sqrt{E}$。对路径 $p \in \{v,g\}$,每个内部层的复合参数为:
$$W^{(\ell)}_{b,p} = \frac{1}{\sqrt{E}}\sum_{e=1}^{E}\alpha^p_{b,e} W^{(\ell)}_e,\quad b^{(\ell)}_{b,p} = \frac{1}{\sqrt{E}}\sum_{e=1}^{E}\alpha^p_{b,e} b^{(\ell)}_e. \tag{8}$$
于是超网络为 block $b$ 产出一份 recipe $(\alpha^v_b, \alpha^g_b)$;在每个内部层,这份 recipe 把该层的专家池融合成独立的 value / gate 参数集;对 $L$ 个内部层重复即得到完整的 $L$ 层 block。因为 $h_\phi$ 不依赖 token 表示,$K$ 个复合 block 可以预先算好并被所有 token 共享——这是整篇文章的效率支点。
Token 级 block 路由¶
路由对每个 token 独立进行:
$$r_t = g_{\text{block-router}}(x_t),\quad \mathcal{B}_t = \mathrm{TopK}(r_t, k), \tag{9}$$
$\mathcal{B}_t$ 是为 token $t$ 选中的 $k$ 个 block 的下标集合,$g_{\text{block-router}}:\mathbb{R}^d \to \mathbb{R}^K$ 默认实现为两层 ReLU MLP。选中 block $b$ 的路由权重为:
$$\pi_{t,b} = \mathrm{softmax}(r_t)_b,\quad b \in \mathcal{B}_t. \tag{10}$$
Block 条件化特征过滤¶
进入选中的 block 之前,token 表示先被该 block 的码本嵌入 $c_b$ 过滤一遍:
$$m_{t,b} = \mathrm{sigmoid}\left(W_f [x_t \,\|\, c_b] + b_f\right),\quad z^{(0)}_{t,b} = x_t \odot m_{t,b}. \tag{11}$$
$[\cdot\,\|\,\cdot]$ 是列向量的纵向拼接,$W_f \in \mathbb{R}^{d\times(d+d_c)}$、$b_f \in \mathbb{R}^d$ 是跨 block 共享的特征过滤层参数,$m_{t,b} \in (0,1)^d$ 是软的逐维掩码。这样不同 block 在施加各自的复合变换之前,就已经拿到了同一个 token 的不同视角。
Dual-Path Residual Gating(DPRG)¶
式 (8) 里每条参数路径对专家基都是线性组合,DPRG 的作用是在两条独立组合出来的路径之间引入非线性交互——用残差式乘性调制把 value 与 gate 路径耦合起来。对内部层 $\ell$ 和输入 $z^{(\ell-1)}_{t,b}$:
$$v^{(\ell)}_{t,b} = W^{(\ell)}_{b,v} z^{(\ell-1)}_{t,b} + b^{(\ell)}_{b,v}, \tag{12}$$
$$g^{(\ell)}_{t,b} = \mathrm{RMSNorm}\left(W^{(\ell)}_{b,g} z^{(\ell-1)}_{t,b} + b^{(\ell)}_{b,g}\right), \tag{13}$$
$$\tilde{z}^{(\ell)}_{t,b} = v^{(\ell)}_{t,b} \odot \left(1 + \lambda\,\mathrm{SiLU}(g^{(\ell)}_{t,b})\right). \tag{14}$$
连续内部层之间施加 LayerNorm:
$$z^{(\ell)}_{t,b} = \begin{cases} \mathrm{LN}(\tilde{z}^{(\ell)}_{t,b}), & \ell < L,\\ \tilde{z}^{(\ell)}_{t,b}, & \ell = L. \end{cases} \tag{15}$$
$F_b(x_t) = z^{(L)}_{t,b}$ 是 block $b$ 的最终输出。可学习的残差尺度 $\lambda$ 在一个 IntBMoE 模块的各内部层之间共享。DPRG 用同一个专家池的两份组合相乘,提升了每个复合 block 的表达力,而参数合成与执行成本只多一个常数因子。
物理含义上,式 (14) 的 $1 + \lambda\,\mathrm{SiLU}(g)$ 是一个以 1 为中心的残差门:$\lambda=0$ 时 block 退化成纯线性组合专家,$\lambda$ 增大则 gate 路径逐渐接管,使得 block 的有效变换是两个线性组合的双线性/乘性函数——这正是"线性张成空间"的组合方式能拿到非线性表达力的原因。
输出聚合与共享专家¶
被选中 block 的输出按路由概率聚合:
$$y^{\text{route}}_t = \sum_{b \in \mathcal{B}_t} \pi_{t,b} F_b(x_t). \tag{16}$$
再加一个始终激活的共享 SwiGLU 专家 $S$,用来承载不需要靠路由区分的公共成分:
$$y_t = y^{\text{route}}_t + S(x_t). \tag{17}$$
共享路径吃掉公共信息,让被路由的 block 专注于那些真正受益于 token 依赖选择的变换。
复杂度与推理缓存¶
设一个 IntBMoE 模块处理 $T$ 个有效 token,每个 block 含 $L$ 层、层 $\ell$ 把 $d_{\ell-1}$ 映到 $d_\ell$,定义 $D = \sum_{\ell=1}^{L} d_{\ell-1}d_\ell$ 为单个多层专家基的总矩阵规模。
- 从 $E$ 个基合成全部 $K$ 个 block:$O(KED)$;
- 为全部 token 执行各自选中的 $k$ 个 block:$O(TkD)$;
- 忽略低阶的路由操作与 DPRG 两路径的常数因子,未缓存时总代价 $O(KED + TkD)$,摊到每 token 为 $O(KED/T + kD)$。
合成项仍然线性于 $E$,但它是为 $K$ 个可复用 block 付一次,而不是每个 token 付一次——这就是与 SMEAR/Lory 的本质区别。
更进一步:block 合成只依赖学习到的 block 嵌入、超网络和专家基。推理时模型参数固定后,所有复合 block 参数可以一次性构造并缓存,把 $O(KED)$ 从请求时计算里彻底摘掉,剩下的主导项只有 $O(TkD)$ 加上路由器、特征过滤器与共享专家。于是在 $K$、$k$ 固定时,缓存版 IntBMoE 的请求时计算量不随专家池规模 $E$ 增长。训练时同一个 minibatch 内所有样本共享同一套复合 block,合成每个 batch 只做一次,成本被摊薄。
实验设置¶
全部实验跑在 8 张 Alibaba T-Head PPU(每张 96 GB) 上。同一数据集内,所有方法共享骨干、输入处理、任务头、优化调度、种子集合与专家初始化,只有 FFN / MoE 模块不同。每个配置跑 3 个随机种子取均值(ImageNet: 214797/531770/635451;MiniPile: 1/145306/145849;IntTravel: 42/4981213/211231244)。
| 数据集 | $H$ | $d$ | $n_{\text{heads}}\times d_{\text{head}}$ | $d_r$ | $E$ | BS | Input | $\lambda_0$ | Training |
|---|---|---|---|---|---|---|---|---|---|
| ImageNet-1K | 8 | 192 | 3×64 | 64 | 16 | 256 | $224^2$ ($p=16$) | 1 | 200 epochs |
| MiniPile | 18 | 768 | 12×64 | 64 | 8 | 8 | 1024 | 1 | 1 epoch |
| IntTravel | 8 | 96 | 1×96 | 64 | 32 | 64 | 126 | 0 | 610K steps |
ImageNet-1K:128 万训练图 / 5 万验证图 / 1000 类,DeiT-Tiny 风格骨干截到 8 层,MoE 只替换偶数层(0/2/4/6)的 FFN 且只作用于 patch token,class token 走独立的稠密 FFN。AdamW $(\beta_1,\beta_2)=(0.9,0.999)$、weight decay 0.05;学习率 5 epoch 内从 $10^{-6}$ 热身到 $5\times10^{-4}$,余弦衰减到 $10^{-5}$。关闭各类 dropout,stochastic depth 最大 DropPath 0.1;增广为 $224\times224$ bicubic RandomResizedCrop(scale [0.08,1.0]、ratio [0.75,1.33])、随机水平翻转 0.5、RandAugment(2 ops、magnitude 9、std 0.5)、pixel-mode Random Erasing(p=0.25,1 块)、Mixup($\alpha=0.8$) + CutMix($\alpha=1.0$)(batch 模式、合计概率 1.0、等概率选择)、label smoothing 0.1。
MiniPile:去重 Pile 的 6 GB 子集,Llama 风格因果 Transformer,每一层的 FFN 都换成 MoE。训练 1 个 epoch 共 15.23 亿 token,测试集 1500 万 token,byte-level BPE 词表 32000。4 步梯度累积使 8 卡有效 batch 为 256 条序列。AdamW $(0.9,0.95)$、wd 0.1;学习率在前 10% 训练热身到 $4\times10^{-4}$ 后余弦衰减到 $4\times10^{-5}$。指标为 token 级交叉熵与 PPL。
IntTravel:同组发布的真实出行推荐数据集(Yan et al., arXiv 2602.11664),1.628 亿用户、730 万 POI、41.3 亿交互。用因果 Transformer 做序列推荐,每个 FFN 与预测头都换成 MoE 模块。AdamW $(0.9,0.999)$、wd $10^{-6}$、恒定学习率 $10^{-4}$。使用其 "Where" 任务预测下一段行程的目的地 POI,报告 HR@1 / HR@5 / NDCG@5。
参数对齐协议(论文写得相当细致,值得单独强调):以被替换掉的骨干原始 FFN 参数量作为"单个专家"的目标规模。IntBMoE 每个内部层维护独立的 $E$ 个基、每个基只含一个权重矩阵;会计时把两个内部层的同下标基配成一对,让其合计参数量对齐该目标。这使两层 block 的维度为 MiniPile 上 $d \to 2844 \to d$、ImageNet-1K 与 IntTravel 上 $d \to 4d \to d$。常驻共享 SwiGLU 专家也按同一目标调整中间宽度对齐。为使各方法总专家参数量可比,带共享路径的 baseline 用 $E$ 个路由专家 + 1 个共享专家,不带共享路径的用 $E+1$ 个路由专家。µMoE 的 CP / TR 分解秩则按"总可训练参数尽量贴近 IntBMoE"来求解(CP 直接解秩 $R$;TR 固定 $R_1=R_2=4$ 解 $R_3$)。
Baseline 配置:Switch Transformer 保留原始 Top-1;其他 token-choice Top-$k$ baseline 在原文未指定 $k$ 时统一用 Top-2;Expert Choice 保留 expert-to-token 路由、capacity factor 2;µMoE 用 entmax1.5 路由;MASS 用 Top-$p$($p=0.5$)。Soft MoE 在 ImageNet 上每个图像 token 一个 slot,在 MiniPile / IntTravel 上被改造成因果版(每个 slot 只由当前及之前的 token 构成),每个专家一个 slot。SMEAR 在图像上用 example-level 组合、在自回归任务上用 token-level 组合。Lory 的 segment 大小为 16。DynMoE / MASS 在 IntTravel / ImageNet / MiniPile 上的初始专家池为 16 / 8 / 4,最大池规模与其他方法的专家数对齐,全部专家参数提前创建;DynMoE 的阈值初始化对应选择概率 0.5、路由温度 1.0,每 300 步剪掉未用专家并在有 token 未激活任何专家时开一个新专家;MASS 在过去 200 步上检测语义漂移,显著性 / 相似度阈值 0.01 / 0.001,冗余正则系数 0.01。
IntBMoE 默认配置:$K=8$ 码本 block、每 token 路由 $k=2$ 个;block 嵌入维度 32、路由器隐层 64、超网络隐层 16;每个 block 含 2 个内部 DPRG 层,两层用等宽的层专属专家池并共享同一对 value/gate 组合系数;常驻 SwiGLU 提供共享路径;专家矩阵用 PyTorch nn.Linear 默认初始化、偏置置零(小的初始权重尺度限制了训练早期复合变换带来的扰动)。
主要实验结果¶
ImageNet-1K 主表¶
| Method | ACC@1↑ | ACC@5↑ | Params (M) | Activated (M) | FLOPs (G) |
|---|---|---|---|---|---|
| Dense | 0.6640 | 0.8769 | 3.938 | 3.938 | 1.453 |
| Switch Transformer | 0.7004 | 0.8937 | 24.070 | 3.951 | 1.458 |
| DeepSeek-V3 MoE | 0.7078 | 0.8969 | 24.004 | 6.306 | 2.382 |
| ReMoE | 0.6971 | 0.8946 | 24.070 | 4.574 | 1.458 |
| V-MoE | 0.7167 | 0.9030 | 24.070 | 5.135 | 1.920 |
| Expert Choice | 0.7170 | 0.9030 | 24.070 | 5.135 | 1.958 |
| DynMoE | 0.6975 | 0.8962 | 24.070 | 10.306 | 4.170 |
| MASS | 0.7008 | 0.8966 | 24.070 | 8.827 | 3.601 |
| Soft MoE | 0.7122 | 0.8996 | 24.201 | 23.017 | 1.656 |
| SMEAR | 0.7178 | 0.9033 | 24.070 | 22.887 | 1.493 |
| Lory | 0.6956 | 0.8892 | 24.005 | 22.822 | 2.003 |
| µMoE (CP) | 0.7012 | 0.8938 | 24.070 | 22.887 | 9.120 |
| µMoE (TR) | 0.6962 | 0.8929 | 24.065 | 22.882 | 9.151 |
| IntBMoE | 0.7376 | 0.9148 | 24.295 | 23.111 | 4.063 |
| IntBMoE (cached) | – | – | – | – | 3.457 |
结论分析。IntBMoE 拿到 73.76% Top-1 / 91.48% Top-5,相对稠密骨干 +7.36 / +3.79 个百分点,相对最强 baseline SMEAR(0.7178)+1.98 个百分点 Top-1、+1.15 个百分点 Top-5。所有 MoE 方法的总参数预算都在 24M 附近对齐;IntBMoE 激活 23.111M 参数,因为构造可复用 block 时整池专家都参与了——这正是"全参与"在参数会计上的体现,与 SMEAR(22.887M)、Soft MoE(23.017M)、µMoE(22.88M)同属"全激活"一档,而稀疏路由方法只激活 4–10M。
但这张表同时暴露了一个 FLOPs 层面的不对齐。论文只对齐了参数量,没有对齐算力:表内 FLOPs 从 1.453 G 到 9.151 G 横跨 6 倍。按算力排序,IntBMoE(未缓存 4.063 G / 缓存 3.457 G)属于最贵的第四档;而它超越的三个最强 baseline——SMEAR 1.493 G、Expert Choice 1.958 G、V-MoE 1.920 G——都比它便宜 1.7–2.3 倍。换个角度看这张表会更公平:在 $\ge 3.4$ GFLOPs 的那一档里(DynMoE 4.170 G / 0.6975、MASS 3.601 G / 0.7008、µMoE 9.12 G / 0.7012),IntBMoE 的 0.7376 领先 3.6–4.0 个百分点,这确实是压倒性的;但论文没有给出任何"把 SMEAR / V-MoE 加宽到 3.5 GFLOPs"的等算力对照,所以 +1.98 点的招牌数字无法排除"多花了 2.3 倍算力"这一平凡解释。
值得注意的是 IntBMoE 与 SMEAR 的激活参数几乎相同(23.111M vs 22.887M)却差 2.3 倍 FLOPs,原因在架构里很直白:SMEAR 每 token 只执行一个融合专家,而 IntBMoE 每 token 要执行 $k=2$ 个两层 block 外加一个常驻共享 SwiGLU,折合约 3 个专家当量。所以"sparse execution"这个性质在论文语境下的准确含义是执行量不随 $E$ 增长,而不是"执行量小"。
跨域泛化:MiniPile 与 IntTravel¶
| Method | MiniPile Loss↓ | MiniPile PPL↓ | IntTravel HR@1↑ | HR@5↑ | NDCG@5↑ |
|---|---|---|---|---|---|
| Dense | 2.8131 | 16.6621 | 0.6748 | 0.8659 | 0.7785 |
| Switch Transformer | 2.7156 | 15.1135 | 0.6798 | 0.8667 | 0.7812 |
| DeepSeek-V3 MoE | 2.7119 | 15.0580 | 0.6805 | 0.8674 | 0.7818 |
| ReMoE | 2.7346 | 15.4034 | 0.6833 | 0.8685 | 0.7836 |
| DynMoE | 2.7108 | 15.0406 | 0.6818 | 0.8677 | 0.7826 |
| MASS | 2.7608 | 15.8128 | 0.6822 | 0.8679 | 0.7829 |
| Soft MoE (causal) | 2.7112 | 15.0466 | 0.6832 | 0.8683 | 0.7835 |
| SMEAR (token-level) | 2.7165 | 15.1277 | 0.6825 | 0.8676 | 0.7828 |
| Lory | 2.7519 | 15.6721 | 0.6811 | 0.8677 | 0.7823 |
| µMoE (CP) | 2.7101 | 15.0306 | 0.6835 | 0.8682 | 0.7837 |
| µMoE (TR) | 2.7171 | 15.1359 | 0.6837 | 0.8685 | 0.7835 |
| IntBMoE | 2.6802 | 14.5878 | 0.6852 | 0.8692 | 0.7850 |
结论分析。MiniPile 上 IntBMoE 的 PPL 相对最强 baseline µMoE (CP) 降低 2.9%,相对稠密骨干降低 12.4%——语言建模这一侧的领先是结实的。
IntTravel 这一侧就需要打个折扣了。IntBMoE 的 HR@1 相对最强 baseline µMoE (TR)(0.6837)只高 0.0015(+0.22% 相对),HR@5 相对 ReMoE / µMoE (TR)(0.8685)只高 0.0007,NDCG@5 相对 µMoE (CP)(0.7837)只高 0.0013。而全部 11 个 MoE baseline 的 HR@1 挤在 0.6798–0.6837 这 0.004 的带宽内,稠密骨干到最弱 MoE 的跳变(0.6748→0.6798,+0.0050)已经比"最强 baseline 到 IntBMoE"(+0.0015)大三倍多。也就是说,在推荐这个域上,"用不用 MoE"的收益是"用哪种 MoE"的 3–6 倍。全文三个数据集都只报 3 个种子的均值,没有任何一处给出标准差或置信区间;在 0.0015 这个量级上,读者无法判断领先是否稳定。
消融与分析¶
组件消融¶
| Metric | Full | 1-Layer | Fixed λ | w/o Gate | w/o Shared | w/o Filter | Softmax Coeff. |
|---|---|---|---|---|---|---|---|
| ImageNet Top-1↑ | 0.7376 | 0.6878 | 0.7244 | 0.6804 | 0.7332 | 0.7372 | 0.7263 |
| ImageNet Top-5↑ | 0.9148 | 0.8910 | 0.9078 | 0.8831 | 0.9108 | 0.9132 | 0.9072 |
| MiniPile Loss↓ | 2.6802 | 2.7174 | 2.6938 | 2.7660 | 2.7281 | 2.6829 | 2.7071 |
| MiniPile PPL↓ | 14.5878 | 15.1410 | 14.7871 | 15.8947 | 15.3035 | 14.6277 | 14.9864 |
| IntTravel HR@1↑ | 0.6852 | 0.6824 | 0.6844 | 0.6820 | 0.6846 | 0.6847 | 0.6835 |
| IntTravel HR@5↑ | 0.8692 | 0.8680 | 0.8685 | 0.8676 | 0.8689 | 0.8687 | 0.8686 |
| IntTravel NDCG@5↑ | 0.7850 | 0.7828 | 0.7827 | 0.7828 | 0.7844 | 0.7846 | 0.7839 |
变体定义:1-Layer 把每个两层 block 换成单层并扩大其专家池以保持专家参数总量不变;Fixed λ 把 $\lambda$ 固定为 1 且不可学;w/o Gate 去掉复合 gate 路径与乘性调制,式 (14) 退化为 $\tilde{z}^{(\ell)}_{t,b} = v^{(\ell)}_{t,b}$;w/o Shared 去掉共享 SwiGLU;w/o Filter 令 $z^{(0)}_{t,b} = x_t$ 绕过 block 条件化特征过滤;Softmax Coeff. 把无约束 + 保方差缩放的系数换成分别 softmax 归一化的 value / gate 系数。
把每项跌幅和"对最强 baseline 的领先幅度"放在一起看(ImageNet 上领先 SMEAR 1.98 点):
| 变体 | Top-1 跌幅 | 与 1.98 点领先的关系 | 退化后是否仍胜过 SMEAR |
|---|---|---|---|
| w/o Gate | −5.72 点 | 远超 | 否(0.6804,低于所有 MoE baseline) |
| 1-Layer | −4.98 点 | 远超 | 否(0.6878,低于所有 MoE baseline) |
| Fixed λ | −1.32 点 | 小于 | 是(+0.66 点) |
| Softmax Coeff. | −1.13 点 | 小于 | 是(+0.85 点) |
| w/o Shared | −0.44 点 | 远小于 | 是 |
| w/o Filter | −0.04 点 | 基本为零 | 是 |
这张对照表给出了本文最重要的一个判断:撑起全部领先幅度的两个组件是 DPRG 的乘性 gate 路径与两层 block 深度——去掉任一个,模型就掉到全部 MoE baseline 之下。而这两者都是通用技巧(门控非线性、更深的专家),与论文冠名的"block 级条件化 / 全专家参与"没有必然联系。MiniPile 上同样是 gate 影响最大(PPL 14.5878→15.8947),IntTravel 上 gate 与 1-Layer 也是跌得最多的两项。
反过来,真正体现论文 insight 的组件反而最弱:block 条件化特征过滤在 ImageNet 上只值 0.04 点、在 IntTravel HR@1 上只值 0.0005(小于对最强 baseline 的 0.0015 领先),共享专家值 0.44 点 / 0.0006。IntTravel 上 w/o Filter 与 w/o Shared 的跌幅都小于领先幅度,按档案的标准规则,这两项在推荐域上无法与噪声区分。
更关键的是一个缺席的消融:全文没有任何变体把"超网络 + 共享专家基线性组合"换成"$K$ 个参数量相同、但彼此独立自由训练的 block"。这正是零假设——一个"Top-2-of-8 路由、两层 gated 专家、外加共享专家"的普通 MoE。没有这个对照,就无法把收益归因到"从整池专家基组合出 block"这件事本身,也就无法支撑"full participation 是收益来源"的核心主张。引入了新的结构信号,不等于收益来自这个信号。
超参数敏感性:两个容量轴都很快饱和¶
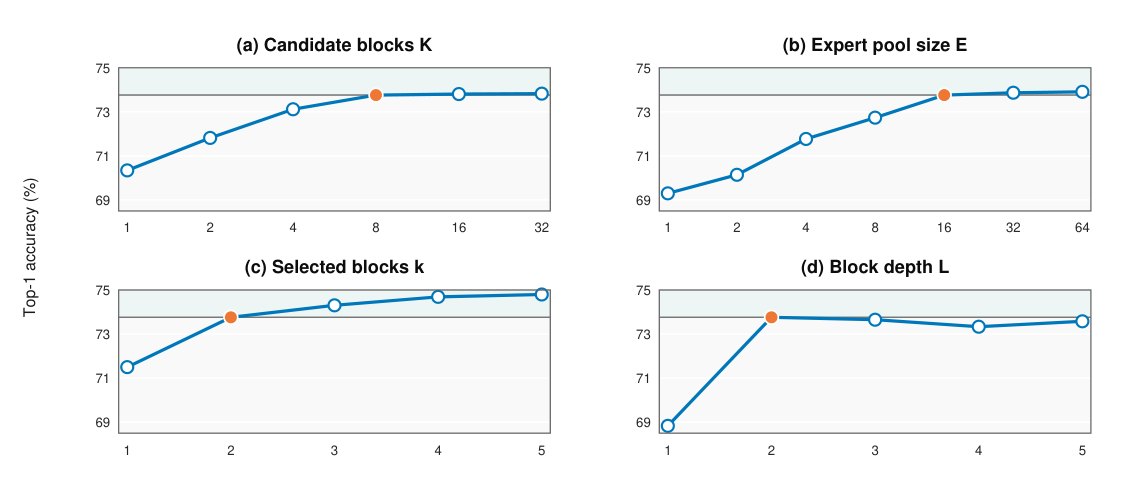
论文从默认配置 $(K,E,k,L)=(8,16,2,2)$ 出发单变量扫描($K=1$ 时令 $k=1$),结论如下:
- 码本规模 $K$:$8 \to 32$ 只涨 0.07 个百分点;
- 专家池规模 $E$:$16 \to 64$ 只涨 0.15 个百分点;
- 选中 block 数 $k$:持续单调改善,论文取 $k=2$ 以"在显著优于 $k=1$ 的同时限制每 token 计算量";
- block 深度 $L$:$L=2$ 最优。
这组数字对论文的叙事是不利的。整篇文章的价值主张是"让每个 token 受益于完整专家池",但把专家池从 16 扩到 64(4 倍)只换来 0.15 点,把可用 block 从 8 扩到 32(4 倍)只换来 0.07 点;而单纯多执行一个 block($k$,纯算力)却持续有效。也就是说,IntBMoE 的两个"容量轴"几乎立刻饱和,唯一好使的旋钮是直接加每 token 算力——这恰恰是 MoE 当初要规避的东西。按档案精读标准里的"方法论可扩展性"维度,这是一个明确的结构性隐患:参数量 scaling 时(加 $E$、加 $K$),表征能力并不能同步增长。
全池专家参与的有效性¶
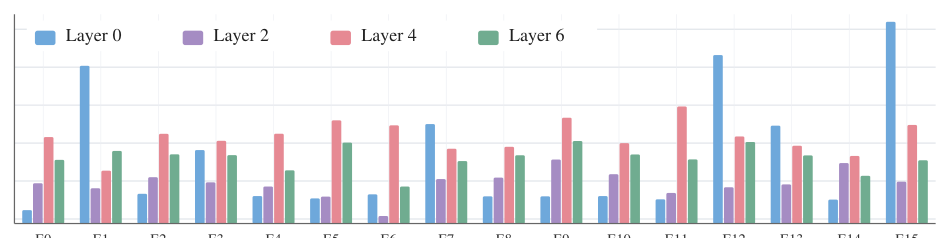
论文意识到"每个 block 由所有专家基构造"本身不能证明每个专家都有实质贡献,于是做了逐基删除实验:每次从某一 MoE 层的所有 block 组合里移除一个专家基,检查 Layer 0/2/4/6 的全部 16 个基共 64 种设置,不重训直接评估原 checkpoint。为了剔除"少了一个基导致复合权重整体缩小"这一尺度效应,把 $1/\sqrt{E}$ 换成 $1/\sqrt{E-1}$ 做补偿。
结果:移除任何一个被检查的专家基都会掉点。Layer 0/2/4/6 的平均跌幅分别为 1.60 / 0.49 / 1.17 / 0.78 个百分点。Layer 0 的贡献极不均衡——移除 E1 / E12 / E15 分别掉 4.10 / 4.99 / 9.15 个百分点,而其他基影响小得多;后面的层则均衡得多(Layer 2 在 0.26–0.74,Layer 4 在 0.60–1.95,Layer 6 在 0.45–1.04)。最小跌幅也有 0.26 点,论文据此断言"每个专家基都有贡献、模型有效利用了整池专家"。
这个论证只能走到一半。"从训练好的模型里删掉一个权重会掉点"对几乎任何训练过的网络都成立,它证明的是"该基已被用上",而不是"全参与这个设计比一个等参数量的非组合替代方案更好"。要支撑后者,需要的是前面提到的那个缺席对照,而不是删除实验。另外 Layer 0 出现单基 9.15 点的极端依赖,反倒说明最浅层其实塌缩到了少数几个基——与"全池均匀参与"的图景相悖。
路由行为与组合系数¶
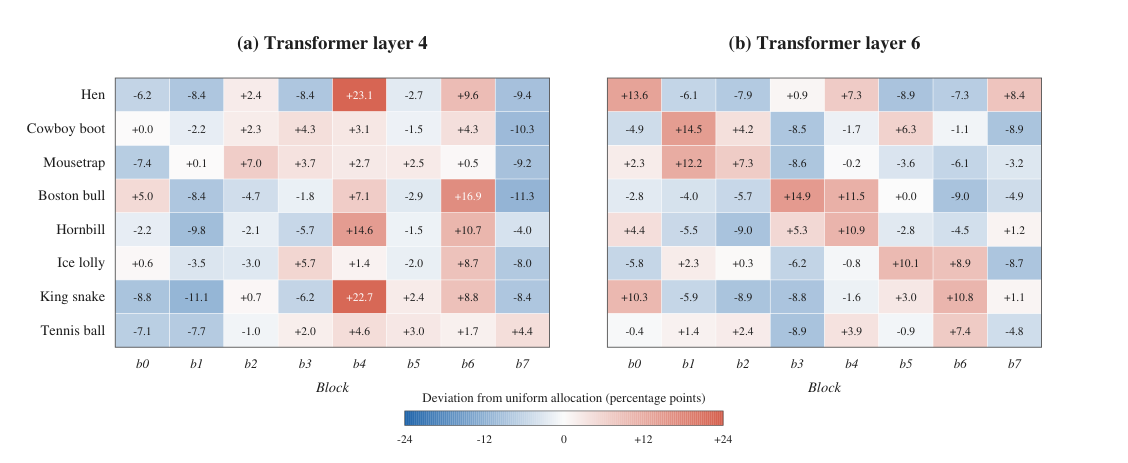
按真实类别统计每个 block 收到的 patch-token 路由占比,再减去均匀分配的 12.5%。不同类别在同一层偏好不同 block,且偏好随深度变化:layer 4 上 hen 偏好 b4(+23.1 点)、Boston bull 偏好 b6(+16.9 点);到 layer 6 两者的偏好分别转到 b0(+13.6)和 b3(+14.9)。路由既是类别条件化的,也是深度依赖的。
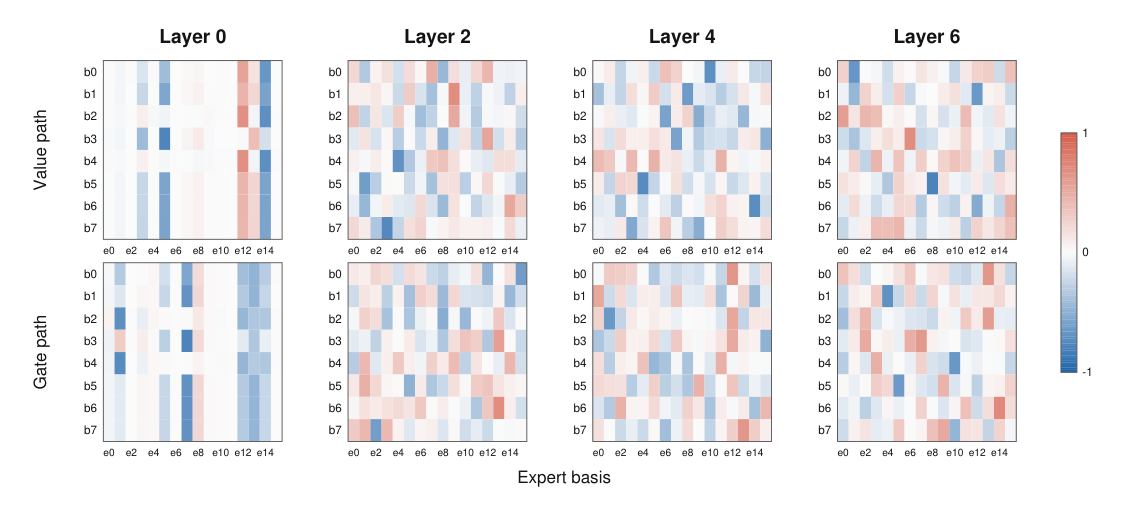
可视化每个 block 的 value / gate 组合系数可见:同层内不同 block 对同一批专家基赋予不同的正负权重,模式还随层与路径变化——说明码本条目学到的是 block 专属的组合 recipe,没有塌缩成同一套融合系数。量化上,value 路径的 block recipe 间平均两两余弦相似度从 layer 0 的 0.796 单调降到 layer 2/4/6 的 0.079 / 0.019 / 0.010;gate 路径同趋势,从 0.726 降到 0.126 / 0.083 / 0.043。论文解释为:浅层视觉特征更通用所以共享组合模式,深层表示则受益于更精细的 block 专属组合。
这组数字与 Figure 4 的发现互相印证也互相制衡:layer 0 的 recipe 高度相似(0.796)且对少数基极端依赖(单基 9.15 点),说明最浅的 MoE 层其实没有用上 block 级条件化,更像一个被复制了 8 份的共享专家。
推理成本与缓存¶
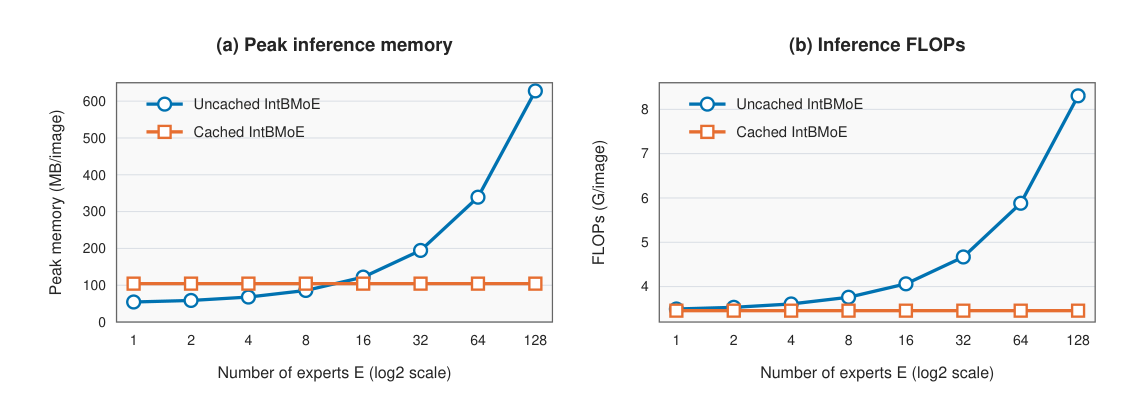
在 ImageNet-1K 配置、batch size = 1 下把 $E$ 从 1 扫到 128:
| $E=1$ | $E=128$ | |
|---|---|---|
| 未缓存 峰值显存 | 54.57 MB | 627.83 MB |
| 未缓存 FLOPs | 3.495 G | 8.305 G |
| 缓存后 峰值显存 | 104.33 MB | 104.33 MB(恒定) |
| 缓存后 FLOPs | 3.457 G | 3.457 G(恒定) |
缓存为预合成 block 引入一份固定显存开销,所以小专家池时反而更费显存,从 16 个专家起开始占优。这组曲线证明缓存把请求时显存与计算从专家池规模上解耦了。训练时同 batch 内共享复合 block,合成成本按 batch 摊薄。
需要留一句保留:这里量的是 FLOPs 与单图峰值显存,不是 wall-clock。档案里 EMO(arXiv 2605.13247)恰恰论证过"MoE 的每 token FLOPs 只跟 $k$ 走,而真实墙钟时间跟整池 $E$ 走"——在固定 FLOPs、4B 激活参数下 $E$ 从 8 涨到 128 仍有 1.72 倍实测减速,来源是 all-to-all、优化器状态显存与小 per-expert GEMM。IntBMoE 的"缓存后成本不随 $E$ 增长"这一结论正好建立在 EMO 警告过的那个代理指标上;论文只在线上部分给了真实时延(19 ms / P99 38 ms),离线这一侧没有任何 wall-clock 验证。
工业部署与线上 A/B¶
论文在高德(AMap)打开 App 时首屏地图的 POI 推荐服务上评估缓存版 IntBMoE。生产端的生成式推荐器预测用户接下来最可能去的 Top-10 POI,并据此决定地图视窗与缩放级别。因为该服务要求 60 ms 内响应,所以把与输入无关的复合 block 参数预计算并缓存,把 block 合成整个从请求路径上摘掉。
A/B 设置与结果:
| 项 | 取值 |
|---|---|
| 实验周期 | 一周 |
| 对照组 | 现有生产模型,不带 MoE 模块 |
| 实验组 | 缓存版 IntBMoE |
| 流量 | 约 5,000 QPS |
| 硬件 | Alibaba T-Head PPU |
| 平均时延 | 19 ms |
| P99 时延 | 38 ms |
| 业务收益 | UVCTR 相对 +2.4% |
| 后续 | 实验结束后全量上线承接生产流量 |
工业证据这一侧是达标的:有具体产品位、具体延迟预算、具体硬件、具体 QPS、平均/P99 双时延、一周周期、全量 rollout,并附带可访问的开源仓库。这不是"工业署名换工业可信度"的那类论文。
但对照组的选择让这个 +2.4% 无法归因到 IntBMoE 本身。对照是"不带 MoE 模块的现有生产模型",所以实验测量的是"加不加 MoE",而不是"IntBMoE 相对 Switch / DeepSeek-V3 MoE / SMEAR"。把这件事放到同论文的 IntTravel 离线结果上换算:稠密骨干 → 最强 baseline MoE 的 HR@1 增益是 0.0089,最强 baseline → IntBMoE 只有 0.0015,即稠密到 IntBMoE 的总增益里约 86% 来自"上了 MoE"这件事本身。若线上按类似比例分解,+2.4% UVCTR 中真正属于 block 级条件化设计的部分可能只有零点几个百分点。论文缺一个等服务成本的 MoE 对照臂,这是本次部署实验最大的缺口。
另有两点量级上的提示(非证伪,但值得记下):摘要里的"服务数亿用户"是高德体量的陈述,而 A/B 本身描述的是约 5,000 QPS;档案里同组的 IntHQ(arXiv 2608.09634,2026-08-10)在同一系统的全量 rollout 报的是 30k QPS / 平均 40 ms / UVCTR +1.60%,可见 5,000 QPS 更像实验桶而非全站流量。另外 IntBMoE 全文没有引用 IntHQ,所以"现有生产模型"具体对应哪一代基座、是否已含 IntHQ 的双流结构,论文没有交代。
核心贡献总结¶
- 一个干净的概念坐标系:把 MoE 拆成参与度 / 执行量 / 物化量三个可独立设定的量,并用它统一解释了稀疏路由、稠密混合、参数融合三家的各自代价。这个坐标系本身就有独立价值,比具体架构更容易被后续工作复用。
- 两阶段解耦的架构实现:学习码本(有界物化)+ 共享超网络逐层融合整池专家基(全参与)+ token 级 Top-$k$ block 路由(稀疏执行),三个性质各自由一个独立的设计元素保证,对应关系清楚。
- DPRG:把同一专家池融合两次得到 value / gate 两路,以残差乘性门耦合,使 block 的有效变换对专家基非线性,代价只是常数因子。
- 无约束 + 保方差系数:明确拒绝 softmax/sigmoid 归一化,允许负系数与线性张成组合,并用 $1/\sqrt{E}$ 稳定尺度;消融显示这比 softmax 归一化好 1.13 个百分点。
- 推理缓存:复合 block 与输入无关 ⇒ 可离线物化,请求时成本与 $E$ 解耦,这是它能塞进 60 ms 预算的直接原因。
- 少见的 baseline 覆盖度:12 个 MoE 方法横跨三大流派,同骨干、同协议、同种子、参数量按统一规则对齐,附录把每个 baseline 的路由配置都交代清楚——这部分实验卫生是全文最扎实的地方。
与已归档相关工作的对比¶
FAT FAT: From Scaling to Structured Expressivity — Rethinking Transformers for CTR Prediction(Alibaba Group, 2025-11-15,KDD 2026)¶
关系:独立并发(本文未引用 FAT,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇的 root cause 完全一致——"想要条件化、特化的参数,但把它们全部显式存下来会爆炸"。FAT 的场景是让 Transformer 投影矩阵按语义域对特化,参数按 $O(F^2d^2)$ 增长($F\sim10^3$、$d\sim128$ 时从 1 亿暴涨到 10 万亿以上);IntBMoE 的场景是让每个路由单元有自己的融合专家,物化成本 $O(GE|\theta|)$ 随路由单元数增长。两者都不是"任务层"的相似,而是同一个物化量爆炸的结构性瓶颈。
- 相近的技术骨架:两者的方法流程图几乎可以重叠——共享基组(basis pool)→ 轻量路由器/超网络把一个离散条件嵌入映成组合系数 → 按系数加权求和合成出目标参数矩阵 → 因为条件集合有限且与输入无关,训练后一次性离线物化并缓存,推理零额外开销。FAT 对每种参数类型 $\Phi\in\{Q,K,V,1,2\}$ 维护 $M=64$ 个基矩阵 $\mathcal{B}_\Phi$,用单层 MLP $g_\psi$ 把域嵌入 $\phi_f$ 映成选择签名 $s^{(f)}$,取 top-$K$($K=3$)后 softmax 得 $\alpha^{(f)}_m$,合成 $W^{(f)}_\Phi=\sum_{m\in\pi_f}\alpha^{(f)}_m B_{m,\Phi}$;IntBMoE 对每个内部层维护 $E$ 个专家基,用 linear-LN-ReLU 超网络把码本嵌入 $c_b$ 映成 $\alpha^v_b,\alpha^g_b$,合成 $W^{(\ell)}_{b,p}=\frac{1}{\sqrt E}\sum_e \alpha^p_{b,e}W^{(\ell)}_e$。连"训练时动态定义、推理前离线物化以满足生产时延约束"这条工程论证都是同一套话术。
- 本文的差异与推进:(a) 条件信号来源不同——FAT 的条件是数据 schema 给定的语义域 ID(外生、可枚举、有语义),IntBMoE 的条件是纯学习出来的码本条目(内生、数量自选、无先验语义),后者更通用但也失去了 FAT 那种"新增特征域只需初始化一个 meta-embedding"的可解释增量演进能力。(b) 在基维度上是稀疏还是稠密——FAT 在基上取 top-$K$=3(稀疏组合),IntBMoE 刻意在基上做全量组合($\alpha$ 覆盖全部 $E$ 个基),这正是它"full participation"的字面含义;两篇在同一个设计点上做了相反的选择。(c) 是否有第二级 token 路由——FAT 合成完就用(同域 token 共用同一矩阵),IntBMoE 在合成之上又叠了一层 token 级 Top-$k$ block 路由,这是它区别于所有 parameter-merging 工作的关键一步。(d) IntBMoE 还多了 DPRG 这条乘性路径,把线性组合抬成非线性。
- 可比的方法 / 实验差异:系数归一化上两篇给出了互相矛盾的实证——FAT 在选中下标上做 softmax(限制在凸包内),IntBMoE 的 "Softmax Coeff." 消融正好把这种做法作为对照,结果 ImageNet Top-1 从 0.7376 掉到 0.7263(−1.13 点)、MiniPile PPL 从 14.5878 升到 14.9864,结论是无约束 + $1/\sqrt{E}$ 保方差优于 softmax 归一化。这是一个可以直接迁移到 FAT 上做验证的具体假设。实验层面 FAT 走的是"扩三个数量级(50M→1.5B)的 scaling 曲线 + Rademacher 复杂度泛化界",把 $\Delta\text{AUC}=1.16\times10^{-4}N^{0.405}$ 拟出来并线上 +2.33% CTR(P99 45→48 ms);IntBMoE 则完全没有 scaling 实验,反而在敏感性分析里显示 $K$、$E$ 两个容量轴早早饱和——同一条"基组合"路线,FAT 给出了可外推的 scaling 证据,IntBMoE 给出的是饱和证据,这个反差对判断这条路线的长期上限很有参考价值。
本步骤的近似候选剔除记录:AIR-MoE(2605.04952)——同样出现"码本",但它的码本是 IVF 风格的路由检索索引(球面 k-means 粗筛专家候选集),参与度依然稀疏,root cause 是 65k 专家下的路由搜索开销,与本文的参与/物化解耦不同构;EMO(2605.13247)——问题同样是"池规模与实际成本的解耦",但解法是训练期分阶段扩池的调度表(由稀疏度 scaling law 微分得到),既无基组合也无超网络,方法流程图无法与本文重合;LLM-HYPER(2604.12096)——同样是"超网络生成参数",但用的是冻结 MLLM 在推理时 prompt 出线性 CTR 估计器权重,root cause 是无标注强冷启,没有专家池、没有路由、没有基组合;HA-MoE(2607.27577)——属 dense output-mixing 家族并对专家输出做 FiLM 调制,但 root cause 是异构信息流下的负迁移与少数类塌缩,与三量解耦无关;IntHQ(2608.09634)——同组、同系统、同 IntTravel 基准、同 UVCTR 指标,但问题是多任务信号的三重塌缩、解法是双流注意力解耦,问题与解法双双不同构,仅作为工业事实的交叉校验写进讨论。
讨论与局限性¶
值得借鉴的设计。 第一是那个三量坐标系:把"谁贡献知识 / 谁被算 / 谁被存"拆开,是分析任何条件计算架构的好工具,即便不采用 IntBMoE 的具体实现,这套语言也能直接拿去审视自己系统里的 MoE。第二是"条件集合有限且与输入无关 ⇒ 可离线物化 ⇒ 请求时零合成开销"这条工程范式;它与档案里 FAT 的 Basis-Composed Hypernetwork 撞出同一答案,说明在严苛时延预算下,这基本上是把超网络送上线的唯一可行姿势。第三是参数对齐协议写得足够细(单专家目标规模、双内部层配对计数、带/不带共享路径的 $E$ vs $E+1$、µMoE 的秩求解),这份实验卫生标准值得抄。
核心局限一:论文的招牌机制没有被任何消融隔离出来。 消融表里跌得最狠的两项是 DPRG 的乘性 gate(−5.72 点)与两层 block 深度(−4.98 点),都是通用技巧;而最能代表"block 级条件化"这一 insight 的特征过滤只值 0.04 点。全文缺少那个决定性的对照——把"超网络从共享基组合出 $K$ 个 block"换成"$K$ 个参数量相同、彼此独立自由训练的两层 gated block"。这个零假设一日不排除,"full participation 带来收益"就一日只是一个未被检验的归因。Figure 4 的逐基删除实验填不上这个坑:它只证明训练好的权重被用上了,不证明组合式构造优于等参数量的非组合替代。
核心局限二:两个容量轴都饱和,可扩展性存疑。 $E$ 从 16 到 64 只值 0.15 点、$K$ 从 8 到 32 只值 0.07 点,唯一单调有效的旋钮是 $k$——而 $k$ 是纯算力。这意味着 IntBMoE 在参数量 scaling 时,表征能力并不能同步增长;它更像是一个在小模型上调好的、性价比不错的 FFN 替代件,而不是一条能往上长的架构路线。对照同为"基组合"路线的 FAT 报出了横跨三个数量级不饱和的幂律,这个反差尤其刺眼。
核心局限三:离线赢面没有等算力对照,线上赢面没有等架构对照。 离线侧,+1.98 点是在 2.3 倍于 SMEAR 的 FLOPs 上取得的,论文只对齐参数不对齐算力;线上侧,对照组是"不带 MoE 模块"的生产模型,于是 +2.4% UVCTR 混合了"上 MoE"与"上 IntBMoE"两件事,而同论文的 IntTravel 数据显示前者约占总增益的 86%。两处缺口方向一致:缺的都是"把优势收窄到论文自己那部分"的那个对照臂。
其他局限。 (a) 实验规模偏小:ImageNet 侧是 8 层 DeiT-Tiny(24M 参数)从头训,MiniPile 侧是 18 层 / 15.2 亿 token / 1 epoch,IntTravel 侧更是 $d=96$、单头、8 层的小模型——一个宣称解决 MoE scaling 权衡的架构,全部证据都来自玩具规模。(b) 三个数据集都只报 3 种子均值、无标准差,而 IntTravel 上的领先只有 0.0015 HR@1。(c) 推荐侧只用了作者自己团队发布的 IntTravel,没有任何标准公开推荐基准(Amazon / MovieLens / KuaiRand)交叉验证。(d) 效率论证只有 FLOPs 与单图 batch=1 峰值显存,没有离线 wall-clock,而档案里 EMO 已经证明 FLOPs 对 MoE 是个糟糕的成本代理。(e) Layer 0 出现单基移除掉 9.15 点、block recipe 余弦相似度高达 0.796 的现象,说明最浅的 MoE 层其实没有用上 block 级条件化,论文对这个与主张相悖的观测只作了"浅层特征更通用"的顺势解释,没有进一步处理(例如浅层是否干脆不该上 IntBMoE)。
工业落地价值的净评估。 部署细节是硬的:高德首屏地图 Top-10 POI 预测决定视窗与缩放、60 ms 预算、一周 A/B、约 5,000 QPS、Alibaba T-Head PPU、平均 19 ms / P99 38 ms、实验后全量承接生产流量、代码开源且链接可达。这些都不是"工业署名换可信度"的空话。真正打折的地方只在归因:这次 A/B 证明的是"在高德这个 60 ms 的生成式推荐系统里,用缓存化的 MoE 模块替换掉无 MoE 的 FFN 能拿到 +2.4% UVCTR 且时延还有一半余量"——这个结论本身对做工业推荐的人有直接参考价值,但它不证明必须是 IntBMoE 这一版设计才能拿到。