Don’t Contrast the Impossible:面向本地社区平台的区域约束对比学习批采样
Danggeun Market Inc.(Karrot)· SIGIR 2026 · arXiv 2607.28971
Seungho Han、Byeongchang Kim(共同一作),Jin Yu
研究动机与背景
大规模推荐系统常用对比学习训练通用用户表示:把用户真实发生的下一次交互作为正样本,把同一 mini-batch 中其他用户的正样本复用为当前用户的负样本。这样无需显式维护巨大的负样本池,计算上很高效;但它隐含了一个通常没有被写出来的前提——任意用户原则上都可能看到 batch 中的任意物品。只有在此前提下,“用户没有与物品交互”才可能反映用户偏好。
Karrot 是典型的 hyper-local 社区平台,覆盖二手交易、二手车、本地工作、社群与本地商业等业务。平台明确按地理范围限制曝光,超过 86% 的交易发生在 5 公里内;用户首页只展示同区域或相邻区域中的内容。因此,随机 batch 里的大量 user-item 配对在产品规则下根本不可能发生曝光。论文把负样本区分为两类:
- 可行负样本(feasible negative):用户有机会看到但没有交互,其非交互包含偏好信息;
- 不可能负样本(impossible negative):物品因地理政策永远不会展示给用户,非交互由系统决定,几乎不携带用户偏好信号。
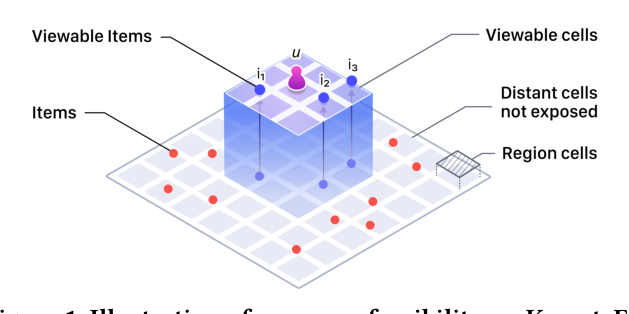
随机 batch 把二者无差别地放入 InfoNCE 分母。当不可能负样本占主导时,模型只需学会地区差异就能完成大量“简单区分”,真正需要学习的同区域细粒度偏好被稀释。这里的问题不只是传统意义上的曝光概率不均,而是 positivity assumption 的结构性破坏:某些 user-item 对的曝光概率严格为零。Inverse Propensity Scoring(IPS)只能重加权曝光概率大于零的观察样本,无法给零概率配对创造不存在的交互,所以不能单独修复这一问题。
论文提出 Region-Constrained Batch Sampling(RCBS):不改模型、不改损失,只让一个 mini-batch 中的用户来自同一区域,使其他用户的正样本大多也位于当前用户的可曝光范围。这样既移除了大量无意义的 impossible negatives,又自然把负样本变难。这个思想也适用于餐饮/生鲜配送的服务区、约会应用的距离阈值等所有具有硬曝光边界的系统。
问题定义与基础模型
行为序列
记用户集合为 $\mathcal{U}$,物品集合为 $\mathcal{I}$。用户 $u$ 的长度为 $T$ 的时间有序行为序列是:
$$ S_u = \{s_{u,1},\ldots,s_{u,T}\},\qquad s_{u,t}=(a_{u,t},\tau_{u,t},i_{u,t}). \tag{1} $$
其中 $a_{u,t}$ 是动作类型,如 click、watch、chat;$\tau_{u,t}$ 是时间戳;$i_{u,t}\in\mathcal{I}$ 是第 $t$ 步交互物品。任务是在看到 $S_{u,1:t}$ 后,将真实下一物品 $i_{u,t+1}$ 与其他候选区分开。
两塔式用户建模
用户塔 $f_{\mathrm{user}}$ 是 Pre-LN Transformer,把整段动作序列编码为逐位置用户表示:
$$ H_u=\{\mathbf{h}_{u,t}\}_{t=1}^{T}=f_{\mathrm{user}}(S_u)\in\mathbb{R}^{T\times d}. \tag{2} $$
物品塔 $f_{\mathrm{item}}$ 把标题、正文、元数据和图片等物品特征编码到同一空间:
$$ \mathbf{v}_i=f_{\mathrm{item}}(i)\in\mathbb{R}^{d}. \tag{3} $$
两侧 embedding 都做 $\ell_2$ 归一化,亲和度是内积 $s(\mathbf{h}_{u,t},\mathbf{v}_i)=\mathbf{h}_{u,t}^{\top}\mathbf{v}_i$,因此也是 cosine similarity。训练 batch 形状为 $[B,T]$;每个位置以下一个真实交互 $\mathbf{v}^{+}_{b,t}$ 为正样本,以 batch 内所有 $BT$ 个正物品为候选,使用温度为 $\tau>0$ 的 InfoNCE:
$$ \mathcal{L}_{\mathrm{NCE}}=-\frac{1}{BT} \sum_{b=1}^{B}\sum_{t=1}^{T} \log \frac{\exp\!\left(s(\mathbf{h}_{b,t},\mathbf{v}^{+}_{b,t})/\tau\right)} {\sum_{b'=1}^{B}\sum_{t'=1}^{T} \exp\!\left(s(\mathbf{h}_{b,t},\mathbf{v}^{+}_{b',t'})/\tau\right)}. \tag{4} $$
分子拉近当前用户状态与真实下一物品;分母中的其他物品负责把它们分开。RCBS 的关键观察是:分母并非纯计算技巧,它定义了模型实际学习的区分任务。如果分母有 98% 是产品上不可能曝光的候选,模型优化的就不是线上真实选择集合中的偏好判别。
核心方法:Region-Constrained Batch Sampling
曝光可行性
把地理空间划分为离散区域单元 $r\in\mathcal{R}$。用户和物品的位置分别通过 $r(\cdot)$ 映射到区域。论文定义 user-item 曝光可行性为:
$$ \operatorname{feas}(u,i)= \mathbf{1}\!\left[\operatorname{dist}(r(u),r(i))\leq\delta_u\right]. \tag{5} $$
$\operatorname{dist}(\cdot,\cdot)$ 是区域单元间非负对称距离,$\delta_u\in\{0,1,2,\ldots\}$ 是用户特定的曝光半径,由平台政策或用户配置决定。$\delta_u=0$ 要求用户与物品严格同区域;$\delta_u>0$ 允许一定范围的相邻区域。若某个负物品满足 $\operatorname{feas}(u,i)=0$,它就是 impossible negative。
区域同质 batch
RCBS 先选一个区域 $r$,再从该区域用户池 $\mathcal{U}_r$ 中均匀抽取 $M$ 个用户:
$$ \mathcal{B}_r=\{(u_b,S_{u_b})\}_{b=1}^{M},\qquad u_b\sim\operatorname{Uniform}(\mathcal{U}_r), \quad \mathcal{U}_r=\{u\in\mathcal{U}\mid r(u)=r\}. \tag{6} $$
同一区域用户具有相近的曝光约束,因此他们各自交互的物品对其他用户更可能可见。算法流程可以概括为:
- 按当前地理单元把用户放入区域池 $\mathcal{U}_r$;
- 每个训练 step 选择目标区域 $r$;
- 从 $\mathcal{U}_r$ 采样一个用户 batch,并读取各自最长 $T$ 个行为;
- 按原两塔网络编码,仍用式(4)的所有 in-batch positives 作为候选;
- 不增加任何 loss 项,也不改变推理图。
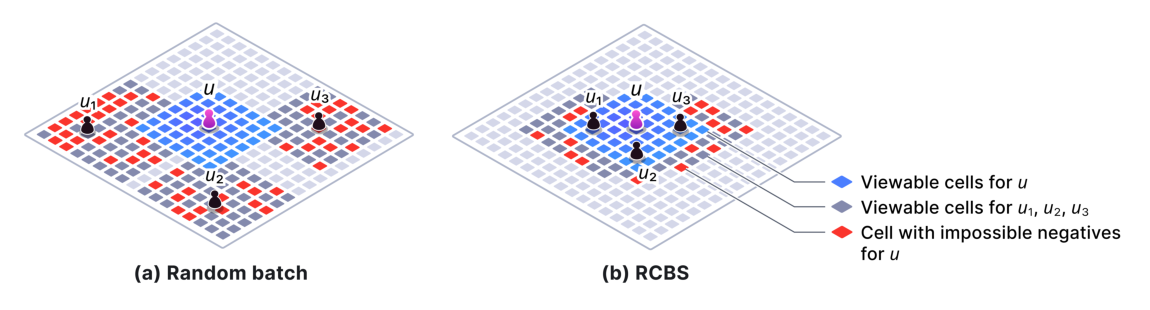
不可能负样本比例
在所有用户均采用精确区域匹配($\delta_u=0$)的简化条件下,mini-batch 内不可能负样本的期望占比为:
$$ \rho=1-\sum_{r\in\mathcal{R}}p_r^2. \tag{7} $$
$p_r$ 是 batch 用户属于区域 $r$ 的概率。$\sum_r p_r^2$ 是随机取两个 batch 成员时同区域的概率,其补集就是跨区、因而不可能曝光的负样本概率。随机 batching 下区域近似均匀,$\rho\approx 1-1/\min(|\mathcal{B}|,|\mathcal{R}|)$,区域或 batch 规模越大,impossible negatives 越接近全部;RCBS 把概率质量集中到一个区域,使目标区域 $p_r\approx1$,故 $\rho$ 接近 0,且不随 batch size 和区域总数膨胀。
真实系统中 $\rho$ 不会严格为 0:不同用户的 $\delta_u$ 不同,较大半径用户产生的正物品对较小半径用户仍可能不可见;用户搬家也会让历史行为跨越多个区域。论文的 fine RCBS 实测将 $\rho_{\mathrm{train}}$ 从随机 batch 的 0.98 降到 0.30,而非归零。
与 IPS 的关系
RCBS 是 data-level correction:在损失计算前改变式(4)分母里出现哪些物品;IPS 是 loss-level correction:对已经观察到、且曝光概率严格大于零的样本按逆倾向加权。对于 $p(o=1\mid u,i)=0$ 的地理禁配对,IPS 没有可重加权的观察值;RCBS 先把 batch 收缩到可行域,IPS 再处理可行域内部残留的非均匀曝光,两者可以串联而非互相替代。论文只讨论了这一组合方向,没有做联合实验。
实验设置
数据与切分
用户建模预训练使用 Karrot 两年生产日志,约 2500 万用户、150 亿次动作;每个用户序列最多保留 1024 个动作。用户级随机划分 95% 训练、5% 评估。
下游任务使用与预训练时段不重叠的服务日志:home feed ranking 用 3 周、home feed retrieval 用 1 周、display ads ranking 用 4 周。评估均为时间切分:feed ranking 与 ads ranking 各取最后 24 小时,feed retrieval 取最后 6 小时。
模型与训练配置
预训练模型为 Transformer 用户塔 + 三层 MLP 物品塔。物品特征由预训练 embedding 模型编码标题、内容、元数据和图片得到。比较三种训练采样:Random-Train、粗粒度区域 RCBS-Train(coarse)和细粒度区域 RCBS-Train(fine)。batch size 为 18、序列长度为 1024,每个 batch 因而有 18,432 个候选;三组保持训练步数及其余超参数一致。
论文没有披露 Transformer 层数、隐藏维度、attention heads、优化器、学习率、温度 $\tau$、训练步数和 coarse/fine 区域的实际尺度,这限制了外部复现。
下游 feed ranking 和 ads ranking 使用生产 DCN 系列模型,把预训练用户 embedding 作为额外特征;feed retrieval 使用生产两塔模型,把表示注入用户塔。系统每天用用户最近 1024 个动作运行用户塔,并对逐位置输出做 mean pooling,得到最终用户 embedding。
指标
- 用户建模:Recall@10、Recall@100;分别在 Random-Eval 和细粒度 RCBS-Eval 下评估。后者候选更可行、更难,因而绝对分数预期更低;另报告训练 batch 的 impossible-negative 比例 $\rho_{\mathrm{train}}$。
- Feed ranking:NDCG@10(排序前十的折损累计增益)与 click Ordered-Pair Accuracy(OPA)。
- Feed retrieval:Recall@10、Recall@100。
- Ads ranking:ROC-AUC 与 PR-AUC,后者在类别不平衡下更关注正例识别。
- 受保密限制,下游离线指标只报告相对生产 baseline 的增益;线上报告 treatment 对 control 的相对变化。
主要实验结果
用户建模预训练
| 训练方法 | Random-Eval R@10 | Random-Eval R@100 | RCBS-Eval(fine)R@10 | RCBS-Eval(fine)R@100 | $\rho_{\mathrm{train}}$ |
|---|---|---|---|---|---|
| Random-Train | 0.100 | 0.422 | 0.082 | 0.349 | 0.98 |
| RCBS-Train(coarse) | 0.125 | 0.456 | 0.112 | 0.403 | 0.79 |
| RCBS-Train(fine) | 0.149 | 0.474 | 0.139 | 0.435 | 0.30 |
结论分析。 从 Random 到 coarse 再到 fine,$\rho$ 单调下降,四个 Recall 指标同时单调上升。fine RCBS 相对 Random-Train 在 Random-Eval 上把 R@10 从 0.100 提至 0.149(相对 +49.0%)、R@100 从 0.422 提至 0.474(+12.3%);在更难的 RCBS-Eval 上,R@10 从 0.082 提至 0.139(+69.5%)、R@100 从 0.349 提至 0.435(+24.6%)。这条“区域越细 → impossible negatives 越少 → 表示越好”的剂量响应链,是论文最直接的因果证据。对同一模型,RCBS-Eval 始终低于 Random-Eval,也支持“可行负样本更难、更有信息”的解释。
但这里没有控制“区域同质 batch 改变用户/物品分布”的其他效应,也没有随机化相同难度但不满足曝光可行性的对照,故相关性还不能完全等同于机制因果证明。
下游离线实验
表中均为加入相应用户 embedding 后,相对各任务生产 baseline 的提升:
| 方法 | Feed ranking $\Delta$NDCG@10 | Feed ranking $\Delta$OPA | Ads $\Delta$ROC-AUC | Ads $\Delta$PR-AUC | Retrieval $\Delta$R@10 | Retrieval $\Delta$R@100 |
|---|---|---|---|---|---|---|
| Random-Train | +0.22% | +0.17% | +0.25% | +1.21% | +4.44% | +2.36% |
| RCBS-Train(fine) | +1.18% | +1.07% | +0.53% | +3.38% | +7.56% | +4.61% |
结论分析。 随机 batch 学到的用户表示并非完全无效,但在 feed ranking 上收益很小;RCBS 表示在六个指标上都更强,说明预训练中的可行负样本选择可以跨任务迁移。Retrieval 增益最大,是因为其两塔点积结构与下一动作 InfoNCE 预训练目标最接近;ranking 模型还有丰富的用户、物品和上下文特征,新增 embedding 的边际贡献自然被稀释。Ads 的 PR-AUC 从 +1.21% 扩到 +3.38%,说明改进不只发生在多数负例主导的 ROC-AUC 上,对稀疏正反馈也有效。
线上 A/B 测试
实验把表现最好的 fine RCBS 用户表示作为额外特征加入生产系统,control 不使用该表示:
| 场景 | 指标 | 相对变化 |
|---|---|---|
| Home feed(召回 + 排序) | Clicks | +10.0% |
| Home feed(召回 + 排序) | Impressions | +5.12% |
| Home feed(召回 + 排序) | DAV(日活跃浏览者) | +1.91% |
| Ads ranking | eCPM | +6.01% |
| Ads ranking | Ad CTR | +7.46% |
结论分析。 五项核心线上指标全部为正,且覆盖用户活跃、内容消费和广告变现,证明 RCBS 表示不是只优化离线 Recall 的代理技巧。最终 embedding 已在 Karrot 多个应用生产部署。需要注意:论文没有报告实验持续时间、流量比例、置信区间和显著性检验,也没有在线直接比较 Random-Train embedding 与 RCBS embedding;因此线上结果验证的是“加入 RCBS 表示相对不加入表示”的整体收益,不能把全部 uplift 严格归因于 batching 策略相对随机 batching 的增量。
消融与分析
论文的核心消融就是 coarse/fine 区域粒度:coarse 把 $\rho$ 从 0.98 降至 0.79,fine 降至 0.30;性能随之单调提高。这说明区域分组不只是一个二元开关,分组粒度决定负样本池与真实曝光边界的吻合程度。
此外,Random-Eval 与 RCBS-Eval 构成评估难度消融:同一训练模型在 RCBS-Eval 上 Recall 更低,表明可行候选比跨区候选更难区分。训练和评估两维交叉后,RCBS-Train 对两种评估方式都优于 Random-Train,排除了“RCBS 只对同分布评估有利”的简单解释。
缺失的消融同样重要:没有单独扫描 $\delta_u$、区域大小或跨区混合比例;没有比较按 item 区域采样、mask 掉不可能负样本、显式 hard-negative mining、IPS 以及 RCBS+IPS;也没有报告 batch 内有效负样本数量、重复物品率、区域长尾造成的采样方差或训练吞吐变化。因此本文充分证明了“简单方案有效”,但尚未确定最优的可行域建模方式。
工业部署与工程价值
RCBS 最大的工程优势是训练侧改动极小:网络结构、InfoNCE、候选数量和线上推理完全不变,只替换 data loader 的 batch 组织方式。推理时依旧每日对最近 1024 个动作编码和 mean pooling,不增加在线延迟。这使它适合已有大规模两塔预训练流水线渐进接入。
同时它把业务规则直接转化为训练采样先验:平台本来就维护用户区域、物品区域与可见半径,RCBS 不需要额外训练难负挖掘器或周期性构建 ANN 索引。对服务区、合规边界、库存可达性等硬约束也可类比复用。真正上线时仍需处理区域用户量高度不均、用户迁移、不同业务线曝光半径不一致以及跨区域内容等数据工程问题,论文未披露这些负载均衡细节。
核心贡献总结
- 首次把本地社区推荐中的地理曝光硬约束明确刻画为 impossible negatives:非交互来自系统禁配而非用户选择,随机 in-batch negatives 因而系统性污染偏好学习。
- 提出 RCBS,以区域同质 mini-batch 在数据层重塑 InfoNCE 分母;方法不改架构和损失,却把随机、无意义负样本替换为可曝光且更难的候选。
- 用 2500 万用户、150 亿动作的生产数据展示 $\rho$ 与表示质量的清晰单调关系,并在 feed ranking、retrieval、ads ranking 的离线与线上实验中取得一致收益。
- 阐明 RCBS 与 IPS 的边界:RCBS 先处理零曝光概率带来的 positivity violation,IPS 再校正可行域内的非均匀曝光。
与已归档相关工作的对比
Cluster GOOBS Cluster GOOBS: Real-Time Hard Negative Sampling via LLM-based Clustering for Large-Scale Two-Tower Retrieval(Meta,2026-07-01)
关系:独立并发(本文未引用 Cluster GOOBS,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两者都指出通用随机负采样让双塔/对比学习的分母被低信息候选占据,模型可以解决过于简单的区分任务,真正有价值的细粒度偏好信号不足。
- 相近的技术骨架:都不重构主模型,而是借助模型外已有的离散结构收缩负样本池,使候选更同质、更难。RCBS 按用户所在 region 形成同质 batch;Cluster GOOBS 按正物品的 LLM/多模态语义 cluster,从哈希 OOB 池实时采同簇负样本。
- 本文的差异与推进:RCBS 的首要目标不是“找最相似物品”,而是先保证负样本具备非零曝光可能性;地理硬约束给出了可解释的因果边界,并把 IPS 无法处理的 positivity violation 从训练数据层移除。Cluster GOOBS 则面向全库召回,重点是语义难度、长尾探索及 O(1) 工业采样系统。
- 可比的方法 / 实验差异:RCBS 只需区域化 shuffle,线上推理零改动,Karrot A/B 获得 Clicks +10.0%、AdCTR +7.46%;Cluster GOOBS 需要离线语义聚类和分段哈希物品池,已归档报告的 Meta A/B 为 CTR +53%,同时把 top-100 物品曝光份额从 50% 降至 32%。二者提示可以进一步做“先按曝光可行域过滤,再在域内按语义簇挖难负”的两级采样。
讨论与局限性
这篇论文最值得借鉴的并非复杂模型,而是对训练样本语义的重新审计:in-batch negative 的计算便利不代表它是有效监督。RCBS 用一个非常小的工程改动修复了由产品曝光政策制造的标签语义错误,并以跨召回、排序、广告的生产结果证明其价值。对于具有硬服务边界的平台,这种“先判断候选是否可能,再讨论它有多难”的顺序比直接做全局 hard-negative mining 更可靠。
方法新颖性属于强 insight、轻算法:区域分桶本身简单,理论只在 $\delta_u=0$ 的简化设定下给出 impossible-negative 比例,没有推导 RCBS 对 InfoNCE 偏差、互信息界或梯度方差的影响。实验规模很大但透明度有限,缺少公开数据集、关键超参数、统计显著性、系统开销和更强负采样 baseline;线上实验也没有直接隔离 RCBS 相对 Random-Train embedding 的增量。
RCBS 还可能带来三类风险。第一,区域内“未交互”仍不等于真实负偏好,可能包含未曝光或曝光不足的 false negatives;第二,小区域和低活跃区域的样本池可能重复率高、分布偏斜,损害训练稳定性与跨区泛化;第三,位置会迁移、曝光半径因用户和业务动态变化,静态 region-homogeneous batch 只是可行域的近似。作者提出的 adaptive region grouping 与 RCBS+IPS 正是合理后续方向;还可以把库存、时效、合规和语言等约束统一成动态 feasibility graph,再在可行子图内做语义 hard-negative sampling。
综合评价,这是一篇 8/10 的扎实工业论文:问题定义精准、方法极简可部署、离线与线上收益强,且已跨多个业务投产;但方法理论深度、对比实验完整性与复现信息尚不足以达到开创性 9 分档。