拆解推荐系统中的「陈旧性」:面向取代与衰减的双过滤器框架¶
Decomposing Staleness in Recommender Systems: A Dual-Filter Framework for Supersession and Decay(Google LLC,CIKM '26,arXiv 2608.15780v1,2026-08-16)
作者:Di Bai, Feng Han, Zhenwei Tang, Jintao Liu, Luoshu Wang, Jialu Liu(均为 Google LLC,Mountain View / Toronto / New York)
关键词(原文):Recommender Systems, Content Staleness, Content Filtering, Knowledge Distillation
研究动机与背景¶
推荐系统天然是时间敏感的:它是在一个持续演化的「相关性」概念之下 surface 内容的,而当系统对相关性的评估滞后于现实时,物品就变成了陈旧(stale)的——它们仍在被曝光,却已不再反映底层话题的当前状态。在 Google Discover 这种规模的系统里,陈旧性是一个普遍存在的挑战,也是用户不满的首要来源之一。
作者的第一个核心论断是:陈旧性不是一个单体问题。物品通过不同的机制失去相关性,而机制决定了陈旧性如何显现、也决定了它必须如何被检测。本文处理两个主要维度:
取代(Supersession)。当一个新到达的物品推进了底层话题时,旧物品突然变陈旧。例如「Queen Elizabeth II 正在接受医疗监护」这条早期简讯,在数小时内就被「她去世」的公告取代;又如「Ohtani 正在权衡多支球队的报价」这条早期报道,在他与 Dodgers 签约的那一刻就被作废。这里的陈旧信号是关系性(relational)的,而非绝对的——因为只有那些矛盾、取代或转移了叙事的更新才会让旧物品陈旧,所以检测必须比较物品对(item pairs),而不能只看发布时间。
相关性衰减(Relevance decay)。物品在其生命周期中自然地失去信息价值,驱动力来自它自身的内容而非被取代。一篇「今晚流星雨」指南在那一个晚上极其有用,之后相关性陡降;一段温情的本地短片也会在没有任何后续报道的情况下自然褪色。这里的陈旧信号是内在(intrinsic)的,直接系于物品的预期寿命。
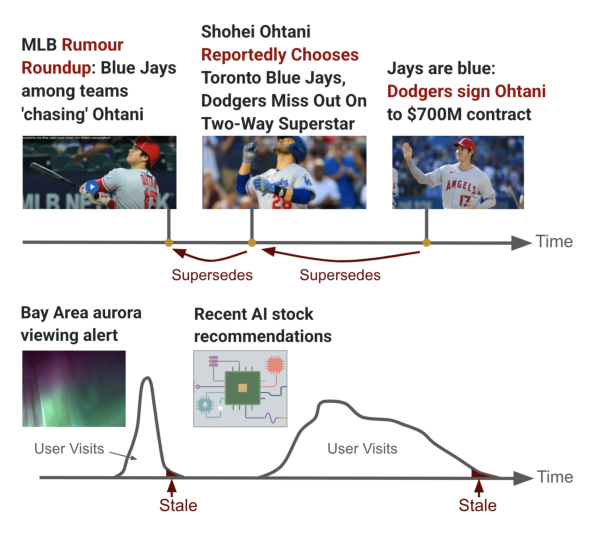
传统对策对两者都无效,作者逐条拆解:
- 基于时间的排序(time-based ranking)只降权而不移除陈旧物品,用户仍被迫滚动划过它们;
- 手工调参的年龄阈值(age cutoffs)粗糙且严重依赖发布时间:阈值放长仍会服务陈旧物品,阈值收紧则会丢掉有用的常青(evergreen)内容;
- 基于互动的启发式(如点击率下限)引入结构性滞后(structural lag):系统只有通过反复把降级体验曝光给用户才能学到某物品已陈旧。
作者提出 SDF(Supersession-Decay Filtering),一个已在 Google Discover(Google Search app 内的开放网络个性化 feed,数亿日活、数十亿月活)全量部署的陈旧性过滤系统。定位上,下游排序系统仍然保持 engagement-based 与 trend-aware,而 SDF 是一个前置的主动过滤层:它在内容进入计算密集的排序阶段之前就剪掉根本性陈旧的内容,向下游交付一个精炼后的候选集。SDF 把问题分解成两个互补组件,各由一个学习到的模型驱动:
- 关系型陈旧过滤器(relational staleness filter) 针对取代:一个带 rationale 监督的成对分类框架,判定新到物品是否让某个已有物品陈旧。由于人工标注在规模上代价过高,作者用 LLM 流水线合成训练数据,再知识蒸馏到一个紧凑的 student 模型以支撑规模化服务。
- 内在陈旧过滤器(intrinsic staleness filter) 针对衰减:提出 PTR(predicted traffic ratio,预测流量比) 模型,以物品的多模态内容为输入、以终身访问流量为训练目标,预测未来各时间视界上的相关性衰减,从而主动过滤接近寿命终点的物品,把服务容量让给更新鲜、更有价值的内容。
两个过滤器在排序阶段上游以析取(disjunction,即 OR) 组合,同时改善用户体验与服务效率。两年生产部署中,用户主动提交的陈旧性举报(in-product user feedback)相对部署前基线下降 54.9%(其中取代类 −64.0%、衰减类 −34.4%)。
相关工作定位¶
推荐系统中的陈旧性建模。 已有研究主要是间接地通过流行度衰减而非直接检测来研究陈旧性。一条路线把时间作为显式模型特征(TimeSVD++ [18]),后续工作把个性化时间衰减应用到点击率 [31]、或在新近性与相关性之间调参 [7]。另一条路线经验性地刻画内容生命周期:由社交媒体活动推导的新闻货架期曲线 [6]、流行度轨迹预测 [10]、类目级生命周期行为 [13]、流行度动力学 [26, 27, 29]。两条路线对「陈旧性过滤」这一任务都有共同的局限:它们需要已观测的互动,而互动是滞后的,所以陈旧内容仍会被服务;且它们在粗粒度而非 per-item 粒度上建模衰减。SDF 的 PTR 正是为此任务设计的:受数据质量领域「currency metric」[15] 启发,在互动被观测到之前、从多模态内容预测内容级 per-item 的终身流量比,并把它部署为上游过滤器,在陈旧候选消耗下游重计算之前就剪掉它们。
另一条独立路线是文档级新颖性检测 [2, 12, 20, 32],它问的是「一篇新到文档是否给语料增加了新信息」;SDF 的关系型过滤器处理的是其逆问题——一个新物品是否让一个更早的物品变陈旧,通过直接的成对关系判断。
工业界的陈旧性与语料过滤实践。 工业推荐系统通常用静态年龄阈值 + 基于互动的启发式做候选管理,尤其用于控制内容新鲜度。这一模式跨平台反复出现:YouTube 的多漏斗新鲜内容栈 [23] 用年龄与互动计数阈值做新鲜内容卡位;快手的冷启动流水线 [8] 用固定曝光阈值做冷启动 gating;Twitter/X 的开源算法 [22] 在 post-ranking 施加启发式过滤,并有审计工作记录了显著的流行度放大 [3, 30]。尽管模式反复出现,内容级的陈旧性建模在工业界仍未被充分探索,对启发式流水线的依赖让陈旧物品消耗了大量下游算力,代表了主动过滤可以回收的有意义的效率空间。
问题形式化¶
记号:
- $d$:Discover feed 中的一个物品;
- $\mathcal{R}(d)$:与 $d$ 共享主话题(如同一事件或实体)的物品集合;
- $\mathcal{A}$:下游排序器从中选择的候选集。
SDF 持续维护 $\mathcal{A}$:加入到达的物品,移除那些通过两种机制之一变陈旧的物品。关系型过滤器针对取代——一旦更新的、话题相关的到达物让 $d$ 陈旧,$d$ 就被移除;内在过滤器针对相关性衰减——当基于内容的预测表明 $d$ 已衰减过其有用寿命时被移除。下游排序器只消费 $\mathcal{A}$,所以被移除的物品永远不会被服务。
任务 1:关系型陈旧性检测。 学习一个成对预测器
$$f(d, d') \in \{0, 1\} \tag{1}$$
它接收一个已有物品 $d$ 与一个新到达物品 $d' \in \mathcal{R}(d)$,预测 $d'$ 是否让 $d$ 陈旧。一旦对某个 $d'$ 有 $f(d,d') = 1$,就判定 $d$ 陈旧并将其从 $\mathcal{A}$ 中移除。
任务 2:内在陈旧性检测。 对在时刻 $t$ 到达系统的候选物品 $d_t$ 与一个前向视界 $\tau$(自到达起的经过时间),学习一个基于内容的预测器
$$g(d_t, \tau) \in [0, 1] \tag{2}$$
估计 $d_t$ 的预期终身流量中在 $[t, t+\tau]$ 内累积的比例。在稍晚的决策时刻 $t' > t$,令 $\tau = t' - t$ 为 $d_t$ 的经过年龄。当其在该年龄上的预测终身流量份额达到阈值 $\theta$(即 $g(d_t, \tau) \ge \theta$)时,把 $d_t$ 从 $\mathcal{A}$ 移除——这表明 $d_t$ 被预测为已经累积了其终身流量的大部分,继续服务的边际回报递减。
SDF 融合。 令 $\mathcal{R}_{>t}(d_t) \subseteq \mathcal{R}(d_t)$ 表示与 $d_t$ 相关、且在 $d_t$ 之后到达的物品。在决策时刻 $t'$ 的两条移除规则形式化为:
$$S_{\text{supersession}}(d_t) = \mathbb{1}\bigl[\ \exists\, d' \in \mathcal{R}_{>t}(d_t) : f(d_t, d') = 1\ \bigr] \tag{3}$$
$$S_{\text{decay}}(d_t; t') = \mathbb{1}\bigl[\, g(d_t, \tau) \ge \theta \,\bigr], \qquad \tau = t' - t \tag{4}$$
两者的 OR 融合给出联合陈旧性指示:
$$S(d_t; t') := S_{\text{supersession}}(d_t) \ \vee\ S_{\text{decay}}(d_t; t') \tag{5}$$
当 $S(d_t; t') = 0$ 时 $d_t$ 留在 $\mathcal{A}$ 中;任一过滤器触发则 $S(d_t; t') = 1$,$d_t$ 被移除。选择 OR 而非 AND 或加权融合,是因为两种机制在语义上是充分条件而非必要条件:任一机制成立即足以判定陈旧。
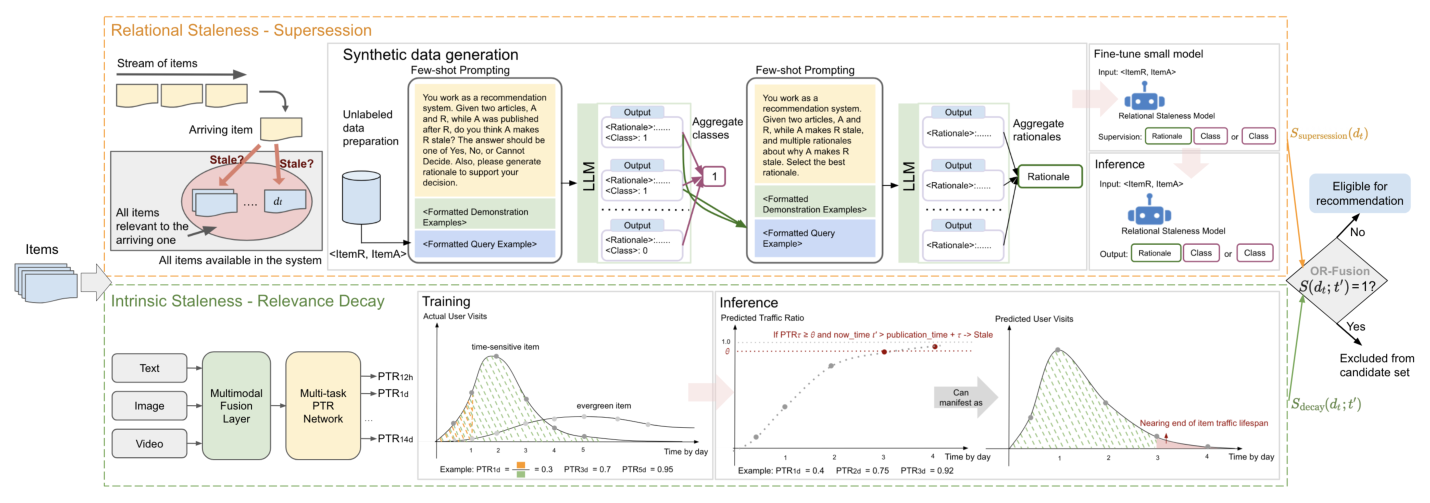
核心方法一:关系型陈旧性检测¶
为在生产资源约束下实现公式 (1) 的成对预测器 $f$,作者把 LLM 教师的知识蒸馏到一个紧凑的 student 模型。流水线分两阶段:先从 LLM 教师合成一个类别平衡的标注 pair 语料,再在这些标签上微调 student。
合成数据生成¶
监督学习需要大规模标注数据,但人工整理不可行:每个 pair 都要求仔细阅读两篇物品。于是作者分两步合成训练集:选择要标注哪些 pair,以及从 LLM 教师获取标签 [9, 14, 21]。
采样(Sampling)。 整理未标注 pair 在两个轴上都非平凡:
- 对内相似度(intra-pair similarity):相似度太高,两物品很可能是信息等价的近重复;太低,则两者无关、其陈旧关系是平凡的。有价值的正样本对(一方取代另一方)只存在于一个狭窄的中等相似度带里。
- 内容冗余(content redundancy):热点话题通常有更多相似物品,因此在不做预过滤时,即使每个 pair 单独看都落在正确的相似度带里,也会生成大量边际价值很低的冗余 pair。
Algorithm 1 同时处理这两个轴:先聚类以限制冗余,再对处于最优相似度区间的 pair 上加权,使得正样本对——尽管在候选总体中只占很小比例——被过采样以产出一个类别平衡的数据集。
Algorithm 1 — 生成未标注物品对 1. 输入:物品集合 $\mathcal{D}$;输出:物品对集合 $\mathcal{P}$ 2. 对 $\mathcal{D}$ 聚类,得到簇集合 $\mathcal{C}$ 3. 对每个簇 $c \in \mathcal{C}$:选出 $c_k$ 个多样化的代表物品,其中 $k \propto |c|$ 4. $\mathcal{I} \leftarrow \bigcup_c c_k$ 5. 定义相似度分数到权重的映射 $M = \{[\sigma_1, \sigma_2), w_1; \dots\}$ 6. 对 $d_1 \in \mathcal{I}$、$d_2 \in \mathcal{I}$:若 $d_1 \neq d_2$ 且来自不同簇,则生成 pair $(d_1, d_2)$;计算该 pair 的相似度 $\sigma$,查表得权重 $w \leftarrow M(\sigma)$ 7. 在候选 pair 上按权重采样,生成 $\mathcal{P}$
标注(Labeling)。 LLM 能通过上下文示范适应任务 [5, 25]。给定一个未标注 pair $\langle d, d' \rangle$ 与关系型陈旧任务的 $K$ 个示范 $\{\langle d^{(j)}, d'^{(j)}, s_j, e_j\rangle\}_{j=1}^{K}$($s_j$ 为类别标签、$e_j$ 为 rationale),作者把它们格式化为 prompt,要求 LLM 解码出同时包含类别与 rationale 的输出序列。
模仿传统人工标注中「多个评分员独立判断再多数投票聚合」的做法,作者对 LLM 抽取多个独立样本并做多数投票 [24]。由于每条标注同时携带类别与 rationale,作者采用两阶段投票:先对类别投票,再通过第二次 LLM 调用在与胜出类别对齐的候选 rationale 中投票。第二阶段之所以重要,是因为即使类别正确,rationale 也可能是错的。
模型训练¶
拿到每个 pair 的类别与 rationale 标注后,作者遵循 LLM 知识蒸馏范式 [28],通过在合成标签上做监督微调,把教师的成对陈旧判断迁移到紧凑的 student。
Student 消费一个 seed prompt:固定任务前缀拼接已有物品 $d$ 与新到物品 $d'$。在 seed prompt 条件下,student 按格式 “{RATIONALE}. Therefore, {CLASS}” 先解码 rationale、再解码类别,仿照 Chain-of-Thought(CoT)解码 [25];但关键差异在于——rationale 是简短的、且直接由教师监督 [17],而不是在推理时才涌现出来。
作者还额外引入自然语言推理(NLI) [4] 参与训练。NLI 要求模型判断假设与前提之间的关系,在结构上与「判断一个到达物品是否取代一个已有物品」是同构的,且提供了一个大规模、人工整理的成对关系判断语料。作者合成的陈旧标签是受教师能力上界约束、且被 Algorithm 1 的采样分布所约束的;而 NLI 让 student 接触到一个更广、独立整理的成对比较分布,强化其判断两段文本输入之间关系的能力。
核心方法二:内在陈旧性检测(PTR)¶
PTR 模型以 $d_t$ 的内容为输入实现公式 (2) 的 $g(d_t, \tau)$,作为内在陈旧过滤器部署,捕捉那些陈旧性来自内在衰减的物品。
训练目标与数据¶
作者取 $t$ 为 $d_t$ 的到达时间,用其索引流水线的标注时间标识,该时间紧密逼近发布时间。作者用物品的用户访问分布作为其相关性衰减的自然代理:一个时间敏感物品会在发布后的短窗口内收集其终身访问的大部分,而常青物品的访问则更均匀地分布在整个寿命上。物品 $d_t$ 在视界 $\tau$ 上的预测流量比定义为在 $t$ 与 $t+\tau$ 之间累积的终身访问份额:
$$\mathrm{PTR}_\tau(d_t) = \frac{\#\ \text{visits in } [t,\ t+\tau]}{\#\ \text{visits over the item's full lifespan}} \tag{6}$$
模型被训练使得 $g(d_t, \tau) \approx \mathrm{PTR}_\tau(d_t)$。两处工程特化把这个概念定义适配到 Discover 的生产使用:
- 分母被操作化为一个固定的 30 天参考窗口,该窗口覆盖 Discover 中大多数内容的寿命;
- 视界 $\tau$ 在一组小而人类可解释的离散偏移上采样:$\tau \in \{12h, 1d, 3d, 5d, 7d, 10d, 14d\}$,选取依据是对齐熟悉的内容生命周期——突发新闻在小时尺度、日常报道在 1 到 3 天、周更内容在 5 到 7 天、慢衰减内容延伸到两周。
直觉解读:$\mathrm{PTR}_{7d}$ 接近 1.0 表示该物品被预测为在发布后一周内收集其终身流量的绝大部分、此后不太可能再吸引流量;低值则表示物品在该视界上仍在吸引流量。
标签来源的关键选择。 PTR 的训练标签由物品的终身访问流量导出,取自匿名化的用户活动日志。作者用搜索点击日志(search-click logs)而非原始页面浏览日志(page-view logs):后者虽然量级更大,但被出版方推广所偏置,难以分离时间敏感与常青分布;搜索点击则反映显式的、及时的用户意图——每次点击都是一次主动的用户选择,信号的是用户感知的相关性而非被动注意力,从而让 PTR 的训练信号与它所建模的相关性衰减现象对齐。标签通过把各视界内的访问数除以 30 天总量得到,因此标签在 $\tau$ 上单调非减。作者过滤掉低于最小流量下限的物品以保证训练标签统计上有意义。最终数据集跨多语言、多格式,覆盖 Discover 的各服务界面。
模型架构与过滤规则¶
作者把 $g(d_t, \tau)$ 实例化为一个带早期融合(early fusion)的多模态多任务网络:输入侧,物品的文本、图像、视频 token 被合并为单一输入送入共享编码器,该编码器由内部多模态预训练骨干初始化,产出一个联合物品表征。表征之上接视界特定的稠密前馈预测头(每个视界一个),一次前向即产出全部 per-horizon 预测。网络以跨视界求和的均方误差(MSE)损失端到端训练。
公式 (4) 表达的是在「与物品当前年龄 $t'-t$ 匹配的理想单一视界」上的衰减决策。实践中 $g$ 是在固定离散视界集合 $\mathcal{T}$ 上训练的,而非 $\tau$ 的连续函数。由于训练标签按构造在 $\tau$ 上单调非减、且 $g$ 在实践中跨 $\mathcal{T}$ 也跟随这一单调性,公式 (4) 特化为在决策时刻 $t'$ 已经流逝的最大训练视界上评估 $g$:
$$S_{\text{decay}}(d_t; t') = \mathbb{1}\left[\ \max_{\tau \in \mathcal{T}}\Bigl( g(d_t, \tau)\cdot \mathbb{1}[\, t' > t + \tau \,]\Bigr) \ \ge\ \theta\ \right] \tag{7}$$
内层指示函数屏蔽尚未流逝的视界;对被屏蔽后的 $g$ 值取 max 即分离出最大的已流逝视界的预测。当该预测达到阈值 $\theta$ 时规则触发,即物品已捕获其终身流量的至少 $\theta$ 比例、继续服务的价值递减。
SDF 的组合与线上服务¶
两个过滤器都依赖非个性化(unpersonalized)、物品级的信号:$f$ 与 $g$ 都不依赖发起请求的用户或除时间之外的任何上下文。它们在用户请求路径之外(off the user-request path)计算,且以足够高的节奏运行使缓存输出保持时效,因此服务时应用公式 (5) 退化为一次针对请求时间戳 $t'$ 的查表,服务时没有任何模型推理。这是整套系统能在数亿日活规模上零延迟代价落地的关键工程前提。
SDF 每天评估数百万新物品的陈旧性。PTR 仅基于内容做 per-item 计算,而关系型过滤器要做成对分类,是两者中计算更重的一个。为在覆盖率与吞吐之间取得平衡,关系型过滤器以两种互补模式运行:
- 在线模式(online mode),针对标注延迟优化:订阅到达物品流,近实时地标注时间敏感物品;使用一个轻量预过滤器丢弃简单负样本(如不相关的 pair),并配合跨不同时间桶的邻居检索以防止近重复物品主导 pair 集合。
- 批处理模式(batch mode),针对吞吐优化:回填长尾与在线模式漏掉的物品,并把一条陈旧标签扩散到同一簇内的其他物品以获得更广覆盖。
实验设置与离线评估¶
作者沿三个轴评估 SDF:逐过滤器的离线评估、在驱动 Discover 上线决策的连续 prevalence-delta 框架下的线上 A/B、以及两年部署在用户举报与服务成本上的结果。
关系型陈旧过滤器的离线评估¶
设置。 遵循内部制度政策,作者用 PaLM 2-L [1] 作为 LLM 标注器。他们人工标注了 300 个类别平衡的 pair 作为开发用黄金集用于 prompt 调优,该集合被留出且与 prompt 中的 few-shot 示范不相交。作者迭代调整 prompt 的指令与示范,直到 PaLM 2-L 在该黄金集上达到 >90% 的精确率与召回率。调优后的标注器对每个 pair 抽取 7 个独立样本并多数投票聚合,产出 1,100,133 个样本(train/val/test = 880,027 / 109,951 / 110,155)。作者指出标注器的残余错误率与广泛使用的基准中被审计出的噪声相当,例如 MMLU 上约 6% [11, 16]。
Student 模型实例化为 T5 [19],从公开可得的 11B checkpoint 微调。训练超参数:batch size 128、学习率 1e−3、20k 训练步、1k warm-up 步。超参数在验证集上调优,指标在测试集上以 Accuracy / Precision / Recall / F1 报告,F1 为主指标。
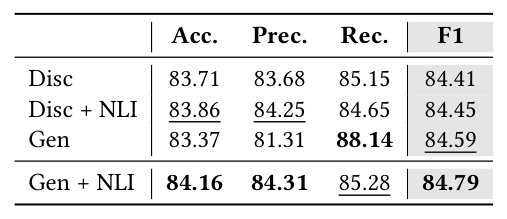
| 配置 | Acc. | Prec. | Rec. | F1 |
|---|---|---|---|---|
| Disc | 83.71 | 83.68 | 85.15 | 84.41 |
| Disc + NLI | 83.86 | 84.25 | 84.65 | 84.45 |
| Gen | 83.37 | 81.31 | 88.14 | 84.59 |
| Gen + NLI(部署配置) | 84.16 | 84.31 | 85.28 | 84.79 |
结论分析。 Table 1 消融了 NLI 辅助训练与 CoT 式 rationale 监督。Disc(判别式) 指 student 只用类别监督训练,Gen(生成式) 指训练同时用教师的 rationale 作为 CoT 式信号监督 student。
- NLI 在两种范式下都提升 F1(84.41→84.45,84.59→84.79),与 §3.2 中「成对关系迁移」的动机一致。作者坦承绝对幅度是 modest 的,但仍完整报告该消融,以便同类应用流水线的研究者与从业者能看到这一设计选择及其经验支撑。
- Gen 在有无 NLI 时都优于 Disc(F1 84.59 > 84.41;84.79 > 84.45),说明在训练时用教师的 rationale 监督 student,比依赖推理时涌现的 chain-of-thought 更有效,且这一收益独立于 NLI 辅助训练。值得注意的是 Gen(无 NLI)的召回率高达 88.14 但精确率只有 81.31——rationale 监督让模型更「敢判陈旧」,而 NLI 把精确率拉回 84.31、代价是召回从 88.14 降到 85.28,最终 F1 最优。这说明 NLI 的实际作用是给生成式范式补上精确率。
- 作者进一步在一个从 Discover 采样、正负平衡、与开发集及训练集均不相交的 550 pair 人工评分黄金测试集上验证已部署模型,取得 83.5% 精确率与 95% 召回率。这个「高召回、中等精确率」的工作点与过滤器的产品定位一致:宁可多剪一些,也不要把陈旧内容漏进候选集。
案例研究¶
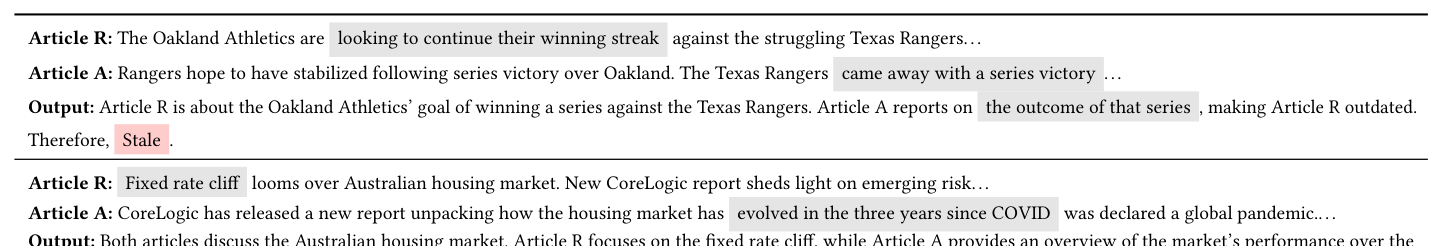
Table 2 展示了关系型过滤器的 CoT 式解码输出,说明生成式表述的一个实用优势:每条预测都附带一段模型解码出的 rationale,暴露出「为什么到达物品让已有物品陈旧、或为什么没有」。
- 判 Stale 的例子:Article R 讲「Oakland Athletics 力求对阵 Texas Rangers 拿下系列赛」,Article A 报道「Rangers 在对 Oakland 的系列赛取胜后有望企稳」。模型输出:Article R 是关于 Athletics 赢下系列赛的目标,Article A 报道了该系列赛的结果,使 Article R 过时。因此,Stale。
- 判 Fresh 的例子:Article R 讲「固定利率悬崖笼罩澳洲房市,CoreLogic 新报告揭示新兴风险」,Article A 讲「CoreLogic 发布新报告,解析 COVID 被宣布为全球大流行三年来房市的演变」。模型输出:两篇都讨论澳洲房市。Article R 聚焦固定利率悬崖,Article A 提供市场过去三年表现的总览。由于 Article A 并未提及固定利率悬崖,它没有让 Article R 陈旧。因此,Fresh。
第二个例子尤其重要:它显示 student 学到的不是「同话题 + 更新 ⇒ 陈旧」的浅层捷径,而是「新物品是否覆盖了旧物品的具体叙事焦点」这一更细的判据。
内在陈旧过滤器的离线评估¶
架构消融:late fusion vs. early fusion。 作者对比一个 late-fusion 基线(文本、图像、视频由各自的每模态编码器处理,输出拼接后送入 per-horizon 稠密头)与 §3.3 部署的 early-fusion 设计(文本、图像、视频 token 合并为单一输入送入共享多模态编码器,再接预测头)。两个变体在相同数据、匹配的优化器与容量预算下训练。在一个经过整理的、带编辑标注时间敏感性的平衡物品池上,作者把每个物品按 $g(d_t, 7d) \ge \theta$ 判为时间敏感。部署的 early-fusion 模型达到 80% 准确率,而 late-fusion 基线为 76%。这 4 个百分点的差距支持了 early-fusion 的选择:联合处理多模态优于逐模态后拼接。
陈旧物品分类。 作者说明:对 PTR 做一个类比关系型分类器的成对留出评测是定义不良的,因为衰减是通过物品的终身流量曲线而非固定的 pair 级标签表达的。因此作者直接把 PTR 评估为一个陈旧物品二分类任务,与其「在阈值 $\theta$ 上作为二分类器」的部署形式匹配。
从一个每个物品由 5 名独立人工评分员标注的留出池中,作者在 $\theta = 0.9$ 上评估公式 (7) 的 PTR 规则;$\theta$ 从操作区间 $\{0.85, 0.9, 0.95, 0.98\}$ 中选取,以在保持高精确率的同时留有足够覆盖。作者在三档扫描评分多数门槛:Majority(≥3/5)、Strong(≥4/5)、Unanimous(5/5) 评分员就物品是否陈旧达成一致,在每一档剔除缺乏强一致的物品。
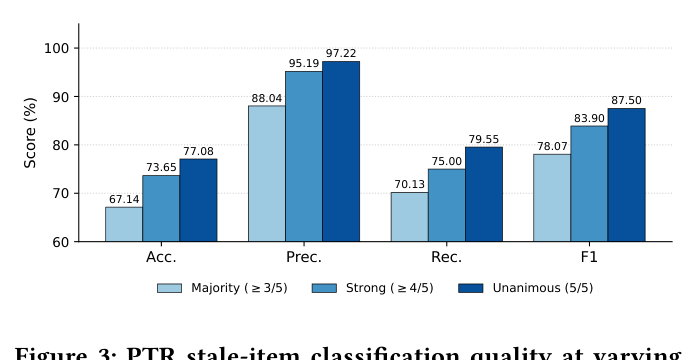
| 多数门槛 | Acc. | Prec. | Rec. | F1 |
|---|---|---|---|---|
| Majority (≥3/5) | 67.14 | 88.04 | 70.13 | 78.07 |
| Strong (≥4/5) | 73.65 | 95.19 | 75.00 | 83.90 |
| Unanimous (5/5) | 77.08 | 97.22 | 79.55 | 87.50 |
结论分析。 随门槛收紧所有指标都上升:更严格的一致性把 ground truth 集合收缩到最清晰的案例,而固定的分类器对这些案例识别得最可靠。F1 从 Majority 档的 78.07% 升到 Unanimous 档的 87.50%;精确率在所有档位都超过 88%(最高 97.22%)。这里的解读要点是:指标上升不代表模型变好了(分类器是固定的 $\theta=0.9$),而是说明模型的错误集中在人类自己也难以达成一致的模糊地带——这恰恰是过滤器在生产中可接受的失败模式。同时,精确率显著高于召回率(88.04 vs 70.13 在 Majority 档)表明 PTR 是一个保守的过滤器:它剪掉的基本都是真陈旧,但会漏掉相当一部分陈旧物品(对应后文「损失」小节中的长尾缓慢衰减问题)。
线上 A/B 实验¶
连续 prevalence-delta 框架¶
用户提交的陈旧性举报太稀疏,无法在任何单个 A/B 实验臂中通过统计置信门槛。 作者因此通过对每个 A/B 实验的对照臂与实验臂、跨连续 4 周每周采样物品并人工评分来度量线上陈旧性。
采样基于每个物品在两臂之间的浏览量差(view delta),限制在最小 view delta 之上并按 delta 幅度加权:promoted(被提升) 物品在实验臂获得的浏览多于对照臂,demoted(被降级) 物品则更少。这种差分采样把评分预算集中在实验臂真正移动了的物品上——这是该框架最巧妙的设计:它绕开了「陈旧举报太稀疏」的统计困境,把测量对象从「用户是否举报」换成「实验实际改变曝光的那批物品有多陈旧」。
每个被采样的物品与一个代表性浏览时间配对,由 5 名独立人工评分员在从「Not at all stale」到「Completely stale」的序数量表上评分,在固定 cutoff 上二值化;当 5 人中至少 3 人评为陈旧时该物品记为陈旧。实验指标把取代与衰减两类陈旧性合并为单一复合指标以保证上线决策的可解释性。评分后分别对 promoted 与 demoted 集合计算陈旧率(stale rate),上线指标是二者之差,即 prevalence delta:
$$\Delta_{\text{stale}} = r_{\text{promoted}} - r_{\text{demoted}} \tag{8}$$
其中 $r_X$ 为集合 $X$ 中的陈旧率。负的、统计显著的 $\Delta_{\text{stale}}$ 意味着陈旧内容在 demoted 集合中比在 promoted 集合中更普遍,即实验臂降低了陈旧性;正值则相反。逐周比率取平均后用于上线汇报。
过滤器 A/B 结果¶
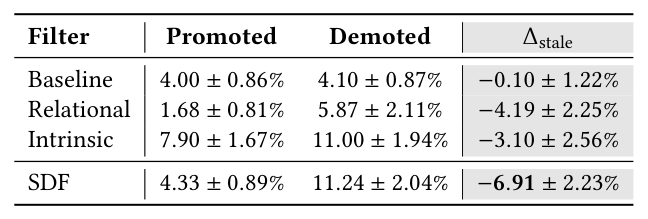
| Filter | Promoted | Demoted | $\Delta_{\text{stale}}$ |
|---|---|---|---|
| Baseline(年龄阈值 + engagement cliff) | 4.00 ± 0.86% | 4.10 ± 0.87% | −0.10 ± 1.22% |
| Relational(关系型过滤器) | 1.68 ± 0.81% | 5.87 ± 2.11% | −4.19 ± 2.25% |
| Intrinsic(内在过滤器) | 7.90 ± 1.67% | 11.00 ± 1.94% | −3.10 ± 2.56% |
| SDF(完整) | 4.33 ± 0.89% | 11.24 ± 2.04% | −6.91 ± 2.23% |
实验纪律。 所有配置被调到 engagement-neutral(互动中性)。作者明确指出:过分激进的剪切可以把陈旧性降得更多,但代价是大幅收缩候选集并损害用户互动,这被显式排除在外。这一约束让 Table 3 的比较具有可比性,也是工业论文里少见的自我设限声明。
结论分析。
- 基线(年龄阈值 + engagement cliff)的 $\Delta_{\text{stale}}$ 只有 −0.10 ± 1.22%,置信区间完全覆盖 0,即统计上与「无效」不可区分。这是全文对传统启发式最有力的一击:不是效果小,而是在互动中性的约束下基本没有效果。
- 在互动中性约束内,SDF 的每个过滤器单独都驱动了统计显著的负 $\Delta_{\text{stale}}$(Relational −4.19%,Intrinsic −3.10%),而完整 SDF 取得最强的降幅 −6.91%。
- 关键推论:−4.19 与 −3.10 之和为 −7.29,与完整 SDF 的 −6.91 非常接近(差异远在置信区间内),说明两个过滤器针对的陈旧机制在很大程度上是不相交的,二者协同良好——这正是「把陈旧性分解为取代与衰减」这一架构决策的经验验证。
- 另一处细节值得注意:Relational 的 promoted 陈旧率只有 1.68%,而 Intrinsic 的 promoted 高达 7.90%。这说明两个过滤器移动的是不同的流量池:关系型过滤器主要作用在新闻类高话题密度内容上(promoted 集合本身就很新鲜),内在过滤器则作用在更广的时间敏感内容上(基础陈旧率更高)。
长期联合 holdback 实验¶
一个两个月的联合 holdback 实验——对一个留出用户群同时关闭两个 SDF 过滤器——量化了在陈旧性移动之外的用户侧影响。相对 holdback,SDF 驱动了:
| 指标 | 变化(95% 置信区间) |
|---|---|
| 用户 dismissal rate(划走率) | −0.16 ± 0.07% |
| Feed diversity(feed 多样性) | +0.13 ± 0.04% |
| Feed positive engagement(正向互动) | +0.26 ± 0.18% |
结论分析。 这一模式与长期系统健康一致:用户划走更少的物品、feed 多样性上升、正向互动提升——而且这一切发生在过滤本身减少了候选量的前提下。最后这一点是关键:过滤器移除候选通常被预期为损害互动的(候选池变小),而这里互动反而上升,说明被移除的陈旧候选本身就是负价值的,它们占据的曝光位置被更有价值的内容取代后净收益为正。需要注意 positive engagement 的置信区间 ±0.18% 相对 +0.26% 的均值偏宽,这一项的显著性弱于前两项。
两年生产部署结果¶
用户举报的两年窗口¶
作者监控 SDF 部署两年窗口内的用户提交陈旧性举报,该窗口覆盖了连续的模型升级与地区(locale)扩展,且用户基数稳定。举报由用户从质量问题菜单中选择 "stale" 提交,随后被归类为取代或衰减。作者同时跟踪 7 天与 28 天滚动平均,其中 28 天视图是官方监控指标,以平滑周内与事件驱动的波动。
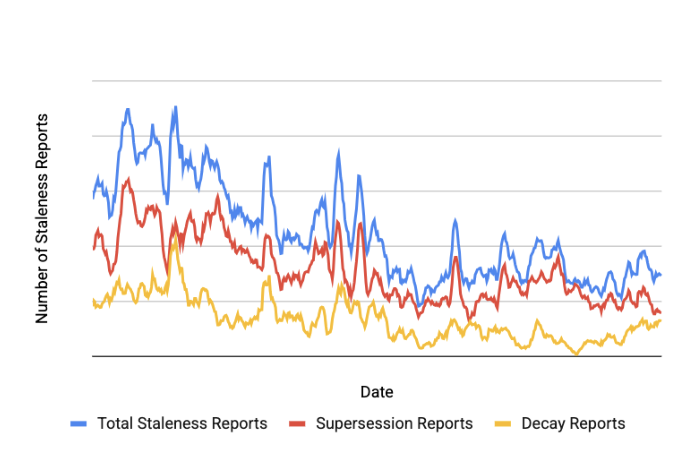
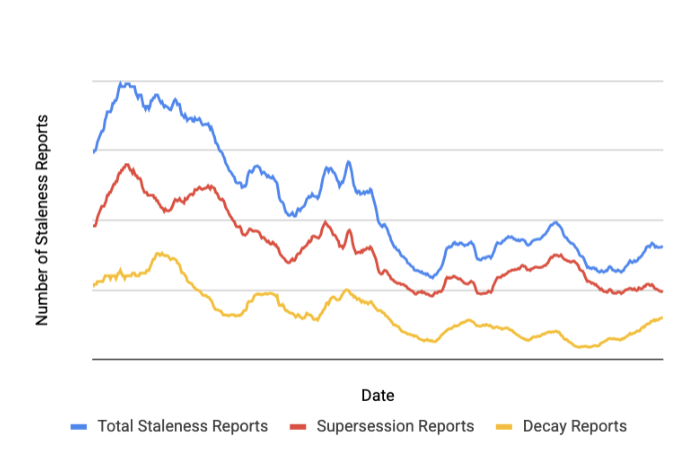
相对窗口起点的部署前基线:
| 举报类别 | 两年降幅 |
|---|---|
| 总陈旧举报 | −54.9% |
| 取代(supersession)类 | −64.0% |
| 衰减(decay)类 | −34.4% |
每一类主要由其对应的过滤器驱动,与 SDF 的架构分解一致。 这一点是全文最有力的证据:举报按机制分类后的下降幅度差异(−64.0% vs −34.4%),与两个过滤器各自的离线能力差异相互印证——关系型过滤器有 83.5% 精确率 / 95% 召回率的高召回工作点,而 PTR 是一个精确率高、召回中等的保守过滤器(Majority 档召回仅 70.13%),因此衰减类举报的下降幅度明显更小。图中两条曲线也可见衰减(黄线)的下降斜率明显缓于取代(红线)。
生产中的成功与失败案例¶
成功(Wins):
- 关系型过滤器正确识别成对新闻取代:「House GOP leaders float new plan」(已有)被「House Republicans failed to agree on a spending plan」(到达)标记为陈旧;「Mazda 3 IPM launching soon?」(已有)被「Mazda 3 prices revealed」(到达)标记为陈旧。
- PTR 正确地在事件窗口结束后丢弃单日物品(Geminid 流星雨指南),在相关期内保留多日物品(普吉岛美食节指南),并不过滤常青物品(NYT 健康教练解释文)。
失败(Losses): 1. 关系型过滤器的成对判断在某些物品上会含混,例如政治评论——这类内容倾向于混合观点与事实,没有哪一篇能干净地取代另一篇。 2. PTR 漏掉了一条缓慢衰减物品的长尾:它们的预测流量比从未达到阈值,因此有些物品在变得中度陈旧后仍未被捕捉。(这与 Figure 3 中 70.13% 的 Majority 档召回率直接对应。) 3. 残余用户陈旧举报中有相当一部分对应的是用户已经在 Discover 或别处看过的内容。这类用户感知的陈旧性(user-perceived staleness)落在 SDF 的取代/衰减范围之外——它是「重复曝光」问题而非「内容失效」问题,需要不同的机制(去重、已读状态、个性化)来解决。
服务成本节省¶
SDF 通过剪枝候选避免了下游的重负载(如 dense scoring)。在 2026 年 Q1 的监控中:
| 组件 | 服务 CPU 与 TPU 小时节省 |
|---|---|
| 关系型陈旧过滤器 | 4.76% |
| 内在陈旧过滤器 | 额外 3.98% |
| 合计 | ≈ 8.74% |
在一个持续更新的语料上,这些效率增益直接转化为等比例的成本削减。这是 SDF 论证中容易被忽略但很重要的一环:过滤层不只是体验优化,它是一个正收益的算力回收机制——把「陈旧性治理」从纯成本项变成了自负盈亏甚至盈余的项目,这对工业系统争取上线资源至关重要。
持续开发方向¶
SDF 部署跨越的两年恰逢 LLM 能力快速演进。作者说明:他们一直在用更新的 LLM 版本渐进升级关系型陈旧模型,而在服务的延迟与成本预算内追平最新 LLM 能力仍是一项持续工作。同时,他们正在用多模态 LLM 推理增强 PTR,并把它扩展到连续视界的寿命表征学习(continuous-horizon lifespan representation learning)——后者正是为了解决公式 (7) 中「离散视界 + max 屏蔽」这一工程近似。
核心贡献总结¶
- 概念贡献:把「陈旧性」分解为取代与衰减两种机制,并论证这两种机制在信号性质上根本不同(关系性 vs 内在性),因此必须用不同的检测方法。这一分解是全文的理论支点,并被「按机制分类的用户举报各自被对应过滤器驱动」的两年数据验证。
- 关系型陈旧过滤器:一条 LLM 教师 → 合成标注(相似度带加权采样 + 聚类去冗余 + 7 样本两阶段投票)→ CoT rationale 监督 + NLI 辅助 → T5-11B student 蒸馏的完整工业流水线,在 550 pair 人工黄金集上达 83.5% 精确率 / 95% 召回率。
- 内在陈旧过滤器 PTR:把「相关性衰减」操作化为从多模态内容预测终身流量比这一可回归的目标,用搜索点击日志(而非页面浏览日志)构造无出版方推广偏置的标签,多任务多视界头 + early fusion 架构(80% vs late fusion 76%)。
- 上游过滤的系统定位:两个过滤器均为非个性化物品级信号,在用户请求路径外计算并缓存,服务时退化为查表。以 OR 融合置于排序阶段上游,既提升体验又回收 8.74% 服务算力。
- 可复用的线上度量方法论:面对「用户举报太稀疏无法通过统计门槛」的困境,提出基于 view delta 差分采样 + 5 人评分的 prevalence delta 框架,并明确在 engagement-neutral 约束下比较。
- 规模化的经验证据:Google Discover(数亿 DAU / 数十亿 MAU)两年部署,用户陈旧举报 −54.9%。
与已归档相关工作的对比¶
Breaking the Loop: An Empirical Comparison of Strategies for Novelty and Freshness in YouTube Music Breaking the Loop: An Empirical Comparison of Strategies for Novelty and Freshness in YouTube Music(Google LLC,2026-07-26)¶
关系:独立并发(本文未引用,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇论文指向同一个 root cause——工业排序器对物品价值的估计由已观测互动驱动,而互动是物品生命周期位置的滞后估计量,于是排序器在时间维度上系统性地误判物品。SDF 把这一滞后表述为「evaluation lags reality → items become stale」,并明确批评 engagement 启发式的 structural lag:「系统只有通过反复把降级体验曝光给用户才能学到某物品已陈旧」;Breaking the Loop 把同一滞后表述为退化反馈闭环:在 logged engagement 上持续重训闭合了「高排名 → 曝光 → 互动 → 下一轮训练进一步强化同一批 item」的环,使新发行在系统 engagement 意义上是 cold 的。两者是同一病因在物品生命周期两端的两个症状:一端是信号尚未积累(新内容被压制),另一端是信号尚未衰减(陈旧内容被延续)。
- 相近的技术骨架:两篇都可抽象为「在排序栈的某一层插入一个非个性化、物品级、时间感知的干预,然后用生产 A/B 度量」,且都因为北极星指标(长期生态健康 / 稀疏用户举报)无法在单臂 A/B 中读出,而各自另造了一套度量方法。Breaking the Loop 的核心方法论正是按施加层组织干预(serving / 训练数据 / 架构 / 探索),每臂只改一层;SDF 则是在这套分层坐标系里选定了「候选集过滤层」这一格并做到极致。
- 本文的差异与推进:Breaking the Loop 的实验给出了 SDF 设计选择的外部验证——它发现 serving 层的启发式 recency boost 虽有真实的 day-1 增益,却会被持续重训的学习闭环在几天内中和,且各臂在 New release 指标上表现相似但曝光跨天摆动更大。SDF 在 Introduction 中独立地给出了同方向的判断:「Time-based ranking demotes rather than removes stale items, forcing users to still scroll past them」,并据此选择硬移除(从候选集 $\mathcal{A}$ 中删除)而非分数降权。SDF 的两年举报下降曲线(−54.9%,且降幅在窗口内保持)正是「过滤层的增益不会被学习闭环中和」的经验证据——因为被过滤的物品根本不产生曝光,也就不产生能被下一轮训练重新拟合的日志。这是本文相对 Breaking the Loop 的实质推进:后者只诊断出「层决定了干预处理哪个症状及其成本」,前者给出了「过滤层为何在时间维度上是持久的」的一个具体实例。
- 可比的方法/实验差异:Breaking the Loop 的干预大多是无学习成本的启发式或架构 auxiliary head(recency boost、指数时间衰减样本加权 $w_t = e^{-\lambda(T-t)}$、position/client bias tower、SNGP 不确定性头),SDF 则为每个机制专门训练了一个重型模型(PaLM 2-L 蒸馏的 T5-11B + 多模态 PTR)。度量上,Breaking the Loop 用两周 A/B 的六个单例臂 + 一个组合臂,SDF 用 4 周连续人工评分的 prevalence delta 加两个月联合 holdback。一个耐人寻味的对照:Breaking the Loop 发现架构去偏与不确定性损失堆叠时在流行度重分配上超加性、却抵消了新发行 lift,而 SDF 的两个过滤器堆叠后近似可加(−4.19 与 −3.10 之和 −7.29 ≈ 完整 SDF 的 −6.91)——差别在于 SDF 的两个组件被显式设计为针对不相交的机制,而 Breaking the Loop 的组合臂中两个干预处理的是同一症状的不同层面。
PinEqualizer PinEqualizer: Full Funnel Content Exploration and Debiasing System at Pinterest(Pinterest, Inc.,2026-07-24)¶
关系:独立并发(本文未引用,两者殊途同归)· 已加载对方精读
- 共同关注的问题:PinEqualizer 的病因诊断与 SDF 同构——整个漏斗普遍存在偏向既有旧内容的 bias,形成 rich-get-richer 反馈回路,新内容因缺乏历史曝光而无法在每一阶段与既有内容公平竞争。这与 SDF 的「互动信号是物品当前价值的滞后估计量」是同一命题的正反两面。更具体的同构点是:两者都认为「候选语料本身需要一个显式的、生命周期感知的管理层」,而不是把问题全部交给排序模型。
- 相近的技术骨架:最强的重合出现在 PinEqualizer 的 corpus selection 阶段与 SDF 的 PTR 过滤器之间。PinEqualizer 用一个 ML 模型从内容与平台外信号预测物品的经验 engagement rate 作为先验 $\alpha$,与经验互动通过 Beta-Binomial 后验均值 $\hat{r} = (\alpha N + e)/(N + n)$ 融合,据此选 top-$K$ 进入 exploration corpus;SDF 的 PTR 则从多模态内容预测物品的终身流量比 $g(d_t,\tau)$,据此把物品移出候选集 $\mathcal{A}$。两者都是「在互动被观测到之前、用内容侧模型预测物品的流量/互动潜力,并据此裁决它是否进入被服务的语料」。更细的对应:PinEqualizer 的 retirement 规则(物品在「累积足够正向互动而毕业」或「互动置信上界低于阈值」时被退出探索)与 SDF 的两条移除规则在结构上完全平行——都是「一个基于累积量的阈值 + 一个基于预测的阈值」。此外两者都因北极星指标是长期的而另建了一套度量框架(PinEqualizer 的 fresh-content holdout → content graduation → under-explored engagement 三层;SDF 的 prevalence delta),且都是两年量级的生产部署。
- 本文的差异与推进:目标方向相反且互补。PinEqualizer 要把内容送进来(350% 新鲜内容曝光增长、成功内容提供者 +99%),SDF 要把内容请出去(陈旧举报 −54.9%、服务算力回收 8.74%)。方法论姿态也不同:PinEqualizer 明确主张「去偏优先于显式探索」——即修正模型对新内容的系统性低估,而非用 UCB / Thompson Sampling 硬塞曝光;SDF 则完全不走去偏路线,而是新造一个正交的、非个性化的判别信号并硬过滤。一个直接的推论是:SDF 的关系型过滤器在 PinEqualizer 的框架里没有对应物——取代关系是 pairwise 的、需要比较两个物品,而 PinEqualizer 的所有组件(内容 embedding、feature dropout、校准、Thompson 采样)都是 per-item 的。这可能是 SDF 最独特的贡献。
- 可比的方法/实验差异:PinEqualizer 的漏斗视角更全(corpus selection → retrieval → ranking → utility 四阶段逐段改进,并配全漏斗瓶颈分析),SDF 只做候选集这一层但把该层做深(两个专门的学习模型 + 在线/批处理双模式服务)。度量上二者都绕开了内容级指标在 user-segmented A/B 中的泄漏问题,但路径不同:PinEqualizer 用 under-explored content engagement volume 作为可在标准用户 A/B 中读出的代理,SDF 用 view delta 差分采样把评分预算集中到实验真正移动了的物品上。两套框架可以直接互补:一个负责生命周期的入口,一个负责出口,且都以候选语料为作用面。
讨论与局限性¶
核心贡献与值得借鉴的设计¶
最值得借鉴的是问题分解本身。 「陈旧」在产品语言里是一个词,但作者论证它在信号性质上是两个问题:一个是关系性的(需要成对比较),一个是内在的(需要内容级回归)。这个分解不是事后总结,而是架构决策的前提——它直接决定了两个组件的模型形态、数据来源、服务模式都不同,也解释了为什么 OR 融合的效果近似可加。工业系统里「一个模糊的产品指标背后是几个机制不同的子问题」是常态,本文给出了一个把这类问题拆开各个击破、并用分机制归因的线上指标(举报按取代/衰减分类)反过来验证分解正确性的完整样板。
第二个值得借鉴的是过滤层的定位。 「在排序前剪枝候选」这个位置同时给出三重收益:用户不用滚动划过降权后仍在的陈旧内容(相比 time-based ranking);被剪的物品不产生曝光,也就不产生能被下一轮训练重新拟合的日志(相比 serving 层的分数调整);下游 dense scoring 的算力被直接省下(8.74%)。这个「三重收益」论证是把体验治理项目做成正收益项目的范式。
第三个是工程约束驱动的设计取舍:非个性化 → 可离线批算 + 缓存 → 服务时零推理,这条推理链让一个 11B student 模型能在数亿 DAU 系统上落地。以及 PTR 用搜索点击日志而非页面浏览日志这个细节——因为后者被出版方推广偏置,无法分离时间敏感与常青分布。这类「标签源选择比模型架构更决定成败」的判断在工业论文里很少被写出来。
局限与争议¶
- 离线消融的绝对幅度很弱,作者自己也承认。 Table 1 中 NLI 带来的 F1 提升只有 0.04(Disc)与 0.20(Gen)个点,Gen vs Disc 也只有 0.18 与 0.34 个点。这些差异没有报告方差或显著性检验,在 110k 测试样本上是否稳健不可知。作者以「为同类流水线的从业者保留经验记录」为由完整报告,态度可取,但不足以支撑「rationale 监督优于推理时 CoT」这一较强的方法论结论。
- PTR 的召回是系统性短板,且被作者列为失败案例。 Majority 档召回仅 70.13%,作者也承认「PTR 漏掉一条缓慢衰减物品的长尾——它们的预测流量比从未达到阈值」。根因在于公式 (7) 的离散视界 + max 屏蔽是一个粗糙近似:物品必须先跨过某个训练视界,其预测才有资格参与判定。对于衰减曲线平缓的物品,任何单一 $\theta$ 都难以在「过早剪掉常青内容」与「漏掉缓慢陈旧内容」之间取到好的工作点。作者提出的「连续视界寿命表征学习」正是针对这一点,但本文未给出结果。
- 两年举报下降的因果归因不够干净。 作者自己说明该窗口「覆盖了连续的模型升级与地区扩展」。−54.9% 中有多少来自 SDF 本身、多少来自同期 Discover 排序系统的其他演进、多少来自 LLM 能力升级带来的关系型模型换代,论文没有做分解。两个月的联合 holdback 是最接近因果的证据,但它测的是 dismissal rate / diversity / engagement,并未报告 holdback 期间的举报量差异——而那才是与 −54.9% 直接可比的量。这是本文实证链条上最明显的缺口。
- 单一大 threshold $\theta$ 的全局性。 $\theta = 0.9$ 是全局固定的,而不同类目、语言、内容格式的衰减曲线形状显然不同(新闻 vs 食谱 vs 常青解释文)。论文提到数据集跨多语言多格式,却没有报告任何按类目/语言的分层结果,也未讨论 per-segment 阈值。考虑到过滤器是硬删除(无法被下游挽回),全局阈值在长尾语料上的风险值得关注。
- 「用户感知陈旧性」超出框架范围,且占残余举报的相当比例。 作者坦承残余举报中有相当一部分是「用户已经看过的内容」。这实际上暴露了 SDF 分类学的不完整:陈旧性至少有三种机制——取代、衰减、重复曝光——而第三种是个性化的(依赖具体用户看过什么),与 SDF 刻意选择的「非个性化物品级信号」架构根本不兼容。这不是实现缺陷而是架构边界:让 SDF 覆盖第三种机制就要放弃「服务时零推理」的核心工程前提。
- 可复现性受限。 PaLM 2-L 教师、内部多模态预训练骨干、搜索点击日志、Discover 语料均不可获得;没有任何公开学术数据集实验。论文的方法论骨架(合成标注 + rationale 蒸馏 + 内容→生命周期流量回归 + OR 融合上游过滤)是可迁移的,但所有数值都不可复现,也无法与外部方法做基准对比。这在工业系统论文中常见,但确实限制了这条路线被学术界接续研究的可能。
工业落地价值¶
本文的落地价值在推荐系统工业论文里属于第一梯队:部署规模(Google Discover,数亿 DAU / 数十亿 MAU)、部署时长(两年,跨模型升级与地区扩展)、可核查的体验指标(用户主动提交的举报量 −54.9%,且按机制拆分为 −64.0% / −34.4%)、可核查的成本指标(服务 CPU/TPU 小时 −8.74%)、明确的工程实现细节(在线/批处理双模式、轻量预过滤器、跨时间桶邻居检索、簇内标签扩散、离线缓存 + 服务时查表)四者齐全。尤其难得的是作者明确写出了工作点选择的产品权衡(engagement-neutral 约束、$\theta$ 从 4 个候选中按「高精确率 + 足够覆盖」选取、高召回低精确率的关系型工作点),以及三条真实的失败模式。对于任何运营时效性内容 feed 的团队,SDF 的分解框架、prevalence delta 度量方法和「过滤层三重收益」论证都可以直接借鉴,且不依赖 Google 的具体模型选型。