A Hierarchical Language Model with Predictable Scaling Laws and Provable Benefits of Reasoning¶
作者与机构:Jason Gaitonde (Duke University)、Frederic Koehler (University of Chicago)、Joonhyung Shin (University of Chicago)、Elchanan Mossel (MIT)、Allan Sly (Princeton University)。arXiv:2605.13687,投稿 2026-05-13。实验代码开源于 https://github.com/joonhyungshin/nanocontext。
这是一篇纯理论 + 合成语言验证的论文,作者阵容是概率论/统计物理方向的核心人物(Mossel、Sly 都是树上广播过程与重构问题的奠基者)。它不提出任何新模型架构,而是回答一个此前只能靠经验回答的问题:自回归语言模型的上下文窗口到底"买"到了什么?推理(reasoning / chain-of-thought)又能在多大程度上替代它? 作者构造了一族分布完全已知且可解析的层次化合成语言(树上广播过程),在其上给出两个方向的定量结论:有界上下文的下界($\Omega(n)$ 上下文才能忠实采样长度 $n$ 的序列)与推理模型的上界($\Theta(\log n)$ 位工作记忆即可精确采样),中间相差一个指数。最关键的是,用真实 transformer 训练出来的曲线在很宽的上下文范围内定量吻合渐近理论预测。
一、研究动机与背景¶
1.1 上下文窗口:中心设计参数,却缺乏定量理论¶
上下文窗口大小是现代 LLM 最核心的设计参数之一:
- 更长的上下文允许捕捉更长程的依赖(Vaswani et al., 2017);
- 它是 reasoning / chain-of-thought 范式的前提(Xiong et al., 2024;Guo et al., 2025 的 DeepSeek-R1;Jaech et al., 2024 的 OpenAI o1);
- 经验上,上下文长度与预测损失之间服从 scaling law(Kaplan et al., 2020;Hoffmann et al., 2022)。
同时它也极其昂贵:注意力关于上下文长度是二次代价,这直接催生了 FlashAttention(Dao et al., 2022)、线性注意力(Katharopoulos et al., 2020)、Linformer(Wang et al., 2020)、DeepSeek-V3.2(Liu et al., 2025)等一整条研究线。
但作者指出:尽管上下文长度如此中心,"上下文长度到底买到了什么、什么时候推理可以替代它"这个问题一直缺乏尖锐的理论刻画。核心障碍非常朴素——真实语言的底层分布是未知的,因此我们根本无法对"生成出来的文本"提出可以严格回答的定量分布性问题。
1.2 破局思路:造一个分布已知且可解析的层次化语言¶
本文的做法是把问题挪到一族合成语言上,这族语言由 $d$ 叉树上的广播过程(broadcast process on trees) 生成:根节点从先验中采样一个 token,然后沿着一个含噪信道逐层向下传播,直到 $d^h$ 个叶子;叶子序列就是观测到的"句子"。
作者特别强调一点区分:这个对象不是"形式语言"(合法字符串的集合),而是字符串上的一个概率分布——而后者才是生成式预训练通过极大似然真正逼近的目标。这一区分把本文与"transformer 表达力 / 形式语言"那条研究线彻底分开了(见 §1.4)。
1.3 层次结构的语言学正当性¶
作者用了相当篇幅论证"树结构表征语言"并非人为设定,而是一条贯穿语言学与 NLP 的长传统:
- 19 世纪教学语法中的层次化句子图解(Reed and Kellogg, 1877);
- 直接成分分析(immediate constituent analysis)形式化了"句子递归分解为嵌套成分"的观点(Bloomfield, 1933;Wells, 1947);
- Chomsky (1957) 与 Tesnière (1959) 都用层次树表示句子;组合语义通过递归组合子树含义来赋予整句含义(Montague, 1970);
- NLP 继承了这一视角:概率上下文无关文法(Jurafsky and Martin, 2026)、树库解析(Marcus et al., 1993 的 Penn Treebank)、树结构神经网络(Socher et al., 2013;Tai et al., 2015 的 Tree-LSTM)。
在广播模型中,潜在的内部节点扮演未观测的句法/语义结构的角色:它们不出现在输出里,却约束了其子树下所有叶子 token。解析树、语义依存、篇章结构都在不同尺度上强加了长程相关——这正是本文要刻画的"多尺度依赖"。
1.4 与三条已有研究线的关系¶
(a) 层次化生成模型与深度的必要性。 Mossel (2016) 最早提出用树上广播过程作为研究"为何需要深度"的数据分布,并指出其重构算法可由系统发生学(phylogenetic reconstruction)已有结果导出,且在 Kesten–Stigum 界以下的半监督设定中给出了分离。后续工作在同一区域建立了低次多项式硬度(Koehler and Mossel, 2022;Huang and Mossel, 2024, 2025)。物理方向的工作(Cagnetta et al., 2024 的 Random Hierarchy Model;Tomasini and Wyart, 2024)分析了变体并实验展示梯度下降与扩散方法能在"易"区域(KS 界以上)学到该模型;Ren et al. (2026) 证明了深度卷积网络配合逐层训练可以高效学习这一类。
(b) 形式语言与 transformer 的表达力。 一批工作从形式语言与最坏情况复杂度角度研究 transformer 的表征能力:Pérez et al. (2021)、Barceló et al. (2023)、Chiang et al. (2023)、Chen et al. (2025)、Merrill and Sabharwal (2023a,b)。例如 Merrill and Sabharwal (2023b) 证明对数精度 transformer 落在 $\mathsf{TC}^0$ 内;而 Pérez et al. (2021)、Merrill and Sabharwal (2023a)、Feng et al. (2023) 证明具备生成中间状态(即 CoT)能力的 transformer 是图灵完备的——甚至线性 next-token predictor 加上 CoT 也图灵完备(Malach, 2023)。
本文与之的关键差异:上述结论基本都是存在性的,说的是"存在这样的参数"。但存在性不蕴含标准训练方法(乃至任何方法)能从样本中高效学到它——带噪奇偶(noisy parity,Blum et al., 2003)这类猜想困难例子说明,即使概念极易表示,学习也可能是密码学困难的。相比之下,本文能实验证明真实 transformer 架构在常规 next-token-prediction 训练下的行为与理论预测高度吻合。
(c) CoT 的学习理论视角。 Malach (2023)、Joshi et al. (2025) 研究了 CoT 对学习的计算/统计可解性的影响,其重要发现是:在训练数据中加入 $O(\log n)$ 长度的短推理轨迹,可以让自回归模型学会像"带噪奇偶"这类去掉轨迹后密码学困难的函数。本文的推理收益在形式上相似(也是 $O(\log n)$ 长度的轨迹),但底层机制截然不同:Malach/Joshi 的机制是计算性的,而本文的机制是统计性的——没有推理轨迹时,亚线性上下文窗口的 transformer 会渐进地丢失关于过去的信息,从而生成错误的语言分布。这一点由本文语言的层次结构驱动(信息天然在不同长度尺度上流动),而这恰恰是稀疏奇偶这类构造所缺乏的。
(d) 其他。 本文的推理构造部分属于 context compression / compaction 范式;作者直接引用了 Anthropic (2025) 关于 Claude Code 等应用中上下文工程重要性的讨论。$k$-gram ansatz 则部分受 Sharan et al. (2018)《Prediction with a short memory》启发——后者证明了对于长尺度互信息有界的语言,简单 $k$-gram 模型有正面结论。
二、核心方法:树上的广播过程与 $k$-gram ansatz¶
2.1 广播模型(Definition 2.1)¶
记 $T_{d,h}$ 为高度 $h$ 的 $d$ 叉树,$\Sigma$ 为有限 token 集。非根节点按层索引,第 $\ell$ 层节点写作 $r \in [d]^{\ell}$。给定 $\Sigma$ 上的概率转移核 $\kappa$(称为广播信道)与根先验 $\nu$,$(d,h,\kappa,\nu)$-广播过程如下生成:
- 采样根值 $X_{\emptyset} \sim \nu$;
- 给定第 $\ell \le h-1$ 层的值,对 $r \in [d]^{\ell+1}$ 独立采样
$$\mu_r(\sigma) = \kappa\big(X_{r[1:\ell]},\, \sigma\big), \qquad \sigma \in \Sigma. \tag{1}$$
记 $X_L \in \Sigma^{d^h}$ 为叶子上的 token 序列。$(d,h,\kappa,\nu)$-语言定义为 $X_L$ 的分布,即 $\Sigma^{d^h}$ 上的一个概率测度。$\nu$ 省略时取平稳分布。
本文研究两个具体实例:
Ising 广播过程(软约束语言):$\Sigma = \{-1,+1\}$,Rademacher 先验,信道为
$$\kappa(\sigma, \sigma') = \begin{cases} \dfrac{1+\rho}{2} & \sigma = \sigma', \\[4pt] \dfrac{1-\rho}{2} & \text{otherwise,} \end{cases} \tag{2}$$
其中 $\rho \in [0,1]$ 是相关参数。等价描述:孩子以概率 $\rho$ 复制父亲的自旋,以概率 $1-\rho$ 重新均匀随机化。这建模的是软的全局相关——每个序列都有正概率,生成序列与真语言的差异是统计性的而非逻辑性的。
Coloring 广播过程(硬约束语言):$\Sigma = [q]$,均匀先验,信道为
$$\kappa(\sigma, \sigma') = \begin{cases} 0 & \sigma = \sigma', \\[4pt] \dfrac{1}{q-1} & \text{otherwise.} \end{cases} \tag{3}$$
即孩子随机挑一个与父亲不同的颜色。这建模的是硬逻辑约束,类比代码或形式数学中语法/逻辑规则排除整类序列的情形。该过程在概率与统计物理中已被广泛研究(Kesten and Stigum, 1966;Higuchi, 1977;Spitzer, 1975;Evans et al., 2000;Mossel, 2004;Mézard and Montanari, 2006)。
2.2 自回归广播过程(Definition 2.2):有界上下文的数学替身¶
这是全文的核心建模步骤。给定 $d, h, \kappa$,上下文深度为 $w \le h$ 的 $(d,h,\kappa)$-自回归广播过程如下生成 $X_L \in \Sigma^{d^h}$:
- 从 $(d,h,\kappa)$-广播过程在(任意)一个大小为 $d^w$ 的子树上的边缘分布采样 $Y_1 \in \Sigma^{d^w}$;
- 对 $r = 2, \dots, d^{h-w}$:先从 $T_{d,h}$ 中深度 $w$ 的相邻子树之间的最近公共祖先(LCA)高度分布独立采样 $h_r \in \{1,\dots,h-w\}$,再在"两子树 LCA 恰在高度 $h_r$"的条件下、给定 $Y_{r-1}$ 采样 $Y_r$。
最终样本为 $X_L = (Y_1, \dots, Y_{d^{h-w}})$。
直观理解:该过程一次生成一棵大小为 $d^w$ 的子树,每步只条件于前一棵子树。下一棵子树的条件分布通过对"相邻子树 LCA 高度的条件分布"求平均从原广播过程模拟出来——也就是说,生成步骤按照 $T_{d,h}$ 中随机一对相邻子树的真实分布来采样。
作者坦承这与逐 token 的自回归略有不同(一次生成一棵深度 $w$ 的子树在数学上更优雅),并明确说明:预期逐 token 的情形结论相同,代价是更复杂的证明;而实验恰恰是按逐 token 跑的。
2.3 $k$-gram ansatz:为什么可以用它替代 transformer¶
考虑这样的模型:给定空提示或高度为 $w$ 的 $d$ 叉树的叶子,输出(随机的)高度为 $w$ 的 $d$ 叉树的叶子。它对应一个转移核
$$p(\cdot \mid -) : \Sigma^{d^w} \cup \{\emptyset\} \to \mathcal{P}(\Sigma^{d^w}), \tag{4}$$
等价于具有 $\Theta(d^w \log|\Sigma|)$ 位上下文的模型。自回归运行 $d^{h-w}$ 次即得 $\Sigma^{d^h}$ 中的一个序列。
关键论证在于训练数据的构造方式:
- 采样 $T_{d,h}$ 的一个 $(d,h,\kappa)$-语言样本 $X_L$;
- 从 $[d^{h-w}]$ 中均匀采样子树索引 $i$;
- 若 $i \ge 2$,输入为第 $i-1$ 棵子树的叶子 $Y_{i-1}$,输出为第 $i$ 棵子树的叶子 $Y_i$;若 $i=1$,输入为空提示。
由于模型每步只能看到高度 $w$ 的子树,这等价于在 $(d,h,\kappa)$-自回归广播过程上训练,而最优模型将精确生成该自回归广播过程。于是问题被彻底化归为:比较真广播过程(Definition 2.1)与其马尔可夫化变体(Definition 2.2)的统计量。作者把这一替换称为 exact $k$-gram ansatz——用"只依赖前 $k$ 个 token 的最优自回归过程"替代上下文长度为 $k$ 的 transformer。
$k$-gram 模型在一般情形下(大 $k$)统计与计算上都不可行(Shannon, 1948),但在这个层次化模型里 $k$-gram 的分布是可解析处理的,从而可以导出生成序列分布统计量的显式 scaling law。§4 的实验则反过来验证这一 ansatz 本身:真实 transformer 的曲线确实与理想 $k$-gram 过程的曲线重合。
三、理论结果¶
3.1 Ising 过程:方差的对数线性标度与高斯化¶
背景:Kesten–Stigum 阈值。 定义
$$q_h := q_h(d,\rho) = \mathbb{E}\big[\mathbb{E}[X \mid Y]^2\big], \tag{5}$$
其中 $(X, Y)$ 分别是深度 $h$ 广播过程的根与叶子。$q_h$ 是"给定叶子对根的(平方)重构优势"。经典结论(Kesten–Stigum,见 Bleher et al., 1995):当 $d\rho^2 < 1$ 时 $q_h \to 0$;当 $d\rho^2 > 1$ 时 $\lim_{h\to\infty} q_h = q_* > 0$。证明用到 $\mathbb{E}[X\mid Y^t]$ 构成后向鞅、$L_2$ 范数单调下降,以及 $d_{TV}(Y_1^h, Y_{-1}^h) \le \sqrt{q_h}$。
对 Ising 语言,自然的统计量是 token 之和的方差(按 $d^{h/2}$ 归一化)——它度量语言的全局对齐/相干性。
Theorem 3.1(下界,方差标度律)。设 Ising 广播过程满足 $d\rho^2 > 1$。给定上下文深度 $0 \le w \le h$,令 $X_L$ 为上下文长度 $d^w$ 的自回归过程的叶子样本。若 $w \to \infty$ 且 $h - w \to \infty$,则
$$\log\left( d^{-h} \cdot \mathrm{Var}\left(\sum_{i=1}^{d^h} (X_L)_i \right) \right) = w \log(d\rho^2) + \log\big(A_{d,\rho}(2)\big) + o(1). \tag{6}$$
相比之下,若 $X_L$ 来自真 Ising 广播过程(即 $w = h$),则
$$\log\left( d^{-h} \cdot \mathrm{Var}\left(\sum_{i=1}^{d^h} (X_L)_i \right) \right) = h \log(d\rho^2) + \log\big(C_{d,\rho}(2)\big) + o(1), \tag{7}$$
其中 $C_{d,\rho}(2) \le A_{d,\rho}(2)$ 是只依赖 $d,\rho$ 的显式常数。
两个常数为
$$C_{d,\rho}(2) := \left(1 - \frac{1}{d}\right)\cdot \frac{d\rho^2}{d\rho^2 - 1}, \qquad A_{d,\rho}(2) := C_{d,\rho}(2) + \frac{2\alpha_*}{1 - \alpha_* q_*}. \tag{8}$$
含义解读(作者原话的两层):
- 全局相干性的多项式损失。自回归过程按定义产生正确的局部边缘分布,但其全局相干性比真语言多项式地小,除非上下文占了语言的线性比例($w = h - O(1)$)。作者给了一个非常贴切的自然语言类比:这就像面对一个是非问题,生成一段冗长而含糊、始终不表态的回答,而不是干净地承诺一个方向。
- 预测是精确定量的。log-方差关于 $w$ 线性,斜率恰为 $\log(d\rho^2)$——实验中训练出的 transformer 紧密确认了这一点。
由于语言长度 $n = d^h$,$w$ 与 $h$ 只差 $O(1)$ 意味着上下文长度 $d^w = \Omega(n)$,这就是摘要中 $\Omega(n)$ 上下文下界的来源。
Theorem 3.2(下界,高斯化)。同样设定下,若 $w \to \infty$ 且 $h - w \to \infty$,则 $\sum_i (X_L)_i$ 的超额峰度满足
$$\mathrm{Kurt}\left(\sum_{i=1}^{d^h}(X_L)_i\right) - 3 := \frac{\mathbb{E}\big[\sum_i (X_L)_i\big]^4}{\Big(\mathbb{E}\big[\sum_i (X_L)_i\big]^2\Big)^2} - 3 = o(1). \tag{9}$$
高斯分布的峰度恰为 3。Theorem 3.2 说的是:有界上下文自回归在这个层次化语言中造成的信息衰减足够快,以至于中心极限型行为浮现——生成的和表现得像各子树近似独立贡献之和,尽管真语言具有重尾的多尺度依赖。
值得强调一个容易读反的点:这里"收敛到高斯"是退化信号而非好事。真语言因为根自旋的全局对齐,其和呈强双峰分布(超额峰度显著为负,实验中约 $-1.73$,接近 Rademacher 的 $-2$);自回归过程把它抹平成高斯(超额峰度 $\to 0$),恰恰说明全局承诺(global commitment)消失了。
证明骨架¶
(i) 等价 Markov chain。 由于 $Y_i$ 边缘上就是一个正常广播过程的样本,可以等价地把从第 $i$ 到第 $i+j$ 棵子树的过程写成
$$Y_i \to X_i \to X_{i+1} \to Y_{i+1} \to X'_{i+1} \to X_{i+2} \to Y_{i+2} \to \cdots \to Y_{i+j}, \tag{10}$$
其中 $X_\ell$ 是第 $\ell$ 棵子树的根。$X_i$ 与各 $X'_{i+\ell}$ 由"给定叶子的根后验"采样得到;$X'_{i+\ell} \to X_{i+\ell+1}$ 则是先采样 LCA 高度 $h_{i+\ell}$、再以 $1 - \rho^{2h_{i+\ell}}$ 的概率重随机化。
(ii) 相邻子树的信号强度。 令 $\alpha := \alpha_{h-w} = \mathbb{E}[\rho^{2h'}]$,$h' \sim D_{h-w}$ 为相邻子树 LCA 高度分布。Proposition B.3 证明:$D_h$ 依分布收敛到 $\mathrm{Geom}(1/d)$(因为在本文的叶子编码下,相邻叶对的 LCA 恰由 $\ell \in [d]^h$ 最后一个不等于 $d$ 的分量决定,无进位),故 $\alpha \to \alpha_* := \mathbb{E}_{s\sim \mathrm{Geom}(1/d)}[\rho^{2s}] < 1$。
(iii) 关键引理:根自旋相关的几何衰减。
$$\mathbb{E}[X_i X_{i+j}] = \alpha \,(\alpha q_w)^{j-1}. \tag{11}$$
这里的机制非常清晰:跨越一棵子树时,信号必须先从根广播到叶子、再从叶子重构回根,每跨一次就付出一个 $q_w$ 因子(式 (5) 的重构优势),再叠加一次 $\alpha$(LCA 随机化)。由于 $\alpha_* q_* < 1$,相关性关于子树距离几何衰减——这正是"有界上下文渐进丢失过去信息"的精确形式。
(iv) 子树和的互相关。 条件于根自旋后子树和条件独立,故
$$\mathbb{E}[Z_i Z_{i+j}] = M_{d,\rho,w}(1)^2 \cdot \alpha \cdot (\alpha q_w)^{j-1}, \qquad Z_i := \sum_{\ell=1}^{d^w}(Y_i)_\ell . \tag{12}$$
(v) 真语言的矩递推。 定义 $M_{d,\rho,h}(k) := \mathbb{E}\big[(\sum_{i\in[d]^h} X_i)^k \mid X_\emptyset = +1\big]$。一二阶矩是初等的:
$$M_{d,\rho,h}(1) = (d\rho)^h, \qquad M_{d,\rho,h}(2) = d^h + d^h\left(1 - \frac 1d\right)\sum_{\ell=1}^{h}(d\rho^2)^{\ell}. \tag{13}$$
其中第二式用到 $\mathbb{E}[X_\ell X_{\ell'}] = \rho^{2\,\mathrm{LCA}(\ell,\ell')}$ 以及 Proposition B.2(与给定叶子 LCA 距离为 $k$ 的叶子数为 $d^k - d^{k-1}$)。三阶、四阶矩通过对根的 $d$ 棵子树和 $Z_1,\dots,Z_d$ 按"重复索引模式"分组递推得到(同一子树取三次 / 两个子树 / 三个不同子树等),结论是 $M_{d,\rho,h}(k) = (1-o(1))\, C_{d,\rho}(k)\,(d\rho)^{kh}$。
(vi) 汇总。 直接展开方差:
$$\mathrm{Var}\left(\sum_{i=1}^{d^{h-w}} Z_i\right) = d^{h-w} M_{d,w}(2) + (1-o(1))\cdot \frac{2\alpha_*}{1-\alpha_* q_*}\cdot (d\rho)^{2w} d^{h-w} = (1-o(1))\, A_{d,\rho}(2)\,(d\rho)^{2w} d^{h-w}. \tag{14}$$
四阶矩的展开需要枚举 $Z_i^4$、$Z_i^2Z_j^2$、$Z_i^3Z_j$、$Z_i^2Z_jZ_k$、$Z_iZ_j^2Z_k$、$Z_iZ_jZ_kZ_\ell$ 六类项(其中 $Z_iZ_j^2Z_k$ 项只需一个上界,被证明是低阶的 $O(d^{h-w}(d\rho)^{4w})$),最终得到
$$\mathbb{E}\left[\left(\sum_{i=1}^{d^{h-w}} Z_i\right)^4\right] = (1-o(1))\cdot A_{d,\rho}(4)\cdot d^{2(h-w)}(d\rho)^{4w}, \qquad A_{d,\rho}(4) = 3\,A_{d,\rho}(2)^2. \tag{15}$$
因子恰好是 3——正是高斯的四阶矩关系,Theorem 3.2 立即得证。
3.2 Coloring 过程:冻结相下的非法生成¶
Ising 刻画的是软约束语言:所有序列都有正概率,生成序列与真语言的差异是统计性的。但很多真实应用涉及硬约束语言——代码、形式数学、结构化数据中,逻辑或语法规则排除整类序列。Coloring 广播过程是这一设定的干净抽象:合法序列恰好对应能延拓为整棵树的合法着色的叶子标注。
冻结(freezing)现象是着色理论的核心相变(Mossel and Peres, 2003;Semerjian, 2008;Sly, 2009):当分支因子 $d$ 相对颜色数 $q$ 足够大时,一棵子树的叶子已经包含足够信息把所有内部标注(包括根)唯一钉死。本文用的是 Sly (2009) Lemma 7 的定量版本:若
$$d \ge q\big(\log q + \log\log q + o_q(1)\big), \tag{16}$$
则以至少 $1 - 1/\log q$ 的概率,$\mathrm{Law}(X_\emptyset \mid X_L) = \delta_i$,其中 $i$ 是边缘均匀的颜色。
另需一条简单引理:
Lemma E.1:设根为 $X_\emptyset$、其孩子为 $X_1,\dots,X_d$。给定第一个孩子 $X_1$ 上的任意分布 $\nu$,$X_2$ 的后验对每一种颜色都被 $\dfrac{q-2}{(q-1)^2}$ 下界。
(证明:给定 $X_1$,$X_\emptyset$ 后验均匀于 $[q]\setminus\{X_1\}$;再给定 $X_\emptyset$,$X_2$ 均匀于 $[q]\setminus\{X_\emptyset\}$。对任意目标色 $i$,有 $q-2$ 个 $X_\emptyset$ 取值使 $X_2 = i$ 的概率为 $1/(q-1)$,而每个这样的取值本身概率至少 $1/(q-1)$。)
Theorem 3.3(下界,非法生成)。考虑 $q$ 色的自回归着色广播过程,$T_{d,h}$ 上任意上下文深度 $w < h$,且 $$d > q\big(\log q + \log\log q + 1 + o_q(1)\big). \tag{17}$$ 则以概率 $1 - o_q(1)$,自回归着色过程采样出的叶子与 $T_{d,h}$ 的任何合法着色都不相容。
证明骨架(coupon collector):取深度 $h-w-1$ 的一个内部节点 $v$,其 $d$ 个孩子各对应一棵大小 $d^w$ 的子树。由冻结定理,每棵子树的根 $X_i$ 以至少 $1-1/\log q$ 的概率被自己的叶子钉死为一个具体颜色;由 Lemma E.1,无论前一棵子树的条件如何,$X_i$ 取任一颜色的概率至少 $(q-2)/(q-1)^2$。于是"$v$ 存在合法颜色"要求存在某种颜色没有被任何一个孩子占用,联合界给出
$$\Pr\big(\exists i \in [q]:\ i \text{ 对 } v \text{ 合法}\big) \le q\left(1 - \left(1 - \frac{1}{\log q}\right)\frac{q-2}{(q-1)^2}\right)^{d} \le \frac{1 + o_q(1)}{\log q}. \tag{18}$$
解释:有界上下文下,自回归过程在每棵子树内部自洽,却无法跨子树维持全局一致性——冻结在一棵子树叶子处所做的"承诺",与另一棵子树的承诺一般性地冲突。作者的类比精准:每个函数都能单独编译通过,但整个程序编译不过。在自然语言的类比里,每棵子树对应一个局部连贯的片段,但整个序列不存在任何全局合法的解析树。
Remark E.1(阈值不可下推):作者指出,降到冻结阈值以下不太可能还得到同样的非法结论——因为该界对冻结是紧的,一旦跌破,冻结概率关于树高双指数衰减。最容易看清的是 $d = q-1$:深度 $h-1$ 的父节点被冻结的概率量级为 $e^{-q}$;沿递归传播,深度 $h-w$ 的节点与叶子不相容的概率量级为 $\exp(-\Theta(q^w))$,只有在极小的上下文深度 $w$ 下才可能被节点数量抵消。
3.3 推理的指数优势(上界)¶
推理模型的形式化:在普通自回归模型上附加一个工作记忆——一个有限状态集 $M$,模型可在生成步骤之间自由读写,其内容不属于最终输出。模型是转移核
$$p(\cdot \mid -) : \big(\Sigma^{d^w} \cup \{\emptyset\}\big) \times M \to \mathcal{P}\big(\Sigma^{d^w} \times M\big). \tag{19}$$
记忆规模 $\log|M|$ 就是相关的"推理预算",类比真实 LLM 中 chain-of-thought 轨迹的长度。
Theorem 3.4(上界)。对任意 $0 \le w \le h$,$|M| = (d|\Sigma|)^{O(h-w)}$ 足以精确采样 $(d,h,\kappa)$-语言。特别地,取 $w = 0$,存在上下文规模 $O(h\log(d|\Sigma|))$ 的自回归推理模型能从真语言采样。
该结论与广播信道 $\kappa$ 无关。 构造(附录 F)取
$$M = \big(\Sigma^{h-w} \cup \{\emptyset\}\big) \times [d]^{h-w}, \tag{20}$$
其中 $\Sigma^{h-w}$ 分量编码从整棵树的根到当前子树根的路径上的值,$[d]^{h-w}$ 分量编码下一棵子树的索引。初始状态 $(\emptyset,(1,\dots,1))$。给定 $M=(P,r)$,采样下一批叶子 $Y'$ 与下一状态 $M'=(P',r')$ 的流程是对定义语言的树做深度优先搜索(DFS):
- 若 $r=(1,\dots,1)$,沿 $\kappa$ 递归采样 $X_\emptyset, X_{(1)}, X_{(1,1)}, \dots, X_r$;否则取最大的 $j$ 使 $r_j > 1$,由归纳假设 $P$ 的第 $j$ 分量已是观测到的 $X_{r[1:j-1]}$,从它出发递归采样 $X_{r[1:j]}, \dots, X_r$;
- 以 $X_r$ 为固定根值采样 $(d,w,\kappa,\delta_{X_r})$-语言,得到 $Y'$;置 $P' = (X_\emptyset,\dots,X_{r[1:h-w-1]})$;
- 取最大的 $k$ 使 $r_k < d$,置 $r' = (r_1,\dots,r_k+1,1,\dots,1)$;若不存在则重置 $r'=(1,\dots,1)$。
直觉:记忆只需携带"从根到当前生成位置的路径"信息——具体说是采样下一棵子树的真条件分布所需的 $O(h)$ 个祖先与近邻兄弟的标注。这是 $O(h\log(d|\Sigma|)) = O(\log n)$ 位状态,比非推理模型所需的 $\Omega(n)$ 上下文指数级地小。
作者把这一结果直接接回工程实践:这为现代 LLM 的上下文压缩现象提供了一个干净的理论对应物——只要底层分布具有可压缩的层次结构,一小块精心选择的工作记忆就能替代一个大得多的上下文窗口(引 Anthropic, 2025)。
四、实验设置¶
4.1 标点化 tokenization¶
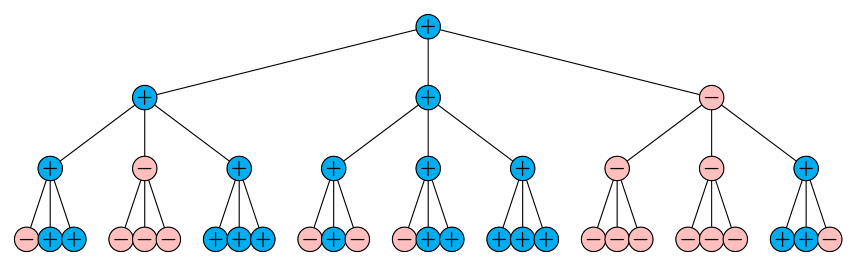
本文语言是 $d$ 叉树 $d^h$ 个叶子的序列,内部节点潜在。为了让有界上下文模型能定位自己在层次结构中的位置,作者每 $d$ 个值插入一个标点 token,"告诉模型某棵子树结束、新子树开始",并且不同高度的子树用不同的标点 token——类比自然语言文档在不同尺度上用逗号、句号、换行标记结构。
token 集为 $T = \Sigma \sqcup P$,$P = \{p_1,\dots,p_{h-1}\}$。含标点后,一棵高度 $h$ 的 $d$ 叉树的 tokenization 长度为
$$L = d^{h-1}(d+1) - 1. \tag{21}$$
第 $m$ 个 token 由展开 $m = r_0 + (d+1)\sum_{i=1}^{h-1}(r_i-1)d^{i-1}$(唯一)确定:$r_0 \ge 1$ 时 $\tau_m = X_{(r_{h-1},\dots,r_0)}$;$r_0 = 0$ 时 $\tau_m = p_{\zeta(m)}$,其中 $\zeta(m) = \max\{i : r_j = 1 \ \forall\, 1\le j < i\}$。
作者强调:理论结果只涉及叶子值的边缘分布,不受这一 tokenization 选择影响。
4.2 训练协议¶
基座模型:nanochat(Karpathy, 2025)。默认配置下 nanochat 会依据给定的层数与上下文规模自动选择超参。所有实验用 10 层 transformer(略大于最大树高 8),权重占用 < 200 MB。
优化器:nanochat 原版组合,即 modified Adam(Jordan et al., 2024a)+ Muon(Jordan et al., 2024b),未做修改。
训练规模:$2^{15} = 32768$ tokens/mini-batch,$2^{19} = 524288$ tokens/iteration(例如上下文 $2^{10}$ 时,一个 optimizer step 处理 $2^5 = 32$ 条训练序列,一个 iteration 固定含 $2^4 = 16$ 个 optimizer step)。按模型跑 3,000–10,000 iterations。
算力:2×A100,1,000 iterations 约 1 小时;全部预训练在数小时内完成,作者明确以易复现为设计目标。
非推理模型的数据构造:额外加一个"上下文刷新" token $\emptyset$(亦即 BOS)。采样一列独立的广播过程 $T^{(1)}_{d,h}, T^{(2)}_{d,h}, \dots$,各自 tokenize 后用 $\emptyset$ 拼成无穷序列 $(\tilde\tau_1,\tilde\tau_2,\dots)$;随机取起点 $\iota \sim \mathrm{Unif}(\{1,\dots,L+1\})$,取长度 $k+1$ 的连续子串,令 $x = (\tilde\tau_\iota,\dots,\tilde\tau_{\iota+k-1})$、$y = (\tilde\tau_{\iota+1},\dots,\tilde\tau_{\iota+k})$,标准交叉熵训练。这刻意模仿了 LLM 在大语料上预训练的方式(作者注:实践中 $\iota$ 常是顺序取的,本文实验中两种做法差异不显著)。推理时用 $\emptyset$ 提示模型,逐 token 采样、超出 $k$ 则截断最老 token,重复 $L$ 次。
关键说明:理论分析的是"给定前一棵子树采样下一棵子树"的受限模型,而实验用的是常规逐 token 自回归训练与推理,比理论设定更贴近实践。标点 token 在此扮演关键角色,它告诉模型当前正在生成/训练子树的哪个部分。
推理模型的数据构造:从头以监督方式训练——把期望的记忆状态人工周期性地插入训练数据。记忆状态被扩展为值与索引交替的序列
$$\sigma_1, r_1, \sigma_2, r_2, \dots, \sigma_{h-h_0}, r_{h-h_0}, \qquad \sigma_i \in \Sigma,\ r_i \in [d],\ 0 \le h_0 \le h, \tag{22}$$
表示模型已采样 $(X_\emptyset, X_{r_1}, \dots, X_{(r_1,\dots,r_{h-h_0-1})}) = (\sigma_1,\dots,\sigma_{h-h_0})$。状态转移按 $h_0 = 0$ / $0 < h_0 < h$ / $h_0 = h$ 三种情形定义(分别对应"在最底层继续向右""向上回溯并下钻到新分支""开始一棵新树"),共 $d^{h-1}(d+1)-1$ 次转移即输出正确的语言分布(含标点)。
记忆状态用 token 集 $T_m = \Sigma \sqcup [d] \sqcup \{\emptyset\} \sqcup \{s,e\}$ 编码,用 $2(h-h_0)$ 个 padding token 补齐为定长,并以"记忆开始 token" $s$ 与"记忆结束 token" $e$ 包裹,从而模型 wrapper 可以在输出中隐藏记忆段。选定 $\ell_v$(每步输出的值 token 数)与 $\ell_m = 2 + 2h$(记忆 token 数),要求 $2\ell_m + \ell_v \le k+1$,即 $1 \le \ell_v \le k - 2h - 1$。训练序列即在 $\tilde\tau_\iota, \tilde\tau_{\iota+\ell_v}, \tilde\tau_{\iota+2\ell_v},\dots$ 之前插入对应的记忆状态 tokenization。
五、主要实验结果¶
5.1 Ising 广播过程¶
参数:$\rho = 0.9$,三叉树 $d = 3$,高度 $h = 8$,故 $d\rho^2 = 2.43 > 1$(KS 界以上),语言长度 $d^h = 6561$,含标点 $L = 3^7 \times 4 - 1 = 8747$。非推理模型上下文规模 $2^4,\dots,2^{11}$;推理模型 $2^6,\dots,2^{11}$。 每个配置采样 ≥ 1,000 次,用标准样本方差与样本超额峰度公式估计(Zwillinger and Kokoska, 1999)。
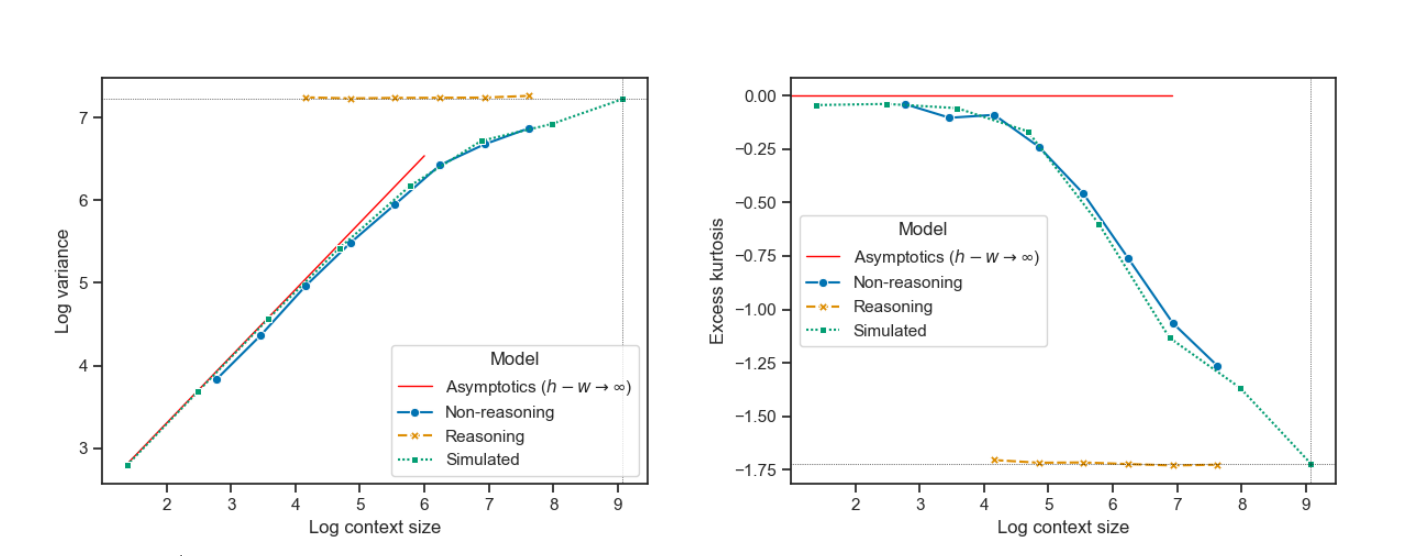
图中四条曲线的含义:Non-reasoning(蓝) 与 Reasoning(橙) 都是训练出的真实 transformer;Simulated(绿) 用 Definition 2.2 的精确自回归广播过程生成(其上下文规模按 $d^{w-1}(d+1)$ 定义以计入标点);Asymptotics(红) 是 Theorem 3.1/3.2 的渐近预测(在 $h-w\to\infty$、$w\to\infty$ 时成立)。灰色水平细线是真语言的取值,竖线标记"上下文覆盖整棵树"($w = h$)的位置。
由于论文只给图不给表,下表是从 Figure 1 读出的近似值(自然对数刻度):
| 上下文($\log$ 规模) | 非推理 log-方差 | Simulated log-方差 | 非推理超额峰度 | Simulated 超额峰度 | 推理模型 |
|---|---|---|---|---|---|
| ≈1.4($2^4$) | ≈2.8 | ≈2.8 | ≈−0.06 | ≈−0.06 | — |
| ≈2.8($2^5$) | ≈3.84 | ≈3.7 | ≈−0.05 | ≈−0.05 | — |
| ≈4.2($2^6$) | ≈4.95 | ≈4.9 | ≈−0.11 | ≈−0.09 | log-方差 ≈7.2,峰度 ≈−1.71 |
| ≈4.9($2^7$) | ≈5.48 | ≈5.47 | ≈−0.24 | ≈−0.27 | ≈7.2 / ≈−1.72 |
| ≈5.6($2^8$) | ≈5.94 | ≈5.9 | ≈−0.45 | ≈−0.53 | ≈7.2 / ≈−1.72 |
| ≈6.2($2^9$) | ≈6.41 | ≈6.35 | ≈−0.77 | ≈−0.87 | ≈7.2 / ≈−1.73 |
| ≈6.9($2^{10}$) | ≈6.86 | ≈6.68 | ≈−1.06 | ≈−1.15 | ≈7.22 / ≈−1.73 |
| ≈7.65($2^{11}$) | — | ≈6.9 | ≈−1.26 | ≈−1.27 | ≈7.22 / ≈−1.74 |
| ≈9.08(全树) | — | ≈7.2(真语言) | — | ≈−1.73(真语言) | — |
结论分析:
- 非推理曲线与 Simulated 曲线几乎重合——这是本文最有价值的实证发现之一,它直接验证了 $k$-gram ansatz 本身:真实训练的 transformer 确实近似实现了"最优 $k$-gram 模型",而不是别的什么东西。这一点在方差与峰度两条曲线上都成立。
- 小上下文段与渐近直线吻合。log-方差在小 $w$ 处与红色渐近线(斜率 $\log(d\rho^2)$)贴合;随 $w \to h$ 出现饱和与偏离,这正是 Theorem 3.1 脚注指出的有限尺寸修正($w$ 接近 $h$ 时 $A_{d,\rho}(2)$ 与 $C_{d,\rho}(2)$ 的常数项差异开始生效)。理论上真语言的 log-方差应为 $h\log(d\rho^2) + \log C_{d,\rho}(2) = 8\times 0.888 + \log 1.133 \approx 7.23$,与图中灰线 ≈7.2 一致。
- 峰度的方向验证了"退相干"叙事。真语言超额峰度 ≈ $-1.73$(强双峰,接近 Rademacher 的 $-2$,反映根自旋主导的全局承诺);随上下文缩小,非推理模型的超额峰度单调升向 0(高斯),与 Theorem 3.2 一致。
- 推理模型在最小上下文下就已完全对齐真语言:上下文 $2^6 = 64 \ll d^h = 6561$ 时,方差与峰度均已贴住真语言的灰线,且在整个上下文范围内保持平坦。这是 Theorem 3.4 的实证对应——指数级的上下文节省是可训练可达的,而不只是存在性的。
5.2 Coloring 广播过程¶
参数:四叉树 $d = 4$,高度 $h = 6$,$q = 3$ 色,语言长度 $d^h = 4096$。上下文规模与 Ising 情形相同。每配置采样 ≥ 1,000 次,判定"合法"的方式是:尝试找一棵高度 $h$ 的 $d$ 叉树的合法 $q$-着色,使其叶子颜色恰为模型生成的序列;valid rate 即成功率。
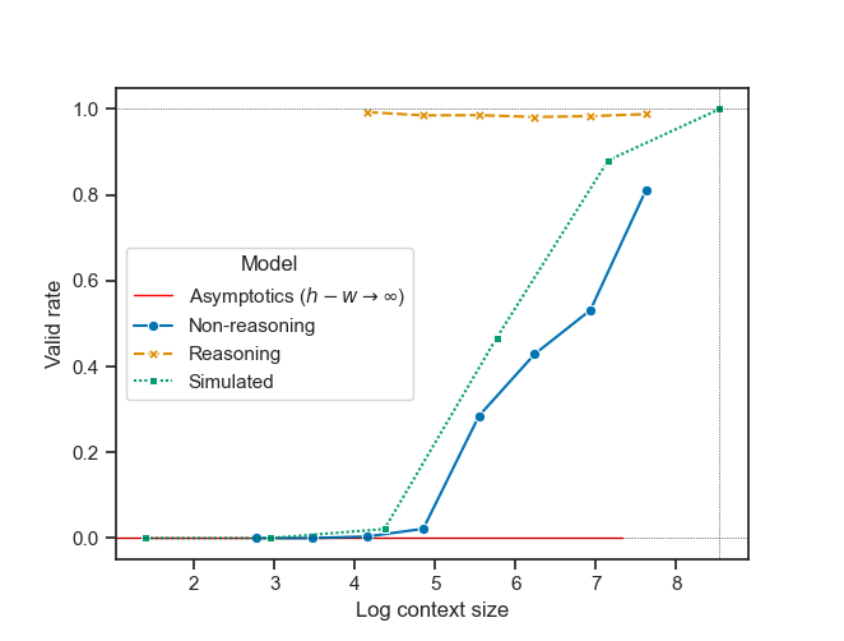
从 Figure 2 读出的近似值:
| 上下文($\log$ 规模) | 非推理 valid rate | Simulated valid rate | 推理 valid rate |
|---|---|---|---|
| ≈1.4 | ≈0.00 | ≈0.00 | — |
| ≈2.8 | ≈0.00 | ≈0.00 | — |
| ≈3.5 | ≈0.00 | ≈0.01 | — |
| ≈4.2 | ≈0.00 | ≈0.02 | ≈0.99 |
| ≈4.9 | ≈0.02 | ≈0.28 | ≈0.98 |
| ≈5.6 | ≈0.28 | ≈0.46 | ≈0.98 |
| ≈6.2 | ≈0.43 | ≈0.65 | ≈0.97 |
| ≈6.9 | ≈0.53 | ≈0.88 | ≈0.98 |
| ≈7.65 | ≈0.81 | — | ≈0.99 |
| ≈8.5(全树) | — | ≈1.00 | — |
(Asymptotics 线恒为 0,即 Theorem 3.3 预测的"完全不一致生成"。)
结论分析:
- 失败模式质变。与 Ising 的"统计退相干"不同,这里是彻底非法:小上下文的非推理模型几乎从不产出合法序列。
- 推理模型全程 ≈0.98–0.99,即便上下文只有 $2^6$。这与 Theorem 3.4 的"信道无关"性质一致——同一套 DFS 记忆构造在硬约束语言上同样精确。
- 一个值得注意的偏差:在中间上下文段,训练出的非推理 transformer 明显低于 Simulated 曲线(如 $\log$ 上下文 ≈6.9 处 0.53 vs 0.88)。这说明真实模型比理想 $k$-gram 模型更差——有限模型容量与优化误差叠加在信息论下界之上。换言之,$k$-gram ansatz 在 Ising 的连续统计量上是紧的,但在 coloring 的"全有全无"判定上偏乐观。这一点作者没有展开讨论,但从图上是清晰可见的。
六、核心贡献总结¶
- 一个分布已知且可解析的层次化合成语言:树上广播过程被作为语言模型的替身引入,且明确区分于"形式语言"——它是字符串上的概率分布,与生成式预训练的 MLE 目标对齐。软约束(Ising)与硬约束(coloring)两个实例分别对应自然文本与代码/形式数学两类场景。
- exact $k$-gram ansatz:用"只依赖前 $k$ 个 token 的最优自回归过程"替代上下文长度为 $k$ 的 transformer,把不可解的模型分析化归为可解的概率计算,并在实验中验证了这一替换本身。这是本文方法论上最值得借鉴的一步。
- 两条定量下界:Ising 下 log-方差关于上下文深度对数线性、峰度高斯化(Theorems 3.1/3.2);coloring 下冻结相中必然非法生成(Theorem 3.3)。二者共同蕴含忠实采样长度 $n$ 序列需要 $\Omega(n)$ 上下文。
- 一条指数上界:仅 $\Theta(\log n)$ 位工作记忆的自回归推理模型可精确采样真语言(Theorem 3.4),构造是对生成树的 DFS,且与广播信道无关。
- 理论与真实 transformer 的定量吻合:这是本文与"表达力/形式语言"路线最本质的区别——那些结论是存在性的,而本文展示的是常规 next-token-prediction 训练出的真实模型在很宽的上下文范围内跟踪渐近预测。
七、与已归档相关工作的对比¶
LIMIT LIMIT: On the Theoretical Limitations of Embedding-Based Retrieval (Google DeepMind / Johns Hopkins University, 2025-08-28)¶
关系:独立并发(本文未引用 LIMIT;LIMIT 早于本文约 8.5 个月,属"可引而未引"的平行路线,两者殊途同归)· 已加载对方精读
时序说明:LIMIT 发表于 2025-08-28,本文投稿于 2026-05-13,LIMIT 明显更早,因此本文完全有条件引用它却没有——这不是时序造成的"无法引用",而是两个社区(IR / 概率论-学习理论)之间的真实脱节。经 grep 检查,本文正文与参考文献中均无 LIMIT、无 Weller、无 sign-rank 相关条目。
- 共同关注的问题:两篇论文攻击的是同一个 root cause——神经生成/检索系统中,某个固定大小的架构资源预算(LIMIT 是 embedding 维度 $d$,本文是上下文长度 $d^w$)与随任务规模组合式增长的表征需求(LIMIT 是所有 top-$k$ 文档子集,本文是长度 $n$ 序列的多尺度全局一致性)之间存在信息论/几何意义上的硬天花板。两者都明确反驳"只要模型更大、数据更好就能解决"的默认假设:LIMIT 的结论是"存在任何 query 都检索不出的 top-$k$ 组合",本文的结论是"任何亚线性上下文都无法匹配真语言的全局统计"。两者都把结论量化成同一形式的下界:LIMIT 是 $d = \Omega\!\big(k\log(en/k)/\log(1+1/\gamma)\big)$,本文是上下文 $= \Omega(n)$。
- 相近的技术骨架:两者的方法流程图几乎可以叠合——(1) 在一个理想化、无学习约束的抽象层上证明容量下界(LIMIT 用带 margin 的球堆积体积论证 + sign-rank,本文用广播过程的矩递推 + 冻结相的 coupon collector);(2) 构造一个"极简到令人尴尬"的合成实例,把最坏情况钉死成一个可跑的数据集/语言(LIMIT 是 46 篇文档、1035 个 $k{=}2$ query 的自然语言数据集,本文是 $d{=}3,h{=}8$ 的 Ising 树与 $d{=}4,h{=}6,q{=}3$ 的着色树);(3) 在该实例上训练/评测真实 SOTA 模型,验证它们的失败与理论预测一致(LIMIT 中单向量模型即便 4096 维、recall@100 仍多在个位数,本文中训练出的 transformer 曲线与渐近线重合);(4) 给出一条绕开该界的更具表达力的架构路径(LIMIT 指向 cross-encoder / 多向量:长上下文 reranker Gemini-2.5-Pro 一次性 100% 解出全部 1000 条 query;本文指向带工作记忆的推理模型:$\Theta(\log n)$ 位即可精确采样)。这种"下界 → 极简合成实例 → 真实模型确认 → 逃逸路径"的四段式是两篇论文共有的、非平凡的骨架。
- 本文的差异与推进:三点实质推进。其一,本文的下界是关于"生成分布"而非"表示能力"的——LIMIT 问的是"某个 top-$k$ 集合能否被表示"(一个静态的几何可行性问题),本文问的是"自回归生成出来的序列的分布统计量偏离真分布多少"(一个动态的、随生成步骤累积的问题),因而必须处理跨生成步的信息衰减(式 (11) 的 $\alpha(\alpha q_w)^{j-1}$ 几何衰减),这是 LIMIT 的静态论证覆盖不到的机制。其二,本文给出的不只是"某处必然失败",而是一条可外推的定量标度律——log-方差 $= w\log(d\rho^2) + \log A_{d,\rho}(2)$ 精确到常数项,LIMIT 的下界只给出可行/不可行的分界,没有"偏离多少"的刻画。其三,本文同时给出了匹配的上界(Theorem 3.4 的 $\Theta(\log n)$ 构造并证明其精确性),而 LIMIT 对 cross-encoder / 多向量能否绕开限制只给了初步实证,明确把理论界留作未来工作。
- 可比的方法/实验差异:LIMIT 的合成实例是自然语言的(用 Gemini 2.5 Pro 生成人名-属性对,因此可以直接评测现成的 SOTA embedder,无需训练),代价是无法解析地知道"理想模型"应该是什么样;本文的合成语言是纯数学的(必须从零训练 nanochat,10 层、2×A100、数小时),代价是与自然语言的距离,收益是有一条精确的 "Simulated" 参照曲线可以逐点比对——本文因此能验证 $k$-gram ansatz 本身,而 LIMIT 无法验证其"自由 embedding"理想模型与真实模型之间差距的来源(它只能观察到"46 篇文档理论上 12 维可解,但真实模型 64 维也解不了"这一现象,无法拆解)。另一个互补点:LIMIT 发现BM25 这类高有效维度的稀疏模型几乎横扫单向量神经模型(LIMIT small 上 recall@2 97.8 vs 单向量模型 < 60),但一旦替换同义词就骤降近 90%;本文没有对应的"另一种模型族绕开"的实验,其逃逸路径只有推理模型一条。
八、讨论与局限性¶
8.1 值得借鉴的设计¶
- "造一个分布已知的合成语言"这一方法论本身比任何单条定理都更有价值。它把"生成文本质量"这种含糊的问题转成了方差、峰度、合法率这些可精确计算、可精确预测的量。任何想对生成式模型做定量理论的工作都可以复用这个模板。
- exact $k$-gram ansatz 的可验证性。用理想 $k$-gram 过程替代 transformer 是一个强假设,但作者没有停在假设上,而是把"Simulated"曲线与训练曲线画在同一张图上逐点比对。这种把 ansatz 本身当作可证伪的实证命题的做法,比单纯声称"我们的理论预测了实验"要扎实得多。
- 对推理收益的机制归因。作者明确区分了自己的"统计性"机制与 Malach (2023)/Joshi et al. (2025) 的"计算性"机制。这个区分很重要:它意味着即使一个任务在计算上是平凡的,只要它有多尺度层次结构,有界上下文也会失败——这比"CoT 让模型能算更难的东西"是一个更普遍、也更贴近真实长文生成失败模式的解释。
- 对上下文压缩的理论背书。Theorem 3.4 给出了一个干净的命题:当底层分布具有可压缩的层次结构时,小工作记忆可以替代大上下文窗口。这对做 context compaction / memory 的工程工作是一条明确的适用条件,而不是一句泛泛的鼓励。
8.2 局限与争议¶
- 合成语言,且是正则树。 作者在 §5 明确承认:理论推导依赖正则 $d$ 叉树的几何才能得到精确的定量预测;推广到更一般的语言或相关结构是开放的。自然语言的"树"既不正则也不定高,实际的依存结构远比这复杂。作者把"在自然语言上研究类似现象"列为最重要的未来方向,这也等于承认目前没有任何证据表明这些定量标度律能迁移到真实语料。
- 理论与实验的设定并不完全对齐。 理论分析的是"一次生成一棵深度 $w$ 子树"的过程(Definition 2.2),实验跑的是逐 token 自回归。作者只说"预期结论相同,代价是更复杂的证明"——这是一个未证明的缺口,尽管实验吻合度给了很强的间接支持。
- Coloring 实验参数不满足 Theorem 3.3 的显式阈值。 定理要求 $d > q(\log q + \log\log q + 1 + o_q(1))$,代入 $q = 3$ 得约 $6.58$,而实验用的是 $d = 4$。作者只说该参数"落在冻结相"(lying in the frozen regime),未解释这一不一致。原因显然是定理的阈值是大 $q$ 渐近(带 $o_q(1)$)而 $q=3$ 太小,实际的冻结/重构阈值需要按 $q=3$ 单独定;但论文没有把这一点讲清楚,严格地说 Figure 2 并不是 Theorem 3.3 条件下的验证,而是在一个经验上认为冻结的参数点上的验证。
- 推理模型的记忆是手工设计并被完全监督的。 训练时作者人工把正确的记忆状态周期性插入训练数据(§G.3),模型学的是"复现给定的 DFS 记忆协议"。这与真实 LLM 里 CoT 从 RL 或自蒸馏中涌现出来完全不同。因此 Theorem 3.4 的实证部分只证明了"存在可被学会的 $O(\log n)$ 协议",没有回答"模型能否自己发现这样的协议"——而后者才是工程上真正困难的部分。
- 模型规模极小、无工业验证。 10 层 nanochat、权重 < 200 MB、2×A100 数小时。这对复现性是优点,但它意味着结论距离前沿 LLM 的实际制度(scale、数据混合、位置编码、注意力变体)非常远。论文也没有任何线上部署或工业 A/B 数据——它不试图有,但从落地价值角度这是事实。
- "scaling law"一词的含义与主流用法不同。 本文的标度律是分布统计量关于上下文深度的解析律,而非 Kaplan/Hoffmann 意义上损失关于参数量与数据量的经验拟合律。二者不可直接比较,读者容易被标题误导。
- coloring 上 $k$-gram ansatz 偏乐观。 如 §5.2 指出,训练出的 transformer 在中间上下文段明显差于 Simulated 曲线。这说明 ansatz 在硬约束语言上并不紧——真实模型的失败同时来自信息论下界与模型/优化误差,而本文的理论只覆盖前者。论文没有讨论这一差距。
8.3 工业落地价值¶
本文没有直接的工业落地成果,也不以此为目标。但有两条对工程有直接指导意义的推论:
- 长文/长程一致性的失败可能是架构性的而非训练性的。 如果一个任务的底层结构是层次化多尺度的,那么"生成的长文局部通顺、全局不表态/自相矛盾"这种现象,在亚线性上下文下不可能靠加数据或加参数消除。本文给出的 Ising 类比(对是非问题给出冗长含糊的回答)与 coloring 类比(每个函数都能编译、整个程序编译不过)分别精确对应了长文写作与长代码生成两类高频失败。
- 上下文压缩的适用条件被讲清楚了。 Theorem 3.4 说明压缩之所以可能,前提是底层分布具有可压缩的层次结构,且需要的记忆内容是"从根到当前位置的路径"——即层次化的、随生成位置滚动更新的状态,而不是对历史 token 的均匀摘要。这对设计 memory / compaction 机制是一条具体的结构性提示。