DHEN:面向大规模 CTR 预估的深度分层集成网络
Buyun Zhang, Liang Luo, Xi Liu 等 · Meta Platforms · KDD'22 · arXiv:2203.11014
研究动机与背景
在线广告是一个数百亿美元规模的产业——仅美国 2021 财年就达到 2843 亿美元,相比 2020 财年增长 25%。点击率(Click-Through Rate, CTR)预估直接决定广告排序质量,因此提升 CTR 预估模型性能是学术界和工业界长期投入的方向。
CTR 预估模型的历史演进大致是「表达能力不断增强」的过程:
- 早期:逻辑回归(LR)建模特征与标签的线性关系,但无法捕捉非线性输入-输出关系,且需要繁重的人工特征工程。
- 决策树(DT):将输入特征先做非线性变换,部分缓解了 LR 的线性假设,但 LR 和 DT 都依赖大量的人工特征交叉(feature crossing)。
- 因子分解机(FM):通过隐向量的内积建模二阶特征交互;但 FM 预定义的浅层结构限制了表达能力。其扩展形式如 HOFMs、FFMs、AFM 虽然更有表达力,却带来了不可接受的高计算成本,还容易过拟合。
- 深度学习模型:2016 年以来,Wide&Deep(Google Play)、DeepFM(华为 AppGallery)、DIN(淘宝)、FiBiNET(微博)等深度模型被工业界大规模部署。这类模型由两个核心组件构成:特征嵌入学习(把类别特征映射为 embedding 向量)与特征交互建模(用各种函数捕捉 embedding 之间的关系)。大量研究表明,交互部分的更好设计能显著提升预测精度。
本文的核心观察(也是全文的立论根基):尽管已有大量工作设计了能捕捉高阶交互的特征交互模块,但作者注意到——这些模块的实际性能排名会随数据集而变化,即使它们声称捕捉相同阶数的交互也是如此。这说明不同交互模块即便面向相同阶数的交互,其优势也各不相同,而且它们捕捉到的信息是非重叠(non-overlapping)的。
更进一步,作者指出一个反直觉的现象:通过堆叠更多交互层来学习更高阶交互,有时反而会带来负面效果。论文明确列举了多个证据(DCN 的 Figure 3、xDeepFM 的 Figure 7(a)、InterHAt 的 Figure 4、xDeepInt 的 Table 2、GIN 的 Figure 3(a) 等)。这与「捕捉更高阶交互应带来更好或至少中性的效果」的理论预期相悖。作者假设其根本原因在于使用了同质(homogeneous)的交互模块,限制了能被捕捉的交互类型。
正是这一观察催生了 DHEN:Deep and Hierarchical Ensemble Network——一个具有分层结构的深度分层集成架构,能够利用异质(heterogeneous)交互模块各自的优势,并学习不同阶数交互之间的层级关系(hierarchy)。
DHEN 层中有两类组件:
- 异质交互模块的集合(collection of heterogeneous interaction modules):不同交互模块可以互补彼此的非重叠信息;
- 集成组件(ensemble component):捕捉异质模块之间的相关性(correlation)。
通过递归地堆叠 DHEN 层,模型学习到不同阶数交互的层级结构,并捕捉异质交互模块之间的相关性——作者在实验中发现这一点对取得更好性能起到了重要作用。
本文的主要贡献:
- 设计了新颖的 DHEN 架构,基于「不同交互模块在不同数据集上有不同优势」的观察。通过递归堆叠交互层与集成层,DHEN 能学习异质模块所学到的不同阶数交互的层级结构。
- 针对 DHEN 更深、多层结构带来的训练复杂度挑战,提出了一系列改进训练性能的机制,包括一种名为 Hybrid Sharded Data Parallel(HSDP,混合分片数据并行) 的新分布式训练范式,相比全分片数据并行(FSDP)实现最高 1.2x 的训练吞吐提升。
- 在大规模 CTR 预估任务上做了全面评估,相比 SOTA 的 AdvancedDLRM 基线,取得最高 0.27% 的 Normalized Entropy(NE)增益。
核心方法 / 模型架构
整体设计思想
论文观察到,跨多种预测任务的 SOTA 高性能架构都采用深度堆叠(deep stacking)结构(如 ResNet、Transformers、Metaformer)。这种堆叠结构通常由重复的、包含同一种交互模块的 block 构成:例如 Transformer 用 self-attention block 堆叠,ResNet 用卷积 block 堆叠。每个 block 消费上一个 block 或原始 embedding token 的输出。
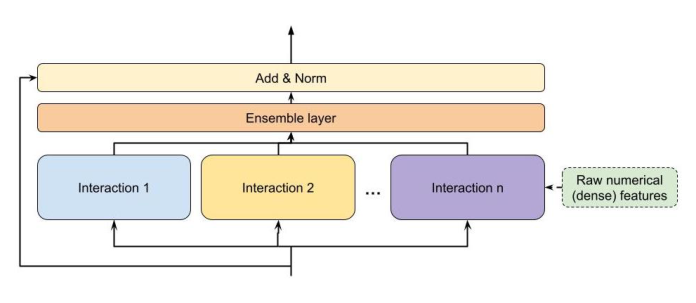
DHEN 沿用了这个整体堆叠策略,但同时构建了一个新颖的分层集成框架,来捕捉多种交互模块的相关性。Figure 1 展示了一个通用的 DHEN 构建块,其中驻留着多个交互模块的集成。注意:原始的数值(稠密)特征可以作为每一层集成的输入的一部分。
2.1 特征处理层(Feature Processing Layer)
CTR 预估的特征输入通常包含离散类别特征(稀疏特征)和数值特征(稠密特征)。本文采用与 DLRM 相同的特征处理层(Figure 3)。
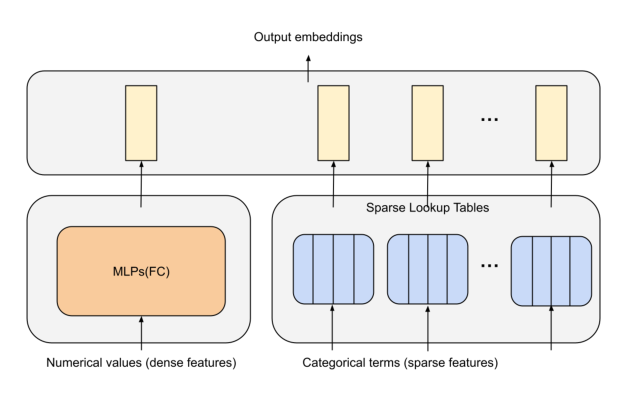
- 稀疏查找表(sparse lookup table)把类别项映射为一组数值 embedding:每个类别项被分配一个可训练的 $d$ 维向量作为其特征表示;
- 数值特征由若干 MLP(多层感知机)处理,输出一个 $d$ 维向量;
- 把稀疏查找表的输出与稠密层的输出拼接(concatenation)后,特征处理层的最终输出为:
$$X_0 = (x_0^0, x_0^1, \ldots, x_0^m) \in \mathbb{R}^{d\times m} \tag{feature-out}$$
其中 $m$ 是输出 embedding 的数量,$d$ 是 embedding 维度。$X_0$ 即是第一层分层集成的输入。
2.2 分层集成(Hierarchical Ensemble)
论文提出的分层集成框架包含多种类型的交互模块及它们之间的相关性。从概念上说,一个深度分层集成网络可以被描述为一个深度、全连接的交互模块网络——类比于一个「神经元全连接」的深度神经网络,只不过这里的「神经元」是交互模块。
逐层前向公式。每层的输入表示为一组 embedding,记作 $X_n \in \mathbb{R}^{d\times m}$。第一层的输入是特征处理层输出的 $X_0$;$n$ 表示第 $n$ 个堆叠层。第 $n$ 层的输出定义为:
$$Y = Norm\!\left(Ensemble_{i=1}^{k}\, Interaction_i(X_n) + ShortCut(X_n)\right) \tag{1}$$
$$ShortCut(X_n) = \begin{cases} X_n, & \text{if } len(X_n) == len(Y) \\ W_n X_n, & \text{if } len(X_n) \neq len(Y) \end{cases} \tag{2}$$
各符号含义:
- $Norm(\cdot)$:归一化方法,本文用 Layer Normalization;
- $Ensemble_{i=1}^{k}(\cdot)$:对 $k$ 个交互模块 $Interaction_1, \ldots, Interaction_k$ 的输出做集成,方式可以是拼接(concatenation)、求和(sum)、加权求和(weighted sum)等;
- $ShortCut(\cdot)$:既充当残差连接(residual),又用于对齐维度。当集成输出与上一层输入 $X_{n-1}$ 的维度不匹配时,用线性投影 $W_n \in \mathbb{R}^{len(X_n)\times len(Y)}$ 对齐维度;
- 最后,集成结果与 shortcut 通过逐元素求和(element-wise sum)组合,输出 $Y$ 成为下一层输入 $X_n$。
分层集成的核心目标是捕捉交互模块之间的相关性。Figure 2(左)展示了一个两层两模块的分层集成组件。与仅捕捉一种高阶交互的传统堆叠结构不同,分层集成可以捕捉多种高阶交互的混合(mixture of high-order interactions)。
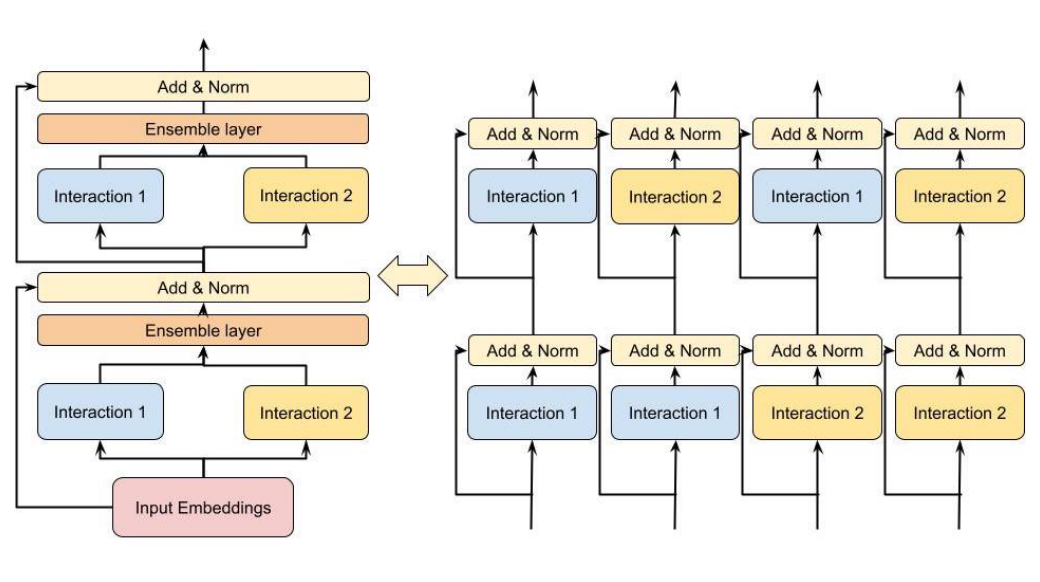
如 Figure 2 右侧的展开图所示,DHEN 的设计让每个模块消费各种交互模块的输出(例如 $Interaction_1(Interaction_1)$、$Interaction_1(Interaction_2)$、$Interaction_2(Interaction_1)$、$Interaction_2(Interaction_2)$),从而在特征间捕捉复杂的高阶交互。因此,这种交互模块的混合能够利用多种特征交互类型来提升模型预测精度。这正是 DHEN 相对「只用一种交互模块的深堆叠结构」的本质优势——用一张方法流程图来看,DHEN 是一个把不同交互模块两两嵌套、层层展开的组合树。
2.3 交互模块(Interaction Modules)
本文在模型中应用了五种类型的交互模块:AdvancedDLRM、Self-attention、Linear、Deep Cross Net(DCN)、Convolution。作者强调 DHEN 能包含的交互模块不限于这五种。
一个重要的工程细节:如果某交互模块输出的是单个张量 $v \in \mathbb{R}^{1\times h}$(例如 MLP 输出的张量),则应用一个映射矩阵 $W_m \in \mathbb{R}^{h\times(d*l)}$ 把它映射为一组维度为 $d$、数量为 $l$ 的 embedding 列表。$l$ 表示该交互模块输出的 embedding 数量。下面逐一介绍五种模块:
2.3.1 AdvancedDLRM。使用 DLRM 风格的交互模块来捕捉特征交互,本文称之为 AdvancedDLRM。给定输入 embedding $X_n$,输出为:
$$u = W_m \cdot AdvancedDLRM(X_n) \tag{3}$$
2.3.2 Self-attention。self-attention 在 NLP 中因其在文本理解上的卓越表现而广泛使用,此前也被用于 CTR 预估。一个典型的 transformer 包含多个堆叠的 encoder/decoder 层,其核心是 self-attention 机制。本文对输入 embedding $X_n$ 应用一个 transformer encoder 层:
$$u = W \cdot TransformerEncoderLayer(X_n) \tag{4}$$
其中 $W \in \mathbb{R}^{m\times l}$ 用于对齐并统一所有交互模块的输出维度。
2.3.3 Convolution。卷积层广泛用于计算机视觉,也被用于 NLP 和 CTR 任务。本文将卷积作为一种交互模块:
$$u = W \cdot Conv2d(X_n) \tag{5}$$
同样地,$W \in \mathbb{R}^{m\times l}$ 用于对齐并统一输出维度。
2.3.4 Linear。线性层是最直接的模块之一,用于从原始特征 embedding 中捕捉信息。给定输入 embedding $X_n$:
$$u = W \cdot (X_n) \tag{6}$$
其中 $W \in \mathbb{R}^{m\times l}$ 作为线性模块权重来对齐维度。
2.3.5 Deep Cross Net(DCN)。DCN 是 CTR 任务中广泛使用的特征交互模块,它引入了一个交叉网络(cross network),能高效学习有界阶数(bounded-degree)的特征交互。给定输入 embedding $X_n$:
$$u = W \cdot (X_n \cdot X_n^T) + b \tag{7}$$
其中 $W$、$b$ 是 DCN 模块的权重和偏置矩阵。注意:本文在此公式中省略了原 DCN 论文的 skip connection 过程,因为在堆叠层之间已经使用了 skip connection 来传递信息。
关键技术细节:训练系统(Training System)
DHEN 的深度堆叠分层集成层带来了表达能力,但也在实际训练中造成挑战。第 3 节介绍如何在集群中高效、可扩展地训练 DHEN——这是本文另一大工程贡献。
3.1 训练策略(Training Strategy)
每个 DHEN 训练样本同时包含类别特征和数值特征,需先转成稠密表示才能被 DHEN 层消费。这一过程带来的巨大规模和复杂度完全超出单台标准数据中心服务器的能力——典型服务器托管 8 张 GPU,总高带宽内存(HBM)为几百 GB,算力达数十 petaflops。而 DHEN 的参数量可达数万亿(trillions),单样本所需 flops 可达 giga 级,因此单服务器严重不足。
为高效训练 DHEN,本文利用 ZionEX 全同步训练系统:
- 系统把 16 台 host 组成一个「supernode」,称为 pod,包含 128 张 A100 GPU(每 host 8 张),总 HBM 容量 5TB、40 PF/s BF16 算力;
- host 内 GPU 通过 NVLink 连接;pod 内 host 之间用高带宽网络连接(最高 200GB/s,8 GPU 共享)。
混合训练范式(分布式策略):
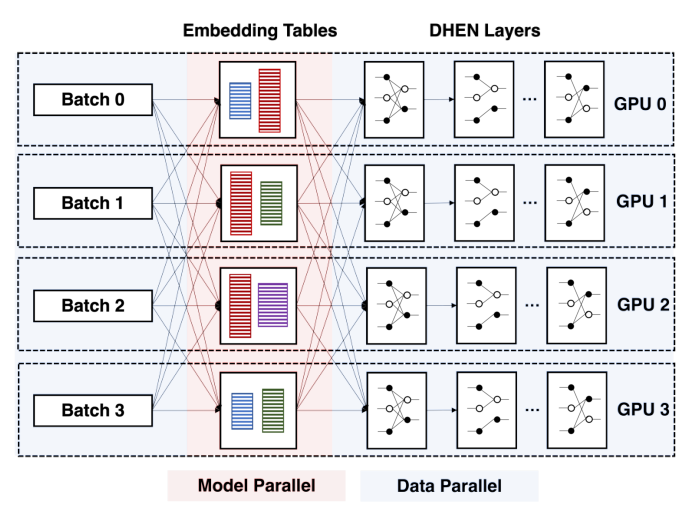
- embedding 表:跨 pod 分布。为更好负载均衡并处理超大 embedding 表,不整表放置,而是主动地把超大 embedding 表按列切分成等宽 shard,依据一个经验成本函数(同时捕捉计算和通信开销)放置这些列。用 LPT(Longest-Processing-Time)近似集合划分算法做负载均衡切分(模型并行,Model Parallel);
- 稠密模块(含 DHEN 层):在每张 GPU 上复制并以数据并行(DP)方式训练。这一选择基于观察:DHEN 稠密层的激活值远大于权重本身,因此同步权重的开销低于通过网络传输激活值的开销。
因此每个 batch 的流程是:以 DP 开始(稠密特征),进入模型并行(分布式 embedding 查找),再以 DP 结束(稠密层)。整个训练策略如 Figure 4 所示。
内存瓶颈:在堆叠的 DHEN 层上用 DP 训练,会带来一个「参数规模上限等于单 GPU HBM 容量」的天花板,阻碍了 DHEN 的可扩展性。为解决这个问题,作者用了 FSDP(Fully Sharded Data Parallel,全分片数据并行) 来消除传统数据并行的内存冗余——把权重进一步分片到不同 GPU、用 activation checkpointing 以更多计算换更低峰值内存、用 CPU offloading 激进地把参数和梯度存到 CPU 再按需取回。由于这些技术都会损害训练效率,作者根据 DHEN 层数谨慎地只开启最少量的这些技术。
3.2 训练优化(Training Optimizations)
3.2.1 通用优化(Common Optimizations)。启用了一系列广泛使用的优化以降低同步频率并加速训练:大 batch 训练、FP16 embedding + 随机舍入(stochastic rounding)、BF16 优化器、量化 all-to-all 和 all-reduce 集合通信——以进一步减少内存足迹、增强数值稳定性、利用 Tensor Core 等专用加速硬件、降低通信开销。
3.2.2 Hybrid Sharded Data Parallel(HSDP,混合分片数据并行)。这是本文最核心的系统贡献。
在训练成本预算内寻找最优 DHEN 配置时,作者需要频繁试验那些内存刚好超过单 GPU HBM 容量的候选模型(称为「embarrassingly-sized」,尴尬规模),这类模型无法用纯 DP,必须用 FSDP。但在生产规模(几百 GPU)下,作者发现直接用 FSDP 并不能带来最优效率:因为 FSDP 的 allgather 操作要把不同 GPU 的权重 shard 汇集起来,位于前向和后向传播的关键路径上,且(1)需与集群所有 GPU 通信,(2)每个 shard 太小无法高效利用网络带宽,导致耗时很长。虽然 prefetch 等技术能缓解,但它们又给系统增加内存压力,违背了用 FSDP 的初衷。
为此,作者提出 HSDP,与 DHEN 模型协同设计(co-designed)。HSDP 识别到 GPU 互连(NVLink,600GB/s)与 host 互连(RoCEv2,25GB/s)之间存在 24 倍带宽差异,并据此工作:
- HSDP 把整个模型分片在单个 host 内部——因此 reducescatter 操作在后向传播中、以及前向和后向传播中的 allgather 操作,都完全在单 host 内完成;
- 当后向传播的 reducescatter 完成后,并发地在每个具有相同 local host ID 的 GPU 之间做 all-reduce,为其本地 shard 计算平均梯度,以异步方式避免阻塞后向传播计算;
- 最后,注册一个 backward hook,让计算等待挂起的 all-reduce 操作完成——因此从训练视角看,HSDP 相比 FSDP 和 DDP 保持了语义完整。
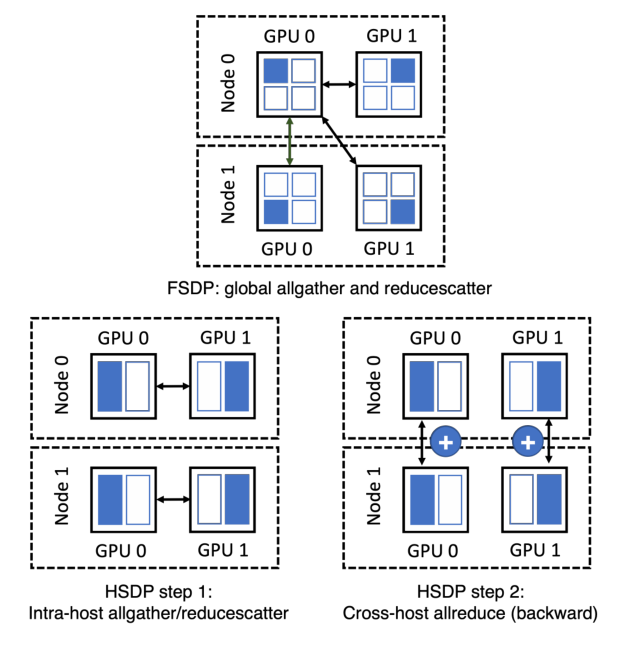
HSDP 相比 FSDP 的定性优势:
- (1) allgather 操作在前后向关键路径上的延迟显著降低——因为它可以利用高速 NVLink 互连,无需通过更慢的 RoCE 链路跨 host 通信;
- (2) 通信集合的规模随 host 数量而非 GPU 数量扩展,提升效率。
HSDP 的权衡(tradeoff):它最多支持纯数据并行支持规模的 8 倍(即每 host 的 GPU 数),并因额外的 all-reduce 而带来 1.125x 的网络字节通信开销。但对这些「尴尬规模」的模型来说,这些开销是可接受的——因为 all-reduce 开销可以被下一层的计算所隐藏(overlap),且 all-reduce 是一个高度优化的算子。
实验设置
数据集与指标:使用一个工业数据集(论文未公开数据集细节,未使用公开学术数据集)。评估指标为 Normalized Entropy(NE,归一化熵损失)——CTR 预估领域的标准指标(来自 [14],即 Facebook 的《Practical Lessons from Predicting Clicks on Ads》)。所有模型用 hundreds of 稀疏(类别)特征 + thousands of 稠密(数值)特征训练。全同步(full-sync)训练方案确保模型性能和训练吞吐都可复现。所有实验中训练超参(学习率、优化器配置)保持相同。
实验目标: 1. 评估分层集成的有效性,并找出一组好的集成用交互模块; 2. 评估 DHEN 相对 SOTA 的 AdvancedDLRM 模型的端到端精度增益; 3. 在训练吞吐上展示系统级优化的有效性。
主要实验结果
4.2 不同交互模块的模型变体(Table 1)
本节测试 DHEN 用不同常用交互模块(DCN、Self-attention、CNN、Linear)时的行为。每个实验用不同类型的交互模块组合,堆叠层数 $N=5$。以 DCN 作为 baseline,用不同训练步(训练样本数)下的相对 NE 损失差异来评估性能(负值表示 NE 下降,即更好)。
| Model id | Interaction type(s) | NE diff @10B | NE diff @20B | NE diff @35B | $N$ |
|---|---|---|---|---|---|
| 1 | DCN (baseline) | NA | NA | NA | 5 |
| 2 | Self-attention | 0.036% | 0.026% | −1.044% | 5 |
| 3 | CNN | −1.441% | −1.535% | −1.534% | 5 |
| 4 | Linear | −1.461% | −1.546% | −1.538% | 5 |
| 5 | DCN + Linear | −0.002% | −0.004% | −0.004% | 5 |
| 6 | Self-attention + Linear | −1.363% | −1.537% | −1.576% | 5 |
| 7 | Self-attention + CNN | 0.024% | −1.270% | −1.508% | 5 |
结论分析:
- 单模块中 Linear(model 4)表现最好——线性交互模块在所有单模块变体中 NE 下降最多。
- Self-attention(model 2)需要大量训练数据才能收敛:在 10B/20B 样本时几乎无提升甚至更差(正 NE diff),到 35B 才显现出 −1.044% 的收益。
- 分层集成的威力(关键发现):当对 Self-attention 和 Linear 做分层集成(model 6)后,在充分训练(35B 样本)时取得所有变体中的最佳性能(−1.576%)。这说明分层集成架构捕捉到了 self-attention 与 linear 模块之间的相关性,并显著帮助了 self-attention 模块的收敛。
- 并非「模块越多越好」:model 5(DCN + Linear 集成)的表现比单用 Linear 更差;model 7(Self-attention + CNN)也类似地弱于最佳组合。这印证了初始假设——不同交互模块捕捉的是非重叠信息,因此「用哪些模块做分层集成」这一选择才是 DHEN 性能的关键,盲目堆叠模块反而有害。
4.3.1 相对工业 AdvancedDLRM 的预测性能(Table 2)
在验证了分层集成的有效性后,作者进一步在工业模型 AdvancedDLRM 之上评估 DHEN——用 SOTA 的 AdvancedDLRM 和 Linear 两个模块作分层集成。训练了 4 个不同层数 $N$ 的 DHEN 模型:
| Model id | Interaction type(s) | $N$ | NE diff @5B | NE diff @15B | NE diff @25B |
|---|---|---|---|---|---|
| 1 | AdvancedDLRM (baseline) | 1 | NA | NA | NA |
| 2 | AdvancedDLRM + Linear | 2 | −0.0315% | −0.134% | −0.176% |
| 3 | AdvancedDLRM + Linear | 4 | −0.071% | −0.197% | −0.255% |
| 4 | AdvancedDLRM + Linear | 8 | −0.068% | −0.208% | −0.273% |
结论分析:
- 所有 DHEN 模型都优于工业 AdvancedDLRM 基线;
- 更深的 DHEN(层数越大)取得越大的 NE 提升——8 层模型在 25B 样本时达到 −0.273% 的 NE 改善(这也是摘要中「0.27% NE 增益」的来源);
- 增益随训练样本增多而持续放大:这说明高阶交互和多种交互模块的相关性在 CTR 任务中都起到重要作用,且随数据集增大而放大的 NE 提升表明 DHEN 的性能既稳定又可泛化(consistent and generalizable)。
补充说明:在 CTR 预估这种海量样本、超薄利润的工业场景下,0.1%~0.3% 的 NE 改善已属显著——[14] 中 Facebook 明确指出 NE 的微小相对改善即可带来可观的线上收益。
4.3.2 Scaling 效率:DHEN 层堆叠 vs MoE 扩展(Table 3)
为评估 DHEN 的扩展效率,作者对比了两种扩展方式:用 MoE(Mixture-of-Experts)扩展 AdvancedDLRM 的 MLP 层 vs 堆叠 DHEN 层。两种方法都基于同一个工业 AdvancedDLRM,DHEN 用 AdvancedDLRM + Linear 集成。以训练 FLOPs 衡量训练复杂度:
| Model id | Scaling method | Training FLOPs | NE diff @50B |
|---|---|---|---|
| 1 | AdvancedDLRM (baseline) | 0.06G | NA |
| 2 | 4 expert MoE | 1.3G | −0.06% |
| 3 | 2 layer DHEN | 1.44G | −0.11% |
| 4 | 8 expert MoE | 3.3G | −0.09% |
| 5 | 4 layer DHEN | 3G | −0.21% |
| 6 | 16 expert MoE | 6G | −0.10% |
| 7 | 6 layer DHEN | 4.6G | −0.26% |
结论分析:
- 在相近的训练复杂度(FLOPs)下,DHEN 一致地击败 AdvancedDLRM 的 MoE 扩展:2 层 DHEN(1.44G FLOPs, −0.11%)优于 4 expert MoE(1.3G, −0.06%);4 层 DHEN(3G, −0.21%)大幅优于 8 expert MoE(3.3G, −0.09%);6 层 DHEN(4.6G, −0.26%)远优于 16 expert MoE(6G, −0.10%)。
- 因此堆叠 DHEN 层是一种投资回报率更高的扩展机制——MoE 增加专家数后收益快速饱和(−0.06%→−0.09%→−0.10%),而 DHEN 加深层数的收益持续增长(−0.11%→−0.21%→−0.26%)。这为「用 DHEN 深度而非 MoE 宽度来扩容 CTR 模型」提供了直接证据。
4.3.3 训练吞吐(Training Throughput)
在基于 ZionEX、256-GPU 的集群上评估训练吞吐。
- 通用优化的效果:对一个用 DP 训练的 8 层 DHEN,应用 FP16 embedding、AMP、量化 BF16 all-reduce 和 all-to-all 后,端到端加速 1.08x。改善主要来自量化集合通信降低的暴露通信延迟;剩余瓶颈在优化器成本和无法与稠密层计算完全 overlap 的 all-to-all 调用上。
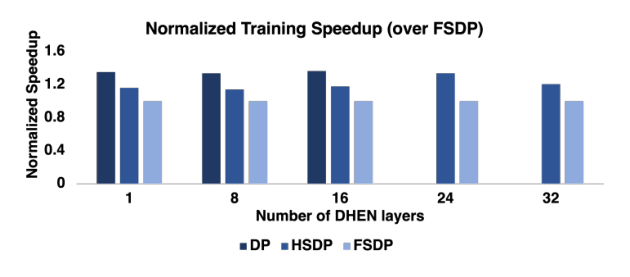
- HSDP 的吞吐收益:DP 在 16 层以内表现良好,层数继续增加会因内存不足而出错;FSDP 和 HSDP 都支持更多层,且 HSDP 一致地优于 FSDP,最高提升 1.2x。trace 分析显示,HSDP 的吞吐增益确实来自「关键路径上 allgather 延迟大幅降低」——得益于单 host 内快速的 NVLink 连接。
- 训练更深 DHEN 需要范式切换:DP 在本集群最多只能训练 22 层 DHEN。HSDP 与 DHEN 协同设计后,既能弥合训练更深 DHEN 时 FSDP 与 DP 之间的吞吐差距(最高 1.2x),也能缩小 DHEN with DP 的内存差距。
消融与分析(综合)
论文的三张表本身就构成了逐层消融:
- 交互模块选择(Table 1):证明「分层集成异质模块」优于「单模块」和「随意组合」——Self-attention+Linear 是最优组合,而 DCN+Linear、Self-attention+CNN 组合反而不如单模块,验证了「非重叠信息假设」。
- 深度消融(Table 2):$N=2 \to 4 \to 8$ 层,NE 收益单调递增(−0.176% → −0.255% → −0.273% @25B),证明「深度即表达力」。
- 扩展方式消融(Table 3):DHEN 深度扩展 vs MoE 宽度扩展,前者在同等 FLOPs 下全面胜出。
- 系统消融(4.3.3 / Figure 6):DP vs FSDP vs HSDP,量化 HSDP 的 1.2x 吞吐增益及其归因(NVLink allgather 延迟降低)。
核心贡献总结
- 架构层面:DHEN 是首个把「异质交互模块的分层集成 + 递归堆叠」系统化的 CTR 架构,用一个统一框架吸纳 DCN / self-attention / CNN / linear / DLRM 等多种交互算子,并显式建模它们之间的相关性与层级结构。
- 认知层面:提出并实证「不同交互模块捕捉非重叠信息、其相对优势随数据集变化、盲目堆叠同质模块反而有害」这一关键洞察,为后续统一架构研究奠定了理论动机。
- 系统层面:提出与模型协同设计的 HSDP 训练范式,利用 NVLink 与 host 网络的 24x 带宽差异,把模型分片限制在单 host 内以降低 allgather 关键路径延迟,相比 FSDP 提升最高 1.2x 吞吐,并支撑了「尴尬规模」DHEN 的可训练性。
与已归档相关工作的对比
Step 2.5:在文档库中未发现与 DHEN「问题 + 解法双同构」的独立并发孪生论文。DHEN 是 2022 年的奠基性架构,文档库中与其相关的论文(Wukong、OneTrans、RankMixer、TokenMixer-Large、LoopCTR 等)均为后续工作且明确把 DHEN 当作前作 / baseline 引用——这类关系属于历史谱系而非「独立并发殊途同归」,其结构化对比由 Step 4 的 DAG 边承载(DHEN 已作为 RankMixer / TokenMixer-Large / LoopCTR 边的 source 存在)。被剔除的近似候选及理由:
- Wukong(Meta,2024):同为 Meta 的判别式特征交互扩展架构,也追求 scaling law,但其解法是「用 FMB + LCB 堆叠 + 因子分解机的密集扩展实现幂律 scaling」,与 DHEN 的「异质模块分层集成」路径不同——是继任者而非并发,剔除,交给 DAG。
- RankMixer / TokenMixer-Large(ByteDance,2025-2026):解决的是「特征交互模型的硬件对齐 scaling」,解法是 token-mixing / MLP 结构,与 DHEN 的「异质交互模块集成」骨架不同,且明确把 DHEN 当 baseline,属谱系关系,交给 DAG。
- OneTrans(2026):统一序列建模与特征交互的单塔 Transformer,问题偏「序列 + 特征联合建模」,解法是单一 Transformer 而非异质模块集成,路径实质偏离,剔除。
因此本步骤不新增 reading.md 叙事对比子节,仅在 DAG 中登记 DHEN 自身实验声明的 baseline 边。
讨论与局限性
值得借鉴的设计:
- 「异质集成 + 层级相关性」的抽象极具启发性——它把「选哪种交互算子」从一个二选一的架构决策,转化为「让多种算子共存并让模型学习它们的组合」的可学习问题,这一思路直接影响了后续的统一特征交互架构(Wukong、OneTrans 等)。
- 模型-系统协同设计(HSDP)是工业论文的典范:不是把系统当作模型的附属,而是让「模型规模选择」与「分布式策略」互相塑造(针对「尴尬规模」模型专门设计 HSDP)。
- 对 scaling 方式的实证比较(深度 vs MoE 宽度)为工业界「如何花算力预算」提供了直接指导。
历史地位:DHEN 是 CTR 判别式排序从「单一精巧交互模块(DCN/xDeepFM/AutoInt)」走向「多算子统一架构」的关键转折点与前驱。它明确指出「同质模块堆叠有害、异质模块互补」,为后续把 Transformer / 因子分解 / MLP 等统一进一张网络(Wukong、HSTU、RankMixer、OneTrans 等)铺平了道路。在本文档库的 DAG 中,DHEN 已作为 TokenMixer-Large、RankMixer、LoopCTR 三条 baseline 边的 source,印证了其「被反复当作对比前作」的地位。
局限性 / 争议:
- 实验仅在 Meta 内部工业数据集上进行,且指标只有 NE,未在任何公开学术数据集(如 Criteo、Avazu)上评估,导致结果不可独立复现,也无法与学术界方法直接横向比较。这是本文最大的可复现性短板。
- AdvancedDLRM 未公开细节(论文明确说「为简洁省略」),作为主 baseline 的黑盒性质削弱了 Table 2/3 结论的可解释性。
- 交互模块组合是人工试验选出的(Table 1 靠枚举找到 Self-attention+Linear 最优),本文未提供自动化的模块选择机制——作者在 Future Work 中也承认可以引入「对各层的专用 gating 激活」「对 DHEN 每层引入 MoE 结构为不同样本分配专用层级」「共享/专用层支持多任务」等方向,说明当前 DHEN 的组合是手工的、次优的。
- HSDP 有明确适用边界:只对「尴尬规模」(内存刚超单 GPU)模型有效,最多支持纯 DP 规模的 8 倍,且带来 1.125x 通信字节开销——对真正超大(大型)DHEN 仍需回退 FSDP。
工业落地价值:本文是 Meta 广告排序的真实生产实践,0.27% 的 NE 增益在数十亿广告请求规模上意味着可观的收入提升;HSDP 已在 ZionEX 128-GPU pod 上验证,是可直接落地的分布式训练方案。