Prompt Generation Technical Report 精读¶
淘宝搜索团队(Alibaba / Taobao Search Team)出品的工业技术报告。核心不是一个新模型,而是一套配置驱动(configuration-driven)的特征工程框架 Prompt Generation(PG):把 LLM 生成式检索里"特征处理逻辑"从"模型结构"里彻底解耦出来,用两份声明式 JSON 文件(
prompt_template.json+prompt_feature.json)作为离线训练与在线服务的单一事实源(single source of truth),从而实现"快训练迭代、快部署、快在线推理"。已在淘宝搜索线上 A/B 取得成交笔数 +0.47%、GMV +0.51% 的统计显著收益,并作为多个淘系搜索/推荐团队的生成式检索迭代基础框架。
一、研究动机与背景¶
1.1 生成式检索的范式转变¶
大语言模型(LLM)在信息检索中催生了 generative retrieval(生成式检索) 范式:传统检索是对已有候选集做排序,而生成式检索直接生成目标 item 的标识符(如文档 ID、商品 ID、Semantic ID)。这一范式已成功应用于网页搜索(Metzler et al., 2021)、推荐系统(Rajput et al., 2023,即 TIGER)、赞助广告(Kong et al., 2025a)等场景,在捕捉复杂用户意图与 item 关系上展现出优势。与传统"query-candidate 显式匹配"不同,生成式模型把丰富的语义关系编码进参数,通过 seq-to-seq 建模生成相关结果。
1.2 工业落地的真正瓶颈:特征处理与模型结构的紧耦合¶
论文指出,把生成式检索模型部署到真实生产系统面临的核心技术挑战,是管理异构特征(heterogeneous features)。与传统检索里"特征工程有成熟范式"不同,LLM 生成式模型必须把多样的特征类型——原始文本字段、预计算 embedding、combo 组合特征、时序行为序列——统一整合进"结构化信息 + 自然语言上下文"的精心设计的 prompt 里。每种特征类型都需要独立的处理流水线,造成特征表示与模型输入格式之间复杂的相互纠缠。
论文把 root cause 精确地归纳为一句话(摘要):
特征处理逻辑与模型结构之间存在紧耦合,每一次特征改动都要触碰训练与服务两侧的代码,且难以跨场景复用。
由此派生出三类工业痛点:
- 手工实现特征处理逻辑易出错、且无法跨场景扩展——每个新应用域或新模型结构都可能需要大量重新工程;
- 训练-服务偏差(training-serving skew)——离线训练与在线服务两个环境的特征计算若不一致,会严重损害模型效果(Bitton et al., 2023);
- 在紧张的在线延迟预算下,缺少系统化的配置/校验/部署框架,成为快速实验与可靠部署的双重瓶颈。
1.3 PG 的解决思路¶
针对上述挑战,论文提出配置驱动的 Prompt Generation(PG) 框架,系统化地管理 LLM 生成式检索中的异构特征。如 Figure 1 所示,PG 把"特征处理"从"模型结构"里解耦,将静态流水线(GR without PG:需要预处理、模型相关、静态配置)转变为动态、模型无关(model-agnostic) 的流水线(GR with PG:快训练迭代、快部署、快在线推理、模型不变、动态配置)。
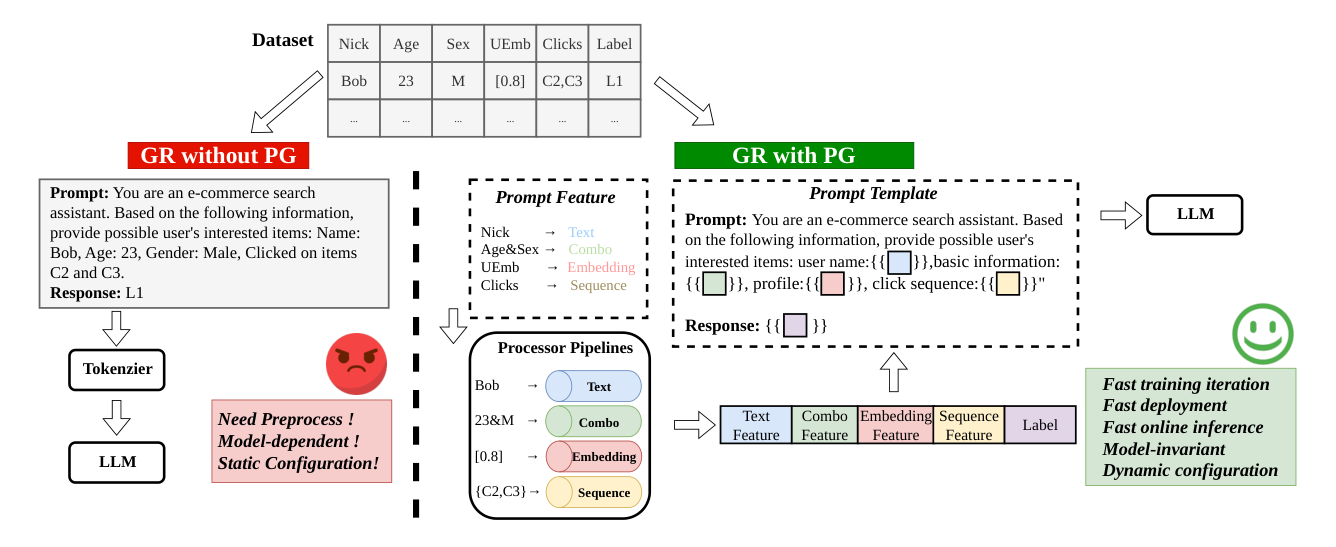
PG 的三个加速层次(对应摘要):
- (1) 快训练迭代(fast training iteration):特征实验只需改配置,且内置针对超长序列的 token 压缩;
- (2) 快部署(fast deployment):新场景只要让特征符合 PG schema、接入统一流水线即可,无需场景专属工程;
- (3) 快在线推理(fast online inference):引擎对标准化配置施加统一的优化,把 PG 的额外开销压到可忽略级别。
论文的主要贡献有四点:
- 设计了统一配置协议 Prompt Generation,通过声明式接口无缝集成 text / embedding / combo / sequence 四类特征,支持灵活的特征变换与压缩;
- 构建了灵活训练框架,仅靠改配置就能快速试验不同特征组合与 prompt 设计,并可与 LLM 驱动的 autoresearch agent 集成做自动化特征探索;
- 构建端到端"训练-服务"架构,配套事件追踪(event tracking)机制,把在线服务的源特征记录下来供离线训练回放,从而消除训练-服务偏差;
- 在淘宝搜索、淘宝推荐、三个开源 benchmark 上做了大量实验(特征实验、语义对齐分析、延迟分析),验证框架在大规模工业应用中的有效性与实用价值。
二、协议设计(Protocol Design)¶
2.1 设计总览¶
PG 采用配置驱动哲学,把特征处理逻辑与模型结构分离。核心是一个基于 JSON 的配置 schema,声明式地指定异构特征该如何被变换、组合、整合进 LLM prompt。这份配置在离线训练与在线推理两个环境里被一致地解释,保证两阶段特征计算对齐。设计遵循三条关键原则:
- 灵活性(flexibility):开发者通过简单改配置即可加入新特征或修改处理流水线,无需改代码或重新部署;
- 一致性(consistency):特征在离线训练与在线服务里被完全相同地计算,避免训练-服务偏差——靠的是两个环境共享同一套配置解析与特征处理组件;
- 可扩展性(extensibility):通过 plugin 架构支持自定义 preprocessor / projector / merger,在保持对已有配置向后兼容的同时容纳新的特征类型与处理组件。
2.2 特征类型分类法(Feature Type Taxonomy)¶
框架定义四种基础特征类型(Figure 2),刻意保持"窄"——因为每新增一种类型都要在离线+在线同时支持,类型爆炸会直接抬高工程与校验成本:
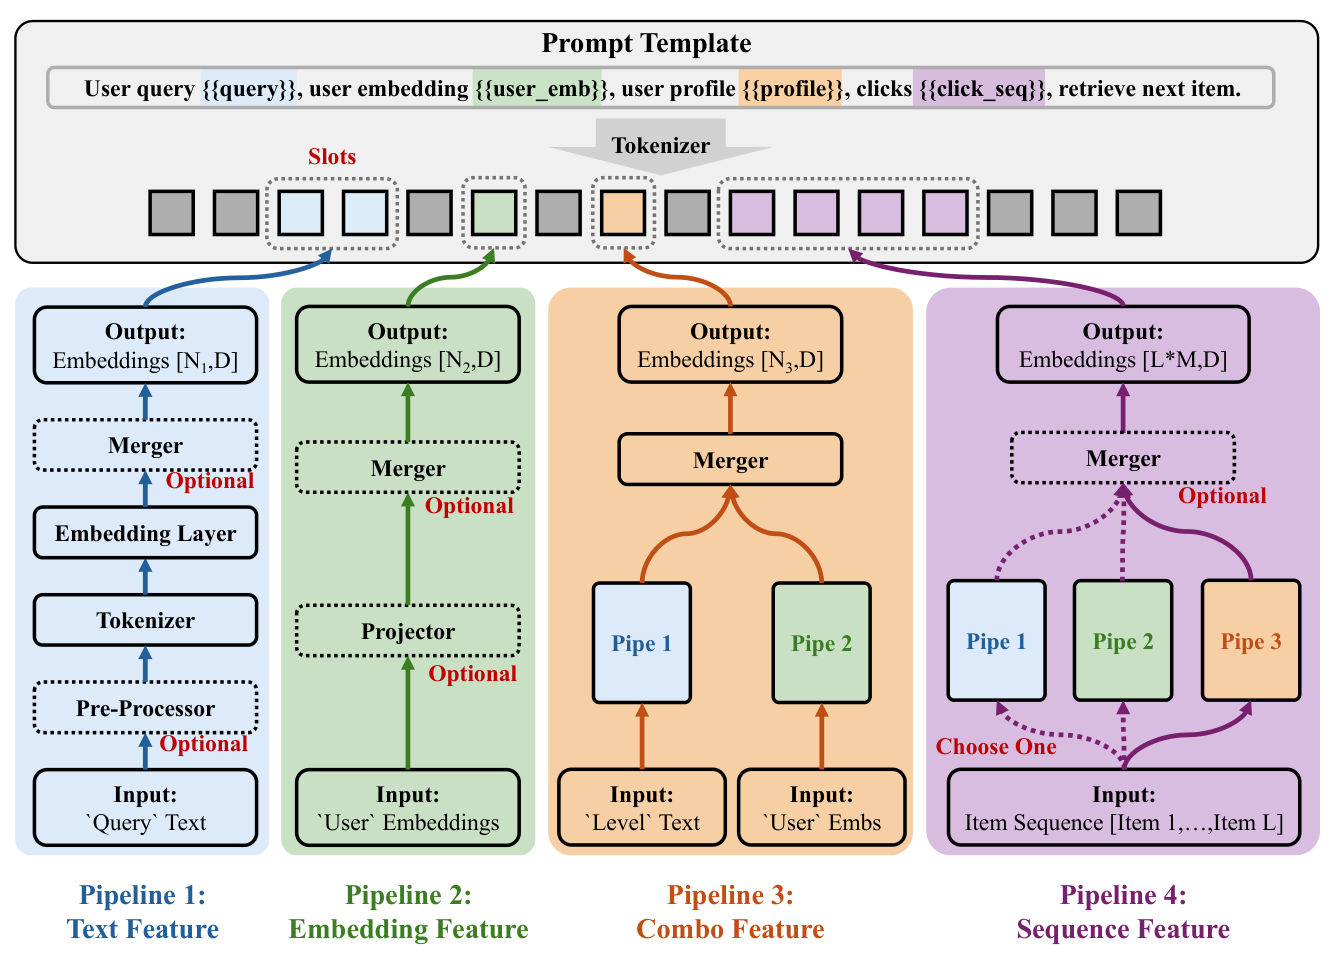
- Text Features(文本特征,蓝):接收原始字符串,直接嵌入 prompt 模板。经可选 preprocessor 变换后,原始串被 LLM 的 tokenizer 和 embedding 层 token 化并嵌入,借助模型学到的表示通过微调捕捉领域语义。典型用例:用户查询、商品标题/描述、类别型用户属性(如性别码经映射转成可读标签)。流水线:Input(
QueryText) → Pre-Processor(可选) → Tokenizer → Embedding Layer → Merger(可选) → Output[N₁, D]。 - Embedding Features(embedding 特征,绿):提供预计算稠密向量,绕过 LLM 的 tokenization 与 embedding 层。每个 embedding 以二维数组
[N, D]声明 shape(N 为向量数,D 为维度)。可选 projector(通常是 MLP)把 embedding 对齐到 LLM 隐层维度或适配预训练表示。支持 inline embedding 和外部表查找。典型用例:编码用户画像/偏好/行为的用户 embedding、代表商品视觉/文本/协同信号的 item embedding。流水线:Input(UserEmbeddings) → Projector(可选) → Merger(可选) → Output[N₂, D]。 - Combo Features(组合特征,橙):把多个任意类型(text/emb/combo)的子特征组合成单一统一表示。每个子特征按其类型各自处理,再用配置的 merger 策略融合。支持简单拼接和可训练 merger 的学习式融合。典型用例:item combo(合并商品 ID + 标题 + 类别)、user combo(合并用户属性 + 兴趣标签 + 行为信号)、上下文增强。流水线:Pipe1 / Pipe2 → Merger → Output
[N₃, D]。 - Sequence Features(序列特征,紫):表示时序/有序集合,每个元素由一个或多个任意类型子特征构成,但序列内所有元素必须共享同一子特征配置,保证序列内表示一致。框架通过截断策略灵活管理序列长度,在历史上下文与计算成本间权衡。典型用例:购买历史、点击历史、浏览序列、会话交互序列。流水线:Input(Item Sequence
[Item1,…,ItemL]) → 三选一 Pipe → Merger(可选) → Output[L*M, D]。
2.3 配置 Schema¶
配置由两份互补的 JSON 组成:
- feature 配置(
prompt_feature.json):声明特征及其类型、数据源、以及关联的处理组件(preprocessor / projector / merger); - template 配置(
prompt_template.json):定义 prompt 结构,用占位槽(placeholder slot,{{feature_name}}双大括号语法)对应到已配置特征,确定最终呈现给 LLM 的文本格式。
2.3.1 配置字段(Table 1)¶
Table 1 完整列出配置字段,分三类:basic settings(建立特征身份)、processing components(定义变换/融合操作)、control logic(处理边界情况与格式化)。核心必填字段是 feature_name、feature_type、expression:
| 字段 | 是否必填 | 说明 |
|---|---|---|
feature_name |
Yes | 模板中的占位标识符({{name}})+ 离线训练表字段名 |
feature_type |
Yes | 特征类型:text / emb / combo / sequence |
expression |
Yes | 在线服务的数据源规格 |
dimension |
emb | embedding shape [N, D](N 向量数,D 维度) |
features |
combo/seq | 子特征定义数组 |
sequence_length |
sequence | 最大序列元素数,仅离线训练用于截断(不做 padding) |
text_token_len |
text(可选) | tokenize 后的固定 token 数,某些 merger(如 concat_mlp 需定长输入)时必填 |
only_record |
可选 | 记录用于分析但不进模型输入 |
comment |
可选 | 文档用可读描述 |
pre_processors |
text(可选) | tokenize 前的链式预处理(mapping / bucketization) |
projector |
emb(可选) | 维度对齐模块(通常 MLP) |
merger |
combo(必填)/其他(可选) | token 聚合策略(mean / sum / concat_mlp)。combo 特征必填 |
empty_processor |
可选 | 空值处理:fill(默认填充)或 drop(省略特征)。drop 仅允许用于顶层 text/emb,不允许用于 combo/sequence 的子特征 |
prefix_text / suffix_text |
可选 | 在特征 token 前/后加文本,仅作用于未被 drop 的顶层特征 |
feature_name 的约束:
- 命名空间约束:
feature_name在同一层级内唯一,但可跨层级复用; - 模板作用域:模板占位符只能引用顶层
feature_name,combo/sequence 的子特征不能被模板直接使用; - 与离线表字段的映射:text/emb 特征支持一对一直接映射;combo 特征只作逻辑聚合器,
feature_name仅作模板占位、不映射到离线单列;sequence 特征的子特征离线列名由外层feature_name+_+ 子特征feature_name拼接自动推导(如click_seq+_+title→click_seq_title)。 - 之所以额外引入
expression字段,是因为在线服务与离线训练的数据源规格需求不同:feature_name承担离线表列名,expression承担在线数据源规格。
2.3.2 处理组件(Processing Components)¶
框架提供三类处理组件,作用于流水线不同阶段:Preprocessors(tokenize 前规范化文本值)、Projectors(对齐 embedding 维度)、Mergers(把多特征聚合成统一表示)。每类可按特征独立配置。
Preprocessors(仅作用于 text 特征),把原始字符串转成规范化表示,有两种:
- Mapping Preprocessor:通过字典查找把原始值转成可读标签/规范形式。参数:
dict(必填,源值→目标串映射)、default_value(可选,未命中时的兜底串;不指定则原样透传)。示例(Listing 1):把性别码"1"→"Male"、"2"→"Female",default"Unknown"。 - Bucketization Preprocessor:把连续数值离散化成类别桶,让模型通过文本表示学习数值特征。参数:
boundaries(必填,排好序的 float 列表)。对边界[a,b,c]生成桶(-∞,a)、[a,b)、[b,c)、[c,∞),映射为字符串桶索引。示例(Listing 2):年龄boundaries: [18,25,35,45,60]。
多个 preprocessor 可在 pre_processors 数组里链式串联,每步作用于上一步输出。
Projectors(对齐 embedding 维度到 LLM 隐层大小),当前支持 MLP,plugin 架构可扩展:
- MLP Projector:全连接层 + 激活。参数:
hidden_dimensions(可选,默认[],中间层维度数组)、activation(默认 relu)、use_bias(默认 true)、dropout(默认 0.0)、use_batch_norm(默认 false)。输出维度在初始化时自动定为模型 embedding 维度。示例(Listing 3):256 维输入 → 512、896 两隐层 → 模型 embedding 维。未指定 projector 时,embedding 必须已匹配模型隐层维度,直接喂入。
Mergers(把多特征聚合成统一表示),控制不同来源 token 如何组合。关键要求:所有输入特征在合并前必须维度一致(例如 embedding 与 text 特征合并前,embedding 必须经 projector 投到模型隐层维度,即便用 concat_mlp merger 也是如此)。
- Mean/Sum Merger:两种无参聚合。mean 做逐元素平均,sum 做逐元素加和,都产生单 token 表示(无论输入 size)。只接受
output_token_len参数,且必须为 1(Listing 4)。 - Concat-MLP Merger:沿 token 维拼接后过 MLP 产生定长输出,是更有表达力的学习式融合。参数:
output_token_len(默认 1,控制输出 token 数)、hidden_dimensions(默认[])、activation(默认 relu)、use_bias(默认 true)、dropout(默认 0.0)、use_batch_norm(默认 false)(Listing 5)。
Table 2 汇总所有处理组件参数。Merger 对 combo 特征必填、对其他类型可选,此时可用来把多个 token 压缩成更少表示。框架的 plugin 架构允许开发者通过注册机制实现自定义组件(如基于 self-attention 的 transformer merger 做上下文感知融合)。
2.3.3 控制逻辑(Control Logic)¶
处理缺失数据与 prompt 文本格式化:
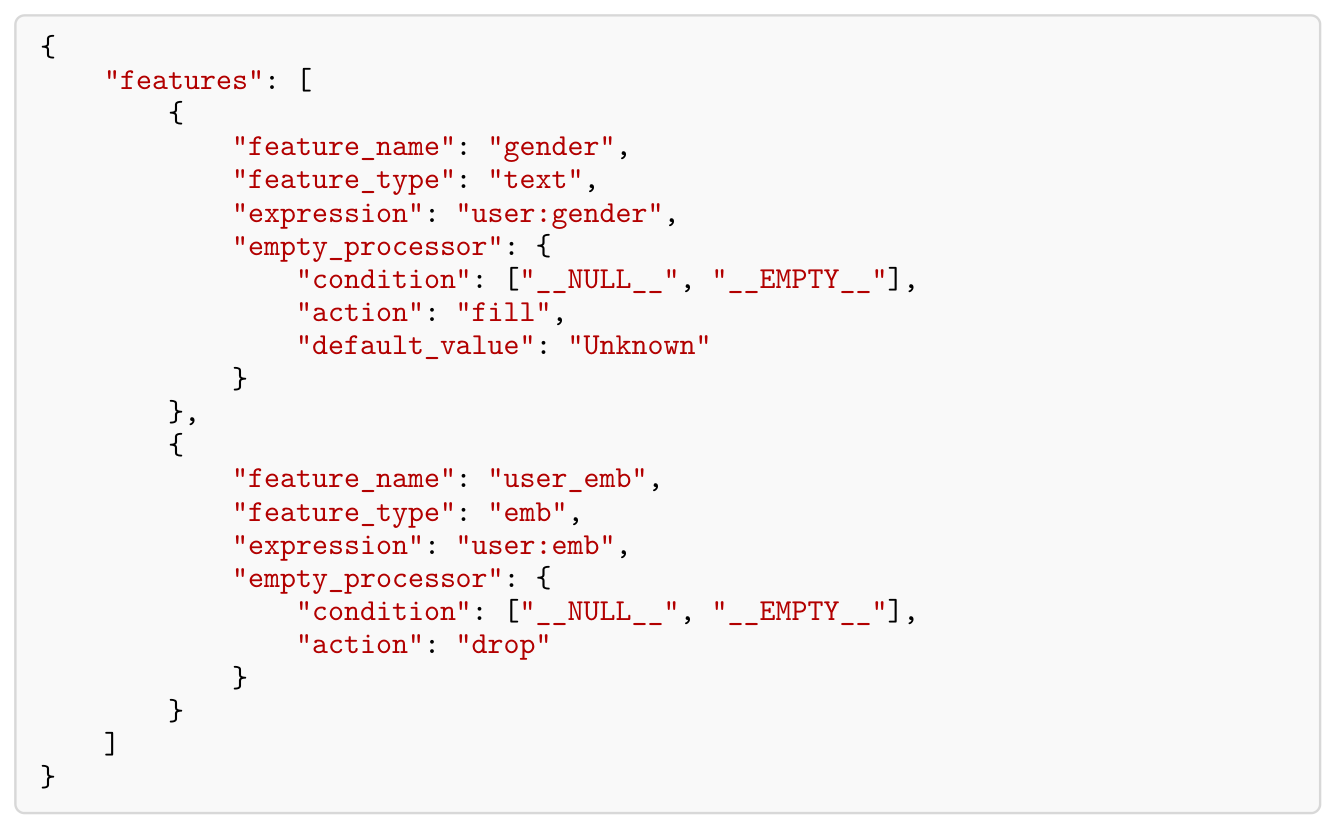
空值处理(Empty Value Handling)——empty_processor 配置,三个参数:condition(触发空处理的条件列表)、action(fill 或 drop)、default_value(fill 时的替换值)。condition 支持两个哨兵值:"__NULL__"(匹配 null/None)、"__EMPTY__"(匹配 text 的空串、emb 的空数组、sequence 的全空序列)。可同时指定多个条件。action="fill" 时缺失值被 default_value 替换、特征保留(default 类型必须与特征类型匹配);action="drop" 时特征缺失即整体从 prompt 排除,drop 仅允许顶层特征,combo/sequence 的子特征必须用 fill 以维持维度一致(Listing 6)。
Prefix/Suffix Text——prefix_text/suffix_text 在特征内容前/后加描述性上下文(任意字符串),实现结构化 prompt 格式化。只作用于顶层特征,combo/sequence 子特征不能有自己的 prefix/suffix(会干扰层级组合),默认为空串。作用有三:语义标签澄清特征含义(如 "User age: ")、通过标点维持语法结构、跨特征类型保持一致格式化。若特征因空处理被 drop,其 prefix/suffix 也一并排除(Listing 7)。
2.4 配置示例走查(Walkthrough)¶
Listing 8(template):"prompt": "User query {{query}}, user embedding {{user_emb}}, user profile {{profile}}, clicks {{click_seq}}, retrieve next item.", "response": "{{label}}"。Listing 9(feature)给出对应的完整特征配置,集成全部四类特征:query(text)、user_emb(emb,256 维,MLP projector 隐层 [512,896])、profile(combo,含 level(text,mean merger) 与 user_emb(emb,MLP),外层 concat_mlp merger)、click_seq(sequence,sequence_length: 20,子特征 item_id(text)、item_emb(emb,128 维,MLP),prefix_text: "Click history: ", suffix_text: ".")、label(text,expression: "item:item_id")。
模板与特征的对应关系:模板里每个占位符(如 {{query}})必须有一个匹配的顶层 feature_name;框架据 feature_name 建立一对一映射;生成时按类型处理每个特征、施加 preprocessor/projector/merger,再把结果 embedding 插入占位符标记的位置。这种"模板结构 vs 特征配置分离"使得试验不同特征组合与处理策略时无需改底层 prompt 格式。
三、系统架构与实现(System Architecture)¶
3.1 架构总览:训练-服务闭环¶
如 Figure 3,系统由两条流水线构成一个训练-服务闭环(training-serving closed loop):左侧离线训练流水线、右侧在线服务流水线。两条流水线共享同一套 PG 配置与配置文件以保证离线/在线一致。离线侧从训练表经 feature_name 抽特征、过配置好的 preprocessor/projector/merger、喂入 LLM 训练;在线侧从实时数据源(如用户画像)经 expression 取特征、施加相同处理序列、用部署模型生成结果。
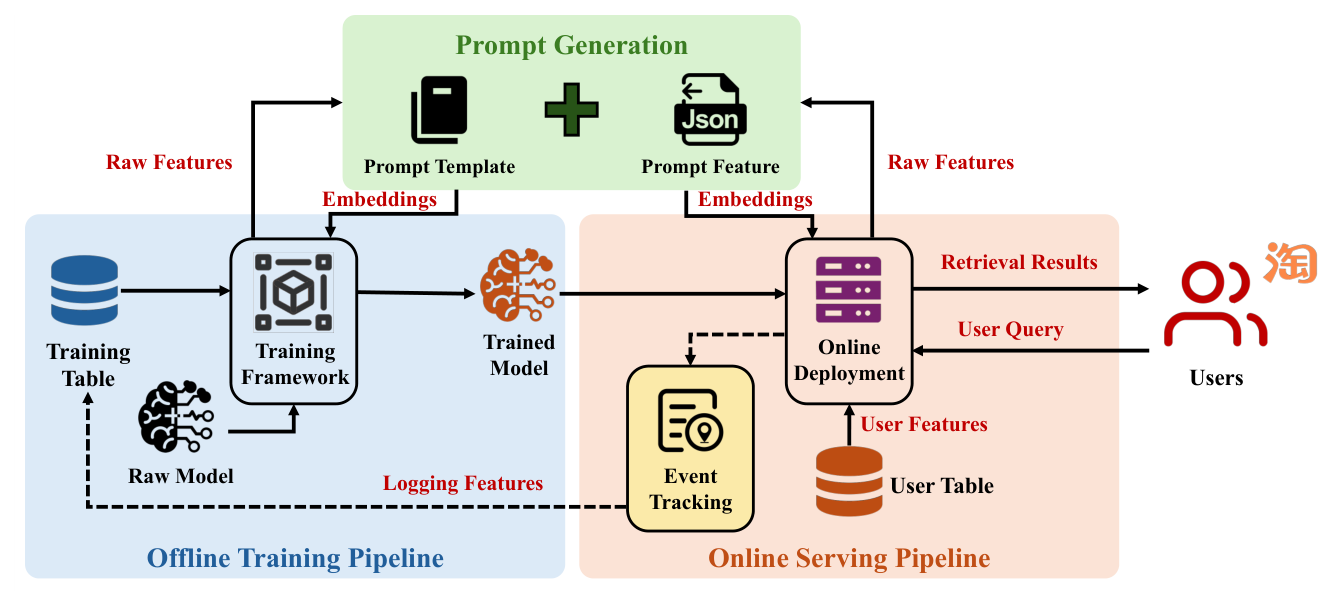
架构关键组件是事件追踪机制(event tracking)(Figure 3 的反馈回路):把在线服务请求的原始特征直接记录、持久化到训练表,让离线流水线回放推理时遇到的精确特征状态。这保证训练数据忠实于真实分布,有效消除训练-服务偏差;同时闭环设计便于调试、性能监控、以及由生产流量驱动的持续模型精调。
3.2 离线训练流水线¶
3.2.1 数据处理流水线(六阶段,Figure 4)¶
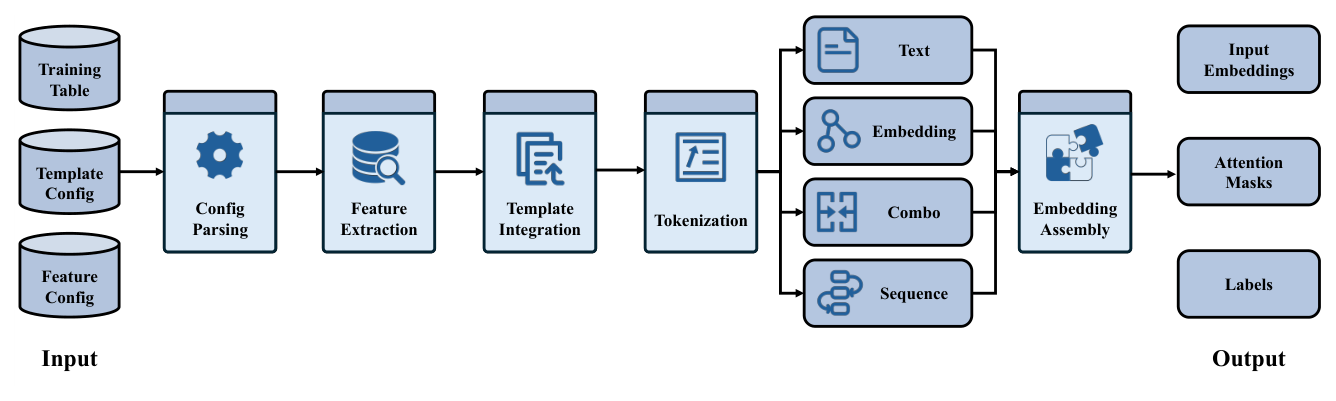
- Config Parsing:加载 template + feature 配置,构建特征处理器 registry(把模板占位符映射到对应处理器),建立处理图;
- Feature Extraction & Preprocessing:按字段路径从训练表取特征,先由 empty processor 按策略处理缺失/null,再由类型专属 preprocessor(mapping/bucketize)规范化;
- Template Integration with Placeholder Mechanism:预处理后的特征整合进模板,按配置加 prefix/suffix。文本部分(字面文本、prefix/suffix、text 特征值)保留为字符串,非文本位置标记占位标识符,产出含文本+占位符的模板切片,以及后续 embedding 替换用的"位置→特征"映射;
- Tokenization:模板文本切片用基座 LLM 的 tokenizer token 化。在占位符位置,系统通过其处理器推断每个特征的输出 embedding 数,插入相应数量的占位 token(
pg_pad_id) 预留精确空间,保证 tokenization 与后续 embedding 替换的序列长度一致;同时特征值由类型专属处理器并行处理准备生成 embedding; - Type-Specific Feature Processing:四类特征经独立路径处理(如 §2 所述),含可学习参数的变换模块(projection 层、merger 网络)与基座 LLM 联合优化;
- Embedding Assembly:扫描 token 化序列,把占位 token 替换为对应处理后的特征 embedding,产出文本 token 与特征 embedding 无缝交错的完整 embedding 序列。训练样本还会拼接 prompt+response embedding、生成 attention mask、构造标签(prompt 位置被 mask)。
3.2.2 训练框架集成¶
与 HuggingFace Transformers(Wolf et al., 2020)通过 wrapper 架构集成,在不改基座内部的前提下给标准因果 LM 加特征处理能力:
- 模型 wrapping 策略:维护两组参数、不同初始化——基座 LLM 参数从预训练 checkpoint 加载(保留语言理解),特征处理参数(projection 层、merger 网络)随机初始化或从此前的 PG checkpoint 加载。这样能无缝迁移到下游任务,兼享预训练知识与任务特定适配。
- 前向实现:用 KV-cache 检查机制区分"初始 prompt 处理"与"后续 token 生成"。cache 为空时识别为首次前向,激活特征处理层替换占位符、构造完整输入序列;cache 非空时(后续生成步)绕过特征处理层,把新 token 直接送 LLM。这样特征处理每样本只发生一次,消除多 token 生成时的重复开销。
3.3 在线推理架构¶
3.3.1 推理框架设计:两层架构¶
如 Figure 5,在线栈拆成两个协作组件 Prompt Service 和 Prompt Generator:
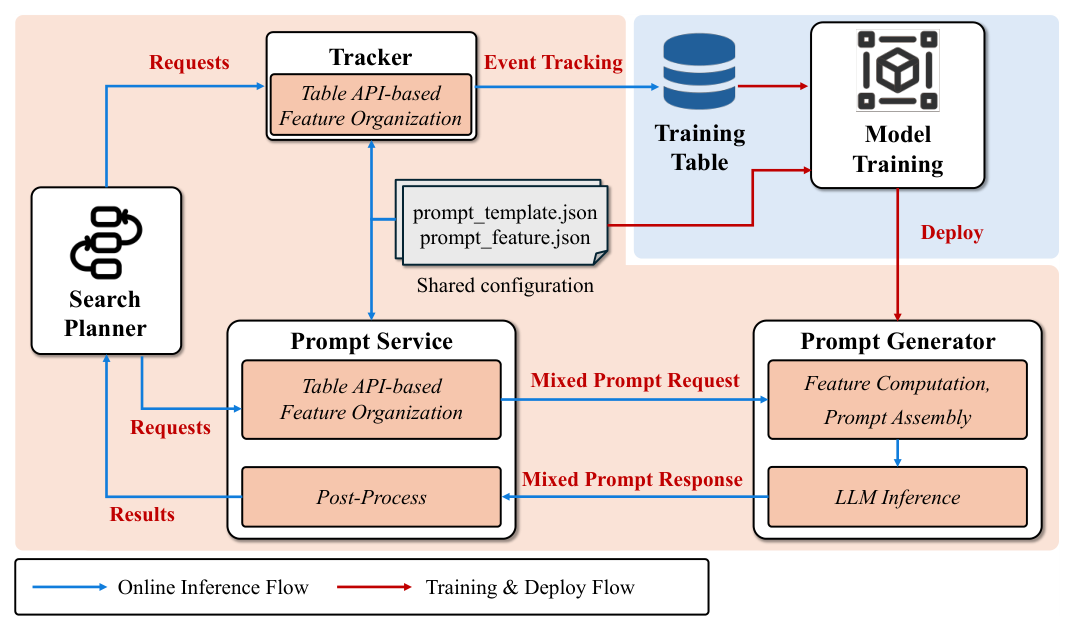
- Prompt Service(特征组织层):做 TableAPI-based 特征检索、特征预处理、混合输入组装,并在返回调用方前对模型输出做后处理;
- Prompt Generator(prompt 计算层):负责 tokenization、embedding 查找、模块 dispatch、最终 prompt 组装,再调用建在 RTP-LLM(Alibaba, 2025) 上的推理后端做 LLM 推理。
这种拆分把 I/O-bound 的特征工作与 compute-bound 的张量工作隔离,两层可独立扩容、批处理、加速。
共享请求协议:两层通过一对结构化消息 MixedPromptRequest / MixedPromptResponse 通信。MixedPromptRequest 携带一个 prompt template、一个有序的 MixedFeature 列表、一份生成配置;MixedPromptResponse 携带推理输出(token IDs / 解码文本 / embedding 张量三者之一)加错误与 trace 信息。MixedFeature 是支持四类型(TEXT / TOKEN / EMBEDDING / COMPOUND)的递归数据类型,内部数据载荷与控制信息刻意解耦,使 Prompt Generator 能延迟操作而不阻塞请求线程。请求在与离线训练相同的 template+feature 配置下被解释,保证离线-在线一致。在线额外引入 module 配置(prompt_module.json),从离线训练好的模型自动导出,在部署时把 merger/projector 等特征处理模块的已学习参数带进在线栈。
推理流水线(Prompt Generator 七步): 1. Request deserialization:反序列化所有 MixedFeature 得到执行逻辑; 2. Embedding lookup:按类型解析每个 MixedFeature 成 item embedding——TEXT 是 tokenize-then-lookup,TOKEN 是直接 lookup,EMB 用携带的 embedding,COMPOUND 对子特征递归; 3. Module dispatch:按依赖序调用每个 MixedFeature 引用的模块,dispatch 到预定义或用户自定义算子,产出 per-feature embedding; 4. Template embedding:从词表查 prompt template 的 token embedding; 5. Placeholder substitution:把第三步 per-feature embedding 插入 template 的特殊 token 位,得到完整 LLM 输入 embedding; 6. LLM inference:执行标准 LLM 推理; 7. Response assembly:经 MixedPromptResponse 把结果返回 Prompt Service。
为满足生产毫秒级延迟预算,沿推理流水线额外施加四项优化:(1) merger/projector 模块的内存池复用 + torch.compile;(2) per-feature 处理器的批量执行摊薄 kernel-launch 开销;(3) 并行多流 dispatch + 降低 beam-search 主机侧开销;(4) beam-search 内存布局优化。详细结果见 §4.5.2。
3.3.2 事件追踪(Event Tracking)¶
工业搜广推里用户行为持续演化,同一用户在不同请求取到的序列特征可能不同,极大复杂化训练表构建。常见做法是按请求时间戳过滤离线行为序列,但工程量大、且离线/在线预处理路径一分歧就会特征错位。PG 改用全覆盖事件追踪流水线,把服务时消费的原始特征持久化回训练表(Figure 5)。因为在线服务与离线训练共享同一 feature+template 配置,训练时从回放特征组装出的 prompt 在构造上与在线所用完全相同。实践中该机制实现在线服务与离线训练间 >99% 的特征一致性。
四、实验(Experiments)¶
实验目标不是穷举所有特征工程选择,而是验证 PG 能通过统一配置协议适配多种基座模型、多种应用场景、多种数据规模,同时保持有竞争力的检索质量。评测覆盖:淘宝搜索、淘宝推荐、三个开源 benchmark 的特征实验,以及语义对齐分析与延迟分析。
说明:为避免披露绝对生产指标,多数 HR 分数以相对 baseline 的相对增益(%) 报告。
4.1 淘宝搜索特征实验¶
任务:预测用户在一次搜索会话内会购买的具体商品,框成生成式预测问题——模型生成目标商品的 3 位 Semantic ID(SID)。输入 prompt 由三部分构成:文本用户画像(如性别)、当前搜索 query、时序历史行为序列(每次交互带 item SID + 商品标题、店铺名、交互时间戳等上下文信号)。
设置:数据取自真实淘宝搜索日志,连续三天成交样本训练、第四天子集评测(时间切分模拟"泛化到未来未见流量")。指标用 HR@50(头部热门 item 的准确率)与 HR@5000(长尾 item 的覆盖率)。基座为 Qwen2.5-Instruct-0.5B(Yang et al., 2024)微调生成目标 SID,推理用 dynamic beam search(Freitag & Al-Onaizan, 2017)产 top-K 候选。所有 HR 以相对 SID-only baseline(锚定 0.00%)的相对增益报告。
离线结果(Table 3,8 种特征配置,同一 backbone + decoding):
| Configuration | Token Length | Train Time | ΔHR@50 | ΔHR@5000 |
|---|---|---|---|---|
| SID only | 251 | 3.88h | 0.00% | 0.00% |
| SID + title | 667 | 6.27h | +0.26% | −0.04% |
| SID + shop name | 335 | 5.28h | +0.50% | +0.09% |
| SID + timestamp | 267 | 4.21h | +0.23% | +0.23% |
| SID + mean(title) | 267 | 4.26h | +0.15% | +0.25% |
| SID + mean(shop name) | 267 | 4.19h | +0.12% | +0.11% |
| SID + combo_mean(mean(title), timestamp, mean(shop name)) | 267 | 4.65h | +0.61% | +0.31% |
| SID + combo_mlp(mean(title), timestamp, mean(shop name)) | 267 | 4.68h | +0.35% | +0.22% |
结论:加任一上下文特征(title/shop name/timestamp)在 HR@50 上都有小而稳定的增益,说明三个信号都携带有用信息。但朴素拼接原始 title 会把 prompt token 数从 251 撑到 667(约 2.7×)、训练时间同步拉长,且 HR@5000 无可测提升。用 mean-pool merger 替代原始拼接,能把 token 预算维持在 SID-only 同级、同时保留大部分 per-feature 增益。用 combo(mean) 算子组合三个 side feature 得到最强配置:HR@50 +0.61%、HR@5000 +0.31% 双最优;同特征集下 combo(MLP) 变体略弱。这说明 PG 把 per-feature merger 与多特征 combinator 都暴露成可配置组件,能在不改模型代码的前提下支持高效有效的特征探索。
4.2 淘宝推荐特征实验¶
任务:预测用户点击 trigger 商品后、在单列会话内会交互的具体商品。相比搜索用 2 位 SID。输入 prompt 三部分:文本用户画像、当前会话 trigger 商品的 SID 与上下文特征(类别/品牌/卖家)、时序历史交互序列(每次交互带 item SID、类别、动作类型 click/purchase、距今时长)。
设置:真实淘宝推荐日志,连续五天训练、第六天子集评测。指标 HR@20 / HR@200 / HR@2000(覆盖 head/mid/long-tail)。基座 Qwen2.5-Instruct-0.5B,dynamic beam search。此处固定特征集(item SID、category、action type、elapsed time),研究不同 prompt 组合方式的影响,并用 attention merger 扩展 PG(子特征经 attention 层组合,通过 plugin registry 注册,不改框架本体)。所有 HR 以相对 2-stage mean-pool baseline(锚 0.00%)报告。
离线结果(Table 4,6 种配置):
| Configuration | Token Length | ΔHR@20 | ΔHR@200 | ΔHR@2000 |
|---|---|---|---|---|
| mean(mean(SID)+mean(category)+mean(time)+mean(action_type))(baseline) | 234 | 0.00% | 0.00% | 0.00% |
| SID + category + time + action_type(未合并) | 790 | +4.32% | +3.19% | +1.78% |
| mean(SID)+mean(category)+mean(time)+mean(action_type) | 516 | +0.93% | +1.34% | +0.47% |
| mlp(mean(SID)+mean(category)+mean(time)+mean(action_type)) | 234 | −0.88% | +0.76% | −0.24% |
| attention(mean(SID)+mean(category)+mean(time)+mean(action_type)) | 234 | −0.72% | +0.44% | +0.08% |
| attention(SID + mean(category)+mean(time)+mean(action_type)) | 234 | +0.08% | +0.08% | −0.05% |
结论:未合并变体(790 token,3.4× 长)给出最强绝对 HR(+4.32%/+3.19%/+1.78%);单阶段 feature-wise pooling 变体(516 token)把 prompt 减半、且恢复了大部分头部增益,是更平衡的折中。在同 234-token 预算下,用学习式 combo(over fully pooled 子特征,rows 4-5)不能稳定超 baseline,MLP 与 attention 变体在 HR@20 上都退化;把 SID 子特征在 attention combo 内保持不 pool(row 6)能消除该退化、三指标与 baseline 持平。没有单一配置在所有轴上占优,最优选择取决于可用 token 预算——PG 让所有这些变体(含用户自定义 merger)都能低成本试验。此外 PG 在此场景可缩放到极端序列长度:一个原始序列达 45K token 的配置经 PG 压到约 11K token,仍能带来进一步离线增益——token 压缩让本来不可行的超长序列变得可用。
4.3 开源 benchmark 特征实验¶
在三个开源电商 benchmark 上评测,它们有异构特征结构、不同 SID 格式、不同 backbone:S1-tiny(来自 FORGE, Fu et al., 2025)、RecIF(来自 OpenOneRec, Zhou et al., 2025)、Amazon Reviews 2018(Ni et al., 2019,MiniOneRec 预处理的两个域)。所有 benchmark 用 dynamic beam search、beam 宽渐进扩展产足够大候选集。
Table 5(benchmark 统计):
| Dataset | Source | Train | Test | Base Model | SID Tokens | Main Metric |
|---|---|---|---|---|---|---|
| S1-tiny | FORGE | 15,697,100 | 9,794 | Qwen2.5-Instruct-0.5B | 3 | HR@K |
| RecIF | OpenOneRec | 113,210 | 27,910 | OneRec-1.7B-pro-pretrain | 5 | Pass@K |
| Amazon (Ind&Sci) | MiniOneRec | 36,259 | 4,533 | Qwen2.5-Instruct-0.5B | 3 | HR@K |
| Amazon (Office) | MiniOneRec | 36,586 | 4,828 | Qwen2.5-Instruct-0.5B | 3 | HR@K |
4.3.1 S1-tiny¶
含 item SID 序列、标题、多模态 item embedding,约 15.7M 训练 / 9,794 测试、每 item 3 SID token。基座 Qwen2.5-Instruct-0.5B(扩展 SID 词表),报 HR@{20,100,500,1000}。Figure 6 展示不同配置的 token 级构造,核心差异在于文本/embedding 信号是被直接展开还是先经 merger 压缩再进序列。
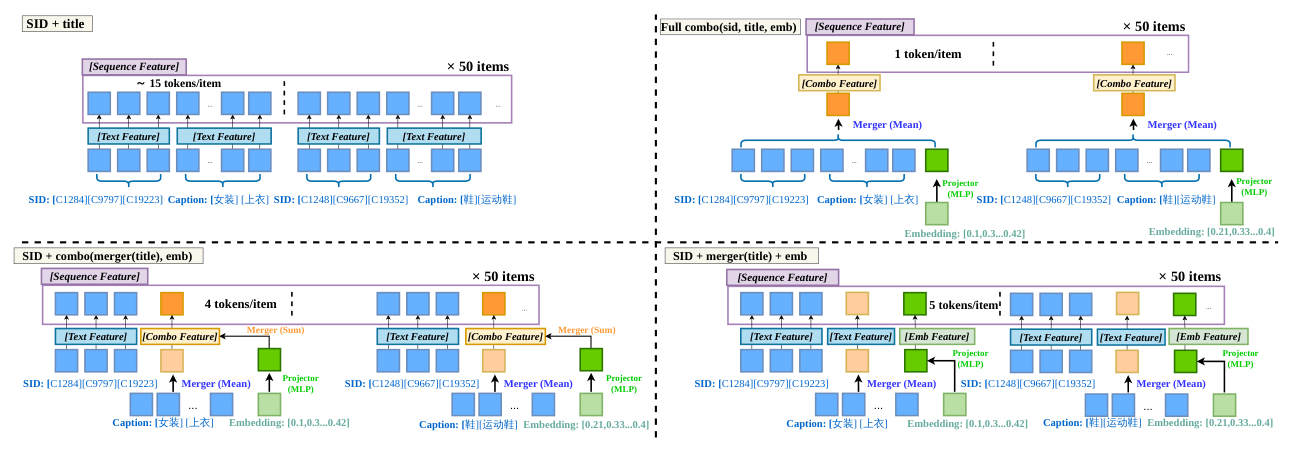
Table 6(S1-tiny 结果):
| Configuration | Tokens/Item | HR@20 | HR@100 | HR@500 | HR@1000 |
|---|---|---|---|---|---|
| SID only | 3 | 1.86 | 4.14 | 8.81 | 10.04 |
| SID + title | ~15 | 1.77 | 4.18 | 8.62 | 9.72 |
| SID + emb | 4 | 1.83 | 4.22 | 8.91 | 10.16 |
| SID + combo(title, emb) | 4 | 1.81 | 4.30 | 8.84 | 10.08 |
| SID + combo(merger(title), emb) | 4 | 1.75 | 4.41 | 9.29 | 10.41 |
| SID + merger(title) | 4 | 1.71 | 4.12 | 8.72 | 9.91 |
| SID + merger(title) + emb | 5 | 1.58 | 4.40 | 9.00 | 10.35 |
| Full combo(sid, title, emb) | 1 | 0.19 | 0.73 | 2.37 | 2.97 |
结论:PG 能通过不同 merger 策略灵活纳入 text 与 embedding 特征。加 embedding 相对 SID-only 有小而稳的增益;最优是先压缩 title 再与 embedding 组合(SID + combo(merger(title), emb)),说明 PG 能在不过度拉长 prompt 的前提下有效融合异构信号。反例极其关键:把 SID 与 text、embedding 全压进单个 combo token(Full combo,1 token/item)导致性能断崖式下跌(HR@20 从 1.86 → 0.19),表明 SID 应保持为显式结构信号、不应被过度合并。
4.3.2 RecIF¶
跨域推荐 benchmark,选有效目标标注 + 足够丰富关联特征的样本构电商子集,约 113K 训练 / 27.9K 测试、每 item 5 SID token。用官方 OneRec-1.7B-pro-pretrain checkpoint(codebook 已覆盖对应 SID)。报 Pass@{1,32,128}。相比 S1-tiny,RecIF 是不同 SID 格式、更长序列、更大 backbone,是跨模型跨域适配性的测试床。
Table 7(RecIF 结果):
| Configuration | Seq. Length | Pass@1 | Pass@32 | Pass@128 |
|---|---|---|---|---|
| Goods SID only | 50 | 3.13 | 22.90 | 34.70 |
| Goods SID only | 100 | 3.11 | 23.11 | 34.96 |
| Goods SID + merger(caption) | 50 | 3.27 | 24.01 | 35.80 |
| Goods SID + video SID | 50 | 3.24 | 23.03 | 34.90 |
| Goods SID + merger(caption) + video SID | 50 | 3.29 | 24.21 | 36.34 |
结论:把 goods SID 序列从 50 延长到 100 只带来边际提升,说明单纯增加历史上下文收益递减——这也凸显 PG 一个实际优势:序列长度可在特征层灵活配置,让开发者在不改模型的前提下平衡效果与算力。加压缩后的 caption 文本带来明显增益,再引入 video SID 信息得到最佳。表明 PG 能仅靠配置自然支持跨域信号,且紧凑文本压缩是"注入辅助语义而不猛增序列长度"的实用手段。
4.3.3 Amazon Reviews¶
用 MiniOneRec 预处理的两个域:Industrial&Scientific(36,259 训 / 4,533 测)、Office_Products(36,586 训 / 4,828 测),每 item 3 SID token,两域训练集都相对小、用户历史短。基座 Qwen2.5-Instruct-0.5B(扩展 SID 词表),报 HR@{1,5,10,20,50}。
Table 8(Amazon 双域结果):
| Configuration | Ind&Sci HR@1 | @5 | @10 | @20 | @50 | Office HR@1 | @5 | @10 | @20 | @50 |
|---|---|---|---|---|---|---|---|---|---|---|
| SID only | 7.21 | 10.08 | 11.54 | 13.66 | 17.23 | 7.52 | 11.27 | 12.99 | 14.66 | 18.81 |
| + Title | 7.35 | 10.02 | 11.69 | 13.74 | 17.12 | 8.06 | 11.16 | 12.70 | 14.73 | 18.25 |
| + Title + Brand | 6.99 | 9.66 | 11.41 | 13.21 | 16.92 | 7.93 | 11.39 | 12.86 | 15.18 | 18.93 |
| + merger(Title) + merger(Desc) | 6.95 | 9.55 | 11.27 | 13.66 | 17.30 | 7.81 | 10.89 | 12.39 | 14.52 | 18.14 |
| + merger(Title) + merger(Brand) | 7.08 | 10.15 | 11.29 | 13.04 | 16.96 | 7.60 | 11.47 | 12.88 | 14.95 | 19.37 |
结论:两域最优配置不同——Ind&Sci 上加文本增益整体小、简单 +Title 最好;Office 上 merger-based +merger(Title)+merger(Brand) 整体最强。两域都有若干变体低于 SID-only,说明单纯加更多文本并非总有益,这很可能是因为小训练集(~36K)限制了模型可靠利用额外文本信号的能力、使额外特征的边际收益不稳定。最优组合依任务而定,PG 让这种探索只靠改配置即可完成。
4.3.4 开源实验小结(三点观察)¶
- 组合多源特征(SID、文本描述、多模态 embedding)常带来互补信息、提升检索质量;
- 直接把原始文本特征拼进 prompt 并非最佳,merger 是"控制 token 预算同时保留相关语义"的有效手段,且在若干设置里比未压缩版更稳定;
- 尽管三 benchmark 有不同 backbone、SID 编码、任务设置,PG 都能适配,上述特征组合探索全靠改 PG 配置、不改任何模型或流水线代码。
4.4 语义对齐实验(Alignment Experiments)¶
证明 PG 的配置协议能自然延伸到 Pre-SFT 对齐阶段,其 merger/combo 组件可直接复用来设计对齐任务、无需额外代码。生成式检索需在下游微调前,为新引入的 SID token 学到有意义 embedding。论文把它实例化为 Pre-SFT 阶段,混合两族对齐数据:SID semantic alignment(Item2SID、SID+Merger(Title)2Title、SID2Cate,桥接 SID 与 item 侧信息)与 SID semantic retrieval(Query2SID,把用户 query 映射到相关 SID)。其中 SID+Merger(Title)2Title 是直接优化 merger 算子的重建任务,Item2SID 与 Query2SID 采样比进一步提高(下游目标是 SID 生成)。Pre-SFT 消费 300M 对齐样本,后续 SFT 用 14 天淘宝搜索行为日志。基座 Qwen2.5-0.5B,下游 SFT 沿用 §4.1 的 SID+Mean(Title) 配置,两对比变体唯一差异就是是否施加对齐 Pre-SFT。评测 search_pay(购买事件)与 search_ipv(item page view 事件),HR@{20,50,100,500,1000,5000}。
Table 9(Pre-SFT 对齐数据集统计):
| Data Type | Input | Output | Samples |
|---|---|---|---|
| Item2SID | Enriched item title | Semantic ID | 100M |
| SID+Merger(Title)2Title | Semantic ID with merged title | Item title | 50M |
| SID2Cate | Semantic ID | Item category | 50M |
| Query2SID | User query | Semantic ID | 100M |
Table 10(对齐 Pre-SFT 对淘宝搜索评测的效果,相对 w/o alignment baseline 的 HR 相对增益 %):
| Slice | ΔHR@20 | ΔHR@50 | ΔHR@100 | ΔHR@500 | ΔHR@1000 | ΔHR@5000 |
|---|---|---|---|---|---|---|
| search_pay | +1.36% | +1.84% | +2.15% | +2.89% | +2.88% | +3.14% |
| search_ipv | +1.63% | +2.15% | +2.71% | +3.80% | +4.06% | +4.56% |
结论:加 Pre-SFT 在两指标上都带来一致正增益,search_pay +1.36%~+3.14%、search_ipv +1.63%~+4.56%,且相对增益随 K 增大而增长。HR@1000/HR@5000 增益最大,说明对齐尤其惠及长尾覆盖、拓宽了模型能正确召回的候选池。这表明 PG 能把语义 ID 对齐作为一个干净的 Pre-SFT 阶段来支持,其 merger/combo 配置机制在 Pre-SFT 数据设计中依然可用、无需改模型代码。
4.5 延迟分析(Latency Analysis)¶
4.5.1 训练速度¶
设置:单节点 8× NVIDIA A100-80G、128 CPU 核、1024GB 主机内存,基座 Qwen2.5-Instruct-0.5B,速度以 iter/s + 单步 wall-clock 度量。构造覆盖代表性 PG 配置的 4 个真实生产场景(Table 11):
| Scenario | #Feats | #Text | #Combo | #Seq | Seq total len | #Merger/projector | Avg LLM input |
|---|---|---|---|---|---|---|---|
| S1(简单短序列) | 8 | 6 | 0 | 2 | 100 | 5 | 205 |
| S2(中等,多长序列) | 10 | 5 | 0 | 5 | 1200 | 10 | 794 |
| S3(复杂,序列密集) | 23 | 9 | 0 | 14 | 1304 | 84 | 1093 |
| S4(深嵌套 combo,长输入) | 32 | 20 | 5 | 7 | 105 | 116 | 3260 |
性能挑战(以最密集的 S3 为优化目标):baseline 有两大瓶颈——(a) List/dict 特征存储:中间特征值存于 Python list/dict 容器,触发 accelerate/Transformers/PyTorch DDP 里的深度遍历 hook,抬高单步开销;(b) per-feature 碎片化执行:序列/combo 特征逐特征组装、merger/projector 逐特征调用,每个操作太小无法摊薄 kernel-launch 开销,GPU 大部分时间在 launch kernel 而非计算。
性能优化(四阶段渐进): 1. Phase 1:遍历安全的特征容器——用两个不被深度遍历 hook 识别的自定义容器类替换 Python list/dict,消除单步遍历开销; 2. Phase 2:批量序列与 combo 组装——把整批序列/combo 特征拍平进单个 embedding 张量、用一个 index 张量一次性组装,把 per-feature 组装换成单个 grouped 操作; 3. Phase 3:分层批量 merger/projector 执行——把同一嵌套层级、同类型的 merger/projector 调用分组成单个 batched call,跨共享算子的特征摊薄 kernel-launch 开销; 4. Phase 4:C++ index-tensor 构造——用 C++ 重实现 index 张量构造,移除组装路径上残留的 Python 侧开销。
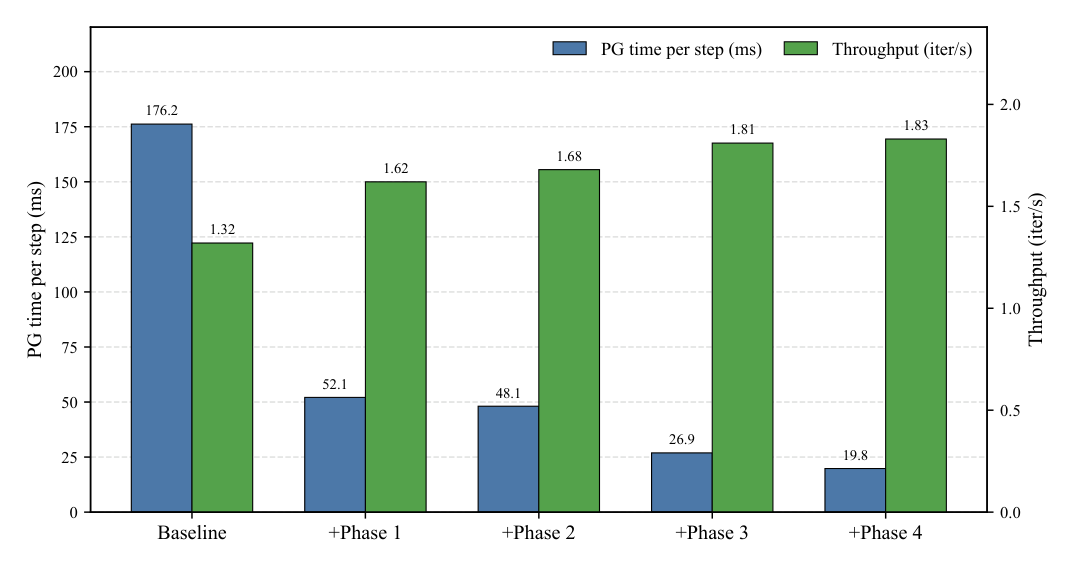
结果:S3 上 PG 时间从 baseline 的 176.2ms 降到 Phase 4 的 19.8ms(−88.8%),throughput 从 1.32 → 1.83 iter/s(+38.6%),GPU 利用率从 63% → 86%。优化后 PG 相关阶段仅占总步时的 3.6%,其余成本转移到 LLM 前向/反向。
逐场景开销(Table 12,PG+LLM vs 纯 LLM baseline):
| Scenario | Batch size | Avg LLM input | Pure LLM step (ms) | PG+LLM step (ms) | PG time (ms) | PG share |
|---|---|---|---|---|---|---|
| S1 | 10 | 205 | 166.7 | 172.3 | 5.6 | 3.2% |
| S2 | 10 | 794 | 379.8 | 447.7 | 67.9 | 15.1% |
| S3 | 10 | 1093 | 470.1 | 544.2 | 74.1 | 13.6% |
| S4 | 5 | 3260 | 614.2 | 643.6 | 29.4 | 4.5% |
PG 每步加 5.6~74.1ms(占总步时 3.2%~15.1%),在生产训练可接受。两个观察:其一,批量执行优化消除了 merger/projector 成本——S3 的 merger 数是 S2 的 8.4×(84 vs 10),但 PG 时间只多 9%(67.9→74.1ms);其二,随 LLM 输入变长,PG 占比缩小——S4 输入最长(3260 token),PG 占比仅 4.5%(尽管绝对成本非零)。
4.5.2 推理速度¶
设置:在淘宝 Newdetail(ND) 场景(Home Guess 核心推荐场景之一)测推理性能。单 ND 请求含一个生成式推荐 query、12 个占位特征排成嵌套 compound 结构,后接变宽 beam search(第一步 128 beam,第二步扩到 1024),max_new_tokens=2。基座 Qwen2.5-0.5B,部署于单 NVIDIA H20 GPU、BF16。稳态负载下测 P50/P99 端到端响应时间(RT)与可持续 QPS。
性能挑战(优化前):GPU kernel 碎片化(数十个 per-feature 处理器负载远小于 kernel-launch 开销)、频繁 CUDA 内存分配(中间张量每请求 alloc/free,cudaMalloc 成本累积)、Python dispatch 开销(eager 模式下 Python→C++→CUDA 链主导小模块运行时)、RTP-LLM beam-buffer 过度分配(变宽 beam 在两解码步间从 128 涨到 1024,强制按最坏情况分配 beam buffer)、RTP-LLM 串行 per-stream dispatch(1024 beam 时逐流 dispatch 使后端在高并发下变成 CPU-bound)。
性能优化(四阶段):
1. Phase 1:张量复用 + 消除 Python dispatch——引入 CUDA tensor pool 跨请求回收中间 buffer,对 merger/projector 施 torch.compile 去 Python 侧 dispatch,用 slice-assignment 替换 concat_mlp 路径的张量拼接避免额外分配;
2. Phase 2:批量特征处理——把 per-feature 执行重构成四阶段流水线(build trees / collect leaves / batch process / process trees),把数十个小处理器调用融合成少量 grouped GPU kernel;
3. Phase 3:并行流 dispatch + 更轻的 beam-search 主机运行时——RTP-LLM 内用线程池并行 per-stream dispatch、缓存 sampler 主机 buffer、模板化 KV-cache 管理路径,消除 1024 beam 时的 CPU 瓶颈;
4. Phase 4:beam-search 内存布局——用按实际生成长度的按需分配替换 beam-search token buffer 的最坏情况预分配,跳过不必要的 beam-logits 拷贝,进一步降内存流量与 dispatch 成本。
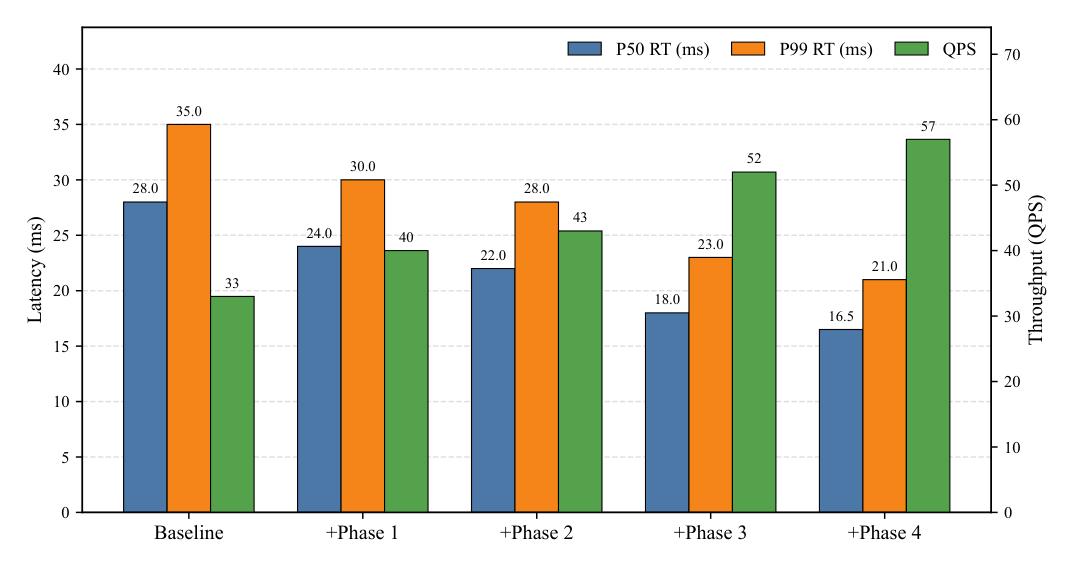
结果:四阶段复合后,端到端 P50 RT 从 28.0ms → 16.5ms(−41%)、P99 RT 从 35.0ms → 21.0ms(−40%)、可持续 QPS 从 33 → 57(+73%)。Phase 1-2 把 Python 特征处理路径重塑成内存/dispatch 友好,Phase 3-4 把 C++ 后端围绕动态增长的 beam-search 负载重塑。这让生成式推荐系统能以更低硬件成本服务生产流量,并为更大 beam 宽和更复杂特征配置留出裕量。
4.6 线上部署(Online Deployment)¶
PG 已在淘系多个搜索/推荐场景生产落地。每个场景采用 PG 只需写两份声明式配置(prompt_template.json + prompt_feature.json)、并通过 plugin registry 注册任何场景专属 merger;同一份配置驱动离线训练与在线服务,服务路径不加任何场景专属代码,§4.5.2 的推理优化直接适用。各场景部署在各自生产集群硬件上,故服务硬件因部署而异。
- Taobao Search(淘宝搜索):与 §4.1 同 Qwen2.5-0.5B 基座,PG 组装丰富特征配置并从 1400+ token 压缩到平均 610 token 再入模型。PG 作为新召回通道接入(统一召回与粗排,其生成候选直送精排阶段)。在 1% 搜索流量、14 天的线上 A/B 中,PG 通道相对同款无 PG 生产系统带来成交笔数 +0.47%、GMV +0.51%。在召回通道层面,PG 通道成交占比提升 +12pp、其独占成交(不被任何其他通道覆盖的部分)提升 +0.8pp,说明它贡献了实质且大体不重叠的覆盖。count 与 GMV 同时提升说明既提高了用户转化又带来更大商业影响。服务跑在 NVIDIA H20 GPU,端到端响应时间 60ms。
- Taobao Recommendation(淘宝推荐 / Home Guess 的 ND 场景):baseline 是无 PG、约 800 token 输入的生成式检索模型。PG 让模型消费 4000+ token 的更丰富原始特征集、内置 token 压缩折回约 800 token(服务输入长度与无 PG baseline 基本持平)。2% ND 流量、12 天 A/B 中,PG 配置带来 ND IPV(item page view)+0.66%、PVR +7.93%。该部署跑在生产服务环境的 AMD Instinct MI308X GPU(区别于 §4.5.2 的 H20 受控 benchmark),PG 把端到端响应时间从 52ms 仅小幅抬到 63ms。
- Shop Search(店铺搜索):由自研基座 TBStars-3B 服务。PG 组装丰富配置、把 1000+ token 原始输入压缩到平均 430 token。10% 店铺搜索流量、两周多的 A/B 中,PG 配置相对同款无 PG 生成式检索模型带来成交笔数 +4.01%。服务跑在 NVIDIA L20 GPU,端到端响应时间 80ms。
- 其他场景:PG 还被作为通用框架用于 iterative GR 开发,包括首页"猜你喜欢"商品推荐、内容搜索、商详页推荐、新品推荐等,进一步证明其通用性、灵活性与有效性。
五、讨论、设计洞察与局限¶
5.1 三个关键发现¶
- 生成式检索没有通用特征配方:跨淘宝搜索、淘宝推荐、三个开源 benchmark,"item SID + 辅助信号"组合一致有帮助,但最优配置随场景而异。PG 的价值正是把这种"场景依赖的探索"变得廉价。
- 异构信号应异构处理:不同特征类型对同一处理组件反应不同,"一刀切" merger 少有效果——实验里文本能容忍重度 mean-pool 压缩几乎无损,但 SID 一旦与文本、embedding 合并进单个 combo token 就会崩掉检索质量(S1-tiny 的 Full combo 反例)。通用原则是按特征类型选处理组件,这正是 PG per-feature 配置的方便之处。
- 无参 mean-pool merger 是强默认:在固定 prompt 预算下,mean-pool 在淘宝搜索、淘宝推荐、S1-tiny 上一致匹配或超过其学习式对手(MLP、attention),因为在重度压缩输入上加可学习参数收益有限。学习式 merger 应留给内容依赖融合明确必要的场景。
5.2 设计洞察¶
PG 的中心设计决策是把特征处理逻辑与模型结构分离,并通过两份声明式 JSON 把整个特征表面暴露出来作为离线训练与在线推理的单一事实源。工业生成式检索里特征集与特征组合的变化远比模型 backbone 频繁,把这些决策搬进配置,让每次特征工程迭代变成一次轻量编辑,也在 schema 层对齐了离线训练与在线推理(两者消费同一配置);配合 §3.3.2 的事件追踪,离线流水线能回放在线所见的精确特征。
第二个设计决策是保持特征分类法窄(仅四类型),并把所有变换分解进三条正交组件轴(preprocessor / projector / merger)。这些原语覆盖大多数工业生产的异构特征混合。刻意保持抽象窄,是因为每个新类型/组件都要在离线+在线同时支持、类型爆炸直接抬高工程与校验成本。值得注意的是 merger 承担双重角色:除聚合子特征外,它还控制每个组合特征向 prompt 贡献多少 token,使得富文本特征可被纳入而不撑长序列;因为 merger 策略活在配置而非模型里,"信息密度 vs 序列长度"的权衡可按特征调优、无需改代码。
5.3 与 Autoresearch 的集成¶
Autoresearch(LLM 驱动 agent 自主跑迭代实验闭环、摊薄大规模模型调优的实验成本,Liu et al., 2026)近来成为一个有前景的方向:agent 提出假设、改代码、跑实验、评估结果、朝用户指定目标迭代,几乎无需人工干预。PG 特别契合这一范式的特征工程轴:传统训练流水线里增删/重组特征通常要跨数据加载、tokenization、输入组装做侵入式改动,agent 很难安全修改;有了 PG,同样的操作简化成对 prompt_template.json 与 prompt_feature.json 的局部编辑,训练栈随后无需改代码就能吸收新配置。论文在淘宝生成式检索场景验证了这一组合:从生产 baseline 出发,agent 仅靠配置编辑探索特征选择、组合、prompt 模板变体,20 轮迭代把 hitrate@20 提升 +3.05%。
5.4 局限与未来工作¶
- 仅在电商场景评测:对内容推荐、赞助广告等其他域的泛化性尚待验证(Conclusion 明确点出);
- merger 算子有限:当前 mean/sum 完全忽略特征交互,concat_mlp 只通过定长前馈层部分捕捉,复杂跨特征交互场景可能需要更有表达力的融合策略;
- 未来工作:(1) 扩展 PG 支持 image 作为新特征类型——把 vision encoder 的 patch embedding 当作 embedding 特征序列、复用现有 projector/merger 压缩视觉 token(因为预编码 image embedding 常丢失细粒度商品信息);(2) 丰富 merger 库、加入建模跨特征交互的算子(attention-based 或 low-rank cross-feature merger);(3) 深化与 autoresearch agent 的集成,让自动探索不仅覆盖特征配置,还覆盖 merger 策略与序列长度权衡。
六、核心贡献总结与评价¶
核心贡献:PG 把 LLM 生成式检索的特征工程从"侵入式代码改动"变成"声明式配置编辑"。它用两份 JSON(+ 部署时自动导出的 prompt_module.json 携带已学参数)作为离线训练与在线服务的单一事实源,配合全覆盖 event tracking 实现 >99% 训练-服务特征一致性,从根上消除 training-serving skew;四类特征 + 三类组件的窄抽象覆盖工业异构特征,merger 的双重角色(聚合 + token 压缩)让"信息密度 vs 序列长度"可按特征在配置层调优,把 45K→11K、1400→610、4000→800、1000→430 token 的重度压缩变成可行。工程层面,通过训练四阶段(PG time −88.8%、占总步时 3.6%)与推理四阶段(P50 −41%、P99 −40%、QPS +73%)优化把框架额外开销压到可忽略。
值得借鉴的设计:
- "配置即单一事实源" + event tracking 回放:这是消除训练-服务偏差的干净范式,比"按时间戳过滤离线序列"工程量小得多且更可靠;
- merger 承担 token 压缩双职:把"特征表达力 vs 序列长度"的旋钮从模型代码搬到配置,使超长行为序列可用;
- 窄抽象 + plugin registry:四类型/三组件刻意保持窄,同时留自定义 merger(attention 等)的扩展口,兼顾一致性与灵活性;
- 与 autoresearch agent 天然契合:把特征工程降维成 JSON 局部编辑,让 LLM agent 能安全自动探索(20 轮 +3.05%)。
局限与争议:
- 这是工业系统/框架报告,非新建模方法——不提出新模型结构(
model_name为空),其价值在于工程范式与线上数据,学术新颖性有限; - 评测只在电商域,跨域泛化未验证;
- merger 算子表达力有限(mean/sum 忽略交互);
- 多数指标以相对增益报告、绝对生产指标未披露,外部难以横向对比;
- "SID 不可过度合并"(Full combo 崩溃)与"文本可重度压缩、mean-pool 是强默认"是很有价值的经验规律,但仍是经验观察、缺乏机制层解释。
工业落地价值(突出):PG 已在淘宝搜索(+0.47% 成交、+0.51% GMV,H20,60ms)、店铺搜索(+4.01% 成交,L20,80ms)、淘宝推荐 ND(+0.66% IPV、+7.93% PVR,MI308X,63ms)三条线拿到统计显著线上收益,并跨 H20/L20/MI308X 多种硬件、Qwen2.5-0.5B / OneRec-1.7B / TBStars-3B 多种 backbone 部署,作为多个淘系团队的生成式检索迭代基础框架。对任何正在把 LLM 生成式检索推向生产的团队,PG 的"配置解耦 + 训练-服务一致 + token 压缩 + 引擎级优化"这套组合拳有直接参考价值。