PailitaoGR:把「看图思考」内化进生成式图像检索
Alibaba Group(拍立淘 / 淘宝图搜),WSDM '27 投稿版,arXiv 2608.26658v1
1. 研究动机与背景
拍立淘(Pailitao)是淘宝的拍照图搜入口,用户直接用一张现实世界的照片检索商品。本文探索把生成式检索(Generative Retrieval)这条路线搬到图搜上:给定 query 图像,模型不做向量近邻检索,而是自回归地直接生成商品的语义标识符(Semantic ID, SID)。
作者指出,把生成式检索从文本搜索扩展到图搜并非平凡,因为真实 query 图像里的视觉信息是异质混杂的,同时包含三类内容:
- 检索目标(search target):用户真正想找的那件商品;
- 有用的辅助证据(auxiliary evidence):品牌、型号等文字线索,用于细粒度区分同款不同货号;
- 无关内容(irrelevant content):水印、其他物体、背景。
因此有效的生成式图像检索需要两种互补能力:识别并聚焦到检索目标,以及有选择地利用辅助证据。
一个直觉的做法是照搬近期的 Think-with-Images 范式(Chain-of-Focus、DeepEyes 等),即让模型通过工具与图像交互——visual grounding、裁剪(cropping)、OCR。但作者认为直接搬到线上生成式图搜有两个致命问题:
- 显式工具调用带来额外计算与多步推理,与在线检索严苛的延迟约束直接冲突;
- 工具产出的辅助信息可能无关甚至误导;同时另一些有用信息可能超出模型自身的感知容量(受限于图像分辨率与模型规模),于是无差别的能力迁移反而有害。
本文提出 PailitaoGR,一个 Latent Think-with-Images 方法:把「聚焦目标」与「利用辅助证据」两种能力内化进模型权重,推理时只吃原始整图,不做任何裁剪、不调用任何 OCR——作者把这两件事分别命名为 Zooming without Cropping(不裁剪的放大)和 Reading without OCR(不 OCR 的读字)。
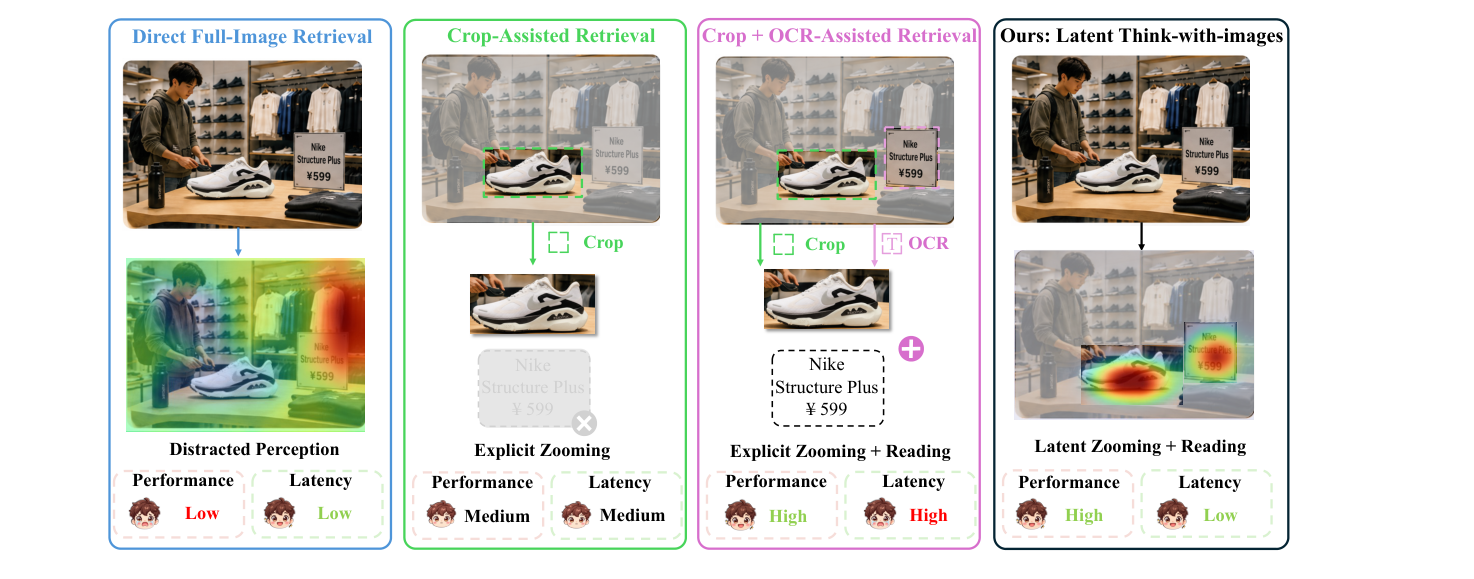
Figure 1 用四栏对比了四种范式:直接整图检索(性能低、延迟低,「注意力被干扰」)、裁剪辅助(性能中、延迟中,「显式放大」)、裁剪 + OCR 辅助(性能高、延迟高,「显式放大 + 读字」),以及本文的 Latent Think-with-Images(性能高、延迟低,「隐式放大 + 读字」)。需要注意的是,这张图的 Performance / Latency 全部是 Low/Medium/High 的定性标注,没有任何实测数值——这一点在后文局限性中会重提。
在 related work 中,作者把自己定位为「据我们所知,第一个直接在原始 query 图像上运行的工业级生成式检索框架」。最接近的前置工作是 OneVision(首个工业级电商视觉搜索生成式检索框架),但 OneVision 的生成式检索器吃的是裁剪后的 query 图像。
2. 任务形式化与方法总览
设商品语料库 $\mathcal{D} = \{d_j\}_{j=1}^{M}$,每个商品 $d_j$ 被赋予一个语义标识符(SID)
$$\mathbf{s}_j = (s_{j,1}, s_{j,2}, \ldots, s_{j,L}) \tag{1}$$
即一串离散语义 token。给定 query 图像 $\mathbf{x}$,生成式图像检索直接建模候选 SID 的条件生成概率:
$$p_\theta(\mathbf{s} \mid \mathbf{x}) = \prod_{t=1}^{L} p_\theta(s_t \mid \mathbf{x}, \mathbf{s}_{<t}) \tag{2}$$
其中 $\mathbf{s}_{<t} = (s_1, \ldots, s_{t-1})$ 是已生成的 SID 前缀。推理时自回归地生成一组高概率 SID:
$$\hat{\mathcal{S}}_K = \operatorname{TopK}_{\mathbf{s} \in \mathcal{S}} p_\theta(\mathbf{s} \mid \mathbf{x}) \tag{3}$$
$\hat{\mathcal{S}}_K$ 中的 SID 再映射回对应商品完成检索。
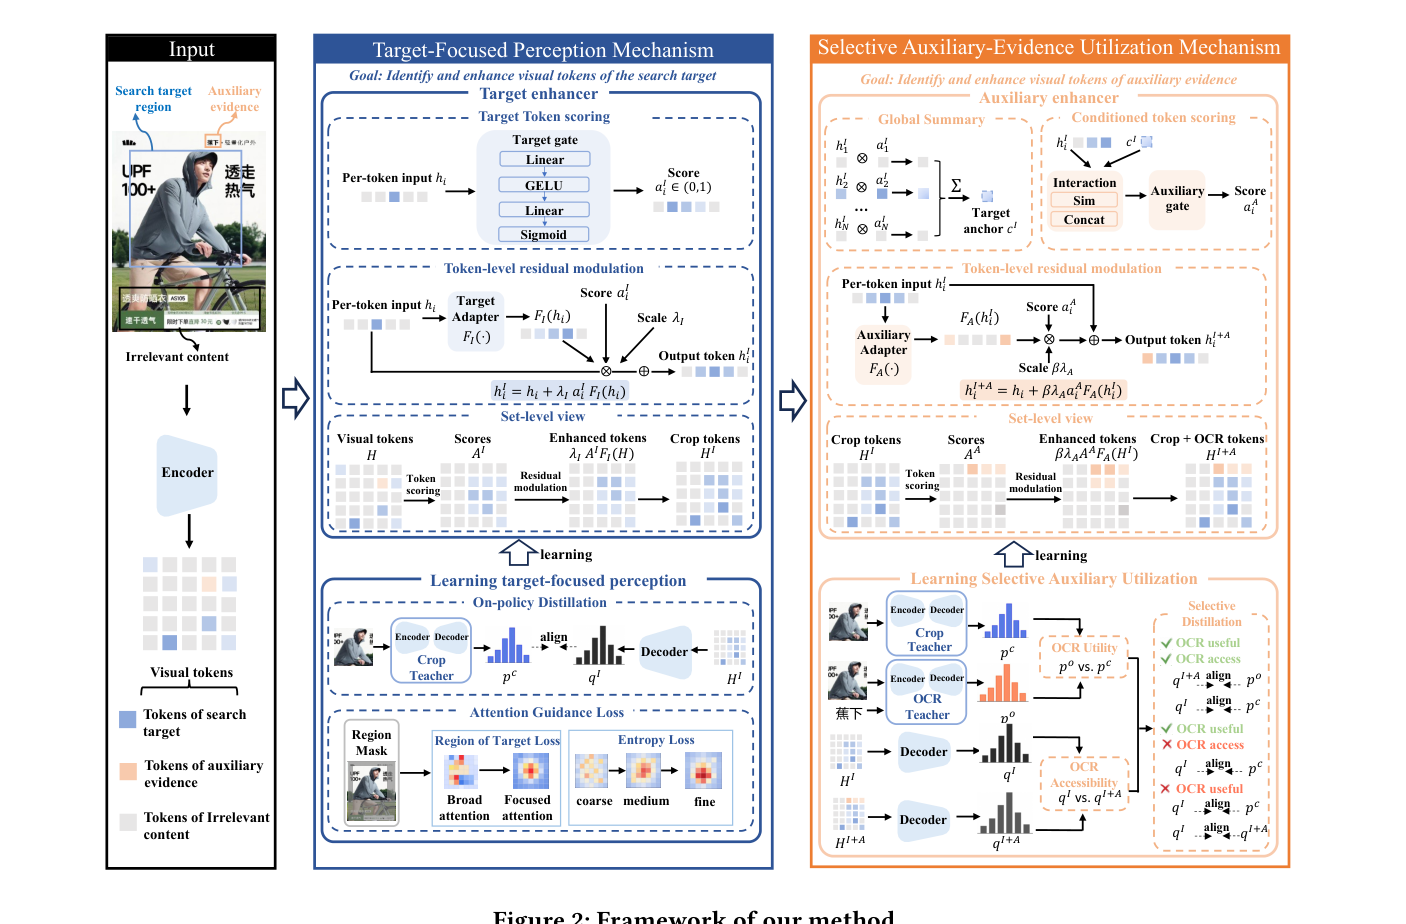
Figure 2 完整展示了框架。左栏是输入:整图经 Encoder 得到视觉 token,token 被概念上分为「检索目标 token」「辅助证据 token」「无关内容 token」三色。中栏是目标聚焦感知机制(Target-Focused Perception),右栏是选择性辅助证据利用机制(Selective Auxiliary-Evidence Utilization)。两个机制的结构高度对称:各有一个 Enhancer(token 打分 + token 级残差调制),各有一套 学习目标(左边是 On-policy 蒸馏 + 注意力引导损失,右边是选择性蒸馏)。
3. 目标聚焦感知机制
3.1 Target Enhancer
给定 query 图像 $\mathbf{x}$,视觉编码器产出一组视觉 token:
$$H = E_\theta(\mathbf{x}) = \{h_i\}_{i=1}^{N}, \quad h_i \in \mathbb{R}^d \tag{4}$$
Target Token Scoring 用一个轻量打分头独立估计每个视觉 token 与检索目标的相关性:
$$a^I_i = \sigma\!\left(w_I^\top \operatorname{GELU}\!\left(W_I \operatorname{LN}(h_i)\right)\right) \tag{5}$$
其中 $W_I, w_I$ 可学习,$\operatorname{LN}(\cdot)$ 是 layer norm,$\sigma(\cdot)$ 是 sigmoid,$a^I_i \in (0,1)$ 衡量 token $i$ 与检索目标的相关度。
作者明确论证了为什么不能只用 $a^I_i$ 去缩放 $h_i$:单纯 rescale 只改变模长、不改变特征方向,而且这个效果还会被后续的 normalization 进一步削弱。因此引入 Token-level Residual Modulation,用一个可学习的残差特征更新:
$$F_I(h_i) = W_{I,2}\operatorname{GELU}\!\left(W_{I,1}\operatorname{LN}(h_i)\right) \tag{6}$$
被选中的视觉 token 按下式增强:
$$h^I_i = h_i + \lambda_I\, a^I_i\, F_I(h_i) \tag{7}$$
$\lambda_I$ 控制残差增强的幅度。最终得到目标增强后的视觉表征,作者称之为 crop tokens(因为它在语义上等价于「裁剪出来的目标区域」):
$$H^I = \{h^I_i\}_{i=1}^{N} \tag{8}$$
残差连接保证原始视觉信息不丢失,同时选择性地放大目标相关 token。
3.2 目标聚焦感知目标:On-policy 蒸馏
记从 $H^I$ 预测的 SID 分布为
$$q^I_t(\cdot) = p_\theta\!\left(\cdot \mid H^I, \mathbf{s}_{<t}\right) \tag{9}$$
标准交叉熵目标为
$$\mathcal{L}_{\mathrm{CE}} = -\frac{1}{L}\sum_{t=1}^{L}\log q^I_t\!\left(s^*_t \mid \mathbf{s}^*_{<t}\right) \tag{10}$$
作者指出,SID 监督只约束最终预测,无法直接指导模型在复杂图像里聚焦到目标。于是引入两个额外目标。
第一个是 On-Policy Distillation(OPD)。训练一个 Crop Teacher $p_{\phi_C}(\cdot)$,它的输入是裁剪后的目标区域 $\mathbf{x}_C$——因为大部分背景被移除,它天然给出更干净、更以目标为中心的 SID 预测参考。
关键设计动机是训练-推理错配:常规自回归蒸馏在 ground-truth 前缀下评估师生,而推理时模型条件于自己的预测。一旦某个 SID token 预测错,模型必须从一个训练中从未见过的错误前缀继续生成,后续预测随之不可靠。为缓解这一点,作者采用 on-policy 蒸馏——先用当前学生模型(吃整图)采一条 SID 轨迹:
$$\hat{\mathbf{s}} \sim p_\theta\!\left(\mathbf{s} \mid H^I\right) \tag{11}$$
然后在每个解码步 $t$,用同一条学生生成的前缀 $\hat{\mathbf{s}}_{<t}$ 同时查询教师与学生:
$$p^C_t(\cdot) = p_{\phi_C}\!\left(\cdot \mid \mathbf{x}_C, \hat{\mathbf{s}}_{<t}\right) \tag{12}$$
$$q^I_t(\cdot) = p_\theta\!\left(\cdot \mid H^I, \hat{\mathbf{s}}_{<t}\right) \tag{13}$$
实践中只蒸馏 Crop Teacher 预测的 top-$K$ 候选,记候选集为 $\mathcal{K}_t$,$\tilde p^C_t$ 与 $\tilde q^I_t$ 是在 $\mathcal{K}_t$ 上重新归一化的师生分布。OPD 目标为
$$\mathcal{L}_{\mathrm{OPD}} = \mathbb{E}_{\hat{\mathbf{s}}\sim p_\theta(\cdot\mid H^I)}\left[\frac{1}{|\hat{\mathbf{s}}|}\sum_{t=1}^{|\hat{\mathbf{s}}|}\operatorname{JSD}\!\left(\tilde p^C_t, \tilde q^I_t\right)\right] \tag{14}$$
$\operatorname{JSD}$ 是 Jensen–Shannon 散度。这样一来,Crop Teacher 提供的「以目标为中心」的监督,恰好落在学生自回归生成时真正会遇到的状态上。
3.3 粒度感知的注意力引导
OPD 只约束「预测什么」,不约束「模型依据图像的哪块区域做出预测」。作者进一步直接监督从 SID token 到视觉 token 的注意力。
记第 $l$ 层第 $h$ 个头上,第 $t$ 个 SID token 对视觉 token $v$ 的注意力权重为 $A^{(l,h)}_{t,v}$。先对 $N_h$ 个头取平均:
$$\bar A^{(l)}_{t,v} = \frac{1}{N_h}\sum_{h=1}^{N_h} A^{(l,h)}_{t,v} \tag{15}$$
再只保留视觉 token 列并归一化,得到视觉注意力分布:
$$\pi^{(l)}_t(v) = \frac{\bar A^{(l)}_{t,v}}{\sum_{v' \in \mathcal{V}} \bar A^{(l)}_{t,v'} + \epsilon}, \quad v \in \mathcal{V} \tag{16}$$
关键洞察:SID 具有由粗到细的语义层级结构。作者利用这一性质,同时引导「模型应该看哪里」和「注意力应该多集中」。
ROT 注意力引导。把检索目标的 bounding box 定义为 region of target(ROT),映射到视觉 token 得到二值 mask $M(v) \in \{0,1\}$。第 $t$ 个 SID token 落在 ROT 内的注意力质量为
$$m^{(l)}_t = \sum_{v \in \mathcal{V}} \pi^{(l)}_t(v) M(v) \tag{17}$$
给每个 SID token 关联其语义粒度 $g(t)$ 和粒度相关系数 $\alpha_{g(t)}$,越细粒度的 SID token 受到越强的 ROT 约束:
$$\alpha_{\mathrm{coarse}} < \alpha_{\mathrm{medium}} < \alpha_{\mathrm{fine}}, \quad \alpha_{\mathrm{sep}} = 0 \tag{18}$$
$$\mathcal{L}_{\mathrm{rot}} = \operatorname{Mean}_{l,t}\left[-\alpha_{g(t)}\log\!\left(m^{(l)}_t + \epsilon\right)\right] \tag{19}$$
物理含义:生成粗粒度 SID token 时约束较弱(此时需要全局信息判断大类),越到细粒度越强制模型依赖目标区域内的视觉证据。
由粗到细的熵引导。为调控注意力的集中程度,再引入基于熵的注意力损失。注意力熵定义为
$$\mathcal{H}^{(l)}_t = -\sum_{v \in \mathcal{V}} \pi^{(l)}_t(v)\log\!\left(\pi^{(l)}_t(v) + \epsilon\right) \tag{20}$$
用粒度相关的方向系数 $\gamma_{g(t)}$ 控制各层级期望的熵:
$$\gamma_{\mathrm{coarse}} = +1, \quad \gamma_{\mathrm{medium}} = \gamma_{\mathrm{fine}} = -1, \quad \gamma_{\mathrm{sep}} = 0 \tag{21}$$
$$\mathcal{L}_{\mathrm{ent}} = \operatorname{Mean}_{l,t}\left[-\gamma_{g(t)}\mathcal{H}^{(l)}_t\right] \tag{22}$$
最小化 (22) 等价于:粗粒度 SID token 保持高熵(注意力铺开,捕捉更广的视觉证据);中/细粒度 token 逐步收窄(集中到有区分度的商品细节)。作者强调二者互补——ROT 决定「在哪里收集证据」,熵决定「在各语义粒度上收集得多广或多窄」。
整体训练目标:
$$\mathcal{L}_{\mathrm{item}} = \mathcal{L}_{\mathrm{CE}} + \lambda_{\mathrm{opd}}\mathcal{L}_{\mathrm{OPD}} + \lambda_{\mathrm{rot}}\mathcal{L}_{\mathrm{rot}} + \lambda_{\mathrm{ent}}\mathcal{L}_{\mathrm{ent}} \tag{23}$$
4. 选择性辅助证据利用机制
建立起以目标为中心的表征后,模型还应进一步利用辅助证据,同时避开无关或误导信息。
4.1 Auxiliary Enhancer
先把 crop tokens $H^I$ 汇总成一个 Target Anchor:
$$c^I = \frac{\sum_{i=1}^{N} a^I_i h^I_i}{\sum_{i=1}^{N} a^I_i + \epsilon} \tag{24}$$
与 Target Enhancer 的无条件打分不同,Auxiliary Enhancer 做的是条件打分——它必须判断某个 token 是否为「当前这个目标」提供互补信息:
$$a^A_i = \sigma\!\left(g_A(h^I_i, c^I)\right) \tag{25}$$
$$g_A(h^I_i, c^I) = w_A^\top \operatorname{GELU}\!\left(W_A\left[\operatorname{LN}(h^I_i);\ \operatorname{LN}(c^I);\ \operatorname{LN}(h^I_i)\odot\operatorname{LN}(c^I)\right]\right) \tag{26}$$
即把「局部 token」「目标锚点」「二者逐元素积(相似度交互)」三路拼接后打分。被选中的辅助 token 同样走 token 级残差调制:
$$h^{I+A}_i = h^I_i + \beta\lambda_A a^A_i F_A(h^I_i) \tag{27}$$
$$H^{I+A} = \{h^{I+A}_i\}_{i=1}^{N} \tag{28}$$
$F_A(\cdot)$ 是可学习残差变换,$\lambda_A$ 控制残差幅度,$\beta$ 控制辅助信息的整体贡献。作者把 $H^{I+A}$ 称为 crop + OCR tokens。
4.2 选择性辅助蒸馏目标:效用 × 可及性
这是全文最有辨识度的设计。OCR 线索可能有用、可能无关、甚至可能误导;即便有用,学生也未必能从原图里可靠地捕捉到。作者从两个维度决定是否施加辅助监督。
用两个教师:Crop Teacher(只吃裁剪图)与 OCR Teacher(吃裁剪图 + 预先抽取的 OCR 文本),其解码步 $t$ 的 SID 分布分别为 $p^C_t$、$p^O_t$。
辅助信息的效用(utility) 定义为 OCR Teacher 相对 Crop Teacher 在 ground-truth SID token 上的提升:
$$u^T_t = \log p^O_t(s^*_t) - \log p^C_t(s^*_t) \tag{29}$$
学生的可及性(accessibility):令
$$q^I_t(\cdot) = p_\theta\!\left(\cdot \mid H^I, \mathbf{s}_{<t}\right) \tag{30}$$
$$q^{I+A}_t(\cdot) = p_\theta\!\left(\cdot \mid H^{I+A}, \mathbf{s}_{<t}\right) \tag{31}$$
$$u^S_t = \log q^{I+A}_t(s^*_t) - \log q^I_t(s^*_t) \tag{32}$$
两个信号各自过一个 soft gate:
$$w^{\mathrm{help}}_t = \sigma\!\left(\tau_T u^T_t - \rho_T\right), \quad w^{\mathrm{cap}}_t = \sigma\!\left(\tau_S u^S_t - \rho_S\right) \tag{33}$$
$\rho_T, \rho_S$ 是选择阈值,$\tau_T, \tau_S$ 控制门的锐度。
情形一:既有用又可及。鼓励辅助增强后的学生靠拢 OCR Teacher,并显式实现相对「仅目标表征」的预测增益:
$$\mathcal{L}_{\mathrm{open}} = \mathcal{L}_{\mathrm{contrast}} + \lambda_{\mathrm{gain}}\mathcal{L}_{\mathrm{gain}} \tag{34}$$
$$\mathcal{L}_{\mathrm{contrast}} = -\log\frac{\exp\!\left(s(q^{I+A}_t, p^O_t)/\tau\right)}{\exp\!\left(s(q^{I+A}_t, p^O_t)/\tau\right) + \exp\!\left(s(q^{I+A}_t, p^C_t)/\tau\right)} \tag{35}$$
$$\mathcal{L}_{\mathrm{gain}} = \left[m - \left(\log q^{I+A}_t(s^*_t) - \log q^I_t(s^*_t)\right)\right]_+ \tag{36}$$
$\mathcal{L}_{\mathrm{contrast}}$ 是对比式蒸馏:把 OCR Teacher 当正样本、Crop Teacher 当负样本,因此迁移的只是 OCR Teacher 相对 Crop Teacher 的增量能力(论文称 in-capacity incremental contrastive distillation)。$\mathcal{L}_{\mathrm{gain}}$ 是一个 margin hinge,强制辅助路径必须比只看目标至少多出 $m$ 的对数似然增益。
情形二:辅助信息无用。压制其影响,让辅助增强后的预测保持贴近「仅目标预测」与 Crop Teacher:
$$\mathcal{L}_{\mathrm{close}} = \operatorname{JSD}\!\left(q^{I+A}_t, q^I_t\right) + \lambda_C \operatorname{JSD}\!\left(q^{I+A}_t, p^C_t\right) \tag{37}$$
情形三:有用但学生够不着。既不迁移也不压制——避免强行模仿一个学生根本无法获取的能力,同时允许它在训练中自然改进。
无论效用与可及性如何,都施加 ground-truth SID 监督并把「仅目标预测」对齐到 Crop Teacher,构成共享的 base 目标:
$$\mathcal{L}_{\mathrm{base}} = \operatorname{CE}\!\left(q^I_t, s^*_t\right) + \operatorname{CE}\!\left(q^{I+A}_t, s^*_t\right) + \lambda_I \operatorname{JSD}\!\left(q^I_t, p^C_t\right) \tag{38}$$
总目标:
$$\mathcal{L}_t = \mathcal{L}_{\mathrm{base}} + \lambda_{\mathrm{gate}}\left[w^{\mathrm{help}}_t w^{\mathrm{cap}}_t \mathcal{L}_{\mathrm{open}} + \left(1 - w^{\mathrm{help}}_t\right)\mathcal{L}_{\mathrm{close}}\right] \tag{39}$$
注意门控的非对称性:开启迁移需要「有用 AND 可及」两个门同时打开($w^{\mathrm{help}}_t w^{\mathrm{cap}}_t$),而压制只由「无用」单个门触发($1 - w^{\mathrm{help}}_t$),与 $w^{\mathrm{cap}}_t$ 无关。这正是情形三「不迁移也不压制」的数学实现。
5. 推理
训练结束后,两种能力都已内化。给定原始 query 图像:Target Enhancer 识别并增强目标 token(Zooming without Cropping);在此基础上 Auxiliary Enhancer 直接从视觉 token 里识别并增强有用辅助线索(Reading without OCR);学到的目标聚焦感知让 SID 解码保持以目标 token 为中心,辅助线索只作为细粒度识别的补充证据。增强后的视觉 token 直接用于 SID 生成,crop 与 OCR 两个教师在推理时被完全移除。
6. 数据构造
数据全部来自拍立淘的线上图搜日志(大规模电商平台)。
训练集:保留有点击、购买、加购、收藏等行为 SID 的 query 图像,且每张 query 图必须关联多于 3 个行为 SID。选取 7 个最高频子类目:女装、童装、男装、女鞋、男鞋、数码 3C、家具。
测试集:取自时间上不相交的时段以避免与训练集 query 图重叠;同样要求 >3 个行为 SID,且至少有一次购买行为;所有测试样本进一步经人工标注员与匹配模型双重验证,确保 query 图与关联商品是同一件商品。评测按点击与购买两类行为分别计算。
| 类目 | 训练集 query 数 | 测试集 query 数 |
|---|---|---|
| 女鞋 | 275,161 | 1,095 |
| 家具 | 232,529 | 483 |
| 女装 | 200,000 | 4,258 |
| 男装 | 163,526 | 624 |
| 童装 | 144,629 | 1,420 |
| 数码 3C | 100,628 | 576 |
| 男鞋 | 43,273 | 191 |
| 合计 | 1,159,746 | 8,647 |
每条 query 关联多个正样本,训练/测试平均分别为 5.87 / 5.61,中位数均为 5;约 57% 的 query 含 4–6 个正样本。作者承诺论文发表后公开数据集与模型权重。
7. 实验设置
评估指标。采用 R@K 与 H@K。给定 ground-truth 行为关联 SID 集合 $\mathcal{S}_{\mathrm{beh}}$ 与 top-$K$ 检索集合 $\hat{\mathcal{S}}_K$:
$$\mathrm{R@K} = \frac{\left|\hat{\mathcal{S}}_K \cap \mathcal{S}_{\mathrm{beh}}\right|}{\min\left(K, \left|\mathcal{S}_{\mathrm{beh}}\right|\right)} \tag{40}$$
$$\mathrm{H@K} = \mathbb{I}\!\left(\left|\hat{\mathcal{S}}_K \cap \mathcal{S}_{\mathrm{beh}}\right| > 0\right) \tag{41}$$
R@K 衡量 top-$K$ 里成功召回了多少比例的行为关联商品(分母做了 $\min$ 截断),H@K 衡量是否至少命中一个。两者都按 CLICK / PURCHASE 分别统计。
对比方法。
- 生成式图像检索:IRGen(CLIP ViT-B/16 视觉编码器 + 24 层 Transformer decoder)、GENIUS(CLIP ViT-L/14 + 6 层 T5 decoder)。均按原论文配置、从对应预训练模型初始化、在本文训练集上训练。
- 传统相似度检索:DINOv3、CLIP(均用 ViT-B/16),用发布的预训练权重初始化后在本文训练集上微调。
- 内部对照:Crop Teacher(吃裁剪图)、OCR Teacher(吃裁剪图 + 预抽 OCR)、SFT Baseline(同骨干、吃整图、纯 SFT)。
实现细节。基座模型 Qwen3.5-0.8B;SID 为 3 级码本,每级码本大小 8,192;batch size 1,024,初始学习率 $1\times10^{-4}$,cosine 衰减。超参:$\lambda_{\mathrm{opd}}=2.0$、$\lambda_{\mathrm{roi}}=0.1$、$\lambda_{\mathrm{ent}}=0.02$;OPD 在教师 top-100 预测上计算散度;ROT 权重 $\alpha=(0.1, 0.3, 0.6, 0)$ 分别对应 coarse / medium / fine / separator;$\tau_T=\tau_S=1.0$、$\rho_T=\rho_S=0.0$、$\lambda_{\mathrm{gain}}=0.5$、$m=0.5$、$\lambda_C=0.5$、$\lambda_{\mathrm{gate}}=0.02$。
8. 主要实验结果
Table 1:测试集上的检索性能(%)
| 方法 | 输入 | CLICK H@1 | H@5 | H@10 | R@5 | R@10 | PURCHASE H@1 | H@5 | H@10 | R@5 | R@10 |
|---|---|---|---|---|---|---|---|---|---|---|---|
| DINOv3 | Crop | 36.38 | 58.61 | 64.36 | 32.60 | 39.87 | 14.64 | 36.98 | 44.35 | 35.84 | 43.27 |
| CLIP | Crop | 30.57 | 53.90 | 61.69 | 28.83 | 36.73 | 12.24 | 32.57 | 41.11 | 31.54 | 40.05 |
| IRGen | Crop | 29.72 | 55.02 | 60.06 | 28.87 | 36.03 | 11.54 | 32.81 | 39.85 | 32.00 | 39.14 |
| GENIUS | Crop | 24.62 | 42.12 | 45.19 | 21.99 | 26.93 | 9.37 | 25.03 | 29.72 | 24.37 | 29.28 |
| Crop Teacher | Crop | 37.48 | 68.16 | 74.25 | 39.02 | 50.41 | 14.70 | 44.28 | 54.47 | 43.41 | 54.02 |
| OCR Teacher | Crop + OCR | 39.74 | 70.77 | 77.02 | 41.22 | 52.88 | 16.00 | 46.47 | 57.06 | 45.54 | 56.48 |
| SFT Baseline | Full Image | 29.25 | 56.13 | 63.24 | 30.71 | 40.74 | 11.55 | 34.69 | 44.57 | 34.06 | 44.05 |
| PailitaoGR | Full Image | 41.88 | 73.33 | 79.19 | 43.46 | 55.27 | 17.20 | 49.39 | 60.12 | 48.46 | 59.48 |
结论分析:
-
相对次优方法平均提升 12.16%(十项指标平均)。注意这里的「%」实为绝对百分点而非相对提升——按 Table 1 复算,PailitaoGR 相对 DINOv3 的十项绝对差平均为 12.09 pp,与文中 12.16 略有出入(应为舍入或统计口径差异)。
-
生成式方法内部:同为 crop 输入的设定下,PailitaoGR > IRGen > GENIUS。作者把这个趋势归因于 decoder 容量:Qwen3.5-0.8B > IRGen(24 层)> GENIUS(6 层)。这个归因是合理的但并未做控制变量实验(三者的视觉编码器也不同)。
-
相对 SFT Baseline 平均提升 13.8 pp(复算为 13.88 pp,与摘要一致)。这是能力内化本身的净收益:同骨干、同输入(整图)、同数据,唯一差别是训练方式。这是全文最有说服力的一组对照。
-
反超两位教师:相对 Crop Teacher +4.76 pp、相对 OCR Teacher +2.76 pp(按 Table 1 复算 OCR Teacher 一项为 +2.46 pp,与文中 2.76 有出入)。教师在训练和推理时都用裁剪 / 裁剪+OCR 输入,学生只用原图却反超——作者据此论证「目标聚焦」与「辅助证据利用」两种能力被有效内化。反超 OCR Teacher 尤其说明选择性内化让模型学会了「用有益线索、但不无差别依赖」。
-
一个值得注意的负面对照:SFT Baseline(整图、纯 SFT)在多数指标上不如 DINOv3 这样的判别式基线(CLICK H@1 29.25 vs 36.38)。也就是说,在图搜里「整图 + 生成式 + 朴素 SFT」这条最直接的路子本身是打不过传统向量检索的——本文的全部增益都来自训练方法,而非生成式范式本身。
9. 目标聚焦能力分析(Zooming without Cropping)
用检索目标的 bounding box 作为 ROT,按 ROT 覆盖的视觉 token 数把测试 query 分组,对比 PailitaoGR 与 SFT Baseline。
Table 2:不同 ROT 面积占比下的检索性能(%),Δ 为相对 SFT Baseline 的绝对提升
| ROT 占比 | 方法 | CLICK H@1 | H@5 | H@10 | R@5 | R@10 | PURCH H@1 | H@5 | H@10 | R@5 | R@10 |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 0–5% | SFT Baseline | 18.01 | 36.53 | 42.42 | 19.12 | 26.44 | 6.23 | 20.71 | 29.12 | 20.51 | 28.85 |
| Ours | 36.53 | 65.49 | 72.05 | 37.82 | 49.92 | 15.32 | 42.59 | 54.38 | 41.83 | 53.85 | |
| Δ | +18.52 | +28.96 | +29.63 | +18.71 | +23.49 | +9.09 | +21.89 | +25.25 | +21.31 | +25.00 | |
| 5–10% | SFT Baseline | 26.02 | 50.52 | 57.25 | 26.86 | 35.88 | 9.85 | 29.06 | 38.11 | 28.71 | 37.81 |
| Ours | 42.11 | 75.18 | 81.18 | 45.20 | 57.25 | 17.29 | 50.68 | 62.05 | 49.66 | 61.30 | |
| Δ | +16.09 | +24.66 | +23.94 | +18.34 | +21.36 | +7.45 | +21.62 | +23.94 | +20.95 | +23.49 | |
| 10–20% | SFT Baseline | 29.59 | 57.88 | 64.93 | 32.04 | 42.36 | 11.51 | 37.04 | 47.30 | 36.40 | 47.08 |
| Ours | 43.82 | 77.20 | 82.46 | 46.98 | 58.88 | 18.43 | 54.35 | 65.02 | 53.60 | 64.28 | |
| Δ | +14.23 | +19.32 | +17.54 | +14.94 | +16.52 | +6.92 | +17.31 | +17.72 | +17.20 | +17.20 | |
| 20–40% | SFT Baseline | 32.76 | 61.20 | 68.62 | 33.99 | 44.70 | 13.39 | 38.80 | 49.12 | 38.15 | 48.49 |
| Ours | 43.84 | 75.18 | 80.88 | 44.44 | 56.64 | 18.09 | 50.95 | 61.75 | 49.82 | 61.11 | |
| Δ | +11.08 | +13.98 | +12.25 | +10.45 | +11.94 | +4.69 | +12.15 | +12.63 | +11.67 | +12.62 | |
| ≥40% | SFT Baseline | 28.93 | 56.06 | 63.39 | 30.12 | 40.19 | 11.52 | 33.55 | 43.28 | 32.78 | 42.53 |
| Ours | 37.39 | 66.75 | 73.65 | 37.92 | 48.76 | 14.59 | 41.60 | 51.86 | 40.82 | 51.43 | |
| Δ | +8.46 | +10.68 | +10.26 | +7.80 | +8.58 | +3.06 | +8.04 | +8.58 | +8.04 | +8.89 |
结论分析:提升幅度与 ROT 占比呈单调递减关系——目标越小(0–5% 组),提升越大(CLICK H@10 +29.63 pp);目标越大(≥40% 组),提升越小(+10.26 pp)。这是一条非常干净的证据链:收益确实来自「在杂乱场景中找到并放大小目标」这件事本身,而不是泛泛的模型能力提升。这组实验是全文方法论最扎实的一处——它把机制假设(内化了裁剪能力)转化为一个可证伪的单调性预测,并且验证成立。
另一个可读出的信息:≥40% 组的绝对性能反而低于 10–20% 组(Ours CLICK H@10 73.65 vs 82.46)。目标占满整图时性能下降,说明这类样本本身另有难点(可能是特写图缺少上下文,或大目标类目本身更难区分),论文未做讨论。
10. OCR 阅读能力分析(Reading without OCR)
按 query 图中是否含 OCR 信息把测试集分两组。
Table 3:有 / 无 OCR 信息的 query 上的检索性能(%)
| OCR | 方法 | CLICK H@1 | H@5 | H@10 | R@5 | R@10 | PURCH H@1 | H@5 | H@10 | R@5 | R@10 |
|---|---|---|---|---|---|---|---|---|---|---|---|
| With OCR | SFT Baseline | 24.50 | 49.84 | 57.40 | 25.69 | 34.87 | 9.45 | 28.76 | 38.04 | 27.87 | 37.20 |
| Crop Teacher | 32.95 | 63.66 | 70.07 | 34.88 | 45.61 | 12.53 | 39.96 | 49.76 | 38.92 | 48.93 | |
| Ours | 37.95 | 70.84 | 77.22 | 40.56 | 52.19 | 15.37 | 46.54 | 57.71 | 45.46 | 56.73 | |
| Δ_SFT | +13.44 | +21.00 | +19.82 | +14.87 | +17.32 | +5.92 | +17.78 | +19.68 | +17.59 | +19.53 | |
| Δ_Crop | +5.00 | +7.18 | +7.15 | +5.67 | +6.58 | +2.84 | +6.58 | +7.96 | +6.54 | +7.80 | |
| Without OCR | SFT Baseline | 32.38 | 60.34 | 67.13 | 34.08 | 44.66 | 12.95 | 38.68 | 48.95 | 38.21 | 48.65 |
| Crop Teacher | 40.53 | 71.20 | 77.06 | 41.81 | 53.65 | 16.16 | 47.19 | 57.65 | 46.47 | 57.48 | |
| Ours | 44.46 | 75.15 | 80.76 | 45.50 | 57.47 | 18.43 | 51.36 | 61.92 | 50.53 | 61.51 | |
| Δ_SFT | +12.08 | +14.81 | +13.63 | +11.42 | +12.81 | +5.48 | +12.68 | +12.97 | +12.31 | +12.86 | |
| Δ_Crop | +3.93 | +3.95 | +3.70 | +3.70 | +3.82 | +2.26 | +4.16 | +4.28 | +4.06 | +4.04 |
结论分析:关键要看 Δ_Crop 这一行——因为 Crop Teacher 已经具备目标聚焦能力但没有 OCR 能力,所以 Ours 相对 Crop Teacher 的增量才是「读字能力」的净贡献。在含 OCR 的 query 上 Δ_Crop 约 +5.0~+8.0 pp,在不含 OCR 的 query 上仅 +3.7~+4.3 pp,前者显著大于后者。这说明模型确实从原图里直接吸取了文字线索,且没有在无文字场景下产生副作用(无 OCR 组仍有正向提升,说明辅助 enhancer 没有把噪声当成证据)。这是对「选择性」这一设计诉求的直接验证。
11. 可视化
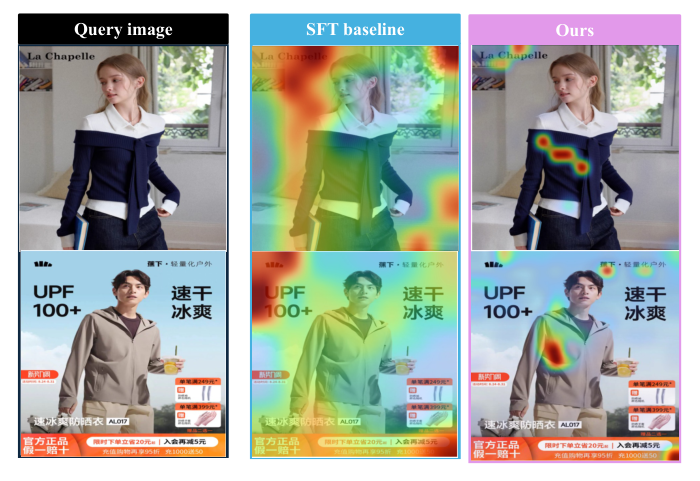
沿用训练目标里同样的注意力计算方式——跨头与跨 Transformer 层平均、聚合三级 SID、投影回原图。SFT Baseline 的注意力相对分散,容易被背景区域带偏;本文模型则一致地把注意力集中在检索目标区域。作者还观察到模型在没有显式 OCR 输入的情况下也会主动关注图中的辅助文字线索。
12. 消融实验
Table 4:核心组件消融
| 方法 | Target | Auxiliary | CLICK H@10 | CLICK R@10 | PURCH H@10 | PURCH R@10 |
|---|---|---|---|---|---|---|
| SFT Baseline | 63.24 | 40.74 | 44.57 | 44.05 | ||
| + Focusing Internalization | ✓ | 76.53 | 52.93 | 57.33 | 56.75 | |
| PailitaoGR | ✓ | ✓ | 79.19 | 55.27 | 60.12 | 59.48 |
目标聚焦机制单独就贡献了绝大部分增益(CLICK H@10 +13.29 pp),辅助证据机制再叠加 +2.66 pp。这符合直觉:先找对东西比读懂细节重要得多;但辅助机制的 2.66 pp 也不可忽略,且从 Table 3 看它精准地作用在有文字的 query 上。
Table 5:目标聚焦感知机制的目标函数消融
| 方法 | OPD | ROT | Entropy | CLICK H@10 | CLICK R@10 | PURCH H@10 | PURCH R@10 |
|---|---|---|---|---|---|---|---|
| w/o OPD | ✓ | ✓ | 73.05 | 49.40 | 53.94 | 53.25 | |
| w/o ROT | ✓ | ✓ | 73.47 | 50.22 | 54.91 | 54.27 | |
| w/o Entropy | ✓ | ✓ | 75.64 | 52.07 | 56.72 | 55.98 | |
| Full | ✓ | ✓ | ✓ | 76.51 | 52.93 | 57.52 | 56.86 |
结论分析:三项目标互补。OPD 贡献最大(去掉后 CLICK H@10 掉 3.46 pp),印证「从 Crop Teacher 转移以目标为中心的预测行为」是核心机制;ROT 注意力引导次之(-3.04 pp),说明显式的区域监督与 OPD 的隐式行为学习不是冗余的——前者约束「看哪」,后者约束「预测什么」;熵正则最小(-0.87 pp)但仍为正,验证由粗到细的注意力集中度调控有效。
Table 6:选择性辅助证据利用机制消融
| 方法 | Utility | Accessibility | CLICK H@10 | CLICK R@10 | PURCH H@10 | PURCH R@10 |
|---|---|---|---|---|---|---|
| Direct Auxiliary Transfer | 77.04 | 53.05 | 57.84 | 57.08 | ||
| + Utility | ✓ | 78.71 | 54.91 | 59.70 | 59.06 | |
| + Accessibility | ✓ | ✓ | 79.19 | 55.27 | 60.12 | 59.48 |
结论分析:无差别辅助迁移已经有效(77.04 vs Table 4 的 76.53),但加入效用判据带来的增益最大——四项指标平均约 +2.0 pp。这直接验证了论文的核心主张:「过滤掉对 SID 预测无益的辅助证据」比「无差别迁移」更重要。再叠加可及性判据带来一致的额外提升(+0.48/+0.36/+0.42/+0.42 pp),幅度较小但方向稳定,说明「只在学生够得着时才迁移」是一个真实但二阶的效应。
13. 核心贡献总结
- 提出 Latent Think-with-Images 范式并落到工业图搜:把工具化视觉能力(裁剪、OCR)在训练期内化进生成式检索模型,推理期只吃原图、零额外工具调用。
- 目标聚焦感知机制:Target Enhancer(token 打分 + token 级残差调制)+ on-policy 蒸馏(避开 teacher-forcing 与自回归推理的前缀错配)+ 粒度感知注意力引导(ROT 决定看哪里、熵决定看多广,并按 SID 由粗到细分层加权)。
- 选择性辅助证据利用机制:条件式 Auxiliary Enhancer(以 Target Anchor 为条件打分)+ 效用 × 可及性双门控的增量对比蒸馏——只迁移 OCR Teacher 相对 Crop Teacher 的增量能力,且只在学生够得着时迁移。
- 构建并承诺开源覆盖 7 个类目的真实线上图搜日志训练/测试集(1.16M / 8.6K query 图,测试集经人工 + 模型双重校验)。
14. 与已归档相关工作的对比
OneSearch-V2 OneSearch-V2: The Latent Reasoning Enhanced Self-distillation Generative Search Framework(Kuaishou,2026-03-25)
关系:显式引用但原文未展开对比(仅在 related work 以「self-distilled thought augmentation」一笔带过,无方法或指标层比较)· 已加载对方精读
- 共同关注的问题:两篇诊断的 root cause 完全一致——显式推理/显式工具在离线有效,但在线延迟预算不允许它出现在推理路径上。OneSearch-V2 发现把关键词 CoT 作为 RAG 输入注入效果最优(Order HR@10 0.2046→0.2139),但「推理时需额外调用 LLM 生成关键词,延迟不可接受」;PailitaoGR 发现裁剪 + OCR 输入的教师最强(OCR Teacher 十项指标全面领先所有公开基线),但「显式工具调用引入额外计算与多步推理,与在线检索的严苛延迟要求冲突」。两篇都拒绝了「把好东西放进推理路径」的解,转而把它放进训练路径。
- 相近的技术骨架:两者都是信息不对称的师生蒸馏 + 推理期移除教师。OneSearch-V2 的 teacher 输入 $x^{(T)}$ 含关键词、student 输入 $x^{(S)}$ 不含,用 KL 让 student 逼近 teacher;PailitaoGR 的 Crop/OCR Teacher 输入含裁剪图与 OCR 文本、student 只有整图,用 JSD/对比损失逼近。「教师拥有特权输入、学生只有原始输入、推理时只留学生」这条流程图两者可以完全重合。
- 一个高度一致的实证发现:学生反超教师。OneSearch-V2 的 Table 7 显示 Self-Distill (S)(推理不用关键词)0.2163 略优于 Self-Distill (T)(用关键词)0.2155,作者归因于「student 的 loss 驱动全部梯度,优化天然倾向于在信息不足条件下的鲁棒性」;PailitaoGR 的 Table 1 显示学生相对 Crop Teacher +4.76 pp、相对 OCR Teacher +2.76 pp。两个独立场景(文本电商搜索 / 图搜)得到同一个反直觉结论,互为佐证。
- 本文的差异与推进:(a)师生形态不同——OneSearch-V2 用完全共享参数的自蒸馏(self-mode),其 Table 8 专门消融过 special-token / CODI 风格 latent / EMA-mode / Joint-mode 四种内化策略,结论是 self-mode 最优;PailitaoGR 用的是独立训练的分离教师,更接近 OneSearch-V2 判定为次优的那一类,但本文未做这个维度的对照。(b)PailitaoGR 多了两层 OneSearch-V2 没有的机制:on-policy 采样(在学生自己的前缀上蒸馏,而非 ground-truth 前缀)与注意力层的显式监督(ROT + 熵)。(c)最实质的推进是「选择性」:OneSearch-V2 是无差别蒸馏(对所有有效 token 位置一视同仁做 KL),而 PailitaoGR 认为教师的优势里有一部分是有害的或学生够不着的,因此加了效用 × 可及性双门控。Table 6 显示光是加效用判据就带来约 +2.0 pp——这恰好是 OneSearch-V2 路线上留白的地方。(d)OneSearch-V2 有完整线上 A/B(+3.98% Item CTR、+2.11% 订单量),PailitaoGR 只有离线实验。
LASAR LASAR: Latent Adaptive Semantic-Aligned Reasoning for Generative Recommendation(Beihang University,2026-05-11)
关系:独立并发(本文未引用 LASAR,两者殊途同归)· 已加载对方精读
- 共同关注的问题:LASAR 的开篇诊断是「CoT 在 token 空间逐字生成,对延迟敏感的推荐系统是致命的」;PailitaoGR 的开篇诊断是「显式工具调用引入额外计算与多步推理,与在线检索的严苛延迟要求冲突」。两者指向同一个 root cause——「显式的、可观测的中间步骤」这一形式本身就是延迟负担,而不是某个具体模型不够好。因此两者的解法方向都是把中间步骤沉入不可观测的连续空间。LASAR 把这称为 latent reasoning,本文称为 latent think-with-images——命名都是「latent + 原范式名」,这本身就说明抽象层是同一个。
- 相近的技术骨架:两者都是「训练时保留显式模态作为锚点、用散度对齐、推理时永不解码它」。LASAR 用 GPT-5 为每条训练样本生成 5 段式 explicit CoT,切段后离线抽取每段的 hidden state 作为锚点 $h_t^{cot}$,用 stepwise bidirectional KL 把每个 latent step 对齐过去(式 4),推理时 CoT 永不产出;PailitaoGR 用 Crop / OCR Teacher 在特权输入上产出 SID 分布作为锚点,用 JSD 逐解码步对齐(式 14),推理时教师被完全移除。「显式锚点 → 散度对齐 → 推理期丢弃」这条主干两者完全重合。
- 本文的差异与推进:(a)对齐的层次不同——LASAR 对齐的是隐状态(把 hidden state 过 softmax 后算 KL),PailitaoGR 对齐的是输出分布 + 注意力分布两处。(b)PailitaoGR 有 on-policy 这一层,LASAR 没有:LASAR 的锚点是离线抽好的静态 hidden state,而 PailitaoGR 明确论证了 teacher-forcing 与自回归推理的前缀错配,改成在学生自己采样的轨迹 $\hat{\mathbf{s}}$ 上查询师生(式 11–13)。这一点上 PailitaoGR 更彻底。(c)LASAR 有自适应深度,PailitaoGR 没有:LASAR 用 Policy Head + REINFORCE 按样本决定 latent 步数 $N$,本文的增强器对所有样本施加同一套固定强度的残差调制($\lambda_I$、$\beta\lambda_A$ 均为超参),没有「这张图需要多强的聚焦」这样的自适应机制——考虑到 Table 2 显示不同 ROT 占比组的收益差异巨大(+29.63 pp 到 +10.26 pp),这是本文一个明显可以补的方向。(d)证据层次不同:LASAR 在 Beauty / Instruments / Sports 三个 Amazon 公开数据集上验证并给出 ~20× 加速的实测,PailitaoGR 在平台规模私有日志上验证但没有报任何延迟实测数字。
- 一个有意思的分歧:LASAR 的核心发现之一是「把 Coconut 直接搬到 SID 上会显著掉点」,必须两阶段解耦(先建立 SID grounding,再开 latent loop),否则优化塌陷;PailitaoGR 没有遇到这个问题,因为它的 latent 化发生在视觉编码器侧(改写视觉 token),SID 解码器的符号系统始终由 CE 直接监督(式 38 的 $\operatorname{CE}(q^I_t, s^*_t)$ 全程在场)。把 latent 化放在输入侧而非解码侧,天然绕开了 LASAR 遇到的 grounding-reasoning 互相干扰问题——这是本文架构选择的一个隐含优势,论文自己没有意识到。
15. 讨论与局限性
值得借鉴的设计:
- 「特权输入教师」是比「更大教师」更便宜的能力来源。本文的两个教师与学生同一个骨干、同一个规模,唯一区别是输入被工具预处理过。这意味着能力提升不需要付出教师侧的算力代价,只需要一条离线的工具流水线。这个 trick 的适用面远超图搜——任何「某种昂贵预处理能显著提升效果但线上做不起」的场景都可以套。
- 「效用 × 可及性」双门控是对朴素蒸馏的一个真正有价值的修正。教师的优势不等于学生的增益,这一点在归档里 Rec-Distill 用 $\eta$(迁移率)在模型层面量化过;本文把它下沉到 per-token 的 soft gate,并且明确处理了「有用但够不着」这第三种情形——既不迁移也不压制,避免强行模仿一个学生根本学不会的能力。这个三分法的处理比二分门控细腻。
- 把 SID 的粗到细结构当作注意力监督的调度信号($\alpha$ 递增、$\gamma$ 从 +1 翻到 −1)。这是一个把领域结构先验直接写进损失的干净例子。
局限与争议:
- 没有线上部署,也没有 A/B 实验。全文出现 0 次 "A/B"、0 次 "deploy",唯一的 "production" 出现在 Ethical Considerations 里说明数据用途。这是本篇最大的缺口:数据是工业的、场景是工业的,但验证是纯离线的。对一篇以「在线延迟约束」为全部动机的论文来说,这个缺口尤其刺眼。
- 延迟这个核心卖点完全没有实测。Figure 1 用 Low/Medium/High 的定性标注声称本方法「性能高、延迟低」,但正文没有任何 QPS、P99、单请求耗时的数字,也没有与 Crop-Assisted / Crop+OCR-Assisted 流水线的端到端耗时对比。方法确实在结构上省掉了工具调用,但 Target/Auxiliary Enhancer 的 token 级打分与残差调制本身有开销,训练时还要跑注意力权重的显式提取——这些代价一个都没量化。
- 缺少最相关的基线 OneVision。related work 明确把 OneVision 认定为「首个工业级电商视觉搜索生成式检索框架,其生成式检索器吃裁剪后的 query 图像」,这正是本文要超越的对象,但 Table 1 里没有 OneVision,只有一个自建的 Crop Teacher 作为替身。
- 公式与实现描述存在多处不一致。(a)式 14 定义 OPD 用 JSD,而 5.1 节实现细节写「we compute the forward KL divergence over the teacher's top-100 predictions」;(b)超参写 $\lambda_{\mathrm{roi}}$,方法节的损失叫 $\mathcal{L}_{\mathrm{rot}}$(ROI vs ROT);(c)3.2 节正文说「we design a Target Router」,其余全文一律叫 Target Enhancer;(d)Figure 2 里辅助残差写作 $h^{I+A}_i = h_i + \beta\lambda_A a^A_i F_A(h^I_i)$,而式 27 是 $h^I_i + \cdots$;(e)Table 4 的「+ Focusing Internalization」(76.53 / 52.93 / 57.33 / 56.75)与 Table 5 的「Full」(76.51 / 52.93 / 57.52 / 56.86)在指标定义上应当同源却对不上;(f)文中「surpasses the OCR Teacher by 2.76%」按 Table 1 复算为 2.46 pp。单看每一处都是小问题,累加起来说明稿件的实验记录与写作之间存在系统性的对不齐。
- 训练集与测试集的类目分布严重错配。女装占训练集 17.2% 却占测试集 49.2%;女鞋占训练集 23.7% 却只占测试集 12.7%。测试集虽然做了人工校验且时间上不相交,但它实际上是一个以女装为主的评测,所以「平均 +13.8 pp」这个数字很大程度上由女装类目主导。论文没有报分类目结果(只按 ROT 占比和有无 OCR 分了组),无法判断增益在类目间是否稳定。
- 对 ROT bounding box 的强依赖。$\mathcal{L}_{\mathrm{rot}}$ 需要每张训练图的检索目标框,Table 2 的分析也依赖它。论文没有说这些框从哪来——人工标注、检测模型、还是线上主体检测服务的产出?如果依赖一个额外的检测模型,那么「不需要工具」这个卖点在训练侧并不成立,只在推理侧成立;框的质量也直接决定 ROT 损失的有效性,论文没有做框噪声的鲁棒性分析。
- 方法论可扩展性:本文的做法是在冻结的 SID 空间之上做视觉侧的表征改造,SID 码本(3 级 × 8,192)由外部给定、不参与优化。这意味着 scaling 时「如何表征查询图像」可以随骨干一起长大,但「如何表征商品」被码本固化住了——两条路径无法同步扩容。同时两个教师必须为每次骨干升级重新训练,训练流水线的耦合度不低。
- 与同期路线的关系:归档里 08-26 精读的 TransRetrieval(2608.25528,同为阿里淘天,展示广告召回)明确反对生成式检索路线,主张瓶颈在每候选 FLOPs 与内积表达力,押注可 scaling 的判别式 Transformer。本文同为阿里、同为检索,却押注生成式。但两者并不构成真正的路线对照:TransRetrieval 面对的是 $10^8$ 级候选库、$\rho \approx 0.08\%$ 打分预算下的广告召回,其 root cause 是异构特征尺度失配与每候选 FLOPs;PailitaoGR 面对的是单张 query 图像内部的信息混杂,其 root cause 与候选库规模、特征异构性都无关。二者是在不同问题上做不同取舍,不宜当作同一问题上的互斥诊断来读。值得注意的倒是 Table 1 里的那个负面对照——整图 + 生成式 + 朴素 SFT 打不过 DINOv3 这样的判别式基线,某种意义上给了 TransRetrieval 一个侧面支持:生成式范式本身不自带优势,优势来自训练方法。
总体判断:方法设计有实质创新(特权输入教师 + 效用/可及性双门控 + 粒度感知注意力监督三者组合,在归档里没有见过完全相同的配方),Table 2 的 ROT 单调性分析是一条难得干净的机制证据链,消融也逐项到位。但工业验证不完整——工业数据 + 工业场景 + 纯离线结论,且核心卖点(延迟)没有任何实测,最相关的基线(OneVision)缺席,稿件本身还有多处数字与命名的不一致。这些共同把它压在「扎实的工作」区间而非「开创性工作」。